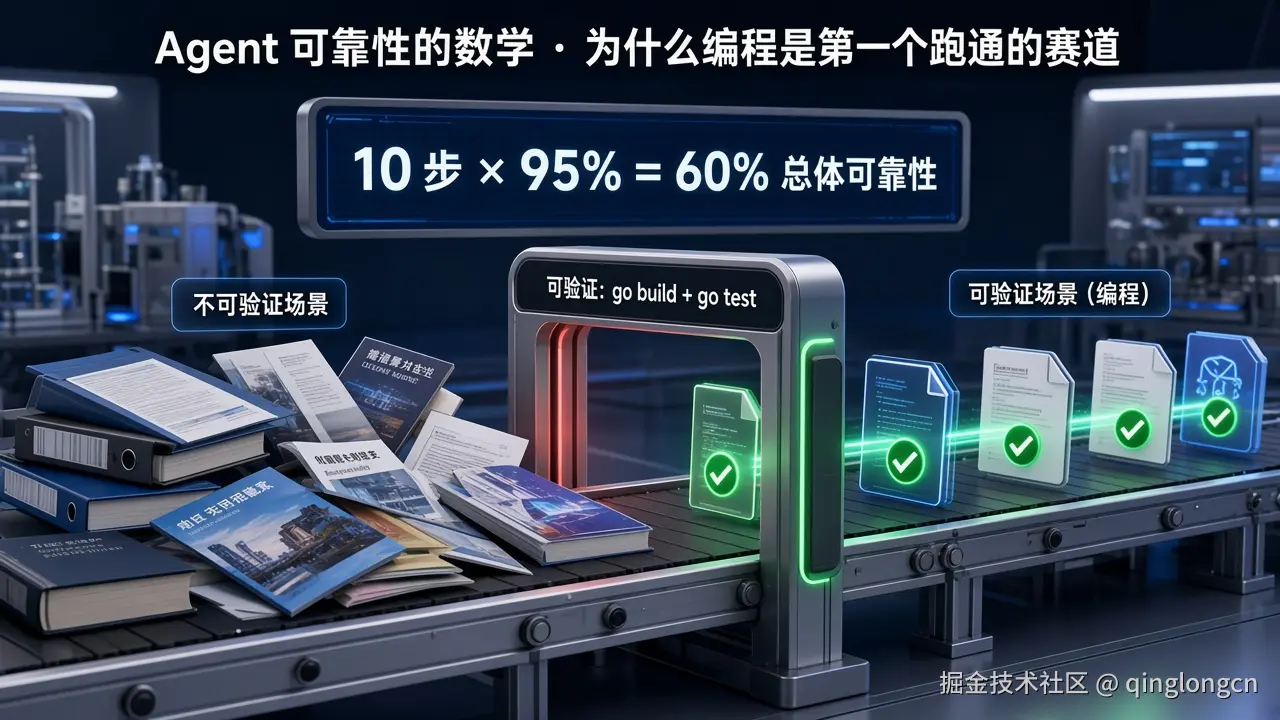
2026-10-15·什么是 Agent 引擎·什么是 Agent 引擎
SWE-bench 三年间从 1.96% 跳到 96%------不只是模型变强了。编程 Agent 率先突破,是因为代码天然拥有最强的验证闭环。理解这个模式,是预测下一波 Agent 落地赛道的关键。
一张 SWE-bench 排行榜能告诉你什么
SWE-bench Verified 是截至本文写作时最权威的编程 Agent 评测。它从真实开源项目(Django、scikit-learn、sympy 等)的 GitHub Issue 中抽取 500 个问题,让 Agent 在代码库中找到 bug 并提交修复。验证标准硬核:项目的测试套件全部通过。
三年间排行榜发生了什么?
重要说明 :SWE-bench Verified 排行榜有两个视角(swebench.com/verified)。"Bash Only"是所有模型在同一个 mini-SWE-agent 最小 bash 环境中运行,是最公平的纯模型对比;"All Agents"是各团队用定制 Agent 系统提交的结果,含多轮验证、定制工具编排等。下表标注了数据视角。
Bash Only 排行榜(纯模型对比,截至本文写作时) ------数据来源:swebench.com 官方 leaderboards.json,第三方镜像 BenchLeader、AI Choice Engine:
| 排名 | 模型 | 通过率 |
|---|---|---|
| 1 | Claude Opus 4.5 (high) | 76.8% |
| 2 | Gemini 3 Flash (high) | 75.8% |
| 3 | MiniMax M2.5 (high) | 75.8% |
| 4 | Claude Opus 4.6 | 75.6% |
| 7 | GPT-5.2 (high) | 72.8% |
| 10 | Claude Sonnet 4.5 (high) | 71.4% |
历史趋势 (同一 Bash Only 条件):2023 年 Claude 2 原始基线 1.96% → 2024 年 Claude 3.5 Sonnet 49% → 2026 年 Claude Opus 4.5 76.8%。
76.8% 看起来远没有"95%"那么震撼。但 95% 是另一个维度的数字------它来自定制 Agent 系统 的提交,含验证循环、多轮 rollout、专用工具编排。部分厂商在 system card 中自报了 90%+ 的结果,独立验证机构(如 Vals.ai)也得到了相似数字(Steel.dev 汇总),但这些数字不是 swebench.com 官方排行榜的默认展示。
这两个数字的差距本身就是本文的核心论点。 同系列模型,纯 bash 环境 76.8% vs 带验证闭环的定制 Agent 系统 90%+------差距来自验证循环,不是模型能力。
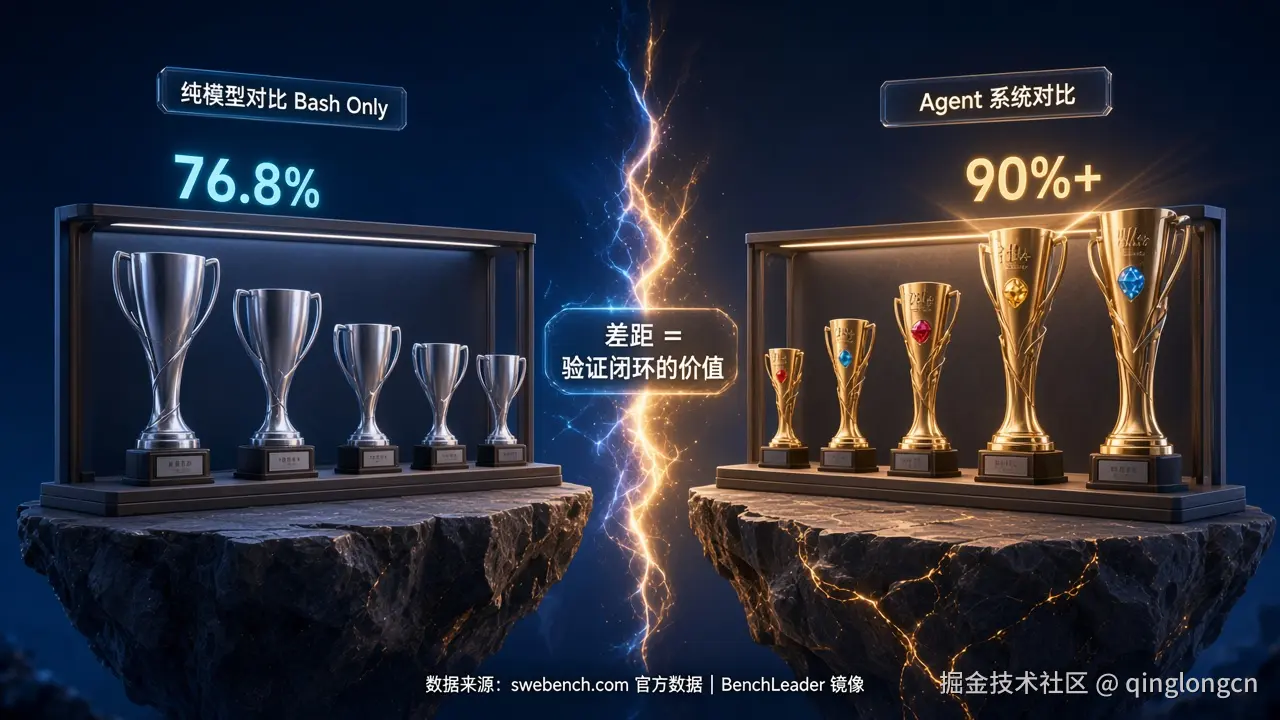
SWE-bench 的 Agent 运行时有一个编程领域独有的优势:每次修改代码后可以跑测试。测试失败了,Agent 看报错,改代码,再跑------这个"改→测→改→测"的循环可以持续几十轮。高分不是"一次就对",是经过多轮验证修正后收敛到正确答案。
Bash Only 排行榜的尾部------纯 LLM 无 Agent 循环(直接输出 patch)------通过率仍然只有个位数。
有验证循环 vs 无验证循环的差距是 10-50 倍。 这不是模型进步能解释的------同一个模型,有没有验证循环,结果天壤之别。
可靠性的数学:为什么步数是敌人
p^n 衰减
Agent 每一步------选工具、填参数、解读结果、决定下一步------都是一次概率判断。串联概率衰减是数学事实:
| 每步准确率 | 5 步 | 20 步 | 50 步 | 100 步 |
|---|---|---|---|---|
| 95% | 77% | 36% | 7.7% | 0.6% |
| 98% | 90% | 67% | 36% | 13% |
| 99% | 95% | 82% | 61% | 37% |
即便用最强模型(99% 单步准确率),100 步后整体正确率也只剩 37%。一次代码重构、一次文档审查、一次数据迁移------这些真正需要 Agent 的任务通常要 50-200 步。
级联失效让实际情况更糟
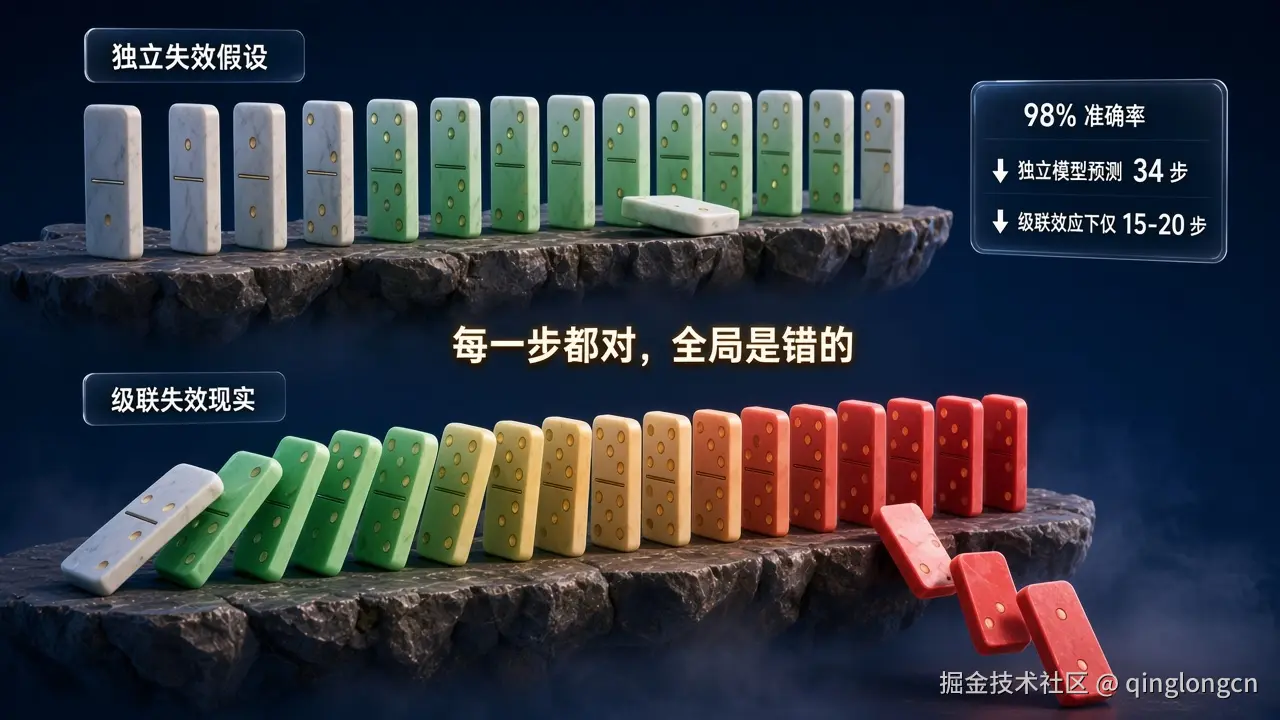
上面的 p^n 假设步骤之间独立------但现实中它们高度耦合。一步的输出是下一步的输入。一旦出错,后续所有步骤都在偏离的状态空间里"正确地"推理。
上一篇引用的 ZS Associates 多 Agent 管线就是典型案例:每一步的输出局部都正确,但全局不连贯------分析出的"原因"和推荐的"行动"之间没有因果关系。每一步都对,全局是错的。 这比某一步胡言乱语更危险,因为它看起来合理。
这意味着实际有效步长(Agent 能保持整体正确率 > 50% 的步数)远低于独立模型的预测------98% 准确率的模型,在有级联效应时可能只能可靠地跑 15-20 步,而不是独立模型预测的 34 步。
三种应对范式
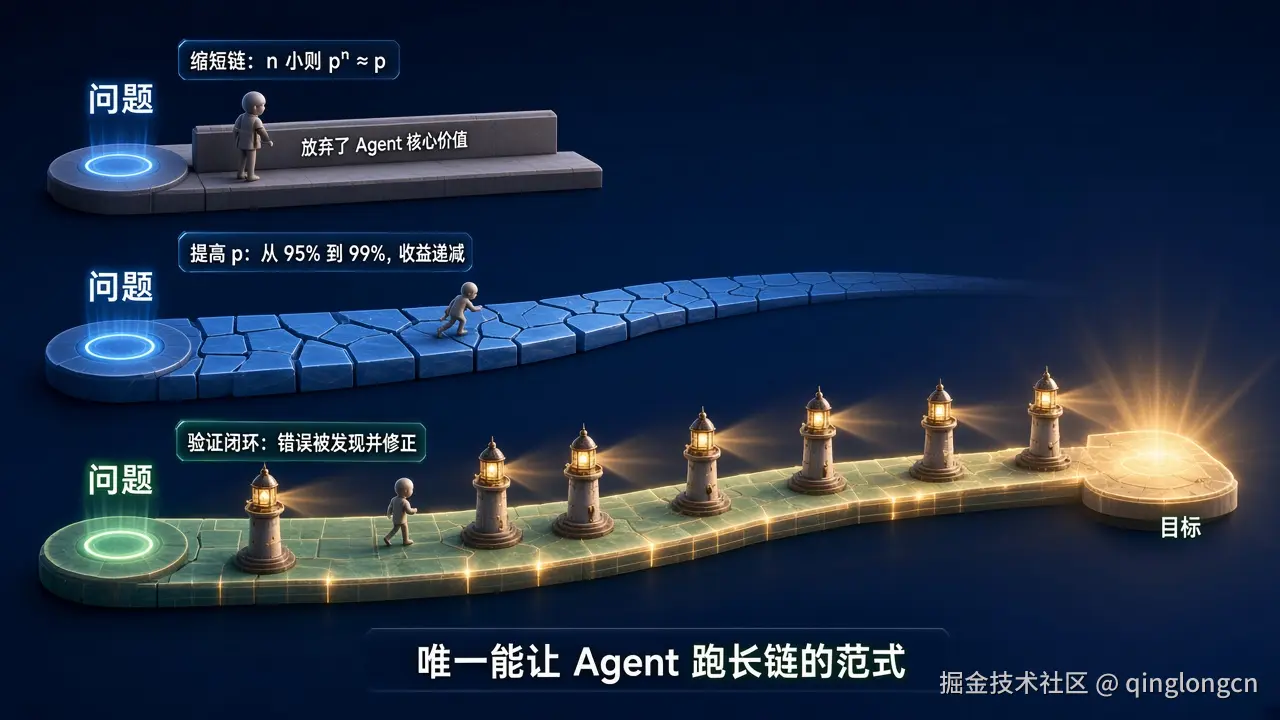
范式 A:缩短链------不让 Agent 跑太久
代表 :GitHub Copilot 单步补全(n=1)、ChatGPT 一问一答、大多数框架的 max_turns 设置。
逻辑:n 越小,p^n 越接近 p。单步补全的可靠性等于单步准确率。
问题:这放弃了 Agent 的核心价值------自主完成复杂任务。一个只能走 5 步的 Agent 是高级补全工具,不是 Agent。
评价:GitHub Copilot 靠单步补全年收入数亿美元------证明这是合理的工程折中。但它回避了问题,不是解决了问题。
范式 B:提高 p------让模型更强
代表:从 GPT-3.5 到 Claude Opus 5 的模型升级路径。SWE-bench 从 1.96% 到 95% 的大部分进步来自这里。
逻辑:把 p 从 95% 提到 99%,有效步长从 13 步延伸到 69 步。
现实:收益递减。从 95% 到 98% 相对容易,从 99% 到 99.9% 极难。而且有效步长是对数关系------p 每多一个 9,有效步长只翻一倍。Amazon 在内部发现的教训是:即便用 Claude Opus,不加 runtime 控制的任务仍然可以超预算 860% 并最终失败(Financial Times / The Next Web)。
范式 C:验证闭环------让错误能被发现和修正
这是唯一能让 Agent 跑长链的范式。
逻辑 :不是让每步都对,是让错误能被检测到 并修正。每隔 k 步做一次验证,检测到偏离就回溯修正。
数学效果:整体可靠性不再是 p^n(随总步数衰减),而更接近 p^k(随验证间隔衰减)。如果 k=3(每 3 步验证一次),即使总任务 100 步,可靠性也由 p^3 决定而不是 p^100。
这就是 SWE-bench 前十名全部在 80%+ 的原因------它们都有验证循环。编程 Agent 的 100 步任务可能实际执行了 300 次工具调用(因为"改→测→改→测"的修正循环),但 200 次试错被闭环吸收了,最终交付的是 100 步正确结果。
验证闭环把一个 p^100 的问题变成了 100 个 p^1 的问题。
编程为什么是最佳验证闭环:来自 Claude Code 和 SWE-bench 的证据
Claude Code 的官方文档(code.claude.com)描述了它的核心循环:
"Claude 通过三个阶段完成任务:收集上下文、采取行动、验证结果。这些阶段融合在一起。当你说'修复失败的测试',Claude 会:跑测试看哪个失败 → 读报错 → 搜相关文件 → 读文件理解代码 → 编辑修复 → 再跑测试验证。"
这个描述里的关键词是**"验证结果"**------它不是可选步骤,是循环的核心组成。Claude Code 官方的建议也印证了这一点:
"Claude 在能检查自己工作时表现更好。包含测试用例、粘贴预期 UI 的截图、或定义你想要的输出。"
编程验证的四个独特优势
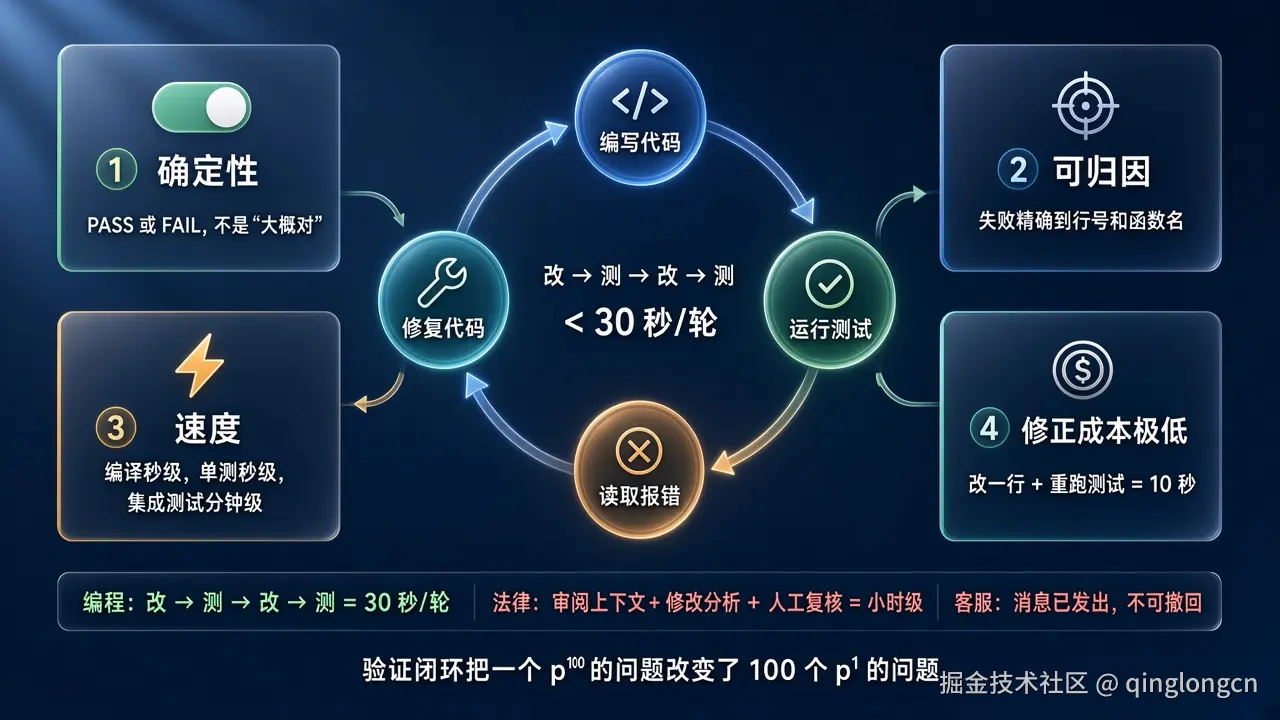
编程的验证信号有四个属性,是截至本文写作时其他领域难以匹配的:
1. 确定性 ------go test ./... 输出 PASS 或 FAIL。不是"大概对"、不是"看起来还行"。Agent 的修正循环可以完全自动化------不需要人判断"这次改对了没有"。
2. 可归因 ------测试失败精确到行号和函数名。FAIL: TestCreateUser/duplicate_email (user_test.go:47)。Agent 不需要猜"哪里出了问题",可以精确定位。
3. 速度------编译秒级、单测秒级、集成测试分钟级。一次"改→测"循环 < 30 秒。Agent 在 100 步任务中可能做了几十次这样的循环,每次消化一个错误。
4. 修正成本极低------发现错误后修一行代码 + 重跑测试 = 10 秒。对比法律:重新审阅上下文 + 修改分析 + 人工复核 = 小时级。对比客服:消息已发出,不可撤回。
SWE-bench 数据的深层含义
仔细看排行榜会发现一个模式:同一模型在不同 Agent 框架下差异巨大。SWE-bench 区分了"mini-SWE-agent"(最简 bash 循环)和各种定制 Agent 系统。定制系统通常比最简循环高 5-15 个百分点------差距来自更好的验证编排(什么时候跑测试、跑哪些测试、怎么解读失败信息)。
更有意思的是 Devin 的位置。Devin 追求全自主------Agent 独立完成整个任务,中间不需要人。但 Answer.AI 的 20 任务实测只有 30% 成功率(14 失败、3 成功、3 无定论),反复出现的模式是"花几天追逐不可能的方案而不是停下来问人"。
对比 Cursor 和 Claude Code------它们是人在循环中 的模式。用户可以随时介入、纠正方向、提供上下文。这不是"AI 更弱所以需要人帮忙"------是人是验证闭环的一部分,人的干预在关键节点截断了级联错误。
其他领域的验证困境------和突破
法律:Harvey 正在构建"法律领域的测试套件"
Harvey(法律 AI,服务 Am Law 100 中 60+ 家律所、142,000+ 法律专业人士)是非编程领域构建验证闭环最系统化的案例。
Harvey 在 2026 年发布了 Legal Agent Benchmark(LAB)------一个开源的法律 Agent 基准测试。它的设计直接映射了编程领域验证闭环的思路:
| 编程的验证 | Harvey LAB 的验证 |
|---|---|
| 测试用例 | Expert rubric(律师专家评审清单) |
| PASS/FAIL | 原子化 pass/fail 判据(事实、结论、引用、金额、格式------每项独立打分) |
| 测试覆盖率 | 跨实践领域覆盖(合同、诉讼、监管、知识产权) |
| CI/CD | 模型升级前跑 LAB 回归 |
Harvey LAB 的初始结果揭示了一个关键发现:Agent 在完成初稿后做一轮验证+修订,all-pass 分数平均提升 1.5 个百分点。 而使用代码/shell 工具做结构化分析(计算、解析、验证证据)再提升 0.3 个百分点------这等于在法律领域复现了"编程 Agent 的验证闭环"效应。
Harvey 的内部实践更具体(harvey.ai/blog/using-agents-to-scale-harveys-knowledge-sources):
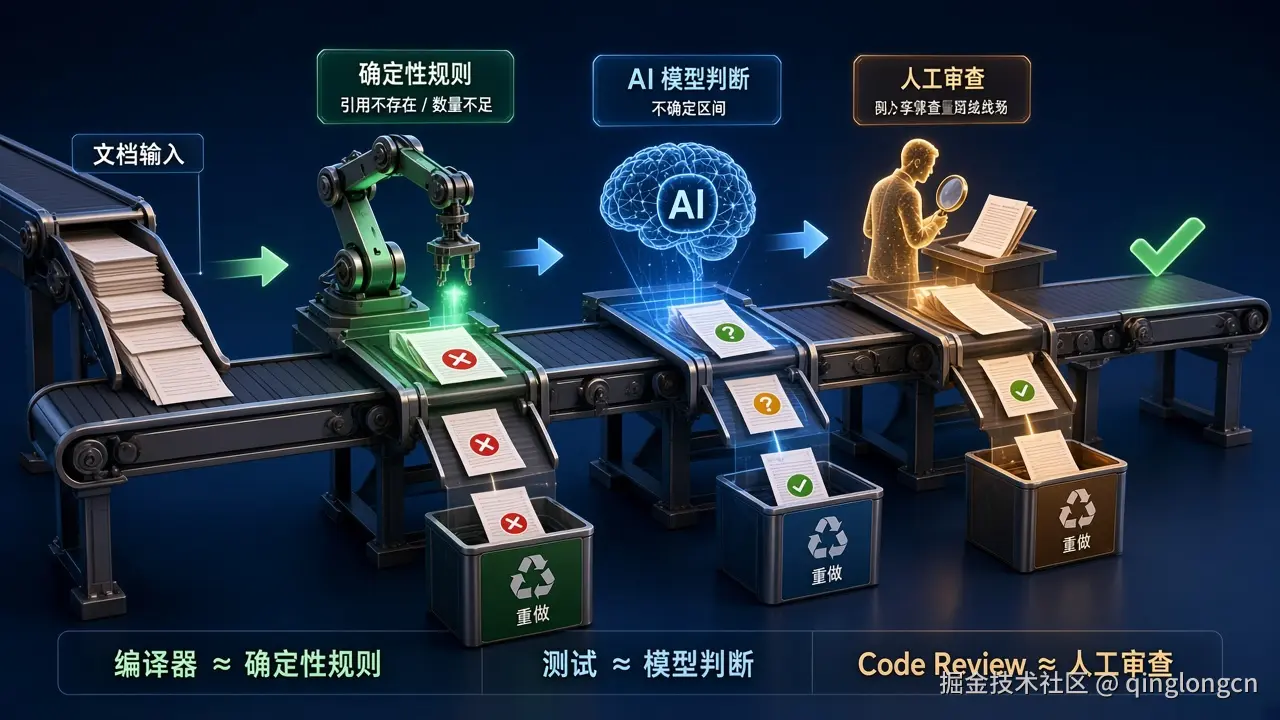
- 引用验证:Agent 引用了"第 12 条"→ 自动检查文档中第 12 条是否存在且内容匹配
- 幻觉检测 :hallucinated citations 自动拒绝
- 分级审查:确定性规则抓明显错误(引用数量过少、低质量引用比例过高),模型处理不确定区间,人工审查余下的
- 句级引用:从 cell-level 升级到 sentence-level citation------每一句话都必须有明确的引用支撑
Harvey 的策略本质上是在法律领域构建"编译器 + 测试套件"------自动检查引用准确性(类似编译器检查类型一致性)、自动检查覆盖率(类似测试覆盖率)。 它不能像编程那样二值判断对错,但它把"开放式法律分析"工程化为"结构化清单核查",每个核查项有明确的验证标准。
零售/运营:Starbucks 和 McDonald's 的反面教训
Starbucks 的 NomadGo 库存系统(11,000 家门店,9 个月后下架)和 McDonald's 的 IBM 语音点餐(3 年合作,被 TikTok 视频杀死)------它们的共同失败点恰恰是缺少编程赛道那种"改→验→改"的闭环:
- Starbucks :AI 扫描货架生成库存数据,但没有自动校验机制。幻觉库存数只有咖啡师手动验证时才被发现------这就是一个验证频率=0、验证靠人的系统
- McDonald's :AI 听到顾客语音→生成订单,但没有确认步骤。如果有一个"您是不是要 260 个鸡块?请确认"的验证闭环,整个失败模式不存在
这两个案例从反面印证了同一个命题:没有验证闭环的 Agent 系统,不管模型多强,在生产环境中都不可靠。
验证闭环三要素:一个预测框架
从以上案例提炼出一个通用分析框架------预测某个领域的 Agent 什么时候能落地,看三个要素:
| 要素 | 问题 | 编程 | 法律(Harvey) | 库存(Starbucks) |
|---|---|---|---|---|
| 检测力 | 能否自动发现错误? | ★★★★★(测试) | ★★★☆(引用验证+规则) | ★☆(靠人眼) |
| 归因力 | 发现后能否定位原因? | ★★★★★(栈追踪) | ★★★(句级引用回溯) | ★(不知道哪个货架数错了) |
| 修正力 | 定位后修正成本多大? | ★★★★★(改一行+重跑) | ★★★(修改分析+重新引用) | ★★(重新扫描整个货架) |
三个要素的乘积决定了验证闭环的有效性。 任何一个为零,闭环不成立,Agent 就退化为"跑几步就停的高级补全"。
用这个框架预测下一波落地赛道:
| 领域 | 检测 | 归因 | 修正 | 预测 | 代表性产品/实践 |
|---|---|---|---|---|---|
| 编程 | ★★★★★ | ★★★★★ | ★★★★★ | ✅ 已落地 | Cursor / Claude Code / GitHub Copilot |
| 法律审查 | ★★★★ | ★★★ | ★★★ | 🟡 正在突破 | Harvey LAB 引用验证 |
| DevOps / IaC | ★★★★ | ★★★★ | ★★★★ | 🟡 正在突破 | terraform plan 确定性预览 + apply 可回滚;devops-agent-harness(策略、审批、审计在 LLM 外) |
| 安全运营(SecOps) | ★★★★ | ★★★ | ★★★ | 🟡 正在突破 | Cloudflare 多 Agent 告警系统:告警关联 + MITRE 映射 + 证据包(Cloudflare Blog) |
| 数据工程 | ★★★★ | ★★★ | ★★★ | 🟡 接近 | Databricks Genie Code(Unity Catalog RBAC + 审计),Integrate.io 评测 |
| 供应链 / 财务 | ★★★ | ★★★ | ★★ | 🟡 接近 | Oracle Fusion Agentic Apps(审批流 + 异常检测),Oracle 公告 |
| 客服(Tier-1 简单工单) | ★★ | ★★ | ★ | ⚠️ 有条件 | 简单产品 60-75% 解决率;复杂产品需人工;不可撤回是核心风险 |
| 自由格式写作 | ★ | ★ | ★★ | ❌ 远期 | 无确定性验证标准 |
注意 DevOps 和安全运营两行 :它们的检测力和归因力已经接近编程------
terraform plan给出精确到资源的变更预览,SIEM 告警精确到 IP/进程/时间。差距主要在修正力:terraform apply可回滚但有风险,安全隔离是单向操作。Cloudflare 的做法(Agent 建议 + 分析师保留最终裁量权)是当前最务实的平衡。
关键洞察 :下一波不是"哪个领域的 LLM 更强",是"哪个领域能构建出自动验证基础设施"。Harvey 在法律领域做这件事,Cloudflare 在安全运营做这件事,Databricks 在数据工程做这件事。每一个成功案例都在复制编程赛道的模式:把开放式任务工程化为可验证的检查清单。
回到引擎视角
验证闭环不是开发者手动写的逻辑------它需要引擎层提供支撑。
几个关键需求:
- 循环必须支持"验证-修正"子循环 。
max_turns=25不区分"有用步骤"和"修正步骤"------一个花了 15 步修正错误的 Agent 只剩 10 步干活。引擎需要理解修正是有价值的步骤 - 上下文管理必须承受验证循环的 token 膨胀 。"改→测→改→测"循环中,每次测试的完整输出都进上下文。如果不智能压缩,token 很快爆炸------而压缩又可能丢掉关键的报错信息(上一篇详述了上下文腐烂问题)
- 工具执行层必须支持验证编排。"改完代码后跑相关测试"不是两个独立工具调用,是一个编排模式。引擎需要让这种编排高效
- 可观测性必须区分"正常步骤"和"修正步骤"。运维看到 Agent 跑了 300 步会紧张------除非能看到其中 200 步是验证修正循环
这些需求在"跑短了就好"的框架上实现不了。只有引擎从设计之初就把验证闭环作为一等公民,长链任务才能可靠运行。
一句话总结
Agent 可靠性 = 单步准确率 × 验证闭环效率。 模型进步提升前者(SWE-bench 从 1.96% 到 95%),工程化的验证机制提升后者(同一模型有验证 vs 无验证差 10-50 倍)。编程率先突破是因为代码天然有最强的验证闭环。下一波将是那些成功构建了领域验证闭环的赛道------Harvey 已经在法律领域这么做了。
引用来源
本文所有数据均可通过以下链接验证。 SWE-bench 数据截止日期:2026 年 10 月。
SWE-bench 数据
- SWE-bench Verified 官方排行榜 --- SWE-bench Verified
- BenchLeader 官方 Bash Only 数据镜像(读 swebench.com leaderboards.json)--- SWE-bench Verified (bash only) leaderboard: 45 AI models ranked | BenchLeader
- AI Choice Engine 官方数据镜像 --- aichoiceengine.com/ai-models/b...
- Steel.dev 汇总(含 Vals.ai 独立验证和厂商自报)--- SWE-bench Verified Leaderboard 2026: Latest Coding Agent Scores | Steel.dev
产品验证实践
- Claude Code 官方文档 "How Claude Code Works" --- How Claude Code works - Claude Code Docs
- Harvey LAB, "Introducing Harvey's Legal Agent Benchmark" --- Introducing Harvey's Legal Agent Benchmark
- Harvey LAB Initial Results --- Legal Agent Benchmark Initial Results | Harvey
- Harvey 引用验证 --- Using Agents to Scale Harvey's Knowledge Sources
- Harvey 句级引用 --- Rebuilding Harvey's Review Algorithm | Harvey
行业验证闭环实践
- Cloudflare agentic security operations --- Building an evidence-grounded agentic security operations harness on Cloudflare | Cloudflare Blog
- devops-agent-harness(策略/审批/审计在 LLM 外)--- devops-agent-harness · PyPI
- AI agents for data engineering (Integrate.io, 2026) --- Best AI Agents for Data Engineering Teams in 2026 | Integrate.io
- Oracle Fusion Agentic Applications (Apr 2026) --- Oracle Introduces Fusion Agentic Applications for Finance and Supply Chain
产品失败案例
- Devin 30% 成功率 --- Answer.AI (Jan 2025)
- Starbucks NomadGo --- Startup Fortune (2026)
- McDonald's + IBM --- ainvasion.com
- Amazon $1.8M Claude failure --- Financial Times / The Next Web
研究
- ZS Associates "Why We Killed Our Multi-Agent Pipeline" --- BigGo Finance