洪水来之前的那几天,是唯一能提前行动的时间。
洪水到来前 5 天,你的手机能不能提前响?
这个问题听起来像是技术问题,但它首先是一个性命攸关 的问题。2024 年 3 月,一篇发表在《Nature》上的论文(Nearing 等人,Nature 627: 559--563)在开篇就引了一组数字:
Early warning systems are an effective way to mitigate flood risks, reducing flood-related fatalities by up to 43% and economic costs by 35--50%.
有效的早期预警,可以把洪水相关的死亡人数降低多达 43% 、经济损失降低 35--50%。
(说明口径:这两个数字是该论文引用先前研究的结果,不是谷歌自己的测量。)
论文还给了另一个更说明问题的分布:
Populations in low- and middle-income countries make up almost 90% of the 1.8 billion people that are vulnerable to flood risks.
全球约 18 亿人面临洪水风险,其中近 90% 在中低收入国家。
**而中低收入国家,恰恰是水文观测站最少的地方。**这就构成了这一期的核心矛盾。
水里的物理:为什么洪水预警这么难
洪水预报的难处,和前面几期讲的不太一样。它不是一个"物理太复杂"的问题------径流这件事的物理,其实比湍流温和得多。
它难在"每个流域都不一样"。
一条河的水流规律,取决于它的地形、土壤、植被、坡度、城市化的程度。传统的水文模型要在每一个流域上单独标定:拿这个流域过去多年的降雨和流量数据去反复调参数,直到模型能重现历史。
这意味着两件事:
**第一,它需要很长的历史数据。**一个流域要积累够标定模型的数据,往往要十年以上。
**第二,它没法迁移。**给 A 流域调好的参数,拿到 B 流域基本不能用。
**而后面的问题就更直接了:全球大量的流域,根本没有观测站。**没有观测站,就没有历史流量记录;没有历史记录,传统模型就没法标定。
**这就是"无观测流域"(ungauged watersheds)问题------水文领域的老大难。**你要给一个从没被测量过的地方预报洪水,靠的只能是判断和推断,而不是本地的数据。
而恰恰是这些地方,最需要预警。
水里的案例:谷歌做了什么
那篇论文做的事,是换掉"每个流域单独标定"这个前提。
它用的是 LSTM(长短期记忆)网络 来预测未来 7 天的日径流。但它不是训练一个模型、然后用这个模型去套每个流域------而是在 5680 个水文站上做交叉验证,让一个模型学会"从气象输入直接推径流"这件事本身。
论文的原文是:
This AI forecast model was trained and tested out-of-sample using random k-fold cross-validation across 5,680 streamflow gauges.
它还在方法里做了更严格的测试:把所有下游站、整个气候带、甚至整个大洲的数据全部扣掉。
**这里的关键设计,是它的架构。**论文的描述是:
we developed a forecast model that uses an encoder--decoder model with one LSTM running over a historical sequence of meteorological (and geophysical) input data (the encoder LSTM ) and another, separate, LSTM that runs over the 7-day forecast horizon with inputs from meteorological forecasts (the decoder LSTM).
两个 LSTM,各干一件事:
- 编码器 LSTM 读的是历史序列------过去一段时间的气象和流域属性;
- 解码器 LSTM 跑的是未来 7 天------输入是气象预报。
**这个设计请记住,本期最后一节会回到它。**因为它其实说明了一件很容易被忽略的事。
关键突破:没有观测站也能预测
结果就是这一期最该讲清楚的一句。论文摘要的原话是:
artificial intelligence-based forecasting achieves reliability in predicting extreme riverine events in ungauged watersheds at up to a five-day lead time that is similar to or better than the reliability of nowcasts (zero-day lead time) from a current state-of-the-art global modelling system.
翻译:在无观测流域,AI 能提前最多 5 天给出预报,而它的可靠性,相当于------甚至超过------当前最先进的全球建模系统"当天"给出的预报。
"当天的预报水平"这个基准很值得琢磨。
那个系统叫 GloFAS(Global Flood Awareness System),是欧盟哥白尼应急管理服务的全球洪水预报系统,由欧洲中期天气预报中心(ECMWF)运营。论文用的是 GloFAS 第 4 版,2023 年 7 月上线的现行运行版本。
所以这个突破可以这么说:AI 把"提前预警的时间"从几乎为零,拉到了 5 天。
论文里还有一句关于区域差异的:
We extended, on average, the reliability of currently available global nowcasts (lead time 0) to a lead time of 5 days , and we were able to use AI-based forecasting to improve the skill of forecasts in Africa to be similar to what are currently available in Europe.
**在非洲,AI 把预报技能提到了接近欧洲当前的水平。**这句话的分量在后面:全球洪水预警最大的缺口就在这类地区,而"接近欧洲水平"意味着差距缩小了一大截。
结果的分寸:不是到处都赢
到这一节,是这一期最需要慢下来读的部分。
因为"AI 更好"这个结论,在这篇论文里是有条件的。
论文给了一组按"重现期"拆开的数字,原文是:
The AI model improved over (was at least equivalent to) GloFAS version 4 in 64% (65%), 70% (73%), 60% (73%) and 49% (76%) of gauges for return period events of 1 year, 2 years, 5 years and 10 years.
翻译成一张图:
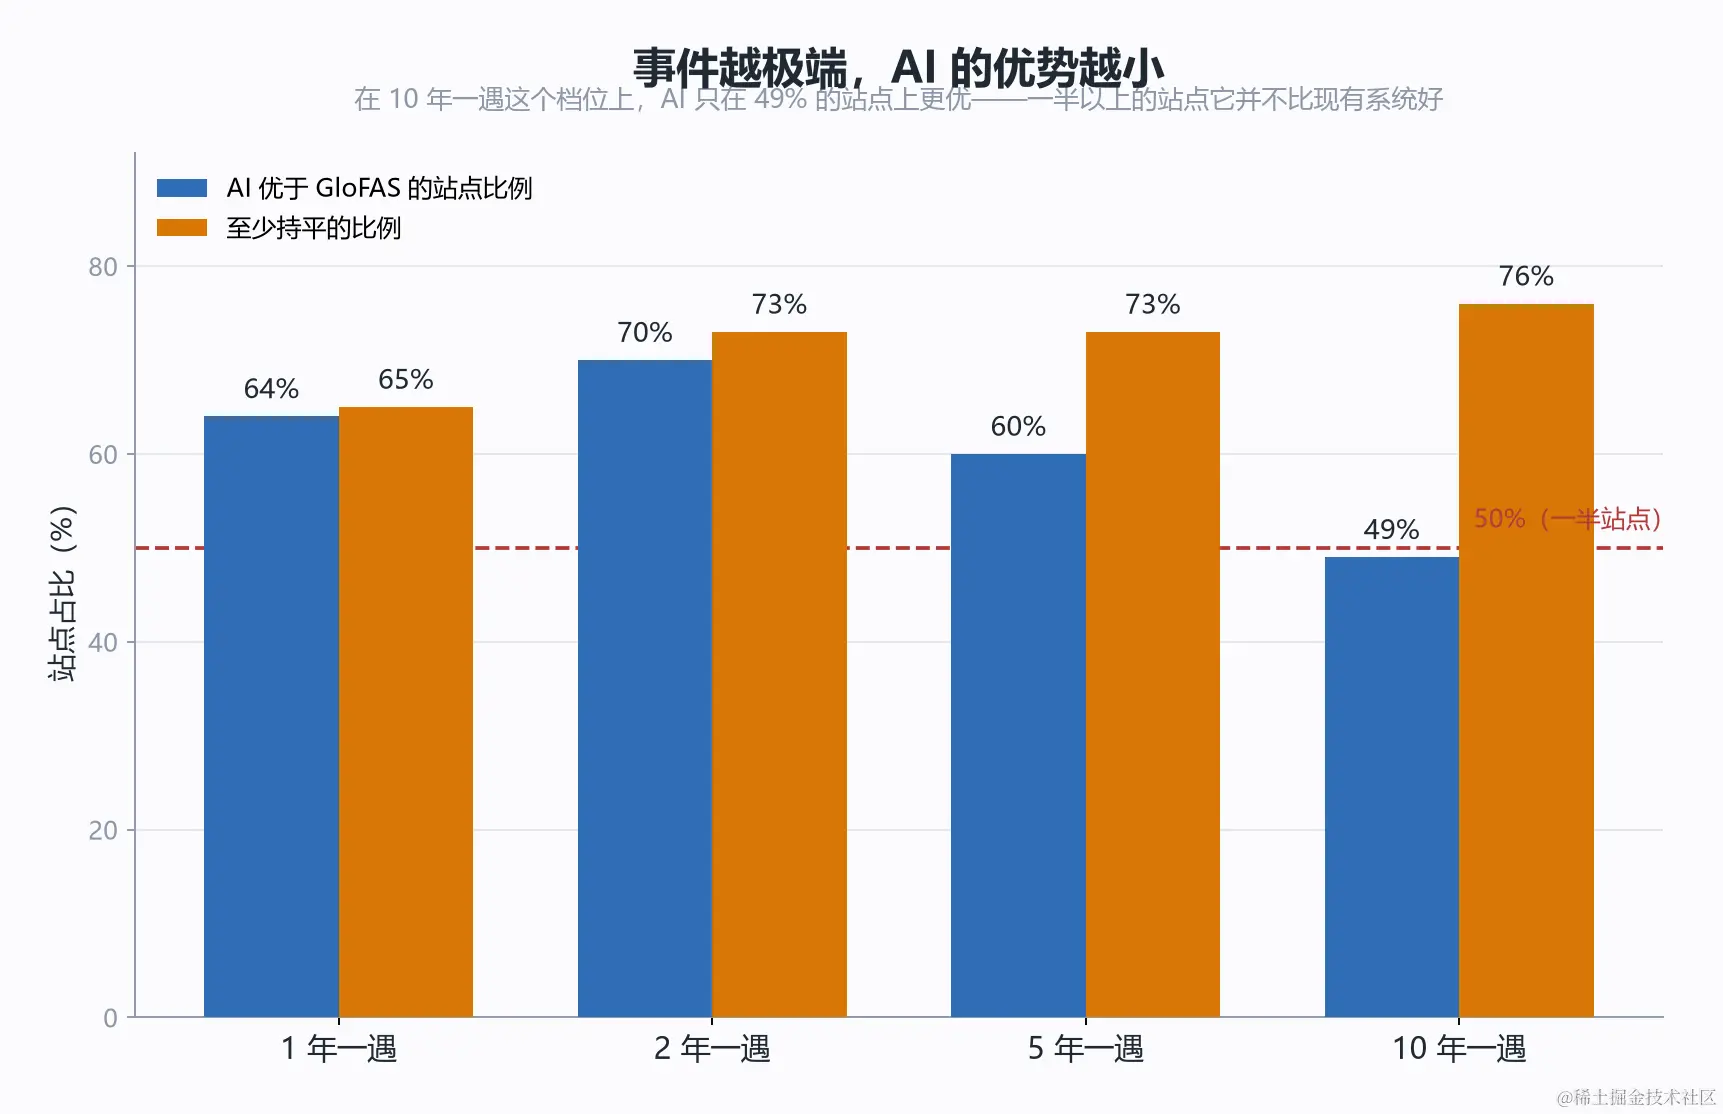
蓝色是"AI 更优"的站点比例,橙色是"至少持平"。请重点看最右边那一组。
**越极端的事件,AI 的优势越小。**在 10 年一遇这个档位上,AI 只在 49% 的站点上更优 ------也就是说,一半以上的站点上它并不比现有系统好。
为什么会这样,其实不难理解 :越极端的事件,历史上发生的次数越少,模型能学到的样本越有限。1 年一遇的事件各地每年都有,10 年一遇的事件在一个流域里十年才一次------后者的"教材"本来就不够。
**而洪水预警真正要防的,恰恰是极端事件。**这是个必须说清楚的矛盾:AI 在常见事件上优势最大,而最需要它的地方,是罕见事件。
论文还提到了区域上的例外。虽然总体上"AI 在所有大洲、所有重现期上得分更高",但有三处没有统计显著差异:非洲的 1 年一遇、亚洲的 5 年一遇和 10 年一遇。
第三处尤其值得注意:在亚洲,5 年和 10 年一遇的事件上,AI 并没有显著胜过现有系统。
还有一条,是论文自己交代的,也是最重要的分寸:
unlike the AI model, GloFAS was not tested completely out-of-sample. GloFAS predictions came from a combination of gauged and ungauged catchments, and a combination of calibration and validation time periods.
**和 AI 模型不同,GloFAS 没有做完全的样本外测试。**它的预测来自"有观测站和无观测站流域的混合",以及"标定期与验证期的混合"。
这句话的意思很直白:这场比较,对 AI 是更严格的,对 GloFAS 是更宽松的。
论文很诚实地把这一点写出来了。而它之所以必须写出来,是因为如果不写,这个比较就会显得比实际更强。
这三条合在一起,才是这一期准确的结论:
AI 在洪水预报上的进步是真的(尤其在无观测流域、在提前量上),但它不是全面替代,越极端的事件优势越小,而且对比本身还有一处对基准不利的偏差。
一个被忽视的事实:它每天早上也得先看天气预报
现在回到那个架构------为什么是"两个 LSTM"?
因为 AI 预报员算不出天气。
论文里关于输入数据来源的一段,写得毫无歧义:
Input data came from the following sources. Daily-aggregated single-level forecasts from the ECMWF Integrated Forecast System (IFS) High Resolution (HRES) atmospheric model. Variables include: total precipitation (TP), 2-m temperature (T2M), surface net solar radiation (SSR), surface net thermal radiation (STR), snowfall (SF) and surface pressure (SP).
它的第一条输入,就是 ECMWF 的 IFS 高分辨率大气模式给出的逐日预报------总降水、2 米气温、净太阳辐射、净热辐射、降雪、地表气压。
这些不是 AI 算出来的。它们来自一个基于物理的数值天气预报模式。
所以那个架构的分工是这样的:
- 气象这一层 (未来会不会下雨、下多少、多热)→ 物理数值模式提供;
- 径流这一层 (这些雨落到这个流域,会变成多大的洪峰)→ LSTM 学出来。
AI 做的,是把"气象预报"翻译成"洪水"。它没有也不需要重算大气。
这就是本系列一直在铺的那条暗线,在这一期最清楚:AI 不是站在物理模型的对立面,它是站在物理模型的输出上。
那位类比说得挺准:AI 是一位读遍了全球水文档案的预报员,但他每天早上还得先看气象局发的天气预报。
**而且这个依赖是有代价的------它把风险也一并接收了。**如果那一份气象预报本身错了(比如降雨落区偏了 50 公里),那么后面这个非常聪明的 LSTM,会把一个错误的输入非常高效地转换成一个错误的洪水预警,而且它不会告诉你"我在上游就被误导了"。
这是上一期讲过的"假信心"在水文上的版本:下游模型再准,也补不回上游的错。
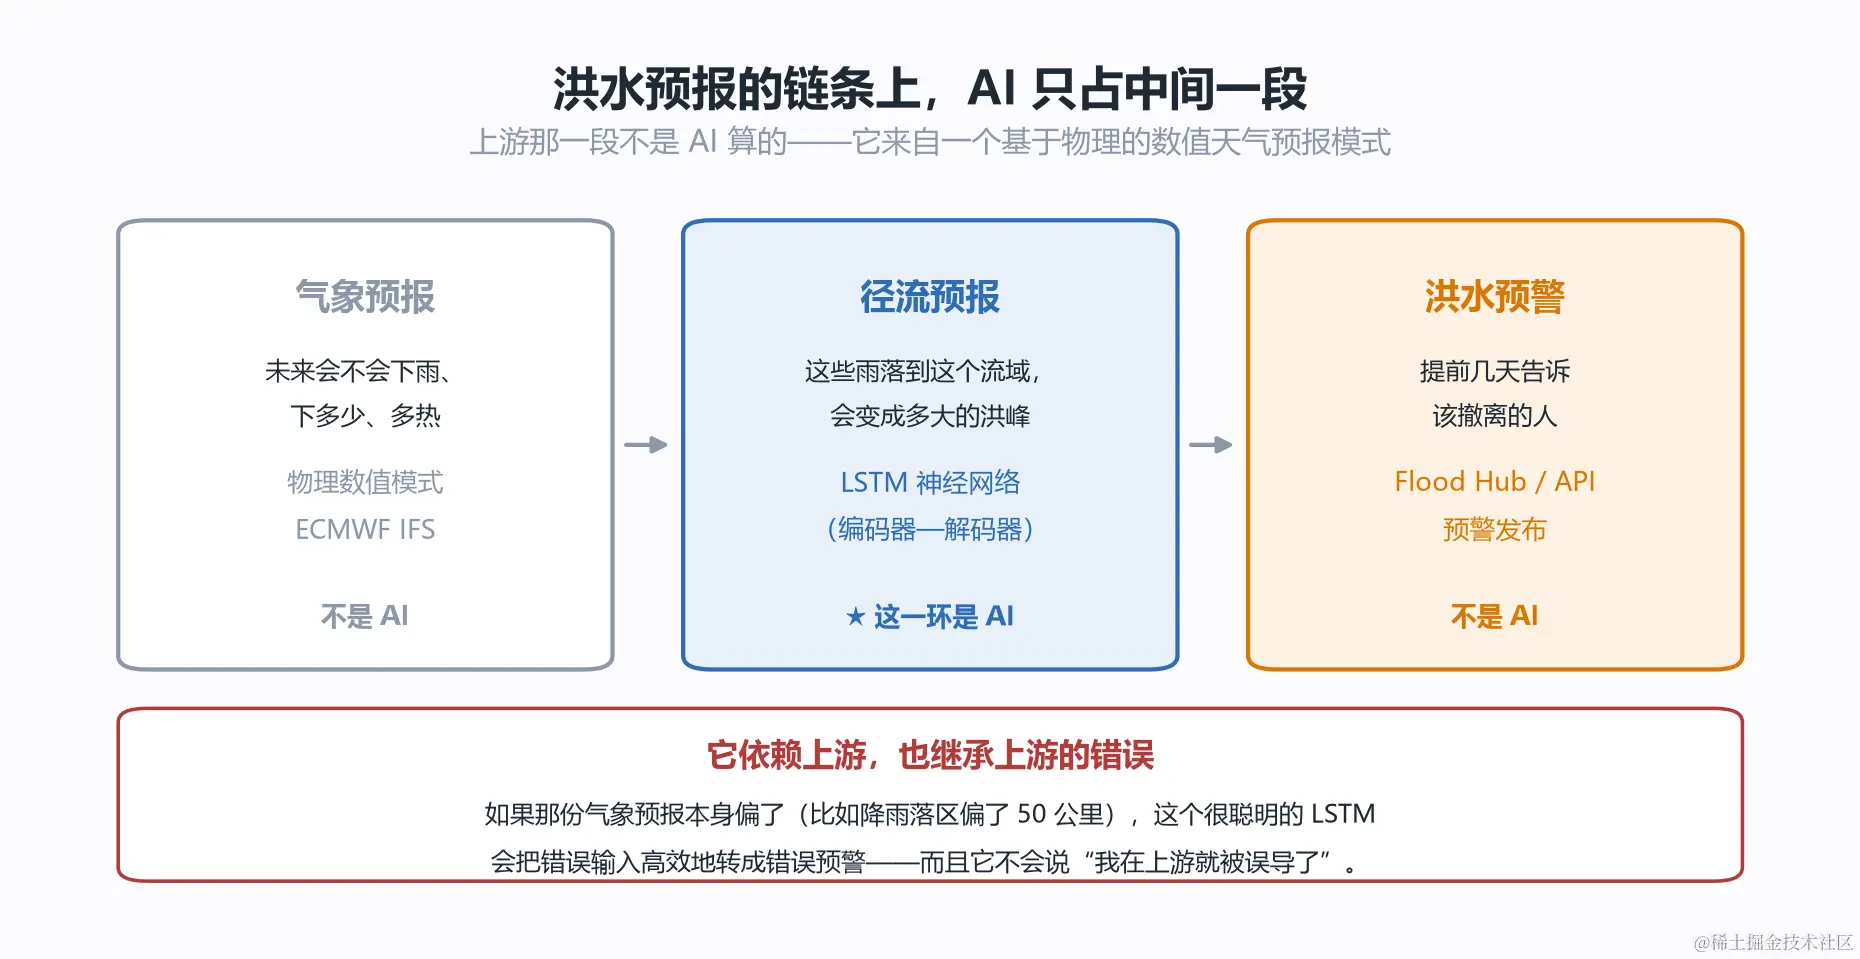
这张图是本期最重要的信息:AI 只占了链条中间的一段。
用到哪,以及你的行业
先说要紧的:这套东西不只是论文。
谷歌把它做成了可用的产品和服务:Flood Hub 提供洪水预报的可视化;还有对外的预报 API ;论文里用的模型有研究版本,实现在开源仓库 NeuralHydrology 里。
覆盖范围要标年份,因为它一直在扩:2024 年的论文里是 80 多个国家 ;据谷歌 2026 年 8 月的博客,现在是覆盖 150 个国家、为超过 20 亿人提供早期预警。
⚠️ 顺带交代一个查证结果:谷歌的博客还提到了一套叫 Groundsource 的方法,说它通过分析历史新闻报道,在没有传感器的地区也能预报洪水。这套方法的具体效果数字(转述中出现的 60%/82%)我在本文不使用------它们来自一篇预印本,尚未经过同行评审。等讲到"没有数据的地方怎么预警"那一期再说。
现在说这一期真正想让你带走的。
上一节的架构,其实映射到每一家做预测的公司:
你们的预测模型,输入里有多少环节不是你们自己能验证的?
具体一点,用三个问题去对:
第一问:你的模型最上游的那个输入,是谁给你的?
洪水预报的上游是气象预报。你们的呢?可能是宏观经济数据、可能是上游供应商的产能、可能是平台的流量分配、可能是一份别人给你的市场调研。这些输入你没有算,你只是收下了。
第二问:那个输入错了,你的模型能发现吗?
这是关键的一问。洪水预报里,AI 是发现不了的 ------它拿到降雨预报就往下算,算得又准又快,但算的是"如果这个降雨是真的"。它能保证自己的转换是准确的,保证不了输入是真的。
大多数公司的预测模型也是这个结构。
第三问:你能给上游加一道你自己的校验吗?
这不一定做不到。有些做法是可行的:用另一个独立来源交叉验证上游输入 ;监控上游输入本身的异常 (比如它的分布突然变了);或者给输出加不确定性------不是只给一个数字,而是给"如果上游偏了,我的结果会偏多少"。
而这三问合起来,就是本系列那条暗线的实操版本:
纯物理的模型慢,但它每一环都能验证;纯数据驱动的模型快,但它会忠实地把上游的错传下去。而真正靠得住的系统,是把两者接起来------并且说清楚哪一环是谁负责的。
说到底,这一期的标题可以是"一场洪水的 AI 推演",但更准确的说法是:
一场洪水里,AI 推演的是中间那一段。前面那一段,是物理算的。