Agent开发入门系列第 2 篇 · 读这一篇需要 6 分钟
先说一个很常见的翻车现场。
一个 Agent 接了完整的工具链,跑「查一下公司今年的差旅政策然后总结给我」这种任务。它输出了一个结构漂亮、条目齐全、语气笃定的答案。政策里有的它说了,政策里没有的------它也说了。同事差点直接转发出去。
问题不在模型,换成更强的模型一样。根源在前一步:整个过程里,Agent 从来没有真的读到过那份差旅政策。文件在磁盘上,但它没进上下文。模型没有眼睛看到的东西,只能靠参数记忆去补------而参数记忆会补得很像真的。
这就是我想在这一篇讲清楚的事:上下文决定 Agent 能看到什么,而 Agent 只能基于它看到的信息做决策。
上一篇我们把上下文叫作"眼睛",说它是一个复合体。这一篇往下钻一层,把这个复合体的五块拆开,看每一块装什么、起什么作用,以及------删掉它会发生什么。
一、一次推理,上下文里到底有什么
从 API 视角看,Agent 每一次调用 LLM,传进去的上下文都由五部分组成。
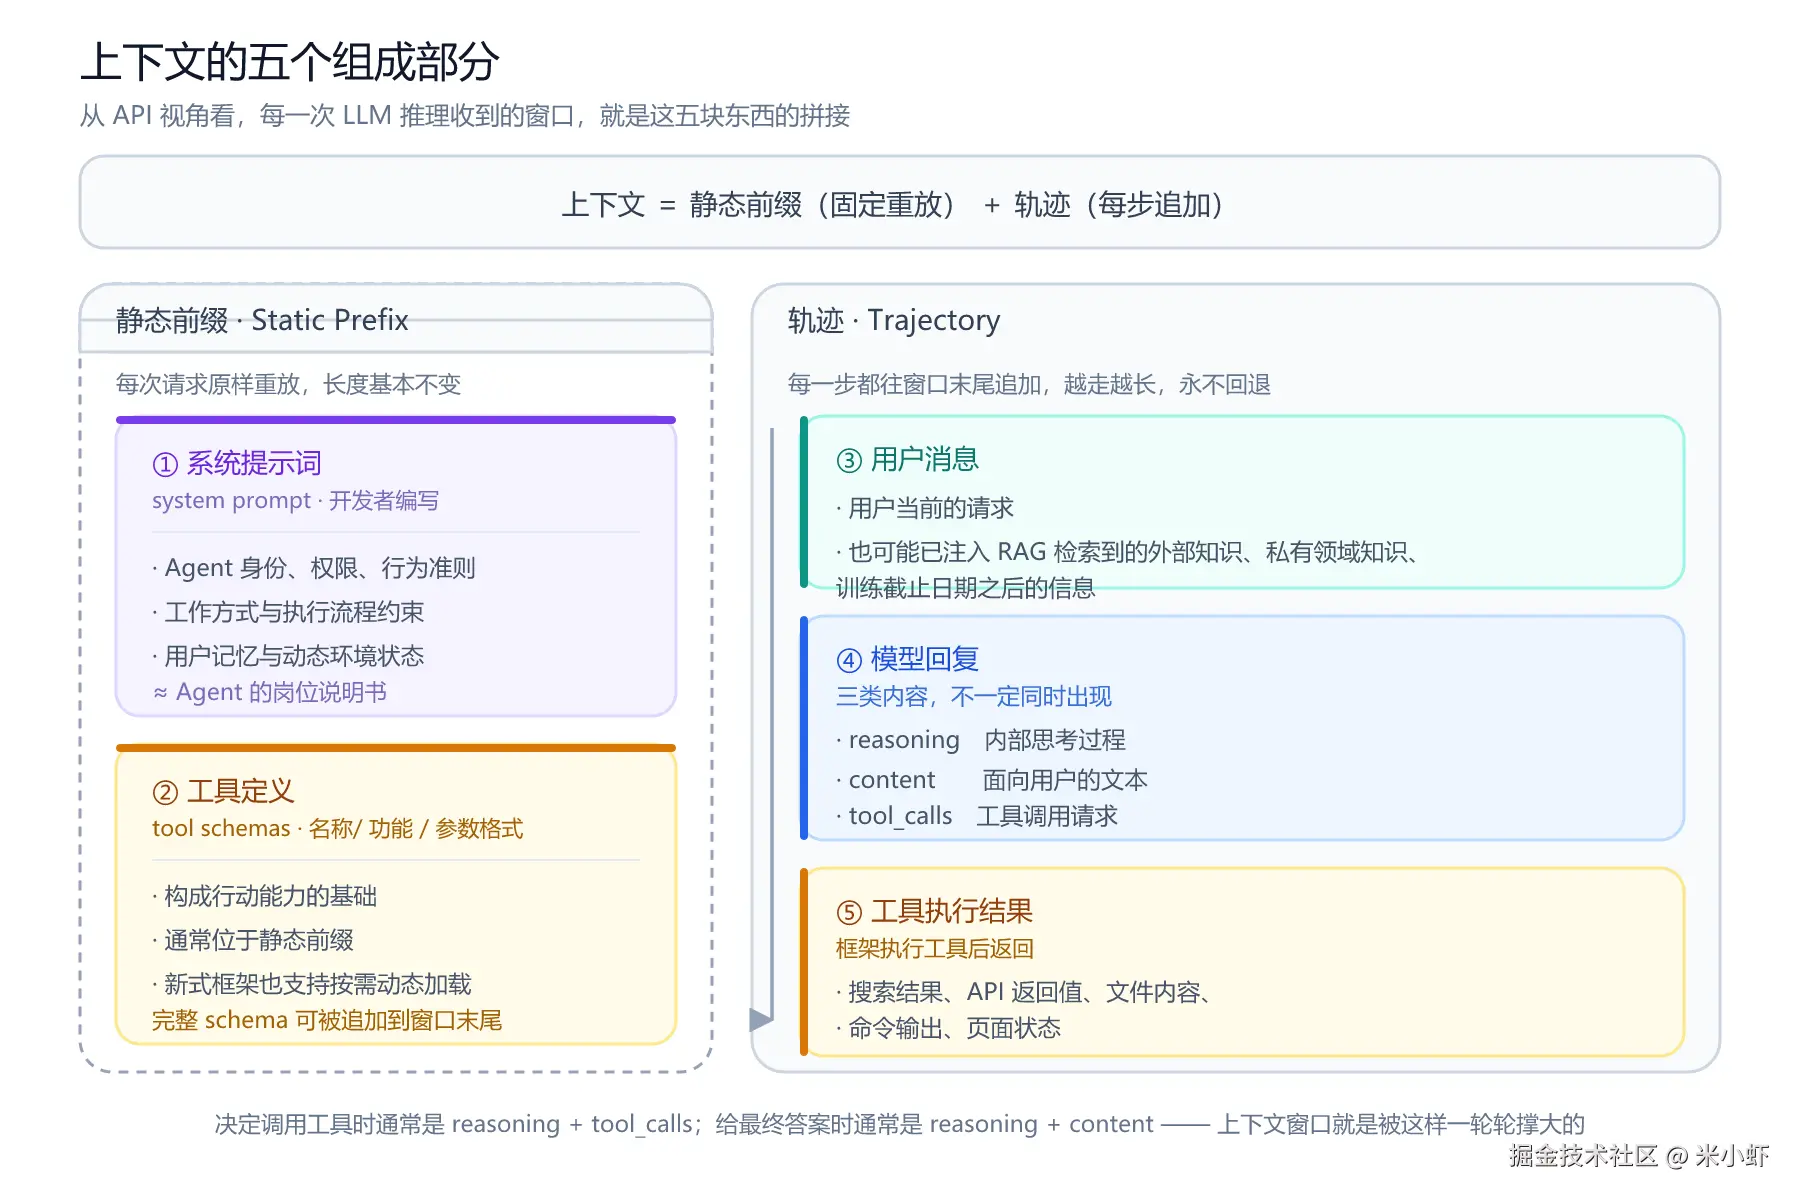
① 系统提示词:Agent 的岗位说明书
由开发者编写,不是模型生成的。它定义的是 Agent 的身份和行事方式:
- Agent 是什么角色
- 有什么权限、边界在哪
- 行为准则(比如"不确定时必须先查证,不许估计")
- 工作方式与执行流程
- 这个用户的记忆
- 当前动态的环境状态
把它理解成新员工入职时那份岗位说明书------只不过这份说明书每个决策点都会被重新读一遍。
这里有个值得注意的细节:用户记忆和动态环境状态被放进了系统提示词。这意味着系统提示词不是一段静态文本,它有一部分是每轮重新拼装的。后面讲到轨迹增长时你会看到,这两个东西的性质完全不同。
② 工具定义:Agent 的手部说明书
工具定义包含三样东西:名称、功能、参数格式。它们构成 Agent 行动能力的基础------没有工具定义,模型就是纯文本输出。
通常它位于上下文的静态前缀 里。但值得注意:新式生产框架开始支持按需把完整的工具 schema 动态加载到上下文末尾,而不是开局就全塞进去。工具一多,开局全塞会让上下文迅速膨胀,而绝大多数任务只用到其中一两个。
③ 用户消息:任务的起点
用户当前的请求。但它不一定只是那句自然语言------RAG 检索到的外部知识、私有领域知识、训练截止日期之后的信息,也常常被拼进用户消息这一块。
换个说法:这一格装的是"任务本身 + 任务需要的背景资料"。检索增强本质上是把检索结果伪装成用户的一部分送进去。
④ 模型回复:模型那一侧的全部输出
这是最容易被简化的一块。模型的回复包含三类内容:
| 类型 | 内容 | 什么时候出现 |
|---|---|---|
reasoning |
内部思考过程 | 几乎每次都有 |
content |
面向用户的文本 | 要给最终答案时 |
tool_calls |
工具调用请求 | 决定动手时 |
这里有个容易忽略的点:一次回复不一定同时包含三类。
- 决定调用工具时 → 通常是
reasoning + tool_calls - 给最终答案时 → 通常是
reasoning + content
记住这个组合,后面判断"哪部分可以省"时要用到。
⑤ 工具执行结果:Agent 唯一的现实反馈
框架执行完工具后返回给模型的东西:搜索结果、API 返回值、文件内容、命令输出、页面状态。
这是模型下一步决策的直接依据。第 1 篇讲的那个闭环,靠的就是这一格把环境的新状态送回模型的眼睛。
二、关键结构:静态前缀 + 轨迹
五块东西摆在一起容易记乱。换一个切分方式,结构立刻清楚得多:
上下文 = 静态前缀 + 轨迹
静态前缀 = 系统提示词 + 工具定义 轨迹 = 用户消息 + 模型回复 + 工具执行结果(随交互不断增长)
区别在会不会随交互增长。
静态前缀每次请求原样重放,长度基本不变;轨迹则是每一步往窗口末尾追加,越走越长,永不回退。
这个视角的价值在于,它直接把"上下文工程"拆成了两件不同性质的工作:
- 管好静态前缀 ------ 是信息设计问题。写什么、不写什么、放什么顺序
- 管好轨迹 ------ 是预算管理问题。哪些该留、哪些能压、哪些能重建
用伪代码看轨迹的追加过程会更直观:
python
# 静态前缀:每轮重放,不增长
static_prefix = [
    system_prompt,          # ① 身份、准则、用户记忆、环境状态
    tool_definitions,       # ② 也可能按需追加到窗口末尾
]

# 轨迹:随交互不断追加
trajectory = [user_message]     # ③ 任务起点 + RAG 检索结果

while not finished:
    trajectory.append(llm(static_prefix + trajectory))
    # 这一步 append 的是 ④ 模型回复:reasoning + (content | tool_calls)

    if last_reply.has_tool_calls:
        trajectory.append(execute_tools(last_reply.tool_calls))   # ⑤
    else:
        finished = True

# 上下文窗口 = static_prefix + trajectory
# 每一轮循环,窗口都变得更长注意最后那行。轨迹是只增不减的------这直接引出了长任务里的上下文预算问题,后面"什么时候这个说法会失效"那节会展开。
三、上下文消融实验:每个组件到底有多重要
上面五块,哪些是"可有可无的装饰"?哪些是"拆了就报废"?
原书给了一个很干净的做法:做消融实验------每次只从完整上下文里移除一个组件,看 Agent 退化多少。
实验设计
五个组件里选四个做消融,每次只动一处,与完整基线对照:
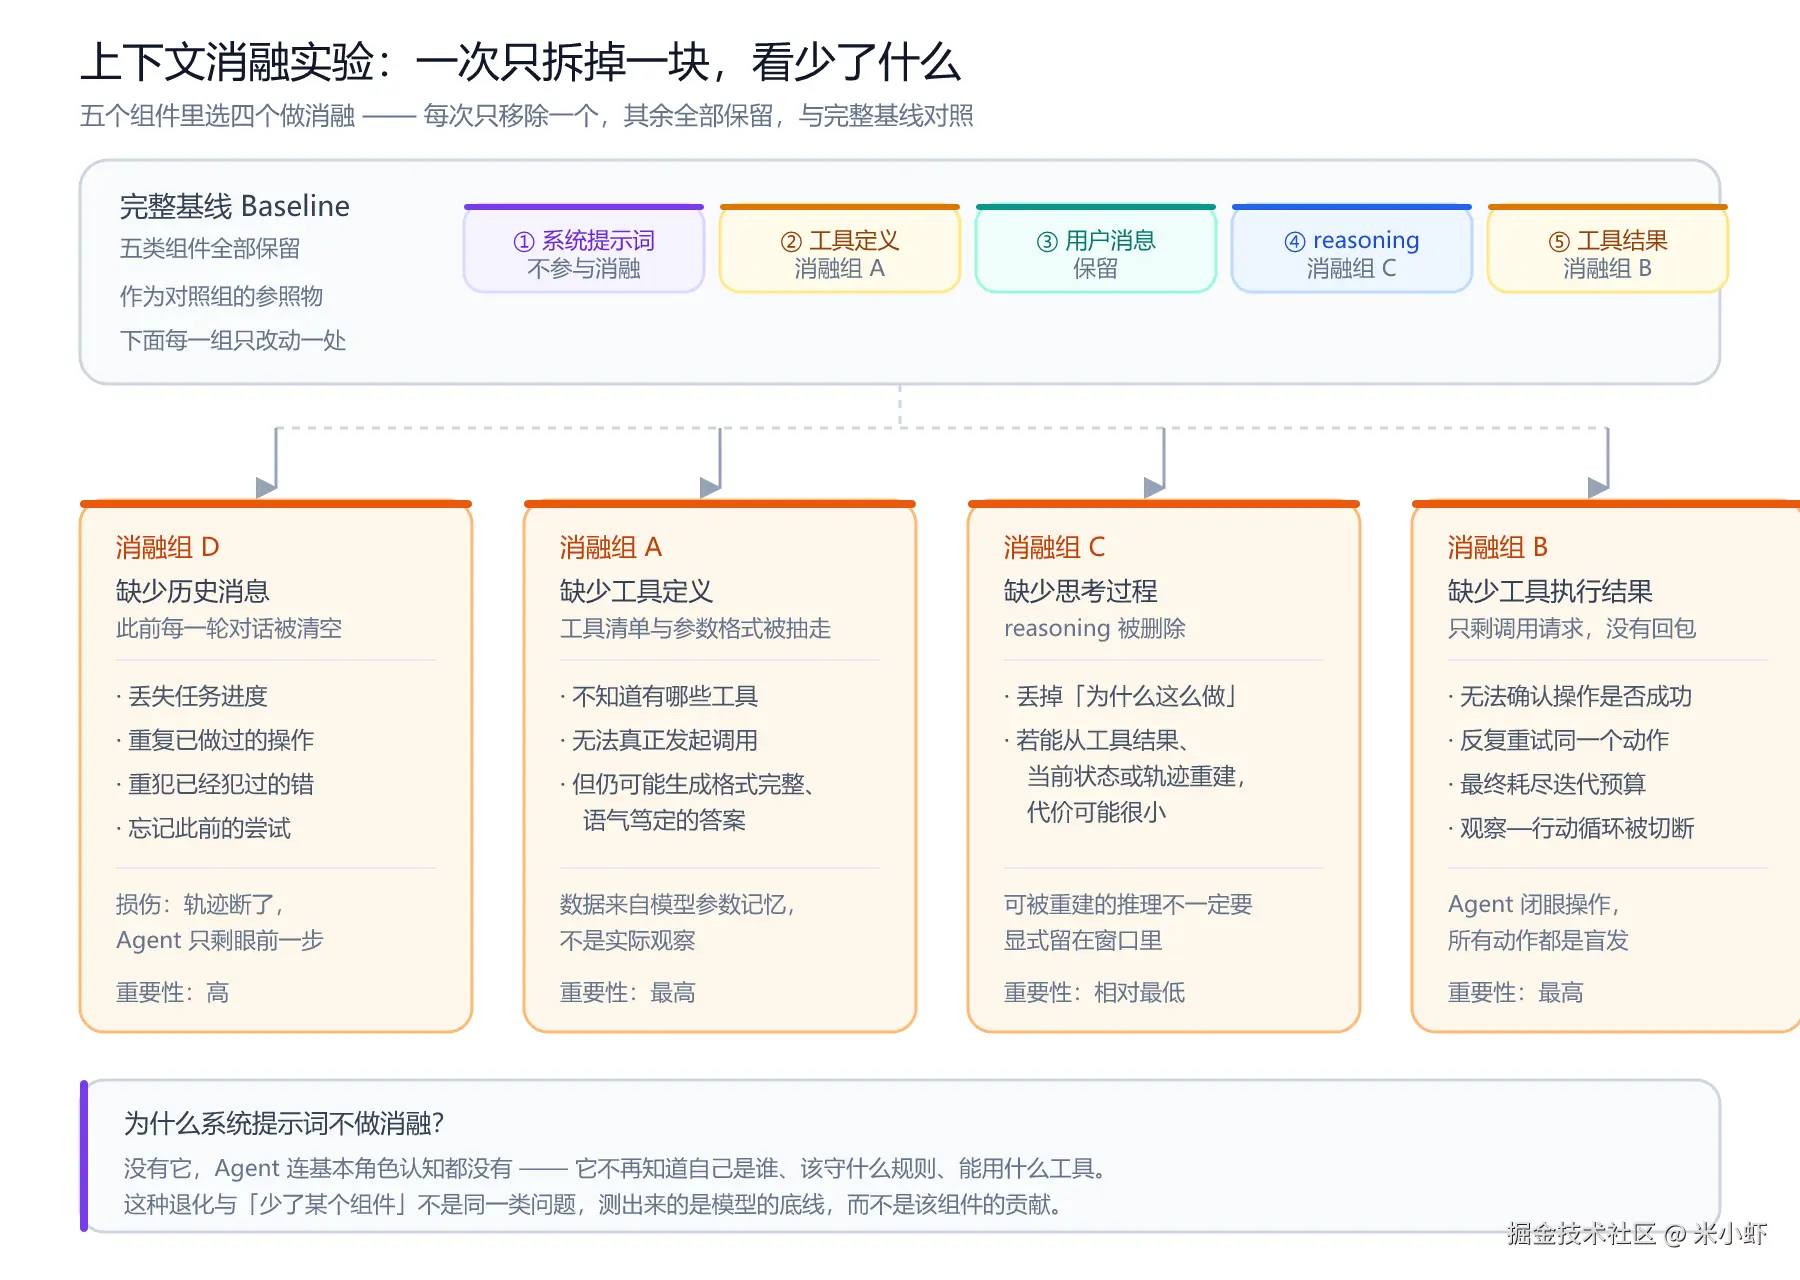
系统提示词不参与消融。 原因很实在:没有它,Agent 连基本角色认知都没有了------它不知道自己是谁、该守什么规则、能用什么工具。这种退化测的是模型的底线,而不是"系统提示词这一块的贡献"。测出来的东西没有解释力。
需要说明的是,这组消融得出的不是分数,而是定性判断:哪个组件一删就伤筋动骨,哪个删了还能凑合。
组件一:工具定义 ------ 删掉它,Agent 就只知道自己在瞎猜
工具定义告诉 Agent:有哪些工具可用、怎么生成正确的调用。
删掉它的后果分两层,第一层是预期的,第二层是危险的:
- 预期的:Agent 无法真正调用工具
- 危险的:它仍然可能生成格式完整、语气笃定的答案
第二层才是关键。模型在训练时见过海量的 API 文档、代码注释、问答对,"某某接口的返回结构是这样的"这类知识大量沉淀在参数里。工具定义被撤走之后,它会从参数记忆里补一个看起来很像的答案。
这里有个坑必须点出来:很多人以为在提示词里写一句"不得自行估计、必须依据工具返回结果"就能解决问题。这只能降低编造概率,不能消除幻觉。 提示词是软的约束,模型仍有概率偏离它。要真正兜住,只有两条路------工具层面的验证 ,以及对结果合理性的校验。第8 篇讲三层护栏时会展开。
组件二:工具执行结果 ------ 删掉它,观察---行动循环断裂
工具结果告诉 Agent 实际发生了什么。它的作用是关闭"观察---行动"这个循环。
没有它,后果链条很清晰:
- 无法确认上一次操作到底成功了没有
- 于是反复重试同一个动作
- 反复重试消耗迭代预算
- 最终耗尽预算,任务中断
换个说法:没有工具结果,Agent 就是在闭着眼睛操作。 它只能看到自己发出的指令,看不到指令造成的后果。
组件三:思考过程 ------ 出乎意料地不重要
reasoning 记录的是"为什么这么做"。
消融的结论有点反直觉:如果推理过程能从工具结果、当前状态或轨迹中重新构建出来,删掉 reasoning 的代价可能很小。
换句话说,reasoning 是一份可以被重建的记录,而不是不可替代的信息源。如果某条推理能被环境现状推导出来,就没有必要把它显式留在窗口里。
这是本篇最值得记住的一条判断------它直接关系到你在做上下文压缩时,哪些内容可以扔。下面把四个组件的次序拉平看。
组件四:历史消息 ------ 删掉它,轨迹断裂
历史消息记录的是任务进度。它承担四件事:
- 记住任务进行到哪一步了
- 防止重复操作
- 避免重复犯错
- 保留此前的尝试(失败的那些也是信息)
删掉之后 Agent 只剩"眼前这一步"。它不知道自己刚做过什么,也不知道某个方案已经试过并且失败了------于是很可能把它再试一遍。
四者的相对次序
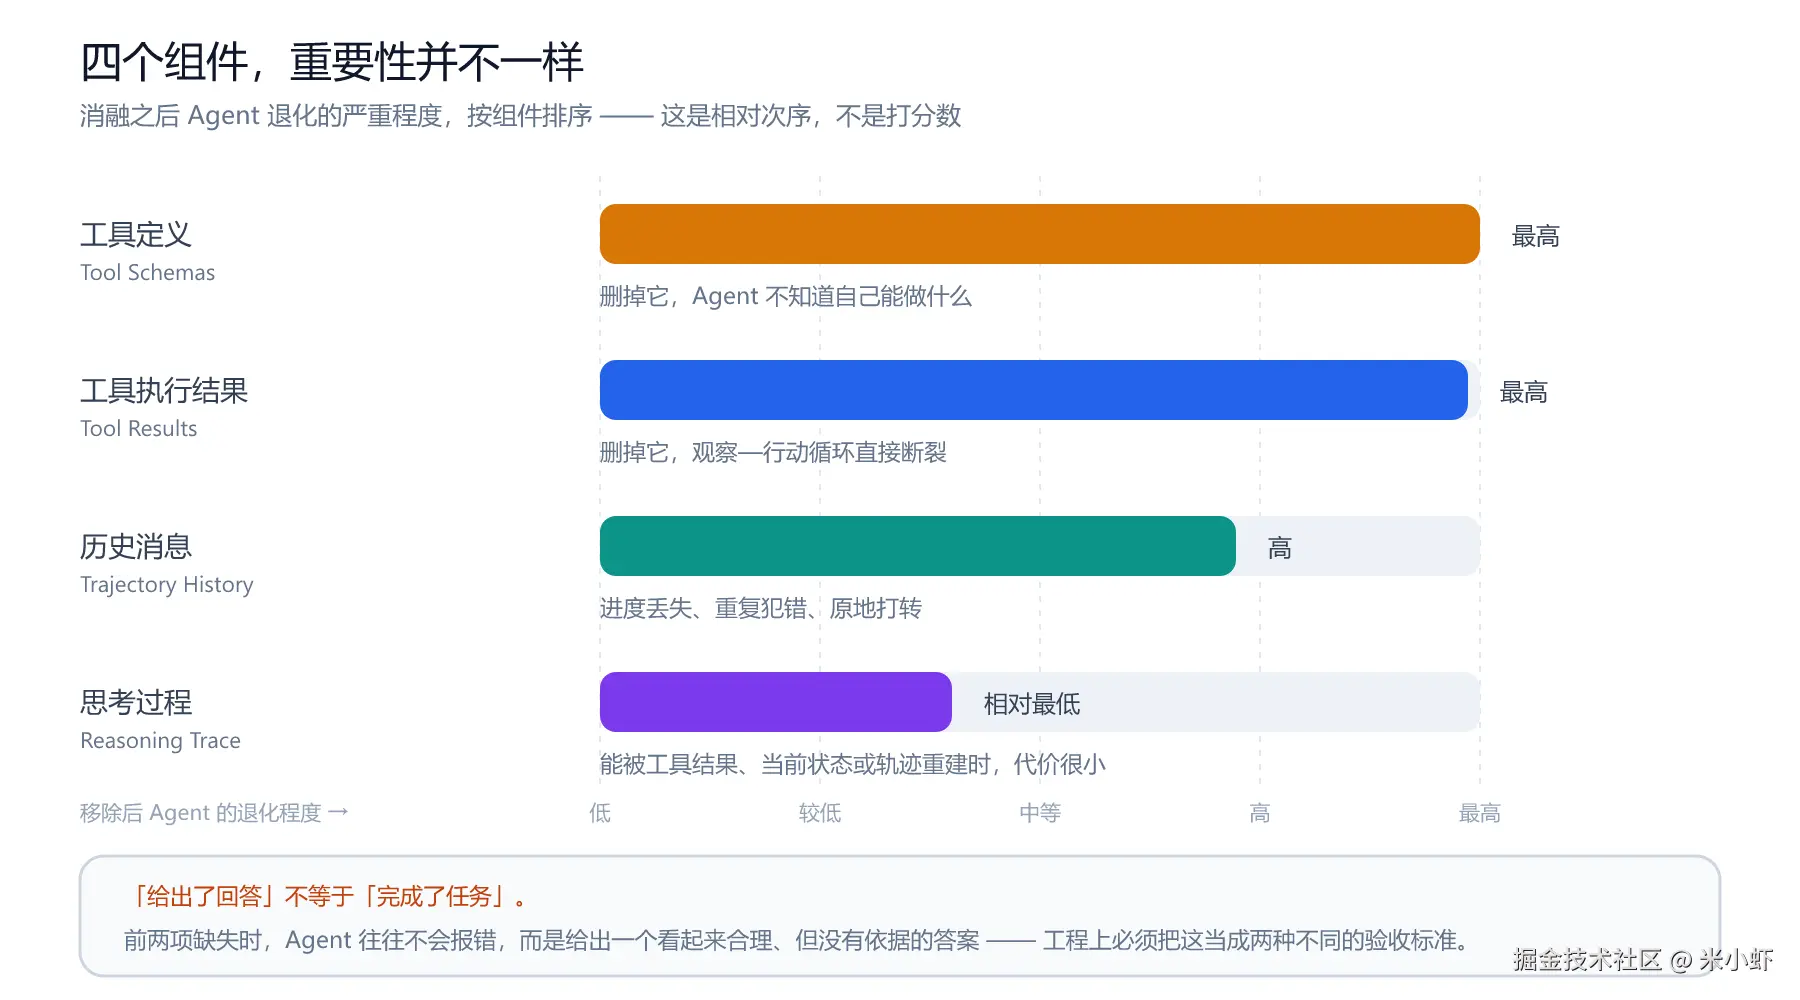
注意这是相对次序,不是分数:
工具定义 ≈ 工具执行结果 > 历史消息 > 思考过程
前两个是"拆了就报废",历史消息是"拆了会转圈",reasoning 是"能重建就能扔"。
四、什么时候这个说法会失效
上面这套结论很好用,但边界要说清楚。
第一,不是所有任务都需要塞满五类组件。 一个纯问答任务里,工具定义和工具结果都是空的------它只有一轮系统提示词 + 用户消息 + 一次回复。硬要按五块去凑,只会让 Harness 变复杂而不带来任何收益。五组件是描述"完整形态"的分析框架,不是每个任务必须填满的表格。
第二,"reasoning 可以被重建"这个判断有前提。 前提是它真的能被重建。如果某条推理依赖一个没有被记录、也没法从环境现状反推的判断依据,那删掉它就是净损失。所以准确的说法是------重建成本低的 reasoning 可以压,重建成本高的必须留,这个成本要自己算,不能一刀切。
第三,组件重要性依赖具体任务,必须实测。 上面那个次序是在特定任务上得出的,不是普适常数。一个以信息检索为主的任务,历史消息的价值可能远高于工具定义;一个多轮工具调用的编码任务,反过来。别照抄结论,去跑自己的消融。
第四,长任务的上下文预算是硬约束。 轨迹只增不减,这个性质在短任务里是优点,在长任务里就是灾难。跑几十步之后窗口被撑爆,压缩、摘要、丢弃低价值步骤就成了必选项------而一旦开始压缩,前面那套分级判断就变成了取舍的依据。消融实验的价值在长任务里比短任务里大得多,因为它直接告诉你哪些内容可以牺牲。
第五,这套分析描述的是"给模型什么",不是"模型会怎么用"。 上下文里有 ≠ 模型会用。塞进去十条规则,模型可能一条都不遵守;塞进去三页文档,模型可能一行都不读。上下文工程的难点从来不只是"放什么",还有"放进去之后模型到底看不看得进去"。这一点第 5 篇讲 Harness 五要素时会具体展开。
小结
这一篇拆完了"眼睛"。
css
上下文五组件:
  ① 系统提示词      开发者编写 · 身份/准则/用户记忆/环境状态
  ② 工具定义        名称/功能/参数格式 · 行动能力的基础
  ③ 用户消息        用户请求 + RAG 检索的外部与私有知识
  ④ 模型回复        reasoning(思考)+ content(答复)+ tool_calls(调用)
  ⑤ 工具执行结果    搜索结果 / API 返回 / 文件内容 / 命令输出 / 页面状态

结构切分:
  上下文 = 静态前缀(① + ②,重放)+ 轨迹(③ + ④ + ⑤,只增不减)

消融结论(定性次序,非分数):
  工具定义 ≈ 工具执行结果 > 历史消息 > 思考过程
四条必须带走的:
- 上下文决定 Agent 能看到什么,而 Agent 只能基于它看到的信息决策
- 工具定义缺失时,模型会用参数记忆冒充观察------提示词约束不能消除幻觉,必须靠工具验证
- reasoning 是可重建的记录,不是不可替代的信息源
- "给出了回答"不等于"完成了任务" ------ 上下文残缺时,Agent 往往不报错,而是给出一个看起来合理但没有依据的答案
第 4 条是最容易被忽略、也最贵的一条。很多 Agent 评测之所以好看,测的只是"有没有给出回答",不是"任务有没有完成"。这两个指标之间隔着的,就是上下文里缺的那几块。
下一篇钻进这个循环本身。Agent 到底是怎么"边想边做"的------想一步、做一步、看一眼、再想下一步,为什么这个循环有效,代价又在哪里。
下一篇:《ReAct:Agent 是怎么"边想边做"的》
关注这个系列,我会持续更新。觉得有用的话,欢迎点个赞------它会让我更有动力把下一篇写好。