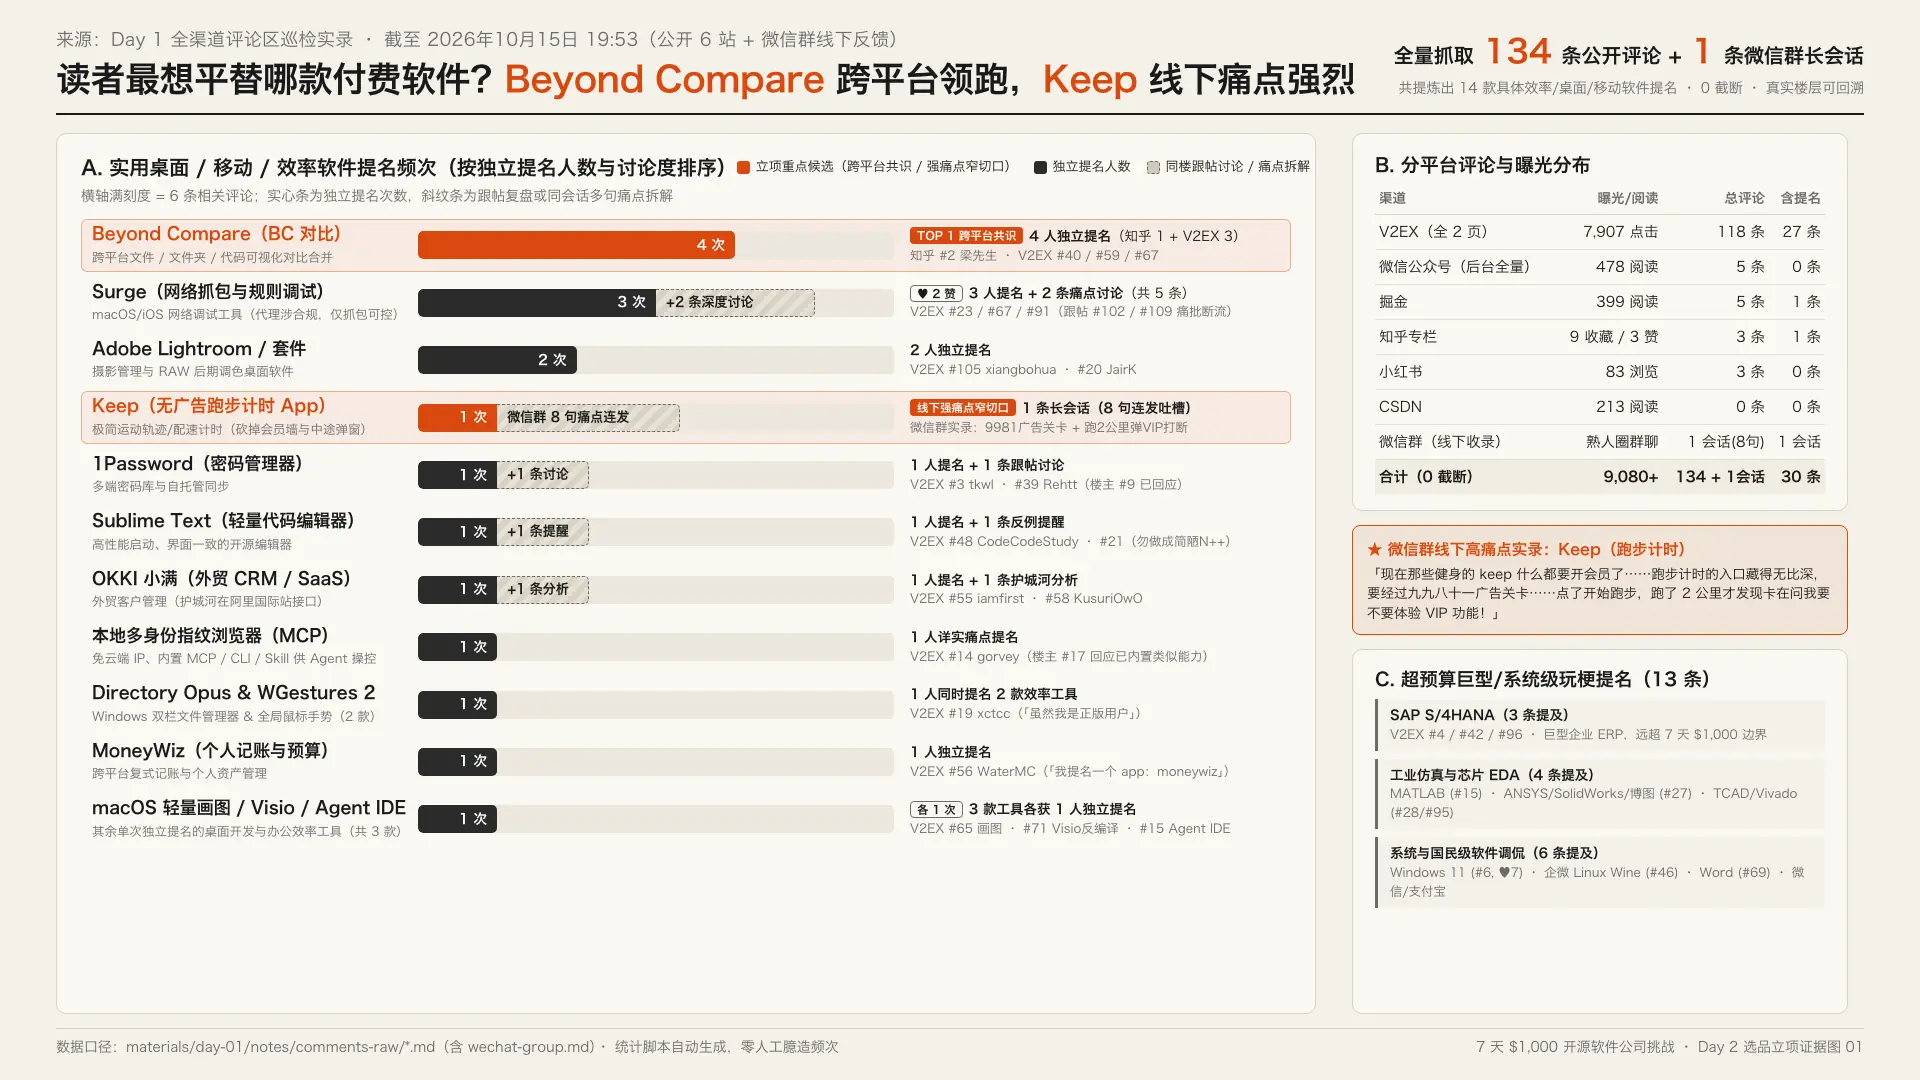
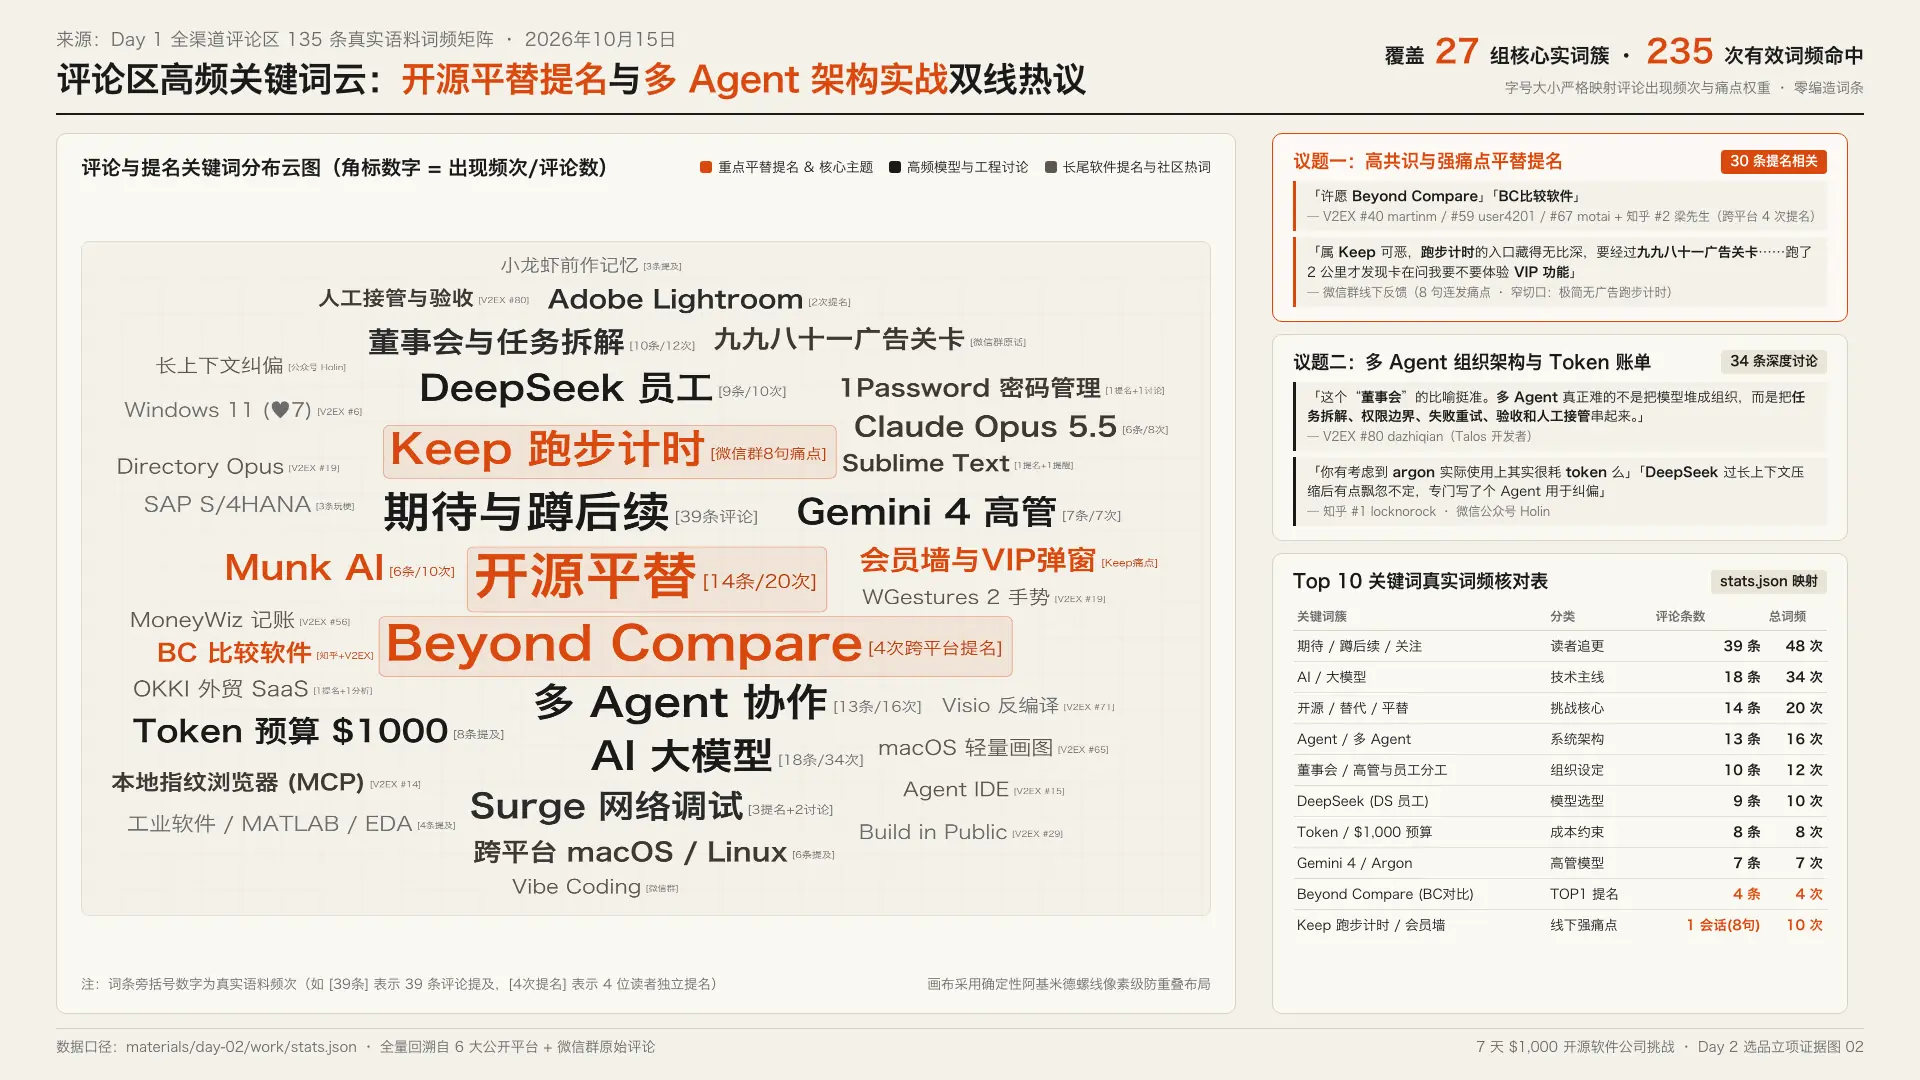
昨天发帖请大家提名最想平替的付费软件。今天交 Day 2 的账单和最终选题。
1. 为什么定下 Beyond Compare?
昨晚到今天,AI 员工把 6 个平台的 134 条评论全抓回来了(V2EX 占了 118 条)。
除去提名重写 Windows 11、SAP、MATLAB 和微信的老哥,呼声最高的实用工具就是 Beyond Compare。
大家苦它久矣:Pro 版买断要 70 美金(约 500 元),跨大版本升级还要交半价。而 Mac 上的开源替代品 Meld 长期断更卡顿,KDiff3 的界面还停在二十年前。
除了评论区提名,AI 还去外网盲测了一圈,把取消买断改收 108 美金年费的录屏软件 Screen Studio 也拉进了决赛圈。 不过内部圆桌吵了两轮后,我还是在手机上拍板了 Beyond Compare ,开源项目定名 OpenCompare。
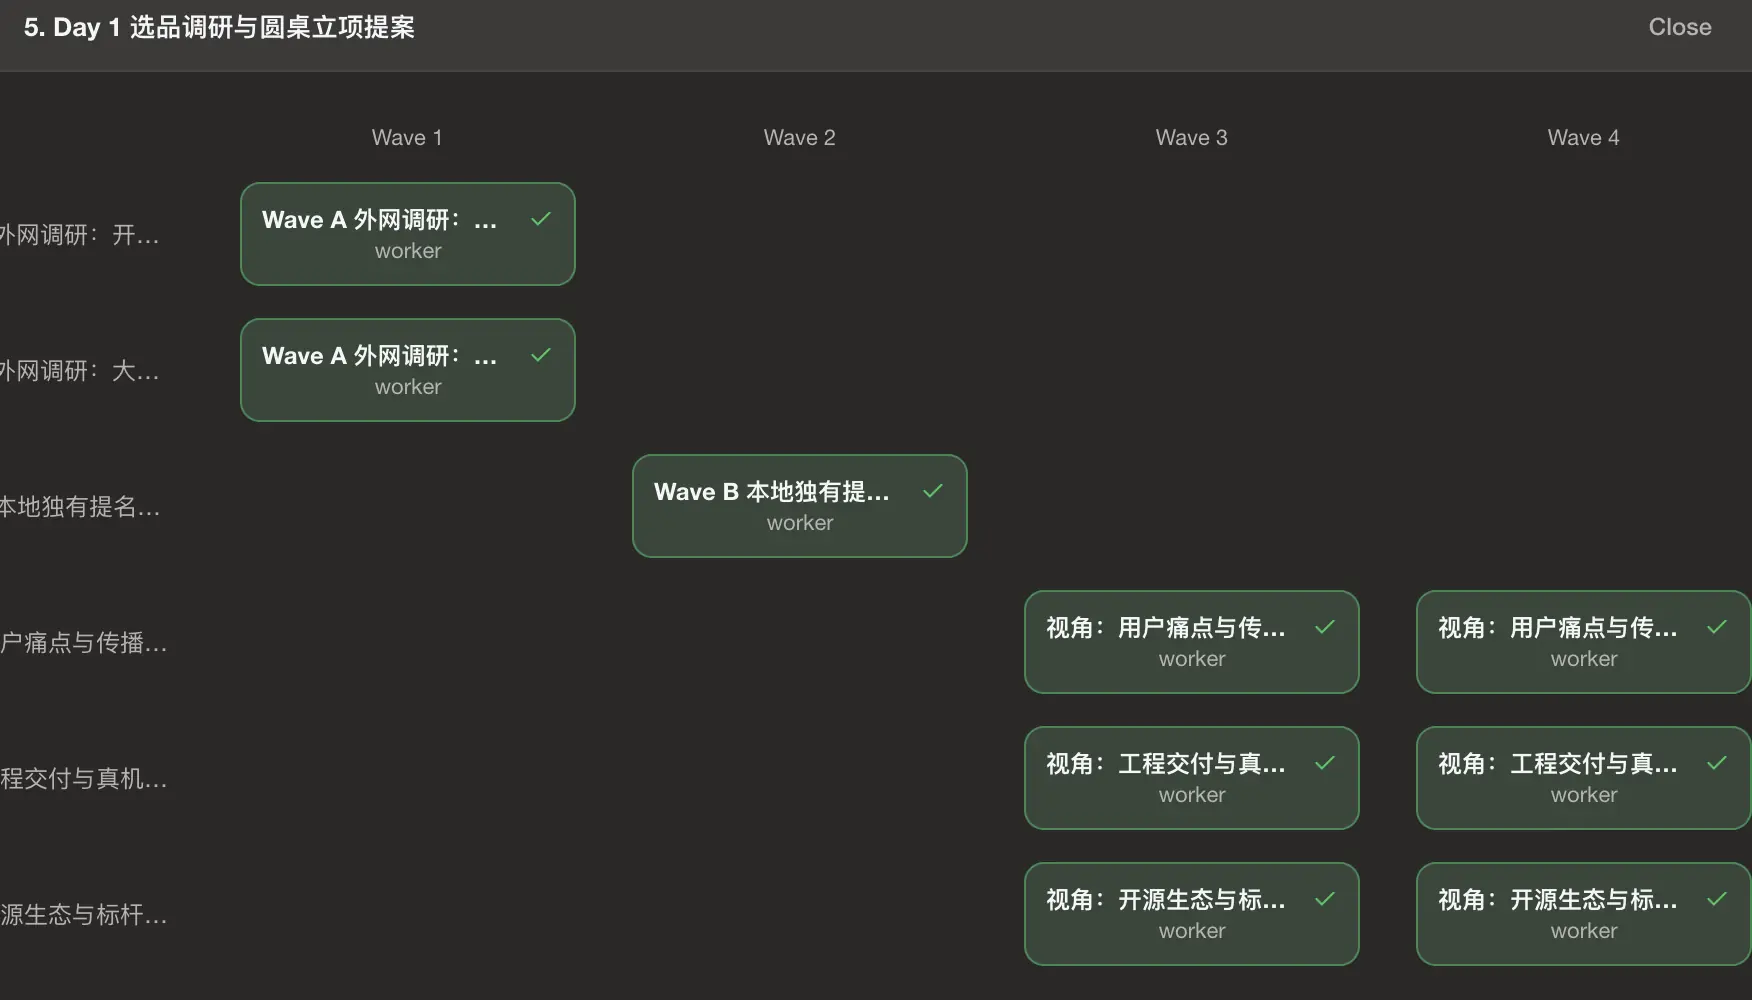
原因很简单:一是听劝,兑现评论区最高票;二是它零外部依赖,做完直接丢测试文件夹、冲突代码和乱序表格进去,机器自己就能跑完桌面实机验收。
2. 5 个研发日,只做哪 4 件事?
去掉首尾,写代码加自测只有 5 天。为了不搞出个半吊子玩具,我们砍掉了十六进制对比、远端挂载和容易误删文件的双向同步,只死磕最常用的 4 个功能:
- 双文件夹极速对比:按大小、修改时间和哈希秒级比对,一键过滤出差异文件。
- 代码双栏对比与三向合并:遇到 Git 冲突时,摆清三方冲突块,点一下就能采纳并导出。
- 千行 CSV 按主键列对齐对比:这是普通编辑器内置 Diff 最抓瞎的地方。两份乱序表格,指定一列当主键(比如订单号),自动拉齐每一行并高亮改过的单元格。
- JSON / YAML 语义对比 + 手机扫码看报告:忽略缩进和键顺序噪音;桌边那台测试手机扫个码,就能在手机上翻看变更摘要。
3. 今日 Token 账单:为什么 Gemini 还是大头?
昨天有 V 友提醒注意 Gemini 4 的 Token 消耗。今天跑完 6 站抓评论、两波调研、两轮圆桌和图表生成,本机一共消耗了 35.69M Tokens:
- Gemini 4(高管/主脑):23.19M Tokens
- DeepSeek(执行员工):12.50M Tokens
- 缓存命中率 :89.4%(共命中 31.92M 缓存,所以实际花费很稳)
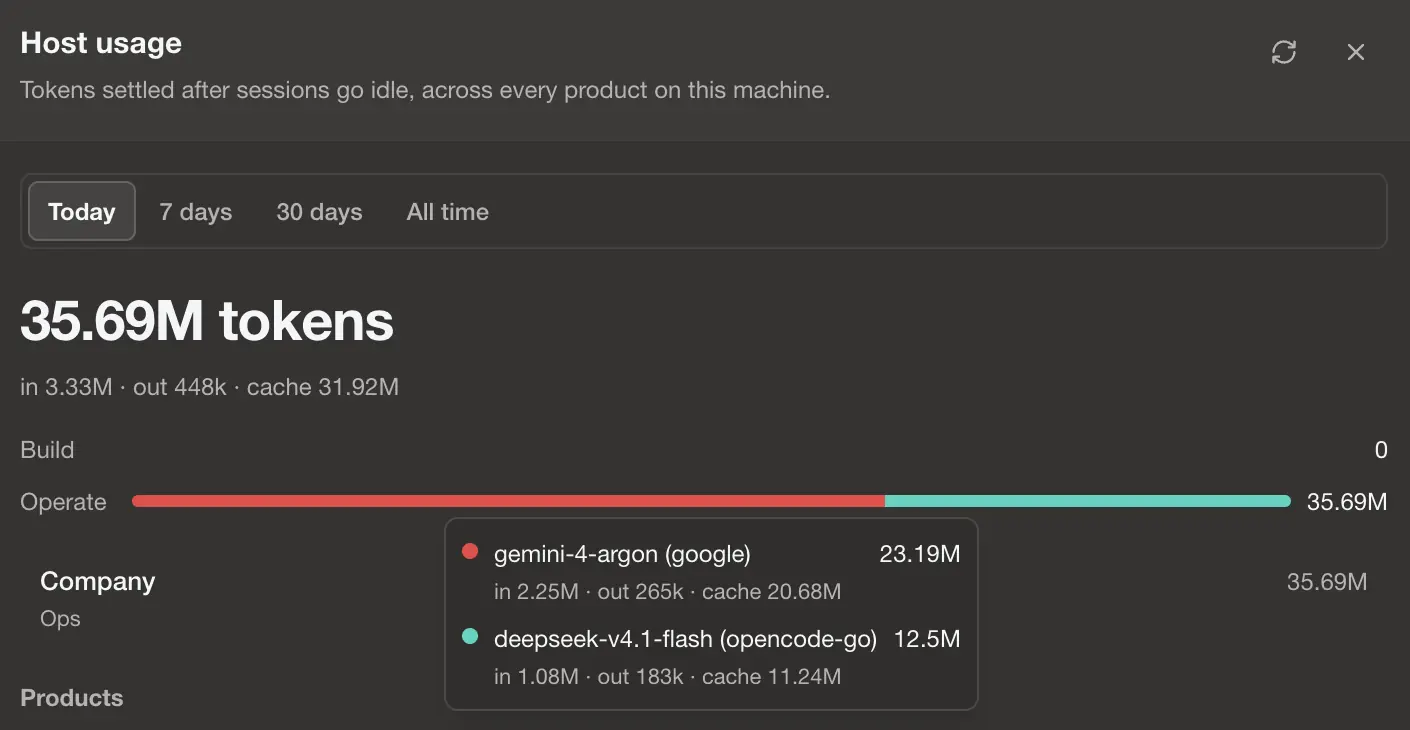
Gemini 占比偏高,不是我故意全扔给旗舰模型。一开始系统有个 bug:派出去的子员工默认继承了主 Agent 的模型。刚开跑的抓评论、外网调研,本来该交给 DeepSeek 干的活,全被记到了 Gemini 4 账上。修完之后,后面的任务才真正开始走 DeepSeek。
今晚 Gemini 4 已经开始搭桌面端架子和对比内核。明天 Day 3,带第一批代码提交和跑起来的真实窗口来交作业。大家平时用 BC 最看重哪个细节,欢迎继续提!