我用三句训练,留一句不参加计数
BPE 不查词典。它一遍一遍找当前最常见的相邻一对,合成一个新 token。我放了三句训练:「低空飞行低空飞行」「低空跳伞低空跳伞」「飞行记录飞行记录」。另外留了一句「高空飞行低调」。这句不参加计数,只拿来看同一套合并会不会把它也切短。
一开始每个字单独算一个 token。三句训练一共 24 个字,那句是 6 个字。训练里出现过的不同字是 8 个,所以第 0 步词表是 8。那句里的「高」和「调」不在这 8 个里。编码时它们仍是单字,不会因为没进训练词表就被丢掉,也不会被换成别的字。
Sennrich、Haddow 和 Birch 把字节对编码用到翻译里,是为了让罕见词还能拆。我这里没有翻译分数,也没有和 jieba 比哪一刀切得对。只看合并顺序,以及那句的长度会不会跟着训练句一起降。
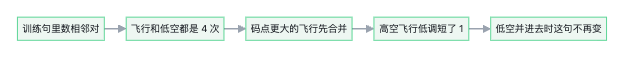
飞行和低空都是 4 次,先合的是飞行
| step | pair | freq | train | held | vocab |
|---|---|---|---|---|---|
| 0 | start | 0 | 24 | 6 | 8 |
| 1 | 飞行 | 4 | 20 | 5 | 9 |
| 2 | 低空 | 4 | 16 | 5 | 10 |
| 3 | 飞行记 | 2 | 14 | 5 | 11 |
| 4 | 飞行记录 | 2 | 12 | 5 | 12 |
| 5 | 跳伞 | 2 | 10 | 5 | 13 |
| 6 | 低空飞行 | 2 | 8 | 5 | 14 |
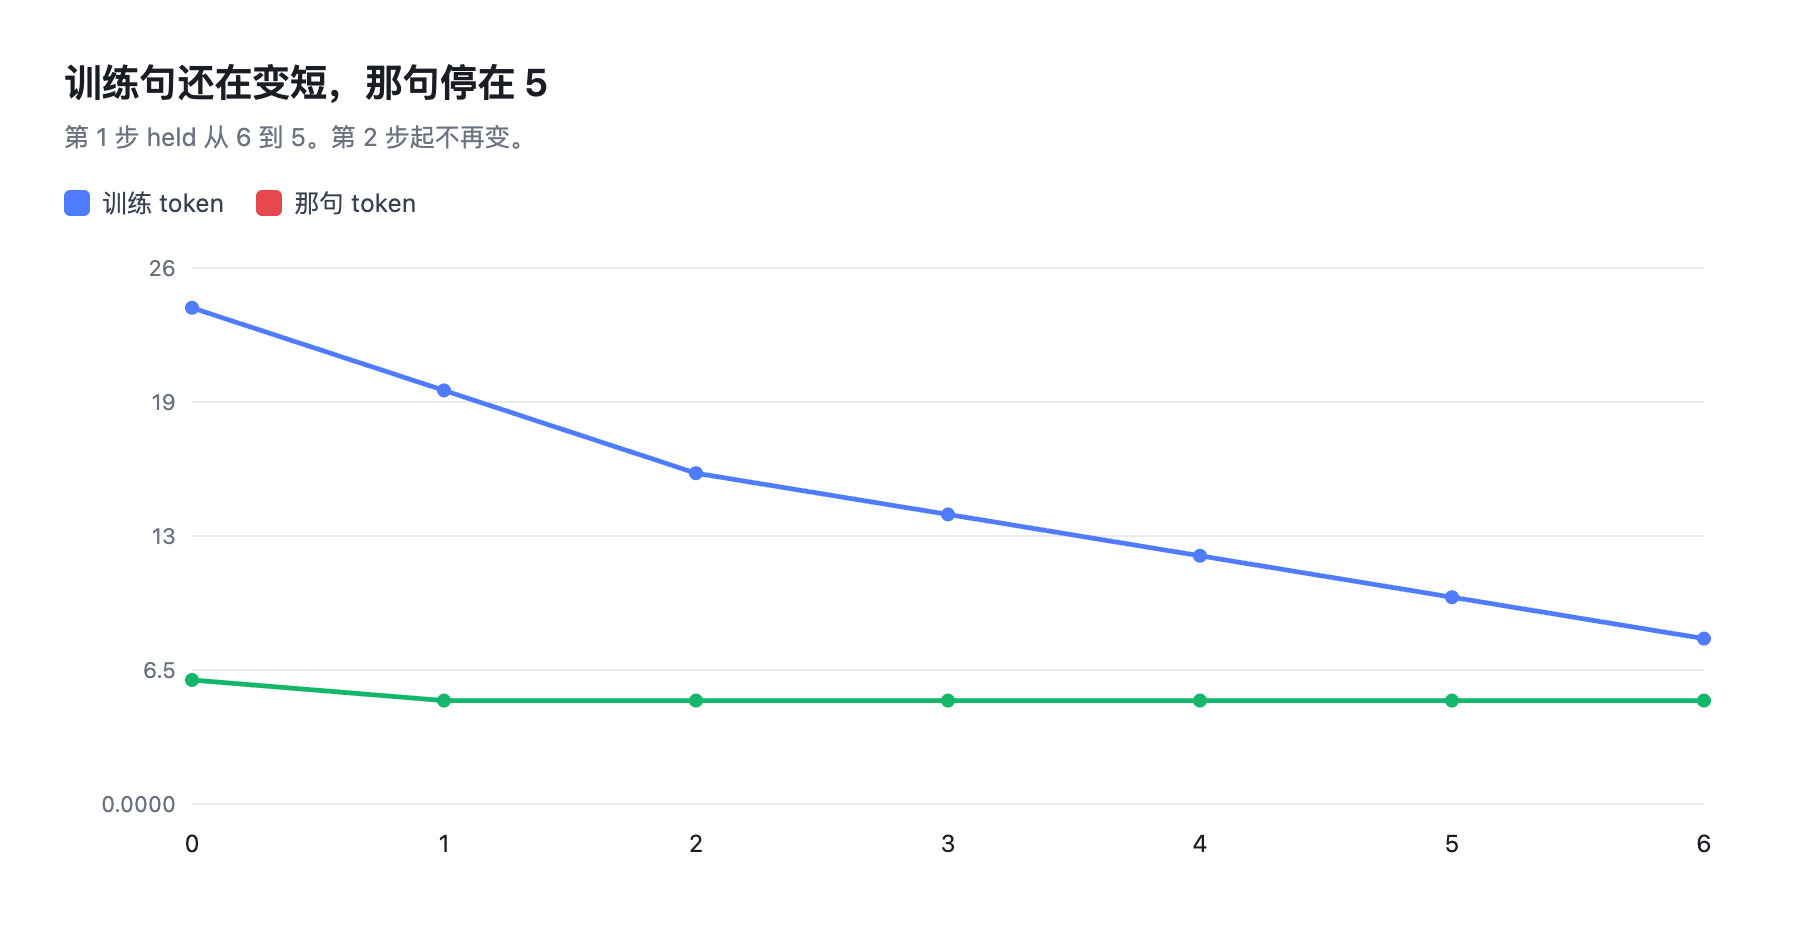
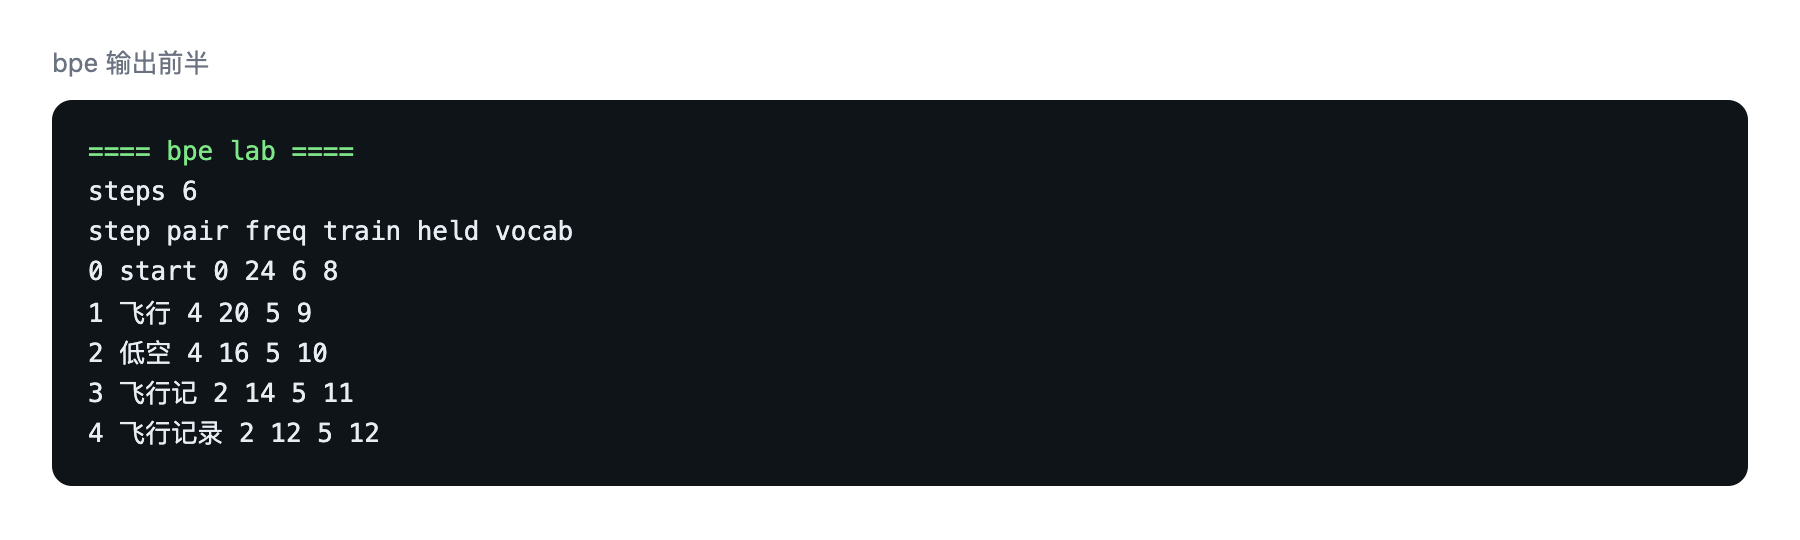
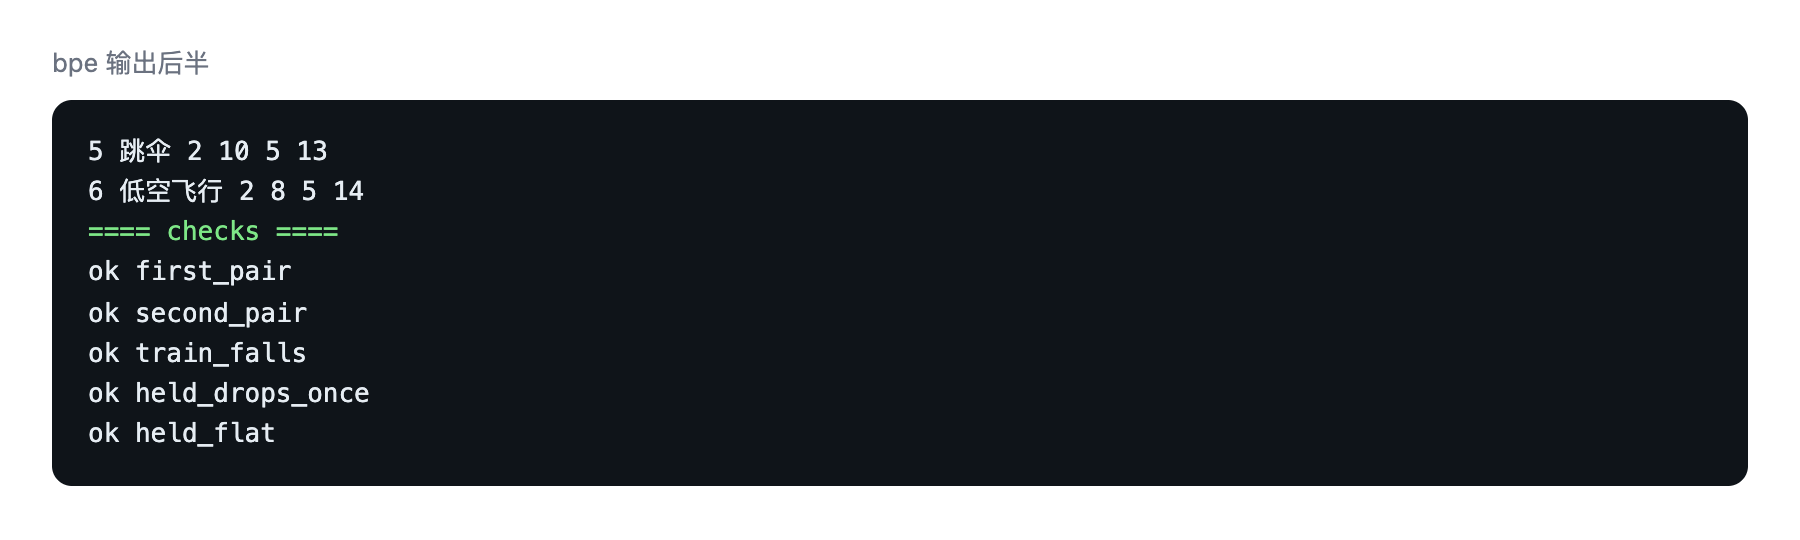
第 0 步的 pair 是 start,freq 是 0,train 是 24,held 是 6,vocab 是 8。第 1 步合并「飞行」,freq 是 4,train 变成 20,held 变成 5,vocab 变成 9。第 2 步合并「低空」,freq 仍是 4,train 变成 16,held 还是 5,vocab 变成 10。
我原来以为次数高的先合,次数一样就看谁先在句子里出现。「飞行」和「低空」在第 1 步之前都是 4 次。脚本用 max,比较键是次数、左字、右字。次数打平以后,码点更大的那对赢。飞的码点比低大,所以「飞行」排在「低空」前面。这不是「飞行」更重要,是平局时的排序。若改成次数一样时取码点更小的,「低空」会先被合,那句在第几步变短就会换一档。我没有改这个排序。
第 3 步是「飞行记」,freq 是 2,train 是 14,held 是 5,vocab 是 11。第 4 步是「飞行记录」,freq 是 2,train 是 12,held 是 5,vocab 是 12。第 5 步是「跳伞」,freq 是 2,train 是 10,held 是 5,vocab 是 13。第 6 步是「低空飞行」,freq 是 2,train 是 8,held 是 5,vocab 是 14。训练 token 每一步都在降。那句只在第 1 步从 6 降到 5,后面五步都停在 5。
合并只吃挨着的那一对
python
def merge(tokens, pair):
    out = []
    i = 0
    left, right = pair
    while i < len(tokens):
        if i + 1 < len(tokens) and tokens[i] == left and tokens[i + 1] == right:
            out.append(left + right)
            i += 2
        else:
            out.append(tokens[i])
            i += 1
    return out


def most(sents):
    counts = Counter()
    for sent in sents:
        counts.update(pairs(sent))
    pair, freq = max(counts.items(), key=lambda item: (item[1], item[0][0], item[0][1]))
    return pair, freq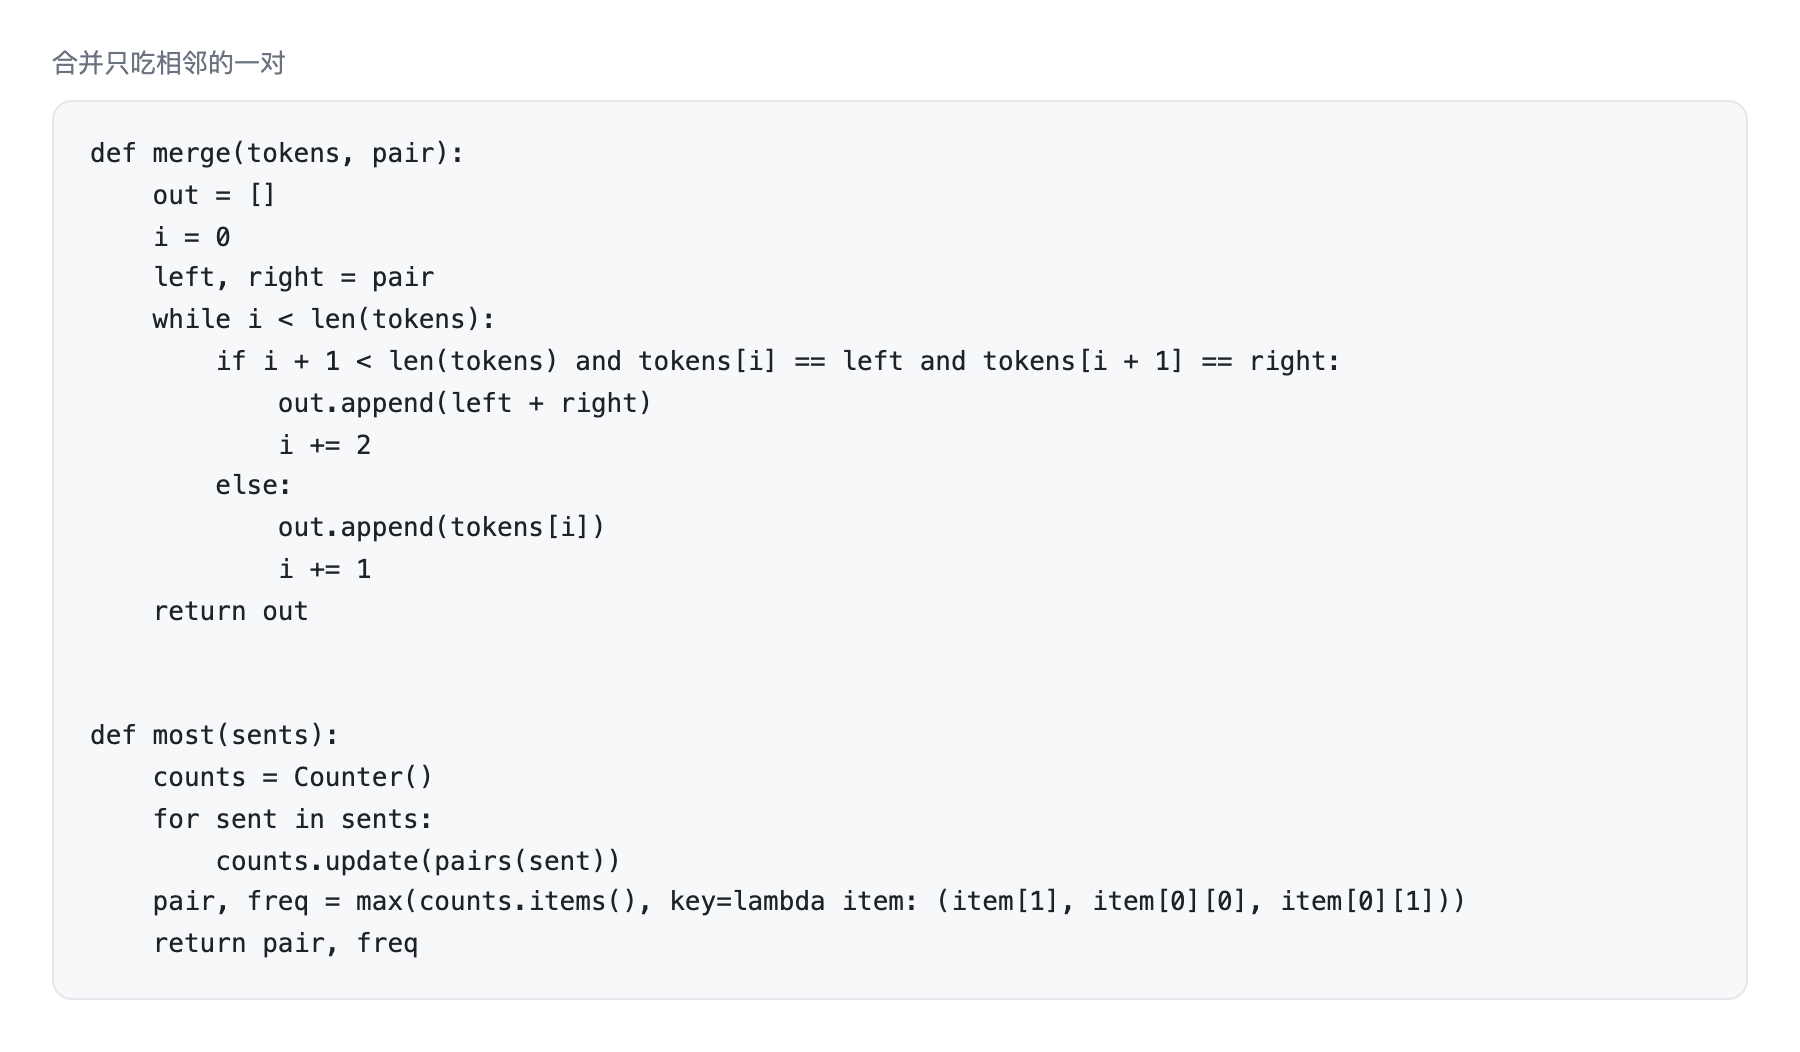
从左往右扫。碰到目标对就合成一个 token,一次吃掉两个位置,不会重叠。所以若出现「飞行飞行」,前一对先被吃掉,后一对要等下一轮。这三句里没有这种紧挨着的同一对。我把不重叠写进循环,是为了和「一次统计、一轮只合一种对」对得上。若允许重叠,同一轮的长度会少得更多,表里的 20 和 16 就不是这套规则了。
那句在第 1 步之后是「高」「空」「飞行」「低」「调」,五个 token。「飞行」被吃掉了,所以 6 变成 5。第 2 步要找的是「低」后面紧跟「空」。这里「空」的前一个是「高」,「低」的前一个是「飞行」。两个字都在这句里,但不相邻,顺序也不对。held 就停在 5。我一开始把「句子里有低也有空」当成会被合并。相邻这个条件比我以为的硬。
我把第 1 步之前的对子手数过
「低空飞行低空飞行」里,相邻对是低空、空飞、飞行、行低,然后再来一遍低空、空飞、飞行。低空 2 次,飞行 2 次。「低空跳伞低空跳伞」里,低空 2 次,空跳 2 次,跳伞 2 次,伞低 1 次。「飞行记录飞行记录」里,飞行 2 次,行记 2 次,记录 2 次,录飞 1 次。加起来飞行 4,低空 4。没有第三对也是 4。打印的 freq 4 和这个手数一样,我才把「两对都是 4」写进正文。
第 2 步为什么还是 4,而不是合完「飞行」以后次数变了。三句里「低空」都不和「飞行」共用同一个边界来互相拆掉。「低空飞行」里,低空合上之后,空和飞的那条边消失了,但低空本身的次数在第 1 步还没被合并,统计发生在合并之前。第 1 步合的是飞行,低空那 4 次还在。所以第 2 步的 freq 仍是 4,不是我把旧次数又抄了一遍。
后面四步都是训练句自己的词
「飞行记」是先有了「飞行」,后面再跟「记」。那句里的「飞行」后面是「低」,不是「记」,第 3 步碰不到。第 4 步「飞行记录」更长,那句里没有「记」,更没有「录」。第 5 步「跳伞」在那句里一个字都没有。第 6 步「低空飞行」要求「低空」和「飞行」已经各自成词,并且挨在一起。那句从未形成「低空」,这一步也吃不到。
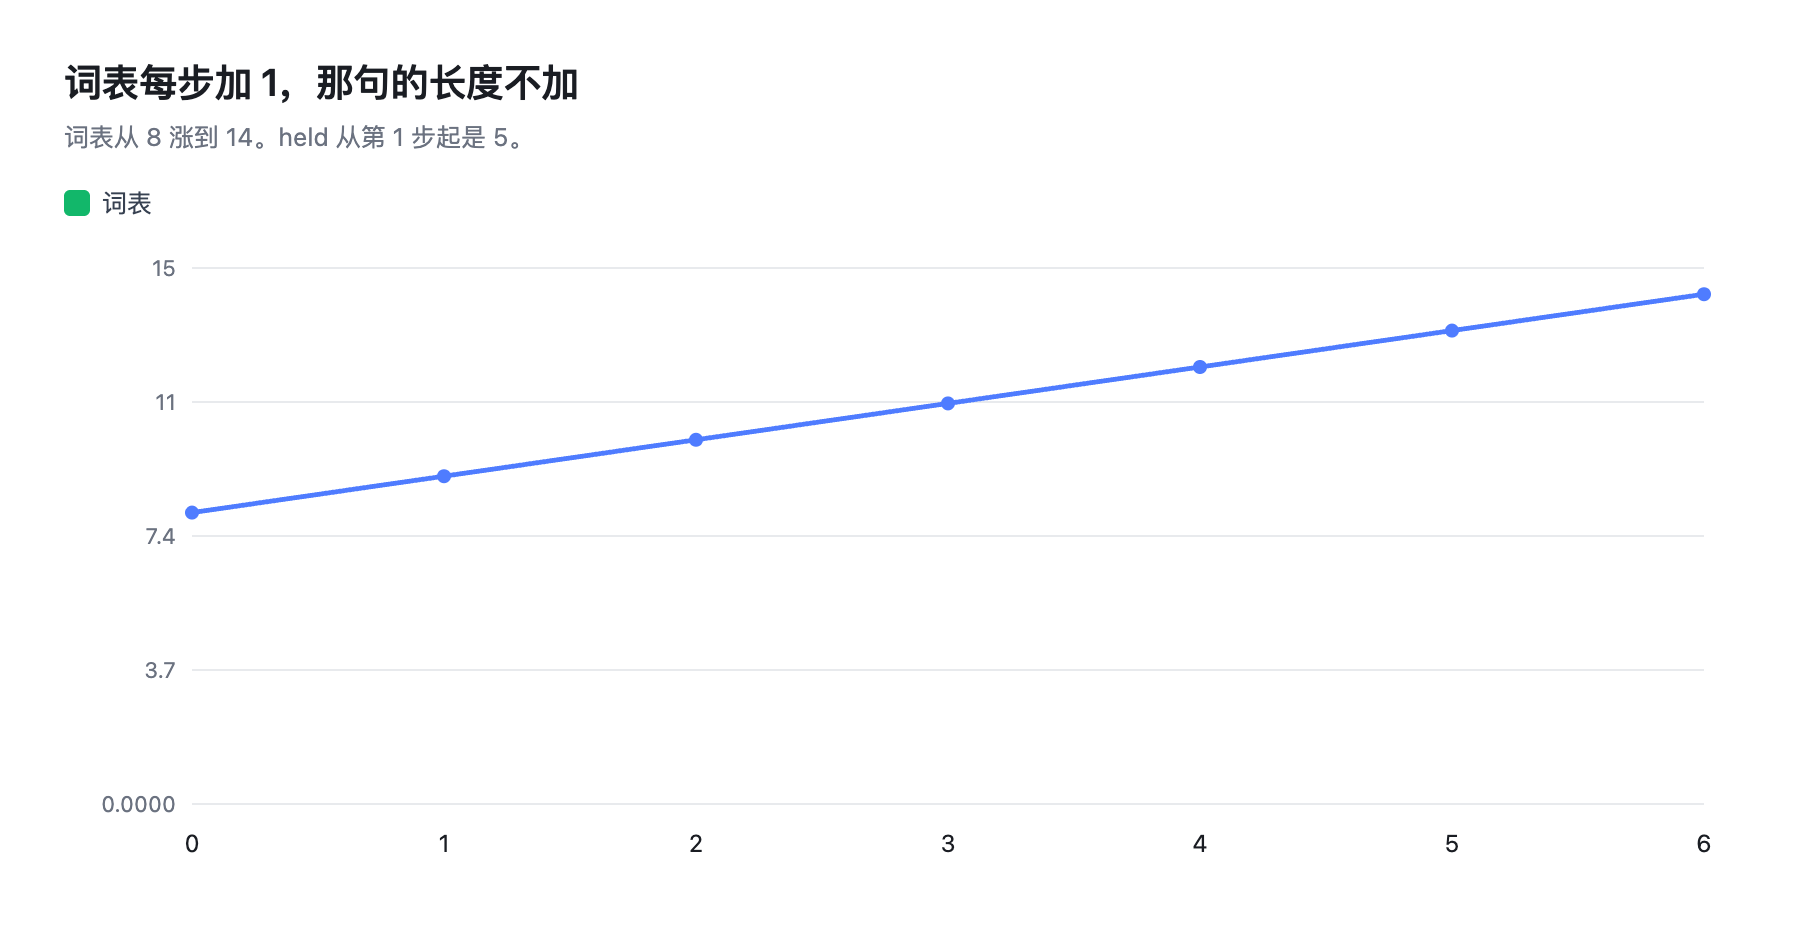
所以 held 从第 1 步到第 6 步都是 5,不是再慢慢降。训练从 24 降到 8。那句只降了 1。词表从 8 加到 14,每步加 1,不管这步对那句有没有用。我若只看词表变大、训练变短,会觉得合并一直在帮忙。held 这列把「帮忙」限制在出现过的相邻对上。
这六步切不开没写进训练的相邻关系
训练只有三句,而且每句都把同一段写了两遍,次数会被放大。「飞行」的 4 次里,有一半来自同一句写了两遍。我没有先去重再数。若先把重复的半句拿掉,飞行和低空的次数会一起变小,平局可能还在,但 freq 不会再是 4。我没跑那一版。
另外,合并是贪心的。第 1 步若先合「空飞」而不是「飞行」,后面的「飞行记」就不会以现在这个样子出现。我没有把每一步的次优对也存下来。所以这张表是一条确定的合并链,不是所有平局规则下的唯一链。链能确定,是因为平局时我把码点顺序写死了。
「高空飞行低调」也不是用来证明某个成语一定会被切坏。它是一句故意留下「飞行」、拆开「低空」的句子。能说的是:同一套合并,训练句可以继续从 20 降到 8,没出现那种相邻关系的句子会停在 5。停住不是回到 6,也不是变成 0。第 1 步已经切过一次,后面只是没再切到它。
训练长度的下降,这六步正好等于 freq
第 1 步 freq 是 4,train 从 24 到 20,少了 4。第 2 步 freq 是 4,从 20 到 16,又少了 4。第 3 步 freq 是 2,从 16 到 14。第 4 步从 14 到 12。第 5 步从 12 到 10。第 6 步从 10 到 8。每一步少掉的 token 数,都等于这一步的 freq。
这是因为这六对在训练句里都不重叠。数次数的时候,一对占两个位置;合并的时候,也是一次吃掉两个位置,长度少 1。次数有几个,长度就少几个。held 不在 freq 里。第 1 步训练少了 4,那句另外少了 1,是它自己有一次「飞行」,这次没有计进 freq。所以不能用 freq 去推那句会少几格。freq 只看训练句。
若某一对像「啊啊啊」那样前后重叠,数次数会把重叠的边都算上,合并却不能重叠着吃,长度的下降就会小于 freq。这三句里没有这种对。下降等于 freq,只在这份语料、这六步上成立。我没有另造一句重叠的来把这个差别做出来。
词表的 14 没有把那句的生字算进去
vocab 从 8 加到 14,加的是六次合并,底数是训练句里的 8 个不同字。那句里的「高」和「调」没有参与这个底数。它们在编码时照样出现,所以 held 的 5 里面有两个训练词表没学过的字。我没有把词表改成 10 再加合并。改了的话,第 0 步就会写成 10,和「只从训练句学词表」对不上。
第 1 步之后那句的五个 token 是「高」「空」「飞行」「低」「调」。其中新词只有「飞行」。后面的「低空」「飞行记」「飞行记录」「跳伞」「低空飞行」没有一个是这五个 token 里的相邻对。所以词表继续变大,这句的切分不再变。变大的是训练侧的库存,不是这句被切得更碎,也不是被切得更短。
我若把「词表 14、训练长度 8」当成模型已经会切中文,会漏掉 held 停在 5 这件事。14 和 8 都是训练句自己的账。那句的账停在第 1 步。两本账从第 2 步起就分开了。