一、开篇
大模型会一本正经地编造不存在的事实,这就是幻觉(Hallucination)。理解幻觉的根源------模型本质是概率语言模型而非事实检索引擎------才能对症选择 RAG、Prompt 约束、调低 Temperature、后处理校验等缓解手段。这一篇覆盖幻觉成因、两种类型与工程缓解方案。
二、幻觉为什么会发生
2.1 模型本质:概率语言模型,不是知识库检索器
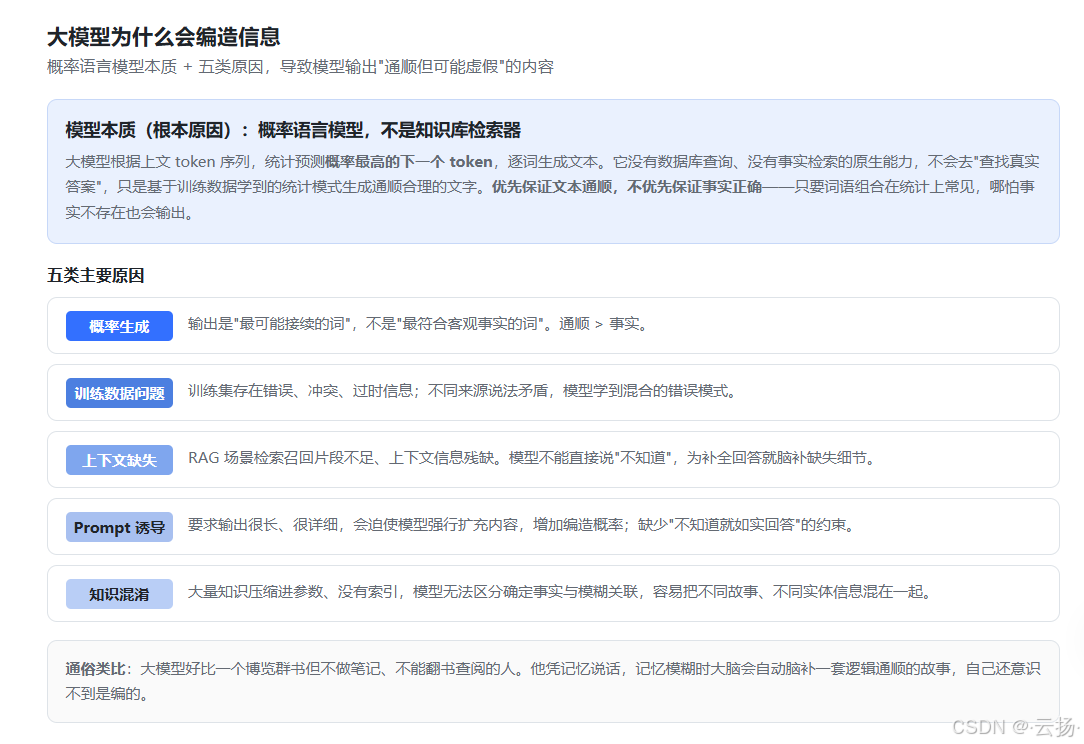
大模型的核心机制:根据上文 token 序列,统计预测概率最高的下一个 token,逐词生成文本。它没有数据库查询、没有事实检索的原生能力,不会去"查找真实答案",只是基于训练数据中学到的统计模式,生成看起来通顺合理的文字。
关键点:模型优先追求文本通顺、符合语言统计分布,不是优先保证事实正确。只要词语组合在统计上很常见,哪怕事实不存在,模型也会输出。
举例:问一个不存在的论文、人名、事件。模型没有见过这个事实,但训练数据里见过大量"论文标题、作者、发表时间"的句式模式,就会按照这个模式,生成一套看起来非常真实的虚假内容。
2.2 幻觉产生的几类主要原因
-
概率生成机制(根本原因):模型输出是"最可能接续的词",不是"最符合客观事实的词"。通顺 > 事实。
-
训练数据问题:训练集存在错误、冲突、过时信息;不同来源说法矛盾,模型学到混合的错误模式。
-
上下文缺失 / 信息不足:RAG 场景检索召回片段不足、上下文信息残缺。模型不能直接说"不知道",为了把回答补全,就脑补填补缺失细节。
-
Prompt 诱导:指令要求输出很长、很详细的回答,会迫使模型强行扩充内容,增加编造概率;缺少"不知道就如实回答"的约束。
-
模型内部知识混淆:训练时大量知识压缩进参数,没有索引,无法区分哪些是确定事实、哪些是模糊关联,容易把不同故事、不同实体信息混在一起。
2.3 两种幻觉类型
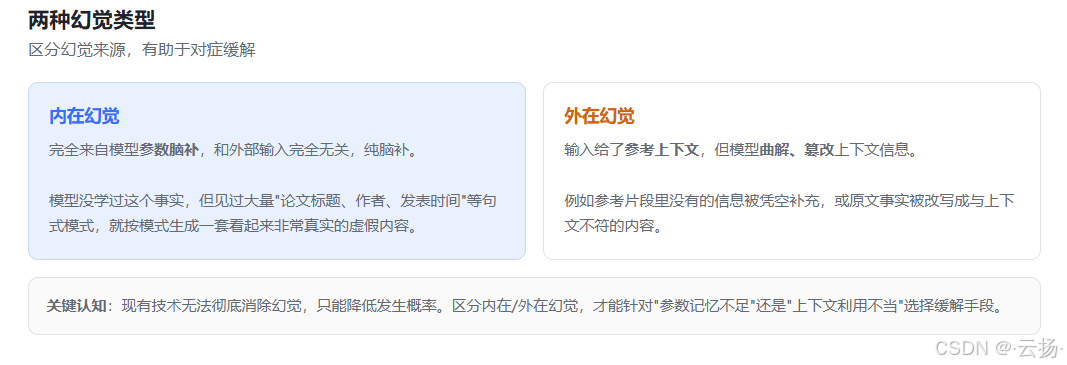
区分两种幻觉,有助于对症缓解:
-
内在幻觉:模型参数里生成出来,和外部输入完全无关,纯脑补。
-
外在幻觉:输入给了参考上下文,但模型曲解、篡改上下文信息。
三、如何缓解幻觉
3.1 四类主流缓解方案
现有技术无法彻底消除幻觉,只能降低发生概率。工程上主要通过四种手段组合缓解:
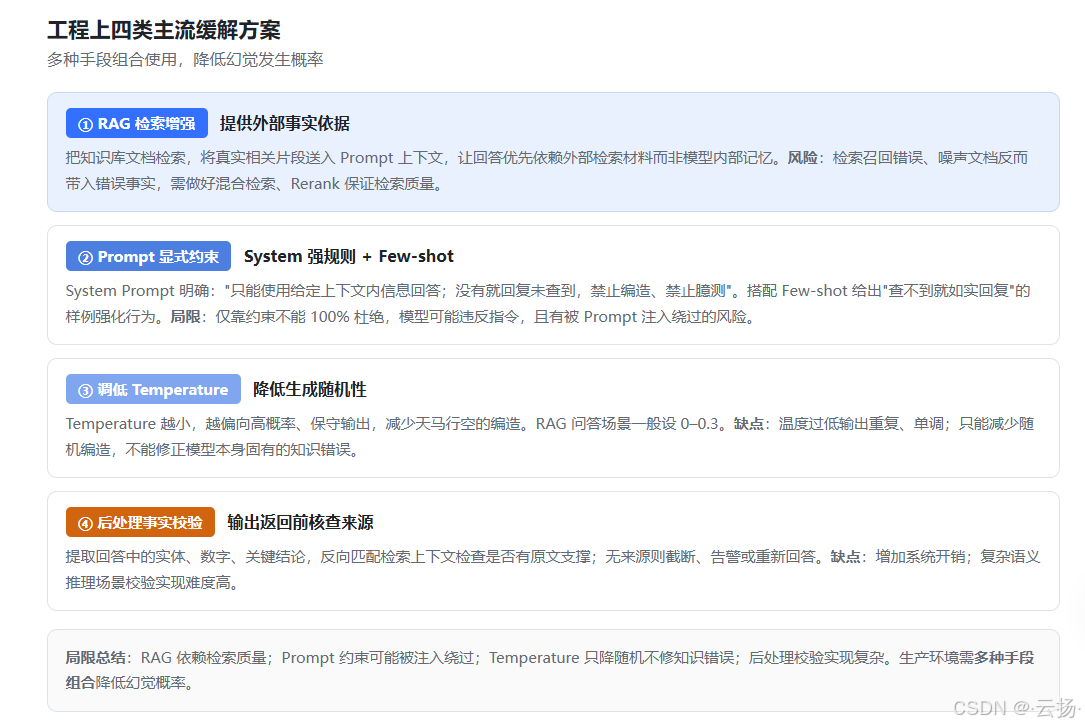
① RAG:引入外部真实资料
把知识库文档经过检索,把真实相关片段送入 Prompt 上下文,让模型回答优先依赖外部检索出来的真实材料,而不是依赖模型内部记忆。风险点:如果检索召回错误、噪声文档,反而会带入错误事实,所以 RAG 需要做好检索质量(混合检索、Rerank)。
② Prompt 显式约束
在 System Prompt 强规则约束:"只能使用给定上下文内的信息回答;如果上下文没有相关信息,直接回复未查到相关信息,禁止编造、禁止臆测,不要使用上下文以外的知识。"搭配 Few-shot 给出"查不到就如实回复"的样例,强化模型行为。局限:仅靠 Prompt 约束不能 100% 杜绝幻觉,模型依然可能违反指令。
③ 调低 Temperature 参数
Temperature 控制生成随机程度:值越大采样越发散、创造性强,幻觉风险上升;值越小越偏向高概率、保守输出,减少编造。RAG 问答场景一般设置 0--0.3。缺点:温度过低输出会变得重复、单调;不能完全解决事实错误。
④ 输出后处理校验(事实核查)
模型输出结果返回用户之前做校验:提取回答中的实体、数字、关键结论;反向匹配检索上下文,检查该信息是否能够在参考片段中找到来源;如果关键信息没有原文支撑,进行截断、告警或者重新回答。缺点:后处理会增加系统开销;复杂语义推理场景校验实现难度较高。
3.2 各方案局限总结
-
RAG 依赖检索质量,检索差会引入错误事实。
-
Prompt 约束存在被 Prompt 注入绕过的风险。
-
Temperature 调低只是减少随机编造,不能修正模型本身固有的知识错误。
-
后处理校验实现复杂,对推理类结论校验困难。
生产环境需要多种手段组合使用,来降低幻觉发生概率。