最近刷到一篇前端 Leader 转型全栈的复盘,观点很直接:你不需要学Linux 运维、Docker、K8s、Nginx、MySQL 调优------Serverless 帮你干掉了这些。
这套搭配我也一直在用:Cloudflare Workers + D1 + Hono + Drizzle ORM。 但网上讲"轻松"的很多,把坑藏起来的很少。
今天我把四个项目的官方文档都翻了一遍,先把三条硬线摆出来------这决定了你能用它做什么:
| 你能做的 | 你做不了的 | | --- | --- | | 中小型 API、个人项目、内部工具 | 长任务(超过 30 秒 CPU)、大数据分析 | | 全球低延迟的 CRUD 服务 | 长视频转码、大模型推理 | | 每天 10 万次请求以内、零成本 | 高并发写密集(单次调用只给50 次查询) |
先看清边界,再决定要不要上手。
一、Workers:不是服务器,是「全球300 多个节点上的函数」
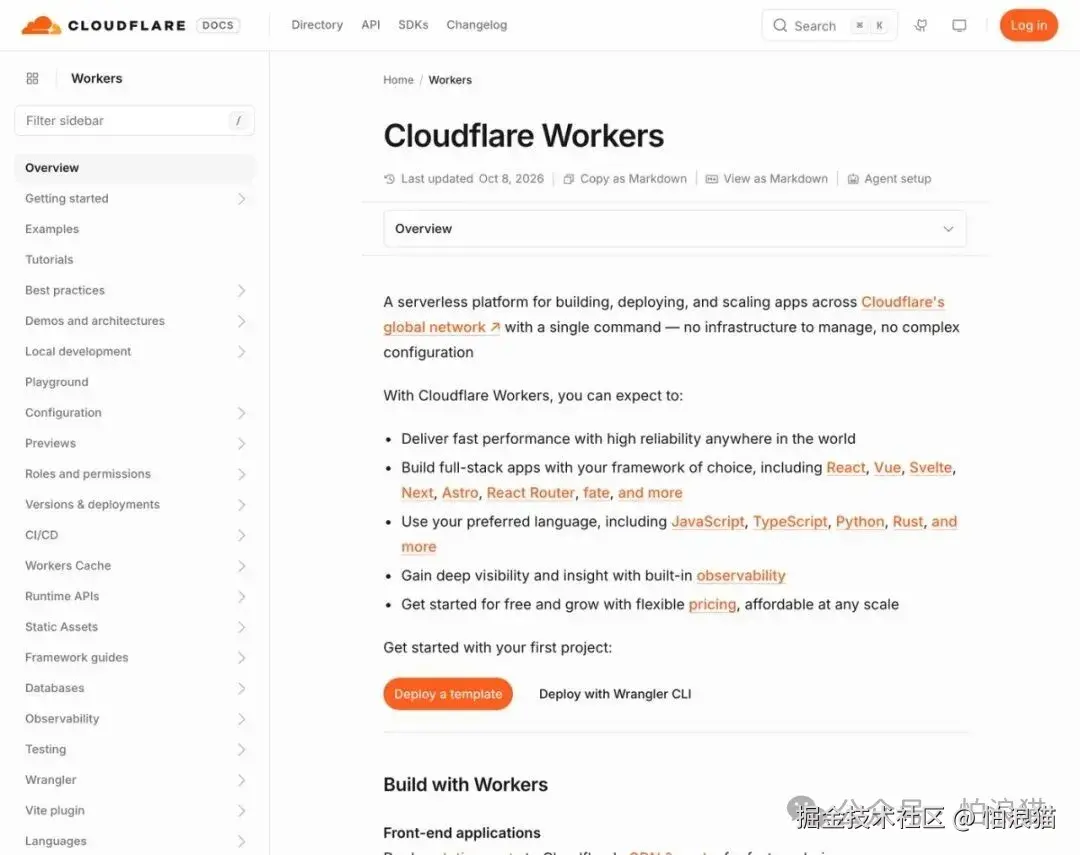
官方定义就一句话------跨 Cloudflare 全球网络构建、部署、扩缩的无服务器平台。
Cloudflare 官方对 Workers 的定位是:用一条命令就能构建、部署、扩缩的应用,没有基础设施要管,也没有复杂配置。
| 项 | Free | Paid | | --- | --- | --- | | 请求数 | 10 万 / 天 | 1000 万 / 月(含) | | CPU 时间 | 10 ms / 次调用 | 3000 万 CPU-ms / 月(含) | | 单次 CPU 上限 | 同上(可调到 5 分钟) | 5 分钟(默认 30 秒) | | 流量与带宽 | 不计费 | 不计费 | | 底价 | 0∣∗∗5 / 月** |
「不计流量」这一条是它跟Vercel 最大的区别------Vercel 流量上来之后账单会让人心跳加速,Workers 这边流量是免费的。
但有一条硬线必须知道:每个 isolate 只有 128 MB 内存。 这是 per-isolate 不是 per-request,一个 isolate 能扛很多并发请求,超了会返回 Error 1102 Worker exceeded resource limits。
128MB 意味着什么? 你不能把一个大模型加载进内存,也不能把一个 200MB 的数据集读进来。它是给"轻逻辑 + 快速 IO"设计的,不是给重计算设计的。
GitHub:github.com/cloudflare/workers-sdk(Wrangler CLI 在这里,4,615 Star)
二、D1:边缘 SQLite,但免费版比你想的紧
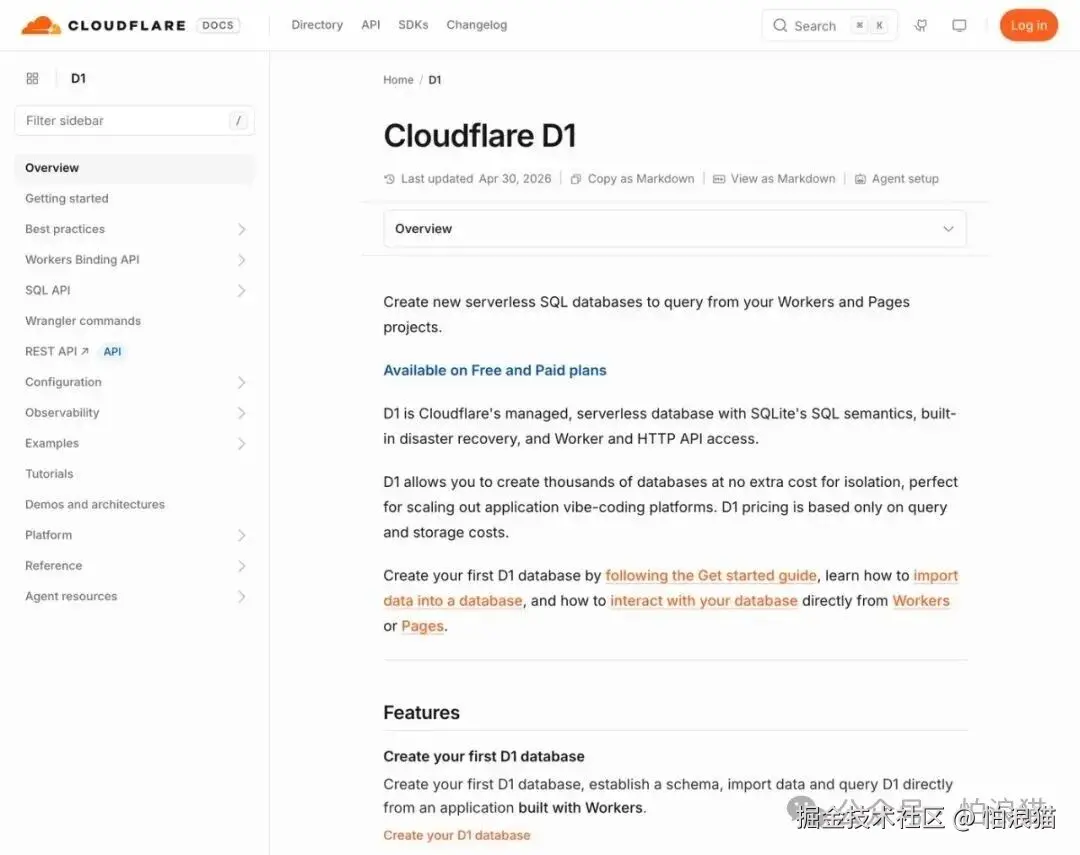
官方定义是「Cloudflare 托管的无服务器数据库,SQLite 语义,自带容灾」。
D1 的卖点是它不是把数据库放在某个机房,而是放在离用户近的边缘节点------查询的计算和数据都在用户附近完成。
定价按「读的行数」和「写的行数」算,不是按小时算:
| 计费项 | Free | Paid | | --- | --- | --- | | 读行数 | 500 万 / 天 | 前 250 亿 / 月含,超出 0.001/百万行∣∣写行数∣∗∗10万/天∗∗∣前5000万/月含,超出1.00 / 百万行 | | 存储 | 5 GB(含) | 前 5 GB 含,超出 $0.75 / GB-月 | | 空闲时 | 不计费(scale-to-zero) | 不计费 |
「读 500 万行/天」这个数要怎么理解? 官方举的例子很直白:一张 5000 行的表跑一次 SELECT * FROM table,就算 5000 行读了。
所以写代码时避免 SELECT * ------在 D1 上这是实打实的成本,不是风格问题。
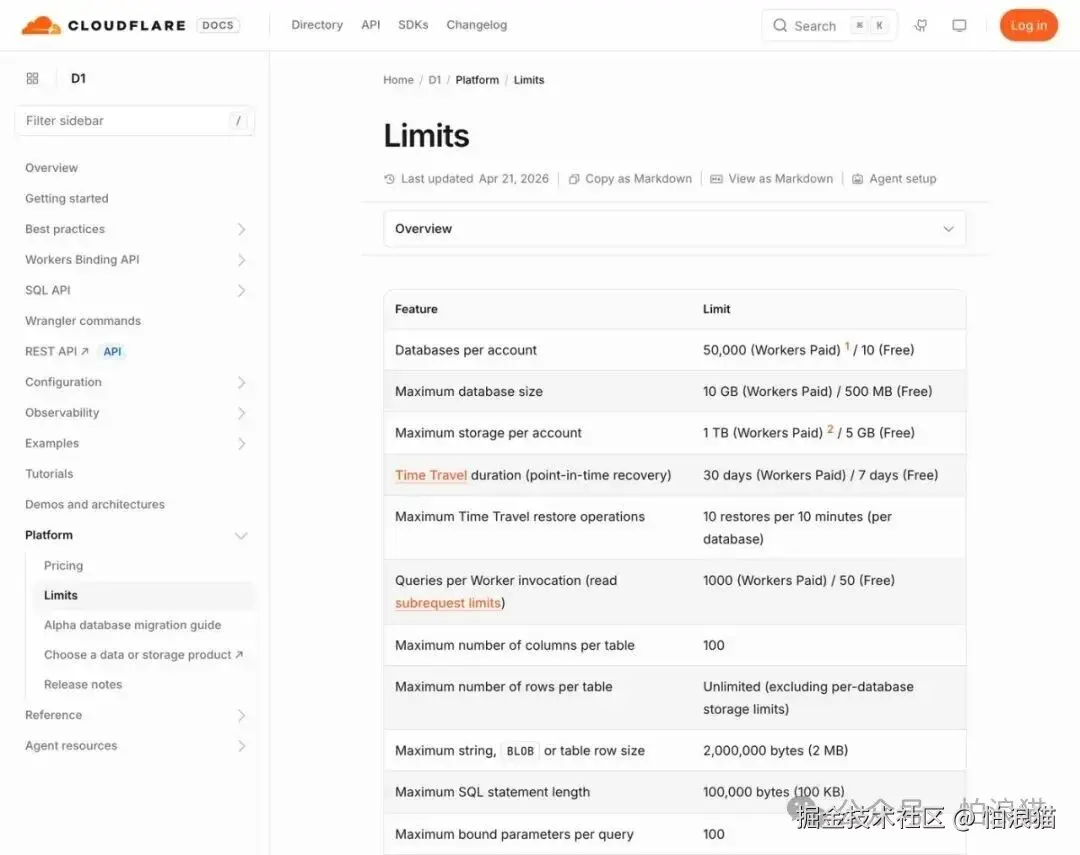
官方 Limits 页,单库最大 500 MB(Free)/ 10 GB(Paid),单次调用最多 50 次查询。
注意「单次 Worker 调用最多 50 次查询」这条 (Paid 是 1000 次)------它意味着你不能在一次请求里循环查数据库,必须用批量查询或 JOIN 把往返压下去。
另外两个容易忽略的:单表最多 100 列,单行最大 2 MB,单条 SQL 最长 100 KB。单库 Free 只有 500 MB,这个体量更适合放配置、用户偏好、会话数据,不是业务主库。
GitHub:Cloudflare 官方仓库,非 GitHub 项目
三、Hono:把 Express 的心智搬到了边缘
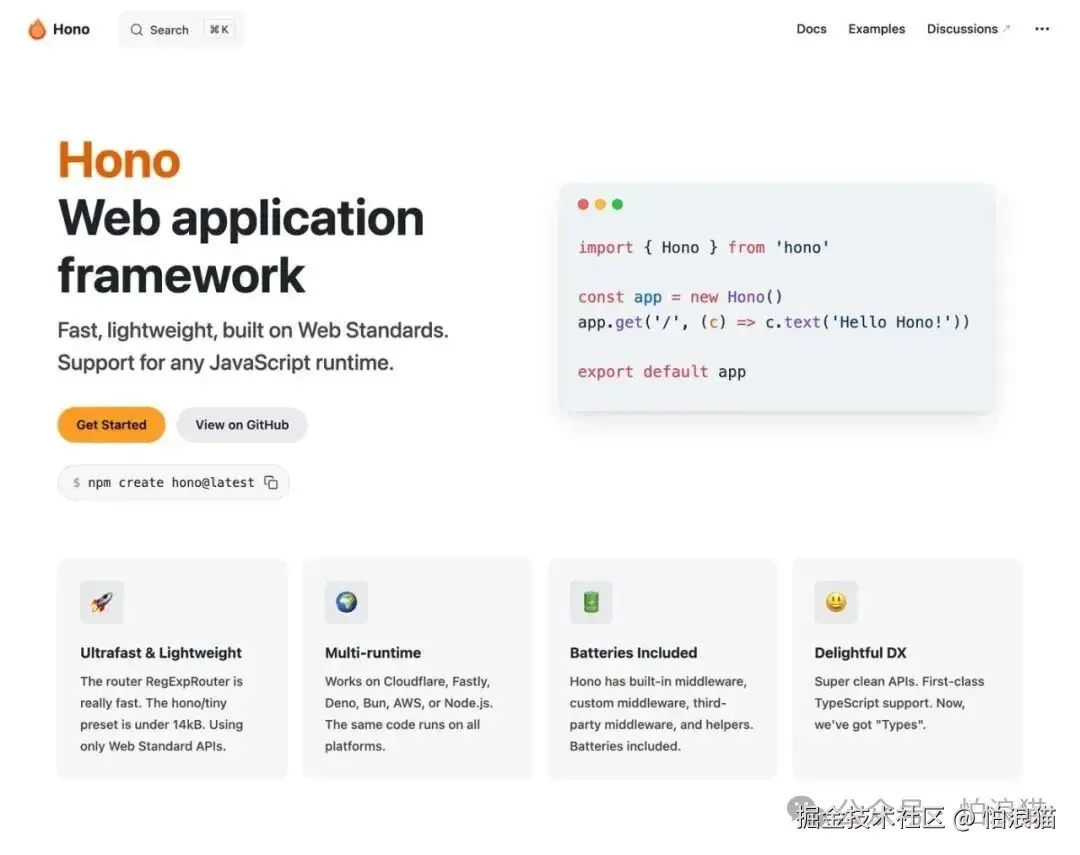
官网首屏那句「Fast, lightweight, built on Web Standards」,以及右上角的 14kB。
Hono 是 32,480 Star 的轻量 Web 框架,只有14KB 的 tiny preset,基于 Web Standards 构建,所以同一份代码能跑在 Cloudflare、Deno、Bun、AWS、Node.js 上。
它对前端为什么友好?因为它长得就像 Express:
bash
import { Hono } from 'hono'; import { drizzle } from 'drizzle-orm/d1'; import { eq, desc } from 'drizzle-orm'; const app = new Hono<{ Bindings: { DB: D1Database } }>(); app.get('/api/posts', async (c) => { const db = drizzle(c.env.DB); return c.json(await db.select().from(posts).orderBy(desc(posts.createdAt)).limit(20)); }); export default app;中间件、路由、上下文对象,全是 Express 那套写法。 会写 Express 的人上手几乎零成本。
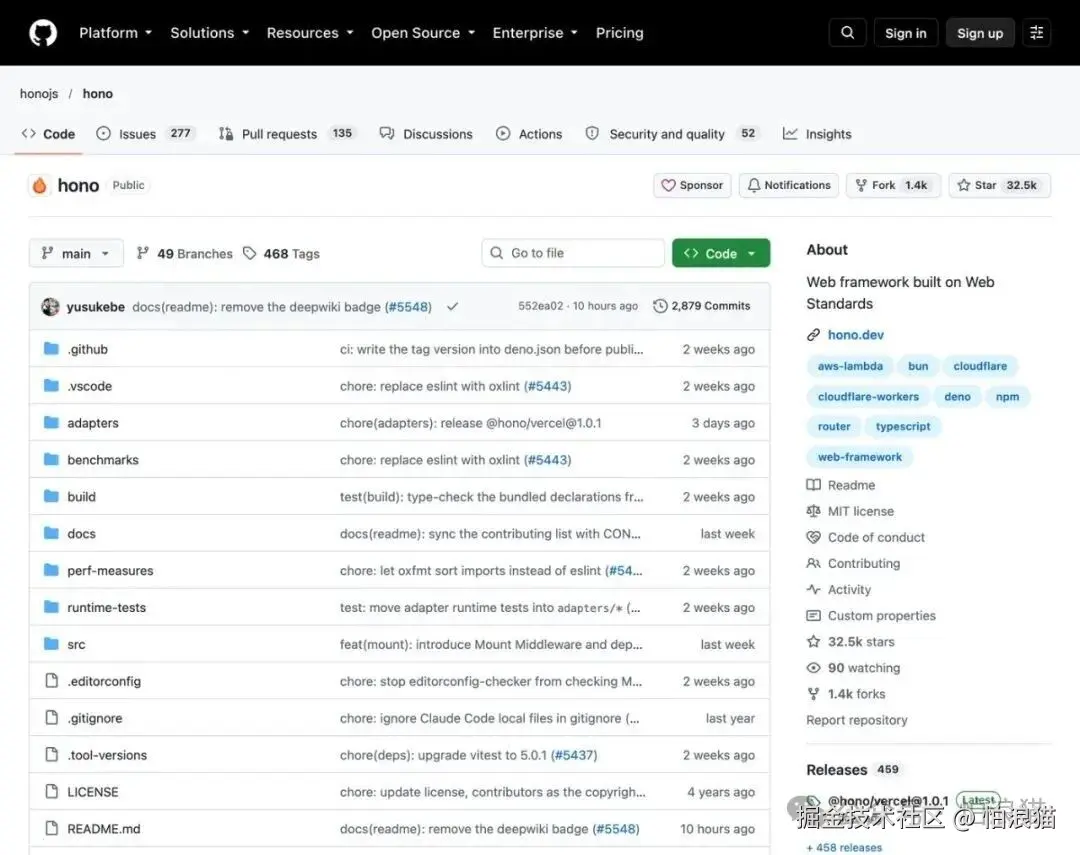
Hono 仓库右侧列了 Cloudflare、Netlify、Vercel、Deno、Bun 等全部适配目标。
它还内置了中间件生态(鉴权、CORS、缓存、静态文件、日志),不需要自己攒。
GitHub:github.com/honojs/hono|32,480 Star|MIT
四、Drizzle ORM:类型推断是真本事,但要看清代价
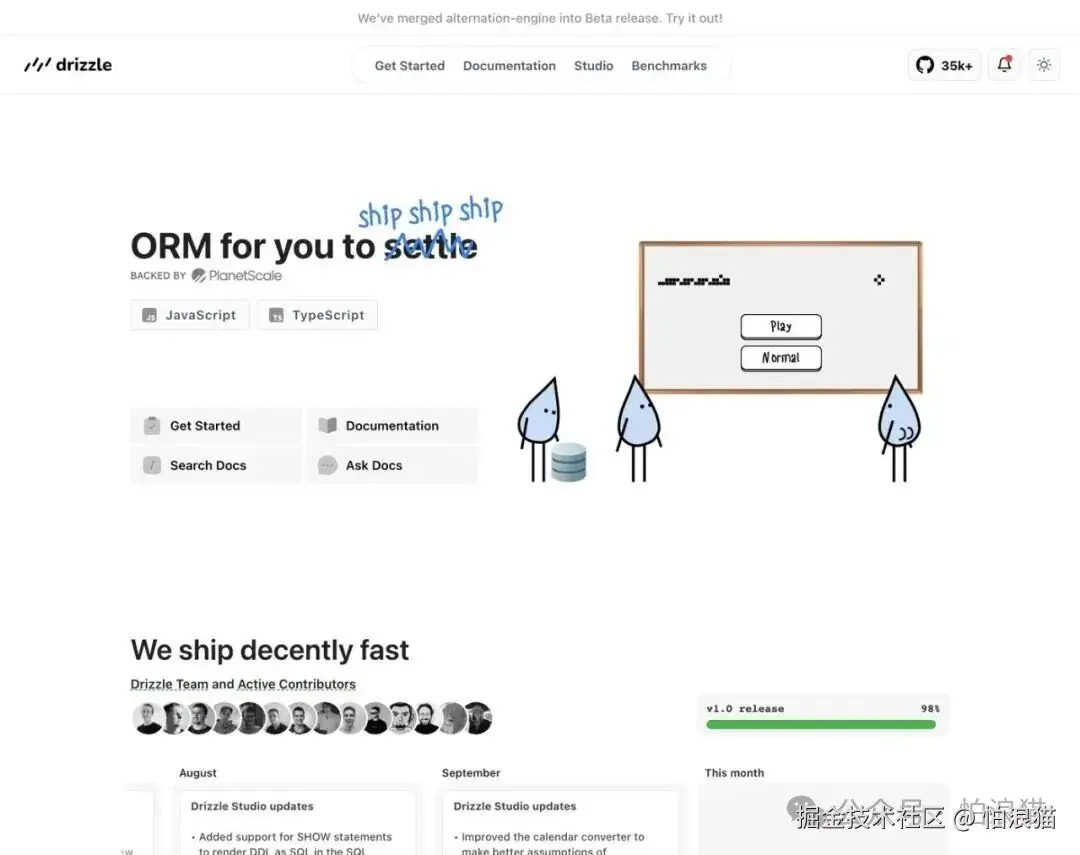
右上角 35k+ Star,左下角写着「Backed by PlanetScale」。
Drizzle 是 35,998 Star 的 TypeScript ORM,最大优势是写完 schema 之后,所有查询结果的类型自动推断出来,不用手写接口类型。
bash
const schema = sqliteTable('posts', { id: integer('id').primaryKey({ autoIncrement: true }), title: text('title').notNull(), createdAt: integer('created_at').notNull(), }); type Post = typeof posts.$inferSelect; // 类型自动出来但它有两个必须知道的代价:
一是 open issue 高达 2,124 个。 这个数字在同类里偏高,说明生态活跃但争议也多。GitHub 侧栏那个数字是issue + PR 相加,实际 issue 数要分开查。
二是它现在由 PlanetScale 背书。 官网顶部写着 "Backed by PlanetScale"------这不一定是坏事(意味着有商业支撑),但你要知道它的治理结构跟纯社区项目不一样。
Get Started 页面,SQLite / Postgres / MySQL 三条路径都从这里进。
GitHub:github.com/drizzle-team/drizzle-orm|35,998 Star|Apache-2.0
五、完整搭配:一条命令跑起来
四件套的组合关系是这样的:
| 层 | 选型 | 官方文档 | | --- | --- | --- | | 运行时 | Cloudflare Workers(V8 Isolates) | developers.cloudflare.com/workers | | 数据库 | D1(边缘 SQLite) | developers.cloudflare.com/d1 | | 路由框架 | Hono | hono.dev | | 数据访问 | Drizzle ORM | orm.drizzle.team | | CLI / 部署 | Wrangler | github.com/cloudflare/workers-sdk |
为什么这四个能拼在一起 :Hono 提供了 Workers 的适配器,Drizzle 提供了 D1 的 driver(drizzle-orm/d1),Wrangler 负责本地开发和一条命令部署。四者都是 Web Standards 优先,所以没有中间层胶水。
本地跑起来的完整流程(官方文档口径):
bash
npm create hono@latest # 起项目 npx wrangler login # 登录 Cloudflare npx wrangler d1 create mydb # 建库,记住返回的 database_id npx wrangler d1 execute mydb --file ./schema.sql # 建表 npx wrangler dev # 本地起服务(默认 8787) npx wrangler deploy # 部署注意 d1 execute 这条命令------建表、导数据都靠它,第一次部署前得先把schema 推上去。
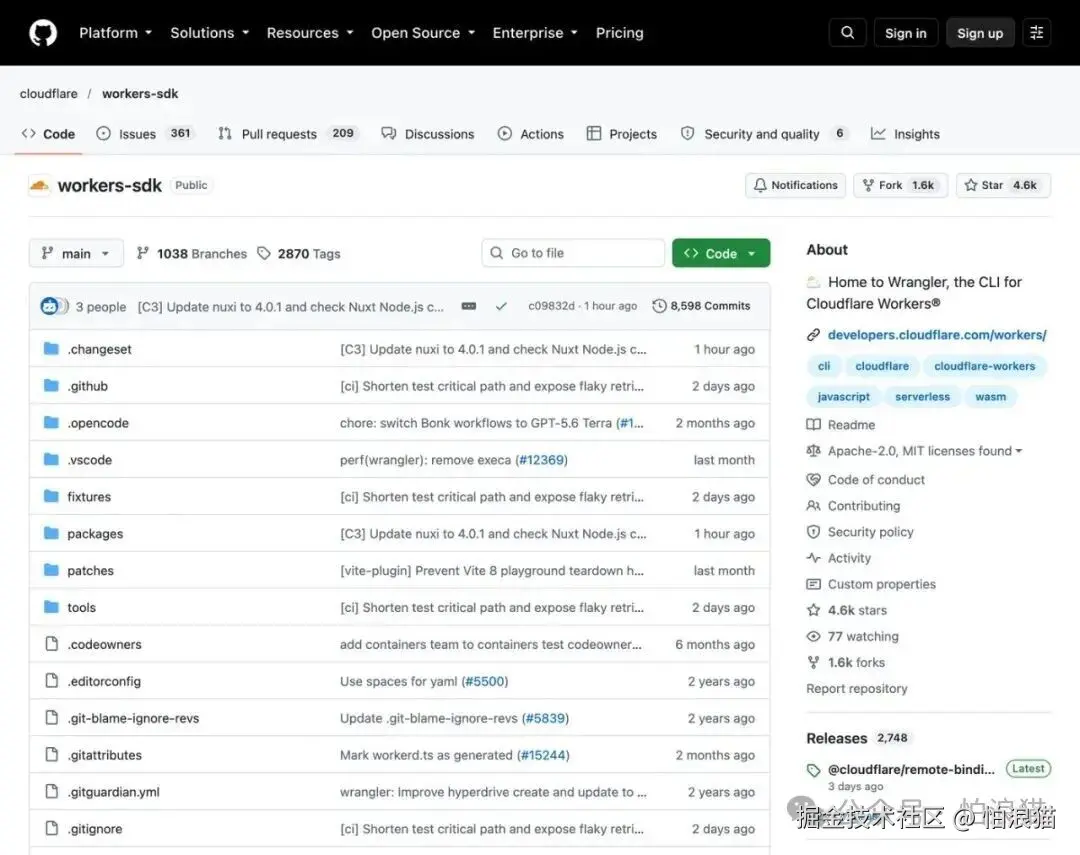
workers-sdk 仓库,Wrangler 的 CLI 全在这里,4,615 Star。
六、这套搭配不适合谁
不适合要跑长任务的。 Workers 单次 CPU 默认 30 秒上限(能调到 5 分钟但要改配置),视频转码、大模型推理、图片批处理都不合适。
不适合数据量大的。 D1 免费版单库 500 MB、单次调用 50 次查询,写一个稍复杂的后台管理系统就会撞墙。
不适合看重复杂查询的。 D1 是 SQLite 语义,没有 ON CONFLICT 之外的高级特性,没法像Postgres 那样做窗口函数、递归 CTE、物化视图。
不适合已经在 Vercel 上有深积累的。 Next.js 全家桶 143,135 Star、34,605 Fork,生态成熟度远高于 Workers 组合,迁移成本不小。
我自己的判断
这套栈最大的价值不是"技术先进",是"学习成本低"。 Hono 像 Express、Drizzle 类型自动推导、Wrangler 一条命令部署------这三件事加起来,你确实不用先学K8s 才能写后端。
但它有明确的边界。 128MB 内存、50 次查询/次调用、500MB 单库,这三个数字会在你写到某个阶段时突然拦住你。
我的建议是:拿它做中小型服务和个人项目,别拿它扛核心业务。 遇到瓶颈再迁------Hono 的代码结构本身很干净,迁走不难。
(四个项目的官网地址和上面那份本地启动命令,后台回我「全栈搭配」就行,正文里的网址点不动,只能这么送。)
上面这些数字------128MB 内存、50 次查询、500 万行/天、$5 底价------我是今天从官方文档里逐条抄的,不是从那篇复盘文章里搬的。这套东西迭代很快,Cloudflare 的额度调整过好几次,你上手前自己再看一眼当前版本。
**你现在手上有项目还在用传统后端吗?或者已经在用这套组合了,卡在哪个环节?**评论区留言告诉我,我挑典型的写一期实测。