1. Deepseek简介
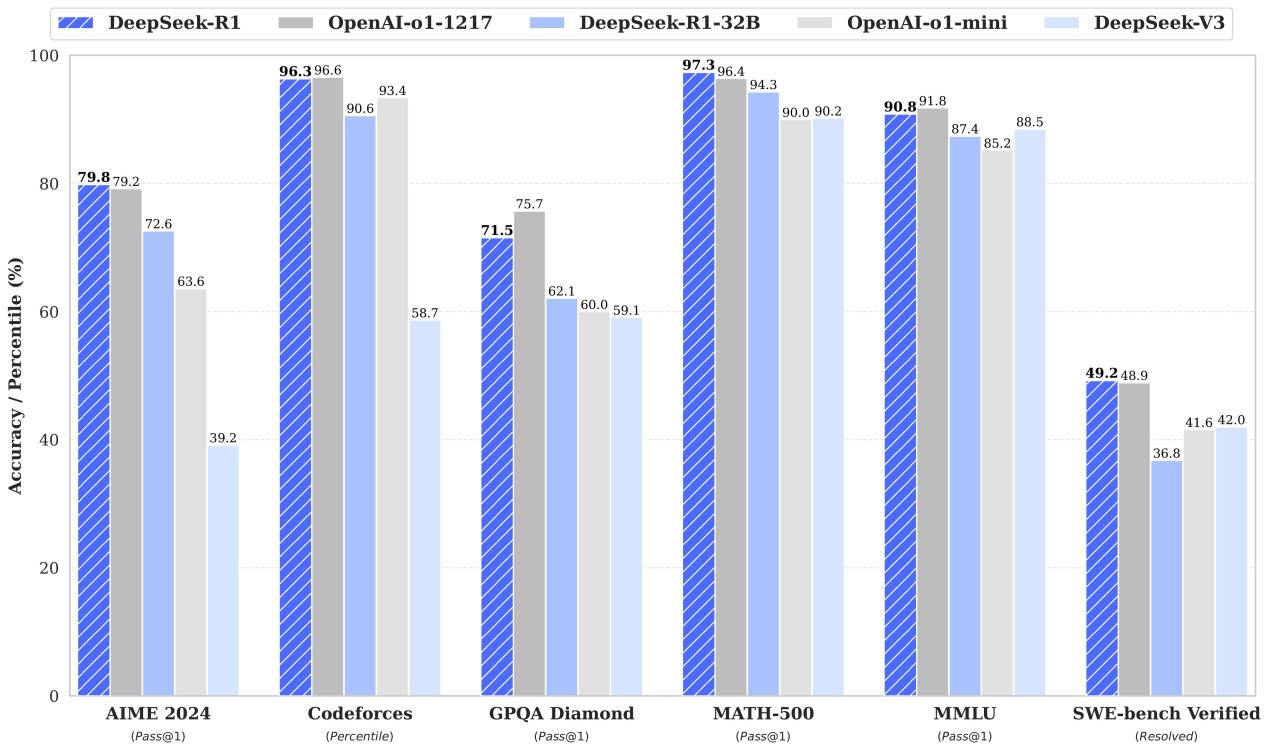
DeepSeek-R1,是幻方量化旗下AI公司深度求索(DeepSeek)研发的推理模型 。DeepSeek-R1采用强化学习进行后训练,旨在提升推理能力,尤其擅长数学、代码和自然语言推理等复杂任务。作为国产AI大数据模型的代表,凭借其卓越的推理能力和高效的文本生成技术,在全球人工智能领域引发广泛关注。
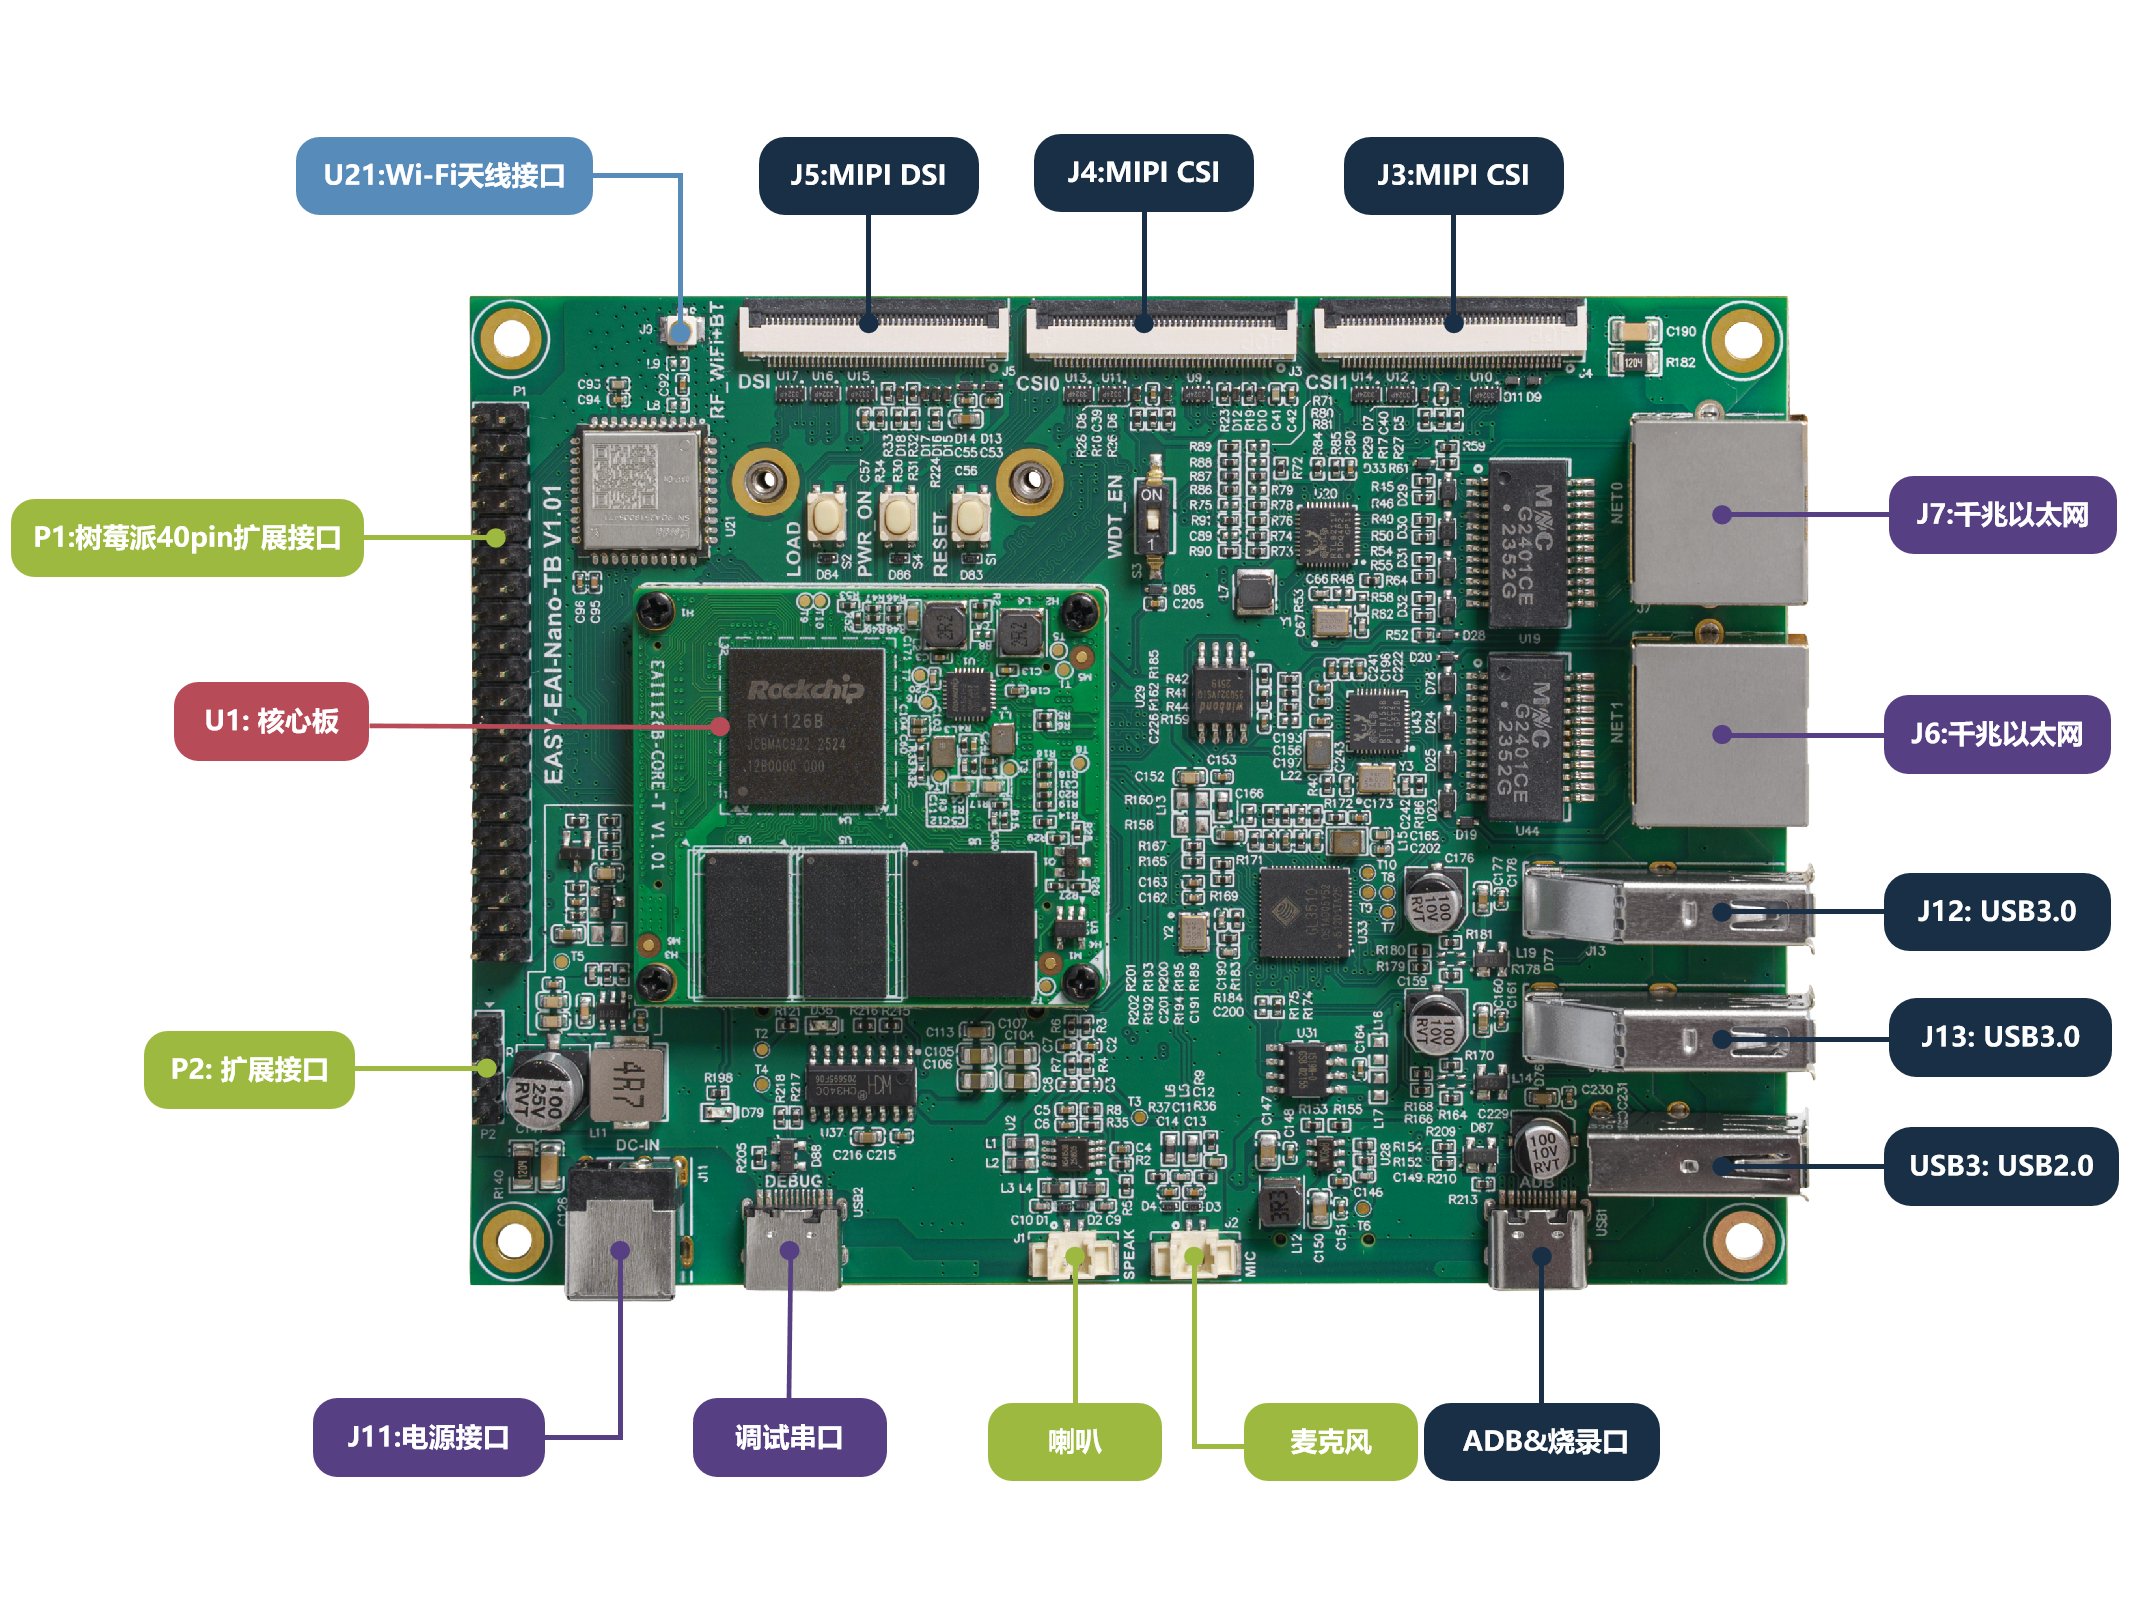
本文主要说明DeepSeek-R1如何离线运行在EASY-EAI-Nano-TB(RV1126B)硬件上, RK1126B具有优异的端侧AI能效比与极高的性价比,是AI落地的不二之选。
2. 开发环境搭建
2.1 RKLLM-Toolkit安装
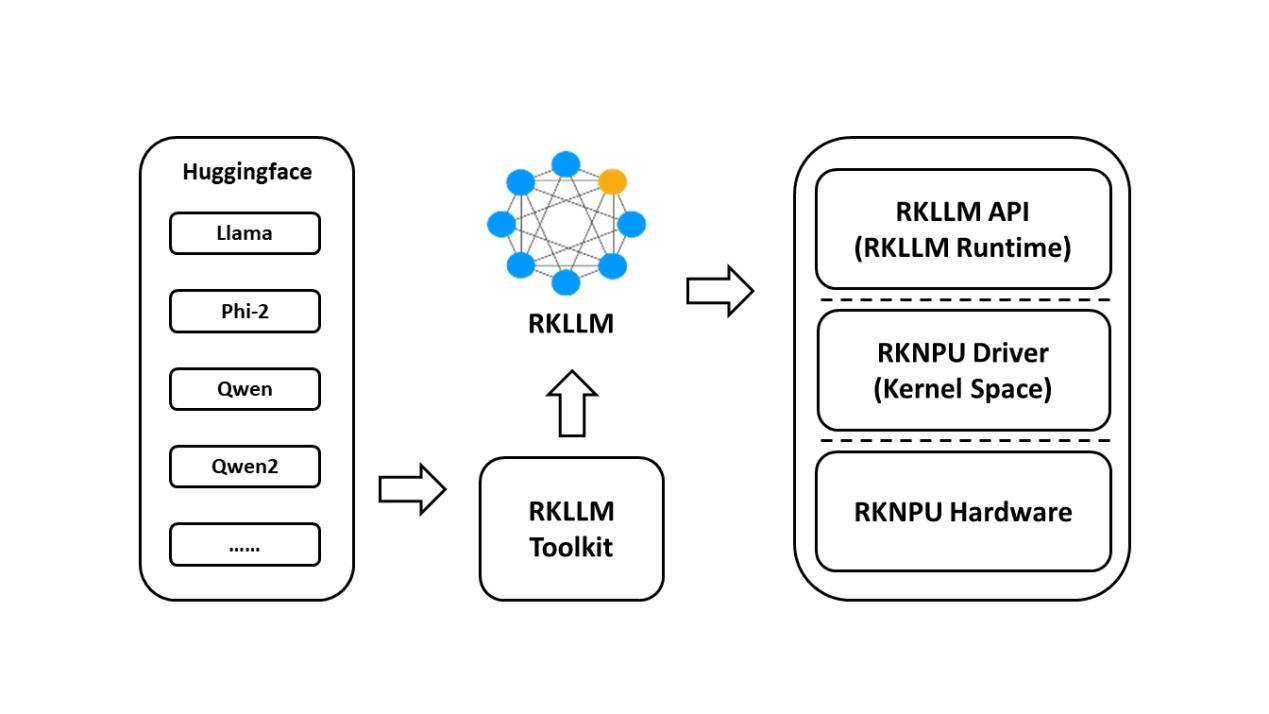
本节主要说明如何通过 pip 方式来安装 RKLLM-Toolkit,用户可以参考以下的具体流程说明完成 RKLLM-Toolkit 工具链的安装。
工具安装包链接: 百度网盘
提取码: 1234。
2.1.1 安装miniforge3工具
为防止系统对多个不同版本的 Python 环境的需求,建议使用 miniforge3 管理 Python 环境。 检查是否安装 miniforge3 和 conda 版本信息,若已安装则可省略此小节步骤。
下载 miniforge3 安装包:
cpp
`wget -c https://mirrors.bfsu.edu.cn/github-release/conda-forge/miniforge/LatestRelease/Miniforge3-Linux-x86_64.sh`安装miniforge3:
cpp
`chmod 777 Miniforge3-Linux-x86_64.sh
bash Miniforge3-Linux-x86_64.sh`
2.1.2 创建 RKLLM-Toolkit Conda 环境
进入 Conda base 环境:
cpp
`source ~/miniforge3/bin/activate`创建一个 Python3.8 版本(建议版本)名为 RKLLM-Toolkit 的 Conda 环境:
cpp
`conda create -n RKLLM-Toolkit python=3.8`进入 RKLLM-Toolkit Conda 环境:
cpp
`conda activate RKLLM-Toolkit`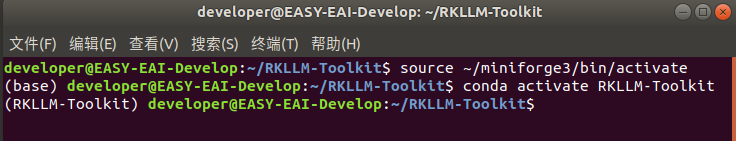
2.1.3 安装RKLLM-Toolkit
在 RKLLM-Toolkit Conda 环境下使用 pip 工具直接安装所提供的工具链 whl 包,在安装过程 中,安装工具会自动下载 RKLLM-Toolkit 工具所需要的相关依赖包。
cpp
`pip install vidia_cublas_cu12-12.1.3.1-py3-none-manylinux1_x86_64.whl
pip install scipy-1.10.1-cp38-cp38-manylinux_2_17_x86_64.manylinux2014_x86_64.whl
pip install torchvision-0.18.0-cp38-cp38-manylinux1_x86_64.whl
pip install transformers-4.46.3-py3-none-any.whl
pip install triton-2.3.0-cp38-cp38-manylinux_2_17_x86_64.manylinux2014_x86_64.whl
pip install  torch-2.3.0-cp38-cp38-manylinux1_x86_64.whl
pip install rkllm_toolkit-1.2.2-cp38-cp38-linux_x86_64.whl`
若在安装的过程中,某些文件安装很慢,可以登录python官网单独下载:
cpp
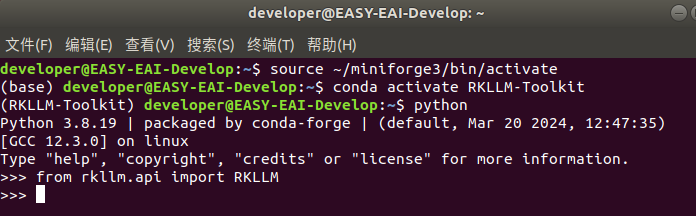
`https://pypi.org/`执行以下命令没有报错,则安装成功。
3. Deepseek-R1模型转换
本章主要说明如何实现Deepseek-R1大语言模型如何转换为RKLLM模型。
3.1 模型与脚本下载
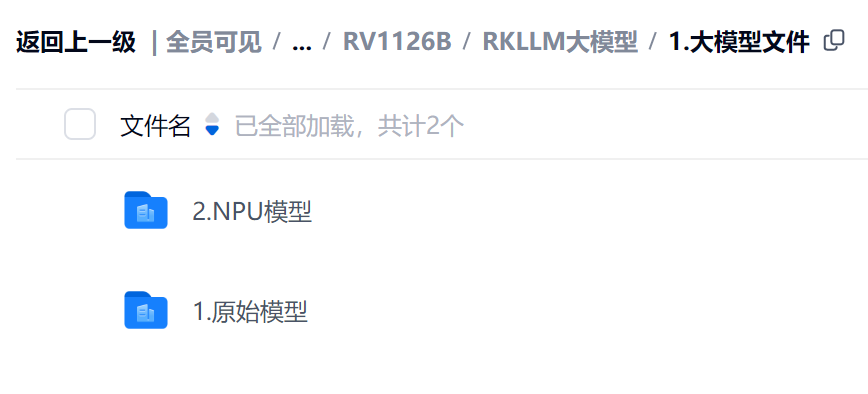
本节提供两种大模型文件,Hugging face的原始模型和转换完成的NPU模型。
还有用于模型转换的脚本:
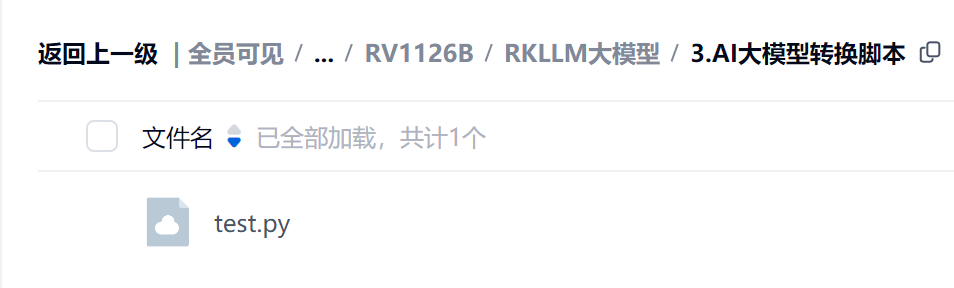
下载链接:
提取码: 1234
3.2 模型转换
下载完成后模型和脚本放到同一个目录:
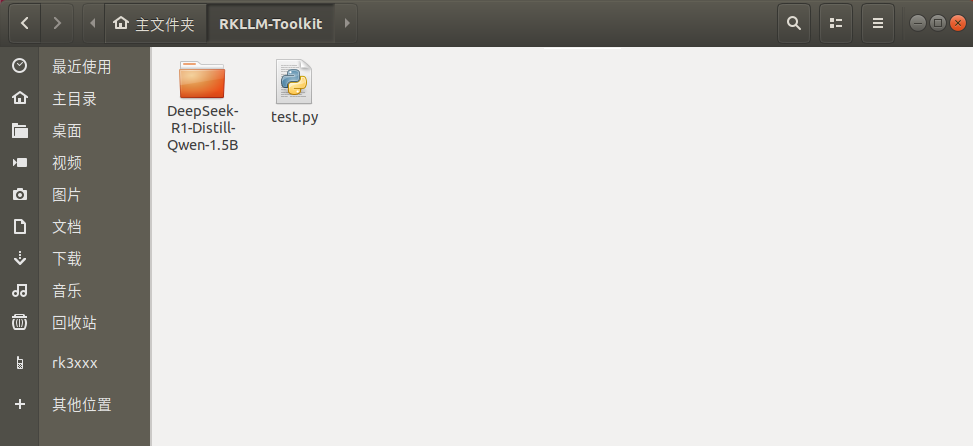
在RKLLM-Toolkit环境,执行以下指令进行模型转换:
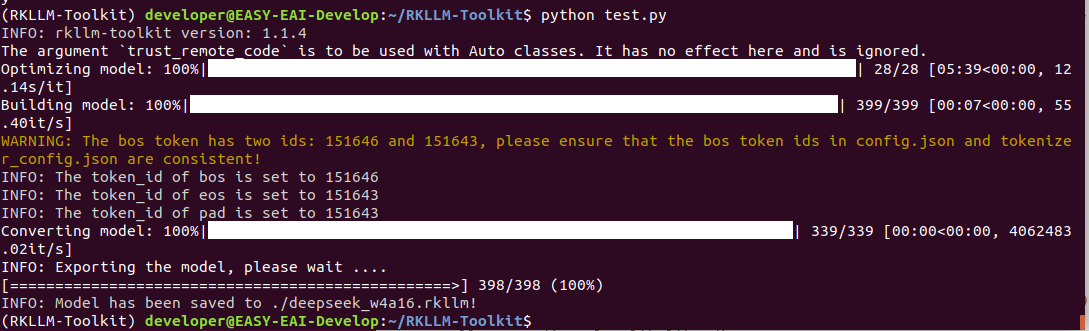
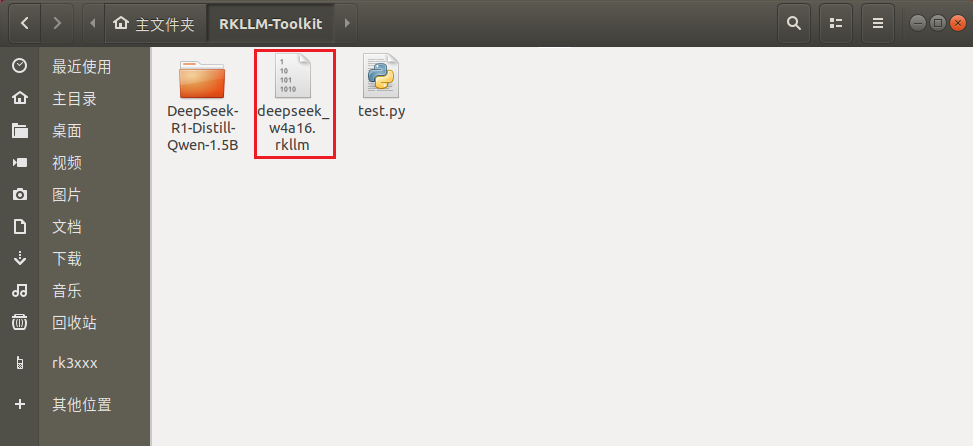
至此模型转换成功,生成deepseek_w4a16.rkllm NPU化的大模型文件:
test.py转换脚本如下所示, 用于转换deepseek-r1模型:
cpp
`from rkllm.api import RKLLM
from datasets import load_dataset
from transformers import AutoTokenizer
from tqdm import tqdm
import torch
from torch import nn
import os
# os.environ['CUDA_VISIBLE_DEVICES']='1'


modelpath = '/home/developer/RKLLM-Toolkit/DeepSeek-R1-Distill-Qwen-1.5B'
llm = RKLLM()

# Load model
# Use 'export CUDA_VISIBLE_DEVICES=2' to specify GPU device
# options ['cpu', 'cuda']
ret = llm.load_huggingface(model=modelpath, model_lora = None, device='cpu')
# ret = llm.load_gguf(model = modelpath)
if ret != 0:
    print('Load model failed!')
    exit(ret)

# Build model
dataset = "./data_quant.json"
# Json file format, please note to add prompt in the input,like this:
# [{"input":"Human: 你好!\nAssistant: ", "target": "你好!我是人工智能助手KK!"},...]

qparams = None
# qparams = 'gdq.qparams' # Use extra_qparams
ret = llm.build(do_quantization=True, optimization_level=1, quantized_dtype='w4a16',
                quantized_algorithm='normal', target_platform='rk1126b', num_npu_core=1, extra_qparams=qparams, dataset=None)

if ret != 0:
    print('Build model failed!')
    exit(ret)

# Chat with model
messages = "<|im_start|>system You are a helpful assistant.<|im_end|><|im_start|>user你好!\n<|im_end|><|im_start|>assistant"
kwargs = {"max_length": 128, "top_k": 1, "top_p": 0.8,
          "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
# print(llm.chat_model(messages, kwargs))


# Export rkllm model
ret = llm.export_rkllm("./deepseek_r1_rk1126b_w4a16.rkllm")
if ret != 0:
print('Export model failed!')`
4. Deepseek-R1模型部署
本章主要说明RKLLM格式的NPU模型如何运行在EASY-EAI-Nano-TB硬件上。
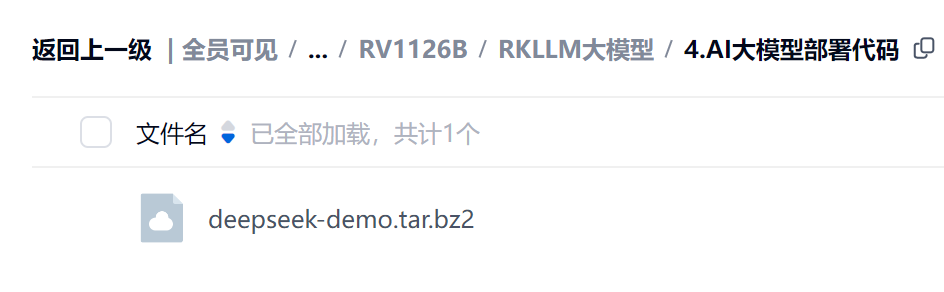
提取码: 1234
然后把例程【复制粘贴】到nfs挂载目录中。(不清楚目录如何构建的,可以参考《入门指南/开发环境准备/nfs服务搭建与挂载》)。特别注意:源码目录和模型最好cp到板子上,如/userdata,否则在nfs目录执行大模型会导致模型初始化过慢。
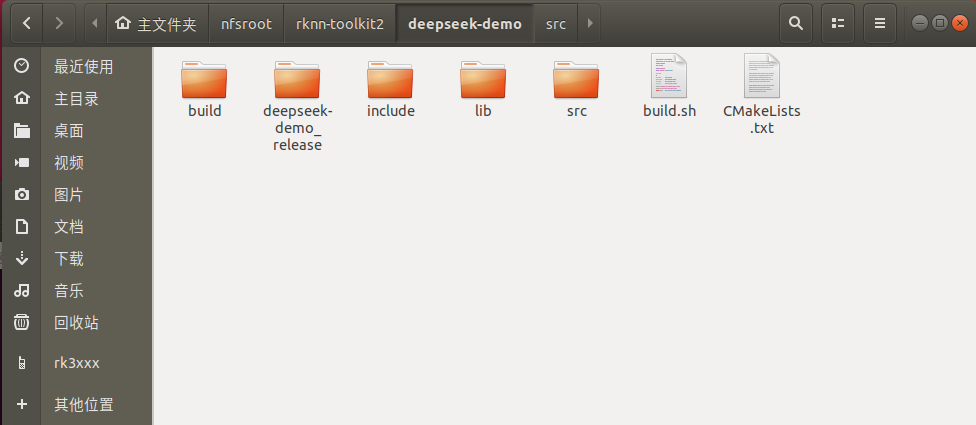
在PC端Ubuntu系统中执行run脚本,进入EASY-EAI编译环境,具体如下所示。
cpp
`cd ~/develop_environment
./run.sh`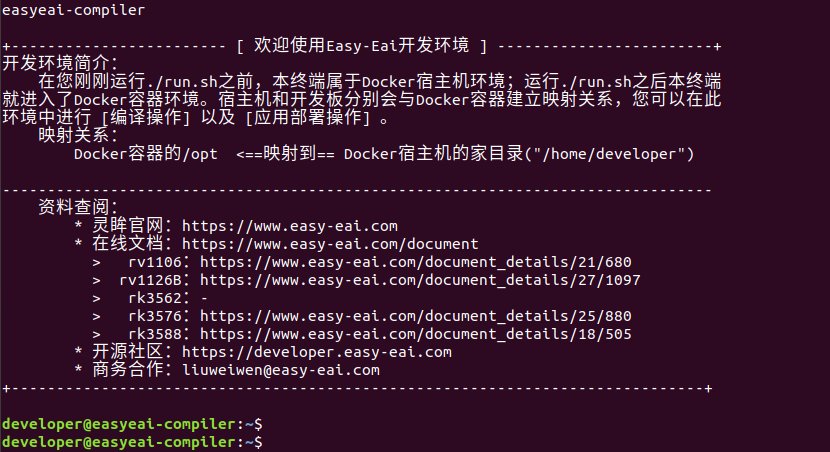
在EASY-EAI 编译环境下,进入到对应的例程目录执行编译操作,具体命令如下所示:
cpp
`cd /opt/nfsroot/rknn-toolkit2/deepseek-demo/
./build.sh`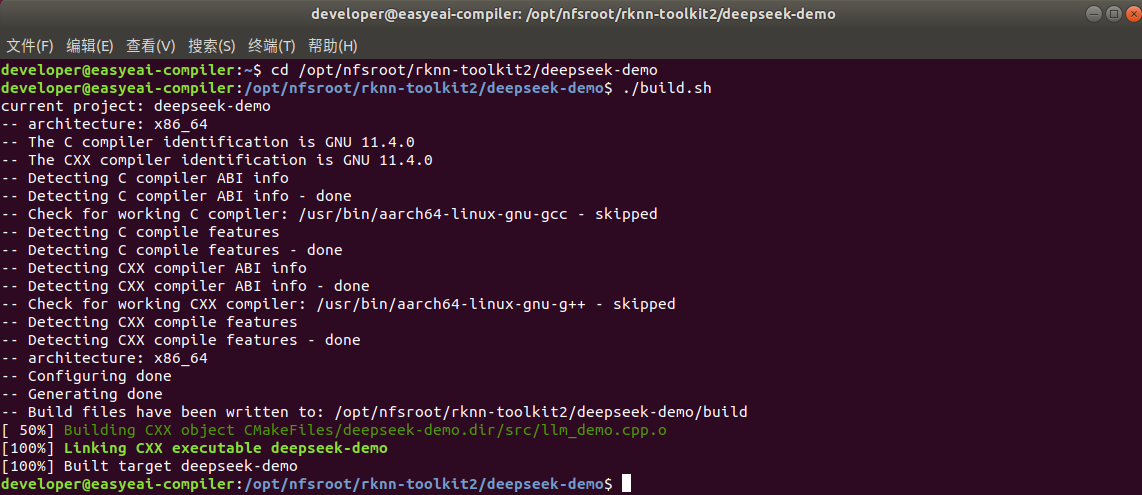
4.1 例程运行 及效果
进入例程的deepseek-demo/deepseek-demo_release目录,执行下方命令,运行示例程序:
cpp
`cd deepseek-demo_release/
ulimit -HSn 102400
./deepseek-demo deepseek_w4a16.rkllm 256 512`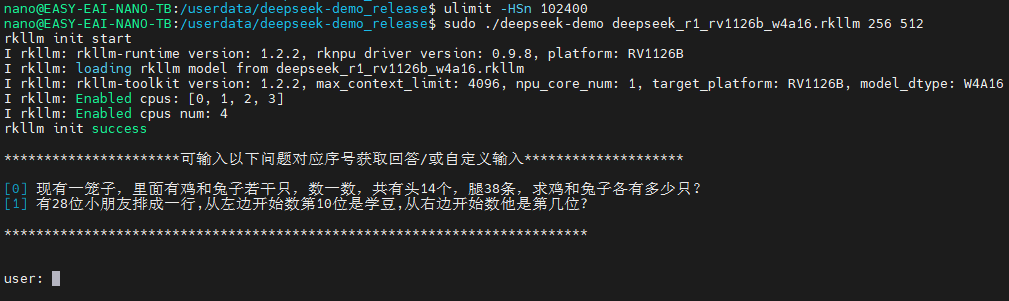
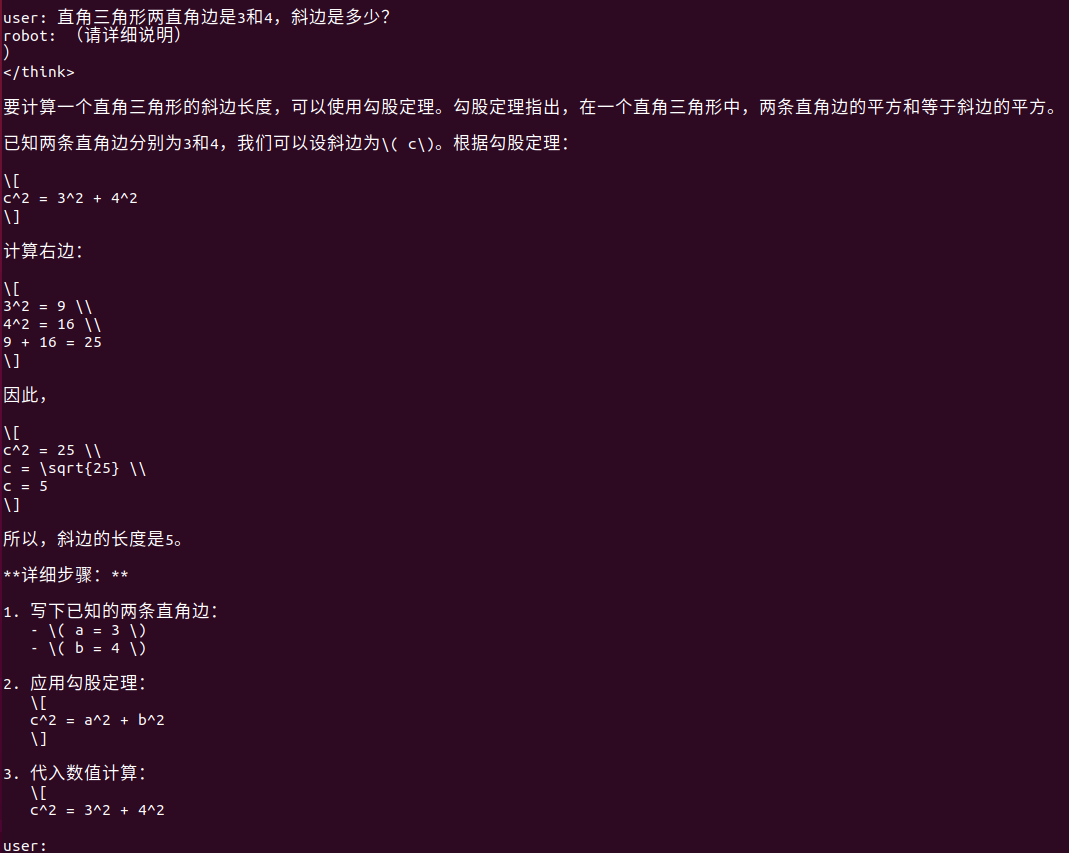
至此可以进行对话测试了,试着输入"直角三角形两直角边是3和4,斜边是多少?"。回答如下所示:
4.2 RKLLM算法例程
例程目录为rkllm-demo*/* src/main .cpp,操作流程如下。
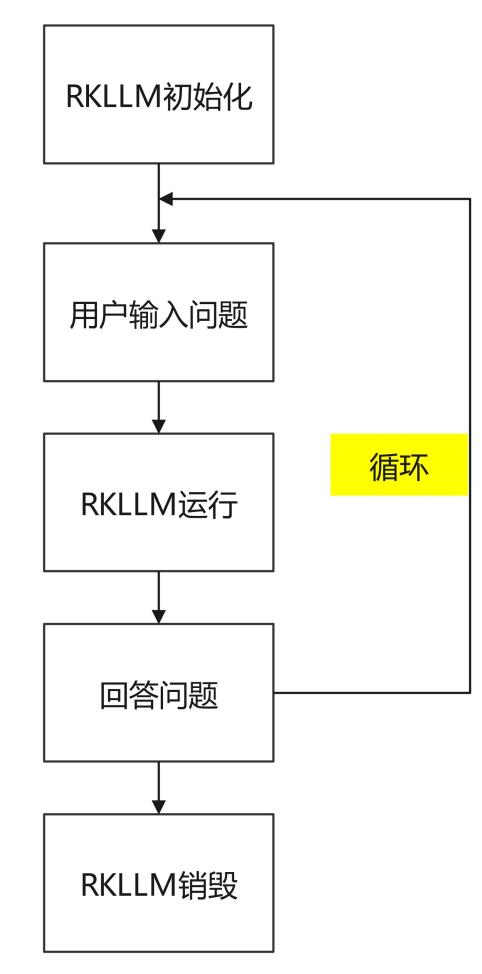
具体代码如下所示:
cpp
`#include <string.h>
#include <unistd.h>
#include <string>
#include "rkllm.h"
#include <fstream>
#include <iostream>
#include <csignal>
#include <vector>
#define PROMPT_TEXT_PREFIX "<|im_start|>system You are a helpful assistant. <|im_end|> <|im_start|>user"
#define PROMPT_TEXT_POSTFIX "<|im_end|><|im_start|>assistant"
using namespace std;
LLMHandle llmHandle = nullptr;
void exit_handler(int signal)
{
if (llmHandle != nullptr)
{
{
cout << "程序即将退出" << endl;
LLMHandle _tmp = llmHandle;
llmHandle = nullptr;
rkllm_destroy(_tmp);
}
}
exit(signal);
}
void callback(RKLLMResult *result, void *userdata, LLMCallState state)
{
if (state == RKLLM_RUN_FINISH)
{
printf("\n");
} else if (state == RKLLM_RUN_ERROR) {
printf("\\run error\n");
} else if (state == RKLLM_RUN_GET_LAST_HIDDEN_LAYER) {
/* ================================================================================================================
若使用GET_LAST_HIDDEN_LAYER功能,callback接口会回传内存指针:last_hidden_layer,token数量:num_tokens与隐藏层大小:embd_size
通过这三个参数可以取得last_hidden_layer中的数据
注:需要在当前callback中获取,若未及时获取,下一次callback会将该指针释放
===============================================================================================================*/
if (result->last_hidden_layer.embd_size != 0 && result->last_hidden_layer.num_tokens != 0) {
int data_size = result->last_hidden_layer.embd_size * result->last_hidden_layer.num_tokens * sizeof(float);
printf("\ndata_size:%d",data_size);
std::ofstream outFile("last_hidden_layer.bin", std::ios::binary);
if (outFile.is_open()) {
outFile.write(reinterpret_cast<const char*>(result->last_hidden_layer.hidden_states), data_size);
outFile.close();
std::cout << "Data saved to output.bin successfully!" << std::endl;
} else {
std::cerr << "Failed to open the file for writing!" << std::endl;
}
}
} else if (state == RKLLM_RUN_NORMAL) {
printf("%s", result->text);
}
}
int main(int argc, char **argv)
{
if (argc < 4) {
std::cerr << "Usage: " << argv[0] << " model_path max_new_tokens max_context_len\n";
return 1;
}
signal(SIGINT, exit_handler);
printf("rkllm init start\n");
//设置参数及初始化
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = argv[1];
//设置采样参数
param.top_k = 1;
param.top_p = 0.95;
param.temperature = 0.8;
param.repeat_penalty = 1.1;
param.frequency_penalty = 0.0;
param.presence_penalty = 0.0;
param.max_new_tokens = std::atoi(argv[2]);
param.max_context_len = std::atoi(argv[3]);
param.skip_special_token = true;
param.extend_param.base_domain_id = 0;
int ret = rkllm_init(&llmHandle, ¶m, callback);
if (ret == 0){
printf("rkllm init success\n");
} else {
printf("rkllm init failed\n");
exit_handler(-1);
}
string text;
RKLLMInput rkllm_input;
// 初始化 infer 参数结构体
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam)); // 将所有内容初始化为 0
// 1. 初始化并设置 LoRA 参数(如果需要使用 LoRA)
// RKLLMLoraAdapter lora_adapter;
// memset(&lora_adapter, 0, sizeof(RKLLMLoraAdapter));
// lora_adapter.lora_adapter_path = "qwen0.5b_fp16_lora.rkllm";
// lora_adapter.lora_adapter_name = "test";
// lora_adapter.scale = 1.0;
// ret = rkllm_load_lora(llmHandle, &lora_adapter);
// if (ret != 0) {
// printf("\nload lora failed\n");
// }
// 加载第二个lora
// lora_adapter.lora_adapter_path = "Qwen2-0.5B-Instruct-all-rank8-F16-LoRA.gguf";
// lora_adapter.lora_adapter_name = "knowledge_old";
// lora_adapter.scale = 1.0;
// ret = rkllm_load_lora(llmHandle, &lora_adapter);
// if (ret != 0) {
// printf("\nload lora failed\n");
// }
// RKLLMLoraParam lora_params;
// lora_params.lora_adapter_name = "test"; // 指定用于推理的 lora 名称
// rkllm_infer_params.lora_params = &lora_params;
// 2. 初始化并设置 Prompt Cache 参数(如果需要使用 prompt cache)
// RKLLMPromptCacheParam prompt_cache_params;
// prompt_cache_params.save_prompt_cache = true; // 是否保存 prompt cache
// prompt_cache_params.prompt_cache_path = "./prompt_cache.bin"; // 若需要保存prompt cache, 指定 cache 文件路径
// rkllm_infer_params.prompt_cache_params = &prompt_cache_params;
// rkllm_load_prompt_cache(llmHandle, "./prompt_cache.bin"); // 加载缓存的cache
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
while (true)
{
std::string input_str;
printf("\n");
printf("user: ");
std::getline(std::cin, input_str);
if (input_str == "exit")
{
break;
}
for (int i = 0; i < (int)pre_input.size(); i++)
{
if (input_str == to_string(i))
{
input_str = pre_input[i];
cout << input_str << endl;
}
}
//text = PROMPT_TEXT_PREFIX + input_str + PROMPT_TEXT_POSTFIX;
text = input_str;
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.prompt_input = (char *)text.c_str();
printf("robot: ");
// 若要使用普通推理功能,则配置rkllm_infer_mode为RKLLM_INFER_GENERATE或不配置参数
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
}
rkllm_destroy(llmHandle);
return 0;
}`5. 资料获取
完整资料包的下载链接:
链接: 百度网盘
提取码: 1234