> 系列:VeapAI 自然语言操作实战(全体系架构专题)
> 本文要点:19 类节点 · 三种运行模式 · 49 节点命令流程 · 五段推理与逐段强校验
一张图,怎么跑成一次执行
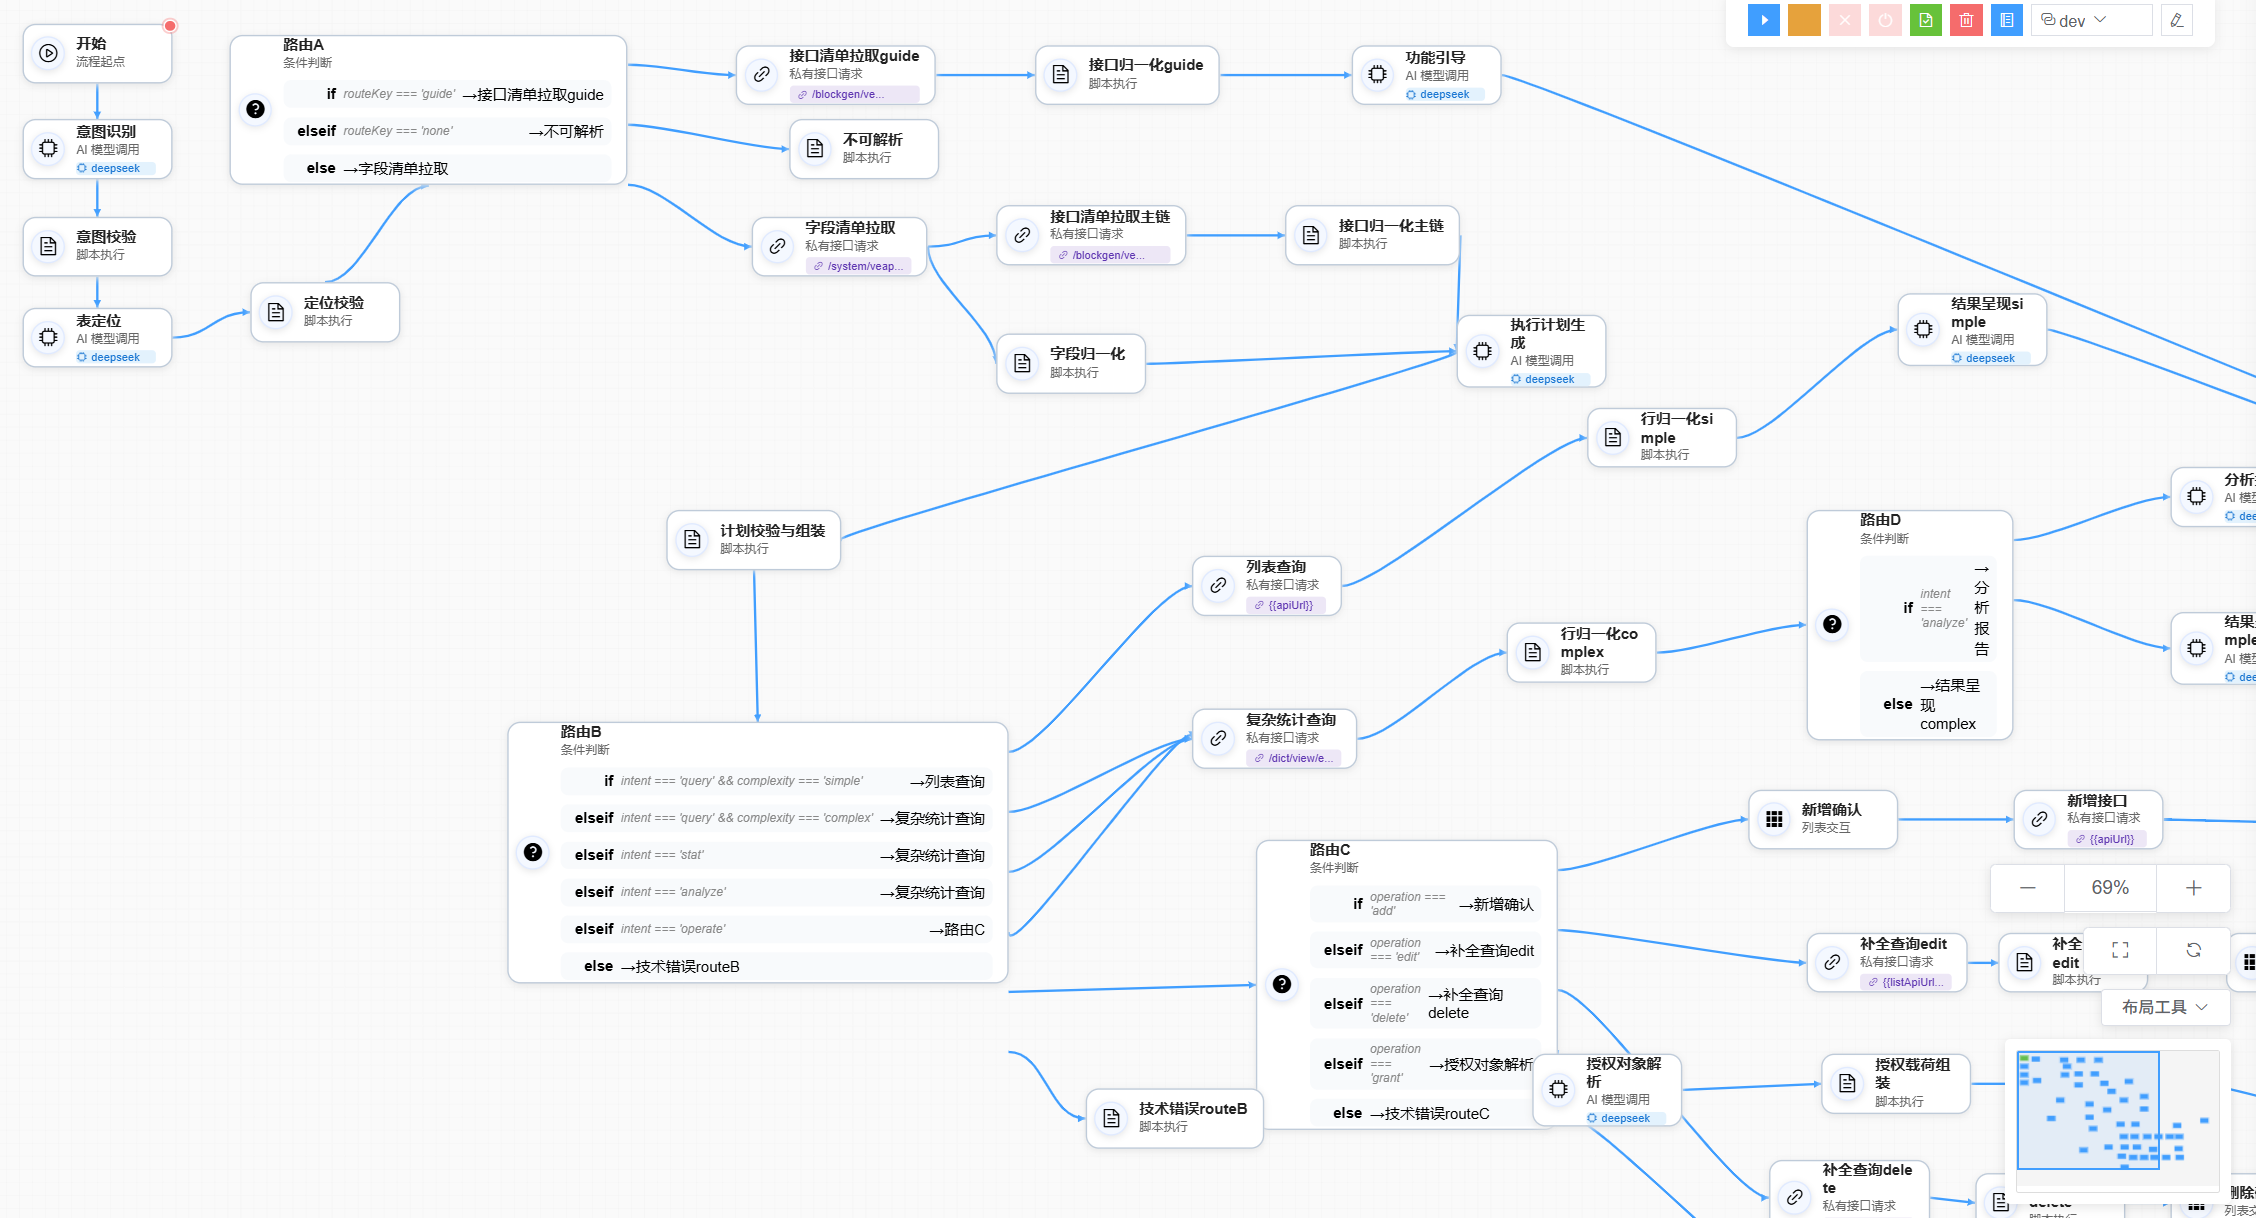
画布上挂着 49 个节点、58 条连线,这张图是"看图说话"还是真能干活?
执行层要回答四个问题:图怎么被调度、状态怎么收口、出错怎么定位、写操作谁负责把关。前两问归引擎,后两问归引擎与业务契约的配合。
!Agent 画布全景:19 类节点在画布上编排,运行与调试共用同一套引擎
引擎:定义、运行、内核
!编排引擎运行架构:编排定义、三种运行模式、执行内核、交互门禁、留痕与稳定契约
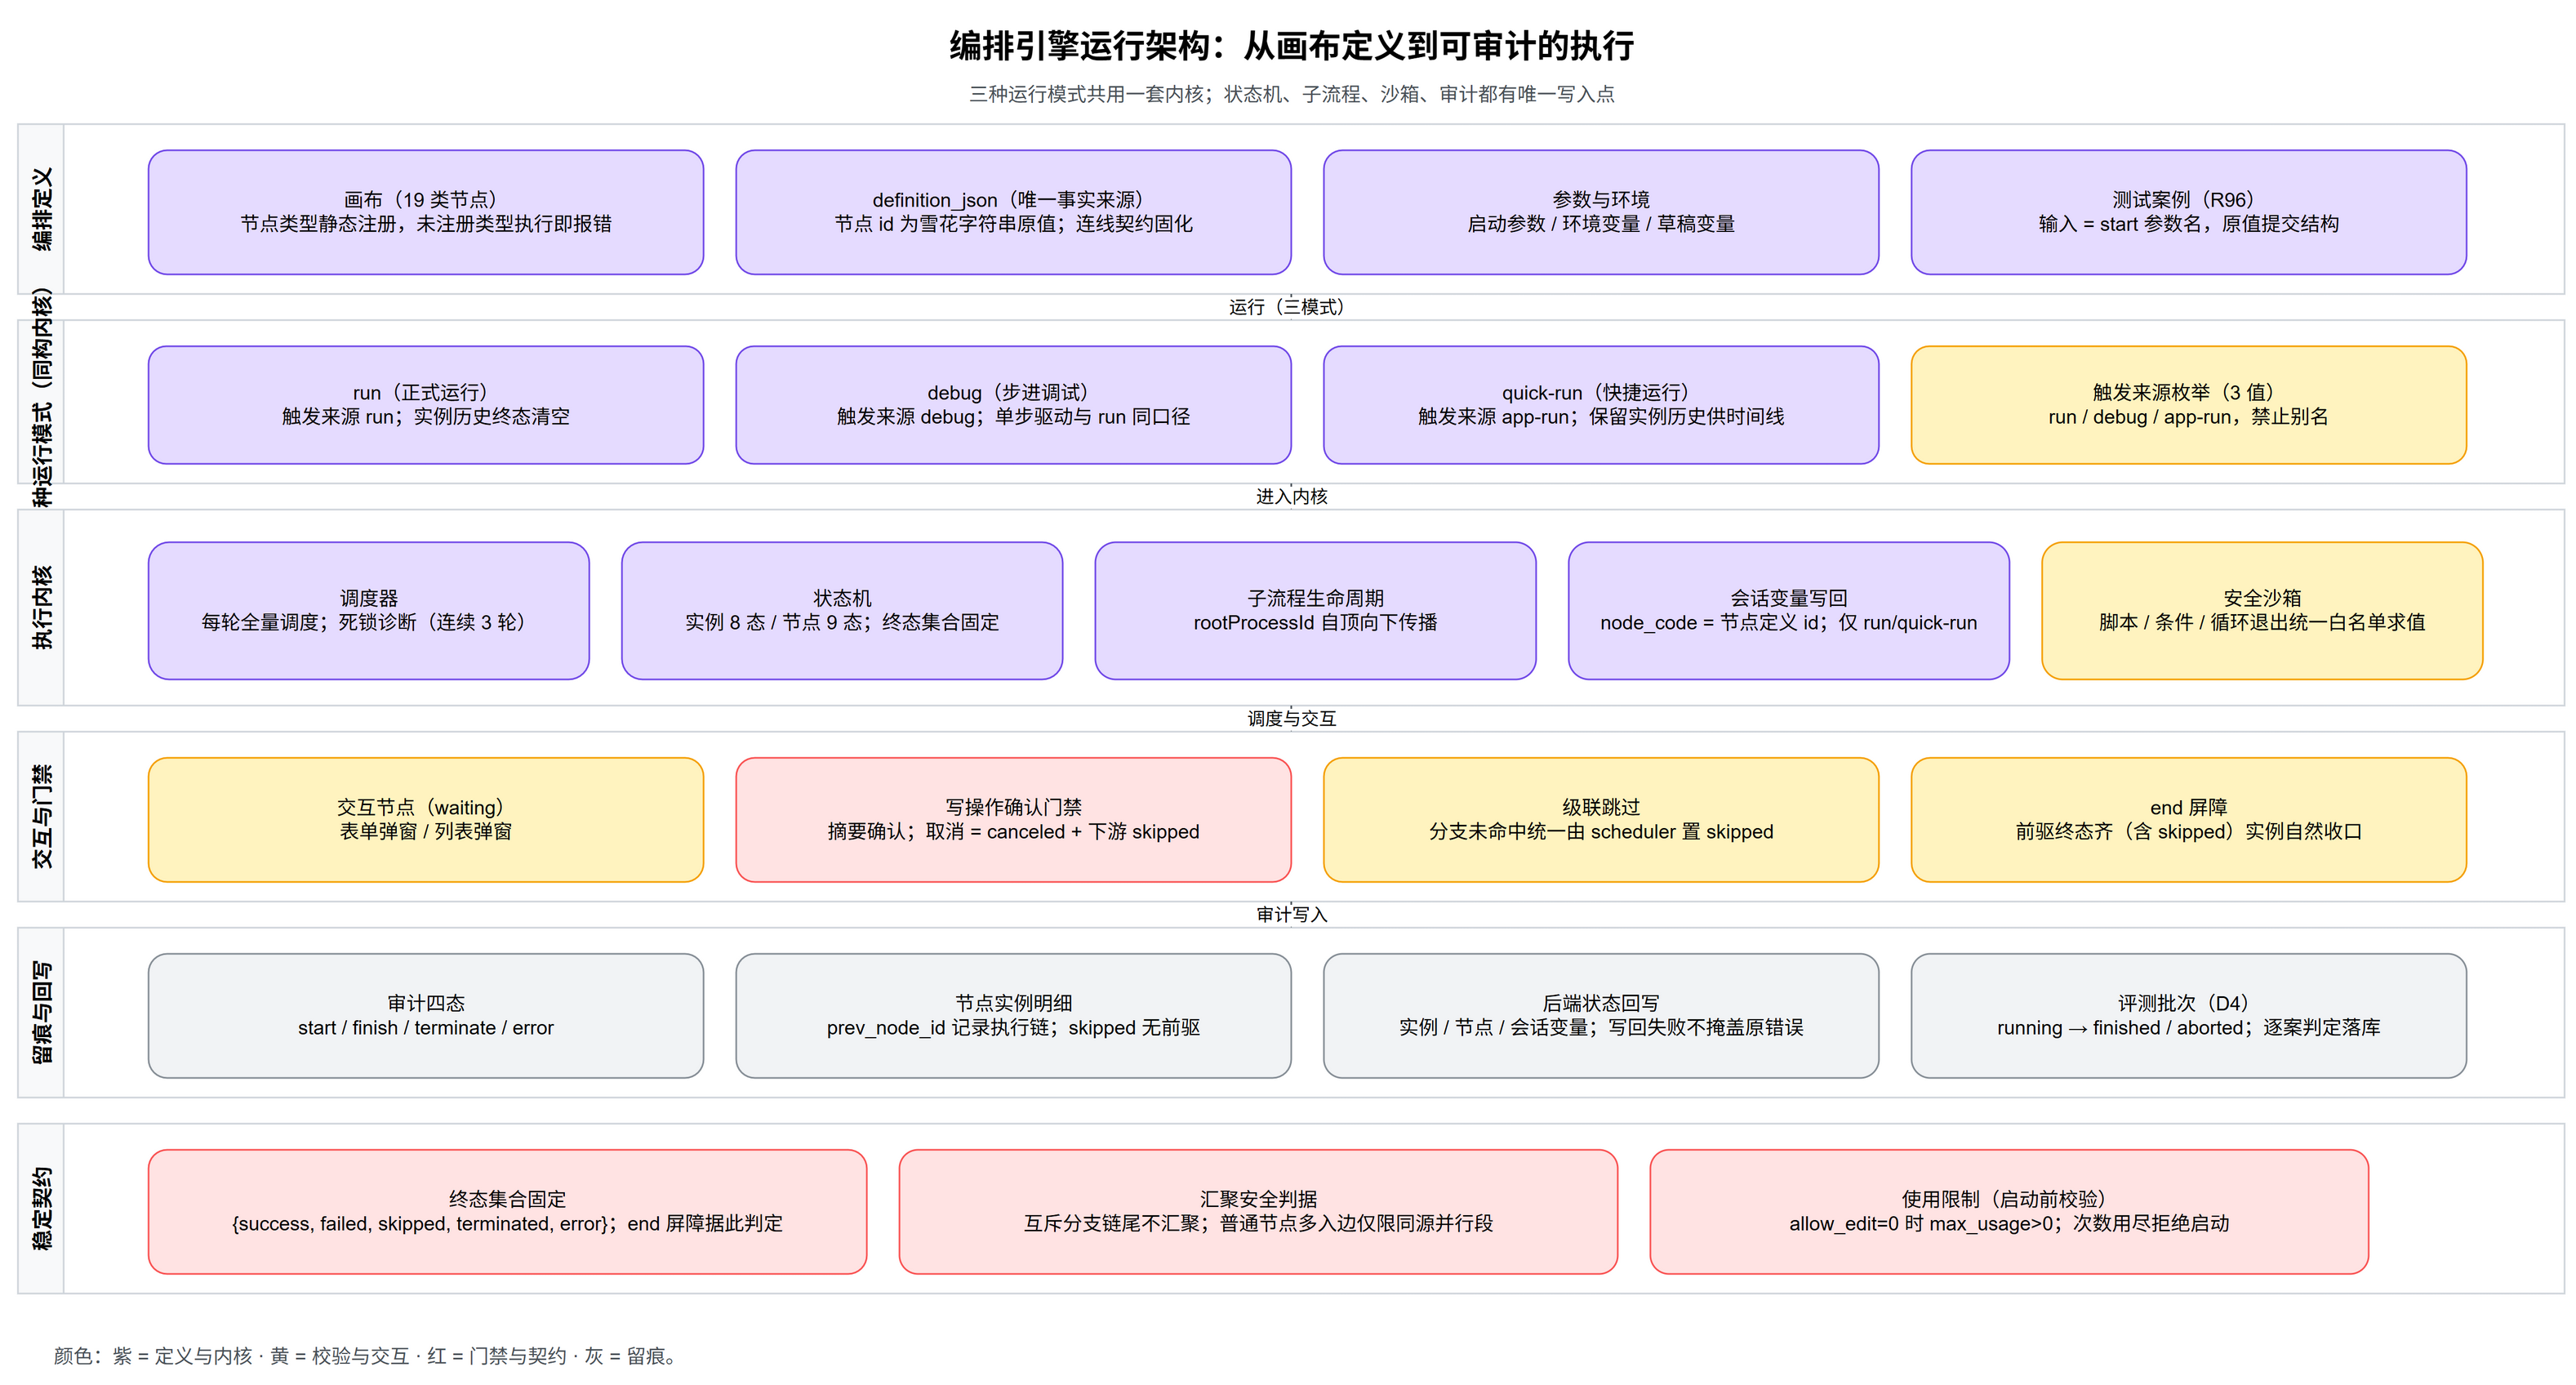
先看编排侧。节点类型一共 19 类,在前端引擎里静态注册,未注册的类型执行时直接报错:
-
start / end / reply / llm / http / private-http / script / condition / loop / var-merge
-
file-read / file-write / file-directory-read / file-download / pdf-write
-
mysql / oracle / form-dialog / list-dialog
流程定义存进 `definition_json`,它是节点的唯一事实来源:节点 id 是雪花字符串,原值入表,不允许转换与推断。
运行侧有三种模式,共用同一套内核:run(正式运行)、debug(步进调试)、quick-run(快捷运行)。触发来源固定三值:run、debug、app-run,禁止别名。三者的调度口径一致,差别只在实例历史的保留策略:run 终态清空历史,quick-run 保留给时间线看,debug 全在本地。
内核里有五件事值得单独记:
-
调度器每轮全量调度;连续 3 轮无可调度节点且没有活跃节点,判定死锁,实例置 error 并写审计------宁可停下来报错,不让页面转圈;
-
状态机一共两套:实例 8 个状态、节点 9 个状态;调度收口认一个固定的终态集合 `{success, failed, skipped, terminated, error}`;
-
子流程有自己的生命周期,`rootProcessId` 自顶向下传播,任何后端 Long 字段都不允许接到前端合成的 id;
-
会话变量写回只发生在 run 与 quick-run,键是"节点定义 id"------这是稳定契约,不是实例 id;
-
脚本、条件、循环退出条件统一走沙箱求值,白名单全局,`window`、`fetch`、`eval` 这类对象被阻断。
交互与门禁则负责"停下来等人":交互节点把实例置为 waiting;分支未命中的节点由调度器统一级联置 skipped;end 节点只做一件事------等前驱全部进入终态(含 skipped),实例自然收口。用户取消确认弹窗时,节点置 canceled、下游全部 skipped,不落任何数据。
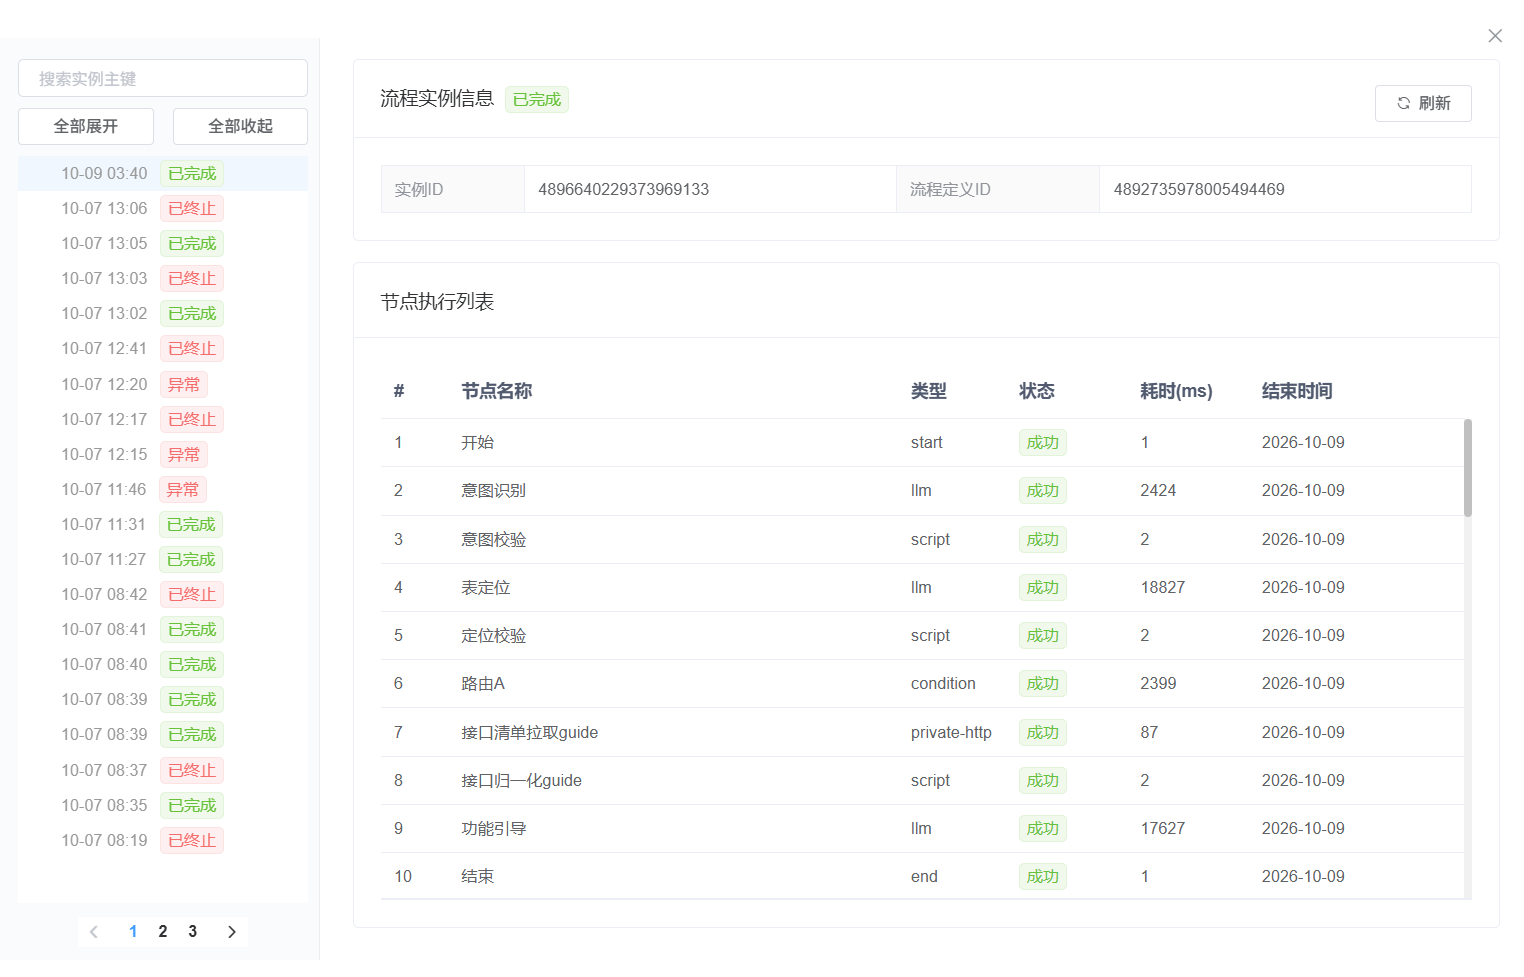
全过程写审计。start / finish / terminate / error 四态由唯一写入点落库。节点实例用 `prev_node_id` 记录执行链,执行失败时能从实例一路定位到具体节点。
!运行时间线:每个节点的状态、耗时与输出在这里可查
全局语义命令:49 个节点怎么排
!全局语义命令拓扑:五段推理、逐段强校验、四组路由、六条执行子链与 G0\~G4 基座
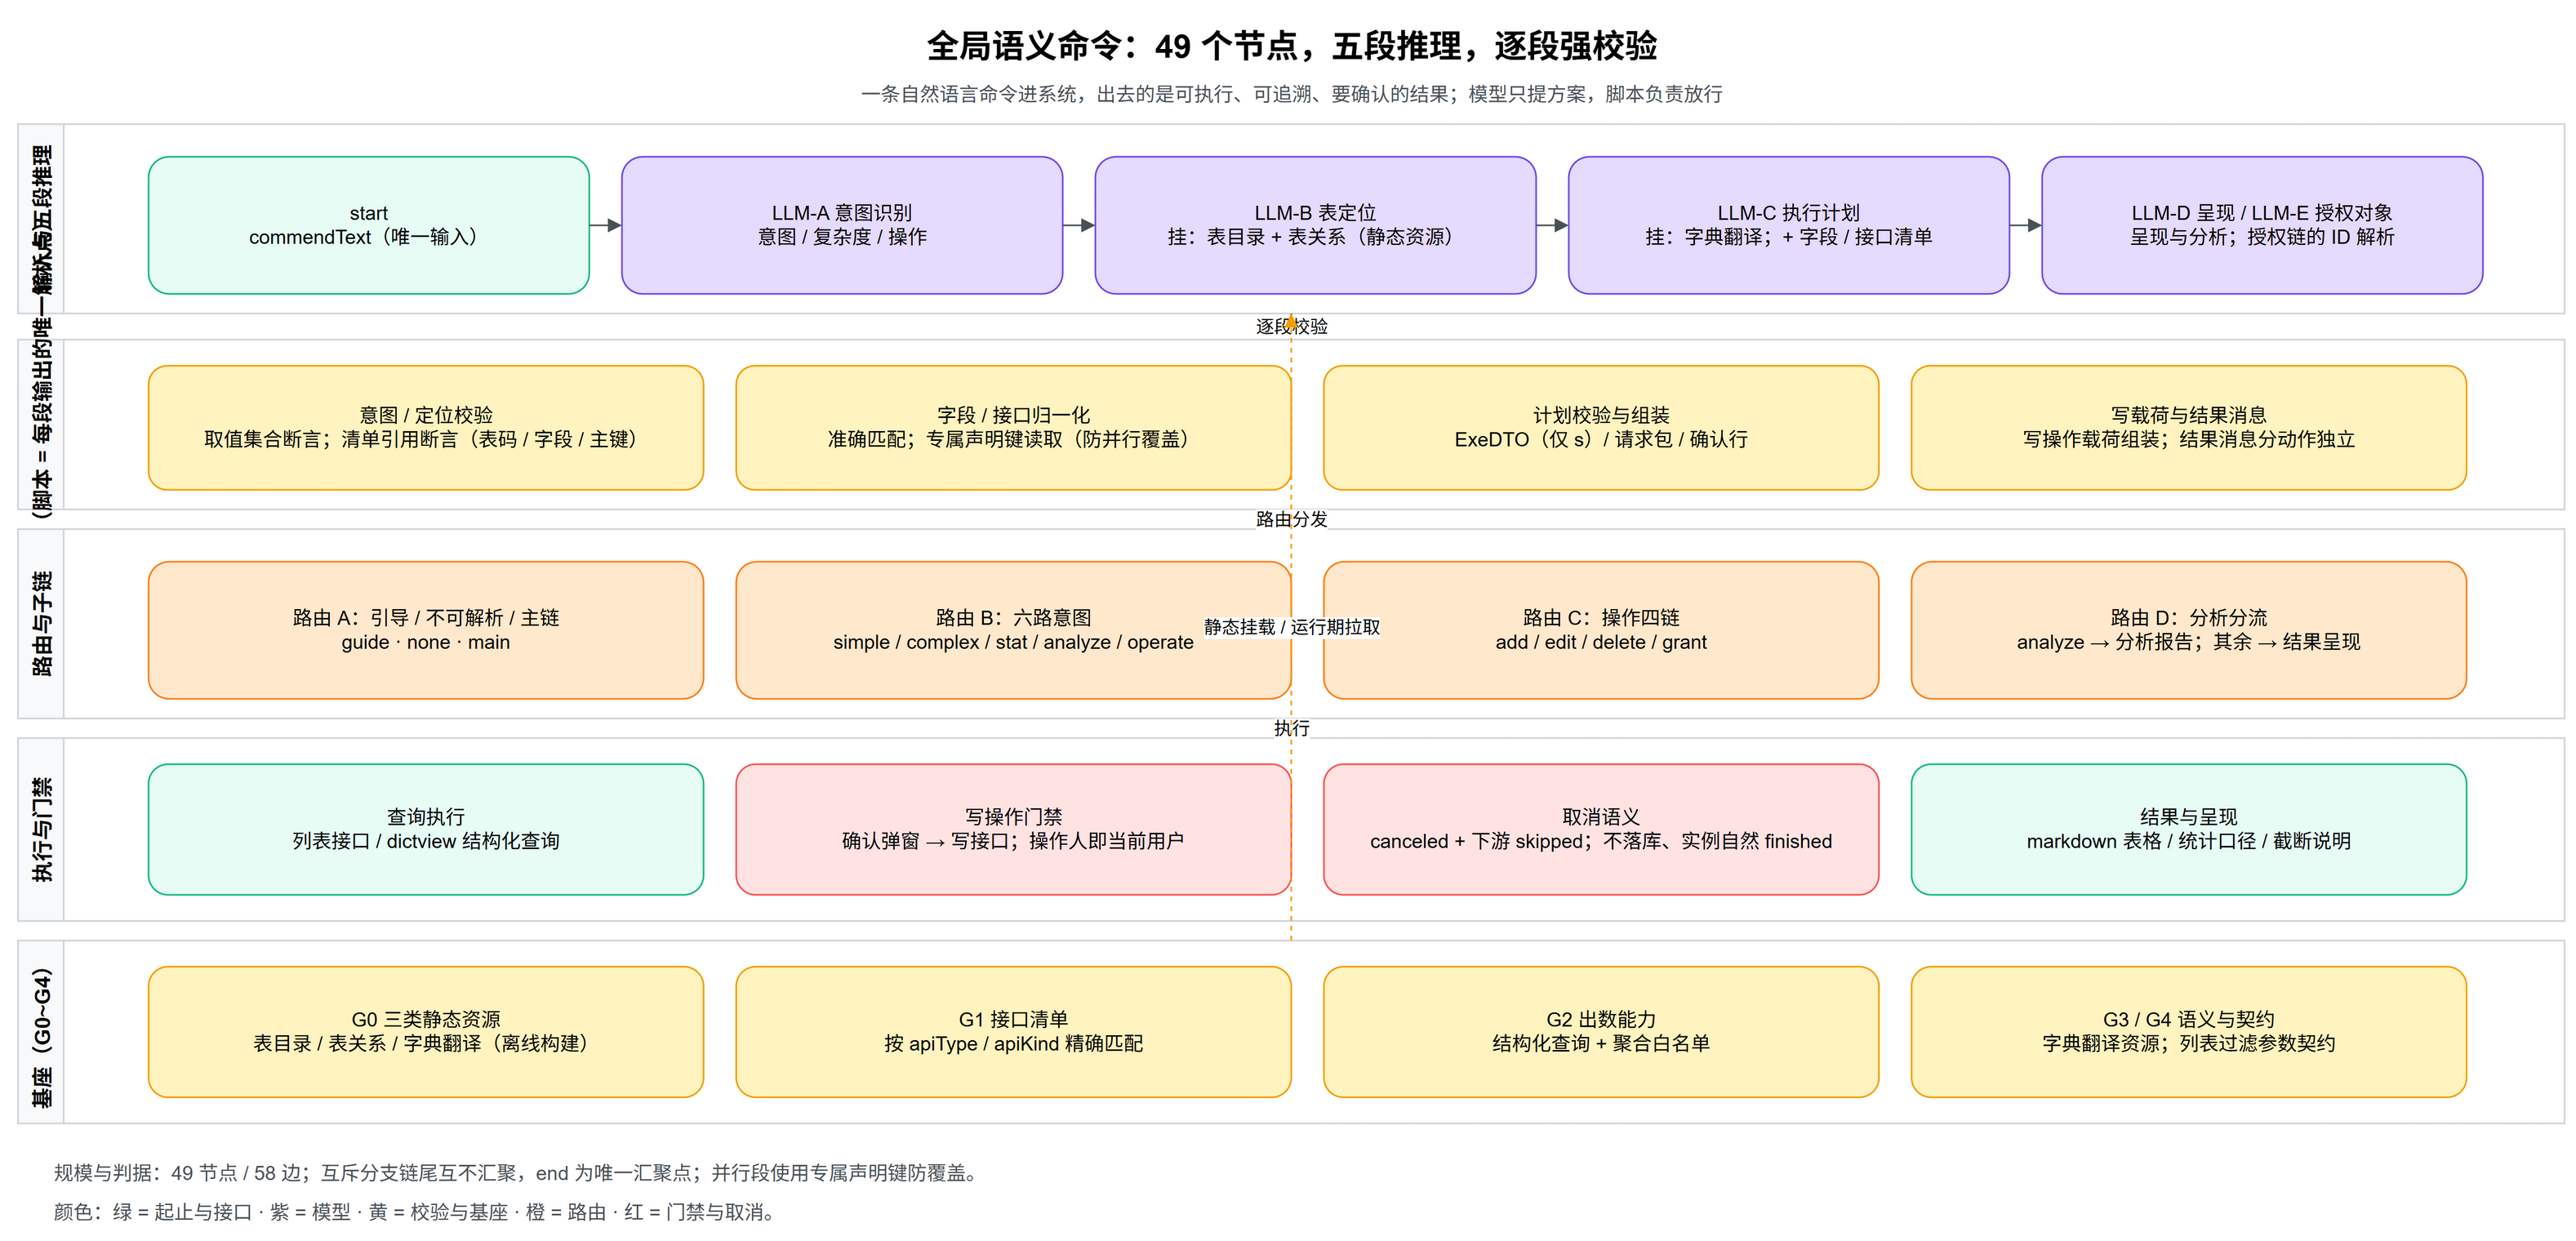
引擎之上,是整个系列的旗舰流程------全局语义命令。它把"一句自然语言"拆成五段推理,每一段后面都站着一个脚本:
-
LLM-A:意图识别,产出意图、复杂度与操作类型;
-
LLM-B:表定位,静态挂载表目录与表关系两份资源,产出目标表与主键、标题字段;
-
LLM-C:执行计划,静态挂载字典翻译,配合运行期拉取的字段清单与接口清单,产出结构化查询或请求包;
-
LLM-D:结果呈现,把结构化结果转成可读正文;
-
LLM-E:授权对象解析,只在授权链上出现,负责把"张三"翻译成系统能认的 ID。
每段脚本的职责都相同:解析、断言、写上下文。取值集合必须在枚举里、表码字段必须来自清单、聚合函数必须来自白名单。模型可以提方案,放行由脚本决定。
之后是四组路由:路由 A 分流引导与主链;路由 B 把命令分到简单查询、复杂查询、统计、分析与操作;路由 C 在操作内分流新增、修改、删除、授权;路由 D 决定结果直接呈现还是转分析报告。
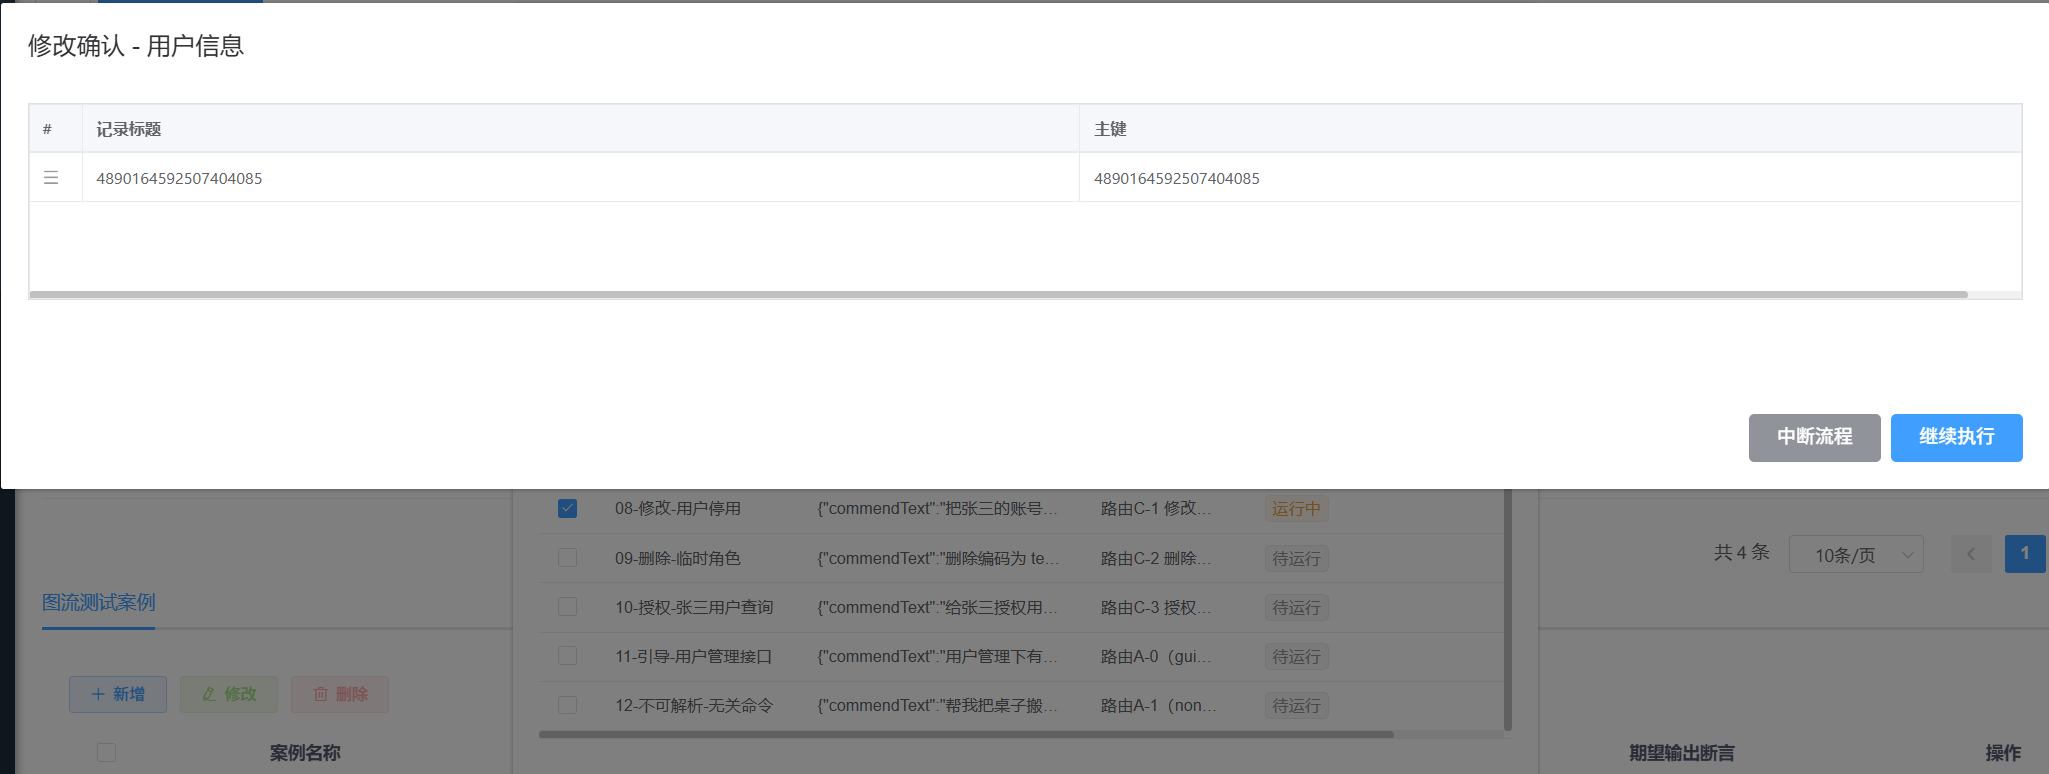
写操作还有一个绕不开的门禁:确认弹窗。把要执行的内容以摘要形式摆给用户,点确认才执行;点取消就走"节点已取消、下游跳过、实例自然收口"的路径。
!写操作确认:将执行的载荷摘要摆在用户面前,确认之后才调用写接口
两条拓扑判据:并发与汇聚
这套流程不用改造引擎实现并发,靠的是拓扑设计:无依赖的链并行跑,调度器天然每轮全量调度。但并发带来两个必须写死的判据。
第一,并行段必须使用专属声明键。引擎对某些固定键(比如 `data`)有恒存在的语义,如果两个并行节点都往里写,后完成的会覆盖先完成的,另一条链就会读到错的数据。解决办法是让并行节点各自声明专属输出键,下游脚本按专属键读取,禁止读固定键。
第二,互斥分支的链尾不许汇聚。普通节点的前驱必须"同生同死",而互斥分支天然不同生:一条执行、另一条被跳过。一旦汇聚,被跳过的那条永远等不到,实例就永远不 finished。这套流程因此让每个分支链各自收尾,唯一允许汇聚的点是 end------它是引擎里唯一认"非 success 前驱"的节点。
这两条判据来自真实事故,下面细说。
源码走读
-
引擎:`veap-ui/src/components/AiAgentEngine`------调度、状态机、子流程、会话变量写回、沙箱与审计写入点;画布侧在 `veap-ui/src/views/ai/agentDesign`;
-
后端:`veap-cloud/veap-modules/veap-ai` 的 agent 相关接口与数据表(流程、实例、节点实例、会话变量、审计日志等);
-
服务端专属能力:文件读写与数据库执行走内网接口(`/ai/aiAgentFileExec/*`、`/ai/aiAgentDbExec/execute`),连接能力由统一的 JDBC 执行服务提供,不允许各自直连;
-
命令流程本体:以 `definition_json` 形式保存,五段提示词与全部脚本按文档化的契约配置。
较真:两个"图上的坑"
第一个坑:并行段互相覆盖。字段清单与接口清单是两条并行链,两个节点都往引擎的固定键里写结果。上线后出现的现象很隐蔽------字段归一化脚本偶尔读到的是接口清单的数据,字段全空。排查确认是覆盖竞态:后完成的节点覆盖了先完成的。修复方式是把两个节点的输出声明改成专属键,下游各读各的。
第二个坑更严重:汇聚死锁。最初的拓扑里,互斥分支的链尾汇聚到了普通节点上。表面没问题,实际运行到一半就挂住:被跳过分支的链尾永远进不了 success,汇聚节点的前驱条件永远不满足,实例永远不 finished。4 处这样的死锁被逐一拆掉:分支链尾各自独立,汇聚只留 end。
这两次修复之后,拓扑判据被写成验收清单:普通节点多入边只允许出现在"同源并行段",互斥分支尾一律独立收尾。后续每次改图,先过这张清单。
复现与验证
-
看流程:在画布(`/agentDesign`)加载"全局语义命令体系",节点计数应为 49、连线 58;
-
跑一次:用快捷运行输入"统计下系统中有多少张数据表",观察时间线里的 stage 标记与结果呈现;
-
查实例:`SELECT run_status FROM ai_agent_process_instance ORDER BY id DESC LIMIT 5;`
-
查节点链:`SELECT node_id, exec_status FROM ai_agent_node_instance WHERE process_instance_id = <实例id> LIMIT 20;`
-
试门禁:跑一条写操作命令,在确认弹窗点取消,核对节点状态是 canceled、下游是 skipped。
这一层的边界:引擎负责"把图跑对",命令流程负责"把话听懂、把关放行"。两者都不负责判断命令本身"该不该做"------那由权限体系裁决;引擎的立场是:做不了的事,报错;不能做的事,拦住。
数据与操作都跑通了,还剩最后一个问题:这一切怎么被观察、被度量、被管住。收尾之前,先看治理层。