这是「近五年 AI 技术演进」系列深挖的第 1 篇。上一部《从 ChatGPT 到 Agent Harness:近五年 AI 技术演进全景》用 1.2 万字串起了 13 个概念,从这一篇开始,我们把每个概念单独拎出来拆到底。第一站是最不起眼、却是一切起点的东西:Prompt(提示词)------用自然语言"编程"模型的接口。后来的 RAG、Function Calling、Agent、MCP,全部建立在"能用自然语言给模型下指令"这块地基上。全文约 5500 字,读完你会知道:为什么同一段模型,有人用出专家水平,有人用出模板水平。
一、Prompt 到底是什么
一句话:Prompt 就是你发给模型的输入文本,模型的一切输出都由它决定。
要掂量这句话的分量,得先知道模型在干什么。大语言模型(LLM)本质上是一台"续写机器":它接收一段文本,预测"接下来最可能出现什么",然后一个词一个词地把回答续写出来。你喂进去的那段文本,就是 Prompt(提示词)。
一个类比:想象你招了一位天才实习生。他读过人类历史上几乎所有的公开书籍,上知天文下知地理,什么文体都会写、什么语言都能翻。但他有三个致命特点------完全失忆 (每次对话都是初次见面,昨天聊的今天全忘)、不认识你的公司 (没读过你的内部文档和代码)、不会读心术(你脑子里的需求他一无所知)。
你交给这位实习生的那份"任务说明书",就是 Prompt。
说明书写得含糊,他只能动用通用知识瞎猜,写出来的东西放到任何公司、任何岗位都"差不多";说明书写得清楚------要什么、给什么、别干什么、写给谁------他就能发挥出接近领域专家的水平。同一个模型,能力上限出厂时就定死了,而你实际拿到手的输出质量,下限和上限之间隔着的,就是这个 Prompt。
二、为什么说它是"编程"
2022 年底 ChatGPT 上线后,开发者们逐渐意识到一件以前不可想象的事:LLM 是一个可以用自然语言编程的通用接口。
"编程"在这里不是修辞。写代码,是用语法精确的语言告诉计算机"做什么";写 Prompt,是用自然语言告诉模型"做什么"。两者的工作流几乎一模一样:
| 传统编程 | Prompt 编程 | |
|---|---|---|
| 你写什么 | 代码,指定逻辑 | Prompt,指定意图 |
| 怎么执行 | 编译器 / 解释器逐条执行 | 模型推理,逐词生成 |
| 输出确定性 | 同样输入必得同样输出 | 带随机性(温度参数控制) |
| 出了问题怎么办 | 调试器断点排查 | 改 Prompt 重试 |
区别在容错方向上:传统语言精确到写错一个分号都跑不起来;自然语言宽容得多------但这份"宽容"是双刃剑,你说得越模糊,模型的自由发挥空间越大。
再打个比方:模型就是那位什么菜都会做的厨师,Prompt 就是你的点单。你说"来点好吃的",厨师只能按自己的理解端一道招牌菜;你说"水煮鱼,微辣,少盐,不放香菜,两人份",这道菜十有八九符合预期。同一口锅,点单方式不同,上桌的东西天差地别。
这就是 Prompt Engineering(提示词工程)在 2023 年火成一整个工种的原因:既然输出质量由输入决定,"怎么写输入"就从聊天技巧变成了一门工程学问------有结构、有方法论、可测试、可迭代。
三、Prompt 的五要素
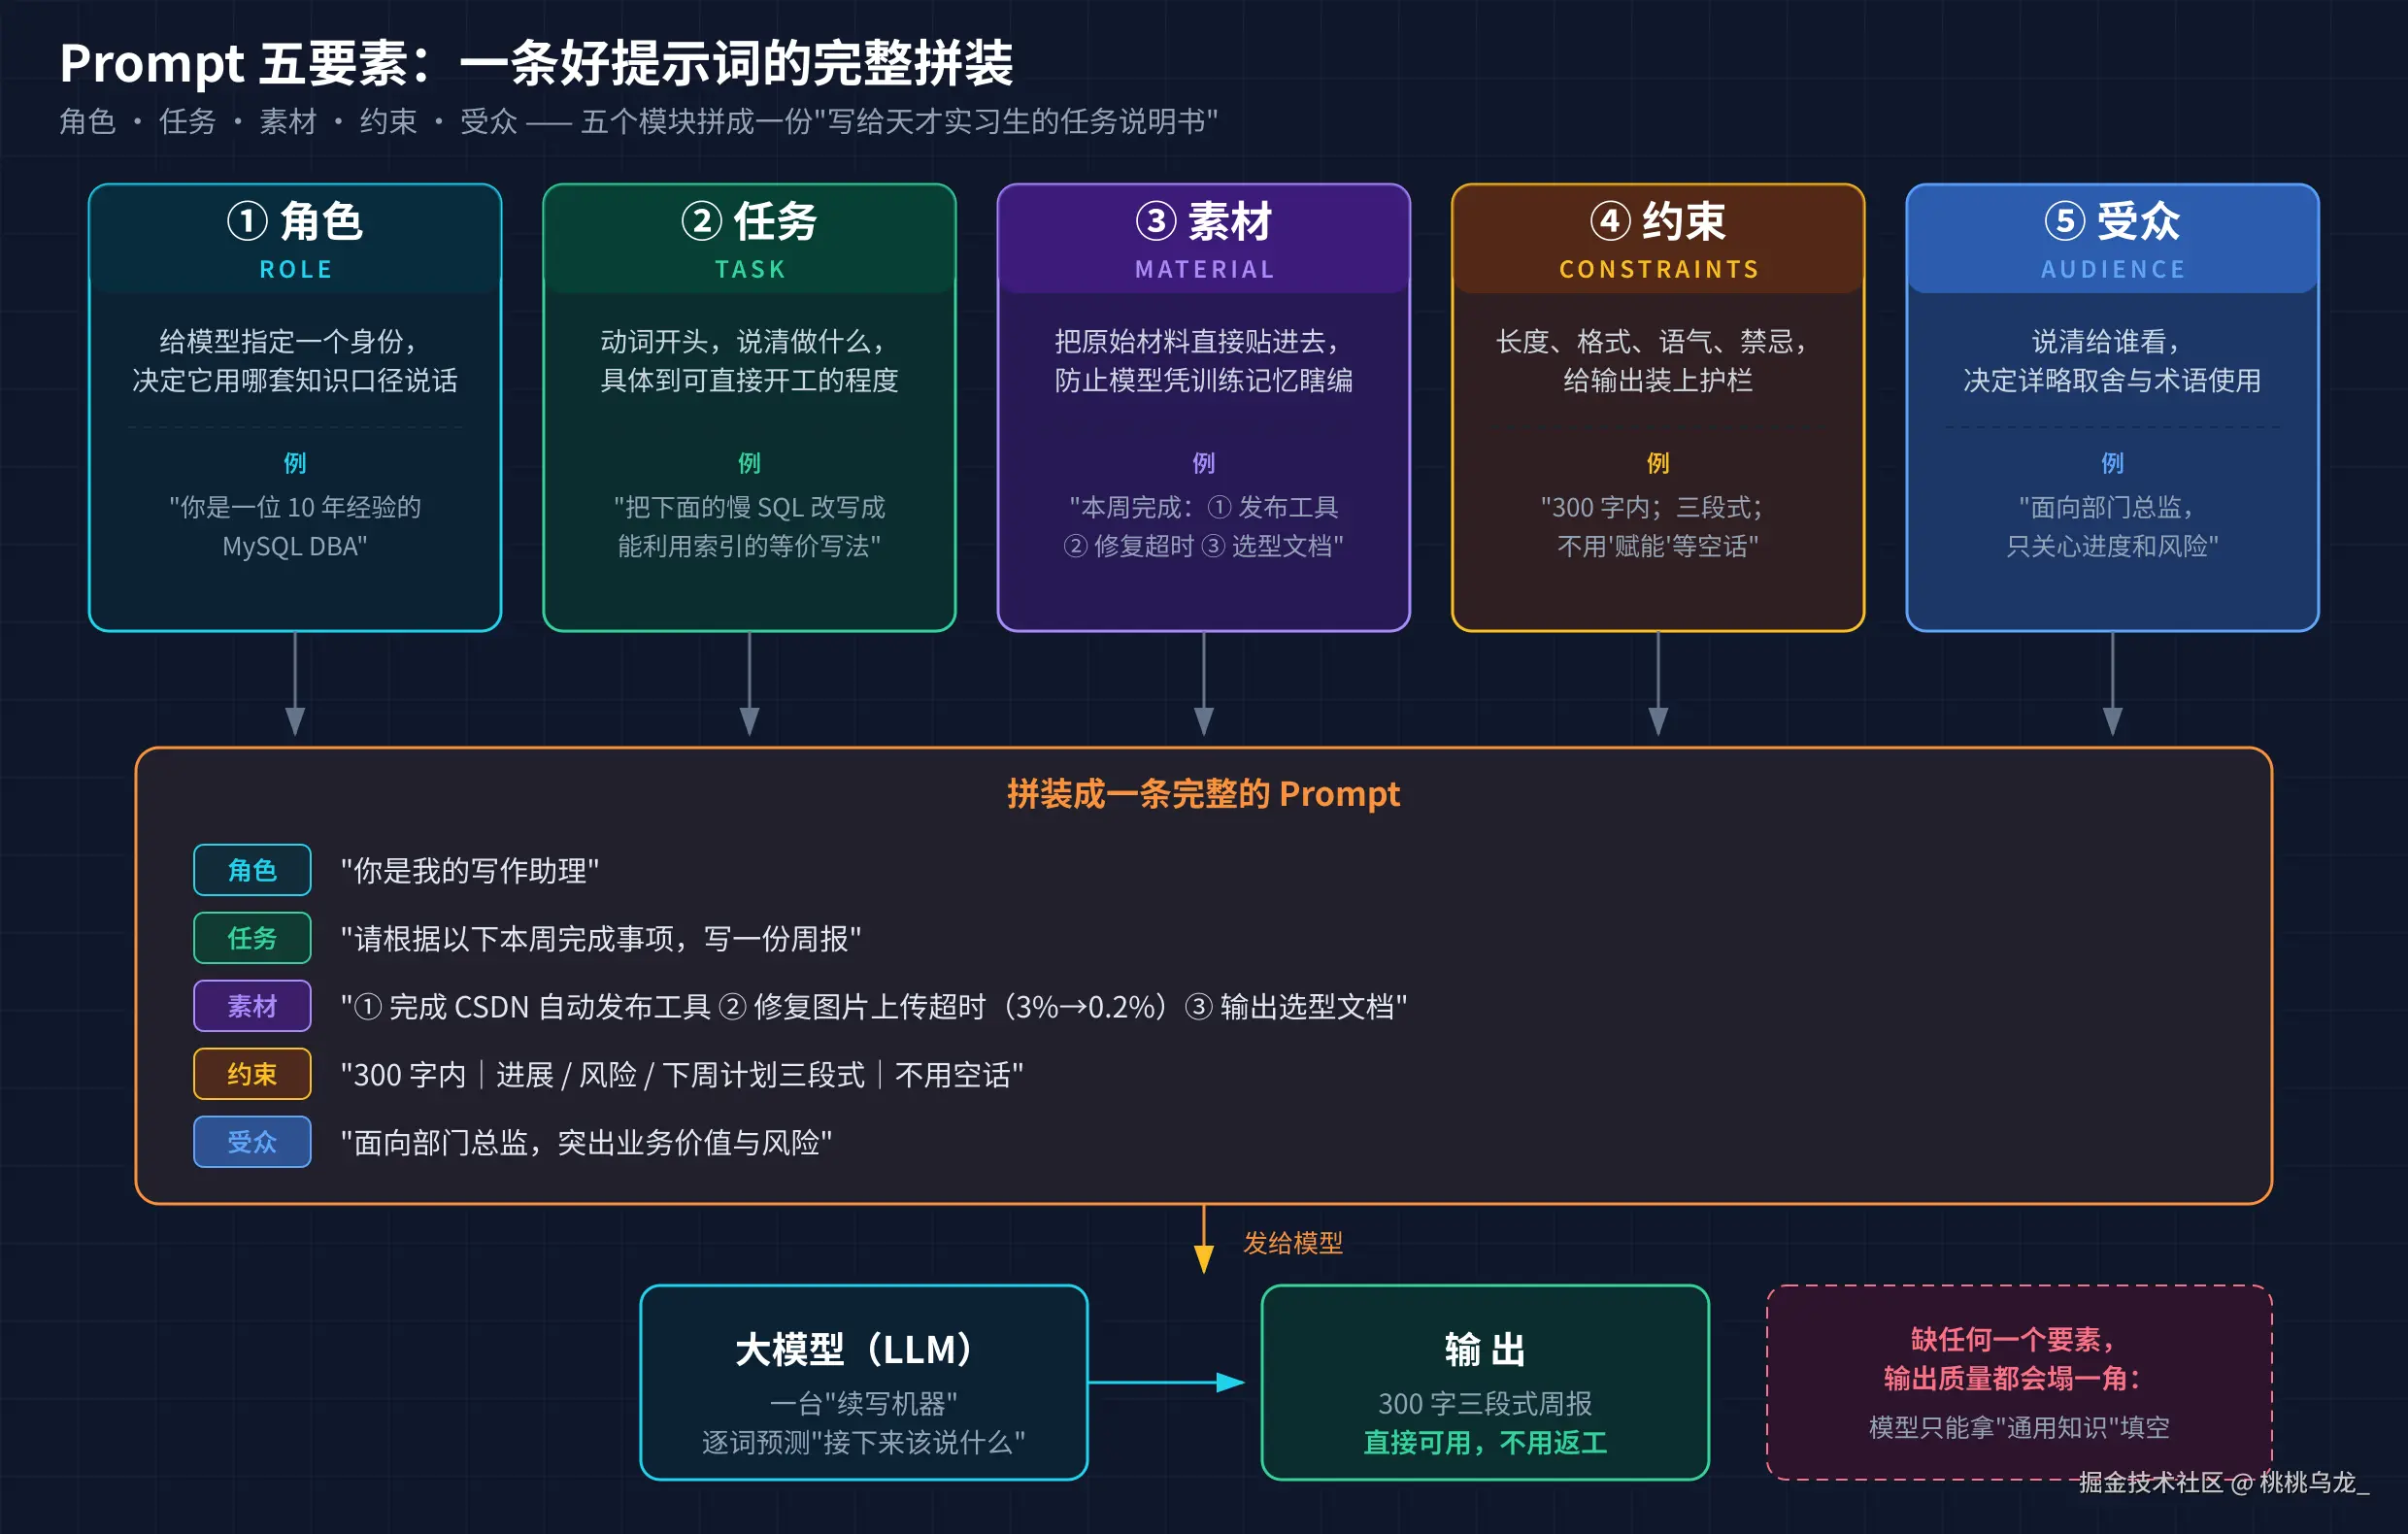
把无数经过验证的好 Prompt 拆开看,绝大多数由五个零件组装而成。角色(你是谁)、任务(做什么)、素材(给你什么)、约束(不能做什么)、受众(给谁看)。
1. 角色(你是谁)
给模型指定一个身份。模型在不同"人设"下,激活的知识区域和语言风格完全不同------一个被设定为"MySQL DBA"的模型,回答慢查询时会直接进入专业口径,而不是泛泛科普。
text
你是一位有 10 年经验的 MySQL DBA,擅长慢查询定位与索引优化。2. 任务(做什么)
用动词开头,把动作说具体。任务是唯一不可省略的要素,且要具体到模型"可以直接开工"的程度。
text
请把下面的慢查询 SQL 改写为能利用索引的等价写法,并逐条解释改动原因。对比一下"帮我看看这个 SQL"------看什么?改成什么样?模型只能猜。
3. 素材(给你什么)
把模型要用到的原始材料直接贴进去。素材是防止模型瞎编的第一道防线:有材料可依据时,它会优先用材料,而不是调动训练记忆里那些可能过时、可能不属于你们的东西。
text
本周完成事项:
1. 完成 CSDN 自动发布工具,支持草稿 / 发布 / 删除
2. 修复图片上传偶发超时的问题,超时率从 3% 降到 0.2%
3. 调研了三个向量库的选型,输出对比文档
4. 约束(不能做什么)
给输出装上护栏:长度、格式、语气、禁忌。约束写得越硬,输出的可控性越强。
text
控制在 300 字内;用"进展 / 风险 / 下周计划"三段式;
不要使用"赋能""抓手"这类空话;直接给结论,不要铺垫。
5. 受众(给谁看)
同一份内容,写给领导、写给同事、写给客户,是完全不同的三样东西。说了受众,模型才知道详略怎么取舍、术语能不能用。
text
读者是部门总监:只关心进度、风险和需要的支持,不关心技术细节。组装模板
五个要素拼起来,就是一份可以直接复用的结构化模板(Python f-string,可直接运行):
python
PROMPT_TEMPLATE = """你是一位{{role}}。
任务:{{task}}
素材如下:
{{material}}
约束:{{constraints}}
受众:{{audience}}
现在开始。"""

prompt = PROMPT_TEMPLATE.format(
    role="有 10 年经验的技术写作助理",
    task="根据素材写一份本周工作周报",
    material="1. 完成 CSDN 自动发布工具\n2. 修复图片上传超时(3%→0.2%)\n3. 输出向量库选型对比文档",
    constraints="300 字内;进展/风险/下周计划三段式;不用空话",
    audience="部门总监,只关心进度、风险和需要的支持",
)
print(prompt)
四、逐字对比:同一个任务,两种写法
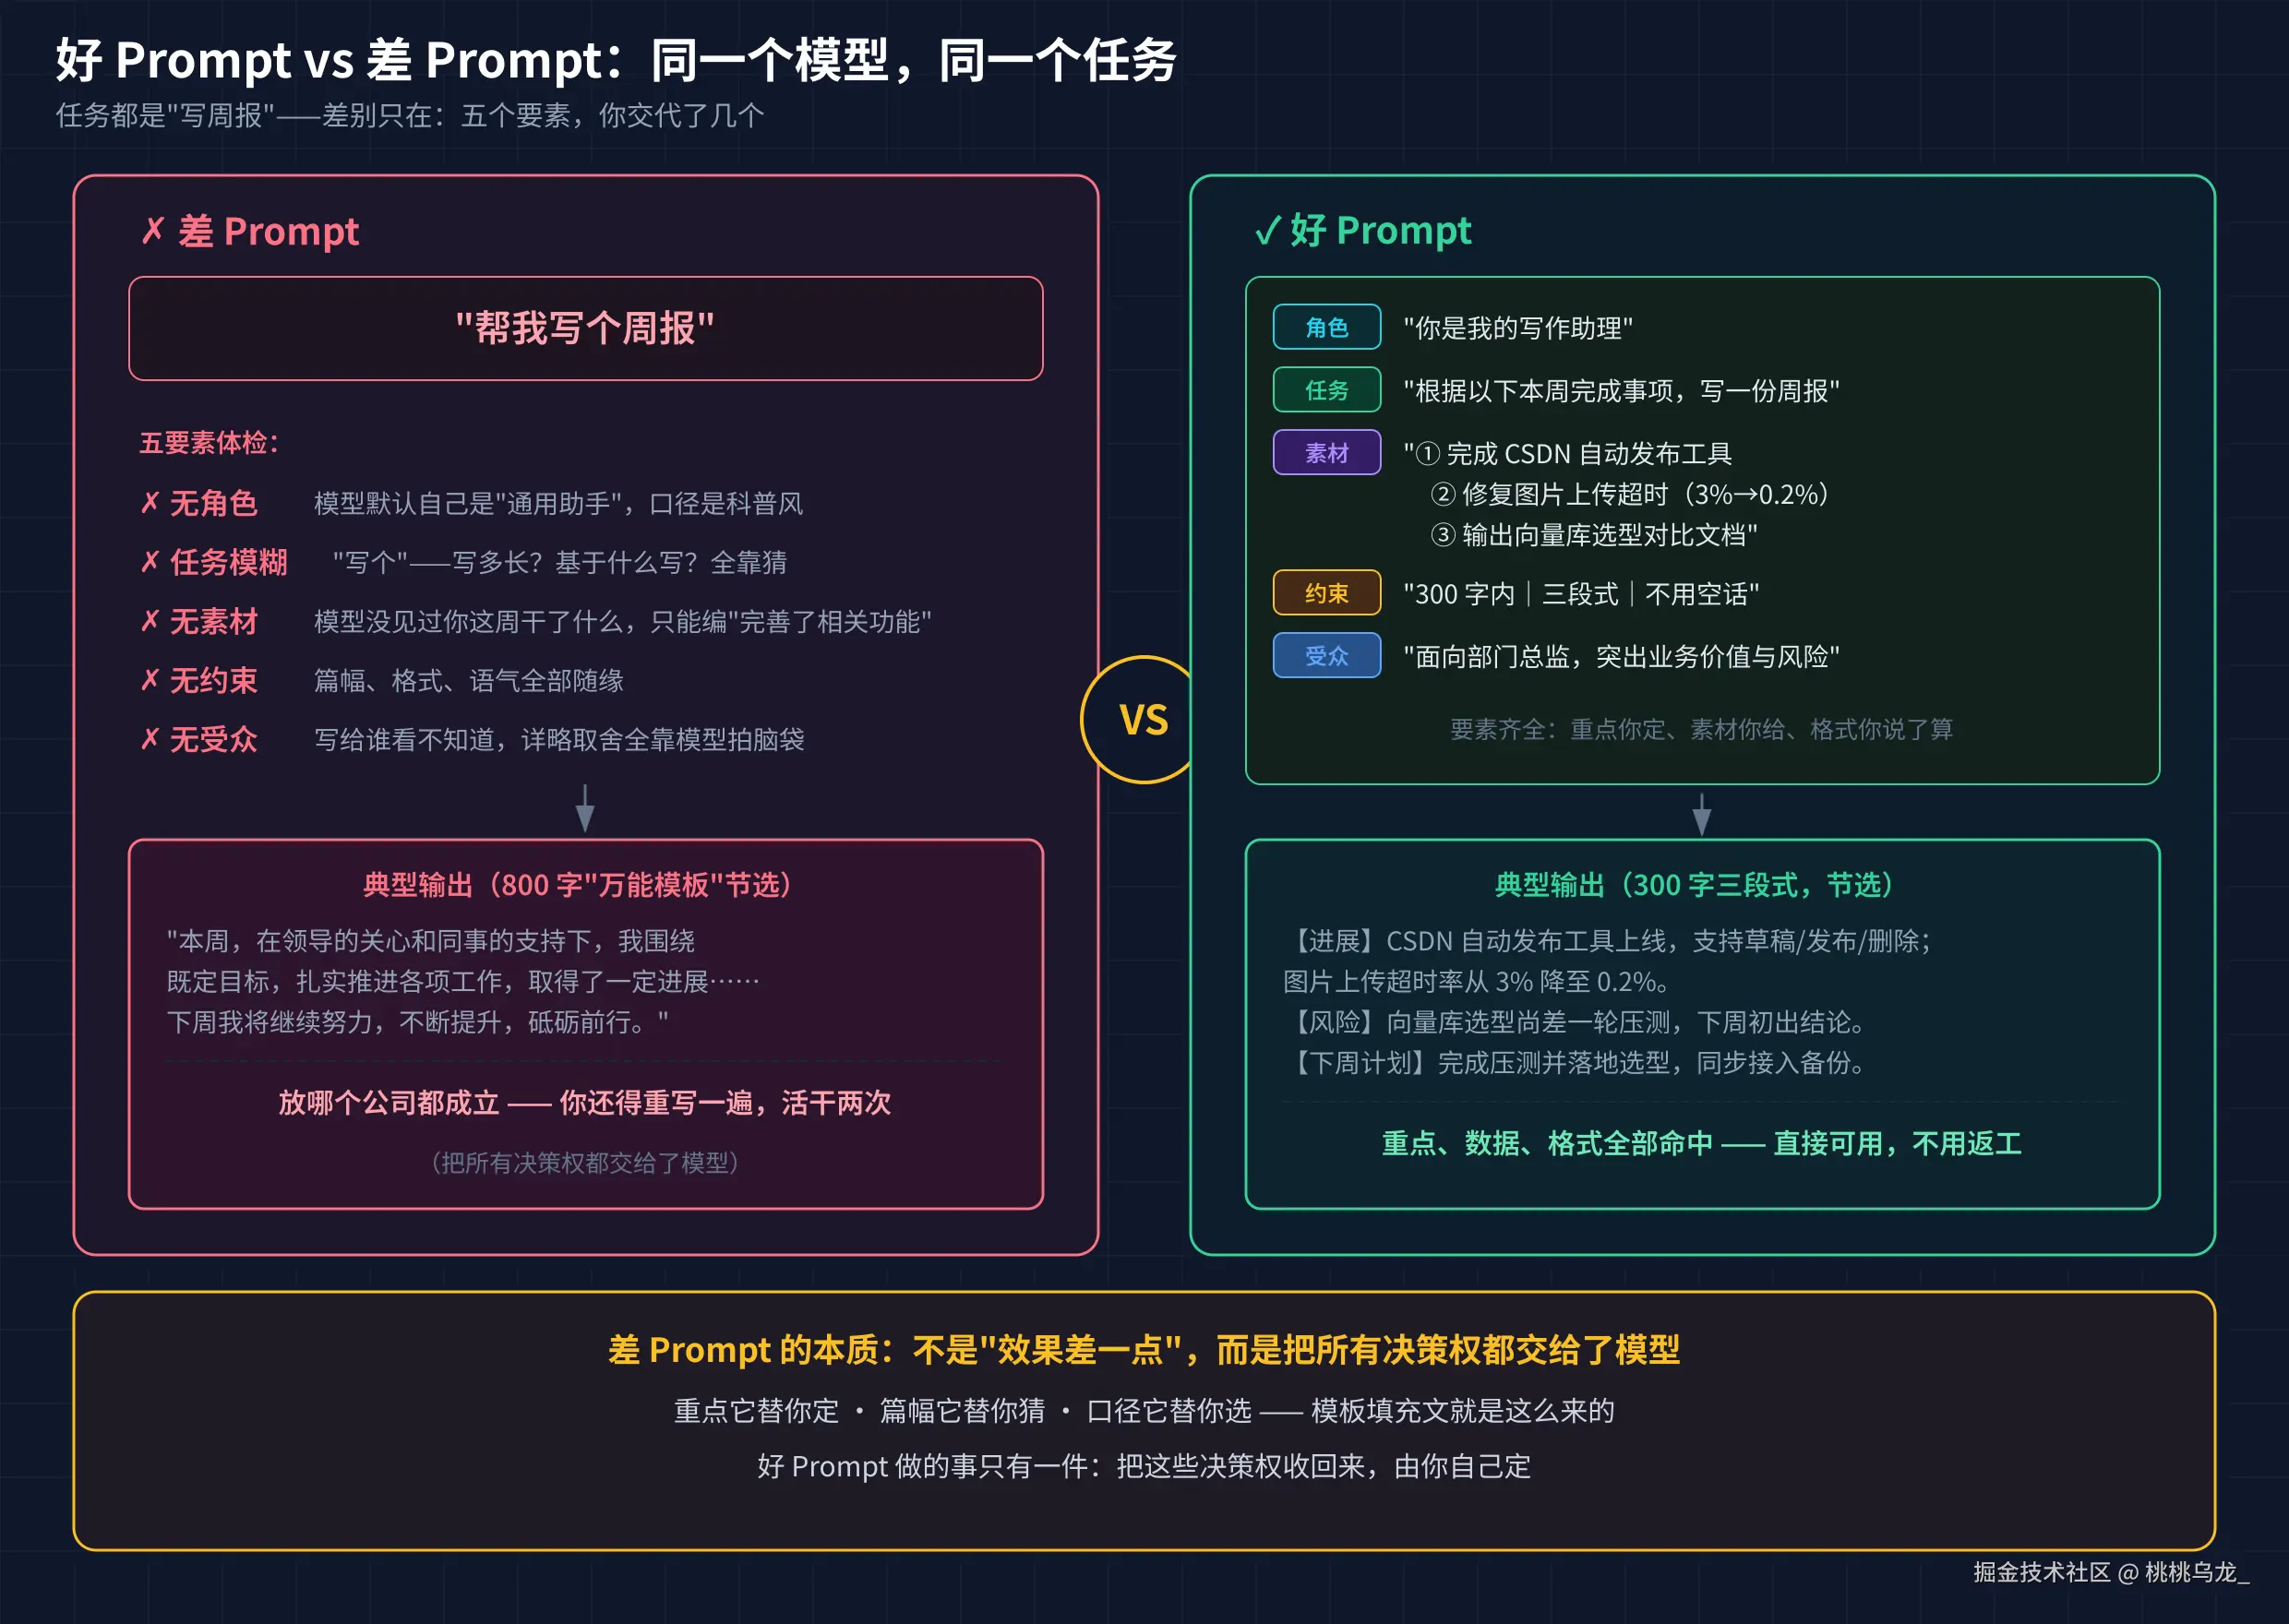
用最真实的场景------写周报------把好与差摆在一起看。
差 Prompt:
text
帮我写个周报好 Prompt:
text
你是我的写作助理。请根据以下本周完成事项,写一份周报:
1. 完成 CSDN 自动发布工具,支持草稿 / 发布 / 删除
2. 修复图片上传偶发超时的问题,超时率从 3% 降到 0.2%
3. 调研三个向量库选型,输出对比文档
要求:面向部门总监,突出业务价值和风险,控制在 300 字内,
用"进展 / 风险 / 下周计划"三段式,不用空话。
逐要素对照:
| 要素 | 差 Prompt | 好 Prompt | 差在哪 |
|---|---|---|---|
| 角色 | 无,模型默认自己是通用助手 | 我的写作助理 | 没有角色,回答口径默认"科普风" |
| 任务 | "写个周报",动词模糊、对象缺失 | "根据以下事项写一份周报" | 动词 + 对象 + 依据全部明确 |
| 素材 | 无,全靠模型编 | 三条具体事项(带数据) | 没素材,模型只能写"完善了相关功能"这类空话 |
| 约束 | 无,篇幅格式随缘 | 300 字内、三段式、禁空话 | 没约束,可能写 800 字散文体 |
| 受众 | 无 | 部门总监,关心价值和风险 | 没受众,详略取舍全靠猜 |
差 Prompt 的本质问题不是"效果差一点",而是把所有决策权都交给了模型:重点它替你定、篇幅它替你猜、口径它替你选。最后你拿到一篇放在任何公司都成立的"模板填充文",还得自己重写一遍------等于活干了两次。好 Prompt 做的事,是把这些决策权收回来,由你自己定。
五、Few-shot:给几个例子,胜过千言万语
是什么:Few-shot(少样本示例)就是在 Prompt 里附上两三个"输入 → 输出"的完整示例,然后让模型照着处理新任务。与之相对,不给示例叫 Zero-shot(零样本),拿成百上千个示例去训练模型则叫 Fine-tuning(微调)。
解决什么问题 :有些需求用语言描述不清。格式、风格、口吻这类"只可意会"的东西,你说一百句"要正式一点但别太僵硬",不如直接给一个例子。示例能同时锁死格式和风格------这是语言描述做不到的。
为什么有效:模型的看家本领就是续写。Prompt 里摆着示例,模型会强烈倾向于延续示例的模式------它不是"理解了你的要求",而是"顺着你的模式续写"。对使用者来说,效果一样。
一个直观对比 。同样做评论情感分类,Zero-shot 的写法是"判断下面评论是好评还是差评"------模型大概率答对,但经常顺手加一句"该评论表达了......的情感",你还得再清洗一次;Few-shot 版本里,三个示例的"判断"字段都只有两个字,模型续写出来的也就只有两个字。示例本身就是最高优先级的说明书。
顺带划一条边界:Few-shot 用的示例是"贴在 Prompt 里"的,每次调用都要重发一遍,模型本身没有学到任何新东西(这叫上下文学习,In-context Learning);想让能力沉淀进模型、不用每次重发,那就要动 Fine-tuning(微调)------成本高一个数量级,非到万不得已不做。
怎么用:
python
prompt = """判断用户评论的情感倾向,只输出"好评"或"差评"。

评论:物流很快,包装完好,东西比想象中还好用。
判断:好评

评论:客服三天才回消息,回了也等于没回。
判断:差评

评论:东西还行吧,就是快递送错了一次,第二天补送了。
判断:"""
模型会续写出"差评"或"好评"------注意最后一条故意模糊,示例教会了模型"只输出标签、不加解释",这条隐含规则你一个字都没写。
什么时候用 :输出格式特殊(固定句式、表格、标签体系)、风格难以言传(文案调性)、分类打标任务。什么时候不用:任务一句话能说清(别为 few-shot 而 few-shot)、示例本身很长(白白挤占上下文窗口)。
六、Chain-of-Thought:让模型"先想再答"
是什么:Chain-of-Thought(CoT,思维链)指在 Prompt 里要求模型"先一步步写出推理过程,最后再给答案",或者在示例里直接展示带推理过程的解答。触发方式可以简单到加一句话:
text
请一步步思考,先给出推理过程,最后单独给出答案。解决什么问题 :模型直接输出答案时是"凭直觉"------所有 token 一次性顺流而下,前面错了后面跟着错。复杂推理(多步算术、逻辑判断、方案规划)的错误率会陡增。让它把中间步骤写出来,相当于强制它打草稿:每一步的生成都以上一步的结论为前提,错误能在中途被自己的推理纠正。
生活化类比:做数学题时直接报答案和列竖式打草稿的区别。同一个学生,报答案靠心算容易错,草稿列出来一步一步算,准确率立刻上去。模型也一样。看一个典型题目:
text
问题:小明有 23 个苹果,给了小红 8 个,又去果园摘了 2 筐、每筐 15 个。
现在小明有多少个苹果?请一步步思考后再给答案。

(模型输出推理过程:23 - 8 = 15;15 × 2 = 30;15 + 30 = 45。
答案:45 个)
不加"一步步思考"时,模型经常直接蹦一个数------错多对少;展开推理后,每一步都摆在那里,既不容易错,你还能一眼看出它错在哪一步(出错时也好定位,这一点在调试 Prompt 时极其有用)。
什么任务必须用 :多步计算、逻辑推理、需要权衡取舍的规划类问题。什么任务不用:分类、翻译、摘要这类"直觉型"任务------加 CoT 只会多烧 token,不涨准确率。
它的历史地位:2022 年 Google 的论文首次证明这个现象,"先想再答"从此成为复杂任务的标准配置;到 2024 年 o1、2025 年 DeepSeek R1 等推理模型出现,思维链被直接内化成了训练目标------模型在训练中学会了自主展开长推理,你不用再在 Prompt 里"求"它思考。可以说,今天所有推理模型,都是 CoT 提示技巧的"转正"。
七、结构化输出:让程序能消费模型的话
前面六节处理的都是"给人看"的输出。但真实的工程场景里,模型的输出经常要给程序消费------下游代码要拿它入库、判断分支、渲染页面。程序要的是结构化数据,不是一段话。
解决什么问题:自然语言输出没法直接解析。早期开发者用正则从模型回答里抠字段,模型措辞稍有变化("答案是:北京" / "北京。" / "该城市为北京"),正则就崩了------脆弱到不可用。
怎么做:把输出格式的约束直接写进 Prompt,用 JSON Schema(一种描述 JSON 结构的标准:字段名、类型、哪些必填)告诉模型"你必须按这个结构吐出来"。配合 SDK 的结构化输出能力,模型会直接返回合法 JSON:
python
# pip install openai
from openai import OpenAI

client = OpenAI()  # 国内模型同理:OpenAI(base_url="...", api_key="...")

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "从这段评论中提取信息:'物流很快,包装完好,东西比想象中还好用'"}
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "review_analysis",
            "schema": {
                "type": "object",
                "properties": {
                    "sentiment": {"type": "string", "enum": ["好评", "差评"]},
                    "keywords": {"type": "array", "items": {"type": "string"}}
                },
                "required": ["sentiment", "keywords"]
            }
        }
    },
)

import json
data = json.loads(response.choices[0].message.content)
print(data["sentiment"])   # 好评 ------ 下游代码可直接使用
这段代码可以直接跑通:模型吐出的永远是 {"sentiment": "...", "keywords": [...]} 这种合法 JSON,json.loads 永远不会抛异常。对比第五节 Few-shot 里"靠示例暗示格式",这里是"靠 Schema 强制格式"------前者是约定,后者是合同。
为什么说这是通向 Function Calling 的关键一步 :让模型学会"按 Schema 输出结构化意图",正是函数调用(Function Calling)的地基。模型输出的那段 {"name": "get_weather", "arguments": {"city": "北京"}},本质上就是一条被 Schema 约束好的输出------只不过 Schema 描述的不是"评论分析",而是"你想调用哪个工具、参数是什么"。这条线索,留到系列第 3 篇展开。
八、三个常见误区
误区一:Prompt 是玄学,效果全看模型心情。 恰恰相反------输出由输入决定,这是因果,不是玄学。同一个 Prompt 跑十次结果有波动,是因为温度参数(temperature,控制采样随机性的设置)引入的随机性;但"差的 Prompt 稳定产出差的结果"这件事本身,稳定得像物理定律。效果不好时,别急着换模型、更别加"请认真思考"这类安慰剂,按顺序过一遍排查清单:**任务动词清不清楚?素材给了没有?约束是不是可执行("写好一点"不可执行,"300 字内"才可执行)?受众说了吗?**九成问题能在这一步定位------这和调试代码走读逻辑没有本质区别,只不过你看的不是变量,是意图。
误区二:堆砌咒语式赞美。 "你是一位世界顶级、拥有 100000 智商、获得过无数大奖的专家......"------这类堆砌没有作用。角色设定之所以有效,是因为它改变了模型激活的知识区域和语言口径,而不是因为你"夸"了它。"世界顶级"四个字不提供任何可执行的区分度。与其堆十个形容词,不如多写一条具体约束:字数、格式、禁忌、受众。前者是装饰,后者是工程。
误区三:忽略上下文长度限制。 模型一次能"看见"的文本有上限,叫上下文窗口(Context Window)。它意味着两件事:一是塞不下的部分等于不存在 ------把 50 页 PDF 整个贴进去,超长部分直接被截断;二是塞得满不等于看得清------研究反复发现,位于上下文中部的信息容易被模型忽略(所谓 lost in the middle)。工程上的正确做法是:素材按需给、长文档先检索再截取相关段落------而这个"先检索、再喂给模型"的思路,就是 RAG(检索增强生成)的出发点,正好是下一篇的主角。
写在最后
回头看,Prompt 之所以是整个 AI 技术栈的第一块地基,是因为它解决了一个此前从未被解决过的问题:让"写指令"的成本从"学会一门编程语言"降到"会说话就行"。
而它身后的整条演进链,都是对 Prompt 某个局限的回应:素材从哪来 → RAG;怎么让程序消费输出 → 结构化输出与 Function Calling;怎么让指令在循环里自主运转 → Agent。下一篇文章,我们讲 RAG:怎么让模型"开卷考试"。
Prompt 不是咒语,是一份写给天才实习生的任务说明书。说明书越清楚,天才越像专家。
参考资料:OpenAI 官方文档(Structured Outputs / Prompt Engineering Guide)、Wei et al. 《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》(2022)、Brown et al. 《Language Models are Few-Shot Learners》(2020)、Anthropic Prompt Engineering 文档。