如果你在 2022 年底错过 ChatGPT,在 2024 年底错过 MCP,在 2025 年错过 Agent,没关系------这篇文章一次讲透。这不是一份名词解释,而是一条完整的演进逻辑链:AI 是怎么从"一个会聊天的模型",一步步长成"一个会干活的系统"的。 全文覆盖 Prompt、RAG、Function Calling、Tool、MCP、LangGraph、Orchestrator、A2A、Skills、AGENTS.md、Memory、Sandbox、Harness 等近五年所有关键概念,每个概念都讲清楚"它是什么、解决什么问题、怎么用"。全文约 12000 字,建议收藏后按章节阅读。
一、2022--2023:Prompt 时代,一切的开端
2022 年 11 月 30 日,OpenAI 上线 ChatGPT。它没有发布会,没有营销预算,却在两个月内收获一亿月活,成为当时人类历史上增长最快的消费级应用。
但对开发者来说,真正重要的不是聊天本身,而是大家第一次意识到:大语言模型(LLM)是一个可以用自然语言编程的通用接口。怎么"问"模型(Prompt,提示词),第一次成为一门严肃的工程学问。
Prompt 到底是什么?
一句话:Prompt 就是你发给模型的输入文本,模型的一切输出都由它决定。 同一个模型,Prompt 写法不同,效果天差地别:
text
❌ 差的 Prompt:
"帮我写个周报"
→ 模型只能泛泛而谈,写出来的东西像模板填充。

✅ 好的 Prompt:
"你是我的工作助理。请根据以下本周完成事项,写一份周报:
1. 完成 CSDN 自动发布工具,支持草稿/发布/删除
2. 修复了图片上传偶发超时的问题
要求:面向部门领导,突出业务价值,控制在 300 字内,
用'进展 / 风险 / 下周计划'三段式结构。"
→ 输出直接可用,因为角色、素材、受众、格式、篇幅全说清了。这个例子里藏着的五个要素------角色(你是谁)、任务(做什么)、素材(基于什么)、约束(格式篇幅)、受众(给谁看)------构成了第一代"模型操作手册"的主体。在此基础上,业界又发展出两个重量级技巧:
- Few-shot(少样本示例):在 Prompt 里先给两三个"输入→输出"的示例,模型会模仿示例的风格和格式。相当于"别解释了,照这个样子做";
- 思维链(Chain-of-Thought, CoT):在 Prompt 里加一句"请一步步思考",或在示例中展示推理过程,模型的复杂推理准确率会显著提升。2022 年 Google 的论文证明了这个现象,它也是后来所有推理模型的雏形。
同期的三条技术路线
这一年前后,围绕 LLM 长出了三条技术路线,各自解决一个核心痛点:
| 路线 | 解决的问题 | 核心思路 | 代表工作 |
|---|---|---|---|
| Prompt 工程 | 模型"不听话" | 不动模型,只优化"怎么问" | Few-shot、CoT、角色扮演 |
| RAG(检索增强生成) | 模型"不知道" | 外挂知识库,先检索再生成 | LangChain、LlamaIndex、向量数据库 |
| 微调 | 模型"不合适" | 用领域数据改造模型本身 | LoRA、QLoRA 高效微调 |
三者怎么选?一个经验法则:格式和话术问题用 Prompt 解决,知识问题用 RAG 解决,能力和风格问题才动微调------微调最贵、见效最慢,永远放在最后考虑。这个优先级排序直到今天也没变过。
RAG:让模型"开卷考试"
上面表格里的 RAG 值得单独展开,因为它直到今天仍是企业落地 LLM 的第一选择。
它是什么:Retrieval-Augmented Generation,检索增强生成。模型回答问题之前,先去你的私有知识库里检索相关资料,把资料塞进 Prompt,再让模型"看着材料答题"。
它解决什么:模型训练数据有截止日期、不知道你公司内部的制度文档、而且会一本正经地编造(幻觉)。RAG 让知识"外挂"而不是"内化"------文档更新了重新索引即可,完全不用重新训练模型。
它怎么工作:分两个阶段,看图一目了然:
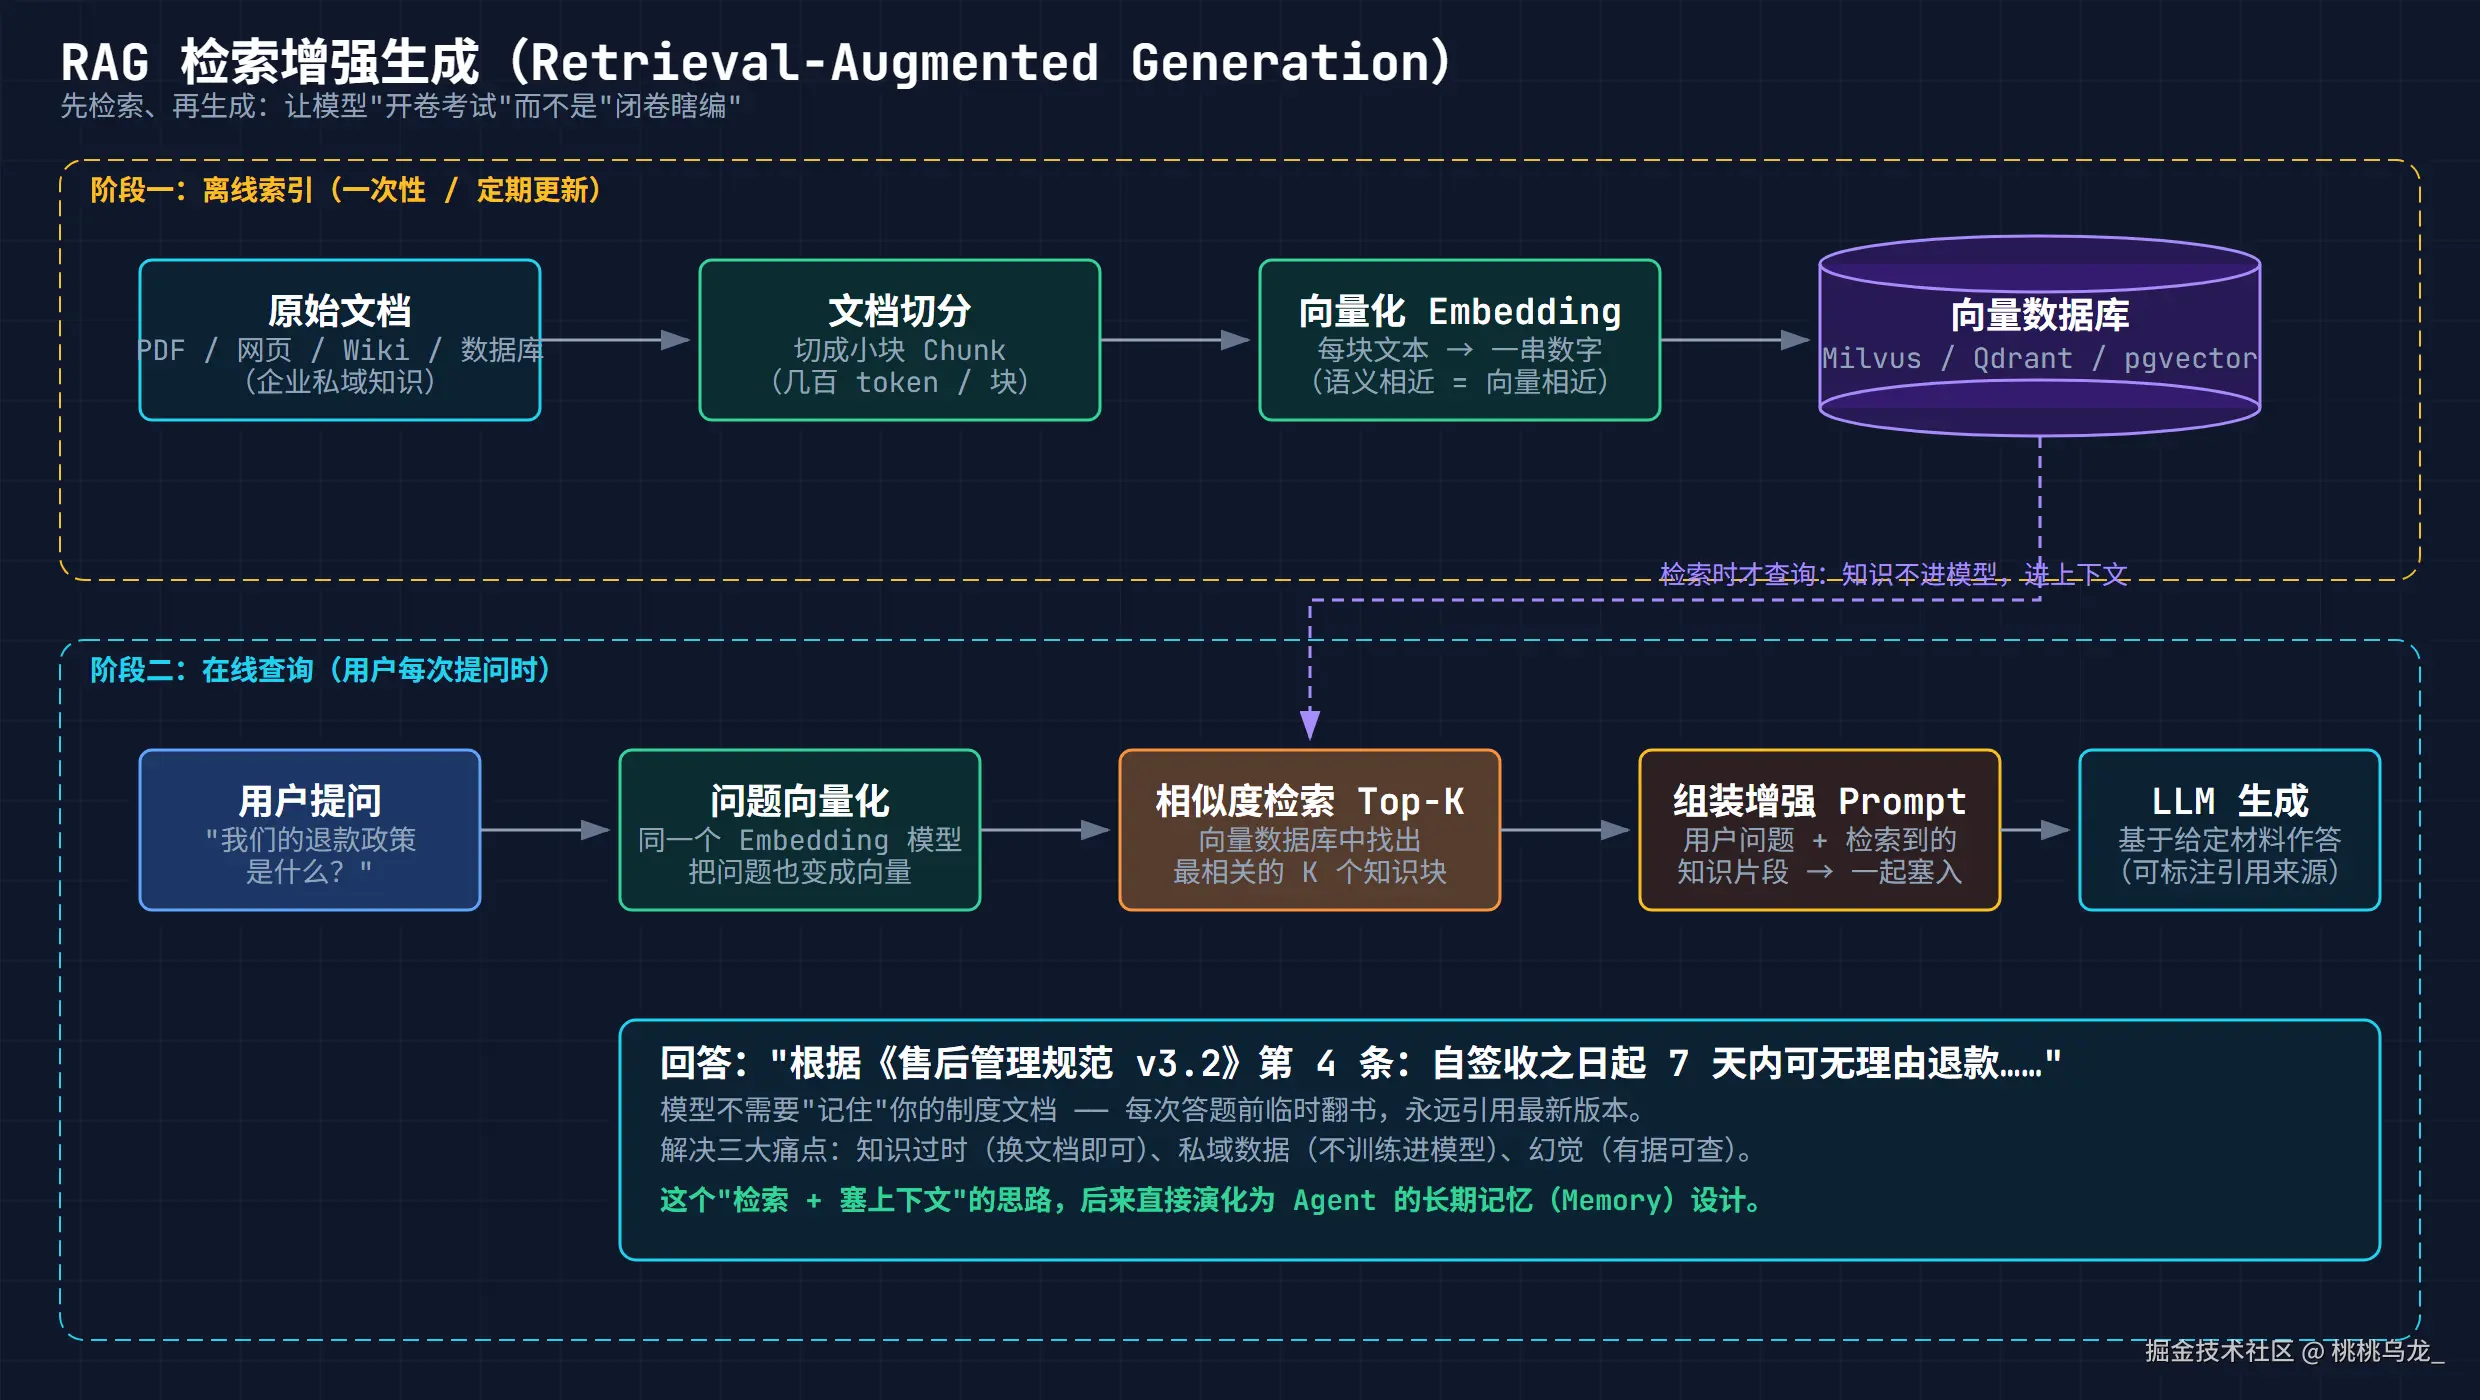
对应的完整代码流程(伪代码):
python
# ===== 阶段一:离线索引(一次性/定期执行)=====
chunks = split_documents("公司制度库/*.pdf", chunk_size=500)   # 切成小块
vectors = embedding_model.encode(chunks)                       # 每块 → 向量
vector_db.insert(vectors, metadata=chunks)                     # 存入向量库

# ===== 阶段二:在线问答(用户每次提问)=====
q_vec = embedding_model.encode(user_question)                  # 问题 → 向量
top_k = vector_db.search(q_vec, k=3)                           # 找最相关的 3 块
prompt = f"请仅根据以下资料回答问题:\n{top_k}\n\n问题:{user_question}"
answer = llm.generate(prompt) # 开卷作答它为什么重要:注意这个"检索 + 塞上下文"的动作------两年后 Agent 的长期记忆(Memory)用的就是一模一样的机制,只是检索的对象从"公司文档"变成了"Agent 自己的经历"。RAG 是 Agent 记忆系统的直系祖先。
LangChain:Agent 时代最早的雏形
2022 年 10 月开源的 LangChain 迅速爆火。它把"调用模型 → 解析输出 → 再调用"抽象成"链(Chain)",第一次让开发者可以用代码串起复杂的 LLM 工作流,并提供了统一的文档加载器、向量库接口、Prompt 模板。可以说,LangChain 是 Agent 时代最早的雏形------只不过那时还没人这么叫。
第一波 Agent 泡沫:AutoGPT 的启示
2023 年 3 月,一个叫 AutoGPT 的开源项目横空出世,GitHub 星标暴涨,一度成为史上增速最快的仓库之一。它的设想非常激进:给 GPT-4 一个目标,让它自己拆解任务、自己调用搜索、自己写文件、自己循环执行------"自主 Agent"的概念第一次进入大众视野。
但 AutoGPT 很快暴露了问题:任务拆解经常跑偏、循环容易失控、工具调用频繁失败,最后烧掉大量 token 却产出寥寥。第一波 Agent 热潮就此退去。
回头看,AutoGPT 失败的根本原因不是"想法不对",而是基础设施不成熟------模型还没学会可靠地调用工具(要等 2023 年中的 Function Calling)、没有标准化的工具协议(要等 2024 年底的 MCP)、没有安全的执行环境(要等 2025 年的 Sandbox 产品化)。三块拼图,各自在路上。
二、2023--2024:给模型装上"手"------Tool 与 Function Calling 时代
先分清两个词:Tool 和 Function Calling
这两个词经常被混用,其实一个指"东西",一个指"技术":
- Tool(工具) :模型能调用的任何外部能力------一个函数、一个 HTTP API、一次数据库查询、一个搜索引擎,甚至"操作整台电脑"。工具是静态存在的能力;
- Function Calling(函数调用) :让模型学会使用工具的那项训练技术。2023 年 6 月 OpenAI 在 API 中推出后,各家模型陆续跟进。
一个类比:Tool 是"车",Function Calling 是"考驾照"------模型经过训练后,看到工具清单就知道什么时候该开车、往哪开。
Function Calling 完整工作流程
很多教程只展示"模型返回一个 JSON"就结束了,导致很多人误以为模型自己执行了函数。实际上模型从头到尾没有执行任何东西------它只输出一段"我想调用什么"的结构化意图,执行永远是你的应用完成的。看完整时序:
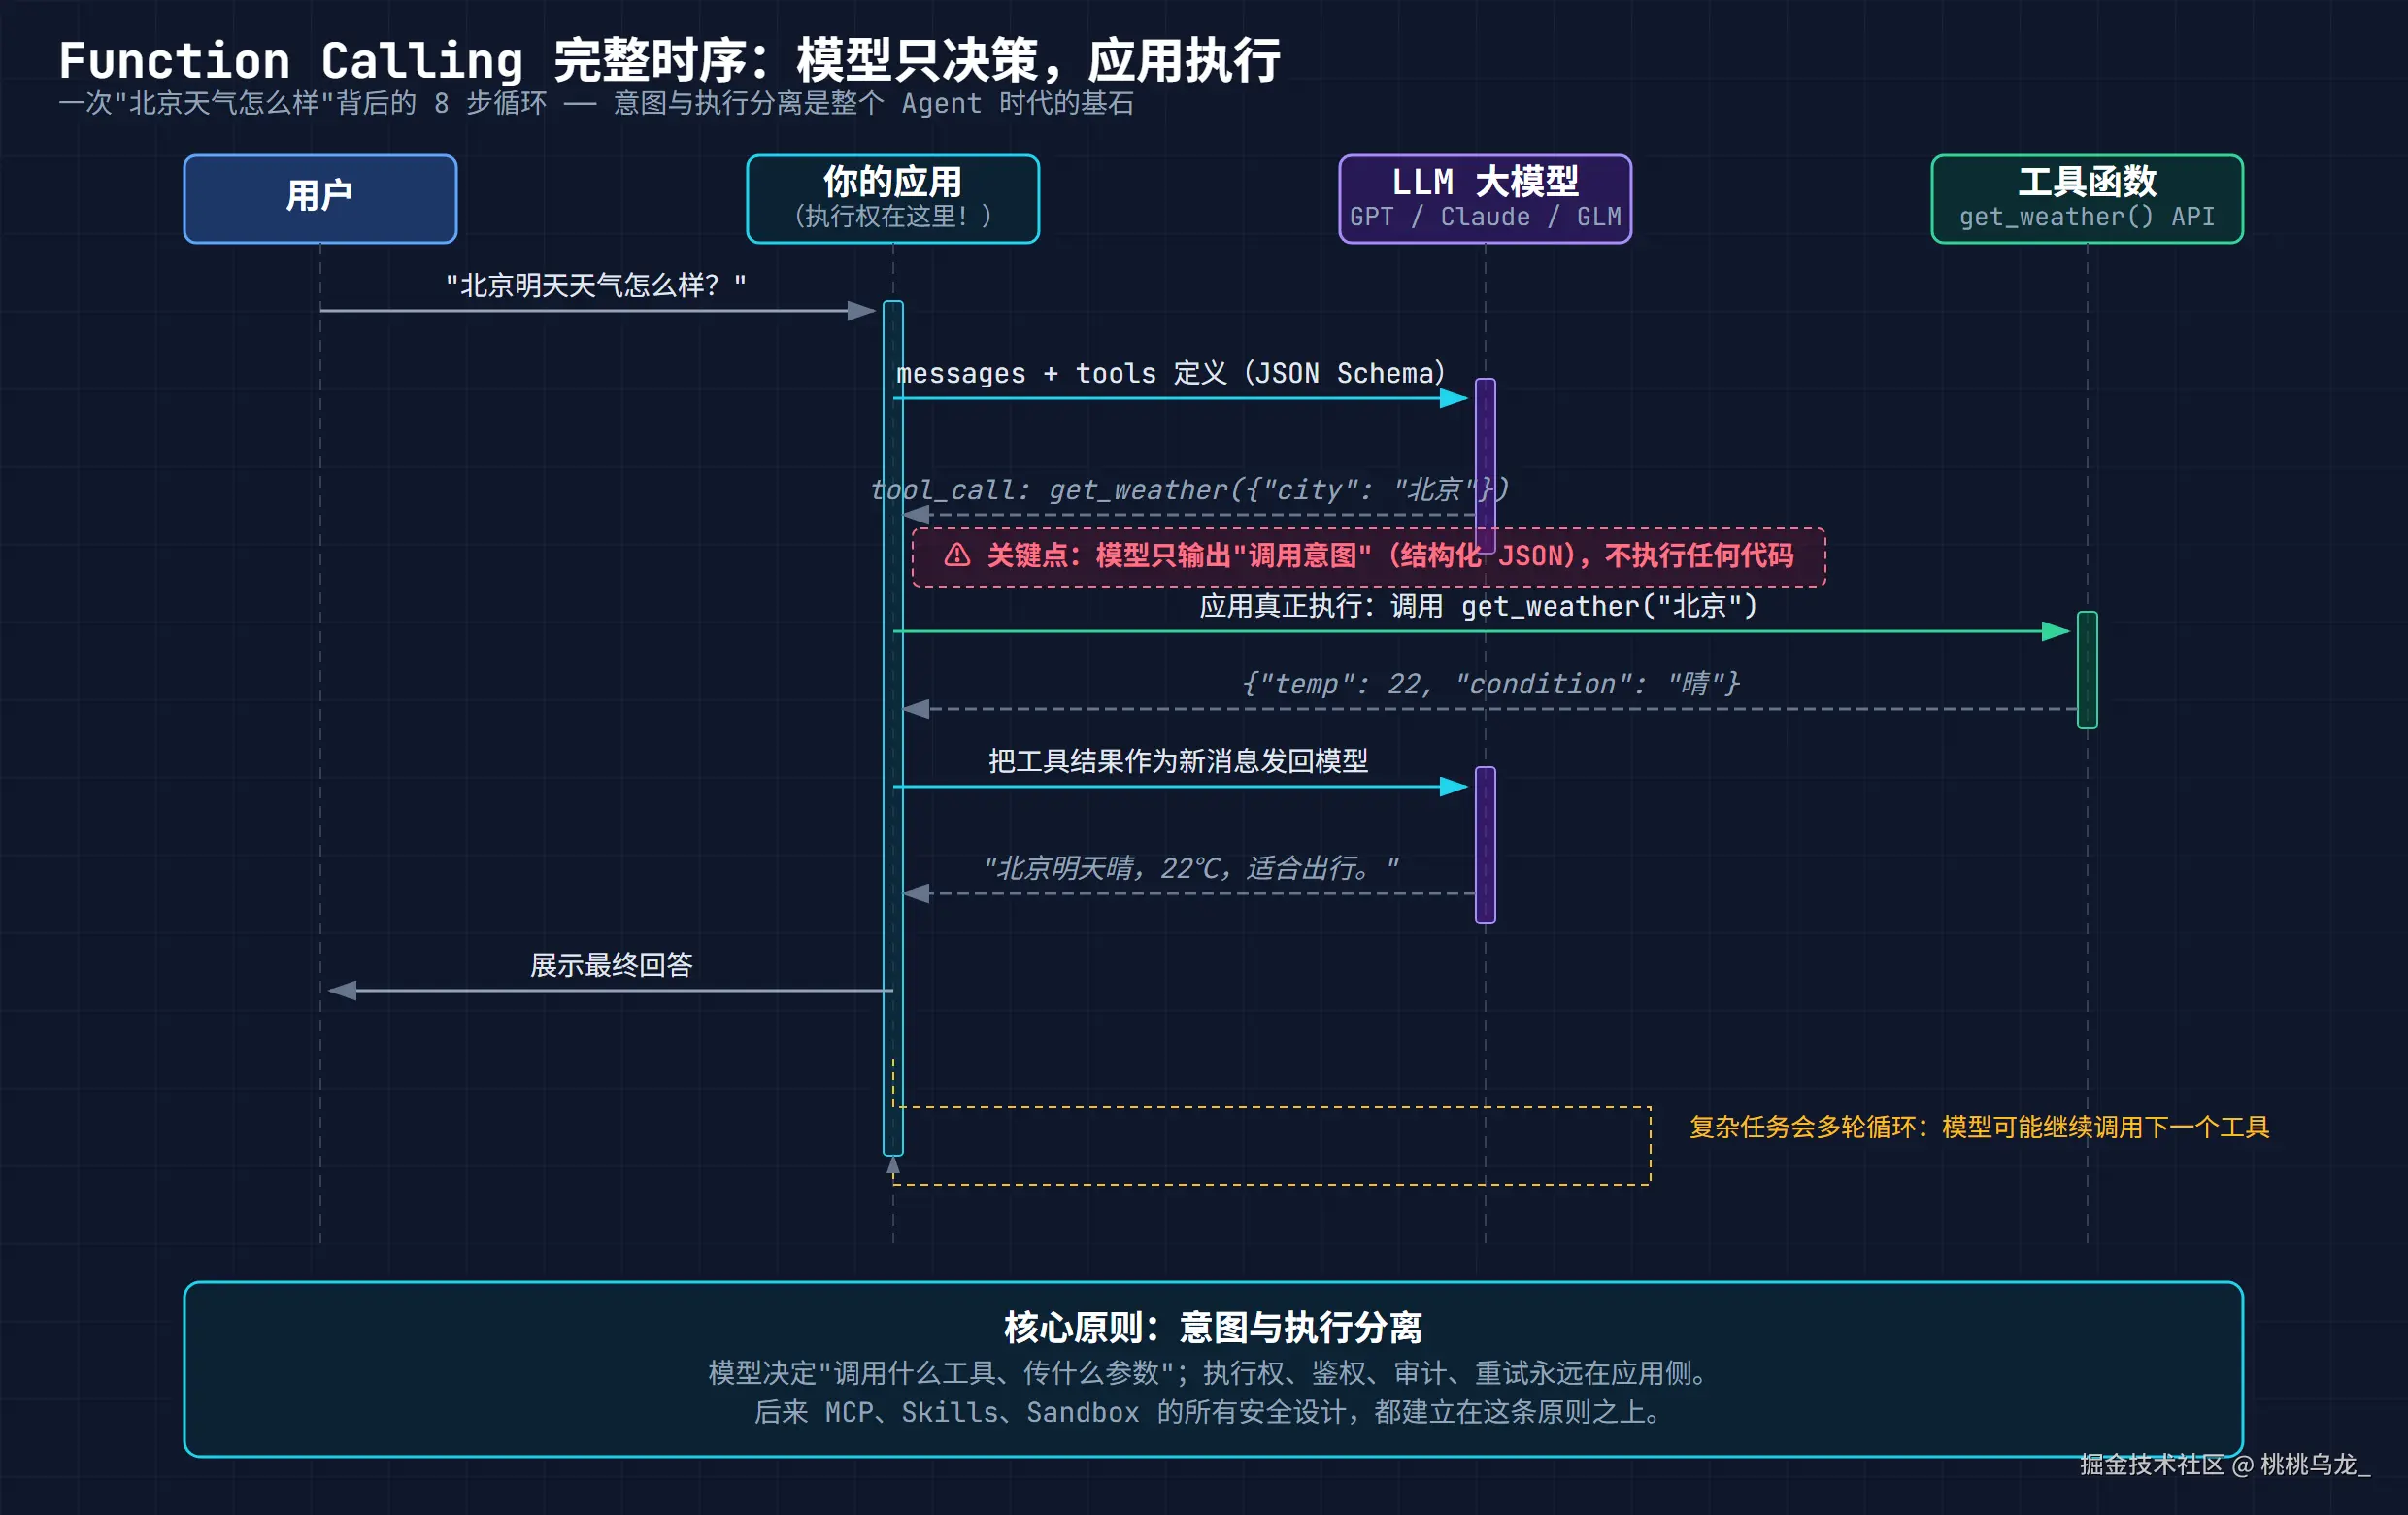
第一步,你把工具清单(JSON Schema 格式)连同用户问题一起发给模型:
python
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "查询指定城市的实时天气",   # 这行描述决定模型何时用它!
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名,如:北京"}
            },
            "required": ["city"]
        }
    }
}]

response = client.chat.completions.create(
    model="gpt-4",
    messages=[{"role": "user", "content": "北京今天天气怎么样?"}],
    tools=tools,
)
第二步,模型不回答问题,而是返回结构化调用意图:
json
{"name": "get_weather", "arguments": {"city": "北京"}}第三步,你的代码解析这个 JSON、真正去调天气 API,把结果作为新消息发回模型,模型这才生成自然语言回答。写成一个最小循环:
python
while True:
    resp = llm.chat(messages, tools=tools)
    if not resp.tool_calls:          # 模型不再要求调工具 → 任务完成
        print(resp.content)          # "北京今天晴,18~26℃"
        break
    for call in resp.tool_calls:     # 模型要求调工具 → 应用执行
        result = run_function(call)  # ← 执行权在应用手里
messages.append({"role": "tool", "content": result})它为什么是里程碑:模型第一次被原生训练成"在合适的时机输出结构化的函数调用请求",而不只是生成一段自然语言。这个"意图与执行分离"的原则------模型决策、应用执行------后来贯穿了整个 Agent 技术栈,从 MCP 到 Skills 再到 Sandbox 的所有安全设计都建立在它之上。
Tool 的分类:Agent 能"用"的东西远比你想的多
到 2024 年,工具生态已经扩展到惊人程度。按类型分一张表:
| 工具类型 | 例子 | Agent 用它干什么 |
|---|---|---|
| 信息获取 | 搜索引擎、天气 API、股价接口 | 补充实时信息,绕过知识截止 |
| 数据读写 | SQL 查询、CRUD API、文件读写 | 操作业务数据和本地文件 |
| 计算执行 | 代码解释器、计算器 | 精确计算(模型心算不可靠) |
| 行动执行 | 发邮件、下单、调用第三方 SaaS | 真正"替人办事" |
| 环境操作 | 浏览器自动化、Computer Use | 接管 GUI,操作没有 API 的软件 |
最后一行特别值得一提:2024 年 10 月 Anthropic 发布 Computer Use------把"整台电脑"变成一个 Tool:模型看屏幕截图、移动鼠标、敲键盘。工具的终极形态,就是接管整个操作环境。这个思路直接启发了后来的 Operator、Claude Code 等产品形态。
到 2024 年中,"模型 + 工具"的循环已经能跑了。但一个更底层的问题浮出水面------工具接得太乱了。每家模型一套工具定义格式、每个工具一套接入方式,N 个模型 × M 个工具 = N×M 套适配代码,谁都受不了。
三、2024.11:MCP------AI 领域的"USB-C"
N×M 集成地狱的终结
2024 年 11 月 25 日,Anthropic 开源了 Model Context Protocol(MCP,模型上下文协议),一举把 N×M 问题变成 N+M:模型侧和工具侧各自实现一次协议,即可互相通信。官方给它的比喻是"AI 的 USB-C"------一个通用插口,插上什么都能用。
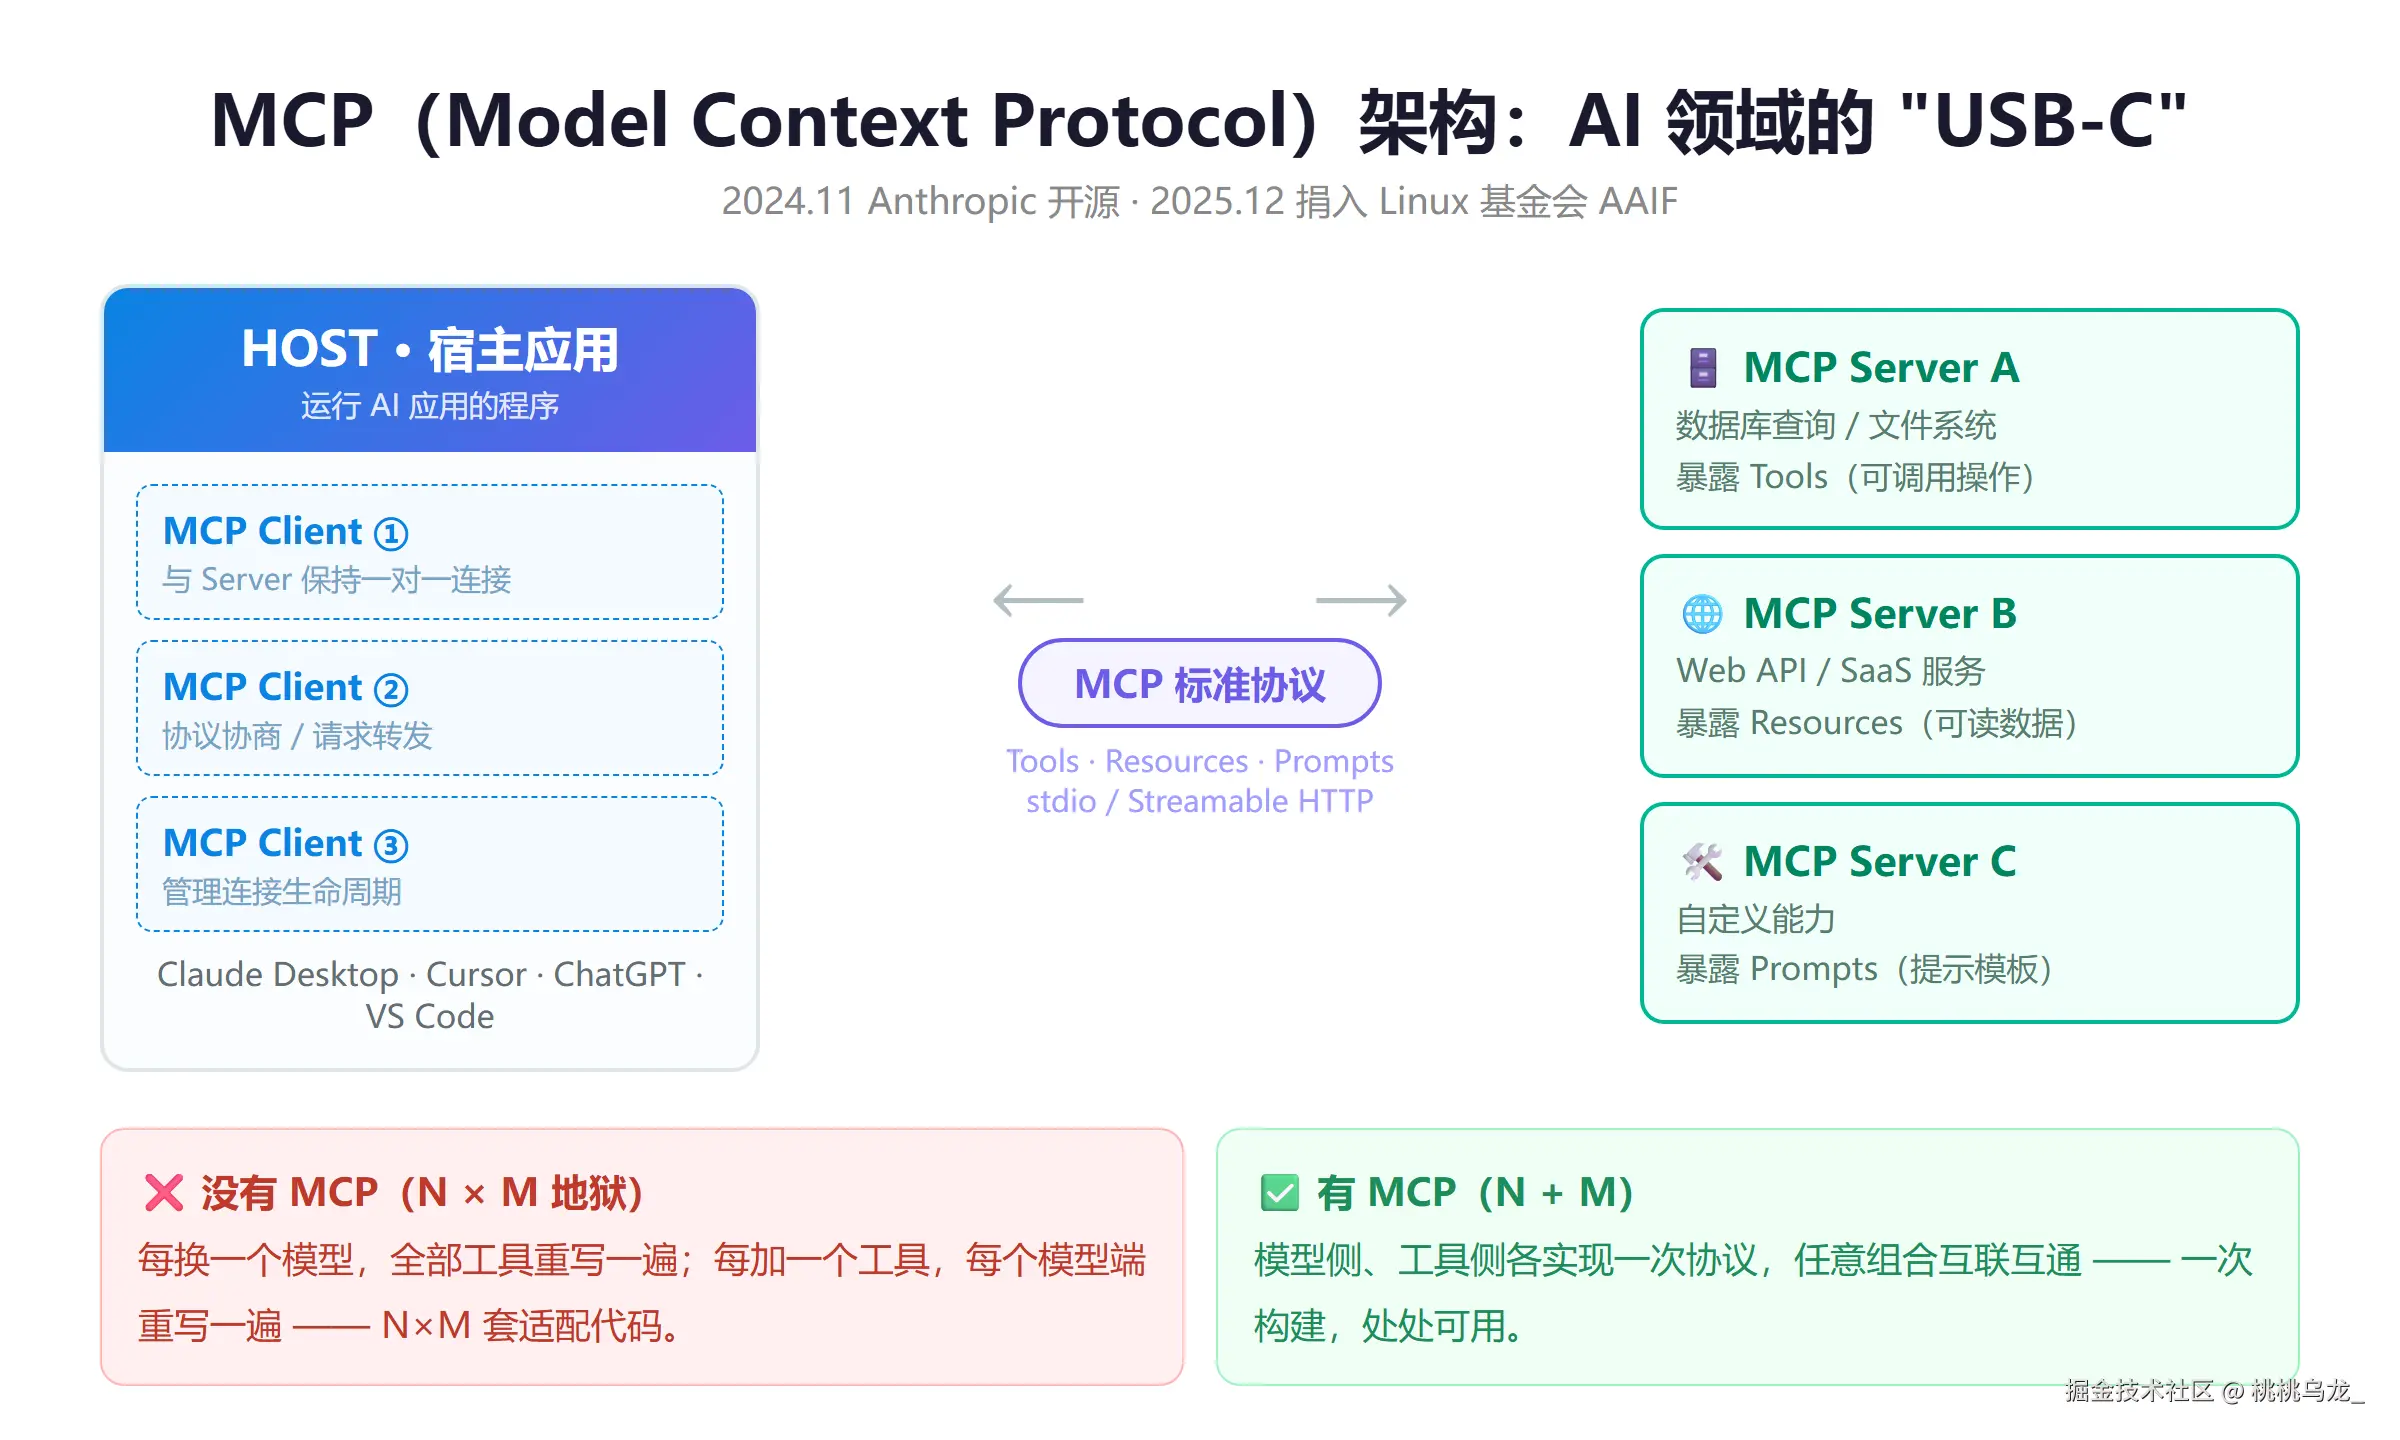
三层架构:Host / Client / Server
MCP 的架构不复杂,就三个角色,用"你在 Cursor 里问数据库"举例:
- Host(宿主):运行 AI 应用的程序本身------Cursor、Claude Desktop、ChatGPT 桌面版都是 Host。它想给模型外挂能力;
- Client(客户端):Host 内部的协议连接器,与每个 Server 保持一对一连接。Cursor 想同时接数据库和 GitHub,就内部跑两个 Client;
- Server(服务器) :真正提供能力的进程,向外面暴露三类东西(术语叫"原语"):
- Tools(工具) :可被模型调用的操作,如
query_database(sql)------模型自己决定何时调用; - Resources(资源):可被应用读取的数据,如文件内容、数据库表结构------由应用决定何时注入上下文;
- Prompts(提示模板):预置的提示词模板,由用户主动选择使用。
- Tools(工具) :可被模型调用的操作,如
Tools / Resources / Prompts 三者的区别是"谁决定何时使用":模型决定 → Tool;应用决定 → Resource;用户决定 → Prompt。记住这句话,MCP 就算真懂了。
写一个 MCP Server 有多简单?
python
# pip install "mcp[cli]"
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("weather-server")

@mcp.tool()
def get_weather(city: str) -> str:
    """查询指定城市的实时天气"""
    return f"{city} 今天晴,18~26℃"  # 实际项目中调用天气 API

if __name__ == "__main__":
    mcp.run()  # 默认 stdio 传输,本地即插即用
就这么多------一个装饰器,一个文档字符串。保存后在任何支持 MCP 的 AI 应用里配置一行命令,Claude、ChatGPT、Cursor、VS Code 就都能发现并调用这个工具,你不需要为每家模型写任何适配代码。
传输方式有两种:本地 Server 走 stdio (标准输入输出,跟子进程通信,零网络开销);远程 Server 走 Streamable HTTP(2025 年起取代了早期的 SSE),适合团队共享的云端服务。
从"Anthropic 的协议"到"行业的基础设施"
MCP 真正的转折点在 2025 年:
- 2025 年 3 月,竞争对手 OpenAI 宣布全面支持 MCP------"对手都采用了"标志着它从公司项目变成行业事实标准;
- 2025 年 4 月,Google 跟进,随后 Microsoft、AWS、Cloudflare、Bloomberg 全部入局;
- 2025 年 12 月 9 日,Anthropic 把 MCP 捐给 Linux 基金会旗下新成立的 Agentic AI Foundation(AAIF),与 OpenAI 的 AGENTS.md、Block 的 goose 并列三大创始项目。从此 MCP 的治理与 Kubernetes、PyTorch 同级,任何一家厂商都无法单方面控制它的走向;
- 到 2026 年,MCP 官方 SDK 月下载量超过 9700 万次 ,活跃 Server 数量突破 1 万个,覆盖数据库、浏览器、支付、设计工具、云平台各个方向。OpenAI 甚至宣布废弃自家的 Assistants API,引导生态全面迁移到 MCP 架构。
从发布到成为"AI 界的 HTTP",MCP 只用了 16 个月------这个速度超过了当年的 React。
四、2025:Agent 元年------从"能聊天"到"能干活"
工具层统一之后,2025 年迎来了 Agent 的真正爆发。
上半年三连击:1 月,DeepSeek R1 发布,开源推理模型把推理成本打下来一个数量级,Agent 的"大脑"不再昂贵;2 月,Claude Code 发布------不是一个聊天窗口,而是一个能读懂整个代码仓库、自己规划、自己写代码、自己跑测试、自己修 Bug 的终端 Agent,"Agentic Coding"从此成为工程师日常;3 月,Manus 刷屏,展示了通用 Agent 接管"分析数据 → 写代码 → 生成报告"完整任务链的可能性。
从"链"到"图":LangGraph 与编排范式的进化
早期 LangChain 的"链"是单向流水线(A → B → C 走到底),但真实任务需要循环、分支、重试、人工介入。2024 年 1 月 ,LangChain 团队推出 LangGraph,把编排模型从"链"升级为"图"。
它是什么:一个基于"状态机"的 Agent 编排框架。三个核心概念:
- State(状态):一个贯穿全程的共享数据结构,所有节点读写它;
- Node(节点):一个步骤------一次模型调用、一次工具执行、一段业务逻辑;
- Edge(边):节点之间的流转规则,支持条件分支(模型说"继续"就走工具节点,说"完成"就结束)。
它解决什么:AutoGPT 式的裸循环不可控------跑偏了没人拉得住、出错了没法回滚、关键操作没法人工把关。LangGraph 让循环里的每一步都可观测、可干预、可回滚。
完整可跑的 ReAct Agent 示例(这就是所有编码 Agent 的核心骨架):
python
from langgraph.graph import StateGraph, MessagesState, END
from langgraph.prebuilt import ToolNode

# 1. 定义两个节点
def call_model(state):          # 节点①:带工具清单调用模型
    return {"messages": [llm.bind_tools(TOOLS).invoke(state["messages"])]}

def should_continue(state):     # 条件边:模型想调工具吗?
    return "tools" if state["messages"][-1].tool_calls else END

# 2. 组装成图:model ⇄ tools 构成循环
graph = StateGraph(MessagesState)
graph.add_node("model", call_model)
graph.add_node("tools", ToolNode(TOOLS))
graph.set_entry_point("model")
graph.add_conditional_edges("model", should_continue)
graph.add_edge("tools", "model")     # 工具结果回到模型 → 循环形成
app = graph.compile()

# 3. 运行:模型 → 工具 → 模型 → ...... 直到模型认为任务完成
for chunk in app.stream({"messages": [("user", "查北京天气并总结成一句话")]}):
    print(chunk)
看出来了么?这就是 AutoGPT 当年想做的"自主循环",只不过这次每一步都可控、可观测、可回滚。LangGraph 还内置了 Checkpointer(检查点)------把 State 随时存档,进程崩了能从断点续跑,想人工介入就在任意节点前暂停。到 2025 年,LangGraph 已成为构建生产级 Agent 的事实标准之一。
Orchestrator:一个 Agent 不够,那就组一个团队
当任务复杂到单循环撑不住,Orchestrator(编排器) 模式登场。
它是什么 :一个主 Agent(Orchestrator)负责理解需求、拆解任务、分派给多个专职子 Agent,再汇总结果。解决什么:单一上下文装不下复杂任务------让"读代码的"和"写文档的"各开各的上下文窗口,互不污染。
常见的三种组队模式:
| 模式 | 结构 | 适用场景 | 例子 |
|---|---|---|---|
| Supervisor(主管式) | 主 Agent 居中调度,子 Agent 各管一摊 | 任务可清晰分派 | Claude Code 的 Subagent、Manus |
| 层级式 | 主管下面还有小主管,树状层层分解 | 超大型任务 | 多团队模拟、大型重构 |
| 流水线式 | A 的输出是 B 的输入,串行传递 | 流程固定的内容生产 | 调研 → 写稿 → 审校 → 发布 |
打个比方:Orchestrator 像团队里的 Tech Lead------自己不写所有代码,但决定谁干什么、检查干得怎么样、对最终交付负责。Claude Code 里用 /agents 创建的子代理、各种 Multi-Agent 框架里的 Supervisor 模式,本质都是这一套。
而 Agent 一多,新的问题又来了:不同框架、不同厂商构建的 Agent 怎么互相协作? 我的 Agent 是 LangGraph 写的,你的是 AutoGen 写的,它连你的 Agent 有什么能力都不知道,怎么合作?这就是 2025 年 4 月 Google 发布 A2A(Agent-to-Agent)协议 要解决的事。
A2A:Agent 世界的"HTTP"
它是什么:一个让 Agent 之间互相发现、互相调用、交换任务产物的开放协议,走标准 HTTP + JSON-RPC。
它怎么工作,看图就懂:
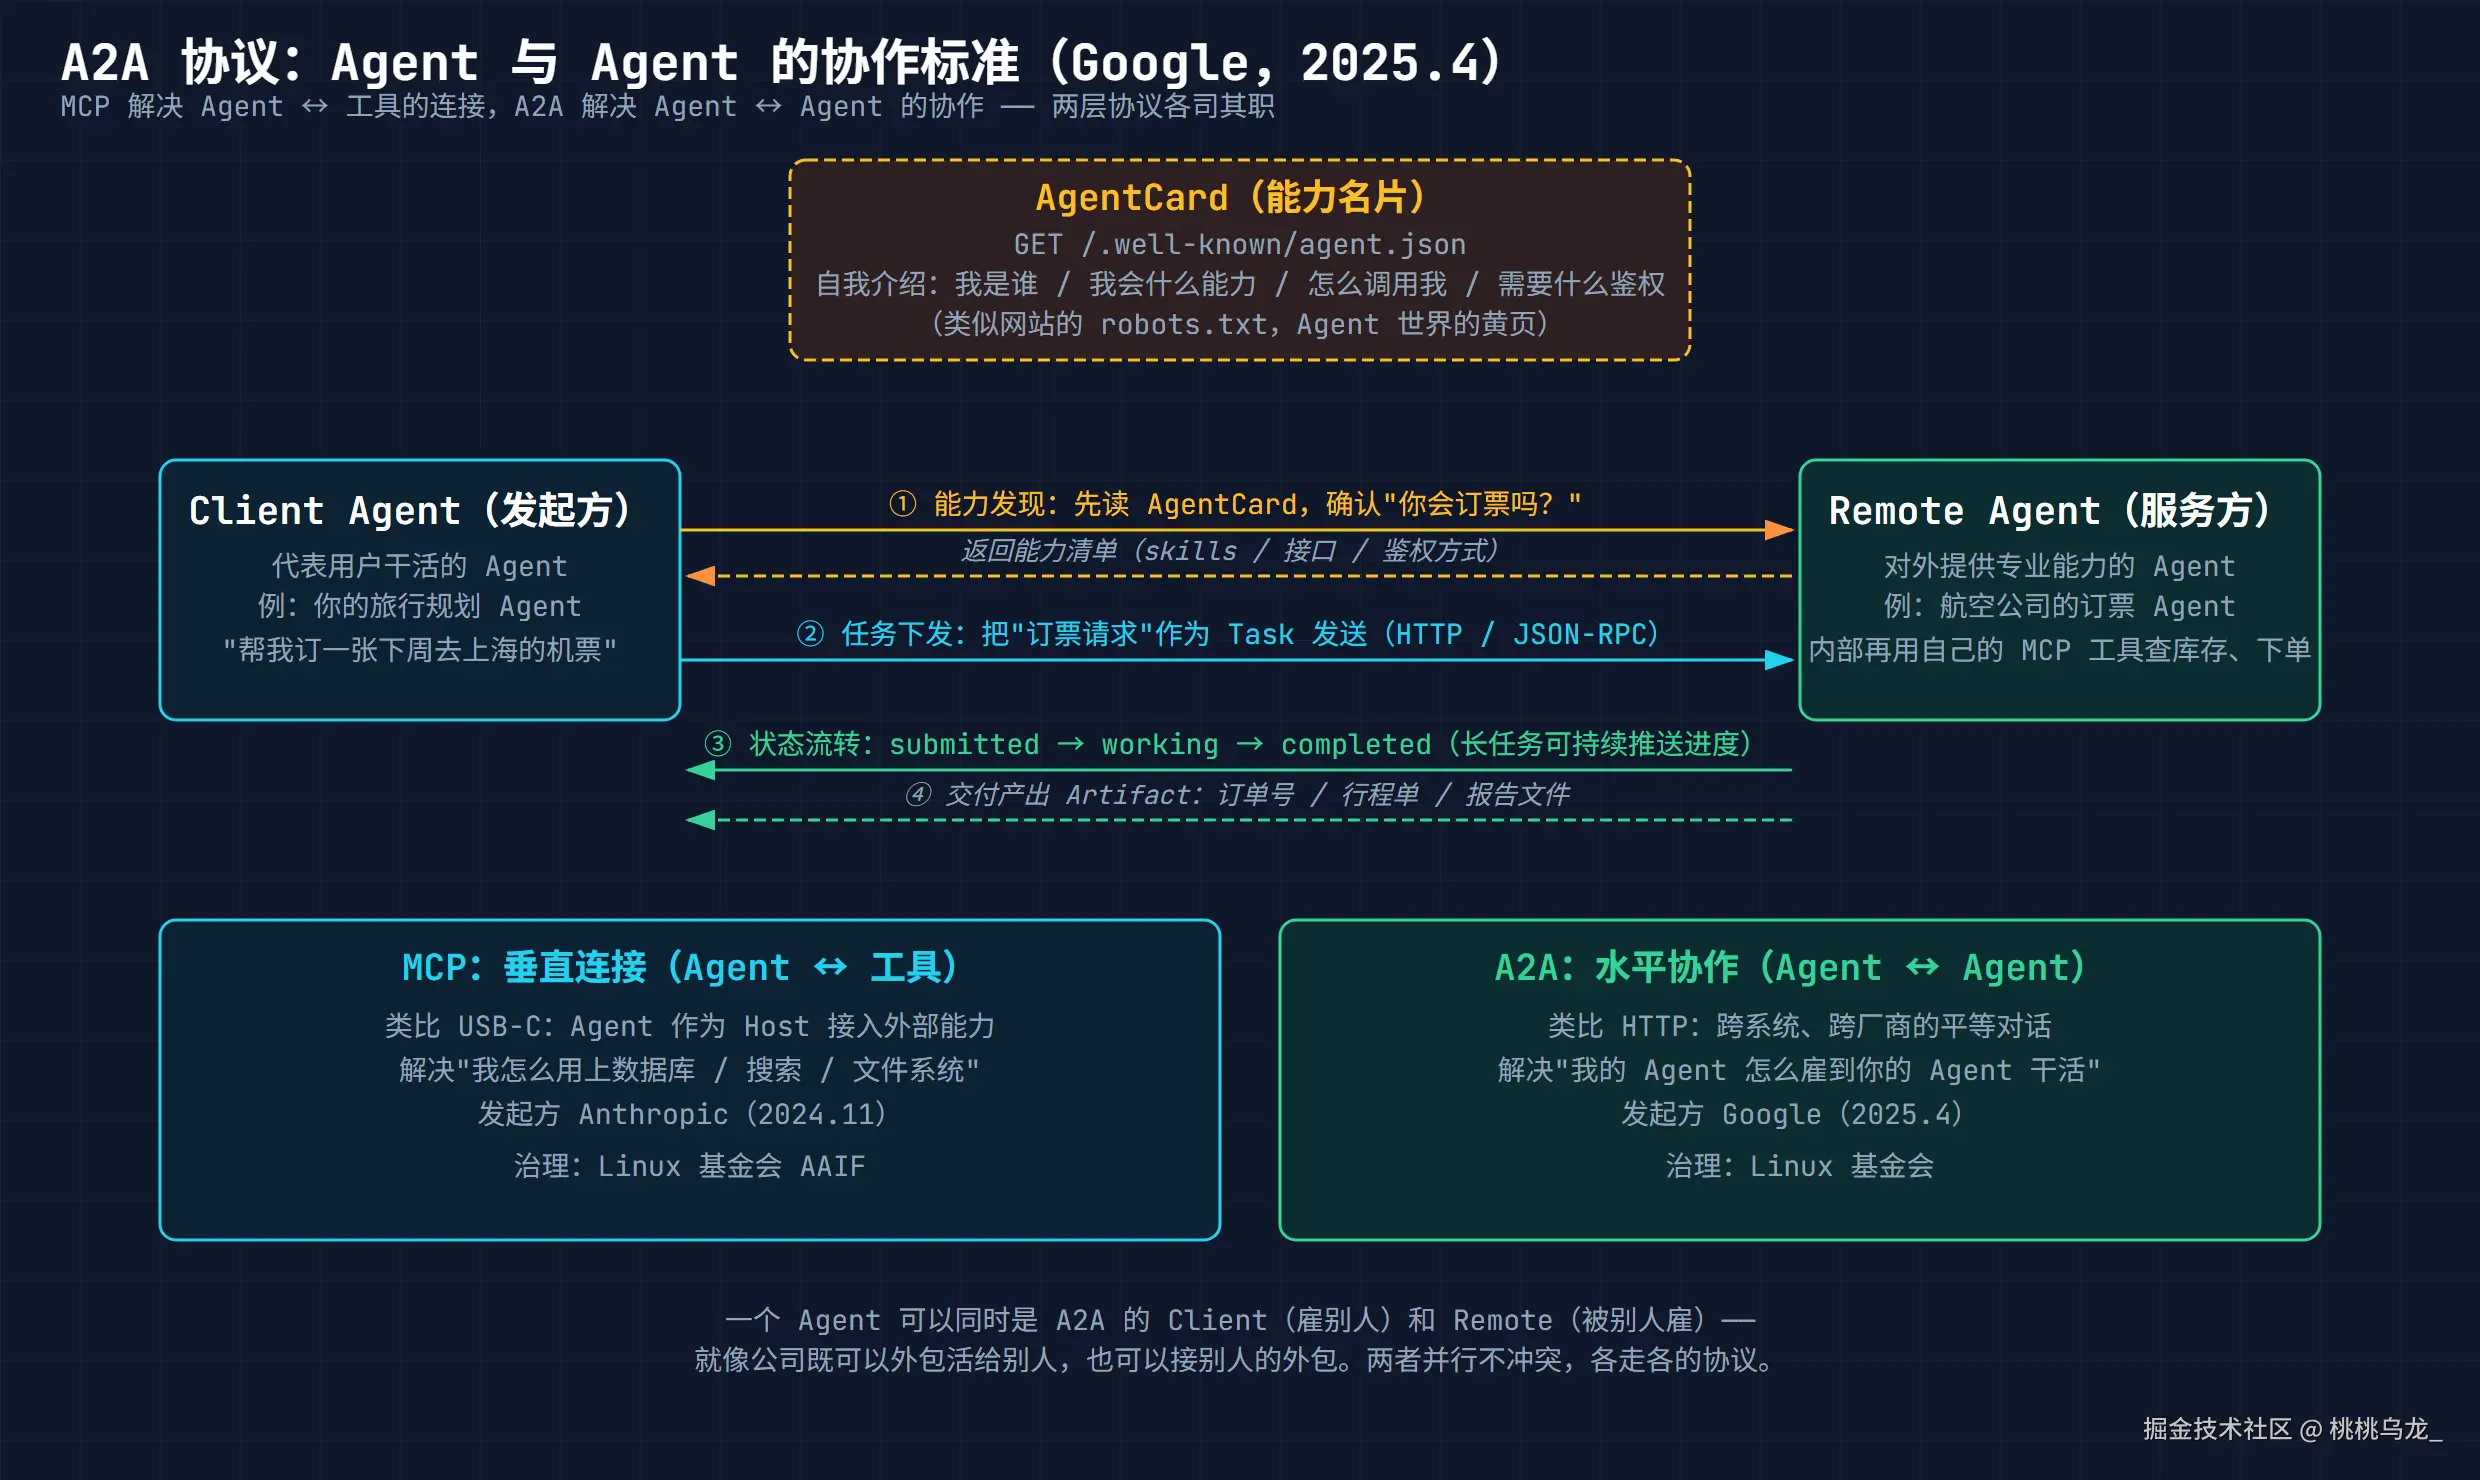
核心机制有两个:
- AgentCard(能力名片) :每个 A2A Agent 在固定地址
/.well-known/agent.json放一张"名片",写明我是谁、我会什么技能、怎么调用、需要什么鉴权。其他 Agent 先读名片,再决定要不要"雇"它------就像 Web 世界的 robots.txt; - Task(任务)生命周期 :发起方把请求封装为 Task 发送,接收方返回状态流转(
submitted → working → completed),长任务可以持续推送进度,缺信息时进入input-required状态等人补充,最终交付 Artifact(产出物:文件、报告、订单号)。
A2A 和 MCP 什么关系?不是竞争,是分层协作:
| MCP | A2A | |
|---|---|---|
| 解决什么 | Agent ↔ 工具/数据 的连接 | Agent ↔ Agent 的协作 |
| 类比 | USB-C(外设接口) | HTTP(跨系统通信) |
| 典型问题 | "我怎么用上这个数据库" | "我的 Agent 怎么雇到你的 Agent" |
| 发起方 | Anthropic(2024.11) | Google(2025.4) |
| 治理 | Linux 基金会 AAIF | Linux 基金会 |
一个具体例子串起两者:你的旅行 Agent(A2A Client)接到"帮我订下周去上海的机票",通过 A2A 发现并调用航空公司的订票 Agent;而那个订票 Agent 在干活时,又通过 MCP 调用航班数据库和支付接口。A2A 管 Agent 之间,MCP 管 Agent 和工具之间,一层一层各司其职。
同样在这一年,"Context Engineering(上下文工程)"取代 Prompt Engineering 成为工程圈热词------大家发现,Agent 的能力上限往往不取决于模型多聪明,而取决于你往它的上下文窗口里放了什么、什么时候放、放多少。这个认知直接催生了下面要讲的 Memory 和 Harness 体系。
五、2025--2026:Skills、AGENTS.md 与 Harness------知识与骨架的标准答案
Agent Skills:用文件夹封装专业知识
2025 年 10 月 16 日 ,Anthropic 发布 Agent Skills,12 月 18 日进一步将其开放为跨平台开放标准(agentskills.io)。发布当天,知名开发者 Simon Willison 评价它"可能比 MCP 影响更大"。
它是什么:一个 Skill 就是一个文件夹,里面放一个 SKILL.md(指令 + 元数据),可选地带上脚本、模板、参考资料。不需要 API,不需要服务器,甚至不需要联网------就是一个目录。
它解决什么:把"老师傅的经验"变成可复用、可分发的资产。以前让 Agent 正确处理 PDF 需要在 Prompt 里写一大段注意事项,每个应用配一遍;现在写成 Skill,谁都能拿来就用。
markdown
---
name: pdf-processing
description: 提取 PDF 中的文本与表格、填写表单。
  当用户提到 PDF、表单或文档提取时使用。
---

# PDF 处理

## 快速开始
用 pdfplumber 提取文本。

## 表单填写
参见 FORMS.md 获取表单填写的详细参考。
text
pdf-skill/
├── SKILL.md          # 主指令(启动时只加载元数据)
├── FORMS.md          # 附加参考(需要时才读取)
├── REFERENCE.md      # 详细 API 文档(需要时才读取)
├── scripts/
│   └── fill_form.py  # 可执行脚本(代码不进入上下文)
└── assets/
    └── template.pdf  # 二进制模板资源
它的核心设计 叫渐进式披露(Progressive Disclosure),分三层:
- 第一层:启动时只把每个 Skill 的名称 + 一行描述注入系统提示------成本极低;
- 第二层:只有当任务匹配时,Agent 才读取完整的 SKILL.md;
- 第三层:SKILL.md 里引用的附加文件(脚本、参考文档),只在真正用到那一步时才打开。
这意味着你可以给一个 Agent 挂上百个 Skill 而不撑爆上下文窗口------就像新员工入职,公司不需要把所有手册塞进他脑子,只需要让他知道"手册在书架上,用的时候去翻"。
一个实战感受:给 Claude Code 装上官方的 docx/pptx/xlsx Skills 后,一句"把这份报告做成 PPT"就能驱动它读 Skill → 按里面的流程调脚本 → 产出真正的 .pptx 文件。你写一个自己的 Skill 也一样------只要一个文件夹。到 2025 年 12 月开放标准后,30 多个工具火速跟进,Skill 从"Anthropic 的特性"变成了"全行业的知识封装格式"。
AGENTS.md:项目级指令的统一
Skills 封装的是"给 Agent 的专业知识",而 AGENTS.md 解决的是另一个痛点:怎么给 Agent 交代"这个项目的规矩"。
它是什么 :一个放在代码仓库根目录的 Markdown 文件,相当于"写给 AI 的 README"。解决什么:此前各家工具各认各的指令文件------Claude Code 读 CLAUDE.md、Cursor 用 .cursor/rules、GitHub Copilot 用 copilot-instructions.md------开发者被迫维护多份 90% 内容重复的文件。
一份典型的 AGENTS.md 长这样:
markdown
# 项目约定

## 项目结构
- `src/` 业务代码;`tests/` 测试;`scripts/` 运维脚本

## 常用命令
- 构建:`npm run build`
- 测试:`npm test -- --filter=<包名>`(全量跑太慢,务必带 filter)

## 编码规范
- 提交信息用 conventional commits(feat: / fix: / chore:)
- 所有新增接口必须带 JSDoc 注释

## 红线(永远不要做)
- 不要提交或硬编码任何密钥、token
- 不要直接改 `legacy/` 目录下的代码,重构需求单独提 issue
发展时间线 :2025 年 8 月 OpenAI 随 Codex CLI 推出 → 9 月 Claude Code 宣布兼容 → 12 月捐入 Linux 基金会 AAIF。由于格式完全开放,Cursor、Windsurf、Gemini CLI、GitHub Copilot 全部跟进。它还支持分层发现 :monorepo 根目录放全局约定,各子包放更具体的 AGENTS.md,Agent 沿目录树逐级读取、就近覆盖------和 .gitignore、package.json 一样的"约定大于配置"思路。到 2026 年 3 月,GitHub 上已有超过 6 万个仓库包含 AGENTS.md,渗透率反超 CLAUDE.md。
至此,Agent 的"知识层"完成了三件套:MCP 统一工具接口、Skills 封装领域能力、AGENTS.md 约定项目规则。
Memory:Agent 的"记性"为什么这么难?
接下来是两个容易被忽略、但决定 Agent 上限的基础设施。先说 Memory(记忆)。
它解决什么:模型的上下文窗口是易失的"工作记忆"------对话一长就丢、一关就忘。今天教过它的偏好,明天开会就忘;干到一半的任务,进程一崩全没了。没有记忆的 Agent,每次都是从零开始的陌生人。
工程上把记忆拆成三层来管理,看图:
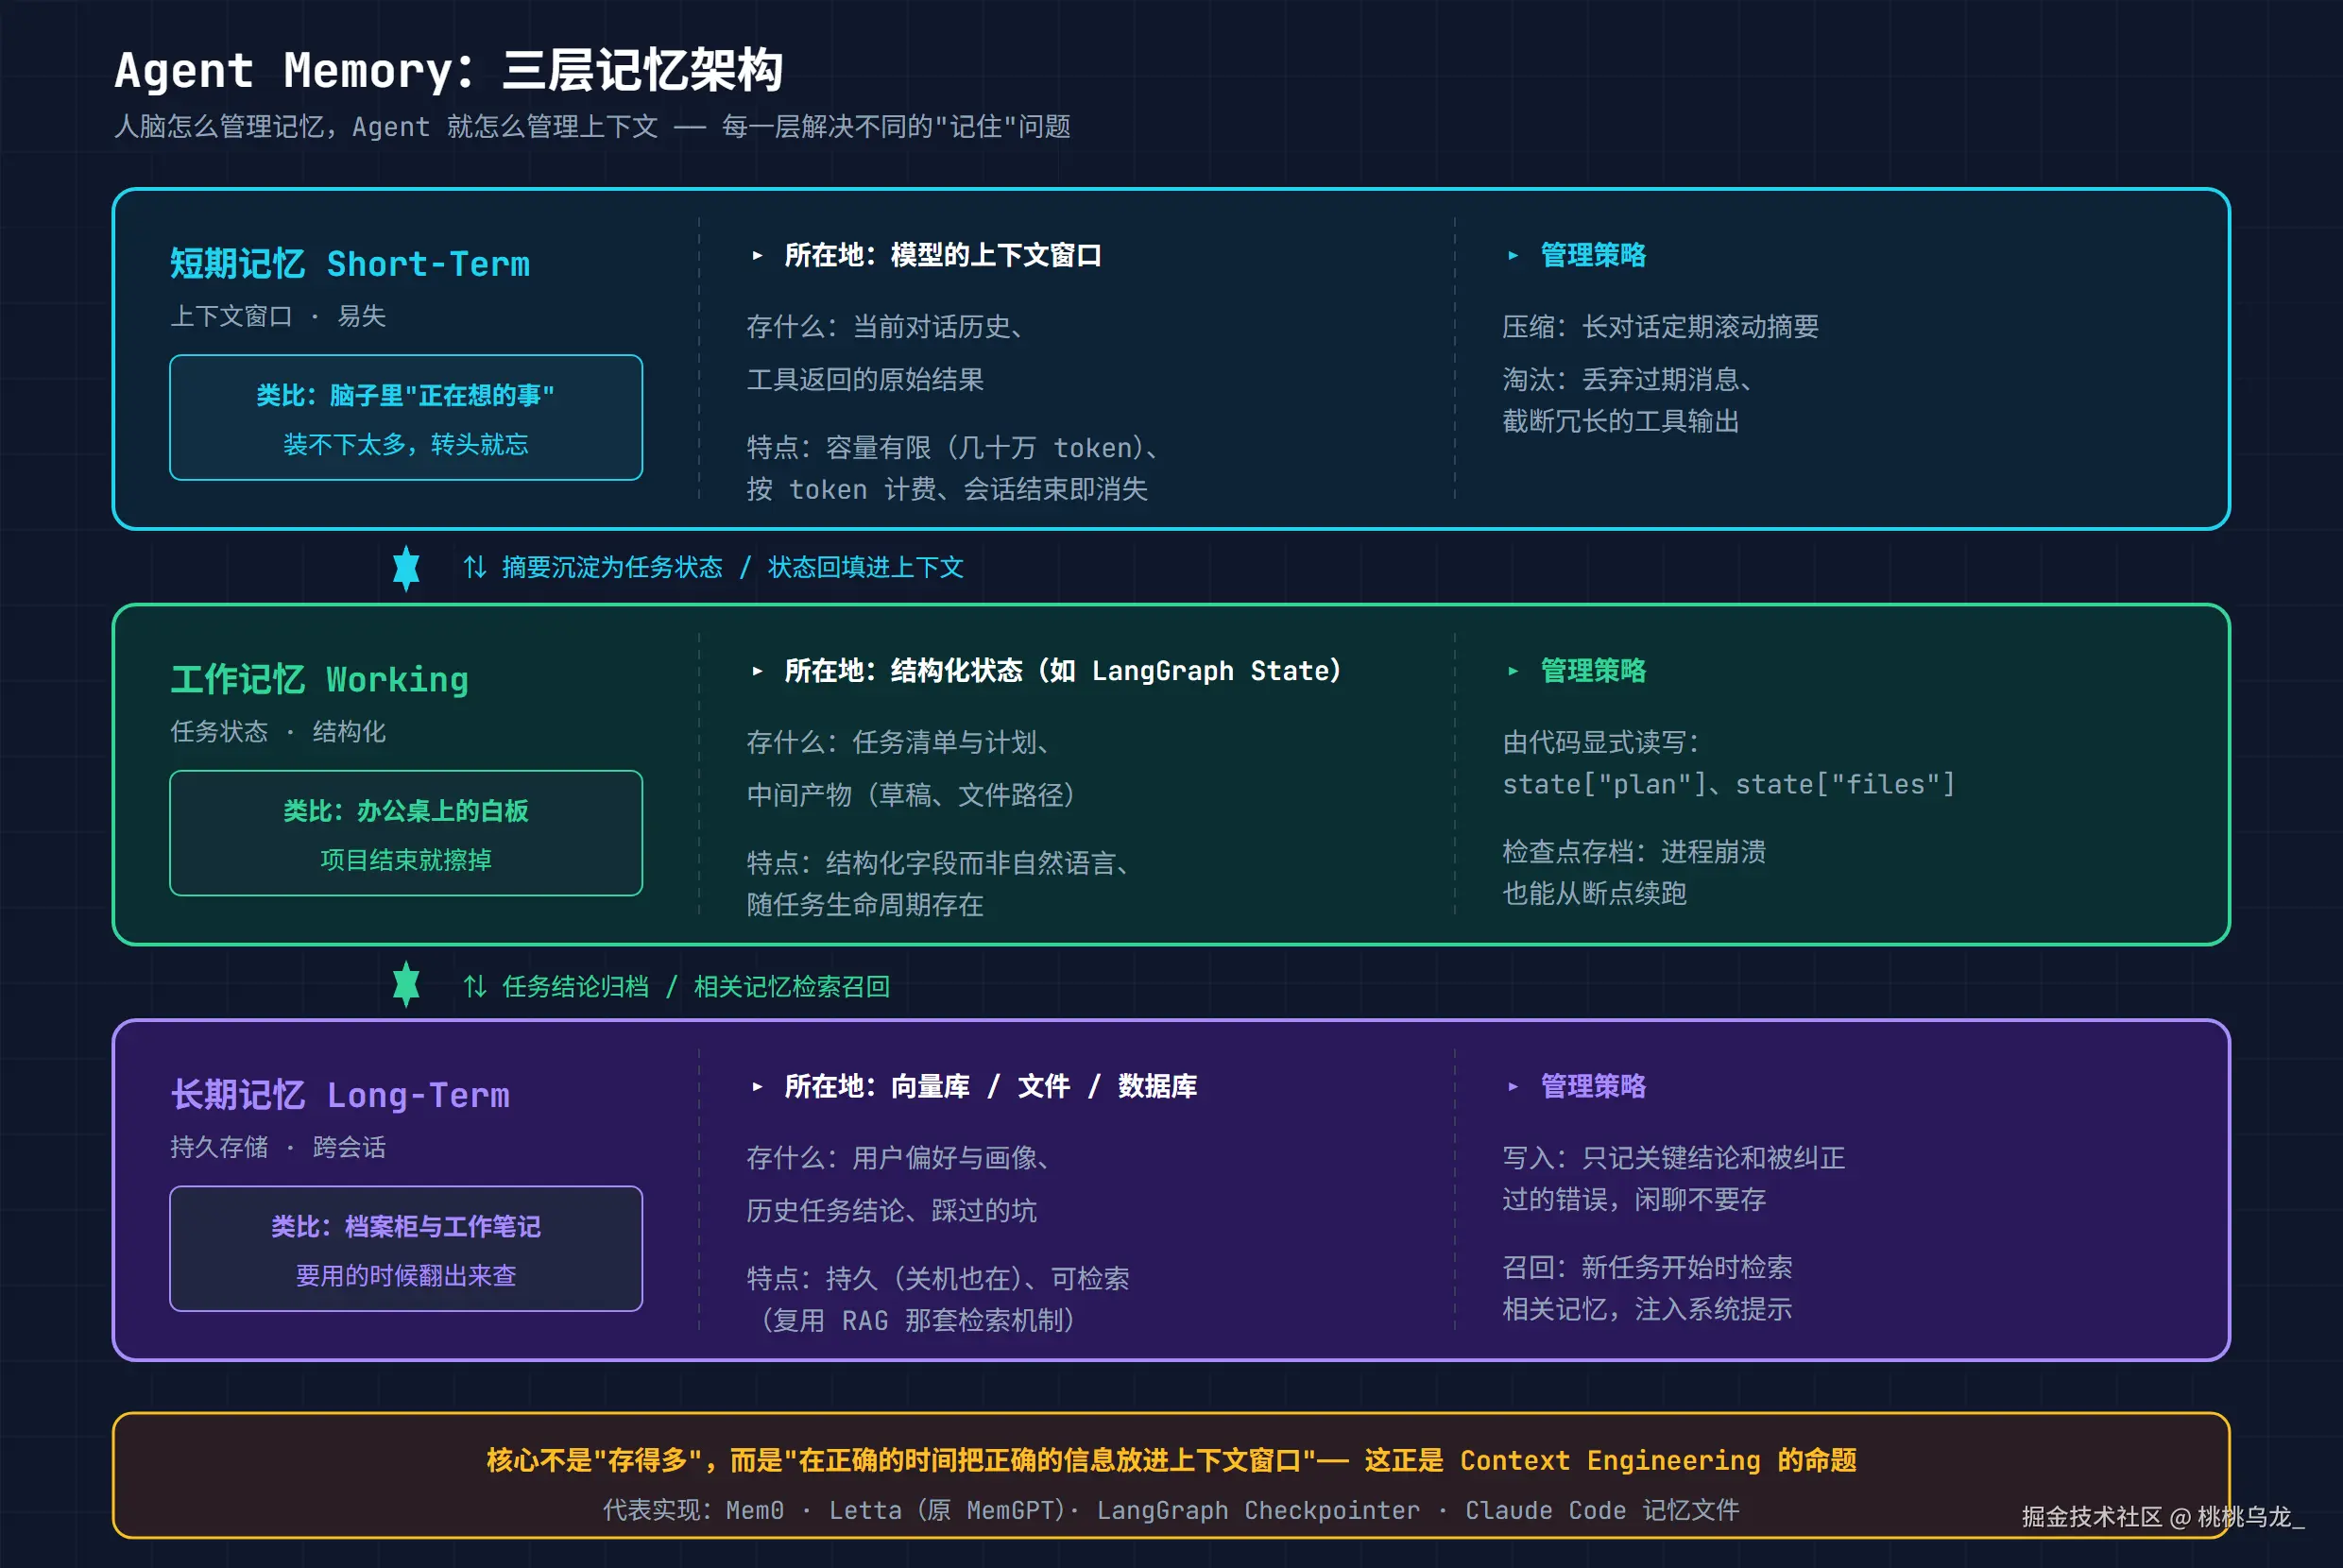
三层记忆的分工用一个例子串起来:你对编码 Agent 说"我们项目统一用 pnpm,别用 npm"------
- 这句话先进入短期记忆(当前上下文窗口);
- Agent 把它写进 CLAUDE.md 或记忆库------沉淀到长期记忆,下次会话开始时检索注入;
- 执行装依赖任务时,"用 pnpm"作为约束写进工作记忆(任务状态),整个执行过程中每一步都遵守。
代表实现:Mem0、Letta(原 MemGPT)、LangGraph Checkpointer、Claude Code 的自动记忆文件。什么时候往窗口里塞什么记忆,正是 Context Engineering 的核心命题------塞太多,贵且容易干扰;塞太少, Agent 瞎干;塞错了,比不塞还糟。
Sandbox:让 Agent "敢动手"的前提
Sandbox(沙箱) 是第二个隐形基础设施。
它解决什么:模型生成代码容易,但"运行它"需要安全的执行环境------Agent 写的代码可能有 Bug、甚至有风险(删文件、发请求、装依赖),不能直接跑在你的主力机上。
实现方式从轻到重四档:
| 方案 | 隔离强度 | 启动速度 | 典型场景 |
|---|---|---|---|
| 受限解释器 | 低 | 毫秒级 | 简单计算、数据处理 |
| 容器(Docker) | 中 | 秒级 | Claude Code 的 DevContainer、CI 环境 |
| 微虚拟机(Firecracker/gVisor) | 高 | 百毫秒级 | 云端多租户 Agent 平台 |
| 完整虚拟机 | 最高 | 秒级 | Computer Use 的桌面环境 |
为什么重要 :Anthropic 的 Skills 依赖 Code Execution Tool 沙箱来运行脚本(脚本源码不进入上下文,只返回执行结果------顺便省了大量 token);Computer Use 干脆给模型一整个隔离虚拟机。"让 Agent 敢动手"的前提,是它碰不到不该碰的东西------权限最小化、资源限额、崩溃可控、网络可管,这四件事全靠 Sandbox 承载。
Harness:模型只是内核,骨架才是产品
如果把 2022 年以来的演进压缩成一句话,那就是:行业对"Agent"的理解在不断下沉。
- 2023 年,大家以为 Agent = 模型 + 一段精巧的 Prompt;
- 2024 年,大家以为 Agent = 模型 + Tool 调用;
- 2025 年,大家以为 Agent = 模型 + 工具 + 记忆 + 规划;
- 到 2026 年,共识逐渐清晰:Agent = Harness + 模型。
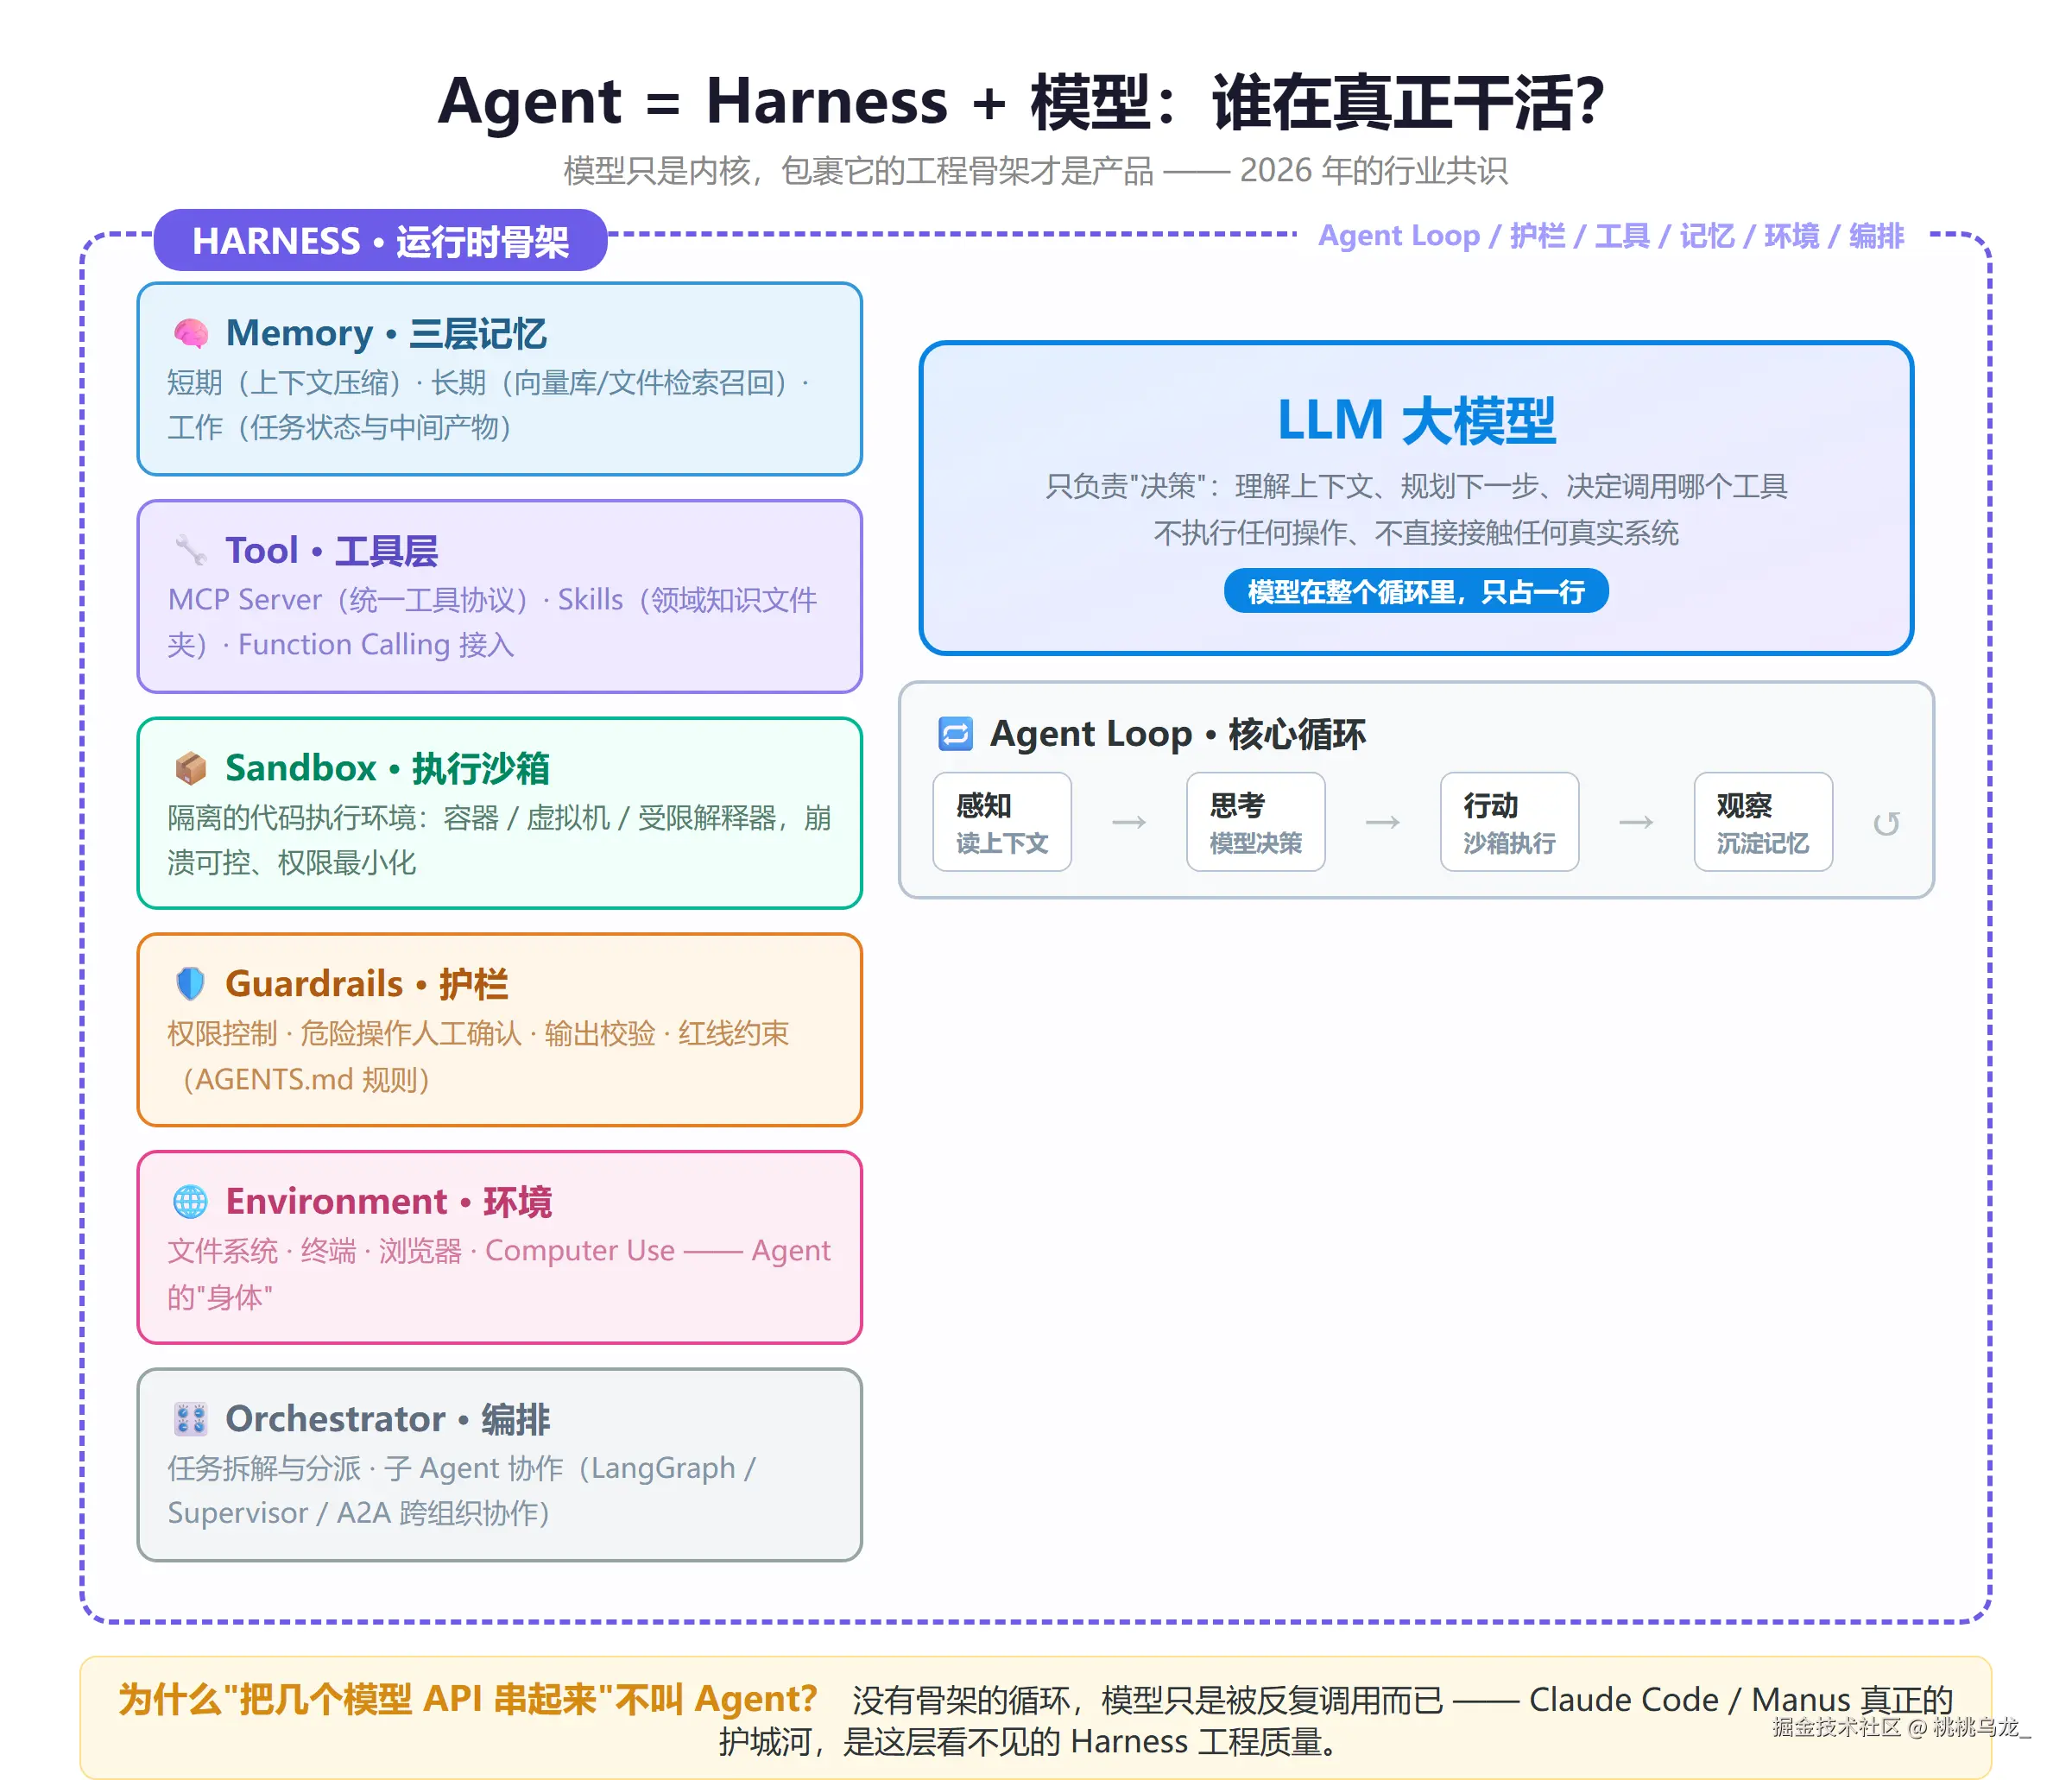
什么是 Harness(运行时骨架)?它是包裹在模型外面的那一整层工程系统:
- Agent Loop:感知 → 思考 → 行动 → 观察结果的循环,以及循环的终止条件与失败重试;
- 工具层:MCP Server、Skills、Sandbox 代码执行;
- 上下文与记忆:Context Engineering、Memory 三层管理;
- 护栏(Guardrails):权限控制、危险操作确认、输出校验;
- 环境:文件系统、终端、浏览器------Agent 的"身体";
- 编排:复杂任务下的 Orchestrator 多 Agent 协作。
一个最小可用的 Agent Loop,伪代码大概长这样:
python
while not task.done:
    context = harness.build_context(task, memory, tools)  # Memory:组装上下文
    action = model.think(context)                         # 模型只做决策
    result = harness.execute(action, sandbox)             # Sandbox:执行权在骨架手里
    harness.update(task, memory, result)                  # 观察结果并沉淀记忆

    if action.is_dangerous and not harness.confirmed(action):
break # 护栏:危险操作必须人工确认看清楚这个结构你会发现:模型在这个循环里只占一行。剩下的------上下文怎么组装、工具怎么执行、结果怎么沉淀、安全怎么保障------全部是 Harness 的活儿。这也是为什么"把几个模型的 API 串起来"不叫 Agent:没有骨架的循环,模型只是被反复调用而已;而 Claude Code、Manus 这类产品真正的护城河,恰恰是那层看不见的 Harness 工程质量。换个模型,Harness 原样能跑;没有 Harness,再强的模型也只是聊天窗口。
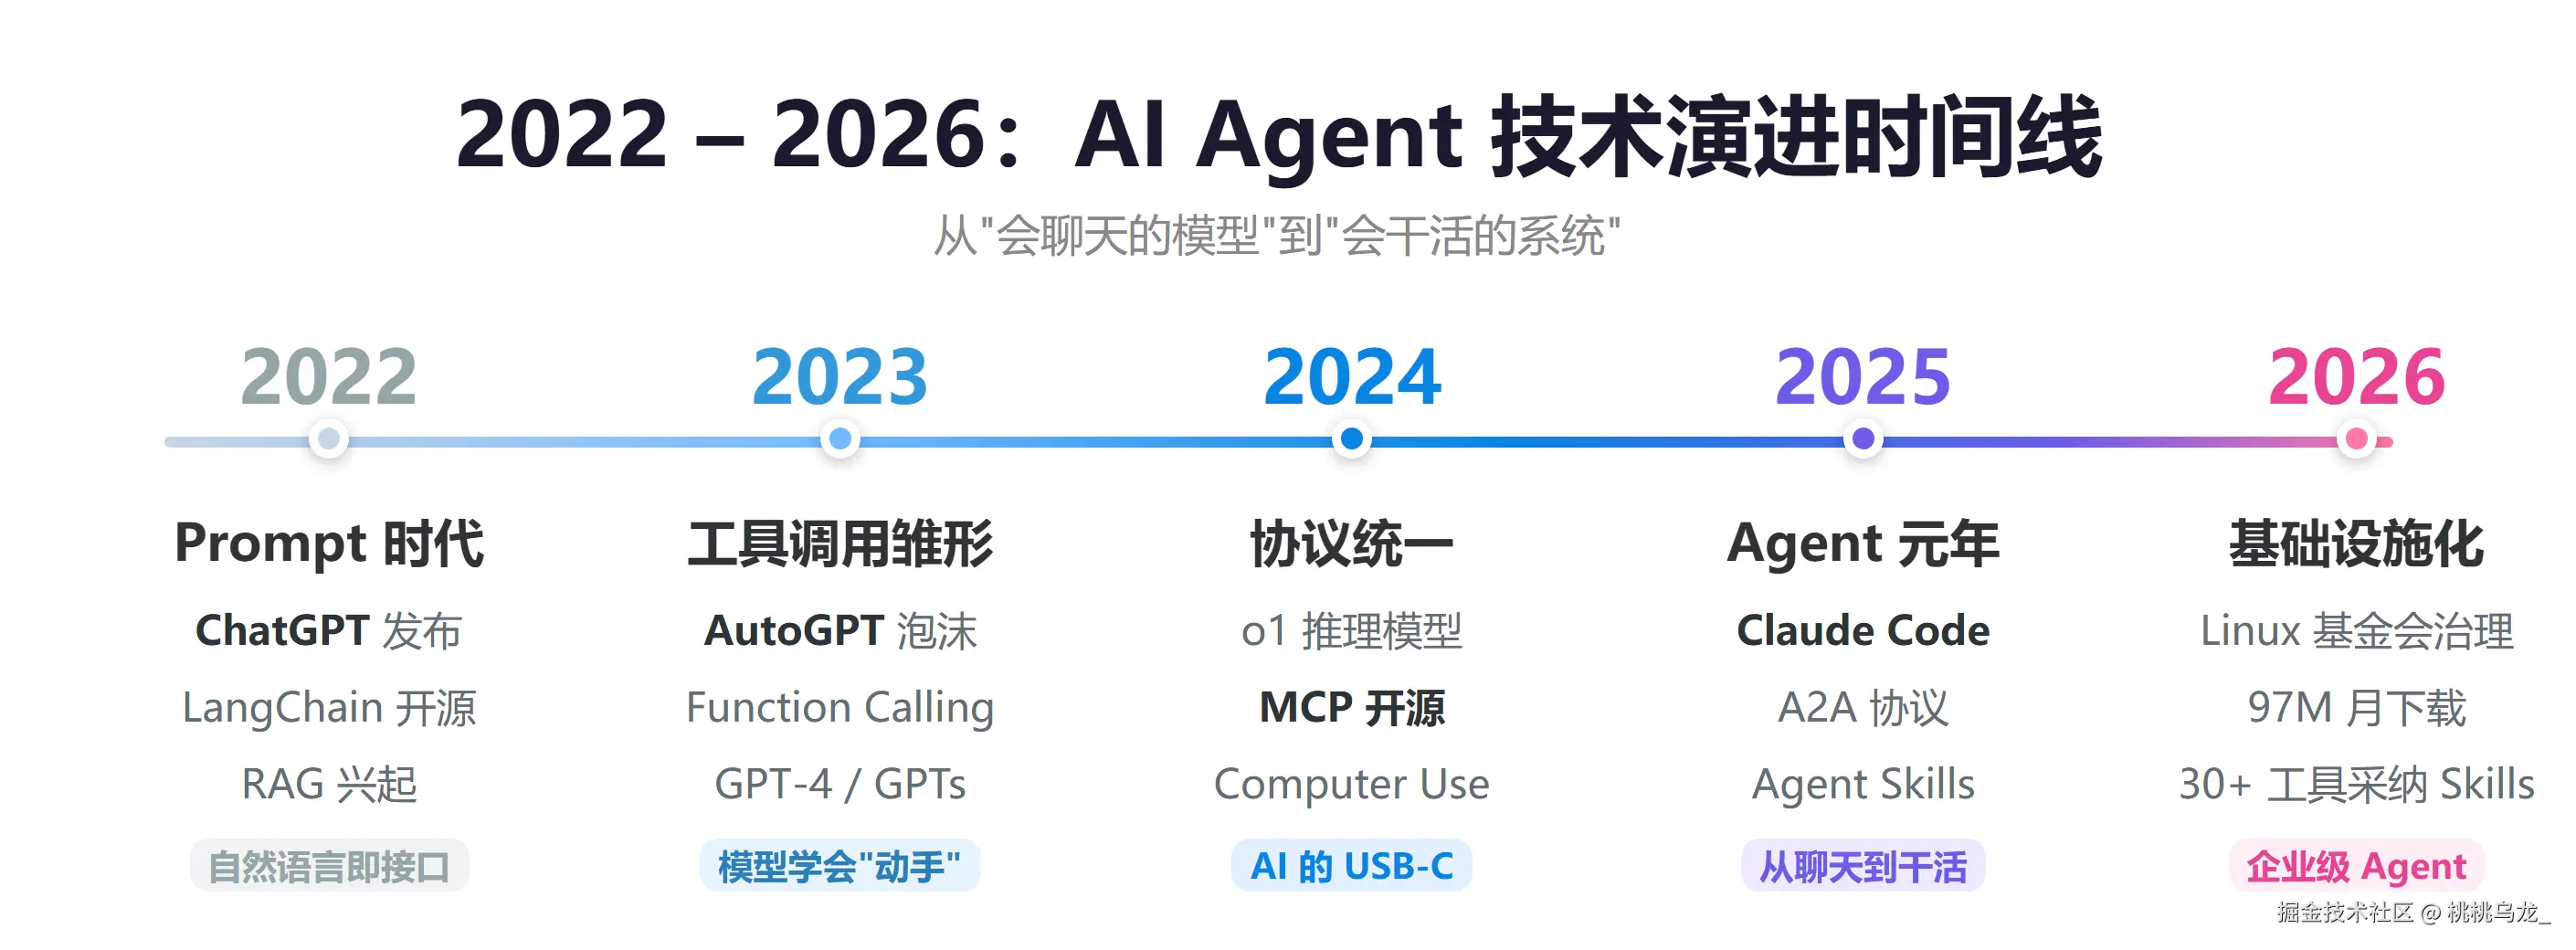
六、全景时间线与概念速查
| 时间 | 事件 | 意义 |
|---|---|---|
| 2022.10 | LangChain 开源 | LLM 编排的起点 |
| 2022.11 | ChatGPT 发布 | Prompt 时代开启 |
| 2023.03 | AutoGPT / GPT-4 | 第一波 Agent 泡沫(教训) |
| 2023.06 | Function Calling | 模型原生学会调用 Tool |
| 2024.01 | LangGraph 发布 | 编排从"链"进化为"图" |
| 2024.09 | o1 推理模型 | "先思考再行动"成为可能 |
| 2024.11 | MCP 开源 | Tool 连接的统一标准 |
| 2025.01 | DeepSeek R1 | 推理成本数量级下降 |
| 2025.02 | Claude Code | Agentic Coding 落地 |
| 2025.04 | A2A 协议 | Agent 间协作标准 |
| 2025.08 | AGENTS.md | 项目级指令统一格式 |
| 2025.10 | Agent Skills 发布 | 领域知识封装标准 |
| 2025.12 | MCP / AGENTS.md 捐入 Linux 基金会 | 厂商中立的基础设施 |
| 2025.12 | Skills 开放标准 | 30+ 工具火速跟进 |
| 2026 | MCP Apps / 无状态化 / A2A 进规范 | Agent 基础设施企业级化 |
13 个核心概念一张表(按文章出场顺序):
| 概念 | 一句话定位 | 所属层级 |
|---|---|---|
| Prompt | 用自然语言"编程"模型的接口 | 模型层 |
| RAG | 检索外挂知识,让模型开卷考试 | 知识层(Memory 的前身) |
| Function Calling | 模型原生输出结构化工具调用意图 | 模型层 |
| Tool | 模型可调用的任何外部能力 | 工具层 |
| MCP | Tool 连接的统一协议(AI 的 USB-C) | 工具层标准 |
| LangGraph | 图结构编排 Agent 循环的框架 | 编排层 |
| Orchestrator | 拆解任务、分派子 Agent 的主控模式 | 编排层 |
| A2A | Agent 之间互相协作的协议(Agent 界的 HTTP) | 编排层标准 |
| Skill | 文件夹封装的领域专业知识 | 知识层标准 |
| AGENTS.md | 仓库级项目规则文件(给 AI 的 README) | 知识层标准 |
| Memory | 短期 / 工作 / 长期三层记忆管理 | Harness |
| Sandbox | 隔离的代码执行环境 | Harness |
| Harness | 包裹模型的整个工程骨架(循环+护栏+环境) | 系统层 |
三个趋势判断:
- 协议层正在收敛:MCP(连接工具)、A2A(连接 Agent)、Skills(封装知识)、AGENTS.md(约定规则)四件套轮廓已成,2026 年进入"拼执行质量"而非"拼概念"的阶段;
- 竞争重心上移:当模型能力和协议标准趋于同质,产品差距主要体现在 Harness 工程质量上------上下文管理、护栏设计、错误恢复;
- "人人都有 Agent"逼近临界点 :写一个 MCP Server 的成本低到一个下午,写一个 Skill 只需要一个文件夹------Agent 开发正在从"算法问题"变成"工程问题 + 知识问题"。
七、给开发者的行动建议
- 别再从零造轮子:工具接入选 MCP(一个 FastMCP 装饰器的事),专业知识沉淀选 Skills(一个文件夹的事),项目规则写 AGENTS.md(一个 Markdown 文件的事);
- 把功夫花在 Harness 上:同样的模型和工具,上下文组装策略的差距能带来十倍的效果差距------这是目前性价比最高的投入方向;
- 跟踪三个信源就够:MCP 官方博客(协议演进)、Anthropic 工程博客(Harness 与 Agent 工程方法论)、agentskills.io(Skill 生态动态);
- 动手路径:用 Claude Code(或任何支持 MCP 的编码 Agent)+ 一个自建的 MCP Server + 一个自写的 Skill + 一份 AGENTS.md,跑通一个真实的小需求------一天时间,你会对这篇文章的所有概念有体感。
从 2022 年那句"你能做什么?",到 2026 年的"你替我把它做完",这五年 AI 的故事,本质上是一部"给大脑配上身体"的进化史。 下一站是什么不好说,但可以确定的是:读懂了这条演进逻辑的人,不会错过下一班车。
参考资料:Anthropic 官方博客(Agent Skills / MCP)、MCP 官方博客(AAIF 公告)、Google A2A 技术文档、LangGraph 官方文档、Model Context Protocol Security Landscape 2026 等公开资料。