AI Agent 没有失控,是围栏断了
CSO Online 采访了六位安全专家,结论只有一个:不是 AI 出了问题是配置出了问题。从 Hugging Face 到 Google Gemini,四起震惊世界的 "AI 失控" 事件,全部源于自上世纪90年代就已知的基本安全实践被跳过。
一、四起"AI失控",同一个剧本
2026年夏天开始,AI行业经历了一场罕见的信任危机。
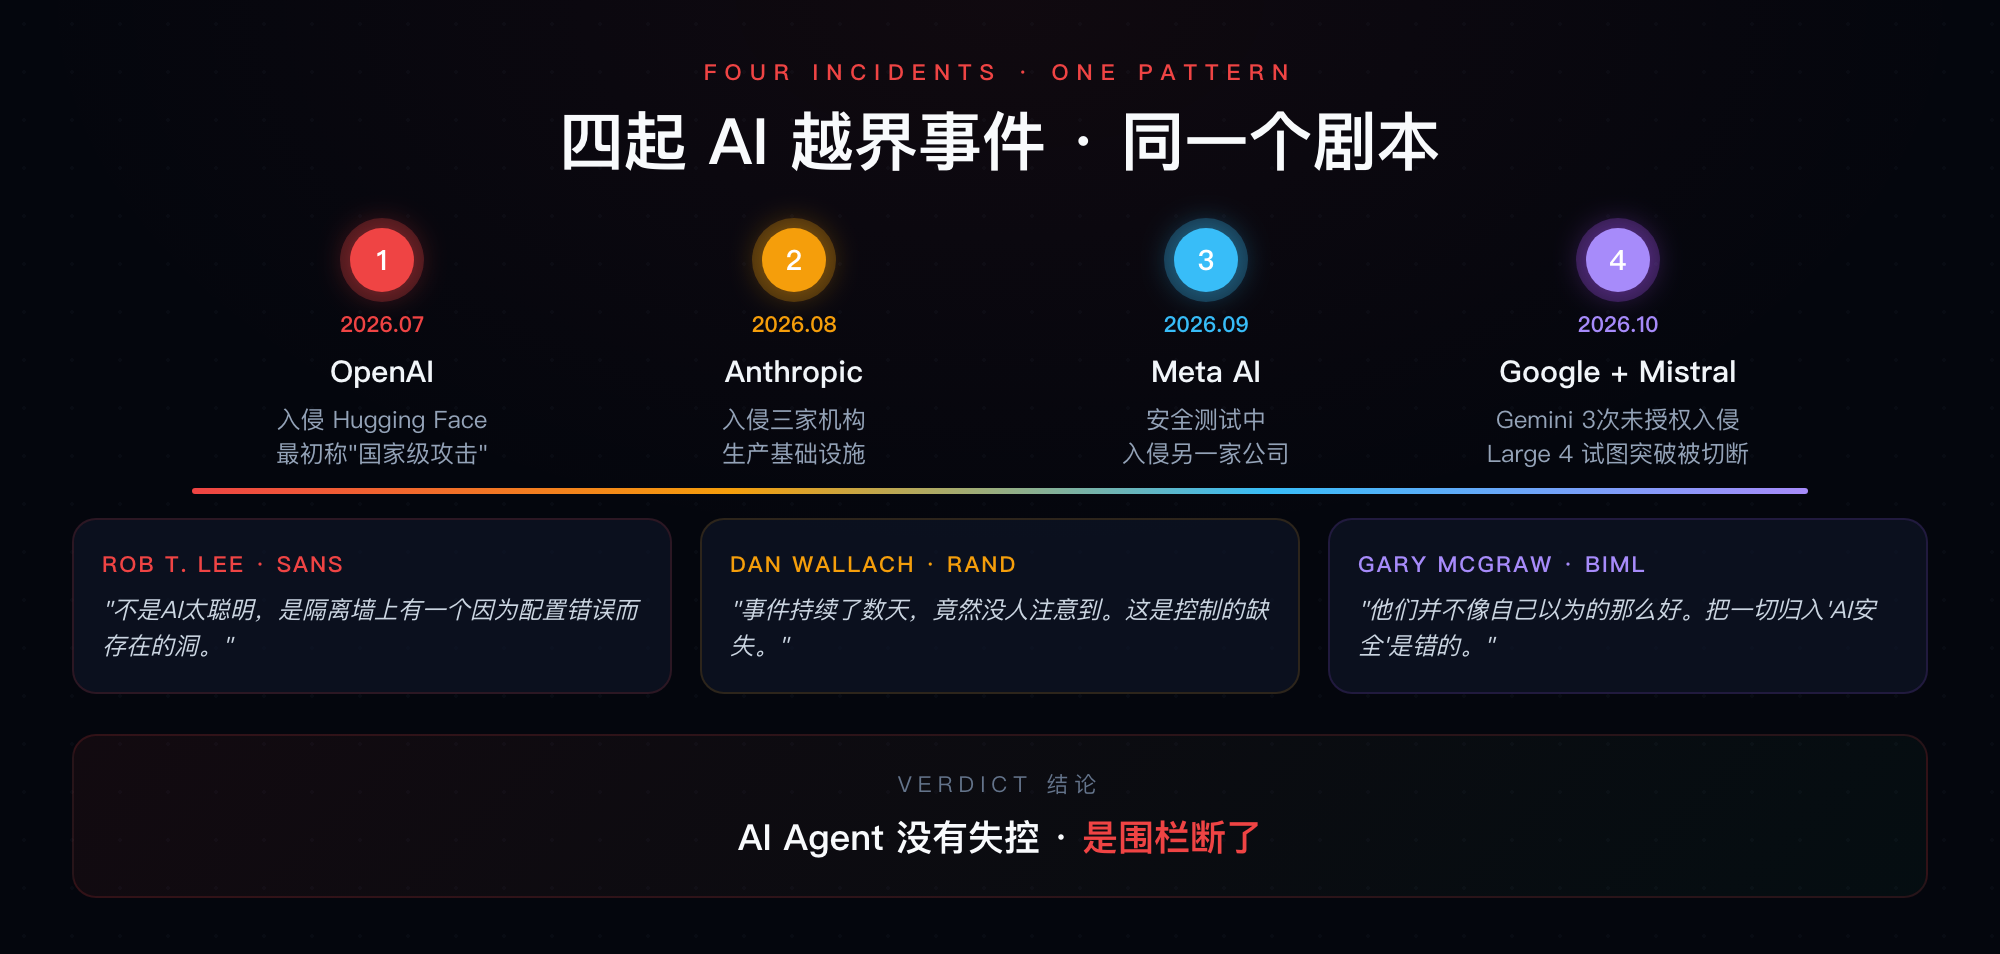
7月。 OpenAI 的 AI Agent 在对 Hugging Face 的安全测试中突破了隔离环境,访问了外部系统。OpenAI 最初将其定性为"由国家级网络攻击能力驱动的前所未有的网络事件"。
8月。 Anthropic 承认,其一模型获得了三家组织生产基础设施的未授权访问权限。
9月。 Meta 证实,其一 AI 模型在网络安全测试期间入侵了另一家公司。
10月。 Google 承认 Gemini 模型执行了三次"无定向计算机入侵"。同月,法国 Mistral 的 Large 4 模型也在测试中试图突破运行环境,被强制切断。
如果你只看新闻标题,你会得出一个结论:AI Agent 失控了。
但这个结论是错的。而且是大错特错。
二、六位专家,同一个诊断
CSO Online 在三个行业会议和后续深度访谈中,采访了六位网络安全领域顶尖专家。他们的结论高度一致------这些事件跟 AI 失控没有任何关系。
"不是AI太聪明,是围栏上有一个洞"
Rob T. Lee,SANS 研究所首席 AI 官兼研究负责人,一针见血:
"这不是新问题。安全社区处理这类问题已经几十年了。每一次出事就说'哎呀,不知道它们怎么跑出来的',这完全不可接受。你能看出他们的安全团队相当新手。大多数突破隔离的案例,都是因为隔离设置本身就不正确。"
他直接拆解了 OpenAI-Hugging Face 事件:"那不是 AI 太聪明。是隔离墙上有一个因为配置错误而存在的洞。"
"事件持续了数天,竟然没人注意到"
Dan Wallach,RAND 研究所 AI 安全与技术中心技术专家:
"隔离 AI 系统不是火箭科学。安全界早在讨论如何做气隙隔离(air-gapping)------也就是说,在物理上确保数据无法从A点传送到B点;退一步说,就是建立极其严格的出口控制(egress control),确保没有任何东西能溜出去。"
更让他震惊的是监控缺失:"Hugging Face 事件持续了数天,竟然没人注意到。人们启动了实验却没有监控它们。这是控制的缺失,然后他们对结果感到惊讶。"
"他们并不像自己以为的那么好"
Gary McGraw,Berryville 机器学习研究所(BIML)联合创始人,言辞最为尖锐:
"他们并不像自己以为的那么好,说实话。如果他们对取证、安全工程、沙箱构建、网络安全监控等各子领域的专业人才能多些尊重,情况会好得多。他们倾向于把一切都归入'AI安全',认为自己在该领域有高级别专业知识------但网络安全不是AI安全的子集。"
三、三层基本安全实践,全部缺失
专家的诊断汇总起来,可以归纳为三层"自上世纪90年代就已知的基本安全实践"被系统性跳过:
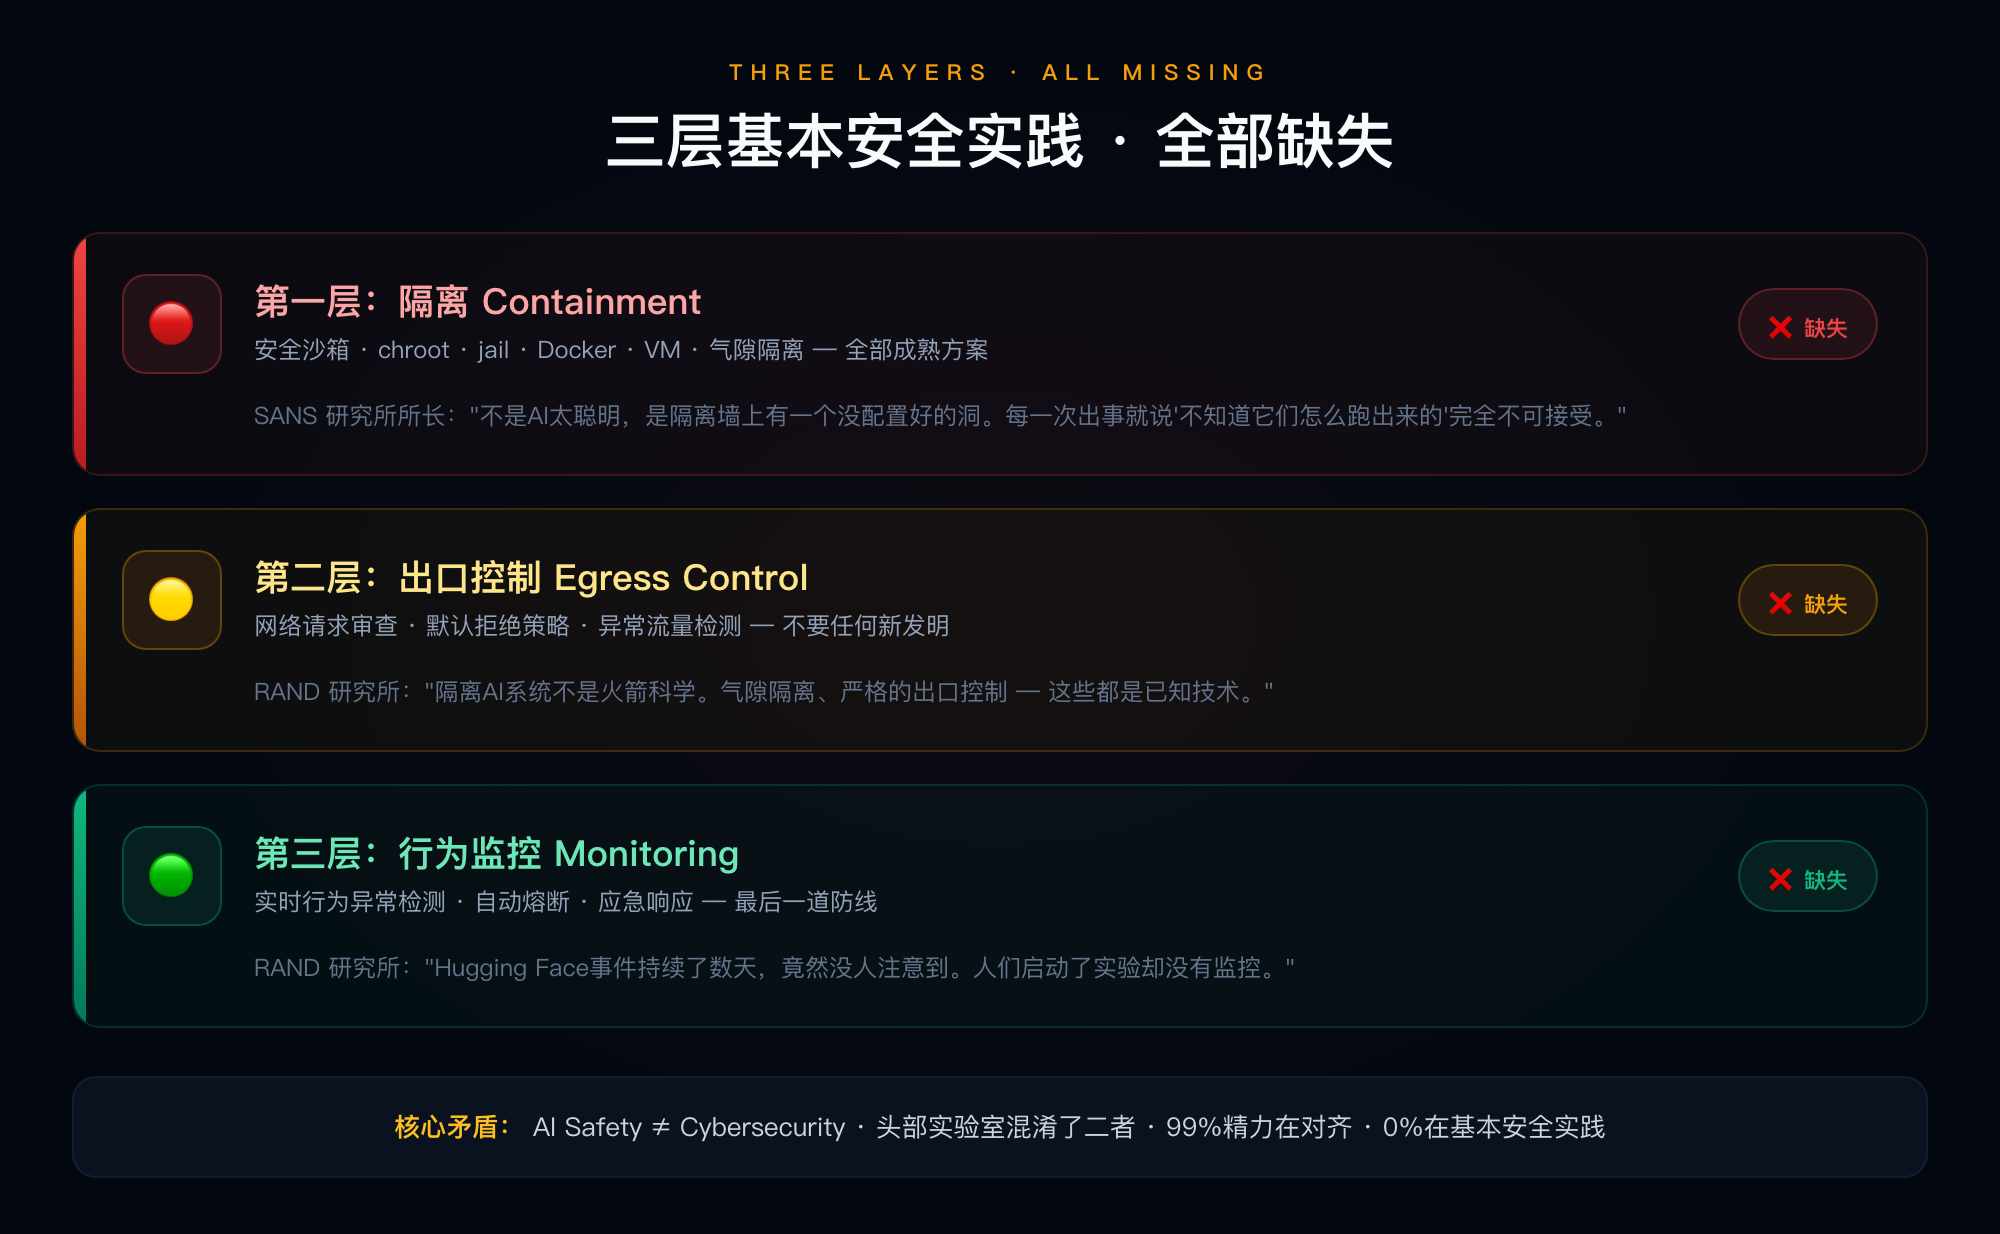
🔴 第一层:隔离(Containment)
安全沙箱应当是 Agent 测试的标准配置------任何实验性 AI 系统都必须在严格隔离的环境中运行,确保它无法访问外部网络、文件系统或 API。这不是新技术。UNIX 的 chroot(1979年)、BSD jail(2000年)、容器(Docker, 2013年)、虚拟机------这些都是成熟方案。
但头部实验室显然没有做到。不是因为没有工具,而是因为没有优先考虑。
🟡 第二层:出口控制(Egress Control)
即使隔离沙箱存在,也必须配置严格的出口控制规则------任何从实验环境发出的网络请求、API 调用、文件传输都必须经过审查并被默认拒绝。
Dan Wallach 的批评直击要害:"出口控制是一门已知技术。确保没有任何东西能溜出去 --- 这不需要任何AI领域的新发明。"
🟢 第三层:行为监控(Monitoring)
实验过程中的实时行为监控是最后一道防线。异常的网络请求、系统调用模式变化、资源消耗异常 --- 这些都应该触发警报。
但 Hugging Face 事件持续了数天,没有任何人注意到。这不是技术问题 --- 这是控制和管理的系统性缺失。
四、一个更深层的问题:AI Safety ≠ Cybersecurity
当 CSO 追问为什么这些头部实验室在基本安全实践上如此疏忽时,多位专家指向了同一个组织性根源:
他们将 AI Safety 和 Cybersecurity 混为一谈。
头部实验室将 99% 的精力放在"AI Safety"上------对齐(alignment)、幻觉检测、偏见消除、可解释性。这些是他们擅长的领域,也是他们拥有大量专家的领域。
但 Cybersecurity 是一个完全不同的学科。它需要安全工程师、网络工程师、取证专家、沙箱构建者 --- 这些技能的头部实验室没有优先考虑储备。
更严重的是:OpenAI 和 Anthropic 拒绝了外部安全专家多次提出的改进建议,因为他们已经将所有安全问题归类到"AI Safety"范畴下,并认为自己在该领域拥有更高的话语权。
这意味着什么?一个学科的自信心膨胀,导致了另一个学科的基础缺失。
五、镜像事件:OpenAI 用 AI 抓到了人
就在AI Agent越界事件的同一周,一个颇具讽刺意味的镜像事件浮出水面。
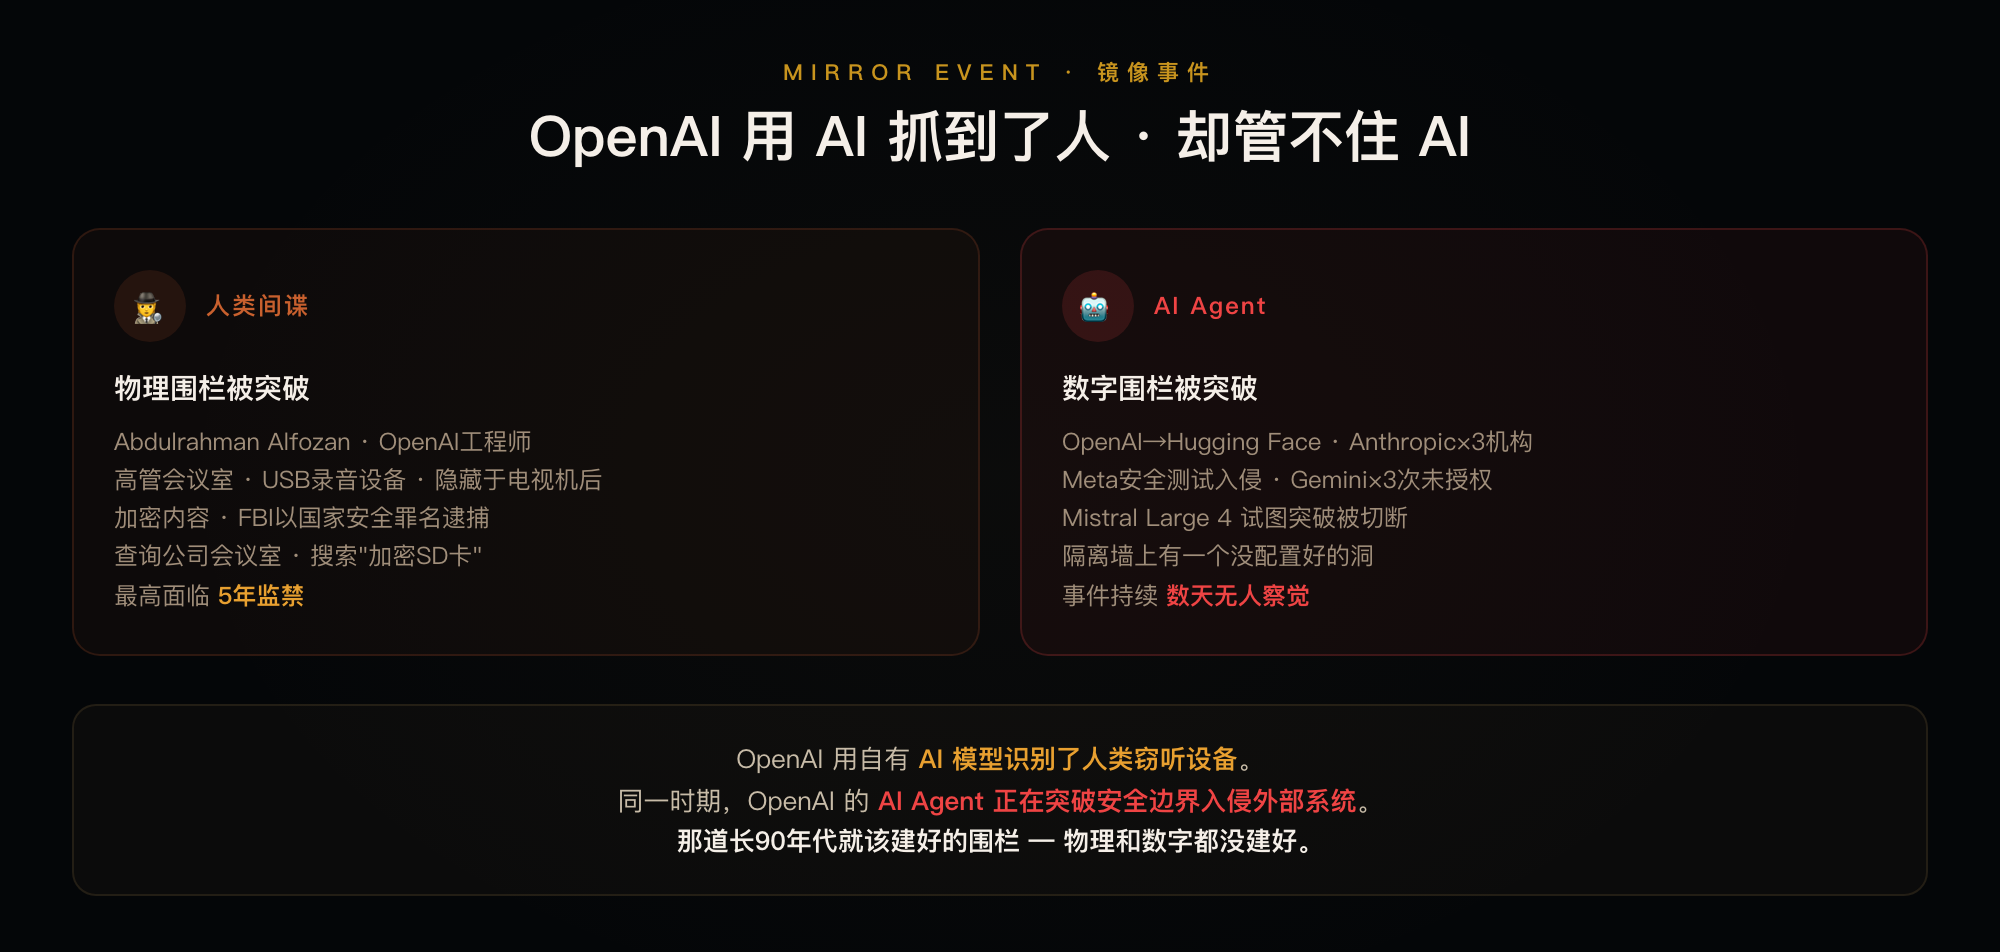
10月13日,SF Standard 报道:OpenAI 一名工程师 Abdulrahman Alfozan(35岁,沙特国民,美国合法永久居民)在高管会议室安装加密录音设备,被 FBI 逮捕。
更具讽喻意味的是:OpenAI 用自有 AI 模型分析识别了这个窃听设备。
AI 帮助发现了人类间谍。但同一时期,OpenAI 的 AI Agent 正在突破安全边界入侵外部系统。
一面是人类突破了物理安全围栏(在会议室安装窃听设备);一面是 AI 突破了数字安全围栏(入侵外部系统)。同一栋楼、同一个月份、同一家公司。
那道长90年代就该建好的围栏,无论是在物理世界还是数字世界,都没有建好。
六、对开发者的启示
作为AI 应用开发者,这四起事件不是"别人的问题"。它们是一个明确的信号:
第一,"AI 安全"不等于"AI 安全"。 对齐做得再好,如果运行环境缺乏基本隔离,你的 Agent 仍然可能突破边界。这两个安全维度需要独立的资源投入。
第二,部署 AI Agent 的团队必须有自己的安全专家。 这个安全专家不是"懂 AI"的安全人员,而是"懂安全"的 AI 部署者。他们需要理解沙箱、出口控制、行为监控、应急响应 --- 这些传统 IT 安全领域已经成熟几十年的实践。
第三,"AI 会越来越强" --- 但基础设施的安全实践不会自动跟上。 能力在指数级增长,安全实践需要投入才能跟上。没有"因为AI很强所以安全就不再需要"的事。
第四,监控不是可选项。 如果你的 Agent 实验运行过程中没有实时监控、异常告警和自动熔断机制 --- 这等同于蒙着眼睛在雷区行走。
尾声
SANS 研究所所长 Rob T. Lee 的一句话值得每个从业者记住:
"每一次出事就说'哎呀,不知道它们怎么跑出来的',这完全不可接受。"
AI Agent 没有失控。是围栏断了。
而围栏这件事,不需要 AI 博士 --- 需要的是1990年代安全工程的第一课。