Redis运行状态总靠手动查?我用redis_exporter+Prometheus把指标、告警和远程抓取全接起来了
前言
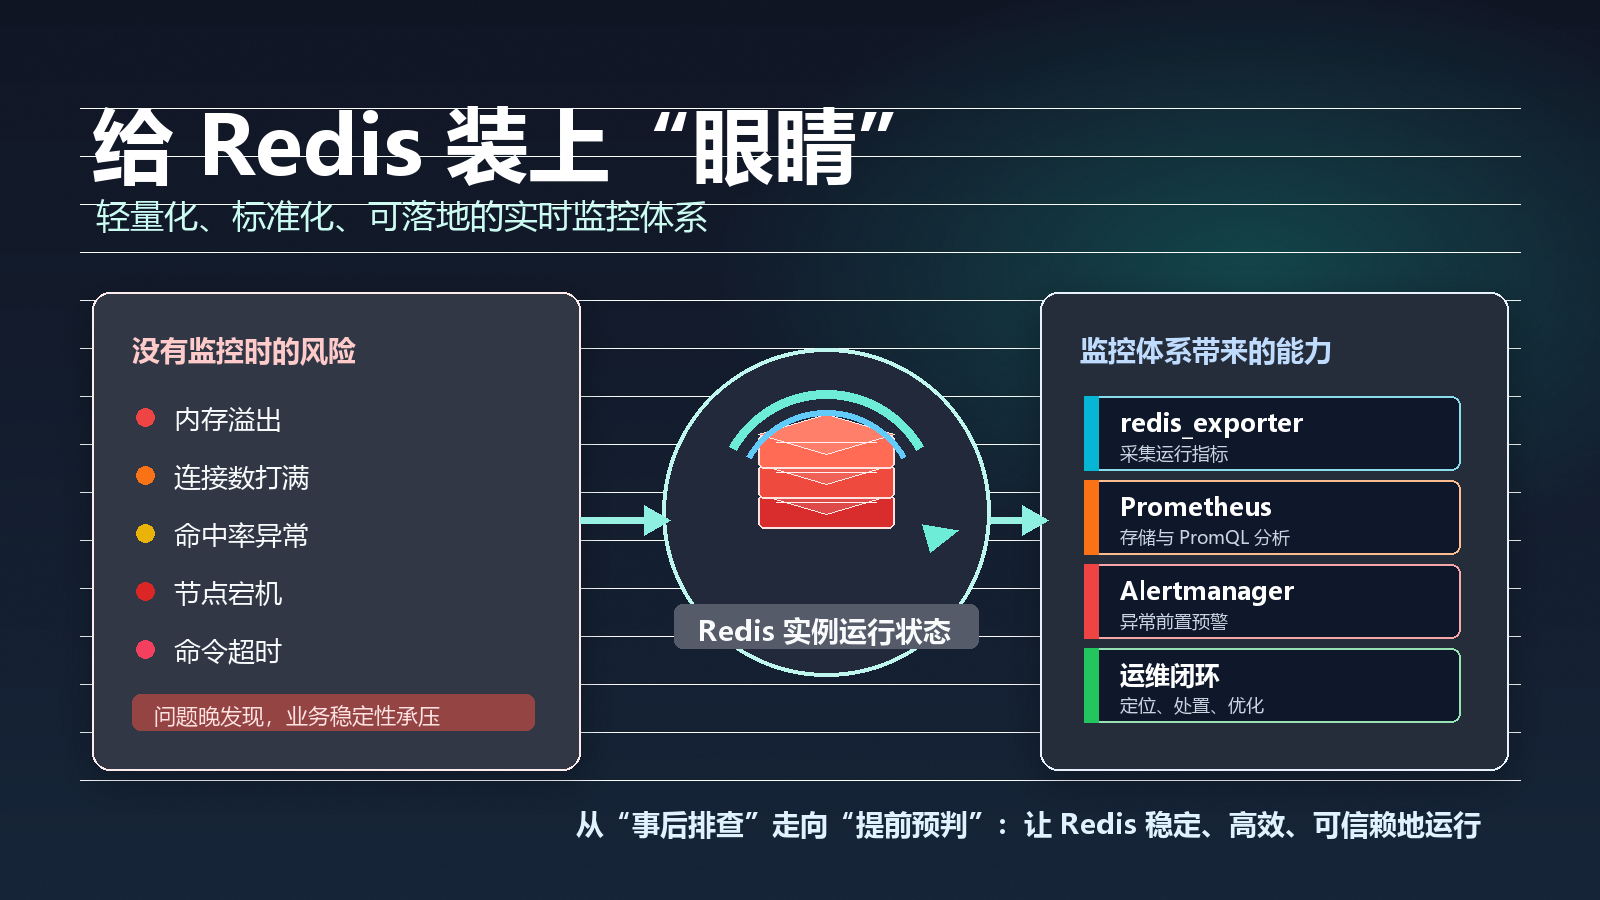
Redis平时跑得很快,但一旦出现内存异常、连接数上涨、实例无响应或主从状态变化,仅靠临时登录服务器查INFO和日志,很难形成连续监控。真正需要的是一条长期运行的链路:有人负责采集Redis指标,有人负责保存和查询这些指标,还要能在达到条件时触发告警。
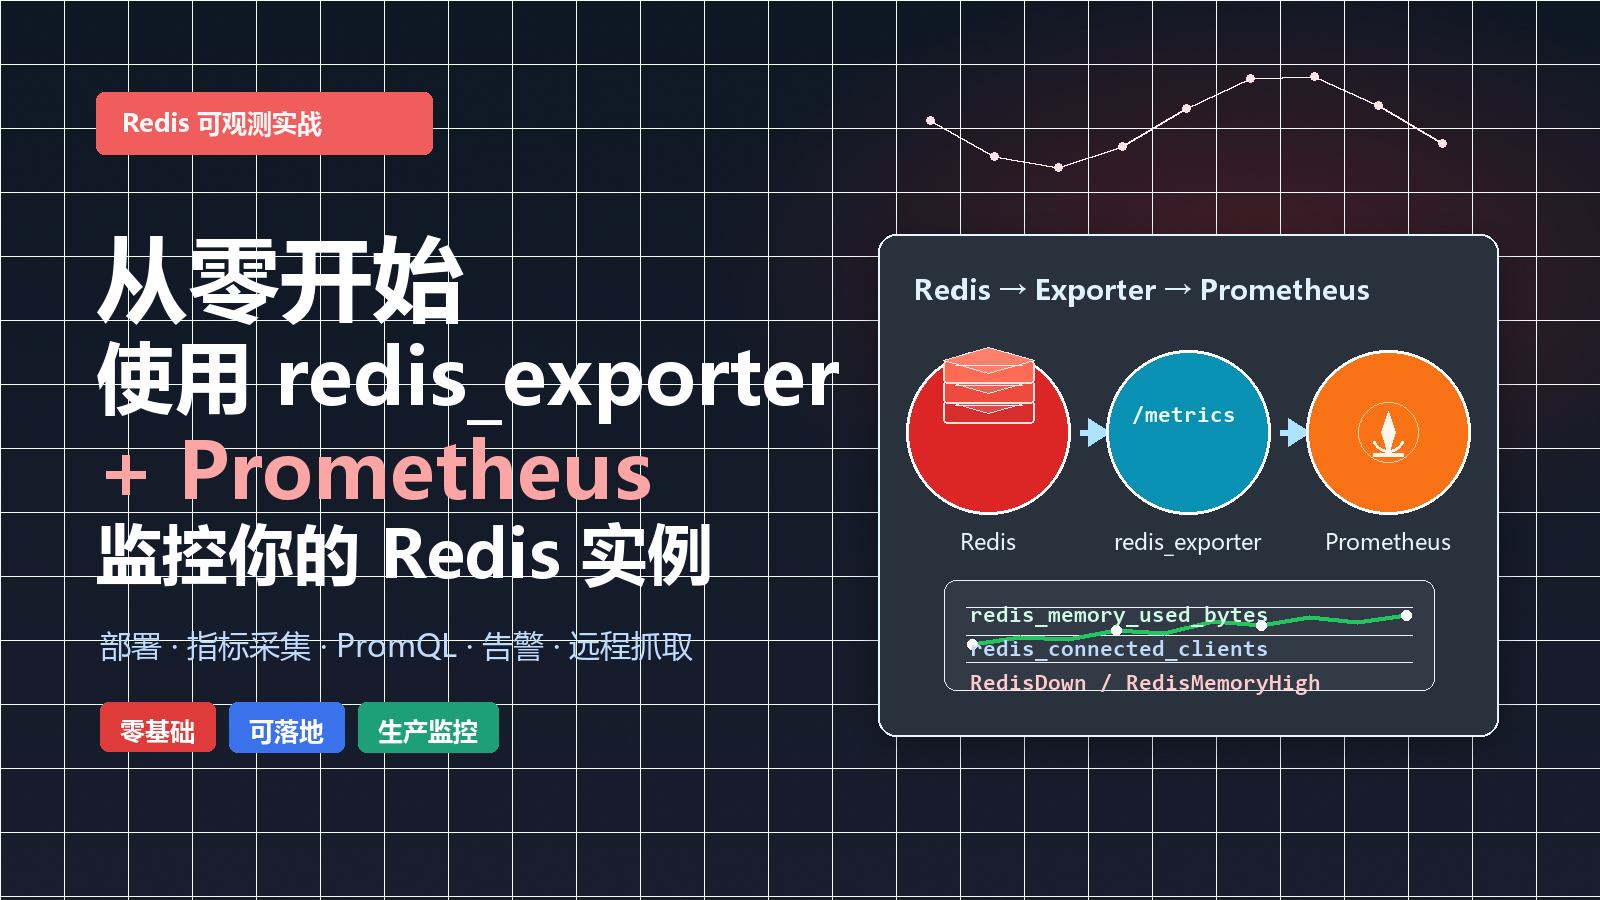
这次我用redis_exporter负责采集Redis运行数据,通过9121端口暴露Metrics;再部署Prometheus,把redis_exporter加入抓取目标,并实际确认Target可以正常采集。
在监控链路跑通以后,再增加Redis实例宕机、内存使用率、连接数和主从复制状态等告警规则。
最后继续把redis_exporter的9121提供给另一网络中的Prometheus抓取,并从随机公网地址切换到固定二级子域名。这样整篇就形成一条清晰的链路:Redis → redis_exporter → Prometheus → 告警规则 → 跨网络抓取。
这类监控最容易踩的坑,是只看到"某个进程启动成功",却没有继续验证数据到底有没有真正流到下一层。Exporter能启动,不代表Prometheus一定抓得到;Prometheus能打开,也不代表告警规则已经生效。因此这次每一段都尽量保留一个明确的验证点。
另外,远程监控也不直接暴露Redis业务端口,而是只把Exporter的Metrics入口提供给另一端Prometheus。这样业务访问和监控采集仍然分开,结构会更清楚。
1 先把redis_exporter和Prometheus的分工弄清楚
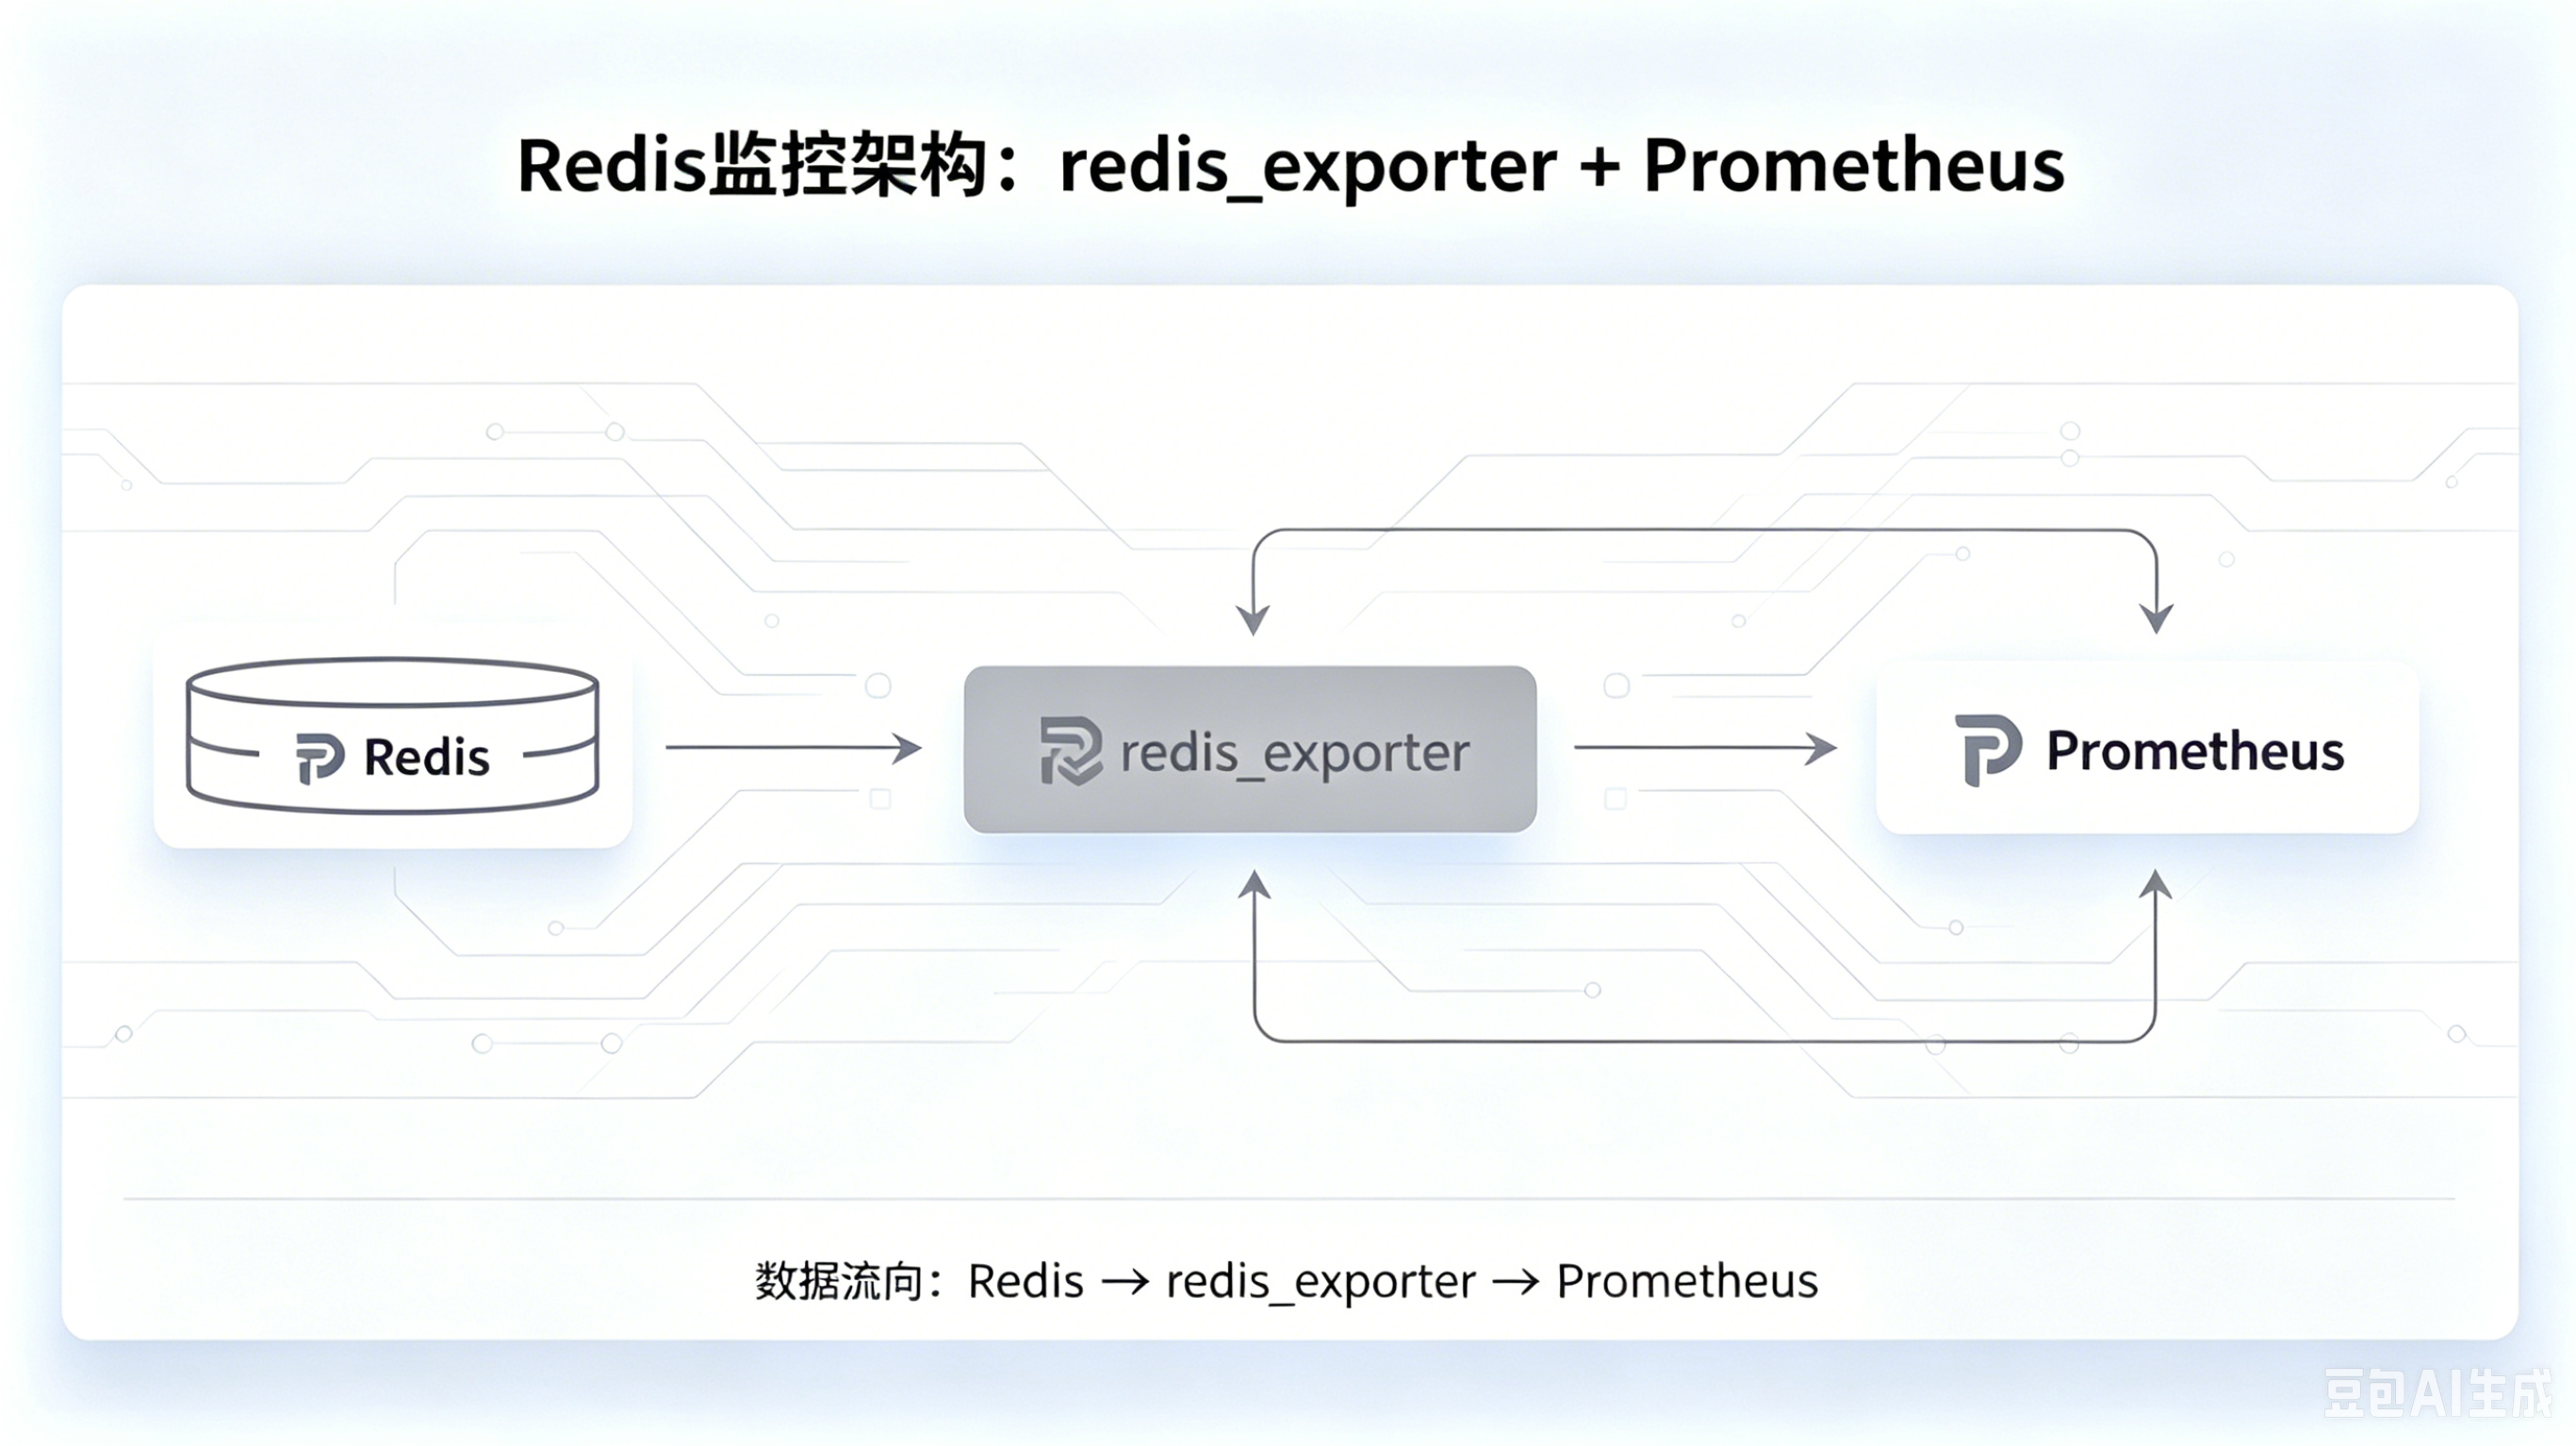
Redis本身提供了大量运行信息,但Prometheus不能直接把这些原生信息当作自己的监控指标来抓取。
redis_exporter负责做中间转换:
Redis运行数据 → redis_exporter → Prometheus Metrics
Prometheus再负责:
- 定时抓取;
- 保存时序数据;
- PromQL查询;
- 告警规则判断。
所以整套监控真正依赖的是两个端口:
- Redis实例:
6379 - redis_exporter Metrics:
9121
2 redis_exporter能采集哪些内容
这类Exporter比较适合持续采集:
- Redis内存使用;
- 客户端连接数;
- Key数量和过期数据;
- 命令调用情况;
- RDB / AOF状态;
- 网络流量;
- 主从复制状态;
- 集群或哨兵相关指标。
它不修改Redis业务数据,作用主要是:
把Redis运行状态转成Prometheus能抓取的指标。
3 下载redis_exporter
这次使用:
redis_exporter v0.21.2
先下载:
shell
wget https://github.com/oliver006/redis_exporter/releases/download/v0.21.2/redis_exporter-v0.21.2.linux-amd64.tar.gz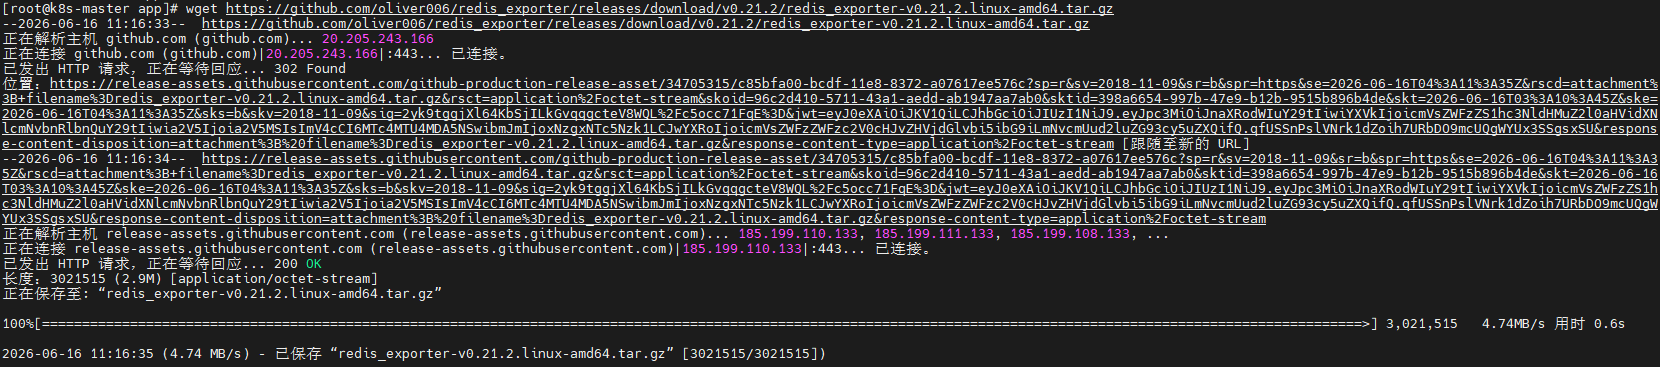
下载完成后解压:
shell
tar -zxvf redis_exporter-v0.21.2.linux-amd64.tar.gz
4 根据Redis连接方式启动redis_exporter
如果Redis设置了密码,使用:
shell
nohup ./redis_exporter -redis.addr 你的redis的ip:6379 -redis.password 密码 -web.listen-address :9121 &如果Redis没有密码,使用:
shell
nohup ./redis_exporter -redis.addr 你的redis的ip:6379 -web.listen-address :9121 &如果Redis和redis_exporter部署在同一台服务器,可以直接连接:
localhost:6379
启动:
shell
nohup ./redis_exporter -redis.addr localhost:6379 -web.listen-address :9121 &三种方式最终都把Metrics暴露在:
9121
5 先确认redis_exporter进程存在
执行:
shell
ps -ef|grep redis_exporter
然后直接访问Metrics:
bash
http://服务器ip:9121/metrics页面:
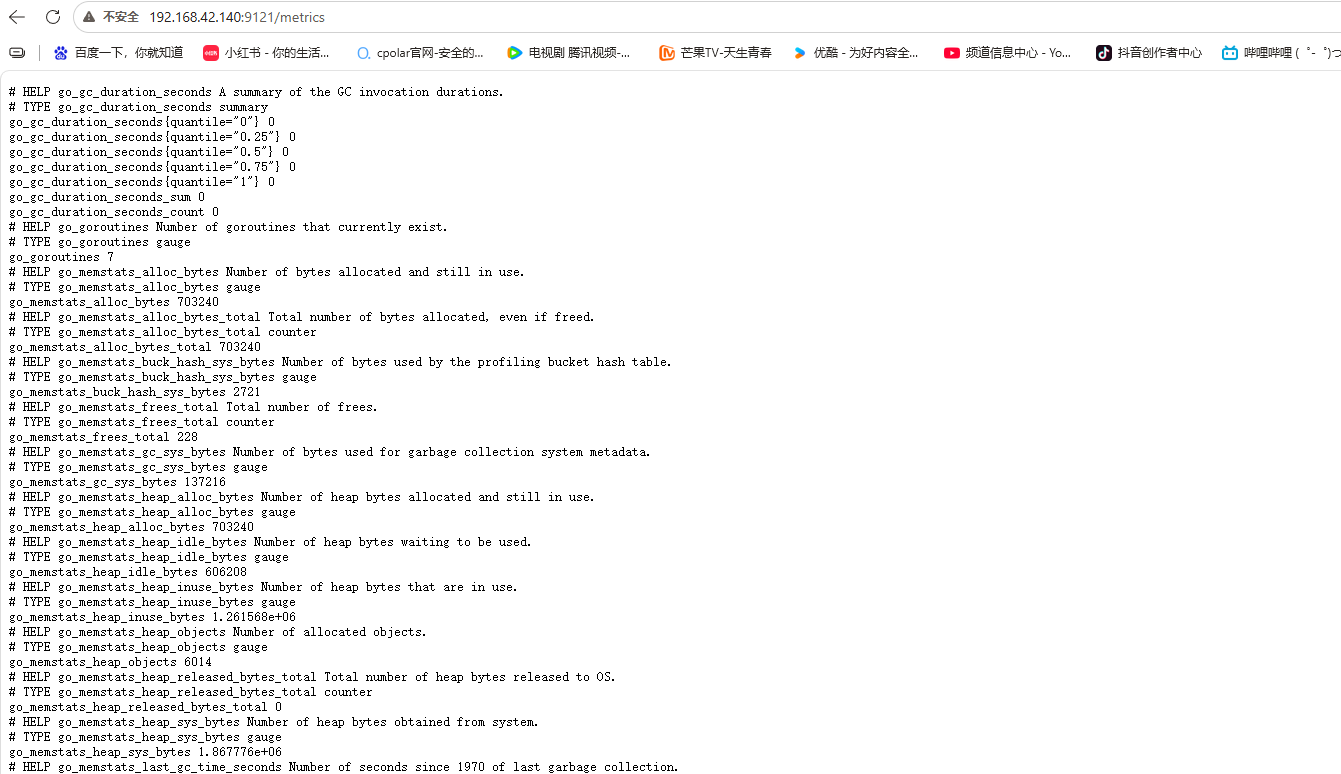
只要这里能看到Prometheus格式的指标数据,就说明:
Redis → redis_exporter → 9121/metrics
已经跑通。
6 准备redis_exporter的systemd服务文件
创建:
shell
vim /usr/lib/systemd/system/redis_exporter.service写入:
shell
[Unit]
Description=Redis Exporter for Prometheus
Documentation=https://github.com/oliver006/redis_exporter
After=network.target

[Service]
Type=simple
User=redis-exporter
Group=redis-exporter
ExecStart=/app/redis_exporter/redis_exporter \
    --redis.addr=redis://localhost:6379 \
    --web.listen-address=:9121 \
    --web.telemetry-path=/metrics
Restart=on-failure
RestartSec=5
StandardOutput=journal
StandardError=journal
SyslogIdentifier=redis_exporter

[Install]
WantedBy=multi-user.target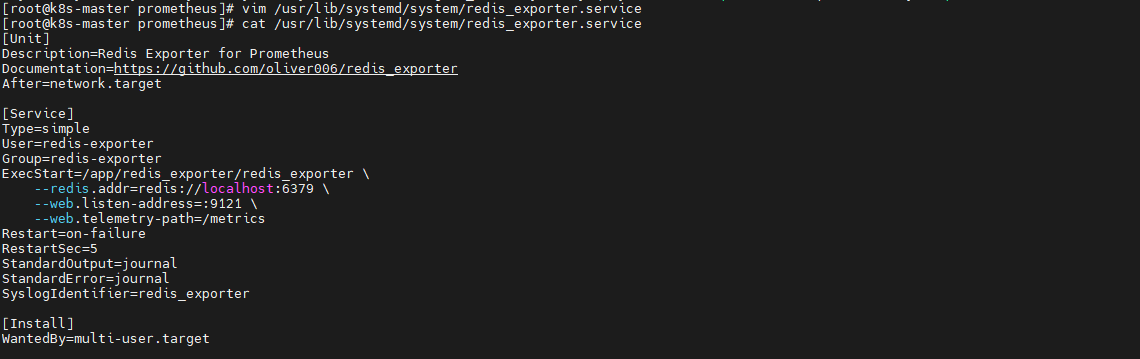
这份服务文件里已经指定:
- 连接Redis:
localhost:6379 - 监听端口:
9121 - Metrics路径:
/metrics - 失败后自动重启。
前面已经用nohup完成过启动验证,这里主要把长期运行需要的服务配置准备好。
随后当前环境继续执行了下面这组服务管理命令:
shell
systemctl enable prometheus
systemctl start prometheus
systemctl status prometheus这里命令操作的是prometheus服务;redis_exporter本身的运行验证仍以前面的进程和9121 Metrics页面为准。
7 接下来安装Prometheus
先创建目录:
shell
mkdir /app进入:
shell
cd /app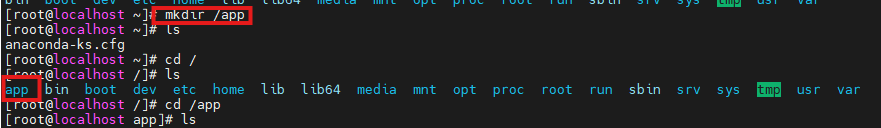
然后下载Linux版本Prometheus:
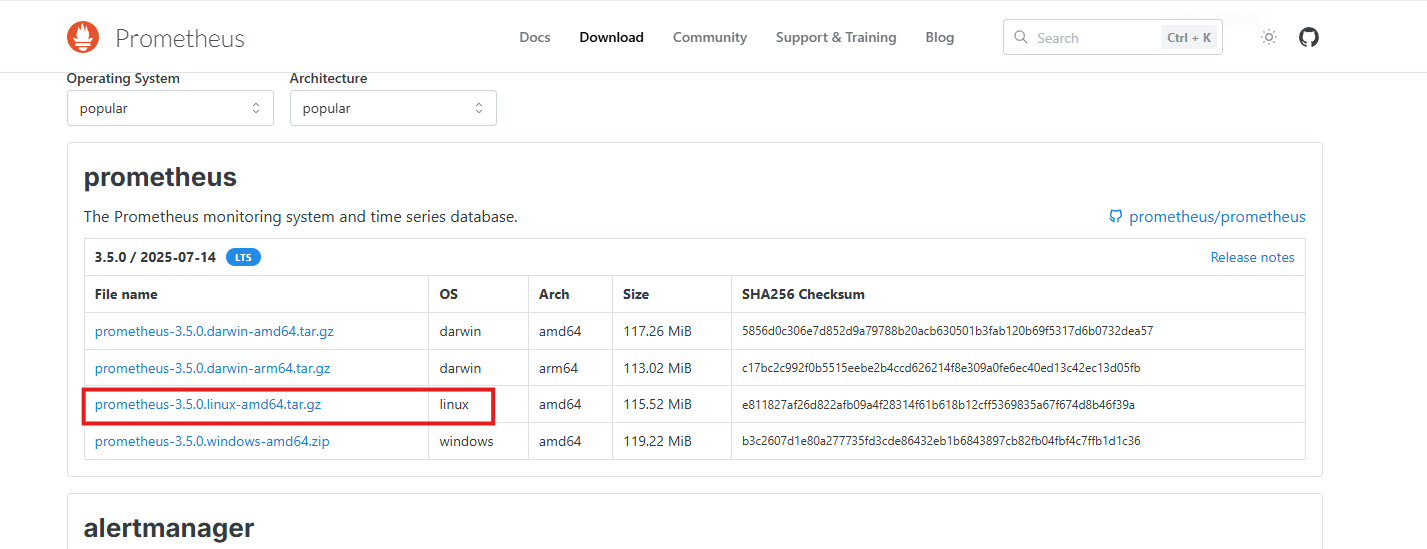
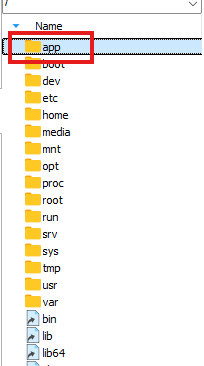
这次使用终端工具把安装包上传到:
/app
点击上传:
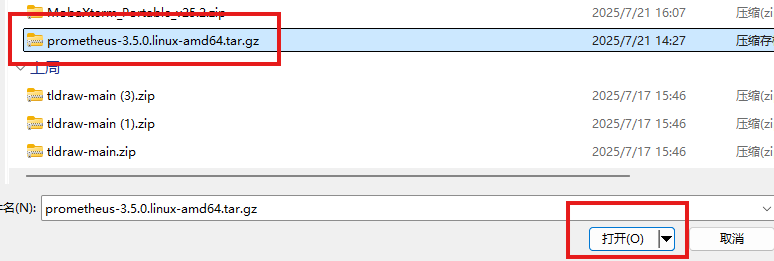
确认文件已经传入:
8 检查文件并解压Prometheus
查看目录:
shell
ls解压:
shell
tar -xzvf prometheus-3.5.0.linux-amd64.tar.gz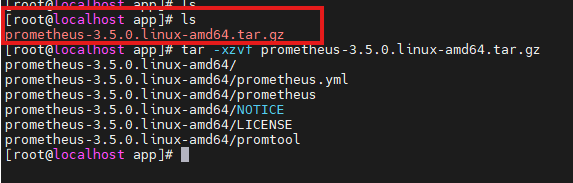
然后改名并删除压缩包:
shell
mv prometheus-3.5.0.linux-amd64 prometheus
rm -rf prometheus-3.5.0.linux-amd64.tar.gz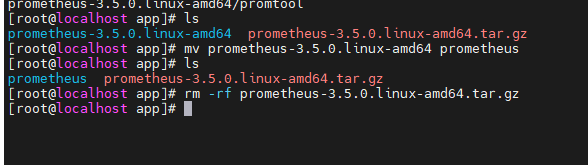
9 确认Prometheus版本
进入Prometheus目录并查看版本:
shell
cd /app/prometheus
./prometheus --version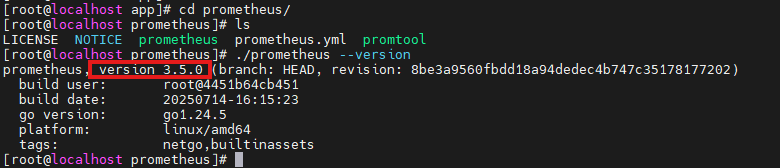
能够正常返回版本信息,说明二进制文件可以运行。
10 创建Prometheus数据目录
执行:
shell
mkdir -p /var/lib/prometheus这里把TSDB数据放到:
/var/lib/prometheus
下一步再交给systemd管理。
11 创建Prometheus systemd服务
编辑:
shell
vim /usr/lib/systemd/system/prometheus.service写入:
shell
[Unit]
Description=Prometheus
Documentation=https://prometheus.io/
After=network.target

[Service]
# Type设置为notify时,服务会不断重启
Type=simple
User=root
# --storage.tsdb.path是可选项,默认数据目录在运行目录的./dada目录中
ExecStart=/app/prometheus/prometheus --config.file=/app/prometheus/prometheus.yml --storage.tsdb.path=/var/lib/prometheus --web.enable-lifecycle
ExecReload=/bin/kill -HUP $MAINPID
KillMode=process
Restart=on-failure

[Install]
WantedBy=multi-user.target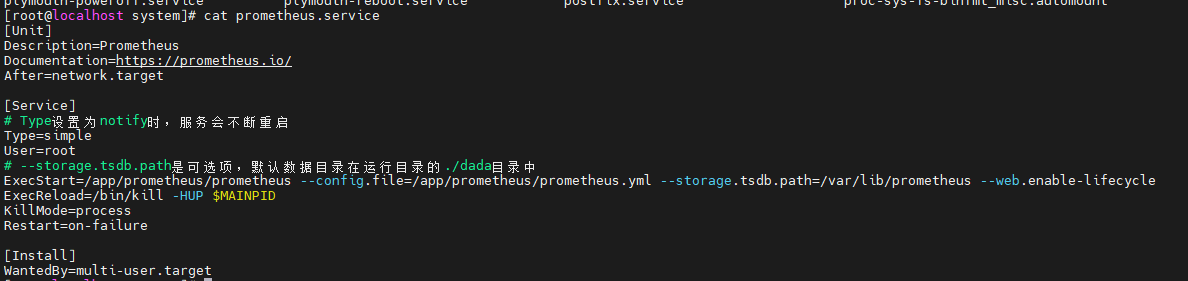
这里指定:
- 配置文件:
/app/prometheus/prometheus.yml - TSDB目录:
/var/lib/prometheus - 开启Web生命周期管理;
- 服务异常后自动重启。
12 启用Prometheus服务
执行:
shell
systemctl enable prometheus
systemctl start prometheus
systemctl status prometheus
随后通过页面检查Prometheus。
当前记录里保留的访问写法是:
shell
ip:9200
后面的Target和告警验证页面使用的是IP:9090访问Prometheus Web界面;实际使用时以你的Prometheus监听端口为准。
13 把redis_exporter加入Prometheus抓取目标
编辑:
shell
vi prometheus.yml加入redis_exporter Target:
shell
      - targets: ["localhost:9121"]
        labels:
          app: "redis_exporter"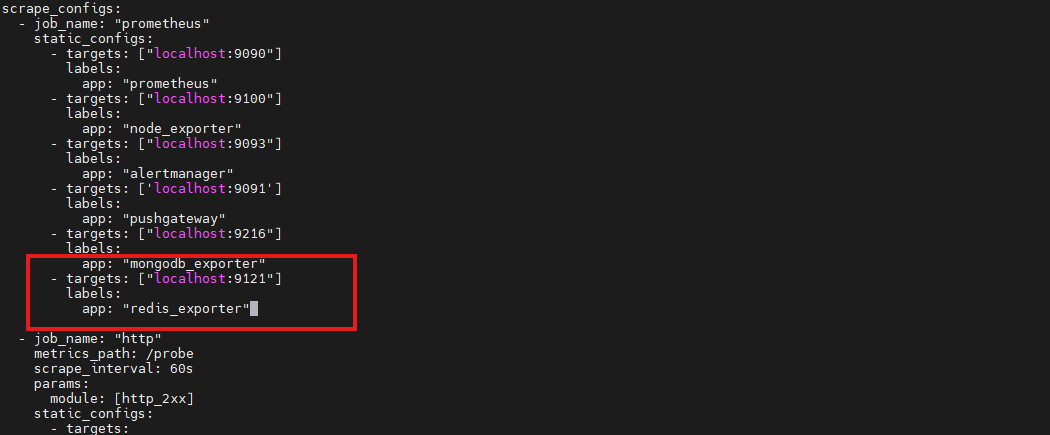
这里Prometheus抓取的是:
localhost:9121
也就是前面已经验证过的redis_exporter Metrics端口。
14 重启Prometheus加载新配置
执行:
shell
systemctl restart prometheus然后通过Prometheus页面检查Target:
继续查看抓取状态:
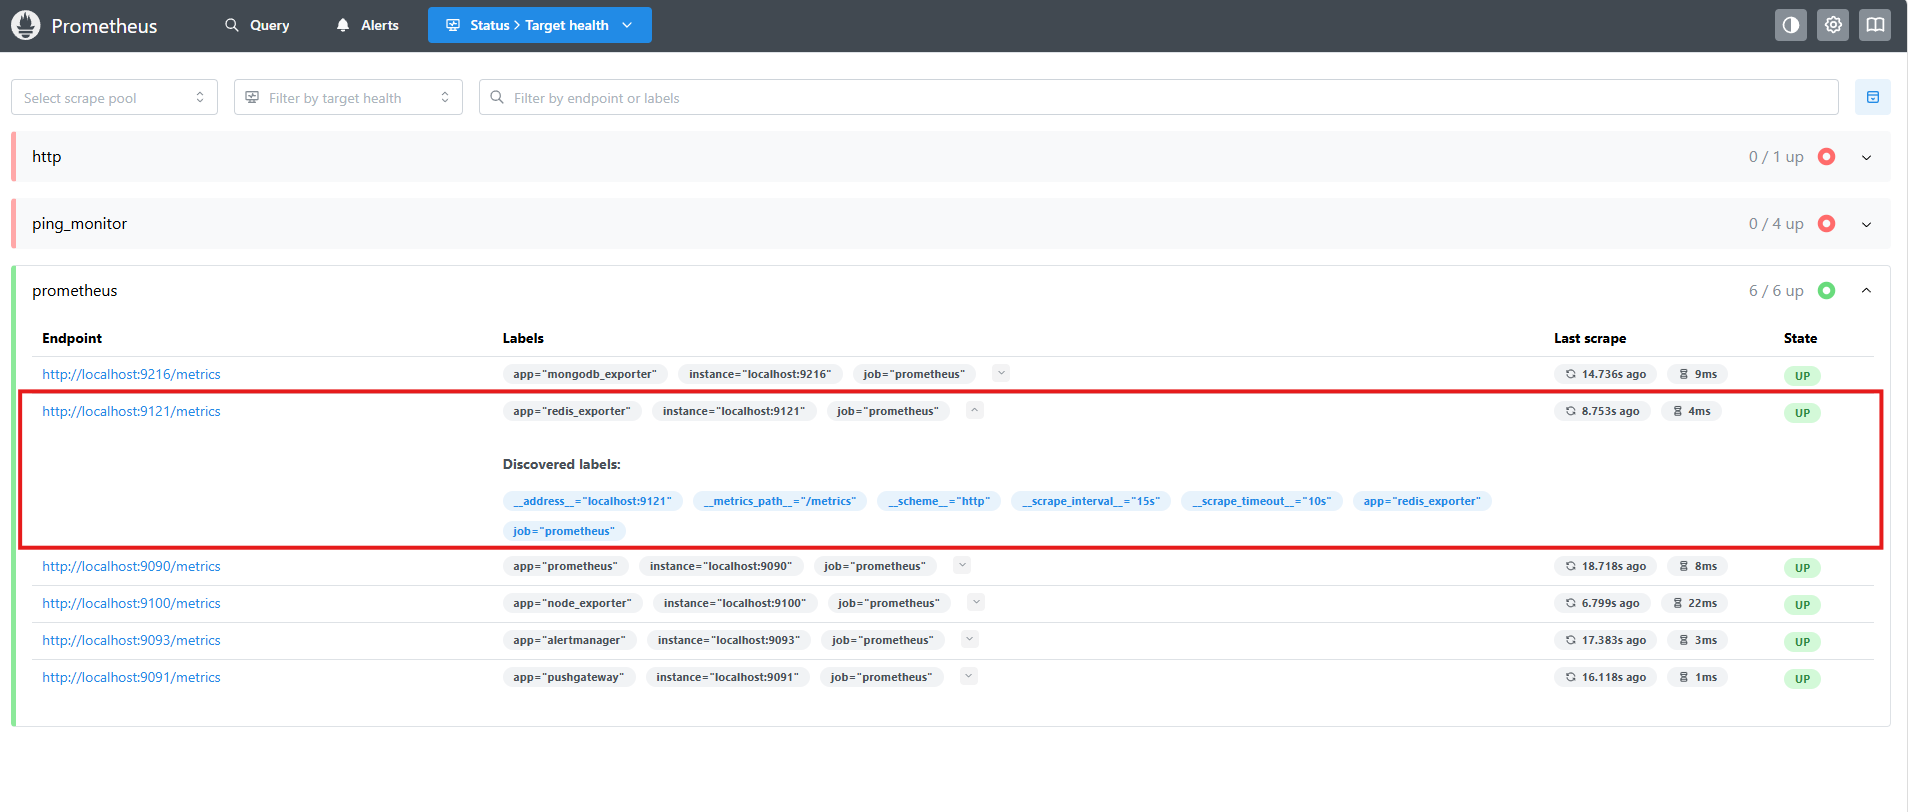
做到这里,可以确认:
Redis → redis_exporter:9121 → Prometheus
已经完整跑通。
15 监控链跑通以后再加告警规则
有指标不等于有告警。
下一步给Redis加一组规则。
这次规则包含:
- Redis实例不可达;
- Redis内存使用率超过85%;
- Redis连接数超过最大连接数的90%;
- 主从复制连接异常。
规则如下:
shell
groups:
  - name: redis-alerts
    rules:
      # Redis 实例宕机(Exporter 无响应)
      - alert: RedisDown
        expr: up{job="redis"} == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Redis instance down"
          description: "Redis instance {{ $labels.instance }} is down for more than 1 minute."

      # Redis 内存使用率过高(>85%)
      - alert: RedisMemoryHigh
        expr: redis_memory_used_bytes{job="redis"} / redis_memory_max_bytes{job="redis"} > 0.85
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Redis memory usage high"
          description: "Redis instance {{ $labels.instance }} memory usage is above 85% (current value: {{ $value | humanizePercentage }})."

      # Redis 连接数接近上限(>90%)
      - alert: RedisTooManyConnections
        expr: redis_connected_clients{job="redis"} / redis_config_maxclients{job="redis"} > 0.9
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Redis too many connections"
          description: "Redis instance {{ $labels.instance }} has too many clients ({{ $value | humanizePercentage }} of max)."

      # Redis 主从复制延迟(仅适用于主从架构)
      - alert: RedisReplicationLag
        expr: redis_slave_info{master_link_status="down", job="redis"} == 1
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Redis replication broken"
          description: "Redis slave {{ $labels.instance }} lost connection to master."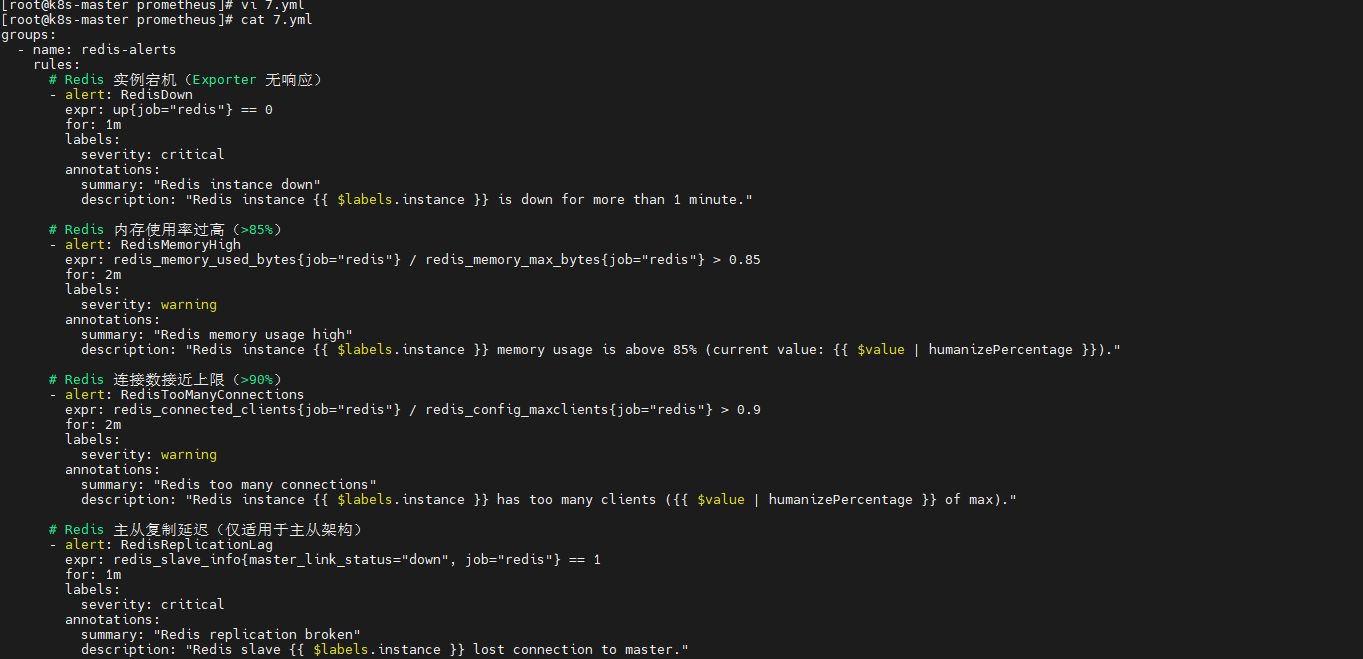
这些阈值按这次实操环境保留,长期使用时可以再根据自己的Redis负载调整。
16 把告警规则文件加入Prometheus
这次规则文件保存为:
7.yml
然后编辑Prometheus配置:
shell
vi prometheus.yml增加:
shell
rule_files:
  -  "/app/prometheus/7.yml"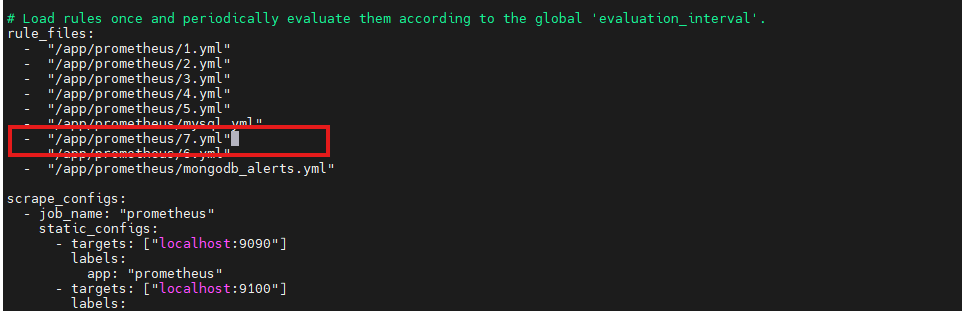
这样Prometheus启动时就会继续加载:
/app/prometheus/7.yml
17 重启Prometheus并查看规则
执行:
shell
systemctl restart prometheus然后通过Prometheus页面查看:
规则已经出现:
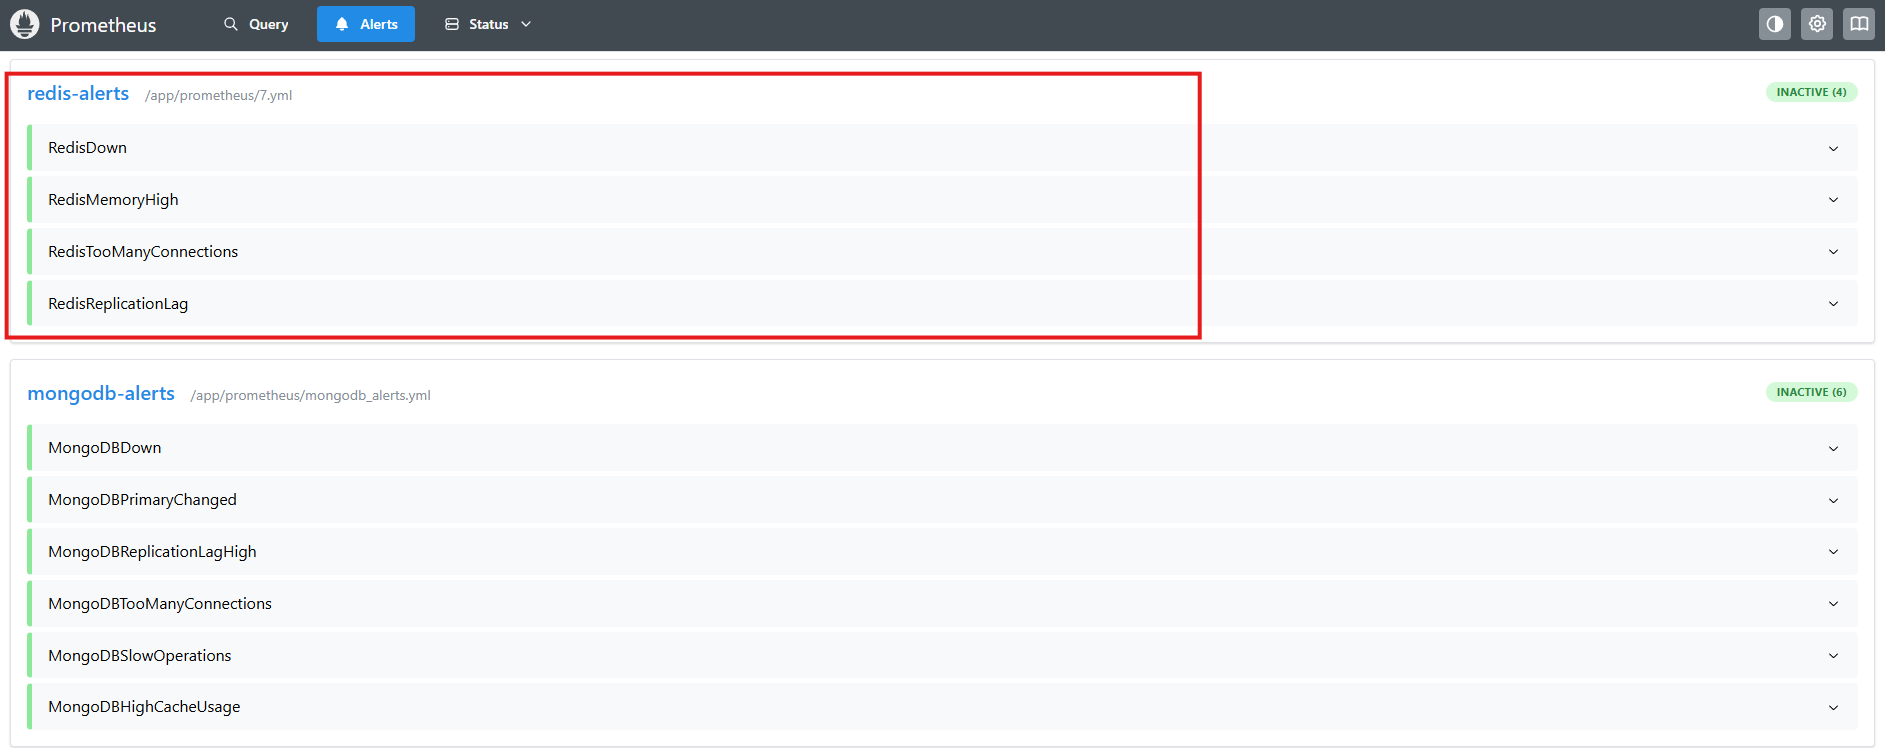
到这里,监控链已经从:
"能抓指标"
继续走到:
"指标达到条件会进入告警状态"
18 本地监控到这里已经完成
当前结构是:
Redis:6379
↓
redis_exporter:9121
↓
Prometheus
↓
Redis告警规则
如果Redis、redis_exporter和Prometheus都在同一个可达网络里,这套结构已经可以长期使用。
后面的步骤解决的是另一个问题:
Prometheus和redis_exporter不在同一个局域网时,怎么继续抓取9121。
19 在redis_exporter所在主机安装cpolar
执行:
shell
sudo curl https://get.cpolar.sh | sh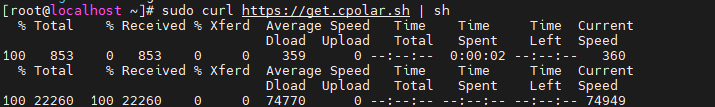
安装完成后查看服务:
shell
sudo systemctl status cpolar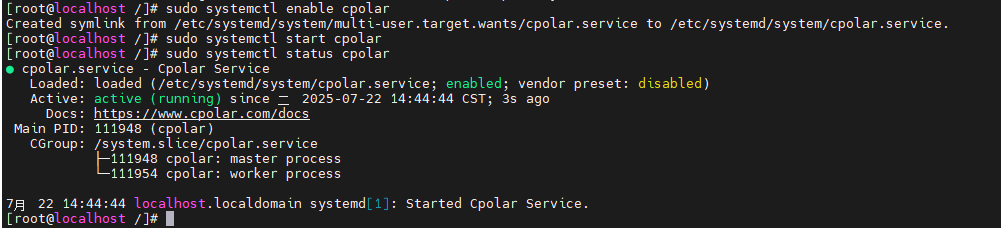
确认正常以后,通过9200端口进入cpolar管理页面:
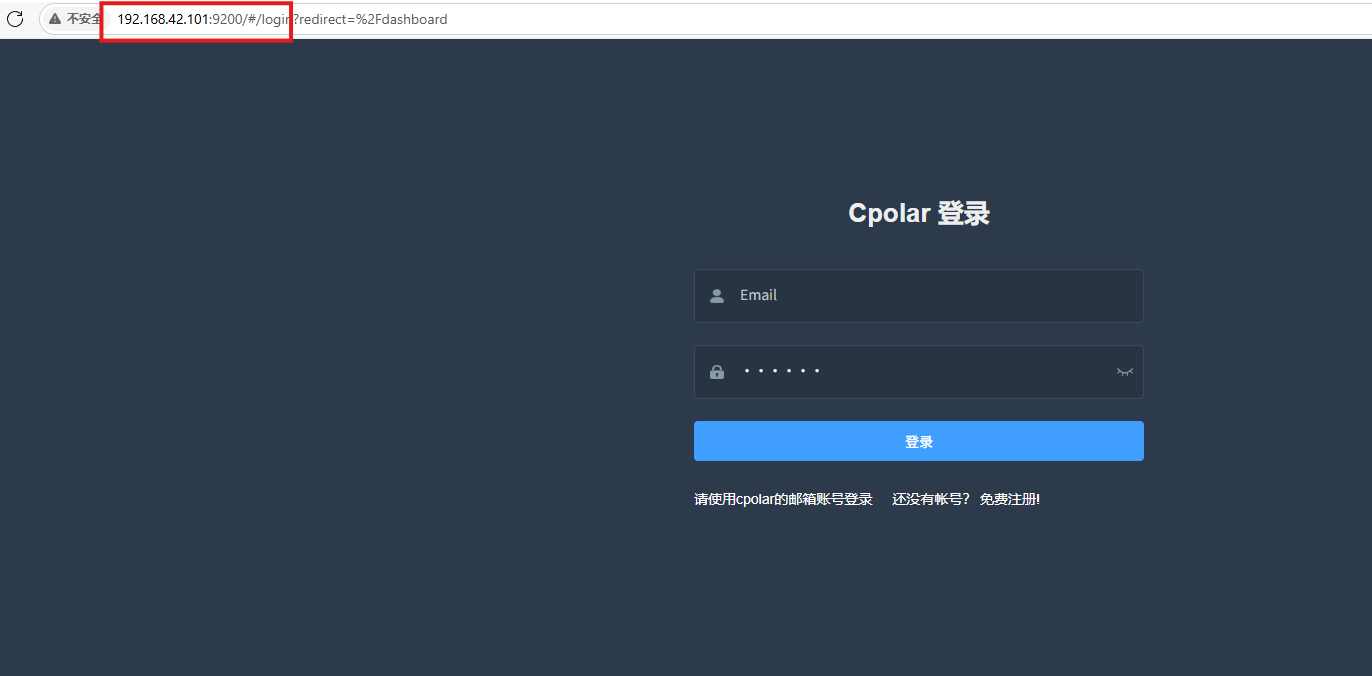
20 给redis_exporter的9121创建HTTP隧道
创建参数:
- 隧道名称:
redis_exporter - 协议:HTTP
- 本地地址:
9121 - 域名类型:随机域名
- 地区:
China Top
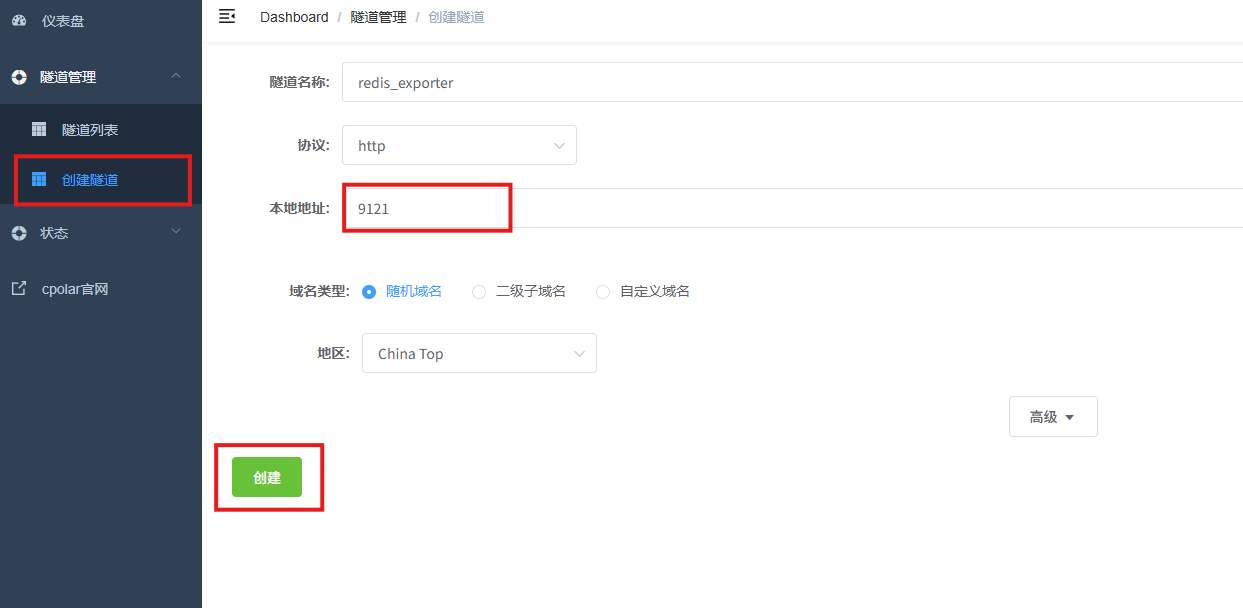
创建完成后进入在线隧道列表:
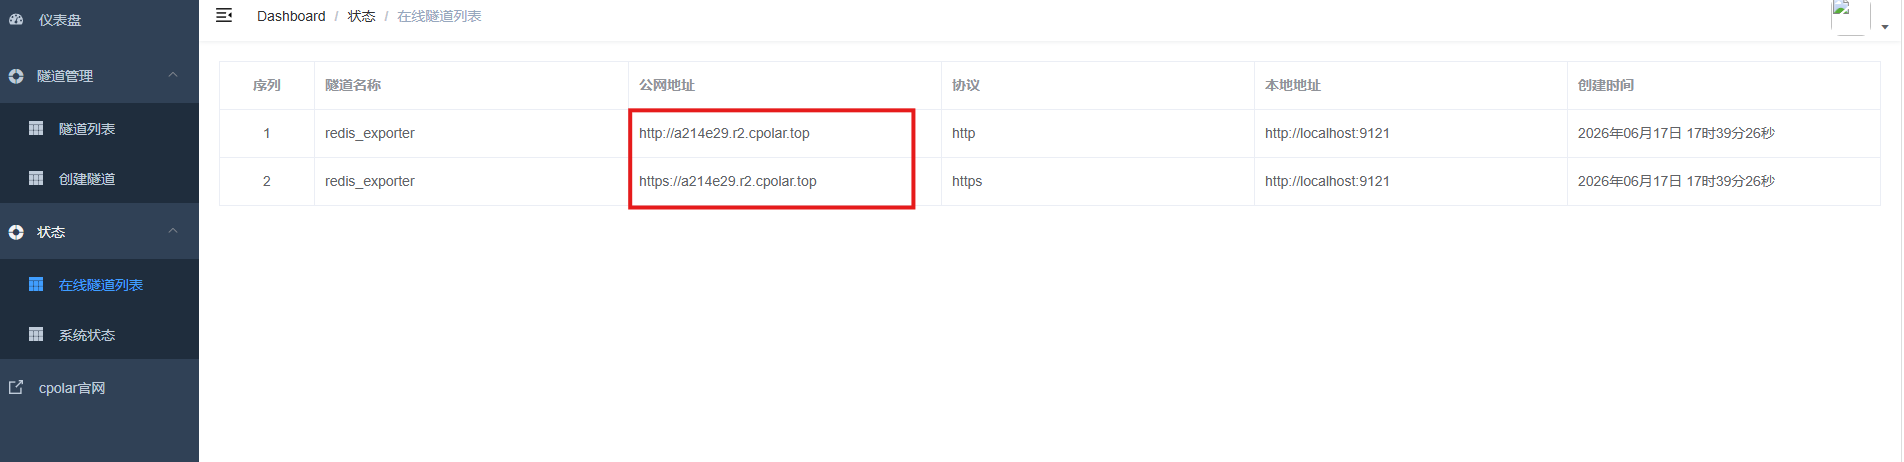
21 先从外部访问redis_exporter Metrics
访问生成的公网地址:
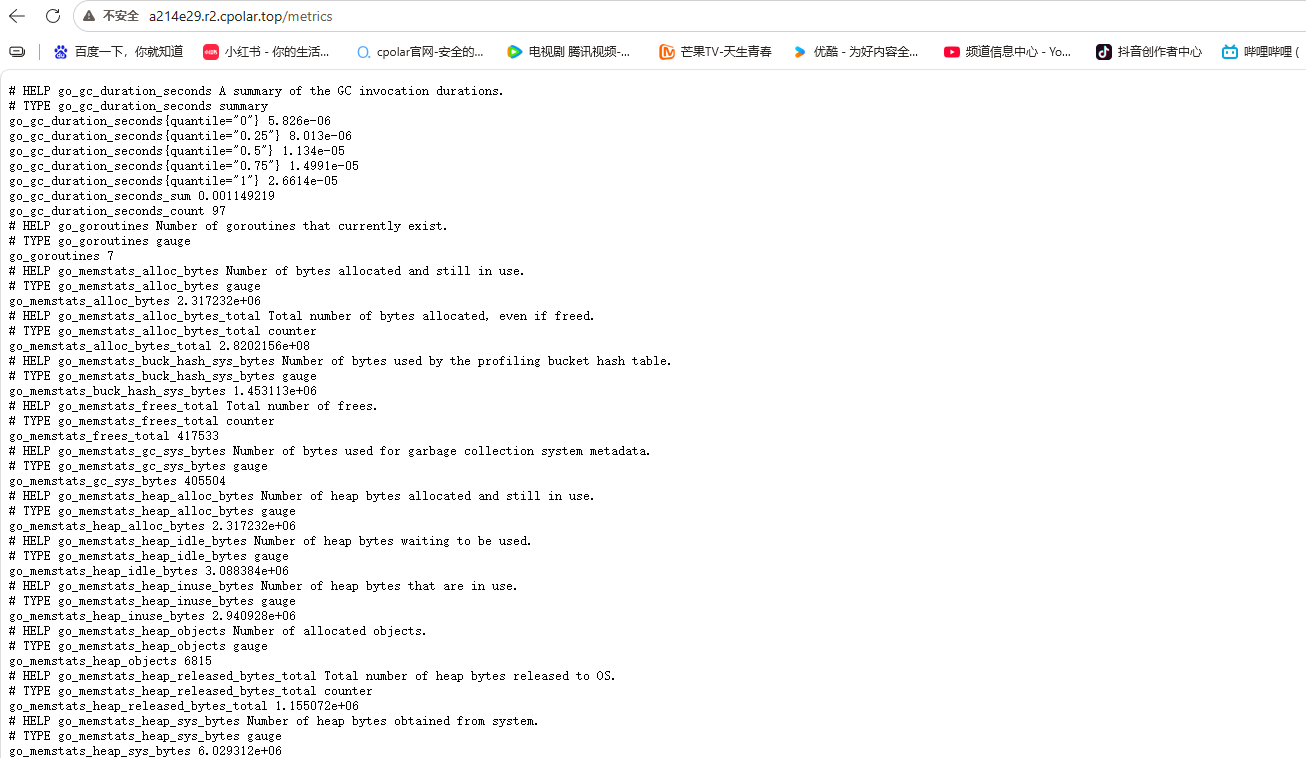
页面能够正常打开以后,可以确认:
公网地址 → cpolar → redis_exporter:9121
已经打通。
这时另一网络中的Prometheus就有条件通过公网地址抓取Exporter指标。
22 Prometheus改为抓公网redis_exporter地址
这次使用的公网地址示例:
a214e29.r2.cpolar.top
配置Target:
shell
      - targets: ["a214e29.r2.cpolar.top"]
        labels:
          app: "redis_exporter"
配置页面:
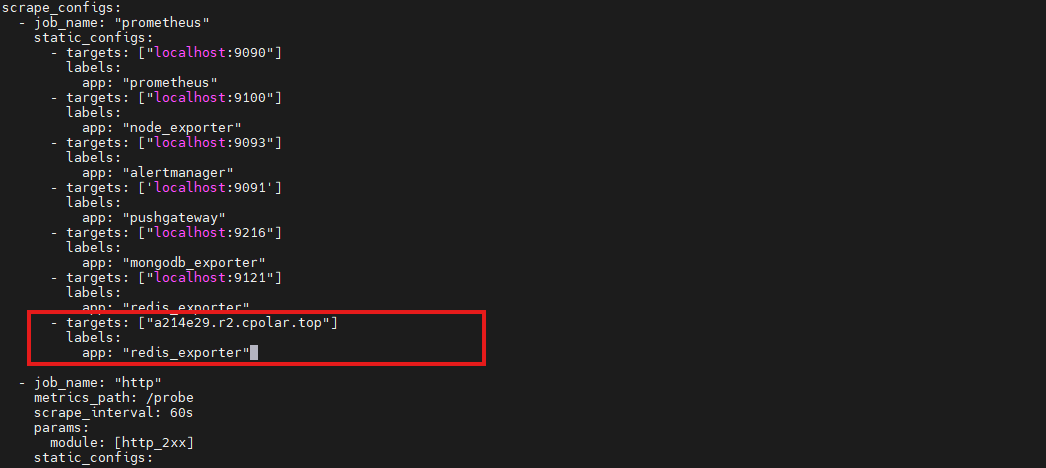
这里真正改变的是:
原来:
Prometheus → localhost:9121
现在:
Prometheus → 公网地址 → redis_exporter:9121
23 确认远程抓取成功
进入Prometheus页面查看:
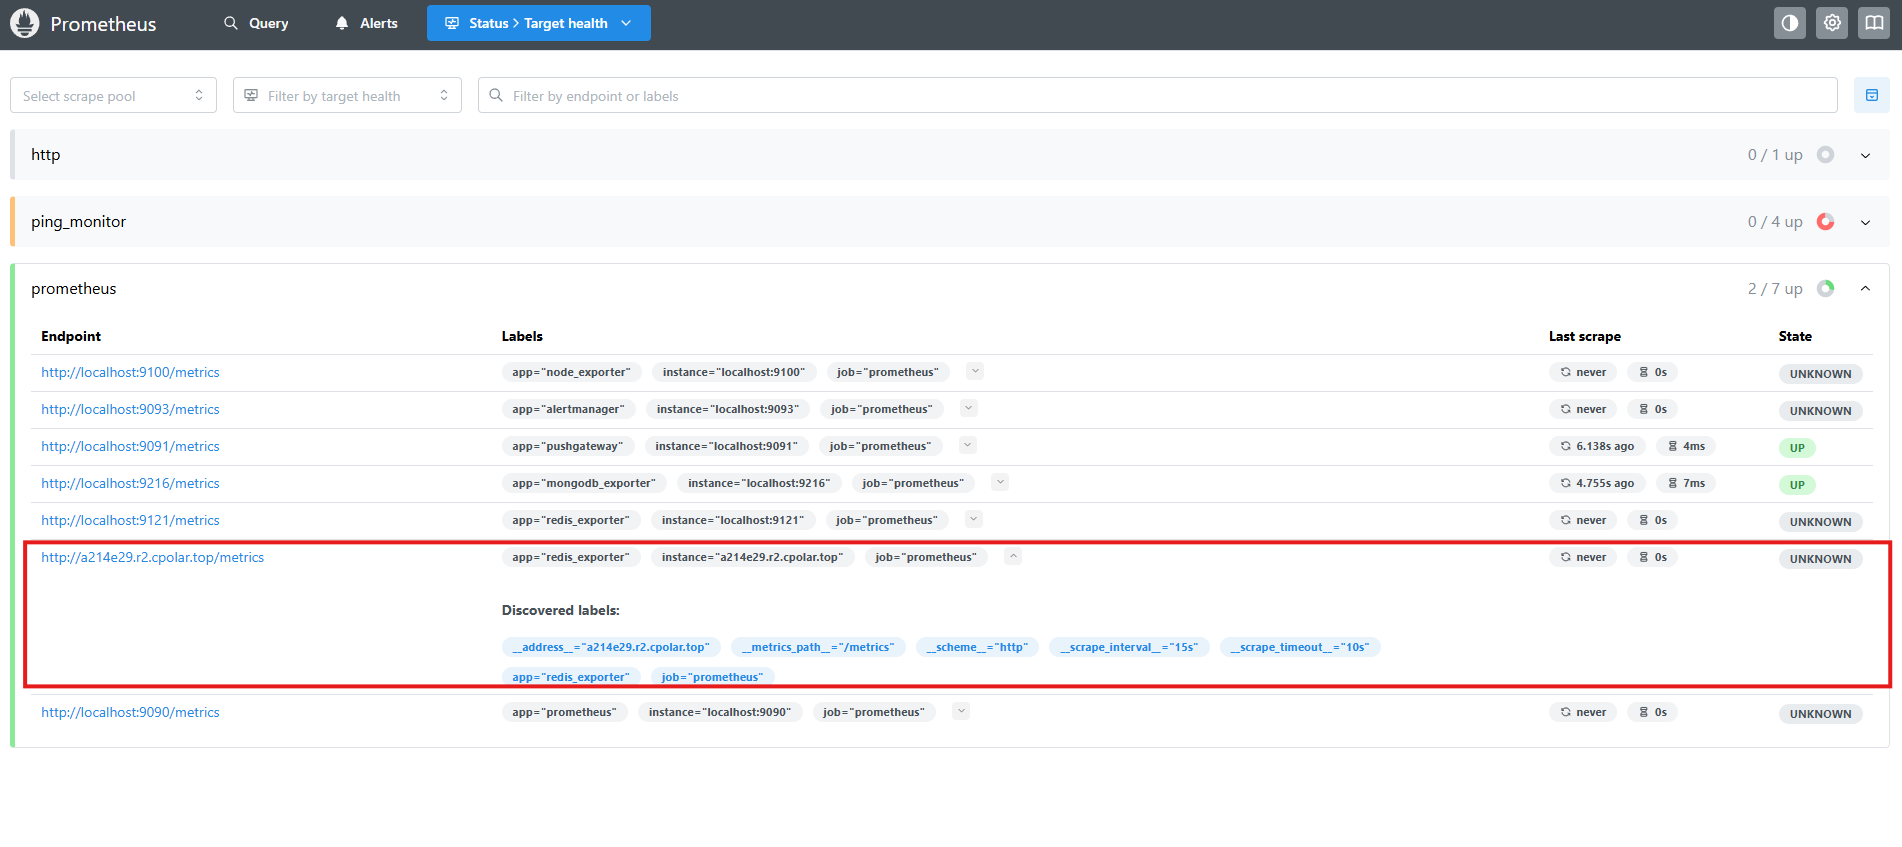
能够成功抓取以后,说明跨网络监控链已经跑通。
这里远程暴露的是:
redis_exporter Metrics入口
而不是直接把Redis的6379暴露给Prometheus。
24 为什么优先暴露Exporter而不是Redis数据库本身
Prometheus真正需要的是指标,不需要直接操作Redis业务数据。
因此跨网络时更合理的链路是:
Redis → redis_exporter → Prometheus
而不是:
Prometheus直接连接Redis业务端口。
这样职责更清楚,也能把监控入口和数据库业务入口分开。
25 随机域名适合先验证
如果只是测试跨网络抓取,随机公网地址已经够用。
但长期运行时,随机地址变化以后,Prometheus配置里的Target也要跟着修改。
所以后面继续配置固定二级子域名。
26 保留固定二级子域名
进入预留页面:
这次示例使用:
redis
作为二级子域名:
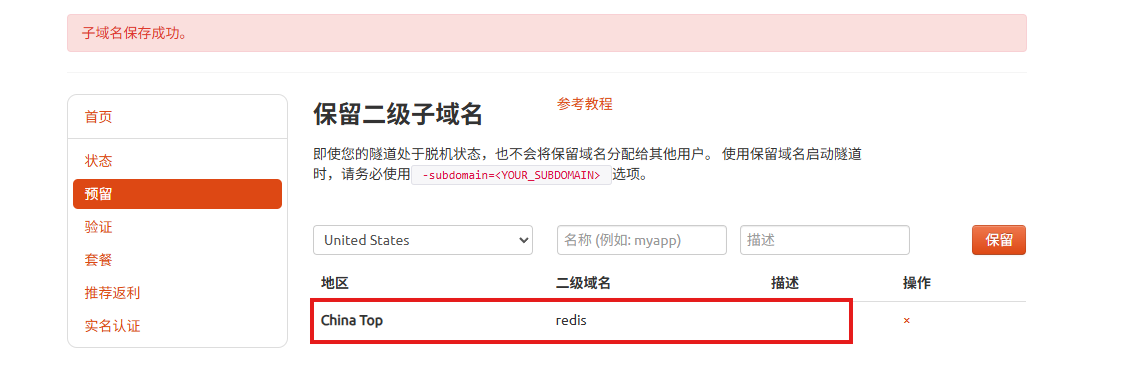
实际名称按自己的账号和可用名称设置。
27 把redis_exporter隧道改成固定地址
回到隧道列表:
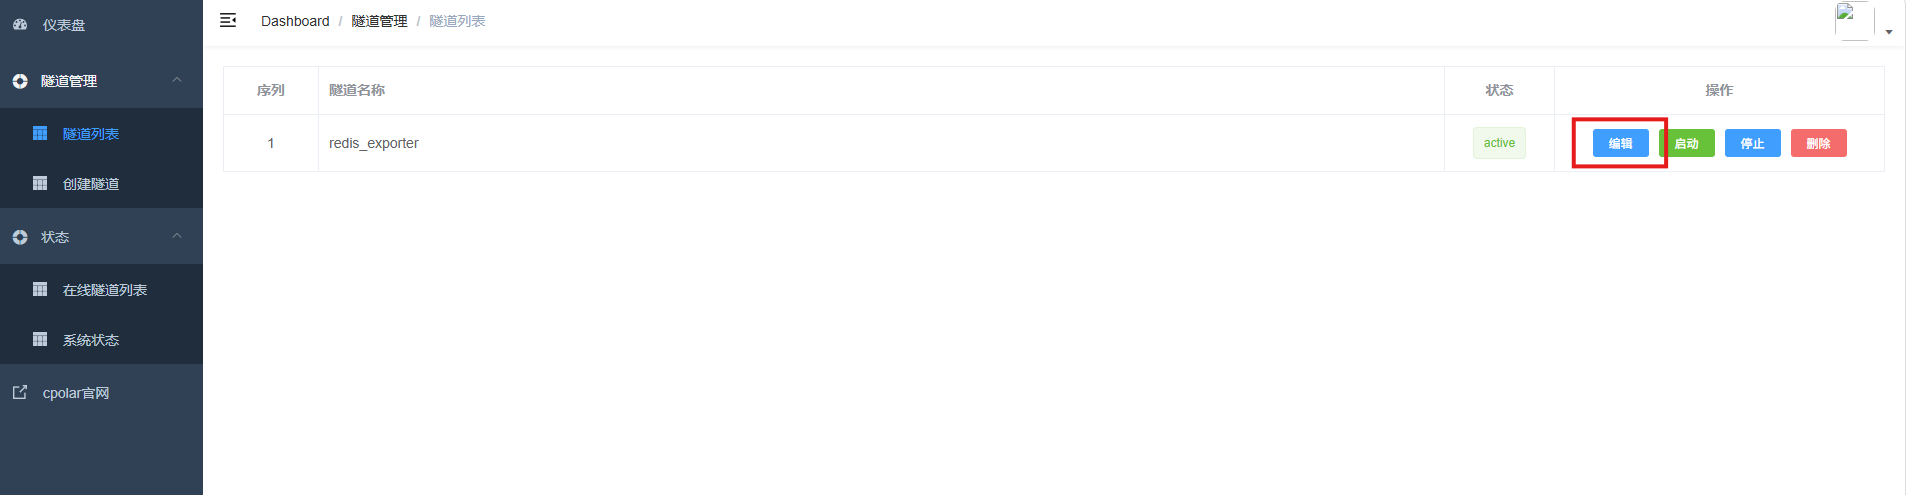
找到:
redis_exporter
进入编辑。
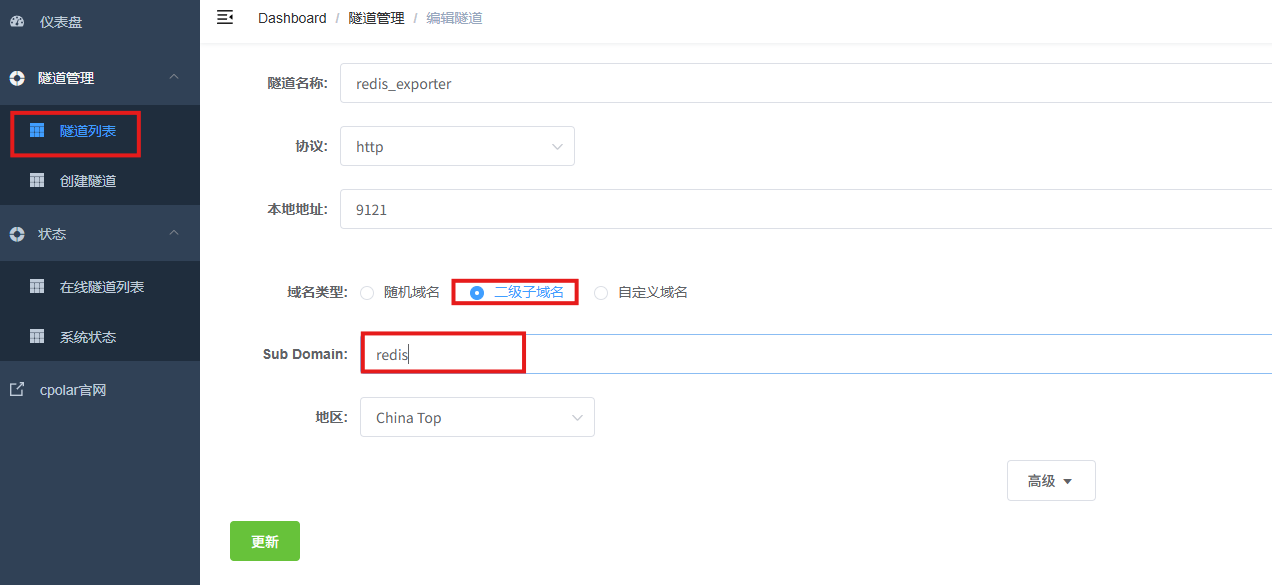
修改:
- 域名类型:二级子域名;
- Sub Domain:已保留名称;
- 地区:
China Top。
更新:
28 确认固定地址已经生效
进入在线隧道列表:
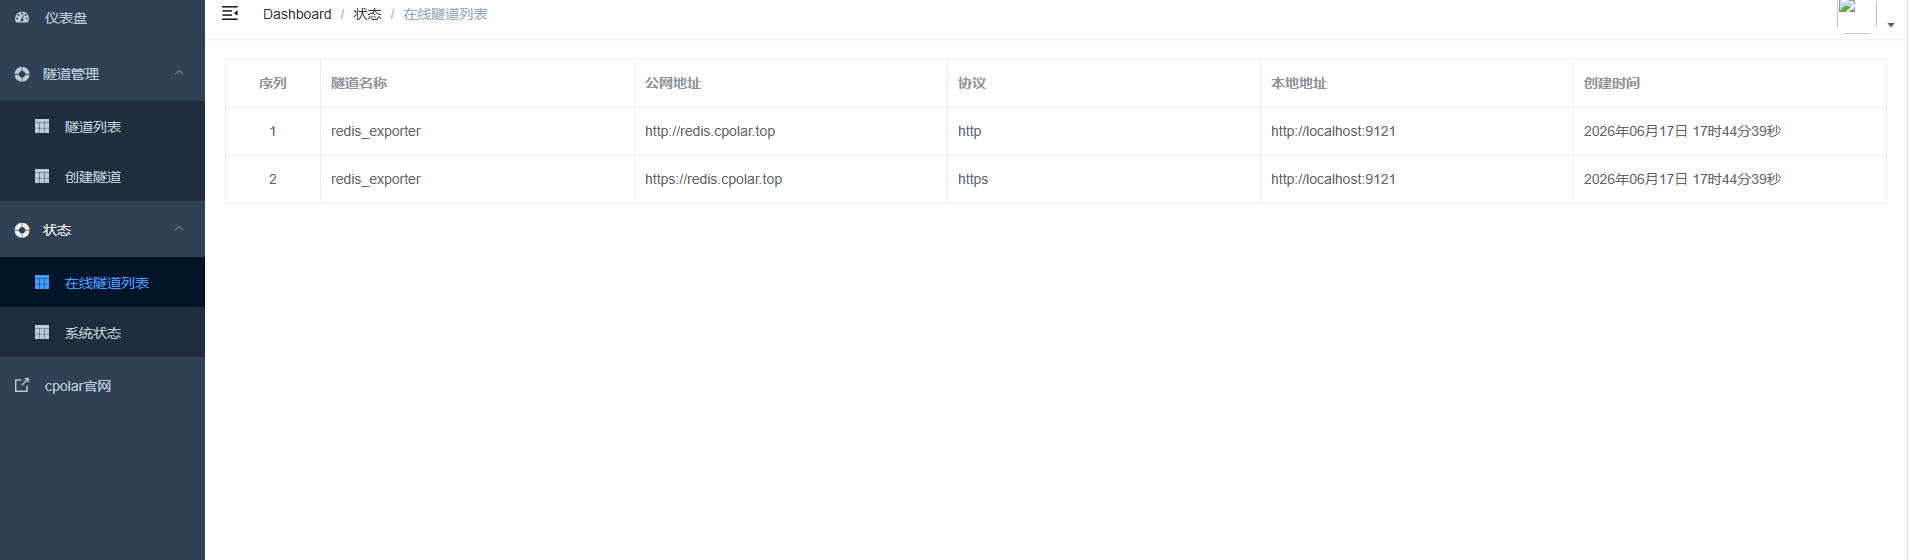
可以看到随机地址已经切换成固定二级子域名。
29 最后再测试固定Metrics入口
使用固定地址访问:
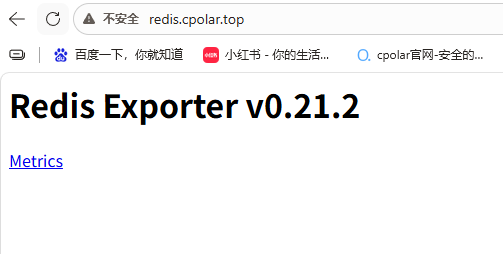
能够正常看到redis_exporter页面以后,固定入口就完成。
后面只需要把Prometheus Target写成这个固定地址,就可以避免随机域名变化带来的配置修改。
30 这套监控真正分成五层
第一层:Redis业务实例
Redis:6379
第二层:指标采集
redis_exporter:9121
第三层:指标存储与查询
Prometheus
第四层:异常判断
Prometheus规则 + Alertmanager链路
第五层:跨网络抓取
固定公网地址 → redis_exporter:9121
把这五层分开以后,后面排错会清楚很多。
31 常见问题可以按链路逐层查
如果Prometheus抓不到Redis指标,可以按顺序检查:
- Redis是否正常;
- redis_exporter进程是否存在;
9121/metrics能否打开;- Prometheus Target是否写对;
- Prometheus配置是否成功加载;
- 公网Exporter地址是否能访问;
- 固定二级子域名是否绑定到正确隧道;
- 告警规则文件是否已加入
rule_files。
不要一上来同时改Redis、Exporter和Prometheus。
先确定是哪一层断了。
32 最后把整条技术链重新看一遍
采集:
Redis → redis_exporter
Metrics:
redis_exporter → 9121/metrics
抓取:
Prometheus → redis_exporter
告警:
Redis指标 → Prometheus规则 → Alertmanager
跨网络:
Prometheus → 固定公网地址 → redis_exporter:9121
实际完成:
- redis_exporter下载;
- 9121启动;
- Metrics验证;
- redis_exporter服务文件;
- Prometheus安装;
- TSDB目录;
- Prometheus systemd;
- Target配置;
- redis_exporter抓取验证;
- Redis告警规则;
- rule_files加载;
- cpolar安装;
- 9121公网访问;
- Prometheus远程Target;
- 固定二级子域名。
这样Redis监控才从"临时查一次状态"变成一条可以持续抓取、判断和扩展的监控链。
总结
这次真正跑通的是一条完整的Redis监控链:redis_exporter负责连接Redis并在9121输出Metrics,Prometheus负责定时抓取这些指标,再通过规则判断实例宕机、内存使用率、连接数和主从复制状态等异常。
整个过程里最重要的验证不是"进程启动了",而是先确认9121/metrics能看到数据,再确认Prometheus Target真正抓取成功。只有这两层都正常,后面的PromQL和告警规则才有意义。
跨网络部分没有直接开放Redis的6379,而是把redis_exporter的9121作为监控入口提供给另一网络中的Prometheus。随机地址先验证链路,固定二级子域名再解决长期Target变化的问题。
以后需要监控更多Redis实例时,仍然可以沿用同样的思路:先把每个实例的指标稳定交给redis_exporter,再由Prometheus集中抓取、存储和告警,逐步扩展成统一的Redis可观测体系。