写代码时大模型哪怕胡说八道,顶多是编译报个错,或者单测红一两项;但如果你试过让 Agent 去逆向一个没有源码的二进制程序,就会知道那场面有多让人崩溃。
比如你想搞清楚 macOS 备忘录的本地全文搜索到底是怎么实现的。丢给 Agent 之后,它在后台调了几个分析工具,几十秒后胸有成竹地交差,贴回一段几百行的反编译伪代码------函数名工整、控制流清晰,甚至连错误处理分支都给你脑补得头头是道。
可当你真正把二进制拖进 Hopper 或 Ghidra,顺着它给的内存地址肉眼对照汇编时,一口老血能直接喷出来:最核心的那几个解密跳转和偏移量,在真实文件里根本不存在。全是大模型凭空编出来的。
逆向工程大概是所有技术工种里,最容不下模型幻觉的一个。 一个地址偏移量错了,一条交叉引用是编造的,后面几个小时顺藤摸瓜的推导就会全盘打水漂。
最近在 GitHub 趋势榜上持续霸榜的开源项目 rea (npm 包名 rea-agents),正是冲着这个工程死穴来的。从一个月前的 4,500 多 Star,到四天破 2 万,再到如今狂揽近 28 万 Star、Fork 破 7 万、npm 周下载量突破 23 万------它之所以引发整个安全圈与 Agent 社区的震动,并不是因为它又封装了多少花哨的反编译命令,而是它第一次把「模型不准瞎编」从一句口头提示词,生生焊成了协议层的硬契约。
用一句话说,rea 是一个用 TypeScript 编写的 MCP(Model Context Protocol)服务器兼 CLI。它做的事情很克制:自己不写反编译算法,而是作为总管家,调度底层的 Hopper、Ghidra、IDA、JADX 等十几种工业级引擎,然后把带着严格证据链的分析结果,安全递给你的 Claude Code、Cursor 或 Codex。
这篇文章我们把它从内到外拆个底朝天:从洋葱架构、异构引擎 Bridge、Evidence 证据协议,一路拆到残局清理与流量狂飙下的工程防线。即便你平时不做逆向安全,光看它如何用一套严丝合缝的协议去锁死大模型的幻觉、治理长链路资源,也能为你设计专业领域的 Agent 工具提供一份极具含金量的架构样本。
1. 定位:它不做反编译,而是引擎们的"总调度器"
先把预期摆正:rea 自身完全不做反编译。
原生二进制的反编译交给 Hopper、Ghidra、IDA Pro;安卓 APK 丢给 JADX;ELF 内存布局分析交给 pwntools;固件解包交给 Binwalk 和 Unblob;网络流量抓包交给 mitmproxy。
rea 的核心生态位是站在这些工业级引擎之上,充当统一的调度编排层、格式归一化层与证据封装层。
它的目标支持矩阵宽得甚至有些惊人,官方 README 列出的开箱支持类型就多达 13 类:原生二进制(Mach-O / PE)、离线 ELF、EVM 字节码、崩溃转储(Crashdump)、JavaScript 与 Electron 打包应用、Web 应用 HAR 抓包、.NET 程序集、安卓 APK、硬件固件镜像、安装包资源、运行时进程行为,甚至连 Ghidra 的 16 位 DOS 实模式分析都覆盖在内。
GitHub 上拿开源反编译引擎套一层 MCP 壳的项目不在少数,但多数停留在"调一下 CLI 输出大段文本给模型"的玩具阶段。一个工具想要同时驾驭十几种异构引擎,并且不被底层脏数据拖垮,架构的定力至关重要。rea 真正拉开代差的第一步,是其严谨的底层分层设计。
2. 架构骨架:标准洋葱模型与异构 Bridge 的工程死磕
打开 rea 的仓库,根目录躺着一份长篇 AGENTS.md。第一眼看像开源项目的 Contributor 指南,细读后才发现这是专供 AI 编码 Agent 阅读的工程规范,条款极其苛刻:
- 「工具执行结果必须显式区分观察(Observation)、推断(Inference)与未知(Unknown)」;
- 「Provider 专有协议与脏逻辑严禁泄露至 Domain 与 Application 层」。
更有意思的是其 src/evaluation/ 目录,内置了 CodexAgentEval.ts 和 KnownAnswerEvaluation.ts,专门拿真实验证集与会话转录来评测模型在使用自身工具时是否发生幻觉。换句话说,这个项目本身就是与 AI 深度结对编码的产物,作者对大模型"一本正经胡说八道"有着切肤之痛。这个背景,完美解释了它后续一切反直觉的防御性设计。
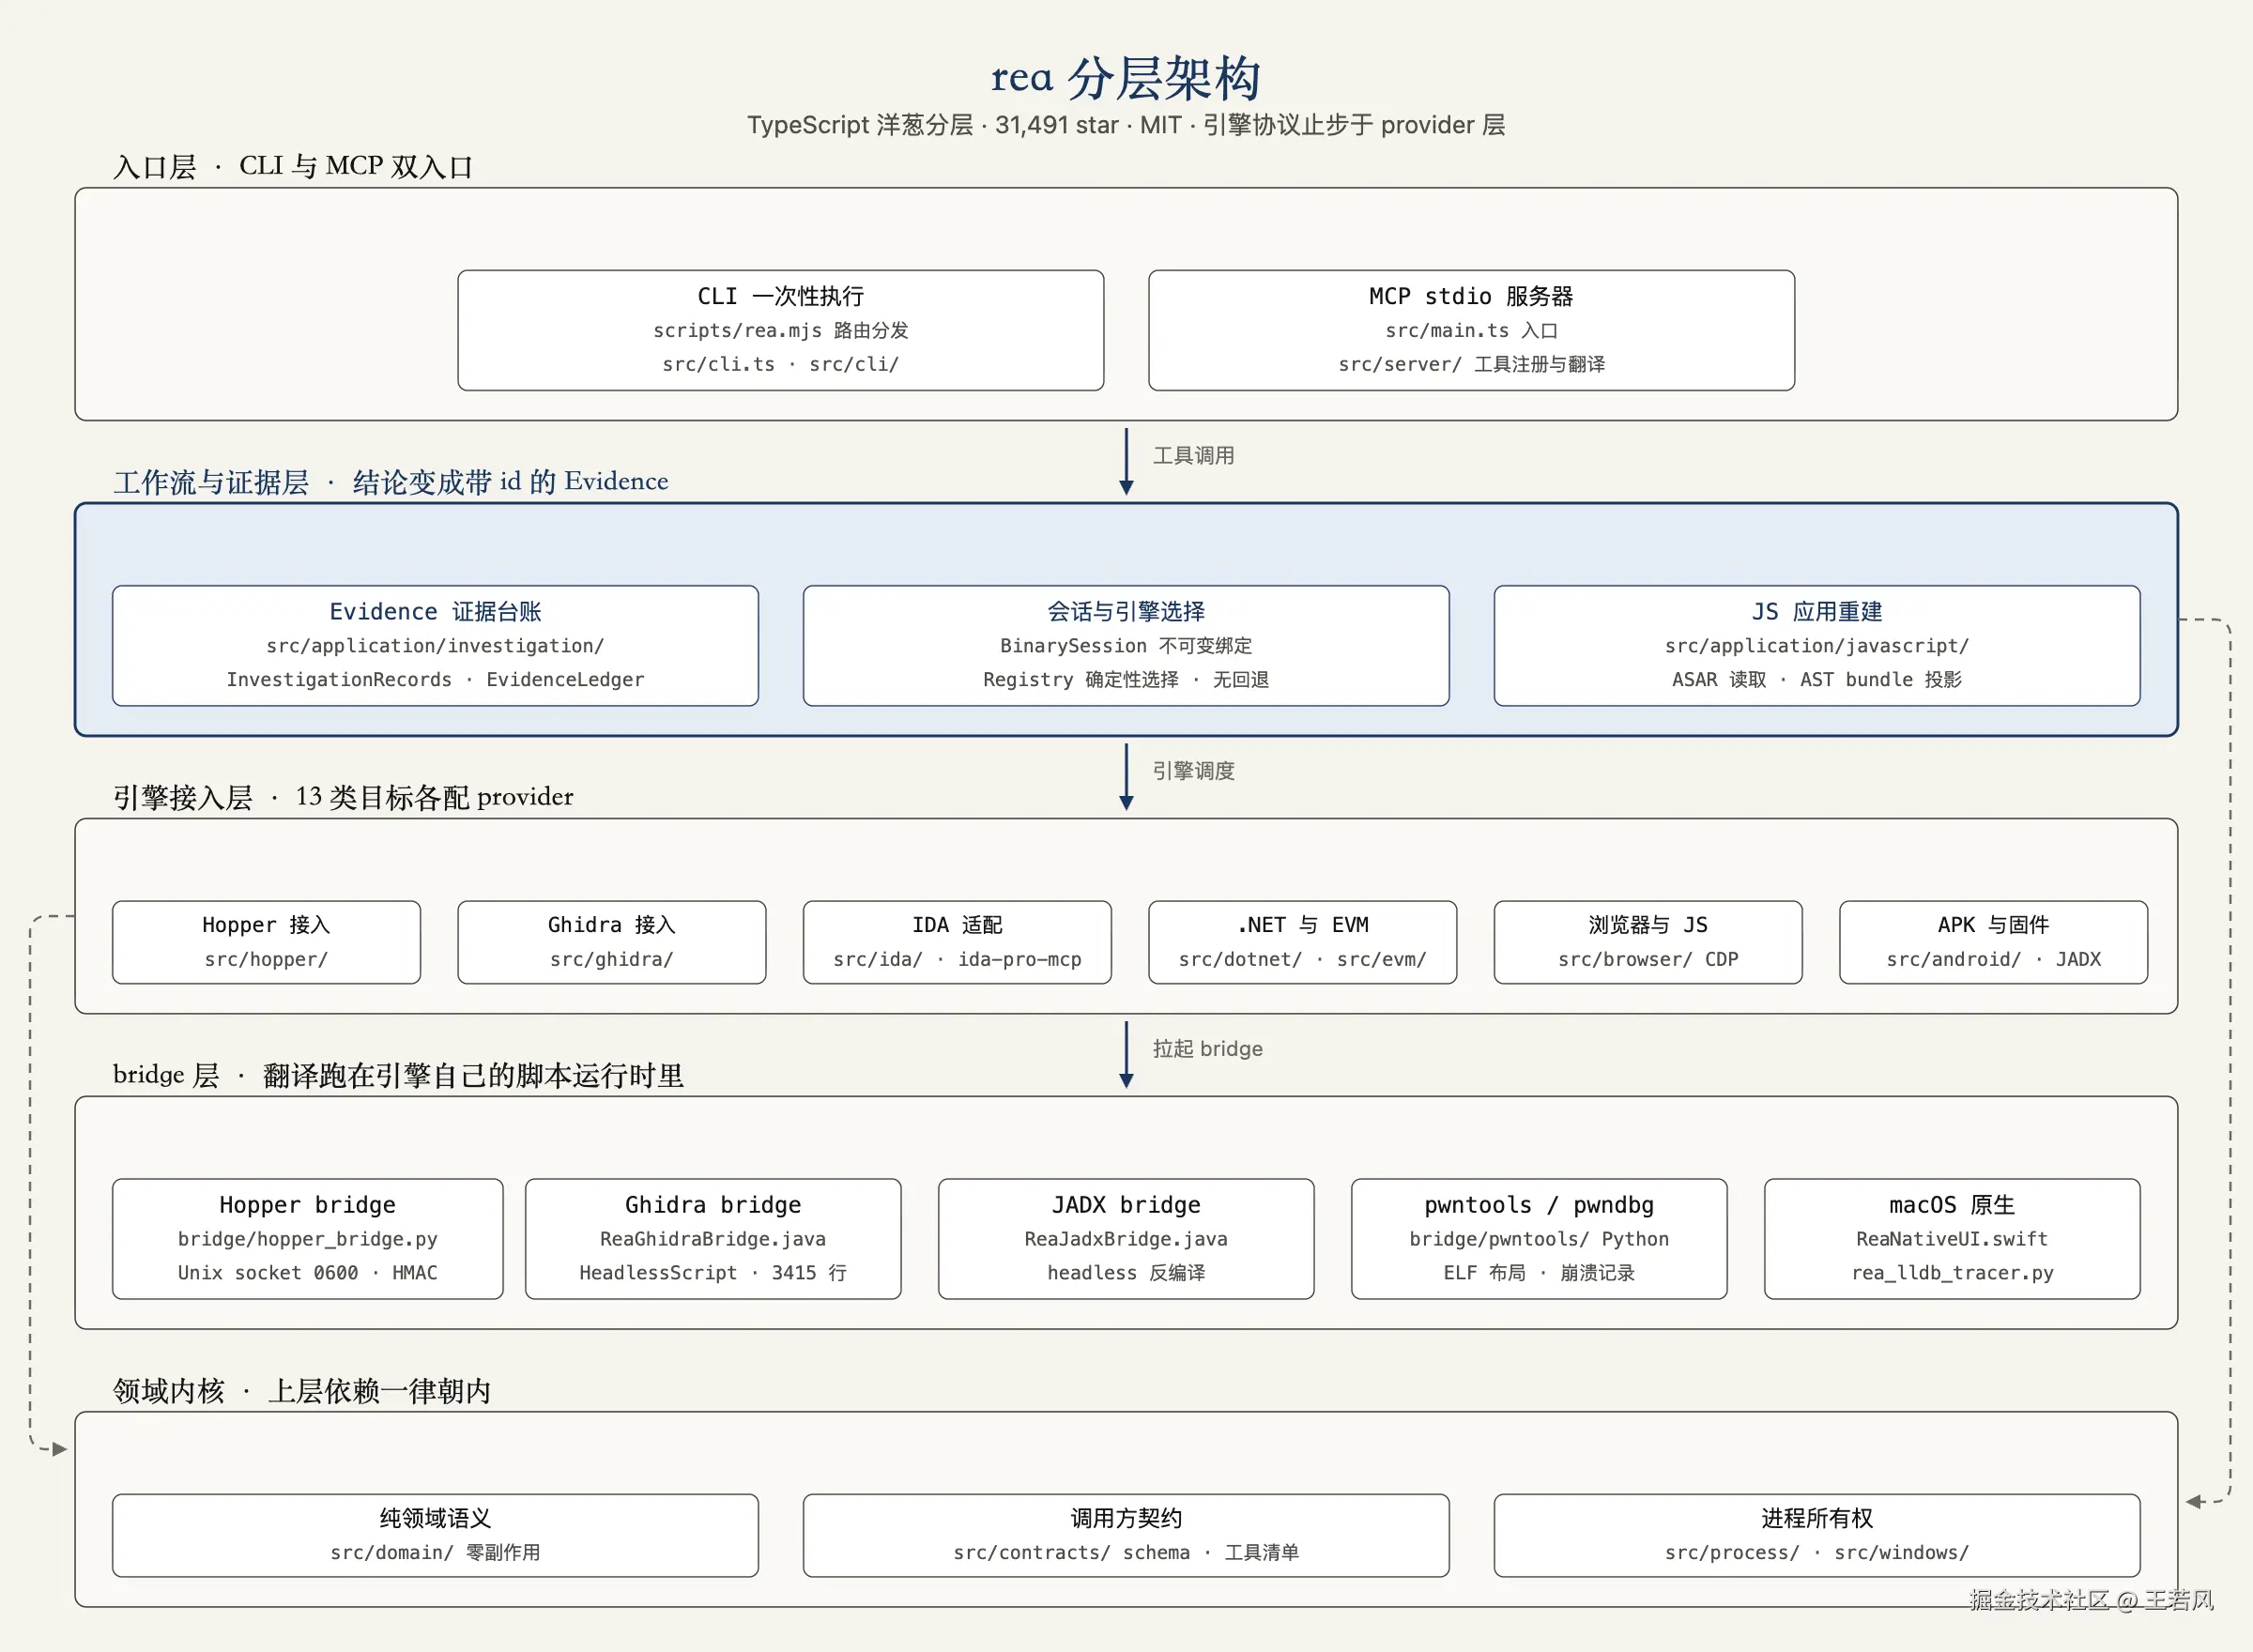
从架构图可以看出,rea 采用了教科书级的洋葱分层架构(Onion Architecture):
- Domain 领域核心(
src/domain/):全由纯函数构成,零外部副作用,仅定义逆向分析的领域实体与规则; - Contracts 契约层(
src/contracts/):定义面向外部与 Agent 的协议规范、Schema 校验规则与工具清单; - Providers 适配层(
src/hopper/,src/ghidra/,src/ida/等):各分析引擎的具体适配实现,将引擎专属数据转为标准实体; - Application 应用层(
src/application/):负责跨引擎工作流编排与会话状态机管理; - Infrastructure 外层入口(
src/cli.ts,src/server/):暴露 CLI 与 MCP JSON-RPC 接口。
所有依赖严格朝内单向流动,外部引擎协议被牢牢隔离在 Provider 层。比如对 IDA Pro 的支持,rea 甚至没有自己重新发明轮子,而是直接适配上游开源的 ida-pro-mcp。借力成熟生态,把所有研发力量集中在别人不具备的证据契约层上。
异构 Bridge 的硬核工程填坑
把图中的各种引擎想象成来自不同国家的技术外包团队:Ghidra 说 Java,Hopper 说 Python,macOS 原生层说 Swift。rea 为每个异构引擎定制了一支桥接器(Bridge),全放在 bridge/ 目录下,这也是整个项目代码里最具含金量的部分:
- Hopper Bridge(Python 单线程隔离) :
hopper_bridge.py开篇文档就标明必须独占运行在 Hopper 的主 Python 线程中------因为一旦把调度交由 Worker 线程,Hopper 内部的 GUI 消息循环会立刻发生死锁。启动时,rea 通过宿主引导器注入REA_SOCKET和随机会话令牌REA_TOKEN,自建一个文件权限为0600(仅当前用户只读可写)的单客户端 Unix Domain Socket,且每一个 IPC 请求都经过严格的 HMAC 消息鉴权。代码里甚至专门防范了 Hopper 原生标签解析器的底层 Bug:当符号名超过 1,024 个 UTF-16 单元时会被截断,常量名直白地标注为HOPPER_SYMBOL_NAME_UTF16_UNITS。 - Ghidra Bridge(Java HeadlessScript) :Ghidra 端是一套长达 3,000 余行的
ReaGhidraBridge.java,作为无头分析脚本挂载在 Ghidra 进程内,承接符号提取、控制流图(CFG)生成与交叉引用比对。他们甚至专门为 Ghidra 补写了 .NET NativeAOT 格式的扩展解析器,用于解析方法调用约定与类型元数据------而这套格式连 Ghidra 官方至今都尚未完善。 - Windows 进程隔离(C++ Node-API) :在 Windows 端,rea 专门用 C++ 编写了一组底层扩展(
native/windows/src/),借助 Node-API 实现了精确的 NTFS 访问控制、受保护 DACL 与 Job Object 原子分配,彻底锁死调试器与衍生子进程的权限逃逸。
有了各引擎专属 Bridge 在底层稳稳托底,数据流向就变得极其清晰:
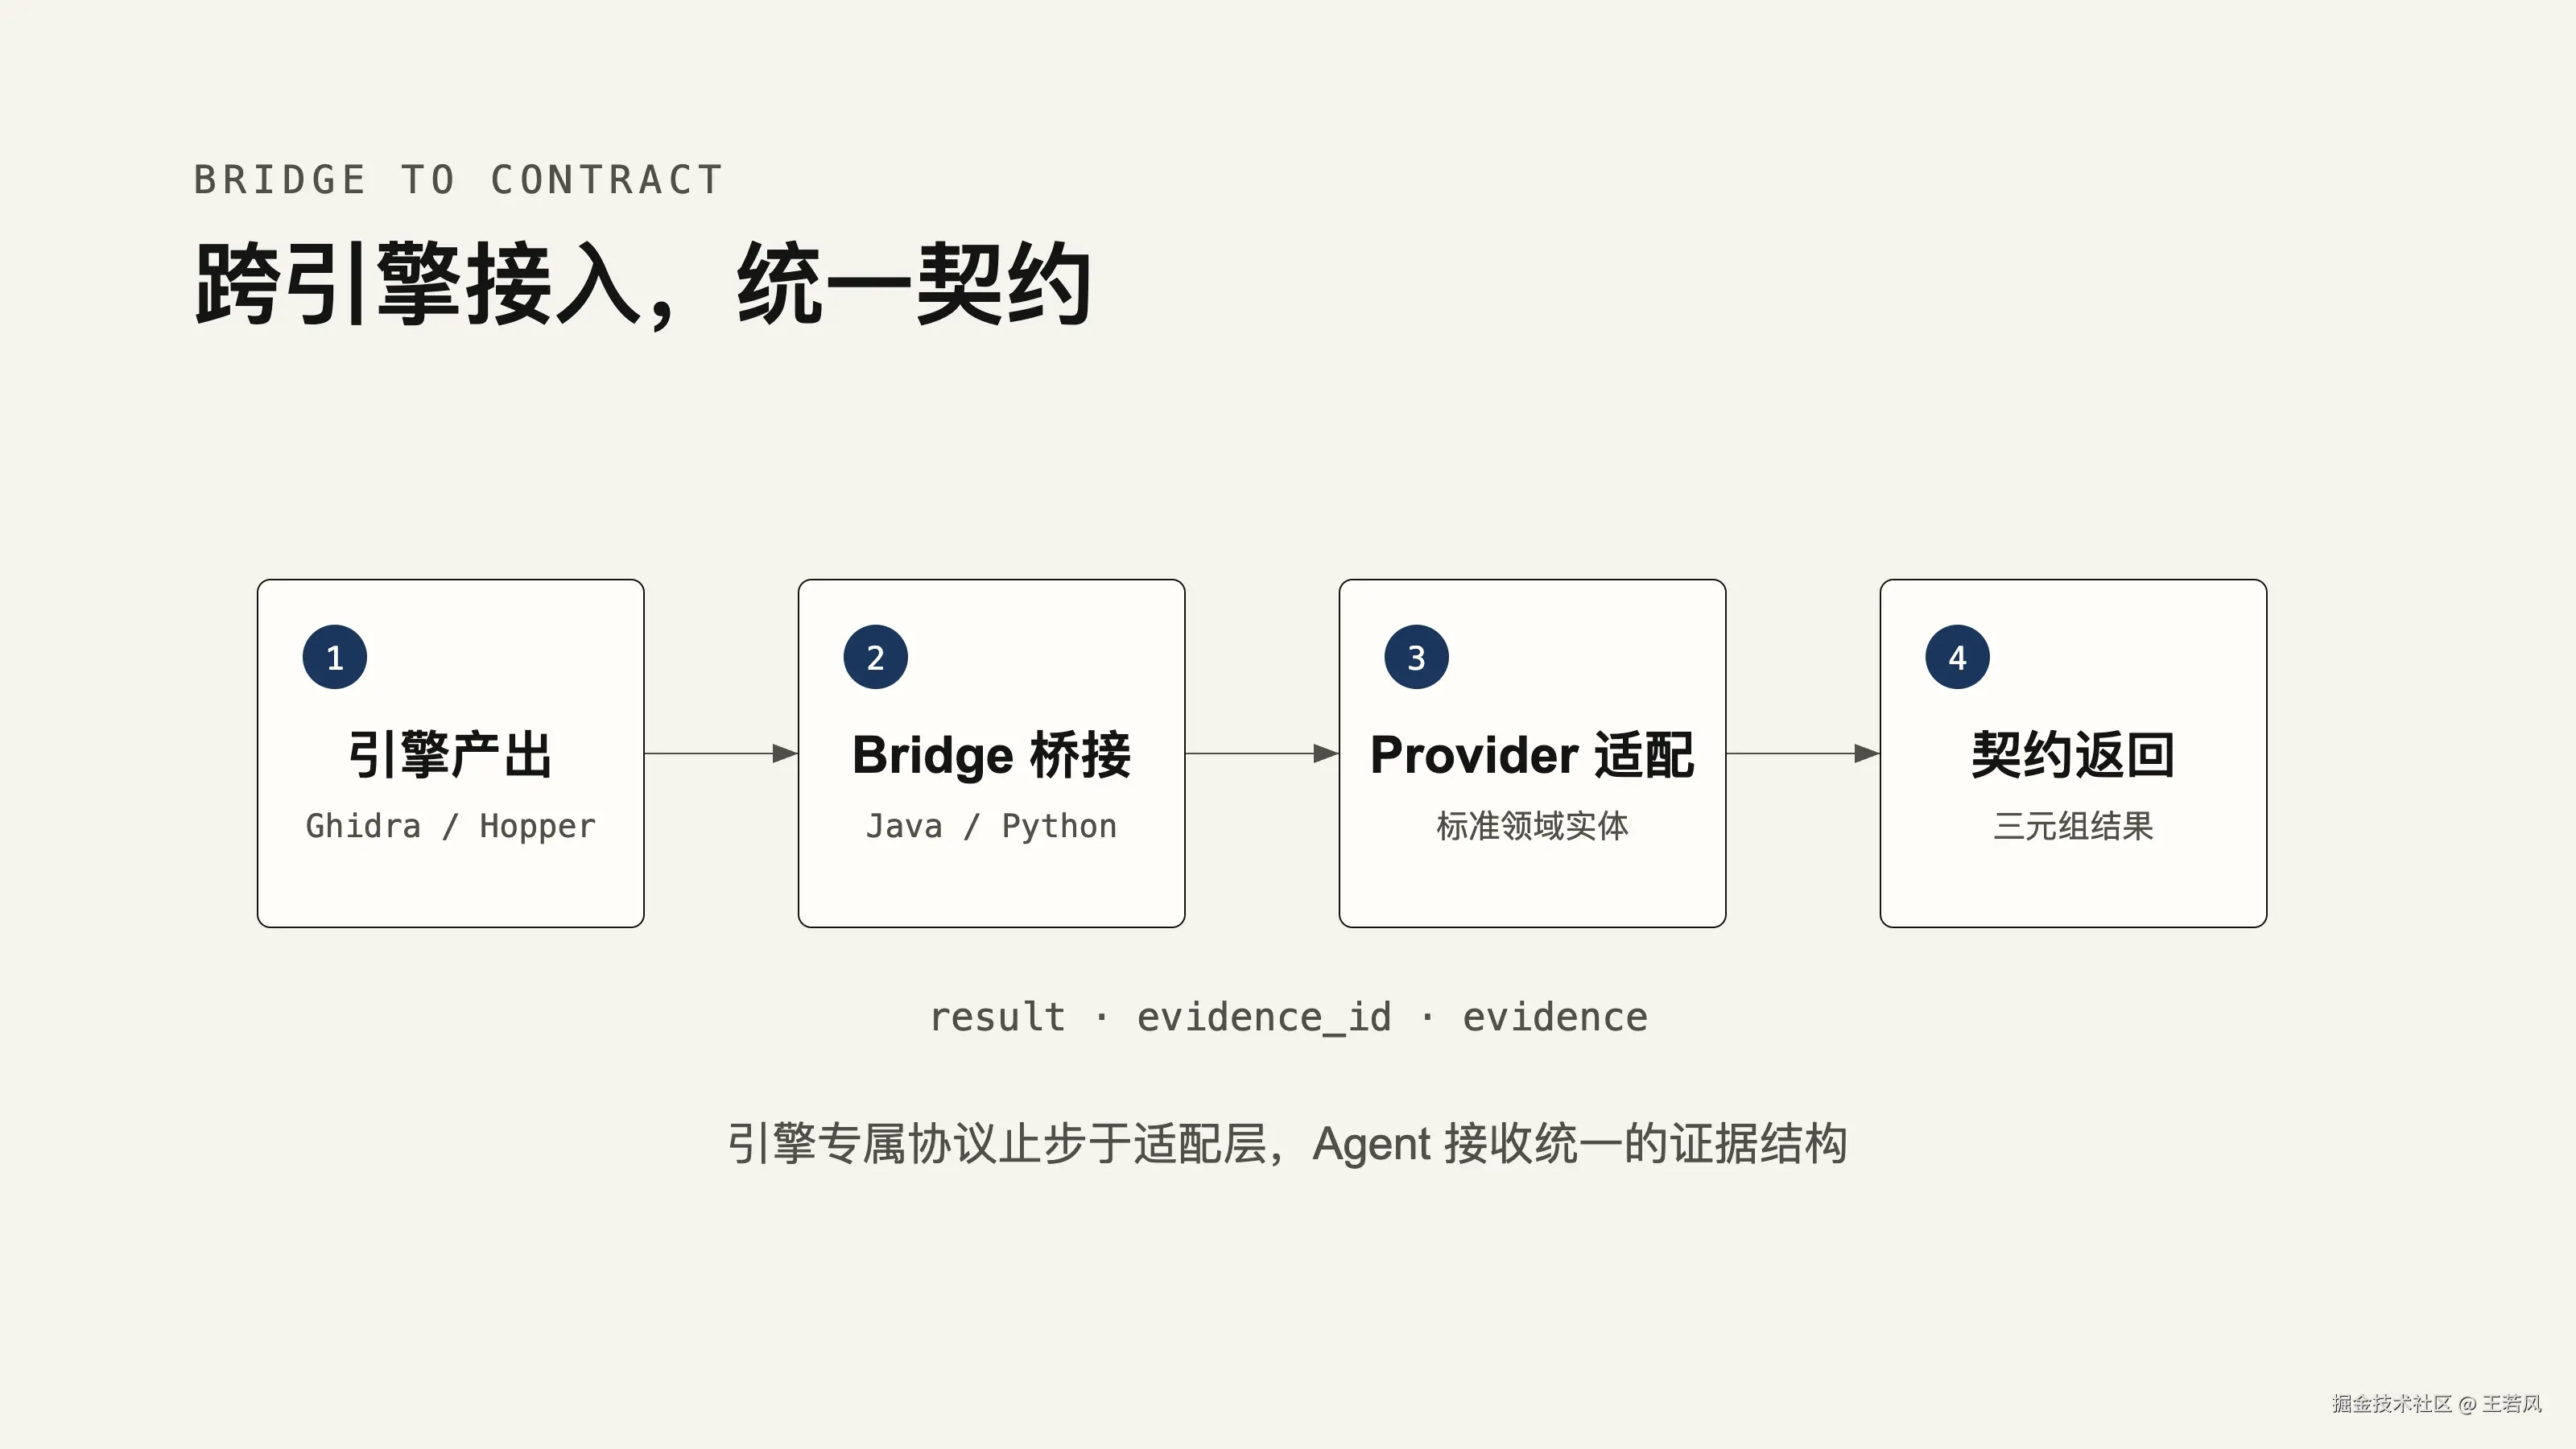
Bridge 负责直接对接各类引擎的底层运行时,Provider 层负责抹平异构数据并转成标准领域实体,最终再包装为统一证据契约返回给上层 Agent。这样一来,无论底层调度的是 Java 写的 Ghidra 还是 Python 写的 Hopper,上层的工作流编排层都无需关心私有协议细节,只需要与统一的证据标准打交道。
3. 核心机制:把「证据链」焊进协议,拒绝做一次性文本
如果仅仅是一个做工精良的编排层,rea 绝不可能在开发者社区引发如此巨大的讨论。读完其契约规范才会意识到,前面的架构分层全是在给这一层做地基:Evidence 证据协议。
在传统的 MCP 设计中,工具调用的返回值大多是终点------模型执行 search_code 或 run_decompiler,拿回一段长文本字符串,并在下一轮对话里自由发挥。而模型只要稍微理解偏差,推论就会开始滑坡。
rea 彻底推翻了这种模式。它规定:凡是有数据产出的工具,返回值必须是严格的三元组结构:
typescript
interface ToolExecutionResult<T> {
  // 1. 归一化后的结构化业务数据(经过领域层校验)
  result: T;

  // 2. 64 位 SHA-256 全局唯一证据指纹,格式形如 "ev_a8f9c2..."
  evidence_id: `ev_${string}`;

  // 3. 不可变规范化证据记录(包含完整的分析上下文、版本、出处及观测标记)
  evidence: EvidenceRecord;
}
关键在于,这些产出的 Evidence 会被存入当前会话的 EvidenceLedger(证据账本)中,并且具备跨工具流转与引用的能力:
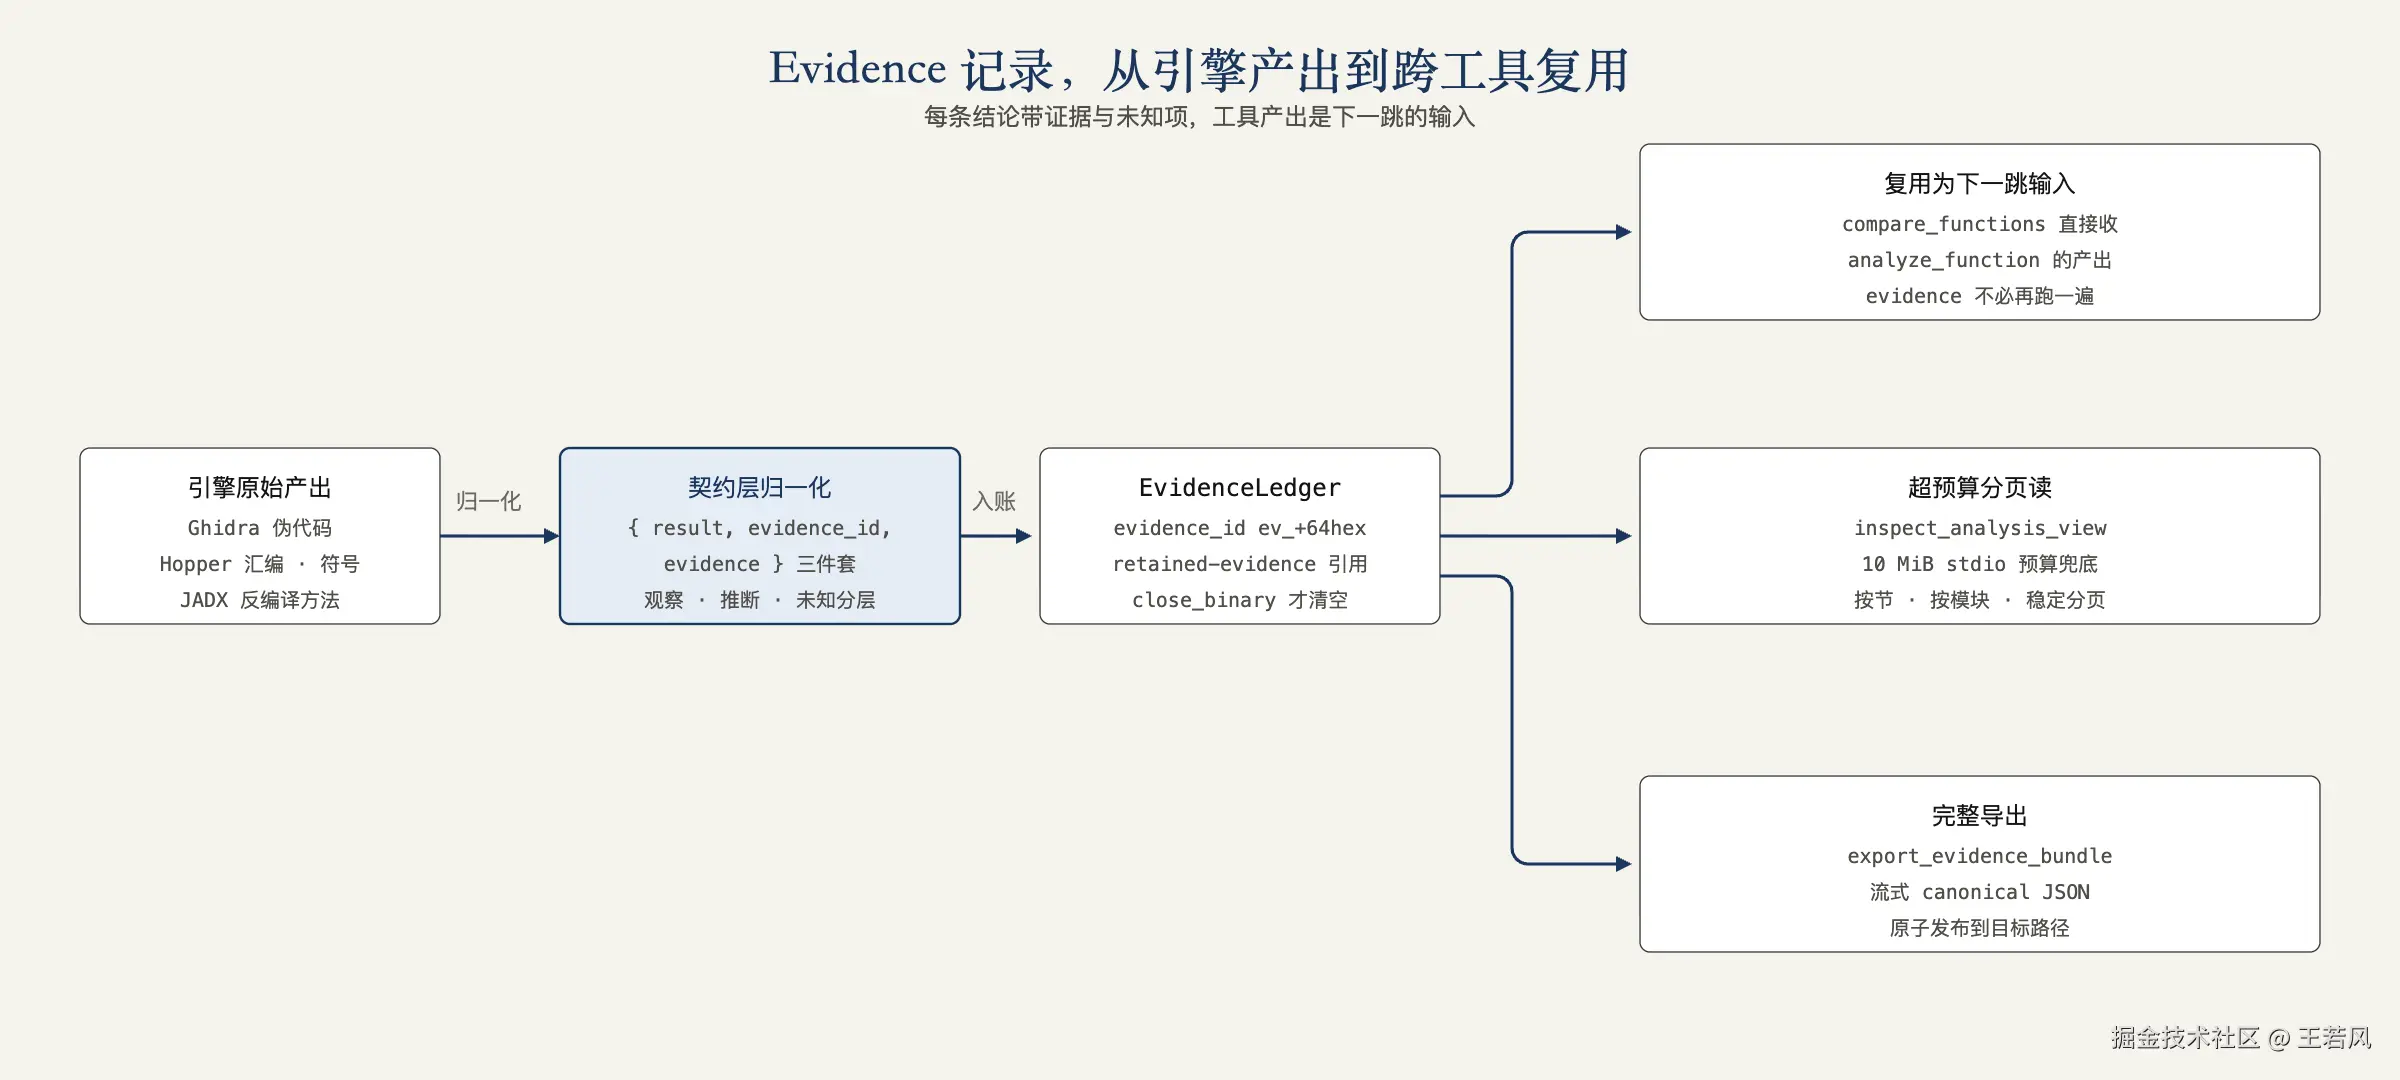
例如,analyze_function 产出的 evidence_id,可以直接作为入参塞给后续的 compare_functions;inspect_artifact 产出的证据可以直接流转至跨平台差异比对工具。工具支持传入完整的证据对象,也支持只传轻量的 evidence_id 引用。
在 rea 中,工具的返回值不是给人类扫一眼就扔的字符串,而是构建系统推论图谱的下一跳积木。
毫米级的反幻觉契约细节
为了防止大模型在细微处编造事实,rea 在协议中注入了大量近乎偏执的工程约定:
- 绝对不伪造进度百分比 :长时间运行的逆向分析(如固件解包)支持向 Agent 发送进度通知,但限流为最多每 100 毫秒一条。契约文档明确规定:如果底层任务无法精确评估总量,协议必须直接省略百分比字段,仅输出当前已处理项------"REA 不得为了视觉平滑而伪造进度百分比"。
- Stdio 10 MiB 缓冲约束与显式逃逸 :MCP 的 stdio 客户端接收缓冲区上限通常为 10 MiB。当反编译结果超过预算时,rea 绝不强行截断,而是直接返回
resource_constraint结构化错误,明确告知 Agent 传输受限,并提供两条确定性的解法路径:- 引导 Agent 调用
inspect_analysis_view按分页与节点取精简摘要; - 引导 Agent 调用
export_evidence_bundle将完整证据会话流式导出为本地持久化文件。
- 引导 Agent 调用
- 计算取消的事务语义:如果 Agent 或用户中途取消了长时间任务,计算让出前产生的一切临时残缺数据一律不入账本,同时确保任务取消前已经落盘的合法证据依然有效可用。
- Source Map 子进程堆隔离:解析巨型 Web/Electron 应用的 Source Map 极易触发 V8 引擎 OOM。rea 将这部分逻辑单独丢进一个限制最大堆内存的 Node.js 独立子进程中运行,哪怕解析崩溃,也绝不拖垮 MCP 主服务进程。
- 显式的未知项(Explicit Unknowns) :在 Schema 设计上,缺失的符号或未被反编译引擎覆盖的代码块,必须显式序列化为
unknown状态,严禁序列化为 null 或空字符串------"未观测到的状态,绝不能被伪装成空事实"。
这套严苛标准在具体逆向场景中是如何落地的?我们可以通过一个具体的函数分析切片来感受:
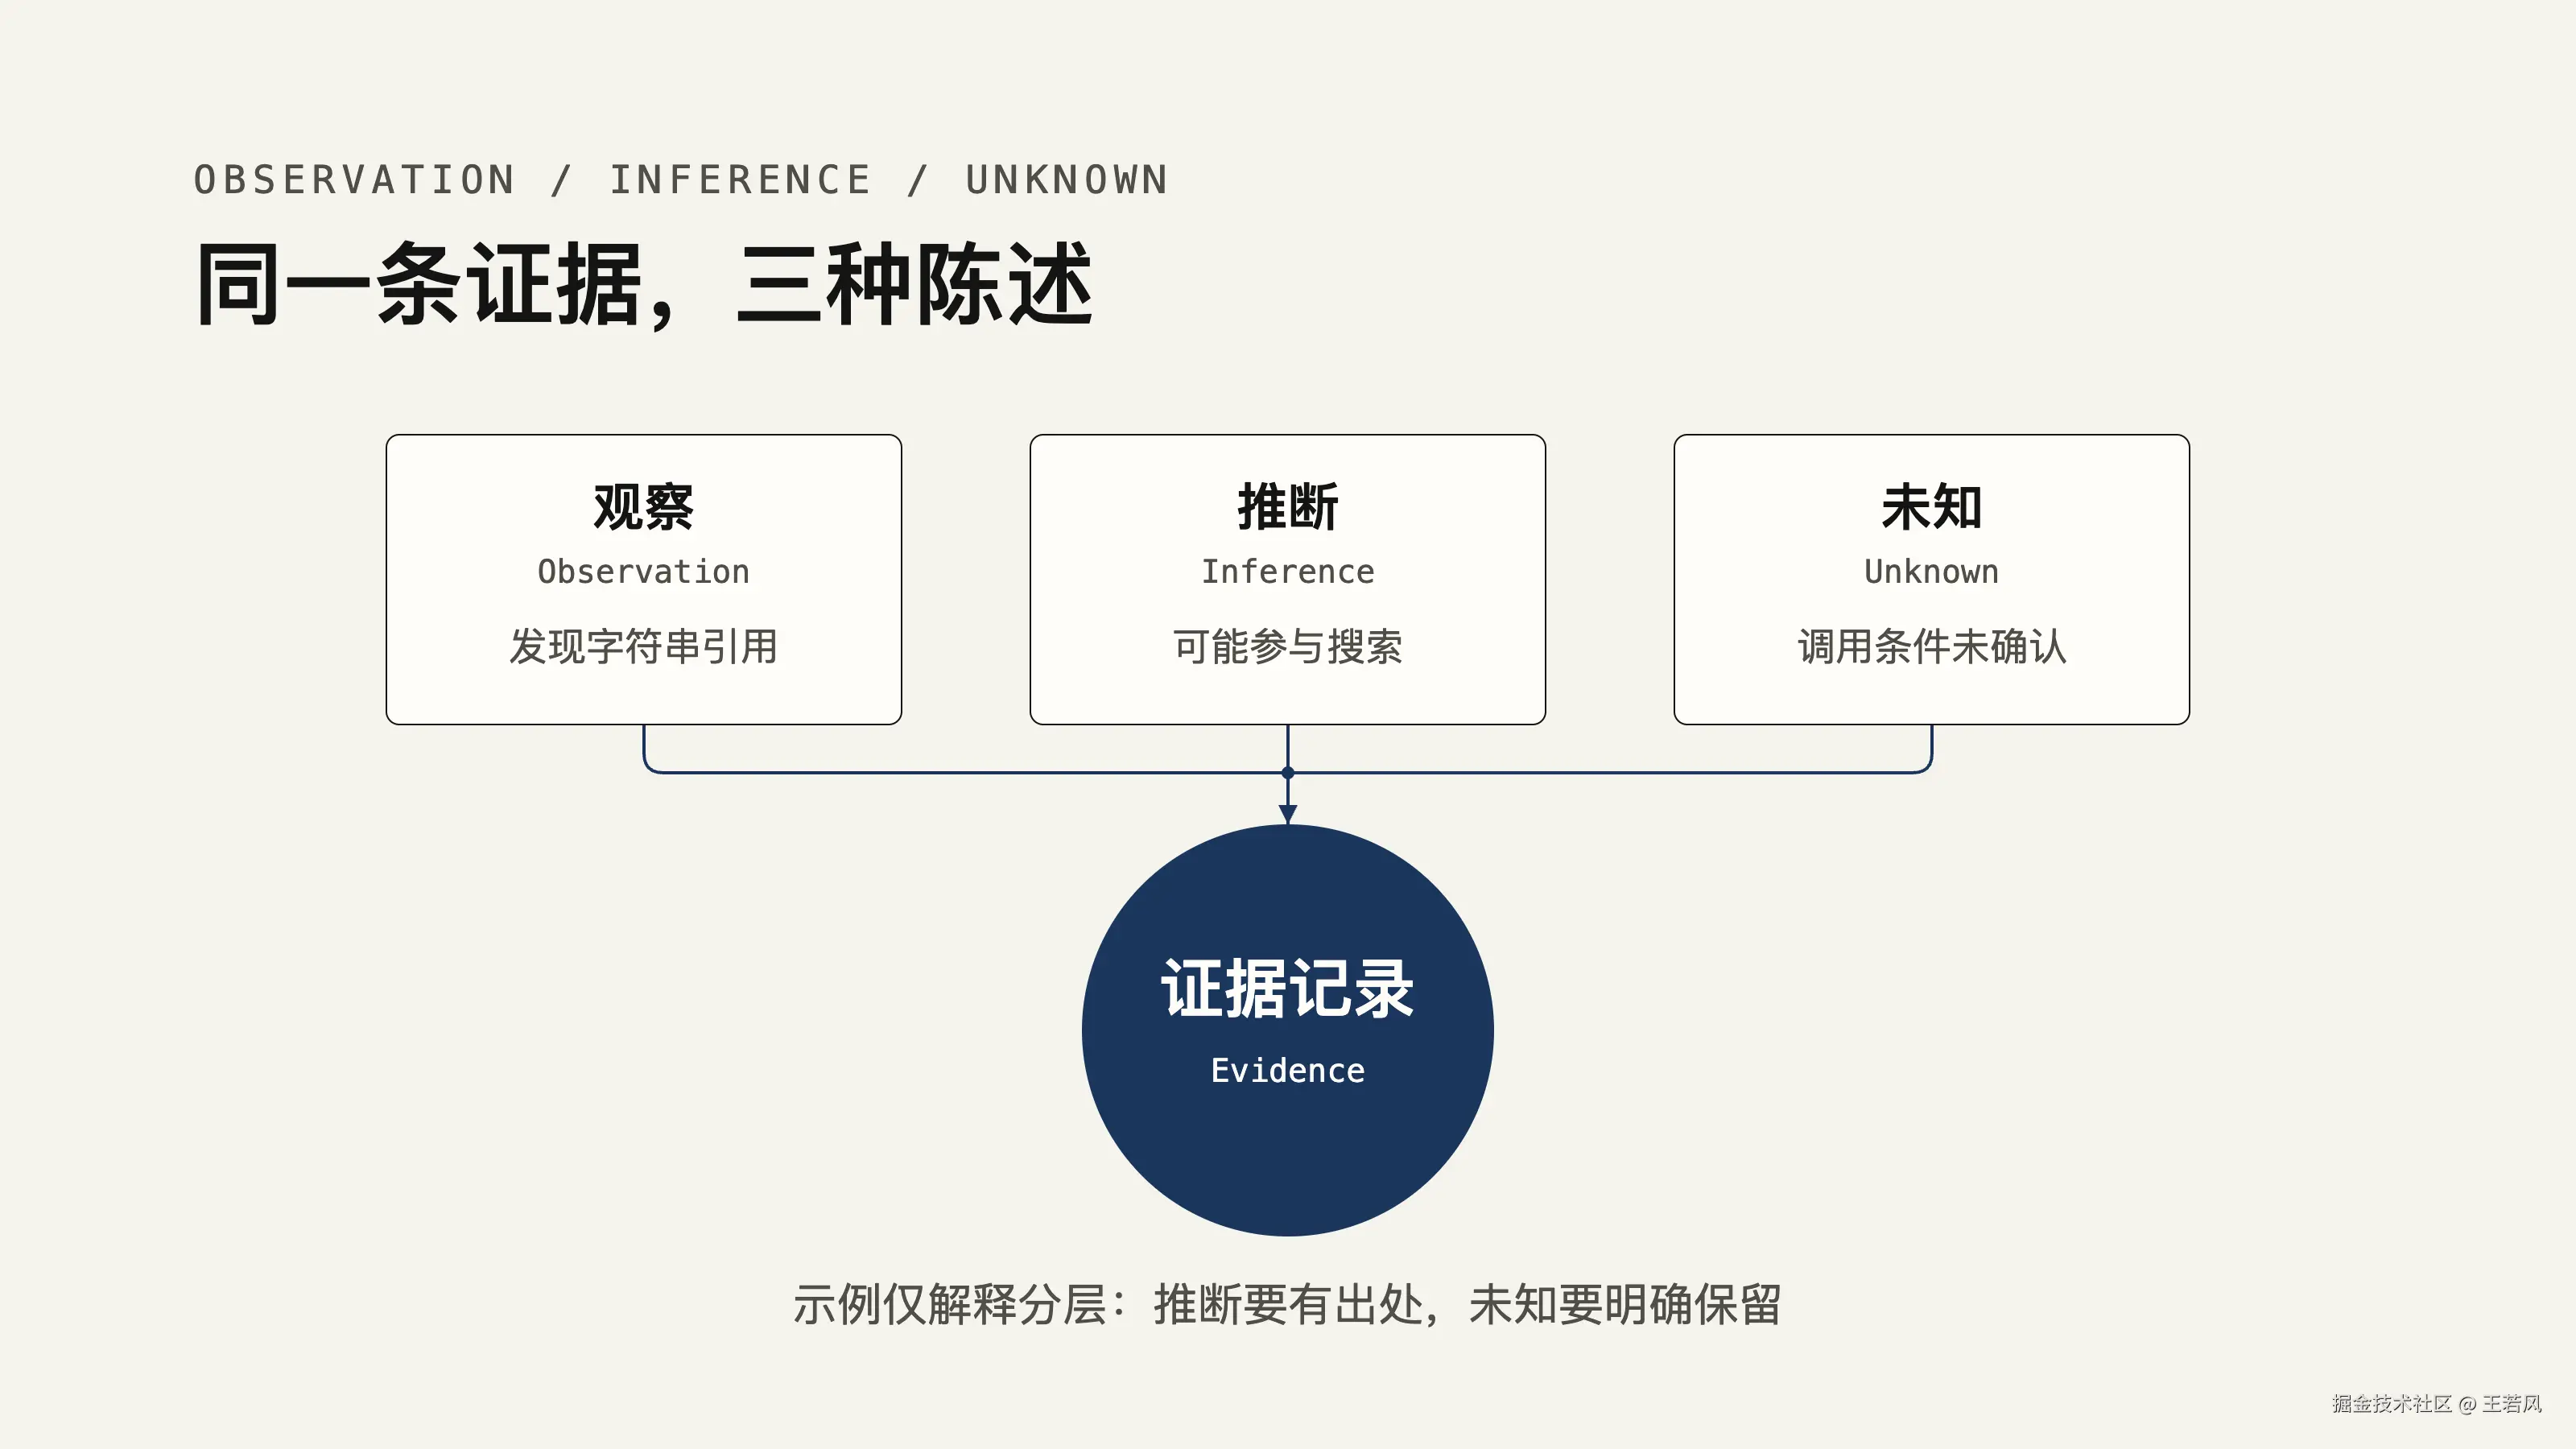
这就是逆向工程里至关重要的三层证据阶梯:
- 观察(Observation) :引擎实测到的硬事实(如绝对地址
0x1004a80存在引用); - 推断(Inference):基于事实的有据推论(如结合上下文推断该函数用于搜索索引),必须附带依据与置信度;
- 未知(Unknown):当前未观测或边界模糊的盲区(如外部调用触发条件),绝不留空或假装不存在。
发现字符串引用,绝不等于已经证实了业务用途。把推断依据与未知盲区显式暴露出来,才能让 Agent 在下一轮分析时清晰知道:自己到底还缺哪一块拼图。
4. 裸机实测:110 条命令与一个不留情面的 doctor
协议定得再严丝合缝,终究要回到终端和 Agent 会话里接受检验。
我在一台完全没有预装任何 Ghidra、Hopper 等逆向工具的 macOS 裸机上,直接执行了最新版的 CLI:
bash
npx rea-agents@latest执行 --help,终端输出了整整 117 行内容,包含约 110 条细分命令。从基础的 analyze、decompile,到硬核的 build-reconstruction-obligation-ledger、demangle-swift。庞大的命令集证明其能力覆盖面极广,但不可否认,新手的认知负担也相当重。
然而,随后的 doctor 自检命令让人眼前一亮。
在没有任何逆向环境的裸机上,doctor 没有抛出一堆杂乱的堆栈报错,而是老老实实输出了 healthy: false,并按顺序完成了 18 项细致入微的系统环境审查。针对缺失的引擎,它逐一给出针对性的补救指南:缺少 Hopper 时提示配置可执行文件或指定 HOPPER_LAUNCHER_PATH;缺少 Ghidra 时明确要求将 GHIDRA_INSTALL_DIR 指向 12.1.x 版本目录。
更令人称道的是,它还会主动巡检本地机器上安装了哪些 AI Agent。在自检过程中,它精确扫描出了我本机开发环境里的 Agent 注册漂移情况。官方文档显示,其巡检规则直接支持了 14 种主流客户端,涵盖 Claude Code、Codex、Cursor、Windsurf 到各种自定义 Agent。
写进 Prompt 里的克制:负向引导
安装进 Agent 内部的 Skill 提示词(版本号已迭代至 34 版)同样体现了极高水准的工程素养。在 Prompt 的开头,作者花了大量篇幅对模型进行负向引导(Negative Guidance):
- 严禁在常规源码仓库的架构分析中滥用 rea;
- 只要逆向工具处于可用状态且注册未失效,直接开始执行任务,严禁每次分析前重复运行
doctor自检。
一个工具能够把「什么时候绝对不要用我」清晰写进给大模型的指令里,这种克制本身就是极高阶的架构思维。
5. 爆红之后:狂飙的发布列车与防御性自治
如果说前面的架构与协议是其内功心法,那么在被流量与聚光灯持续冲刷的这一个月里,rea 展现出的则是一种极具反差的"防御性自治"。
面对海量涌入的 Star 与 Issue,团队没有选择常规的建群或挂赞助,而是疯狂给自己上紧发条。在一个月内,仓库推进了 36 个版本;短短 7 天内更是连发 4 个大版本,包含了多达 23 项 Breaking Changes:
| 版本号 | 发布日期 | Breaking 变更 | 核心演进方向 |
|---|---|---|---|
| 6.2.0 | 10-09 | 6 项 | 彻底重写证据协议,使用 normalized_result 替代旧版封装 |
| 6.3.0 | 10-09 | 8 项 | 收紧屏幕抓拍与浏览器环境契约,严格拒绝无溯源旧数据 |
| 6.4.0 | 10-11 | 9 项 | 引入 ADB 设备巡检、JEB 接入、深度重构资源所有权 API |
| 6.5.0 | 10-14 | 0 项 | 兵器库大扩容:覆盖从 SQLite、HAR 到 NMOS 6502 裸机汇编 |
6.2.0 的那次重构尤为决绝:MCP 的返回数据格式被彻底打破,强制推行规范化的 Evidence 契约。官方在迁移指南的第一行直接挑明:项目严格奉行 always-bump-minor 策略,次版本号的递增本身就包含破坏性变更,绝不代表向后兼容承诺。 任何旧版本的会话记录必须重新生成,严禁通过给旧数据硬补字段来拼凑语义。
这种坦诚虽然体面,但也带来了肉眼可见的代价:当前基于 rea 固化下来的逆向证据,有效保质期基本以天为单位计算。
能力野蛮扩张下的边界感
在版本狂飙的同时,其能力版图也在疯狂拓宽:
- 安卓端接入了 ADB 设备动态巡检、Split-APK 提取、Logcat 日志与实时截屏;
- Web 端支持直接从打包 JS 中反向提取 tRPC 路由与具名 GraphQL 查询;
- 扩展支持了 SQLite 快照、TShark 流量解析、sigrok 逻辑分析仪信号解码、QUIC 协议 qlog 追踪、Fiddler SAZ 归档、WASM 逆向,甚至连 1975 年红白机 CPU 架构的 NMOS 6502 裸机固件都支持无头分析。
但值得注意的是,每增加一项新能力,rea 都会在其后附加一份极其详尽的已验证范围声明(Verified Scope) 。例如 sigrok 明确标注"仅支持 Linux、必须启用 prlimit 内存限制、不负责物理硬件信号采集";SQLite 快照分析明确要求"必须在带有 DatabaseSync.limits 的 Node.js 24.15+ 运行时中执行,且带 WAL 模式的活库拷贝不被承认为原子快照"。
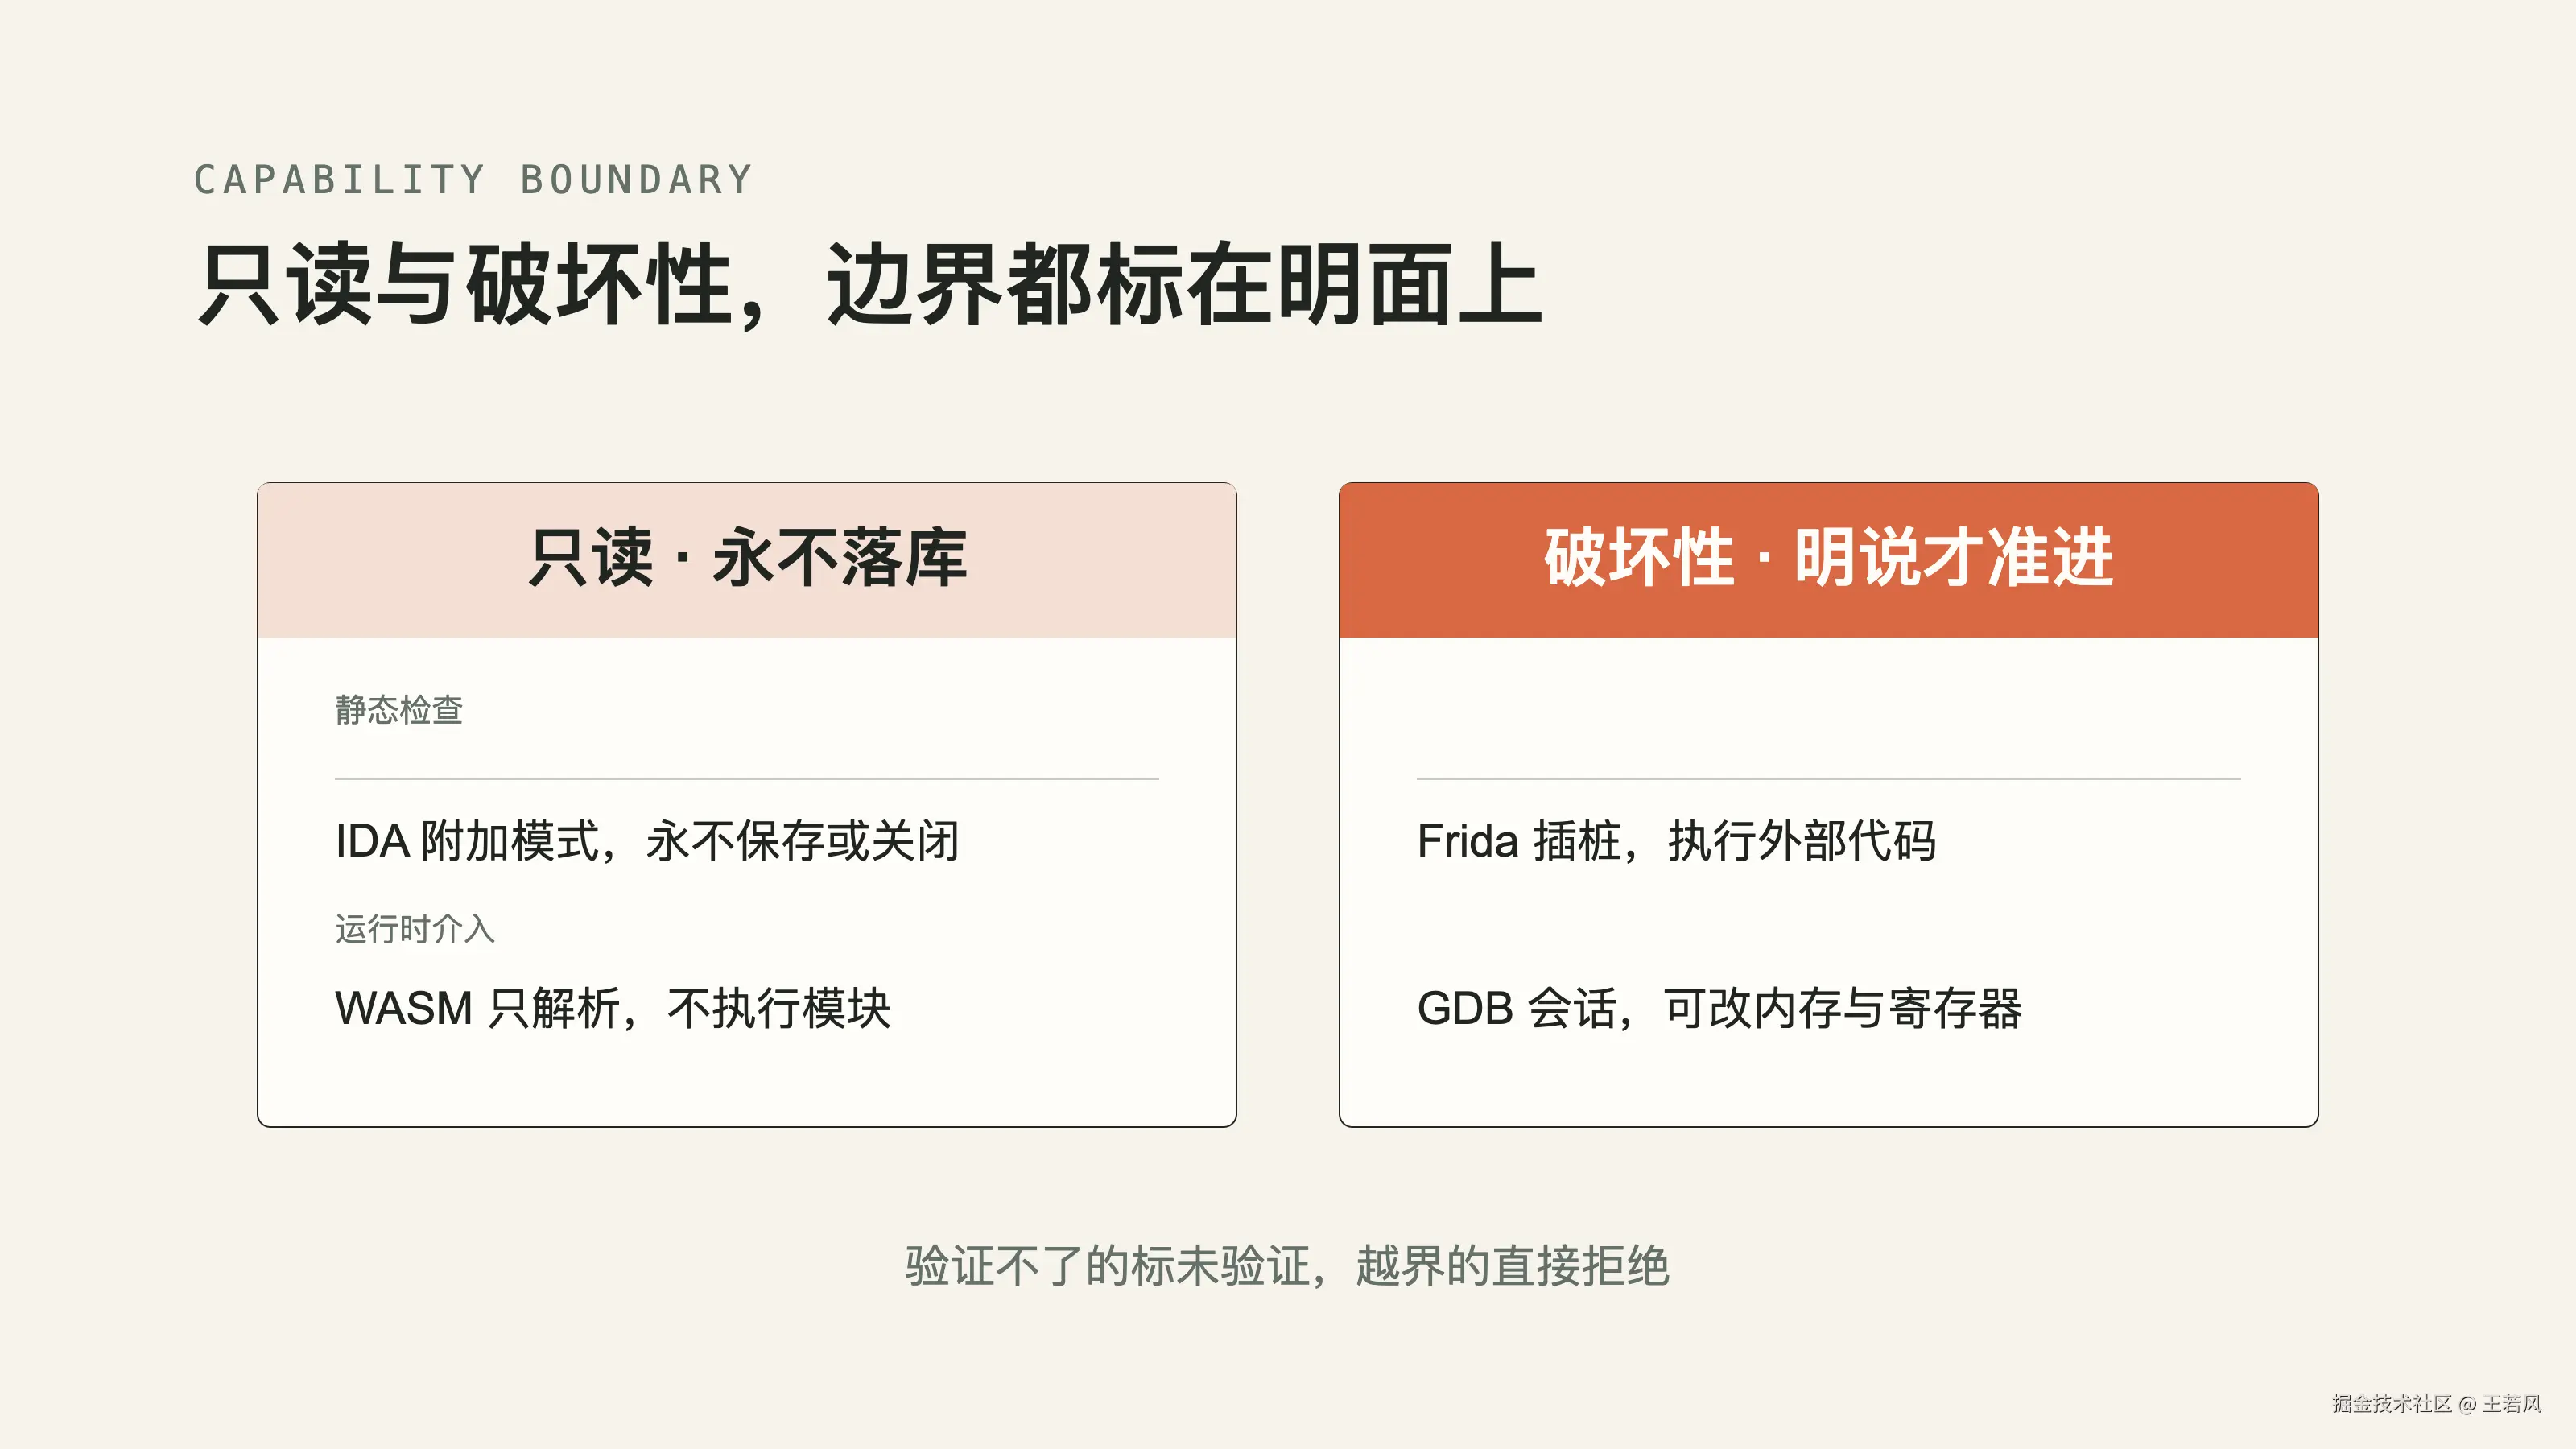
当引入基于 Frida 的动态 Hook 插桩能力时,官方在发布日志中格外郑重地标注:动态插桩涉及在外部目标进程内注入执行任意代码,具备破坏性(Destructive),不再属于只读安全边界。 这种将只读分析与破坏性执行泾渭分明的界限划分,展现出了极具说服力的安全底线。
6. 残局治理:为什么资源清理不能只是一个 finally 块?
拆完整套代码后,最让我感到震撼的不是其反编译能力的丰富,而是他们在**残局处理(Cleanup & Retention)**上所下的硬功夫。
翻看最近几天的 Git Commit,连续数十条提交全都是清一色的 fix,且绝大多数都在死磕同一件事:当逆向分析失败、超时或者被 Agent 强行取消时,那些打开的几百个文件句柄、挂载的动态调试器、启动的子进程和临时解压目录,到底该由谁来善后?
在普通命令行工具中,开发者按一下 Ctrl + C,操作系统内核会自动回收进程表与文件描述符。但当工具由 AI Agent 驱动时,逻辑完全变了:
Agent 在一次复杂的逆向推理中,往往需要链式触发数十个工具调用。
中间任何一步如果发生异常,泄漏的文件句柄或孤儿调试进程会直接锁死后续所有分析步骤;而更灾难的是,如果清理逻辑写得过于粗暴,把前几步已经花费大量算力生成的合法分析产物一起当成垃圾清理掉了,Agent 在下一轮推理中就只能被迫从头再来。
在 Issue #2799 中,作者完整披露了一场架构大手术:在 6.4.0 版本中,rea 引入了调用方自持的 ArtifactResourceScope 生命周期管控机制,并贯穿解包、分析、加载到回收的完整生命周期:
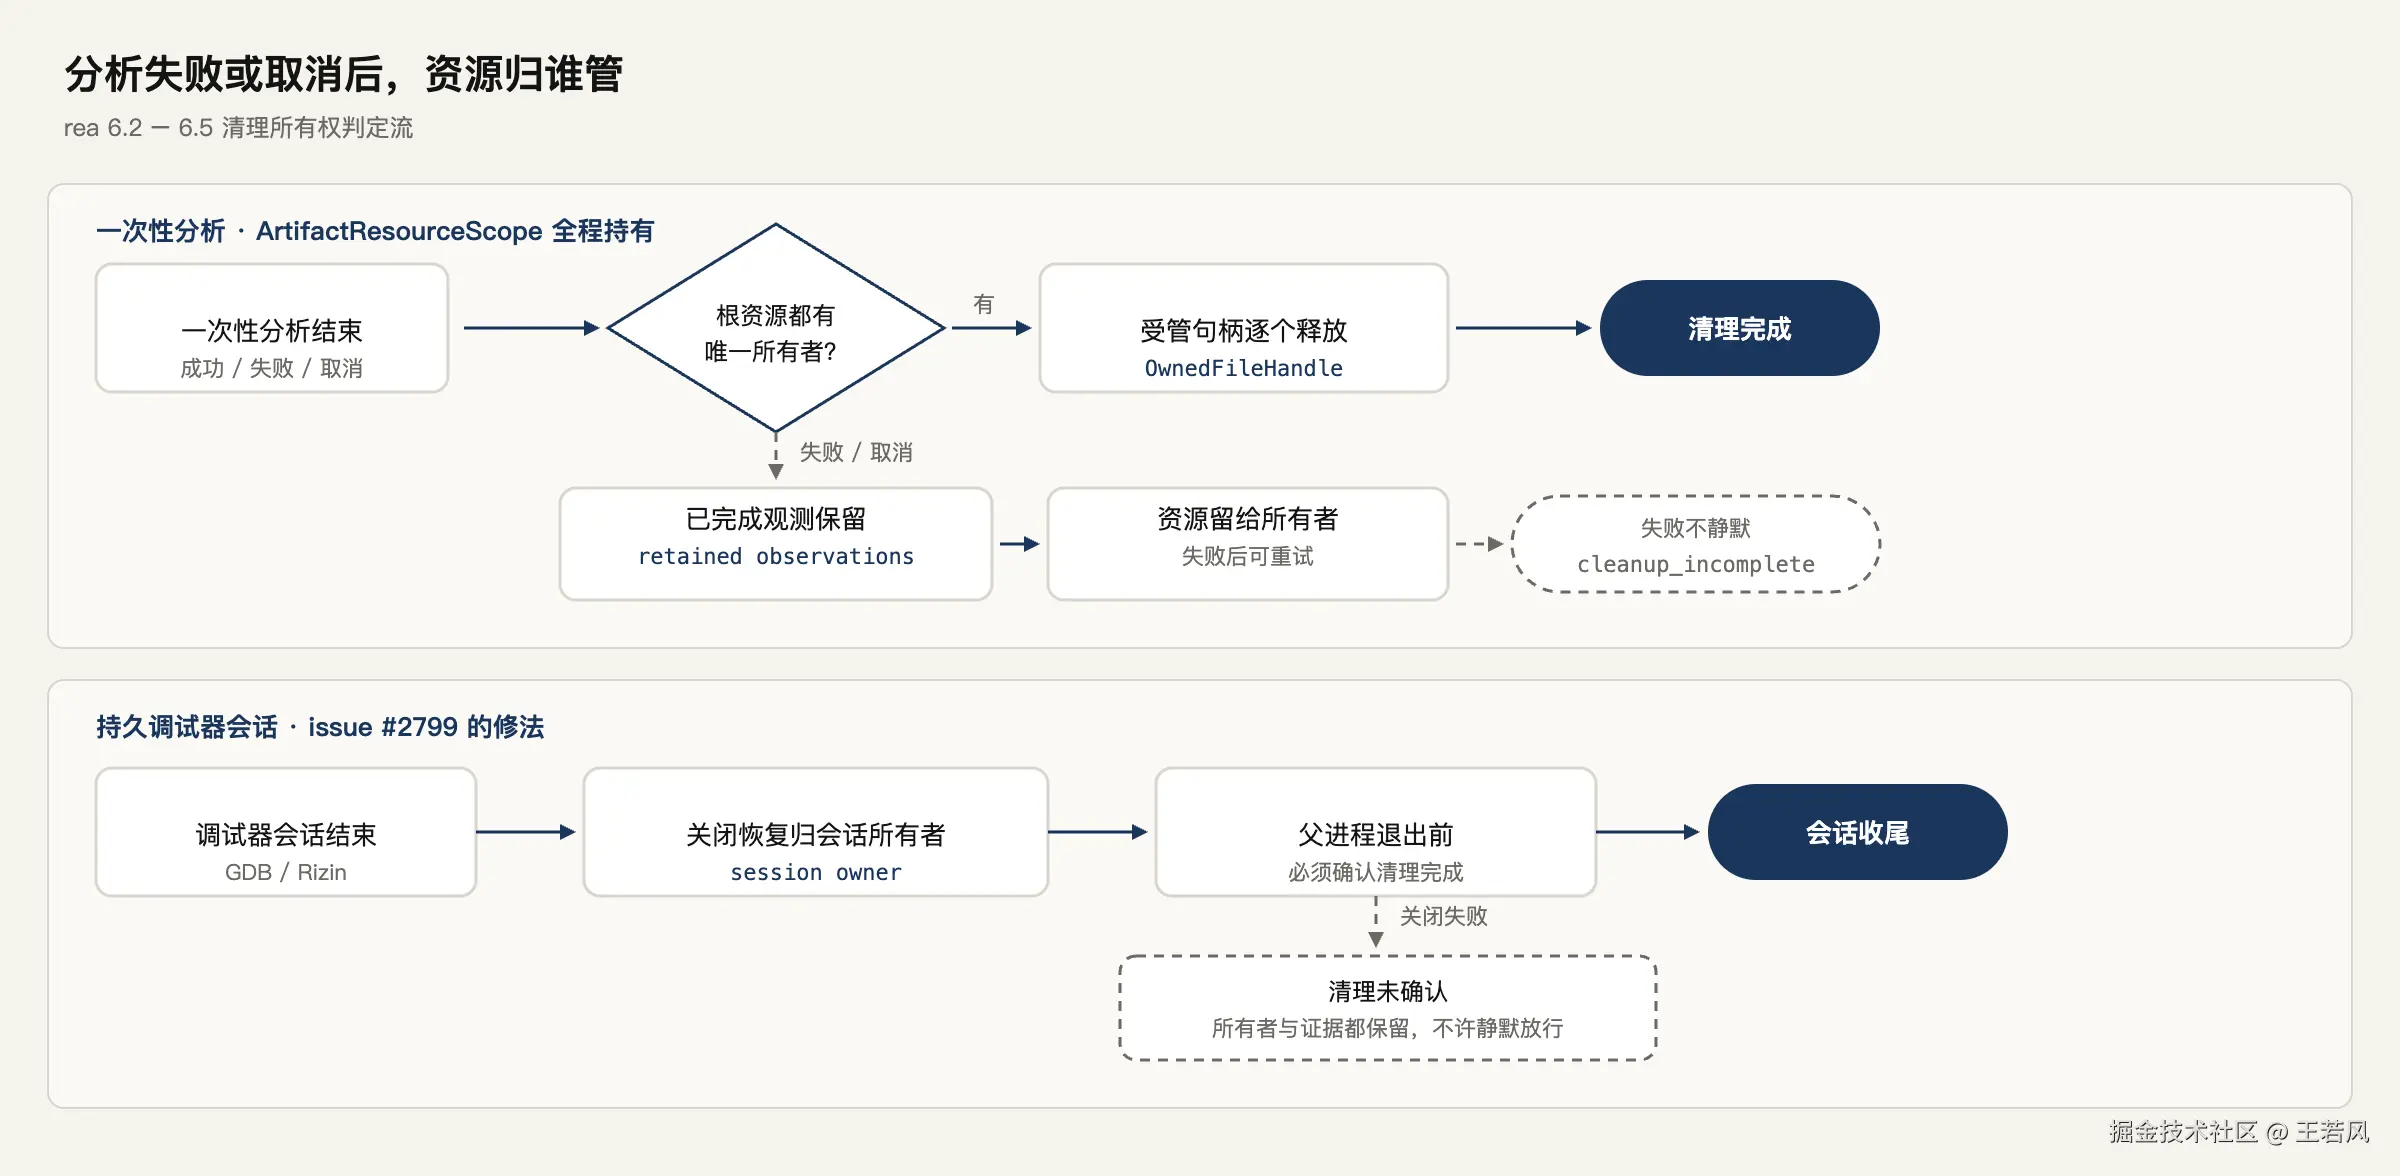
- 句柄受管化 :将裸文件操作全面替换为具备所有权语义的
OwnedFileHandle,彻底废弃未经托管的流操作; - 清理所有权唯一化:每一组衍生资源有且仅有一个唯一的清理持有者(Cleanup Owner)。当外部环境触发异常时,由持有者负责调度 GDB 或 Rizin 调试器的关闭握手;
- 失败时的部分证据保留 :即使资源清理过程发生异常,系统绝不抛出未经处理的未捕获异常,而是向 Agent 汇报明确的
cleanup_incomplete契约错误,同时竭尽全力保留此前已经生成的有效证据。
随之公布的一组基准性能测试足以说明这套机制的威力:在对 16 MiB 帧数据切分 256 块进行并发解析的场景下,冷启动开销从 154.5 ms 骤降至 3.5 ms,内存峰值占用从 1.17 GiB 暴跌至 248 MiB。令人敬佩的是,写下这组基准测试数据的作者,还在报告末尾冷静地补了一句声明:"本测试仅反映特定块解析场景,不构成系统端到端提速的宽泛承诺"。
7. 盛名之下的冷思考:狂飙列车与单点维护风险
拆解技术方案不能只唱赞歌。对于考虑在实际业务中跟进或选型的团队,rea 目前存在几个必须正视的现实风险:
- 版本更新过于激进,缺乏向后兼容承诺:首发至今短短一个月推进了 36 个版本,多次把 Minor 版本号当 Major 用。你今天基于当前版本调试通畅的自动化逆向流水线,下周就可能因为上游的 Breaking Changes 无法运行。证据存档格式的变化,使得构建长周期的自动化 CI/CD 质检非常艰难。
- 极度集中的维护结构(Bus Factor = 3):翻阅项目的贡献者图谱,核心作者 morluto 一个人贡献了超过 1,700 次提交,仅最近一周就独自提交了 790 余次代码;排名前三的贡献者包揽了非 Bot 提交的 90% 以上。随着架构防线和准入门槛越设越高,核心维护者的代码 Review 速度已经成为整条流水线唯一的吞吐瓶颈。
- 外部蹭热度乱象:伴随 GitHub 狂揽 27 万 Star,社区周边开始出现仿冒仓库,甚至有人打着该项目的旗号发行同名加密货币,逼得官方不得不在 README 首页用 18 种语言加粗澄清"未发行亦不背书任何代币"。这种过高的噪音,也在一定程度上分散了核心团队的迭代精力。
8. 总结:两套普适工程模式与理性选型建议
抛开逆向工程本身的领域壁垒,rea 对整个 Agent 工具生态最大的贡献,在于它验证并沉淀了两套可直接复用在任何专业垂直领域的工程范式:
模式一:反幻觉脚手架(Anti-Hallucination Scaffolding)
在为专业垂直领域(无论是逆向、数据库调优、性能排障还是金融量化)编写 MCP 工具时,核心工作绝不是堆砌一堆让模型直接执行的自然语言接口,而是先找到该领域里「什么样的业务断言必须提供出处」,并将其强行编译进 Schema 。
逆向工程界恪守了几十年的铁律------结论必须附带地址与交叉引用、测试覆盖率必须精确度量、未观测项必须显式承认。rea 把这些铁律翻译成了 evidence_id、resource_constraint 以及链式流转的 EvidenceLedger。我们无法在模型底层完全消除幻觉,但我们可以在协议层搭起坚固的脚手架,逼迫模型在每一个可能发生幻觉的分支上,都必须交出真实的证据。
模式二:变更即证据(Change-as-Evidence)
当一个系统的迭代速度注定停不下来时,最佳的解法不是试图遏制变化,而是把每次变更本身也纳入证据链。通过精确的迁移指引、显式的运行环境依赖标注(如前置 Node 版本与操作系统限制),以及不加夸大的基准性能标注,让下游集成方把一次充满未知的"版本升级",变成一次边界清晰、风险可控的工程操作。
给开发者的选型建议
最后,如果你正考虑在团队或个人工作流中引入 rea,送上三条直接的选型参考:
- 如果你需要逆向 Electron / 静态 Web 应用、还原打包模块或做版本代码差异比对:无需任何犹豫,现在就可以直接接入。由于纯 JS/TypeScript 分析完全依赖 Node.js 运行时,环境极其干净,开箱即用。
- 如果你需要逆向原生二进制,且团队日常本来就有使用 Hopper、Ghidra 或 IDA 的技术积累:强烈推荐立即在本地环境配置体验。配合 Claude Code 或 Cursor,它所带来的可溯源证据链体验,绝对是传统纯手工作业所无法比拟的。
- 如果你期望构建一套跨版本的长期自动化流水线,或者高度依赖 Windows 原生逆向:建议先在测试分支保持观望。目前架构依然在高速演进,建议等版本列车的刹车片踩稳几站之后,再进行深度业务集成。
动手体验之前,别忘了先在终端里执行一次:
bash
npx rea-agents@latest doctor让它先为你那台机器的逆向环境,做一次诚实而彻底的体检。