很多 AI 聊天示例只展示了"调用模型 API 并打印回答"。真正做成一个聊天后端,还要处理会话管理、消息持久化、多轮上下文、流式传输,以及模型调用失败时的数据一致性。本文记录我基于 FastAPI 搭建 AI 聊天后端的过程,以及实现中的取舍和踩坑。
一、项目介绍
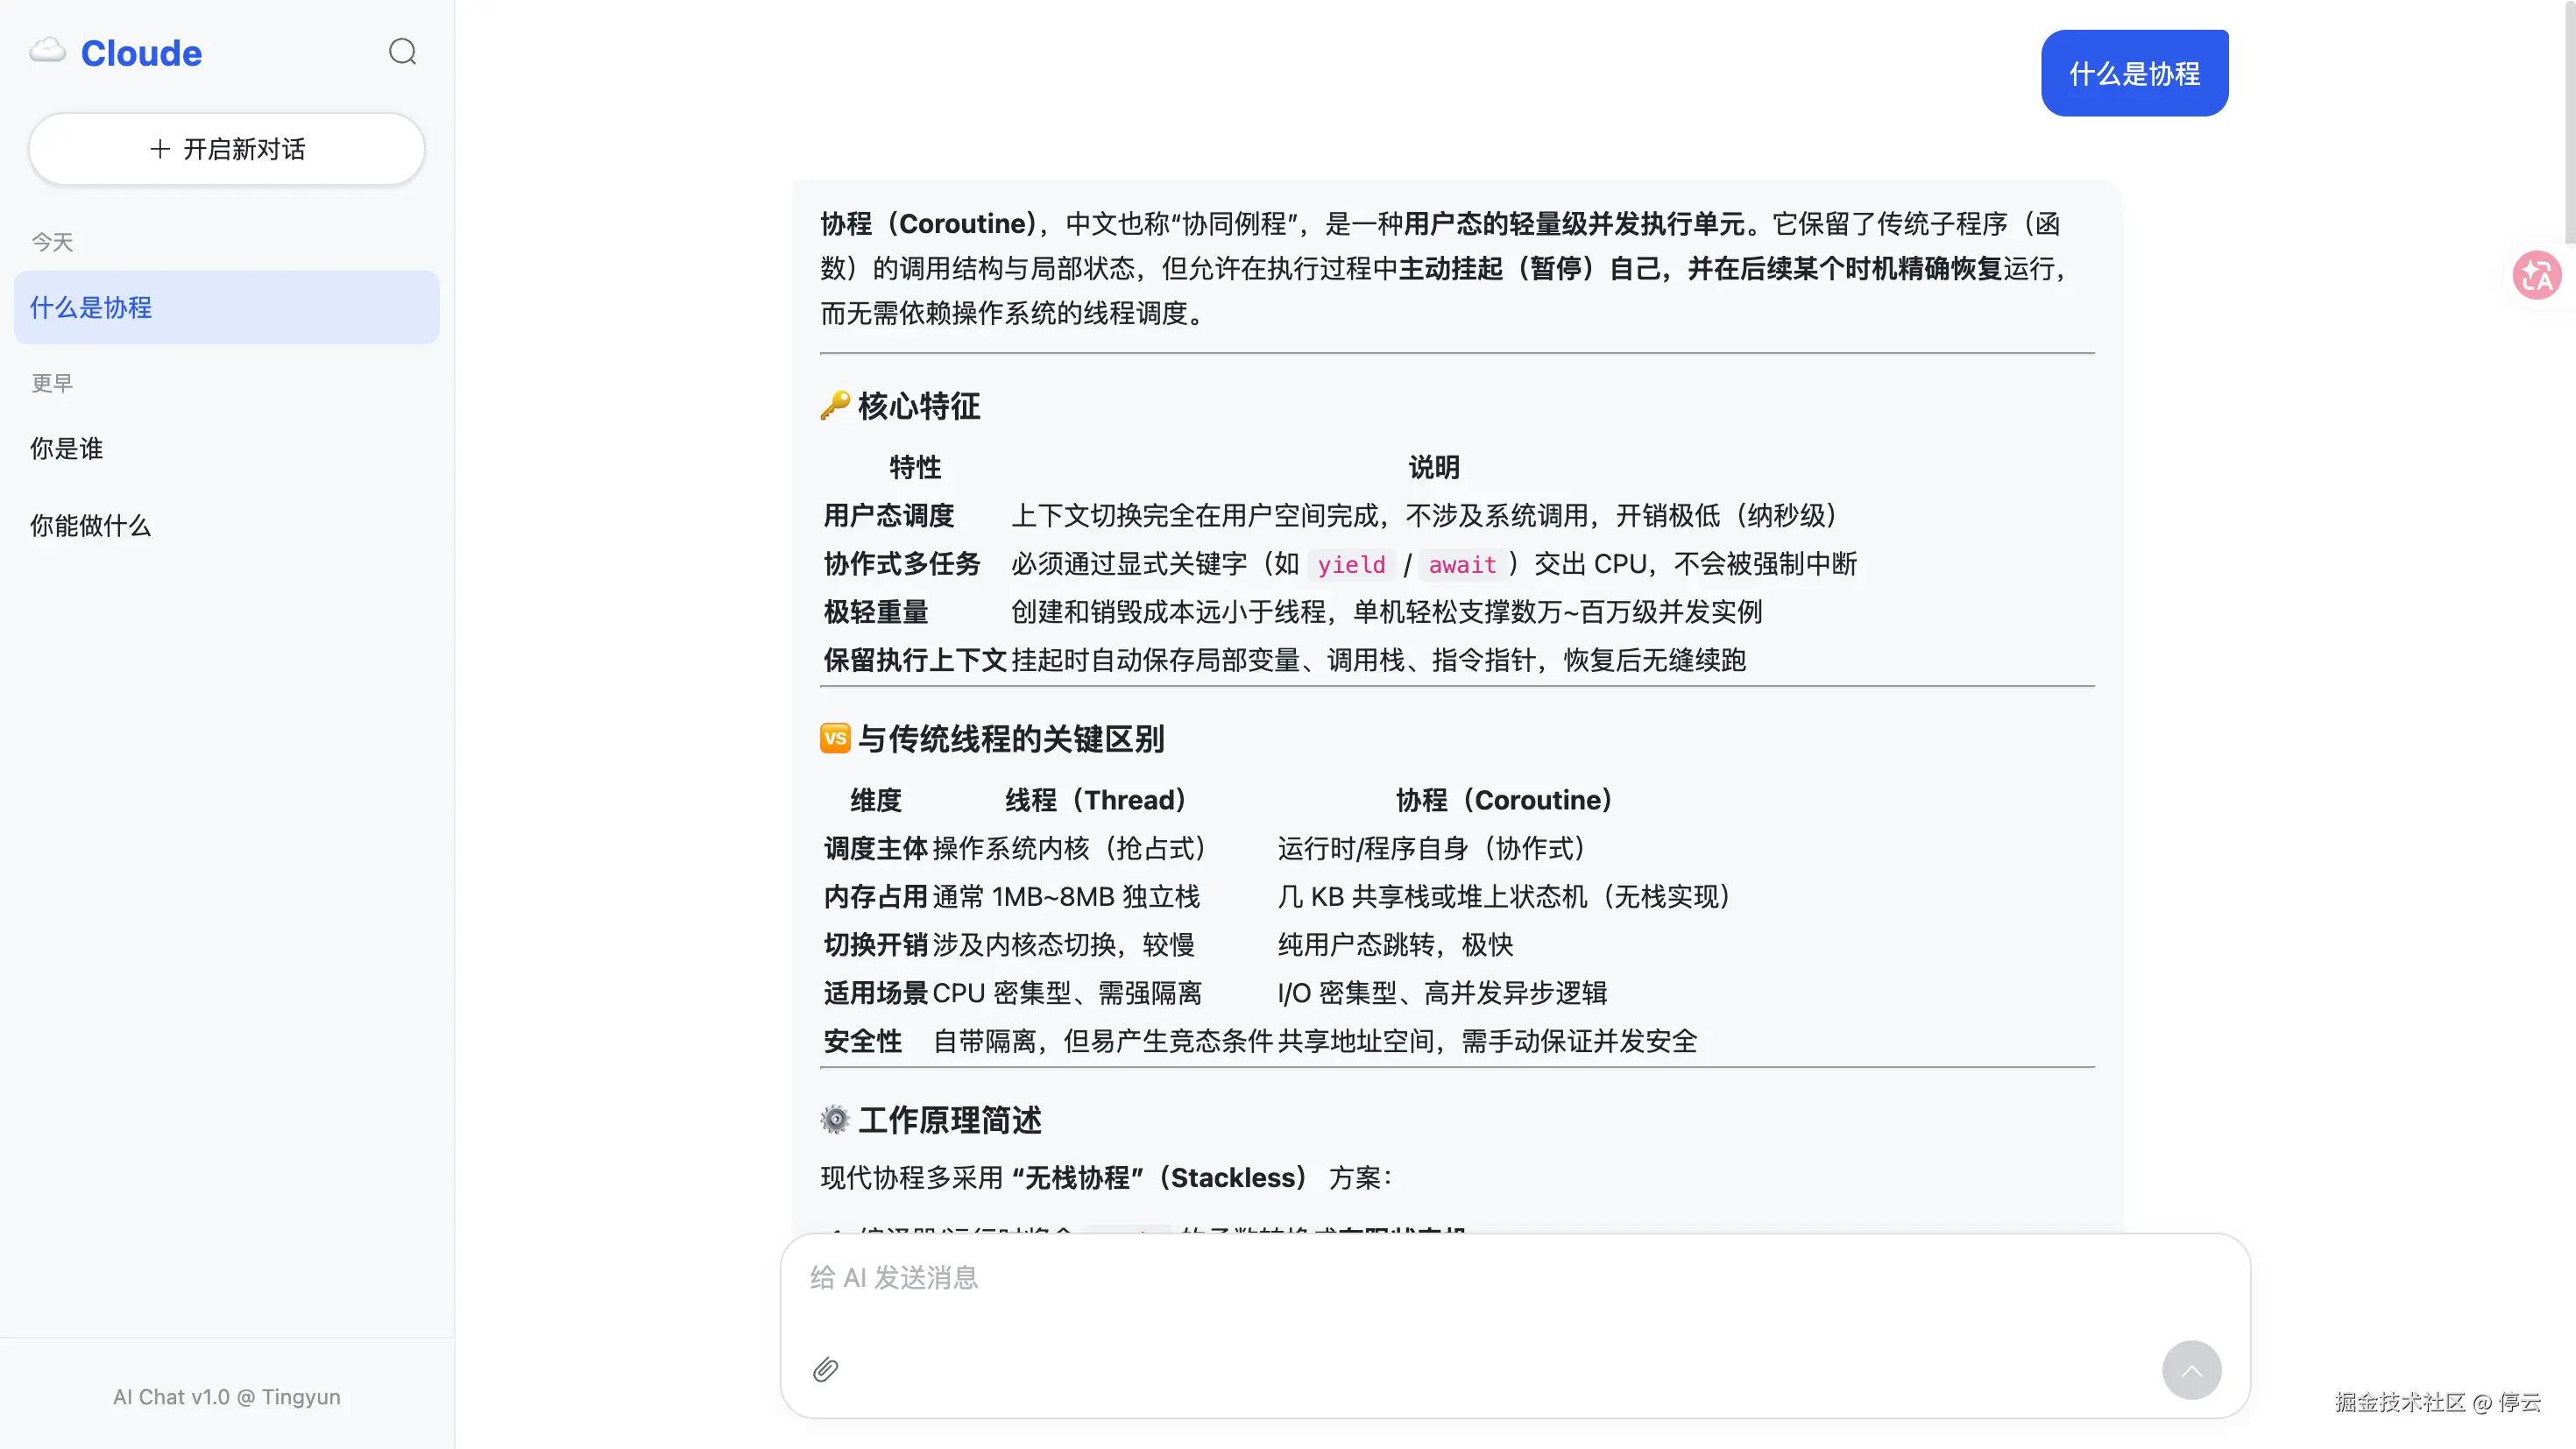
这个项目实现了一个简单的 AI 聊天后端,主要功能包括:
- 创建、查询、重命名、暂停会话、重新生成和删除会话
- 查询会话下的历史消息
- 调用兼容 OpenAI API 的模型服务
- 通过 SSE 将模型回答逐段推送给前端
- 将用户消息和 AI 回答保存到数据库
项目的核心不是"把问题转发给模型",而是建立一条完整的数据流:
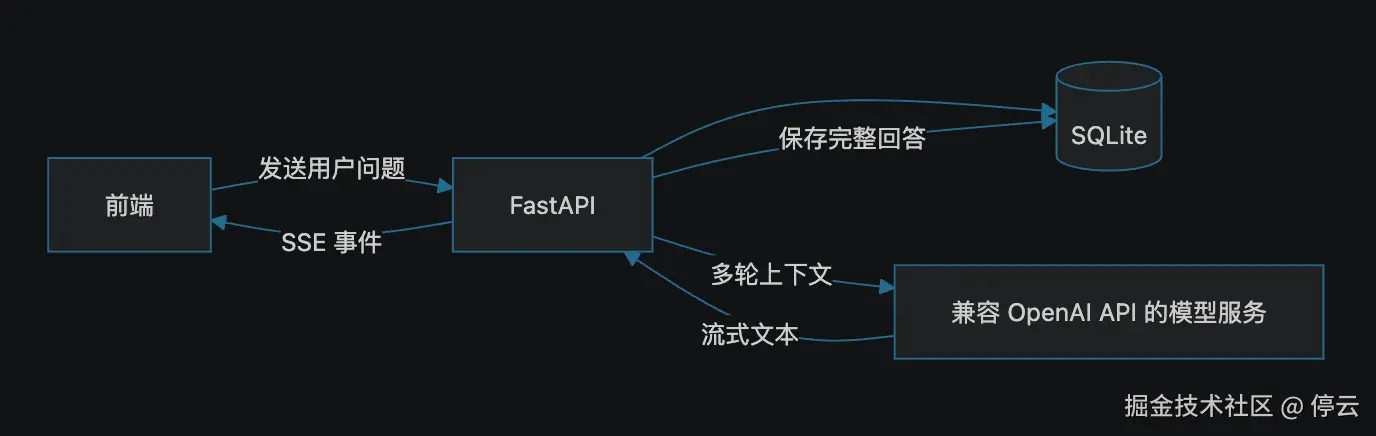
二、技术栈
- FastAPI:提供 REST API 和依赖注入
- Pydantic:体验请求体
- SQLAlchemy Async ORM:异步访问数据库
- SQLite:本地存储会话和消息
- OpenAI Python SDK:调用兼容 OpenAI API 的模型服务
- SSE:将模型生成的文本分段推送给浏览器
- CORSMiddleware:开发阶段处理跨域请求
模型服务地址和 API Key 不应该写死在代码里。项目从环境变量读取 DASHSCOPE_API_KEY,部署时也应确保密钥只存在于服务端环境中,不要放进前端代码或提交到代码仓库。
三、核心数据模型
项目将会话和消息拆成两张表:
Session:保存会话标题、创建时间和更新时间Messages:保存会话 ID、角色、内容和创建时间、消息状态、暂停原因
这样做是为了让会话列表与消息历史可以分别查询,也便于按会话删除消息。
消息角色使用枚举表示:
python
class RoleEnum(str, enum.Enum):
    SYSTEM = "system"
    USER = "user"
    ASSISTANT = "assistant"
把角色限制在明确的曲直范围内,比直接在数据库里存任意字符串更容易发现无效数据。不过,接口层的请求模型也应进行角色校验,避免错误值直接写入数据库时才暴露。
四、核心难点
1. SSE 流式输出
为什么使用 SSE
如果等模型生成完整回答后再返回,用户只能在模型完成后看到整段文本。SSE 允许服务端通过一个 HTTP 响应持续推送事件,前端可以边接收边显示内容。
目前后端把每段生成内容封装成 SSE 事件:
python
yield f"data: {json.dumps({'content': delta}, ensure_ascii=False)}\n\n"事件以空行分隔,生成结束时再发送结束标记:
python
yield "data: [DONE]\n\n"这里需要注意:SSE 不是简单地"返回一个字符串"。服务端需要保持响应连接,并按 SSE 格式发送数据;前端也要按事件流解析,而不是把整个响应当作普通 JSON。
服务器返回
Content-Type: text/event-stream→ 保持 TCP 连接不中断 → 随着 LLM 生成内容,持续向该连接写入data: ...\n\n格式的数据块 → 直到发送[DONE]才主动关闭连接。这是一个长连接、单向推送的流式模型。
一个容易忽略的异步问题
OpenAI SDK 的同步流如果直接在 async def 中用普通 for 遍历,遍历过程仍可能阻塞事件循环。即使创建流的调用放进了线程池,也不代表后续读取每个 chunk 自动变成异步。
⚠️ 踩坑反思:初版实现中我使用了
asyncio.to_thread包装同步 SDK 的流创建调用,误以为这样就实现了全链路异步。但实际上for chunk in stream仍然是同步阻塞的------to_thread只解决了"建连"的阻塞,没有解决"消费"的阻塞。当模型响应较慢时,这个同步迭代会卡住整个事件循环,影响其他请求。正确做法 是使用 OpenAI SDK 原生的
AsyncOpenAI客户端配合async for,实现从建连到消费的完整异步链路。
2. 多轮对话上下文
多轮对话的核心是将历史消息拼接成 messages 数组传给 LLM。但这里有一个隐蔽的时序问题:
- 用户发送消息 -> 需要先存入 DB
- 查询该 session 所有历史消息 -> 构造 context
- 调用 LLM 流式生成 -> 边生成边推送给前端
- 流结束后 -> 把 AI 的完整回复存入 DB 陷阱:在
StreamingResponse的生成器执行时,外层的 FastAPI 请求上下文已经结束,依赖注入的session已被关闭。如果直接在生成器里用外层 session 保存 AI 回复,会报SessionClosed错误。
解决方案:生成器内部独立创建 Session
python
# ✅ 流结束后,新开一个独立的 session 来保存 AI 回复
async with AsyncSessionLocal() as save_session:
    ai_msg = Messages(
        session_id=session_id,
        role=RoleEnum.ASSISTANT,
        content=full_reply,
    )
    save_session.add(ai_msg)

    # 同时更新会话的 update_at 时间戳
    target = (await save_session.execute(
        select(Sessions).where(Sessions.id == session_id)
    )).scalar_one()
    target.update_at = datetime.now()

await save_session.commit()设计亮点:
- 用户消息在流开始前就 commit,确保即使 AI 调用失败,用户的输入也不会丢失。
- AI 回复在流结束后才 commit,保证存入的是完整内容,而非碎片。
- 使用独立的
AsyncSessionLocal()彻底解耦请求生命周期与流式响应生命周期。
3. 重新生成对话
3.1. 如何保留多次生成结果
重新生成时,不能简单覆盖原来的 AI 回复:这样既无法保留历史版本,也无法展示或比较不同回答。
当前做法是:每次重新生成,都创建一条新的 AI 消息,用 parent_id 指向对应的用户消息,用 version 记录这是第几版。
例如:
| 用户消息 | AI 回复版本 | 含义 |
|---|---|---|
| "解释一下异步" | 1 | 第一次回答 |
| "解释一下异步" | 2 | 第一次重新生成 |
| "解释一下异步" | 3 | 第二次重新生成 |
关键点在于: "重新生成"是在同一条用户消息下增加新版本,而不是覆盖旧回复。
3.2. 如何构造不会重复、又符合对话顺序的上下文
发送给模型的上下文必须包含此前对话和当前问题,但要避免重复。
重新生成时,当前用户消息本来已经存在数据库中,如果历史查询把它也取出来,然后再追加一次,就会导致同一个问题被发送两遍。因此实现中查询当前用户消息之前的已完成历史,再把当前用户消息单独追加到末尾。
此外,旧 AI 回复版本虽然留在数据库中,但不能把所有版本都传给模型,否则同一轮对话会出现多条 AI 回答。代码通过_build_messages_payload按用户消息的 parent_id 分组,只选择最高版本的已完成 AI 回复作为上下文。
这里的难点是要区分:
- 数据库中保留的历史:可以包含多个 AI 回复版本;
- 发给模型的有效对话上下文:每轮只应该包含选定的一个 AI 回复版本。
3.3. 如何处理停止生成,而不丢失已生成内容
这里的"暂停"实际上是取消当前生成任务,不是从模型的某个 token 位置真正续传。
停止时会调用 task.cancel(),让生成协程收到 asyncio.CancalledError。取消处理中,生产者要:
- 将状态设置为
PAUSED; - 将已生成内容保存到数据库;
- 完成保存后,再传播取消信号。
这里需要注意:收到取消信号后,清理工作本身也可能被取消。如果数据库写入也被中断,就会出现前端已经看到部分文本,但数据库没有保存的情况。因此代码使用 asyncio.shield(...) 保护持久化任务,并等待保存完成。
再次点击重新生成时,会发起全新的模型请求,创建下一个版本;不会接着之前的部分回答继续生成。
3.4. 如何避免同一会话出现相互冲突的生成任务
如果同一会话的两个请求同时开始生成,它们可能会:
- 同时创建回复版本;
- 互相覆盖
active_tasks中的任务记录; - 让停止接口无法明确应该取消哪一个任务。
当前实现用会话级预留状态和异步锁,在创建生成任务前检查该会话是否已经有任务运行。任务正式登记后,再释放预留状态。生成结束时则移除任务记录。
这样能解决单进程应用中的会话级并发问题,但它不是跨多个进程或 Uvicorn worker 的分布式锁。
3.5. 为什么要为客户端断开连接设计清理逻辑
SSE 连接可能中途断开。如果消费者停止读取队列,生产者却继续调用模型,就会白白消耗资源;队列中的数据也可能不断累积。
因此消费者在流没有正常完成、但客户端已经中断时,会请求取消生成任务,并等待任务结束和保存结果。这里体现了一个重要原则:
流式响应结束和后台任务结束不是天然绑定的,需要应用代码明确处理任务的取消与清理。
这套"重新生成"功能的难点,不只是再次调用一次模型 API,而是要同时处理回复版本、上下文构造、异步流式传输、任务并发、取消后的数据持久化,以及客户端断开时的资源清理。
五、踩坑记录与改进方向
1. Pydantic 请求对象的字段层级
请求体是:
json
{
    "messages": [
        {
            "role": "user",
            "content": "你是谁"
        }
    ],
    "model": "qwen3.7-flash"
}
content 属于 messages 中的单条消息,不属于整个请求对象。因此应从 payload.messages 中获取消息,而不是访问 payload.content。
这次排查让我更明确地认识到:看起来 JSON 里存在某个字段,不代表它就在请求模型的顶层;需要对照 Pydantic 模型的结构判断字段路径。
2. 流结束块不一定包含 choices
阿里云 DashScope 的 OpenAI 兼容接口在流末尾会发送不包含 choices 的统计信息块,直接访问 chunk.choices[0] 会触发 IndexError。
- 修复:每次取值前加
if not chunk.choices: continue防御性判断。
后续优化方向
- 向量检索 (RAG):当前仅支持纯对话,下一步计划接入 ChromaDB 实现知识库问答。
- Token 计数与截断:当历史消息过长时,按 Token 数裁剪上下文,避免超出模型窗口。
- Redis 缓存热点会话:减少数据库查询压力。
- 结构化日志与监控:接入 Prometheus 追踪流式响应的首字延迟 (TTFT) 和吞吐量。