前言
数据分析不仅要算得快,也要尽早用上新数据。在多级湖仓链路中,数据从 ODS 加工到 DWD、DWS,往往需要逐层等待处理和湖表提交。即使 Spark 查询本身很快,读到的数据也可能已经落后于业务变化。缩短提交周期可以降低这部分延迟,但也会增加小文件、compaction 和元数据管理的开销。如果另建一条实时链路,还需要维护两套数据的同步和查询逻辑。
Apache Fluss 是面向实时分析的 streaming storage,为 Lakehouse 补充了可直接查询的实时数据层。新数据写入 Fluss 后即可被 Spark、Flink 等计算引擎读取,再通过 lake tiering 将历史数据保存到 Paimon 等 lake storage。这样,数据何时可查不必完全取决于何时入湖,也能利用湖存储保存大规模历史数据。
Spark + Fluss 让已有的 SQL 分析和 batch read 任务用上更新鲜的数据。通过 union read,Spark 可以在一次查询中组合湖中的历史数据与 Fluss 中的新数据,并处理主键更新,无需业务侧手动拼接两份结果。这既能让报表更早反映订单、用户行为等变化,也能减少实时与历史数据之间的重复加工。结合 EMR Serverless Spark 的弹性计算和免密接入,用户可以继续使用熟悉的 Spark SQL,简化从数据访问到分析的流程。
本文基于 Fluss 1.0 介绍功能支持情况。使用 EMR Serverless Spark 时,请选择 esr-4.10.0(Spark 3.5.2、Scala 2.12)及以上版本。
Fluss 功能支持概览
EMR Serverless Spark 通过 Fluss Catalog 访问 Fluss。基础 DDL、DML、batch read 和 batch write 的支持情况如下:
| 类别 | 支持能力 | 说明 |
|---|---|---|
| 数据库 DDL | 创建、查看、删除数据库 | 通过 Catalog 管理 Fluss 数据库 |
| 表 DDL | 创建、查看、删除表 | 支持 Log Table、Primary Key Table 及分区表 |
| 表属性 | 设置、修改、移除表属性 | 部分属性受 Fluss 服务端规则限制 |
| 分区管理 | 查看、新增、删除分区 | Primary Key Table 的主键需包含分区字段;删除分区时需指定完整分区键 |
| batch read | 全表读取、按条件查询 | 可结合 Spark SQL 执行过滤、聚合和关联计算 |
| batch write | 批量插入、将查询结果写入表 | Log Table 采用 append;Primary Key Table 采用 Upsert,具体更新行为由 merge engine 决定 |
| 读取优化 | column projection、partition pruning、filter pushdown、LIMIT pushdown | 减少扫描和数据传输;filter pushdown 的支持范围取决于读取路径、数据格式、表达式和 lake 插件 |
2. union read:一次查询历史数据和新数据
union read 是什么
在 lake tiering 场景中,lake storage 保存已入湖的历史数据,Fluss 提供尚未入湖的新数据。union read 在一次查询中组合这两部分数据,让用户通过同一张 Fluss 表访问它们。
例如,订单表最近一次入湖后,又有新订单写入,一些订单也从"待支付"变成了"已支付"。只读 lake snapshot 时,看不到这些变化。union read 会读取 lake snapshot,并补上该快照对应位置之后的 Fluss 数据;对于 Primary Key Table,还会按主键合并变更,返回本次查询读取范围内的最新状态。
Connector 负责衔接 lake snapshot 和 Fluss 的读取位置。用户不需要分别查两份数据,再自己处理重叠记录和主键更新。
union read 的优势
新数据不必等入湖后再查询。 查询可以直接读取 Fluss 中尚未入湖的数据,减少入湖周期带来的数据延迟。数据新鲜度与查询耗时是两个概念:SQL 的完成时间仍取决于数据量、计算资源和查询复杂度。
降低历史数据的存储成本。 已入湖且仍由 lake storage 保留的历史数据,可以继续通过 union read 查询,无需将全部历史数据长期保存在 Fluss 中。
应用只需面向一张表。 报表、分析任务和数据加工使用同一个表入口,不需要维护一套历史查询和一套实时查询,再额外编写合并逻辑。
Spark 对 union read 的支持
Spark 的 batch read 支持对 Log Table 和 Primary Key Table 执行 union read。完成 Fluss Catalog 和 lake tiering 配置后,对已开启 lake tiering 的表执行普通查询即可使用 union read,无需调用专门的函数。
| 能力 | 支持情况 |
|---|---|
| Log Table | 组合 lake 历史记录与 Fluss 中后续追加的记录 |
| Primary Key Table | 合并 lake snapshot 和 Fluss 中后续的主键变更,返回本次查询读取范围内的最新状态 |
| 分区表 | 支持读取分区数据,并结合分区条件减少扫描范围 |
| SQL 计算 | 读取结果可继续参与 Spark 的过滤、聚合、Join 等计算 |
| read-optimized mode | 可以只读快照,省去合并后续变更的步骤,但可能看不到最近的更新 |
使用 union read 前,需要将表属性 table.datalake.enabled 设为 true,配置 lake storage 并启动 tiering service。EMR Serverless Spark 也需要具备对应的 lake 插件、Catalog 配置和数据访问权限。
支持的 lake format 以运行环境提供的插件为准。
示例:从建表到 union read 查询
下面用一张城市销售额表展示完整流程:先将 Beijing、Hangzhou 的数据写入并完成入湖,再更新 Beijing 的金额、增加 Shanghai 的记录,最后通过 union read 查询合并后的结果。
示例假定已在 EMR Serverless Spark 中配置 fluss_catalog,并已启用以 Paimon 为 lake storage 的 tiering service。为确认数据已入湖,还需配置一个指向同一 Paimon lake 的 paimon_catalog,并授予读取权限。下文使用默认的同名数据库和表映射。
第一步:创建开启 lake tiering 的 Primary Key Table。
sql
CREATE DATABASE IF NOT EXISTS fluss_catalog.demo;

CREATE TABLE fluss_catalog.demo.city_sales (
  region STRING,
  amount DECIMAL(10, 2)
) TBLPROPERTIES (
  'primary.key' = 'region',
  'bucket.num' = '1',
  'table.datalake.enabled' = 'true',
  'table.datalake.freshness' = '300s'
);
region 是主键,同一城市再次写入时会按默认 merge engine 更新金额。300s 配置入湖新鲜度,不代表写入后必须等待 300 秒才能查询,也不保证入湖恰好在 300 秒后完成。
第二步:写入第一批数据,确认入湖完成。
sql
INSERT INTO fluss_catalog.demo.city_sales VALUES
  ('Beijing', 120.00),
  ('Hangzhou', 80.00);
等待 tiering service 完成入湖,再通过 Paimon Catalog 查询湖表。首次入湖前,湖表可能尚未创建或还没有数据,应等待后重试。
sql
SELECT region, amount
FROM paimon_catalog.demo.city_sales
ORDER BY region;
确认湖表返回以下数据后,再进行下一步:
| region | amount |
|---|---|
| Beijing | 120.00 |
| Hangzhou | 80.00 |
第三步:更新已有城市,并写入新城市。
sql
INSERT INTO fluss_catalog.demo.city_sales VALUES
  ('Beijing', 140.00),
  ('Shanghai', 90.00);
这次写入将 Beijing 的金额更新为 140,同时新增 Shanghai。为观察 lake snapshot 与 Fluss 新数据合并的过程,请在这批变更入湖前执行下一步。
第四步:再次查询 Paimon,确认变更尚未入湖。
sql
SELECT region, amount
FROM paimon_catalog.demo.city_sales
ORDER BY region;
如果第二批数据尚未入湖,湖表仍返回以下两行:
| region | amount |
|---|---|
| Beijing | 120.00 |
| Hangzhou | 80.00 |
此时 Beijing 仍为 120,Shanghai 尚未出现。确认这一结果后,立即执行下一步。如果湖表已经出现更新后的数据,说明第二批变更已完成入湖,本次操作未捕捉到需要展示的时间窗口。
第五步:通过 Fluss Catalog 执行 union read。
sql
SET spark.sql.fluss.read.optimized = false;

SELECT region, amount
FROM fluss_catalog.demo.city_sales
ORDER BY region;
预期结果如下:
| region | amount |
|---|---|
| Beijing | 140.00 |
| Hangzhou | 80.00 |
| Shanghai | 90.00 |
Hangzhou 保留湖中的历史值,Beijing 使用 Fluss 中更新后的值,Shanghai 则来自新增记录。Beijing 只返回一行,不会把历史值 120 和新值 140 相加。
对比两次查询,Paimon Catalog 返回湖中已有的数据,Fluss Catalog 通过 union read 补上尚未入湖的更新和新增记录。由于 tiering service 持续运行,两次查询应尽量连续执行;如需进一步确认,可在第五步后复查湖表仍保持第四步的结果。
3. 增量 batch read:按时间窗口读取变更
union read 用于查询历史数据和最新状态。定时加工任务如果只需要处理一段时间内的变化,可以使用 fluss_incremental_between_timestamp 进行增量 batch read。
它是一个 Table-Valued Function(TVF),可以放在 SQL 的 FROM 后面。返回结果可以像普通表一样继续过滤、聚合或参与 Join。
TVF 用法与参数
调用形式为 fluss_incremental_between_timestamp(table, start[, end]):
| 参数 | 含义 |
|---|---|
table |
Fluss 表名字符串,支持 table、database.table、catalog.database.table;省略的部分使用当前 Catalog 和数据库 |
start |
开始时间,包含该时间点 |
end |
结束时间,不包含该时间点;省略时,使用 SQL 分析时刻作为结束时间 |
时间范围为左闭右开 [start, end),依据 Fluss 记录的 commit timestamp ,而不是业务字段中的事件时间。时间参数支持日期时间字符串、epoch 毫秒值、DATE 或 TIMESTAMP 等常量,也支持能在查询规划时求值的时间表达式,但不能引用表中的列。日期时间字符串按 Spark 会话时区解释。
使用前,需要在创建 Spark 会话时,将 org.apache.fluss.spark.FlussSparkSessionExtensions 加入 spark.sql.extensions。以下示例假定已配置 fluss_catalog,且示例表已存在。
读取固定时间段
下面读取北京时间 10 点到 11 点之间提交的订单事件。请将示例时间替换为实际需要处理、且仍在 Fluss 保留范围内的时间段。
sql
SET spark.sql.session.timeZone = Asia/Shanghai;

SELECT *
FROM fluss_incremental_between_timestamp(
  'fluss_catalog.demo.order_events',
  '2026-09-17 10:00:00',
  '2026-09-17 11:00:00'
);
读取最近一小时
临时分析时,可以直接在 SQL 中计算时间范围:
sql
SELECT event_type, COUNT(*) AS event_count
FROM fluss_incremental_between_timestamp(
  'fluss_catalog.demo.order_events',
  date_format(now() - INTERVAL 1 HOUR, 'yyyy-MM-dd HH:mm:ss'),
  date_format(now(), 'yyyy-MM-dd HH:mm:ss')
)
GROUP BY event_type;
生产调度中,如果需要失败重跑得到相同时间窗口,建议由调度任务传入固定的起止时间,避免重跑时 now() 改变读取范围。
从指定时间读取到当前
省略结束时间时,读取范围从指定开始时间(含)到本次 SQL 分析时刻(不含):
sql
SELECT *
FROM fluss_incremental_between_timestamp(
  'fluss_catalog.demo.orders',
  '2026-09-17 10:00:00'
);
返回结果与使用限制
| 表类型 | 返回结果 |
|---|---|
| Log Table | 时间窗口内追加的记录 |
| Primary Key Table | 将窗口内的主键变更合并,返回窗口结束前的最终有效值;最终被删除的主键不返回,也不输出删除事件 |
| 已开启 lake tiering 的表 | 按对应表类型处理,但只读 Fluss 中的数据,不执行 union read |
例如,一个订单在窗口内先变为"已支付",随后变为"已发货",Primary Key Table 的结果只保留"已发货"的记录。因此,这个 TVF 适合提取变化后的数据,不适合直接充当包含所有中间变化和删除事件的完整 CDC 通道。
使用时还需注意:
-
开始时间必须早于结束时间。
-
查询只能读取 Fluss 仍保留的数据,受
table.log.ttl影响。即使过期数据已入湖,TVF 也不会从 lake storage 补齐;超出保留范围的窗口可能只返回部分数据或空结果。
4. EMR Serverless Spark + 阿里云流存储 Fluss
为什么选择 EMR Serverless Spark
EMR Serverless Spark 是面向 Data+AI 的全托管 Lakehouse 计算产品,也是 OpenLake 解决方案的核心计算引擎。它将计算、数据开发和工作流编排整合到同一平台,并与湖存储、元数据及权限体系协同,支持数据分析和 AI 场景。更多信息可参见EMR Serverless Spark 产品官网。
弹性分配资源。 支持秒级资源弹性,最小分配粒度为 1 核,并提供任务或队列级资源计量。对于定时运行的 Fluss 增量加工任务,可以按负载使用资源,并通过队列隔离不同团队或开发、生产任务。
优化 SQL 计算与 Shuffle。 内置 Fusion Engine 和企业级 Celeborn Remote Shuffle Service,为 SQL 计算及大规模 Shuffle 提供优化。读取 Fluss 后的聚合、关联任务可结合这些能力优化执行,实际收益取决于算子支持情况和读取路径。
开发、调度与排障一体化。 通过 SQL Editor、Notebook 开发和调试任务,使用工作流编排定时加工,再通过任务历史、Spark UI 和日志排查问题。产品还提供版本管理及开发、生产环境隔离,便于将 TVF 增量 SQL 从调试交付到生产。
融入已有湖仓生态。 支持 DLF、Hive Metastore 和 Paimon、Iceberg 等 lake format,可对接 Airflow、DolphinScheduler 等调度系统,也支持通过 DataWorks 和 dbt 提交任务,方便将 Fluss 数据加工接入现有工作流程。
一条 SQL 组合查询多个 Catalog。 EMR Serverless Spark 支持在同一会话中访问多个 Catalog,通过 catalog.database.table 定位不同数据源中的表。配置好相应 Connector、网络和访问权限后,就可以将 Fluss 与其他 Catalog 中的表放在同一条 SQL 中执行 Join、过滤和聚合。例如,将 Fluss 中的最新订单与 Paimon 或 Iceberg Catalog 中的用户、商品维度表关联,分析不同用户群体的成交情况,无需先把这些表同步到同一个存储系统。EMR Serverless Spark Catalog 管理
这一能力也可以与 union read、增量 TVF 配合使用:通过 union read 获取 Fluss 表的历史数据和最新状态,再关联其他 Catalog 的业务数据;或先用 TVF 选出指定时间段内的变更,再补充维度信息,完成增量加工。数据保留在各自的存储系统中,通过对应的 Catalog 访问,由 EMR Serverless Spark 统一完成计算。
免密接入阿里云流存储 Fluss
阿里云流存储 Fluss 是基于 Apache Fluss 构建的全托管列式流存储服务,支持低延迟读写、实时更新和 Partial Update,并可通过 lake tiering 对接 Apache Paimon 等 lake format,兼顾数据新鲜度与历史数据的存储成本。产品提供可视化管理、监控告警和权限控制,减少基础设施运维工作。更多信息可参见阿里云流存储 Fluss 产品官网。
在 EMR Serverless Spark 的数据目录中添加阿里云流存储 Fluss 集群,并在 Fluss 中为提交作业的 RAM 用户配置访问权限后,即可通过该 Catalog 访问数据。
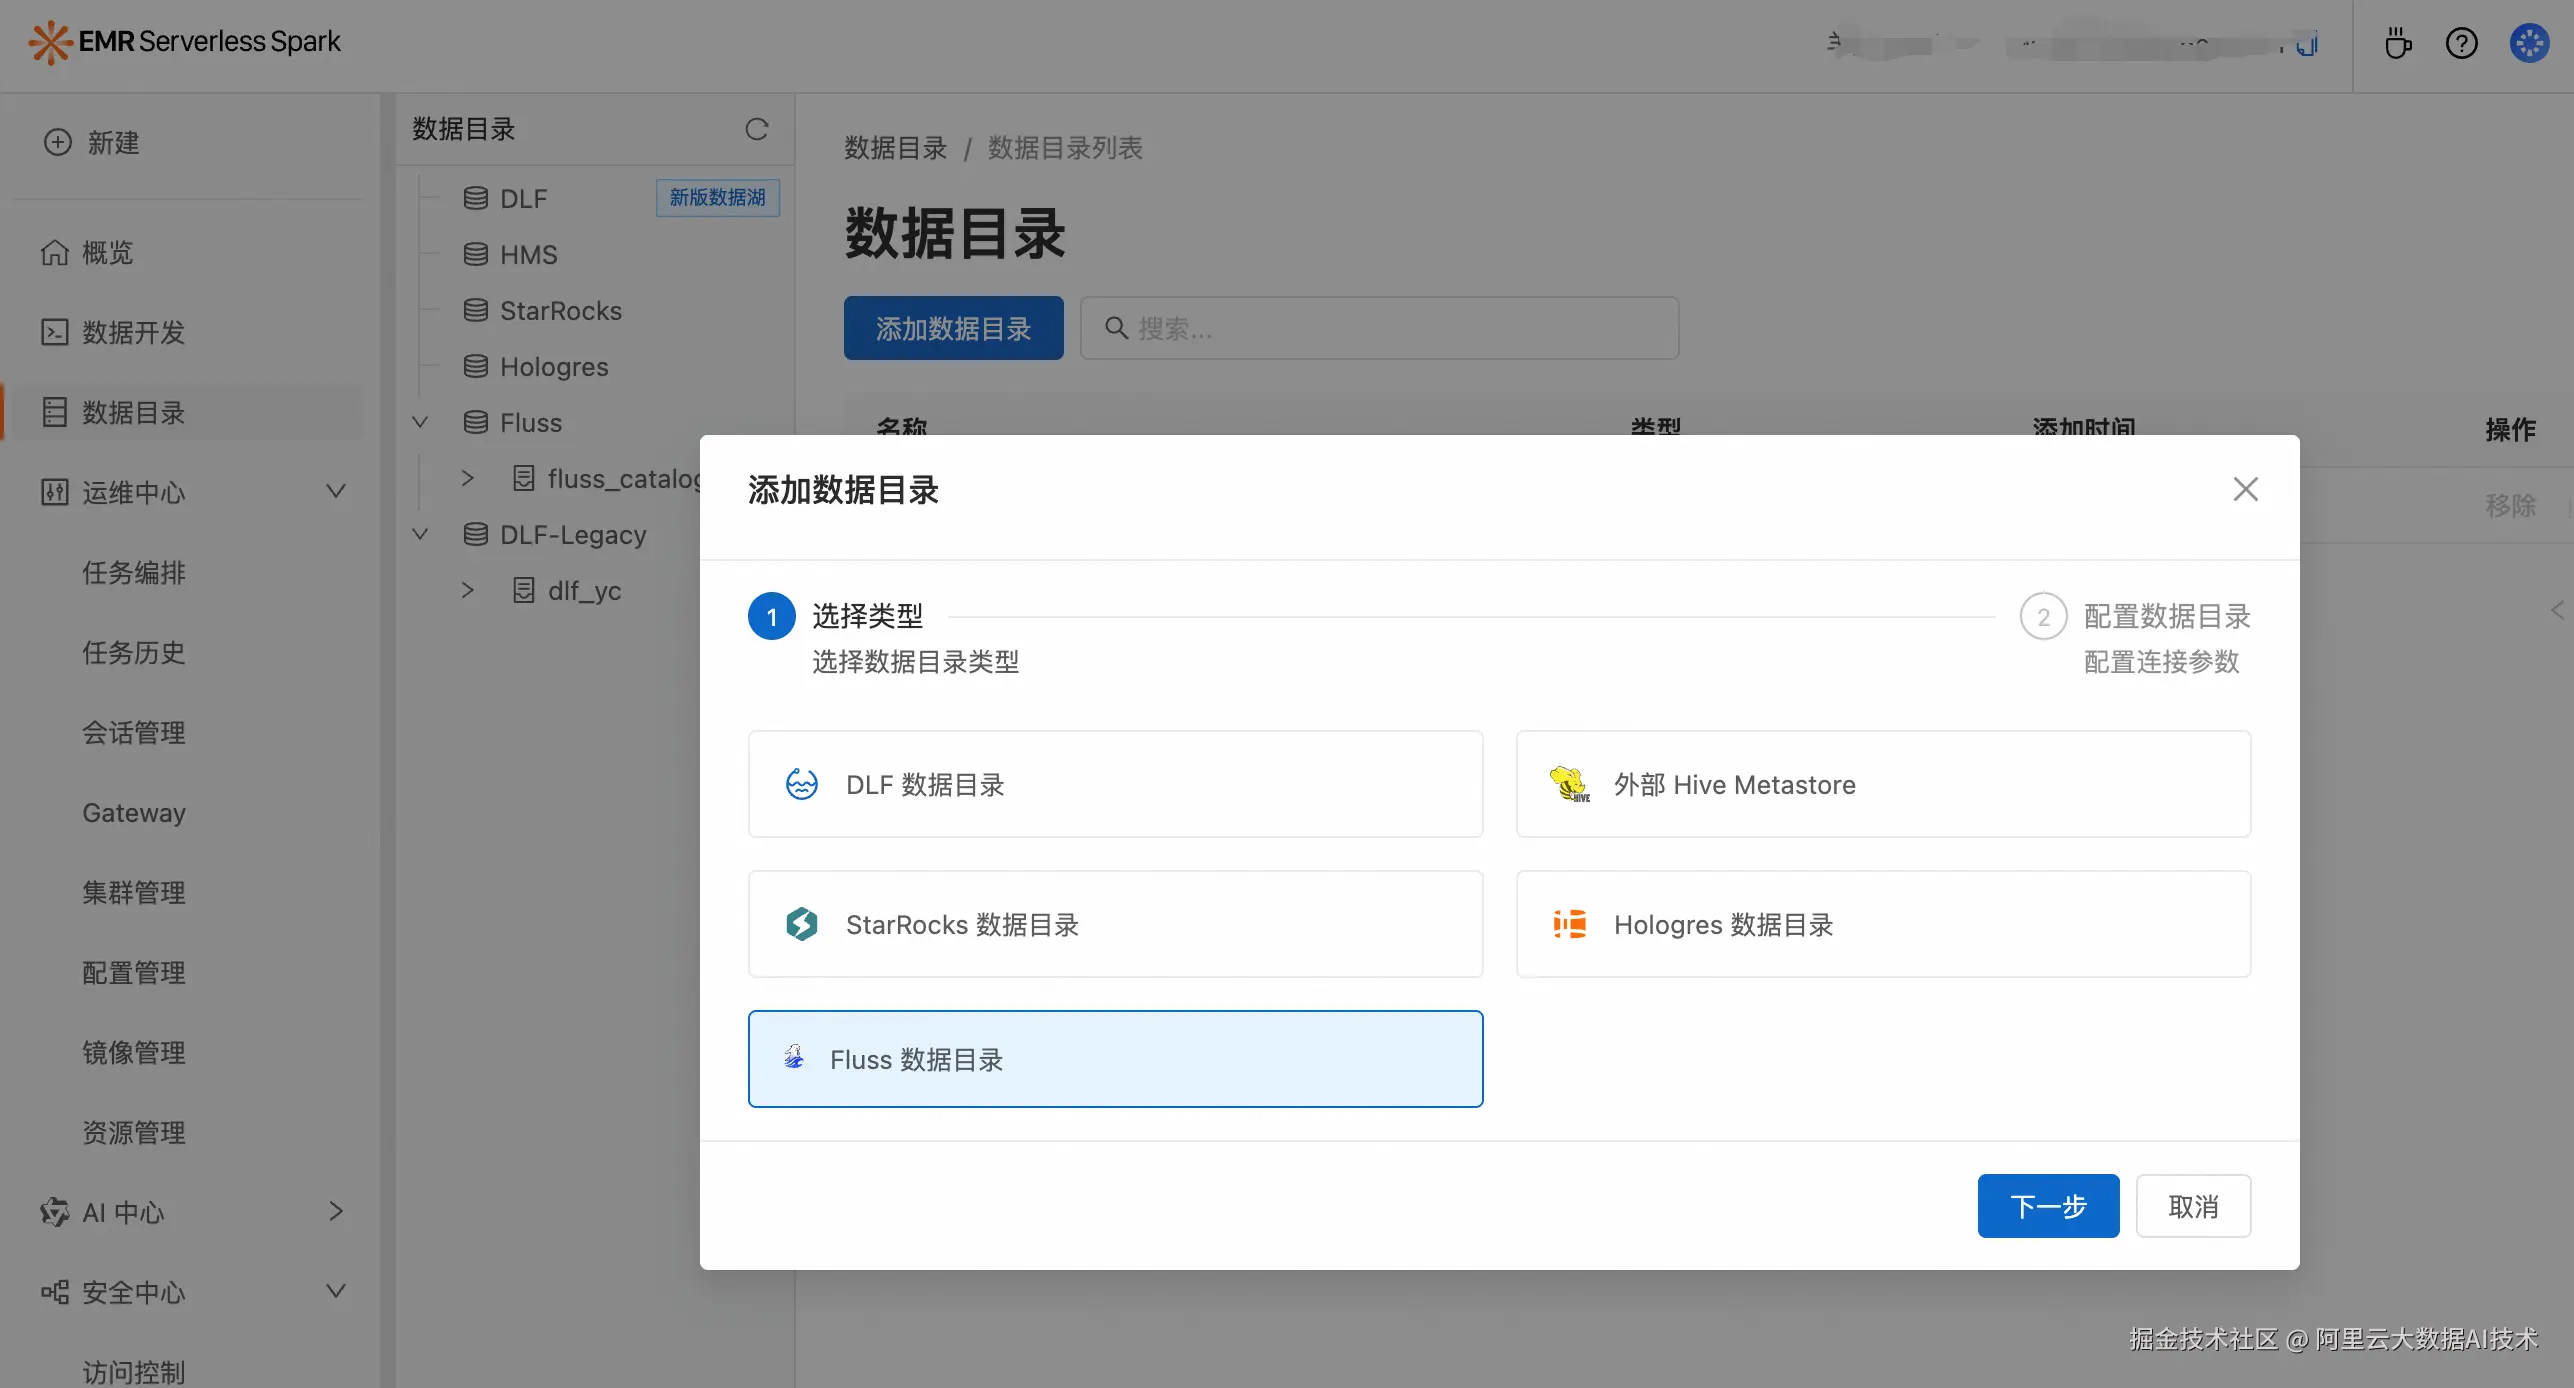
免密接入配置
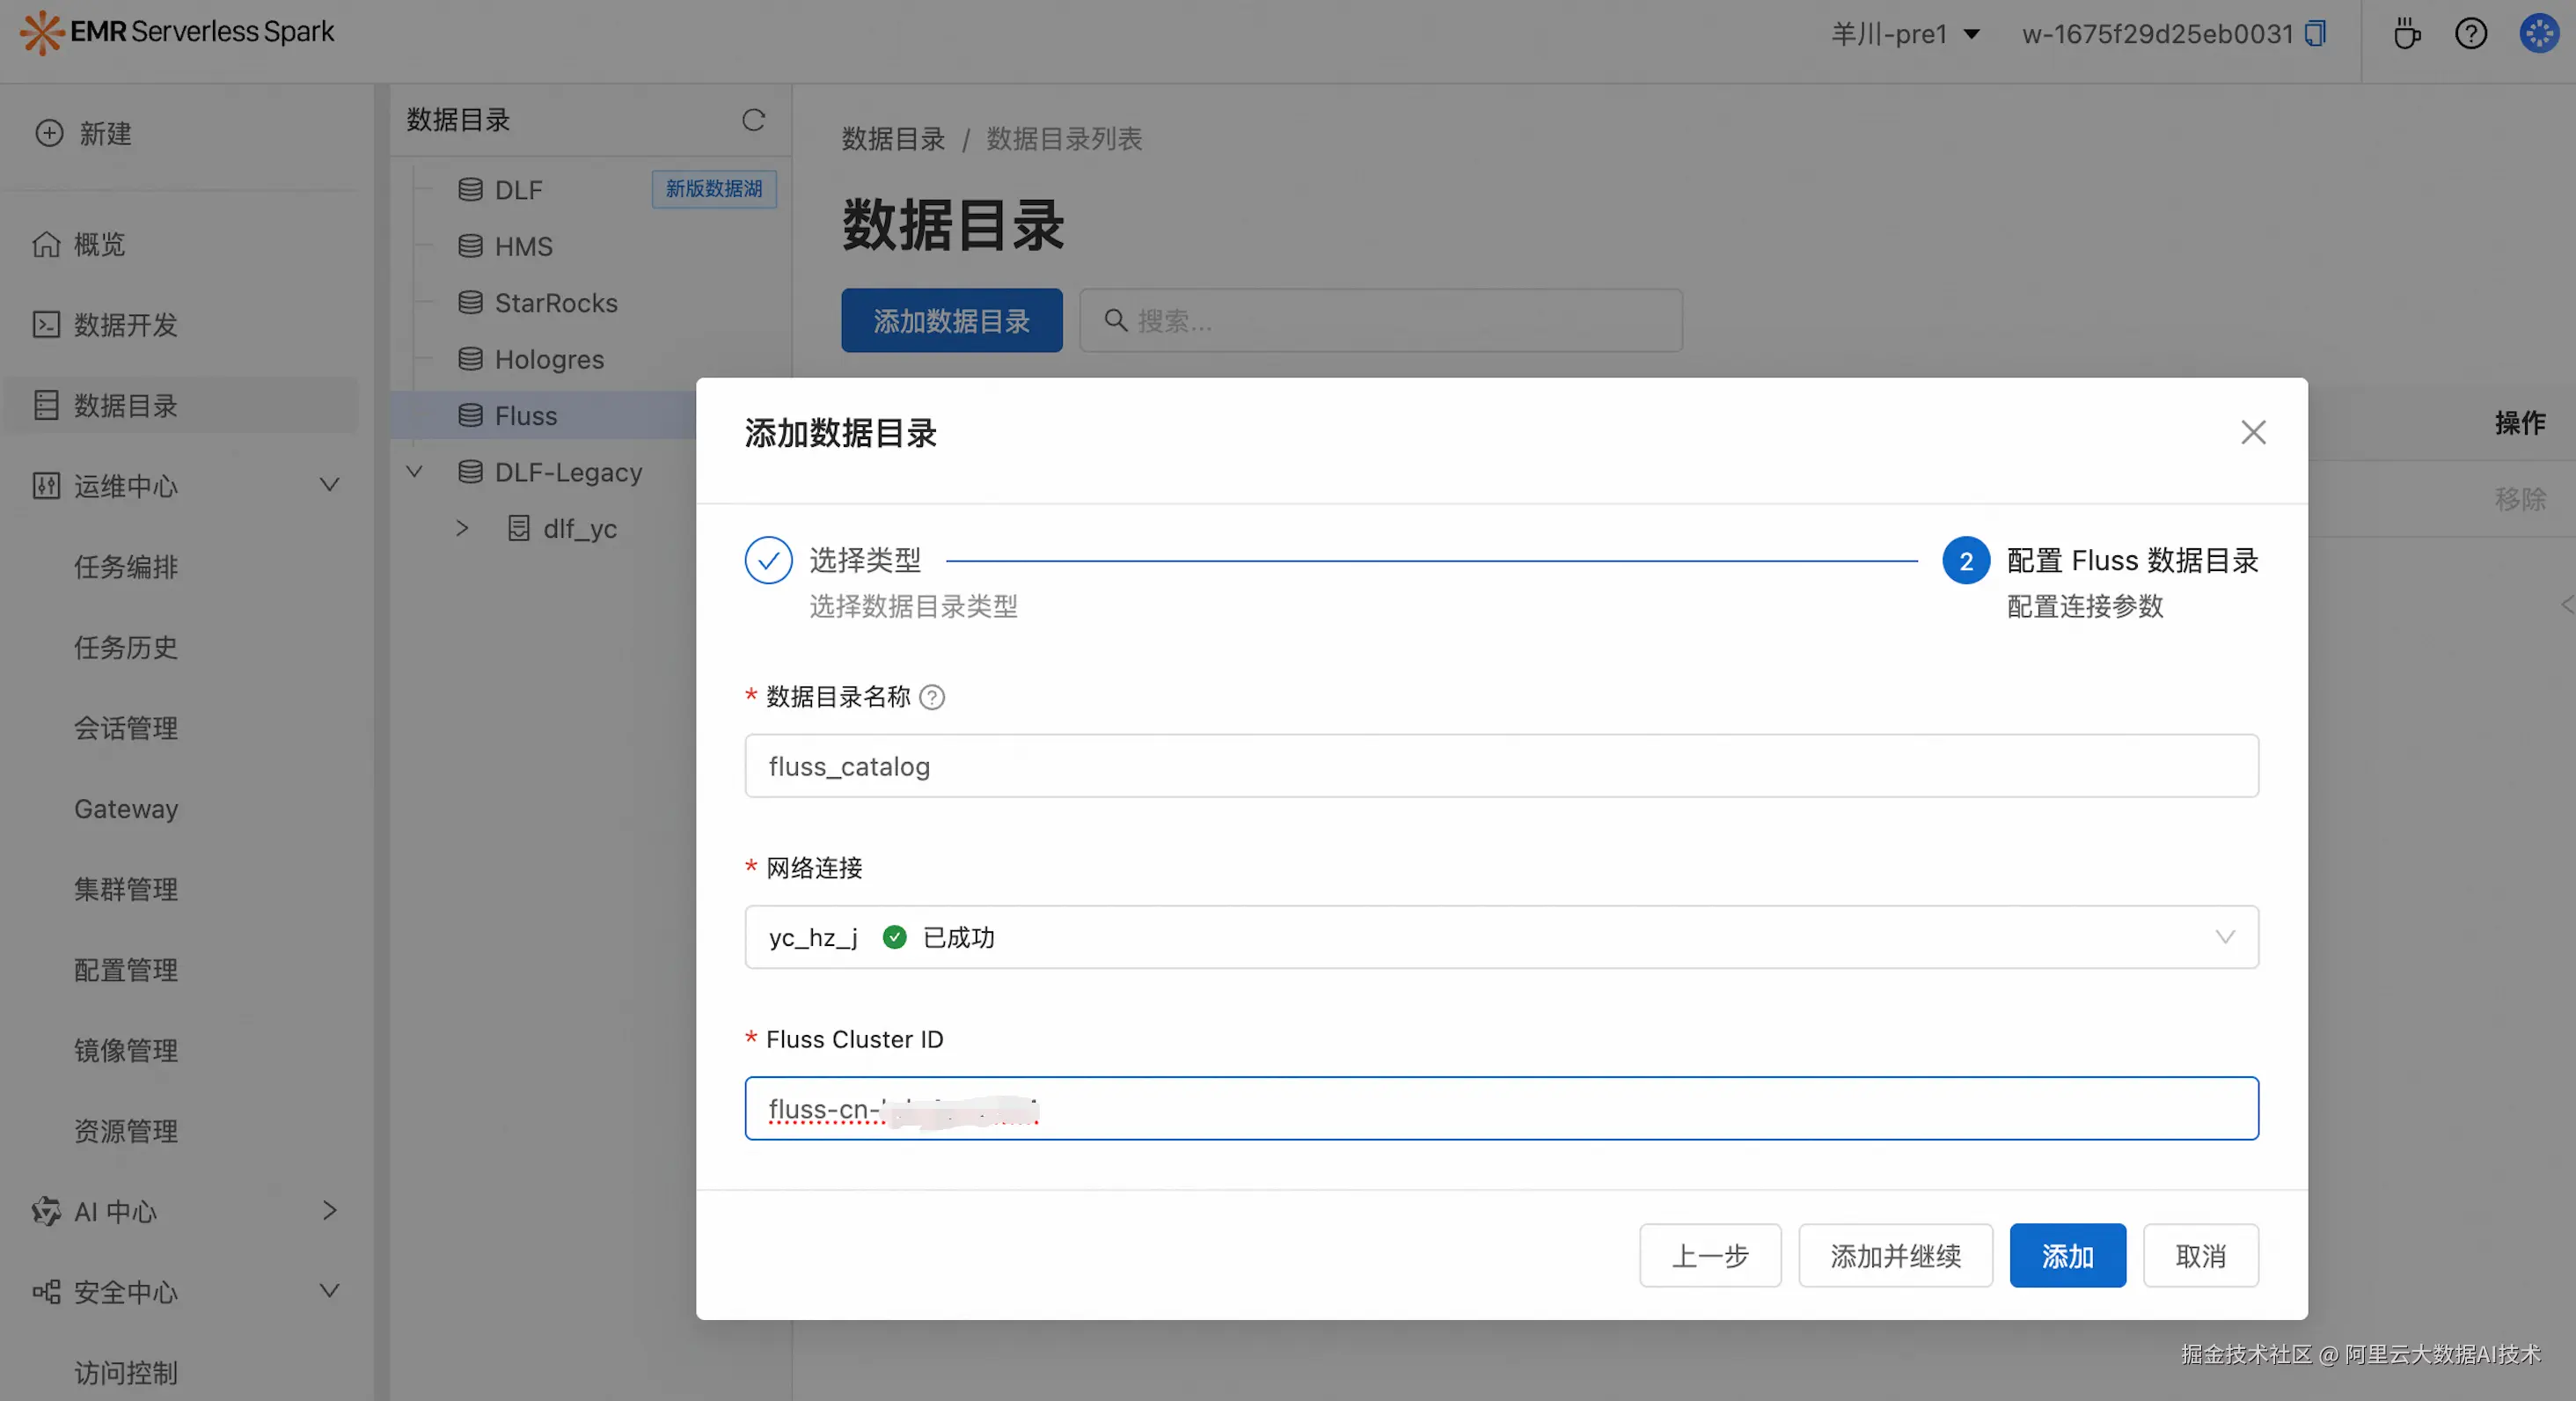
免密接入配置详情
作业运行时,平台会自动注入连接和认证所需的配置,包括访问 lake storage 所需的 DLF Token,并根据提交作业的 RAM 用户身份动态获取和刷新 Fluss 临时访问凭证。用户无需在 SQL 或作业参数中手动填写用户名、密码等认证信息。
示例:通过 union read 查询最新数据
完成免密接入后,用户在 EMR Serverless Spark 中查询 Fluss 表,就可以通过 union read 同时读取已入湖的数据和 Fluss 中尚未入湖的新数据。下面以产品演示中的实际截图,展示阿里云流存储 Fluss、DLF 与 EMR Serverless Spark 如何配合完成这一查询。
1. 在 Fluss 中开启 lake tiering。
示例表是一张 Primary Key Table,已开启湖流一体,数据新鲜度设置为 300s。Fluss 控制台可以查看关联的湖表及快照同步进度;下图显示,表已完成首个湖快照的同步。
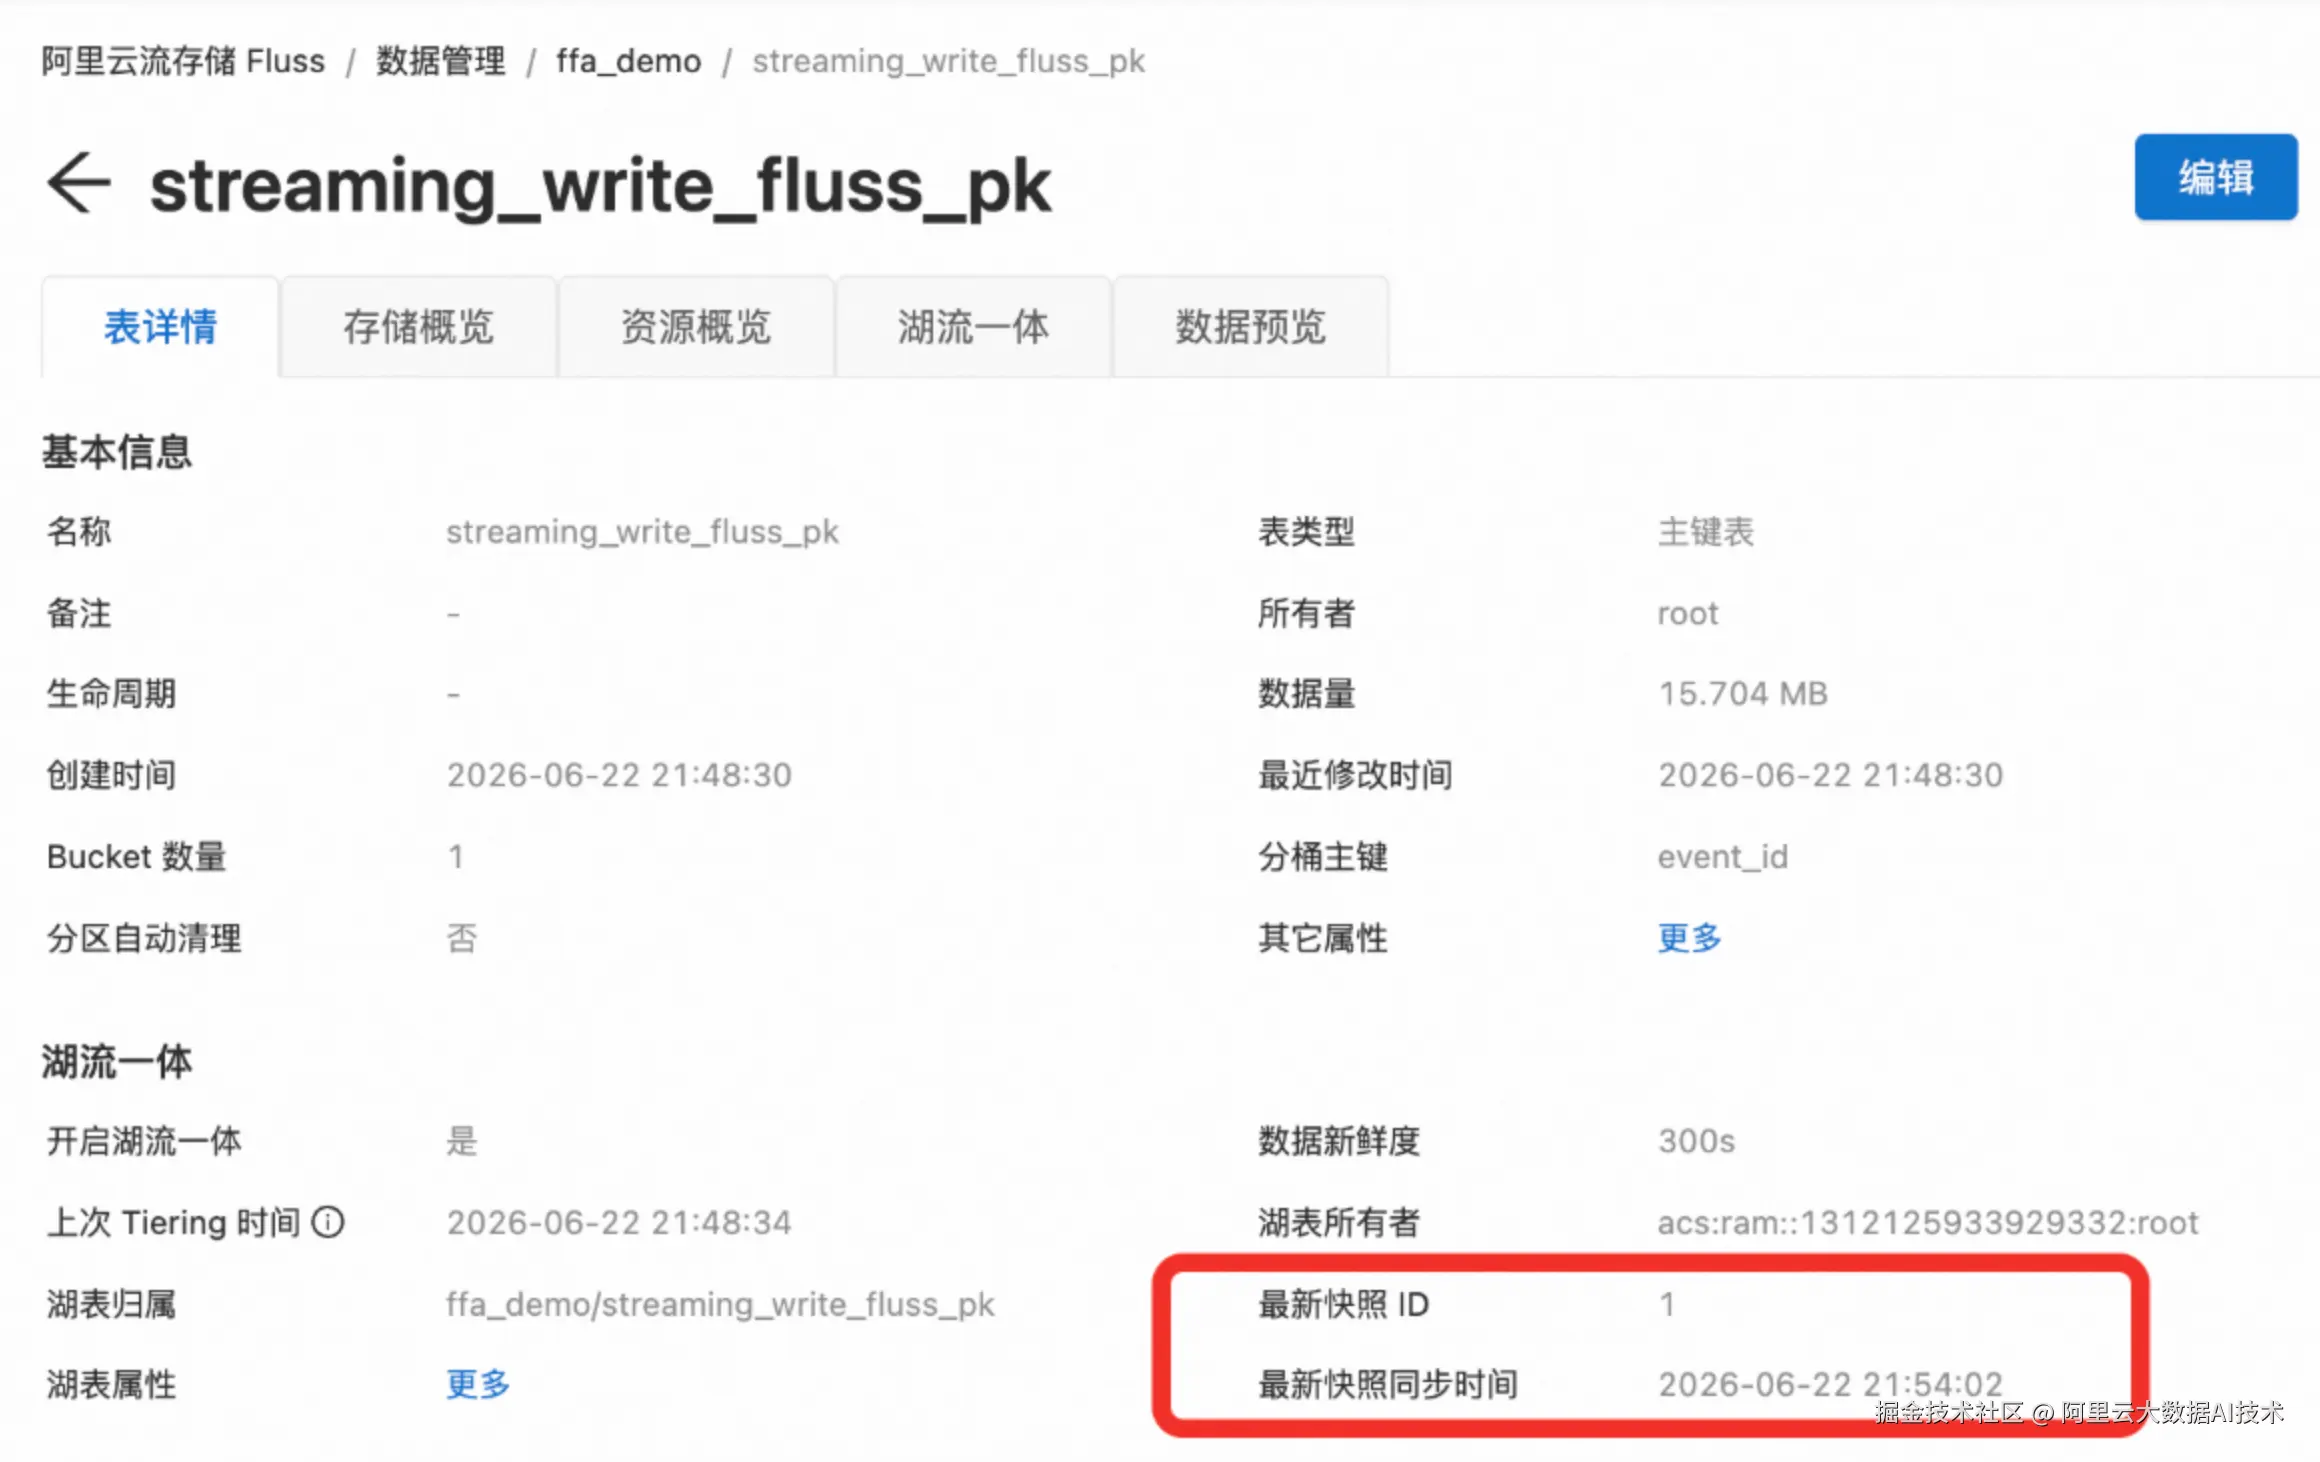
Fluss 控制台 lake tiering
2. 在 DLF 中查看已入湖的数据。
DLF 的版本历史记录了每次湖快照的提交时间和表总行数。下图中,21:55:47 提交的快照 2 包含 434,805 行,下一次 APPEND 提交发生在 21:59:29。这意味着,在这两次提交之间,直接读取湖表只能看到 434,805 行。
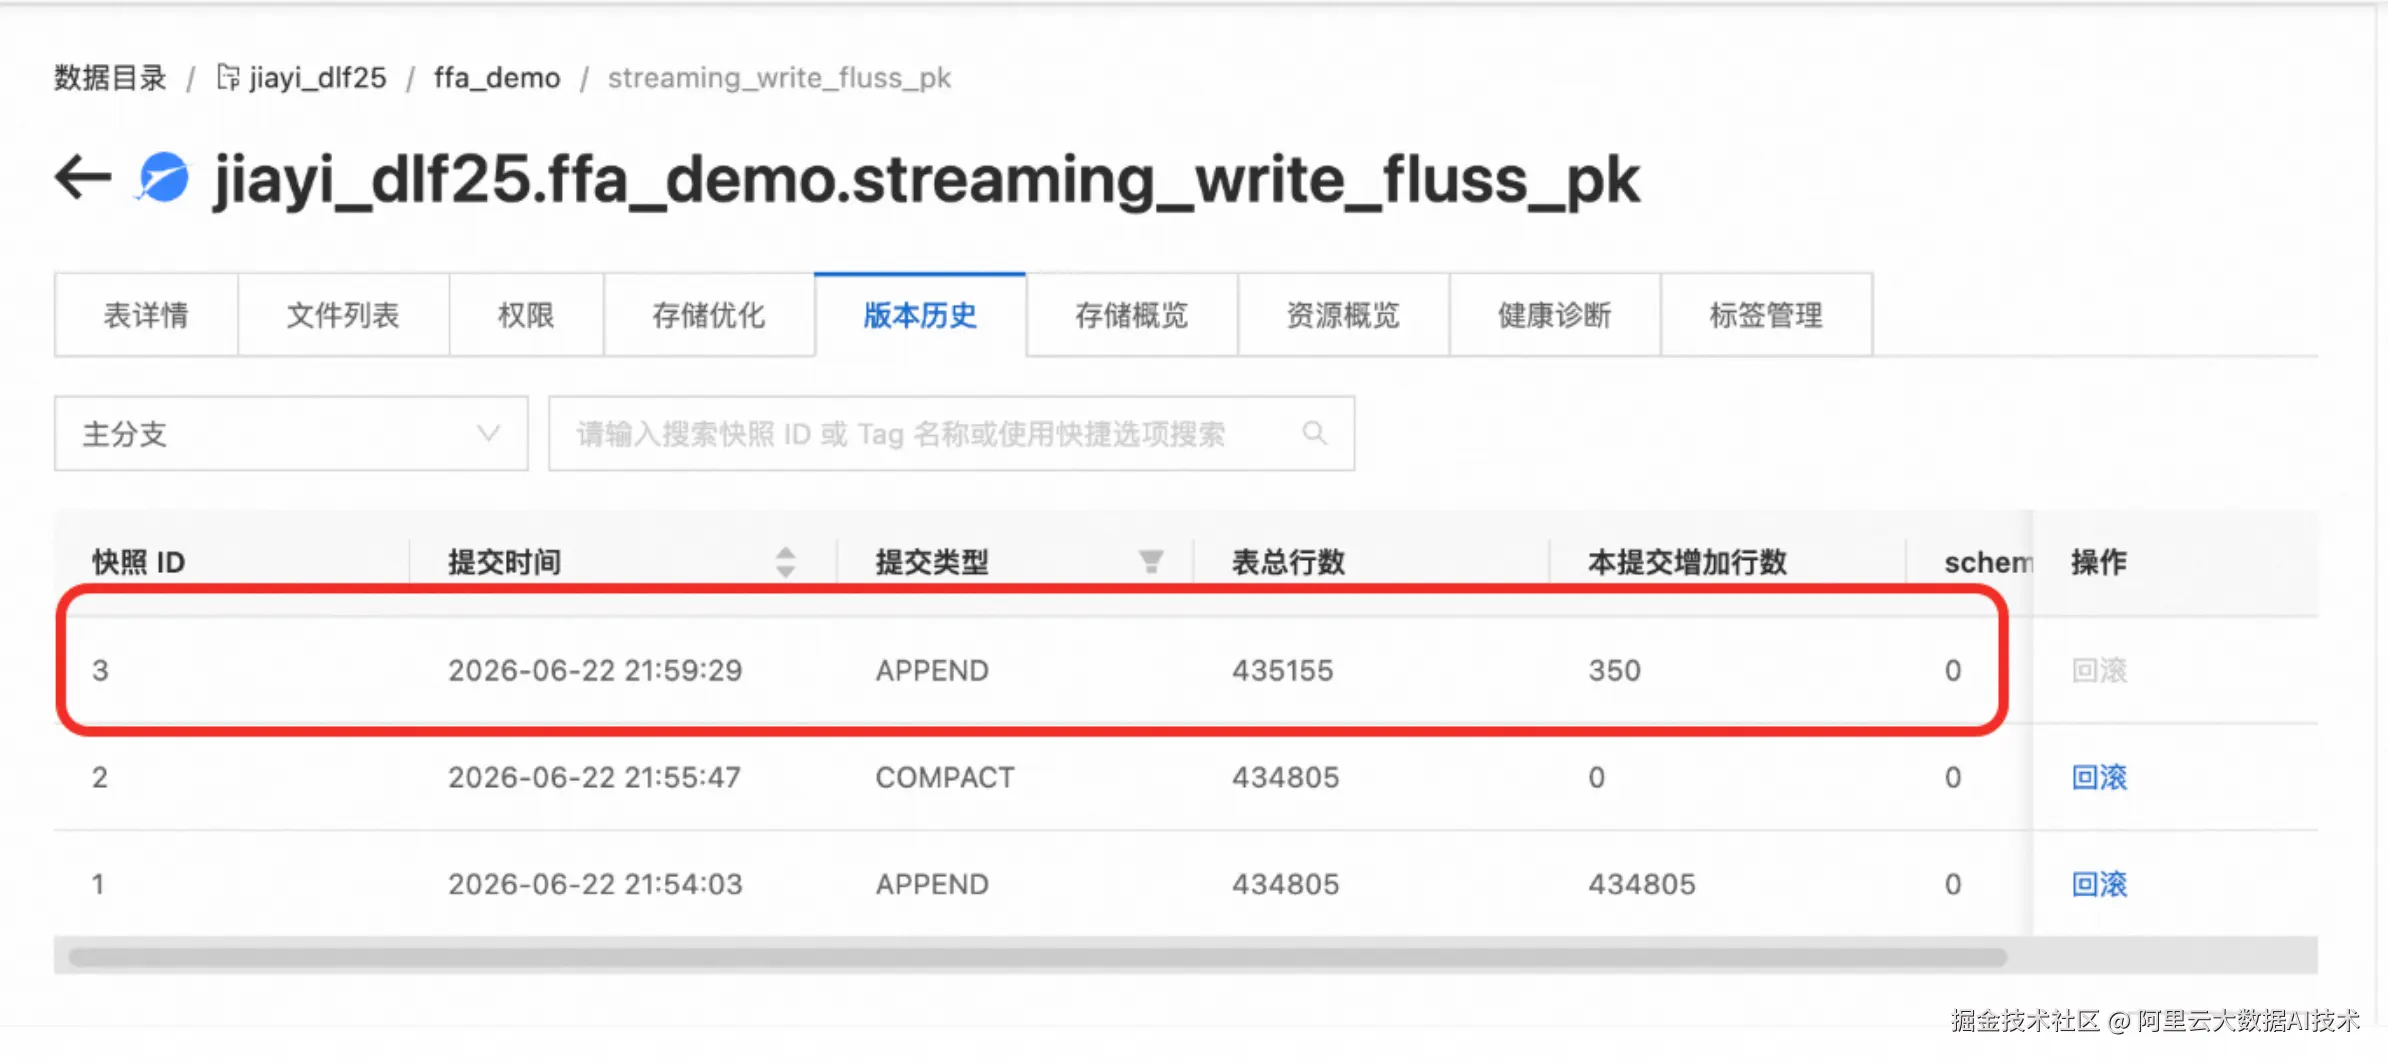
DLF 版本历史
3. 在 EMR Serverless Spark 中查询 Fluss 表。
演示在 21:56:28 执行了下面的 SQL,查询时间位于上述两次湖快照提交之间:
sql
SELECT current_timestamp(), count(*)
FROM fluss_catalog.ffa_demo.streaming_write_fluss_pk;
查询返回 434,975 行 ,比当时湖表中的 434,805 行多出 170 行。这部分数据尚未进入湖快照,却已经能通过 Fluss Catalog 查到,体现了 union read 的作用:无需等待下一次 lake tiering,即可将湖中的历史数据与 Fluss 中的新数据一起用于分析。
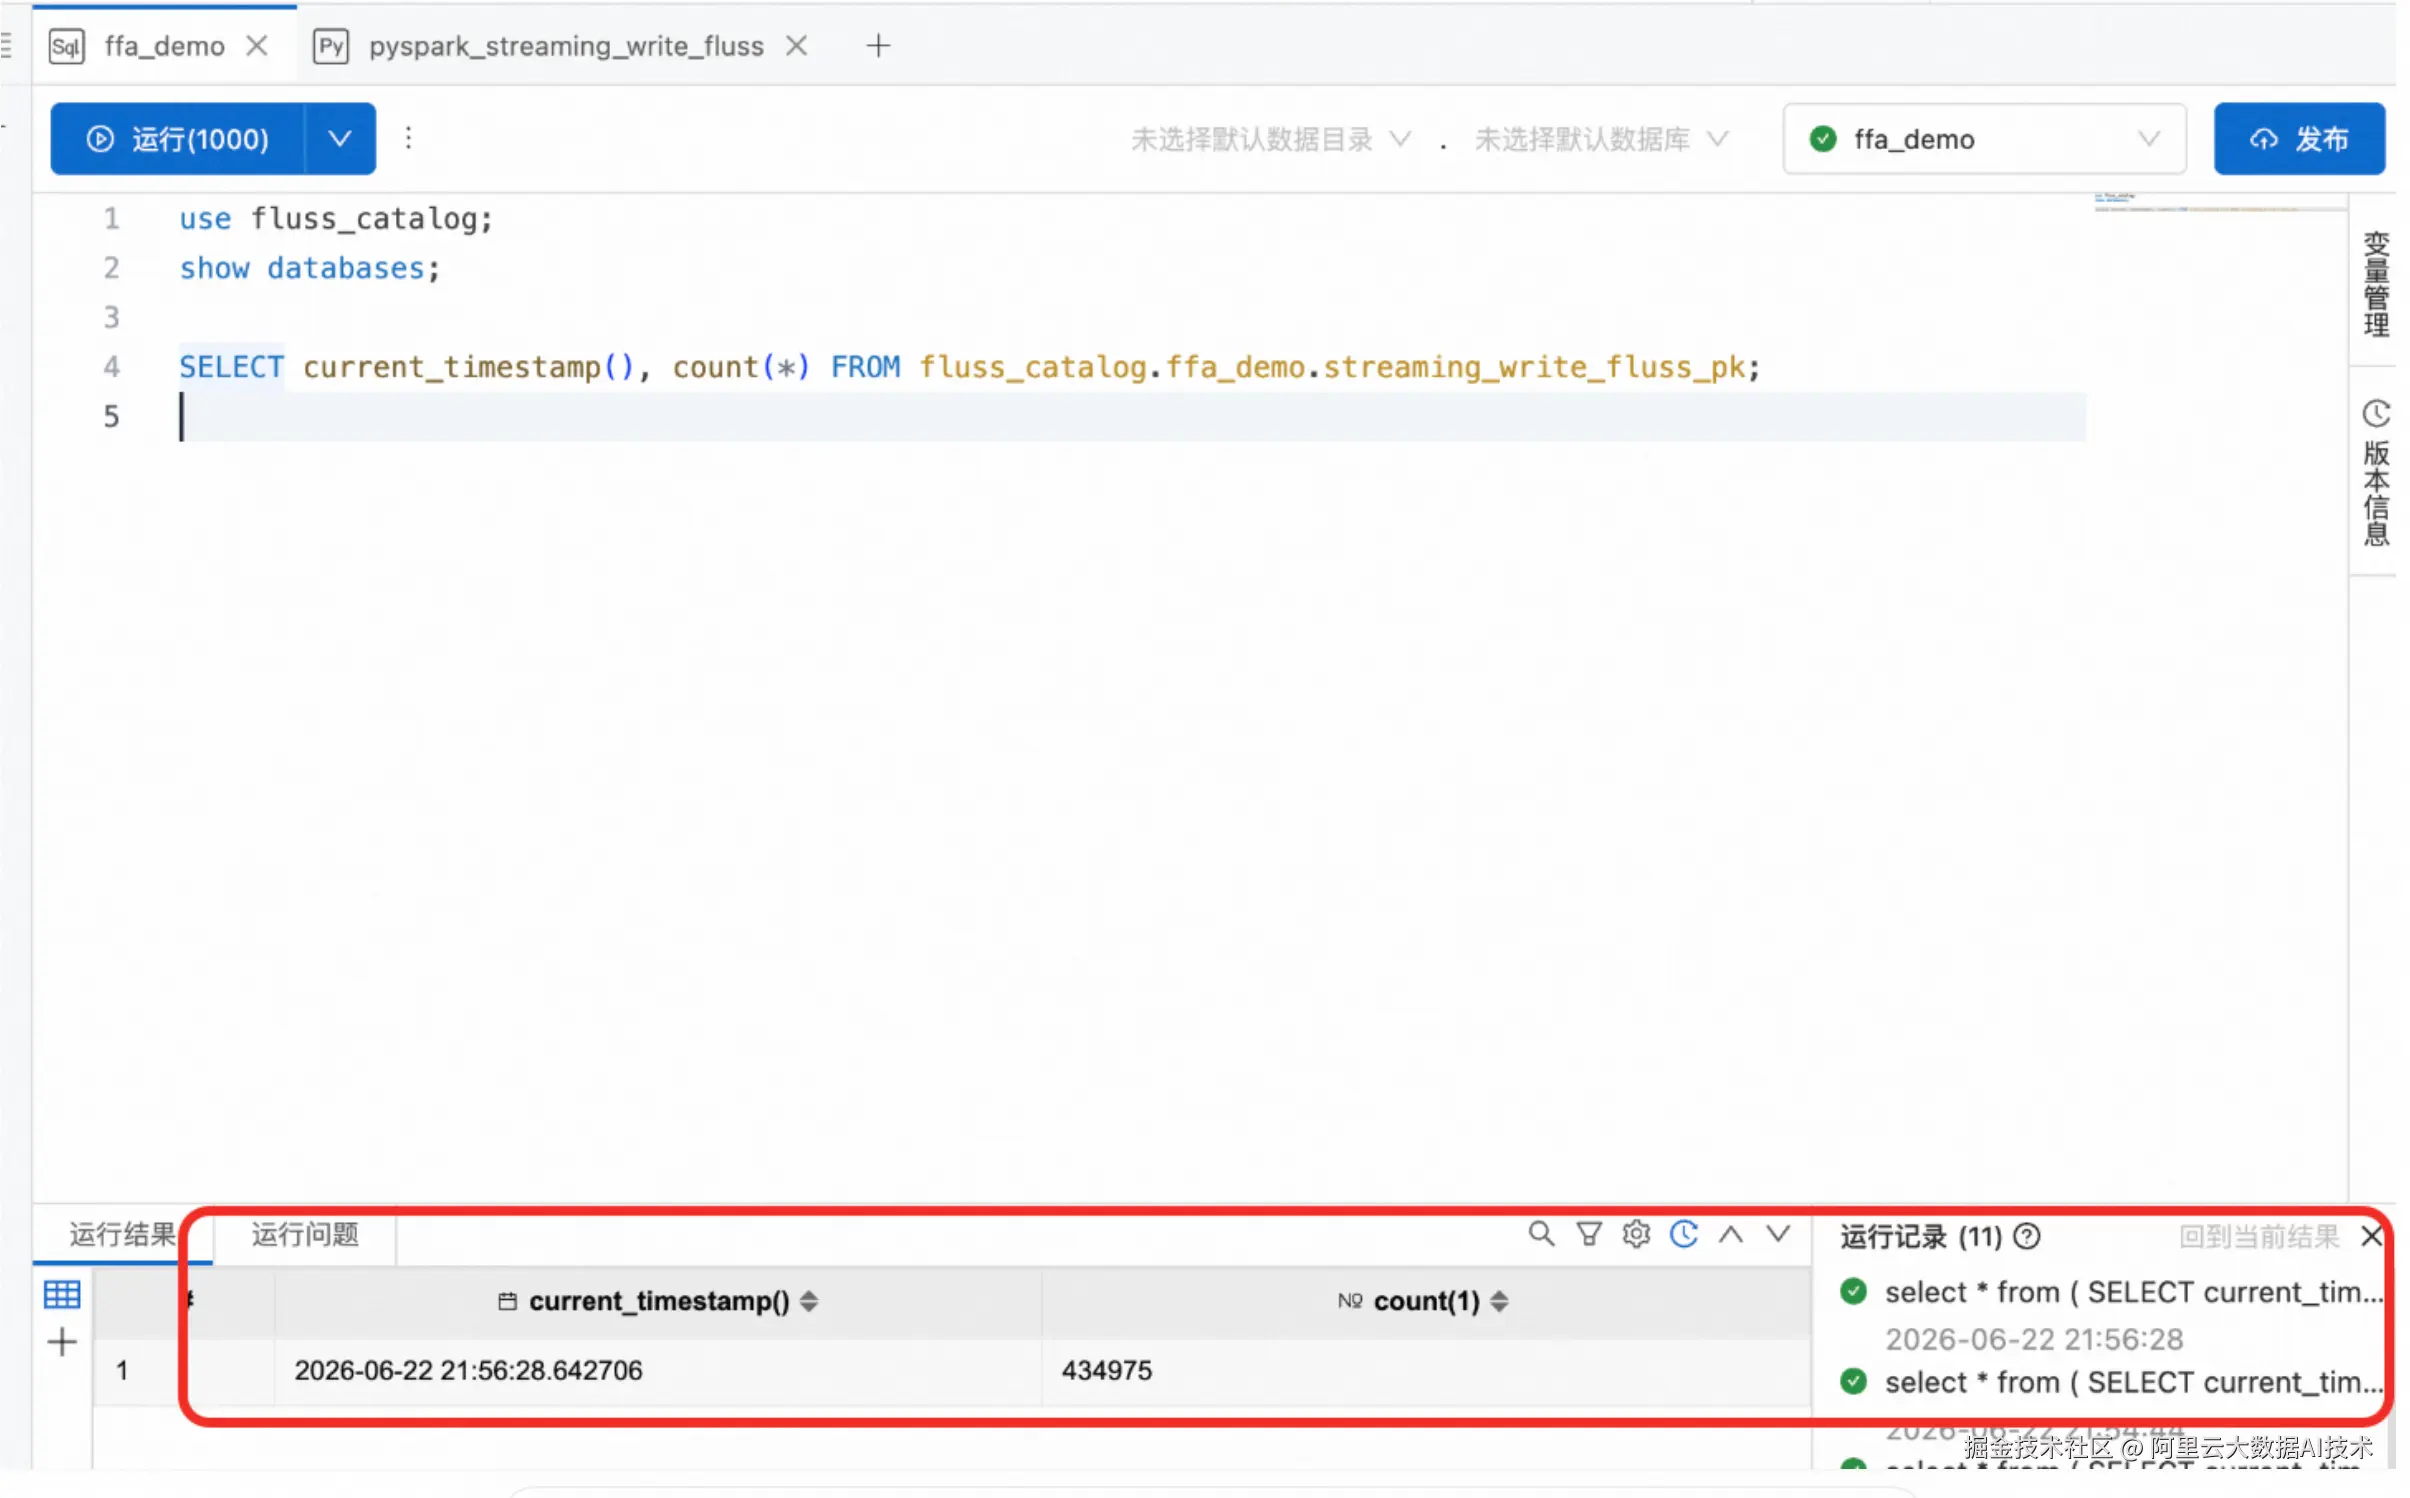
Spark 查询结果
对于用户,整个查询仍是一条普通 SQL:通过免密接入访问 Fluss Catalog,由 union read 完成两层存储的数据读取与合并,无需手动拼接湖表和 Fluss 数据。