Agent开发入门系列第 3 篇 · 读这一篇需要 6 分钟
系列导读:这个系列不追热点,只把 Agent 架构里那些密度极高、一次读不透的概念,一个一个拆开。
上一篇我们把 Agent 的骨架立起来了:大脑、眼睛、手脚,以及 Model--Harness 两层结构。
但那是一张静态的图。真正跑起来的时候,会冒出一个很反直觉的问题:
Agent 处理一个"算两笔账再求个平均"的请求,竟然调用了 4 次工具、跑了 3 轮才给出答案。
大多数人第一反应是------这也太绕了吧?加法而已,模型自己算不行吗?
这个"绕"恰恰是本篇要讲透的东西。它不是实现上的笨拙,而是Agent 从"会答题"变成"会办事"的那道分界线。
一、为什么一次调用不够
先说清楚问题的根源。
上一篇的公式里,Model 的职责是"决定下一步"。注意这句话里没有"执行"。模型自己不查汇率、不跑代码、不碰任何外部状态。它只能输出决策。
那么问题来了:如果只调用模型一次,让它直接给答案,会发生什么?
会死在两个地方。
第一,模型不知道今天的汇率。 汇率是外部事实,存在于某个环境里。模型只能通过工具调用拿到它。没有任何一个提示词能让模型"知道"它不知道的东西。
第二,模型看不到自己动作的结果。 就算它侥幸猜对了汇率并直接输出总额,你也无法验证这个数字是怎么来的------没有中间过程,没有工具返回,没有可回溯的记录。一旦错了,你连"错在哪一步"都定位不了。
所以必须有一个机制,让模型能够:做一次动作 → 看到真实结果 → 再决定下一步。
这个机制就是 ReAct。
二、ReAct 循环:想、做、看
ReAct = Re asoning + Act ing。名字里只有两个词,但实际执行是三个环节:
- 想(思考) ------ 模型根据当前上下文判断该做什么
- 做(行动) ------ 调用工具,产生真实的状态变化
- 看(观察) ------ 把工具返回的结果写回上下文
连起来就是一个闭环:
想 → 做 → 看 → 想 → 做 → 看 → ......
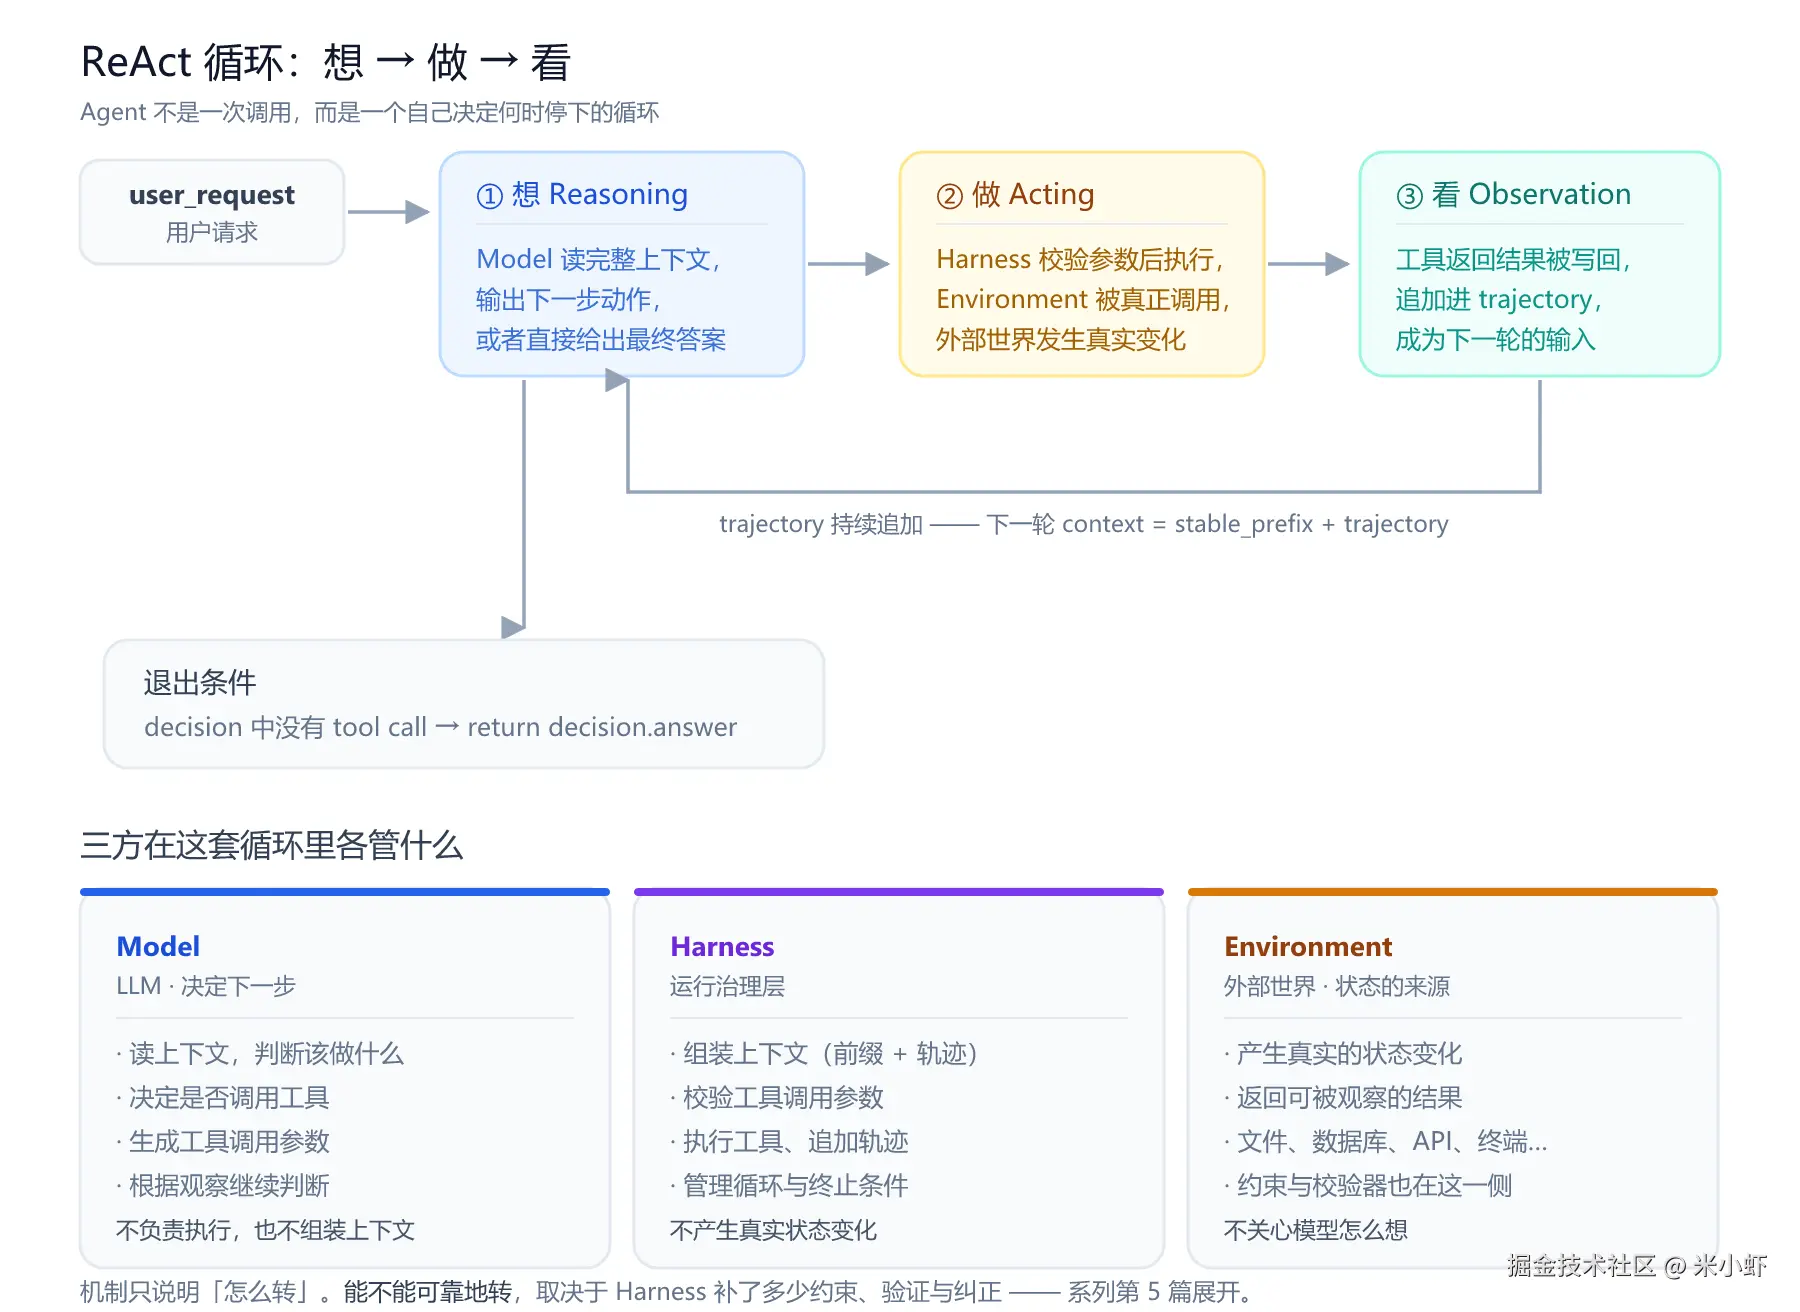
图里有三处值得停下来看。
第一,Model 只出现在"想"这一格。 做和看两格都是 Harness 和 Environment 在忙。模型不查汇率、不做加法,它只负责决定"下一步该干什么"。
第二,"看"的结果会回到"想"的前面。 这就是闭环的意义------第二轮的决策,是在第一轮的真实结果之上做出的。它不再是猜测,是在收敛。
第三,有一条明确的退出分支。 当某一次决策里不再包含工具调用时,循环终止,答案返回。
现在看最小运行骨架。
三、最小运行骨架:三方各管什么
这是最小实现,一段可以直接当伪代码读的 Python:
python
trajectory = [user_request]
repeat:
    context = stable_prefix + trajectory
    decision = Model(context)
    trajectory.append(decision)

    if decision has no tool call:
        return decision.answer

    for call in decision.tool_calls:
        # independent calls may run in parallel
        validated_call = Harness.validate(call)
        observation = Environment.execute(validated_call)
        trajectory.append(observation)
十几行,把三个组件的职责切得干干净净。逐行拆开看:
| 行 | 谁在干活 | 干了什么 |
|---|---|---|
context = stable_prefix + trajectory |
Harness | 把系统提示词 + 工具定义(静态前缀)和历史轨迹拼成完整上下文 |
decision = Model(context) |
Model | 读上下文,输出决策:要么是工具调用,要么是最终答案 |
trajectory.append(decision) |
Harness | 决策入轨,无论它是工具调用还是答案 |
if decision has no tool call: return |
判断边界 | 没有工具调用 = 想清楚了 = 退出循环 |
Harness.validate(call) |
Harness | 校验参数合法性,不合法就不许落地 |
Environment.execute(...) |
Environment | 真正执行,产生真实状态变化 |
trajectory.append(observation) |
Harness | 观察入轨,成为下一轮上下文的最后一块 |
三方的职责边界,用一句话讲清:
- Model:决定下一步。只做这一件事,不执行、不组装上下文、不直接接触环境。
- Harness:组装上下文、校验并执行工具、维护轨迹和循环。是治理层,本身不产生状态变化。
- Environment:产生真实的状态变化和可观察的结果。不关心模型怎么想,只负责"世界真的会变"。
注意 trajectory.append 出现了两次------决策和观察都往里追加。这就是轨迹的来源。
还有那行注释值得注意:# independent calls may run in parallel。无依赖的调用可以并发。但这只是伪代码里的一个注释,落地时的"什么算无依赖""并发到什么程度",是 Harness 的活,不是模型的活。
四、一条完整轨迹:多币种收入汇总
抽象讲完了,来点具体的。
任务很简单:根据公司季度收入------Q1 2.5M 美元,Q2 2.1M 欧元,Q3 1.8M 英镑,Q4 380M 日元------计算年度总收入和季度平均收入。
看起来就是加法。但注意,这里有四个币种,而模型的输出必须统一到一个币种。汇率在环境里,不在模型里。
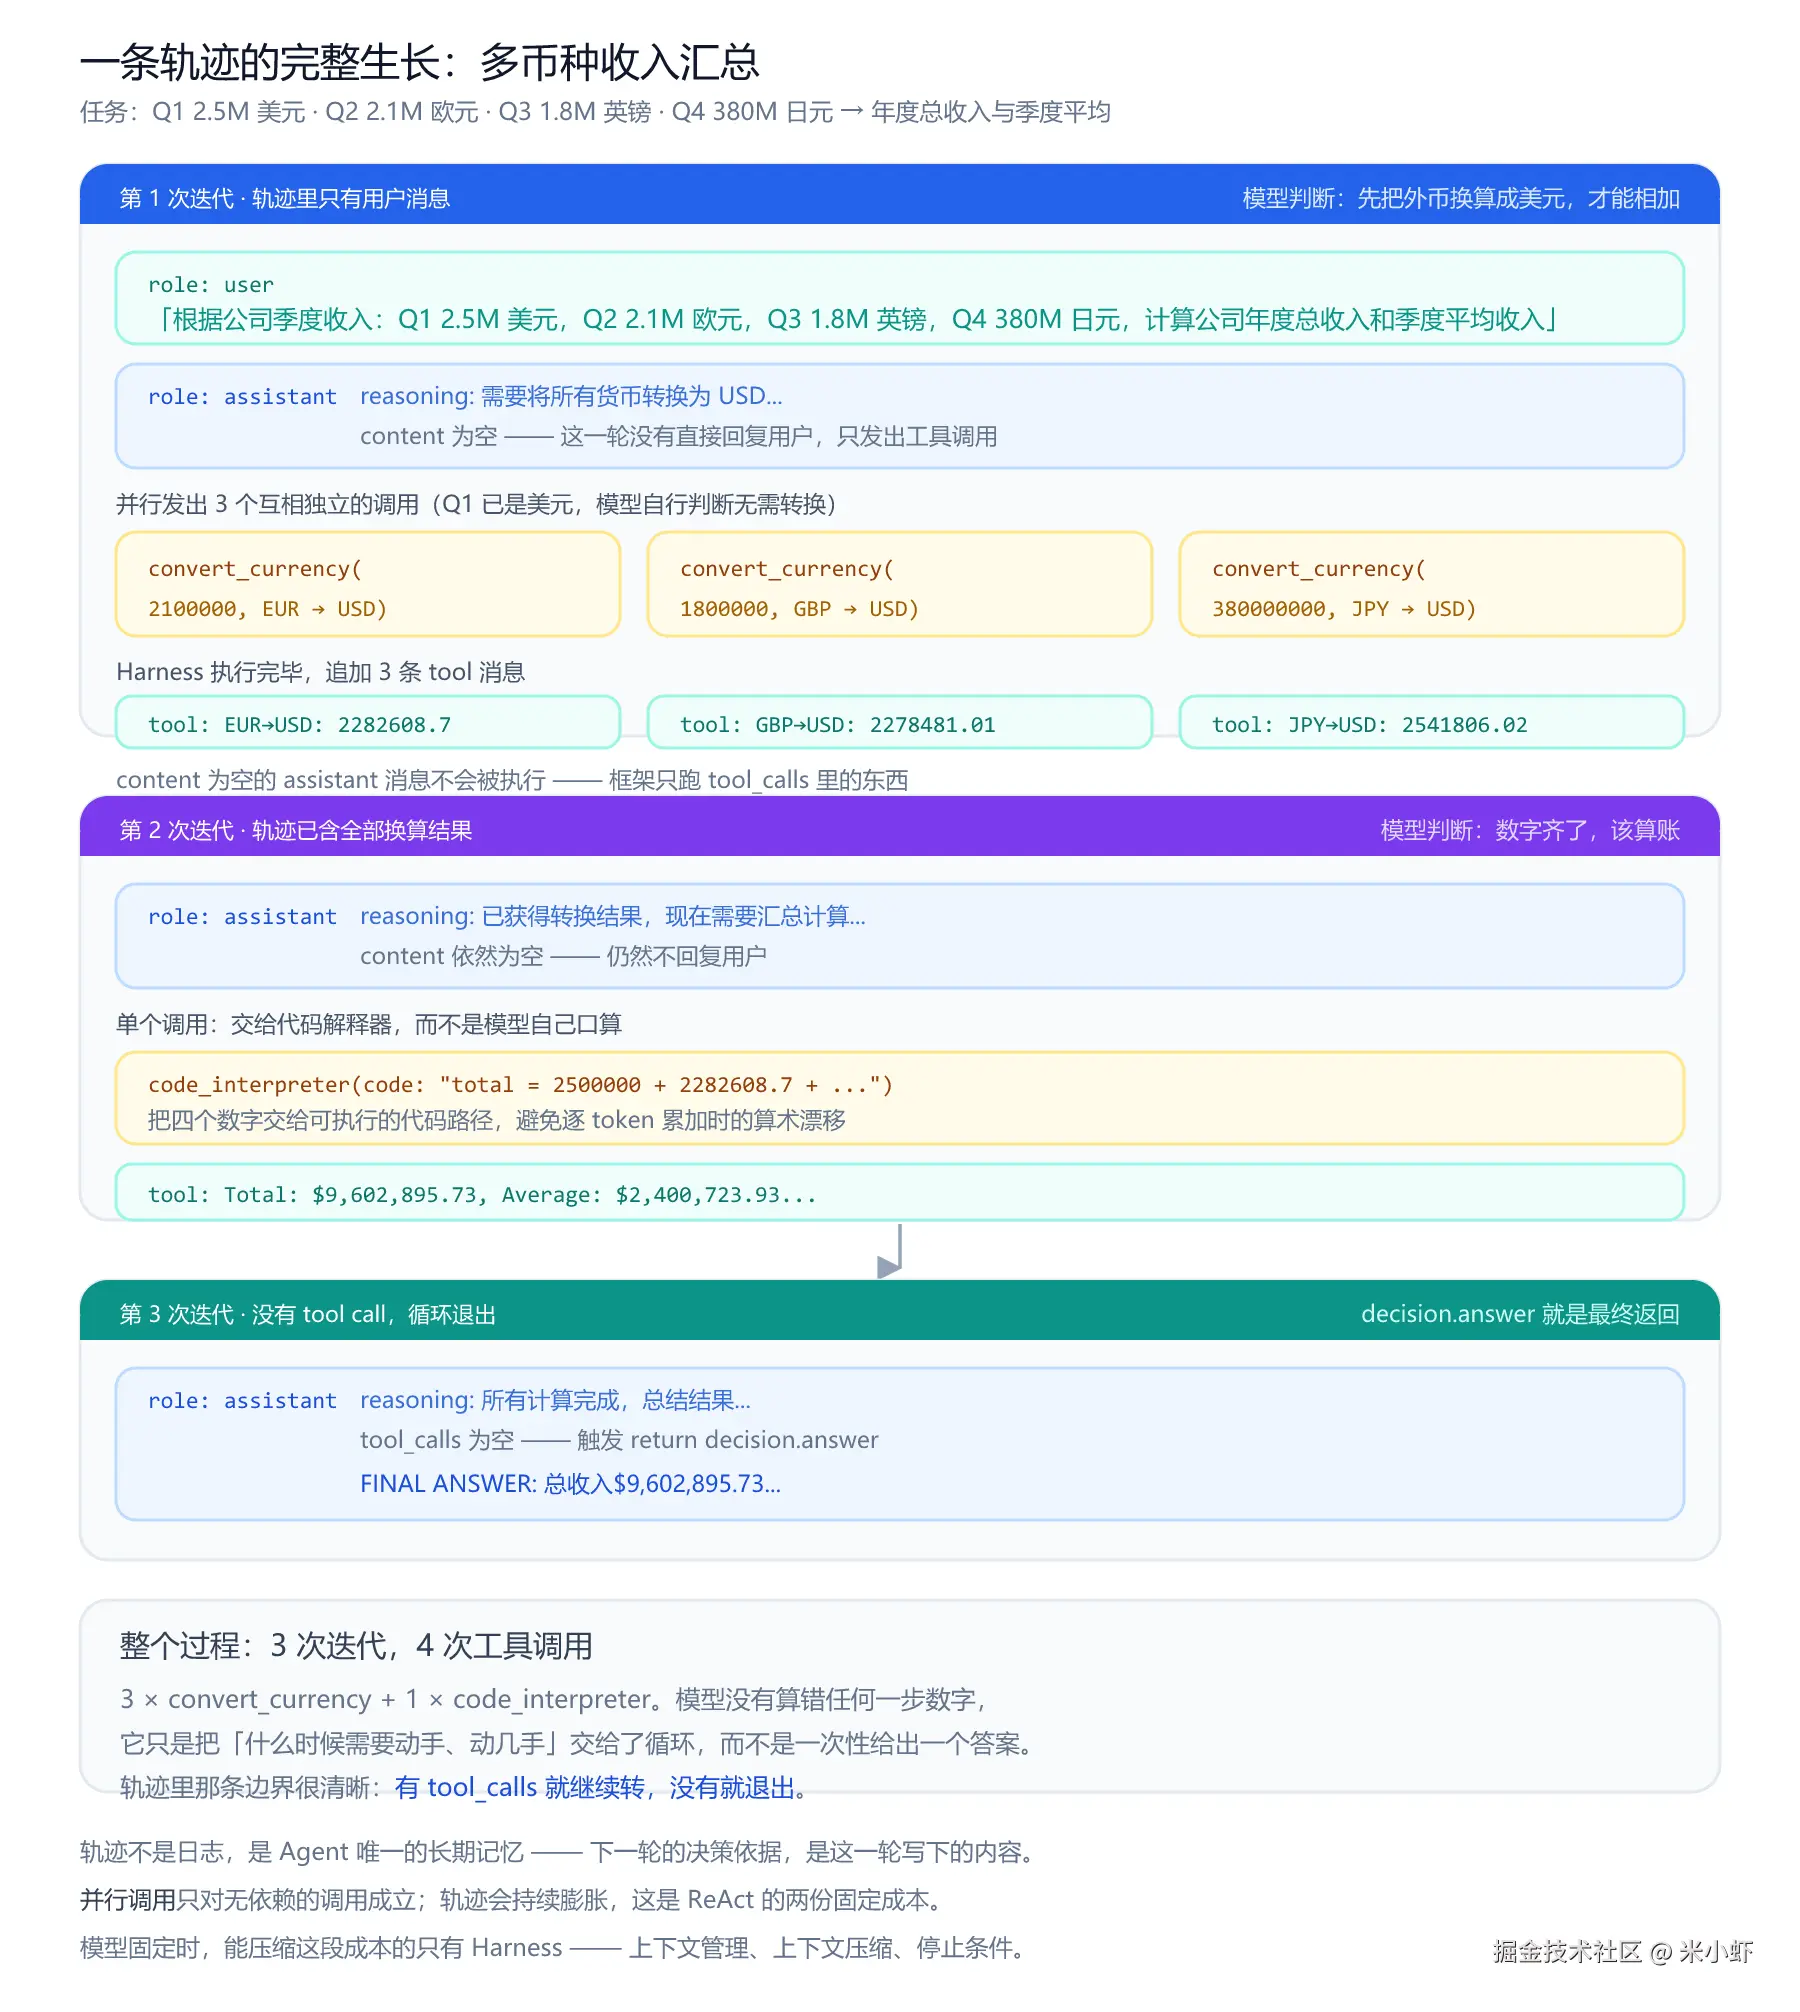
完整轨迹长这样:
text
轨迹 = [
  {
    role: "user",
    content: "根据公司季度收入:Q1 2.5M 美元,Q2 2.1M 欧元,Q3 1.8M 英镑,Q4 380M 日元,计算公司年度总收入和季度平均收入"
  },
  # 第一次迭代 - LLM 看到上述轨迹,生成响应
  {
    role: "assistant",
    reasoning: "需要将所有货币转换为 USD...",
    content: "",
    # 没有直接回复用户
    tool_calls: [
      { name: "convert_currency", args: {amount: 2100000, from: "EUR", to: "USD"} },
      { name: "convert_currency", args: {amount: 1800000, from: "GBP", to: "USD"} },
      { name: "convert_currency", args: {amount: 380000000, from: "JPY", to: "USD"} }
    ]
  },
  # Agent 框架执行工具,添加结果到轨迹
  { role: "tool", content: "EUR->USD: 2282608.7" },
  { role: "tool", content: "GBP->USD: 2278481.01" },
  { role: "tool", content: "JPY->USD: 2541806.02" },

  # 第二次迭代 - LLM 看到完整轨迹,包括工具结果
  {
    role: "assistant",
    reasoning: "已获得转换结果,现在需要汇总计算...",
    content: "",
    tool_calls: [
      { name: "code_interpreter", args: {code: "total = 2500000 + 2282608.7 + ..."} }
    ]
  },
  { role: "tool", content: "Total: $9,602,895.73, Average: $2,400,723.93..." },

  # 第三次迭代 - LLM 看到完整轨迹,生成最终答案
  {
    role: "assistant",
    reasoning: "所有计算完成,总结结果...",
    content: "FINAL ANSWER: 总收入$9,602,895.73..."
  }
]
值得留意的是效率:**整个过程只用了 3 次迭代、4 次工具调用。**一道需要查询、换算、汇总的财务题,没有跑出循环。
把这 3 次迭代摊开看,得到三个观察。
观察一:模型自己判断了谁不需要转换
第一次迭代发起了 3 个调用,不是 4 个。Q1 的 2.5M 美元被直接跳过。
没人告诉它"美元不用换"。它读懂了"转换成 USD"这个目标,并且判断出:已经是 USD 的数字,换了也是换给自己看。
这种判断力是模型决策能力的直接体现------它不是在执行预设流程,而是在给定工具边界内自己决定调什么、不调什么。
顺带说,第二轮代码里写的是 total = 2500000 + ...。那个 2500000 就是原封不动的 Q1。跳过的判断,在第二轮又被用上了。
观察二:并行工具调用
第一次迭代的三个 convert_currency,EUR、GBP、JPY 互不依赖。模型把它们塞进同一个响应里一次性发出,框架并发执行,三个结果一起回来。
这直接换来了时间收益:串行要三次往返,并行只要一次。
但这里有个必须说清的边界:并行只对无依赖的调用成立。 如果第二步要用到第一步的结果(比如"换算完再除以 4"),那就必须串行。盲目并行是很多 Agent 实现的 bug 来源------模型给了三个调用,框架不管有没有依赖就一起塞进线程池。
观察三:轨迹在增长,决策在收敛
三轮迭代的差异全在 reasoning 上:
| 迭代 | 模型看到的轨迹 | reasoning | content | 动作 |
|---|---|---|---|---|
| 1 | 只有用户消息 | 需要将所有货币转换为 USD... | 空 | 3 个并行 convert_currency |
| 2 | 含 3 条换算结果 | 已获得转换结果,现在需要汇总计算... | 空 | 1 个 code_interpreter |
| 3 | 含汇总结果 | 所有计算完成,总结结果... | FINAL ANSWER: ... | 无工具调用,退出 |
两条值得单独拎出来的细节:
前两轮的 content 都是空的。 模型没有在每一轮都对着用户说话。它把话憋到最后一轮才说。中间两轮它只在"想"和"做"------这就是"边想边做"在数据层面的样子。
汇总计算交给了 code_interpreter,不是模型自己心算。 这是个很关键的选择。让语言模型逐 token 累加四个大数,天然有算术漂移的风险。交给代码执行,一次搞定且精确。能不能选对工具,比算得对不对更影响结果可信度。
五、轨迹的六项价值
看到这你应该明白了:轨迹不是日志,是 Agent 唯一可靠的长期记忆。
它至少支撑六件事:
- 解释 Agent 行为 ------ 用户问"为什么给我这个数",你能把轨迹原样摊开:他调用了什么、得到了什么、怎么算的。
- 调试失败 ------ 出问题时能精确定位到是哪一步错了。工具报错了、参数生成错了、还是循环绕进去了。
- 识别任务进度 ------ 模型每次调用都能看到完整轨迹,因此清楚任务进行到哪一步、此前尝试过什么、得到了什么结果。
- 发现重复循环 ------ 轨迹里连续出现相似的工具调用,就是卡住的信号。这是生产环境里最实用的一个早期预警。
- 优化工具设计和决策路径 ------ 分析大量轨迹能发现行为模式:哪个工具总被误用、哪条路径总是绕远、哪个返回格式总让模型理解错。这是唯一能拿到"真实决策数据"的途径。
- 沉淀知识库或强化学习数据 ------ 轨迹可以喂进检索库当 few-shot 示例,也可以用来训练更好的模型,形成从经验中学习的闭环。
第 4 条和第 5 条,恰好对应两个常见故障:卡住 和 绕远。有轨迹,才能诊断。
六、更可靠的循环:从"能跑"到"可靠"
上面那个骨架能跑,但离可靠还差一步。加一层约束、验证和纠正,就是第二版实现:
python
observation = Environment.observe()
trajectory = [observation]

while true:
    actions = Model(Harness.build_context(trajectory))
    if len(actions) == 0:
        break

    allowed_actions = Harness.constrain(actions)
    observation = Environment.apply(allowed_actions)

    if not Harness.verify(Environment):
        observation = Harness.correct(Environment)

    trajectory.append(allowed_actions, observation)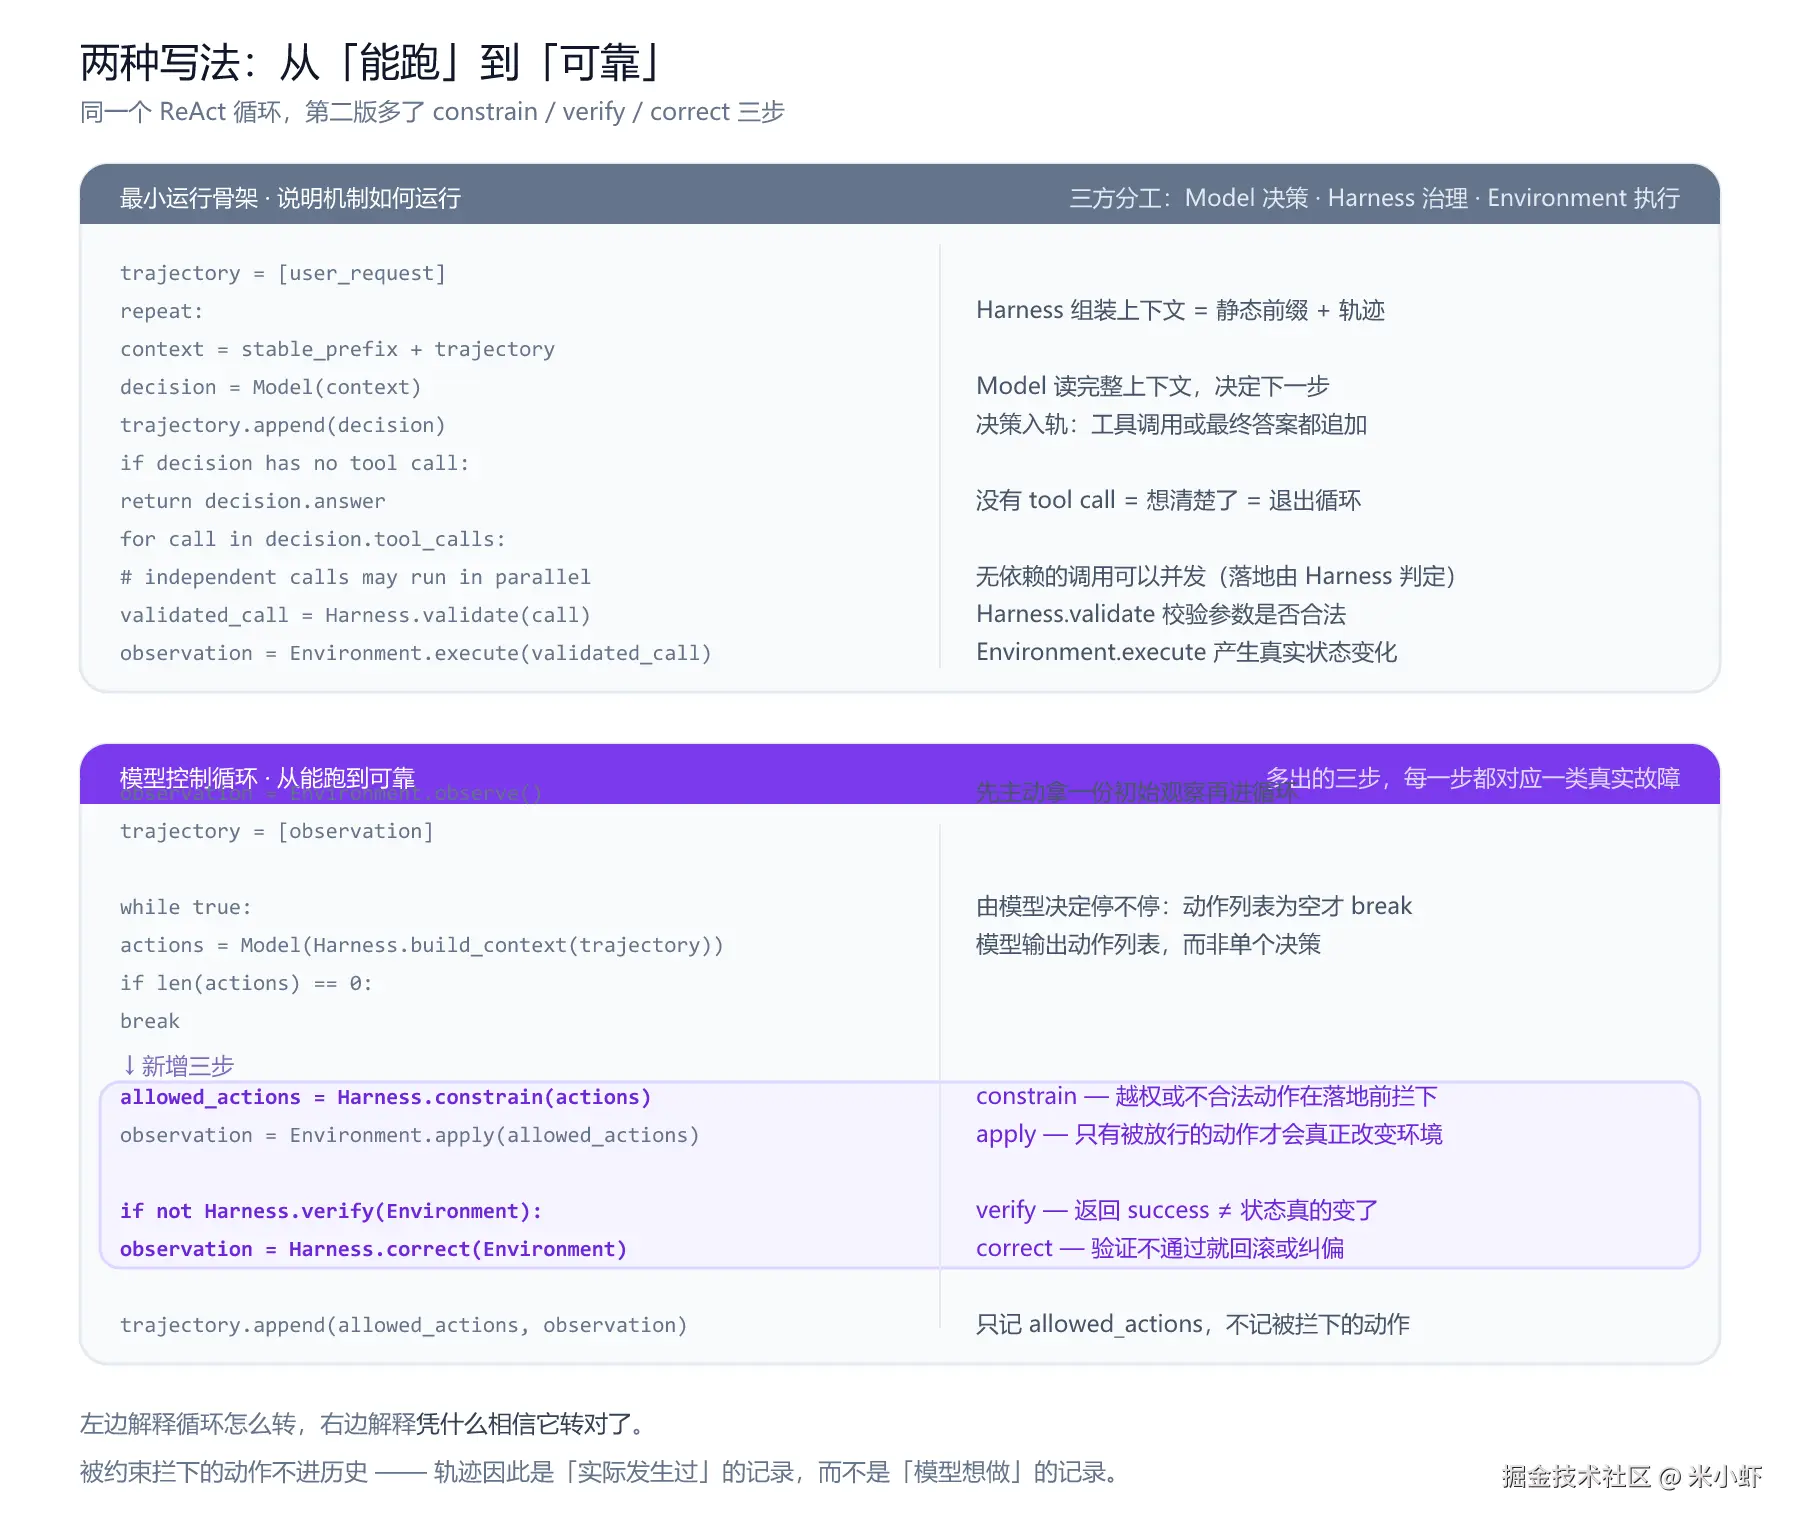
对比着看,多出来三步,每一步都对应一个真实故障:
Harness.constrain(actions) ------ 约束。 模型可能给出越权或不合法的动作。在它落地之前拦下来。模型不执行工具,所以"该不该执行"这道闸门,只可能在 Harness 上。
Harness.verify(Environment) ------ 验证。 工具调用返回了 success,不代表世界真的变了。写文件返回成功但没落盘、API 返回 200 但数据没进去。只有回读环境状态,才能确认副作用真的发生。
Harness.correct(Environment) ------ 纠正。 验证失败之后的回滚、纠偏、或者换一条路。
还有一个细节值得注意:第二版的轨迹里记的是 allowed_actions,不是模型原始的 actions 。也就是说,被约束拦下的动作不进历史。轨迹保留下来的,是真正被执行过的操作。这保证了轨迹是"实际发生过的记录",而不是"模型想做的记录"。
这三步,正是 Harness 五要素里的 Constrain / Verify / Correct。
从"能跑"到"可靠",差的不是模型能力,是这三步。 具体怎么工程化,第 5 篇展开。
七、什么时候这个说法会失效
ReAct 不是免费的。该说边界了。
第一,简单任务不需要循环。 如果任务就是"把这段话翻译成英文"或者"解释这行代码",一次模型调用更快、更准、更便宜。硬套 ReAct,只会增加成本和延迟,并让输出带上多余的"我现在要开始计算了"这种噪音。循环的价值来自"中间结果不可预知",如果中间结果能被预知,就不需要循环。
第二,并行调用只适用于无依赖的场景。 前面说过三次汇率转换可以并行,但如果调用之间有数据依赖,就必须串行。工程上真正难的不是"起几个线程",而是准确判断依赖关系------这需要 Harness 提供依赖声明或执行计划能力。做不到就全部串行,宁可慢,不要错。
第三,轨迹会持续膨胀,带来成本和延迟。 这条最容易被忽略。每一轮迭代,上下文都要带上全部历史。 轨迹越长,每轮的 token 成本越高,延迟也越高。跑到第 15 轮时,上下文可能已经长到让模型开始"忘事"------早期工具结果被淹没在中间,无视它。
长上下文会真实地降低决策质量 ,这不是费用问题,是能力问题。缓解手段只有两条:压缩轨迹(丢弃或摘要化早期轮次)、限制最大迭代次数。ReAct 能跑多远,取决于你有多会管上下文。
第四,ReAct 可能陷入重复循环。 模型反复用同样的参数调同一个工具,或者在没有进展的空转里打转。没有停止条件的 ReAct 会烧掉大量预算甚至撞上速率限制。必须设上限:最大迭代次数、最大 token 消耗、连续无进展检测。 这三条不是可选优化,是必备的熔断。
第五,客户端与服务端的编排边界会改变设计。 上面两段伪代码都假设 Agent 循环跑在 Harness 里。如果实际形态是客户端只发请求、服务端托管工具和密钥,那么 validate / constrain 这类逻辑必须在服务端做;如果执行环境在用户的机器上,权限和约束就要重新划一遍。ReAct 的循环逻辑可以跨端,但"谁能按下执行按钮"这件事,必须落在可信的一侧。
小结
这一篇只讲透了一件事:Agent 为什么要自己转。
ini
ReAct = 想 → 做 → 看 → 想 → 做 → 看
context = stable_prefix + trajectory
Model:决定下一步
Harness:组装上下文、校验执行、维护轨迹
Environment:产生真实状态变化与观察
退出:没有 tool call 就返回 answer
多币种那个例子里,3 次迭代、4 次工具调用、$9,602,895.73 这个数字,没有一步是模型在"凭空聪明"。 每一步都是"看了真实结果,才敢走下一步"。而 Q1 的美元被跳过、汇总交给代码解释器这两个决定,则说明它又确实在做判断,不是在走流程。
轨迹是这套机制的副产品,也是它最值钱的资产。能解释、能调试、能识别进度、能发现卡死、能优化工具、能喂给下一轮训练。
代价同样明确:更长的上下文、更高的延迟、更复杂的终止条件管理。
下一篇要聊一个更现实的问题:你给 Agent 挂了 30 个工具,它反而变笨了。 为什么"多给工具"是个陷阱,以及该怎么设计工具集。
下一篇:《工具设计:为什么"多给工具"是个陷阱》
关注这个系列,我会持续更新。觉得有用的话,欢迎点个赞------它会让我更有动力把下一篇写好。