Agent开发入门系列第 4 篇 · 读这一篇需要 6 分钟
系列导读:这个系列不追热点,只把 Agent 架构里那些密度极高、一次读不透的概念,一个一个拆开。
先说一个我见过太多次的翻车现场。
某天一个团队把公司的工具箱整个挂了上去------搜索、数据库、文件系统、发邮件、写代码、查日历、算汇率、调审批流程,一共 50 来个。跑简单任务很顺,接上一个稍微复杂点的需求,Agent 就开始干傻事:查天气先去翻了三个文件,写总结时调了两次发邮件,甚至把一个只读接口当成了能改数据的接口用。
工程师的第一反应是"这模型不行,换个更强的"。换完之后问题一模一样,只是换了种错法。
真正的原因不在模型。工具集本身就是一份给模型看的说明书,它越多,模型要做的选择就越多;而每增加一个工具,静态前缀就长一截。 第 2 篇讲过,工具定义住在上下文的静态前缀里,每轮都要原样重放。50 个工具的 schema 摊在窗口最前面,模型的注意力、指令、判断一起被稀释------能力没涨,成本和出错率先涨了。
所以这一篇要解决两件事:工具到底有哪几类 ,以及该给它几个、给它什么样的。
一、最朴素的样子:工具调用的四步
工具调用(Function Calling)的机制比很多人想象的简单。它就是四步:
- 在上下文中声明工具 ------ 名称、功能、参数格式。第 2 篇说过,这三样就是工具定义的全部。
- 模型决定 ------ 是否调用、调用哪个、使用什么参数。
- 执行工具,并把结果追加到上下文 ------ 注意是"追加",写进轨迹的第 ⑤ 格。
- 模型依据结果决定下一步 ------ 拿到新观察,回到第 2 步,或者给出最终答复。
用一个天气查询走一遍,结构是这样的:
text
第一步:声明工具
第二步:模型决定调用
tools: [{
  assistant: {
    name: "get_weather",
    tool_calls: [{
      parameters: {
        function: "get_weather",
        city: "string"
        arguments: { city: "北京" }
      }
    }]
  }
}]

第三步:结果追加到上下文
第四步:模型基于结果回复
tool: [{
  assistant: {
    tool_call_id: "call_1",
    content: "北京今天 28°C,晴。"
    content: '{"temp":28,"sky":"晴"}'
  }
}]
这个例子里有两个细节值得注意。
第一,第二步的三个决定是分开的。 是否调用、调用哪个、用什么参数------这是三件事,可以有不同答案。用户问"我穿外套合适吗",模型可以靠常识回答,一个工具都不调;问"北京呢",它才知道必须调。
第二,工具结果有两种形态。 call_1 对应的是返回的整句人话,同时还有结构化的 {"temp":28,"sky":"晴"}。模型拿到的如果是"北京今天 28°C,晴。"这一句话,就得从文本里重新解析温度;拿到 JSON,就可以直接拿来算。 同一个事实,机器可读的形式决定了它能不能被继续加工。
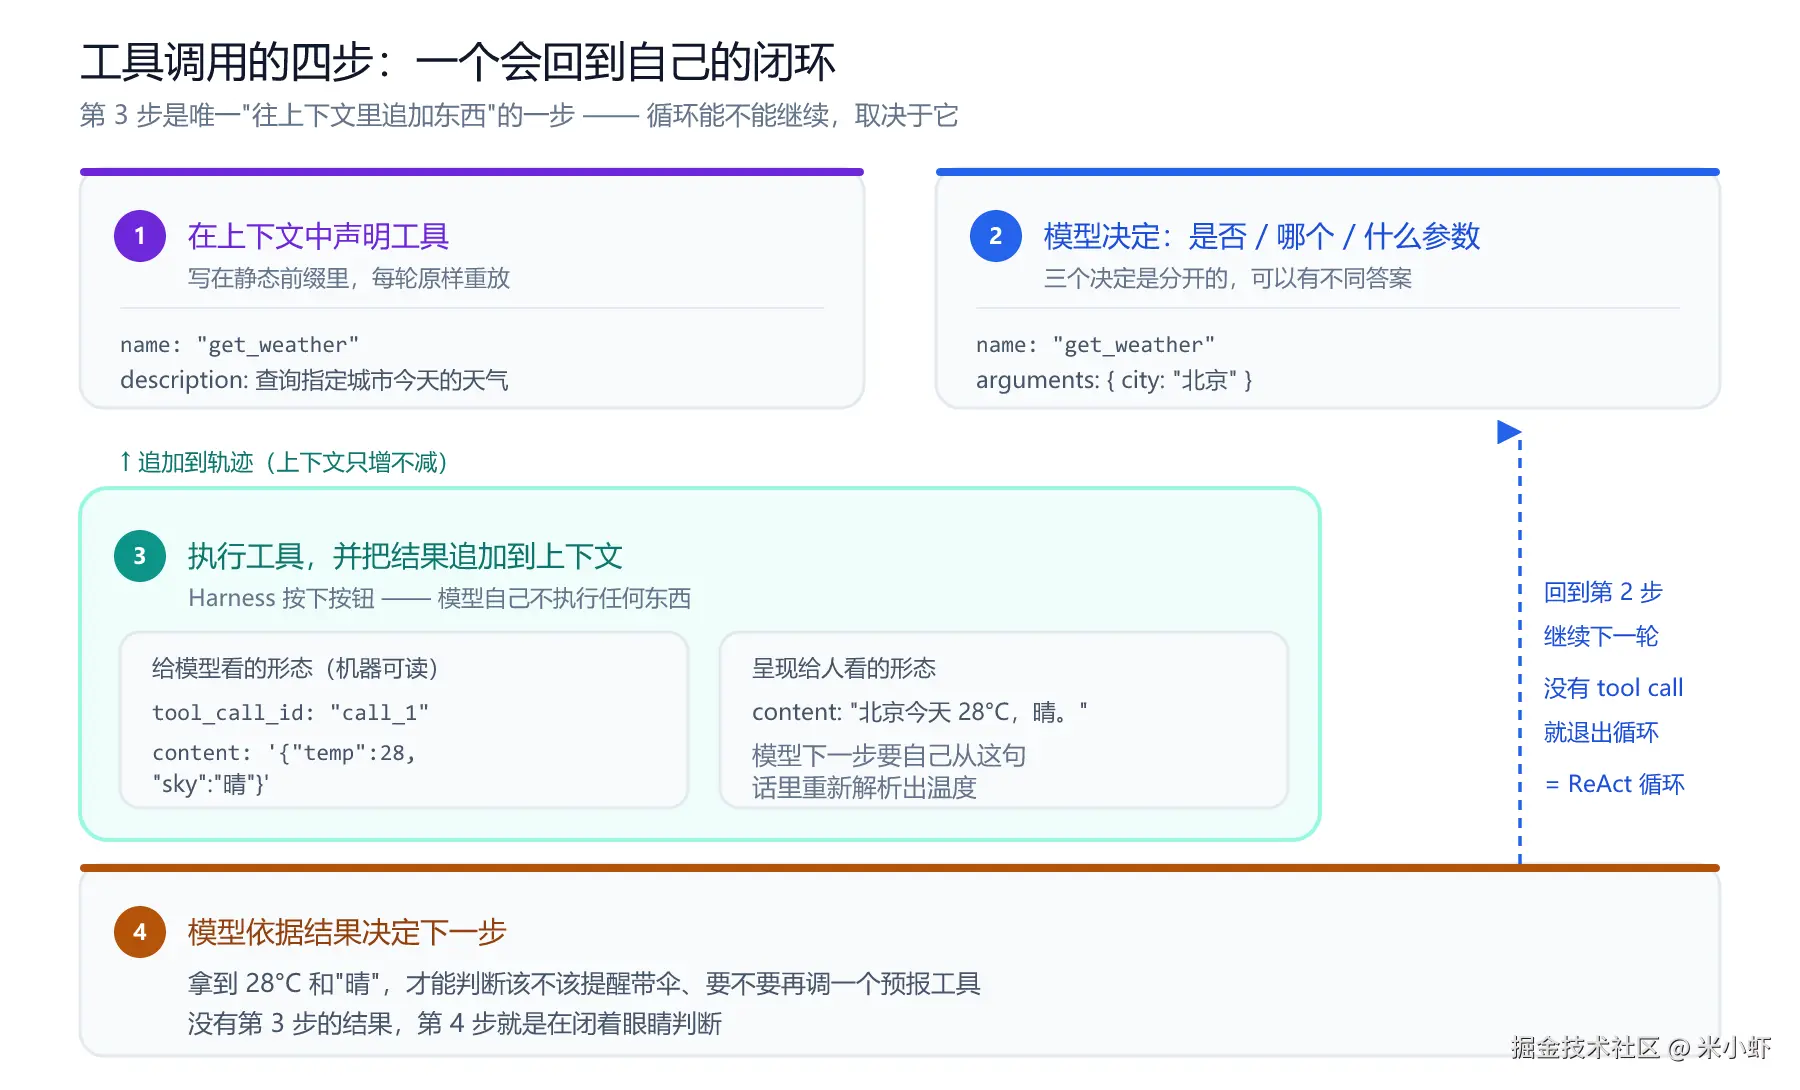
四步走完是一个闭环------第 4 步的判断会触发下一轮的第 2 步。上一篇讲的 ReAct 循环,本质就是这个闭环的反复执行,差别只有一个:ReAct 里"没产生 tool call"就意味着退出循环。
二、工具不止是函数:五类工具
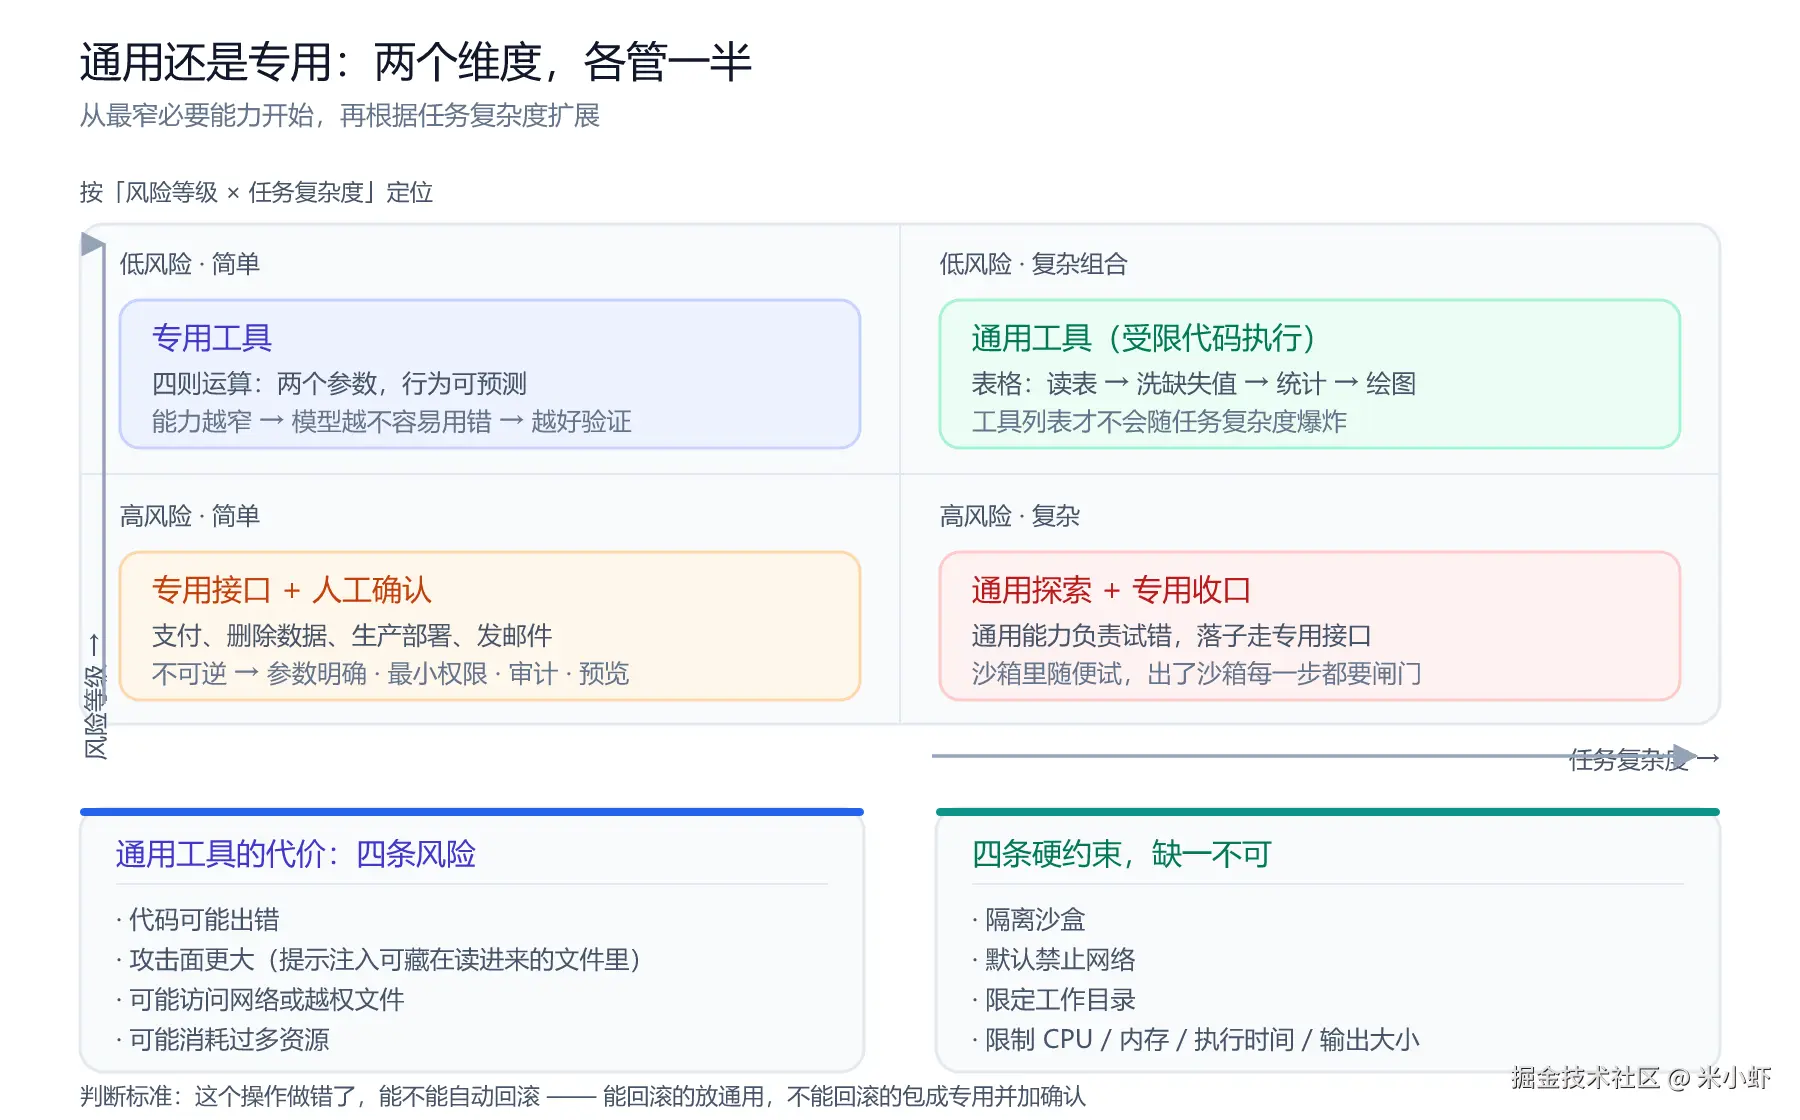
现在说本篇的骨架。工具不只是五个并列的能力清单,它们分属五个完全不同的方向 ,混在一起讲是最常见的误解。接下来这道题才是设计层面真正难的那道:挂几个?挂什么样的?
| 类别 | 方向 | 做什么 | 例子 |
|---|---|---|---|
| 感知工具 | Environment → Agent | 访问信息 | 搜索引擎、文件系统、API、数据库 |
| 执行工具 | Agent → Environment | 改变世界 | 代码执行、文件操作、系统命令、外部 API 调用 |
| 协作工具 | Agent ↔ 其他 Agent / 人 | 双向协作 | 委托子 Agent、请求人工确认、多 Agent 协调 |
| 事件触发工具 | Environment → Agent(不经模型主动) | 被外部事件激活 | 新邮件、定时任务、Webhook 回调 |
| 用户沟通工具 | Agent → 用户 | 传递信息与交互 | 文字消息、语音通话、邮件 |
感知与执行:一支箭的两头
感知工具把外部信息搬进上下文,不改任何东西。但没有它,Agent 的判断就只能靠参数里的记忆------第 2 篇讲过,那会产出格式完整、语气笃定的错误答案。执行工具恰好相反,它是唯一会改变外部状态的一类。
换个说法:感知工具决定 Agent 的天花板,执行工具决定它的地板。 而"模型自己不执行任何东西"这个前提依然成立------模型只输出一段调用意图,按下按钮的是 Harness,所以权限、限流、审计这些约束只能落在 Harness 侧。
协作工具:Agent 不总是独自工作
委托给子 Agent、请人确认、多 Agent 互相协调,都属于这一类。值得注意它们的性质差异:子 Agent 委托本质上是上下文操作。 把子任务交出去,子 Agent 用自己的窗口干活,只把结论带回来------这是压缩上下文最有效的手段之一。
事件触发工具:唯一不由模型决定的一类
前三类都是模型主动发起的。事件触发工具不一样------新邮件到了、定时器触发了、Webhook 回调来了,Agent 根本没"决定"调用它。 这一类的调用权在外部,模型只有"接到之后怎么办"的权力。
视角上值得注意:事件适配器可以看作 Environment 向 Agent 提供观察的另一条通道。 新邮件这个观察不是模型搜出来的,是环境主动推过来的。第 1 篇画的那支箭头,事件触发工具就是它的一种实现方式。
用户沟通工具:重点在传递,不在改变
文字消息、语音通话、邮件,看着像执行工具,但重点完全不同。执行工具的重点是改变外部世界;用户沟通工具的重点是把信息传递给用户、把用户的反馈接回来。 发一封通知邮件,用户邮箱里确实多了一封,但这条工具的意义不是"改邮箱"而是"让用户知道"。前者的失败会造成脏数据,后者的失败只是用户没收到消息。
工具系统 ≠ 函数集合
第 1 篇那句话在这里有了确切含义:真实的工具系统还包括工具定义、调用协议、适配器、代码执行沙箱、子 Agent 委托机制、主动与用户沟通的通道。一个孤零零的 get_weather() 函数和这六件事构成的完整系统,能力差的是数量级,不是百分比。
三、通用性 vs 专用性:本篇最该记住的判断
这里的设计原则可以浓缩成一句话:
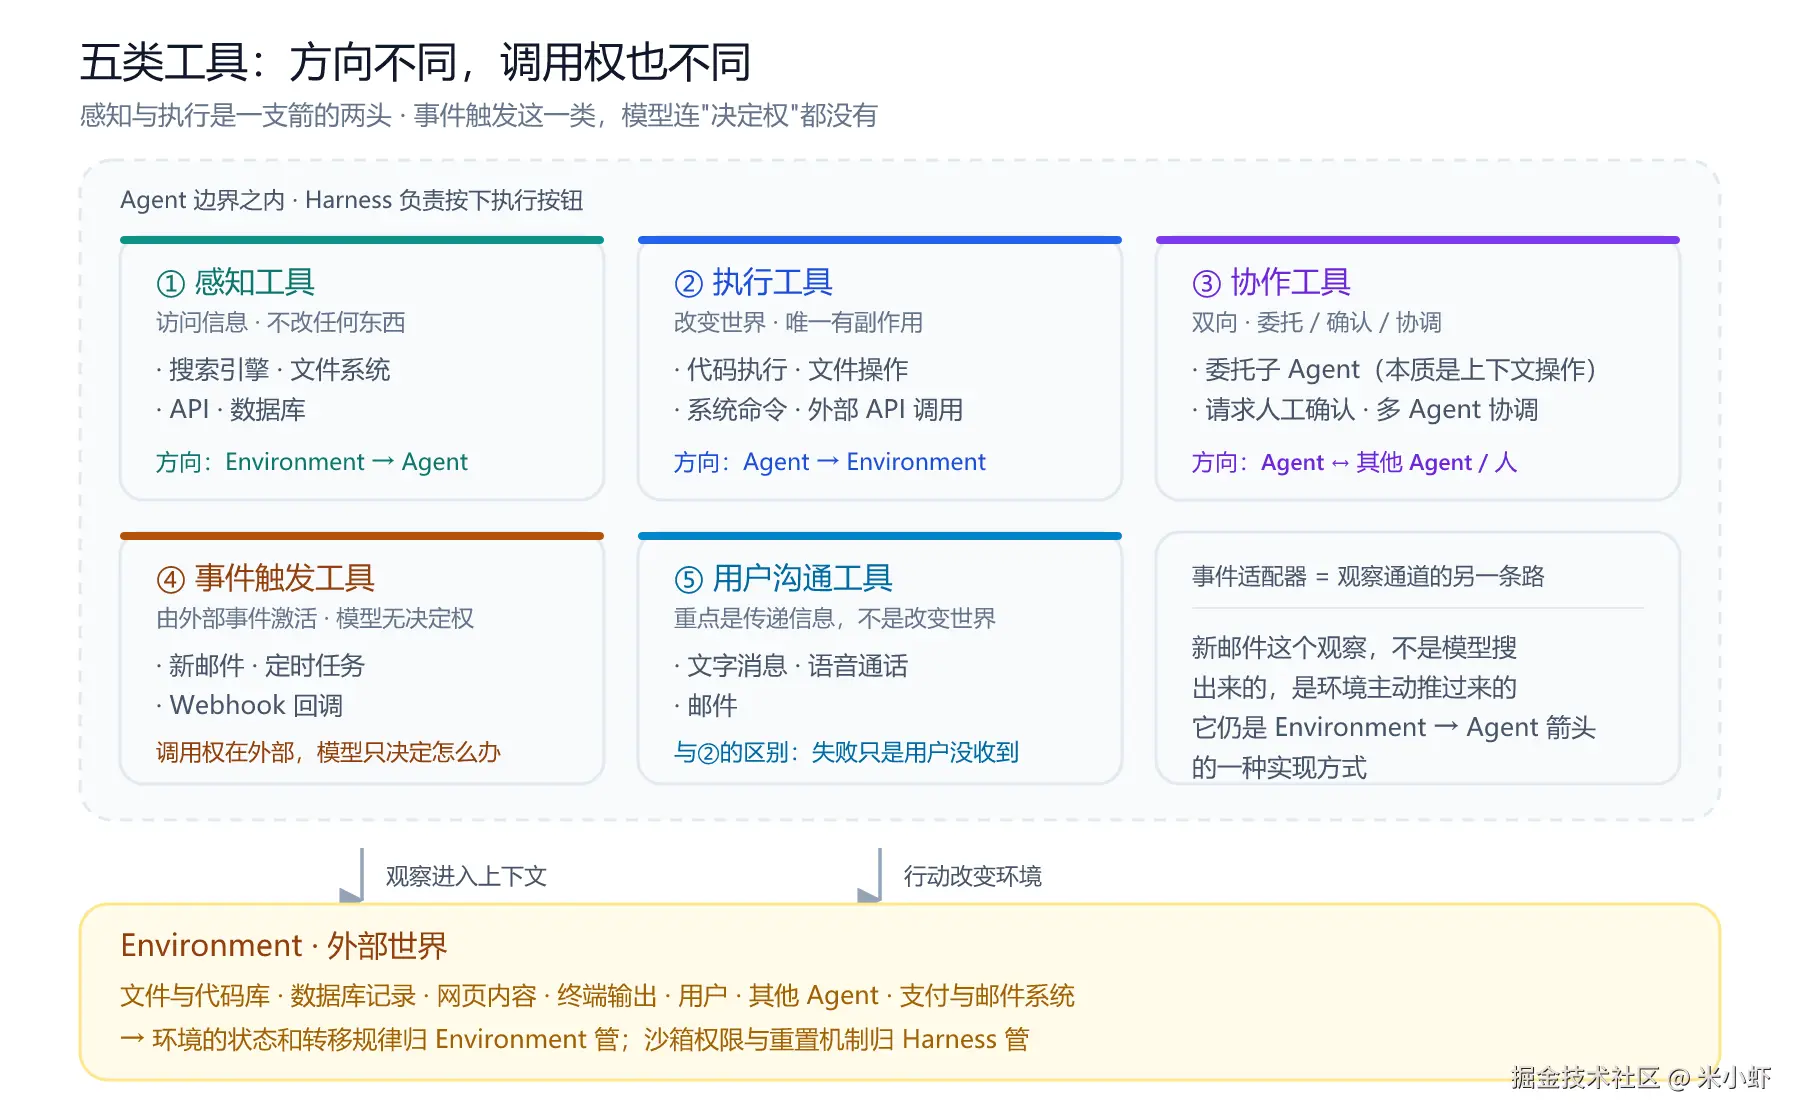
从最窄必要能力开始,再根据任务复杂度扩展。
这不是一句正确但无用的话,它有非常具体的推论。
简单任务 → 专用工具
四则运算就是典型。给它一个 add(a, b),参数是两个数,行为完全可预测,出错面极小。能力越窄,模型越不容易用错,Harness 越好验证。
复杂组合任务 → 通用工具
现在看表格处理:读表格、洗缺失值、算统计量、画图。
你当然可以为每一步写一个专用工具------read_csv()、drop_missing()、compute_stats()、plot()。看上去很整齐,实际用起来会很难受:需求稍微一变(比如"按月分组再算"),就得加工具。工具列表会随任务复杂度爆炸。
换个说法:受限的 Python 解释器通常比叠加一大片专用工具更容易组合 。第 3 篇那个多币种例子正是这个逻辑------模型没有调"汇率汇总"这个专用工具,它调的是 code_interpreter。
通用工具的风险
这里有个坑必须点清楚:通用能力换来的灵活性,是用风险买来的。
- 代码可能出错 ------ 语法错误、类型错误、逻辑错误,全都会发生
- 攻击面更大 ------ 提示注入可以藏在读进来的文件里,诱导模型执行任意代码
- 可能访问网络或越权文件 ------ 一个
open()就可能读到不该读的东西 - 可能消耗过多资源 ------ 一段死循环能把整个运行时拖垮
后两条最容易被低估:它们不是"可能发生的小概率意外",而是通用能力本身必然带来的敞口。
对应的约束措施有四条:隔离沙盒 、默认禁止网络 、限定工作目录 、限制 CPU、内存、执行时间、输出大小 。这四条不是可选项------没有沙盒的通用工具,等于把宿主机直接交给模型的每一次判断。
长任务 → 受控的虚拟工作目录
还有一类情况介于两者之间:任务很长,长到需要跨步骤保存东西。
长程任务要保存计划、中间结果、运行日志、最终产物。这些东西不可能一直待在上下文里------上下文是只增不减的轨迹,存进去会挤爆窗口。
正确做法是给 Agent 一个受控的虚拟工作目录 让它把状态落盘,限制可读写的路径范围、容量上限、允许的文件类型、路径越界(../)、向宿主文件系统的暴露范围。换个说法:工作目录是 Agent 的长期记忆,沙盒是它的边界,这两件事经常被合并成一个"临时文件夹",但要解决的问题完全不同。
高风险操作 → 必须用专用工具
支付、删除数据、发送邮件、生产部署------这几类不管任务多简单,都应该走专用工具。原因是它们的失败不可逆,而且失败很贵。这类工具应该具备参数明确的专用接口 (不是"执行任意命令",而是"从订单号发起退款")、最小权限 、全程审计 + 预览 + 人工确认 。判断标准很朴素:问一句"这个操作做错了,能不能自动回滚"。
落点
通用基础能力用于组合与探索;专用工具用于约束高风险和强业务规则操作。
值得注意这条原则的方向性:它不是说通用工具更好,也不是说专用工具更安全。 它说的是两者的分工。混在一起是两种典型错误:什么都是专用工具 ,任务一变就得加工具,列表永远长不完;什么都是通用工具,风险敞口全开,安全只能靠提示词喊话。
四、MCP:把接入成本降下来的一件事
上面所有讨论都建立在"工具是自己一个个接进来的"这个前提上。MCP(Model Context Protocol,模型上下文协议)用标准化的方式描述模型与外部工具、数据源、系统的连接,让同一个工具服务不必为每个客户端重写一遍适配层。
换个说法,它降低的是工具接入的成本结构,不是工具设计的判断成本。 接入便宜了不等于该挂 50 个。MCP 的协议细节与生态现状不在这一篇的范围内,这里不展开。
五、什么时候这个说法会失效
写到这里该说边界了。这套取舍逻辑好用,但它的适用条件比想象中窄。
第一,沙盒健全时,通用工具确实更灵活。 如果运行环境有完善的隔离、网络默认关闭、资源限额齐全,那么"受限 Python 解释器 + 受控工作目录"能覆盖的任务范围远大于任何专用工具集合。本篇讲的取舍,前提是你能把这套约束真的做出来------做不到还硬上通用工具,是最糟的组合。
第二,工具数量本身不是唯一变量。 50 个工具会稀释注意力,但稀释程度还取决于另外两件事:命名是否清晰 (get_user_info 和 fetch_user_profile 摆在一起,模型要先花力气区分),参数设计是否自解释 (mode: string 还是 mode: "readonly" | "write")。所以"工具要多而精"是句废话------真正的问题是"工具设计得好不好"。
第三,MCP 改变了成本结构,也就改变了结论的权重。 当接入一个外部服务的成本从"写一套适配器"降到"配一个 server",工具集膨胀的阻力会小很多。那时候更该警惕的是另一个方向:工具太多导致的选择困难,而不只是上下文长度。 这两个问题手法不同,别混着治。
第四,有些场景专用工具堆叠反而更易维护。 如果业务规则多、变更有审计要求、每一步都需要幂等和可回滚,那么"一堆薄薄的专用工具"比"一个万能 Agent 在沙盒里自己想办法"更容易测试、更容易定位问题,牺牲通用性换确定性是划算的交易。而工具粒度本身也有合理边界:太细 每个业务动作一个工具,模型根本选不出来;太粗 一个万能工具包办一切,参数臃肿、行为不可预测。具体位置取决于任务分布。
第五,本篇只谈了"该有什么工具",没谈"怎么保证它不乱用"。 沙盒、工作目录、最小权限,这些是约束 ;而"工具返回 success 但世界没真的变""高风险动作要不要先问人"属于验证和纠正 。能力上去了,可靠性没跟上,得到的只是一个更快犯错的系统。
小结
这一篇把"手脚"拆完了。
arduino
工具调用四步:
  ① 声明工具(名称/功能/参数格式)→ ② 模型决定(是否/哪个/什么参数)
  → ③ 执行并追加结果到轨迹 → ④ 模型依据结果决定下一步(回到 ②,或退出)

五类工具:
  感知     Environment → Agent    读信息,决定能力天花板
  执行     Agent → Environment    改状态,唯一有不可逆副作用的一类
  协作     Agent ↔ Agent/人       委托、确认、协调
  事件触发 Environment → Agent    由外部激活,模型没有"决定权"
  用户沟通 Agent → 用户          重点是传递信息,不是改变世界

取舍:
  简单任务 → 专用工具(可预测、易验证)
  复杂组合 → 通用工具(沙盒 + 默认禁网 + 限定目录 + 资源限额)
  长任务   → 受控虚拟工作目录(长期记忆 + 边界)
  高风险   → 专用接口 + 最小权限 + 审计 + 预览 + 人工确认

通用基础能力用于组合与探索;专用工具用于约束高风险和强业务规则操作。
四条必须带走的:
- 工具集是写给模型看的说明书,不是越多越好 ------ 开头那个翻车现场,根因不在模型
- 五类工具方向不同,感知和执行是一支箭的两头,事件触发那一类模型甚至没有"决定权"
- 工具结果要给机器可读的形态 ------ 一句"28°C,晴"和一个
{"temp":28,"sky":"晴"},模型的用法完全不同 - 通用工具的风险必须靠硬约束挡住,提示词里的"请谨慎"一文不值
第 4 条最容易被跳过。很多人知道要给沙盒,但不知道沙盒隔离的只是"崩不掉",网络、路径、资源这三道口子还得单独堵。
下一篇回到 Harness:光有工具设计还不够------工具铺开了,接下来需要的是约束、验证、纠正,这正是从"能跑"到"可靠"之间的全部距离。
下一篇:《Harness 五要素:从"能跑"到"可靠"》
关注这个系列,我会持续更新。觉得有用的话,欢迎点个赞------它会让我更有动力把下一篇写好。