【计算基础|MySQL06】MySQL 架构与一条 SQL 的旅程
前面五篇你一直在"用"MySQL------建表、查数据、授权、备份。但面试官最爱问的恰恰是"MySQL 内部是怎么干活的":你那条 SELECT * FROM user WHERE id=1,从敲下回车到结果回来,中间经过了哪些模块?一条 UPDATE 为什么要先写 redo log 再落盘?为什么 MySQL 8 把查询缓存删了?
这一篇钻进 MySQL 肚子里,把架构分层、一条 SELECT 和一条 UPDATE 的完整链路画出来。机制图全部 Mermaid,每节配"面试怎么考"。所有版本号、参数都在本机 MySQL 8.0.46 上验证过。
环境:Docker MySQL 8.0.46,InnoDB 引擎,
innodb_page_size=16384,innodb_file_per_table=ON。
一、整体架构:两层,别搞混
结论先给:MySQL = Server 层(通用服务)+ 存储引擎层(真正管数据)。Server 层是所有引擎共用的,存储引擎才是"数据存在哪、怎么取"的地方。
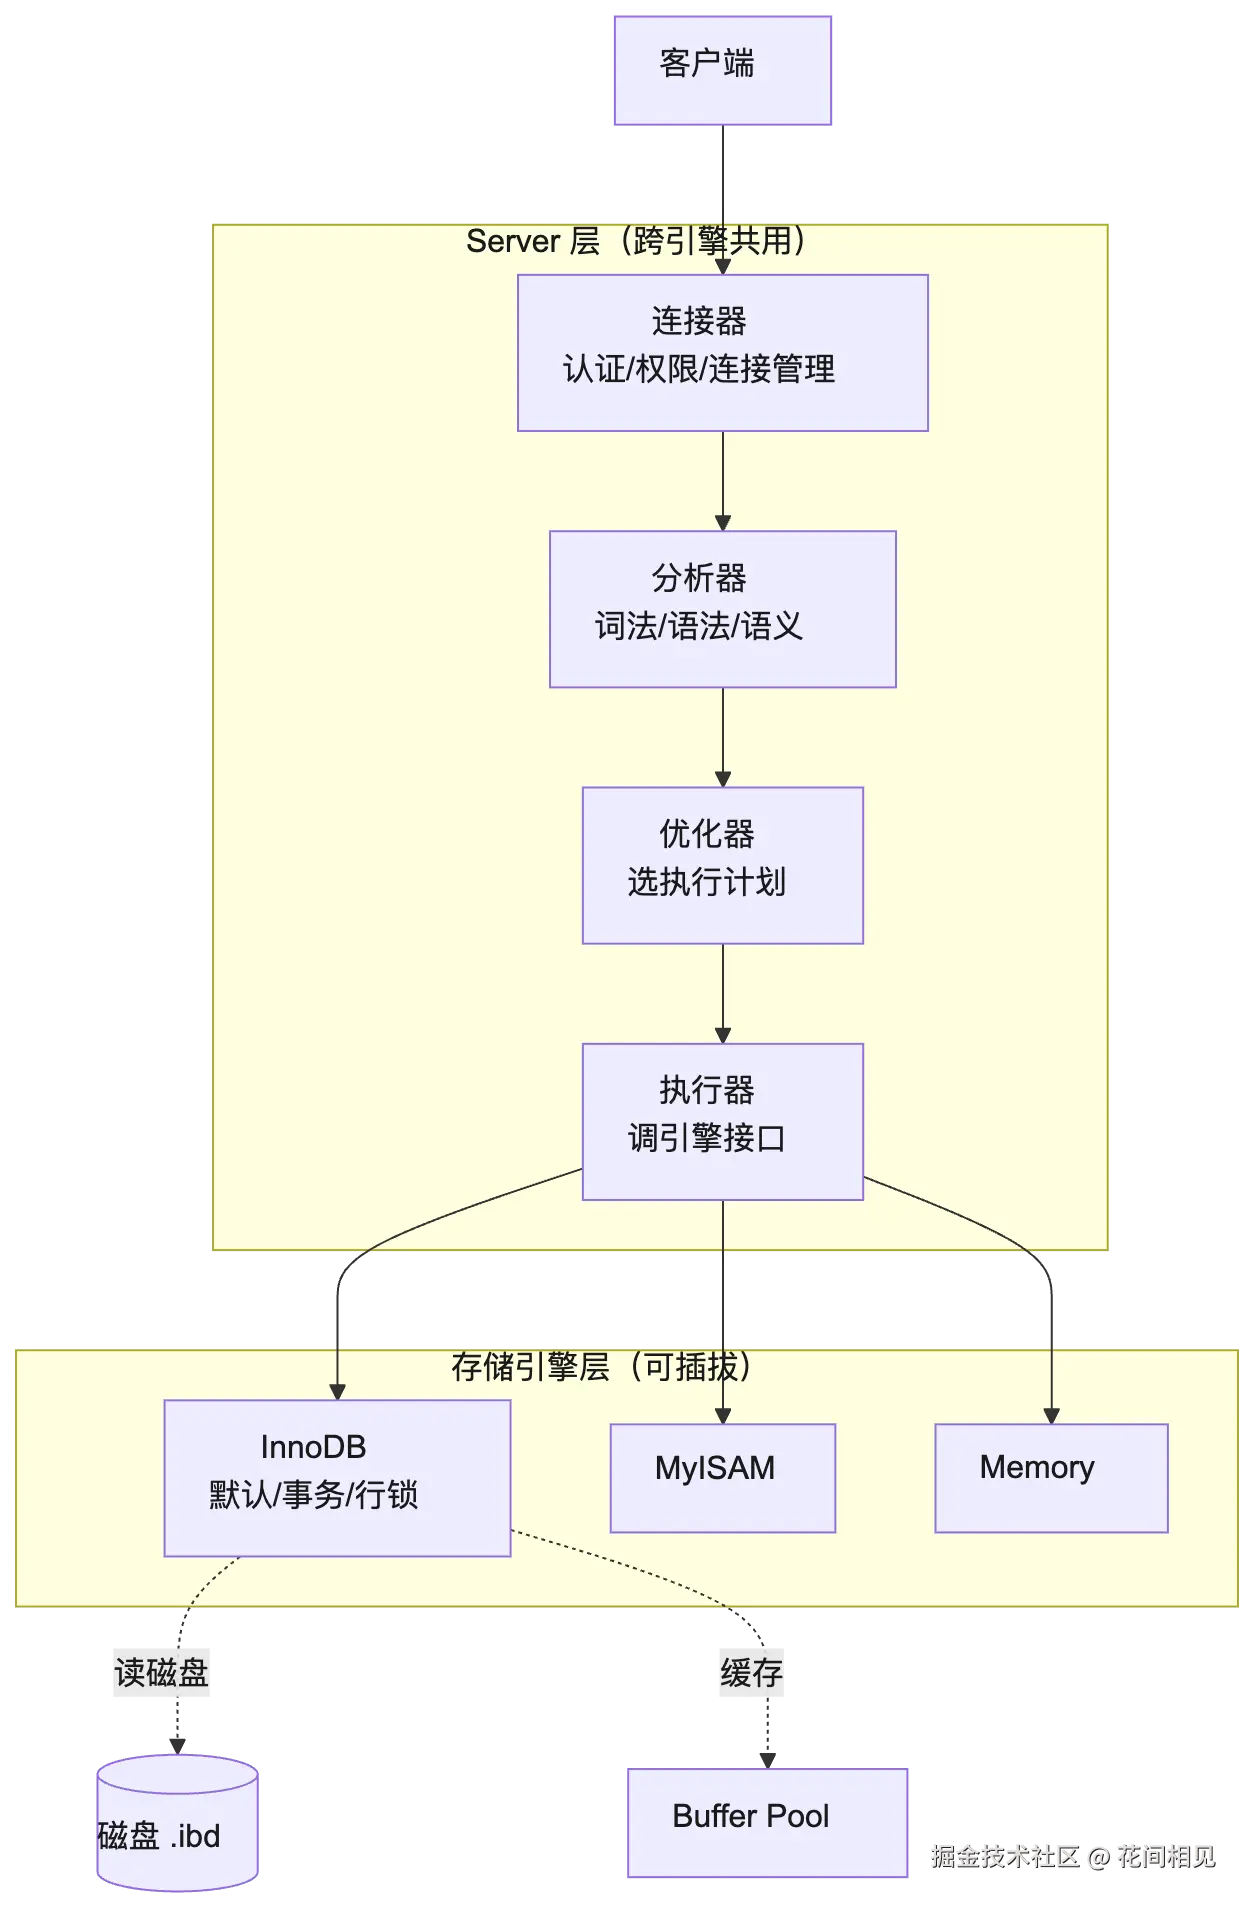
🔴 关键认知:分析器、优化器这些在 Server 层,跟用什么引擎无关;真正"数据页长什么样、锁怎么加、崩溃怎么恢复"全在引擎层。这也是为什么换引擎(比如从 MyISAM 换 InnoDB),你写的 SQL 一行不用改。
二、Server 层五个组件逐个拆
2.1 连接器:先验身份,再谈别的
你连 MySQL,第一件事就是连接器接你:
- 校验账号密码(
user@host二元组,上一篇讲过); - 这个连接占用一个线程,
SHOW PROCESSLIST能看到; - 记住你的权限,后续执行 SQL 时直接读这份缓存(不用每次查系统表)。
sql
SHOW PROCESSLIST;实际输出(本机实例):
sql
Id	User	Host	db	Command	Time	State	Info
5	event_scheduler	localhost	NULL	Daemon	135	Waiting on empty queue	NULL
53	root	localhost	NULL	Query	0	init	SHOW PROCESSLIST
两个连接概念:
| 概念 | 说明 |
|---|---|
| 长连接 | 连上后一直用,直到断开;省握手开销,但 wait_timeout(默认 28800 秒=8 小时)空闲超了会被踢 |
| 短连接 | 用完就断;频繁建连握手开销大,高并发会把连接数打满 |
连接数上限:
sql
SHOW VARIABLES LIKE 'max_connections';
-- max_connections = 151(默认)
超过这个数新连接直接被拒。生产上这个数要调大,配合连接池用。
面试怎么考:
Q:连接过来时,权限校验是在哪一步做的? A:连接器建立连接时校验一次权限并缓存;执行器真正执行前会再校验一次(防止连接期间权限被回收)。两次校验,别只答一次。
2.2 查询缓存:MySQL 8 为什么把它删了
MySQL 5.7 有个查询缓存------把 SELECT 的结果原样存起来,下次一模一样的 SQL 直接返回。听起来很美,但 MySQL 8.0 直接移除了这个功能。验证:
sql
SHOW VARIABLES LIKE 'query_cache%';
-- Empty set (0.00 sec)  → 8.0 里根本没这个变量了
为什么移除?三个致命问题:
- 失效粒度太粗:只要这张表有任何一行更新,这张表相关的所有查询缓存全废。写多的业务命中率极低。
- 锁竞争:读写缓存要加全局锁,高并发下反而成瓶颈。
- SQL 必须字字相同才算命中(大小写、空格、注释都敏感)。
⚠️ 所以从 MySQL 8 开始,别再想"靠查询缓存加速",要加速靠索引、靠 Buffer Pool。
2.3 分析器:识别你写的是什么
SQL 进来,分析器干三件事:
- 词法分析 :把字符串拆成 token,识别出
SELECT、user、WHERE这些关键字和标识符; - 语法分析:按 SQL 语法规则拼成语法树;
- 语义分析:检查表存不存在、列存不存在、你有没有权限。
⚠️ 你写的 SQL 语法错了,在这一步就报 ------比如把 SELCT * FROM user 敲错,分析器直接 You have an error in your SQL syntax,根本走不到优化器。
2.4 优化器:决定怎么执行
同一条 SQL 往往有无数种执行方式:用哪个索引、表连接顺序、用什么关联算法。优化器基于代价模型(CPU 代价 + IO 代价)选它认为最便宜的一条。
sql
EXPLAIN SELECT * FROM user WHERE id=1;
sql
id	select_type	table	type	possible_keys	key	rows	Extra
1 SIMPLE user const PRIMARY PRIMARY 1 NULLtype=const、key=PRIMARY 就是优化器选了主键索引。再看没索引的:
sql
EXPLAIN SELECT * FROM user WHERE name='张三';
sql
id	select_type	table	type	possible_keys	key	rows	Extra
1	SIMPLE	user	ALL	NULL	NULL	3	Using where
type=ALL 就是全表扫描------优化器发现 name 上没索引,只能一行行扫。下篇索引篇会让 EXPLAIN 成为你的看家工具。
2.5 执行器:真正干活
优化器给了执行计划,执行器按计划调用存储引擎的接口一行行取数据。执行前还会再做一次权限检查(前面连接器那次是缓存的,这里实时核对)。
三、存储引擎:InnoDB 为什么是默认
MySQL 用插件式存储引擎,SHOW ENGINES 列全:
sql
SHOW ENGINES;
objectivec
Engine	Support	Comment	Transactions
InnoDB	DEFAULT	Supports transactions, row-level locking, and foreign keys	YES
MEMORY	YES	Hash based, stored in memory	NO
MyISAM	YES	MyISAM storage engine	NO
CSV	YES	CSV storage engine	NO
...
重点三个:
| 引擎 | 事务 | 锁粒度 | 崩溃恢复 | 外键 | 地位 |
|---|---|---|---|---|---|
| InnoDB | ✅ | 行锁 | ✅ | ✅ | 默认,OLTP 业务都用它 |
| MyISAM | ❌ | 表锁 | ❌ | ❌ | 老古董,只读日志/归档才用 |
| Memory | ❌ | 表锁 | ❌(重启丢数据) | ❌ | 临时表、缓存表 |
建表时指定引擎:
sql
CREATE TABLE t (...) ENGINE=InnoDB;⚠️ MySQL 8 已经把系统表从 MyISAM 换成 InnoDB 了,MyISAM 基本退出历史舞台。面试问"为什么 InnoDB 是默认",答三点:支持事务、行锁并发高、崩溃能自动恢复。
四、一条 SELECT 的旅程
把前面串起来,一次 SELECT * FROM user WHERE id=1 走过的路:
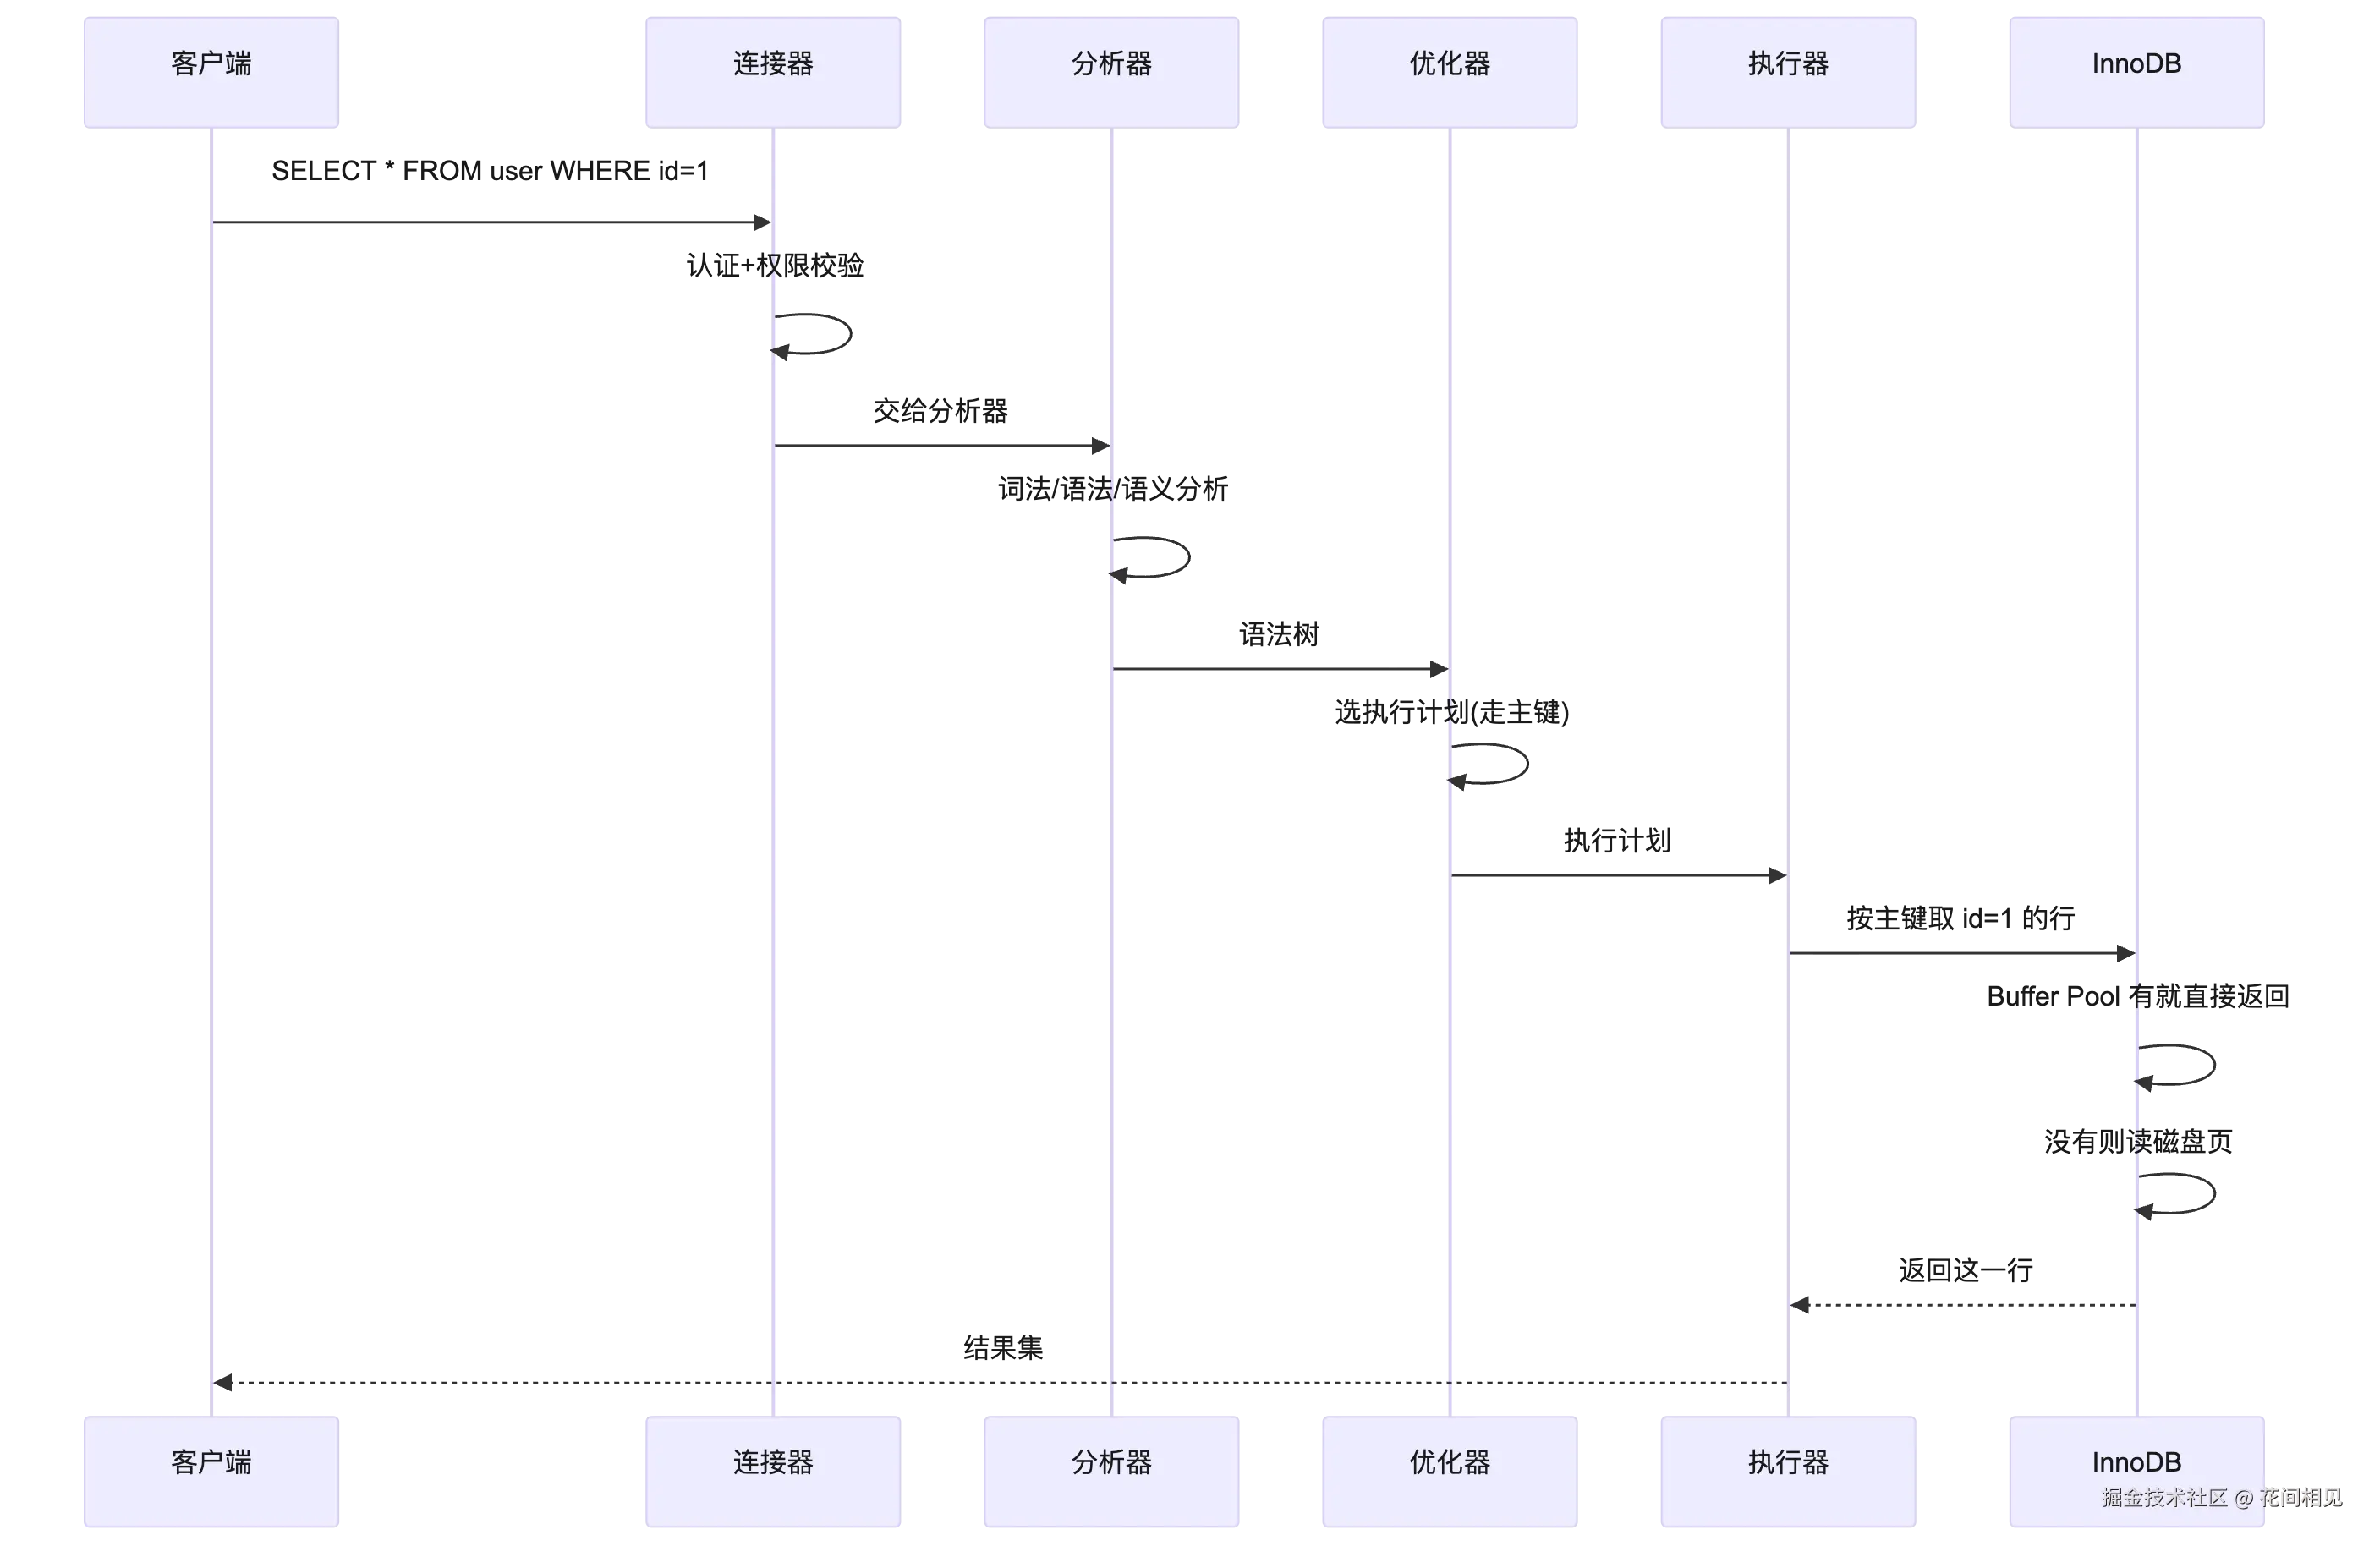
没什么花活:连接器接活、分析器读懂、优化器选路、执行器调引擎、InnoDB 从内存或磁盘把行捞出来。
五、一条 UPDATE 的旅程(重点)
UPDATE 比 SELECT 复杂得多------因为改了数据必须保证崩溃不丢 。MySQL 用 WAL(Write-Ahead Logging,预写日志)解决:先写日志,再写磁盘数据页。
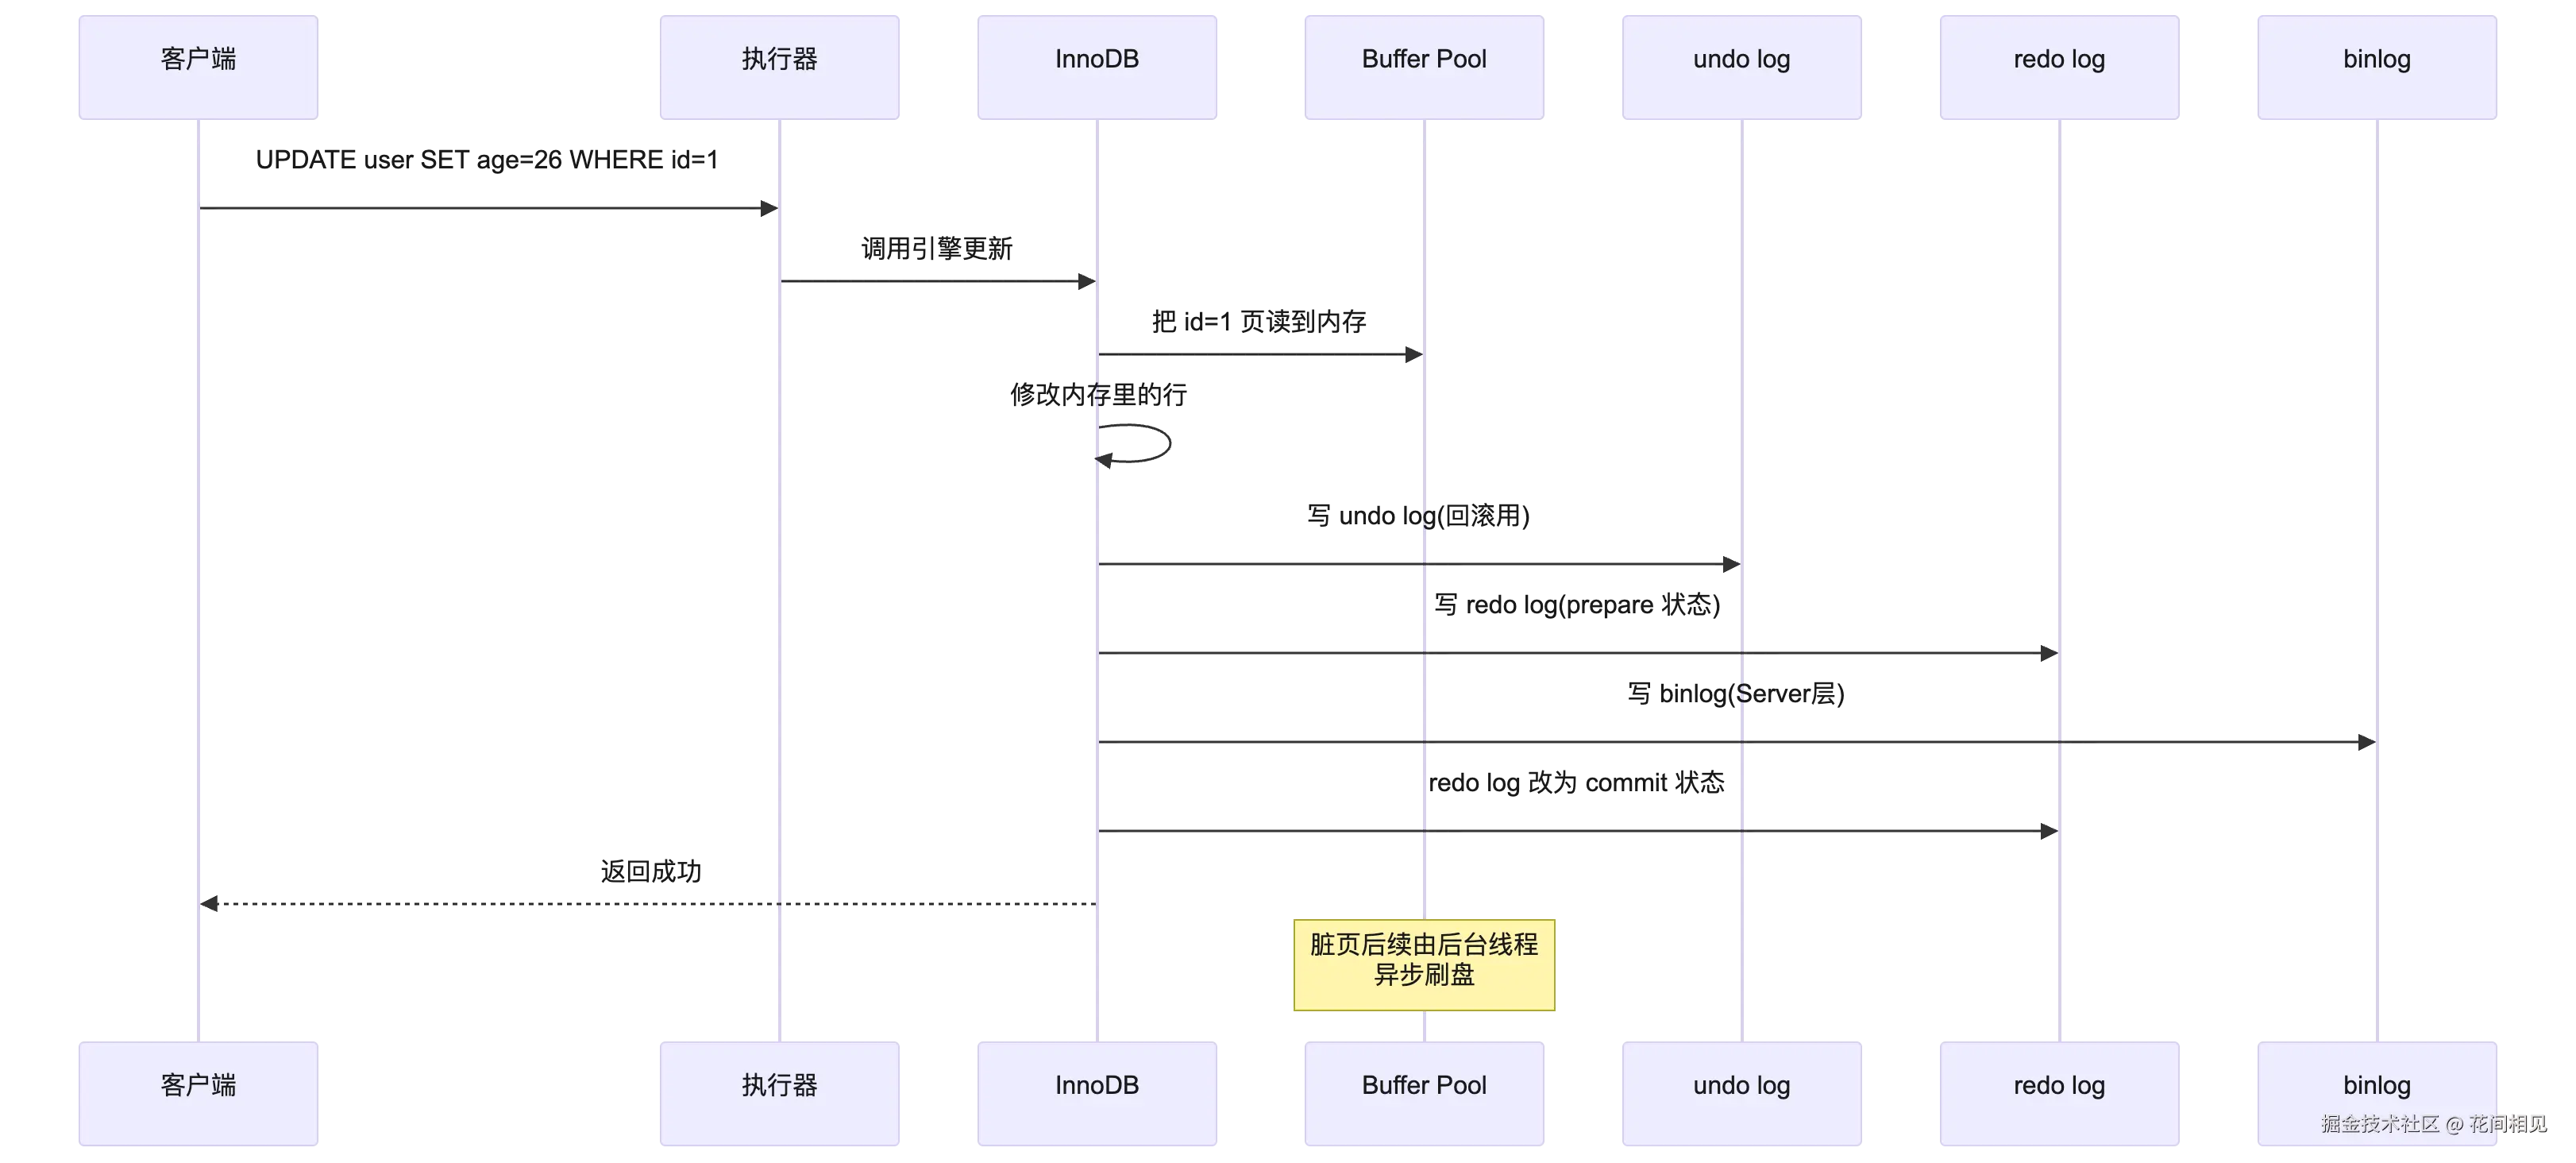
🔴 WAL 的核心:更新只改内存 Buffer Pool,立刻记 redo log 落盘就返回成功。真正把数据页刷到磁盘是后台异步做的。这样即使机器突然断电,重启后拿着 redo log 重放就能恢复------因为日志已经持久化了。
两个日志要分清(后面事务篇会深挖):
| 日志 | 谁的层 | 作用 |
|---|---|---|
| redo log | InnoDB | 崩溃恢复,保证持久性(数据不丢) |
| binlog | Server 层 | 主从复制、数据恢复,记录所有变更 |
| undo log | InnoDB | 事务回滚、MVCC 快照 |
六、Buffer Pool:为什么查第二次快
InnoDB 不是每次都读磁盘------它在内存里开了一块 Buffer Pool,把磁盘页缓存住。查过的页留在内存,下次直接命中。看一眼本机状态:
sql
SHOW ENGINE INNODB STATUS\G截取关键段:
yaml
BUFFER POOL AND MEMORY
Buffer pool size   8192
Free buffers       5725
Database pages     2453
Buffer pool hit rate 1000 / 1000
hit rate 1000/1000 就是命中率 100%(热数据都在内存)。这部分很重要,后续专门一篇讲 Buffer Pool 和 Change Buffer。
七、常用排查命令速查
| 命令 | 看什么 |
|---|---|
SHOW PROCESSLIST |
当前有哪些连接、在跑什么 SQL |
SHOW ENGINE INNODB STATUS\G |
InnoDB 内部状态(事务/锁/Buffer Pool/日志) |
SHOW VARIABLES LIKE 'xxx%' |
配置参数 |
SHOW STATUS LIKE 'xxx%' |
运行时统计 |
information_schema 库 |
元数据(表结构、索引、锁) |
配置文件在 my.cnf 的 [mysqld] 段,运行时改:
sql
SET GLOBAL max_connections = 300;   -- 全局生效,重启失效
SET SESSION wait_timeout = 600;     -- 只影响当前连接
八、面试怎么考(本篇高频)
Q1:MySQL 逻辑架构分层? 两层:Server 层(连接器/分析器/优化器/执行器,跨引擎共用)+ 存储引擎层(InnoDB/MyISAM 等,可插拔)。
Q2:一条 SELECT 执行流程? 连接器认证 → 分析器解析 SQL → 优化器选执行计划 → 执行器调引擎取数据 → InnoDB 从 Buffer Pool 或磁盘读 → 返回。
Q3:查询缓存为什么 MySQL 8 移除? 表一更新该表所有缓存全失效,命中率低;缓存读写有全局锁竞争;SQL 必须字字相同才命中。弊大于利。
Q4:InnoDB 为什么是默认引擎? 支持事务(ACID)、行锁并发好、崩溃自动恢复(redo log)、支持外键。MyISAM 表锁、不支持事务、崩溃易丢数据。
Q5:一条 UPDATE 为什么快?WAL 是什么? 先改内存 Buffer Pool,写 redo log 落盘就返回,数据页异步刷盘(WAL 预写日志)。靠 redo log 保证断电不丢数据。
总结:你真正需要记住的 7 件事
- MySQL = Server 层(连接器/分析器/优化器/执行器)+ 存储引擎层(InnoDB 为主),引擎可插拔。
- 连接器管认证和连接,权限先在连接时缓存一份、执行时再核对一次。
- 查询缓存 MySQL 8 已删除------别再指望它,加速靠索引和 Buffer Pool。
- 分析器报错(语法/表列不存在)走不到优化器;优化器选执行计划,用 EXPLAIN 看。
- InnoDB 默认:事务、行锁、崩溃恢复;MyISAM 已淘汰。
- UPDATE 走 WAL:先改内存 + 写 redo log,数据页异步刷盘,断电靠 redo 恢复。
- 三条日志分工:redo 崩溃恢复、binlog 主从复制、undo 回滚与 MVCC。
验证清单
- 能默画 MySQL 架构图,标出 Server 层四个组件和引擎层
- 跑
SHOW ENGINES,说出 InnoDB 和 MyISAM 的三点区别 - 跑
SHOW PROCESSLIST,认出当前连接的 Id/Command/State - 解释为什么 MySQL 8 没有 query_cache_type 变量
- 用自己的话讲清 WAL:为什么 UPDATE 不立刻刷盘也不怕丢数据
- 区分 redo log、binlog、undo log 各自属于哪层、干什么
- 说出 Buffer Pool 的作用,并能在 InnoDB STATUS 里找到命中率
参考资源
- MySQL 8 架构 dev.mysql.com/doc/refman/...
- 存储引擎对比 dev.mysql.com/doc/refman/...
- InnoDB 缓冲池 dev.mysql.com/doc/refman/...
- EXPLAIN 输出 dev.mysql.com/doc/refman/...
- redo log / WAL dev.mysql.com/doc/refman/...
下一篇《一行数据在磁盘上怎么存》:知道了一条 SQL 走过哪些模块,这篇往下钻一层------InnoDB 把一行数据最终落到磁盘的哪个文件?为什么默认页大小是 16KB?数据页内部长什么样,怎么在一页里二分查找?页分裂又是怎么回事?我们把"表空间→段→区→页→行"这条存储层级画到底。