生图灵感库是我做的一个 GPT Image 提示词网站,积累了 9,000 多张样张。起步的时候追求快------静态 HTML 加 JSON 数据,图片和代码放一起推 GitHub,Cloudflare 自动部署,整条链路很短。
这套方式在素材少的时候没问题。图片越来越多之后,仓库越来越重,每次拉代码都要带上整个图片库。某天推了一版新内容,网站却没更新,翻部署日志才发现:静态资源数量超过了平台上限。
这篇文章记录的就是这次架构升级------把图片搬进 Cloudflare R2、解除构建对整库图片的依赖、把统计历史从 Git 提交记录中拆出来、最后给膨胀的仓库减重。全程借助 GPT-6.1(Sol模型 推理强度低)辅助编写迁移脚本、排查问题和验收,大约半天时间完成。过程中有顺利的验收,也有分支切换时图片险些丢失的教训。写下来,给同样从小项目开始、正在遇到增长烦恼的人一些参考。
生图灵感库,一个拥有 9K+ 样张的 GPT Image 提示词网站
生图灵感库现在有 5,513 组素材、9,263 张图片(一组素材可能有多张样张)。用法很直接:按风格、主题或标签筛选,看到喜欢的成图就打开详情,复制提示词到自己的生图工具里试。比起面对空白输入框发呆,先看到效果图、再理解文字怎样描述画面,起步容易得多。
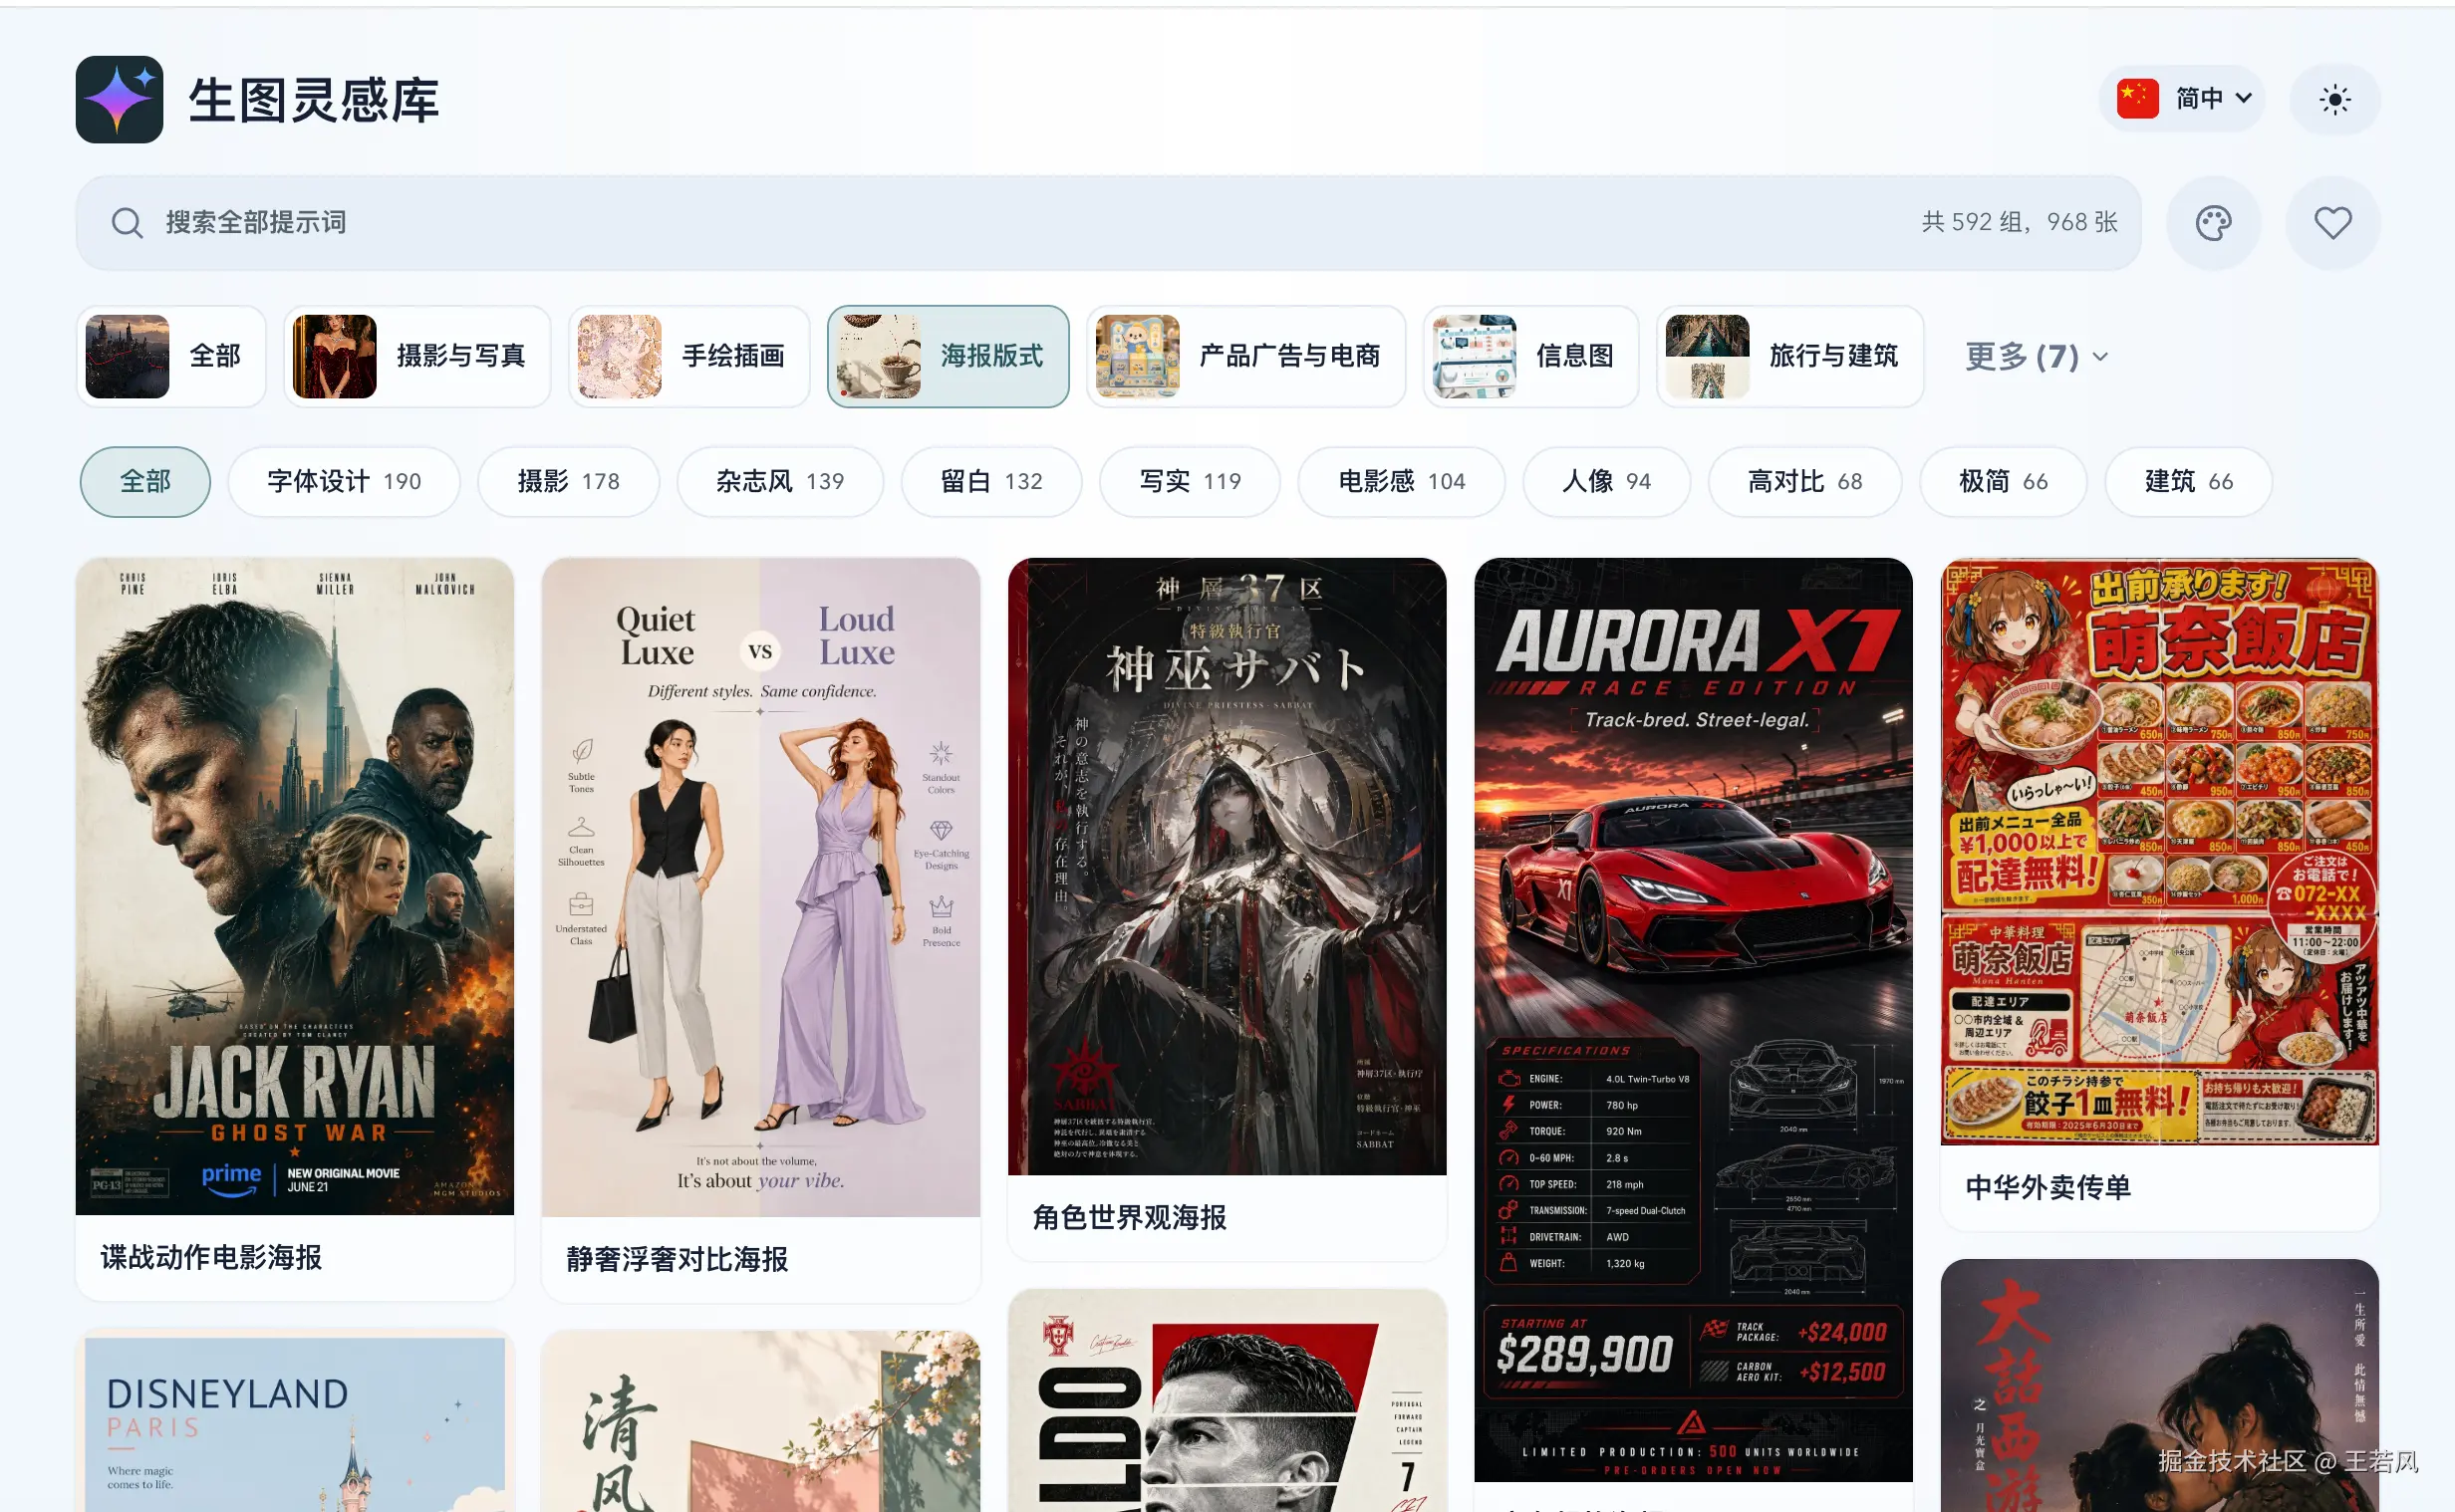
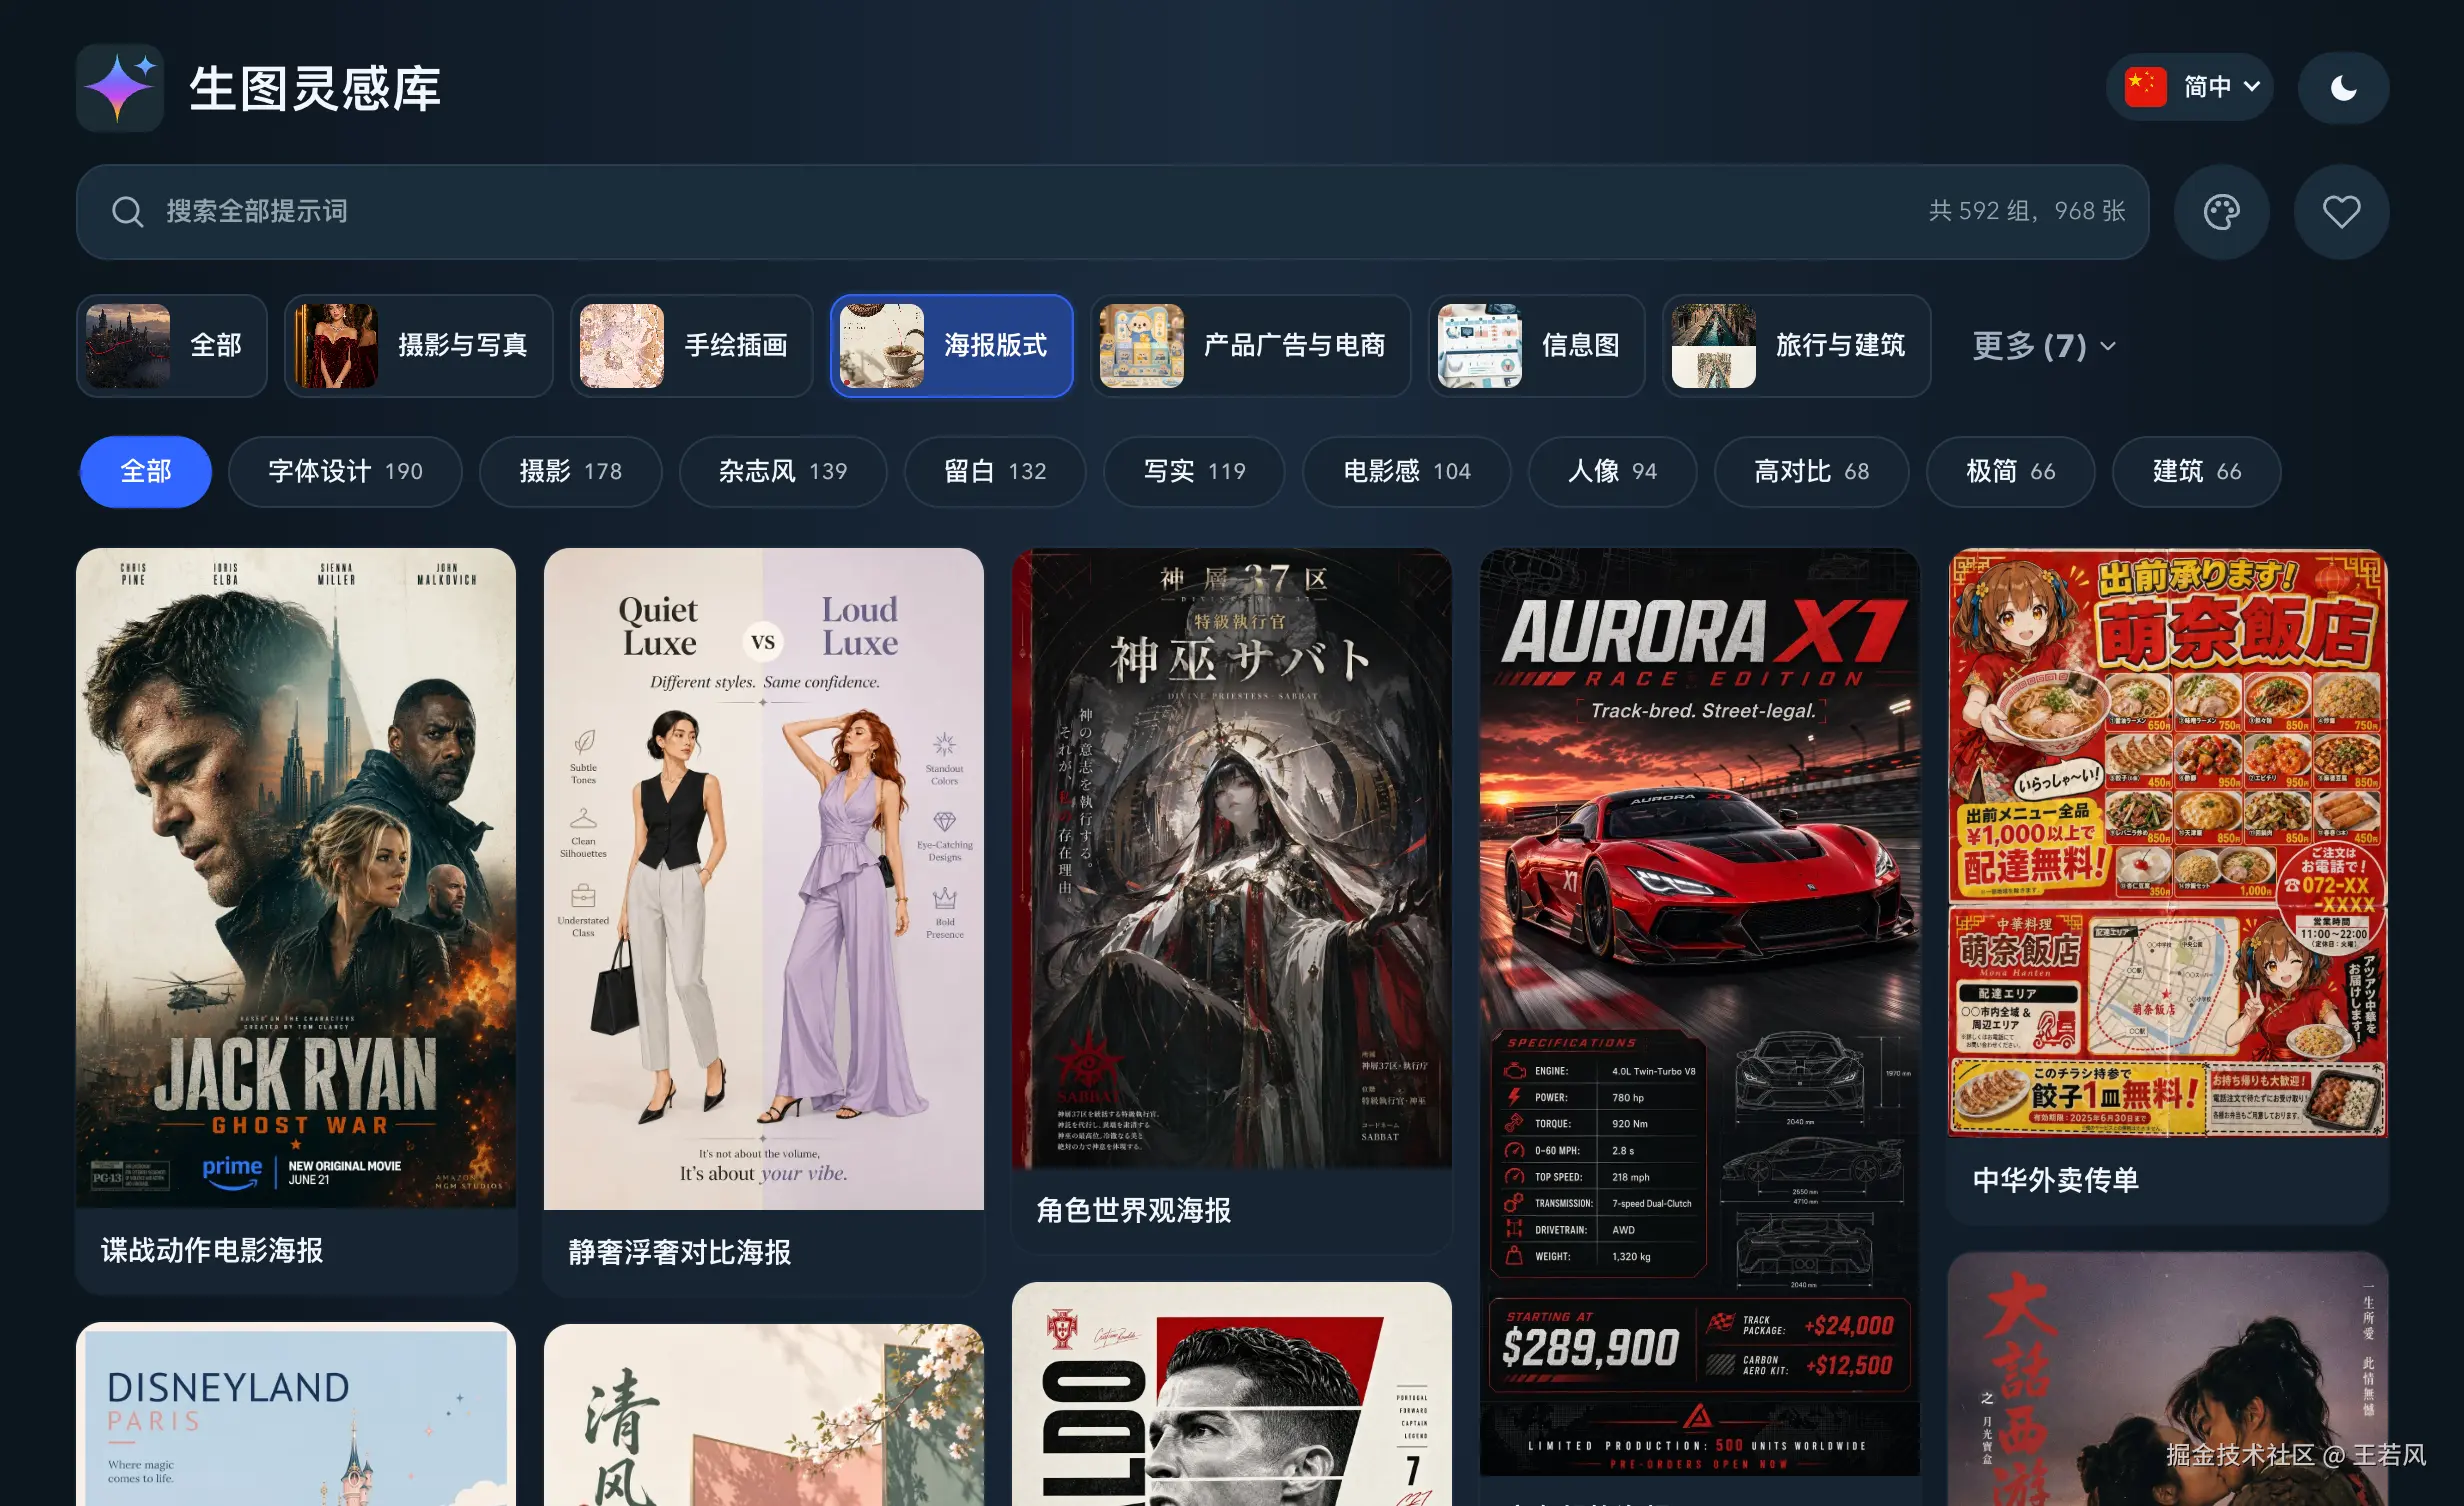
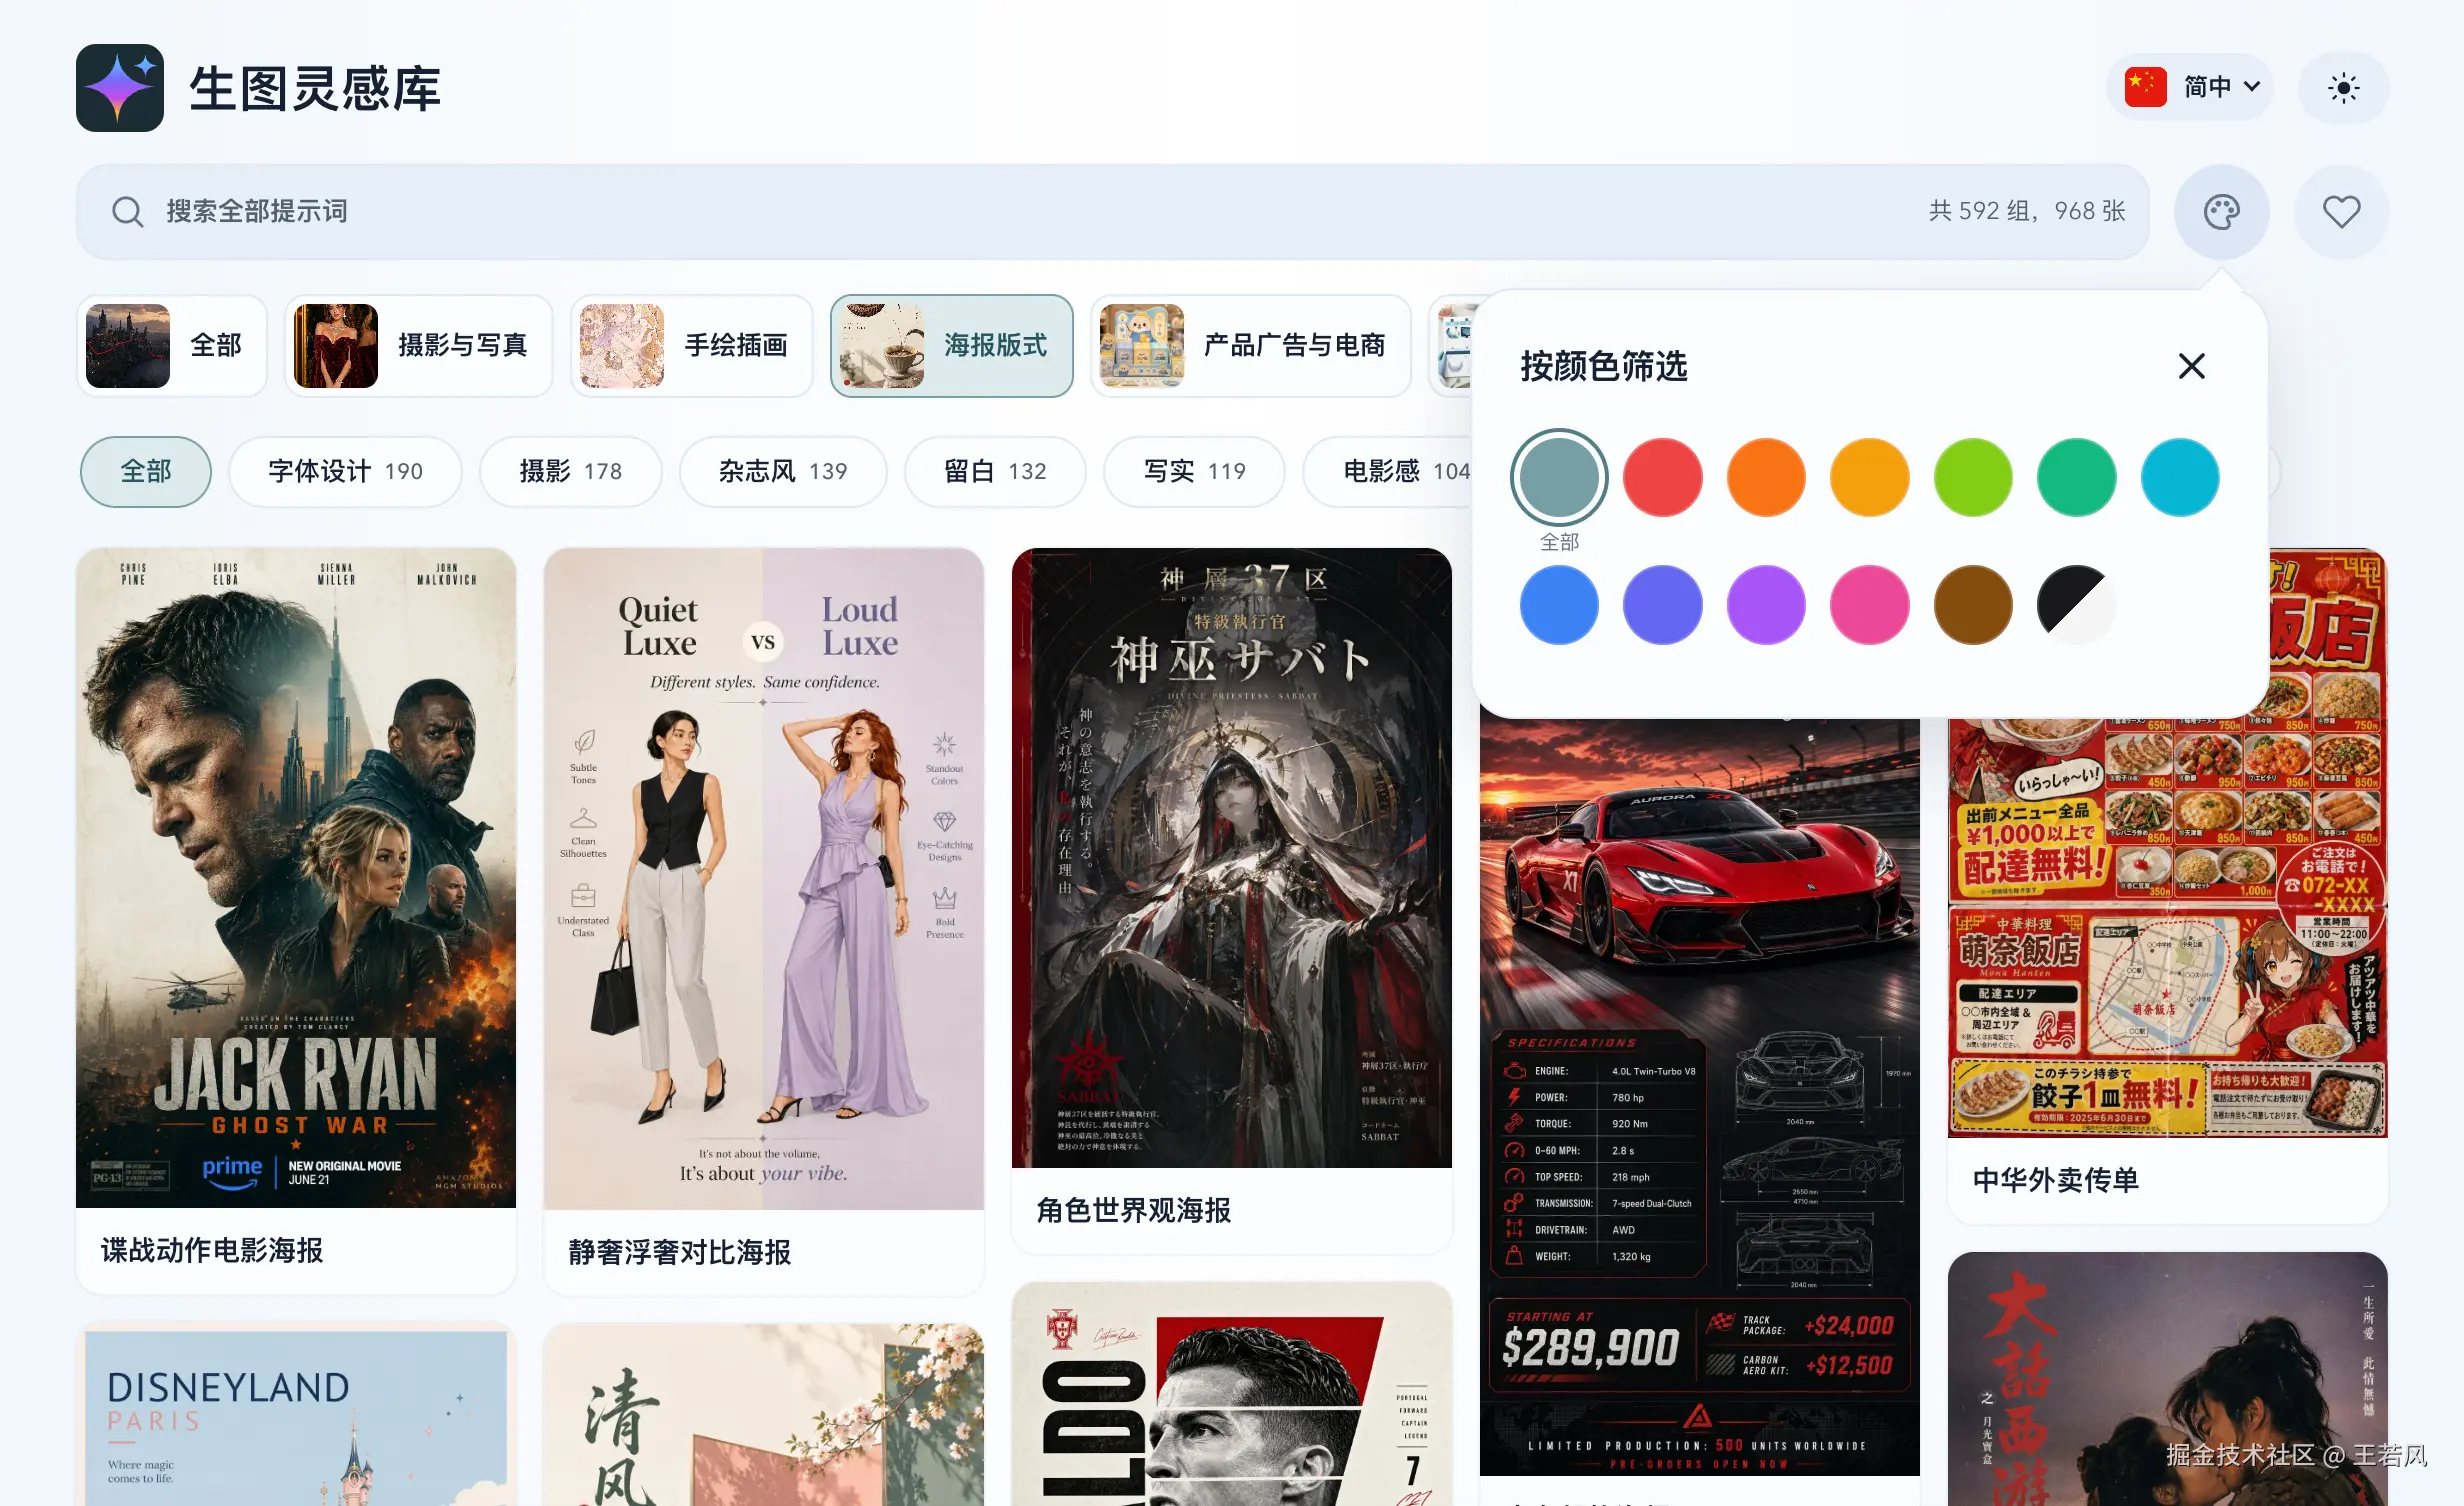
下面是浅色和深色模式的截图。选的是「海报版式」分类,右上角 777 组、920 张是这个分类的统计,不是全站总量。
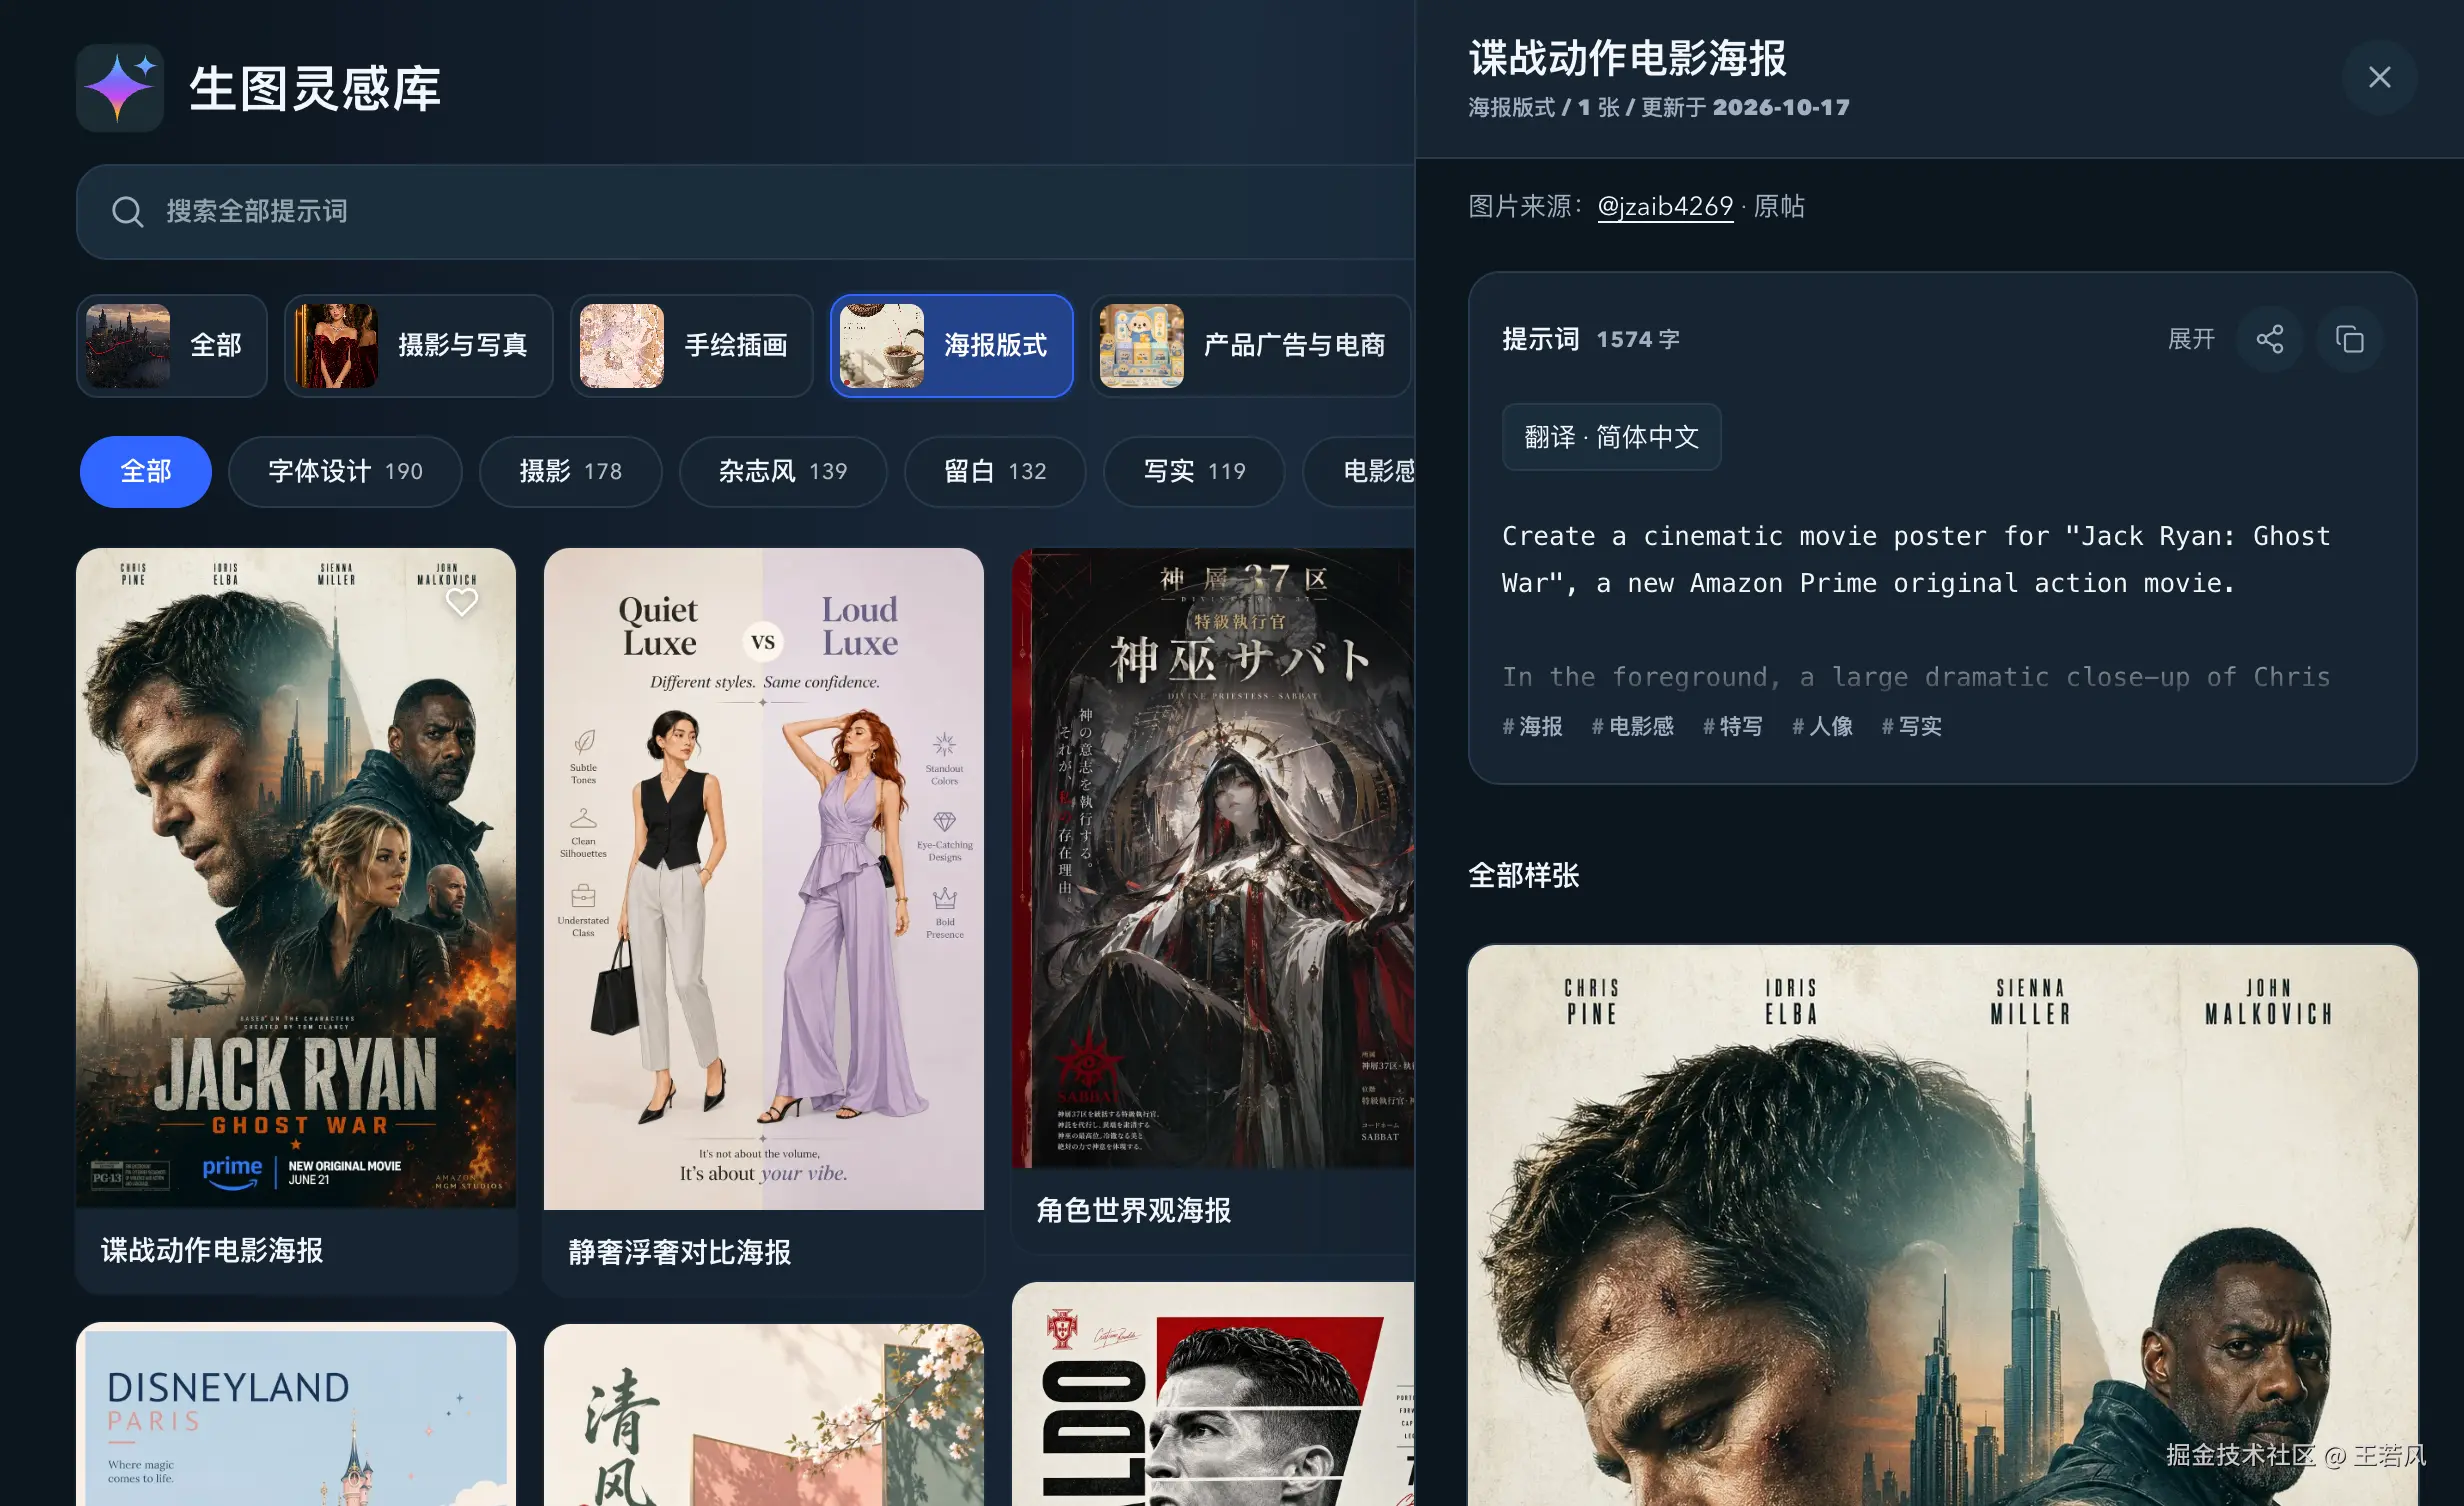
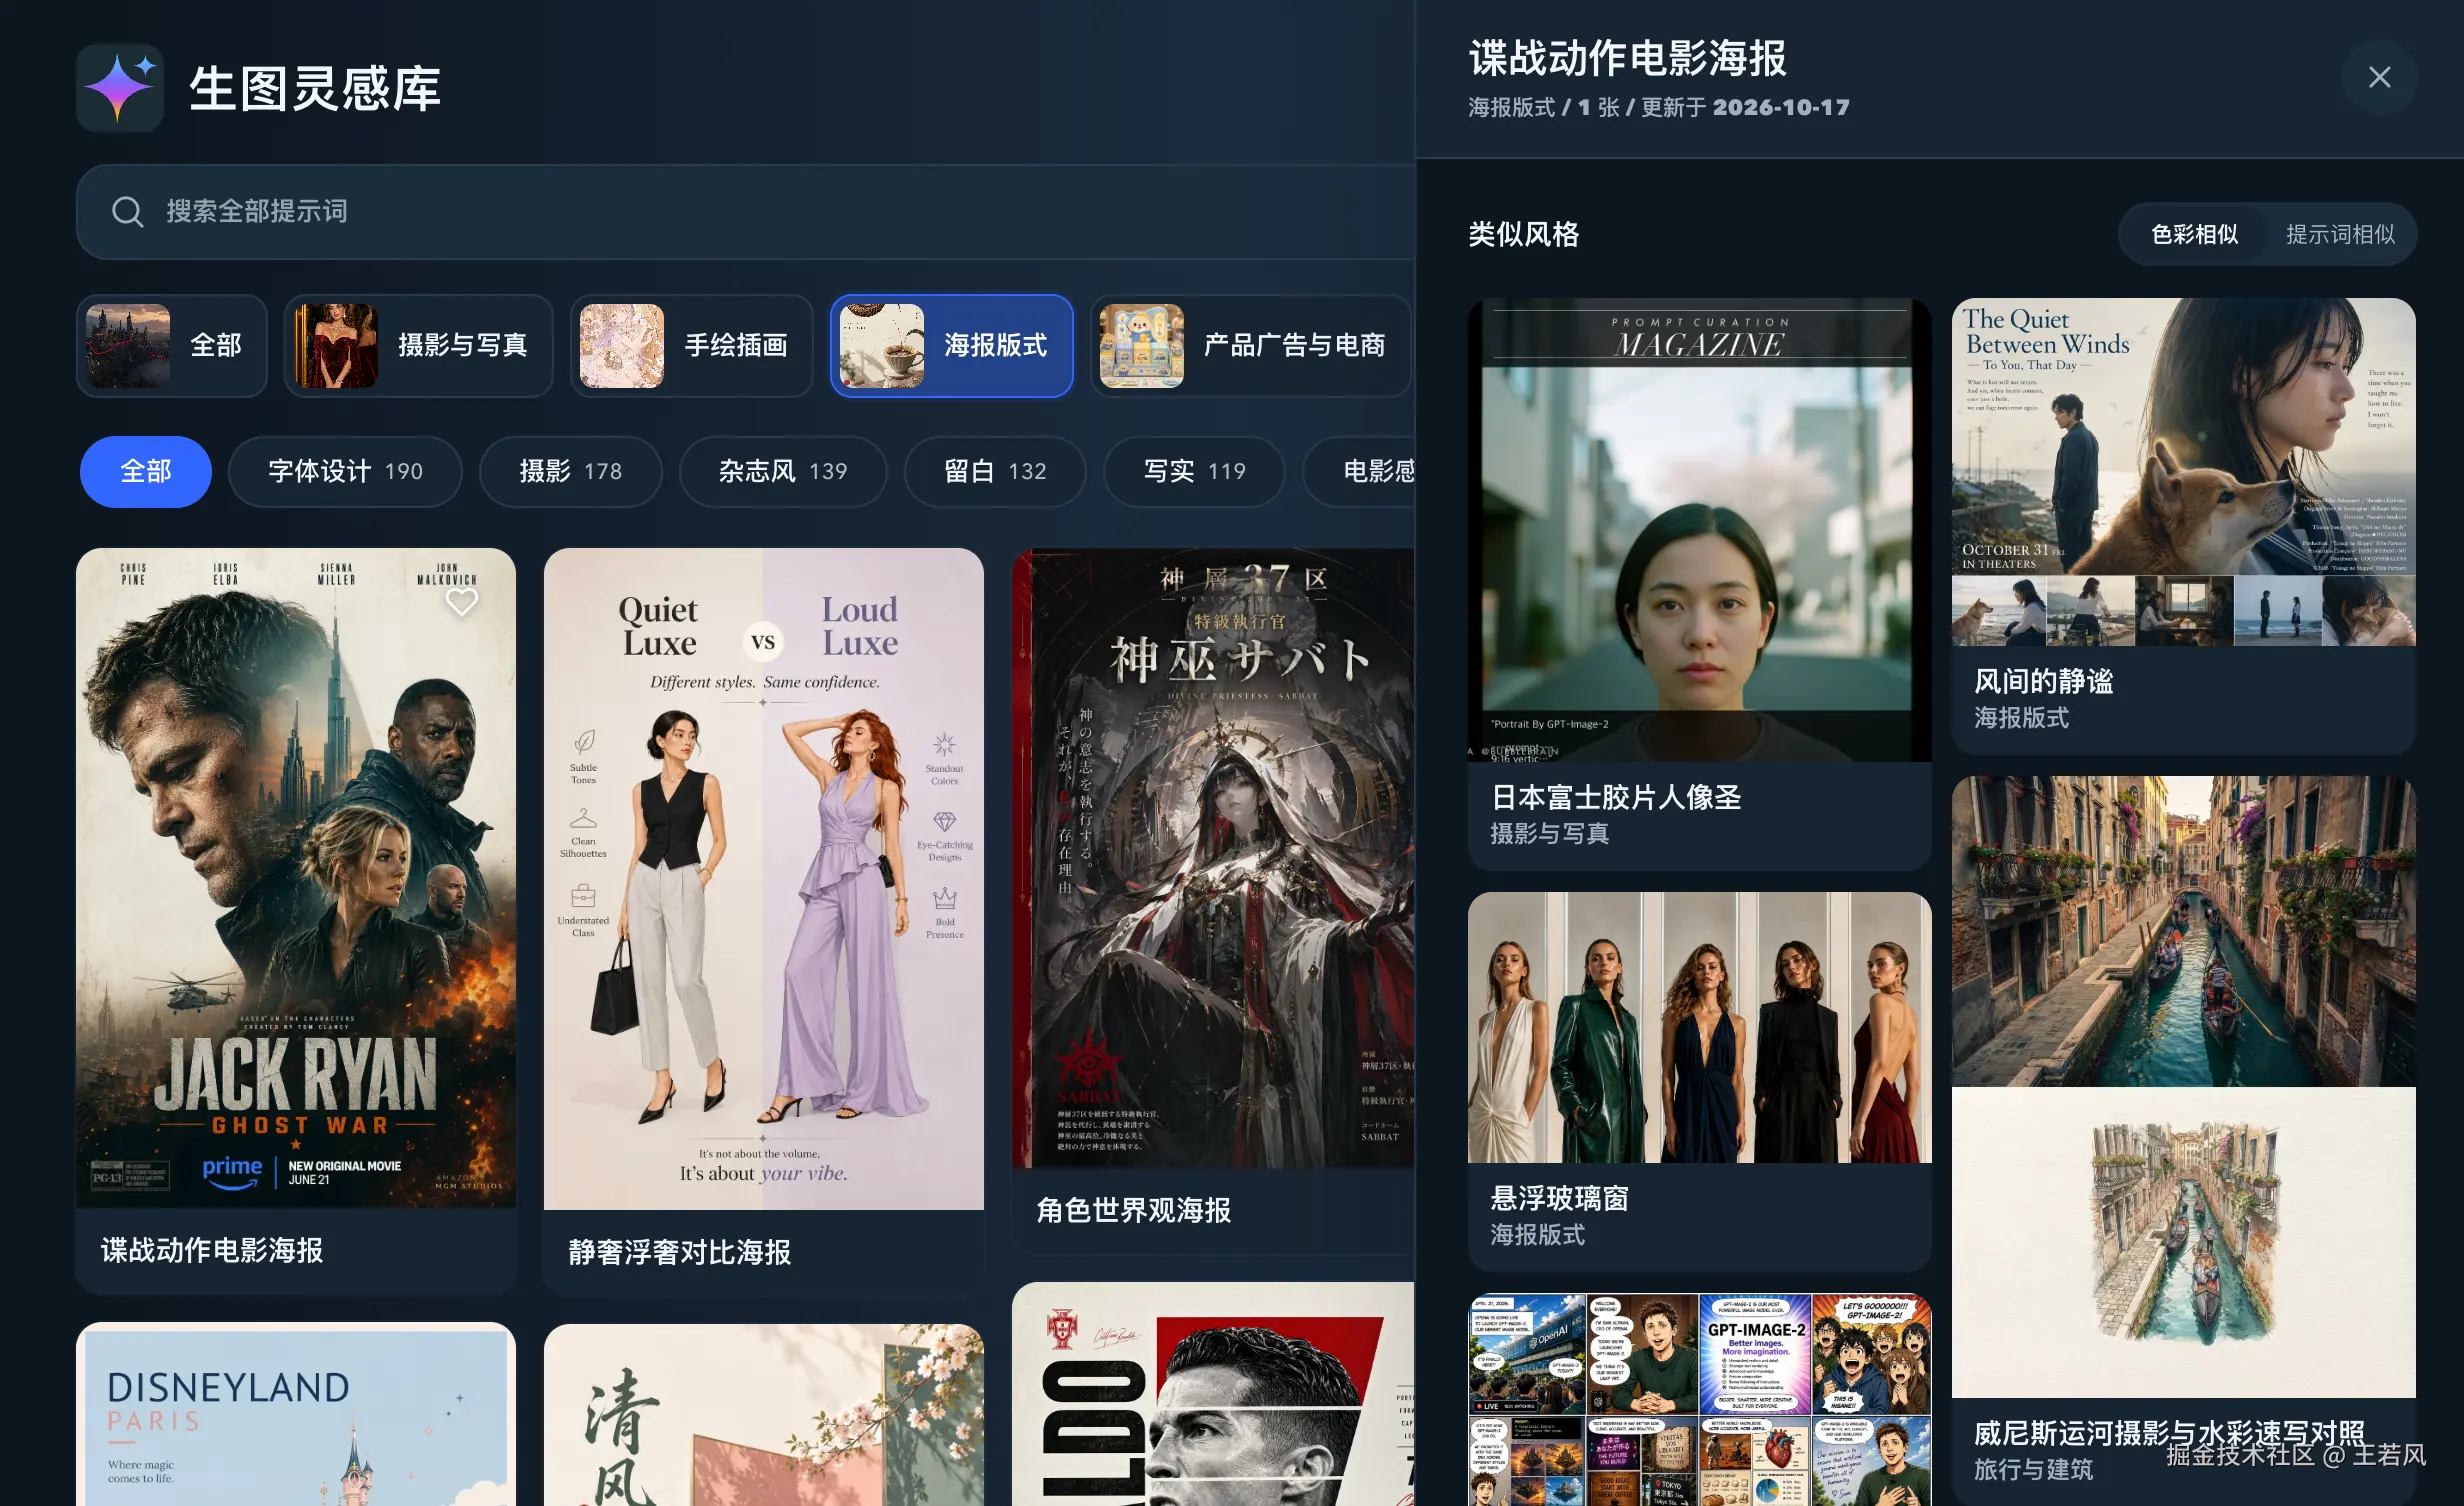
点开卡片,侧边面板会显示来源、提示词全文和对应样张,可以一键复制或翻译。往下翻还有按色彩或提示词相似度推荐的其他风格。
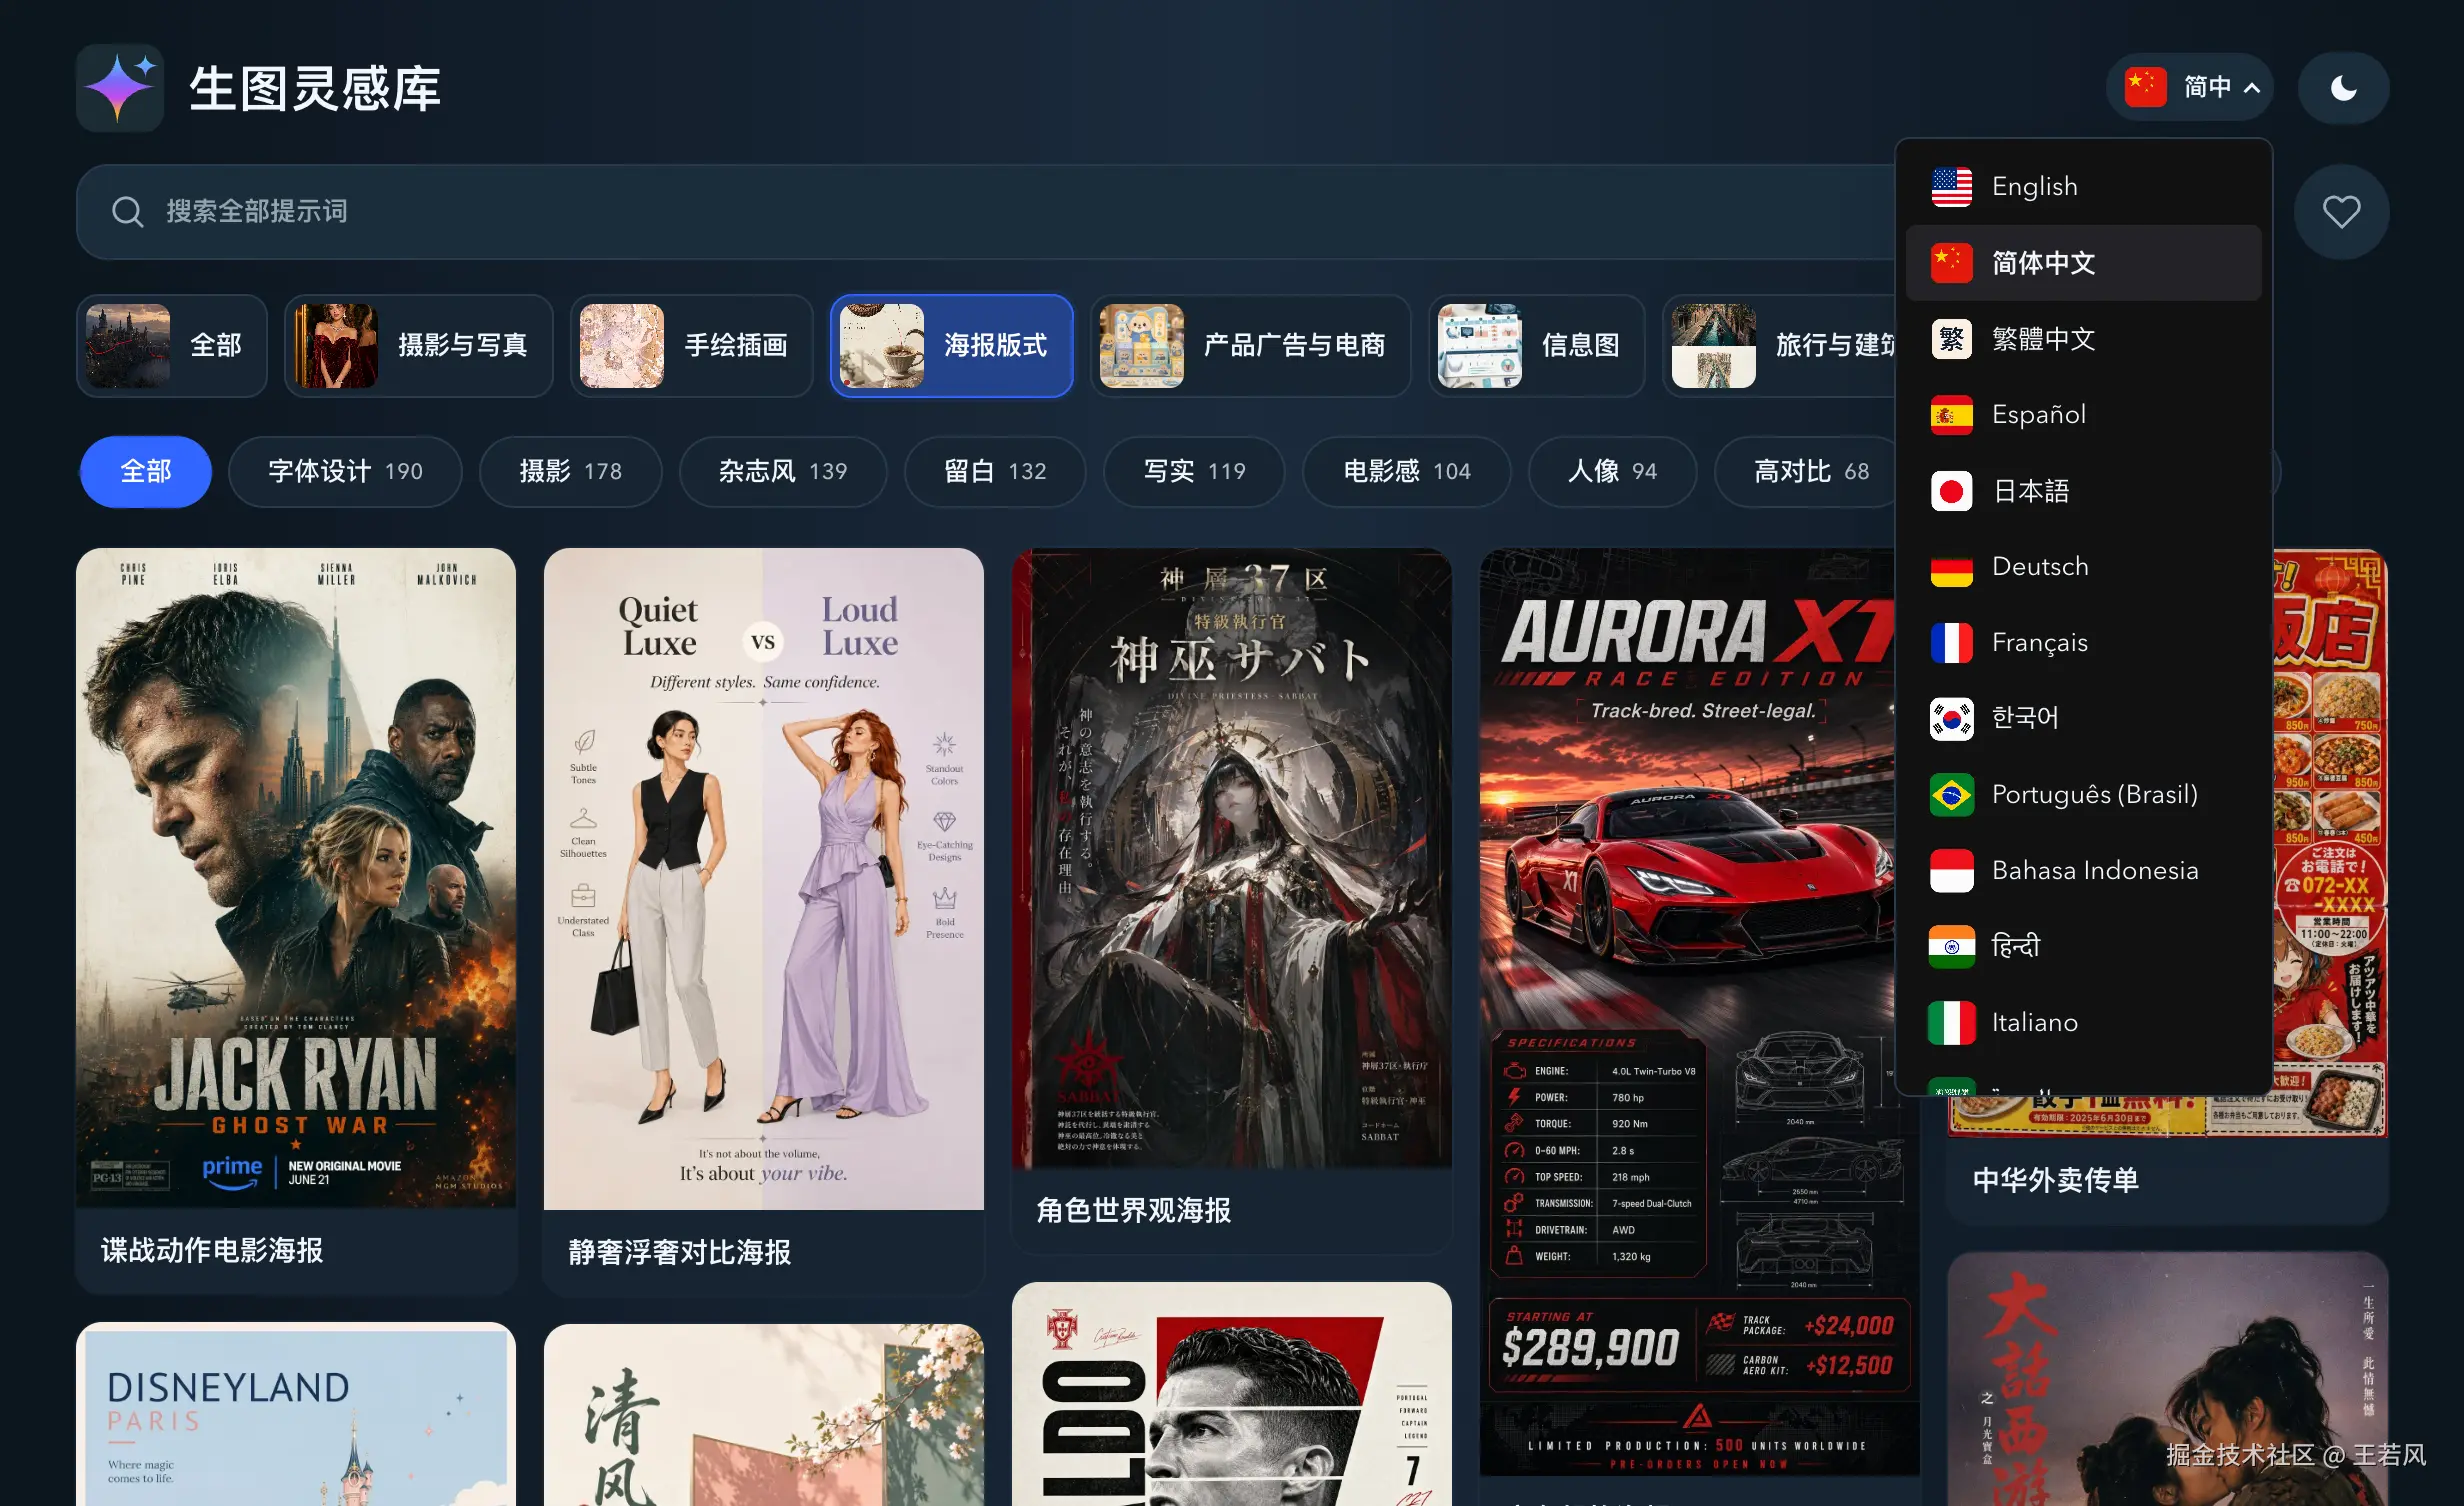
还有多语言切换和颜色筛选------如果心里已经有目标配色,可以直接从颜色入手找样张。
日常使用直接访问网站就好。下面进入正题:支撑这个网站的存储、构建与发布架构升级。
快速上线的方案,撞上了持续运营的墙
最初把图片和代码放在一起,好处很实际:一次提交就能保存页面、提示词和样张的对应关系,发布时不用协调多个存储位置。
代价是随着内容增长慢慢显现的。新图片要进 Git,旧版本的图片继续留在历史里;换台电脑开发,得先拉取越来越大的仓库;部署工具也要处理大量本来可以独立分发的图片。
真正推动改造的,是一次部署失败。
起初我怀疑 GitHub 没触发自动部署。查构建记录才发现,触发正常,失败在资产上传阶段------日志显示待部署资源 20,379 个,超过了 Workers Free 的 20,000 文件上限,报错 10304。
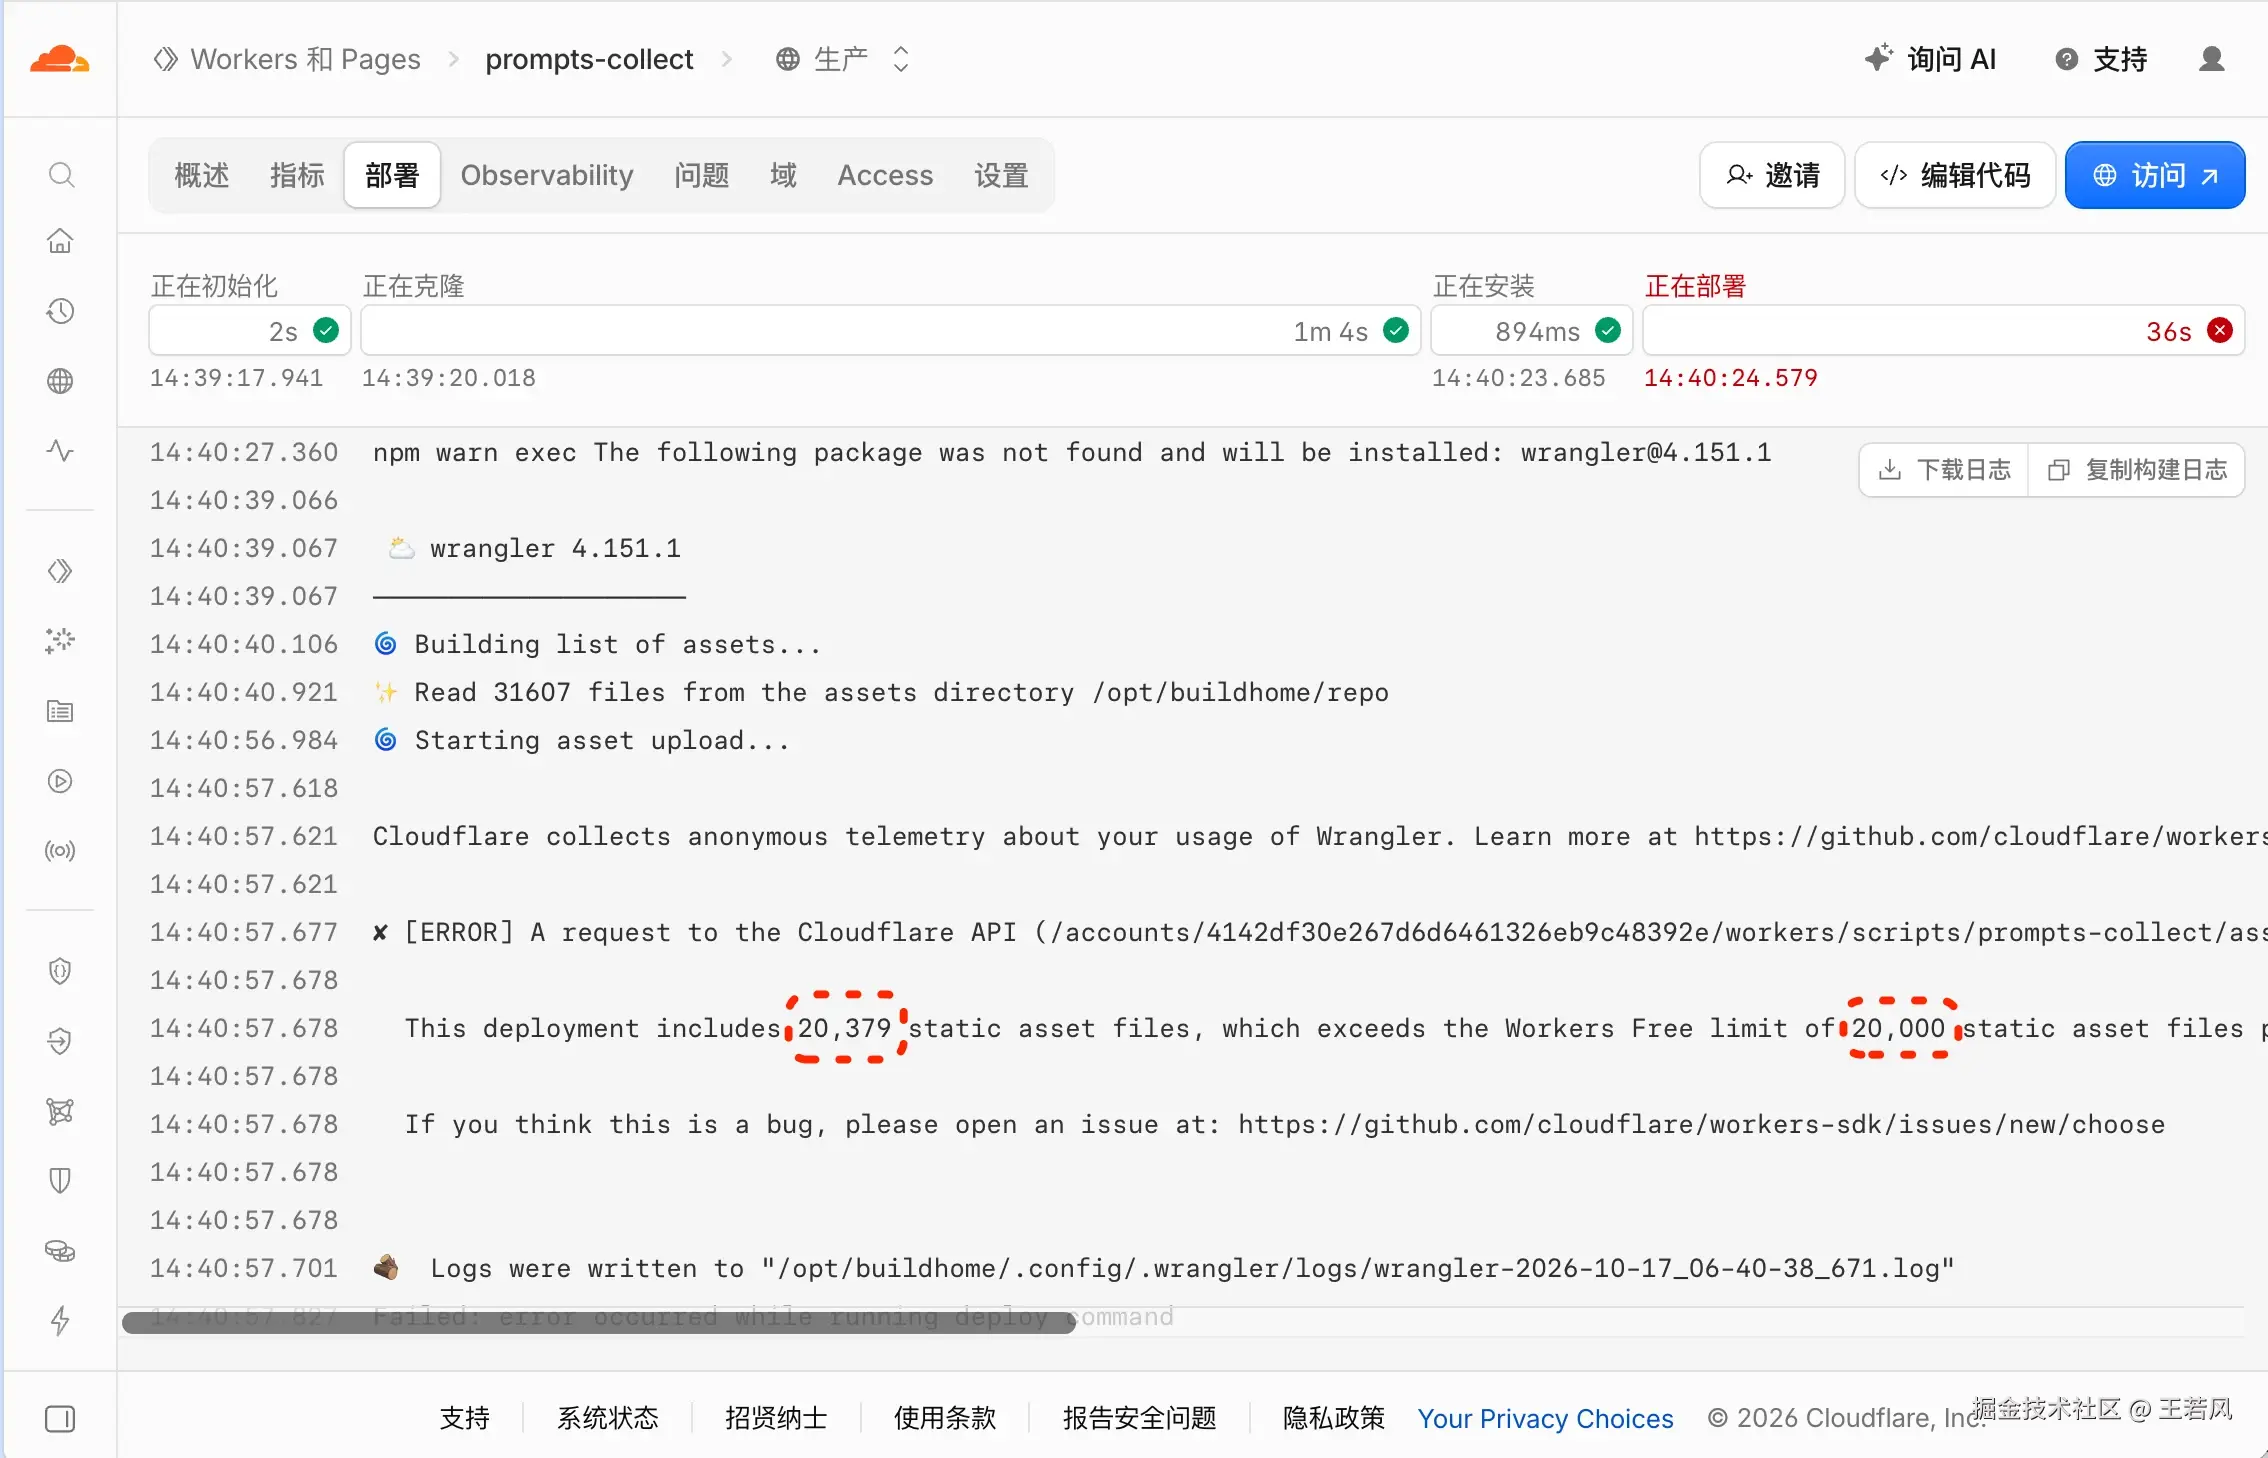
这个限制针对的是单个部署版本的资产数量,跟每月部署次数无关。Cloudflare 官方限制文档会随产品调整,实际使用时要核对当前计划。
付费提高上限能解决这次的问题,但图片还会继续进 Git,换设备和维护历史的成本只会越来越高。需要从根上重新安排这些文件的归属。
我的目标是保留静态站的简单结构,让图片增长不再拖着代码仓库一起膨胀,同时继续支持本地开发、素材去重、推荐构建和历史统计。这几条要求框定了迁移范围。
Cloudflare R2 架构升级,拆分代码与图片存储
这次没有重写网站,也没有引入数据库。页面、交互脚本和结构化内容继续走 GitHub 与 Workers Static Assets,样张交给 R2,通过独立图片域名提供访问。
| 部分 | 上线初期 | 升级后 |
|---|---|---|
| 页面与提示词数据 | Git 保存并发布 | 继续保留原流程 |
| 样张文件 | 跟随代码进入 Git 和部署 | 存放在 R2,浏览器直接请求图片域名 |
| 图片构建信息 | 读取本地图片计算 | 提交元数据索引,历史图片无需整库下载 |
| Admin 历史统计 | 从 Git 历史提取 | 使用独立压缩档案,按内容变化追加快照 |
| 本地预览 | 依赖本地样张,缺失时回退远端 | 统一从 R2 读取样张 |
浏览器从站点域名加载页面和 JSON,从 prompts-img.wangruofeng007.com 加载样张。logo、语言图标等少量站点资源继续随页面部署。
这个拆分符合项目现阶段的需求:图片是持续增长的对象文件,提示词和页面数据仍然适合 Git 管理。身份系统、私有作品、生图任务这些能力,以后需要的时候再设计。
搬走图片之前,先处理依赖图片的代码
光把图片上传到 R2、替换一下首页地址,迁移远远没有结束。
项目原来的去重、色彩推荐等构建逻辑都要读取本地图片。保留这些依赖的话,新电脑照样得先下载整库;让脚本静默跳过缺失文件,又可能生成不完整的结果。
所以迁移的第一步是盘点全部引用,确认 9,263 张样张都有来源、没有孤儿文件,然后保留原来的路径结构:
text
images/thumbs/<styleSlug>/<md5>.webp详情 JSON 继续保存相对路径,由构建器和前端转换成图片域名下的地址。这样变更范围可控,素材主键、样张关系和去重逻辑都能保留。
图片索引 scripts/image-manifest.json 记录了对象路径、MD5、字节数、尺寸、格式、上传收据,还有 dHash 和色彩向量。它既帮助上传续传,也让构建脚本可以直接读元数据而不必下载整库图片。当然,新增图片仍然必须用真实本地文件验收。
为了验证这一点,我在独立临时副本中移除了历史图片、跑了全量构建,生成的推荐索引与原版本哈希一致。这里用的是真实复制而非硬链接,避免副本中的写入污染原工作区。
地址替换也不只是改首页。静态详情页、Open Graph、结构化数据和 sitemap 都要检查。中文和空格按路径段编码,避免整个 URL 被编码或已有编码被重复处理。
MD5 在这里用于内容寻址与一致性核对------内容变了就用新文件名,配合长期 immutable 缓存。它不承担安全认证。正式访问使用自定义域名,R2 公共存储桶文档解释了自定义域名与缓存的关系。
发布流程也要跟着变
原来一次 Git 推送就包含页面和图片。拆成两个系统之后,发布顺序变成了必须显式处理的问题------页面先上线、图片还在传,用户看到的就是缺图。
新的发布入口把顺序固定下来:
bash
node scripts/prepare-publish.mjs先验收本地新增图片,再增量上传 R2,成功后保存收据、检查引用覆盖,最后构建页面。全部通过,才能提交并推送。
Wrangler 部署配置也加了索引检查,防止绕过本地流程发布缺少上传记录的引用。没有图片变化的代码更新可以跳过上传,不需要读取上传凭据;CI 只检查已有收据,不负责上传整库。
上传本身也得可恢复。这批样张约 1.78 GB,大量小对象,请求、连接和重试都会影响耗时。早期还想过换电脑接力,后来放弃了交接,在原机器上续传完成。
上传器按线程复用连接,超时后重试并指数退避,每处理 100 个对象保存一次索引,用临时文件替换来降低索引损坏风险。Wrangler 登录快过期时自动刷新,凭据留在本机。中断时可能有少量对象已写入但收据没存,续传重复写入相同内容,这是可以接受的恢复成本。
续传阶段试过 64 并发,最终脚本默认值定在 8。并发高了未必增加有效吞吐,反而可能增加超时和重试。这次没做严格对照实验,不能把某个数字当通用推荐。
对象存储与 Git 之间没有事务。固定顺序、失败即停,能缩小出错窗口,但仍然需要后续在线检查来兜底。
验收架构变化,不能只看首页能打开
索引完整只说明上传记录覆盖了引用。对象后来被删了,或域名规则改了,索引本身不会知道。
这次分别检查了本地索引和公开域名:
bash
node scripts/check-image-manifest.mjs
python3 scripts/verify-r2-images.py
远端检查覆盖了全部 9,263 张图片,核对响应状态、Content-Length、ETag 和 CORS;另抽了约 30 张实际下载并计算 MD5。首次抽检遇到网络超时,补了 GET 重试后通过。全量访问检查和抽样内容核验提供的是不同维度的证据,这次 ETag 与 MD5 一致,但不能推广到所有上传方式。
迁移之后,还有两个容易忽略的变化。
浏览器跨域行为变了
跨域图片能显示,不等于下载和 Canvas 读取也没问题。
跨域 <a download> 无法保证按指定文件名下载,桌面下载因此改为 fetch 图片、生成 Blob 和临时对象 URL,再触发下载并释放。实际下载的文件做了 MD5 核对。
本地开发服务把缺失图片 302 到 R2 时,Chrome 里普通图片能加载,匿名 CORS 的详情图请求却失败了。迁移阶段先调整了本地请求与失败回退,随后统一本地和线上的 R2 地址解析,一并修复了编码和部分详情缺图。正式站保留匿名 CORS,为 Canvas 等读取操作提供条件。
手机在本地预览远端图片时,Canvas 分享仍可能退回打开原图。桌面下载通过,不能代替手机分享场景的验收。测试时也要确认控件可见、脚本缓存已更新------工具等待超时本身不足以判定产品故障。
图片请求离开了原来的 Worker
原站的 UA 黑名单写在站点 Worker 里。图片改走 R2 域名后,自然不再经过那段逻辑。
迁移阶段为图片域名配了独立 WAF 规则,延续既有 UA 黑名单,同时关闭 r2.dev 公开入口。检查时 GPTBot 被拦截、Googlebot 正常访问。不过 UA 可以伪装,这只是规则验收,不能代替完整防盗链。
这次没有加 Referer 白名单,怕影响分享、本地预览和搜索引擎收录,也没有动其他项目正在用的免费限速规则。拆分域名之后配置更清晰,但账户或区域下的共享额度仍然要一起管理。
图片搬走了,Git 的旧负担还在
R2 解决了后续图片的存储和发布问题,但历史图片仍然留在 Git 里。
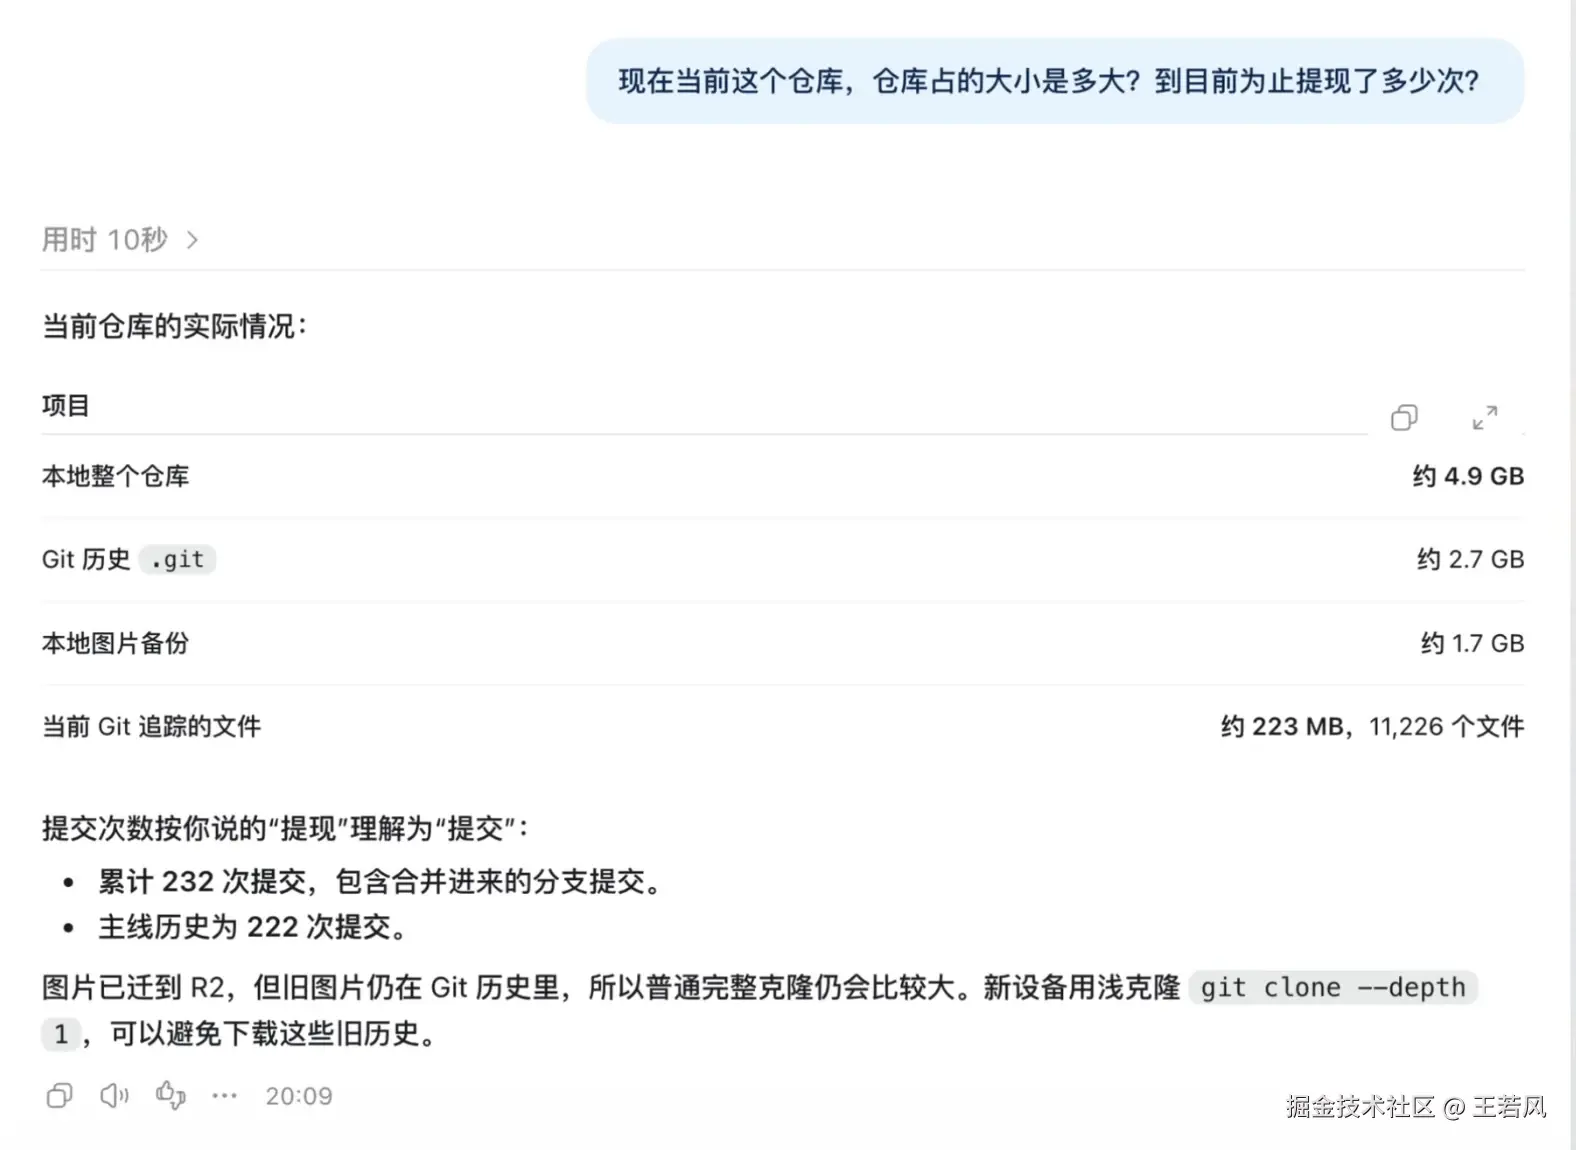
这张中途盘点的截图:整个本地目录约 4.9 GB,.git 约 2.7 GB,本地图片备份约 1.7 GB,当前追踪文件约 223 MB。这些口径不能混用------当前文件变少也不意味着完整克隆立刻变小。
Git 的 rm --cached 只从索引移除文件,不会清除旧提交中的对象。这里还有一个实际教训:迁移分支取消追踪后,本地图片还在;切回旧 main 再合并包含删除记录的迁移提交时,Git 把工作区里的这些图片删了。当时从旧提交恢复了全部 9,263 张样张,重新核对数量才放心。
教训很明确:已有完整图片库的设备,拉取这类删除提交前要先把备份放到仓库外面。rm --cached 保留了本地文件,不代表后续合并也会保留。
先解除统计历史对 Git 的依赖
准备清理 Git 时又发现了一个前置问题------Admin 历史统计依赖 Git 提交记录。直接重新初始化,历史曲线就没了来源。
于是先把统计数据导出到 data/admin/history.json.gz,保留了 223 条历史提交记录和 90 次库存变化快照,压缩后约 915 KB。构建改为读取这个独立档案,数据有变化时追加快照,再生成浏览器使用的报告 JSON。缺少 .git 或无法调用 Git 的构建场景也验证过了。
这个档案保存的是统计和必要的溯源信息,不包含旧版完整源码和图片。后续快照只能记录构建时的状态,两次构建之间发生又撤销的变化无法还原。档案损坏或缺失必须明确报错,不能静默生成一份从零开始的历史。
保留历史,还是从最新版本重新开始
动手之前,先在仓库外归档了完整项目------覆盖原 .git、忽略文件、图片和工作区改动,核对了归档条目和 SHA-256。归档约 3.03 GiB,35,226 个条目。
最初想保留代码演进历史,在隔离镜像里用 git-filter-repo 删图片和缓存。过滤后 Git 目录约 228 MB,打包约 225 MiB,已经大幅缩小了。
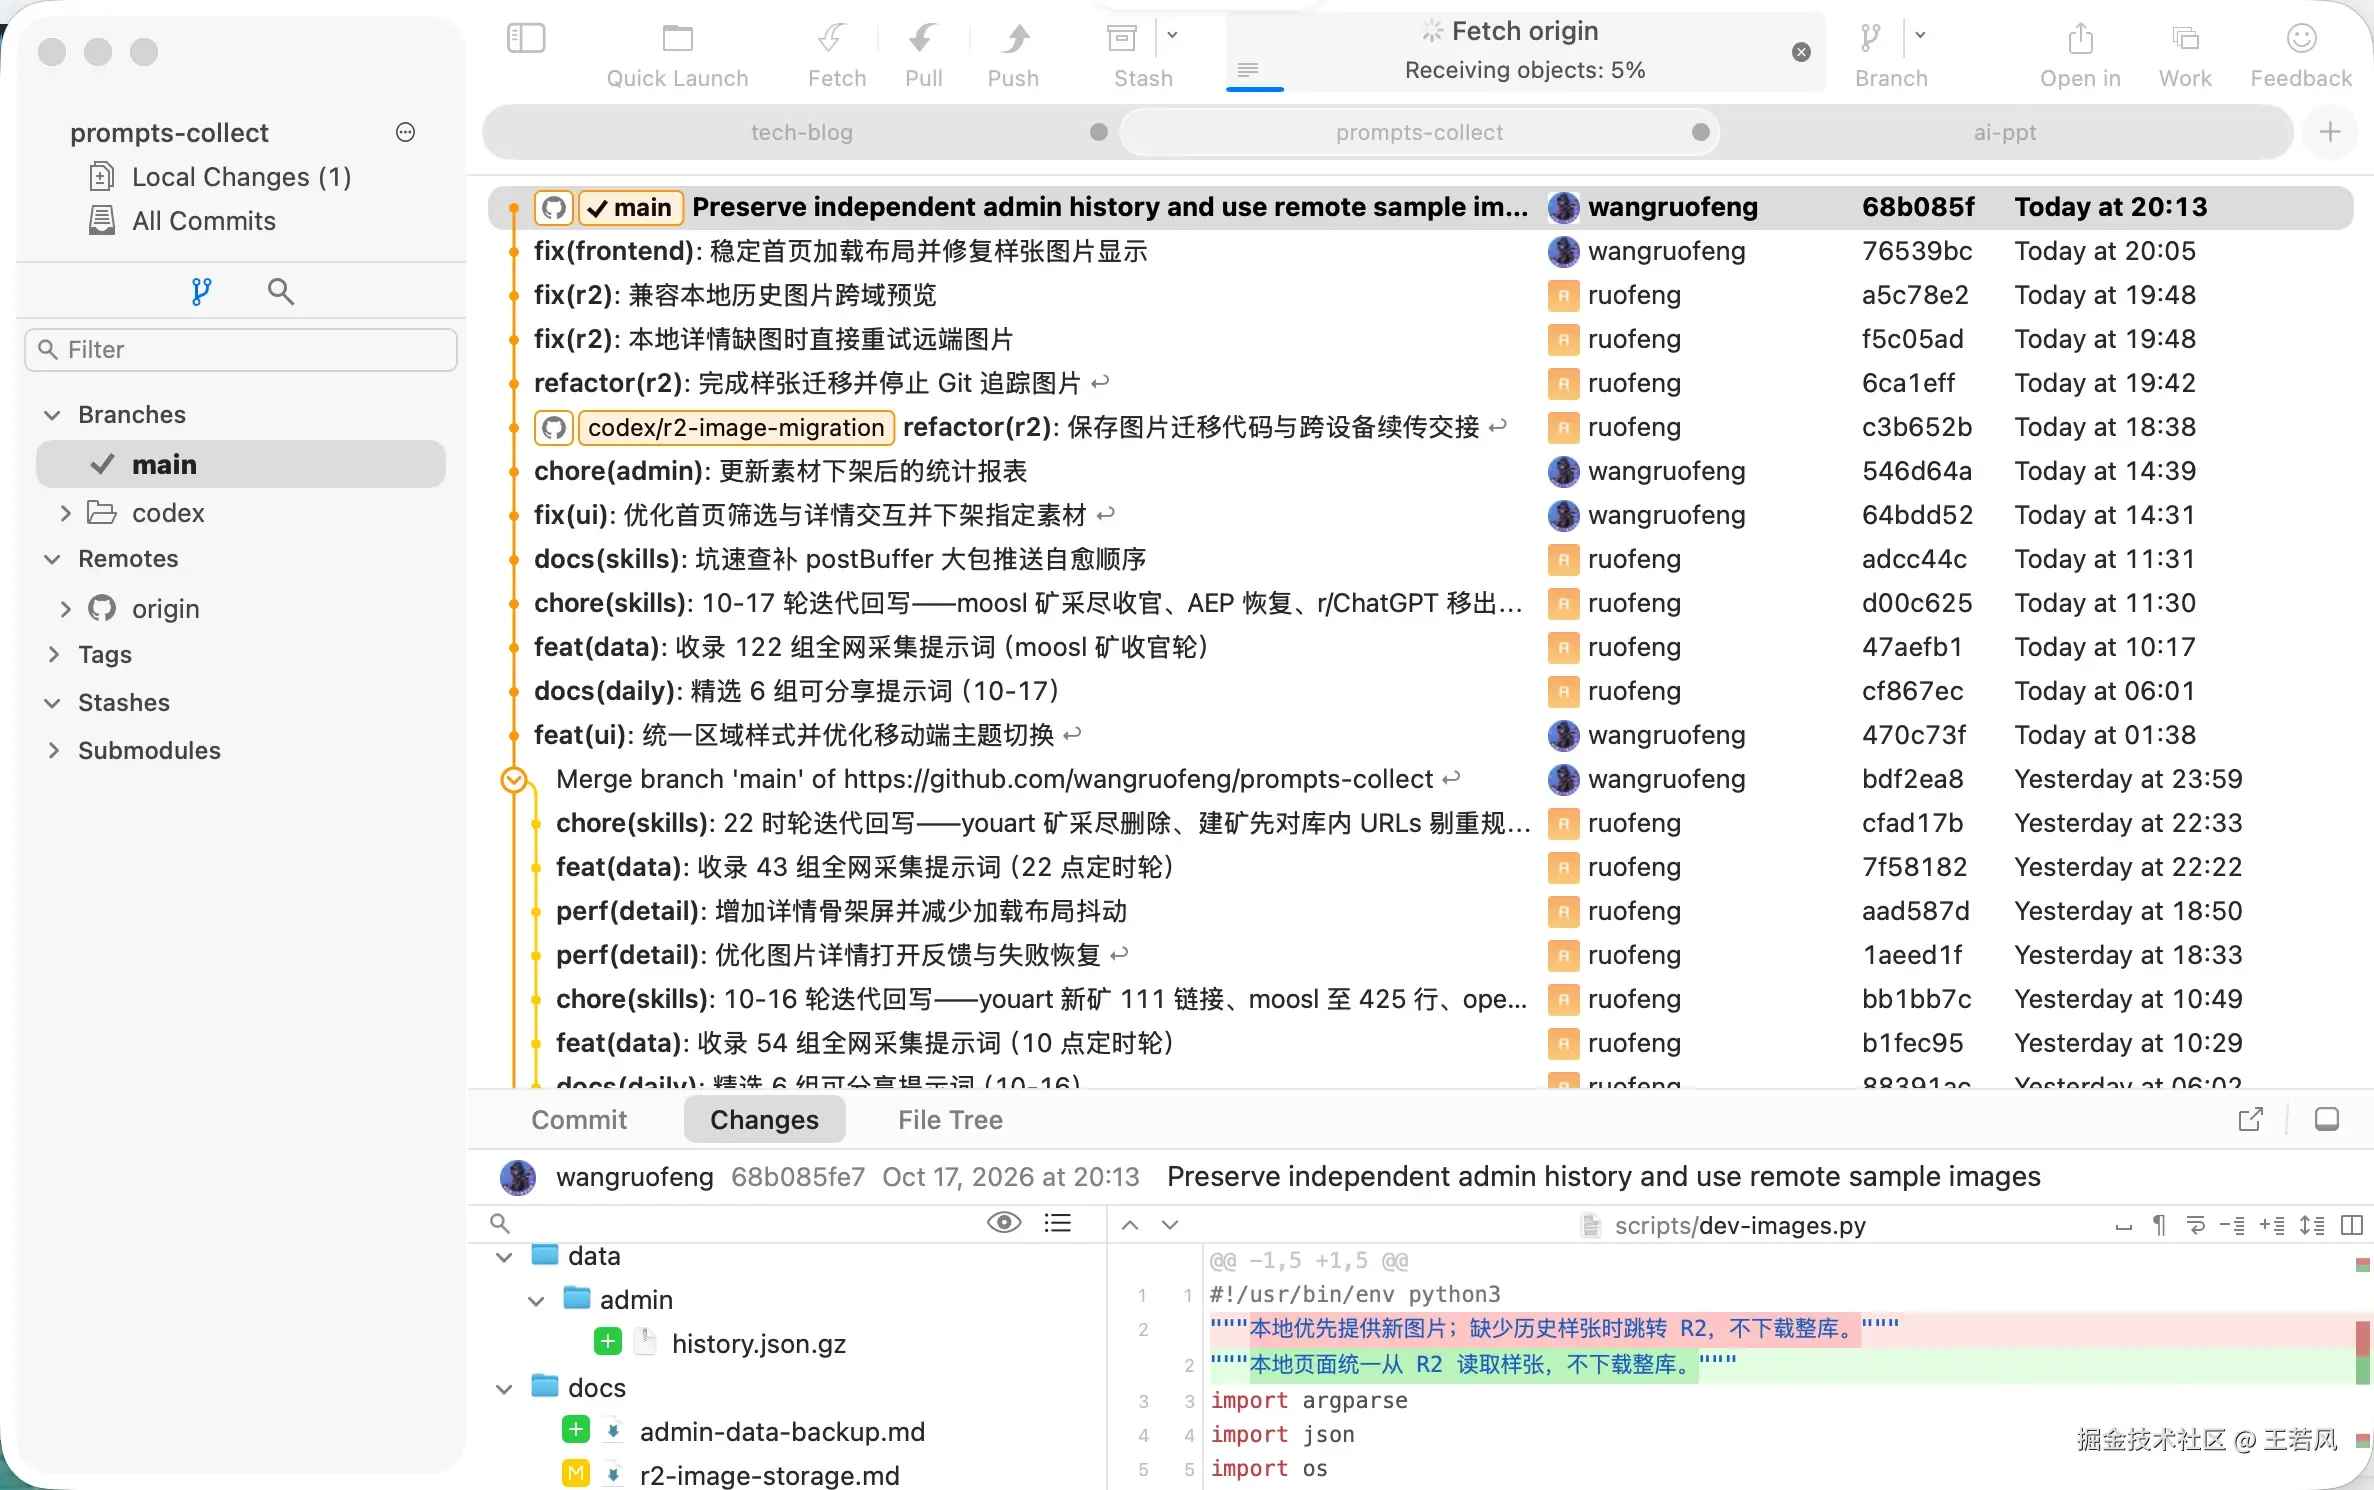
但这个历史包通过代理推送时遇到 HTTP 408,增大 http.postBuffer 也没解决。这只是那次传输没完成的问题,Git 推送和 R2 上传需要分别诊断。
最终我选择保留最新代码和内容、创建新的 Git 根提交,覆盖原 GitHub 仓库的分支历史。项目地址不变,本地 .git 降到约 68 MB。导入前检查了文件集合,避免把凭据、缓存和备份带进新仓库;其他设备随后需要重新克隆。
这是接受旧提交历史丢失之后的选择。有保留历史需求的团队完全可以停在过滤或浅克隆方案------历史重置和图片迁移应该分开决策。
文章整理期间,前面提到的完整项目备份已经删了,不能再当作恢复点。独立的 Admin 数据备份还在,但它无法恢复旧项目的完整内容。备份保留多久、什么时候删,也是迁移之后要管的事。
这次升级带来了什么
| 方面 | 结果 | 代价或边界 |
|---|---|---|
| Git 体积 | 约 2.8 GB 降至约 68 MB,减少约 97.6% | 近似体积计算,旧提交不再可达 |
| 图片发布 | 9,263 张样张迁入 R2,新增图片先上传再发布引用 | 需要维护对象存储和发布检查 |
| 新设备开发 | 无需下载历史图片即可预览和构建 | 浏览远端样张需要联网 |
| 历史统计 | 独立档案支持 Admin 持续积累 | 统计档案无法替代完整项目备份 |
| 自动部署 | R2 迁移阶段已验证恢复成功 | 后续 Git 重置提交需要独立验收 |
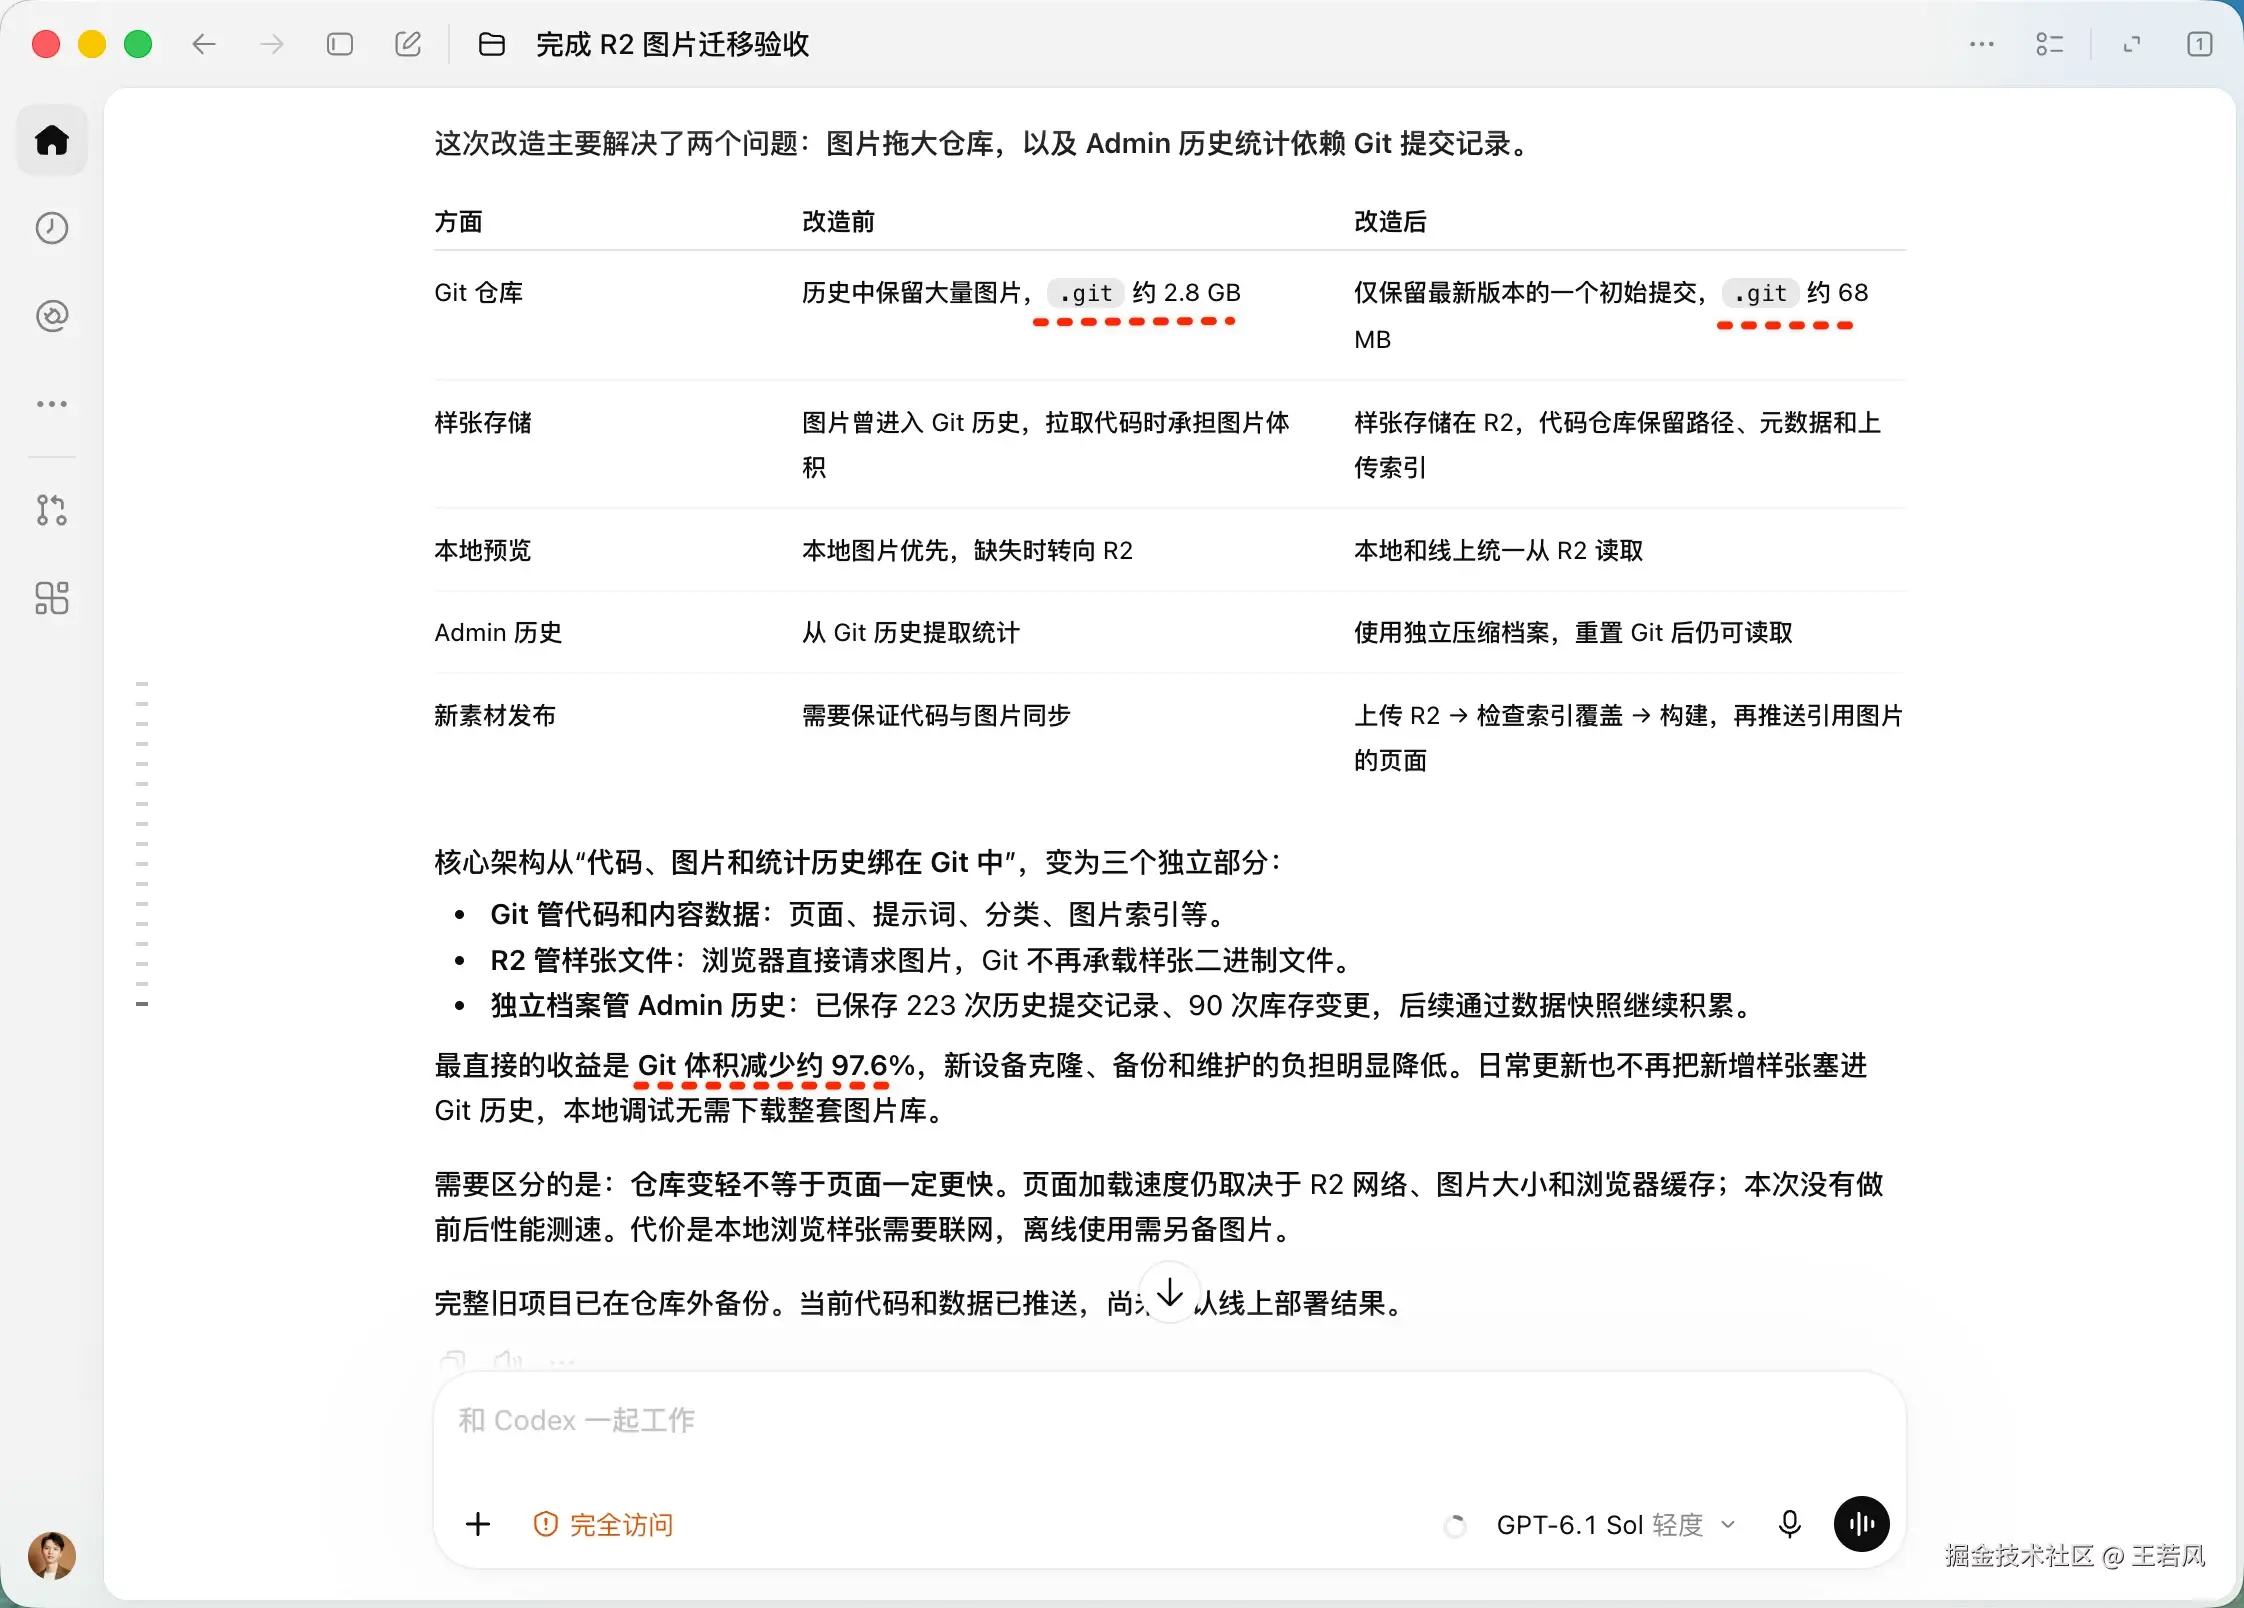
最直接的变化:内容继续增长时,Git 不再随样张二进制文件一起膨胀了。代码、图片和统计各有各的存储方式,发布流程显式检查它们之间的关系。
但仓库减重不等于页面提速。这次没做前后性能基准,页面加载仍然取决于图片大小、缓存和网络。R2 的存储量、操作量和费用也需要长期观察,不能从一次验收就推出永久零成本。HTML 和详情 JSON 还在增长,静态资源数量上限仍然值得关注。
验收记录按阶段保留。R2 迁移提交 fe3735917 对应 Cloudflare 版本 bd5094ce-2dd6-4f45-b1c4-e44a920c06bd,当时确认了部署成功、正式站脚本版本、图片来源及下载 MD5,也核对了旧图片链接 302、缺失路径 404、部署排除的索引 404。
后续 Git 重置的根提交 d3f2586bb97be43744c77fd81deaf00d15efe660,通过了 8 项测试、索引覆盖及 Git 完整性检查。不过这个阶段没有再跑完整站点构建或独立确认生产部署结果------前一阶段通过了,不代表这个新提交也不需要验收。
给同样在运营小项目的人
回头看最初的实现,我依然觉得那是适合起步的选择。它让网站很快上线,让我能持续添加素材,再从真实运营中发现限制。直到图片规模、跨设备开发和部署要求真的变了,才有足够具体的依据去拆分存储和发布。
如果你的项目也开始遇到类似的问题,可以先盘点:二进制资源怎么增长、构建是不是依赖整库文件、业务历史是不是绑死在 Git 上。想清楚了再决定迁移范围。保留仍然适用的页面和数据结构,逐项替换带来负担的部分,每一步留下可核对的结果------这样更容易判断改造到底有没有解决实际问题。
对我来说,这次值得记下来的,是生图灵感库从快速做出来,走到了需要认真安排存储、发布和维护的阶段。9,000 多张样张让一些早期选择撞上了边界,也让下一步该怎么改变得具体。
欢迎来生图灵感库逛逛,找一张喜欢的图,看看提示词怎么描述它,再按自己的主题去试。网站里的图片是参考,实际效果会随模型和参数变化;这篇文章留下的,是支撑这些内容的一次架构演进。