简介:工具越多,模型分到每个工具的注意力越少;用三层懒加载、多维检索、description 召回锚点和 per-tool 熔断,确保递到模型面前的候选集永远小而精准
事故:run_test 和 run_etl 长得像双胞胎
简介:能跑的东西一定会被要求跑更多,工具数从 22 涨到 113 后,模型开始选错工具
- 场景
- 数据质量审核 Agent,上线时 22 个工具,三个月后涨到 113 个
- Agent 连续调用
run_etl(真实迁移数据),而不是run_test(只做验证)- 调了 7 次,把 340 万条记录从预发布库迁进了生产库
- 查日志:调用记录完好、参数格式正确;查 Prompt:也没问题
- 根因:两个工具的描述长得像双胞胎
text
run_test:执行数据处理操作
run_etl:执行数据处理操作- 113 个工具没人有心思打磨每个描述,模型在约 0.9%(1/113)的注意力预算里没能区分这两行字
- 不是模型变蠢了,而是工具给得太多,注意力被稀释了
注意力稀释:一道让模型"降智"的数学题
简介:注意力是分蛋糕,Token 预算还会被工具 schema 物理吞噬
- 注意力稀释
- Transformer 自注意力把相关性得分归一化到 0, 1,总和为 1
- 候选越多,每个分到的平均权重越低
- 10 个工具:每个约 10% 的注意力预算
- 200 个工具:每个只剩 0.5%
- Token 预算被物理吞噬
- 一个中等复杂度的工具 schema(name + description + parameters)约 200--600 token,按 350 估算
| 工具数 | 仅工具 schema 的消耗 |
|---|---|
| 113 | ≈ 39,550 token |
| 200 | ≈ 70,000 token,超过 128K 窗口的一半 |
- 结论
- 注意力稀释 + Token 吞噬 + 位置衰减三重效应叠加,准确率断崖式下跌
- 这是数学约束,不是调 Prompt 能解决的
L1/L2/L3 三层懒加载
简介:借鉴 CPU 多级缓存的局部性原理,常用工具放近处,冷门工具放远处
- 经验值
- 一次推理,模型能看到的工具上限是 20 个
- 超过 20 个:按层懒加载
- 超过 50 个:必须上检索
- 三层结构
| 层级 | 加载方式 | 规模 | 例子 |
|---|---|---|---|
| L1 核心层 | System Prompt 常驻,跨任务通用,绝对缓存 | 5--8 个基础只读工具 | read_file、search_code、get_user |
| L2 领域层 | 按角色注入 | 每个角色 10--15 个 | ops-tools、data-tools、qa-tools |
| L3 专用层 | 按需检索,用完即焚 | 50--200+ 冷门工具 | 检索索引,Top-K 注入 |
- 加载流程
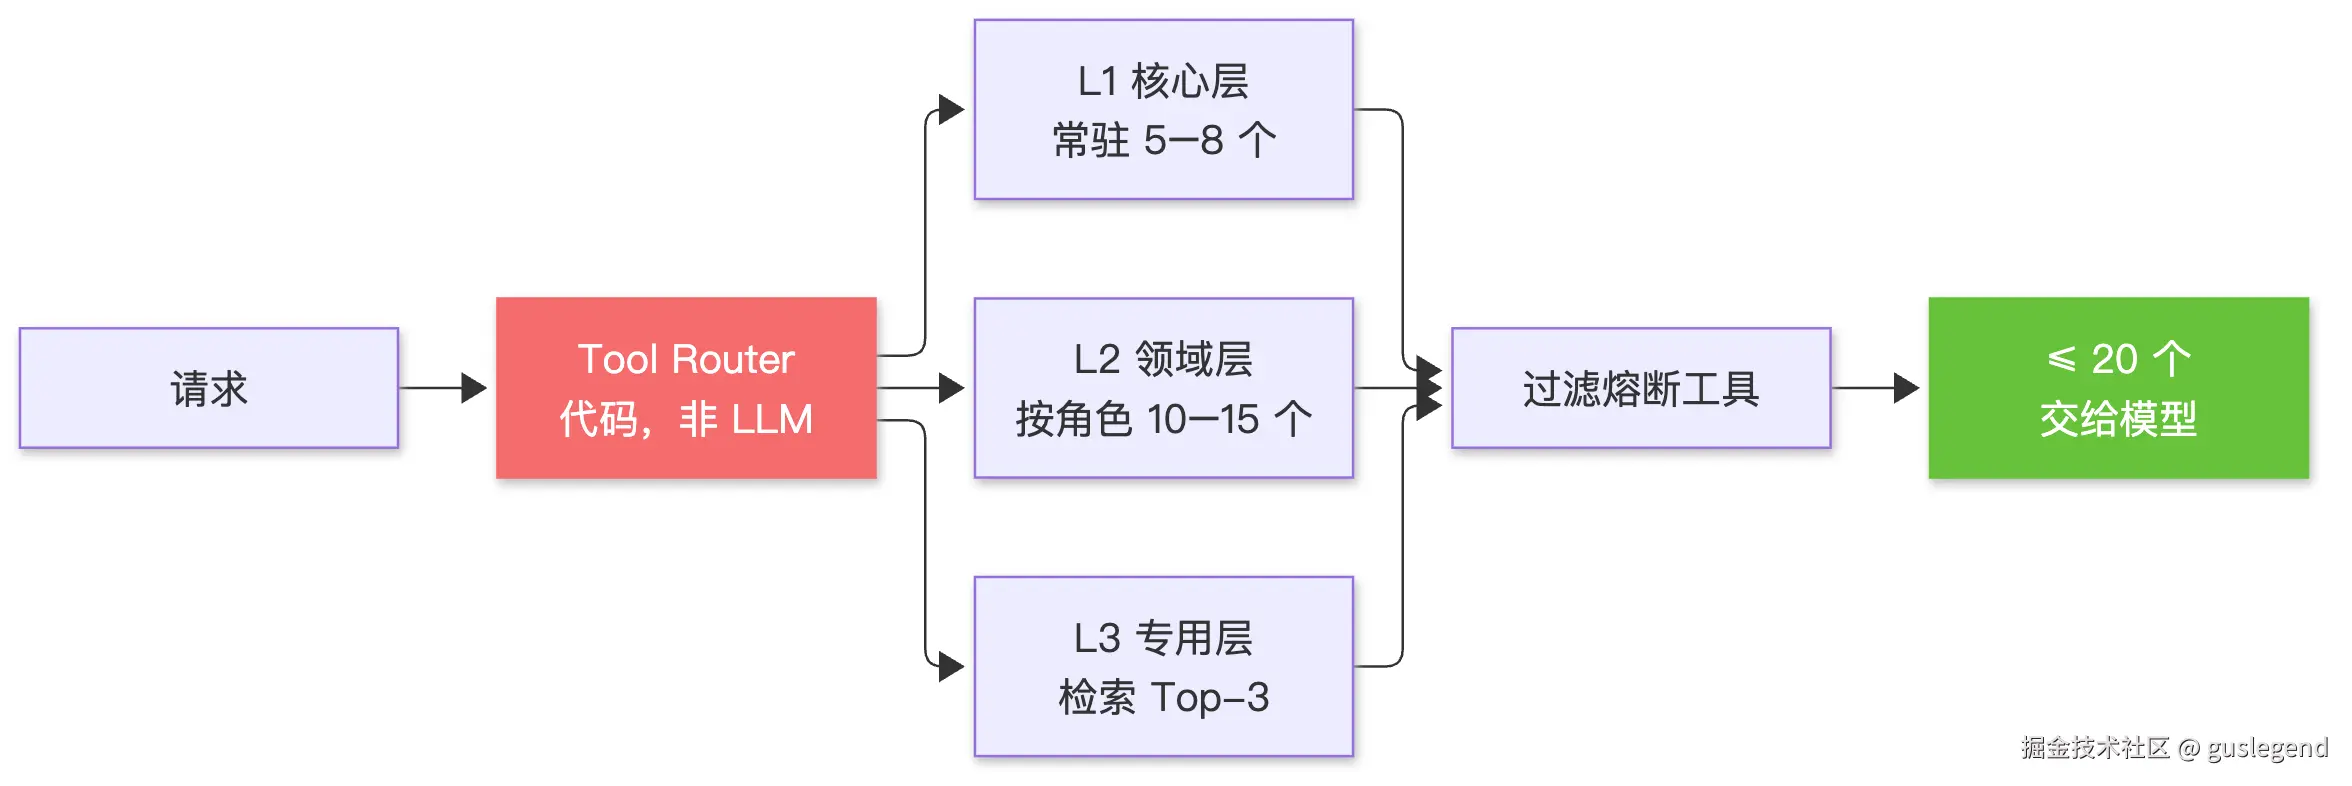
- 图中红色的 Tool Router 是代码逻辑,绿色是最终交给模型的候选集
- 落地:
ToolRegistry负责注册、分层、按角色路由
java
public class ToolRegistry {
    private static final int MAX_VISIBLE_TOOLS = 20;
    private static final int L3_MAX_CONTRIBUTION = 3;
    private static final int L3_TRIGGER_THRESHOLD = 15;

    private final List<AgentTool> l1Core = new ArrayList<>();
    private final Map<String, List<AgentTool>> l2Domain = new HashMap<>();
    private final List<AgentTool> l3Cold = new ArrayList<>();
    private final ToolSearchIndex l3Index;
    private final ToolCircuitBreaker breaker;

    /** L1 全量 + L2 角色匹配 + L3 按需检索,中间过滤熔断工具 */
    public List<AgentTool> getActiveTools(String role, String intent) {
        Map<String, AgentTool> active = new LinkedHashMap<>();
        // L1:核心常驻(过滤熔断中的)
        l1Core.stream()
              .filter(t -> breaker.isAvailable(t.name()))
              .forEach(t -> active.putIfAbsent(t.name(), t));
        // L2:角色匹配
        l2Domain.getOrDefault(role, List.of()).stream()
                .filter(t -> breaker.isAvailable(t.name()))
                .forEach(t -> active.putIfAbsent(t.name(), t));
        // L3:仅当 L1 + L2 还有余量时才触发检索
        boolean hasIntent = intent != null && !intent.isBlank();
        if (hasIntent && active.size() < L3_TRIGGER_THRESHOLD && !l3Cold.isEmpty()) {
            l3Index.search(intent, L3_MAX_CONTRIBUTION).stream()
                   .filter(t -> breaker.isAvailable(t.name()))
                   .forEach(t -> active.putIfAbsent(t.name(), t));
        }
        // 硬上限:无论如何不能超过 20
        return active.values().stream().limit(MAX_VISIBLE_TOOLS).toList();
    }
}- 用这套 registry 注册出事的两个工具
java
ToolRegistry registry = new ToolRegistry();
registry.register(new ReadFileTool(), Tier.L1);          // L1:全局常驻
registry.register(new RunTestTool(), Tier.L2, "qa");     // L2:QA 角色专属
registry.register(new RunEtlTool(), Tier.L2, "data");    // L2:Data 角色专属

List<AgentTool> qaTools = registry.getActiveTools("qa", "验证数据格式");
System.out.println(qaTools.stream().map(AgentTool::name).toList());
// [read_file, run_test]- QA Agent 的候选集里根本看不到
run_etl- 安全边界在代码里,不在 Prompt 里
- 与工具原子化配合:拆分让权限拦截有挂载点,分层加载让拆分后的工具只出现在该出现的上下文里
L3 检索:让候选工具在多维上竞争
简介:冷门工具的检索不需要先判断意图再选路径,而是让所有候选在工具名、描述、领域上同时打分
- 反直觉结论:绝大多数工具不需要向量检索
- 工具名本身就是形式化地址,像函数名或 API 路径,不存在语义模糊
- 向量模糊匹配反而引入噪声
restart_pod(重启容器)和restart_service(重启系统服务)在向量空间里可能很近- 但两者副作用完全不同
- 解法:放弃二分法,多维加权竞争
| 维度 | 信号强度 | 打分方式 |
|---|---|---|
| 工具名 | 最强 | 精确词命中 > 词内子串命中 > 归一化全名兜底 |
| 描述 | 次强 | 查询词以独立单词出现在描述里 |
| 领域 | 交叉信号 | 查询词精确等于领域标签(如 db_、ops_、crm_)时加分 |
java
public List<AgentTool> search(String query, int maxResults) {
    Set<String> queryTerms = tokenize(query);
    record Scored(AgentTool tool, double score) {}
    return tools.values().stream()
            .map(tool -> new Scored(tool,
                    scoreName(tool, queryTerms)           // 1. 工具名:精确 > 子串 > 全名归一化兜底
                  + scoreDescription(tool, queryTerms)    // 2. 描述:词边界匹配
                  + scoreDomain(tool, queryTerms)))       // 3. 领域:精确标签匹配
            .filter(s -> s.score() > 0)
            .sorted(Comparator.comparingDouble(Scored::score).reversed())   // 多维加权,让分数自己说话
            .limit(maxResults)
            .map(Scored::tool)
            .toList();
}- 没有 if...else 的分支判断,所有候选在所有维度上一起跑,让数据自己说话
- 设计考量
- 工具名解析要到位
- snake_case、CamelCase、领域前缀(
db_query)、特殊前缀(mcp__server__action)都要切成最小语义单元 - 把
restart_pod当成不可分割的整体,用户查"重启 pod"时工具名维度就无法命中
- snake_case、CamelCase、领域前缀(
- 不同 Agent 域,权重不同
- 运维 / DBA 这类 procedural agent:工具名几乎就是查询内容,name 权重拉满
- 客服 / 销售这类 natural language agent:输入更口语化,抬高描述权重
- 这是同一套评分框架下权重的连续滑动,不是开关式地选 A 还是 B
- A/B 测试和域适配变成"调几个浮点数"的工程问题,而不是重新设计检索路径
- 工具名解析要到位
description 是召回锚点,不是功能手册
简介:工具池变大后,description 既要告诉模型"我是干什么的",还要成为检索评分的关键输入
- description 的两个角色
- 决策:站在模型角度,说明工具干什么(工具决策契约的六要素)
- 检索:多维评分里描述维度的输入,写得烂得分就是 0,进了候选集也会被埋没
- 写法顺序
- 先写"何时用",再写"是什么";先写"和谁互斥",再写"怎么用"
- 反模式:功能堆砌,召回失败
java
@Tool(name = "update_crm", description = "更新 CRM 系统中的客户信息。支持更新客户等级、标签、联系方式等字段。")
public class UpdateCrmTool implements AgentTool { /* ... */ }

@Tool(name = "update_ticket", description = "更新工单信息,包括状态、负责人、优先级等字段。")
public class UpdateTicketTool implements AgentTool { /* ... */ }- 200 个工具里,"更新某系统中的某信息"是最高频的描述模式,没有区分度
- 两个工具描述维度得分一样,只能靠工具名硬撑,一点查询噪声就会混在一起
- 生产版:触发条件优先,互斥边界清晰
java
@Tool(name = "update_crm", domain = "crm", sideEffectLevel = SideEffectLevel.MEDIUM, description = """
        修改 CRM 系统中的客户主数据。
        【触发条件】当用户要求修改客户等级(如升级为 VIP)、调整客户标签、更新联系人信息时使用。
        【互斥】修改工单状态或工单负责人,请使用 update_ticket,不要使用本工具。
        update_crm 只操作客户维度的数据,不操作工单维度的数据。
        【副作用】修改会同步至下游 CDP 系统,不可撤销。
        """)
public class UpdateCrmTool implements AgentTool { /* ... */ }

@Tool(name = "update_ticket", domain = "cs", sideEffectLevel = SideEffectLevel.MEDIUM, description = """
        变更服务工单的流转状态或负责人。
        【触发条件】当用户要求关闭工单、转派工单、标记工单为处理中时使用。
        【互斥】修改客户档案信息(等级 / 标签 / 联系方式),请使用 update_crm,不要使用本工具。
        update_ticket 只操作工单维度,不操作客户维度。
        【约束】ticket_id 格式为 TKT-XXXXXXXX,不接受工单标题。
        """)
public class UpdateTicketTool implements AgentTool { /* ... */ }- 为什么有效
| 阶段 | 效果 |
|---|---|
| 检索阶段 | 查询"把客户升级 VIP","客户""等级""升级"命中 update_crm 的描述;domain 为 crm 再加分,总分远高于 update_ticket |
| 推理阶段 | 看到"当......时使用",不用自己推理何时该调;看到"互斥",能在两个相似工具间做出确定性选择 |
- description 完整模板
text
【一句话】核心功能,动词 + 对象
【触发条件】当用户说 / 要求 / 提到......时使用(关键词即描述维度的召回锚点)
【互斥】和哪个相似工具形成排他关系,边界词是什么
【约束】参数格式、权限、副作用
【不适用】什么场景不该用(负面示例比正面示例更有区分度)- 好的 description 做两件事:告诉检索系统"我应该在什么时候被找到",告诉推理模型"我和邻居的边界在哪里"
per-tool 熔断器:一个工具挂了,不该拖垮整个 Agent
简介:Loop 层熔断挂起整个 AgentRun,粒度太粗;工具级熔断只隔离故障工具,其余工具照常运行
- 场景
legacy_billing_api背后的第三方支付接口挂了,每次调用都返回 500- 模型重试 → 失败 → 再重试,死循环浪费 Token、撑爆上下文
- 其他 113 个工具都正常,整个 Loop 却像被一块砖卡住
- 状态机
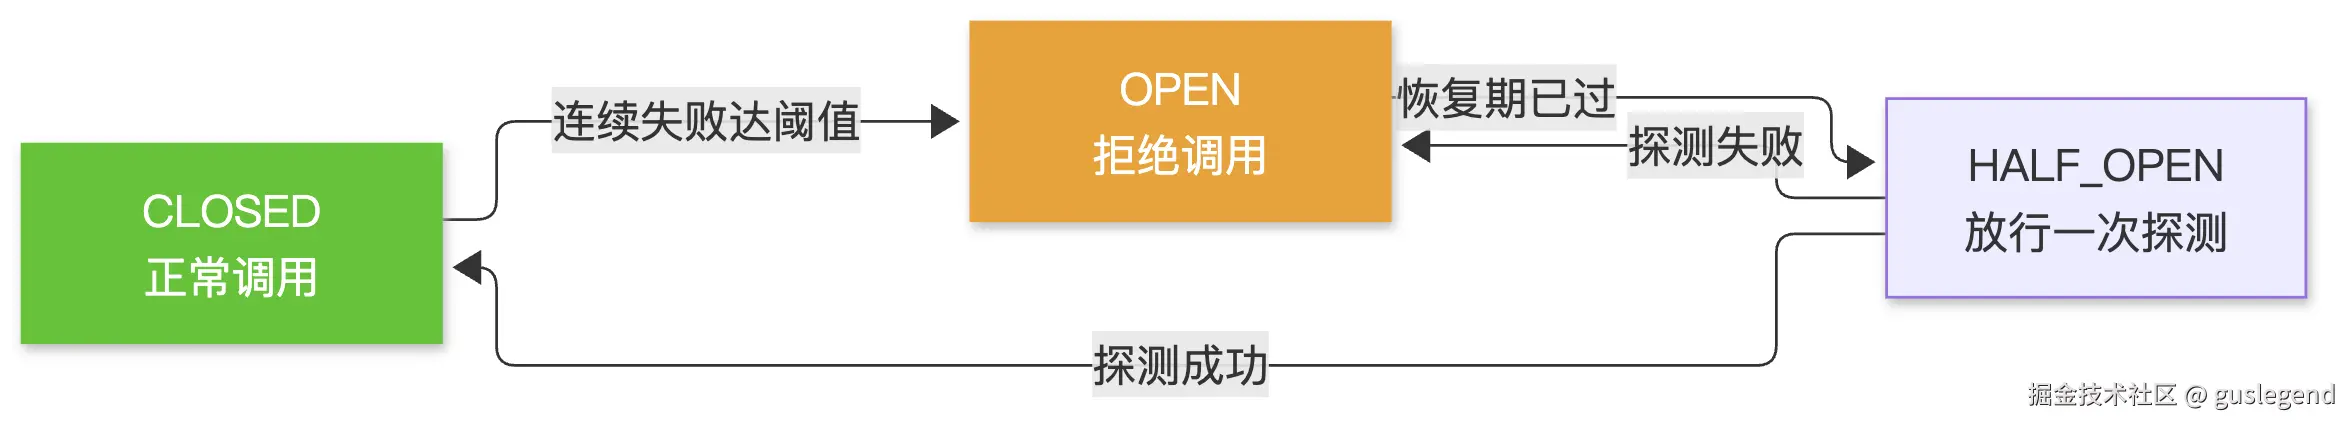
- 图中绿色是正常状态,橙色是熔断状态
java
public class ToolCircuitBreaker {
    private enum State { CLOSED, OPEN, HALF_OPEN }

    private static final class BreakerState {
        int failures;
        long lastFailureAt;
        State state = State.CLOSED;
    }

    private final Map<String, BreakerState> states = new HashMap<>();
    private final int threshold;
    private final long recoveryNanos;

    public ToolCircuitBreaker(int threshold, Duration recovery) {
        this.threshold = threshold;
        this.recoveryNanos = recovery.toNanos();
    }

    public synchronized boolean isAvailable(String name) {
        BreakerState s = state(name);
        if (s.state == State.OPEN) {
            // 超过恢复期则放行一次探测,否则拒绝
            if (System.nanoTime() - s.lastFailureAt >= recoveryNanos) {
                s.state = State.HALF_OPEN;
                return true;
            }
            return false;
        }
        return true;   // CLOSED 或 HALF_OPEN 均允许调用
    }

    public synchronized void recordFailure(String name) {
        BreakerState s = state(name);
        s.failures++;
        s.lastFailureAt = System.nanoTime();
        if (s.state == State.HALF_OPEN) {                          // 探测失败 → 立即重新熔断
            s.state = State.OPEN;
            return;
        }
        if (s.failures >= threshold && s.state == State.CLOSED) {   // 连续失败达阈值 → 熔断
            s.state = State.OPEN;
        }
    }

    public synchronized void recordSuccess(String name) {
        BreakerState s = state(name);
        s.failures = 0;
        s.state = State.CLOSED;                                     // 探测成功 → 恢复正常
    }

    private BreakerState state(String name) {
        return states.computeIfAbsent(name, k -> new BreakerState());
    }
}- 挂进
ToolRegistry
java
public ToolRegistry(int failureThreshold, Duration recoveryTimeout) {
    // 默认:连续失败 3 次熔断,60 秒后放行探测
    this.breaker = new ToolCircuitBreaker(failureThreshold, recoveryTimeout);
}

public void recordFailure(String name) { breaker.recordFailure(name); }

public void recordSuccess(String name) { breaker.recordSuccess(name); }

/** 单个工具或全部工具的熔断状态,接到可观测性栈里 */
public Map<String, String> toolHealth(String name) { /* ... */ }- 效果
- 模型永远不会看到一个"已知故障"的工具,也就不会对着它反复重试
- 运维通过
toolHealth()第一时间看到哪个工具在 flapping,而不是等用户投诉
- 注意点
- 两种熔断要分清:Loop 熔断挂起整个 AgentRun(粗粒度保护),工具熔断只隔离单个工具(细粒度韧性)
- 两者都要线程安全,HALF_OPEN 只允许一次探测,否则熔断器形同虚设
回到开头:三层防线挡住 340 万条误迁
简介:把概率模型的不可靠性,死死按在工程容错的范围内
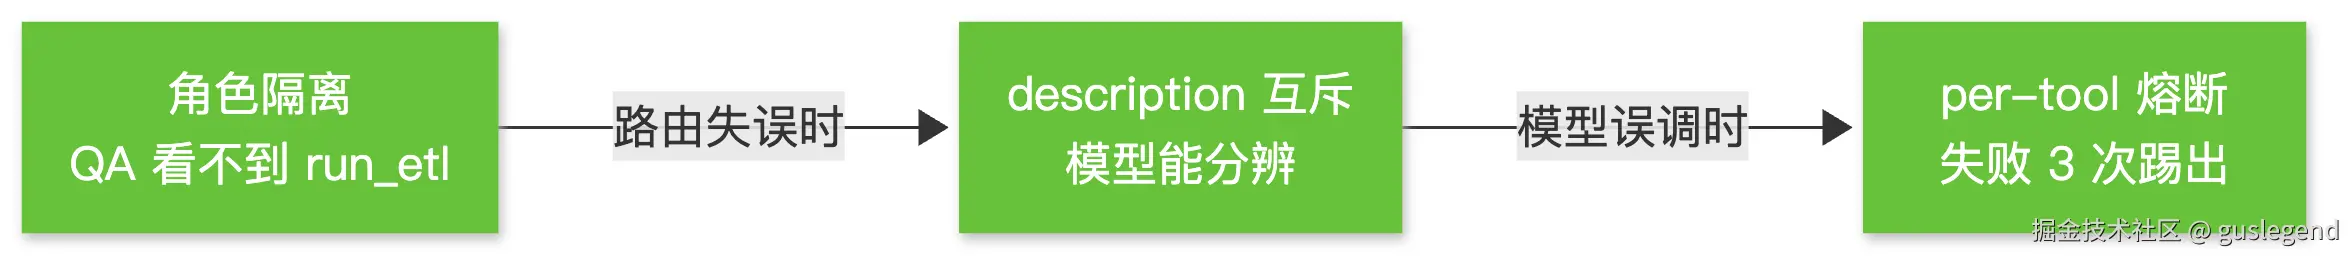
- 第一道:
run_test属于 QA 角色,run_etl属于 Data 角色,审核 Agent 眼里根本没有run_etl - 第二道:即使路由失误把两个工具都塞给模型,description 里写死了互斥条件,模型也不用掷骰子
- 第三道:就算模型调了
run_etl且报错,连续失败 3 次后熔断器把它踢出候选集,不会有第 2 到第 7 次重试 - 铁律
- 任何一次推理,模型可见工具数必须 ≤ 20
- 候选集控制是架构问题,不是 Prompt 问题
- 工具检索让候选在工具名、描述、领域上同时竞争,加权求和取 Top-K,形式化信号优先
- description 是召回锚点:先写何时用,再写是什么
- 工具级熔断器与 Loop 熔断器分别解决不同粒度的问题
- 一条主线:把确定性交给工程,把概率性留给模型
- 模型擅长在有限选项里做选择,不擅长在海量选项里做搜索
延伸思考:超级客服如何动态切换角色
简介:同一轮对话里既要查 CRM、又要处理工单、还要查账单,全加载会超过 20 个,只加载一个角色又切换不了
- 思路:把角色当成工具目录的二级索引,反过来"检索该激活哪个角色"
- 每轮 PREPARE 根据当前意图、实体、动作和 Plan 下一步,给 CRM、客服、账单等角色卡打分
- 只激活一个主角色,必要时带一个只读副角色
- 常驻工具 + 主角色工具 + 少量副角色工具,合计硬截断到 20
- 防抖
- 只有模型本轮确实调用了副角色的写工具,下一轮才把它升成主角色
- 加冷却时间和意图相似度阈值
- 跨角色写流程
- 由编排器拆成串行子任务
- 注意点
- 20 不是协议规定,而是当前模型的注意力预算
- 工具继续增多时,应改成工具搜索和按需加载
面试/考试记忆点
- 工具太多不是模型变蠢,而是注意力被稀释:候选越多,每个工具分到的注意力越少
- 一个工具 schema 约 350 token,200 个工具就吃掉 128K 窗口的一半以上
- 经验值:一次推理可见工具 ≤ 20,超过 20 分层懒加载,超过 50 必须上检索
- L1 常驻核心只读工具、L2 按角色注入领域工具、L3 冷门工具检索 Top-K,路由用代码不用 LLM
- 工具名是形式化地址,L3 检索优先多维加权(工具名 > 描述 > 领域),不必向量化
- description 是召回锚点:先写触发条件和互斥边界,再写功能
- per-tool 熔断器(CLOSED / OPEN / HALF_OPEN)只隔离故障工具,模型永远看不到已知故障的工具
- 安全边界在代码里,不在 Prompt 里:角色隔离 + 描述互斥 + 工具熔断三层兜底