context-mode 这周在 GitHub 涨了 4,400 多星,README 和 npm 包描述都写着能省掉 98% 的上下文。本文读了它 1.0.169 版本的源码,并绕开模型直接调用它的 MCP server 做了复现。结论分三点:它省 token 靠三层机制,分别是 hooks 引导模型改用沙箱工具、子进程只回传 stdout、大输出切块存进 SQLite FTS5 按需检索;98% 是作者预先写好的汇总脚本输出与原始文件的字节比,对照基线是「原始数据全部进入上下文」;在 Claude Code 里,一份 56KB 的网页快照走检索路径实测省 89%,代价是多一次工具调用。
这个差距值得单独讨论。98% 与 89% 本身差得不多,问题在于基线。Claude Code 自带的机制已经把超过 3 万字符的 Bash 输出存成文件、只给模型 2,000 字符预览,WebFetch 抓到的页面也先经过一次独立的模型调用再进入主上下文。拿「全量原文」当分母,等于把 Claude Code 已经替你省掉的部分也算进了插件的功劳。
所以判断要不要装,看的是你的会话里有多少输出落在 Claude Code 自带闸门之外。下面先讲闸门在哪,再拆插件的三层机制,最后给出适用边界。
Claude Code 自带的四道输出上限
按官方文档(tools-reference、env-vars 两页),工具输出进入上下文前已经有四个上限:
| 工具 | 自带上限 | 超出后模型收到什么 |
|---|---|---|
| Bash | 有效结果内联约 30,000 字符 | 存成会话目录下的文件,只给路径 + 前 2,000 字符预览 |
| Read | 单次 25,000 token,整文件超过 256KB 拒绝 | 第一页 + PARTIAL view 提示,需要 offset/limit 分页 |
| WebFetch | 不设长度上限,但先跑一次独立模型调用 | 按 prompt 抽取后的结果,不是原页面 |
| MCP 工具 | MAX_MCP_OUTPUT_TOKENS 默认 25,000 token | 超过 10,000 token 时警告 |
真正会整块涌进上下文的,是落在这些上限以内的中等输出:5,000 到 30,000 字符的测试日志和构建输出、25,000 token 以内的文件 Read、Playwright 和 GitHub 这类 MCP 工具的返回。一份 57KB 的 Playwright 页面快照约一万四千 token,低于 MCP 上限,会原样进入上下文。context-mode 能拿到的收益集中在这一段。
context-mode 的三层机制:hooks、沙箱、FTS5
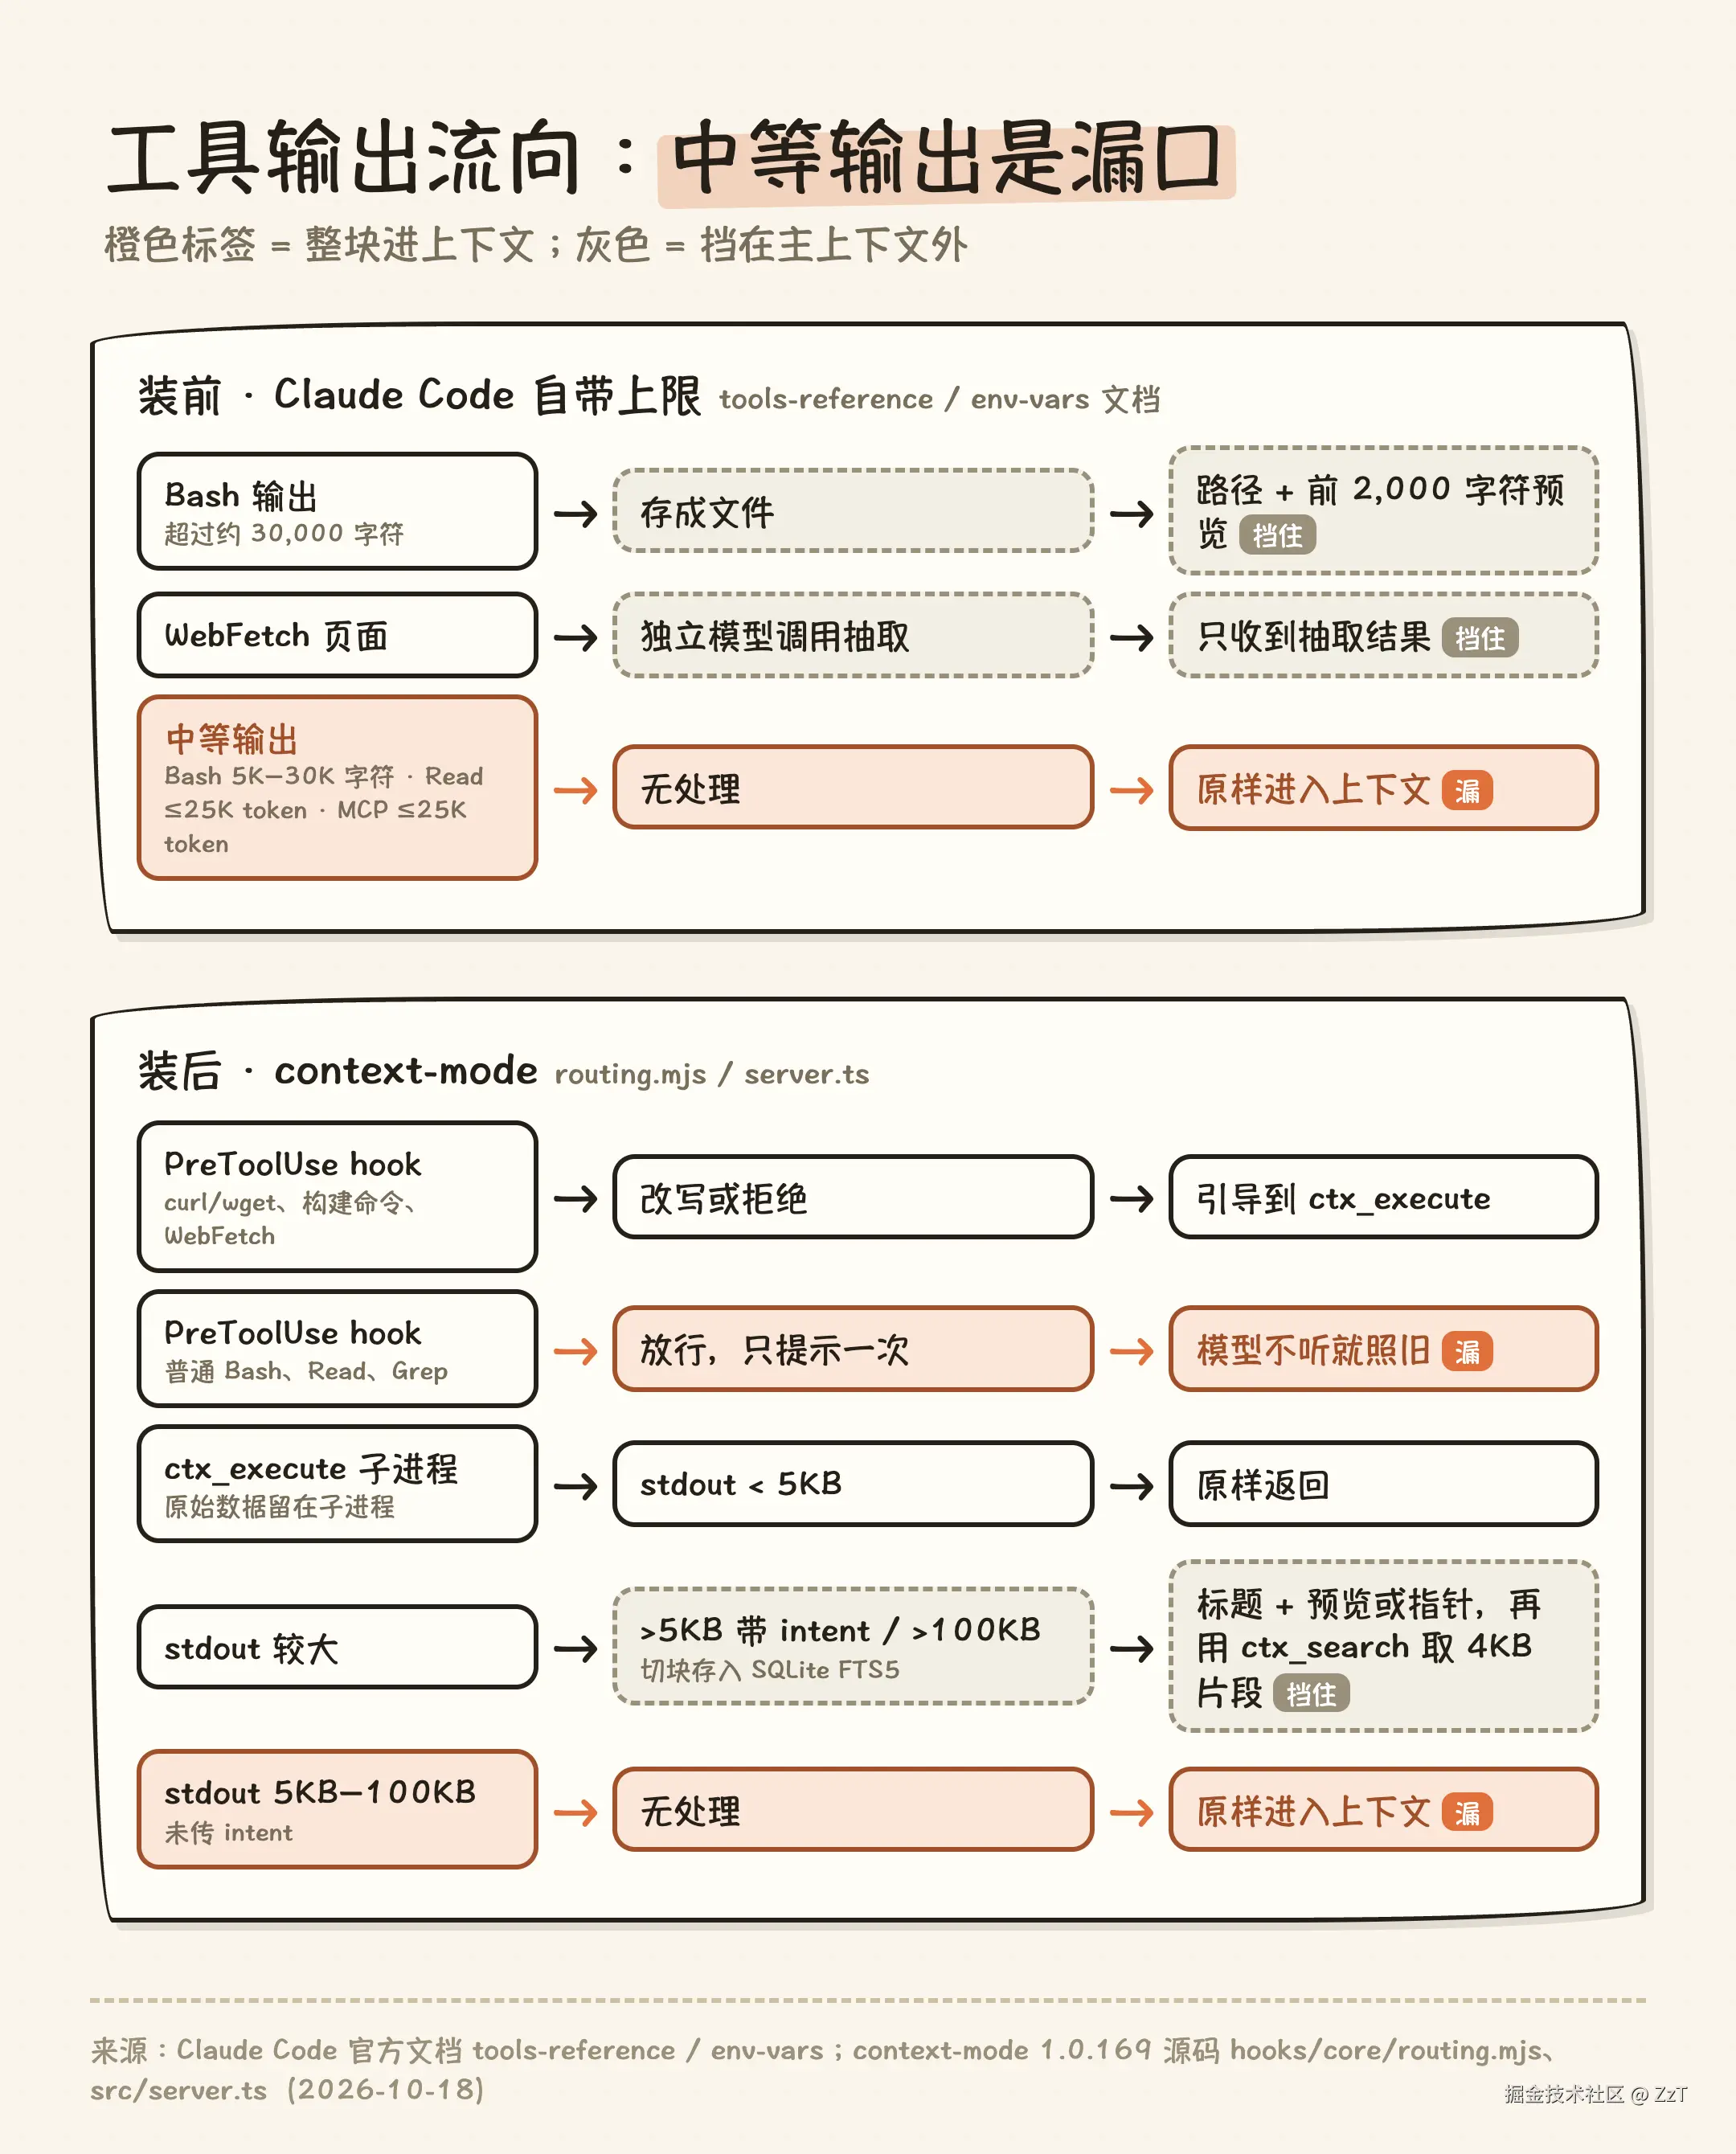
第一层是 hooks 路由,大部分是建议而不是拦截。 PreToolUse hook 的逻辑在 hooks/core/routing.mjs。真正被改写或拒绝的只有几类:输出到 stdout 的 curl/wget、命令里内联的 HTTP 请求(fetch(、requests.get()、gradle/mvn/sbt 构建命令,以及 WebFetch。普通 Bash 命令、Read 和 Grep 全部放行,只在本会话第一次调用时附一段提示,建议改用沙箱工具。直接给 hook 喂 cat access.log 可以验证:第一次返回提示,第二次返回空,命令照常执行。这意味着 Read 和 Bash 这两条最常用的路径能省多少,取决于模型是否听从提示改用 ctx_execute。README 自己的表格也给出了这个区别:有 hooks 约 98%,只有说明文件约 60%。
第二层是子进程沙箱,只回传 stdout。 ctx_execute 在独立子进程里运行模型写的代码,ctx_execute_file 把文件内容作为 FILE_CONTENT 变量注入子进程。原始数据留在子进程里,进入上下文的只有代码打印出来的内容,外加一段代码回显。这就是 README 说的「Think in Code」:模型不读 50 个文件,而是写一段统计脚本,只读脚本打印的结果。
stdout 本身也有分支,阈值写在 src/server.ts:
- 小于 5KB:原样返回。
- 大于 5KB 且调用时传了
intent:全文切块入库,只返回匹配段落的标题、首行预览和一张可搜索词表。 - 大于 100KB 且没传
intent:全文入库,只返回一句「Indexed N sections,用 ctx_search 查询」。 - 5KB 到 100KB 之间且没传
intent:原样返回,没有任何压缩。
最后一条容易被忽略。模型如果写了一个打印太多的脚本又没带 intent,几十 KB 照样进上下文。
第三层是 FTS5 检索,用来按需取回原文。 入库内容存在 ~/.claude/context-mode/content/<项目hash>.db,按 markdown 标题切块、代码块保持完整,单块上限 4KB。检索同时跑两路:porter 分词的 BM25 和 trigram 子串匹配,再用 RRF 合并排名。ctx_search 返回的是原文片段,不是摘要,所以需要精确代码或数字时,这条路径不会丢细节。
98% 的分子和分母
98% 出自 BENCHMARK.md 第一部分:14 个真实工具输出的 fixture,合计 315KB,经 ctx_execute_file 处理后剩 5.5KB。计算公式在 tests/ecosystem-benchmark.ts 第 466 到 467 行:
ini
savings = 1 − 脚本 stdout 字节数 / fixture 原始字节数有三处需要读者自己折算:
- 汇总脚本是作者预先写好的。 Playwright 场景的脚本专门用正则抽 Hacker News 的新闻标题,nginx 场景专门抽状态码和延迟。真实会话里这段脚本由模型现场写,第一次写偏了要重跑。
- 分子不含脚本本身。 模型写脚本要消耗输出 token,脚本还会作为工具调用参数留在上下文里,
ctx_execute返回时也会回显代码。这些都没有计入。 - 分母是全量原文。 前面已经说过,Claude Code 对 Bash 长输出和 WebFetch 本来就不会全量放进上下文。
同一份文档的第二部分换成 ctx_index + ctx_search 返回原文片段,节省率是 82%。在需要精确内容的场景,这个数字比 98% 更接近实际。
一份 56KB 页面快照的实测:89%,两次调用
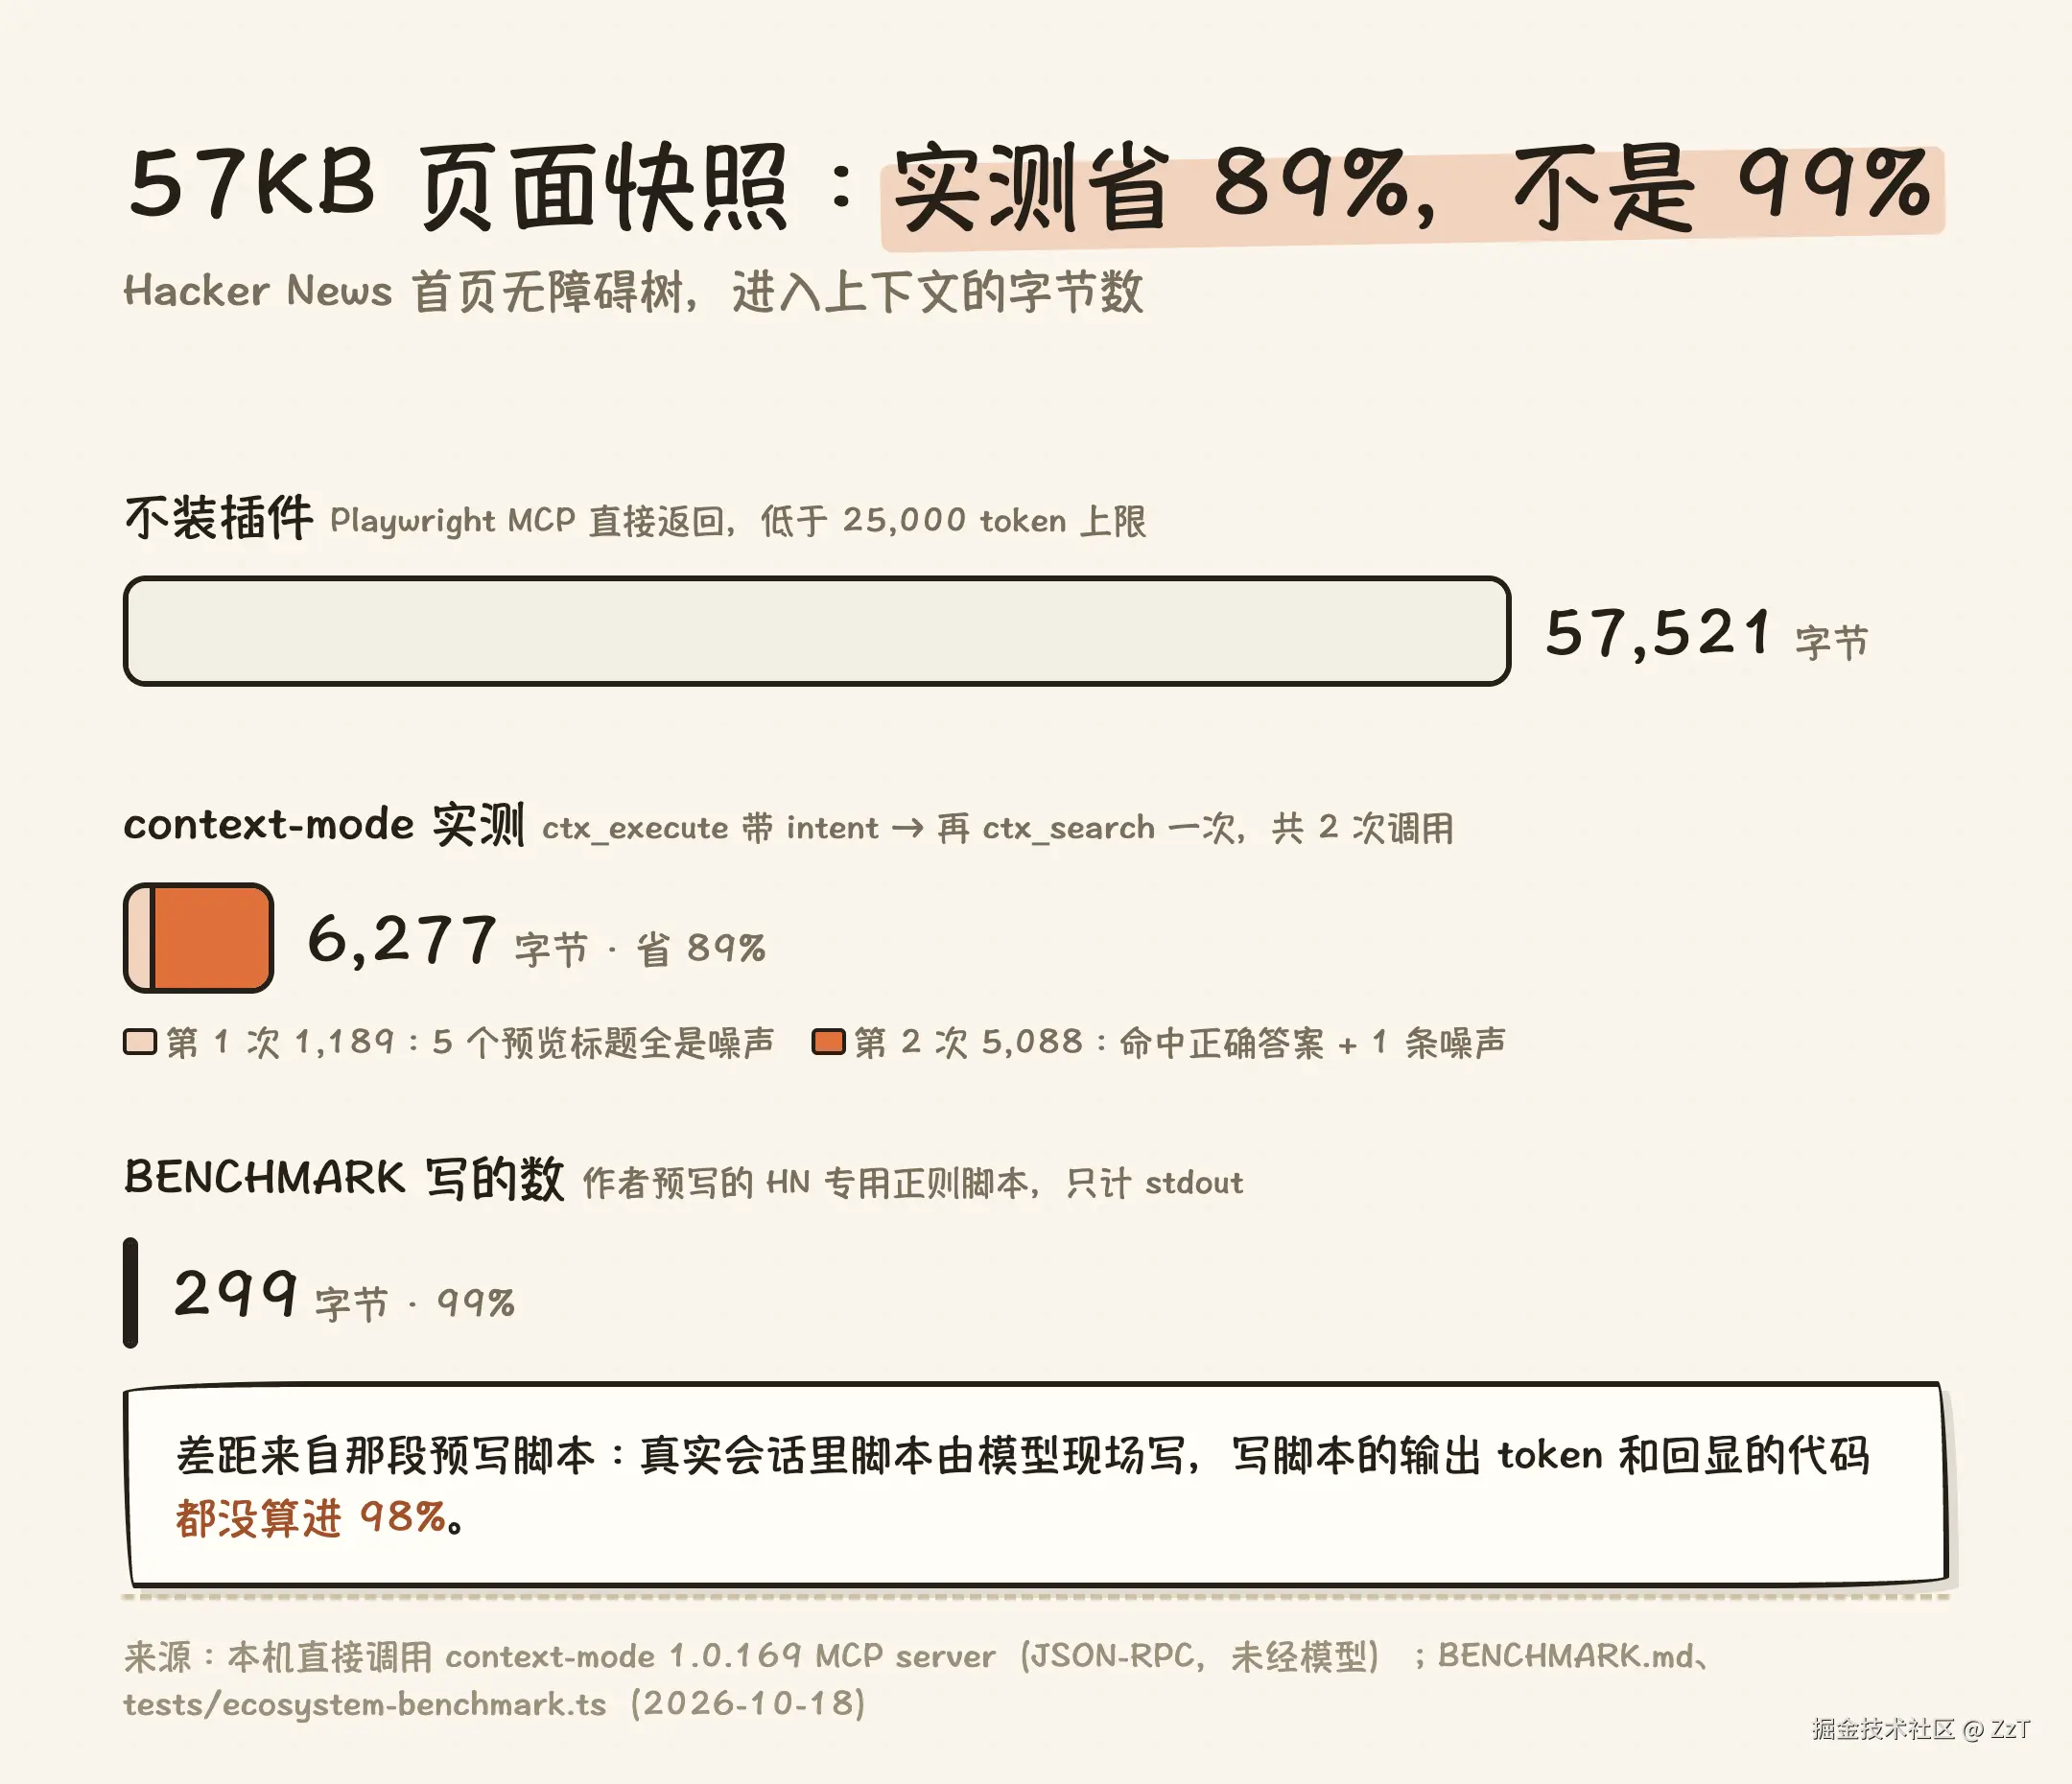
复现方法:不经过模型,直接通过 JSON-RPC 调用 context-mode 的 MCP server,CLAUDE_CONFIG_DIR 指向隔离目录。素材用仓库自带的 playwright-snapshot.txt,即 Hacker News 首页的无障碍树快照,57,521 字节。
第一步按 README 推荐的方式调用 ctx_execute,执行 cat 并带上 intent: "top stories titles points"。返回 1,189 字节,号称匹配了 5 个段落,但段落标题是 - text: )、- generic [ref=e251]: 这类无意义的行。原因是无障碍树不是 markdown,没有标题可切,切块时只能拿块的第一行当标题。只看这次返回,模型拿不到任何新闻标题。
第二步按提示用 ctx_search 查一条具体新闻的分数和评论数。返回 5,088 字节,第一条结果正确,给出了标题、50 points 和 38 comments;第二条是另一条新闻的分数行,属于噪声。
两步合计 6,277 字节,比原文少 89%。BENCHMARK 对同一份 fixture 写的是 299 字节、99%,差别全部来自那段预先写好、专门针对 Hacker News 页面结构的正则脚本。
这次没有用 claude -p 跑装前装后的完整会话对比,所以没有端到端的 token 账单,89% 只覆盖「一份大输出进上下文」这一个环节。
会话记忆:compact 之后用 SQLite 快照接上
上下文省下来,是为了让会话少 compact、晚 compact。context-mode 的第二个功能处理 compact 之后的事。PostToolUse 和 UserPromptSubmit 两个 hook 把文件读写、git 操作、报错、用户的纠正(「用 X 不要用 Y」)写进每个项目一份的 SQLite。PreCompact 触发时生成一份快照,SessionStart 在 compact 或 resume 之后把它注入上下文,内容包括最后一次请求、任务清单、改过的文件和未解决的错误,详细记录仍留在库里供 ctx_search 查。
这里文档和代码不一致。README 说快照有 2KB 预算、超出时先丢低优先级事件;src/session/snapshot.ts 的注释写的是所有非空分类全部输出,没有字节预算,maxBytes 参数保留只为兼容、实际忽略。另外,不带 --continue 开新会话时,上一个会话的记录会被直接清掉。
装之前要知道的固定开销和副作用
- 每个会话固定多出约 4.6KB。 SessionStart hook 注入的路由说明实测 4,631 字节,不管这个会话用不用大输出工具都要付。
- 11 个工具定义合计 30KB。 Claude Code 默认开启 tool search,MCP 工具定义延迟加载,首轮只占工具名;但模型第一次调用前要先走一次 ToolSearch 把定义拉进来。
- 会改全局配置。 插件的启动脚本
start.mjs每次启动都会在~/.claude/hooks/写一个自愈脚本,并在~/.claude/settings.json的 SessionStart 里注册它。 ctx_execute_file只能读项目根目录以内的文件,越界会被拒绝,需要在权限设置里单独放行。- 许可证是 Elastic License 2.0,不是 MIT 或 Apache,公司内二次分发前要看条款。
对照:billion-context 压缩的是对话历史
同一周起量的 billion-context 走的是另一条路。它是一个本地代理,Claude Code 的 base URL 指向它,它在请求里注入 compress、decompress、search_context 等工具,由模型自己决定把哪一段历史消息折叠成摘要,需要细节时再展开。原文存在本机 ~/.local/share/billion-context/。
两者处理的是上下文的两个不同部分:context-mode 让工具输出一开始就不进来,billion-context 把已经进来的历史压掉。前者不碰模型请求,后者要接管所有模型流量,同一台机器上各实例共享同一份存储,没有按会话鉴权。README 标语里的「省 5 倍 token」没有给出测法,论文给的是 17 万次模型调用的生产统计,而不是对照实验。
什么时候值得装
| 会话特征 | 判断 |
|---|---|
| 大量使用 Playwright、GitHub 等 MCP 工具 | 值得。这类输出在 25,000 token 以内会整块进上下文,是收益最大的一段 |
| 反复跑测试或构建,单次输出在 5,000 到 30,000 字符 | 值得。前提是模型确实改用 ctx_execute 并只打印失败项 |
| 同一份文档要查很多次 | 值得。索引一次,之后每次只取几个 4KB 片段 |
| 主要在读文件、改文件 | 收益有限。Edit 需要原文在上下文里,Read 也只是被建议而不是被拦截 |
| 需要精确查找细节(某一行、某个数字) | 要多一次检索往返;非 markdown 输出的预览标题可能全是噪声 |
| 短任务、少量工具调用 | 不值得。每个会话固定的 4.6KB 加 hook 开销可能比省下的多 |
context-mode 的工程判断是对的:大输出的处理应该交给代码,而不是交给上下文窗口。它的营销数字则需要打折。98% 是用预写脚本对着全量原文算出来的,装进 Claude Code 之后,前一部分要模型自己写,后一部分 Claude Code 已经替你挡掉了一截。值不值得装,取决于你的会话里有多少 MCP 和中等长度的命令输出,而不是那个百分比。
- context-mode:github.com/mksglu/cont...
- billion-context:github.com/ranxianglei...
- 想先看自己的会话 token 花在哪个工具上,可以用 cc-statistics 统计本机会话日志:github.com/androidZzT/...