金融合规问答助手-RAG查询路由落地
峰哥AI手记 · 金融合规 RAG 实战(第 8 篇)
上篇讲了"查询路由"的设计:W6 的 A/B 证明改写是按查询类型增益------口语化单文档题 hit@4 从 90% 拉到 100%,但跨文档综合题反而从 100% 掉到 80%。所以"是否改写"不该是全局开关,而该在检索前先判断这条查询"像不像需要改写的口语题"。
这篇记录实际落地:一个朴素路由规则 + 一份领域术语表 + 三路 A/B 评估,把上一篇里"理想路由 100%"的推演换成真实数字。
一、路由到底路由什么
路由不做检索,只在检索前决定"这条查询走哪条链路":
css
用户问题
   │
   ├─[route() 路由分类器]── 判断查询特征 ──┐
   │                                      │
   ▼                                      ▼
[hybrid]                            [hybrid + rewrite]
 (精确/专业术语,不改写)            (口语化,先 LLM 改写再检索)
   │                                      │
   └──────────────┬───────────────────────┘
                  ▼
            重排 + 生成(永远看用户原文)
关键约束(沿用前面几周立下的纪律):
- 路由只决定链路,不改写问题本身------和改写那条原则一致,答题 LLM 永远看用户原文,改写只发生在检索侧。
- 路由必须可降级 ------分类器任何异常,默认走
hybrid(W6 基线,最稳),不让路由成为可用性瓶颈。 - 路由要可量化 ------和前面几周一样,路由规则改动必须能跑
evaluate_w8.py出数字对比。
这一周复用的是 W6 的完整检索链路(向量 + BM25 + RRF + CrossEncoder 重排 + 查询改写),只在前头加了一个 route()。独立的 rag_w8.py,向量库 chroma_db_w8/,不和前面的周互相污染。
二、朴素路由的三条信号
用三个"零成本"信号,按优先级短路判断(命中即返回,不继续算):
信号 1:聚合/对比词 → 保广度,走 hybrid 跨文档综合题往往含"全流程""分别""对比""结合""综合"等聚合词。这类题改写容易把召回面压窄。直接命中 AGG_WORDS 集合就走 hybrid。
信号 2:术语密度 → 用户已用文档语言,走 hybrid 维护一张 data/glossary.txt(从三份 PDF 抽的 43 条高频专业词:个人金融信息、委托处理、适当性、穿透式登记......)。统计问题里命中术语的字符数占比:
python
def term_density(query, terms):
    hit = sum(len(t) for t in terms if t in query)
    return hit / max(1, len(query))   # ∈ [0,1]
密度 ≥ 0.30 就认为"用户已经在用监管术语提问",改写要么画蛇添足、要么引入歧义,走 hybrid。
信号 3:否则口语化 → 走 hybrid+rewrite 前两条都不命中,说明是"外包公司处理客户资料"这种口语题,交给 W6 的改写链路提成文档术语。
python
def route(query):
    if any(w in query for w in AGG_WORDS):
        return "hybrid"
    if term_density(query, DOMAIN_TERMS) >= 0.30:
        return "hybrid"
    return "hybrid+rewrite"
阈值 0.30 是拍的第一个数,A/B 跑完看效果再调(详见第五节)。
三、代码怎么接
rag_w8.py 里路由只新增了 route() 和 ask(question, auto_route=True),其余全复用 W6:
python
def ask(question, mode="hybrid", rewrite=None, auto_route=False):
    decision = None
    if auto_route:
        decision = route(question)
        rewrite = (decision == "hybrid+rewrite")
    elif rewrite is None:
        rewrite = False
    # 之后和 W6 完全一致:改写(可选) → 混合检索 → 重排 → 生成
    ...
    meta = {"mode": mode, "rewrite": rewrite,
            "rewritten_query": ..., "route": decision}
    return answer, retrieved, meta
meta["route"] 把路由决策带出来,方便回归时看"这道题分到了哪条链路、分对没"。 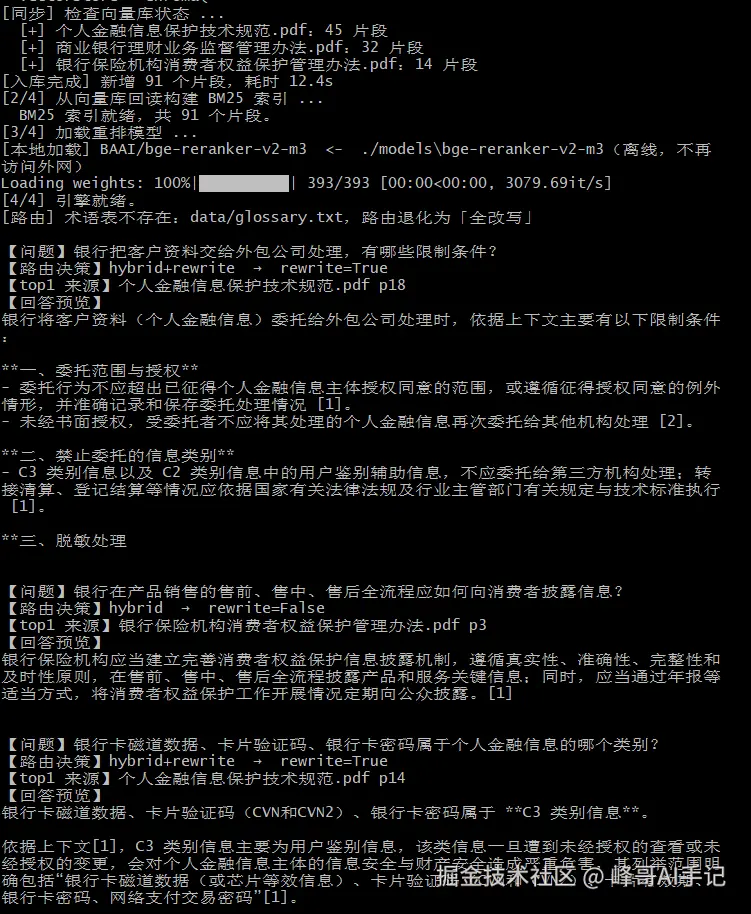
evaluate_w8.py 跑三路:hybrid(固定不改写)、hybrid+rewrite(固定全改写)、route(按 route() 决策)。三路共用同一份 eval_set_v2.json(30 题 = 20 正例 + 10 负例),唯一变量就是"改不改写"。
四、三路 A/B 结果(真实数字)
evaluate_w8.py --retrieval-only 跑完,三路对比(正例 20 题,k=2/4/8):
| 模式 | hit@2 | hit@4 | hit@8 | MRR |
|---|---|---|---|---|
| hybrid(基线,不改写) | 90.00% | 95.00% | 95.00% | 0.912 |
| +rewrite(全改写) | 100% | 100% | 100% | 0.975 |
| route(W8 路由) | 100% | 100% | 100% | 1.000 |
按难度拆 hit@4:
| 难度 | hybrid | +rewrite | route |
|---|---|---|---|
| keyword(5 题) | 100% | 100% | 100% |
| paraphrase(10 题) | 90% | 100% | 100% |
| cross(5 题) | 100% | 100% | 100% |
核心看点:路由把 W6 的 trade-off 完全拉平了------paraphrase 档守住 +rewrite 的 100%,cross 档也稳在 100%,整体 hit@4 从基线 95% 提到 100%,MRR 从 0.912 提到 1.000。
一个要说明的细节:本次重跑里 +rewrite 路的 cross 档也是 100%,和文章 7 引用的 W6 那次 80% 不一致。原因在第五节------改写本身是非确定的,跨文档题用改写有波动风险;路由的价值恰恰是用稳定规则把这类风险消掉,而不是赌某次改写的运气。
五、bad case:路由分对了吗
先看结论:路由零误判,20/20 全部 rank=1,MRR=1.000。
逐题看 route 的决策,分流是干净的:
- keyword 题:id1/id5(密度高)走 hybrid,id2/3/4(密度低)走 rewrite------都 rank=1;
- paraphrase 题(id6--12、21--23):全部走 rewrite------都 rank=1;
- cross 题:id13/id17 走 hybrid,id14/15/16 走 rewrite------都 rank=1。
路由最关键的防守在 id13 :「银行在产品销售的售前、售中、售后全流程应如何向消费者披露信息?」含聚合词"全流程",被路由锁死在 hybrid,rank=1。而强制 +rewrite 路里,这道题这次只排到 rank=2(W6 那次评估甚至直接 miss,hit@4=0)。也就是说,改写对跨文档题是非确定的------有时排第 2,有时干脆 miss;路由用"聚合词"这个稳定信号把它拦在 hybrid 外,波动风险直接归零。这正是对文章 7 那个 −20pp 的实打实防御。
残留的结构性隐患:id14/15/16 也是跨文档题,但既没有聚合词、术语密度也低于 0.30,被路由分到了 rewrite。本次它们改写后恰好命中(rank=1),可一旦 DeepSeek 改写这批题时像 id13 那样波动,就会重现 W6 的 −20pp。规则对"无聚合词的跨文档题"还缺一个专属信号------这正是文章 7 第六节预言的"路由分错比无脑改写更糟"的真实缺口,也是 W9 语义路由要补的刀。
route 相对 +rewrite 的边际收益就在 id13:MRR 0.975 → 1.000,差距就是这道题从 rank=2 被提回 rank=1。路由不是让更多题"命中",而是让已命中的题"排到第一"。
六、路由的成本与边界
- 延迟:规则版路由近乎零成本(几次字符串包含判断 + 一次密度统计),相比一次 CrossEncoder 重排可以忽略。
- 误判代价 :路由分错比"无脑改写"更糟------把跨文档题误分到
rewrite会直接重现 W6 的 −20pp。所以规则从"保守"起步:宁可少改写,不要误改写跨文档题。 - 术语表维护 :
glossary.txt要随语料更新。下一周可以写个脚本从data/*.pdf自动抽高频专业词,减少手工。 - 可观测 :每次路由决策记进
meta,回归时能直接定位误判题,而不是只看总分。
量化是这条系列的命根子。量化体检、查询改写、查询路由,串起来就是一条"用数字驱动每一刀优化"的主线。下一篇见。
若这篇文章对您有一点点帮助或启发,欢迎点赞 / 评论 / 收藏,与君共进步。