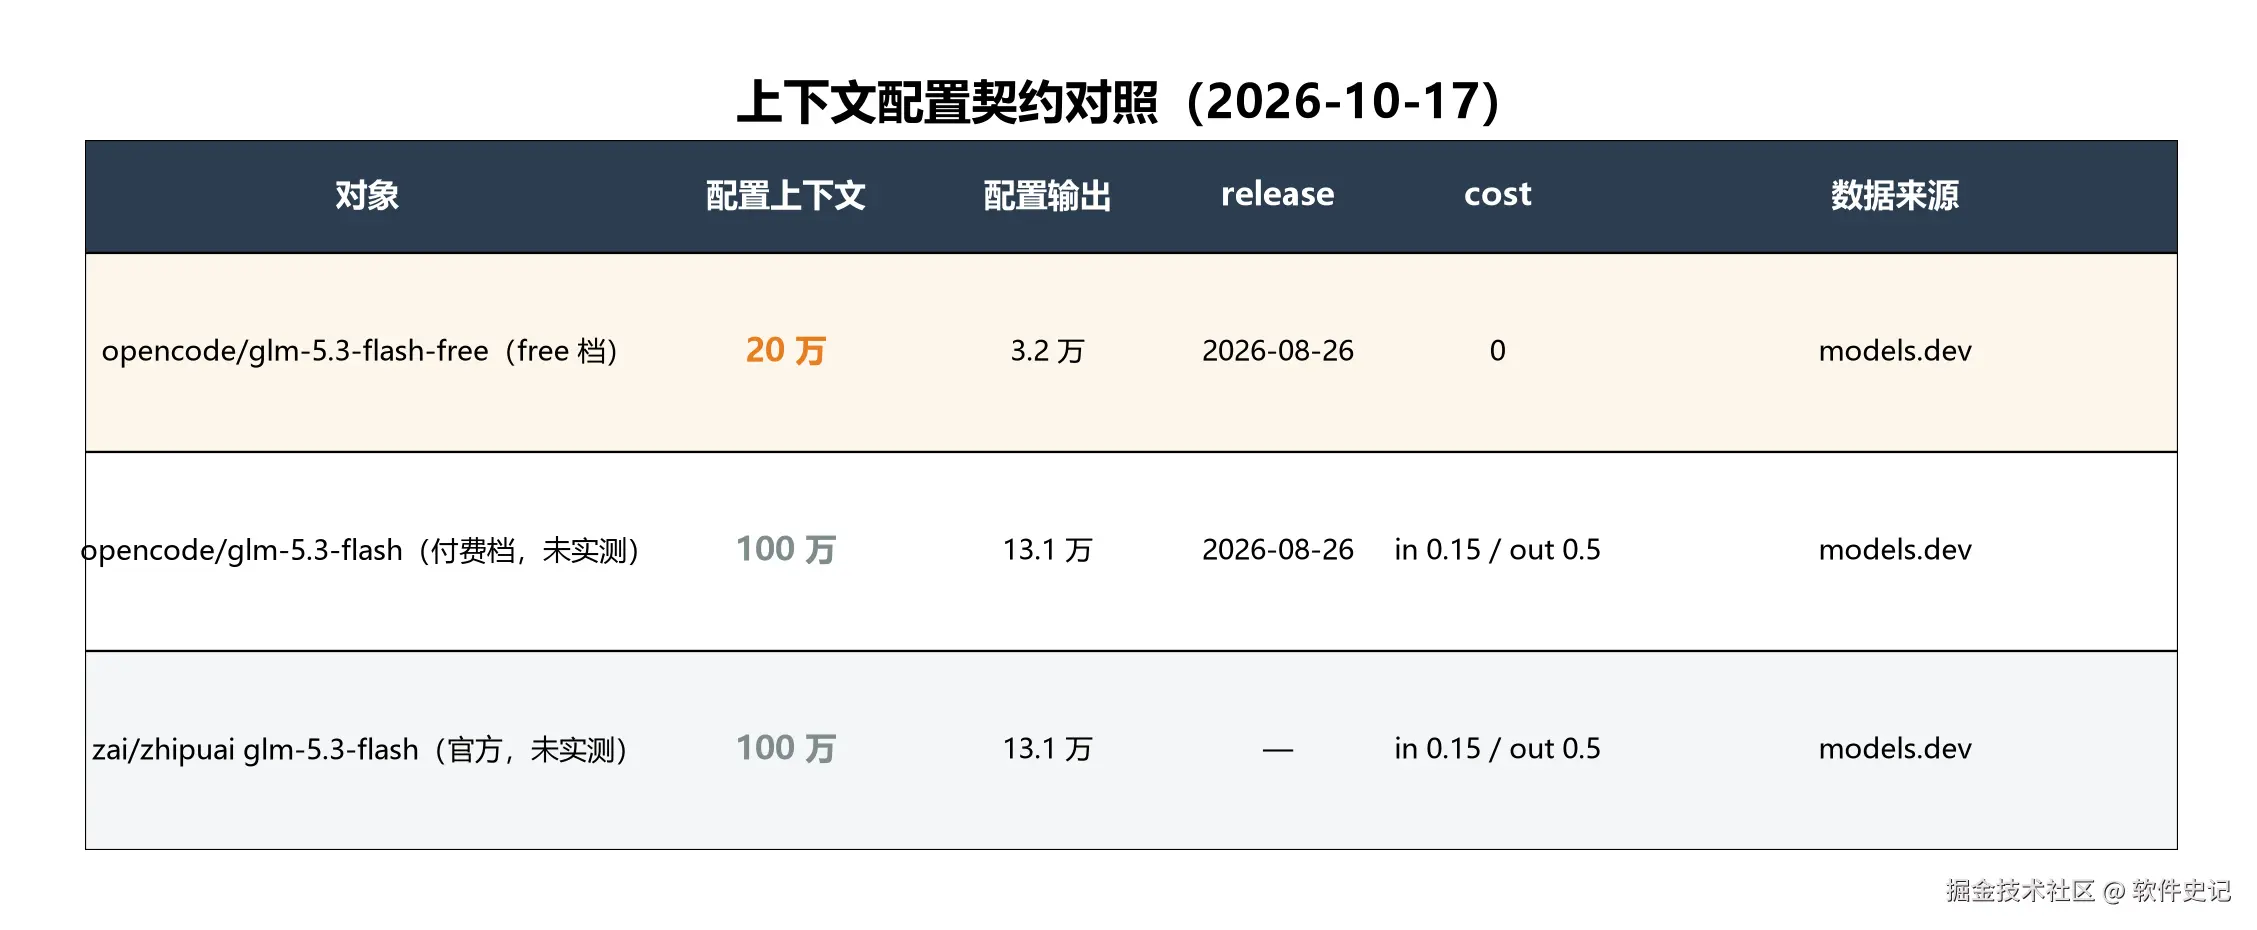
GLM-5.3-Flash Free 是 opencode 10 月 16 号刚上架的免费模型,配置里写的是 20 万上下文、3.2 万输出;同一型号的付费档,models.dev 标着 100 万。这两个数差这么多,我忍不住把它拉到真机上实测了一轮。
先说结论
免费档的 20 万上下文,是客户端软限制,不是服务端硬限制。
验证的办法很直接:我拿默认 20 万配置,发了一个 27 万 tokens 的请求。服务端并没有拒绝,把 27 万照单收下,是 opencode 客户端自己把上下文压缩了再继续跑,最后藏在文末的秘密词居然还是找回来了。服务端那头,没有在 20 万这个数上设硬闸。
实测:上限放开后,服务端照单全收
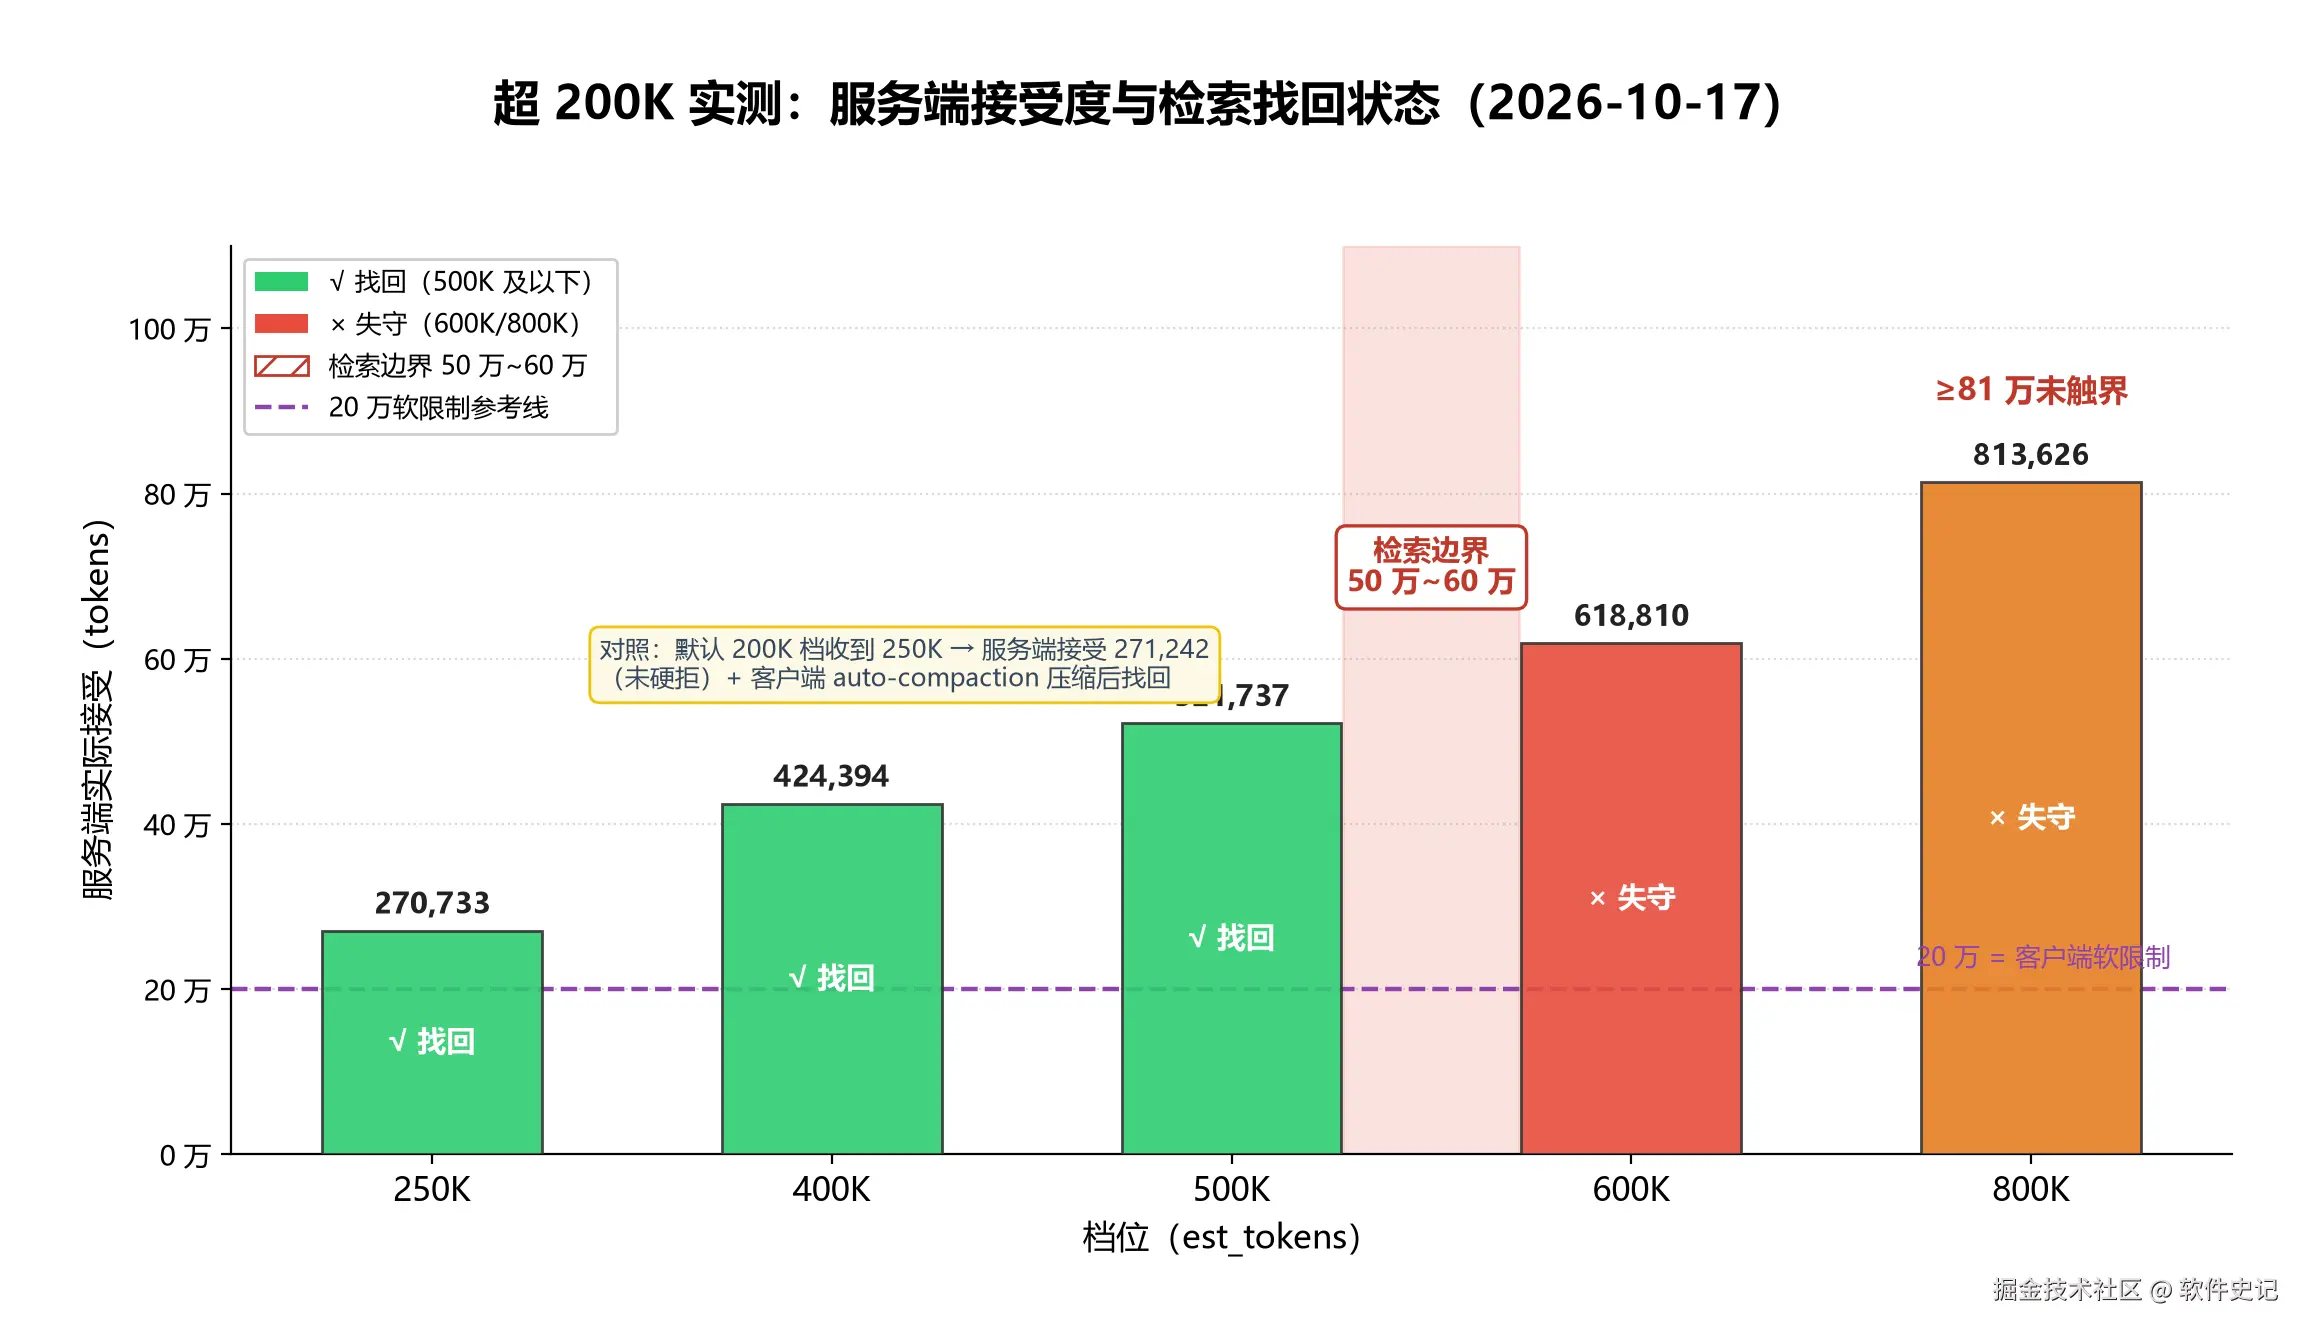
所以我把免费档的默认上限直接放开,再看:25 万、40 万、50 万、60 万、80 万的请求,服务端全部照单全收,实际吃进去 27.1 万、42.4 万、52.2 万、61.9 万、81.4 万 tokens,没有一个返回 400 或长度拒绝。也就是说,这个 20 万只是平台挂在免费档上的配置,真正生效的是客户端那层。
转折:接得下,不等于找得回
不过,服务端接得下,和模型找得回,是两回事。我在几十万 tokens 的填充文本尾部藏了个秘密词让它找:50 万档找回了,60 万档没找回(输出一通分析,就是不给词),80 万档服务端接受 81.4 万正常跑完,模型却回了个无关填充词。检索能力边界大致落在 50 万~60 万之间。顺带一句,上一篇我用同一套方法测 DeepSeek V4.1 Flash Free,80 万档是找回来的(831,272);这次没找回。两个模型毕竟不是同一道题,谁高谁低不好下定论,我只把这次测到的差异摆出来。
它还是那个 GLM
其它方面,这个免费档用起来还是"那个 GLM":模板特殊符号 5/5 原样回显、推理/事实/中文/结构化 10 项全过、三种思考档位都认,自报身份也是 GLM-5.3-Flash、底模智谱 GLM。只有一点没对上:它自己说上下文是 12.8 万,跟配置里写的 20 万不一致,暂时没弄清楚为啥------这种自报的数,当个参考就行。
所以,现在要不要用它
普通编码、日常任务直接开用------免费、行为正常;真想塞大文档,50 万 tokens 以内稳,60 万往上容易"接得住却找不回";80 万级任务别指望它检索。另外两点:这个免费档 10 月 16 号刚上架,上游随时可能调整配置,想试趁早;付费档和官方端点的 100 万,我这回没实测,只是它们标出来的,别当成已经验证过的数。