前面讲了 Flink SQL 的 TableEnvironment、Table API、查询与过滤、分组与聚合、自定义 UDF,这些都是无状态或有状态的基础操作。但流处理有一个核心问题:无界流上的聚合怎么做? 如果没有窗口,全局聚合的状态会无限增长,永远不会输出最终结果。这时候就需要 Window(窗口)------把无界流按时间切分成有限大小的"桶",对每个桶内的数据做聚合,状态被限制在窗口范围内,可自动清理。
Table Window 是 Flink Table API / SQL 中的窗口机制,支持两种 API 风格:分组窗口(Grouped Window,旧 API)和窗口表值函数(Windowing TVF,Flink 1.13+ 推荐的新 API)。很多同学对这两种 API 的区别搞不清楚,也不了解窗口内部的执行机制、窗口 TopN、窗口 Join 这些高级用法。
这篇从 Table Window 本质定义、两种 API 风格对比、四种窗口类型(滚动/滑动/会话/累积)、窗口属性三列、内部执行机制、窗口聚合、窗口 TopN、窗口 Join、完整代码实现、六个常见坑、八条最佳实践,把 Table Window 一次性讲透。
一、Table Window 本质定义与两种 API 风格
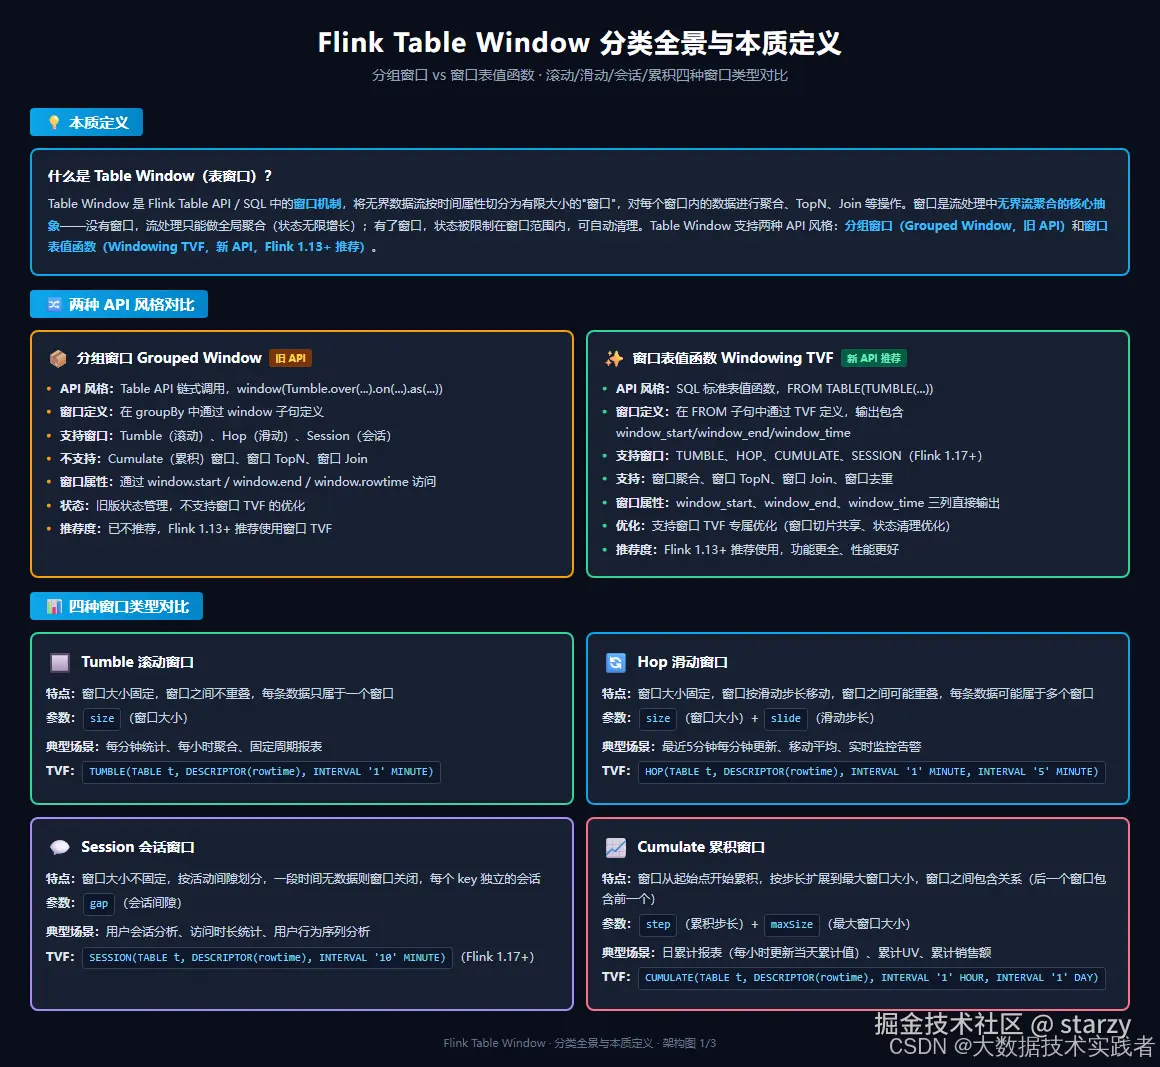
Table Window 的本质一句话概括:将无界数据流按时间属性切分为有限大小的"窗口",对每个窗口内的数据进行聚合、TopN、Join 等操作,是流处理中无界流聚合的核心抽象。
下面这张图把 Table Window 本质定义、两种 API 风格对比、四种窗口类型放在一起展示。
1.1 为什么需要窗口
流处理的数据是无界的------数据持续到达,没有终点。如果做全局聚合(如统计所有订单的总金额),状态会无限增长,而且永远不会输出"最终结果"(因为数据还在来)。窗口解决了这个问题:
- 状态可控:每个窗口的状态是有限的,窗口结束后可自动清理。
- 结果可输出:窗口结束时(Watermark 到达 window_end)输出该窗口的聚合结果。
- 业务语义清晰:按时间窗口统计(每分钟、每小时)是最常见的业务需求。
1.2 两种 API 风格对比
Flink Table API / SQL 提供了两种窗口 API 风格:
| 维度 | 分组窗口 Grouped Window(旧 API) | 窗口表值函数 Windowing TVF(新 API 推荐) |
|---|---|---|
| API 风格 | Table API 链式调用 | SQL 标准表值函数 |
| 语法 | window(Tumble.over(...).on(...).as(...)) | FROM TABLE(TUMBLE(...)) |
| 支持窗口 | Tumble、Hop、Session | TUMBLE、HOP、CUMULATE、SESSION(1.17+) |
| 窗口 TopN | 不支持 | 支持 |
| 窗口 Join | 不支持 | 支持 |
| 窗口去重 | 不支持 | 支持 |
| 窗口属性 | window.start / window.end / window.rowtime | window_start / window_end / window_time 三列 |
| 优化 | 旧版状态管理 | 窗口切片共享、状态清理优化、两阶段聚合 |
| 推荐度 | 已不推荐 | Flink 1.13+ 推荐使用 |
核心结论:新业务一律用窗口表值函数(Windowing TVF),功能更全(支持 Cumulate、窗口 TopN、窗口 Join)、性能更好(窗口切片共享、状态清理优化)。分组窗口是旧 API,仅在维护老代码时需要了解。
二、四种窗口类型详解
2.1 Tumble 滚动窗口
滚动窗口的窗口大小固定,窗口之间不重叠,每条数据只属于一个窗口。
- 参数:size(窗口大小)
- 典型场景:每分钟统计订单数、每小时销售额、固定周期报表
- 窗口分配:timestamp / size 向下取整,每条数据只分配到一个窗口
sql
-- 每分钟统计订单数和总金额
SELECT
  window_start,
  window_end,
  COUNT(*) AS order_cnt,
  SUM(amount) AS total_amount
FROM TABLE(
  TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
)
GROUP BY window_start, window_end;
2.2 Hop 滑动窗口
滑动窗口的窗口大小固定,窗口按滑动步长移动,窗口之间可能重叠,每条数据可能属于多个窗口。
- 参数:size(窗口大小)+ slide(滑动步长)
- 典型场景:最近 5 分钟每分钟更新、移动平均、实时监控告警
- 窗口分配:每条数据分配到 size/slide 个窗口
- 注意:slide 必须 ≤ size,否则窗口之间有间隙,间隙数据被丢弃
sql
-- 最近5分钟的订单数,每分钟更新一次(slide=1分钟, size=5分钟)
SELECT
  window_start,
  window_end,
  COUNT(*) AS order_cnt
FROM TABLE(
  HOP(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE, INTERVAL '5' MINUTE)
)
GROUP BY window_start, window_end;
2.3 Session 会话窗口
会话窗口的窗口大小不固定,按活动间隙划分,一段时间无数据则窗口关闭,每个 key 独立的会话。
- 参数:gap(会话间隙)
- 典型场景:用户会话分析、访问时长统计、用户行为序列分析
- 窗口分配:动态分配,根据数据间隙合并或切分窗口,每个 key 独立
- 注意:Flink 1.17+ 才支持 SESSION TVF,之前版本只能用分组窗口
sql
-- 用户会话分析,10分钟无操作则会话结束
SELECT
  user_id,
  window_start,
  window_end,
  COUNT(*) AS action_cnt
FROM TABLE(
  SESSION(TABLE user_actions, DESCRIPTOR(action_time), INTERVAL '10' MINUTE)
)
GROUP BY user_id, window_start, window_end;
2.4 Cumulate 累积窗口
累积窗口从起始点开始累积,按步长扩展到最大窗口大小,窗口之间是包含关系(后一个窗口包含前一个窗口的数据)。
- 参数:step(累积步长)+ maxSize(最大窗口大小)
- 典型场景:日累计报表(每小时更新当天累计值)、累计 UV、累计销售额
- 窗口分配:每条数据属于多个包含关系的窗口
- 优势:相比滑动窗口,累积窗口利用前一个窗口的结果增量计算,避免重复聚合
sql
-- 日累计销售额,每小时更新一次(step=1小时, maxSize=1天)
SELECT
  window_start,
  window_end,
  SUM(amount) AS cumulative_amount
FROM TABLE(
  CUMULATE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' HOUR, INTERVAL '1' DAY)
)
GROUP BY window_start, window_end;
三、窗口属性三列
窗口表值函数(TVF)的输出自动包含三列窗口属性:
| 列名 | 类型 | 含义 |
|---|---|---|
| window_start | TIMESTAMP | 窗口起始时间(包含),如 10:00:00 |
| window_end | TIMESTAMP | 窗口结束时间(排他),如 10:01:00 |
| window_time | TIMESTAMP | 窗口时间属性列,等于 window_end - 1ms |
关键点:
- window_end 是排他的:窗口范围是 [window_start, window_end),Watermark 到达 window_end 时触发窗口计算。
- window_time 的作用:可用于后续窗口嵌套(如小时窗口内的分钟窗口),或作为 Watermark 传递的时间属性列。
- 窗口聚合必须按 window_start, window_end 分组:GROUP BY 中必须包含这两列(以及分组 key),否则报语法错误或结果不正确。
- 窗口嵌套:window_time 列可作为下一层窗口的时间属性,实现多级窗口(如先按分钟聚合,再按小时汇总)。
四、Window 内部机制与执行原理
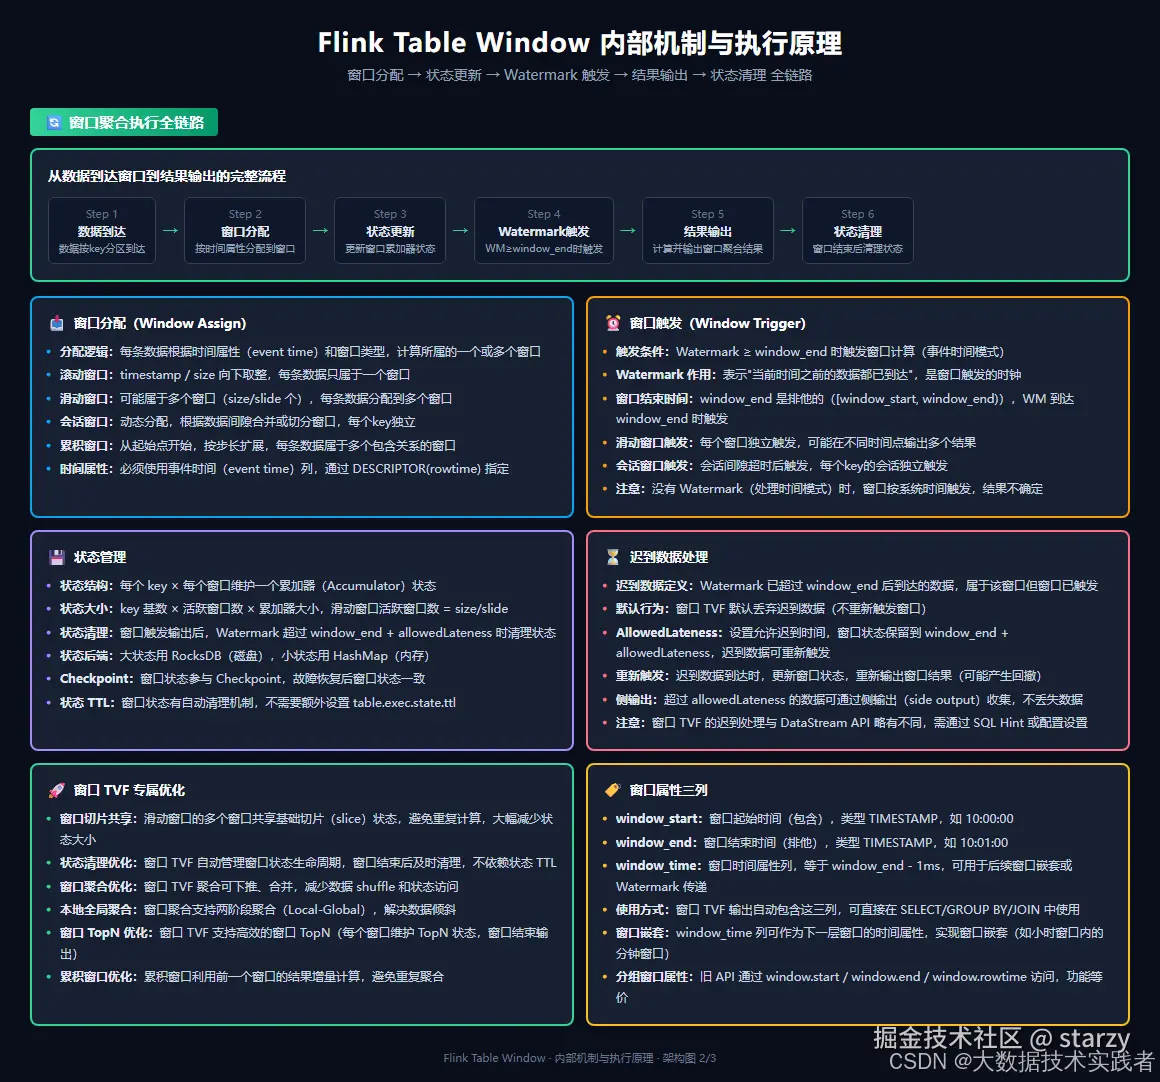
理解窗口的内部执行机制,才能写出高性能、稳定的窗口作业。下面这张图把窗口聚合执行全链路、六大核心机制放在一起展示。
4.1 窗口聚合执行全链路六步
从数据到达窗口到结果输出,完整流程分为六步:
- 数据到达:数据按 key 分区到达窗口算子。
- 窗口分配:根据时间属性和窗口类型,计算数据所属的一个或多个窗口。
- 状态更新:更新对应窗口的累加器(Accumulator)状态。
- Watermark 触发:Watermark ≥ window_end 时,触发窗口计算。
- 结果输出:从累加器提取聚合结果,输出窗口聚合行。
- 状态清理:窗口结束后(超过 allowedLateness),清理窗口状态。
4.2 窗口分配(Window Assign)
每条数据根据事件时间(event time)和窗口类型,计算所属的窗口:
- 滚动窗口:timestamp / size 向下取整,每条数据只属于一个窗口。
- 滑动窗口:可能属于多个窗口(size/slide 个),每条数据分配到多个窗口。
- 会话窗口:动态分配,根据数据间隙合并或切分窗口,每个 key 独立。
- 累积窗口:从起始点开始,按步长扩展,每条数据属于多个包含关系的窗口。
必须使用事件时间列 ,通过 DESCRIPTOR(rowtime) 指定。处理时间(PROCTIME)窗口按系统时间触发,结果不确定,生产环境不推荐。
4.3 窗口触发(Window Trigger)
事件时间模式下,Watermark ≥ window_end 时触发窗口计算。Watermark 表示"当前时间之前的数据都已到达",是窗口触发的时钟。
- window_end 是排他的([window_start, window_end)),WM 到达 window_end 时触发。
- 滑动窗口每个窗口独立触发,可能在不同时间点输出多个结果。
- 会话窗口在会话间隙超时后触发,每个 key 的会话独立触发。
- 没有 Watermark 时窗口永远不触发,这是最常见的坑------DDL 中必须为事件时间列定义 Watermark。
4.4 状态管理
- 状态结构:每个 key × 每个窗口维护一个累加器(Accumulator)状态。
- 状态大小:key 基数 × 活跃窗口数 × 累加器大小。滑动窗口活跃窗口数 = size/slide,所以滑动窗口状态比滚动窗口大。
- 状态清理:窗口触发输出后,Watermark 超过 window_end + allowedLateness 时清理状态。窗口 TVF 自动管理状态生命周期,不需要额外设置 table.exec.state.ttl。
- 状态后端:大状态用 RocksDB(磁盘),小状态用 HashMap(内存)。
- Checkpoint:窗口状态参与 Checkpoint,故障恢复后窗口状态一致。
4.5 迟到数据处理
迟到数据是指 Watermark 已超过 window_end 后到达的数据,属于该窗口但窗口已触发。
- 默认行为:窗口 TVF 默认丢弃迟到数据(不重新触发窗口)。
- AllowedLateness:设置允许迟到时间,窗口状态保留到 window_end + allowedLateness,迟到数据可重新触发窗口,更新结果(可能产生回撤)。
- 侧输出:超过 allowedLateness 的数据可通过侧输出(side output)收集,不丢失数据。
- 注意:窗口 TVF 的迟到处理与 DataStream API 略有不同,需通过 SQL Hint 或配置设置。
4.6 窗口 TVF 专属优化
窗口 TVF 相比分组窗口有几个专属优化,性能更好:
- 窗口切片共享:滑动窗口的多个窗口共享基础切片(slice)状态,避免重复计算,大幅减少状态大小。这是滑动窗口性能的关键优化。
- 状态清理优化:窗口 TVF 自动管理窗口状态生命周期,窗口结束后及时清理。
- 两阶段聚合:窗口聚合支持 Local-Global 两阶段聚合,解决数据倾斜。
- 窗口 TopN 优化:每个窗口只维护 TopN 状态,窗口结束输出,性能好。
- 累积窗口增量计算:利用前一个窗口的结果增量计算,避免重复聚合。
五、窗口聚合代码实现
窗口聚合是最常用的窗口操作,语法:窗口 TVF + GROUP BY window_start, window_end + 聚合函数。
java
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import java.time.ZoneId;

public class WindowAggregateExample {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(60000);
        StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);
        tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai"));

        // DDL创建Kafka源表,必须定义事件时间和Watermark
        tableEnv.executeSql("""
            CREATE TABLE orders (
                order_id BIGINT,
                user_id BIGINT,
                amount DECIMAL(10,2),
                city STRING,
                order_time TIMESTAMP(3),
                WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
            ) WITH (
                'connector' = 'kafka',
                'topic' = 'orders',
                'properties.bootstrap.servers' = 'localhost:9092',
                'format' = 'json'
            )
        """);

        // 滚动窗口:每分钟统计各城市订单数和总金额
        Table tumbleAgg = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                city,
                COUNT(*) AS order_cnt,
                SUM(amount) AS total_amount,
                AVG(amount) AS avg_amount
            FROM TABLE(
                TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
            )
            GROUP BY window_start, window_end, city
        """);

        // 滑动窗口:最近5分钟的城市订单数,每分钟更新
        Table hopAgg = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                city,
                COUNT(*) AS order_cnt
            FROM TABLE(
                HOP(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE, INTERVAL '5' MINUTE)
            )
            GROUP BY window_start, window_end, city
        """);

        // 累积窗口:日累计销售额,每小时更新
        Table cumulateAgg = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                SUM(amount) AS cumulative_amount
            FROM TABLE(
                CUMULATE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' HOUR, INTERVAL '1' DAY)
            )
            GROUP BY window_start, window_end
        """);

        // 执行(示例:输出滚动窗口结果到控制台)
        TableResult result = tumbleAgg.execute();
        result.print();
        env.execute("Window Aggregate Example");
    }
}
关键点:
- 必须定义 Watermark :DDL 中
WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND,没有 Watermark 窗口不触发。 - GROUP BY 必须包含 window_start, window_end:窗口聚合的分组条件必须包含这两列,以及业务分组 key(如 city)。
- 窗口大小用 INTERVAL 语法 :
INTERVAL '1' MINUTE、INTERVAL '5' MINUTE,支持 SECOND/MINUTE/HOUR/DAY。 - 滑动窗口参数顺序:HOP 的参数是 (表, 时间列, slide, size),注意 slide 在前 size 在后。
六、窗口 TopN 代码实现
窗口 TopN 是每个窗口内取前 N 名的操作,标准模式:ROW_NUMBER() OVER (PARTITION BY window_start, window_end ORDER BY ...) + 过滤 rn ≤ N。
java
// 窗口TopN:每小时销售额Top10的商品
Table topN = tableEnv.sqlQuery("""
    SELECT
        window_start,
        window_end,
        product_id,
        product_name,
        total_amount,
        rank_num
    FROM (
        SELECT
            window_start,
            window_end,
            product_id,
            product_name,
            SUM(amount) AS total_amount,
            ROW_NUMBER() OVER (
                PARTITION BY window_start, window_end
                ORDER BY SUM(amount) DESC
            ) AS rank_num
        FROM TABLE(
            TUMBLE(TABLE order_items, DESCRIPTOR(order_time), INTERVAL '1' HOUR)
        )
        GROUP BY window_start, window_end, product_id, product_name
    )
    WHERE rank_num <= 10
""");
关键点:
- 先聚合再排名:子查询中先按窗口+商品分组聚合(SUM(amount)),再用 ROW_NUMBER 排名。
- PARTITION BY 必须包含 window_start, window_end:排名是在每个窗口内进行的,分区条件必须包含窗口列。
- ORDER BY 用聚合结果:按聚合指标(如 SUM(amount) DESC)排序,取 TopN。
- 外层过滤 rn ≤ N:WHERE rank_num <= 10 取前 10 名。
- Flink 有窗口 TopN 专属优化:每个窗口只维护 TopN 状态,窗口结束输出,性能好。
七、窗口 Join 代码实现
窗口 Join 是两个流在相同窗口内关联的操作,语法:两个流分别做窗口 TVF,然后按 window_start, window_end + key JOIN。
java
// 窗口Join:每分钟订单流与支付流关联
Table windowJoin = tableEnv.sqlQuery("""
    SELECT
        o.window_start,
        o.window_end,
        o.order_id,
        o.user_id,
        o.amount AS order_amount,
        p.pay_id,
        p.pay_amount,
        p.pay_time
    FROM (
        SELECT * FROM TABLE(
            TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
        )
    ) o
    JOIN (
        SELECT * FROM TABLE(
            TUMBLE(TABLE payments, DESCRIPTOR(pay_time), INTERVAL '1' MINUTE)
        )
    ) p
    ON o.window_start = p.window_start
       AND o.window_end = p.window_end
       AND o.order_id = p.order_id
""");
关键点:
- 两个流分别做窗口 TVF:订单流和支付流分别用 TUMBLE 切分窗口,窗口大小必须相同。
- JOIN 条件包含 window_start, window_end:只关联相同窗口内的数据,窗口列必须相等。
- 业务 key 关联:除窗口列外,还需要业务 key(如 order_id)关联。
- 相比 Interval Join 的优势:窗口 Join 状态更可控(窗口结束自动清理)、更高效(只关联相同窗口内的数据)。
- 支持 INNER/LEFT/RIGHT/FULL JOIN:窗口 Join 支持各种 Join 类型,语法与常规 SQL 一致。
八、分组窗口(旧 API)简要说明
分组窗口是 Flink 早期的 Table API 窗口方式,通过 window() 子句定义,这里简要说明以便维护老代码。
java
// 分组窗口旧API(Table API链式调用)
Table result = tableEnv.from("orders")
    .window(Tumble.over(lit(1).minute()).on($("order_time")).as("w"))
    .groupBy($("city"), $("w"))
    .select(
        $("city"),
        $("w").start().as("window_start"),
        $("w").end().as("window_end"),
        $("amount").sum().as("total_amount")
    );
分组窗口的限制:
- 只支持 Tumble、Hop、Session 三种窗口,不支持 Cumulate。
- 不支持窗口 TopN、窗口 Join、窗口去重。
- 窗口属性通过 window.start / window.end / window.rowtime 访问,不如 TVF 的三列直观。
- 没有窗口切片共享等专属优化,滑动窗口性能较差。
新业务一律用窗口 TVF,分组窗口仅在维护老代码时需要了解。
九、完整代码实现
下面是一个完整的 Table Window 使用示例,包含创建环境、DDL 建表、滚动窗口聚合、滑动窗口聚合、窗口 TopN、窗口 Join、输出执行。
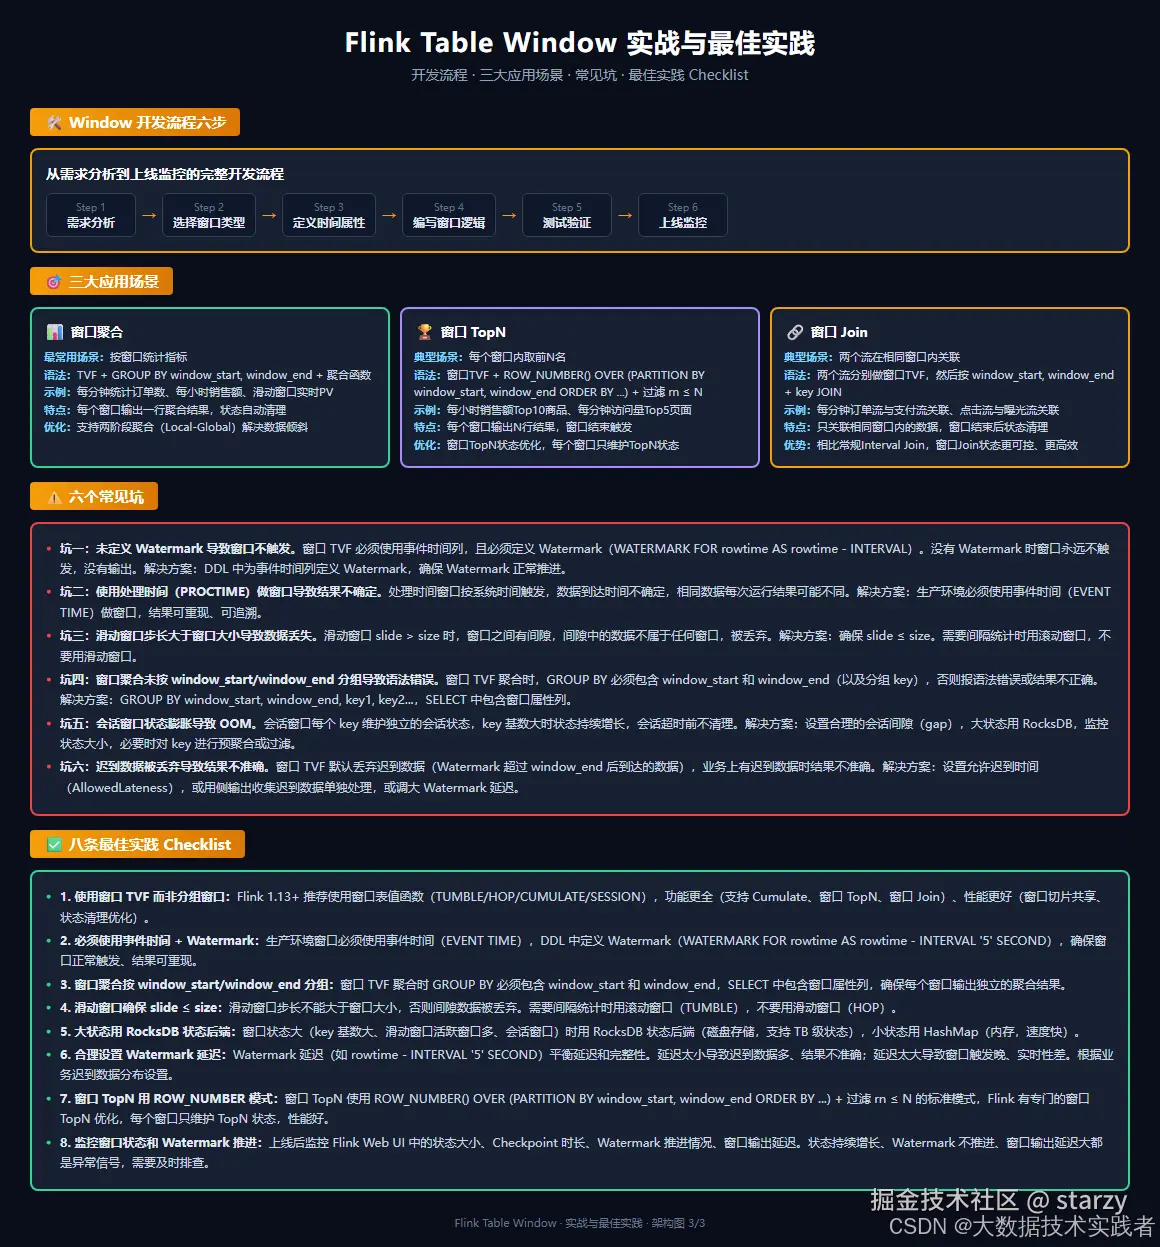
下面这张图把开发流程、三大应用场景、六个常见坑、八条最佳实践放在一起展示。
java
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import java.time.ZoneId;

public class TableWindowCompleteExample {

    public static void main(String[] args) throws Exception {
        // 1. 创建执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(60000);
        StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);
        tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai"));

        // 2. DDL创建订单表(必须定义事件时间和Watermark)
        tableEnv.executeSql("""
            CREATE TABLE orders (
                order_id BIGINT,
                user_id BIGINT,
                product_id BIGINT,
                product_name STRING,
                amount DECIMAL(10,2),
                city STRING,
                order_time TIMESTAMP(3),
                WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
            ) WITH (
                'connector' = 'kafka',
                'topic' = 'orders',
                'properties.bootstrap.servers' = 'localhost:9092',
                'format' = 'json'
            )
        """);

        // 3. DDL创建支付表
        tableEnv.executeSql("""
            CREATE TABLE payments (
                pay_id BIGINT,
                order_id BIGINT,
                pay_amount DECIMAL(10,2),
                pay_time TIMESTAMP(3),
                WATERMARK FOR pay_time AS pay_time - INTERVAL '5' SECOND
            ) WITH (
                'connector' = 'kafka',
                'topic' = 'payments',
                'properties.bootstrap.servers' = 'localhost:9092',
                'format' = 'json'
            )
        """);

        // 4. 滚动窗口聚合:每分钟各城市订单统计
        Table tumbleAgg = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                city,
                COUNT(*) AS order_cnt,
                SUM(amount) AS total_amount,
                AVG(amount) AS avg_amount
            FROM TABLE(
                TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
            )
            GROUP BY window_start, window_end, city
        """);

        // 5. 滑动窗口聚合:最近5分钟订单数,每分钟更新
        Table hopAgg = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                COUNT(*) AS order_cnt
            FROM TABLE(
                HOP(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE, INTERVAL '5' MINUTE)
            )
            GROUP BY window_start, window_end
        """);

        // 6. 窗口TopN:每小时销售额Top10商品
        Table topN = tableEnv.sqlQuery("""
            SELECT
                window_start,
                window_end,
                product_id,
                product_name,
                total_amount,
                rank_num
            FROM (
                SELECT
                    window_start,
                    window_end,
                    product_id,
                    product_name,
                    SUM(amount) AS total_amount,
                    ROW_NUMBER() OVER (
                        PARTITION BY window_start, window_end
                        ORDER BY SUM(amount) DESC
                    ) AS rank_num
                FROM TABLE(
                    TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' HOUR)
                )
                GROUP BY window_start, window_end, product_id, product_name
            )
            WHERE rank_num <= 10
        """);

        // 7. 窗口Join:每分钟订单与支付关联
        Table windowJoin = tableEnv.sqlQuery("""
            SELECT
                o.window_start,
                o.window_end,
                o.order_id,
                o.user_id,
                o.amount AS order_amount,
                p.pay_id,
                p.pay_amount
            FROM (
                SELECT * FROM TABLE(
                    TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
                )
            ) o
            JOIN (
                SELECT * FROM TABLE(
                    TUMBLE(TABLE payments, DESCRIPTOR(pay_time), INTERVAL '1' MINUTE)
                )
            ) p
            ON o.window_start = p.window_start
               AND o.window_end = p.window_end
               AND o.order_id = p.order_id
        """);

        // 8. 执行(示例:输出滚动窗口结果到控制台)
        TableResult result = tumbleAgg.execute();
        result.print();

        env.execute("Table Window Complete Example");
    }
}
代码关键点:
- Watermark 是窗口的前提 :每张表的 DDL 都定义了事件时间列和 Watermark(
WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND),没有 Watermark 窗口永远不触发。 - 窗口 TVF 语法 :
FROM TABLE(TUMBLE(TABLE 表名, DESCRIPTOR(时间列), INTERVAL '大小' 单位)),四种窗口类型语法类似。 - GROUP BY 包含窗口列:窗口聚合的 GROUP BY 必须包含 window_start, window_end,以及业务分组 key。
- 窗口 TopN 标准模式:子查询先聚合再 ROW_NUMBER 排名,外层过滤 rn ≤ N,PARTITION BY 包含窗口列。
- 窗口 Join 条件:两个流分别 TVF,JOIN ON 包含 window_start, window_end 相等 + 业务 key 相等。
- 滑动窗口参数顺序:HOP(表, 时间列, slide, size),slide 在前 size 在后,注意不要搞反。
十、六个常见坑
10.1 坑一:未定义 Watermark 导致窗口不触发
现象: 窗口作业运行后没有任何输出,Flink Web UI 中窗口算子没有记录发出。
根因: 窗口 TVF 必须使用事件时间列,且必须定义 Watermark。没有 Watermark 时,Watermark 永远是 Long.MIN_VALUE,窗口永远不触发,没有输出。
解决方案: DDL 中为事件时间列定义 Watermark:WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND。确保 Source 正常发送数据,Watermark 正常推进。
10.2 坑二:使用处理时间做窗口导致结果不确定
现象: 相同数据每次运行窗口结果不同,无法重现,排查困难。
根因: 处理时间(PROCTIME)窗口按系统时间触发,数据到达时间不确定,网络延迟、系统负载都会影响数据落入哪个窗口,结果不可重现。
解决方案: 生产环境必须使用事件时间(EVENT TIME)做窗口,结果可重现、可追溯。事件时间是数据本身携带的时间(如订单创建时间),与处理时间无关。
10.3 坑三:滑动窗口步长大于窗口大小导致数据丢失
现象: 滑动窗口统计结果比预期小,部分数据没有被统计到。
根因: 滑动窗口 slide > size 时,窗口之间有间隙,间隙中的数据不属于任何窗口,被丢弃。
解决方案: 确保 slide ≤ size。需要间隔统计时用滚动窗口(TUMBLE),不要用滑动窗口(HOP)。滑动窗口的设计目的是窗口重叠(如最近 5 分钟每分钟更新),不是间隔统计。
10.4 坑四:窗口聚合未按 window_start/window_end 分组
现象: 窗口聚合 SQL 报语法错误,或执行结果不正确(多个窗口的结果混在一起)。
根因: 窗口 TVF 聚合时,GROUP BY 必须包含 window_start 和 window_end(以及分组 key)。缺少窗口列分组时,所有窗口的数据被混在一起聚合,结果错误。
解决方案: GROUP BY window_start, window_end, key1, key2...,SELECT 中包含窗口属性列。这是窗口聚合的硬性要求。
10.5 坑五:会话窗口状态膨胀导致 OOM
现象: 会话窗口作业运行一段时间后状态持续增长,TaskManager OOM,作业失败。
根因: 会话窗口每个 key 维护独立的会话状态,key 基数大时状态持续增长,会话超时前不清理。如果 key 基数很大(如所有用户),状态会膨胀到 OOM。
解决方案: 设置合理的会话间隙(gap),避免会话过长;大状态用 RocksDB 状态后端;监控状态大小;必要时对 key 进行预聚合或过滤(如只统计活跃用户)。
10.6 坑六:迟到数据被丢弃导致结果不准确
现象: 窗口统计结果比实际值小,部分数据没有被统计到。
根因: 窗口 TVF 默认丢弃迟到数据(Watermark 超过 window_end 后到达的数据)。业务上有迟到数据(如网络延迟、客户端断网后重传)时,这些数据被丢弃,结果不准确。
解决方案: ① 设置允许迟到时间(AllowedLateness),窗口状态保留更久,迟到数据可重新触发;② 用侧输出收集迟到数据单独处理;③ 调大 Watermark 延迟(如 order_time - INTERVAL '30' SECOND),减少迟到数据量,但会增加窗口输出延迟。
十一、八条最佳实践 Checklist
上线前逐条检查:
-
使用窗口 TVF 而非分组窗口:Flink 1.13+ 推荐使用窗口表值函数(TUMBLE/HOP/CUMULATE/SESSION),功能更全(支持 Cumulate、窗口 TopN、窗口 Join)、性能更好(窗口切片共享、状态清理优化)。新业务一律用 TVF。
-
必须使用事件时间 + Watermark :生产环境窗口必须使用事件时间(EVENT TIME),DDL 中定义 Watermark(
WATERMARK FOR rowtime AS rowtime - INTERVAL '5' SECOND),确保窗口正常触发、结果可重现。不要用处理时间做窗口。 -
窗口聚合按 window_start/window_end 分组:窗口 TVF 聚合时 GROUP BY 必须包含 window_start 和 window_end,SELECT 中包含窗口属性列,确保每个窗口输出独立的聚合结果。
-
滑动窗口确保 slide ≤ size:滑动窗口步长不能大于窗口大小,否则间隙数据被丢弃。需要间隔统计时用滚动窗口(TUMBLE),不要用滑动窗口(HOP)。滑动窗口的设计目的是窗口重叠。
-
大状态用 RocksDB 状态后端:窗口状态大(key 基数大、滑动窗口活跃窗口多、会话窗口)时用 RocksDB 状态后端(磁盘存储,支持 TB 级状态),小状态用 HashMap(内存,速度快)。
-
合理设置 Watermark 延迟:Watermark 延迟平衡延迟和完整性。延迟太小导致迟到数据多、结果不准确;延迟太大导致窗口触发晚、实时性差。根据业务迟到数据分布设置(常见 5 秒~5 分钟)。
-
窗口 TopN 用 ROW_NUMBER 模式 :窗口 TopN 使用
ROW_NUMBER() OVER (PARTITION BY window_start, window_end ORDER BY ...)+ 过滤rn ≤ N的标准模式,Flink 有专门的窗口 TopN 优化,每个窗口只维护 TopN 状态,性能好。 -
监控窗口状态和 Watermark 推进:上线后监控 Flink Web UI 中的状态大小、Checkpoint 时长、Watermark 推进情况、窗口输出延迟。状态持续增长、Watermark 不推进、窗口输出延迟大都是异常信号,需要及时排查。
十二、总结与下一篇预告
Table Window 原理及代码实现要点回顾:
第一,本质:Table Window 是将无界数据流按时间属性切分为有限窗口,对每个窗口内的数据进行聚合、TopN、Join 等操作,是流处理中无界流聚合的核心抽象。窗口让状态可控、结果可输出、业务语义清晰。
第二,两种 API 风格:分组窗口(Grouped Window,旧 API,Table API 链式调用)和窗口表值函数(Windowing TVF,新 API 推荐,SQL 标准表值函数)。新业务一律用窗口 TVF,功能更全、性能更好。
第三,四种窗口类型:Tumble 滚动窗口(固定大小不重叠,每条数据一个窗口)、Hop 滑动窗口(固定大小可重叠,每条数据多个窗口,slide ≤ size)、Session 会话窗口(动态大小按间隙划分,每个 key 独立)、Cumulate 累积窗口(从起始点累积扩展,窗口包含关系,日累计报表)。
第四,窗口属性三列:window_start(包含)、window_end(排他)、window_time(= end - 1ms,可用于窗口嵌套)。窗口聚合必须按 window_start, window_end 分组。
第五,内部执行机制:数据到达→窗口分配→状态更新→Watermark 触发(WM ≥ window_end)→结果输出→状态清理六步全链路。Watermark 是窗口触发的时钟,没有 Watermark 窗口不触发。
第六,状态管理:每个 key × 每个窗口维护累加器状态,窗口结束自动清理,参与 Checkpoint。滑动窗口活跃窗口数 = size/slide,状态比滚动窗口大。大状态用 RocksDB。
第七,三大应用场景:窗口聚合(TVF + GROUP BY 窗口列 + 聚合函数)、窗口 TopN(ROW_NUMBER 模式 + 过滤 rn ≤ N)、窗口 Join(两流分别 TVF + 按窗口列和 key JOIN)。
第八,专属优化:窗口切片共享(滑动窗口性能关键)、状态清理优化、两阶段聚合、窗口 TopN 优化、累积窗口增量计算。
第九,六个常见坑:未定义 Watermark 窗口不触发、处理时间窗口结果不确定、滑动 slide > size 数据丢失、窗口聚合未按窗口列分组、会话窗口状态膨胀 OOM、迟到数据被丢弃。
第十,八条最佳实践:用窗口 TVF、必须事件时间 + Watermark、窗口聚合按窗口列分组、滑动 slide ≤ size、大状态用 RocksDB、合理设置 Watermark 延迟、窗口 TopN 用 ROW_NUMBER 模式、监控窗口状态和 Watermark 推进。
Table Window 是流处理的核心能力之一,掌握窗口的原理、四种类型、内部机制、三大应用场景,就能应对绝大多数流处理统计需求。窗口 TVF 是 Flink 1.13+ 的推荐方式,新业务一律使用。