周五 22 点,你让 coding agent 去生产服务器改一个 BUG。它写了个验证脚本,循环没收口、又把依赖编译了一遍------半小时后 CPU 和内存双双吃满,SSH 都登不进去,只能物理重启。你丢的不只是那条修复,是这台机器上跑着的监控、备份、所有生产服务。
一、把改 BUG 外包给 Agent,账单先打到宿主机上
V2EX 上一条帖子把这件事说得很难听:让 coding agent 连到远程机改 BUG,「稍微大一点的工作,就导致远程小鸡 CPU 内存占满,不重启根本没法再用」。先 SSH 登、再塞 IDE、再让 agent 直接改,机器往往先于结果废掉。这类帖子不是个例。只要 agent 的执行环境没有边界,「它为了把事做完,会一路跑验证循环、编译、反复跑测试」,而这三样都是资源密集且时长不确定的。
它没有「预算意识」,这一点容易被忽略。Agent 的目标函数里只有一项------把活干完,宿主还剩多少资源根本不进它的判断。根因就在这里:它的问题出在「压根不知道有宿主在」,而不在「跑得太猛」。所以同一个 BUG,换个更大的验证脚本,资源占用就直线上升,你没法从任务本身预判它会吃多少。
这就是为什么把资源护栏放在它外面才有效:一旦触发熔断,被切掉的是「这个任务」,后果由任务承担,宿主只损失一点余量。反过来说,把「小心别占满」写进 prompt 是没用的------它没有这个机制去遵守,触发条件永远不在它那一侧。
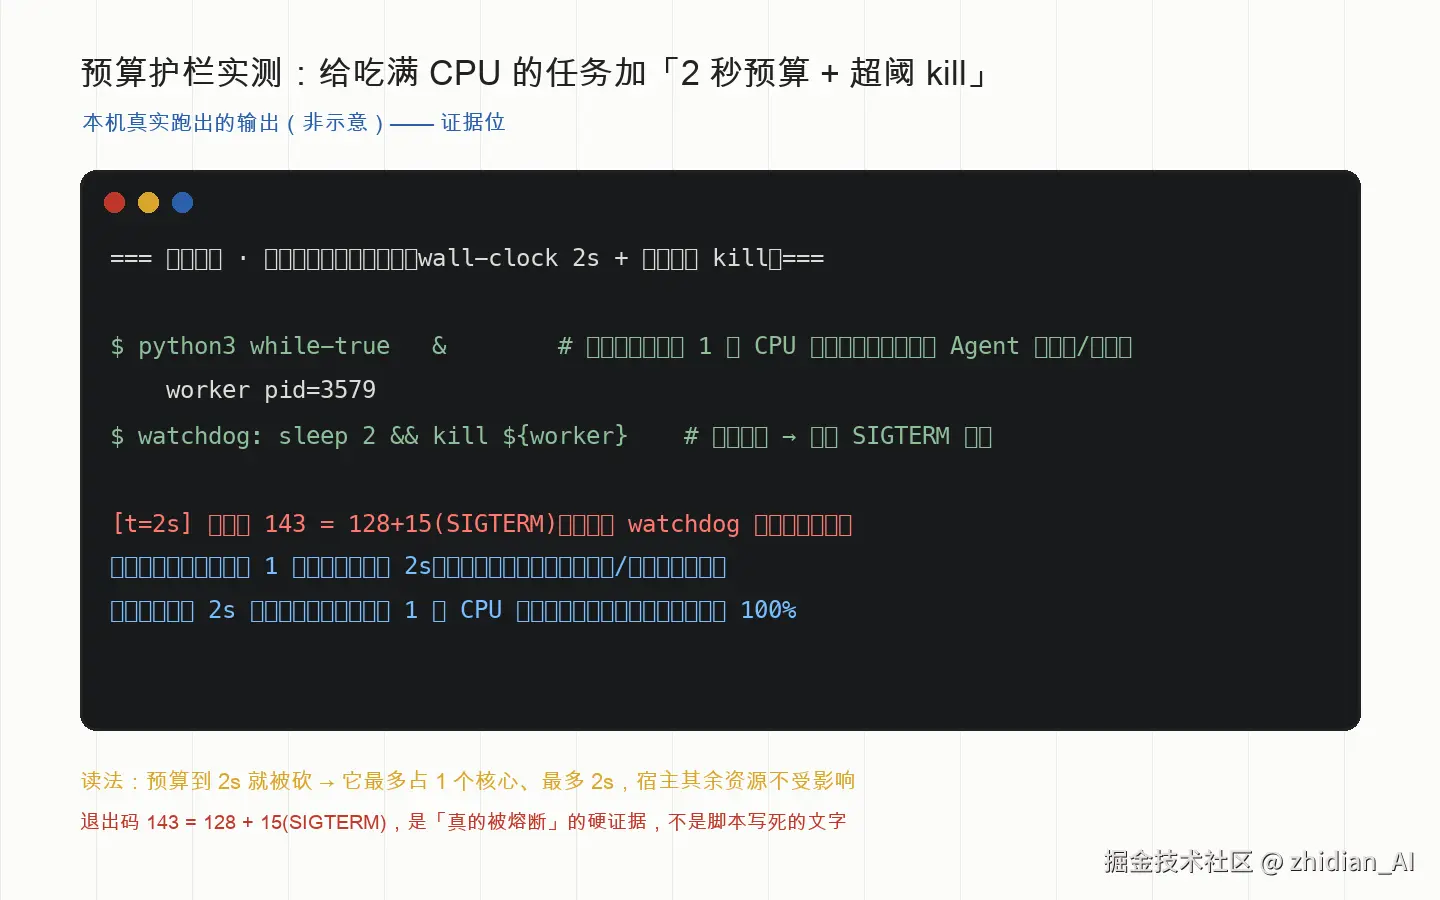 真正的问题被大多数人漏掉:这里最贵的成本是「它执行的那一刻,把宿主机拖到不可用」。因为一台宿主机上通常还跑着监控、备份、其它生产服务------Agent 把资源吃满的那一刻,掉的不只是它自己。这个连锁代价比「改错要返工」贵一个量级,而且往往事后才被算出来:返工是 Agent 的账、重跑一次就行;拖垮宿主是全团队的账、得物理重启。
代价:资源吃满 → SSH 掉线 → 只能物理重启。付出去的代价是「宿主上所有服务一起被打挂 + 一次不可控现场」,换来的只是「这一次改 BUG 跑完了」。把 Agent 放裸宿主上跑,等于让它带着生产机器的全部资产去试错,而它根本不知道自己在花谁的资源。
二、上生产前,先问三个问题
我认为要破的点,从来不是「怎么让它改得更快」。让它更快解决的是正确性与效率;让它「执行时伤不到宿主」才是要先解决的问题。我的判断很直接:给执行环境加三道资源护栏------隔离、预算、回滚。三道护栏各对应一个上线前必须问清的问题:
- 隔离:它跑起来,能碰宿主的哪些资源?放进容器 + cgroup 限额(CPU/内存上限)、只读挂载依赖、临时工作区、网络白名单。它再怎么跑,也只在框里跑,宿主保留 30% 余量给监控/备份/生产。
- 预算:单次执行给它多少资源?给每个任务一个 CPU 秒数 + 内存上限 + 超时熔断,超阈自动 kill。预算就是「给宿主留活路」的那条护栏。
- 回滚:它改坏了宿主怎么兜?每个任务一个独立 git 工作区 + 快照,改坏直接 revert;宿主镜像与基线不动,崩了回退而不是重做。
其中容器与 cgroup 命令属于社区通行做法(Docker 的 --memory / --cpus、cgroup v2、沙箱 bwrap 都在做同一件事)。我们日常那条「抓 N 个源 → 逐个打分 → 汇总」的痛点流水线,是「外置编排 + 单条处理 + 失败可定位」的活例------今天这一版就抓了 180 条,每条独立、失败能定位到「第几个源、哪一步」,且从没把宿主资源池吃满,根子正在于它把循环和收集放在编排层、每一步只碰单条。
三问之外,该上满三道还是够用就行,可以对着这张表定:
| 判断项 | 上满 3 道护栏 | 够用就行 |
|---|---|---|
| 跑在哪 | 生产宿主机 / 共享集群 | 独立沙箱、独占机 |
| 单次资源 | 无上限、时长不确定 | 小任务、可预估 |
| 宿主上还跑着 | 生产 / 监控 / 备份 | 只有这一个任务 |
| 拿到的凭据 | 能碰生产(必须最小权限) | 无生产凭据 |
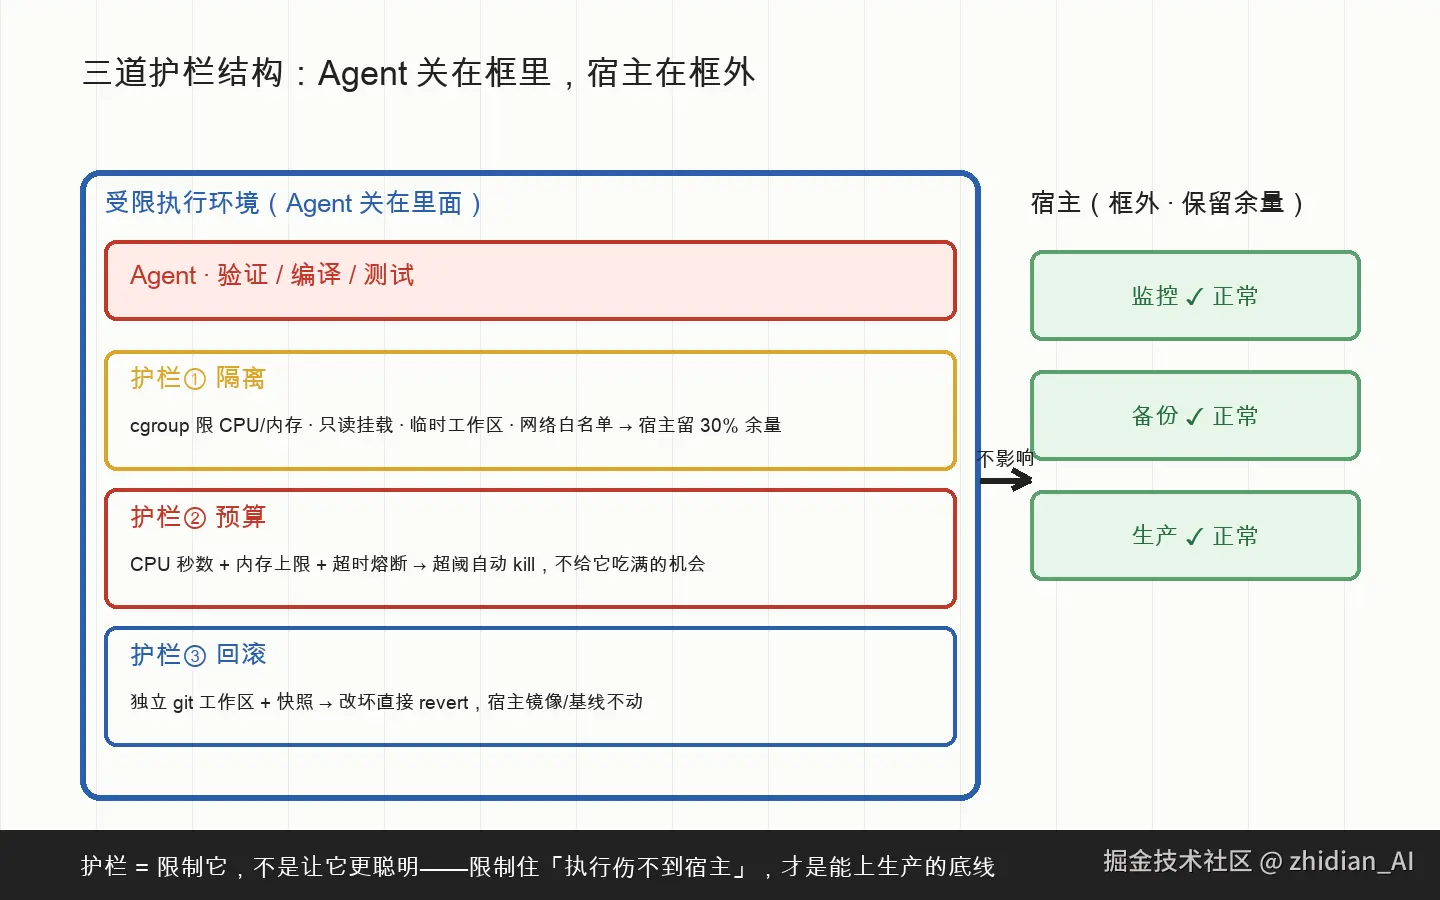 三道护栏的共同动作是「限制它」。这里有个反直觉的点:多数团队把力气全花在调教模型上(加 critic、写更狠的 prompt),却没给它装资源护栏,结果模型再强,也照样能把宿主吃满。限制它(限额、熔断、回滚)解决的是「执行时伤不到宿主」,这恰恰是能不能上生产的底线;让它更聪明解决的才是正确性。把两者顺序摆反,是最常见的误区。一句话能带走:模型负责把结果改对,护栏负责把宿主保住------谁越界,谁买单。
三、我们的做法,和明天就能做的 5 步
我们的做法:给企业做 Agent 落地项目时,执行环境默认就是「容器 + cgroup 限额 + 只读挂载 + 临时工作区 + 网络白名单」这套;每次任务一个预算,超阈自动熔断,改坏按 git 回滚。最小权限是前提------不拿宿主机 root、不碰生产凭据。护栏不是加料,是它能不能安全上生产的入场券。
把三道护栏落到「明天就能做」的动作,就五步,照着执行即可:
- 隔离 :给 Agent 的执行放容器,设
memory / cpus上限,依赖只读挂载,工作区用临时卷。 - 预算:每个任务写清 CPU 秒数与超时,超阈自动 kill + 记一条日志,别让它「默默吃满」。
- 回滚:任务开独立 git 工作区,跑前打快照,失败直接 revert,宿主基线不动。
- 最小权限:不拿 root、不给生产凭据,网络只白名单它要连的那几个端点。
- 可观测:画资源曲线(宿主 vs Agent 分别占多少),设阈值报警------超阈先熔断再看,不靠人肉盯。
这套做完,「让 Agent 在线改 BUG」就从「赌宿主不崩」变成「它崩了也只崩在框里」。一句话能带走:**Agent 一次失控,伤不伤得到框外的宿主,才决定它配不配上生产。**同一条命令,加了隔离 + 预算 + 回滚,最坏结果是「这个任务被熔断、按快照回滚、宿主上的监控/备份/生产没受影响」,代价只是丢掉这一次任务本身。
反过来说,也有不该上满三道护栏的时候:任务在独占沙箱、没有生产凭据、单次可预估,用「预算 + 回滚」两道就够,多装隔离是过度设计。我更看重「逐条可定位 + 熔断兜底」胜过「跑得更快」------一条失控能被 kill 掉、被 revert,比它多塞一倍算力更值钱。
一个业务现场问题
一个业务现场问题 你们让 Agent 上生产时,最大的资源事故是「把它宿主拖垮了」,还是「它拿着凭据越权操作」?把你们限制 Agent 资源的那段配置(容器 / cgroup / 预算 / 回滚)发我,我们对着真实执行环境拆,看哪道护栏还没装。