没有集中管理的专家接力方式的多智能体Agent协作
本文基于 LangGraph 官方库 langgraph-swarm(v0.1.0)源码,主要讲解它怎么用、原理是什么。建议先读上一篇《LangGraph 的Supervisor 多智能体机制》,因为交接(handoff)的原理在那里已经讲过了。
一、先看场景:它到底解决什么问题
和上一篇一样,先从场景说起。以下三种情况,采用 Swarm Agent 多智能体特别合适。
场景一:客服热线式的转接
用户说"我要找会说西班牙语的顾问"。前台 Agent 接到后,发现自己不合适,于是直接把对话转给西班牙语顾问 Agent------转完它就不管了,之后用户的所有追问都由西语顾问 Agent 直接接待,不需要有人中转。
这和客服电话的体验一模一样:转接之后,你不会每隔一句话被转回前台确认一次。
场景二:一次要跑好几个领域的连环问题
用户:"帮我看看这张机票能不能改签,改完告诉我落地那份酒店能不能退。"
- 机票专家处理改签,处理完直接把对话(含改签结果)交给酒店专家
- 酒店专家看到的不是一句孤立的转述,而是完整的对话记录:改签后的新日期、原来的酒店订单,全都在这儿
信息跟着人走,不需要中介传话。
场景三:用户主导的闲聊式多专家对话
用户在和一个"懂 Python 的朋友"聊天,聊着聊着问到了法律问题,这个 Agent 直接把对话甩给法律专家;聊完法律又绕回 Python,法律专家再甩回来。整个过程由用户的提问内容驱动,而不是一个固定流程。
这三种场景的共同点
- 每个问题基本上一次只需要一个专家在场
- 接手的专家需要看到完整的来龙去脉
- 专业分工是清楚的,但先找谁、后找谁说不准
这正是 Swarm Agent 多智能体架构适合解决的问题场景。
什么时候不该用它
- 任务需要并行:比如同时派三个人去查三家数据------Swarm 不支持并行,一次只有一个人干活
- 需要有人盯着全局:想知道"机票订了、酒店没订,还差什么"------Swarm 里没有任何一个角色知道全局
- 问题类型事先不知道:Swarm 需要一个预先建好的专家 Agent 名单,运行时没法凭空生成一个新 Agent 专家
二、一句话说清 Swarm
Swarm 就是"传球":一群平级的专家,谁拿着球谁说话,不想拿就传给下一个专家。
和 Supervisor 最直观的区别:
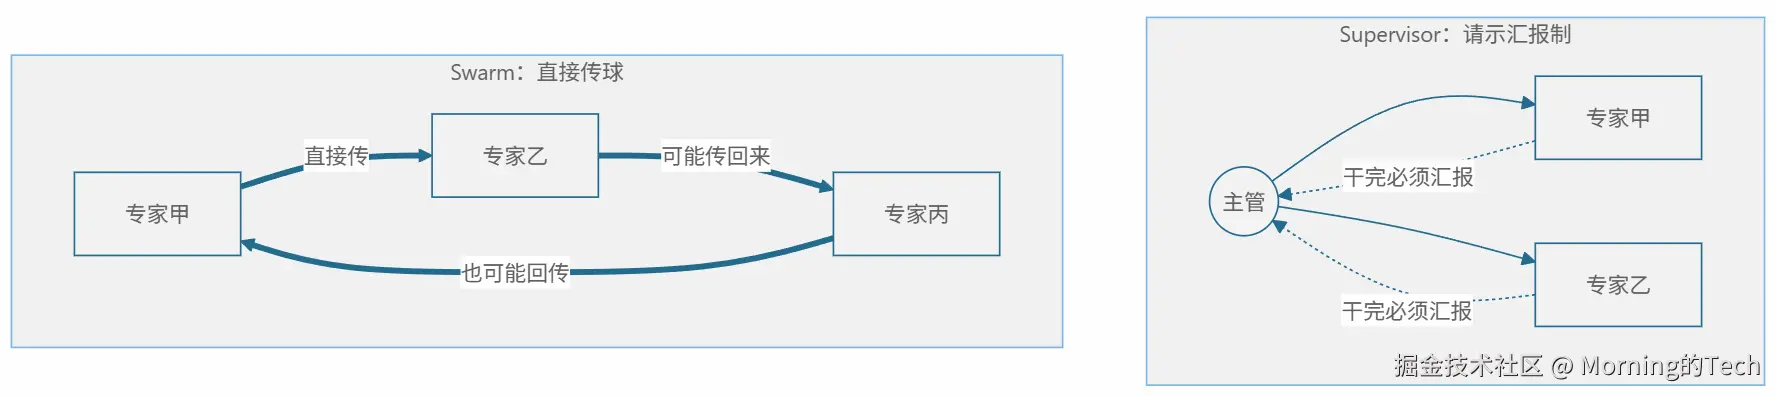
Supervisor 是"派工---汇报",Swarm 是"接力跑"。
还有一个关键设计:Swarm 记得最后是谁拿着球 。这一轮是酒店专家接的话,下一轮用户再继续提问,还是从酒店专家开始------不会回到起点重来: 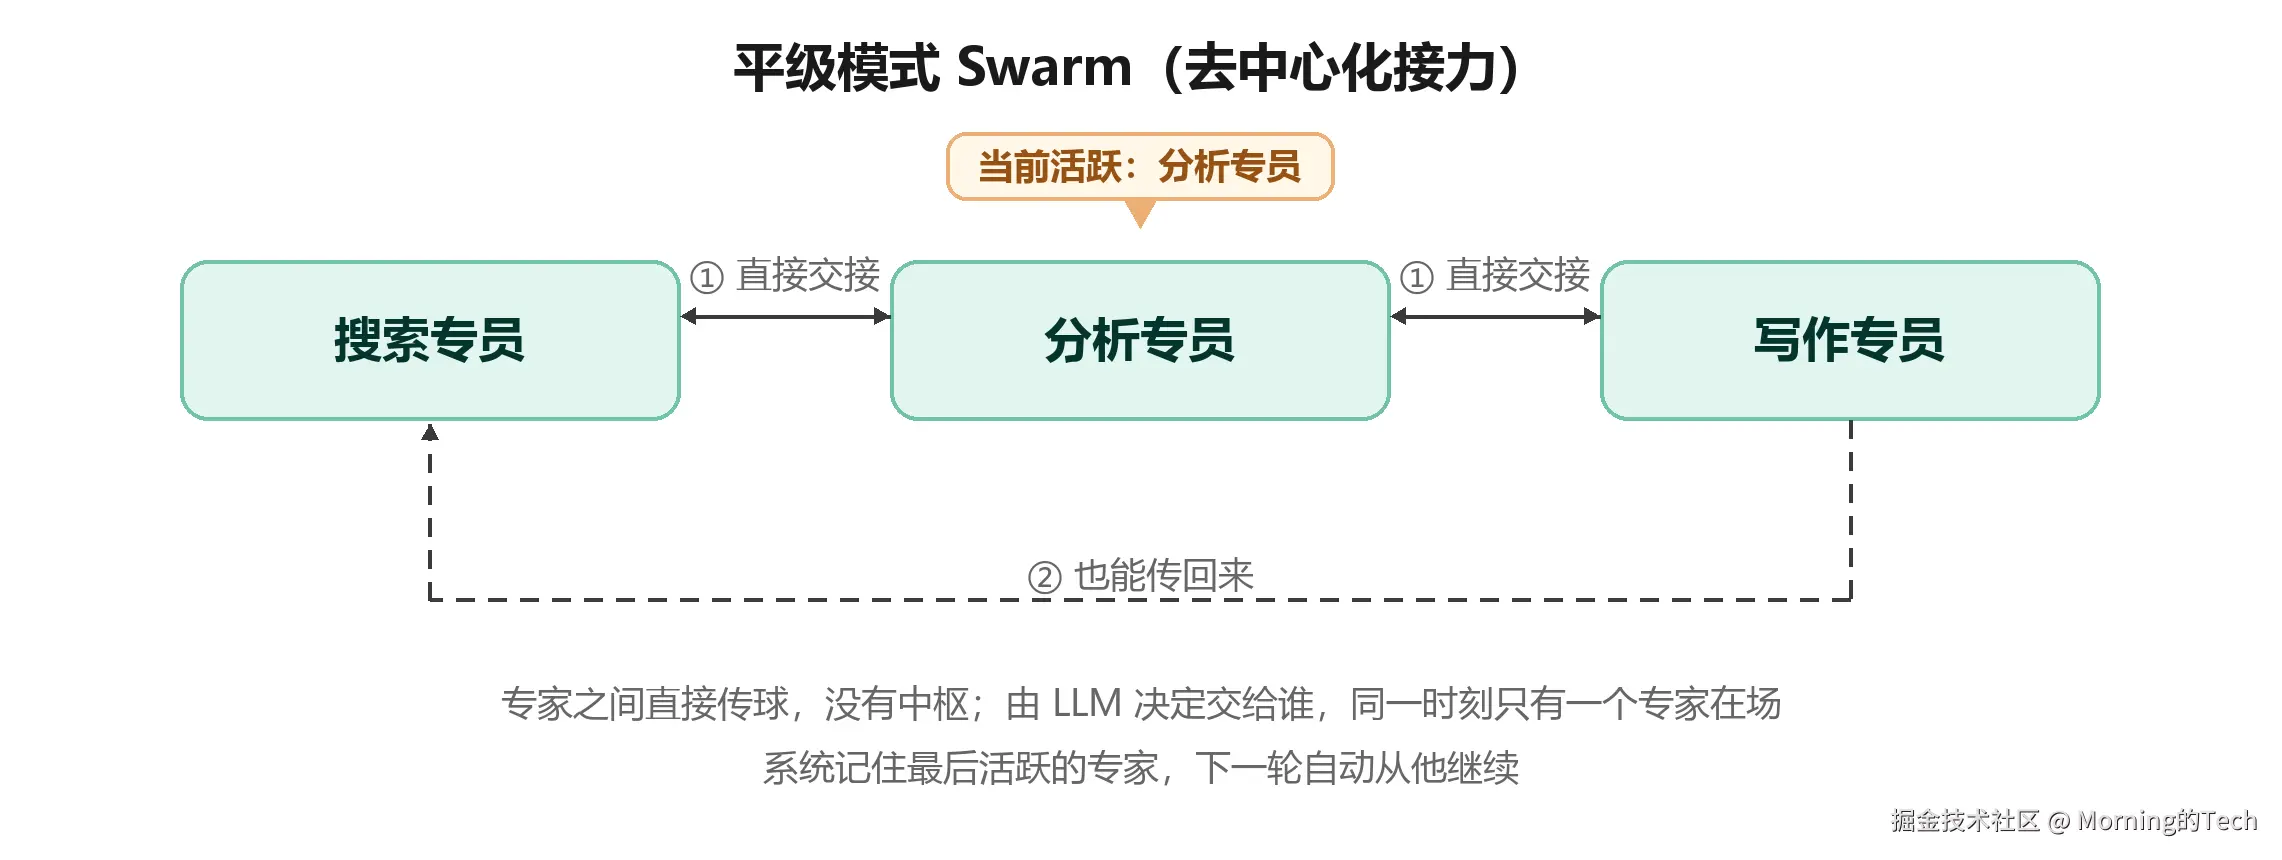 图里那个"当前活跃"的标记,就是
active_agent 字段------它由交接工具在跳转时写进状态,靠 checkpointer 记住,是 Swarm 全部"记忆"的来源。
三、怎么用
3.1 最小可运行例子
python
from langchain_openai import ChatOpenAI
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver
from langgraph_swarm import create_handoff_tool, create_swarm

model = ChatOpenAI(model="gpt-4o")

def book_flight(date: str, city: str) -> str:
    """订机票:指定出发日期和目的城市"""
    return f"已订 {date} 飞{city}的机票,确认号 CA1834"

def book_hotel(city: str, nights: int) -> str:
    """订酒店:指定城市和入住晚数"""
    return f"已订{city}的酒店,{nights} 晚,订单号 H2049"

# 机票专家:带着订机票工具,和一个"转给酒店专家"的工具
flight_expert = create_agent(
    model,
    tools=[book_flight, create_handoff_tool(agent_name="hotel_expert", description="转给酒店专家,她负责订酒店")],
    system_prompt="你是机票专家,负责订机票。遇到酒店的事,转给酒店专家。",
    name="flight_expert",
)

# 酒店专家:带着订酒店工具,和一个"转给机票专家"的工具
hotel_expert = create_agent(
    model,
    tools=[book_hotel, create_handoff_tool(agent_name="flight_expert", description="转给机票专家,他负责订机票")],
    system_prompt="你是酒店专家,负责订酒店。遇到机票的事,转给机票专家。",
    name="hotel_expert",
)

workflow = create_swarm(
    [flight_expert, hotel_expert],
    default_active_agent="flight_expert",   # 还没记录活跃专家时(比如第一轮),默认从机票专家开始
)
app = workflow.compile(checkpointer=InMemorySaver())   # 记忆必须配!

config = {"configurable": {"thread_id": "1"}}

# 第一轮:用户要订酒店,默认从机票专家开始,基于用户问题执行了handoff后,控制交给了酒店专家
app.invoke({"messages": [{"role": "user", "content": "我想订酒店,上海 3 晚"}]}, config)
# 此时系统记住:现在是酒店专家在说话

# 第二轮:什么都不用指定,自动从酒店专家继续
app.invoke({"messages": [{"role": "user", "content": "再帮我订一张去上海的机票"}]}, config)
# 酒店专家发现剩下的是机票的事,把对话交回机票专家
顺带说一个小技巧:active_agent 这个字段允许你在输入里直接指定,app.invoke({"messages": ..., "active_agent": "hotel_expert"}, config) 就等于"这轮强制从酒店专家开始"。不指定时才走 default_active_agent。
跑完这两轮,共享的对话记录长这样:
markdown
1. 用户:        我想订酒店,上海 3 晚
2. 机票专家:     我要调用 transfer_to_hotel_expert
3. 工具回执:     Successfully transferred to hotel_expert
4. 酒店专家:     我要调用 book_hotel("上海", 3)
5. 工具回执:     已订上海的酒店,3 晚,订单号 H2049
6. 酒店专家:     酒店订好了,订单号 H2049
7. 用户:        再帮我订一张去上海的机票
8. 酒店专家:     我要调用 transfer_to_flight_expert
9. 工具回执:     Successfully transferred to flight_expert
10. 机票专家:    我要调用 book_flight("10 月 20 日", "上海")
11. 工具回执:    已订 10 月 20 日飞上海的机票,确认号 CA1834
12. 机票专家:    机票订好了,确认号 CA1834
第 2、3 行就是上一篇讲的 handoff。这里唯一的区别是------没有人把它追回来,机票专家交完之后就退场了。
顺带复读上一篇的关键点(容易搞混):第 2、4、8、10 行里"我要调用某某"是模型给出的工具调用请求,模型本身不执行任何东西;真正跑去执行工具的,是外层那段负责协调的程序(详见上一篇文章)。下面几张流程图里的"调用"同理。
提醒:checkpointer 在多轮对话里是必需的。不配的话,"现在是酒店专家在说话"这个事实和全部历史都会丢,第二轮会回到机票专家重新开始。
3.2 让交接时携带额外的指令
默认的交接工具在模型眼里是"零参数"的------它只能决定交给谁,没法交代去干什么。如果希望下一个 Agent 一接手就知道任务背景(比如"用户要订 10 月 20 日飞上海的机票,酒店已经订好"),就得自己写一个定制的交接工具。
自己写时记住三件事就够了:
- 给工具多开一个参数。默认工具只知道要"交给谁";自定义时多加一个让模型填的字段,它就能在交接时顺便带上一句话,比如"用户要订 10 月 20 日飞上海的机票,酒店已经订好"
- 新字段要先在状态里登记。这句"带过去的话"不在默认的状态里,得先告诉外层图多了这个字段,否则运行时直接报状态更新错误
- 下游得自己读它------最容易漏的一步 。话带到了,不等于下游会自动看。官方 README 在同样的示例后面特意注明:下游 Agent "would need to implement logic for how to consume it" ,得自己实现怎么消费,接手的专家才真的看见
跑起来的效果是这样:酒店专家提议交接时顺带填的就是这句话,机票专家一上手就明确知道要订哪天的机票,不用从一整段聊天记录里自己找重点。
默认的交接工具给不了这个参数------这就是自定义它的全部意义。
3.3 不想让别人看见某位专家的内部执行过程
默认的 Swarm 是"所有人共用一个大群聊"------机票专家中间查了三次航班、比了两轮价格,这些过程全在共享历史里,后面接手的专家照样能看到。
想给某位专家一个私人工作区,思路分三步:给它一个独立的消息键,让执行的中间过程信息只写在自己那儿;用一个包装函数做转换,公共历史喂进去、只把最终结果取回来;然后手动拼装整个 Swarm。
这属于进阶定制------走到这一步,专家就不能用 create_agent 一行造出来了,得用 StateGraph 从零搭一个带工具循环的 Agent,官方 README 的 "Customizing agent implementation" 一节给了完整示例,本文不展开。
更务实的替代:如果你只是想避免中枢角色反复读到中间过程,Supervisor 的 output_mode="last_message" 就能解决,一行配置,不用手写这么多。
四、Swarm原理:一个字段 + 一个开关
Swarm 的核心逻辑非常薄------handoff.py 加 swarm.py 两个文件,去掉大段文档字符串,真正干活的代码只有一百多行。原理可以浓缩成两句话:
状态只多存一个字段 active_agent;图的入口加一个"看这个字段决定先去哪"的开关。
4.1 状态是什么
python
class SwarmState(MessagesState):
    active_agent: str | None      # 当前谁拿着球
全部的协作状态就是这两样:对话记录 + 当前是谁。
构图时还有个小巧思:它会把 active_agent 的类型从 str 收紧成 Literal"flight_expert","hotel_expert",让这个字段在类型层面就只能填专家名单里的名字。真正兜底的则是编译期校验------某个专家手里的交接工具如果指向了名单外的名字(比如"Carol"),compile() 阶段就会报错,而不是等到运行时才暴露(4.2 会讲它是怎么被发现的)。
4.2 图是怎么拼起来的
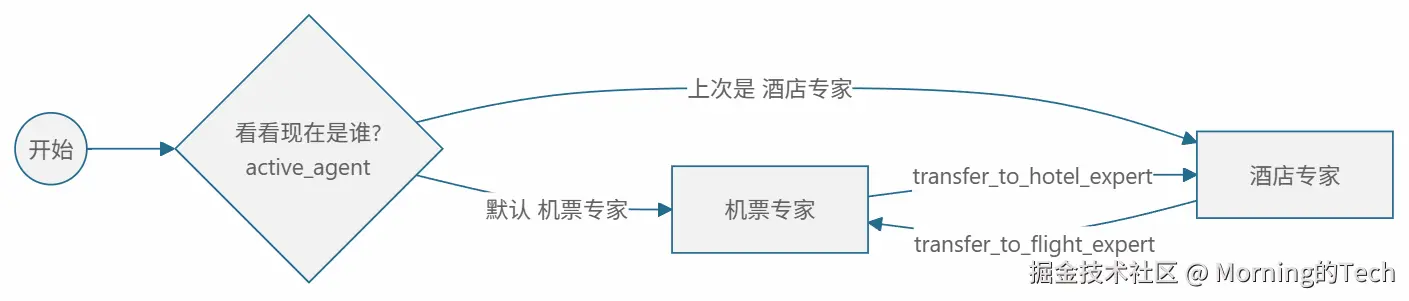 把上图拆开,只有两部分。
先回答一个自然会冒出来的问题:第二轮对话时,图怎么知道该从酒店专家开始?
答案就是入口那个开关。每一轮 invoke 都从 START 出发,START 后面挂了一个条件边,读状态里的 active_agent,决定本轮第一个进哪个节点------没有记录,就用 default_active_agent。源码核心就一行(add_active_agent_router 做的事):
scss
def route_to_active_agent(state):
    return state.get("active_agent", default_active_agent)

builder.add_conditional_edges(START, route_to_active_agent, path_map=route_to)
两个参数解释一下:
- path_map:返回值 → 节点名的对照表。路由器返回 "hotel_expert",就跳 "hotel_expert" 节点;返回名单外的值,直接报错。create_swarm 传进去的就是专家名单 "flight_expert", "hotel_expert"
- default_active_agent:没有记录时(比如第一轮)的默认值
每个专家作为一个普通节点挂上去,同时扫一遍它的工具、找出所有交接目标,登记为这个节点的 destinations:
css
for agent in agents:
    builder.add_node(
        agent.name,
        agent,
        destinations=tuple(get_handoff_destinations(agent)),
    )
get_handoff_destinations 的工作方式很有意思:它打开 Agent 内部的工具节点,翻出所有带 __handoff_destination 标记的工具,读出各自"指向谁"。也就是说,Swarm 图的连线不是手写的,是由每个专家手里的交接工具隐式声明的------你在 Agent 上挂一个交接工具,就自动多出一条潜在走向。
这里有个容易误解的点:destinations 并不驱动执行------真正让图跳起来的是交接工具返回的那张"通行证"(Command(goto=...),上一篇 2.3 讲过)。destinations 有两个实际作用:一是画图时能把这些潜在走向画出来;二是编译期校验------如果某个交接工具指向了名单外的名字,compile() 会直接报错 Found edge ending at unknown node 'Carol',这正是 4.1 说的"兜底"。
4.3 一次完整流程
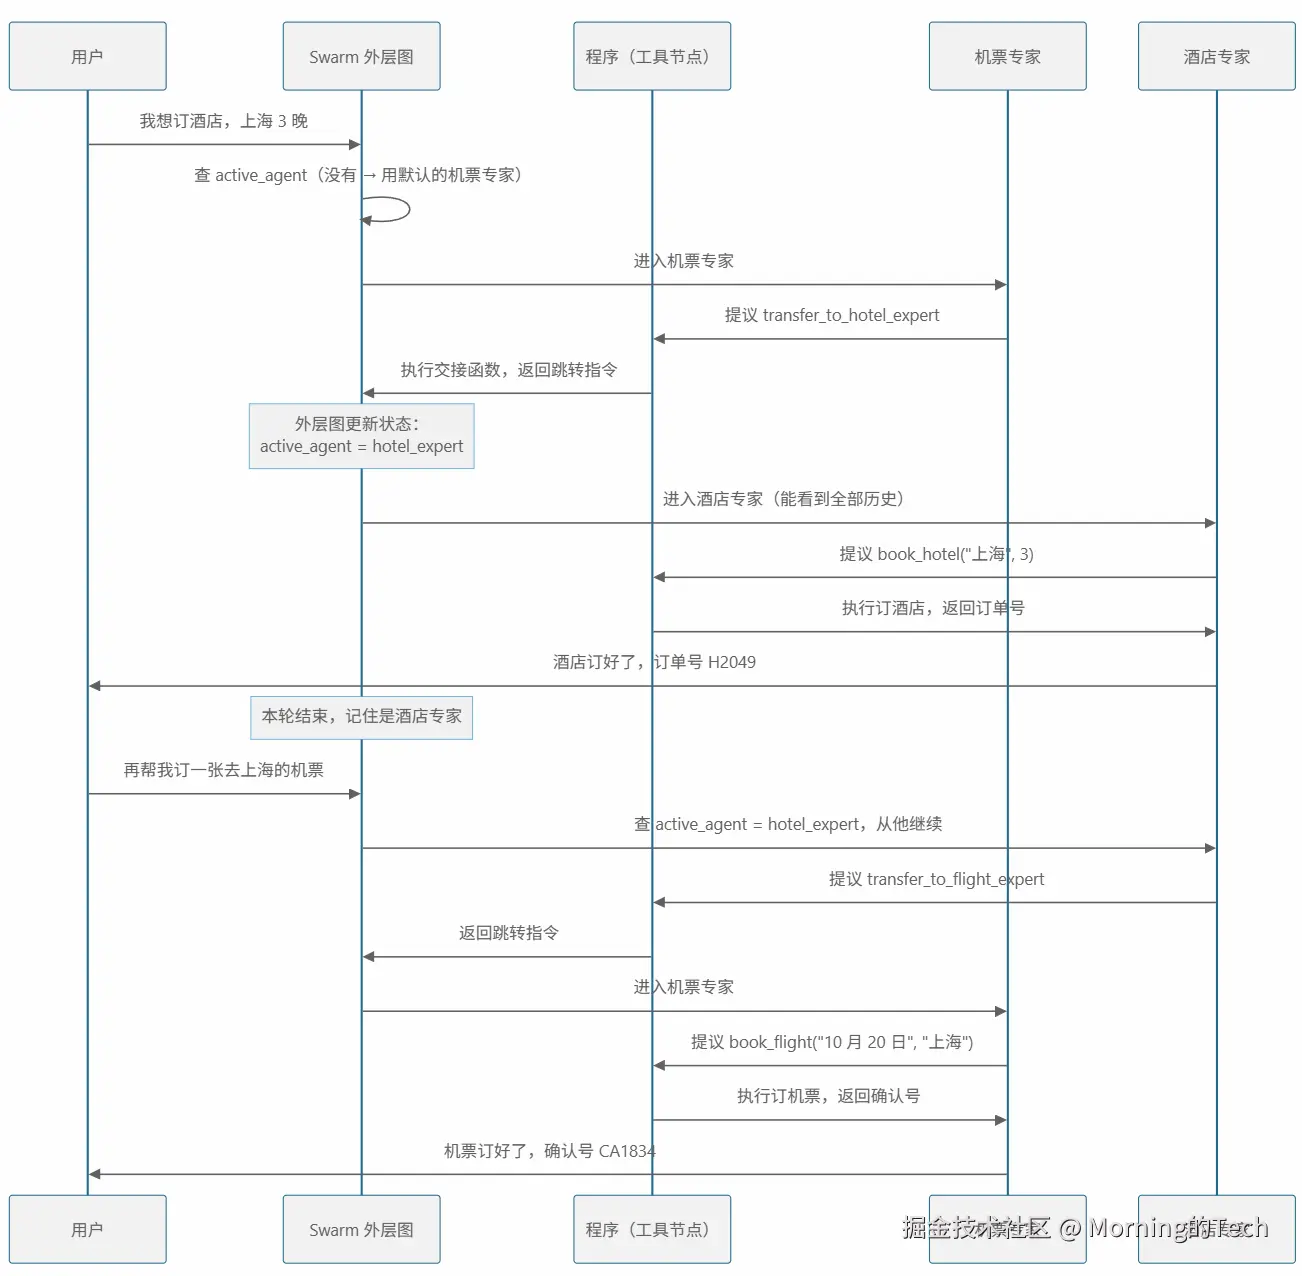
要注意的一点:同一时刻只有一个人在干活。看起来像在"商量",其实是串行接力------一个专家干完才轮到下一个,中间可以随时互相传回来。
五、和 Supervisor 怎么选
一张速查表:
| 你的情况 | 选 |
|---|---|
| 需要有人统管全局、看得见进度 | Supervisor |
| 需要多人并行干活 | Supervisor |
| 步骤有先后、一次只要一个专家 | Swarm |
| 希望接手的人看到完整对话,省一层传话 | Swarm |
| 成本敏感(少一层中枢反复读历史) | Swarm |
| 需要可追溯的决策链路 | Supervisor |
它们底层其实一模一样:都是共享消息状态 + 交接工具 + Command(PARENT) 跳转。差别只在于这套零件被拼成了什么形状。
六、它的边界要说清
Swarm 很轻巧,但也正因为轻,有几件事它做不到:
- 不能并行。任务没法拆开让两个人同时做
- 没人负责全局。没有任何节点知道"整体任务完成到哪一步了"
- 不支持"多人同场" 。没有任何机制让两个 Agent 同时在场对话,它是一条接力赛道,不是一间会议室
- 名单开工前定死。运行时不能凭空生成一个新专家
- 默认单机同进程。所有专家在同一张图、同一个进程里跑。想把某个专家放到另一台机器上,LangGraph 的 RemoteGraph 可以调远端的图,但它是"调用方"的能力,不是 Swarm 自带的部署方案------用时得自己把专家换成 RemoteGraph 节点
- 共享历史会变臃肿。每个人的中间过程都在同一个大群里,长任务下 token 涨得快
适合它的,是那种"专家分工清楚、一次一个专家、上下文不该被拆散"的活儿。超出了这个范围,就该换 Supervisor,或者自己搭建工作流。
系列:《LangGraph 的Supervisor 多智能体机制》→ 《LangGraph 的 Swarm 多智能体机制》