前面讲了 Flink SQL 的 TableEnvironment、Table API、查询与过滤、分组与聚合、自定义 UDF、Table Window,这些都是 Flink SQL 的基础能力。但基础能力讲得再多,不落到真实的企业级场景中,总觉得差了点什么------生产环境中的数据量、延迟要求、稳定性挑战、运维复杂度,和 demo 完全不是一个量级。
这篇不讲新的 API,而是把前面讲的所有能力串起来,落到三个真实的企业级案例中:实时订单统计大屏(电商/零售)、实时用户画像系统(互联网/营销)、实时风控告警系统(金融/支付)。每个案例都包含完整的业务背景、架构设计、核心 Flink SQL 代码、技术挑战与解决方案、关键性能指标。最后总结企业级最佳实践、性能调优、常见坑和上线 Checklist。
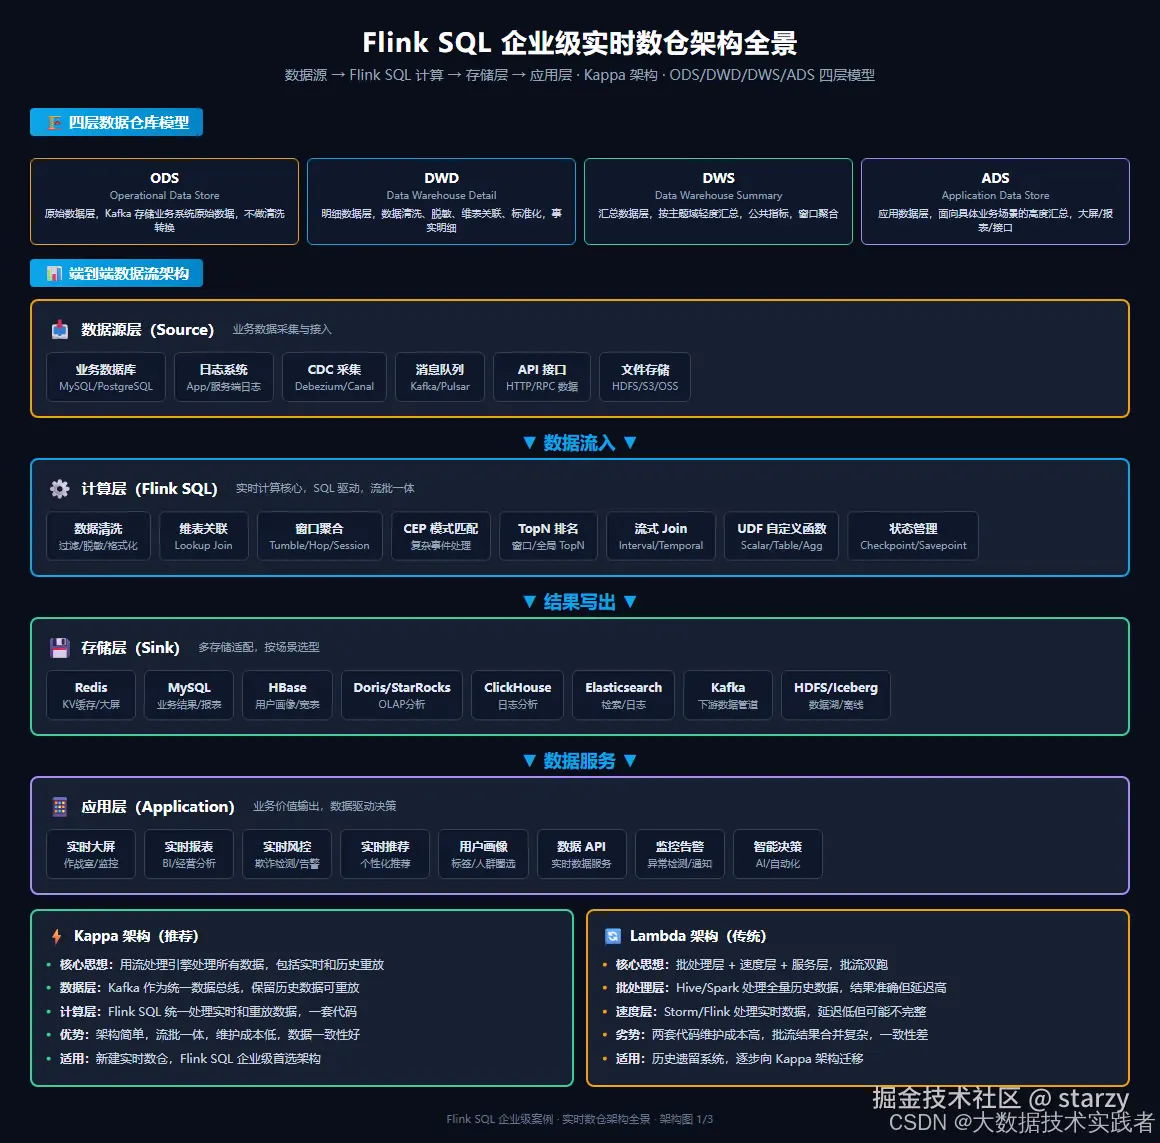
下面这张图是企业级实时数仓的整体架构,包含 ODS/DWD/DWS/ADS 四层模型、端到端数据流、Kappa 与 Lambda 架构对比。
一、企业级实时数仓架构
1.1 为什么需要实时数仓
传统的离线数仓(Hive + Spark)是 T+1 的------今天的数据明天才能看到,对于大促监控、风控拦截、实时推荐这些场景,T+1 完全不够用。实时数仓的核心价值是秒级甚至毫秒级的数据可见性,让业务决策从"事后复盘"变成"实时响应"。
Flink SQL 是实时数仓的计算核心------SQL 驱动降低了开发门槛,流批一体保证了口径一致,Exactly-Once 保证了数据准确,状态管理和 Checkpoint 保证了稳定性。
1.2 四层数据仓库模型
企业级实时数仓通常采用四层模型:
| 层级 | 全称 | 职责 | 典型存储 |
|---|---|---|---|
| ODS | Operational Data Store | 原始数据层,存储业务系统原始数据,不做清洗转换 | Kafka |
| DWD | Data Warehouse Detail | 明细数据层,数据清洗、脱敏、维表关联、标准化,事实明细 | Kafka/Doris |
| DWS | Data Warehouse Summary | 汇总数据层,按主题域轻度汇总,公共指标,窗口聚合 | Kafka/Redis |
| ADS | Application Data Store | 应用数据层,面向具体业务场景的高度汇总 | MySQL/Redis/大屏 |
数据从 ODS 到 DWD 到 DWS 到 ADS 逐层加工,每一层都有明确的职责和数据粒度。这种分层模型的好处是:公共逻辑下沉到 DWD/DWS,避免重复计算;ADS 层只做面向应用的轻量加工,响应快;数据血缘清晰,问题排查容易。
1.3 Kappa 架构 vs Lambda 架构
- Kappa 架构(推荐):用流处理引擎统一处理所有数据,包括实时和历史重放。Kafka 作为统一数据总线保留历史数据,Flink SQL 一套代码处理实时和重放。架构简单,流批一体,维护成本低,数据一致性好。新建实时数仓首选 Kappa。
- Lambda 架构(传统):批处理层(Hive/Spark)+ 速度层(Storm/Flink)+ 服务层,批流双跑。批处理结果准确但延迟高,速度层延迟低但可能不完整,服务层合并两边结果。两套代码维护成本高,批流结果合并复杂,一致性差。历史遗留系统逐步向 Kappa 迁移。
核心结论:新业务一律用 Kappa 架构,Flink SQL + Kafka 是当前实时数仓的最佳组合。
二、案例一:实时订单统计大屏
2.1 业务背景
电商/零售行业在大促期间(双11、618)需要实时监控 GMV、订单量、客单价、转化率等核心指标,运营团队需要秒级感知异常(如某渠道订单量骤降),管理层需要实时大屏展示战况。
核心指标:实时 GMV、订单量、客单价、支付转化率、各渠道/各地区占比、TOP 商品。
SLA 要求:延迟 1-3 秒,峰值吞吐 10 万+ 订单/秒,7×24 高可用,Exactly-Once 不丢不重。
2.2 架构设计
scss
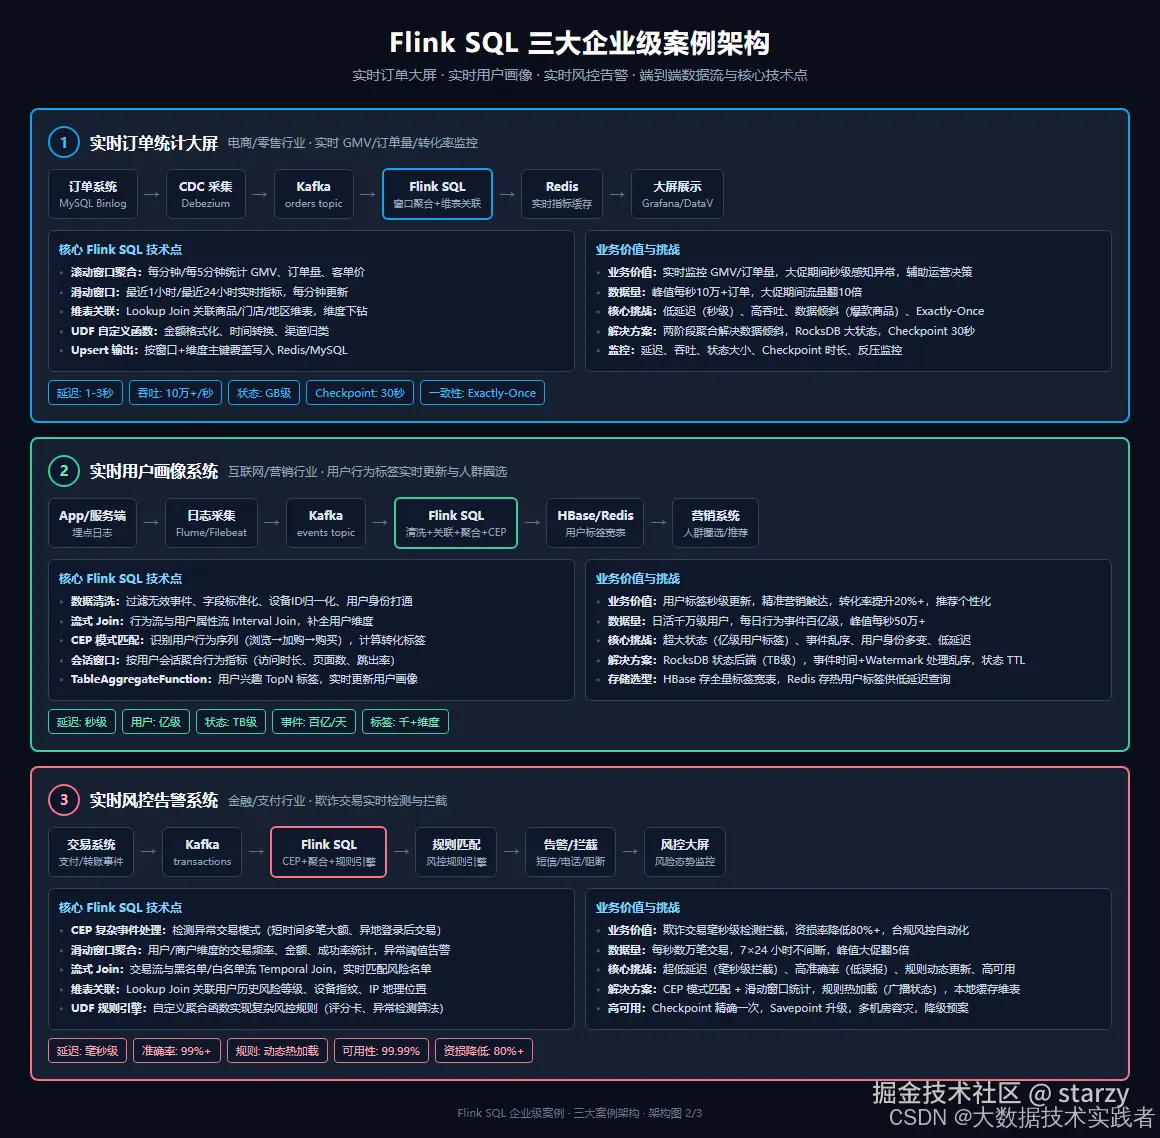
订单系统 MySQL → Debezium CDC → Kafka(orders topic) → Flink SQL → Redis → 实时大屏
↘ MySQL(历史明细)- 数据源:订单系统 MySQL 通过 Debezium CDC 采集 Binlog,写入 Kafka orders topic,保证数据不丢。
- 计算层:Flink SQL 做滚动窗口聚合(每分钟)、滑动窗口聚合(最近1小时/24小时)、Lookup Join 关联商品/门店/地区维表、UDF 做金额格式化和渠道归类。
- 存储层:实时指标写入 Redis(大屏低延迟查询),历史明细写入 MySQL/Doris(回溯分析)。
- 应用层:Grafana/DataV 大屏从 Redis 读取指标,秒级刷新。
2.3 核心 Flink SQL 代码
sql
-- 1. 订单源表(CDC采集,事件时间+Watermark)
CREATE TABLE orders (
    order_id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    shop_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    channel STRING,
    order_time TIMESTAMP(3),
    WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
) WITH (
    'connector' = 'kafka',
    'topic' = 'orders',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'properties.group.id' = 'realtime-dashboard',
    'format' = 'debezium-json',
    'scan.startup.mode' = 'latest-offset'
);

-- 2. 商品维表(MySQL Lookup表)
CREATE TABLE dim_product (
    product_id BIGINT,
    product_name STRING,
    category_id BIGINT,
    category_name STRING,
    PRIMARY KEY (product_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://mysql:3306/dim',
    'table-name' = 'dim_product',
    'username' = 'readonly',
    'password' = 'xxx',
    'lookup.cache.max-rows' = '10000',
    'lookup.cache.ttl' = '10min'
);

-- 3. 地区维表
CREATE TABLE dim_region (
    city_id BIGINT,
    city_name STRING,
    province_name STRING,
    region_name STRING,
    PRIMARY KEY (city_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://mysql:3306/dim',
    'table-name' = 'dim_region',
    'username' = 'readonly',
    'password' = 'xxx',
    'lookup.cache.max-rows' = '5000',
    'lookup.cache.ttl' = '1h'
);

-- 4. Redis结果表(Upsert模式,按窗口+维度主键覆盖)
CREATE TABLE rt_dashboard (
    window_start TIMESTAMP(3),
    window_end TIMESTAMP(3),
    dimension STRING,
    dimension_value STRING,
    gmv DECIMAL(14,2),
    order_cnt BIGINT,
    avg_amount DECIMAL(10,2),
    PRIMARY KEY (window_start, window_end, dimension, dimension_value) NOT ENFORCED
) WITH (
    'connector' = 'redis',
    'host' = 'redis-host',
    'port' = '6379',
    'password' = 'xxx',
    'db-namespace' = 'dashboard',
    'key-format' = 'csv',
    'value.format' = 'json'
);

-- 5. 每分钟各渠道GMV和订单量(滚动窗口聚合+维表关联)
INSERT INTO rt_dashboard
SELECT
    window_start,
    window_end,
    'channel' AS dimension,
    o.channel AS dimension_value,
    SUM(o.amount) AS gmv,
    COUNT(*) AS order_cnt,
    AVG(o.amount) AS avg_amount
FROM TABLE(
    TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE)
) o
WHERE o.status = 'PAID'
GROUP BY window_start, window_end, o.channel;

-- 6. 最近1小时各地区GMV(滑动窗口,每分钟更新)
INSERT INTO rt_dashboard
SELECT
    window_start,
    window_end,
    'region' AS dimension,
    r.region_name AS dimension_value,
    SUM(o.amount) AS gmv,
    COUNT(*) AS order_cnt,
    AVG(o.amount) AS avg_amount
FROM TABLE(
    HOP(TABLE orders, DESCRIPTOR(order_time), INTERVAL '1' MINUTE, INTERVAL '1' HOUR)
) o
JOIN dim_region FOR SYSTEM_TIME AS OF o.order_time AS r
  ON o.city_id = r.city_id
WHERE o.status = 'PAID'
GROUP BY window_start, window_end, r.region_name;
2.4 技术挑战与解决方案
挑战一:数据倾斜(爆款商品/大渠道) 大促期间某个爆款商品的订单量可能是其他商品的 100 倍,导致聚合时该 key 的并行实例过载。 解决方案:开启两阶段聚合 table.optimizer.agg-phase-strategy=TWO_PHASE,热点 key 先在多个本地实例预聚合,全局只 merge 少量结果。同时开启 MiniBatch 微批预聚合,减少状态访问。
挑战二:维表关联的性能和一致性 Lookup Join 每次关联都查 MySQL,高并发下数据库压力大,且维表数据可能变化。 解决方案:开启 Lookup 缓存 lookup.cache.max-rows=10000 + lookup.cache.ttl=10min,减少数据库查询。用 FOR SYSTEM_TIME AS OF 时态关联,保证关联的是订单发生时刻的维表版本(维表变化不影响历史数据口径)。
挑战三:Exactly-Once 端到端一致性 Kafka Source + Flink Checkpoint + Redis Sink 如何保证不丢不重? 解决方案:Kafka Source 支持 Checkpoint 记录 offset,故障恢复从 Checkpoint 的 offset 重新消费。Redis Sink 用 Upsert 模式(按主键覆盖),重复数据幂等写入,最终一致。Checkpoint 间隔 30 秒,保证故障恢复后最多重复 30 秒数据,Upsert 幂等消除重复。
2.5 关键性能指标
| 指标 | 值 | 说明 |
|---|---|---|
| 端到端延迟 | 1-3 秒 | 订单创建到大屏展示 |
| 峰值吞吐 | 10 万+ 订单/秒 | 大促峰值 |
| 状态大小 | GB 级 | 滑动窗口+维表缓存 |
| Checkpoint 间隔 | 30 秒 | 平衡延迟和恢复时间 |
| 一致性 | Exactly-Once | Kafka offset + Upsert 幂等 |
| 可用性 | 99.99% | 多机房容灾 |
三、案例二:实时用户画像系统
3.1 业务背景
互联网/营销行业需要基于用户实时行为更新用户标签(如"最近30分钟浏览了iPhone"、"高消费用户"、"活跃用户"),用于精准营销触达、个性化推荐、人群圈选。传统的离线画像 T+1 更新,用户兴趣变化快时推荐不精准。
核心能力:用户行为实时采集、身份归一化、行为序列分析、标签实时计算、人群圈选、标签服务 API。
SLA 要求:标签秒级更新,日活千万级用户,每日行为事件百亿级,峰值 50 万+ 事件/秒,标签查询毫秒级响应。
3.2 架构设计
scss
App/服务端埋点 → Flume/Filebeat → Kafka(events) → Flink SQL → HBase(全量标签宽表)
↘ Redis(热用户标签) → 营销系统/推荐系统- 数据源:App 和服务端埋点日志通过 Flume/Filebeat 采集,写入 Kafka events topic。
- 计算层:Flink SQL 做数据清洗(过滤无效事件、字段标准化)、身份归一化(设备ID→用户ID打通)、Interval Join(行为流与用户属性流关联)、CEP 模式匹配(识别浏览→加购→购买序列)、会话窗口(用户访问指标)、TableAggregateFunction(用户兴趣 TopN 标签)。
- 存储层:HBase 存储全量用户标签宽表(亿级用户、千+标签维度),Redis 存储热用户标签供低延迟查询。
- 应用层:营销系统人群圈选、推荐系统个性化推荐、数据 API 服务。
3.3 核心 Flink SQL 代码
sql
-- 1. 用户行为事件源表
CREATE TABLE user_events (
    event_id STRING,
    user_id BIGINT,
    device_id STRING,
    event_type STRING,
    product_id BIGINT,
    category_id BIGINT,
    page_id STRING,
    duration INT,
    event_time TIMESTAMP(3),
    WATERMARK FOR event_time AS event_time - INTERVAL '10' SECOND
) WITH (
    'connector' = 'kafka',
    'topic' = 'user_events',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'properties.group.id' = 'realtime-profile',
    'format' = 'json'
);

-- 2. 用户属性流(用户注册/信息变更)
CREATE TABLE user_profile (
    user_id BIGINT,
    gender STRING,
    age_group STRING,
    city STRING,
    member_level STRING,
    update_time TIMESTAMP(3),
    WATERMARK FOR update_time AS update_time - INTERVAL '10' SECOND
) WITH (
    'connector' = 'kafka',
    'topic' = 'user_profile',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'format' = 'debezium-json'
);

-- 3. HBase用户标签宽表
CREATE TABLE user_tags (
    user_id BIGINT,
    tag_family ROW<
        active_level STRING,
        consumption_level STRING,
        interest_top1 STRING,
        interest_top2 STRING,
        interest_top3 STRING,
        last_visit_time TIMESTAMP(3),
        session_count BIGINT,
        total_duration BIGINT
    >,
    PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
    'connector' = 'hbase-2.2',
    'table-name' = 'user_profile:user_tags',
    'zookeeper.quorum' = 'zk-host:2181',
    'zookeeper.znode.parent' = '/hbase'
);

-- 4. 用户会话指标(会话窗口:30分钟无操作则会话结束)
CREATE VIEW user_session_stats AS
SELECT
    user_id,
    window_start AS session_start,
    window_end AS session_end,
    COUNT(*) AS event_count,
    SUM(duration) AS total_duration,
    COUNT(DISTINCT page_id) AS page_count
FROM TABLE(
    SESSION(TABLE user_events, DESCRIPTOR(event_time), INTERVAL '30' MINUTE)
)
WHERE user_id IS NOT NULL
GROUP BY user_id, window_start, window_end;

-- 5. 用户活跃度标签(最近1小时行为统计)
CREATE VIEW user_active_tags AS
SELECT
    user_id,
    CASE
        WHEN COUNT(*) >= 50 THEN 'highly_active'
        WHEN COUNT(*) >= 10 THEN 'active'
        WHEN COUNT(*) >= 1 THEN 'light_active'
        ELSE 'inactive'
    END AS active_level,
    SUM(duration) AS total_duration,
    MAX(event_time) AS last_visit_time
FROM TABLE(
    HOP(TABLE user_events, DESCRIPTOR(event_time), INTERVAL '5' MINUTE, INTERVAL '1' HOUR)
)
WHERE user_id IS NOT NULL
GROUP BY user_id, window_start, window_end;

-- 6. 用户消费等级标签(基于历史累计消费,从用户属性流获取)
CREATE VIEW user_consumption_tags AS
SELECT
    p.user_id,
    CASE
        WHEN p.total_consumption >= 10000 THEN 'high_value'
        WHEN p.total_consumption >= 1000 THEN 'medium_value'
        WHEN p.total_consumption >= 100 THEN 'low_value'
        ELSE 'potential'
    END AS consumption_level
FROM user_profile p;

-- 7. 写入HBase标签宽表(Upsert模式,按user_id覆盖)
INSERT INTO user_tags
SELECT
    a.user_id,
    ROW(
        a.active_level,
        c.consumption_level,
        CAST(NULL AS STRING),  -- interest_top1 由CEP/TopN作业单独计算
        CAST(NULL AS STRING),
        CAST(NULL AS STRING),
        a.last_visit_time,
        CAST(NULL AS BIGINT),
        a.total_duration
    ) AS tag_family
FROM user_active_tags a
LEFT JOIN user_consumption_tags c ON a.user_id = c.user_id
WHERE a.window_end = (
    SELECT MAX(window_end) FROM user_active_tags WHERE user_id = a.user_id
);
3.4 技术挑战与解决方案
挑战一:超大状态(亿级用户标签) 千万级日活用户,每个用户维护多个窗口的状态,总状态 TB 级,HashMap 内存后端放不下。 解决方案:用 EmbeddedRocksDBStateBackend(磁盘存储,支持 TB 级状态),managed memory 占比 50%+,RocksDB 配置 LZ4 压缩和合理的 block cache。设置状态 TTL(如最近1小时窗口的状态 1 小时后清理),防止状态无限增长。
挑战二:事件乱序与迟到 App 埋点事件可能因为网络延迟、断网重传导致乱序,迟到数据到达时窗口已经触发。 解决方案:用事件时间 + Watermark(event_time - INTERVAL '10' SECOND),容忍 10 秒乱序。设置 AllowedLateness(如 5 分钟),迟到数据可重新触发窗口更新标签。超过 AllowedLateness 的数据用侧输出收集单独处理。
挑战三:用户身份归一化 用户未登录时用 device_id 标识,登录后需要把 device_id 的行为归到 user_id 下,历史行为需要合并。 解决方案:用 Interval Join 关联行为流和登录事件流,把 device_id 映射到 user_id。用 CEP 识别"匿名浏览→登录→继续浏览"的序列,把登录前的匿名行为归到登录后的 user_id。身份映射表存 Redis/HBase,支持跨设备身份打通。
3.5 关键性能指标
| 指标 | 值 | 说明 |
|---|---|---|
| 标签更新延迟 | 秒级 | 行为发生到标签更新 |
| 用户规模 | 亿级 | 累计用户数 |
| 日事件量 | 百亿级 | 每日行为事件 |
| 状态大小 | TB 级 | RocksDB 磁盘存储 |
| 标签维度 | 千+ | 用户画像标签数 |
| 标签查询延迟 | 毫秒级 | Redis 热标签查询 |
四、案例三:实时风控告警系统
4.1 业务背景
金融/支付行业需要实时检测欺诈交易(如盗刷、洗钱、薅羊毛),在交易发生的毫秒级内识别风险并拦截,避免资损。传统的离线规则引擎 T+1 出结果,欺诈交易已经完成,资损无法挽回。
核心能力:异常交易模式识别(CEP)、用户/商户风险统计(滑动窗口)、黑白名单实时匹配(Temporal Join)、设备指纹/IP 地理位置关联(Lookup Join)、风控规则引擎(UDF)、实时告警与拦截。
SLA 要求:检测延迟毫秒级(交易必须在 100ms 内完成风控检测),准确率 99%+(低误报,避免影响正常交易),规则动态热加载(运营可随时调整规则无需重启),7×24 高可用 99.99%。
4.2 架构设计
scss
交易系统 → Kafka(transactions) → Flink SQL(CEP+聚合+Join+规则UDF) → 规则匹配 → 告警/拦截
↘ 风控大屏- 数据源:交易系统将每笔交易事件写入 Kafka transactions topic。
- 计算层:Flink SQL 做 CEP 复杂事件处理(检测异常交易模式)、滑动窗口聚合(用户/商户交易频率和金额统计)、Temporal Join(黑白名单实时匹配)、Lookup Join(用户风险等级/设备指纹/IP 地理位置)、UDF 规则引擎(评分卡、异常检测算法)。
- 决策层:规则匹配引擎根据 CEP 结果、统计指标、名单匹配结果、规则评分综合决策,输出"通过/告警/拦截"。
- 应用层:拦截接口同步返回交易系统(阻断高风险交易)、告警通知(短信/电话/工单)、风控大屏(风险态势实时监控)。
4.3 核心 Flink SQL 代码
sql
-- 1. 交易事件源表
CREATE TABLE transactions (
    txn_id STRING,
    user_id BIGINT,
    merchant_id BIGINT,
    amount DECIMAL(12,2),
    currency STRING,
    card_no STRING,
    device_id STRING,
    ip STRING,
    txn_type STRING,
    txn_time TIMESTAMP(3),
    WATERMARK FOR txn_time AS txn_time - INTERVAL '3' SECOND
) WITH (
    'connector' = 'kafka',
    'topic' = 'transactions',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'properties.group.id' = 'realtime-risk',
    'format' = 'json',
    'scan.startup.mode' = 'latest-offset'
);

-- 2. 黑名单流(动态更新,Temporal Join用)
CREATE TABLE blacklist (
    entity_type STRING,  -- user/card/device/ip/merchant
    entity_id STRING,
    risk_level STRING,   -- high/medium/low
    update_time TIMESTAMP(3),
    WATERMARK FOR update_time AS update_time - INTERVAL '3' SECOND,
    PRIMARY KEY (entity_type, entity_id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'risk_blacklist',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'format' = 'debezium-json'
);

-- 3. 用户风险等级维表(MySQL Lookup)
CREATE TABLE dim_user_risk (
    user_id BIGINT,
    risk_score INT,
    risk_level STRING,
    history_fraud_count INT,
    PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://mysql:3306/risk',
    'table-name' = 'dim_user_risk',
    'username' = 'risk_reader',
    'password' = 'xxx',
    'lookup.cache.max-rows' = '50000',
    'lookup.cache.ttl' = '5min'
);

-- 4. IP地理位置维表
CREATE TABLE dim_ip_geo (
    ip STRING,
    country STRING,
    province STRING,
    city STRING,
    is_proxy BOOLEAN,
    PRIMARY KEY (ip) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://mysql:3306/risk',
    'table-name' = 'dim_ip_geo',
    'username' = 'risk_reader',
    'password' = 'xxx',
    'lookup.cache.max-rows' = '100000',
    'lookup.cache.ttl' = '1h'
);

-- 5. 风控结果表(Kafka,交易系统消费做拦截决策)
CREATE TABLE risk_results (
    txn_id STRING,
    user_id BIGINT,
    risk_score INT,
    risk_level STRING,
    decision STRING,  -- pass/alert/block
    hit_rules STRING,
    process_time TIMESTAMP(3)
) WITH (
    'connector' = 'kafka',
    'topic' = 'risk_results',
    'properties.bootstrap.servers' = 'kafka-broker:9092',
    'format' = 'json'
);

-- 6. 用户近5分钟交易统计(滑动窗口,检测高频交易)
CREATE VIEW user_txn_stats AS
SELECT
    user_id,
    window_start,
    window_end,
    COUNT(*) AS txn_count,
    SUM(amount) AS total_amount,
    COUNT(DISTINCT merchant_id) AS merchant_count,
    COUNT(DISTINCT ip) AS ip_count,
    MAX(amount) AS max_amount
FROM TABLE(
    HOP(TABLE transactions, DESCRIPTOR(txn_time), INTERVAL '10' SECOND, INTERVAL '5' MINUTE)
)
GROUP BY user_id, window_start, window_end;

-- 7. CEP异常模式检测:短时间内多笔大额+异地+代理IP
-- (实际生产中CEP用MATCH_RECOGNIZE语法,这里展示核心逻辑)
CREATE VIEW cep_alerts AS
SELECT *
FROM transactions
MATCH_RECOGNIZE (
    PARTITION BY user_id
    ORDER BY txn_time
    MEASURES
        FIRST(t.txn_id) AS first_txn_id,
        LAST(t.txn_id) AS last_txn_id,
        COUNT(*) AS txn_count,
        SUM(t.amount) AS total_amount
    ONE ROW PER MATCH
    AFTER MATCH SKIP PAST LAST ROW
    PATTERN (t1 t2 t3) WITHIN INTERVAL '2' MINUTE
    DEFINE
        t1 AS t1.amount > 5000,
        t2 AS t2.amount > 5000 AND t2.ip <> t1.ip,
        t3 AS t3.amount > 5000 AND t3.ip <> t2.ip
);

-- 8. 综合风控评分与决策(关联统计+CEP+维表+名单,UDF计算评分)
INSERT INTO risk_results
SELECT
    t.txn_id,
    t.user_id,
    risk_score_udf(
        s.txn_count,
        s.total_amount,
        s.ip_count,
        u.risk_score,
        b.risk_level,
        g.is_proxy,
        c.txn_count
    ) AS risk_score,
    CASE
        WHEN risk_score_udf(...) >= 80 THEN 'high'
        WHEN risk_score_udf(...) >= 50 THEN 'medium'
        ELSE 'low'
    END AS risk_level,
    CASE
        WHEN risk_score_udf(...) >= 80 THEN 'block'
        WHEN risk_score_udf(...) >= 50 THEN 'alert'
        ELSE 'pass'
    END AS decision,
    hit_rules_udf(s.txn_count, s.ip_count, b.risk_level, g.is_proxy, c.txn_count) AS hit_rules,
    CURRENT_TIMESTAMP AS process_time
FROM transactions t
LEFT JOIN user_txn_stats s
  ON t.user_id = s.user_id AND s.window_end >= t.txn_time
LEFT JOIN dim_user_risk FOR SYSTEM_TIME AS OF t.txn_time AS u
  ON t.user_id = u.user_id
LEFT JOIN blacklist FOR SYSTEM_TIME AS OF t.txn_time AS b
  ON b.entity_type = 'user' AND b.entity_id = CAST(t.user_id AS STRING)
LEFT JOIN dim_ip_geo FOR SYSTEM_TIME AS OF t.txn_time AS g
  ON t.ip = g.ip
LEFT JOIN cep_alerts c ON t.user_id = c.user_id;
4.4 技术挑战与解决方案
挑战一:超低延迟(毫秒级检测) 交易必须在 100ms 内完成风控检测并返回决策,否则影响用户体验和交易成功率。 解决方案:① 所有维表用 Lookup 缓存(用户风险等级缓存 5 分钟、IP 地理位置缓存 1 小时),避免每次查数据库;② 黑白名单用 Temporal Join(版本化表,状态在 Flink 内部,不查外部);③ CEP 和滑动窗口聚合状态在内存中(小状态用 HashMap);④ UDF 规则引擎本地计算,不调外部服务;⑤ 网络优化(Flink 与 Kafka/交易系统同机房部署)。
挑战二:规则动态热加载 风控规则需要频繁调整(如新型欺诈出现后紧急加规则),不能每次改规则都重启作业。 解决方案:① 黑白名单用 Kafka 流(Temporal Join),运营后台更新名单后实时写入 Kafka,Flink 秒级感知;② 规则参数用广播状态(Broadcast State),配置变更广播到所有并行实例;③ 评分卡规则用 UDF 从配置中心(Apollo/Nacos)动态读取,规则变更无需重启;④ 复杂规则用 CEP MATCH_RECOGNIZE,规则变更通过 SQL 升级 + Savepoint 恢复。
挑战三:高准确率(低误报) 误报率高会拦截正常交易,影响用户体验和商户收入。风控系统的核心指标是"在保证召回率的前提下降低误报率"。 解决方案:① 多维度特征交叉(用户历史风险 + 当前交易行为 + 设备指纹 + IP 地理位置 + 商户风险),单一维度容易误报;② 规则评分卡机制(每条规则贡献不同分数,总分超过阈值才拦截),避免单条规则直接拦截;③ 模型辅助(用机器学习模型计算欺诈概率,UDF 调用模型服务),规则 + 模型双引擎;④ 持续迭代(误报案例反馈,规则调优,模型重训)。
4.5 关键性能指标
| 指标 | 值 | 说明 |
|---|---|---|
| 检测延迟 | 毫秒级 | 交易进入到决策输出 |
| 准确率 | 99%+ | 欺诈识别准确率 |
| 误报率 | <0.1% | 正常交易被误拦截比例 |
| 规则更新 | 秒级热加载 | 无需重启作业 |
| 可用性 | 99.99% | 7×24 高可用 |
| 资损降低 | 80%+ | 相比离线风控 |
五、企业级最佳实践与运维监控
下面这张图把三大企业级案例的端到端架构、核心技术点、业务价值、关键指标放在一起展示。
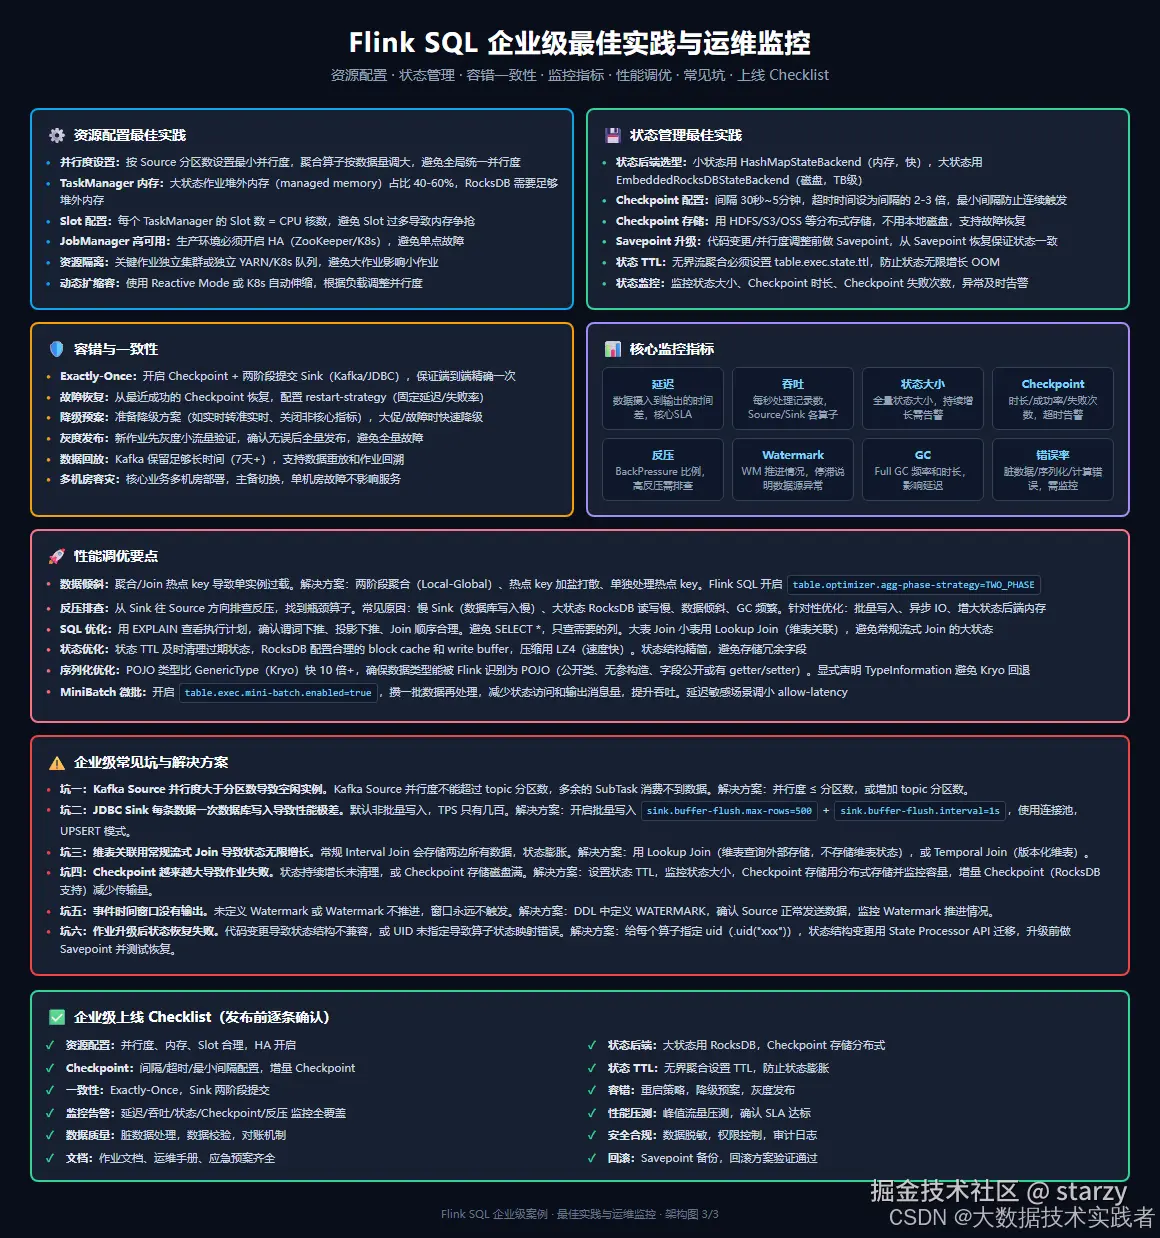
下面这张图是企业级最佳实践与运维监控的全景,包含资源配置、状态管理、容错一致性、监控指标、性能调优、常见坑、上线 Checklist。
5.1 资源配置最佳实践
- 并行度设置:按 Source 分区数设置最小并行度,聚合算子按数据量调大,避免全局统一并行度。Source 并行度不能超过 Kafka topic 分区数。
- TaskManager 内存:大状态作业堆外内存(managed memory)占比 40-60%,RocksDB 需要足够堆外内存。网络内存(network memory)占比 10-15%,高吞吐作业适当调大。
- Slot 配置:每个 TaskManager 的 Slot 数 = CPU 核数,避免 Slot 过多导致内存争抢。Slot Sharing 让不同算子共享 Slot,提高资源利用率。
- JobManager 高可用:生产环境必须开启 HA(ZooKeeper/K8s),避免单点故障。JobManager 内存 2-4GB 足够,大作业适当调大。
- 资源隔离:关键作业独立集群或独立 YARN/K8s 队列,避免大作业影响小作业。生产和测试环境隔离。
5.2 状态管理最佳实践
- 状态后端选型:小状态(<10GB)用 HashMapStateBackend(内存,速度快),大状态用 EmbeddedRocksDBStateBackend(磁盘,支持 TB 级)。企业级生产环境默认用 RocksDB。
- Checkpoint 配置:间隔 30 秒~5 分钟(风控等低延迟场景 10-30 秒,大屏场景 1-5 分钟),超时时间设为间隔的 2-3 倍,最小间隔防止连续触发。RocksDB 用增量 Checkpoint 减少传输量。
- Checkpoint 存储:用 HDFS/S3/OSS 等分布式存储,不用本地磁盘,支持故障恢复和跨机房恢复。存储容量监控,避免磁盘满导致 Checkpoint 失败。
- Savepoint 升级 :代码变更/并行度调整前做 Savepoint,从 Savepoint 恢复保证状态一致。给每个算子指定 uid(
.uid("xxx")),避免状态映射错误。 - 状态 TTL :无界流聚合必须设置
table.exec.state.ttl,防止状态无限增长 OOM。窗口聚合的状态由窗口自动清理,不需要额外设置 TTL。
5.3 容错与一致性
- Exactly-Once:开启 Checkpoint + 两阶段提交 Sink(Kafka 0.11+、JDBC XA),保证端到端精确一次。非两阶段提交 Sink(如 Redis Upsert)用幂等写入实现最终一致。
- 故障恢复:从最近成功的 Checkpoint 恢复,配置 restart-strategy(固定延迟:重启 3 次每次间隔 10 秒;失败率:5 分钟内失败 3 次则失败)。
- 降级预案:准备降级方案(如实时转准实时、关闭非核心指标、限流),大促/故障时快速降级,保证核心链路可用。
- 灰度发布:新作业先灰度小流量验证,确认无误后全量发布。A/B 测试对比新旧作业结果,避免全量故障。
- 数据回放:Kafka 保留足够长时间(7 天+),支持数据重放和作业回溯。数据修复时可从指定 offset 重放。
5.4 核心监控指标
| 指标 | 说明 | 告警阈值 |
|---|---|---|
| 延迟 | 数据摄入到输出的时间差 | 超过 SLA 的 2 倍 |
| 吞吐 | 每秒处理记录数 | 持续低于预期 50% |
| 状态大小 | 全量状态大小 | 持续增长或超过阈值 |
| Checkpoint 时长 | Checkpoint 完成时间 | 超过间隔的 80% |
| Checkpoint 失败率 | Checkpoint 失败次数 | 连续失败 3 次 |
| 反压 | BackPressure 比例 | 高反压持续 5 分钟 |
| Watermark | WM 推进情况 | WM 停滞 5 分钟 |
| GC | Full GC 频率和时长 | Full GC 每分钟 >1 次 |
| 错误率 | 脏数据/序列化/计算错误 | 错误率 >1% |
监控工具:Flink Web UI(内置 Metrics)、Prometheus + Grafana(企业级监控)、告警通道(短信/电话/飞书/钉钉)。
5.5 性能调优要点
- 数据倾斜 :聚合/Join 热点 key 导致单实例过载。解决方案:两阶段聚合(Local-Global)、热点 key 加盐打散、单独处理热点 key。Flink SQL 开启
table.optimizer.agg-phase-strategy=TWO_PHASE。 - 反压排查:从 Sink 往 Source 方向排查反压,找到瓶颈算子。常见原因:慢 Sink(数据库写入慢)→ 批量写入+连接池;大状态 RocksDB 读写慢 → 增大 managed memory+调优 RocksDB;数据倾斜 → 两阶段聚合;GC 频繁 → 调大堆内存+对象复用。
- SQL 优化:用 EXPLAIN 查看执行计划,确认谓词下推、投影下推、Join 顺序合理。避免 SELECT *,只查需要的列。大表 Join 小表用 Lookup Join(维表关联),避免常规流式 Join 的大状态。
- 序列化优化:POJO 类型比 GenericType(Kryo)快 10 倍+,确保数据类型能被 Flink 识别为 POJO(公开类、无参构造、字段公开或有 getter/setter)。显式声明 TypeInformation 避免 Kryo 回退。
- MiniBatch 微批 :开启
table.exec.mini-batch.enabled=true,攒一批数据再处理,减少状态访问和输出消息量,提升吞吐。延迟敏感场景调小allow-latency(如 1 秒)。
六、六个企业级常见坑
6.1 坑一:Kafka Source 并行度大于分区数导致空闲实例
现象:Source 算子有多个 SubTask,但部分 SubTask 消费不到数据,吞吐上不去。
根因:Kafka Source 并行度不能超过 topic 分区数,多余的 SubTask 没有分区可消费,处于空闲状态。
解决方案:并行度 ≤ 分区数。需要更高吞吐时增加 Kafka topic 分区数(注意增加分区会影响 key 分区顺序,仅对无 key 顺序要求的 topic 安全)。
6.2 坑二:JDBC Sink 每条数据一次数据库写入导致性能极差
现象:JDBC Sink 写入 MySQL/PostgreSQL 时 TPS 只有几百,延迟高,反压严重。
根因:默认非批量写入,每条数据一次数据库 INSERT,网络往返和事务开销大。
解决方案 :开启批量写入 sink.buffer-flush.max-rows=500 + sink.buffer-flush.interval=1s,攒一批数据一次写入。使用连接池(HikariCP),UPSERT 模式(按主键覆盖,减少锁竞争)。数据库端合理设置索引和 innodb_flush_log_at_trx_commit。
6.3 坑三:维表关联用常规流式 Join 导致状态无限增长
现象:用常规 Interval Join 关联事实流和维表流,状态持续增长,Checkpoint 越来越大,最终 OOM。
根因:常规流式 Join 会存储两边所有数据(直到超过时间区间),维表数据变化频繁时状态膨胀。
解决方案:用 Lookup Join(维表查询外部存储 MySQL/Redis,不存储维表状态,只缓存查询结果),或 Temporal Join(版本化维表,只存储当前版本,状态可控)。维表关联是 Lookup Join 的典型场景,不要用常规流式 Join。
6.4 坑四:Checkpoint 越来越大导致作业失败
现象:作业运行一段时间后 Checkpoint 时长越来越长,最终超时失败,作业重启。
根因:状态持续增长未清理(无状态 TTL),或 Checkpoint 存储磁盘满,或全量 Checkpoint 传输量大。
解决方案 :① 设置状态 TTL(table.exec.state.ttl),及时清理过期状态;② 监控状态大小,异常增长及时排查;③ Checkpoint 存储用分布式存储(HDFS/S3)并监控容量;④ RocksDB 用增量 Checkpoint,只传输变更部分,减少传输量;⑤ 大状态作业增大 Checkpoint 超时时间。
6.5 坑五:事件时间窗口没有输出
现象:窗口聚合作业运行后没有任何输出,Flink Web UI 中窗口算子没有记录发出。
根因:未定义 Watermark(DDL 中没有 WATERMARK FOR 子句),或 Watermark 不推进(Source 没有发送 Watermark,或所有数据的事件时间不增长),窗口永远不触发。
解决方案 :① DDL 中定义 Watermark:WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND;② 确认 Source 正常发送数据且事件时间递增;③ 监控 Flink Web UI 中的 Watermark 推进情况,WM 停滞说明数据源异常;④ 测试环境可用处理时间窗口验证逻辑,但生产环境必须用事件时间。
6.6 坑六:作业升级后状态恢复失败
现象:代码变更后从 Savepoint 恢复作业,报状态恢复失败,或算子状态映射错误,结果异常。
根因:代码变更导致状态结构不兼容(如累加器类变更),或算子 UID 未指定导致状态映射到错误的算子。
解决方案 :① 给每个算子指定 uid(.uid("source_orders")),保证升级后状态映射正确;② 状态结构变更用 State Processor API 迁移旧状态到新结构;③ 升级前做 Savepoint 并在测试环境验证恢复;④ 不兼容的变更(如状态结构大改)考虑从零启动(接受历史状态丢失),或用双跑过渡(新旧作业并行运行,确认一致后切流)。
七、企业级上线 Checklist
发布前逐条确认:
- 资源配置:并行度、内存、Slot 合理,JobManager HA 开启。
- 状态后端:大状态用 RocksDB,Checkpoint 存储用分布式存储(HDFS/S3)。
- Checkpoint:间隔/超时/最小间隔配置合理,RocksDB 用增量 Checkpoint。
- 状态 TTL:无界流聚合设置 TTL,防止状态膨胀。
- 一致性:Exactly-Once,Sink 两阶段提交或幂等写入。
- 容错:重启策略配置,降级预案准备,灰度发布方案。
- 监控告警:延迟/吞吐/状态/Checkpoint/反压/Watermark/GC 监控全覆盖,告警通道配置。
- 性能压测:峰值流量压测,确认 SLA 达标,找到性能瓶颈并优化。
- 数据质量:脏数据处理,数据校验,对账机制(实时 vs 离线 T+1 对账)。
- 安全合规:数据脱敏(手机号/身份证/银行卡),权限控制,审计日志。
- 文档:作业文档、运维手册、应急预案齐全,新人能接手。
- 回滚:Savepoint 备份,回滚方案验证通过,能快速回退到稳定版本。
八、总结
Flink SQL 企业级案例分析要点回顾:
第一,企业级实时数仓架构:ODS(原始数据)→ DWD(明细清洗)→ DWS(汇总指标)→ ADS(应用数据)四层模型,Kafka 作为统一数据总线,Flink SQL 作为计算核心,Kappa 架构(流批一体)是新建实时数仓的首选。
第二,案例一实时订单统计大屏:CDC 采集订单 Binlog → Kafka → Flink SQL(滚动/滑动窗口聚合 + Lookup 维表关联 + UDF)→ Redis → 大屏。核心挑战是数据倾斜(两阶段聚合)、维表性能(Lookup 缓存 + 时态关联)、Exactly-Once(Kafka offset + Upsert 幂等)。延迟 1-3 秒,吞吐 10 万+/秒。
第三,案例二实时用户画像系统:App 埋点 → Kafka → Flink SQL(清洗 + Interval Join + CEP + 会话窗口 + TableAggregate TopN)→ HBase(全量标签)+ Redis(热标签)→ 营销/推荐。核心挑战是超大状态(RocksDB TB 级)、事件乱序(Watermark + AllowedLateness)、身份归一化(Interval Join + CEP)。用户亿级,事件百亿/天,标签秒级更新。
第四,案例三实时风控告警系统:交易事件 → Kafka → Flink SQL(CEP 模式匹配 + 滑动窗口统计 + Temporal Join 黑白名单 + Lookup 维表 + UDF 规则引擎)→ 规则匹配 → 拦截/告警。核心挑战是超低延迟(维表缓存 + 内存状态 + 本地计算)、规则热加载(Kafka 流 + 广播状态 + 配置中心)、高准确率(多维度特征 + 评分卡 + 模型辅助)。延迟毫秒级,准确率 99%+,资损降低 80%+。
第五,企业级最佳实践:资源配置(并行度/内存/Slot/HA)、状态管理(RocksDB/Checkpoint/Savepoint/TTL)、容错一致性(Exactly-Once/故障恢复/降级/灰度/回放)、监控指标(延迟/吞吐/状态/Checkpoint/反压/Watermark/GC)、性能调优(数据倾斜/反压/SQL 优化/序列化/MiniBatch)。
第六,六个常见坑:Kafka 并行度 > 分区数、JDBC 非批量写入、维表用常规 Join 状态膨胀、Checkpoint 过大、事件时间窗口无输出、作业升级状态恢复失败,每个坑都有明确的解决方案。
第七,上线 Checklist 12 项:资源、状态、Checkpoint、TTL、一致性、容错、监控、压测、数据质量、安全、文档、回滚,发布前逐条确认。
企业级 Flink SQL 应用的核心不是某个 API 用得有多溜,而是端到端架构的合理性、稳定性保障、性能优化能力、运维监控体系。三个案例覆盖了电商、互联网、金融三个典型行业,核心技术点(窗口聚合、维表关联、CEP、状态管理、容错一致性)在所有企业级场景中都是通用的。掌握了这些,就能应对绝大多数企业级实时计算需求。