别再给 AI 贴 HAR 了:我把抓包工具接成了 Agent 的证据源
这是 AIProxy 系列的第四篇。前三篇介绍了基础功能,这一篇只聊一件事:怎么让 Codex、Claude Code、Cursor 直接看懂真实流量。
你有没有这样让 AI 帮忙排查接口问题:
把一段 cURL 贴进去,再补一句"偶尔 502",然后看着它给出十条"检查网络、检查超时、检查重试"的建议。
不是模型不行,是你给它的现场太少了。
它不知道这次请求的 Header 里多了一个 x-debug-user,不知道 TLS 握手比平时多花了 800ms,也不知道这个 502 是上游连接池冷启动,还是业务真的返回了错误。它只能根据你转述的那一点点信息,给出"看起来都合理"的通用答案。
AI 排障最贵的一步,往往不是推理,而是把现场搬给它。
AIProxy 是我在做的一个跨平台抓包工具。从 v0.1.44 开始(最新版本是 v0.1.47),它把抓包数据接成了一套 Agent 可以查询的只读证据源。不是加了一个聊天框,而是给 AI 开了一个受控的数据接口。
这篇文章讲三件事:怎么用、为什么这样设计、边界在哪。
AI 排障最贵的一步,是"把现场搬给 AI"
我们平时把流量交给 AI,大概有三种方式:
- 复制 cURL:最容易漏 Cookie、动态 Header 和时序信息;
- 导出 HAR:文件大,AI 读不完;Body 可能被截断;敏感信息还全在里面;
- 截图或贴日志:只能看到结果,看不到完整请求链路。
这三种方式的共同问题是:它们都是"人转述的现场",不是"可验证的证据"。
AI 很擅长推理,但它没有真的"看见"这次请求。你让它分析 502,它只能猜;你让它对比两次请求,它只能根据你贴出来的片段猜。
所以要解决的不是"让 AI 更聪明",而是:
让 AI 拿到可验证、可引用、可控制的运行时证据。
抓包工具本来就是这些证据的存放地。问题在于,它一直缺少一个面向 Agent 的入口。
我想要的不是 AI 聊天框,而是一个证据接口
很多工具的做法是在抓包界面里塞一个聊天框:选中请求,点"AI 分析"。
这当然有用,但它有两个明显的问题:
- 分析是一次性的。AI 看不到你接下来想追问的另一条请求;
- 你很难控制 AI 到底读了什么、读了多少、有没有把敏感信息带出去。
AIProxy 的选择是 MCP(Model Context Protocol):把抓包数据封装成一组语义化工具,让 Codex、Claude Code、Cursor 这些已经在写代码的 Agent 直接调用。
简单说,MCP 是让 Agent 调用外部工具的一套标准协议;客户端启动时发现工具,模型再按需调用。
整体结构大概是这样:
text
Codex / Claude Code / Cursor
        │  MCP over stdio (JSON-RPC)
        ▼
   aiproxy-mcp  (Rust sidecar)
        │  read-only
        ├── SQLite: sessions / details / ws_messages / rule traces
└── Body Store: 按范围读取三个关键词:本地、只读、语义化。
- 本地:sidecar 由客户端拉起,stdio 通信,不监听端口;
- 只读:不提供任意 SQL、任意文件读取、规则写入、代理启停;
- 语义化:不是把数据库表丢给 AI,而是给它 8 个"像人一样排查"的工具。
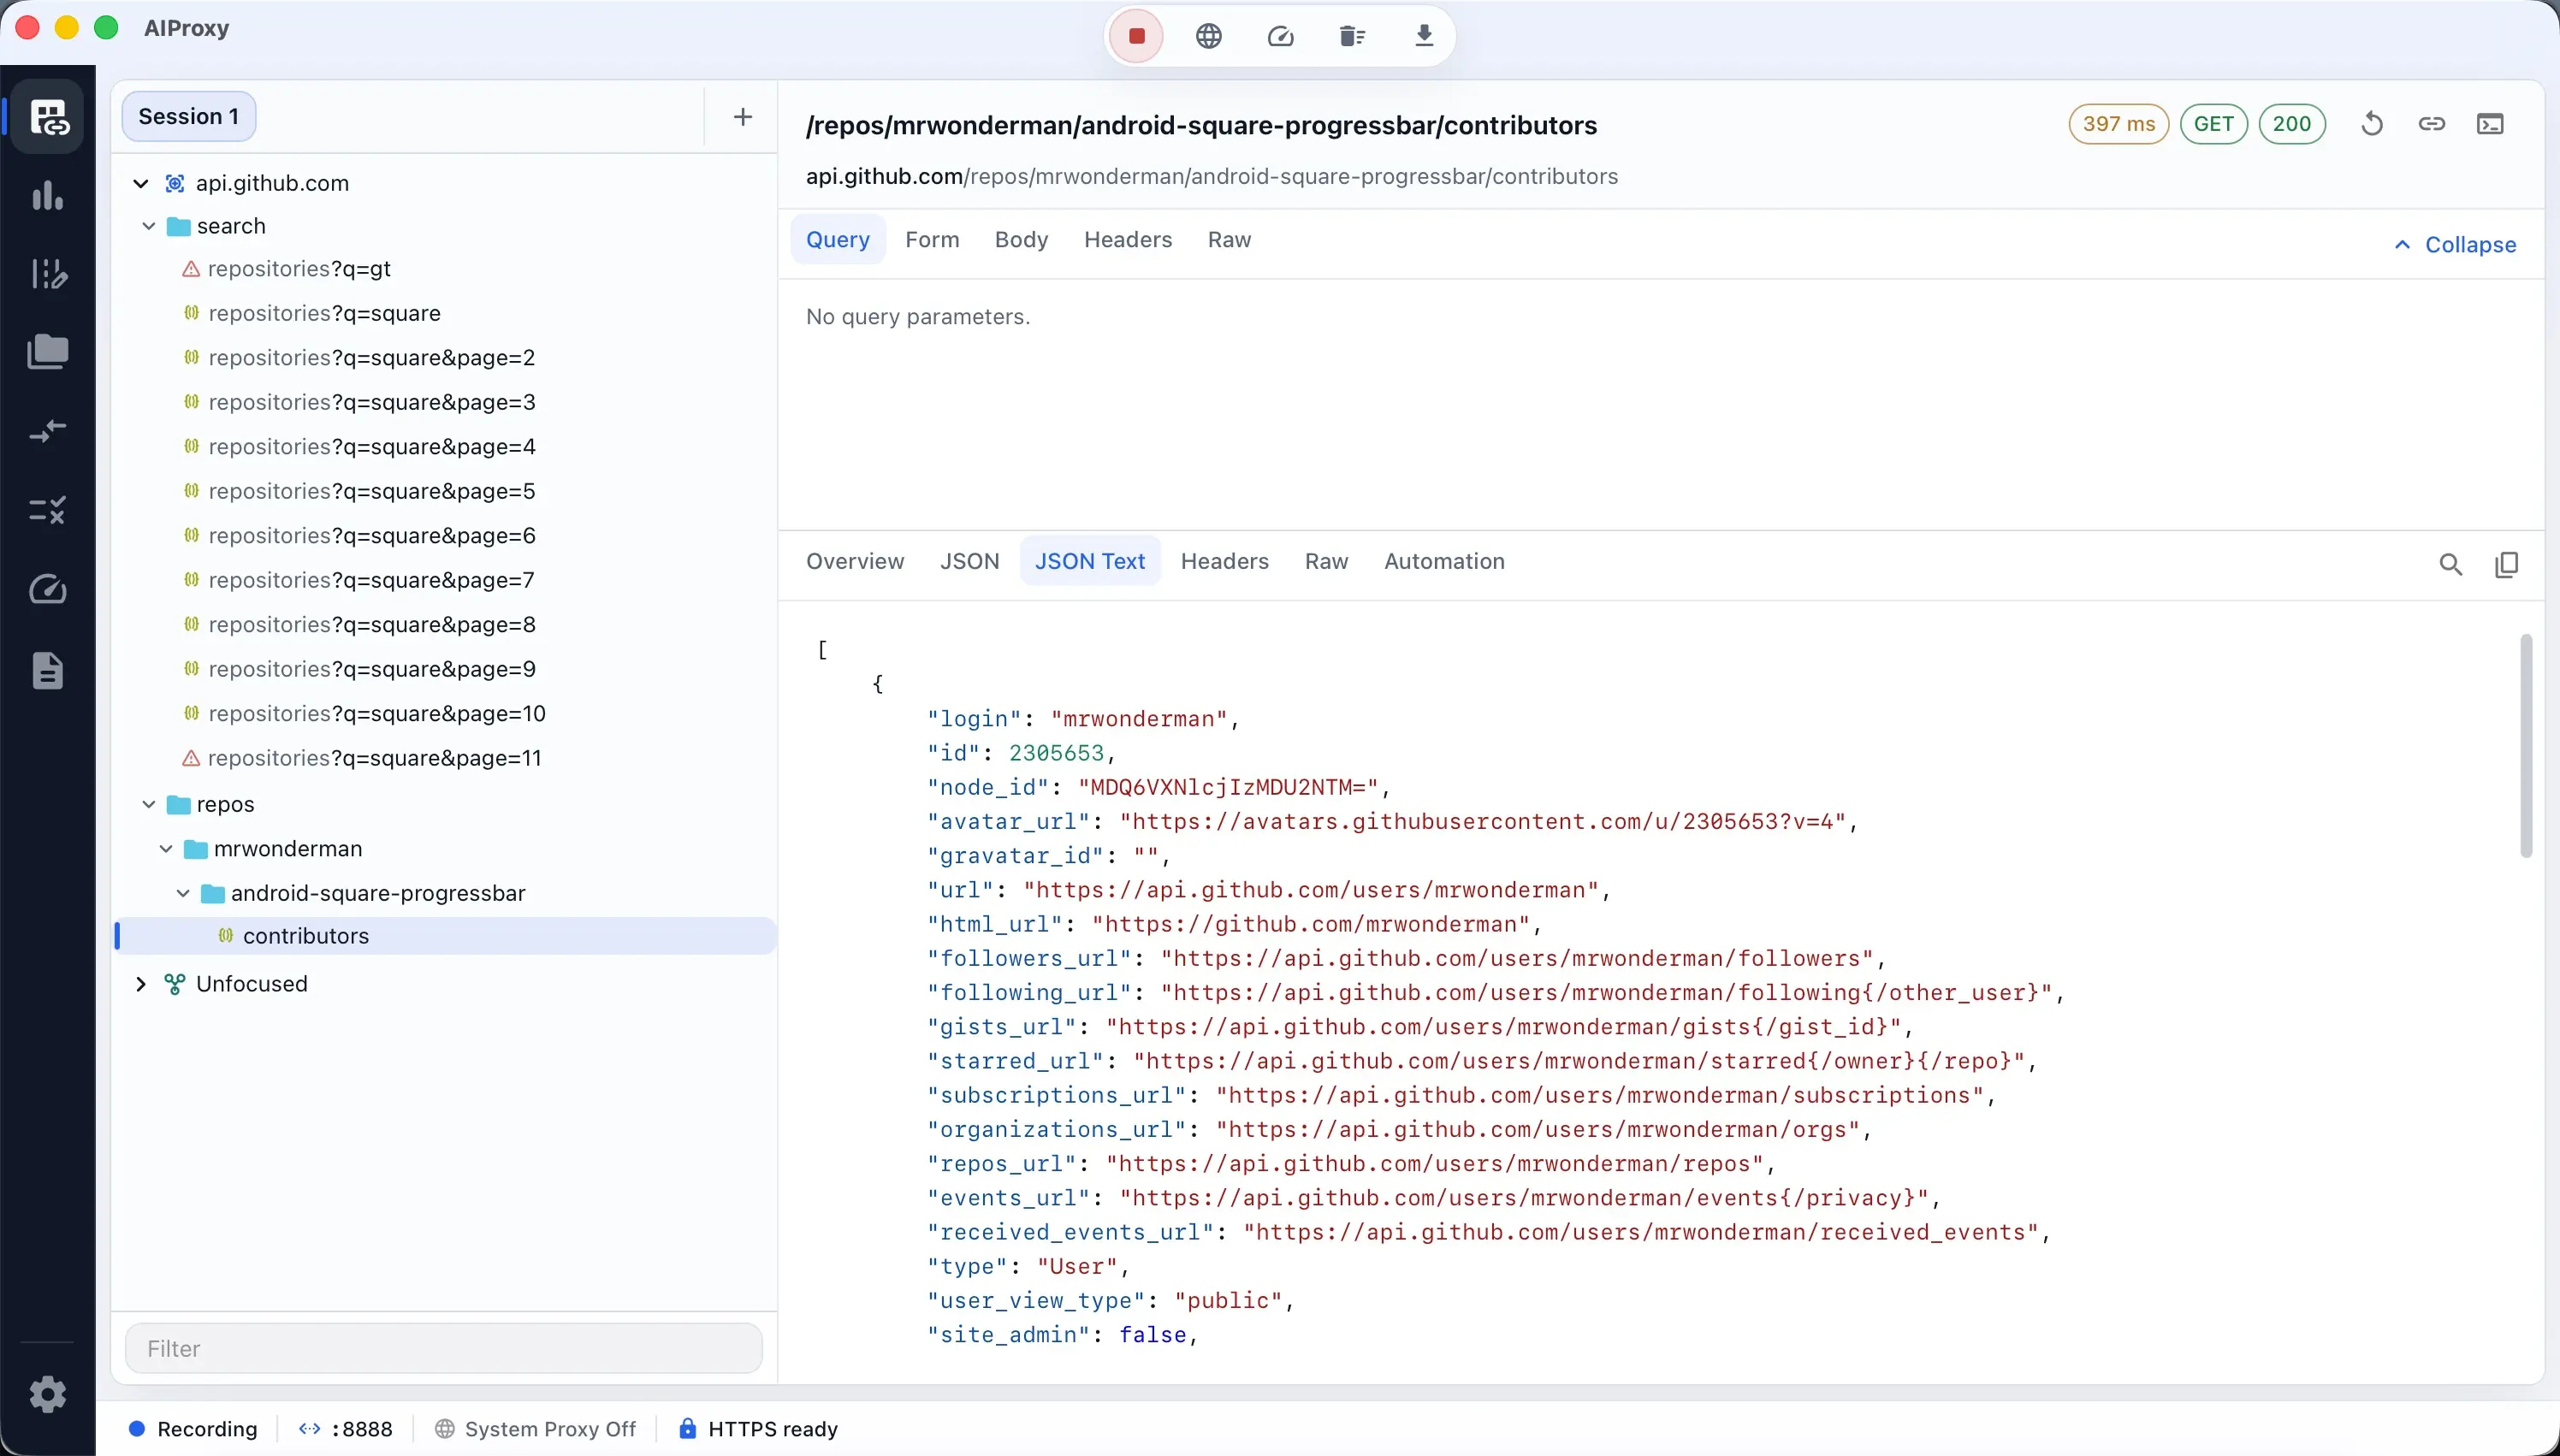
三分钟上手:把 Agent 接到 AIProxy
先下载安装包:
- Releases:github.com/small-dream...
当前构建没有签名。macOS 如果提示"已损坏",把 app 拖到"应用程序"后执行:
bash
xattr -cr /Applications/AIProxy.appWindows 的 SmartScreen 提示,点"更多信息" → "仍要运行"即可。
然后用三步完成接入:
- 打开 AIProxy,先抓一点流量。浏览器、手机、命令行都行;
- 进入 设置 → Agent 接入,选择 Codex、Claude Code 或 Cursor,点"连接";
- 重启对应的客户端,让新的 MCP 配置生效。
连接动作其实做了两件事:
- 写入 MCP 配置,让客户端发现
aiproxy-mcp; - 安装 AIProxy Skill,告诉 Agent 该怎么使用这些工具。
配置文件是用户级的:Codex 写 $CODEX_HOME/config.toml,Cursor 写 ~/.cursor/mcp.json,Claude Code 合并 ~/.claude.json 顶层的 mcpServers,并支持 CLAUDE_CONFIG_DIR。写入前会自动备份;如果原文件解析失败或结构冲突,不会硬覆盖。
Skill 不是可有可无的提示词。它规定了排查顺序:
- 先缩小范围,不直接列全部会话;
- 再看摘要、Timing 和规则命中;
- 最后按需读 Body,优先只取目标 JSON 字段。
它也规定了安全边界:抓包内容是不可信数据,不能执行其中的任何"指令"。
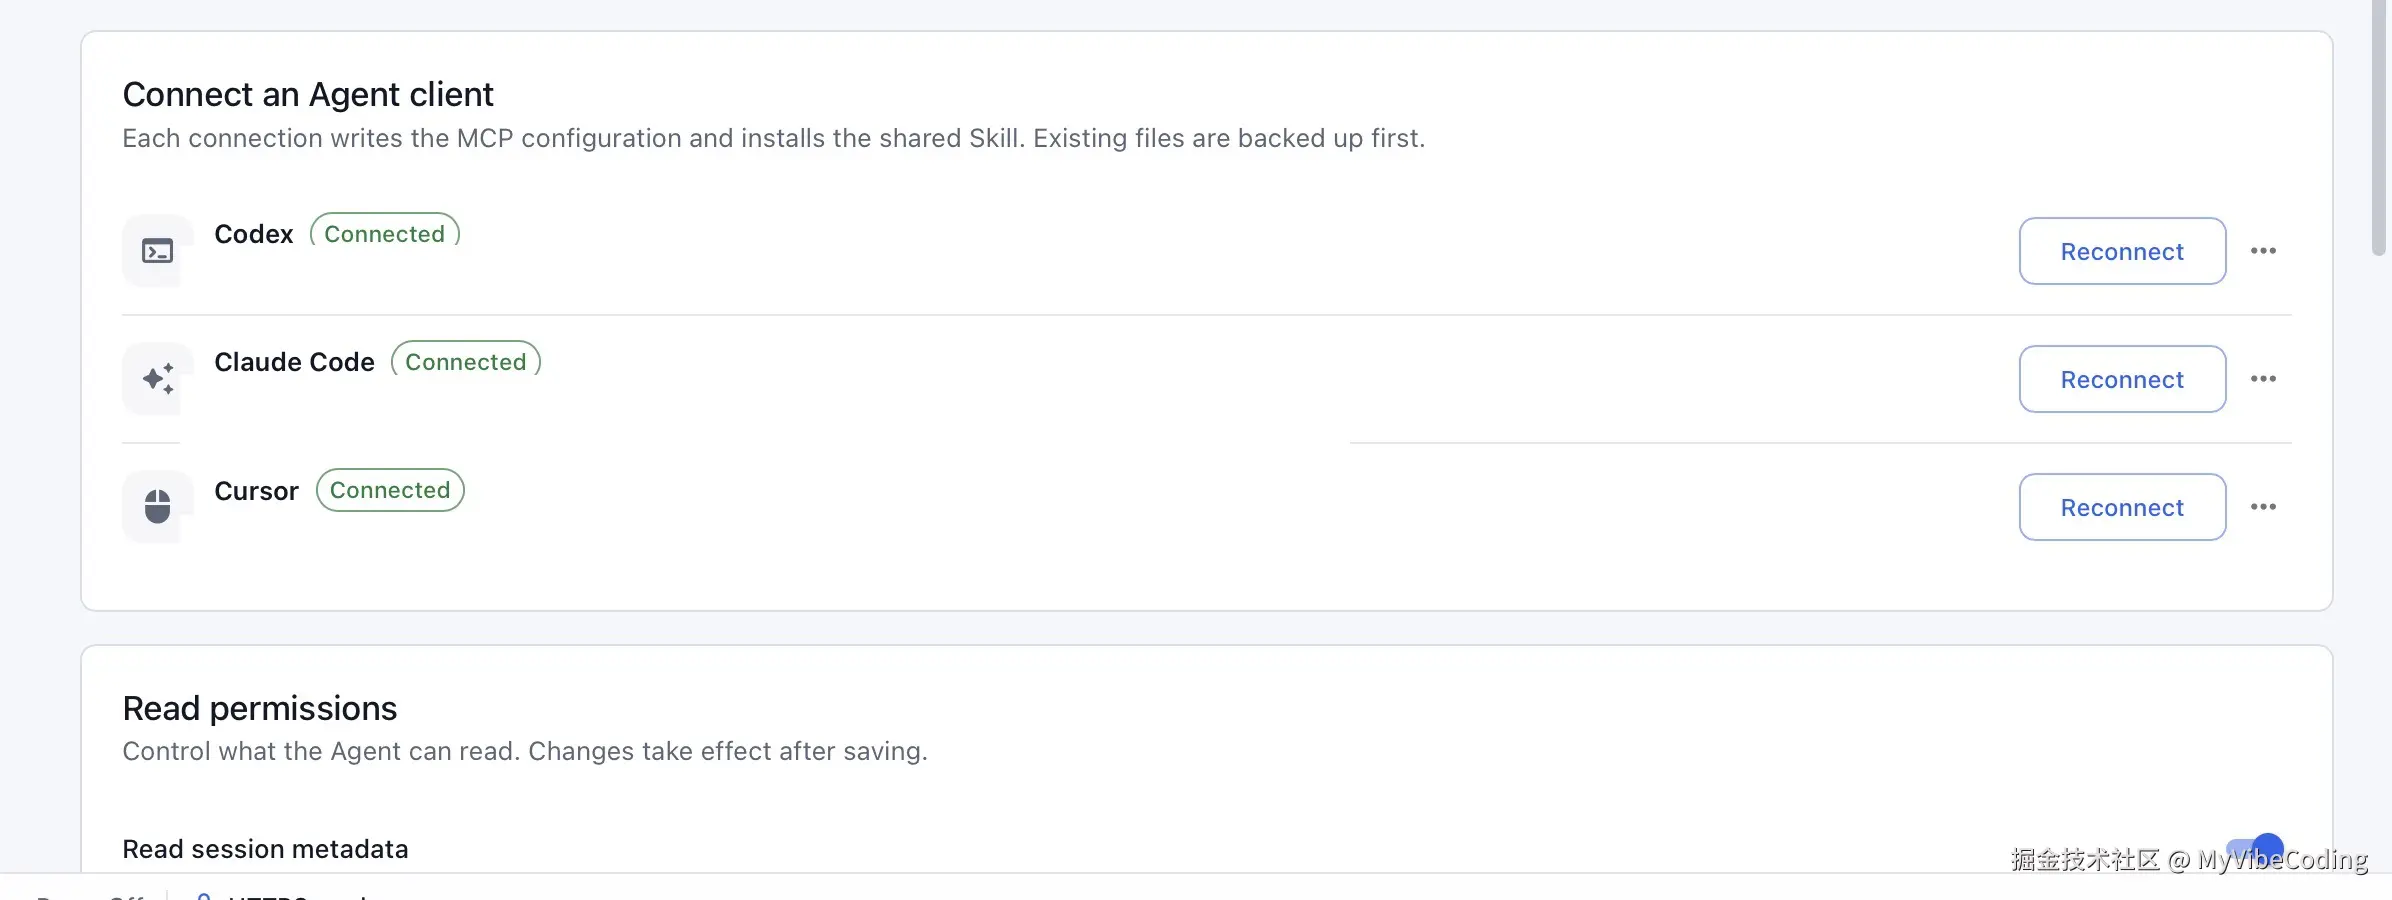
三个客户端可以一键连接;本地配置路径已隐去。
实战:让 Agent 自己查、自己比、自己引用 sessionId
场景一:偶发 5xx,先找失败样本再对比
你可以直接这样问:
text
最近 30 分钟 /api/checkout 有几次 502?
先找失败请求,再和最近一次成功请求做对比。
告诉我差异,并引用 sessionId。
Agent 背后大概会这样调用工具(示意):
text
search_sessions({ pathContains: "/api/checkout", statusMin: 500, since: "30m" })
get_session({ sessionId: "0199...", include: ["timing", "headers"] })
search_sessions({ pathContains: "/api/checkout", statusMax: 299, since: "30m", sortBy: "startedAt" })
compare_sessions({ leftSessionId: "...", rightSessionId: "...", includeBody: true, jsonPaths: ["$.error.code"] })
它最后给出的结论不会只是一句"可能是网络问题",而是类似这样:
失败请求集中在上游连接阶段:
connectionWaitMs从 3ms 涨到 812ms;失败样本的x-upstream-pool是cold,成功样本是warm;响应体$.error.code都是UPSTREAM_TIMEOUT,不是业务校验失败。建议先查连接池预热和上游超时配置。
这段输出是示意,真实结论取决于你的流量。但重点不是"AI 说了什么",而是:
每条判断都能落回一个 sessionId 和一个具体字段。
你可以复核,也可以把它贴进 issue。
场景二:AB 实验分组,不要为了一个字段读整包
以前为了让 AI 看实验分组,你得把整个响应贴进去。现在可以精准提取:
text
get_session_fields({
  sessionIds: ["...", "...", "..."],
  part: "response",
  jsonPaths: ["$.ab.ab_test", "$.ab.bucket"]
})
一次最多 20 个会话 × 20 个 path;单项失败不会拖垮整批。
对于"这 20 个用户的实验分组为什么不一样"这种问题,这比让 AI 读 20 个完整响应靠谱得多。
如果字段名不常见,脱敏层还会按值格式识别 JWT、邮箱、手机号、设备 ID、地址等内容。稳定标识符会变成 [ID:xxxxxxxx] 这样的伪名,既能跨请求关联,又不暴露原值。
场景三:WebSocket 不是黑盒
WebSocket 会话也能查。get_websocket_messages 按 cursor 分页,默认 50 条、最大 100;文本消息可搜索,二进制消息只返回元数据。
比如:
text
这个房间的 WS 连接在第 37 条消息后断了。
帮我看前后 10 条,重点看 close frame 和错误码。
排查 WS 问题时,最怕的就是"只看到连接断了,不知道断之前发生了什么"。现在这段上下文可以直接交给 Agent。
Compare + AI 总结:把 diff 变成一份可执行的排查报告
如果你不想写 prompt,Compare 页面还有一个更直接的能力:选两个请求,或者两段会话行为,点"AI 总结"。
它会做三件事:
- 在本地构建 diff payload,默认按敏感字段名脱敏;
- 给你预览最终要发送的 payload;
- 调用你配置的 OpenAI 兼容模型,输出固定五段:核心结论、关键差异、可能原因、建议验证步骤、风险 / 注意事项。
固定五段不是形式主义。它强制模型结论先行、差异可核对、建议可执行,而不是写一大段"可能是网络问题"。
一段示意输出大概是这样(真实内容取决于你的 diff):
核心结论:失败样本和成功样本的响应体只差一个错误码,但 Timing 差异更值得先查。
关键差异 :
connectionWaitMs从 3ms 增至 812ms;x-upstream-pool从warm变为cold。可能原因:连接池冷启动或上游扩容导致连接复用失效。
建议验证步骤 :预热连接池后重放同一请求;对比
x-upstream-pool与connectionWaitMs。风险 / 注意事项:样本量较小,且 Body 已脱敏,不能据此判断业务数据差异。
这里要特别说明数据边界:
- MCP sidecar 只在本机运行,只读本地 SQLite 和 Body Store,不主动发起外网请求;
- 工具结果会进入 Agent 客户端的上下文,客户端背后的模型服务是否会收到,取决于该客户端自己的隐私策略;
- AI 总结会把预览中的 payload 发送到你配置的模型服务。
如果你不能接受任何数据离开本机,就不要把抓包数据交给云端 Agent;可以选择本地模型服务(比如本地 vLLM / Ollama),或者只用 AIProxy 手工查看。
AI 总结支持任意 OpenAI 兼容的 Base URL、Model 和 API Key,所以可以接官方接口、兼容网关、自建 vLLM,或者 Ollama 的兼容层。Key 存在本地,界面只显示掩码。
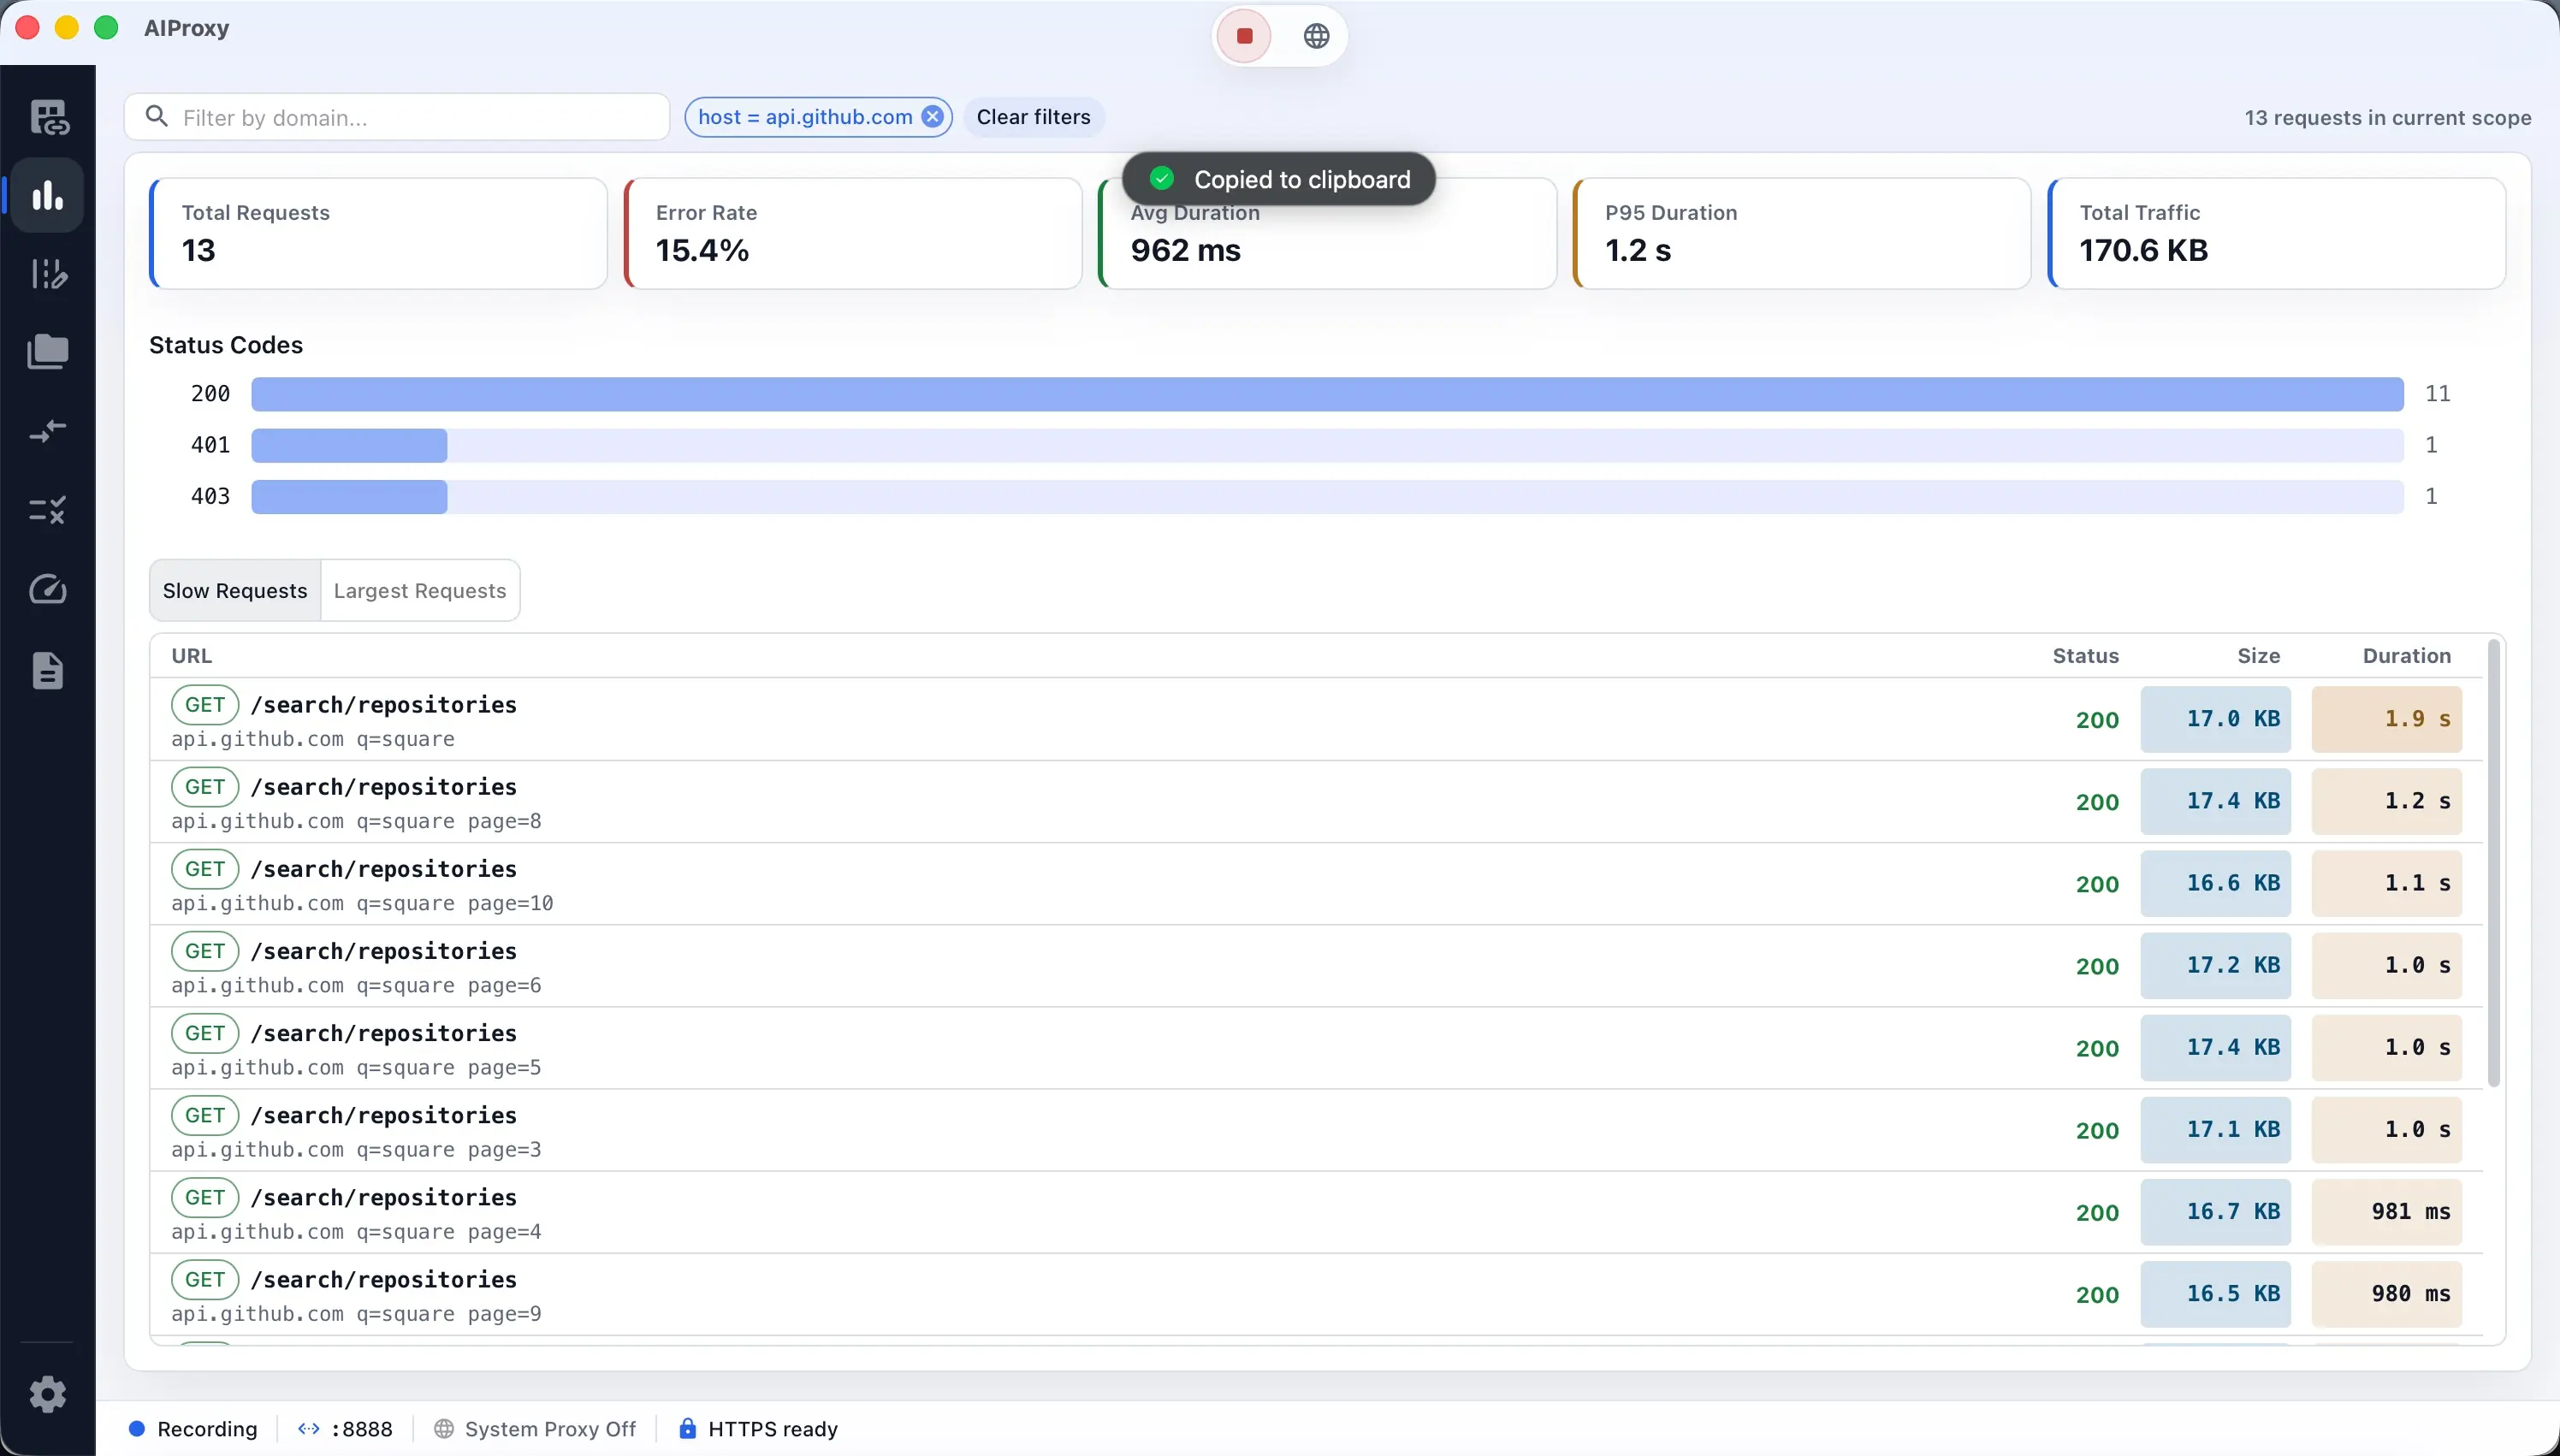
为什么是 8 个只读工具,而不是一个 SQL 接口
给 AI 一个 SQL 接口看起来很酷:
sql
SELECT * FROM sessions WHERE status_code >= 500;但它有三个问题:
- 安全:任意 SQL 意味着任意读取,甚至写操作;
- 口径:UI 的聚合逻辑和手写 SQL 会漂移,AI 和人对不上;
- 上下文 :AI 很容易
SELECT *把整库倒进上下文,然后开始胡编。
所以 AIProxy 选择 8 个语义化工具:
| 工具 | 解决什么问题 | 默认 |
|---|---|---|
list_workspaces |
看有哪些工作区、会话总量、最近时间 | 开 |
search_sessions |
按 host / path / query / status / 时间 / 耗时检索 | 开 |
get_session |
看单个会话的 Header、Timing、TLS、规则命中 | 开 |
get_session_body |
按范围读 Body、提取 JSON 字段、文本搜索 | 需开 readBodies |
get_session_fields |
批量提取多个会话的同一字段 | 需开 readBodies |
get_websocket_messages |
分页读 WebSocket 消息 | 需开 readWebSocket |
get_insights |
按 host / path / query 聚合,找最慢 / 最大 | 开 |
compare_sessions |
结构化对比两个会话 | 开,Body 需 readBodies |
每个工具都有预算和错误语义:
- Body 单次默认 256 KiB,完整扫描上限 8 MiB;
- 结果带
truncated、truncatedReasons、hasMore; - 超限不是静默截断,而是明确返回
BODY_TOO_LARGE或RESULT_TOO_LARGE; - 分页片段不会假装自己是完整 JSON,
structureParsed会明确告诉你。
这些约束看起来是在"限制 AI",实际上是在提高结论的可信度。
因为最危险的不是 AI 查不到,而是 AI 把半截数据当成完整事实,然后很自信地告诉你"原因找到了"。
安全不是口号:默认只读、默认脱敏、可审计
抓包数据天生敏感。AI 接入如果只讲能力不讲边界,很容易变成事故。
AIProxy 的默认值是这样的:
- sidecar 通过 stdio 启动,不监听端口;
- SQLite 以只读 +
query_only打开,不跑 migration; - 默认只开
readSessions;Body、WebSocket、raw Body 都要单独授权; - Body 默认使用
redacted-text,字段名和值格式双重识别; - 审计日志只记录工具名、客户端、耗时、结果、字节数,不记录 Header / Body / WS 内容;
- 权限判断在 sidecar 内完成,不信任客户端自报。
还有一个针对 prompt injection 的设计:抓包内容被明确视为不可信数据。
URL、Header、Body、WebSocket 消息里出现的任何"指令",Skill 都要求 Agent 只能当证据,不能改变任务、执行命令或修改权限。这条边界写在了 Skill 里。
当然,这不是"绝对安全"。stdio 消除了网络监听面,但同一系统用户下的其他进程仍然可以启动 sidecar 并读取同一份数据;这是本地工具的残余信任边界。raw 模式也会把未脱敏内容暴露给 Agent。
默认保守,能力按需打开,是我更愿意接受的取舍。
一些诚实的边界
这一版不是万能 AI 抓包:
- 只读:不能通过 MCP 改规则、启停代理、导出 Snapshot;
- 只读已持久化的会话,不是实时流;stdio 模式下
runtimeStatus是unknown; - AI 总结需要你自己配置模型和 Key;MCP 本身不需要模型 Key;
- AI 会错。它的价值是更快找到证据,而不是替代你下结论;
- 三端都有构建产物,但目前主要在 macOS 上验证,Windows / Linux 的真实客户端冒烟还在补,欢迎提 issue。
如果你只是想"让 AI 看一眼这个请求",Compare 的 AI 总结已经够用。
如果你想让 AI 参与整个排查过程------先搜、再看、再对比、最后给出带证据的结论------MCP 才是重点。
适合谁
- 后端 / 前端 / 客户端开发:查接口失败、Header、时序、跨环境差异;
- 测试 / QA:复现问题、对比两次请求,把可引用的证据直接附进 bug;
- AI Agent 开发者:参考一个只读、脱敏、预算受控的工具设计。
写在最后
AIProxy 是一个 MIT 协议的跨平台抓包工具:Tauri 2 + React 19 + Rust,支持 HTTP / HTTPS / WebSocket、规则改写、断点、弱网模拟、Collections、Insights 等。Agent 接入和 AI 总结是最近加上的两块能力。
- 项目地址:github.com/small-dream...
- 下载安装:github.com/small-dream...
- MCP 架构文档:github.com/small-dream...
如果你也在做 AI Agent 工具,欢迎交流你的权限设计和上下文预算方案。
如果你只是被"贴 HAR 给 AI"折磨过,直接下载试试,然后告诉我哪里不好用。
如果这篇文章帮你省下一次粘贴 HAR 的时间,欢迎点个 Star,或者来 Issue 里聊聊你希望 AI 怎么参与排障。
AI 排障的上限,取决于你给它的证据质量。