企业里的"数据同步"经常被一句话带过:把几个系统的数据搬到一个库里。真正开始做以后,问题很快分开了。客户主数据来自 CRM,订单来自交易库,门店编码又在另一套系统里维护;同一个客户在不同系统里可能有不同编号,字段名称和状态值也不一样。直接把表一张张复制过去,目标库里得到的只是几批互相不认识的数据。
金仓异构数据同步软件 Kingbase FlySync(KFS)除了实时复制,也覆盖数据集中共享、分发和应用上云等场景。官方产品介绍列出了一对一、一对多、多对一和级联等拓扑。把它当成数据集成软件来用时,我更关心三件事:数据从哪里来、经过什么规则、最后由哪些系统消费。拓扑只是外形,映射和落库规则才决定这套集成能不能长期维护。
先画清楚来源、规则和去向
一个实际的客户服务平台可以有三类来源:CRM 提供客户基础资料,交易库提供订单和退款,门店系统提供区域与渠道编码。汇总库接收标准化后的数据,分析库和风控库再从汇总结果分发出去。
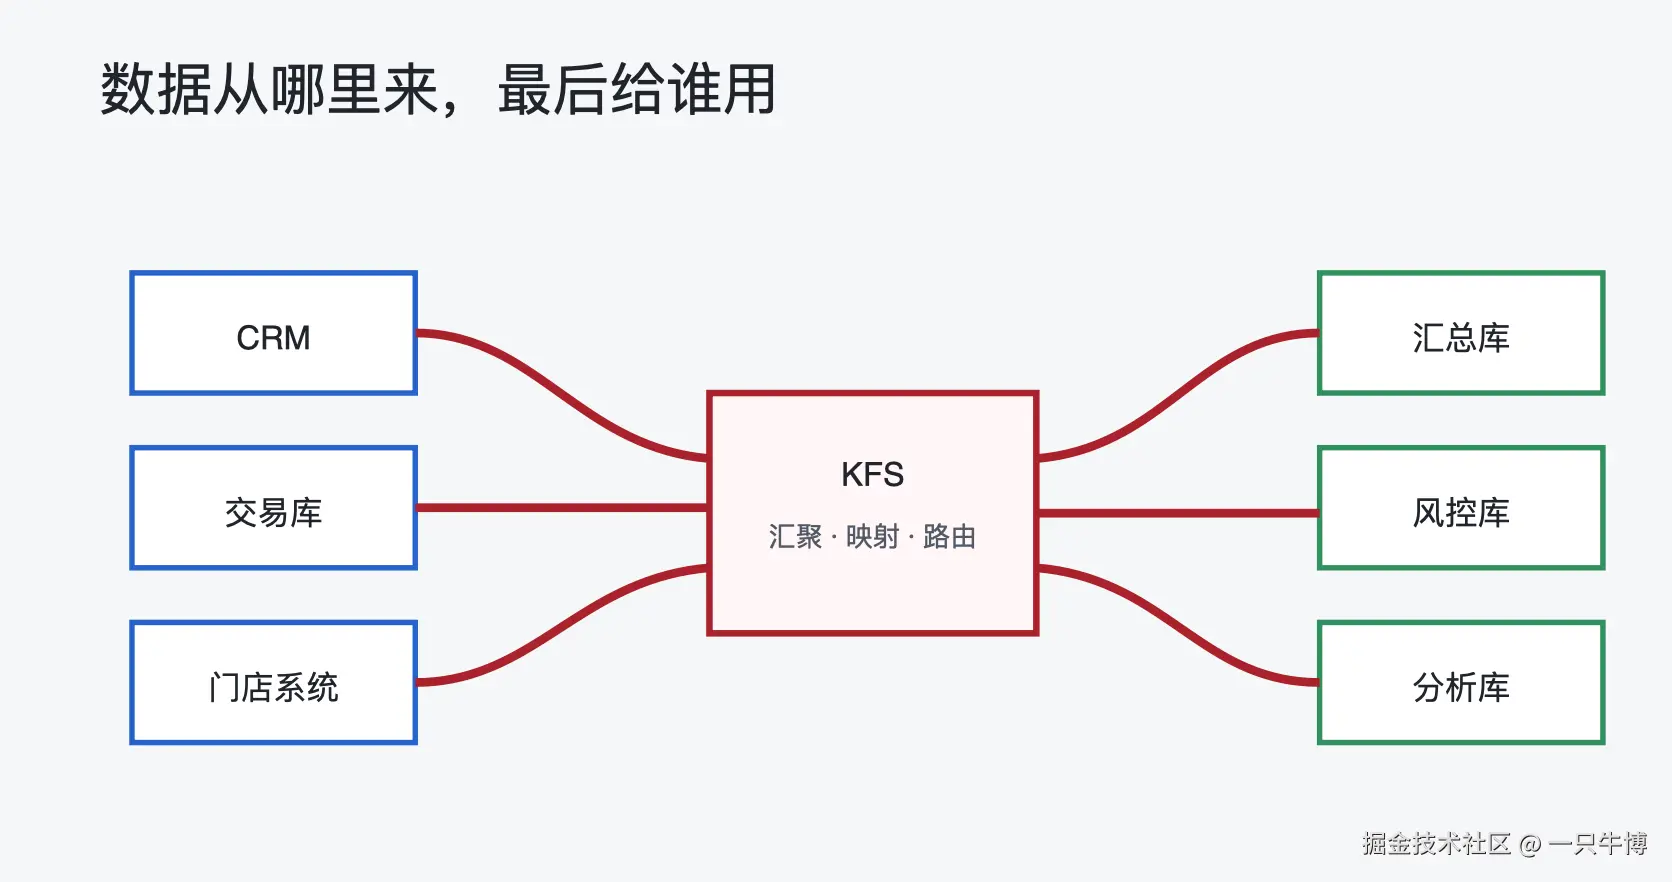
KFS 的同步拓扑可以支持多对一和一对多,但我不会先按"有几条链路"来设计。先列出每张表的主键、更新时间、删除语义和责任系统,才能决定是直接同步、先落中间表,还是经过字段转换后再发送。
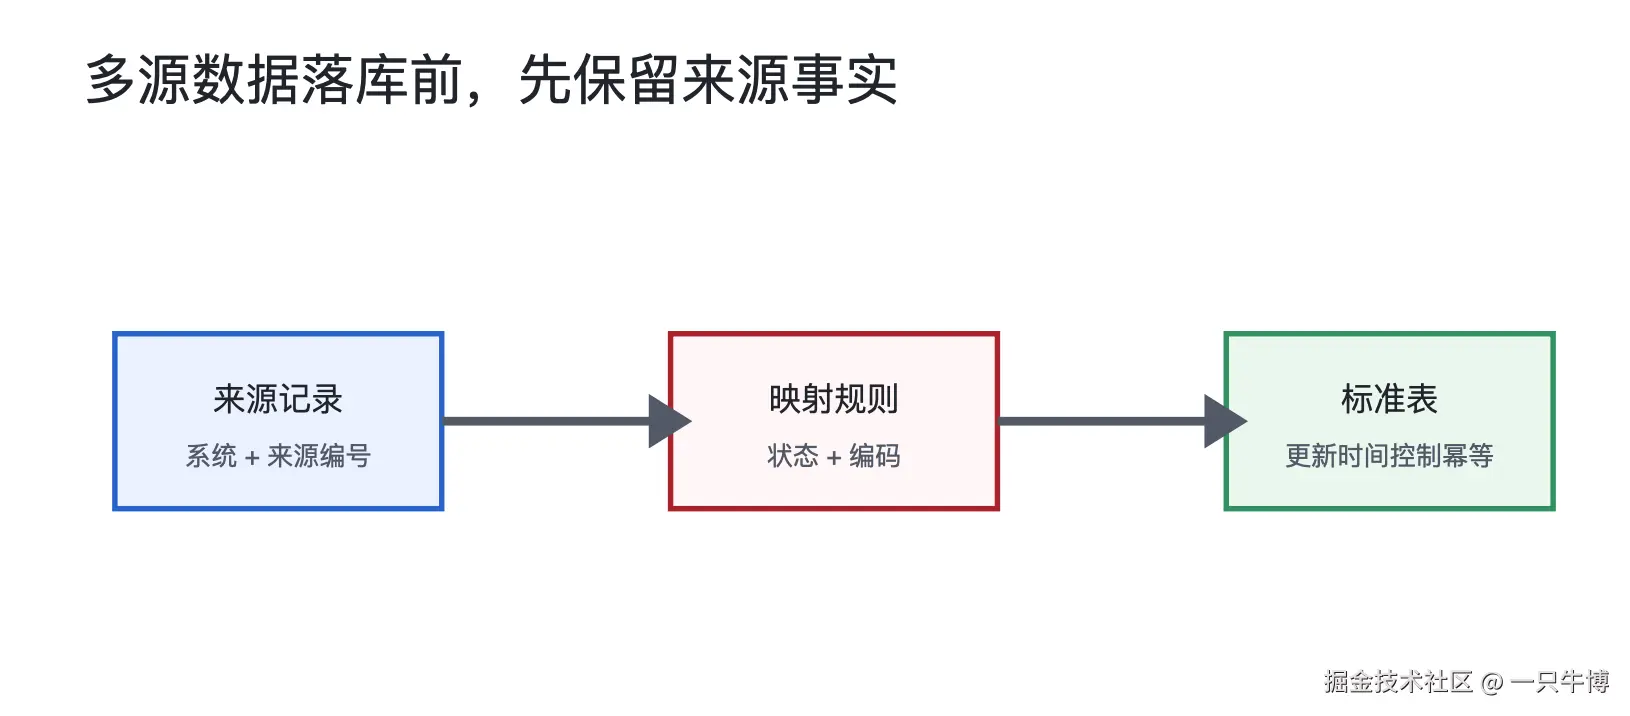
比如客户表的主键不能直接拿三个系统的 customer_id 混用。汇总库可以保留来源系统和来源编号:
sql
CREATE TABLE ods_customer (
    source_system  VARCHAR(32) NOT NULL,
    source_id      VARCHAR(64) NOT NULL,
    customer_name  VARCHAR(128),
    mobile         VARCHAR(32),
    region_code    VARCHAR(32),
    source_status  VARCHAR(16),
    source_updated_at TIMESTAMP NOT NULL,
    ingest_time    TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (source_system, source_id)
);
这张表保存的是来源事实,不负责决定三个系统里谁是最终客户主档。数据集成阶段把来源留住,后面出现重复客户或编码冲突时,才有机会追溯原始记录。
先落原始层,再做标准化
字段转换不应直接覆盖来源值。订单状态是最常见的例子:交易系统用 P 表示已支付,门店系统可能用 DONE,汇总库则希望统一成 PAID。标准化表保留统一状态,同时保留原状态用于排查:
sql
CREATE TABLE dwd_order (
    source_system   VARCHAR(32) NOT NULL,
    source_order_id  VARCHAR(64) NOT NULL,
    customer_key     VARCHAR(128) NOT NULL,
    order_status     VARCHAR(16) NOT NULL,
    source_status    VARCHAR(16) NOT NULL,
    order_amount     DECIMAL(14, 2) NOT NULL,
    order_time       TIMESTAMP NOT NULL,
    source_updated_at TIMESTAMP NOT NULL,
    PRIMARY KEY (source_system, source_order_id)
);
标准化动作可以按来源分别配置,也可以先进入中间表后再由目标库 SQL 完成。无论用哪种方式,映射表都应该独立保存,不要把大量 CASE 永久写死在应用代码里:
sql
CREATE TABLE map_order_status (
    source_system VARCHAR(32) NOT NULL,
    source_value  VARCHAR(32) NOT NULL,
    target_value  VARCHAR(32) NOT NULL,
    enabled       CHAR(1) NOT NULL DEFAULT 'Y',
    PRIMARY KEY (source_system, source_value)
);

INSERT INTO map_order_status
    (source_system, source_value, target_value)
VALUES
    ('crm', 'P', 'PAID'),
    ('store', 'DONE', 'PAID'),
    ('trade', 'SUCCESS', 'PAID');
KFS Loader 的产品手册将它描述为集成在 KFS 中的数据搬迁工具:从原始业务系统读取数据,按预先设计的规则转换,再按计划导入目标库。这个能力适合初始汇聚和批量装载;对于持续变化的数据,则要继续明确增量抽取和目标端应用的边界,不能把一次性装载当成实时集成已经完成。
多对一汇聚时,先处理重复和迟到
多源汇聚经常卡在到达顺序上,连接本身反倒不是最难处理的部分。CRM 的客户修改可能比交易库的订单晚几分钟到达,门店系统的网络中断也会让一批订单集中补发。汇总库要用来源键和更新时间控制幂等:
sql
INSERT INTO dwd_order (
    source_system,
    source_order_id,
    customer_key,
    order_status,
    source_status,
    order_amount,
    order_time,
    source_updated_at
)
SELECT source_system,
       source_order_id,
       customer_key,
       target_value,
       source_status,
       order_amount,
       order_time,
       source_updated_at
FROM ods_order AS o
JOIN map_order_status AS m
  ON m.source_system = o.source_system
 AND m.source_value = o.source_status
 AND m.enabled = 'Y'
ON CONFLICT (source_system, source_order_id)
DO UPDATE SET
    customer_key = EXCLUDED.customer_key,
    order_status = EXCLUDED.order_status,
    source_status = EXCLUDED.source_status,
    order_amount = EXCLUDED.order_amount,
    order_time = EXCLUDED.order_time,
    source_updated_at = EXCLUDED.source_updated_at
WHERE dwd_order.source_updated_at < EXCLUDED.source_updated_at;
这段 SQL 的前提是目标库使用支持该冲突处理语法的版本和模式,具体项目仍需在目标环境确认。它表达的业务规则是:同一来源订单重复到达时不重复插入,只有来源更新时间更新才覆盖旧值。KFS 负责把变更送到目标端,幂等规则则必须由目标模型和落库语句共同承担。
一对多分发,不要让下游各自改口径
汇总库的数据要分发给风控和经营分析时,也要提前划清字段责任。风控只需要客户、订单状态和金额,经营分析还需要区域、渠道和商品分类。如果每个下游都各自把 P、DONE、SUCCESS 解释成 PAID,一段时间后同一订单在不同系统里可能出现不同状态。
可以在汇总层形成统一的消费视图:
sql
CREATE VIEW v_risk_order AS
SELECT source_system,
       source_order_id,
       customer_key,
       order_status,
       order_amount,
       order_time
FROM dwd_order
WHERE order_status IN ('PAID', 'REFUNDED');

SELECT order_status,
       COUNT(*) AS order_count,
       SUM(order_amount) AS amount_sum
FROM v_risk_order
GROUP BY order_status
ORDER BY order_status;
KFS 的一对多拓扑可以让一份变更流向多个目标服务,但下游接收表仍要按实际用途设计。风控侧如果只接收已支付订单,可以在目标端过滤;如果审计要求保留所有状态,就不能在同步层提前丢弃未支付记录。过滤位置不同,后续补数和追责的难度也不同。
删除不是"没有这行"这么简单
客户注销、订单取消和门店关闭都会带来删除语义。物理删除一旦传到多个下游,后面很难判断这条记录是正常删除、同步失败,还是人工清理。对于需要保留审计的数据,我更倾向于把删除转换为状态变化或记录删除时间:
sql
ALTER TABLE dwd_order
ADD COLUMN deleted_at TIMESTAMP;

UPDATE dwd_order
SET deleted_at = CURRENT_TIMESTAMP,
    order_status = 'CANCELLED'
WHERE source_system = :source_system
  AND source_order_id = :source_order_id
  AND deleted_at IS NULL;
这不代表所有表都必须软删除。订单明细、临时表和纯缓存表可以采用不同策略,前提是来源端、同步规则和下游表对删除含义有同一个约定。KFS 能传递删除操作,并不替项目决定删除是否应该保留历史。
用三类检查把集成任务看住
数据集成上线后,我会分别看来源接入、转换结果和目标分发,而不是只看任务是否运行:
sql
SELECT source_system,
       COUNT(*) AS row_count,
       MAX(source_updated_at) AS source_watermark,
       MAX(ingest_time) AS last_ingest_time
FROM ods_customer
GROUP BY source_system
ORDER BY source_system;

SELECT order_status,
       COUNT(*) AS row_count,
       SUM(order_amount) AS amount_sum,
       MAX(source_updated_at) AS last_source_update
FROM dwd_order
GROUP BY order_status
ORDER BY order_status;
第一段看各来源有没有继续进入,第二段看标准化后的状态和金额是否在变化。再配合 KFS 的任务状态、日志和数据比对结果,才能区分来源断流、转换规则漏配和目标端落库失败。
数据集成不是把数据库连起来就结束了。来源键、映射规则、迟到数据、幂等更新和删除语义都要落在表结构和 SQL 里。KFS 的拓扑、实时同步和 Loader 能把数据送到该去的位置,但业务口径仍然要由项目自己写清楚、查得出来。