做长上下文、RAG 或 Agent 记忆管理的人大概都见过这种尴尬:知识明明全在库里,模型每次回答却都要从头翻一遍。用户问「这两个版本的行为差在哪」,答案散在五份设计文档和三个 issue 线程里------检索器捞回一堆片段,模型在推理时现场拼图,拼错一步答案就歪了。更气的是,下一个用户问的还是同一批文档。斯坦福和 CMU 的团队(Chelsea Finn 与 Aviral Kumar 组)在这篇论文里提出反转思路:与其每次提问都临时翻原文,不如先训一个「图书管理员」,提前把文档收拾好。
💡 TL;DR:论文把「预先整理语料」变成了可用强化学习训练的能力。builder agent 在看不到任何用户问题的前提下,用建、并、删、停四个动作把非结构化文档重组成分层文件系统工作区,每个合成文件都带指回原文的溯源链接;训练奖励直接是「答题 agent 用它能答对多少题」。结果:BrowseComp-Plus 上 0.75/0.77 的准确率,比最强检索与预计算基线平均高 33 个百分点;零样本迁移 BRIGHT 平均 pass@1 52%、pass@3 67%;摊薄后每答对一题的 token 还比未训练版本省 33.8%。
📄 论文:Librarian Agents: Training LLMs to Curate Long-Context Workspaces that Anticipate Future Queries(arXiv 2610.22273)💻 代码:teresaz05/librarian-agents | 🌐 主页:librarian-agents.github.io
痛点:RAG 在临时抱佛脚,知识图谱在刻舟求剑
先把两条主流路线的病根摆上台面。第一条是 RAG(检索增强生成,先搜后答):每个查询触发一轮全新搜索,跨文档关系------「A 方案的缺陷后来在 B 文档里被修掉了」这种连线------每次都要在推理时重新发现。Agentic RAG 把搜索变成多轮工具调用,看着更聪明,本质还是 reactive:查询不来,它一动不动。
第二条是预计算路线:GraphRAG、RAPTOR 这类方法在推理前把语料加工成知识图谱或层级摘要。方向对了,但流程是写死的------抽实体、建关系、生成社区摘要,靠固定规则和预定义 schema(预先约定的数据结构)。查询落在索引形状上它很好,需要索引里没有的中间产物它就帮不上忙。论文的概括很准:这些方法都在强加「结构的归纳偏置」,而结构本身从没被学习过。
那有没有第三条路?作者抓住了一个有趣的不对称:如今的 coding agent(Claude Code 这类 agent 工具外壳)很擅长逛一个现成的文件系统------列目录、读文件、追引用,动作娴熟;但几乎没有模型被训练过「为未来的查询预构建一个这样的文件系统」。会逛图书馆的人很多,会当图书馆员的很少。Librarian Agents 补的正是这半边:训练一个 builder agent,把原始文档变成一座「开馆前就整理完毕」的图书馆。
🛠️ 思路:把「收拾文档」本身变成一个可以 RL 的策略
系统里有两个角色,分工泾渭分明。builder agent (图书馆员)负责整理:面对一堆原始文档,它通过四个动作迭代改造工作区------CreateFile(从原文档或已有合成文件中整合出新文件,必须附溯源链接)、MergeFiles(把相关合成文件聚合成更高层的摘要或索引,引入层级)、Delete(清理冗余合成文件,原始文档永不动)、Stop(宣布竣工)。answering agent(答题者)全程冻结,开馆后接单:从 README 和根目录条目出发,按需深入子目录,实在找不到再回退到原始文档。
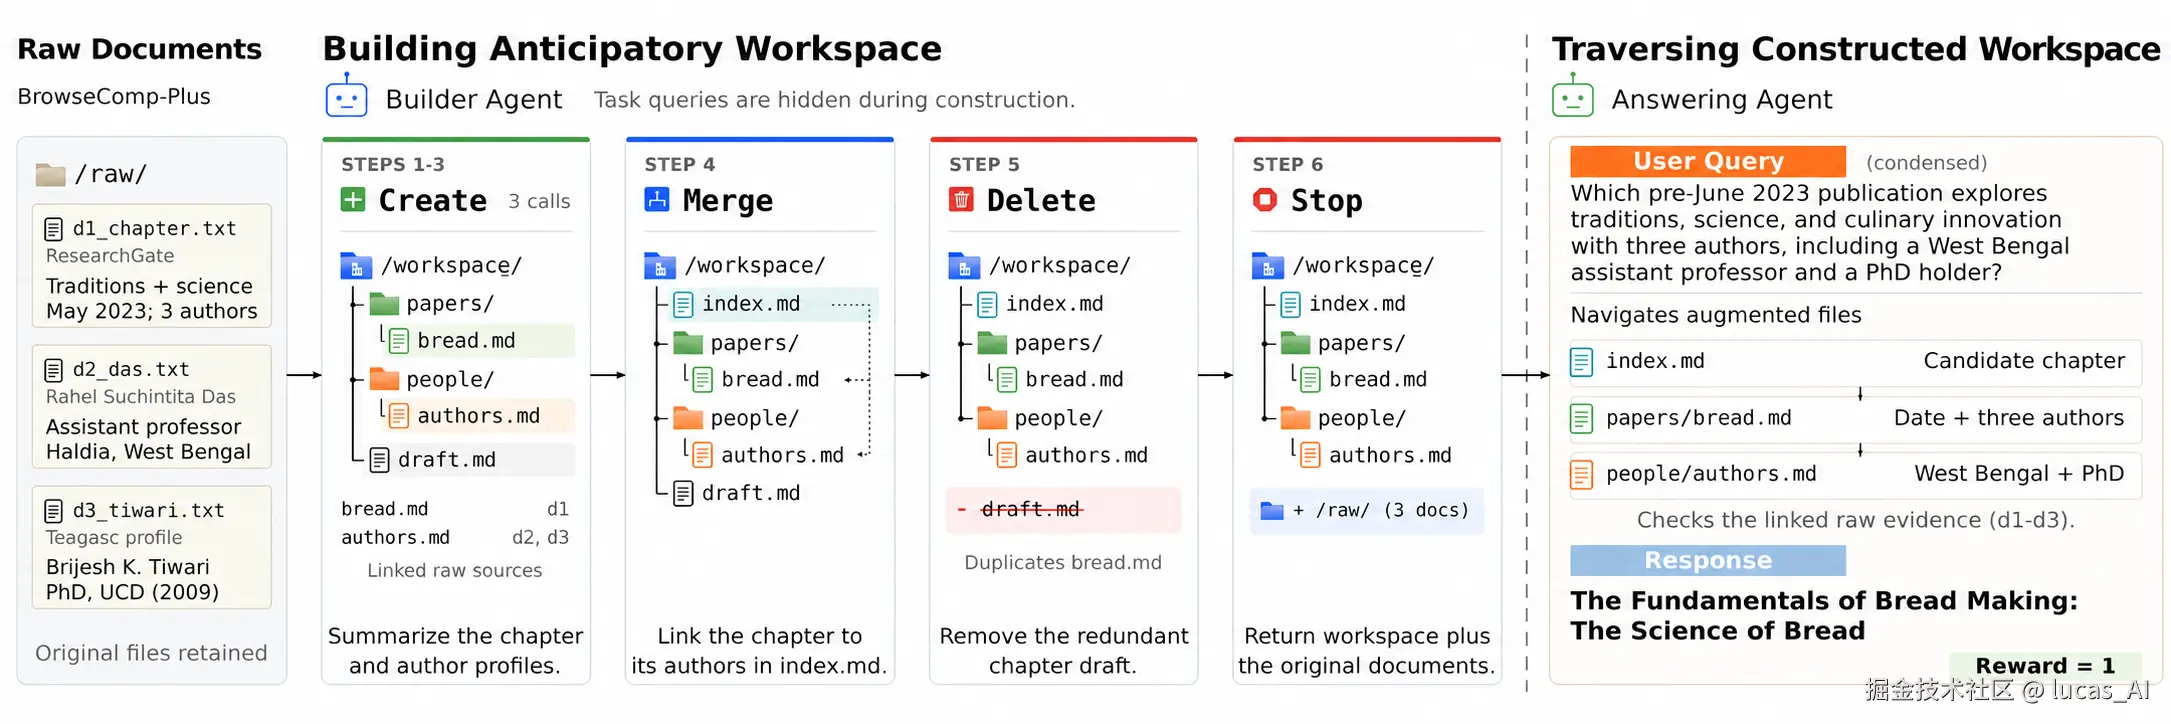
这套流程被形式化成一个有限步数的 MDP(马尔可夫决策过程,强化学习的标准问题框架:状态、动作、奖励三件套)。状态是当前工作区,动作就是上面四个文件操作,而奖励的设计是全文最妙的一处:不看整理得像不像样,只看答题 agent 用这份工作区能在隐藏训练问题上答对多少。等于说,「什么是好的整理」这个原本靠人工经验定义的问题,被直接交给了下游任务效果来裁决。
奖励怎么算得过来?每编辑一步就跑一遍完整答题评估太贵,论文用了个务实的代理信号:每 8 个 builder 回合插入一次 answerability 探针(快速估一下工作区「可回答性」),奖励取相邻探针间的变化量,最后加终局答题得分;它在理论上与稀疏目标数学等价(势函数塑形的望远镜求和),工程上把学习信号密度提了一个量级。训练用 GRPO(一种策略梯度强化学习方法)微调 Qwen3.5-4B 当 builder,文件内容的实际撰写交给更大的固定模型 Qwen3.5-35B-A3B 执行,答题者可以是 Qwen3.5-4B 或 Gemini 3.1 Flash Lite,全程冻结。
两条纪律值得划线:builder 构建时从来看不到任何评测问题,工作区必须是 query 无关的,训练时连奖励用的 mini-batch 问题也对它隐藏;所有方法共用同一批冻结的答题模型,性能差异只能归因于「整理出来的记忆质量」,归因链条干净。
📈 效果:33 个点的差距,和一个「不整理就输」的消融
主战场是 BrowseComp-Plus(深研究型问答基准,每个任务配一组真实网页文档)。50 个留出语料上的结果如下图,右数第三组「No-FT」是未做强化学习的同款 builder。
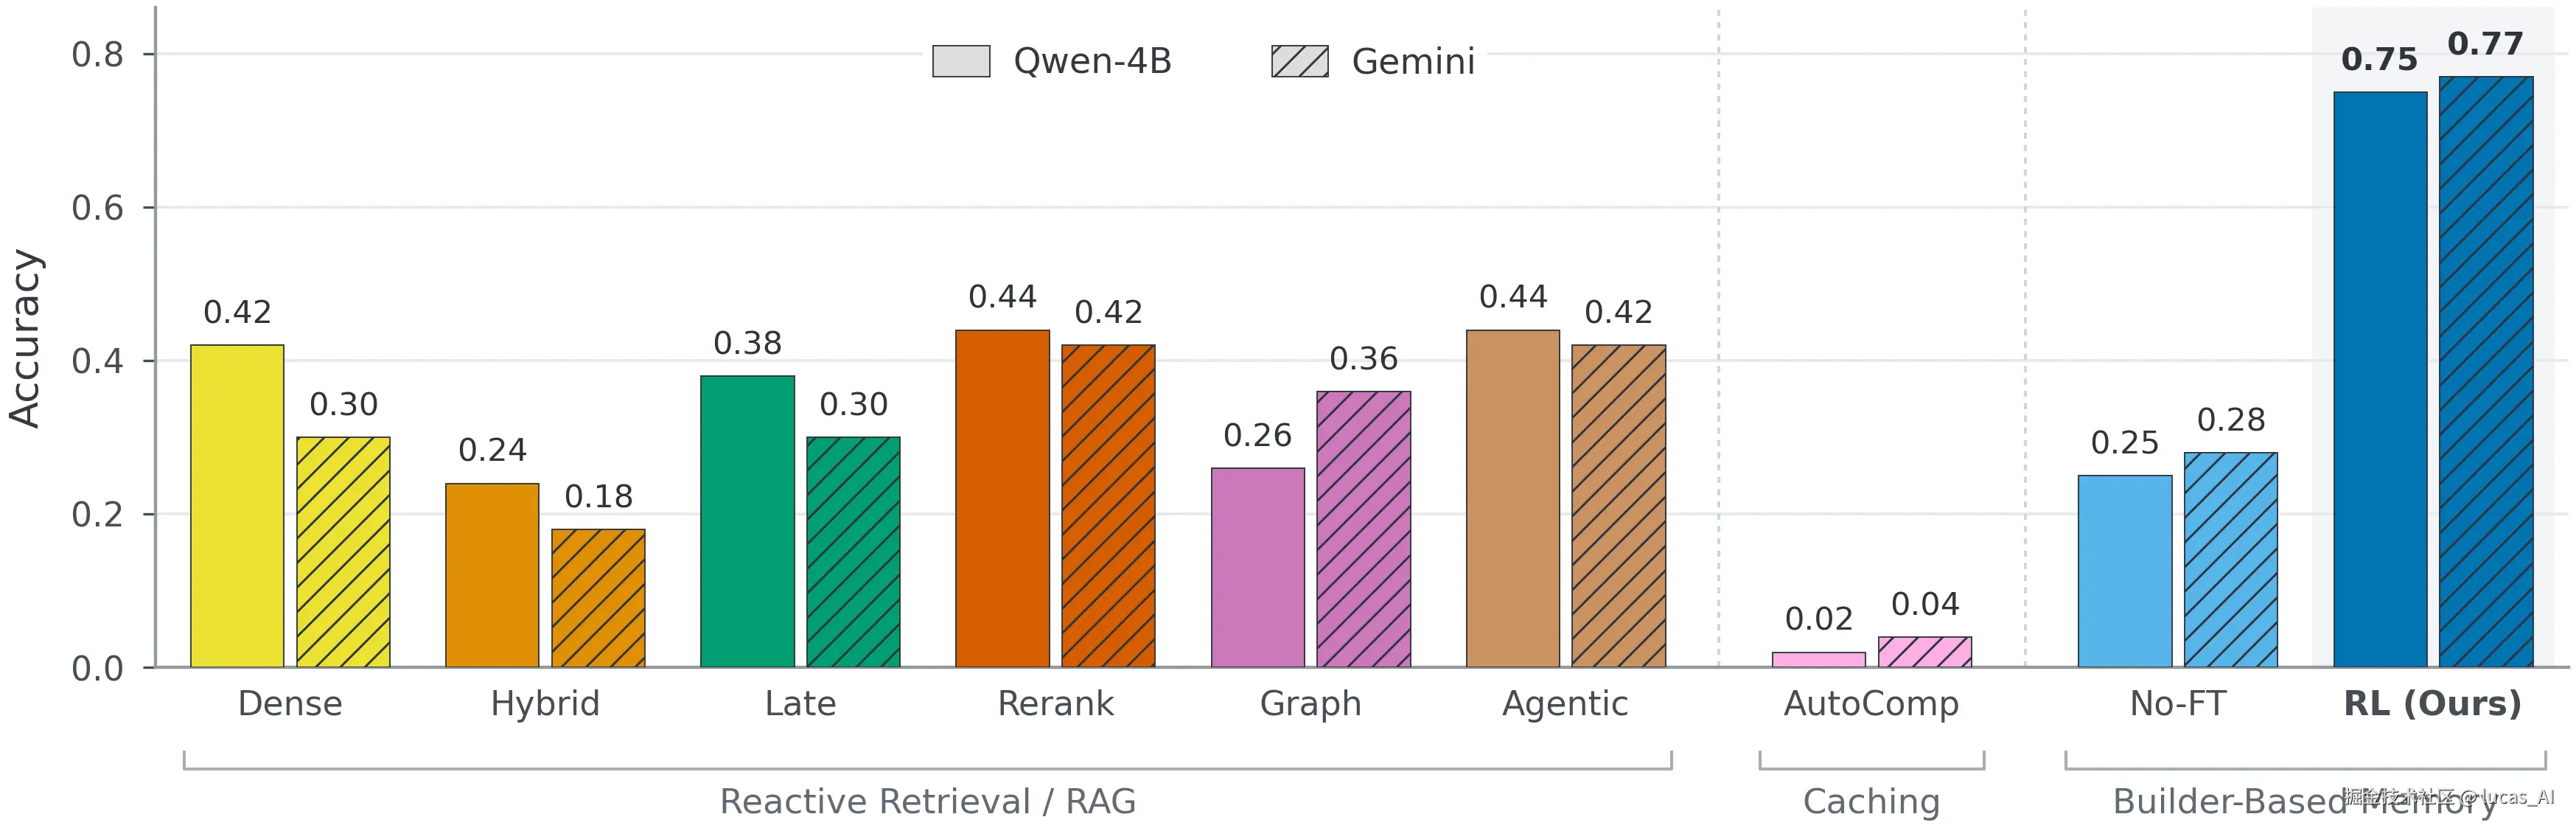
三个读图要点。最强基线(Rerank 与 Agentic RAG)在两个答题模型下分别是 0.44 和 0.42,Librarian Agents 达到 0.75 和 0.77------对最强基线平均高出 33 个百分点,就是摘要里那个核心数字。No-FT 消融只有 0.25/0.28,甚至打不过普通检索基线,说明增益不是「给了它一个文件系统」,而是 RL 把「如何为别人整理」真正教会了模型。最后看最惨的 AutoCompaction(把文档流压缩成与查询无关的笔记):砸了 50 万 token 构建成本,准确率 0.04------没有组织结构的压缩近乎销毁证据,这盆冷水泼给所有「无脑摘要党」。
再看成本账(Table 1):GraphRAG 花 1.2 万 token 构建,准确率 0.36;Librarian Agents 花 17.9 万 token,准确率 0.77。构建贵了 15 倍,但这是一次性的开销。摊薄曲线是关键:
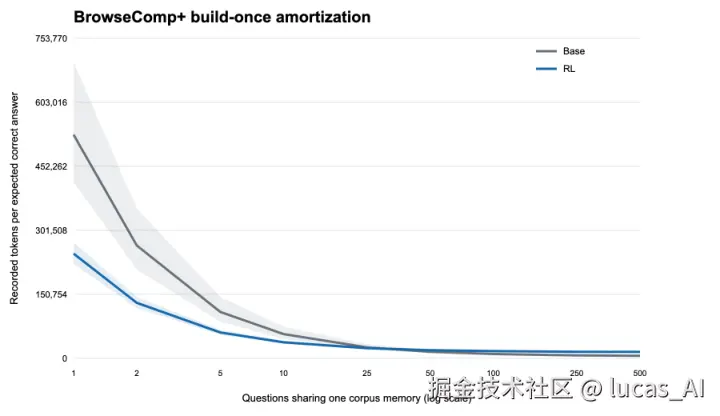
按「每答对一题花多少 token」归一化,每库 10 个问题时 RL 版比 base 版省 33.8%(置信区间 0.504, 0.836);换成纯记账口径,盈亏平衡点大约在每库 31 个问题。也就是说,一份会被反复提问的语料(企业知识库、产品文档、代码仓库),提前整理是笔划算买卖;只查一次就束之高阁的语料,老老实实用检索。
第三张成绩单最让人意外:builder 只在 BrowseComp 类深研究任务上训过,零样本搬到 BRIGHT 基准(数学题解、生物、Stack Overflow 等完全不同的领域,每域 50 问、全域共用一份工作区),平均 pass@1 52%、pass@3 67%,而所有检索类基线平均只有 4.5--20.8,Stack Overflow 域 pass@1 高达 85.5%。另外 9 个附加域对 base builder 九战九胜,Earth Science 从 26.3% 直接跳到 73.8%。这说明它学到的是「预期性整理」这个可迁移能力,不是对某个数据集的过拟合。
结构变化也佐证了这一点:BRIGHT 上 RL builder 平均建出 53.4 个活跃合成文件、45.4 个簇、8 次合并,base 只有 4.8 个文件、0.6 次合并------前者在认真「建馆」,后者在敷衍「贴标签」。
它建出来的图书馆长什么样?两个案例
数字之外,定性对比更能说明 RL 教会了什么。下图是同一语料的对照,问题问南非某镇一所 1980 年代教会学校最资深处长的角色。
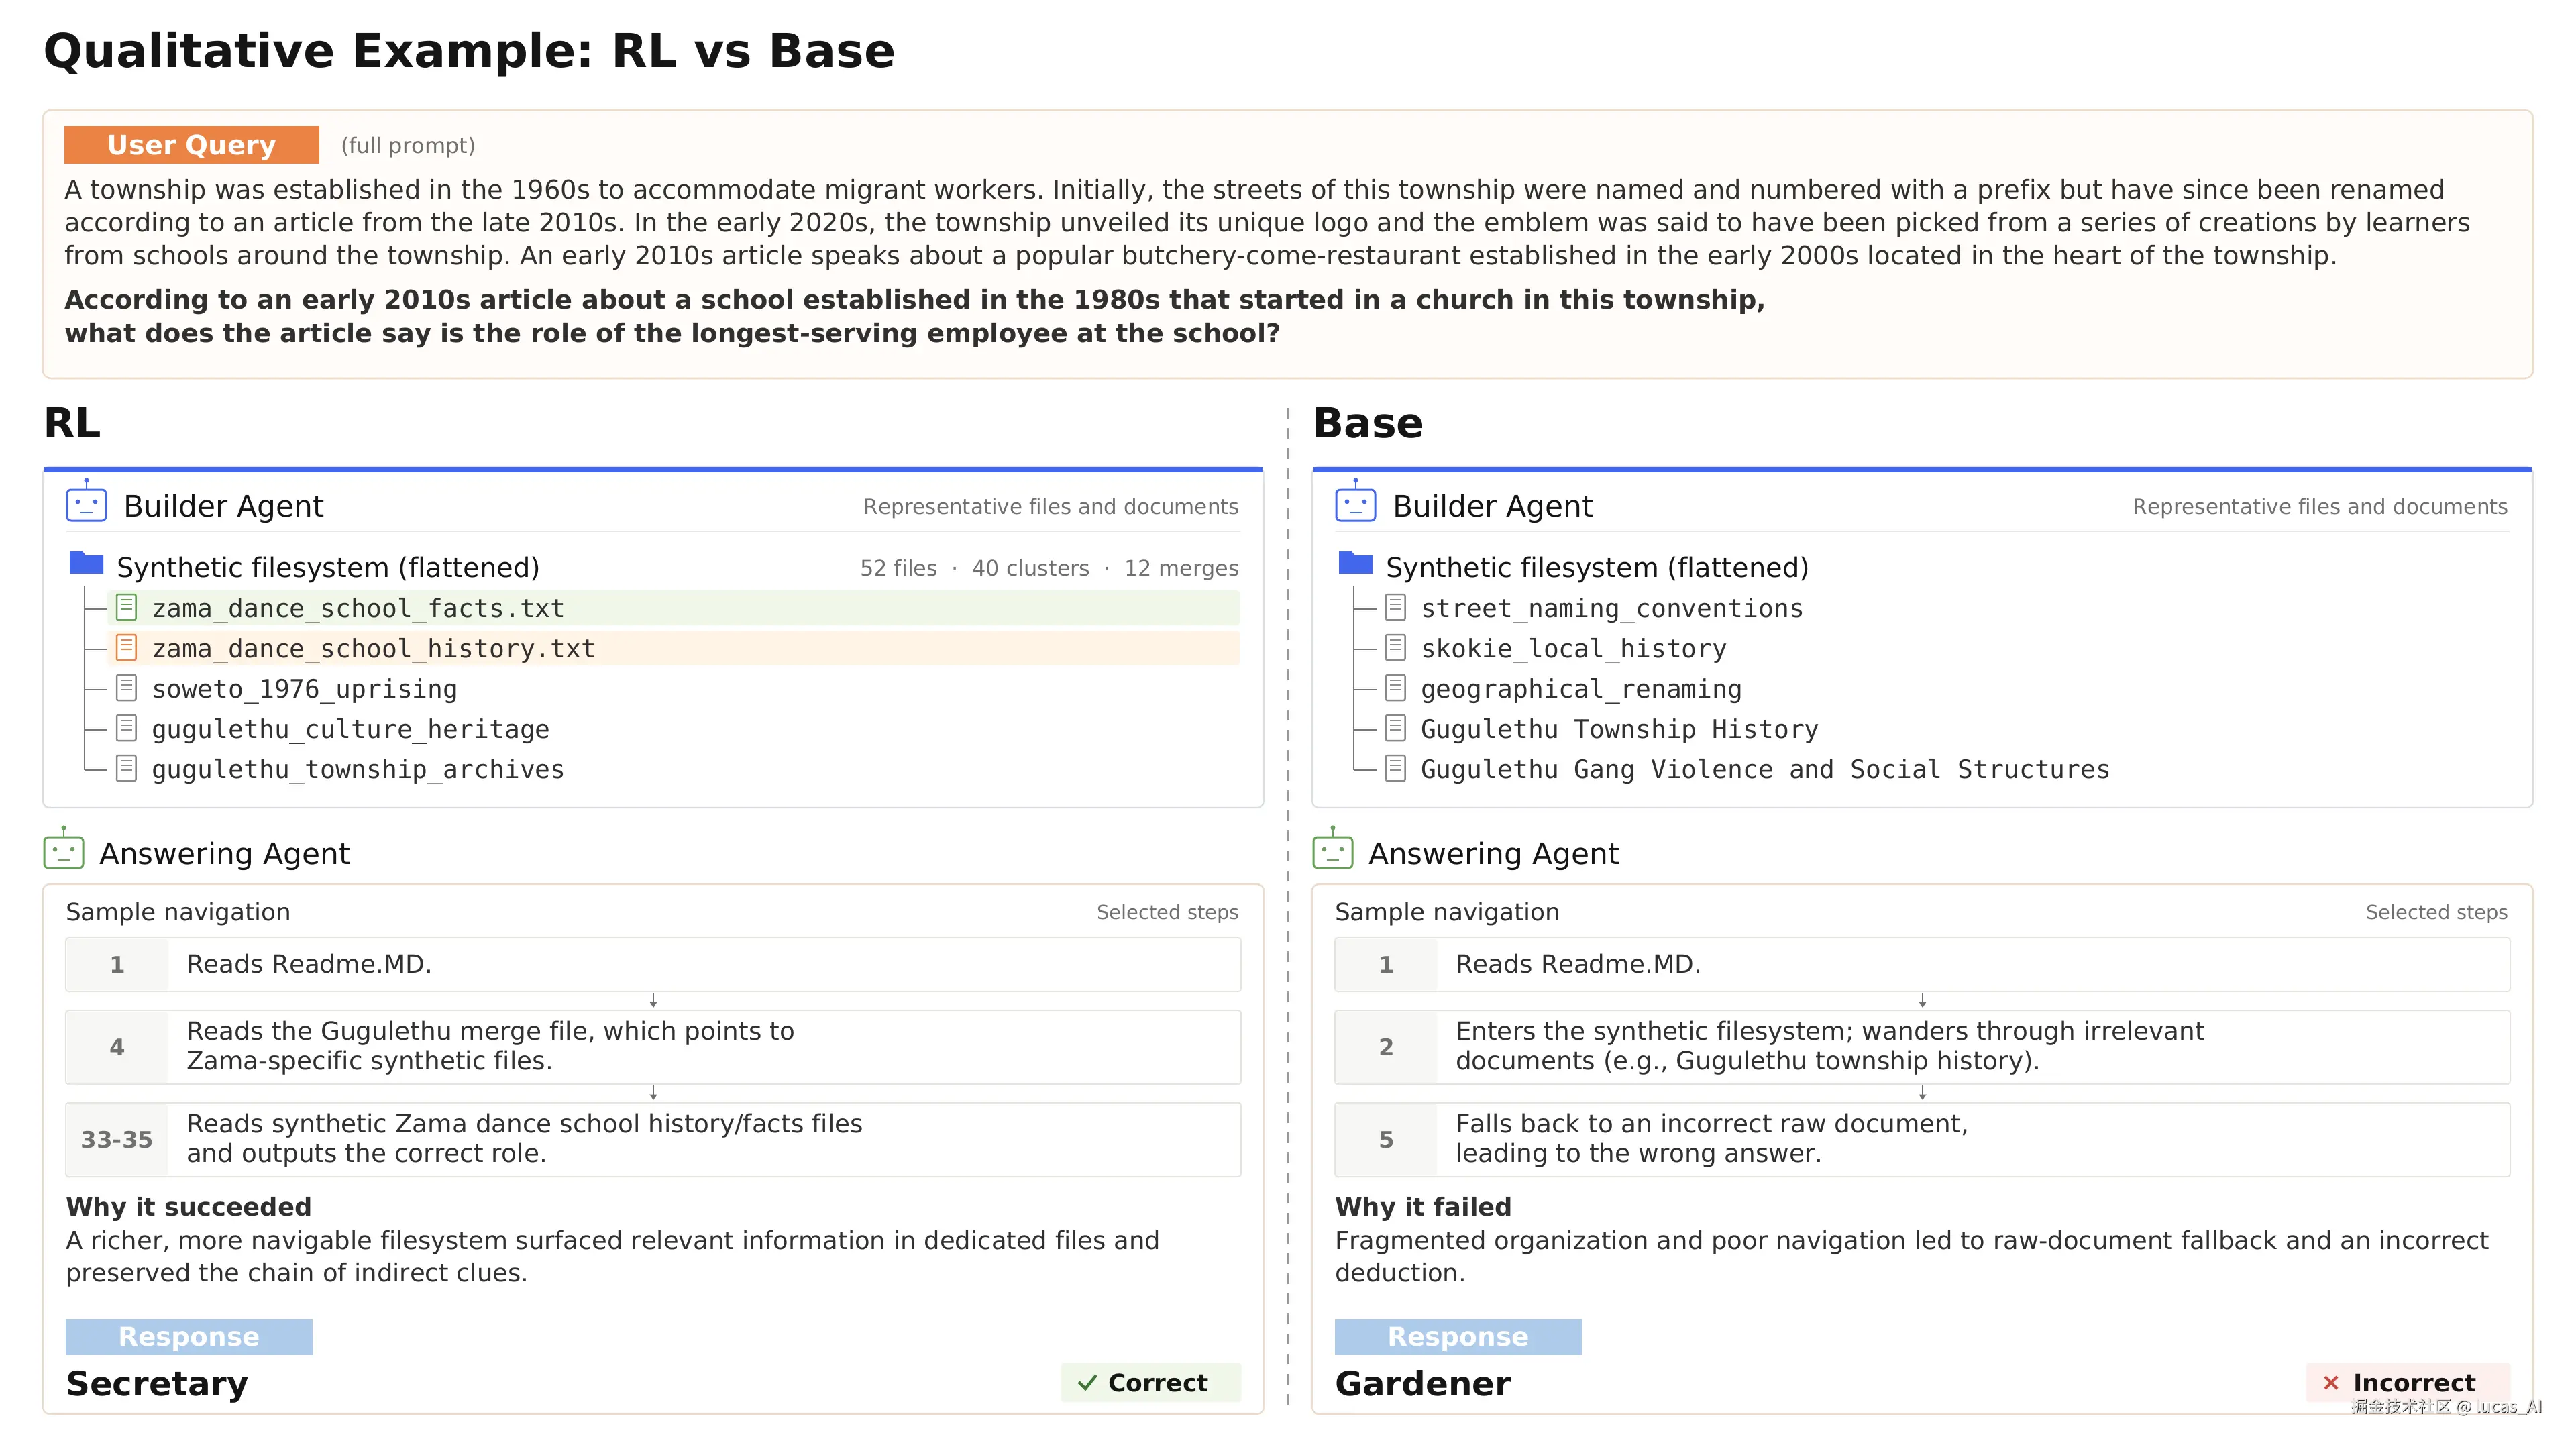
RL 版的文件系统里有 zama_dance_school_facts.txt 这样精准命中的合成文件,答题者读完 README、顺着合并文件两级跳就到了答案;base 版建的是街道命名规范这类「看起来合理但答不了题」的通用文件夹,答题者迷路后回退原文还回错了文档。同一个模型,训与不训,一个像藏书楼,一个像废纸堆。
第二个案例回答一个更尖锐的质疑:合成层是压缩,压缩就会丢细节,needle 型问题(答案藏在某个不起眼的局部事实里)怎么办?论文的答案是溯源链接------每个合成文件都指回原文,丢了的可以找回来。
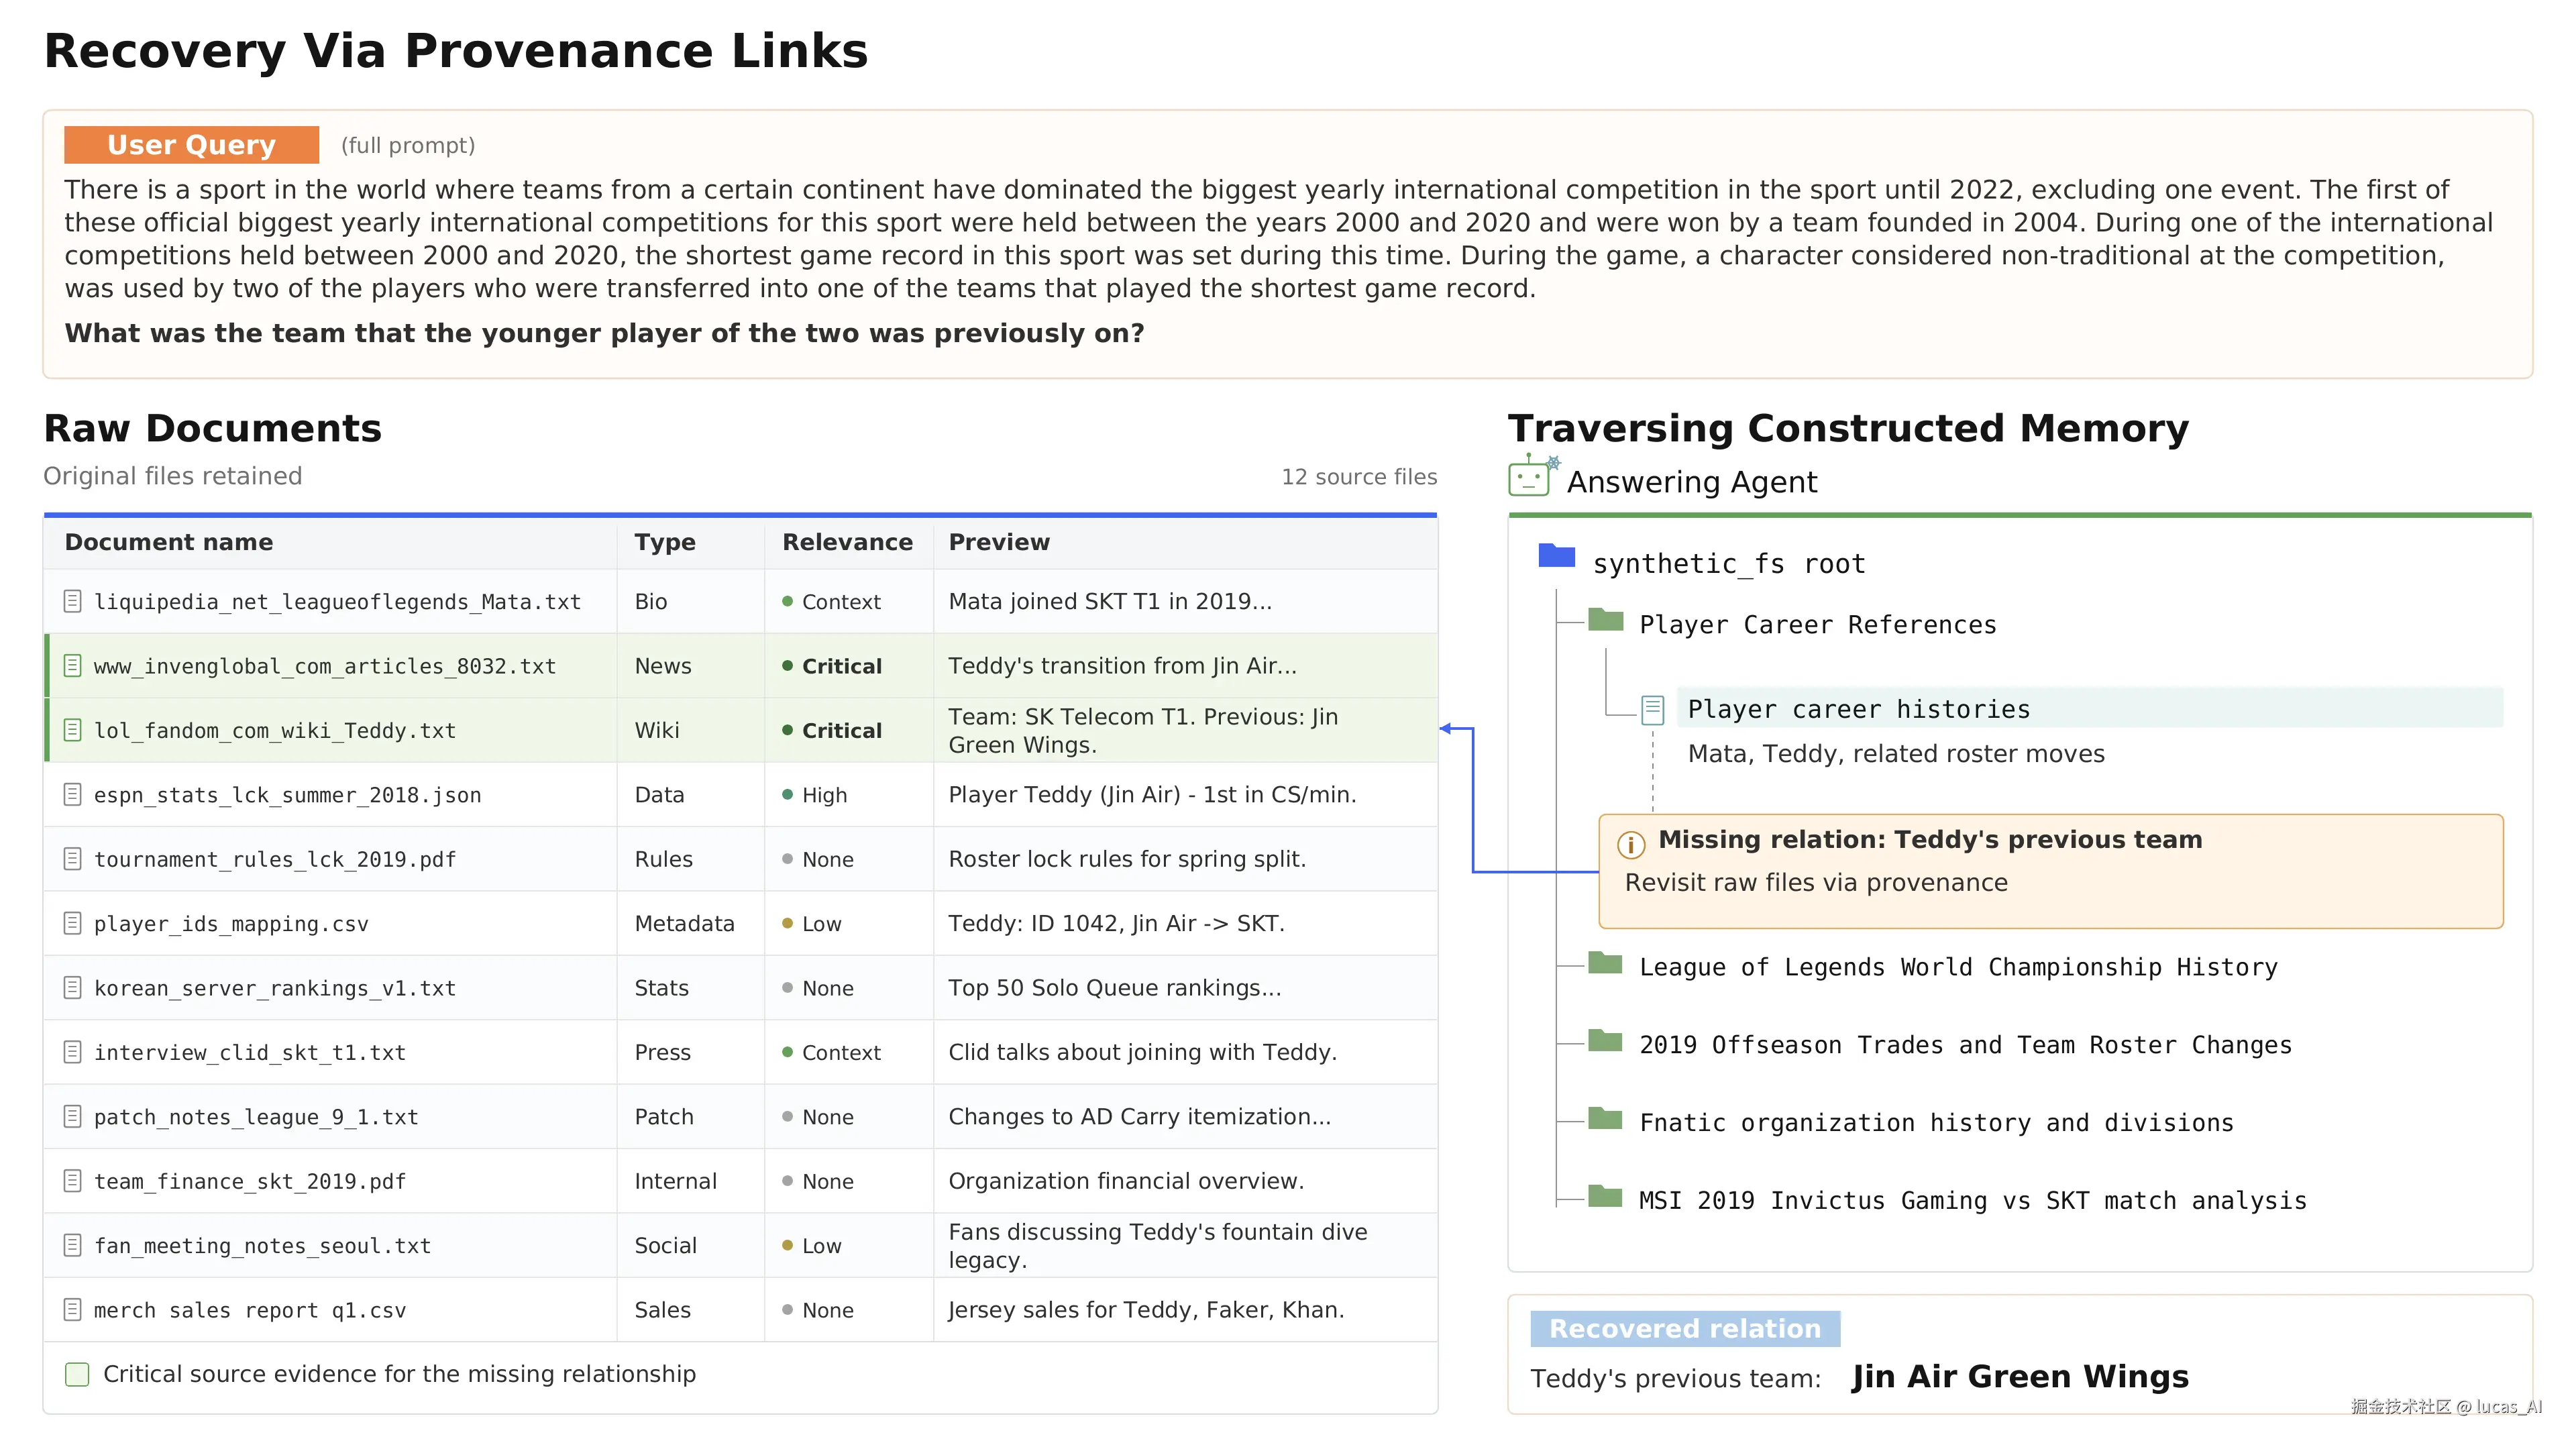
上例里答题 agent 发现合成层缺一条关键关系,没有硬猜,而是顺着引用链接回到两条原始文件补齐证据。配套的结构消融(Table 7)给出两条可迁移的准则:把层级拍平,准确率不变但导航 token 涨 51%(3,635→5,497);把语义摆放打乱,导航成本不变但准确率掉 4.1 个点(55.86→51.72)。层级决定「找的代价」,摆放本身携带「找不找得到」的信息------这两句可以直接贴在任何知识库治理规范里。
怎么用到你自己的系统里
论文框架离落地还差工程化,但思路可以按性价比排序拆解:
- 先估算查询频次:语料预期被问几十次以上才值得预整理,一次性任务留在 RAG 舒适区;本文的盈亏平衡点(原始 token 口径约 31 问/库)是现成的参考量级;
- 整理动作对齐 LLM 已会的接口:文件系统是 agent 生态的「母语」,合成文件加溯源链接不挑模型------不训 RL,用强模型加一份「为未来问题建索引」的系统提示,也能先吃到工程版红利;
- 评价标准换成下游效果:别用「摘要写得好不好」评审知识库治理,冻结一个答题模型、出一批隐藏测试题,用答对率说话------这是本文奖励设计最值得抄的部分;
- 溯源链接是压缩的安全网:允许合成层丢信息,但每个文件必须指回原文,needle 问题交给回退路径兜底。
把这套逻辑放进真实场景:企业知识库团队每周收到上百个跨文档问题,多围绕版本差异、发布变更、依赖更新。与其每次问答都在文档海里捞针,不如让 builder 每周把新增文档归档成「发布时间线」「组件级索引」几套视角的合成文件,答题 agent 按问题类型取道------这正是论文图 1 的工作流。
🧊 泼冷水时间
方法是真漂亮,但五盆冷水得泼。
第一盆:评测盘子小,裁判单一。 主评测只有 50 个留出语料;正确性判定用 Gemini 3.1 Flash Lite 当 LLM judge,与其中一个答题模型同源,判分偏置没有人工抽检兜底。+33 个点里有没有判分红利,需要更严格的复现确认。
第二盆:静态语料假设。 论文自己在 Limitations 里承认,文档一变工作区就过期,增量维护是开放问题;而企业知识库恰恰是活的,重整理的触发时机与成本全文未讲。
第三盆:账面 token 反而变多。 答题端每问要读 9,346 token(base 只有 1,238),省的 33.8% 是「按正确率归一化后」的钱;在线服务对延迟和单次费用敏感的话,这笔账要重新算------尤其是盈亏平衡点之前的那些查询。
第四盆:构建与训练都不便宜。 每份语料 17.9 万 token 的一次性构建,背后还有 680 个任务上的 GRPO 训练,以及训练期反复跑答题 agent 的探针开销。中小团队想原样复训,先掂量算力。
第五盆:BRIGHT 的 85.5% 需要冷静看。 Stack Overflow 域一域一库、全域 50 问共享一份工作区,加上语义判分和小样本(±3.9 的标准误),单域数字不宜外推;好在 9 个附加域对照方向一致,大趋势可信,但「零样本 52% 平均分」别直接当成你业务上的预期值。
💡 理性看待
把视角拉高,这篇论文真正的贡献不是又多了一个 RAG 变体,而是完成了一次范式搬家:「语料组织」从写死的工程管线,变成了一个可学习、可用下游效果直接优化的策略。它与 sleep-time compute、缓存复用同属一个思想谱系------把计算在时间轴上重新分配,把「每个用户都要重复付的成本」变成「系统只付一次的成本」,区别在于这次被前置的不是推理或摘要,而是「结构」本身。
对做 Agent 和知识库的工程团队,它给出一个低成本可试的启发:文件系统是大模型已然熟练的接口,「为未来的自己写好 README 和索引」未必需要 RL 才有价值;正式投入时,论文的奖励设计(隐藏问题上的下游答对率)提供了比一切人工启发式都干净的优化目标。对做 RL 研究的人,它是「多轮 agent + 稀疏长 horizon 任务」 reward 稠密化的又一个实证案例。
回到标题那个比喻:图书馆员的价值,从来不在藏书多少,而在开馆之前把每本书放对位置。过去我们训练模型做一个好读者,这篇论文开始训练模型做一个好馆员------至于这座图书馆能不能跟着馆藏变化自己重新上架,那是下一章的故事了。