做过文档解析流水线的人,大概率见过这种尴尬:OCR 报表上的准确率接近满分,产品经理随手一问「论文里 Figure 3 那张图画了啥」,系统当场哑火。图框出来了、字也抠干净了,但「这张图到底表达了什么」这件事,从来不在任何解析器的交付清单里。图进了知识库,就是一块没有说明书的黑方框。
来自卡尔斯鲁厄理工学院(KIT)的团队把这事捅破了一张纸:不是模型不行,是考卷从来只考单科。版面、文字、阅读顺序、图像描述,四个子任务各考各的、各发各的榜,没有任何一张考卷要求它们写在同一份答案里还互相能对上号。
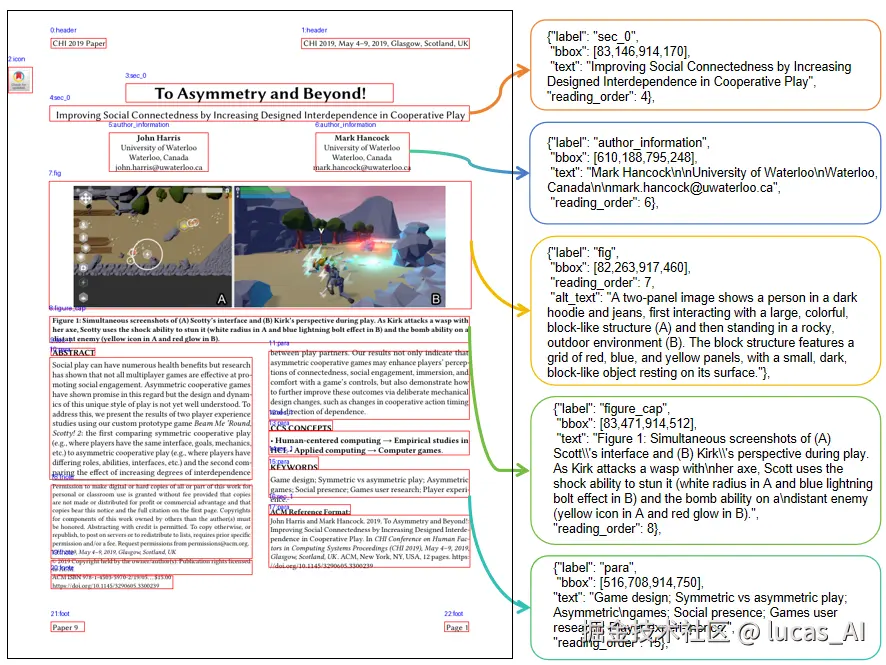
这篇《Read, Parse, Describe》干脆自己出卷:给一页论文图像,模型必须一次交出一份按阅读顺序排列的元素清单------每个元素带边界框、语义标签、顺序号、识别出的文字,视觉元素还得挂上图注关联、再写一句「这图画了什么」的替代文本。2400 多篇论文、1.8 万余页考下来,结论清晰得有点残酷:单科冠军一抓一把,全科及格的没有。
💡 一句话总结:Read-Parse-Describe 把「读字、拆版面、讲图意」捆成一份统一的页面级解析合同,用 2402 篇论文、18,164 页、125,218 个版面元素和 11,338 个视觉实例做成基准;实测管线解析器不产图注关联和替代文本、通用大模型空间定位拉胯、文档专用模型各缺一角。配套的 SARA 适配器冻住基座 VLM 只训 8400 万参数,就把 Qwen3.5-2B 的版面 F1 从 0.7336 拉到 0.9189,阅读顺序同步涨到 0.9774。
想看原文的自取:
- 📄 论文 · arXiv 2610.20335(数据集与代码作者称将开源,精读时项目链接尚未放出,此处不编造)
痛点:每个解析器都瘸一条腿,基准还在帮着打掩护
先把四门课的名字念清楚。版面分析(Document Layout Analysis,DLA)负责在页面上框出「这是标题、那是段落、这是图」;OCR(光学字符识别)负责把图片里的字抠成文本;阅读顺序预测决定双栏排版里先读左栏还是右栏;图像描述生成负责说清一张图的内容。听起来分工明确,效率挺高。
但一页真实的论文里,这些东西是咬合在一起的:图注指着旁边的图,公式拦腰打断正文,双栏文字跨页延续,脚注缩在页底。分开考试考不出「一份自洽的页面解析」------而 RAG 知识库、无障碍阅读、文献挖掘工具,吃的恰恰是这份自洽的整页结果。单科满分加起来,不等于会做整张卷子。
拧巴到什么程度?论文用同一套考卷测了一批现成系统,单科瘸腿比比皆是。MinerU 文字识别准确率 0.9671 接近满分,阅读顺序分却只有 0.6757;MonkeyOCR 反过来,阅读顺序 0.9684,版面 F1(精确率与召回率的调和平均,衡量框得准不准)只有 0.6030。最整齐的一幕是:所有管线式解析器在替代文本(alt text,就是网页图片加载失败时给屏幕阅读器念的那段说明文字)一栏整列空白------不是写得差,是压根没有这个字段。
那把四科各自补齐不就完了?问得好,但这正是论文要纠正的直觉。四门课分别考满分,跟「把五科答案写在同一份卷子上且互相能对上号」是两种能力------后者才是真实使用时的样子。
思路 🛠️:把「读、拆、讲」捆成一份合同
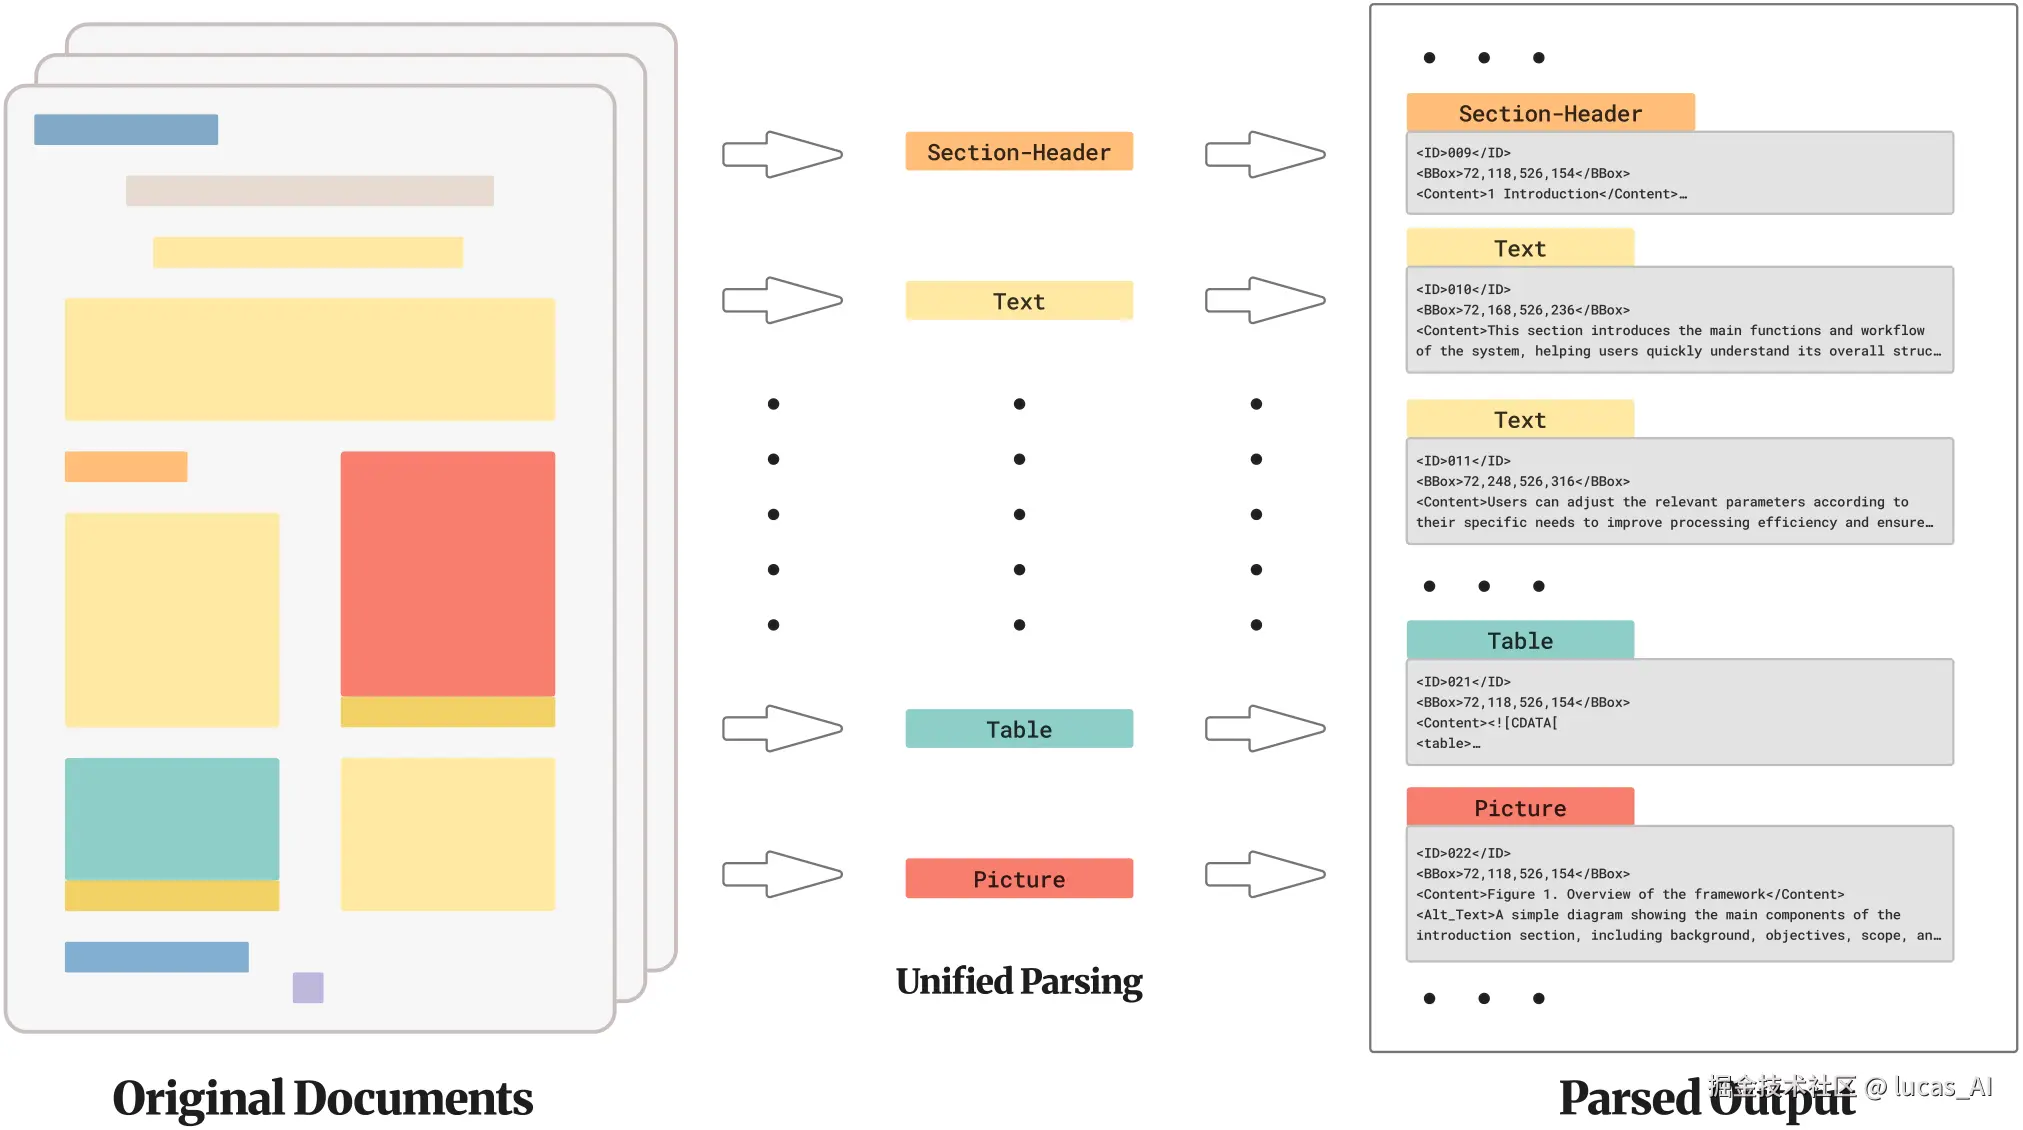
任务:一份有序的元素清单
Read-Parse-Describe 的交付物很具体:对一页图像,输出一个按人类阅读顺序排列的元素列表,列表里每个元素都要带齐五件事。缺一样,这一项就不算完成。
- 边界框和语义类别------它在页面哪里、是什么(标题/段落/图/表/公式/脚注,共 23 类);
- 阅读顺序序号和识别出的文字------第几个读、写了什么,表格还要输出 HTML 结构;
- 图注关联(caption_id)------指认「说明我的那句话是哪条」;
- 替代文本------对图表类元素,写一句忠于画面的事实性描述。
关键词是「捆绑」。游离的 OCR 字符串、孤零零的图片描述,哪怕写得再漂亮,挂不到对应元素上就不给分。描述挂错了图,第一次变成可测量的错误,而不是被默默放过;双栏顺序、跨栏大图、和图分离的图注,也第一次有了统一的暴露口。这是这份基准真正的新意:不发明任何单个字段,而是强制字段之间互相咬合。
数据规模也够看:2,402 篇 ACM 开放获取论文、18,164 个连续页、125,218 个版面元素、11,338 个视觉实例。语料取每篇前 8 页------别嫌抠门,附录算过账:参考文献类元素 91.75% 落在第 9 页以后,而公式 78.42%、图和图注 69.15% 都挤在前 8 页,截断保留的恰是信息密度最高的部分。切分按论文级 9 : 0.5 : 0.5 划训练/验证/测试,防止同一篇论文的相邻页互相「泄题」。
标注怎么来的?机器打底、人工联修。解析器先初始化所有框,人对框、类别、图注关联、阅读顺序做联合修正------挪一个框,文本裁剪、图注候选、顺序位置全得跟着动,所以必须一起改。替代文本则走「Gemini 3 Pro 生成初稿、Gemini 3 Flash 按 1--5 分打分」的流程,低于 4 分的 1408 条转人工精修,精修后满分率从 66.2% 提到 98.1%。这个精度够做基准,但后面泼冷水时会回到这。
SARA:给冻住的 VLM 补一针「空间感」
光有考卷不够,作者还顺手交了一份「怎么提分」的答卷。背景是:现代视觉语言模型(VLM,同时吃图像和文本的模型)普遍把图像 token(模型的最小输入单元)压缩合并后再喂给语言解码器,压缩省了算力,但也把「元素边界在哪、图注贴着哪张图」这类局部空间线索压糊了------恰好是这份考卷最考的地方。
SARA(Spatial Alignment Residual Adapter,空间对齐残差适配器)的思路是「不动基座,旁路补线索」,一共三步。第一步,从视觉编码器的早中层(第 2、5、8、11 层)抽中间特征------这些层还保留着精细的边界和布局信息,没被高层语义稀释;第二步,把多层特征拼接后过一个小投影器,再按每个图像裁剪块的网格做对齐,池化到和原生合并后 token 一模一样的长度和维度,保证残差信号能逐位对上;第三步,用一个可学习的门控(初始化为 1.0)把对齐后的空间线索以残差形式注回原视觉 token 流。
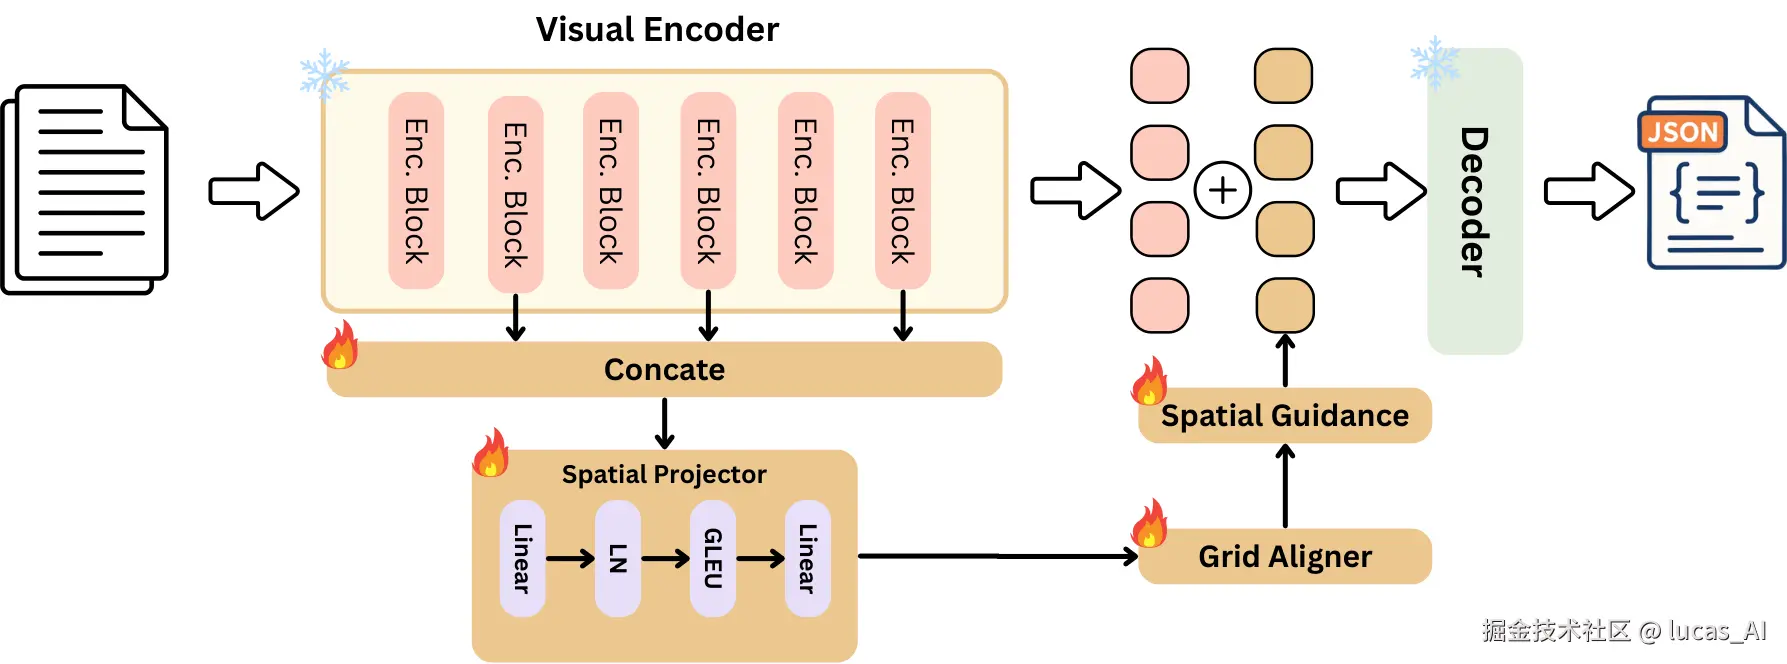
这套设计的代价小得反常:基座全程冻结,Qwen3.5-2B 上只训 8399 万参数,对照全量微调的 18.8 亿,不到二十分之一。它能起作用的前提也直白------空间线索本来就在视觉特征里,只是被合并压掉了,旁路对齐等于把丢失的信息原样还回去。
效果 📈:单科冠军不少,全科及格的没有
先看零样本横评,也就是拿现成模型直接考。管线解析器字抠得好但交不了完整卷子:MinerU 识别 0.9671、阅读顺序 0.6757,替代文本一栏是空的;PP-StructureV3 阅读顺序更低,只有 0.5054。通用 VLM 能填满 schema 但框不准:ChatGPT-5.6 是零样本全能选手(版面 F1 0.7489、阅读顺序 0.9448、BERTScore 0.9004 为全场最高),可定位框的重叠率上不去;Gemma4-E4B 版面 F1 只有 0.5473。定位和描述,在零样本世界里是两种技能。
微调之后呢?文档专用模型在定位上逼近天花板:Dolphin-v2 全量微调后 F1 0.9826、阅读顺序 0.9857,双双全场第一;DeepSeek-OCR 拿下描述指标 METEOR(一种衡量生成文本与参考文本相似度的指标)最高的 0.3998。但注意,它们依然不产出完整的替代文本字段------专用强在「拆」,不在「讲」。
真正的看点是 SARA 对比自己的基座。同样冻住 Qwen3.5-2B:只加 LoRA(冻结原模型、只训一小片低秩矩阵的轻量微调法)F1 是 0.7004,换 SARA 直接跳到 0.9189,差距 0.2185;Gemma4-E4B 上同样成立,F1 和 mIoU 分别高出 0.1750 和 0.1898。和全量微调(1.88B 参数)比,SARA 的 83.99M 参数换来 F1 0.7336→0.9189、阅读顺序 0.9628→0.9774、识别准确率 0.9408→0.9636,五项指标全面领先。
拆开看消融,有两个数字最值得记住。其一是「缺一不可」:只训网格对齐模块 F1 0.7541,只训投影器反而跌到 0.6830(比全量微调还差,说明增益不来自多加的参数本身),两者合体才到 0.9189。其二是「层选对了」:早中层 {2,5,8,11} 特征给到 0.9192,换成晚层 {16,18,20,22} 只剩 0.7221------空间细节确实住在浅处,晚了就被语义磨平了。
不过有个前提要说破:SARA 的优势是「喂饱了才显灵」。训练数据只给 10% 时,它四项结构指标全输全量微调;到 50% 反超(F1 0.8781 对 0.6991),100% 全面领先。输入分辨率砍到 25% 也不行,识别准确率直接掉 0.1988。约 8000 页的数据量和足够分辨率,是这份「划算」的入场券。
效果光看数字不够直观,论文给了同一页的四连拍对比。先是人工真值,每个元素的框、标签、顺序、替代文本严丝合缝:
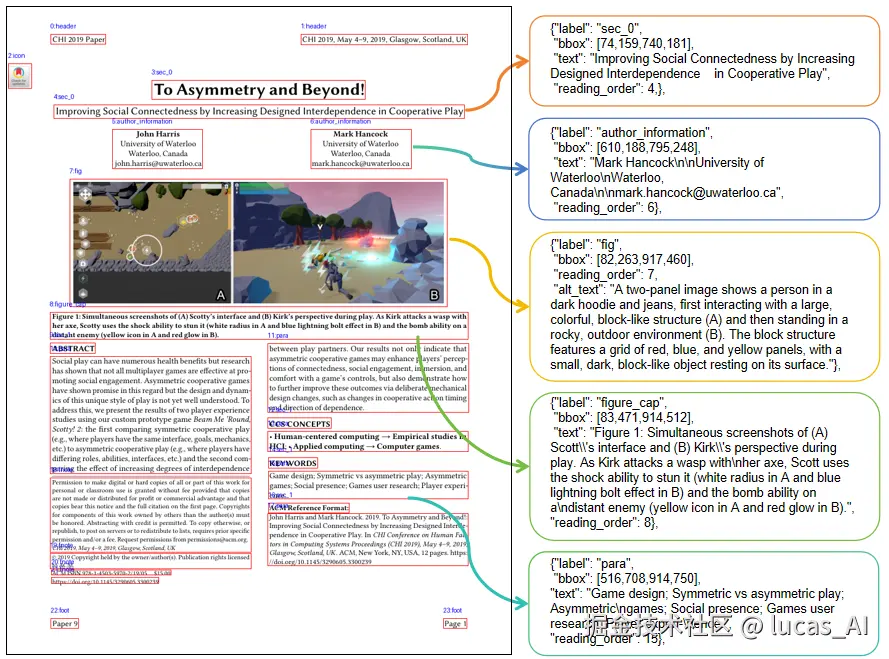
基座 Qwen3.5-2B 直接考,输出稀碎:元素映射残缺、空间 grounding 松散,框和内容对不上号:
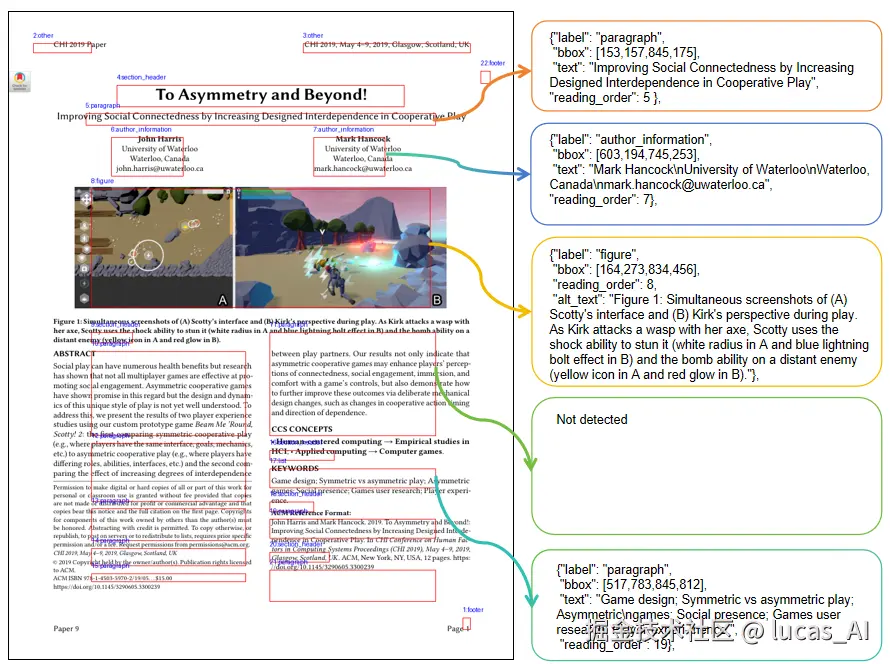
换上 SARA 之后,元素框的位置、图注挂接和阅读顺序明显向真值收敛------特别是图注关联和替代文本,终于「长在」正确的对象上:
一句话概括这张四连拍:全量微调让答案变得合规,SARA 让答案变得「在正确的位置」。前者修语法,后者修空间。
怎么用:三路人马各自的抄作业姿势
做 RAG / 知识库 ingest 的,最值得偷的是「替代文本进 chunk」这一手。论文图表带数字、带结论,正是检索时最该被命中的内容------把 alt_text 和图注关联并进切分结果,用户问「某方法的准确率趋势」时,命中的不再是一块黑方框。评测自家解析器时,也可以直接借它的验收清单:定位 F1、mIoU(预测框与真值框的重叠率)、阅读顺序、识别准确率、描述质量五项一起看。
做无障碍或合规的,重点不是 SARA 而是任务定义本身:替代文本是解析结果的必填字段,不是锦上添花的附件。KIT 这个组本身就背着德国 KATE 无障碍辅助技术项目的资助,整份基准的动机端就是屏幕阅读器用户------描述必须挂在正确的对象上、跟图注对上号,错配是会被量出来的错误。
想自己训一个的,路线图也给了:如果已有几千页级标注数据(论文里 SARA 的优势从 50% 训练集、约 8000 页开始显现),冻住基座加一个 SARA 式旁路,比全量微调省钱且结构指标更好;如果数据不足或只是想补齐描述字段,务实做法是管线解析器做前端、VLM 做后端补图注与替代文本------论文实测这两类系统的短板恰好互补。
🧊 泼冷水:合同是好合同,出卷人有点偏科
第一盆,语料窄。2,402 篇全部来自 ACM 开放获取库,还只取前 8 页;分析池里 AI & ML 只占 12.6%,长尾「其他」倒有 36.7%。发票、报表、多语种扫描件在这份基准上完全没有发言权,考出来的「统一合同」别急着外推到所有文档场景。
第二盆,裁判和选手可能沾亲带故。替代文本由 Gemini 3 Pro 生成、Gemini 3 Flash 打分,人工只精修 1408 条低分样本,而「194/200 人工与 LLM 打分一致」的审计里 LLM 也是裁判之一。作者自己承认无法排除闭源模型预训练时见过 ACM 语料------用这份基准给闭源模型排名时,记得裁判席上坐着谁。
第三盆,描述质量的度量是软肋。METEOR、BERTScore 本质都在算「跟参考文本像不像」,测不出「盲人用户听完是否真能看懂这张图」。作者明说标注流程不等于可部署的无障碍管线------拿它当生产方案前,人工验收省不掉。
第四盆,SARA 不是免费午餐。10% 数据下全面落败、Gemma4-E4B 上阅读顺序反而从 0.9628 掉到 0.9288、分辨率减半指标就明显松动。它是个「数据充足、分辨率够用」前提下的结构适配器,而不是通用增强剂。
第五盆,工程细节还糙。数据集与代码只承诺开源、精读时项目链接仍是占位符;正文多处把任务名误写成 Read-Parsing-Describe,摘要 18,163 页与正文 18,164 页对不上,两处全量微调参数量(1881.83M 与 2218.4M)也不一致。小毛病不伤结论,但复现前建议等代码落地。
💡 理性看待:真正值钱的是那纸合同
平心而论,这份工作最持久的贡献不是 SARA 那 0.18 的 F1 提升本身,而是它把「什么算一份合格的页面解析」写成了可检验的合同:字段必须互相咬合,错配必须可测量。以前的基准像允许开卷带小抄的单科考,它第一次要求交一份自洽的整卷。
对做文档产品的人,它给了一个立刻能用的自查动作:把自家解析输出按这五项字段摆一遍,哪一列是空的、哪一列对不上号,短板当场现形。大多数团队的答案会和论文里那批系统一样------单科漂亮,整卷残缺。
至于「图里画了什么」,过去它只是学术论文里一句轻飘飘的图注,现在它成了必须交付、可以被打分的字段。这大概就是这份基准真正的潜台词:解析的终点不是把字抠出来,而是把一页纸讲明白。