老照片糊成一团,一键变清晰。
这次项目用 Python 写。
但机器没要求。
随便一台电脑就行,集成显卡都够用。
不用买显卡,不用配 CUDA。
照片也不出电脑,全本地推理。
5 行核心代码:
bash
from gfpgan import GFPGANer                    # 导入修脸器
import cv2                                     # 读图、写图

restorer = GFPGANer(
    model_path="weights/GFPGANv1.4.pth",       # 主模型权重
    upscale=2,                                 # 最终放大 2 倍
    arch="clean",                              # clean 版结构
    channel_multiplier=2,                      # 通道倍数,跟权重对应
)
_, _, out = restorer.enhance(
    cv2.imread("old.jpg"),                     # 读入老照片
    paste_back=True,                           # 修完的脸贴回原图
    weight=0.5,                                # 保真度,越小修得越狠
)
cv2.imwrite("new.jpg", out)                    # 结果存盘
就这些。
剩下都是工程活。
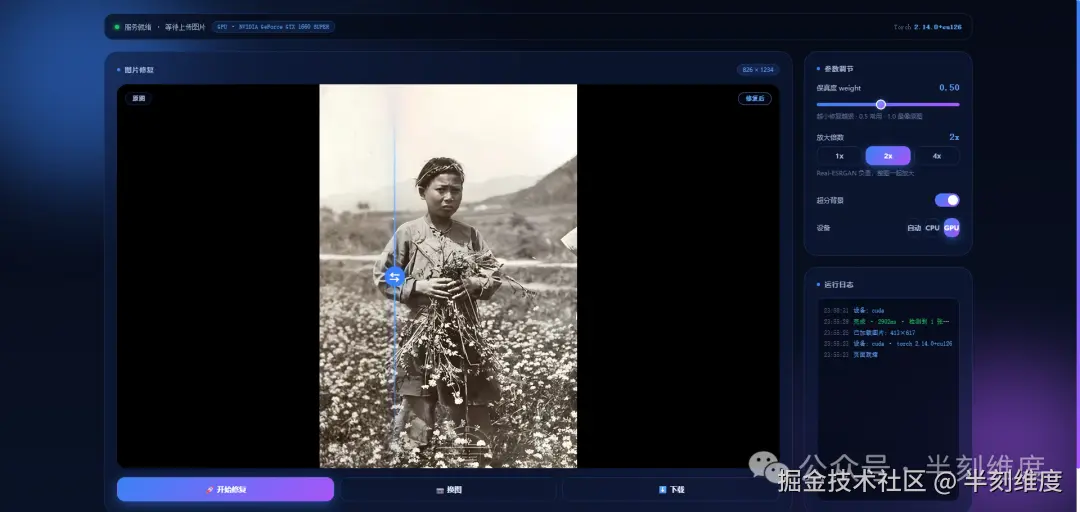
流程图
bash
    上传老照片
        │
        ▼
    Real-ESRGAN 4x 超分(背景)
        │
        ▼
    facexlib 人脸检测对齐
        │
        ▼
    GFPGAN v1.4 修脸
        │
        ▼
    按遮罩贴回原图
        │
        ▼
    CPU 单张 8 秒,有显卡更快
1 痛点
爷爷奶奶那辈的照片,扫描出来脸糊成一团。
调云端 API,一张图几分钱。
全家几十张,账单吓人。
更麻烦的是,图得传外网。
家庭照片、客户资料,能往外发吗?
这套组合,全本地推理。
2 两个模型怎么分工
| 模型 | 星数 | 干啥 | | :-- | :-- | :-- | | GFPGAN | 37.6k | 修脸,专治糊脸 | | Real-ESRGAN | 36.8k | 超分,整图放大补像素 |
都是腾讯 ARC 实验室出品,同一套生态。
GFPGAN 靠 GAN + 人脸先验。
它见过几百万张脸,知道正常人脸该长啥样。
糊掉的五官,它敢按先验补回来。
Real-ESRGAN 管背景,整图放大 4 倍,像素一点点补。
两个一起用,脸和背景都清楚。
demo 就是个网页:拖图进去,滑条对比,参数可调,日志实时。
3 有显卡自动加速
设备选择就几行:
bash
def pick_device():                                        # 挑一个运行设备
    forced = os.getenv("DEVICE", "").strip().lower()      # 读 DEVICE 环境变量
    if forced in ("cuda", "cpu"):                         # 手动指定过就听它的
        return forced
    return "cuda" if torch.cuda.is_available() else "cpu" # 有显卡上显卡
装 CPU 版 torch 它就走 CPU。
换 CUDA 版,代码一行不改。
显存小也不怕,超分器按分块跑:
bash
tile = 512 if device == "cuda" else 192 # 显卡切大块,CPU 切小块省内存实测(CPU,413×617 含人脸, CPU: AMD5500):
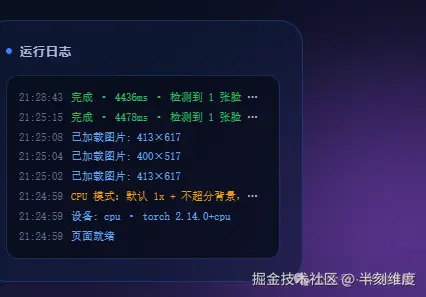
所以 CPU 4秒出图。
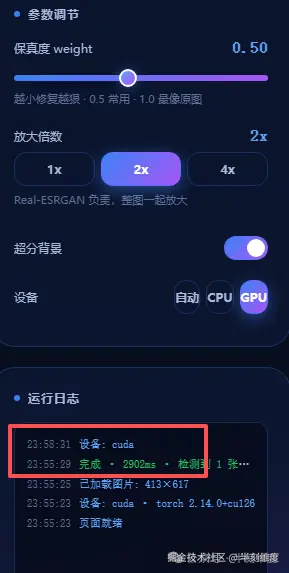
因为我还有个老古董1660S显卡, 开了CUDA试了下, 确实快了很多, 但是就1张照片的话无所谓了, 就快2s。
4 装环境不用踩坑
三个坑,脚本全填平了。
一是 basicsr 源码安装时要 import torch。
先装 torch,再装模型库,顺序对了就能过。
二是 gfpgan 硬依赖 tb-nightly,国内源没有,用 --no-deps 绕过。
那包只有训练才用,推理一行不碰。
三是新版 torchvision 删了 functional_tensor,造个替身塞进去:
bash
def patch_torchvision():
    import sys, types                                  # 改模块表 + 造新模块
    import torchvision.transforms.functional as F     # 新版功能都在这里
    shim = types.ModuleType(                           # 造一个空壳当替身
        "torchvision.transforms.functional_tensor")
    shim.__dict__.update(                              # 把函数全搬进替身
        {k: v for k, v in F.__dict__.items() if not k.startswith("__")})
    sys.modules[                                       # 注册进模块表
        "torchvision.transforms.functional_tensor"] = shim
import gfpgan 之前跑一次就行。
依赖全用 uv,比 pip 快一个数量级,源走清华:
bash
uv venv                                                      # 建虚拟环境
uv pip install -r requirements.txt                           # 先装 torch 等基础依赖
uv pip install --no-deps basicsr facexlib realesrgan gfpgan  # 后装模型库,绕开 tb-nightly
5 权重下载不断线
四个文件,约 580MB。
GitHub 直连常被限速到几十 KB/s。
大文件走多线程分块下载:
bash
headers = {**UA, "Range": f"bytes={start}-{end}"} # 每个线程只下自己那段镜像挂了自动回直连,重试 20 次。
还有个暗坑:官方 parsing_parsenet 的 v0.1.0 链接是 404,真地址在 v0.2.2。
脚本还会把检测、解析这两个权重复制进 facexlib 包目录。
不复制的话,运行时它自己去 GitHub 下,基本必卡。
6 接口简单,模型带缓存
FastAPI 接收图片、调修脸器、返回 base64:
bash
@app.post("/api/restore")                          # 前端把图传上来
async def api_restore(file: UploadFile = File(...),
                      upscale: int = Form(2), weight: float = Form(0.5)):
    img = cv2.imdecode(                            # 字节流转图片矩阵
        np.frombuffer(await file.read(), np.uint8), cv2.IMREAD_COLOR)
    _, _, out = get_restorer(upscale, bg).enhance( # 取缓存的修脸器
        img, paste_back=True, weight=weight)
    ok, buf = cv2.imencode(".png", out)            # 编成 PNG
    return {"image": "data:image/png;base64="      # 拼 data URI 给前端
            + base64.b64encode(buf.tobytes()).decode()}
get_restorer 按 (device, upscale, bg) 缓存。
参数不变就复用,不重复加载模型。
没检测到人脸也不返回空,自动退化成整图超分。
前端日志直接打:
bash
完成 · 8123ms · 检测到 1 张脸 · cpu端口被占了自动找下一个空位。
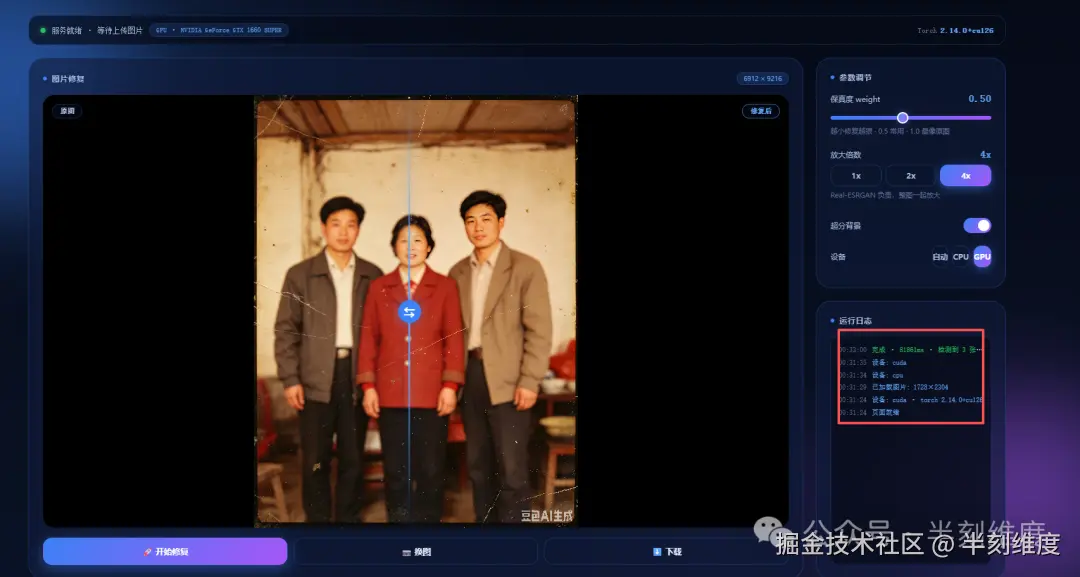
分辨率高的执行时间也长, 但是效果真的好
7 跑起来
bash
cd demo/24
powershell -ExecutionPolicy Bypass -File setup.ps1 -Run   # 装完直接起服务
bash
老照片修复服务 · http://localhost:3024
  设备: cpu · 权重: D:\www\ai-coder\demo\24\weights
强制设备也简单:
bash
$env:DEVICE="cpu";  .\.venv\Scripts\python.exe server.py   # 锁死 CPU
$env:DEVICE="cuda"; .\.venv\Scripts\python.exe server.py   # 有显卡走显卡
总结
-
• GFPGAN:37.6k 星,GAN + 人脸先验,专治糊脸
-
• Real-ESRGAN:36.8k 星,整图超分,管背景
-
• 本地推理:照片不离开电脑,CPU 只修脸 4 秒
-
• 一键脚本:三个装环境坑全填平,权重断了接着下
一张老照片,八秒钟的事。
不用买显卡,不用配 CUDA。
老照片发朋友圈,家人都会说,你小子有本事。