YaoJaro · 独立开发者,正在造 metweave------把公开气象数据编织成可嵌入产品的图。
跟着这个系列走到这里,你把报文读成了卡片、画成了图。有没有停下来想过:图里那条气压线,数据是怎么到你机器上的?
拉一次接口谁都会,curl 一下就有了。但产品要的不是"拉一次",是持续、完整、可证明地拉:源站抽风要兜底、断网了要说清丢了什么没丢什么。这件事有个名字,叫数据管道。这个系列把基建放在最后讲,因为它是地基------今天补上。
先交代底盘:我本机常驻着一条三源归集管道,一跑就是数月------断口有过、每个都有台账、每笔账都能对上。为了验证预报报文(TAF)真的不丢,我做了件更较真的事:用第二个数据源当考官,把它 9.5 天里发行的每一份逐条对了一遍账。这篇把这套方法完整拆给你------凡对账报出的数字,全部出自真实对账台账;属推演的账,正文会当场声明。
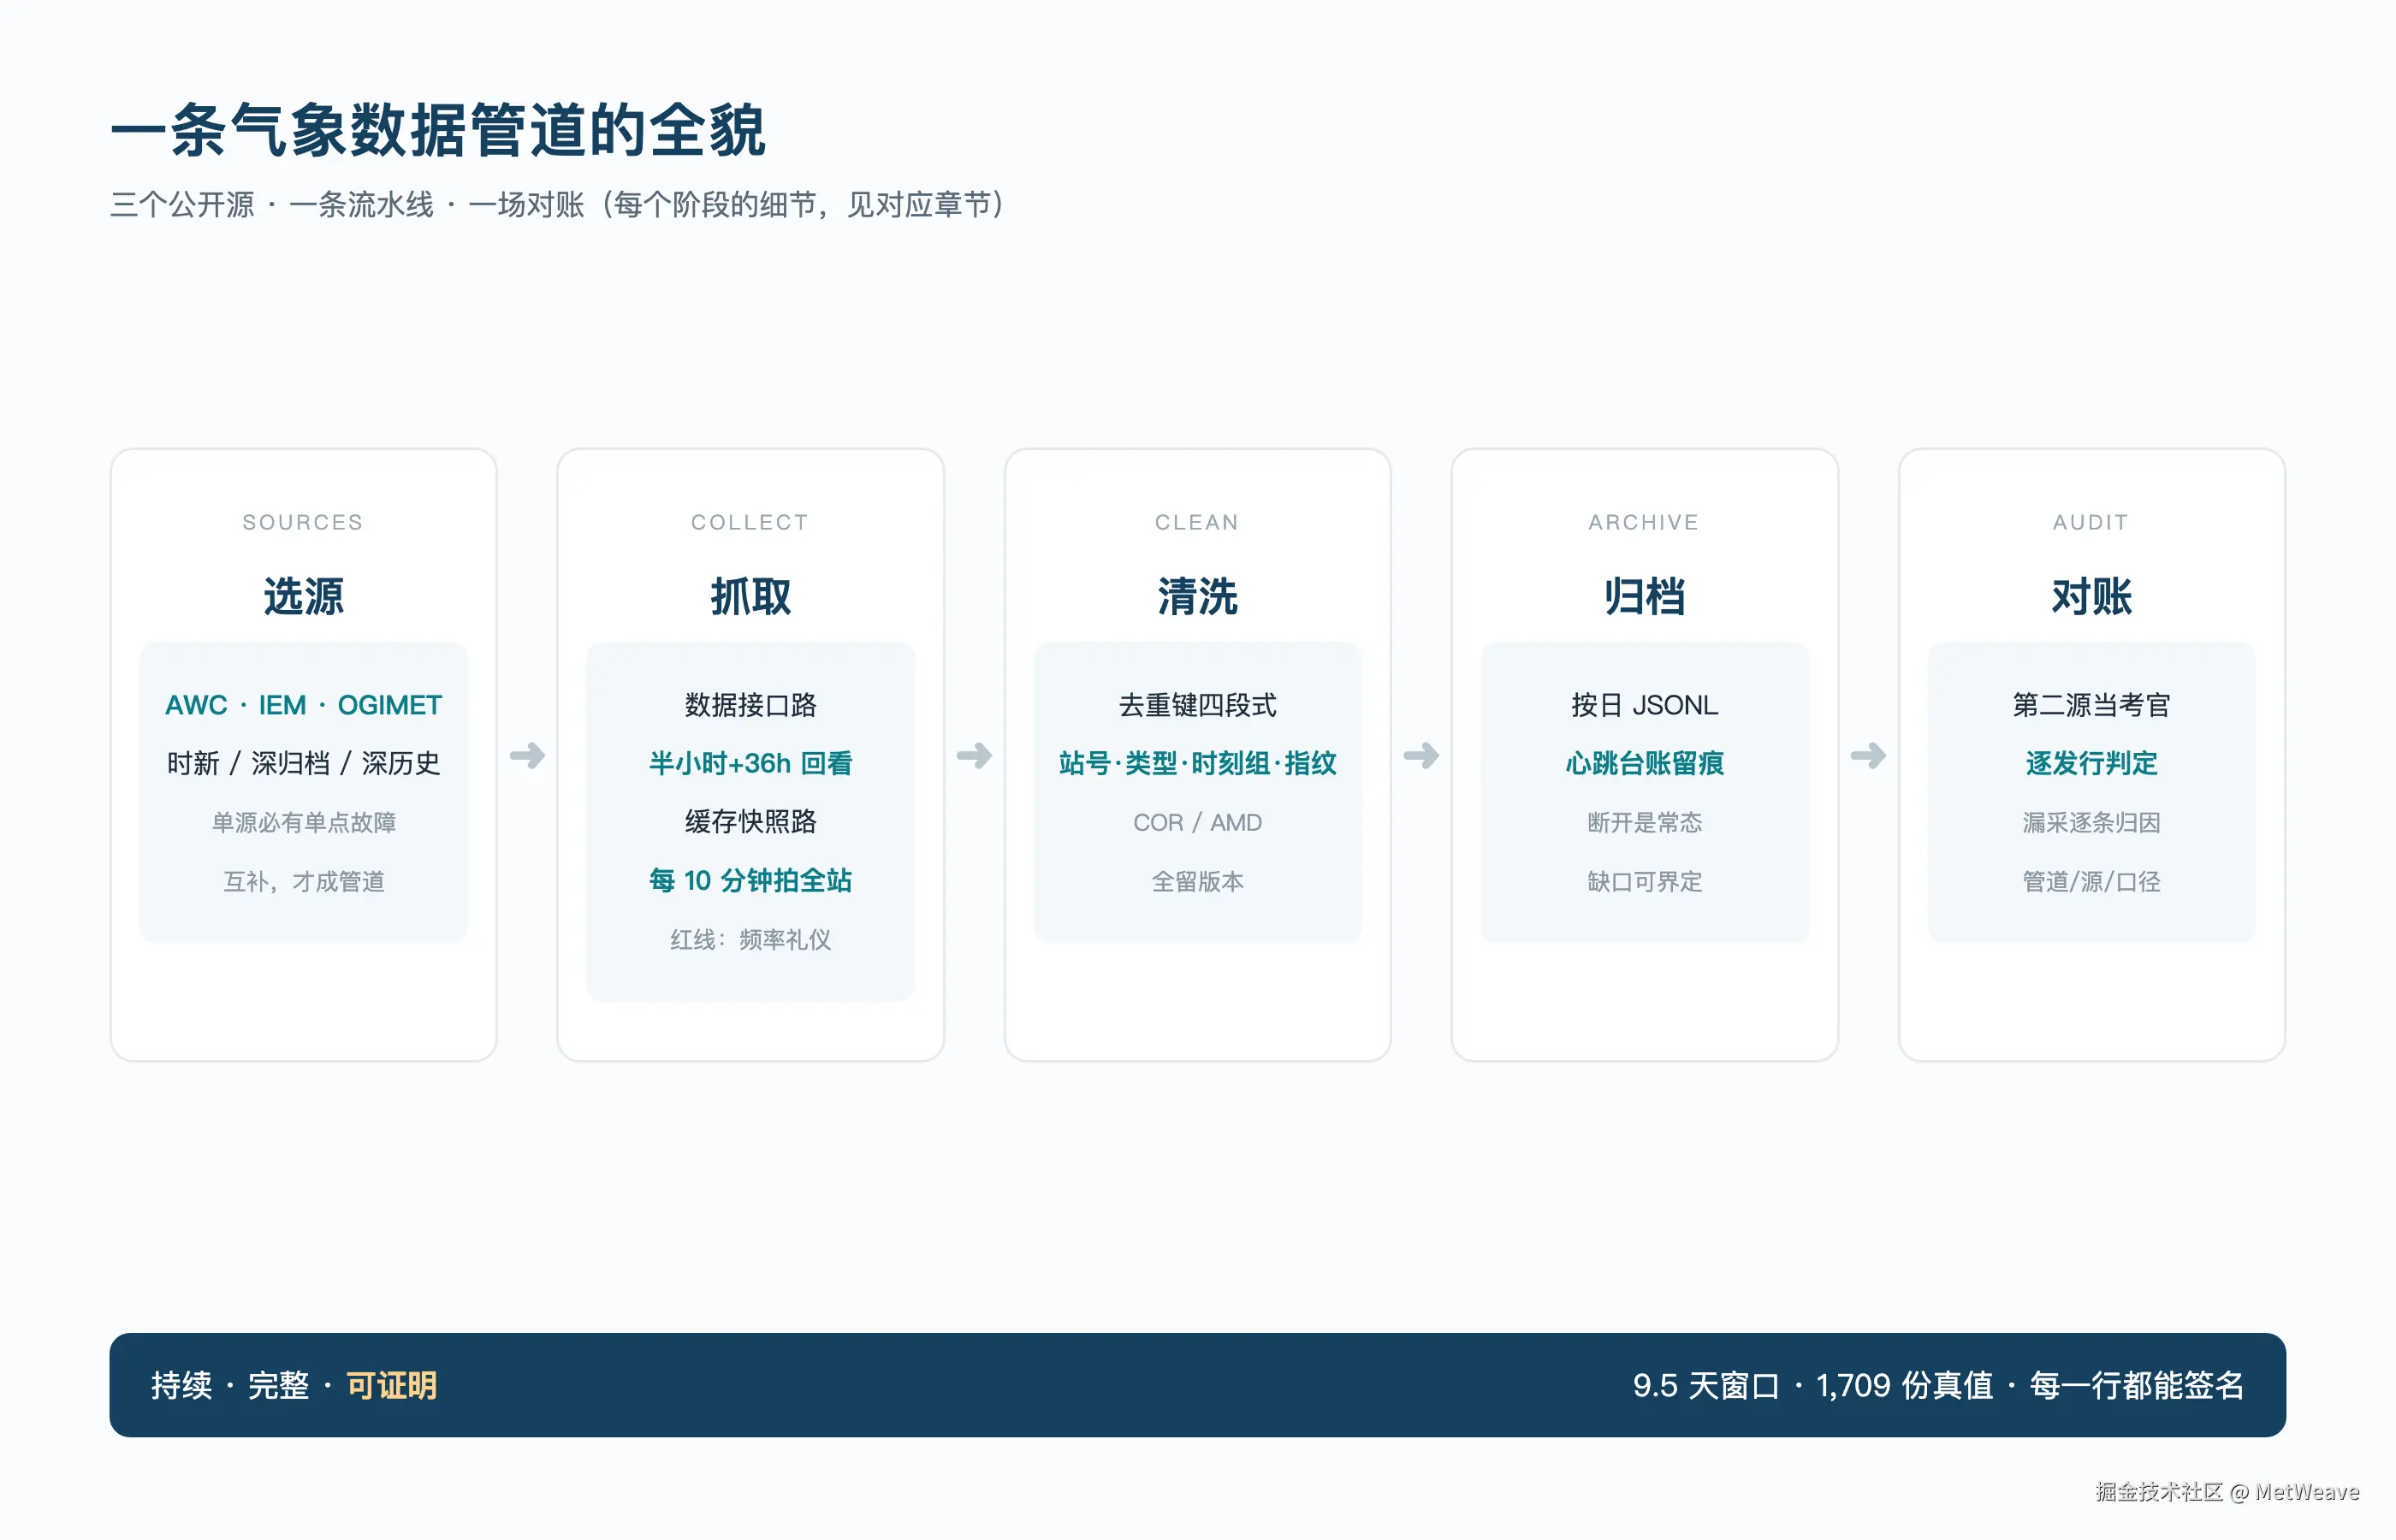
一、三个公开源,为什么非要三个
先花十秒认识三位主角(后面不再重复):METAR 是机场例行发的实况观测报文;SPECI 是例行之间天气达到或通过规定阈值时加发的观测;TAF 是机场预报,一份管着未来一整天。
航空气象数据在公开网络上至少有三个靠谱来源,脾气各不相同:
| 源 | 是什么 | 强项 | 短板 |
|---|---|---|---|
| AWC(美国航空天气中心,NOAA 旗下) | 美国官方发布面,全球 5,000 余机场的观测与预报报文 | 分钟级时新;缓存文件一次拉全球 | 历史只有 30 天;预报无回看 |
| IEM(爱荷华州立大学环境 mesonet,州立大学跑的观测网数据服务) | 学术维护的历史归档 + 实时面 | 深归档(北京站 1975 年起连续) | 中国 TAF 无归档 |
| OGIMET(西班牙个人维护的 GTS(全球电信系统)归档) | 全球报文历史库 | 中国 TAF 深历史(2006 年起)无替代 | 50 秒一次的节奏红线;个人服务,自带"不得用于关键任务,仅供参考"的免责 |
为什么非要三个?因为单源必有单点故障,而且短板恰好互补:AWC 管时新,IEM 管深历史,OGIMET 补上中国 TAF 那块谁都缺的拼图。管道的第一课不是写代码,是选源------选错了,后面全白搭。
条款也交代清楚(出处都是各家官方页面,白纸黑字):AWC 这边是 NOAA/NWS 条款------数据属公有领域,任何合法目的下商用、再分发明文允许,代价是三条红线:不能据为己有、不能暗示官方背书、不能改完冒充官方;NWS 的名称和标识受商标保护,做产品别蹭。IEM 同属公有领域,署名致谢是礼节(一行字的事)。OGIMET 情况最微妙:它没有一份集中的许可明文------无明文商用禁令,也无明文授权。我的走法是保守的:用它,免责口径随数据带走;商用要动它,先把授权信发出去。
二、抓取(上):选对通道,事半功倍
选完源,第一道坎是通道。同一个 AWC,给 TAF 预备了两条路,我在这上面栽过一次跟头,讲给你听。
路一:逐站 API 。问它"ZBAA 的最新 TAF",它只给你当前生效的那一份------没有历史参数,昨天发过什么、今天修订过什么,一概不记得。这种只留最新一份的模式,行话叫 latest-only。我最初用这条路日访一次,对账一算,捕获率只有 25% 上下:大部分发行在我两次到访之间就发出去又过期了。
路二:缓存文件 。AWC 还提供 tafs.cache.xml.gz------每 10 分钟全量重刷一次,一个请求打包全球约三千份 TAF ,压缩后约 320KB;METAR 侧同款,metars.cache.csv.gz 每分钟更新,5,000 余份打包 250KB 上下。你要做的只是定期来拍一张快照,把每份报文的"一生"拍成连续剧。
一条命令,你现在就可以试:
bash
curl -s https://aviationweather.gov/data/cache/metars.cache.csv.gz | gunzip | head -2我写下这段时跑了一遍,第一行数据恰好就是条 SPECI(圣保罗机场,SPECI SBSP 170810Z AUTO ...,组级片段)。顺手教你读报文钟:170810Z 就是 17 日 08:10 UTC------UTC 是全世界对表用的标准时间,报文末尾的 Z 就是它的标记。全球此刻 5,000 多份在架报文里有 174 条 SPECI,这种"活报文"正是缓存通道的价值:它替你把全世界盯住了。
TAF 翻案的完整故事线是这样的:9 月我判定"放弃 AW(航空天气)TAF 采集"(因为 latest-only 捕获率太低),10 月发现缓存通道后推翻重来------同样的数据、同样的源,换个通道,捕获率从 25% 到几乎 100%。你以后遇到"这源不行"的结论,先别急着信自己,换条通道再试一次。
三、抓取(中):节奏与礼仪
通道选对,接下来定节奏。先看报文的"班表":METAR 例行观测以逐小时一发为基准 ,繁忙机场加密到半点,具体到每个机场的发报分钟位还得逐站学。TAF 的例行班次对应世界时 00/06/12/18 起算的四档有效期,但各站都提前发行------中国站实测约提前三小时、集中在 03/09/15/21 时前后,分钟位逐站各异;蒙古站班次另有时位,朝鲜站一天只有两班。外加不定期插队的修订版(AMD),恶劣天气密发的站日一天能冲到 7--10 份。SPECI 是阈值触发------例行之间天气通过规定阈值就发,转坏转好都发------发完存活到该站下一份例行或特殊报为止,典型半小时到一小时,赶得不巧,短到几分钟。
实践中常见两种配置。走数据接口的,每半小时一轮、带 36 小时回看窗,抓漏了能回头补------这是它的先天优势。而本文想教你想明白的,是另一条路的账:假如你走第二节例文那条缓存快照路(每 10 分钟或 30 分钟拍一张全站快照),节奏怎么定?先看寿命:TAF 一份例行版作为"最新份"在架上只活约 6 小时(有效期另有 24--30 小时),只要它进了缓存,10 分钟一轮就必然被拍到。例外有两种:压根没进缓存的------这是源的账,第七节真让你见到一例;快照间隔内连发两版互相覆盖的------极罕见,第五节有个现成案例,好在两版只差三分钟,容差把它兜住了。至于同一份内容两版连发、两边记下的份数对不上------第七节还有两例。
SPECI 的账更细,也最容易被想当然。缓存是每站只留最新一份的,所以一条 SPECI 的生死就看它能不能撑到你下一次快照。半小时一轮下,相当一部分短命 SPECI 会直接错过;10 分钟能把漏网压到"寿命极短的边角"------注意是收窄 ,不是堵死:恰好在例行报前一分钟出生的短命 SPECI,什么节奏都难保。这笔账没有对账数字撑腰,属于理论推演,写在这里是提醒你每换一种报文都要重算一遍。给你个体感:全球瞬时在架 174 条 SPECI(成稿时刻实测),而北京站约一天半才有一条------稀少的东西,漏一条就是肉眼可见的缺口。
对源头的礼仪也得讲(NWS 官方规则,白纸黑字):自定义 User-Agent 并附联系方式、按数据的更新频率取数、正确处理错误码。我的整条管线跑下来,请求量占 AWC 限流(100 次/分)不到千分之二------高频和礼貌从来不冲突,冲突的是无脑裸拉。
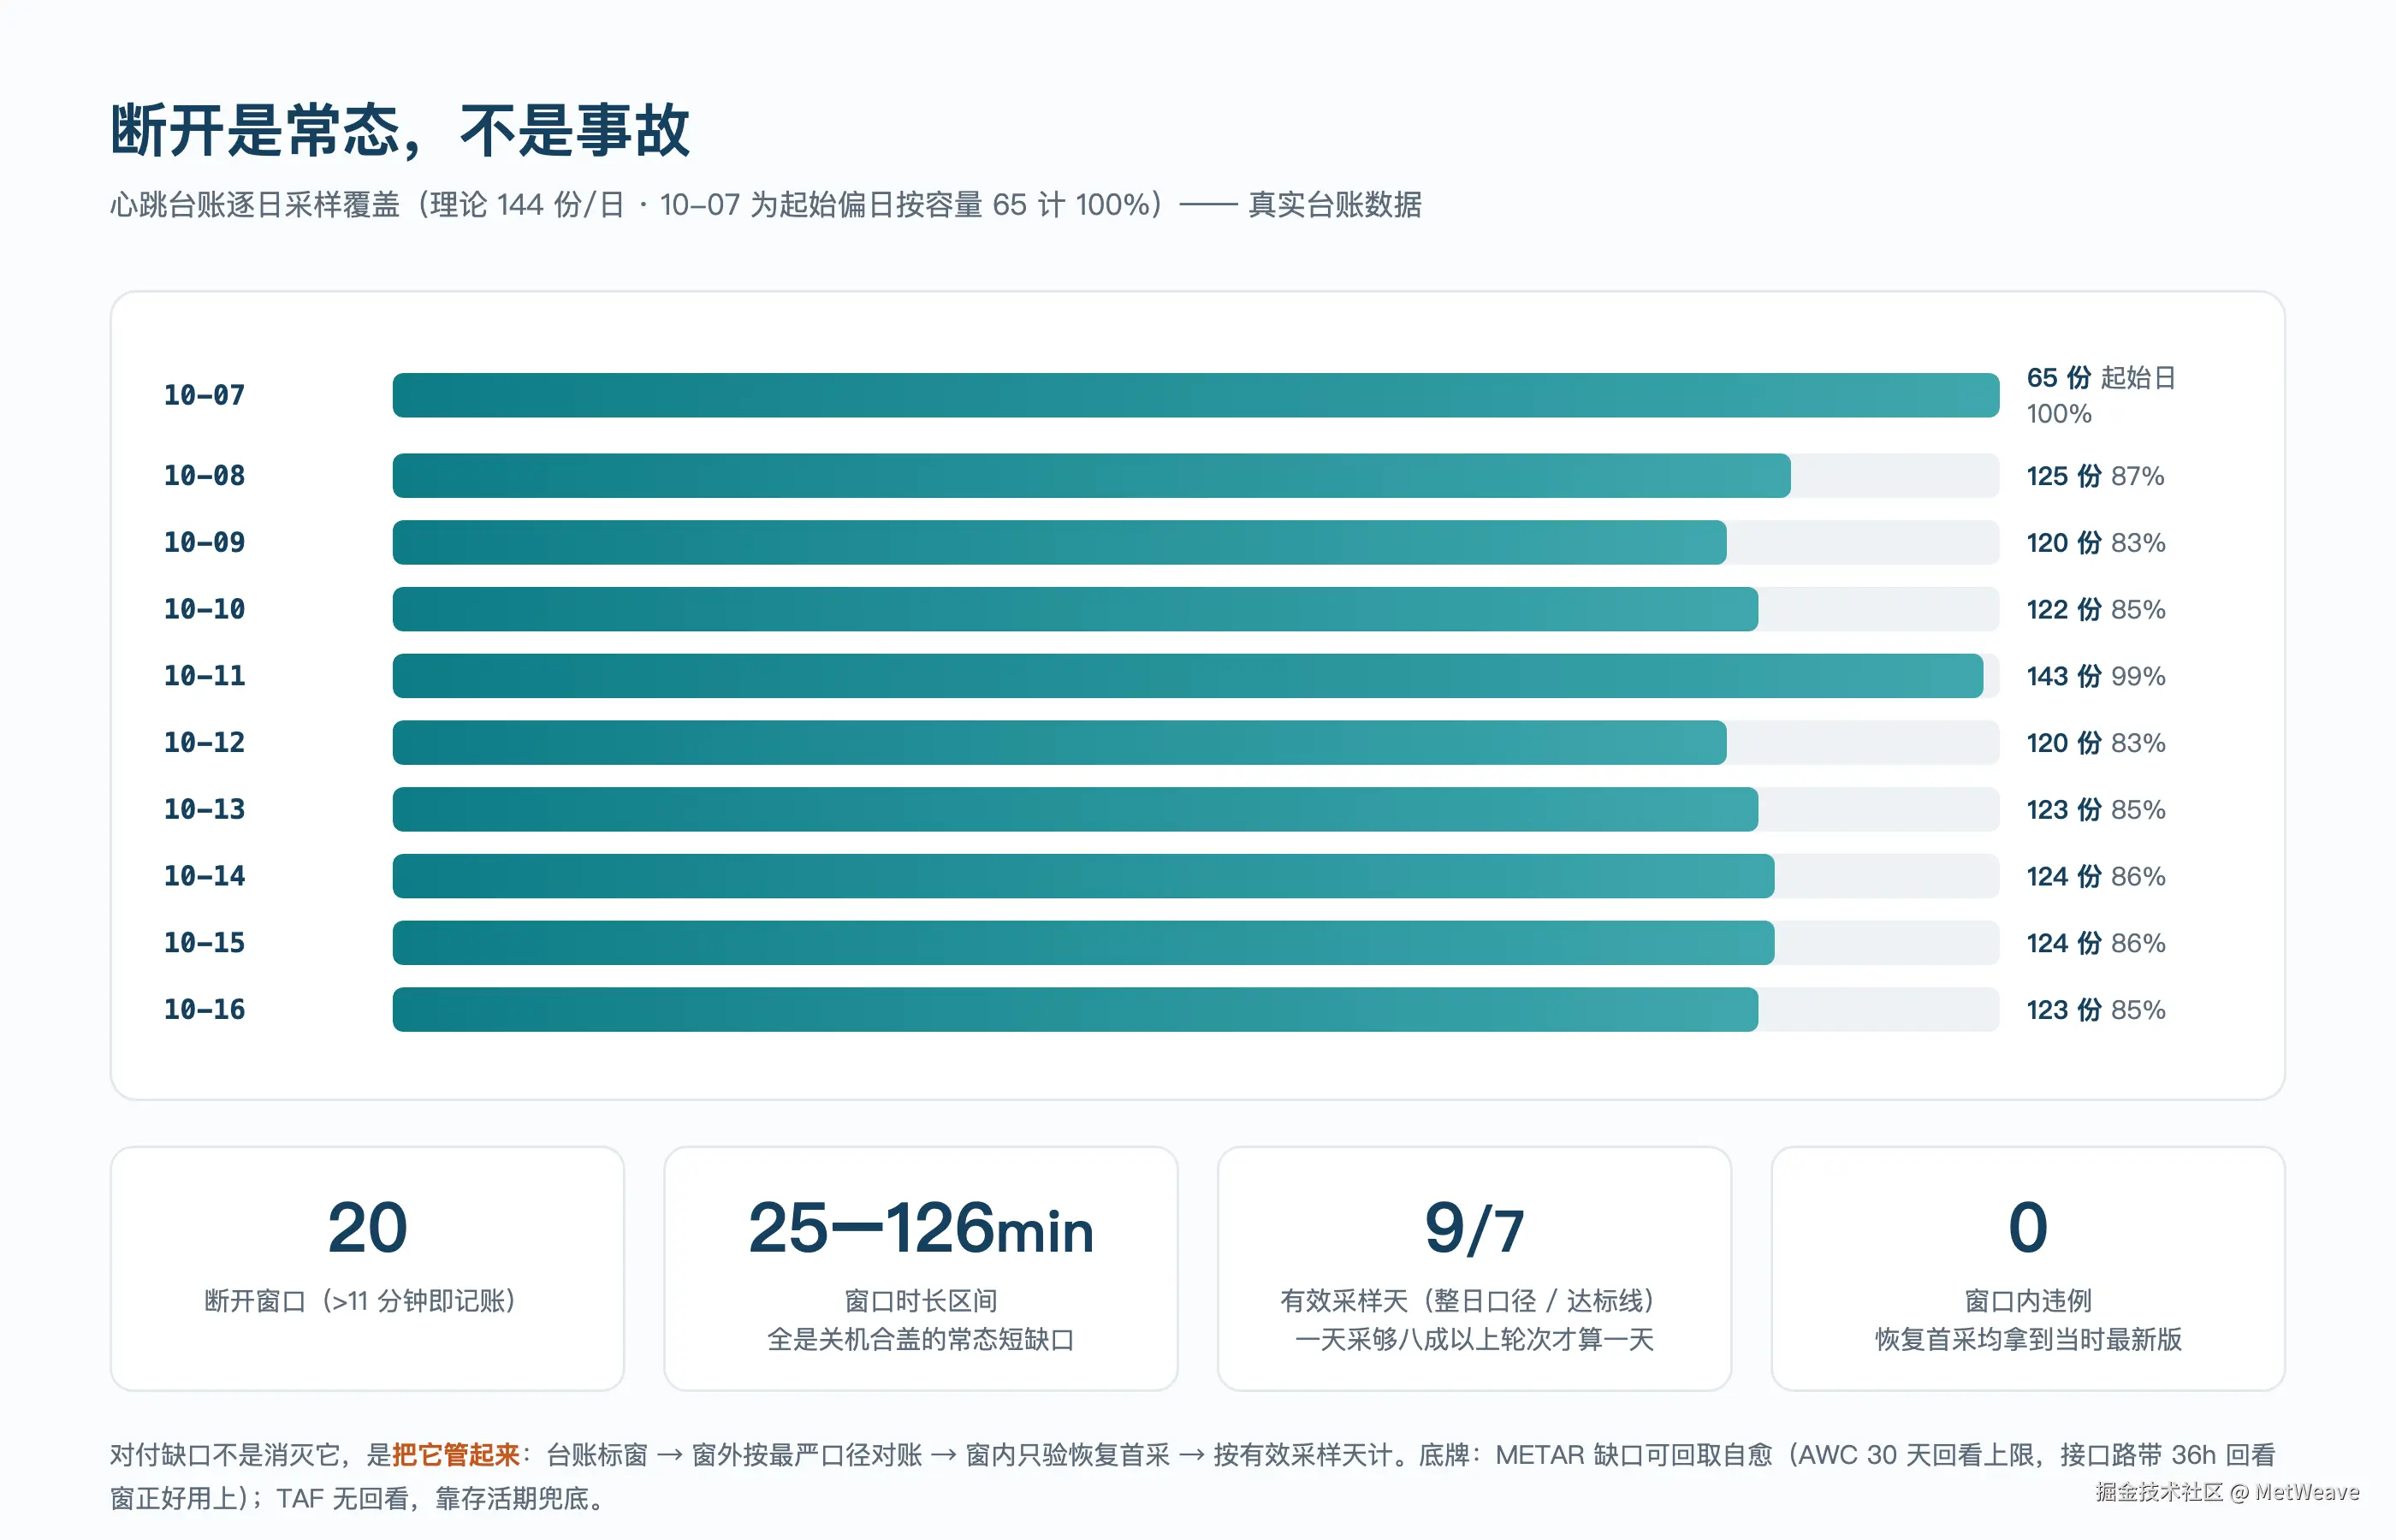
最后一条,也是个人跑管道最重要的心态:断开是常态,不是事故。合盖、断网、重启,缺口一定会出现。9.5 天对账窗里,我的心跳台账(每轮拉取记一笔成败,没成的那轮就在账上留个缺口)记下了 20 个断开窗口,25 到 126 分钟不等,全是关机合盖的常态短缺口。缺口怎么管?四步:台账标出每个窗口;窗口外发生的发行按最严口径对账------先当它丢了,再想办法洗清;窗口内只验一件事------恢复后第一次采样有没有拿到当时最新版;整个观察窗按有效采样天计(一天采够八成以上轮次才算一天)。管不住的怎么办?看清底牌:METAR 面的缺口可以事后回取自愈(AWC 在线库 30 天回看上限,36 小时回看窗就是为这个准备的),TAF 面没有回看、全靠存活期兜底------断口里恰好连发两版就真丢了。这也是为什么 TAF 采样迟早要搬到不关机的宿主上。规矩立到这里,你就再也不用为"今天电脑关了俩小时"瞎焦虑了------焦虑之前,先对账。
四、抓取(下):难缠的源
三个源里,OGIMET 最有个性,单独一节------它身上埋的每个坑,都是"读文档读不出来"的实战经验。
坑一:钥匙不止一把。 直接请求它的查询接口,会拿到缩水的残缺结果。我一度误判"OGIMET 没有这数据",后来才发现门锁是三重的:先访问一次主页取会话 cookie,查询时还得带上浏览器 User-Agent 和 Referer(来源页标记),缺一个都被拒之门外:
python
import http.cookiejar, urllib.request, urllib.parse


jar = http.cookiejar.CookieJar()

opener = urllib.request.build_opener(urllib.request.HTTPCookieProcessor(jar))

opener.open("https://www.ogimet.com/metars.phtml.en") # 第一把钥匙:会话


query = urllib.parse.urlencode({ # 平壤顺安机场(ZKPY)的 TAF

"lang": "en", "lugar": "ZKPY", "tipo": "FT", "fmt": "txt",

"ord": "DIR", "nil": "SI", "nohtmlo": "yes", "annot": "yes", "leng": "0",

"ano": 2026, "mes": "10", "day": "14", "hora": "00", "min": "00",

"anof": 2026, "mesf": "10", "dayf": "17", "horaf": "00", "minf": "00",

"send": "send"})

url = "https://www.ogimet.com/display_metars2.php?" + query

req = urllib.request.Request(url, headers={ # 第二、三把:UA + Referer

"User-Agent": "Mozilla/5.0", "Referer": "https://www.ogimet.com/metars.phtml.en"})

body = opener.open(req, timeout=60).read().decode()

print(len([l for l in body.splitlines() if l and l[0].isdigit()]), "rows")
这段你能直接跑。tipo=FT 是它家"报 TAF"的写法------tipo 是西语"类型",ano(年)也是;少一个字母、缺一个参数,它不报错,只给你空结果。末行打印的就是抓到的 TAF 条数。我成稿时实测过这组对照:同一个会话,不带浏览器 UA 和 Referer------1,672 字节、0 行数据;三件套齐了------3,647 字节、6 行 TAF。一对照就现形。这个查询窗的归档至今还在回填,你跑到的行数只会比我多------数字对不上不是你错了,是历史还在长。
坑二:节奏红线。 每次查询间隔的红线记 50 秒------再急就是无响应式拒绝:不带任何错误说明,直接把连接掐掉。我回填真值那阵跑 55 秒留余量;现在跑日更增量,一查从发起到跑完约两分钟。早期我以为它还有每日约 60 次的配额,后来单日跑了 596 次查询零被拒------真正约束从来是节奏红线和运行时长,不是想象中的配额。"先按它的规矩来,规矩比你想的松"和"不按规矩来,比你想的狠"在这家源身上同时成立。
坑三:横幅页障眼法。 两轮对账里都遇到过:返回内容带着 HTML 头,脚本按规则判为残缺响应丢弃------人工打开一看,横幅页正文里躺着完整的 TAF 数据 。两次都靠人工复核捞了回来。这条经验我立成了规矩:判定"源没有数据"之前,先排除"你没按它的规矩来"------会话、节奏、响应形态,挨个查完再下结论。
顺带交代管线的另一条 OGIMET 通道:日切(UTC 零点翻日)之后,它会把"昨天一整天"的窗补拉进本地归档------它是这条管道的历史位,第八节算时新性账时会再碰到它。
五、清洗:去重键与版本保留
数据抓回来了,第一件事是去重------一轮轮快照拍下来,同一份报文会被拍到一次又一次,得认出"这是同一份"。
我的去重键是四段式:站号 + 报文类型 + 时刻组 + 原文指纹 。站号不说了;类型必须进键------METAR、SPECI、TAF 是三种东西,混在一张桌上会互相顶掉;时刻组识别"这是哪一次"------注意 METAR/SPECI 报文里的是观测时刻 ,TAF 头上才是发行时刻,统称时刻组;原文指纹是把整段原文压成一个短短的记号(术语叫哈希),原文改一个字、记号就完全变样,所以能认出"是不是同一份"。
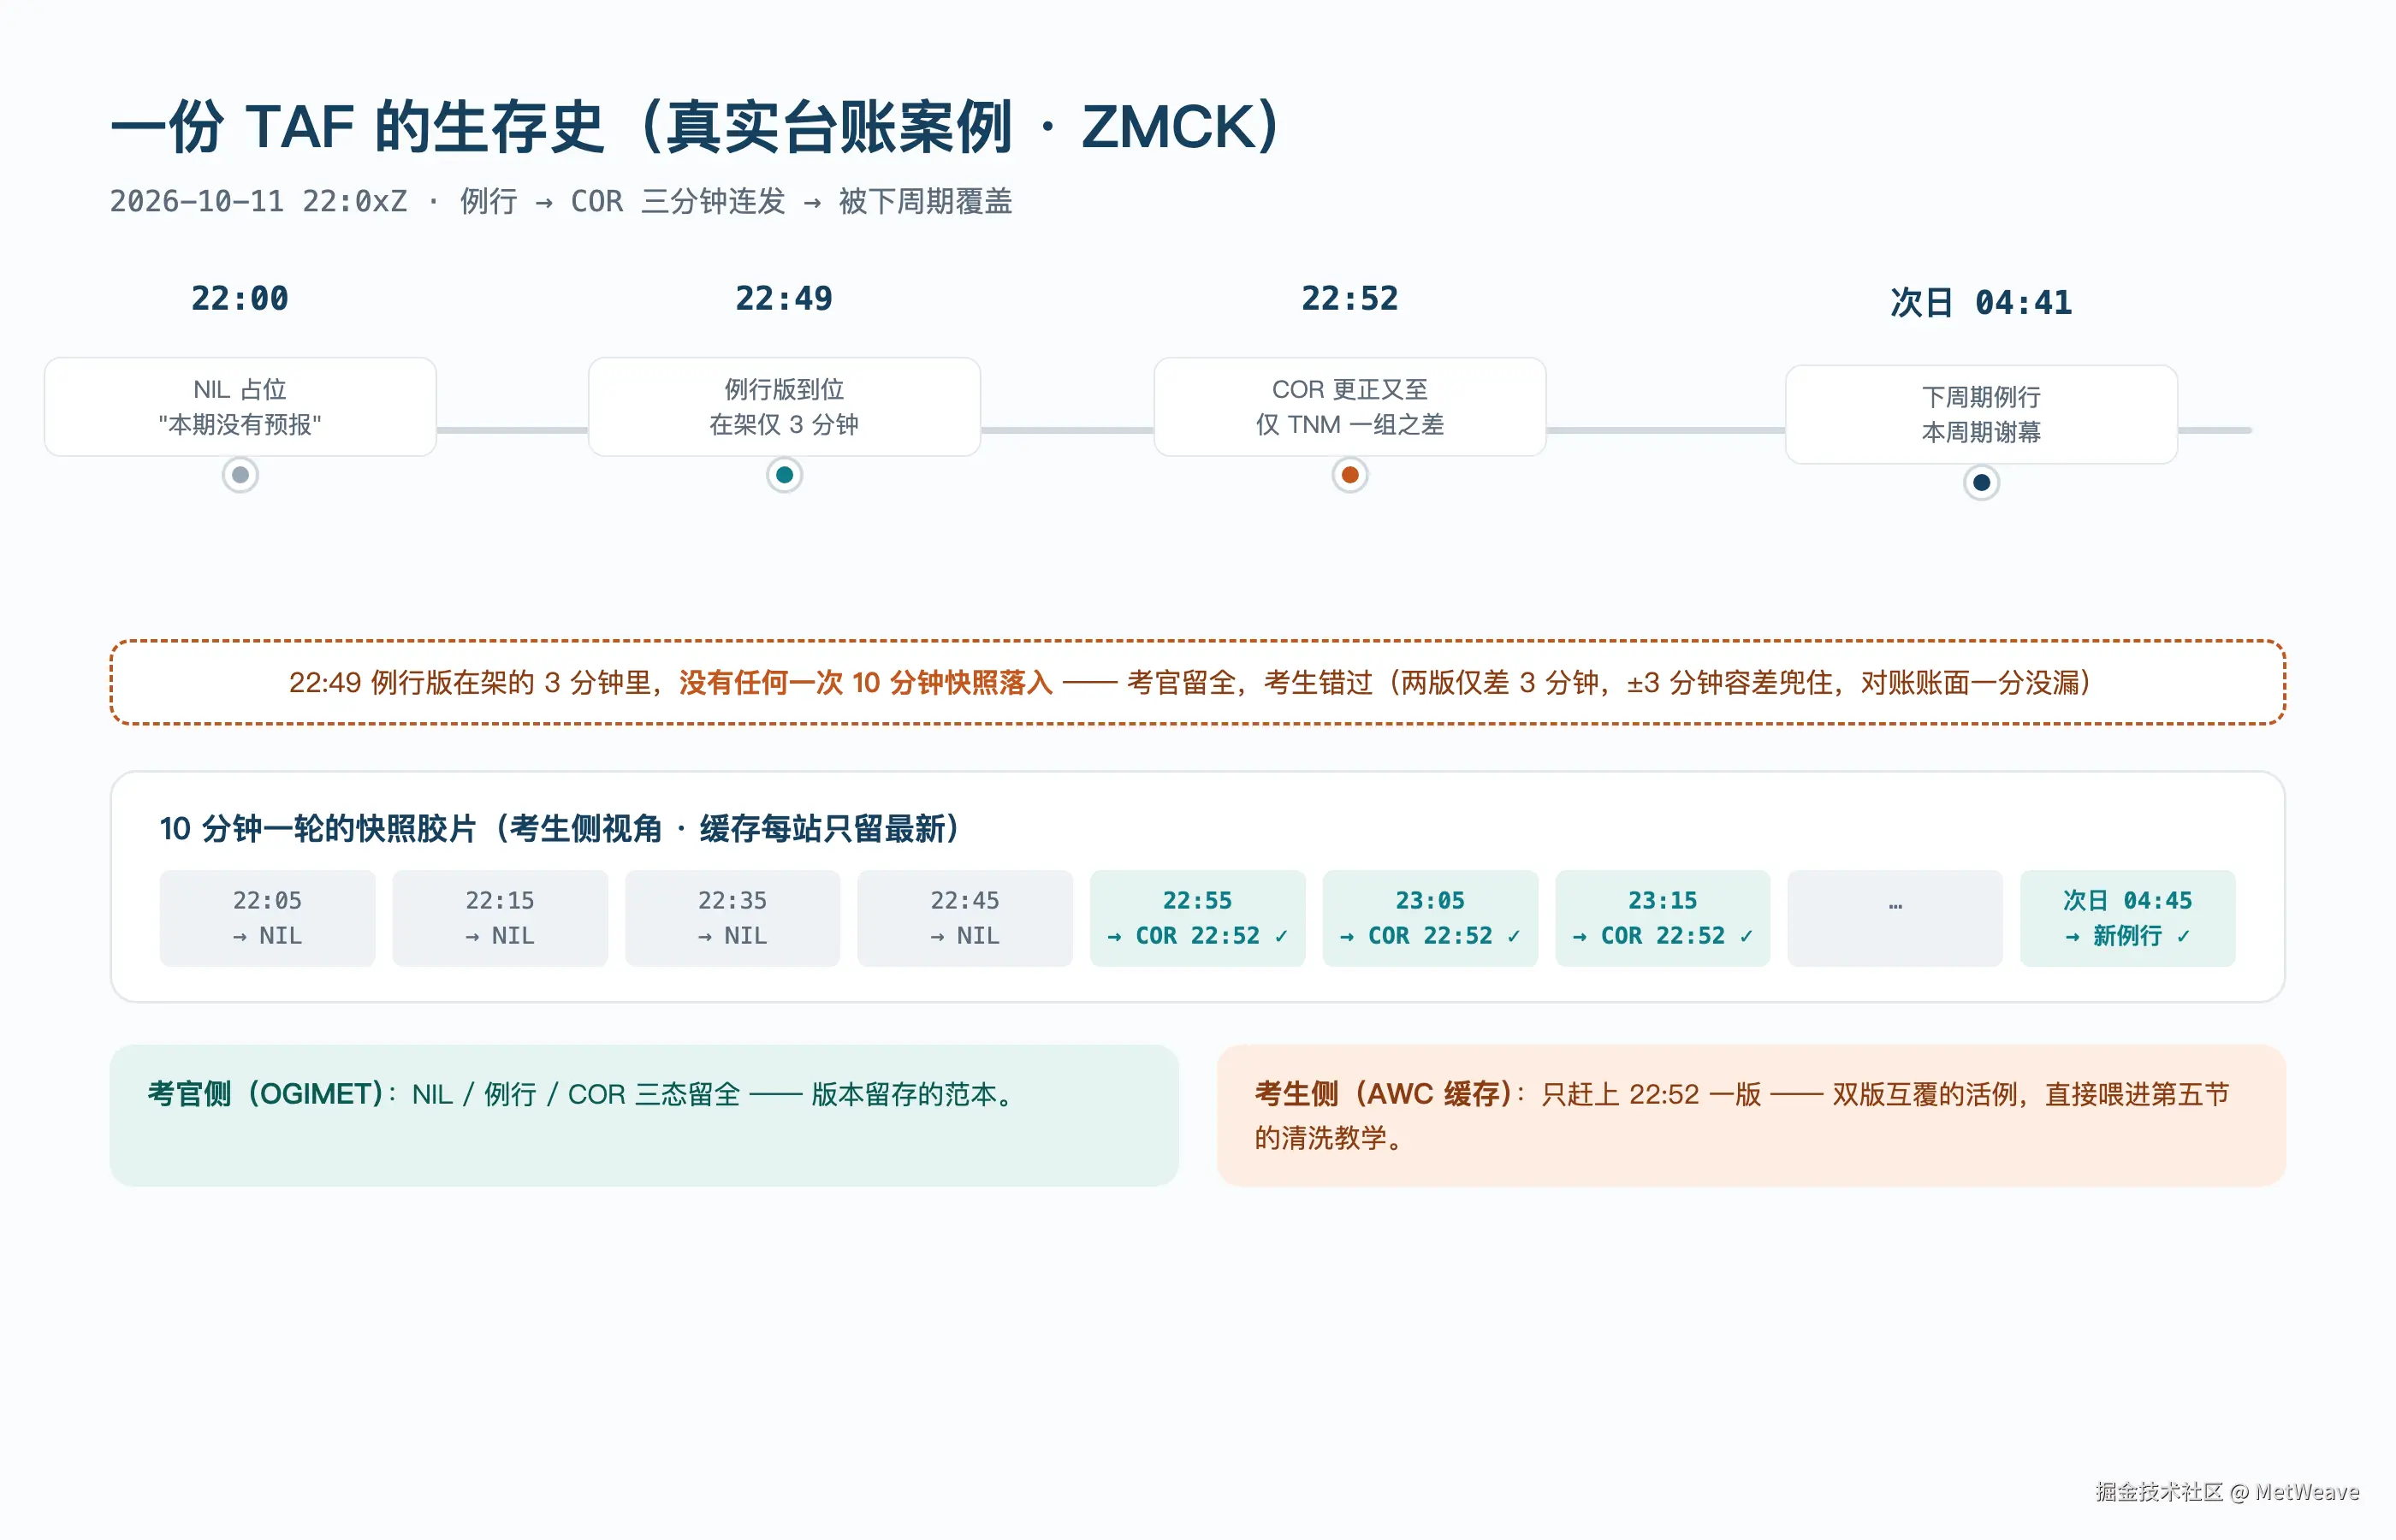
真正有意思的是指纹的另一面。两种情况要分清:AMD(修订) 带着新的发行时刻,自成一条新记录;COR(更正) 有的沿用原时刻组------键完全相同、指纹不同,有的则自带新时刻组、自成新记录。无论哪种,都得留。我台账里的真例比教科书给的例子还全:ZMCK 站某天夜里 22:00 一份 NIL 占位("本期没有预报"),22:49 例行版到位,22:52 COR 更正又至------三态连发,例行版到更正只隔三分钟。考官那边的台账把三态留全;我这边只赶上 22:52 的 COR 一版------22:49 的例行版三分钟后就被更正版顶掉,快照没赶上,这正是第三节说的"快照间隔内连发两版互相覆盖"的活例。好在两版只差三分钟,±3 分钟容差恰好把它兜住,对账账面一分没漏。报文是有生命史的:例行版发布、AMD 插队修订、COR 事后更正、下个周期覆盖------管道的任务是保住这条时间线,而不是只要最新一帧。
示例一下这个思路(Python 标准库就够,全球缓存半秒跑完):
python
import gzip, re, hashlib, urllib.request


req = urllib.request.Request(

"https://aviationweather.gov/data/cache/tafs.cache.xml.gz",

headers={"User-Agent": "demo/0.1 (contact: you@example.com)"}) # 联系方式换成你自己的

body = gzip.decompress(urllib.request.urlopen(req, timeout=60).read()).decode()

if not body:

raise SystemExit("拿到空响应------先别判『源没数据』,重试并按第四节查自己的请求")


pat = re.compile(r'<raw_text><!\[CDATA\[(.*?)\]\]></raw_text>'

r'\s*<station_id>(Z[A-Z]{3})</station_id>' # Z 字头:国际交换域(中国及蒙古、朝鲜)

r'.*?<issue_time>([^<]+)</issue_time>', re.S)

seen = {}

for chunk in body.split("<TAF>")[1:]: # 先切块再匹配,原因见下

m = pat.search(chunk[:3000])

if m:

raw, st, it = m.group(1).strip(), m.group(2), m.group(3)

key = (st, it, hashlib.md5(raw.encode()).hexdigest()[:8]) # TAF 专用:类型恒定故省

seen.setdefault(key, raw.splitlines()[0][:50])


print(f"Z 域在架发行 {len(seen)} 份") # 你跑出来的数和我不同是正常的------缓存每一刻都在变
这段我成稿时跑了一遍:全球约 2,900 个 TAF 块,Z 域(我盯的 45 站清单:中国 40 加蒙古、朝鲜)命中 44 份在架发行,AMD 原文完好。这段例文里埋着我真实踩过的一个坑,送你避雷:正则的坑从来是两个叠加的 。我第一版把发行时刻写成"纯数字",可它是 2026-10-17T14:03:00.000Z 这种 ISO 格式------格式想当然,匹配就永远差半步;更糟的是当时还在整段 XML 上裸跑 findall,几千个不匹配的块让引擎一层层退回去重试,5MB 数据直接卡到分钟级。把格式改对、又坚持在全文上找,还会踩另一脚:跨记录拼接出根本不存在的"报文"。所以规矩是先按 <TAF> 切块、每块只搜前 3KB------语义和耗时都有界,半秒跑完。正则,你可以把它当成"按格式挑内容的筛子":筛网太贪心、筛眼太天真,都会让你一无所获还以为是数据的问题。
六、对账:怎么证明管道没丢数据
管道跑起来了,用户(包括未来的你自己)迟早会问一句:**凭什么信它没丢数据?**抓得多不叫完整,"我能证明每一份都在"才叫。这就是对账------本篇最想交给你的方法。
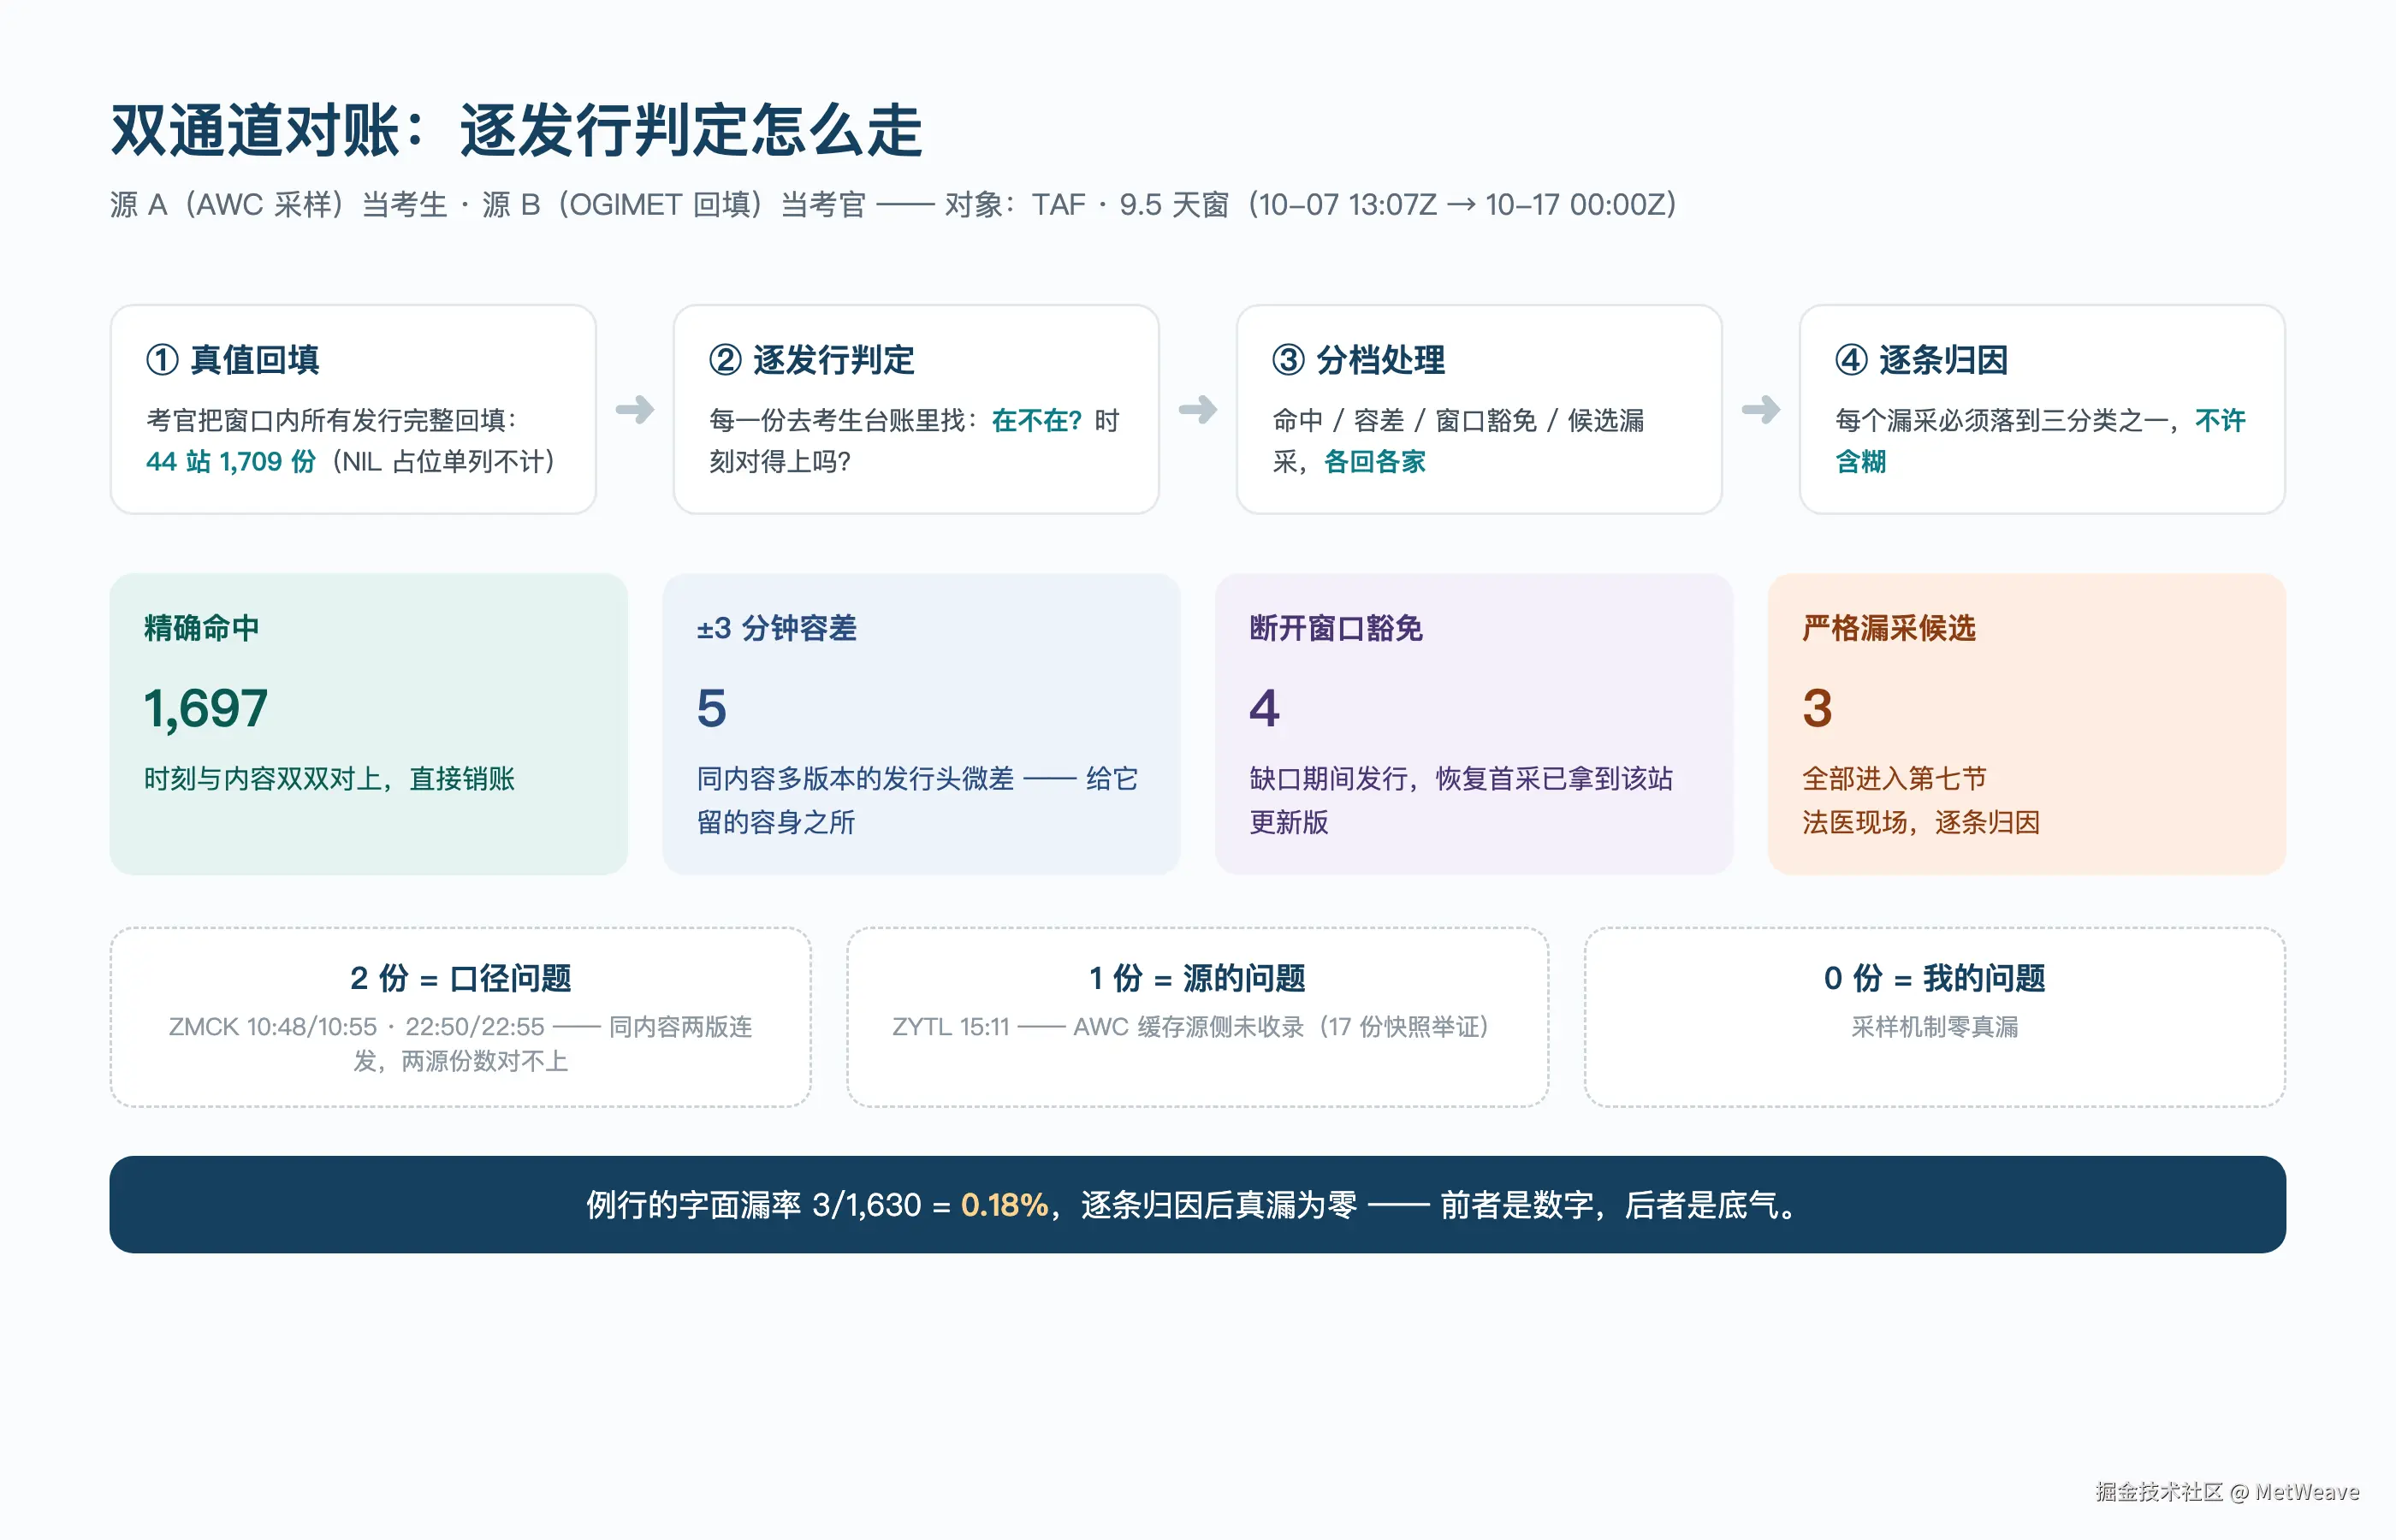
设计很简单:考生和考官分开。这次考试的对象是 TAF:我采样侧的 AWC 当考生,OGIMET 当考官------同一个时间窗,让考官把窗内所有发行完整回填一遍,然后逐发行判定:考生的台账里有没有它?对不上的,再分档处理------落在断开窗口内的,只要求"恢复后首次采样拿到了当时最新版";时刻对不上但差几分钟的,用 ±3 分钟容差给"同一份内容的多版本微差"留个容身之所;剩下的,才是真正的漏采候选。一句诚实的限定:考官的"独立"指采集路不同------它归根到底也转引自 NOAA 的数据,源头独立性是做不到的,能验的是"两条采集路互为盲审"。
然后是真枪实弹。窗口设计 10 个日历天,对账取其中 9.5 天(10-07 起跑到 10-17 零点),45 个站(Z 字头国际交换域:中国 40 站,加蒙古、朝鲜等邻区站)。考官回填出 1,709 份真值(例行 1,630 + AMD 修订 78 + COR 更正 1),逐条对完:
-
修订完整性:AMD 0 漏(0/78)------最容易丢的修订版,一份没丢;
-
例行报:字面漏 3 份(3/1,630,0.18%)------注意"字面"两个字,下一节告诉你为什么;
-
站点覆盖:45 对 44,考生一个站不缺,还多出一个考官归档里没有的站;
-
20 个断开窗口逐窗验证:违例 0;
-
有效采样天:9 天(整日口径;含起始偏日 10 天。达标线 7 天,我自己定的)。
两轮对账跑完,这套 TAF 管线拿到的不是"看起来没丢",是9.5 天窗口内逐发行级的清白记录。这个方法不挑数据------报文、行情、日志,只要能找到第二条独立采集路当考官,你就能把自己的管道拎出来验一遍。
七、法医现场:三个"漏采"的归因
上一节那 3 份字面漏采,是全篇我最想讲的部分------每一条漏,都要归因到"管道的问题、源的问题、还是口径的问题"三者之一,不许含糊。(下面这些时刻都是 UTC,不再逐个标。)我把三份的法医报告原样摊开:
案例一:ZMCK 站,10:48 对 10:55。 考官的账上有两行:一份发行头写着 151048Z(10 时 48 分),7 分钟后又一行写着 151055Z(10 时 55 分)。先把事实摆平:漏掉一版,是真的 ------对账如实记了"字面漏采"。那它是不是管道的问题?把两版原文并排放着看:正文组几乎逐字一致(... 1512/1618 08005MPS 9999 SCT033 SCT100 TNM04/1522Z,组级片段,两版仅 TEMPO 一组的起时差一个数字),都顶着例行形态、没有修订词------这是同一份预报在链路上的两个版本 :源头先发了一版,7 分钟后又重发了一版更全的;缓存按"只留最新"的规矩收下了后者。要保护的预报信息,一字没丢;丢掉的只是中间版这个"历史标本",而且它从头到尾没进过缓存------是源的最新版策略把它覆盖的,不是采样漏的。归因就此落定:两个源对"一份发行"的记账口径 不同------考官按收录的行数计,考生按缓存版本计,多版本事件下账面天然差一。口径问题。±3 分钟容差正是为这种事件设计的,这次两版隔了 7 分钟,容差罩不住,人工归因收口。
案例二:ZMCK 站,22:50 对 22:55。 同款剧情:考官账上 22:50、22:55 两版连发,考生台账里是 22:55 那版,差了 5 分钟,出了容差。内容对上------一份例行预报,报着中雪夹雨伴吹雪(1600/1706 11008MPS 4500 SNRA BLSN ...,组级片段)。漏的同样是中间版,预报内容零损失。归因同案例一:口径问题。
案例三:ZYTL 站,15:11 的例行报,台账里根本没有。 这次多版本救不了------台账里前后几小时都没有对应内容。我把它抓了个现行:把 14:09 到 16:50 之间的 17 份连续快照 逐一翻开,该站份份在架:14:09 那份的最新版还是 09:06 的例行报,14:19 起的 11 份全是 14:06Z 发行的 AMD(报文头 141406Z),16:09 起的 5 份换成了 16:07 的又一版 AMD------考官手里的 15:11 例行报,从头到尾就没进过缓存 。结论:源的问题,AWC 漏收了这一次发行。采样管道无法捕获源里不存在的东西;而且该站后续版本我照常拿到了,实际零损失。
三份"漏采",两份口径问题、一份源的问题------管道本身:零真漏 。归因做完,你拿到的就不是一份"合格率 99.82%"的成绩单,而是一份每一行都能签名的审计记录。前者是数字,后者是底气。
八、更新节奏账:每个源都要算时新性
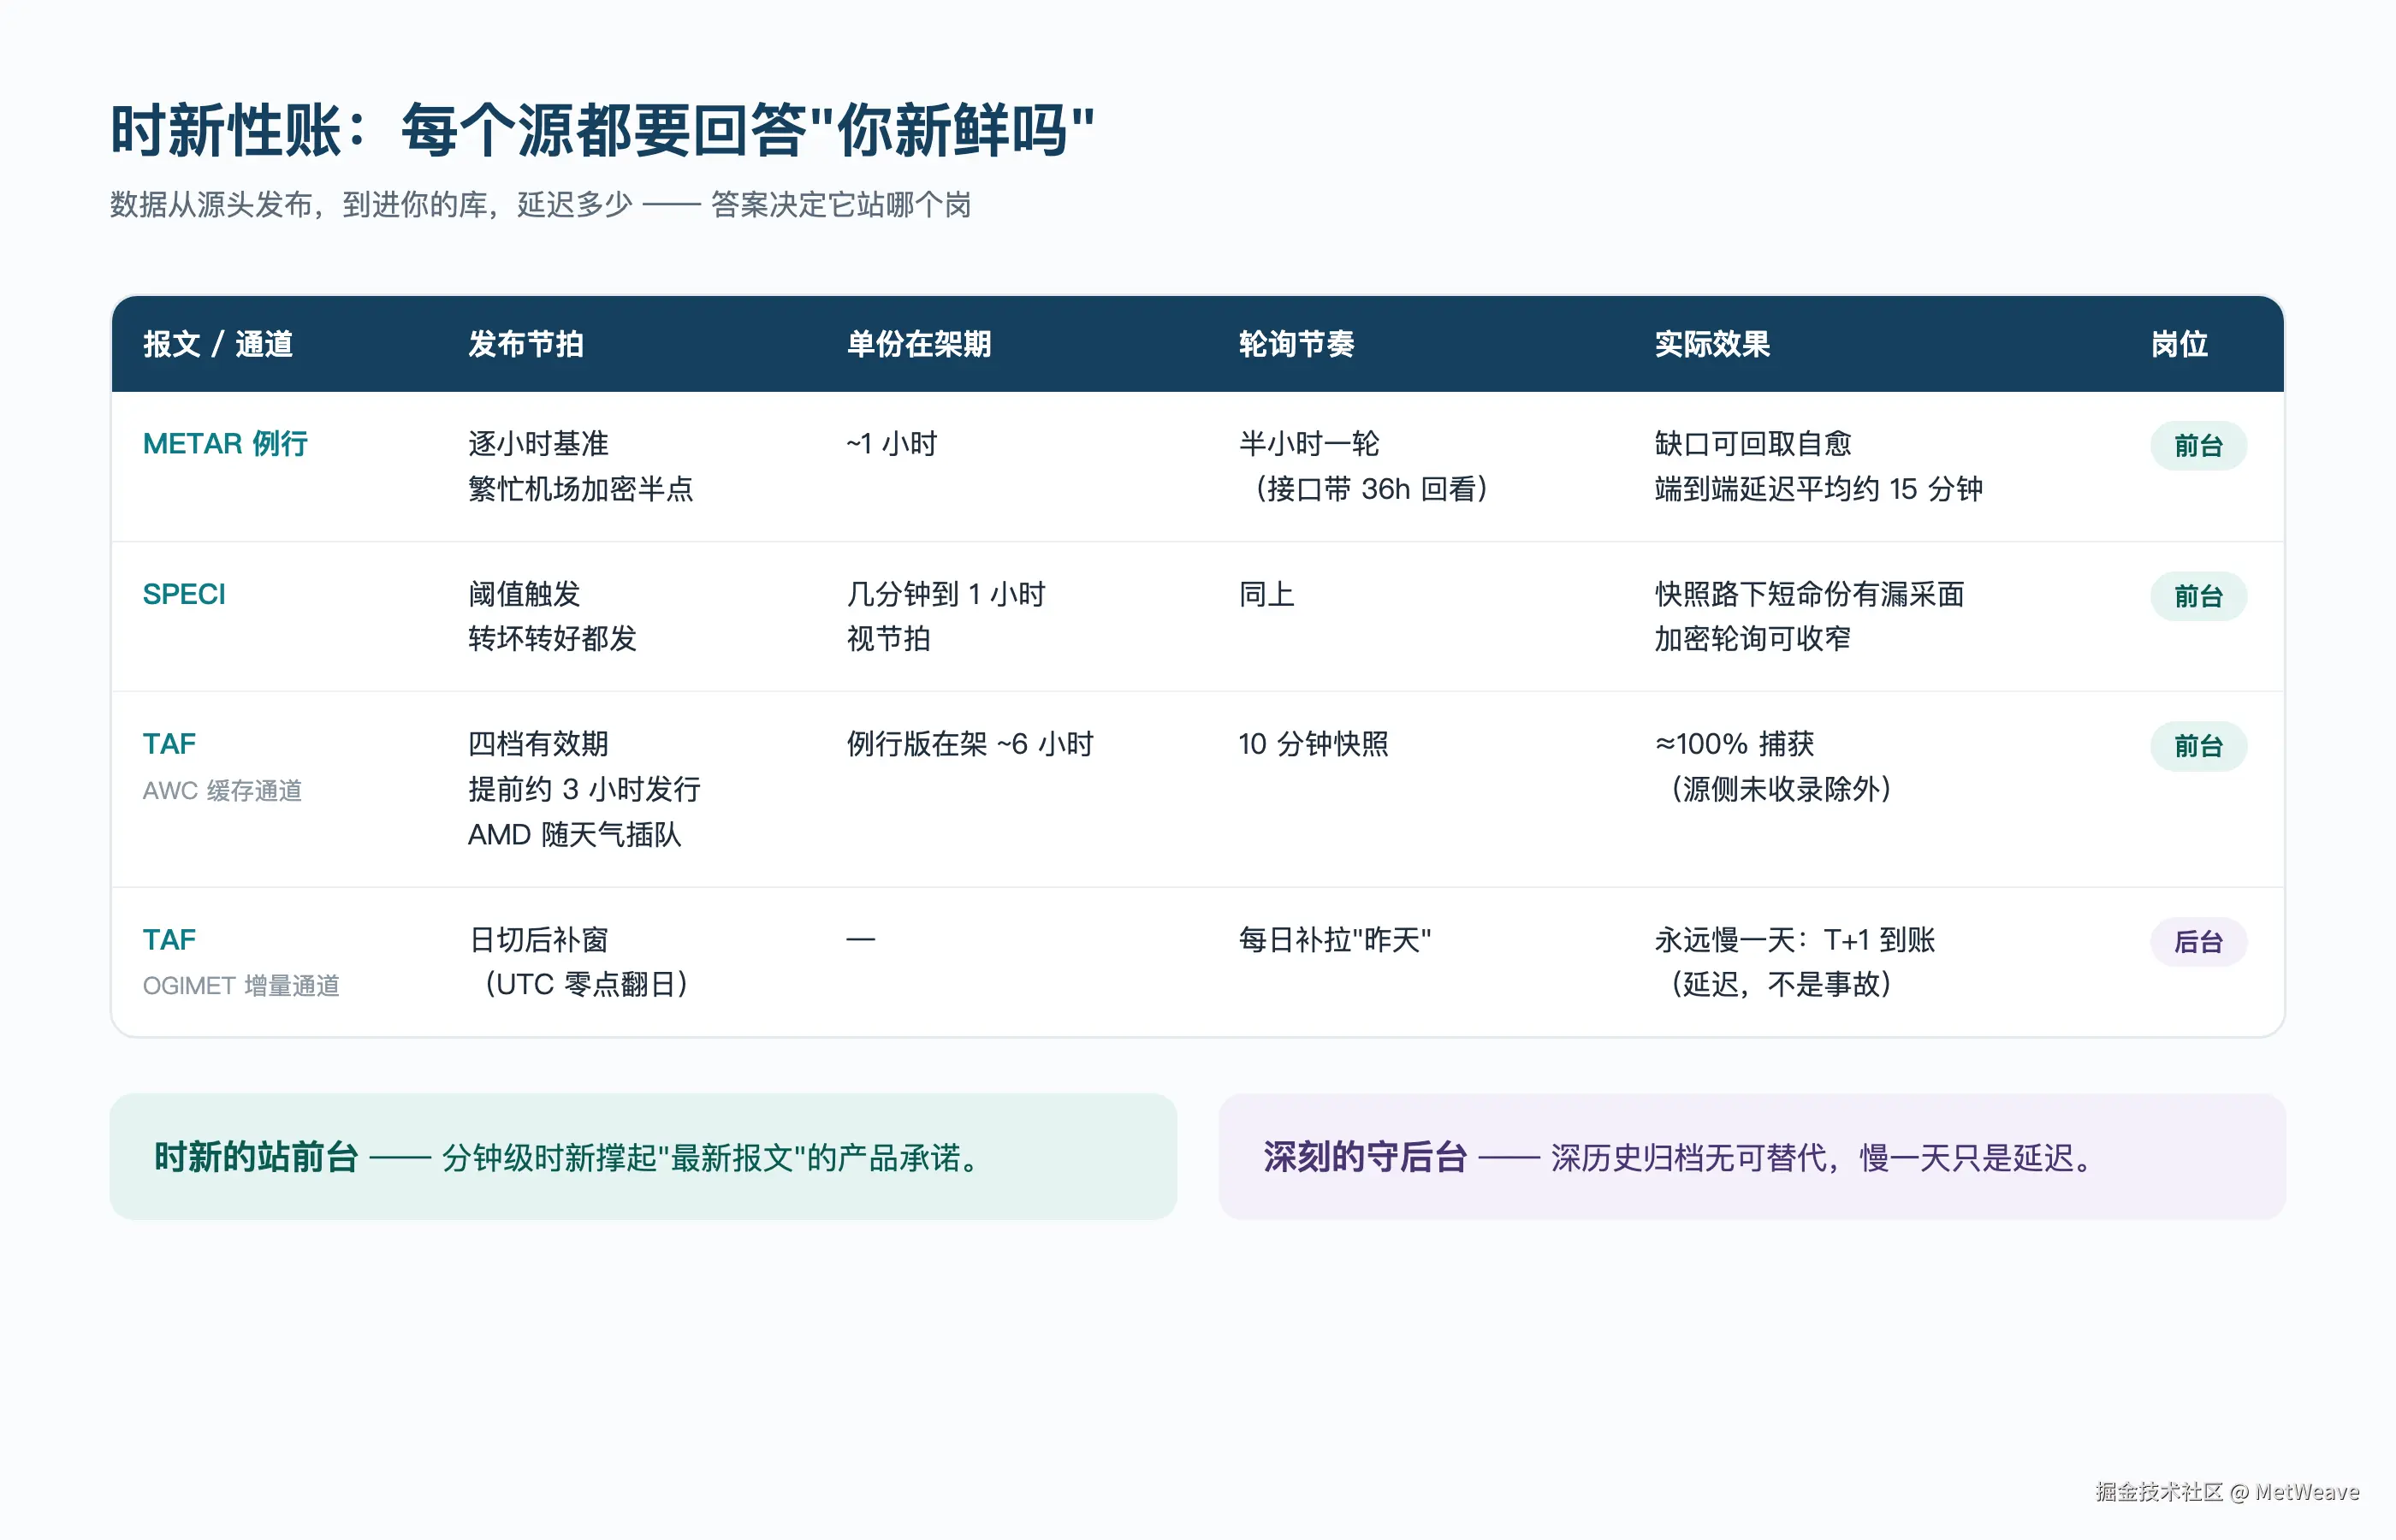
管道的最后一笔账是时新性:数据从源头发布,到进你的库,延迟多少?把前面散落的账收拢成一张表:
重点看表里最后一行:OGIMET 那条增量通道要等 UTC 零点翻日、前一天的账封完才动手,所以它的数据永远"今天见不到今天"。这不是缺陷,是定位------它是历史位,不是实时位。管道里每个源都要回答"你新鲜吗",答案决定它站哪个岗:时新的站前台,深刻的守后台。把岗站对,一天的延迟就只是延迟,不是事故。
九、下一步:从归集到服务(展望)
归集管线再往上走一层,就是把归档变成服务:采集器把清洗好的数据推进对象存储(理解成一个大网盘,存的是处理好的成品),后台进货的传送带和前台给人查的窗口分成两摊。为什么必须分?以 Cloudflare Workers 免费档为例:无服务器函数(平台替你跑、按次计费的小函数)每次请求只给 10 毫秒 CPU------解压加解析全站缓存它根本干不动,但"从存储里读一份现成结果"它闭着眼都能完成。重活留给定时采集,轻活留给在线查询,这个架构判断的过程比结论值钱。这一层的落地实践本文不展开------这里只讲已经真实跑起来的部分;等查询面正式上线,值得单独再写一篇。
系列到这里,基建篇收官:数据从哪来(选源)、怎么抓(通道与节奏)、怎么洗(去重与版本)、凭什么信(双通道对账)、新鲜到什么程度(时新性账)。
数据来源:航空天气中心(AWC,美国 NOAA)/ IEM(爱荷华州立大学)/ OGIMET------均为公开发布数据。使用 OGIMET 数据,随附原站免责口径:不得用于关键任务,仅供参考。
署名:YaoJaro · 独立开发者
系列会一直写下去,欢迎在掘金关注 @MetWeave。