(以下为一个示例场景,用来对齐问题,不是我经历过的某次真实事故。)
凌晨两点,监控群弹出一条告警:订单服务 P99 超过 3 秒,持续 40 秒,然后自己恢复了。你爬起来打开 Kibana,按 level: ERROR 搜,一条没有;换成 trace_id 搜,那条请求的日志断在调用支付网关之前,后面什么都没留下。本地起服务,用同样的参数跑一百次,全绿。第二天下午又来一次,还是这样,还是查不出东西。
偶发故障最折磨人的地方不是难,是它没有现场。没有堆栈,没有复现路径,甚至连"它到底发生在哪台机器上"都不确定。你唯一确定的事实是"它发生过"。
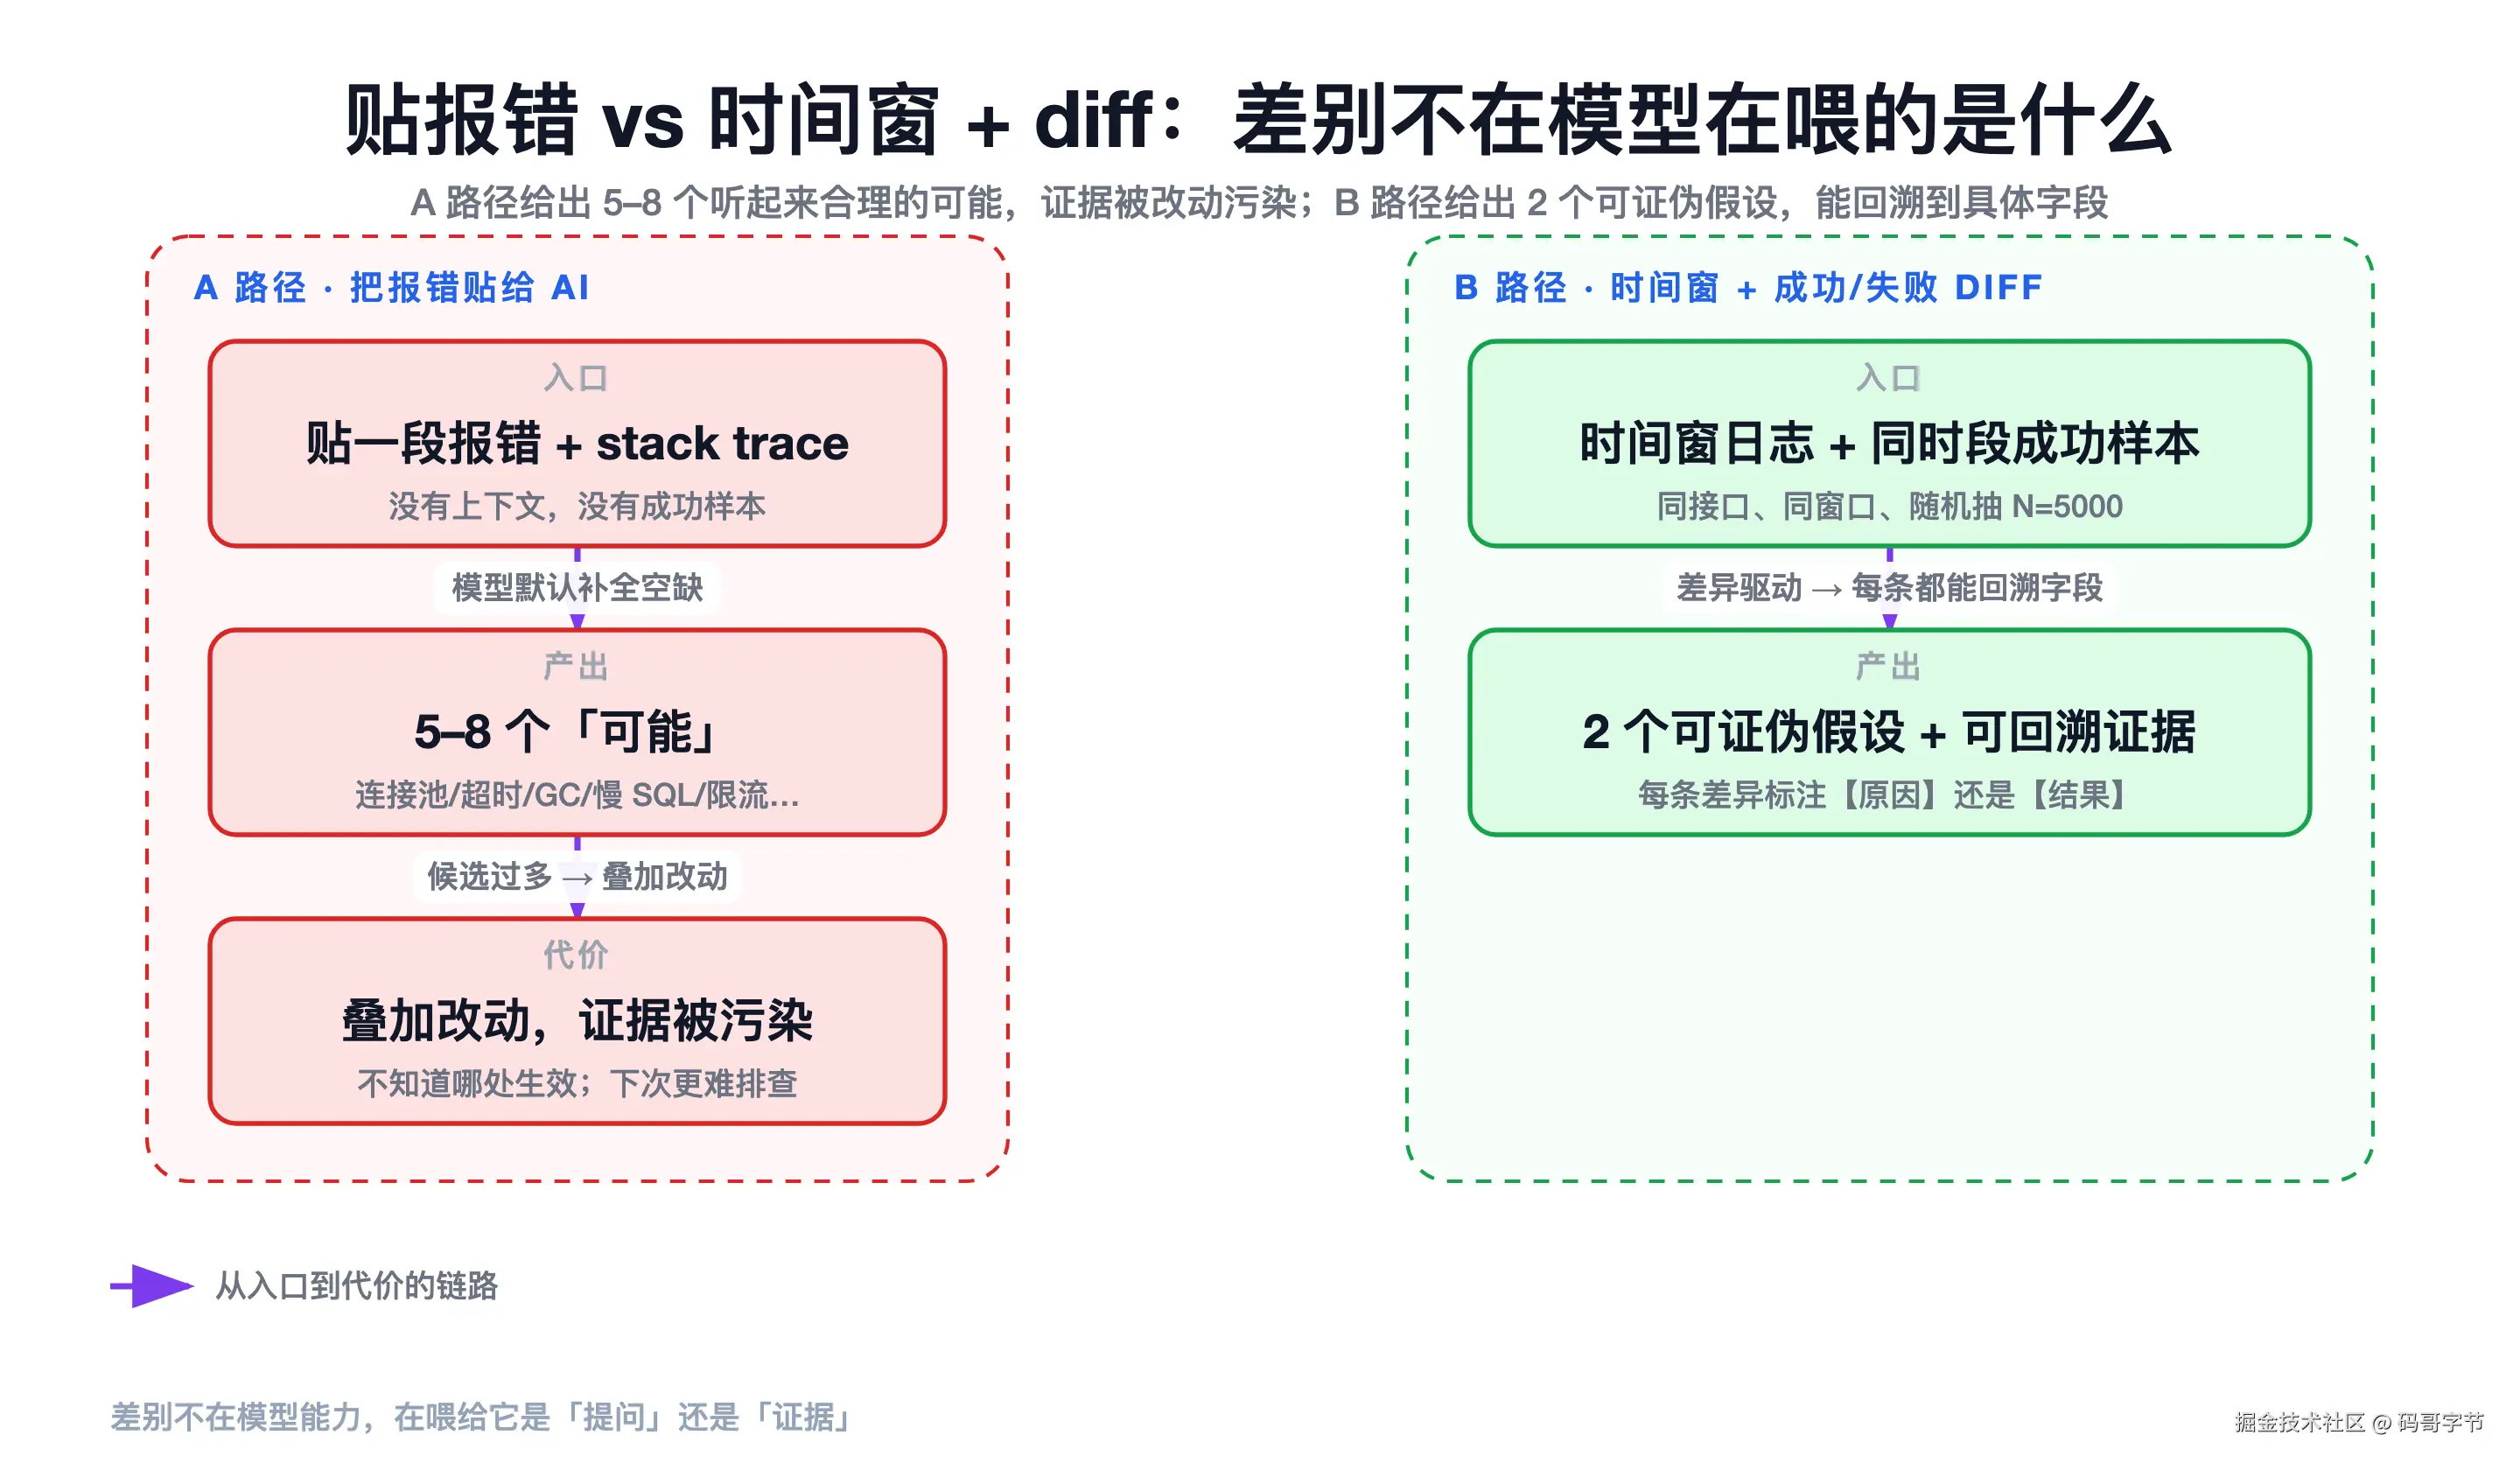
更麻烦的是,你已经试过把报错贴给 AI 了。它给了五条听起来都很合理的可能:连接池不够、超时配置太短、GC 停顿、慢 SQL、下游限流。你挑了两条改了,第二天又告警------而且你不知道是改动没生效,还是那是另一条路径。
这篇不讲"AI 很强"。给的是五个套路、四段可以直接粘的 prompt、一套把公司自建日志平台和数据库监控接进 AI 的接法与安全底线。
一句话主张先摆在这:AI 帮你缩小范围,不是替你修。
先划边界:AI 在偶发故障里能干什么、不能干什么
技术根据有两条,先讲清楚,否则后面的套路会被误读成"让 AI 多猜几次"。
第一,模型读你的代码是静态 的。它能看懂你的锁实现、连接池参数、超时配置,然后告诉你"这段看起来是对的"------而它大概率是对的。问题在于偶发故障往往不在你写的代码里,而在代码与调度器、内存分配器、连接池、网络栈的交互里。这些运行时状态 AI 读不到。
第二,观测本身有副作用。Heisenbug 是 Jim Gray 在 1983 年提出的,指的就是"一观测就消失"的 Bug:加一行 println 就是一次系统调用,时序变了;下一个断点,暂停的时间足够让竞态自行消解;用 Valgrind 跑,程序慢 20--50 倍,很多问题直接不复存在。所以"加了日志它就不出现了"从来不是好消息。
合起来,边界很清楚:
AI 能干的是检索与枚举。 把 5 万行日志压成 20 行候选,把 8 个假设砍到 2 个。这些事的共同点是规模大、规则机械、不需要对后果负责------恰好是模型擅长的。
AI 不能干的是责任判断。 决定改哪一行、这一行改了会不会在另一个场景炸掉,代价由你和你的团队承担,模型不承担。这部分不能外包。
2018 年 Stripe《Developer Coefficient》调研:开发者每周花在维护(debug、重构、修坏代码)上的时间是 17.3 小时 ,占 41.1 小时工作周的 42%(2018 年数据,别当成最新结论用)。这个池子很大,但 AI 能替代的只是其中"找"的那一段。
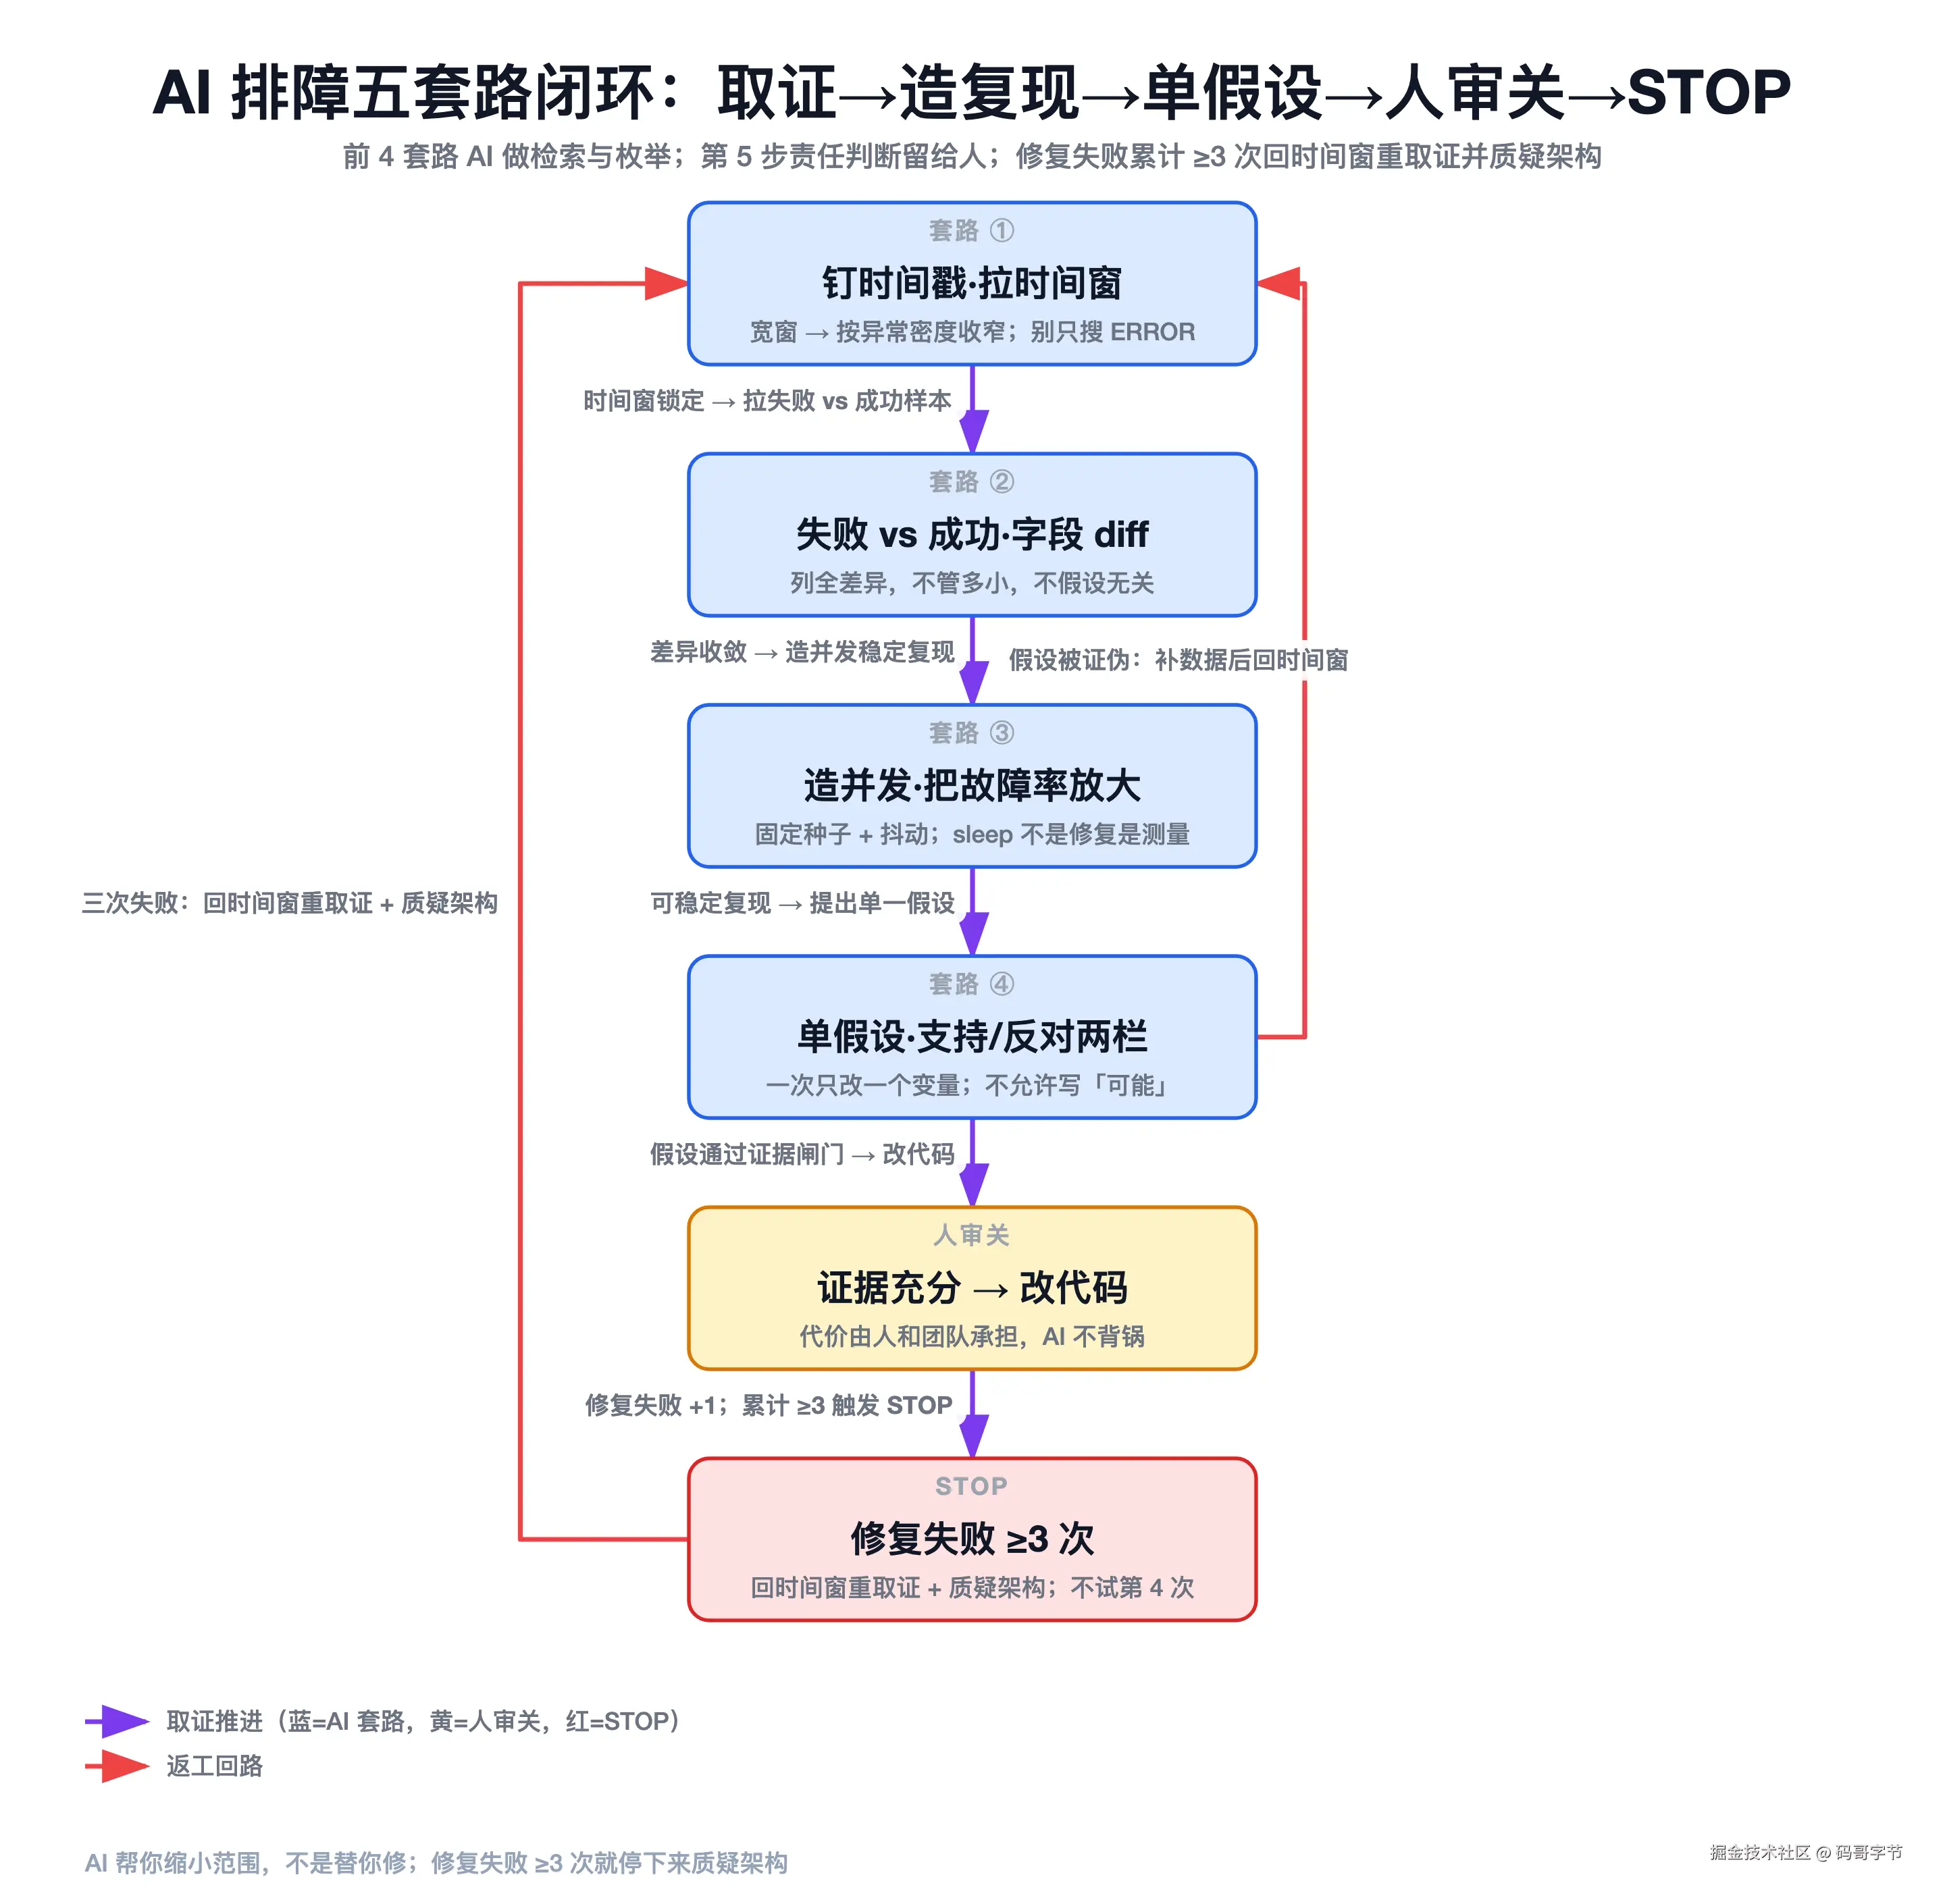
五个套路围绕这条线设计:前四个做"缩小范围",第五个解决"数据从哪来"。
套路一:先钉时间戳,再做日志回溯
偶发 Bug 的第一现场在日志,不在代码。新人上来就翻源码,老手先定时间窗------差别在于源码是"所有请求都会走的路径",日志才是"那一次到底走了哪条路径"。
第一步,定时间窗。 以告警时刻为中心先拉一个宽窗:往前 5 分钟、往后 2 分钟。往前扩是因为因常在果之前------连接池可能 30 秒前就开始排队了;往后扩是为了看到恢复过程,是自己恢复的,还是重启/扩容之后才恢复的,这个区别很关键。拿到宽窗结果后按异常密度往中间收窄,这叫时间盒。
第二步,别只搜 ERROR。 这条很多人做错了。偶发失败在日志里的形态,大量是 HTTP 200 + 业务错误码,或者是 WARN 级的慢查询、连接池等待、线程池队列堆积。你按 ERROR 搜,一条没有,于是得出"日志里没东西"的结论------其实是被你的查询条件过滤掉了。
下面三段按你的日志栈挑一段用。Loki:
bash
# 时间盒:以告警点为中心,先拉宽窗,再按异常密度收窄
logcli query \
  --from="2026-09-05T02:08:00Z" \
  --to="2026-09-05T02:16:00Z" \
  --limit=5000 \
  '{app="order-service",env="prod"} | json | level!="INFO"'
Elasticsearch / Kibana,用 ES DSL 直接做一次聚合,看异常集中在上游哪个依赖:
json
{
  "size": 0,
  "query": { "bool": { "filter": [
    { "term":  { "service.name": "order-service" }},
    { "range": { "@timestamp": { "gte": "2026-09-05T02:08:00Z", "lte": "2026-09-05T02:16:00Z" }}},
    { "range": { "duration_ms": { "gte": 1000 }}}
  ]}},
  "aggs": {
    "by_upstream": { "terms": { "field": "upstream.keyword", "size": 10 }}
  }
}
ClickHouse / Doris 这类日志库,用 SQL 更直接,而且能一次算出"哪条路径又慢又错":
sql
SELECT upstream,
       count()                       AS cnt,
       quantile(0.99)(duration_ms)   AS p99,
       countIf(err_code != 0)        AS biz_err
FROM logs.order_service
WHERE ts BETWEEN '2026-09-05 02:08:00' AND '2026-09-05 02:16:00'
GROUP BY upstream
ORDER BY biz_err DESC, p99 DESC
LIMIT 20;
查到这一步,把结果连同样本一起丢给 AI。prompt 里要限制它只能基于给定数据说话:
text
下面是 order-service 在 2026-09-05 02:08:00 ~ 02:16:00 的日志聚合结果与 20 条原始样本。
期间发生了一次 P99 超 3 秒、持续约 40 秒的偶发抖动,之后自行恢复。

请只做三件事,不要给修复建议:
1. 按时间顺序把异常样本排序,指出异常密度最高的 1~2 个子时间窗(精确到秒)。
2. 列出这些样本里重复出现的字段组合(upstream、错误码、线程名、机器 IP 等)。
3. 明确指出哪些字段在你拿到的数据里【没有出现】,因此无法用于判断。

约束:每条结论后面必须附上样本行号或聚合行作为依据。
数据中看不出的一律回答"数据不足",不要推测。
第三条约束是关键。没有它,模型会用常识把空缺填满,而你分不清哪句是它看到的、哪句是它编的。
套路二:让它写「对比查询」,不是「搜索查询」
搜索查询的问题是:你必须先知道要搜什么。而偶发故障的特点就是你不知道。
换一个问法------同时拉失败请求和同时段成功请求,做字段级 diff。你不需要先知道为什么,只需要知道这两批请求差在哪几个字段。这一步可以批量化,是 AI 最擅长的机械工作。
obra/superpowers 的 systematic-debugging 在模式分析阶段有一条原文要求,我每次都直接抄进 prompt:
List every difference, however small. Don't assume "that can't matter".
列出所有差异,不管多小,不要假设某个差异无关。为什么要这么硬?因为你自己会过滤。你会想:"机器 IP 不同而已,肯定是随机的""用户 ID 不一样很正常"。可线索经常就藏在你觉得"很正常"的那个字段里。模型的价值在这里恰恰是它不会嫌麻烦。
采样有个讲究:成功样本要和失败样本同接口、同时间窗、随机抽,量级取失败数的 10--50 倍。同接口保证可比,同时间窗排除版本和流量基线的影响,随机抽防止你"顺手挑几个"时无意中挑到某一类请求。
text
这是同一个接口 order/create 在同一时间窗内的两组请求,A 组失败(N=137),B 组成功(N=5000)。

请给出两组请求的字段级差异分析:
1. 逐字段对比,输出三类字段:
   - 只在 A 组出现的值/取值范围
   - 两组都有但分布明显不同的字段(给出分布差异)
   - 两组完全一致、可以排除的字段
2. 对每一处差异,标注它可能是【原因】还是【结果】(例如 latency 高通常同时是结果)。
3. 列出所有差异,不管多小,不要假设某个差异无关。
4. 最后只保留 2 个最值得验证的假设,其余归入"暂不验证"并说明为什么。

约束:不要给修复方案,不要改代码,每条差异都要能回到具体字段名。
第 2 点是我加的。原因和结果必须分开标,否则你会拿着"失败请求耗时更长"去查超时配置,而那只是失败的表现。
套路三:最小复现是造并发,不是写复现步骤
偶发 Bug 复现不出来,通常不是"触发条件没找到",而是并发度和时序没造出来。单线程跑一百次全是绿的,因为大部分偶发问题的窗口只在特定交错下才打开。
先纠正一个常见误判:sleep 能让它消失不是修复,是测量。 你加了个 sleep(100ms),Bug 不出现了,这告诉你的信息是------竞态窗口比 100ms 还小。它不是解决方案,是一把尺子。真拿它上线,等于把窗口从"偶尔撞上"改成"负载更高时一定会撞上"。
正确方向是反过来:把故障率从 1/10000 提到 1/10,才能稳定观测。手段是并发压测加调度扰动,另外固定随机种子,让失败可重放。
下面是一个 Go 的并发复现骨架,替换掉 callOrderService 就能跑:
go
package main

// 用法:go run repro.go -n 20000 -c 200 -seed 42
// 目的:把 1/10000 的偶发失败,用并发放大到可稳定观测的比率
import (
	"context"
	"flag"
	"fmt"
	"math/rand"
	"sync"
	"sync/atomic"
	"time"
)

func main() {
	var (
		total = flag.Int("n", 20000, "总请求数")
		conc  = flag.Int("c", 200, "并发度")
		seed  = flag.Int64("seed", 42, "随机种子:固定种子才能让失败可重放")
	)
	flag.Parse()

	rnd := rand.New(rand.NewSource(*seed)) // 固定种子
	var ok, fail int64
	var mu sync.Mutex
	samples := make([]string, 0, 20) // 只留少量失败样本,避免内存被打爆

	sem := make(chan struct{}, *conc)
	var wg sync.WaitGroup
	ctx, cancel := context.WithTimeout(context.Background(), 5*time.Minute)
	defer cancel()

	for i := 0; i < *total; i++ {
		wg.Add(1)
		sem <- struct{}{}
		go func(i int) {
			defer wg.Done()
			defer func() { <-sem }()

			// 关键:让请求之间的间隔抖动,逼出时序窗口
			time.Sleep(time.Duration(rnd.Intn(8)) * time.Millisecond)

			if err := callOrderService(ctx, i); err != nil {
				atomic.AddInt64(&fail, 1)
				mu.Lock()
				if len(samples) < 20 {
					samples = append(samples, fmt.Sprintf("i=%d err=%v", i, err))
				}
				mu.Unlock()
			} else {
				atomic.AddInt64(&ok, 1)
			}
		}(i)
	}
	wg.Wait()

	fmt.Printf("total=%d ok=%d fail=%d rate=%.4f%%\n",
		*total, ok, fail, float64(fail)/float64(*total)*100)
	for _, s := range samples {
		fmt.Println(s)
	}
}

// callOrderService 换成你真实的调用:HTTP / gRPC / DAO 都可以
func callOrderService(ctx context.Context, i int) error {
	// TODO: 替换为真实调用
	return nil
}(这是骨架,callOrderService 需要你替换成真实调用,未在本地执行过。)
还有一件事:怎么加日志才不改变行为。 每条请求都打点会改 I/O 和时序。改用环形缓冲(flight recorder 模式):日志常驻内存循环覆盖写,只在出错那一刻落盘。既保留时序,又不改时序。
go
// 环形缓冲:常驻内存写,只在出错时才落盘,避免把 I/O 加进关键路径
type ring struct {
	mu   sync.Mutex
	buf  []string
	next int
}

func (r *ring) add(s string) {
	r.mu.Lock()
	defer r.mu.Unlock()
	r.buf[r.next] = s
	r.next = (r.next + 1) % len(r.buf)
}

func (r *ring) dump() []string { // 只在 panic / 超时 / 业务失败时调用
	r.mu.Lock()
	defer r.mu.Unlock()
	out := make([]string, 0, len(r.buf))
	for i := r.next; i < r.next+len(r.buf); i++ {
		if s := r.buf[i%len(r.buf)]; s != "" {
			out = append(out, s)
		}
	}
	return out
}
让 AI 帮你写这段骨架是很合适的,因为它是纯机械代码,你能一眼审完:
text
我有一个偶发故障:接口 order/create 在生产环境大约每 10000 次请求失败 1 次,
单线程本地复现不出来,怀疑是并发时序问题。

请帮我写一个 Go 并发压测脚本(不要给修复建议):
1. 支持 -n 总请求数、-c 并发度、-seed 随机种子三个参数,固定种子保证可重放。
2. 在每次请求之间加入随机抖动(0~8ms),用于放大时序窗口。
3. 用一个环形缓冲记录最近 N 条调用上下文,只在失败时落盘,避免常态打日志改变时序。
4. 结束时输出失败率和前 20 条失败样本。

约束:脚本只做观测,不得修改任何业务状态;失败判定用我提供的 err != nil。
套路四:单假设验证,强制 AI 输出「支持证据 / 反对证据」两栏
到这一步你手上已经有几个候选假设了。接下来最容易出的事是确认偏误:你心里有个最喜欢的假设,于是 AI 给的每条证据都在支持它,反对证据被自动忽略。
对抗办法很粗暴:强制它把支持证据和反对证据分成两栏输出。模型在"找支持证据"上非常有创造力,你让它同时找反对证据,它起码得把两边都摆出来。
配套两条纪律(第二条很多人做错了):
- 一次只改一个变量。 改完不管用就换新假设,不许叠加改动。叠加改动的后果是:你不知道哪一处生效,而且新改动会污染后续证据,第二次排查比第一次更难。
- 假设卡片化。 每个假设一张卡,模板如下:
| 字段 | 内容 |
|---|---|
| 假设 | 支付网关连接池在峰值被打满,请求排队超过 1s 后超时 |
| 支持证据 | 失败样本的 upstream 100% 为 pay-gateway;失败集中在 02:13:10~02:13:50 |
| 反对证据 | 同期 pay-gateway 自身 P99 正常;连接池监控未见等待队列堆积 |
| 验证方式 | 用套路三的并发脚本在预发环境把并发提到 200,观察 pool_wait_ms 是否随并发线性上升 |
| 当前结论 | 待验证 / 已证伪 / 已确认(三选一,不允许写"可能") |
"当前结论"只准三选一是有意的。写"可能是"的假设卡等于没写,它会在你的列表里躺三个月。
让 AI 填卡片时,prompt 里要写死反对证据必须存在:
text
针对以下假设,请严格按两栏输出,不要给修复建议:

假设:<把你的假设原样贴进来>
已有数据:<日志样本 / 监控指标 / 压测结果>

【支持证据】逐条列出能支持该假设的数据,每条注明来源(哪条日志/哪个指标)。
【反对证据】逐条列出与该假设矛盾或该假设无法解释的数据。
  如果确实找不到反对证据,必须明确写出"未找到反对证据",
  不允许留空、不允许只写支持项。
【验证方式】给出一个能在预发环境执行、能在 30 分钟内出结果的具体步骤。
【当前结论】只能在 待验证 / 已证伪 / 已确认 中选一个。
然后是这套方法论里我认为最值钱的一条,它不是 AI 技巧,是工程判断:
三次失败规则。 同一个问题的修复尝试达到 3 次仍不奏效,就 STOP------不要试第 4 次。回去质疑架构,而不是继续猜参数。superpowers 的 systematic-debugging 把这条写成铁律,原文是修复失败 3 次后停下质疑架构。
为什么是 3 次?前 3 次失败的信息量是递增的:第 1 次说明假设错了;第 2 次说明假设空间错了;第 3 次说明这个问题不属于你当前的抽象层级------你在参数层修一个架构层的问题。比如重试能缓解但总会复发,通常意味着这不是"超时配置太短",而是"这个调用本来就不该是同步强依赖"。
这条规则难在心理上:第 4 次的边际成功率极低,但因为前 3 次已经投入了,人倾向于"再试一个,我觉得快对了"。所以要写成规则,不靠临场判断。
还有一句专门堵死"偶发问题查不出就算了"这条退路,superpowers 原文:
95% of "no root cause" cases are incomplete investigation.
95% 的"查不出根因"其实是调查不完整。这句话很刺,但它指向一个可执行的事实------"查不出"是调查过程的属性,不是 Bug 的属性。你没查出来的原因通常是:时间窗没对齐、只搜了 ERROR、差异没做全、假设没被证伪过。这些都是能补的动作,不是运气问题。
套路五:把公司日志和数据库监控接进 AI
前四个套路有个共同前提:你能低成本地把日志和监控数据喂给 AI。靠手动复制粘贴,第四个套路你就懒得做了。
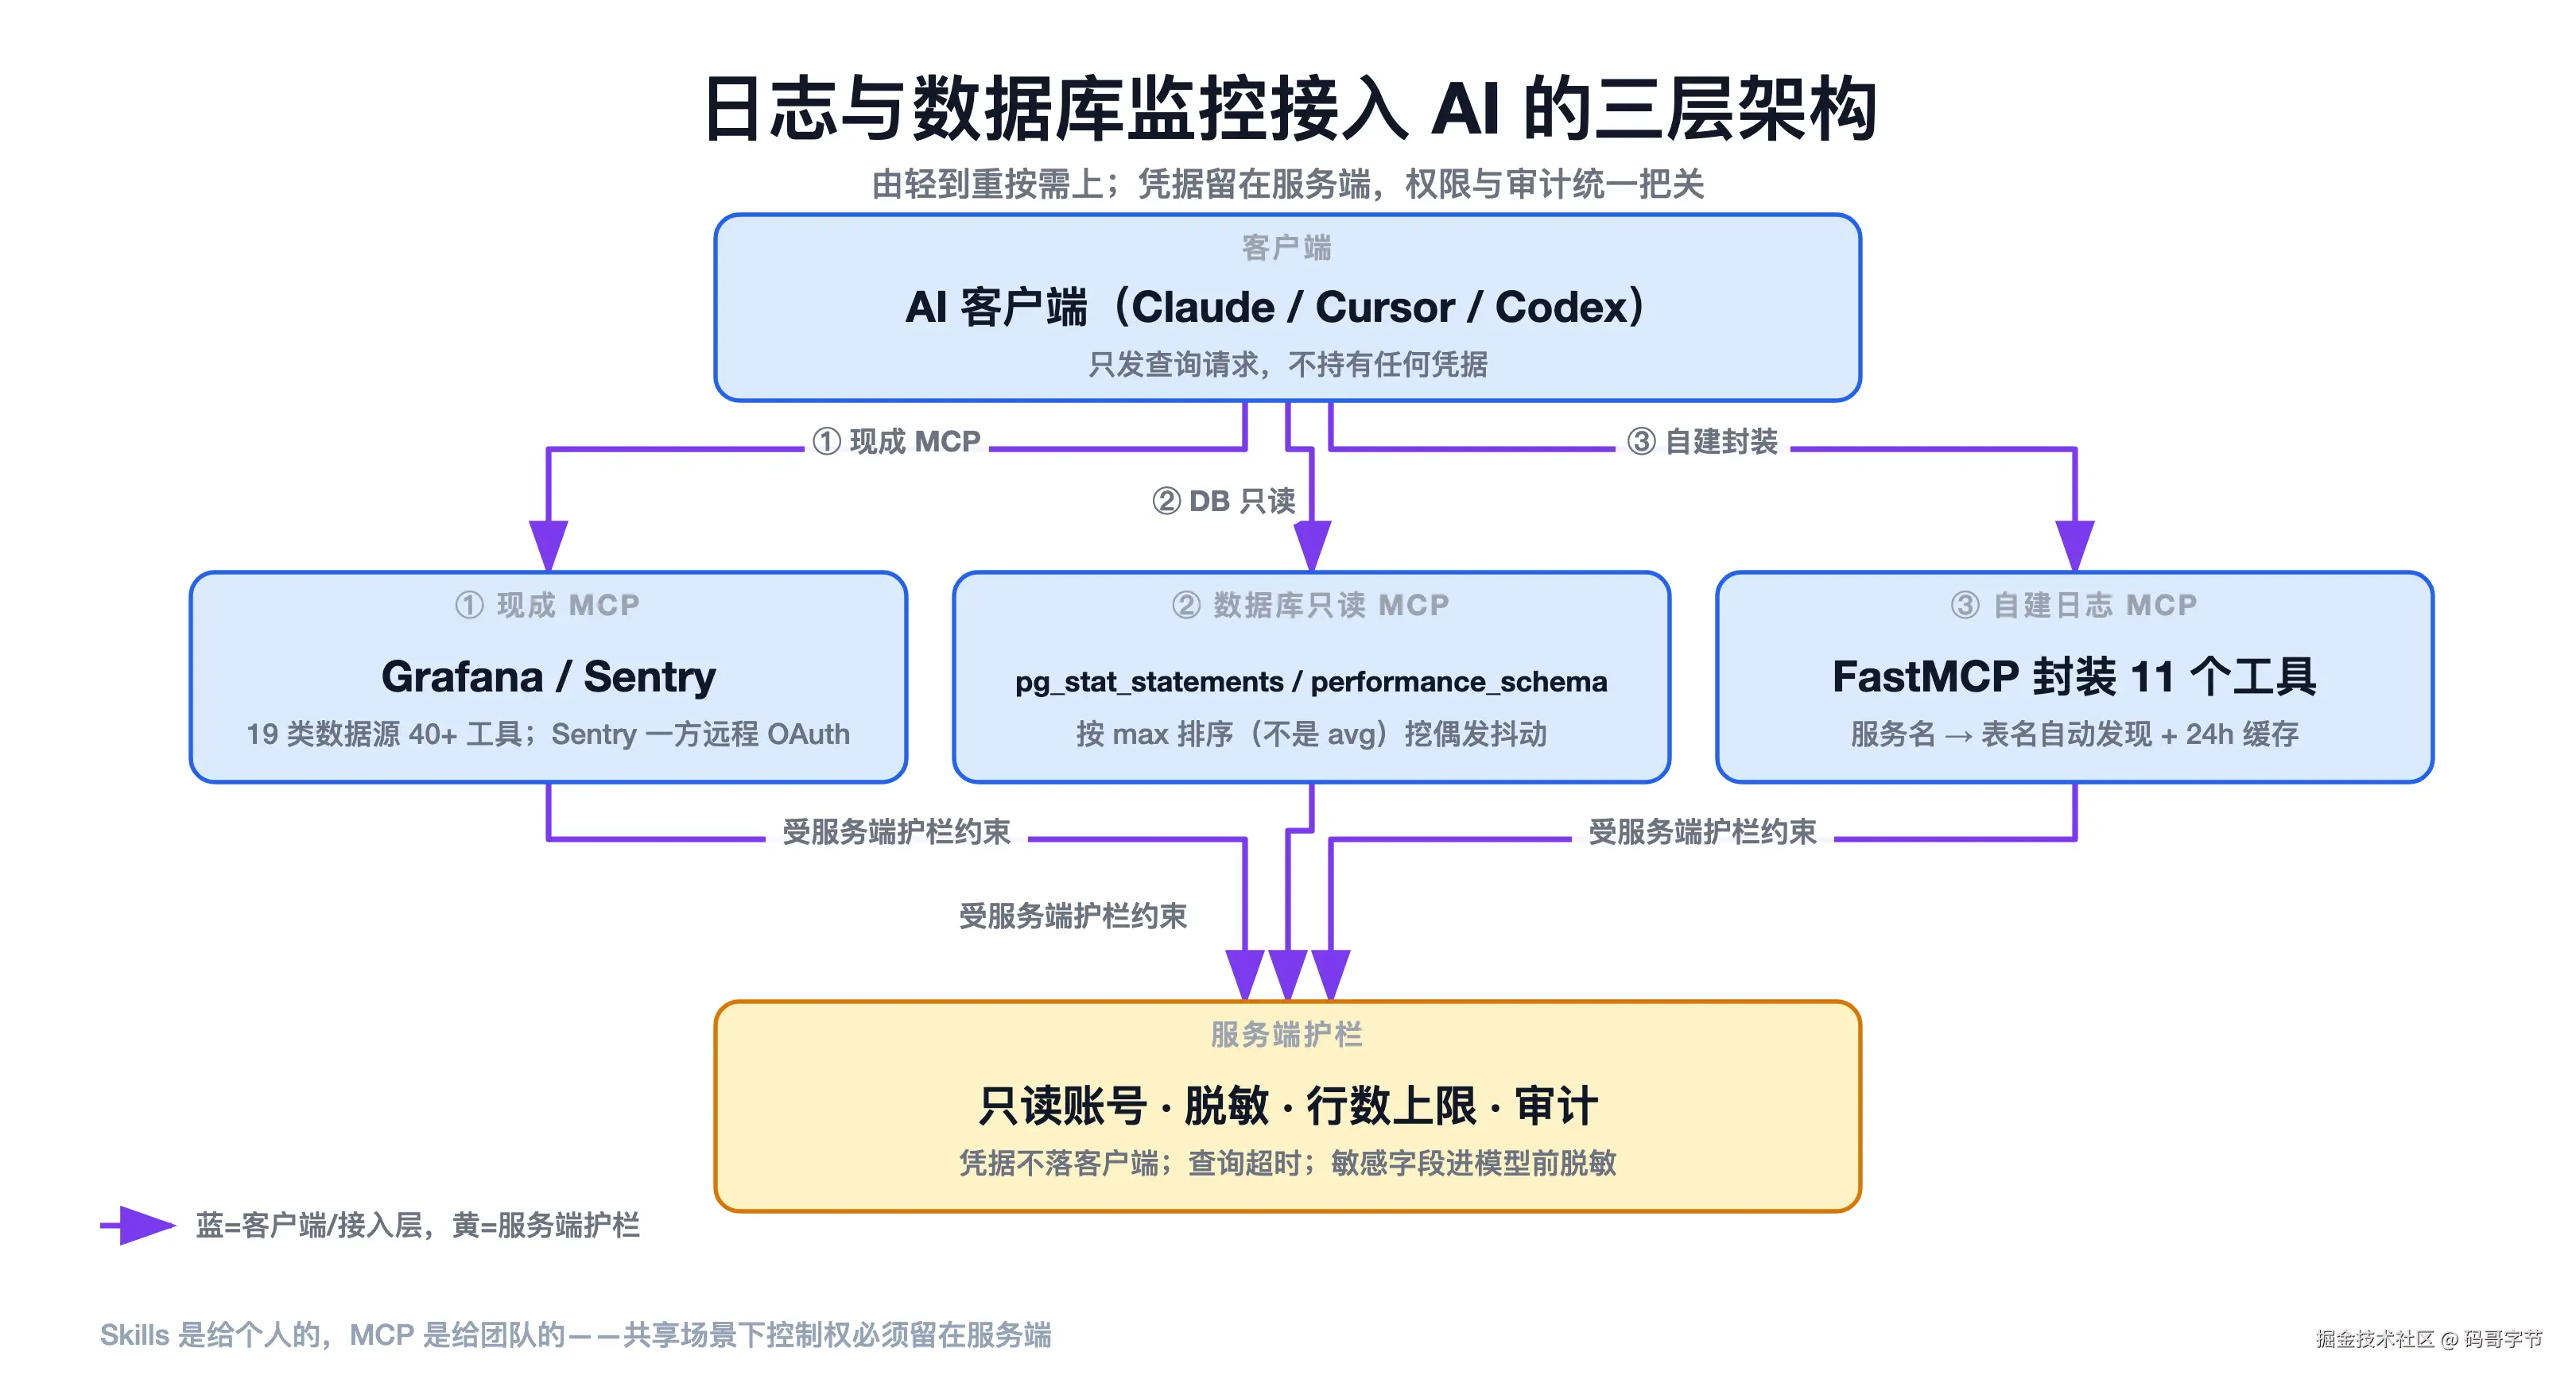
接入分三层,从轻到重,建议按顺序上,不要一次全铺。
第一层:现成 MCP。 用 Grafana 的话,官方 mcp-grafana 最省事:覆盖 19 类数据源、提供 40+ 个工具,支持用 tool categories 控制上下文窗口------这点重要,全量工具会把上下文吃光。截至 2026-09-05 核验,仓库 3,413 stars。Sentry MCP 是其中唯一的一方远程服务,地址 mcp.sentry.dev,走 streamable-HTTP + OAuth 不用本地装;每个 event 都带 release 归属,你可以直接问"这个问题是哪个 release 首次引入的"。
第二层:数据库只读 MCP。 很多偶发超时最后查到是数据库侧的慢查询或锁等待,而 Grafana 这一层往往只有聚合曲线,没有原始语句。给 AI 一个只读库账号,让它查 pg_stat_statements / performance_schema:
sql
-- PostgreSQL:找出均值不高但最大值极高的语句,偶发抖动常藏在这里
SELECT substring(query, 1, 80)              AS q,
       calls,
       round(mean_exec_time::numeric, 2)    AS avg_ms,
       round(max_exec_time::numeric, 2)     AS max_ms
FROM pg_stat_statements
WHERE mean_exec_time > 5
ORDER BY max_exec_time DESC
LIMIT 20;
sql
-- MySQL / RDS:同样按最大值排序,不看均值
SELECT digest_text,
       count_star,
       round(avg_timer_wait/1e9, 2) AS avg_ms,
       round(max_timer_wait/1e9, 2) AS max_ms
FROM performance_schema.events_statements_summary_by_digest
ORDER BY max_timer_wait DESC
LIMIT 20;两条都按 max 排而不是 avg------均值完全掩盖偶发抖动,1 万次里 1 次 5 秒的查询,均值看起来毫无异常。
第三层:自建日志 MCP。 日志在自建 ClickHouse / Doris / ELK 上、没有现成 MCP,就用 FastMCP 这类框架自己封一层。公开案例里有这么做的(公开案例,非我司实测 ):面向 150+ 微服务暴露 11 个工具(find_errors、trace_request、search_keyword、log_statistics 等),核心设计是"服务名 → 表名自动发现 + 24 小时缓存"------新增服务不用改配置,AI 自己能找到表。
这里必须拆一个很多人的误区:面向团队共享时,Skills 和 MCP 不能选错。
| 维度 | Skills(教 AI 写 SQL) | MCP(给 AI 一个查日志的 API) |
|---|---|---|
| 凭据位置 | 散落在每个用户本地 | 服务端统一持有 |
| 跨平台 | 换个客户端要重配 | 一次接入,所有客户端可用 |
| 连接管理 | 每会话各自建连接,无池化 | 服务端连接池 |
| 审计 | 无 | 有查询日志,可追溯谁问了什么 |
| 权限粒度 | 取决于个人账号 | 可强制只读账号 |
结论很直接:Skills 是给个人的,MCP 是给团队的。 共享场景下控制权必须留在服务端,否则你没法回答"上周是谁把生产库密码贴进了对话上下文"。
接完跑一遍自检清单,六项缺一项别上线:
- 只读账号 :
SELECTonly,不给 DDL/DML 权限。 - 专用服务账号:不要用任何人的个人账号,方便独立回收。
- 凭据轮换:有轮换周期和回收流程。
- 结果行数上限:服务端硬限制,比如单次最多 200 行。
- 查询超时 :单条查询超时强制中断,避免一个
SELECT *拖垮日志库。 - 敏感字段脱敏:手机号、身份证、token、cookie 在进模型之前必须脱敏。这条最容易被跳过,也最容易出事。
还有两个真实的坑。版本坑:Grafana MCP 在 Grafana 9.0 以下,部分关键工具会静默失败------不是报错,是返回空结果。你会以为"日志里确实没东西",然后顺着错的方向查下去。上之前先确认版本。
安全坑:日志内容本身就是模型输入 ,而日志里充满用户可控字符串(User-Agent、请求参数、报错 message)。攻击者构造一个特殊 User-Agent 让它在报错日志里出现,就可能构成间接 prompt 注入。2026 年 4 月披露的 GrafanaGhost 正是这个攻击面的真实利用(未分配 CVE)。所以别把接了日志 MCP 的 Agent 配成有写权限的自动执行体,原则是让它看,不要让它顺手动手。
什么时候 AI 排障一定失效
说清楚边界,省得你在不可能的场景上耗时间。
真正的竞态和内存可见性问题。 AI 读不到 CPU 指令重排、缓存一致性状态、调度器的实际交错。它能帮你读代码、写复现脚本,但"这里为什么需要内存屏障"这种判断,你得自己核对规范,不能直接用它的答案。
跨主机时钟漂移。 基于日志时间戳的关联都建立在时钟可信的前提上。NTP 没配好,几十毫秒漂移就足以把因果关系排反------你会看到"果"发生在"因"之前。这类问题日志里查不出来,先查 ntpq -p 和各机器时钟偏移。
第三方依赖的黑盒抖动。 下游是云厂商或外部供应商,你拿不到内部指标。AI 再强也只能告诉你"确实是对方慢了",然后选项只剩重试、降级、换供应商。
没有 trace_id 串联的老系统。 最现实的一条。请求跨 5 个服务、日志里没有统一 trace_id,套路一和套路二都做不下去------你连"同一次请求"都拼不出来。正确答案是先把 trace_id 打通,不是让 AI 用时间戳和用户 ID 猜请求归属。
关于"没有可观测性会贵多少",有一份可引用的数据:Sherlocks 对 2026 年 1--5 月 73 起生产环境 AI Agent 事故 的分析显示,无可观测性的故障平均 MTTR 是 4.2 小时 ,带 schema 校验的工具调用故障是 54 分钟。
必须标注清楚:这是 AI Agent 系统故障的统计,不是传统后端 Bug 的统计,不能换算成"你的后端服务 MTTR"。但方向一致------证据缺失时排查代价是陡增的,不是线性增加的。
FAQ
小团队没有日志平台,这套还能用吗? 能用,套路一和套路二要降级。日志还在机器上时,先用 grep + awk 按时间窗切出来,攒成一个文件再喂给 AI;重点是别跳过时间窗,也别只搜 ERROR。真要长期做,优先补 trace_id,比补平台更先见效。
接 MCP 会不会泄露数据? 看你把凭据放哪。放服务端(MCP)比放每个人本地(Skills)安全得多,前者有统一账号、审计日志和只读限制。真正的风险不在"接不接",在两件事:有没有脱敏、有没有给写权限。
为什么我贴了日志 AI 还是在猜? 三种可能,按概率排:一是没加"数据不足就回答数据不足"这条约束,模型默认会补全;二是你贴的是单条报错,没有同时段成功样本,它做不了 diff;三是你问的是"为什么出问题",这个问法本身就在邀请它猜。改成"这两组请求差在哪几个字段"。
偶发问题查了很久查不出根因,要不要放弃? 别把"查不出"当成 Bug 的属性。"95% 的查不出根因其实是调查不完整"这句话不是给你打鸡血的,是让你检查流程:时间窗对齐了没、只搜 ERROR 了没、差异列全了没、假设被证伪过没。这四个动作补完仍没结果,才轮到考虑"这是不是第三方黑盒"或者"要不要先补 trace_id"。
最后
把这篇压成一句话:让 AI 做检索与枚举,把"改哪一行"留给自己,修复失败 3 次就回去质疑架构。
最小可行的下一步:挑一个你最近没查到底的偶发问题,只做套路一和套路二------定时间窗、拉成功与失败两组样本、做字段 diff。这两步不需要改任何基建,今天就能跑,而且经常在这两步就把范围从"整个系统"缩到"一个模块"。
🔧 文中用到的完整 Prompt
以上我分享了最核心的几条,完整版合集(共 42 条,涵盖 Code Review · 重构 · 单测生成 · 架构设计 · AI Agent 调教)已整理好。
回复「prompt」即可获取,持续更新。
如果这篇对你有帮助,转发给你的程序员朋友 --- 大家都在摸索 AI 提效,你的分享可能帮他省很多时间。