这篇文章写给有后端经验、刚接触电话/VoIP 的开发者。读完你应该能弄明白:一通电话是怎么进到 FreeSWITCH 的,又是怎么把声音交给 AI 机器人、再把机器人的回答播回去的;你还能在自己的服务器上用分机 1000/1001/1004 把整条链路跑通。
1. 为什么语音机器人需要电话系统
我的开源项目 voice-robot(实时语音机器人)现在的工作方式是:浏览器或 App 通过 WebSocket 把麦克风音频推上来,服务端走一遍 ASR(语音识别,声音转文字)→ LLM(大模型,理解并生成回复)→ TTS(语音合成,文字转声音),再把合成的声音推回去。
但真正的"客服"场景里,用户不会打开你的网页,他们只会拨一个电话号码。要让机器人"接电话",中间少了一层:
- 接入运营商线路:电话网说的是电信协议,不是 HTTP,也不是 WebSocket;
- 管理通话:振铃、接听、转人工、挂断、排队、录音、话单;
- 处理媒体:电话音频的编码格式(G.711 等)和你的 ASR/TTS 用的 PCM 不一样,需要转码、重采样。
这一层就是软交换(Softswitch)------用软件实现的电话交换机。FreeSWITCH 就是最主流的开源软交换之一。
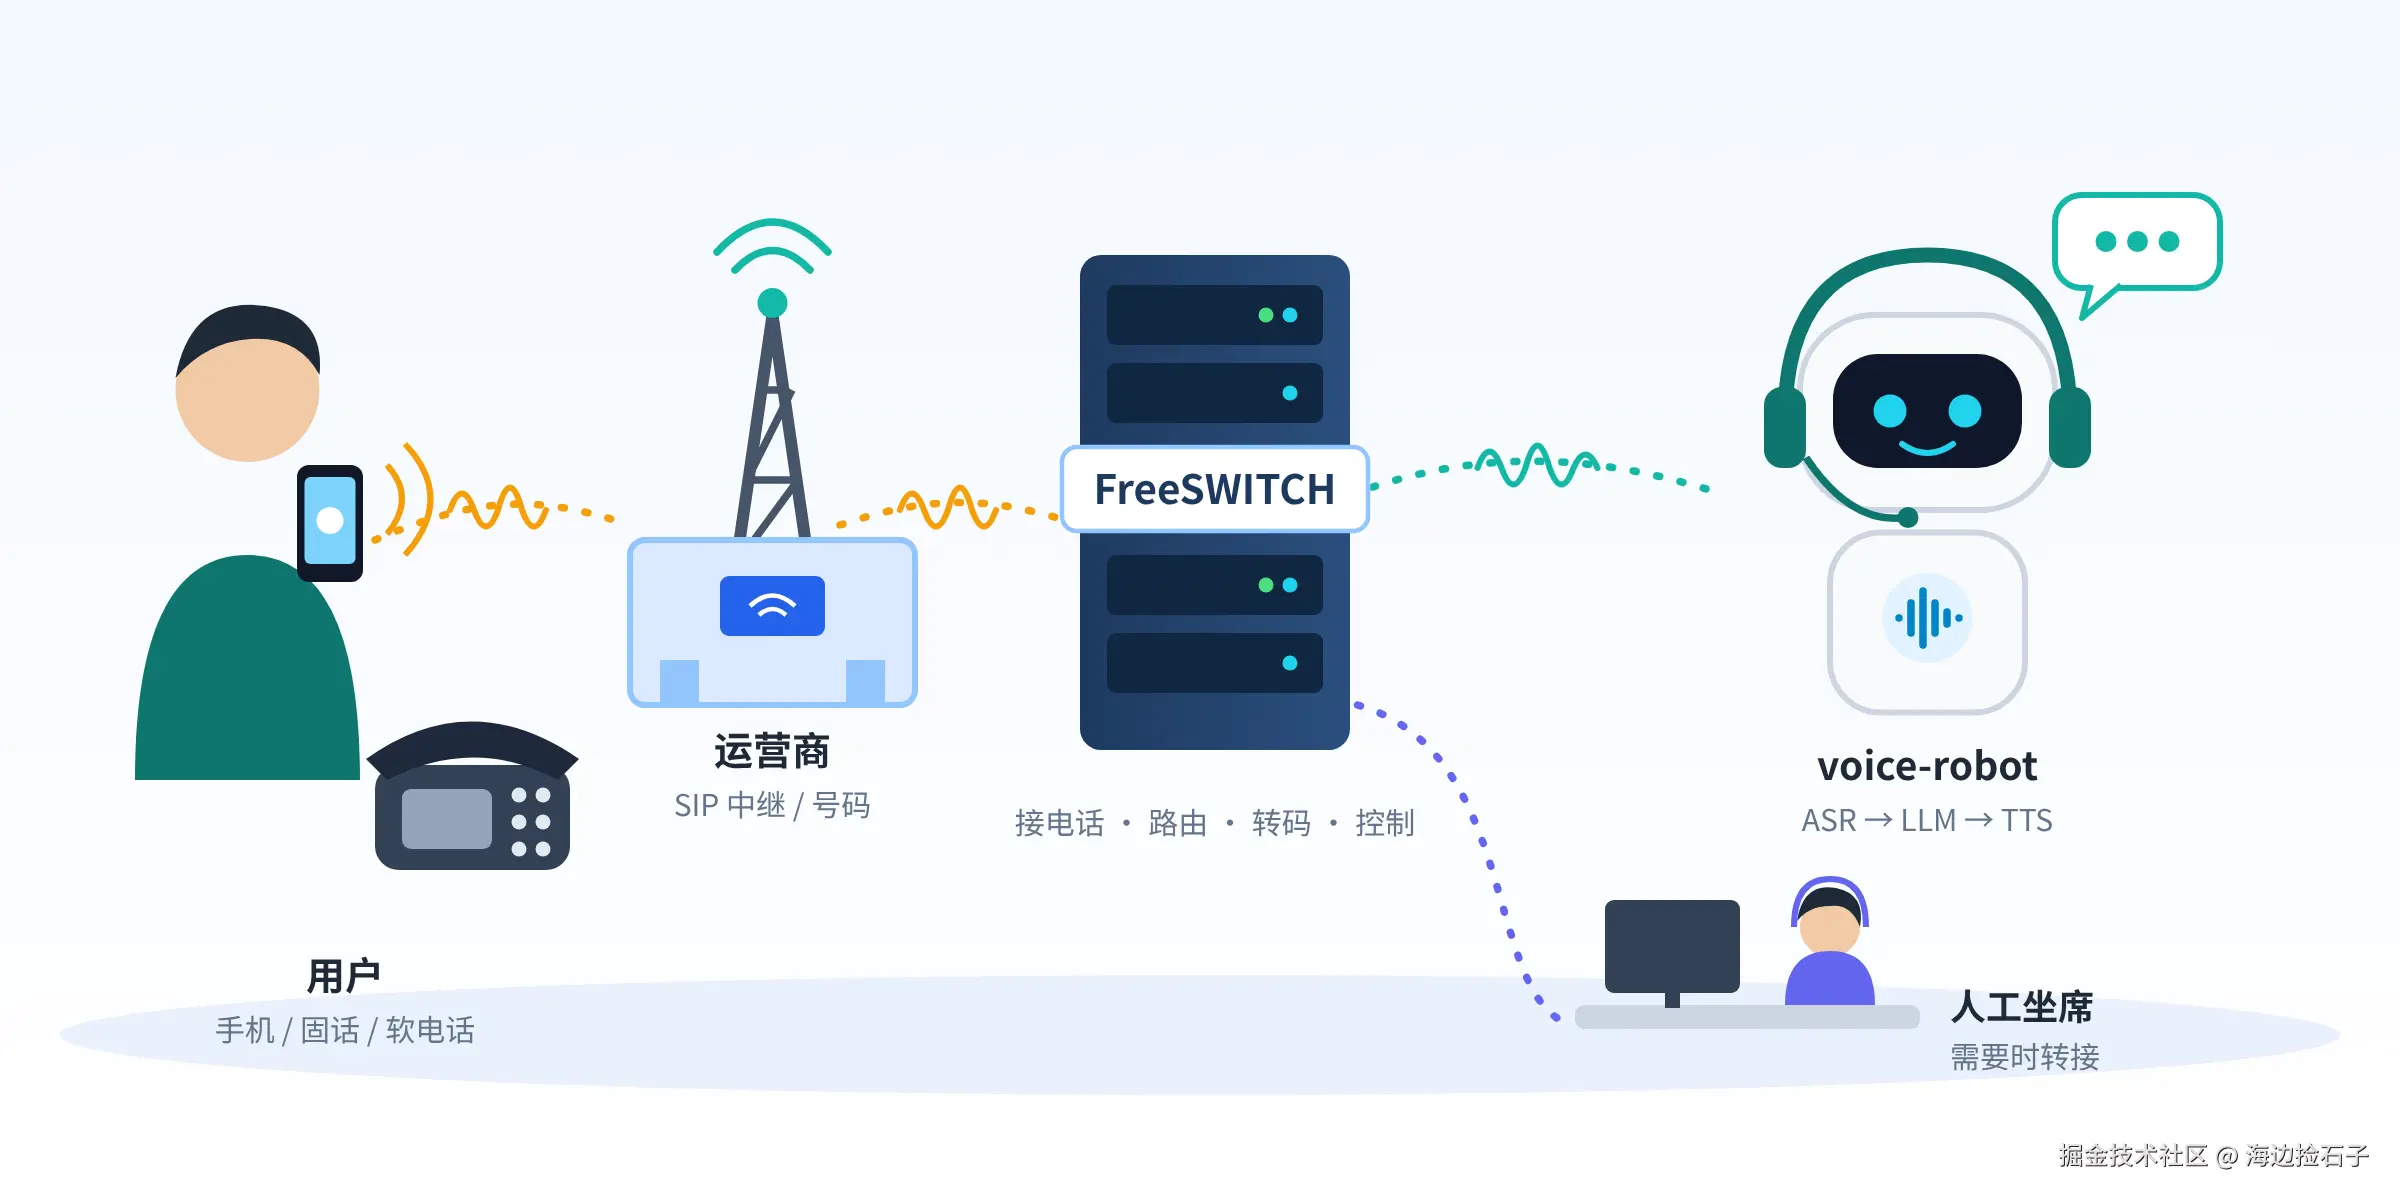
图 1 场景示意:用户的电话经运营商线路进入 FreeSWITCH,由 voice-robot 应答,需要时转给人工坐席
FreeSWITCH 是什么、能做什么
FreeSWITCH 是一个用 C 写的开源电话平台(MPL 协议),可以把它理解成**"电话界的 Nginx"**:它不关心你的业务,只负责把呼叫可靠地接进来、路由到该去的地方,并且把能力开放给外部程序来控制。它能做:
- 分机注册与互拨(企业内部电话)、对接运营商线路;
- IVR(按键导航,"查话费请按 1")、呼叫中心排队、会议;
- 录音、放音、转码、话单;
- 通过 ESL 让你用 Python/Go/Java 远程控制每一通电话------这正是接 AI 机器人的关键。
和 Asterisk 比一句:Asterisk 历史更久、生态更老牌;FreeSWITCH 从设计上就是多线程、模块化的,高并发下更稳,对外的事件/控制接口(ESL)也更适合"程序驱动通话",所以 AI 语音机器人项目里更常见。
2. 必须先搞懂的基础概念
电话领域术语多,但核心只有十来个。下面每个都配一个后端开发熟悉的类比。
2.1 SIP 与 RTP:信令 vs 媒体
一通 VoIP 电话其实是两条完全独立的"管道":
| SIP(会话初始协议) | RTP(实时传输协议) | |
|---|---|---|
| 干什么 | 信令:谁打给谁、振铃、接听、挂断 | 媒体:真正的声音数据 |
| 长什么样 | 文本协议,像 HTTP(INVITE、200 OK、BYE) |
二进制 UDP 包,每 20ms 一个 |
| 端口 | 通常 UDP/TCP 5060、5080 | 动态分配的 UDP 端口(FS 默认 16384--32768) |
| 类比 | 打电话前的"握手和协商" | 握手后真正流动的"数据流" |
SIP 里有一段叫 SDP(会话描述协议) 的内容,双方用它协商"声音发到哪个 IP:端口、用什么编码"。记住这一点,后面讲 NAT 时你就明白为什么会"能接通但没声音"。
几个常见 SIP 消息:REGISTER(分机上线报到)、INVITE(发起呼叫)、180 Ringing(振铃)、200 OK(接听)、ACK(确认)、BYE(挂断)。
下面这张图把一通 A 拨 B 的电话拆开看:上半部分是 SIP 信令,全部经过 FreeSWITCH 的 5060 端口;中间的 RTP 媒体走的是 SDP 里协商出来的另一组 UDP 端口;最后再由 SIP 的 BYE 收尾。
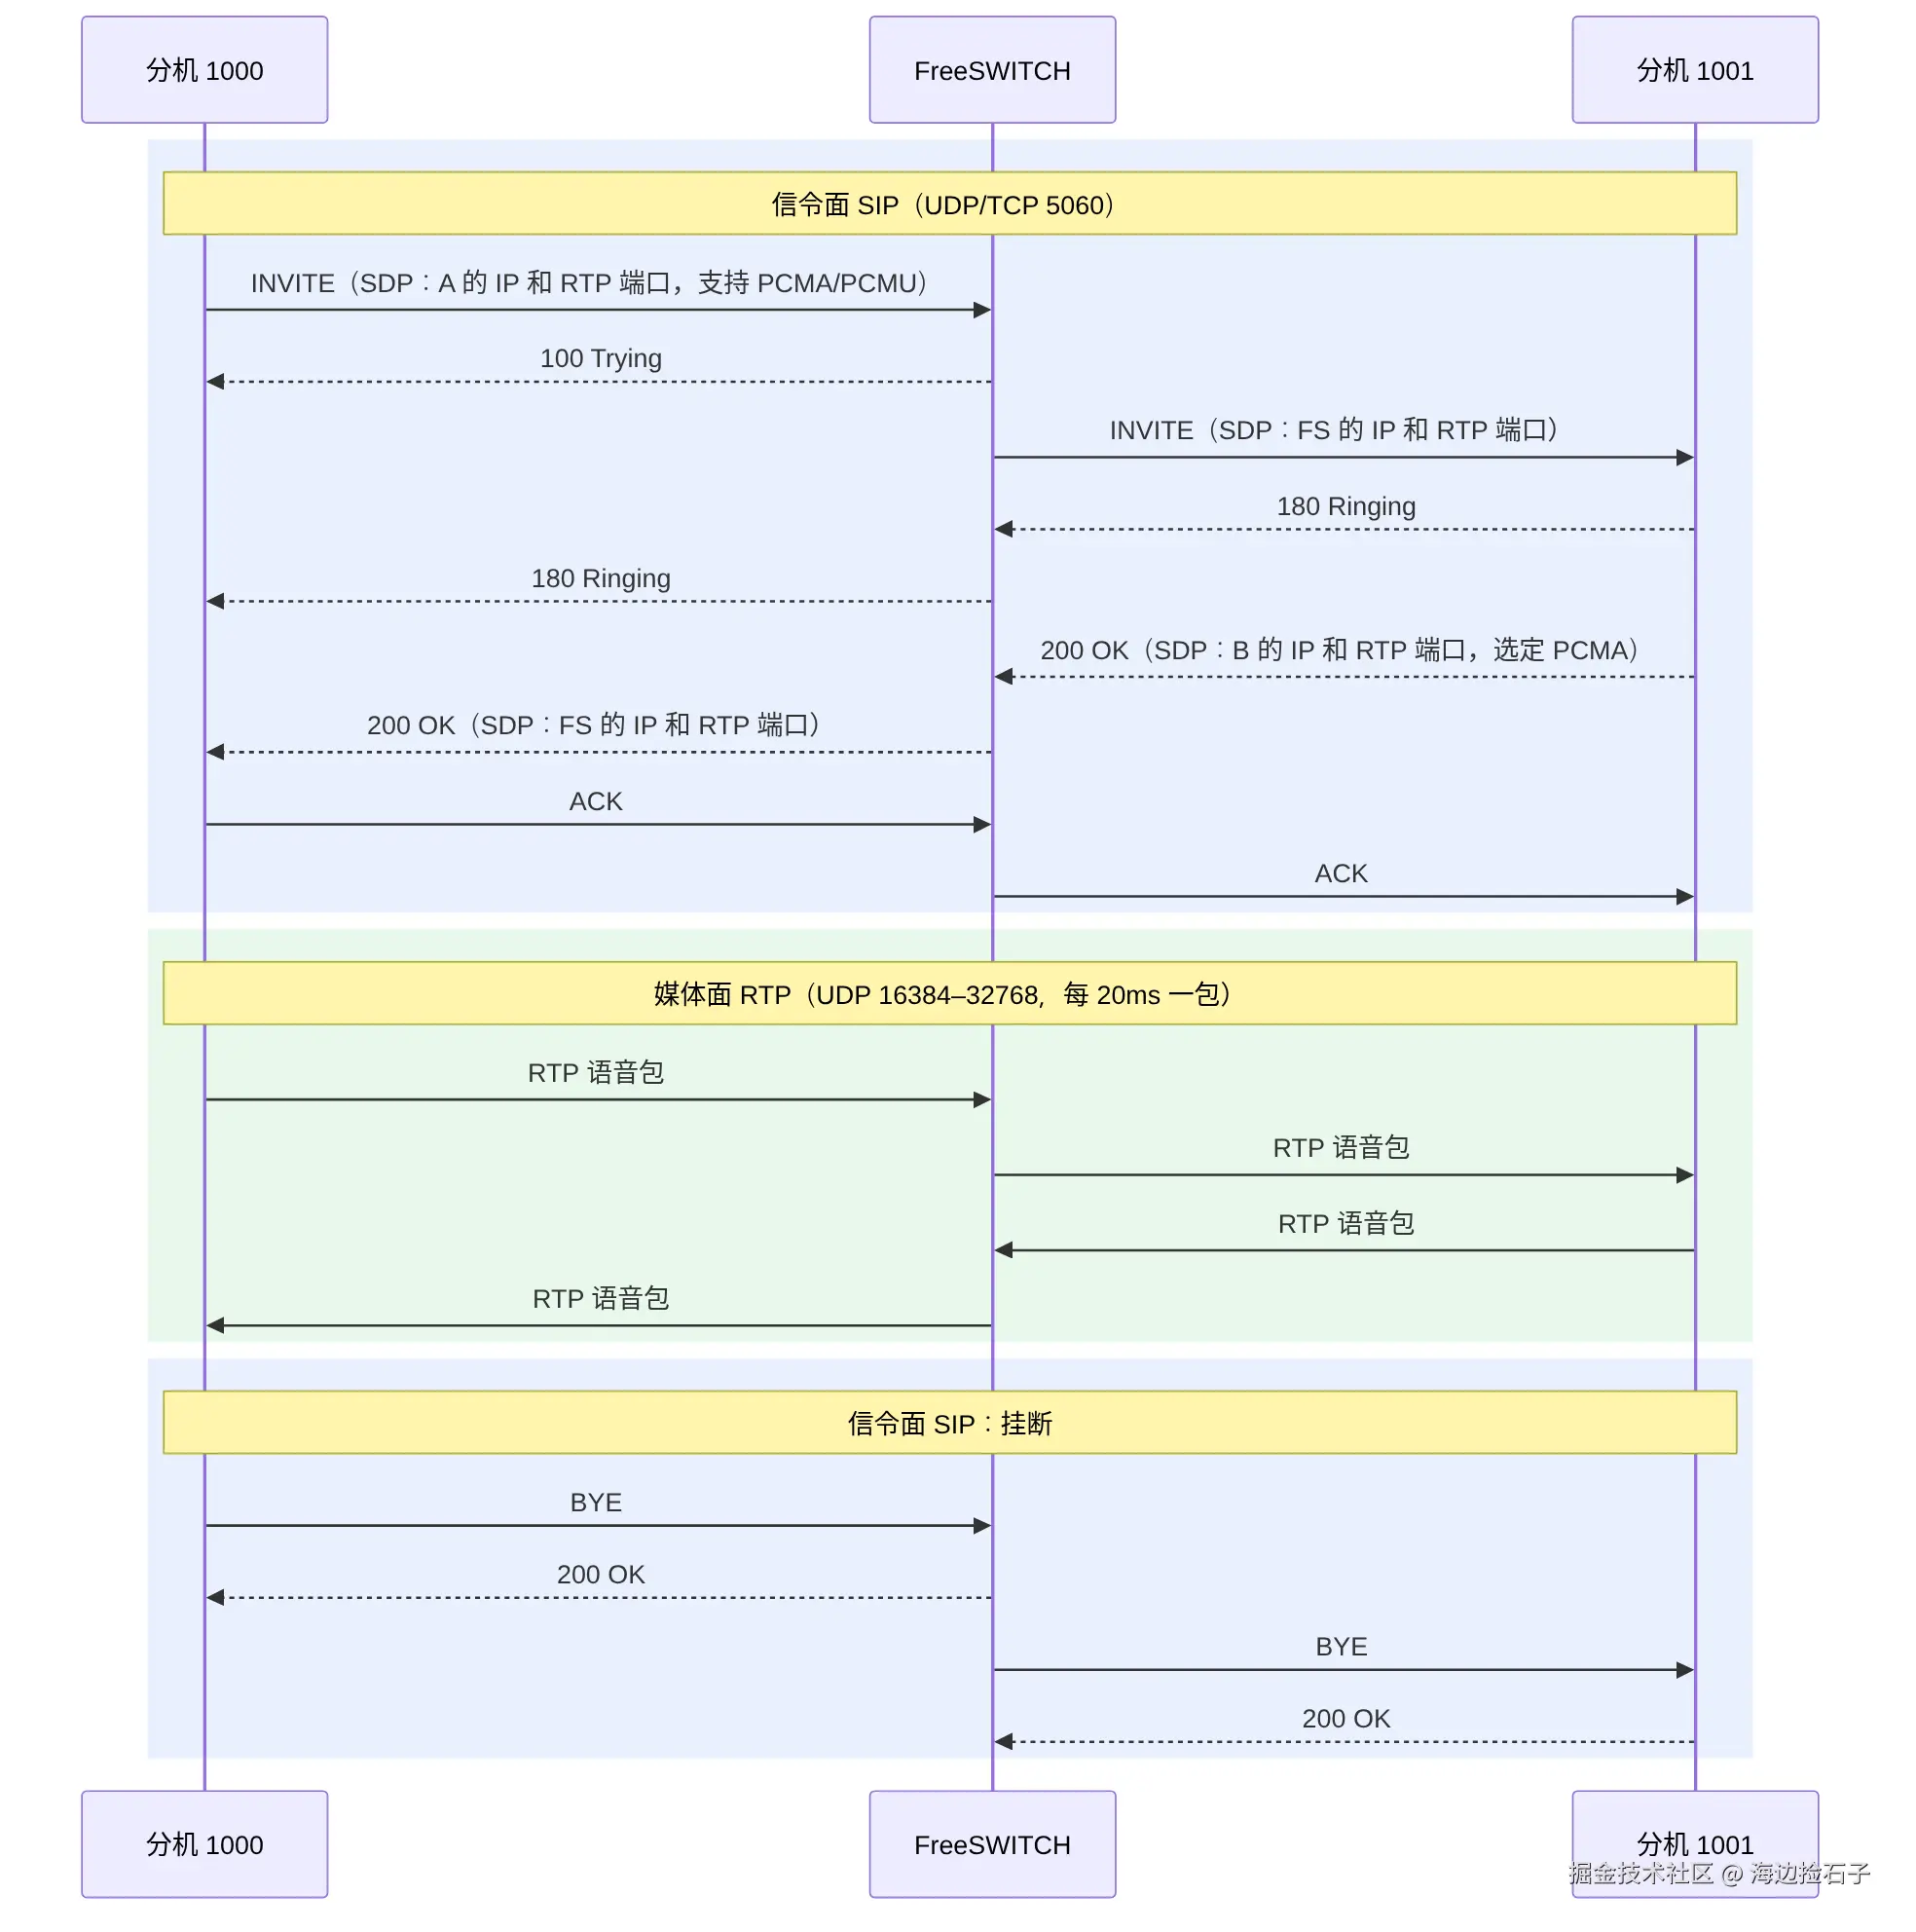
图 2 SIP 信令与 RTP 媒体分离:信令和媒体走不同的端口,甚至可以走不同的路径
2.2 注册与分机(user directory)
分机 就是一个 SIP 账号,比如 1000,配一个密码。软电话(如 Linphone、MicroSIP)用这个账号向 FreeSWITCH 发 REGISTER,相当于"登录",FS 就知道"1000 现在在 192.168.1.20 这台机器上",有人拨 1000 时就能找到它。
这些账号定义在 user directory(用户目录) 里,路径通常是 conf/directory/default/*.xml。默认安装自带 1000--1019 共 20 个分机,密码统一是 1234 (由 vars.xml 里的 default_password 决定)------这是上公网前必须改的第一件事。
2.3 Sofia 模块与 internal / external profile
FreeSWITCH 的功能都在模块里,负责 SIP 协议的模块叫 mod_sofia (基于 Sofia-SIP 协议栈)。一个 Sofia profile(配置档) 就是"一个监听着某个 IP:端口的 SIP 服务",默认有两个:
| profile | 默认端口 | 给谁用 | 是否要求认证 | 来电进入的 context |
|---|---|---|---|---|
| internal | 5060 | 内部分机(员工话机、软电话) | 要(分机账号密码) | default(认证后按分机的 user_context 走) |
| external | 5080 | 运营商线路、外部 SIP 服务 | 一般不要(靠 IP 白名单或网关注册) | public |
类比:一个 Web 服务开了两个端口,一个给登录用户用的后台,一个给外部回调用的开放接口,安全策略不同。
2.4 网关 / SIP 中继:接入真实电话线路
要打通手机和固话,你需要向运营商或云通信服务商申请 SIP 中继(SIP Trunk)------一条走 IP 网络的"电话线",通常会给你一个或一批号码(DID,直拨号码),外加账号、密码、服务器地址(或者只做 IP 对接)。
在 FreeSWITCH 里,一条中继配置成一个 gateway(网关) ,放在 sip_profiles/external/ 下,填上运营商给的账号、密码、服务器地址(proxy)以及是否注册(register)。之后外呼写成 sofia/gateway/<网关名>/<号码>。本地测试不需要中继,用 user/1001 呼叫本地分机即可,两者只是"拨号字符串"不同,其余逻辑完全一样。
2.5 拨号计划 dialplan:电话的"路由表"
一通电话进来后去哪里,由 dialplan(拨号计划) 决定。它就是电话版的 Nginx location / Web 框架路由:
- context(上下文) :一组路由规则的集合,类似"虚拟主机"。内部分机进
default,外线进public。这样隔离是为了安全:外部来电不能随便用你的线路往外打。 - extension(扩展) :一条路由规则,类似一个
location块。 - condition(条件) :匹配条件,最常用的是
field="destination_number"(被叫号码)配正则。 - action(动作) :条件命中后依次执行的"应用(application)",如
answer(接听)、playback(放音)、bridge(接通另一方)、park(挂起等待外部程序控制)、socket(交给外部程序)。
FreeSWITCH 的 XML 拨号计划分两个阶段,理解了这一点,很多"变量为什么没生效"的疑问就解开了:
- 查找(hunting)阶段 :在来电对应的 context 里,按文件和书写顺序逐个检查 extension 的 condition。条件命中,就把这个 extension 里的 action 收进"待执行列表"(条件不命中时,收进的是
anti-action)。默认命中第一个 extension 就停止查找,除非这个 extension 写了continue="true"。 - 执行(execute)阶段 :按顺序执行列表里的 action。所以查找阶段里
set的变量,要等到执行阶段才真正生效;如果后面的 condition 需要用到它,要给这个set加上inline="true"。
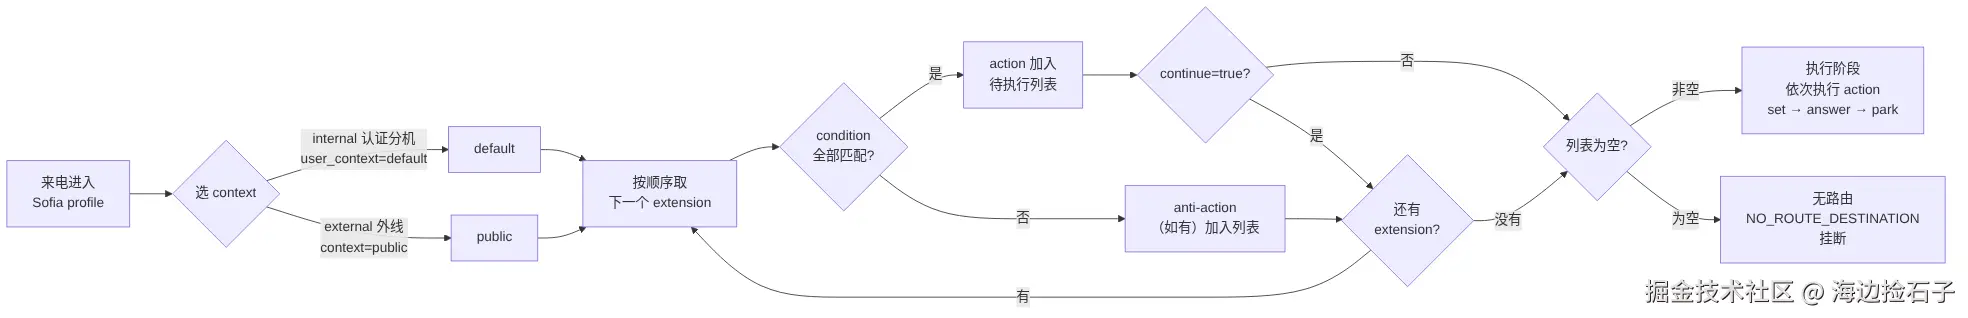
图 3 dialplan 匹配流程:context → extension → condition → action
2.6 Channel / Session / Call-ID / UUID
- Channel(通道):FS 里每一个"通话腿"就是一个 channel。A 拨 B,FS 内部其实是两条腿:A 腿(呼入 FS)和 B 腿(FS 呼出到 B),FS 在中间把它们**桥接(bridge)**起来。
- Session(会话):channel 在代码层面的载体,大多数时候你可以把两者当成一回事。
- UUID :FreeSWITCH 给每个 channel 分配的唯一 ID,几乎所有控制命令都以它为参数(
uuid_kill <uuid>、uuid_break <uuid>)。在机器人系统里,UUID 就是会话主键,对话历史、ASR 流、TTS 任务都挂在它下面。 - Call-ID :SIP 协议层的呼叫标识,由发起方生成,和运营商对账、抓包排错时用。FS 里对应通道变量
sip_call_id。注意它和 UUID 是两套东西。
每个 channel 从创建到销毁会经过一组固定的状态(channel state) ,show channels 的 state 列显示的就是它。主干如下:
| 状态 | 含义 | 相关事件 |
|---|---|---|
| CS_NEW → CS_INIT | 收到 INVITE 或 originate,创建并初始化通道 | CHANNEL_CREATE |
| CS_ROUTING | 在拨号计划里查找路由;transfer 后会回到这里 |
--- |
| CS_EXECUTE | 依次执行 action,answer、park、bridge 都在这一步执行 |
CHANNEL_ANSWER |
| CS_EXCHANGE_MEDIA | 作为被桥接的一条腿收发媒体(如 bridge 的 B 腿) | CHANNEL_BRIDGE |
| CS_HANGUP | 挂断 | CHANNEL_HANGUP |
| CS_REPORTING | 汇总通道变量,用于写话单 | CHANNEL_HANGUP_COMPLETE |
| CS_DESTROY | 释放资源 | CHANNEL_DESTROY |
注意两点:接听不是一个 channel state ,它属于另一套"呼叫状态"(Channel-Call-State:DOWN → RINGING/EARLY → ACTIVE → HANGUP);拨号计划里 park 住的通道仍显示 CS_EXECUTE,只有 uuid_park 停住的通道才进入 CS_PARK。
2.7 编解码:PCMU / PCMA / Opus 与 8k 采样率
codec(编解码器) 决定声音怎么压缩成字节:
| 编码 | 采样率 | 码率 | 说明 |
|---|---|---|---|
| PCMU(G.711 μ-law) | 8 kHz | 64 kbps | 北美/日本常用,几乎所有设备都支持 |
| PCMA(G.711 A-law) | 8 kHz | 64 kbps | 中国、欧洲运营商线路最常见 |
| Opus | 8--48 kHz | 6--510 kbps | 现代宽带编码,WebRTC 默认,音质好 |
关键结论:传统电话网是 8 kHz 窄带音频 ,带宽只到约 3.4 kHz。而多数 ASR 模型按 16 kHz 训练,TTS 常输出 16k/24k。所以链路中一定有重采样这一步------要么让 FreeSWITCH 或媒体模块做,要么在 voice-robot 里做,后面会具体讲。
2.8 NAT 与 ext-rtp-ip / ext-sip-ip
云服务器通常只有内网 IP,公网 IP 是通过 NAT(网络地址转换) 映射过来的。如果 FS 在 SDP 里告诉对方"声音发到 172.16.x.x",对方当然发不过来------结果就是经典的**"能接通、没声音"或"单通"(只有一方能听见)**。
解决办法是在 Sofia profile 里设置对外宣告的地址:
ext-sip-ip:SIP 信令里对外宣告的 IP;ext-rtp-ip:SDP 里对外宣告的媒体 IP。
默认它们引用 vars.xml 中通过 STUN 探测出来的 external_sip_ip / external_rtp_ip。云服务器上建议直接写死公网 IP,并在安全组放行 SIP 端口和 RTP 端口段。
2.9 ESL:用程序遥控电话
ESL(Event Socket Library,事件套接字) 由 mod_event_socket 提供,是一个基于 TCP 的文本协议。通过它你可以:发命令 (接听、放音、转接、挂断、外呼)和收事件(振铃了、接通了、挂断了、按键了)。它有两种模式,"in/out" 是站在 FreeSWITCH 的角度说的:
| inbound 模式 | outbound 模式 | |
|---|---|---|
| 谁连谁 | 你的程序 → FS 的 8021 端口 | FS → 你的程序(端口自定,如 8040) |
| 连接数 | 一条长连接管全局 | 每通电话一条连接 |
| 类比 | 客户端连数据库 | Nginx 反向代理到后端 |
| 适合 | 外呼、全局监控、话单、控制中心 | 逐通电话的顺序流程(IVR 脚本) |
本文的示例用 inbound:一个常驻的"控制服务"订阅全局事件,管所有电话。
重要:ESL 只传命令和事件,不传声音。声音要另外走一条路。
2.10 mod_audio_fork / WebSocket 音频流
要把通话的实时音频交给 voice-robot,需要一个"媒体分叉"模块:它在通道上挂一个 media bug(媒体钩子) ,把音频复制一份,转成 L16(16 位线性 PCM) ,通过 WebSocket 推给你的服务。
社区里常用的是 mod_audio_fork (来自 drachtio-freeswitch-modules 项目,另有若干社区分支)和 mod_audio_stream(amigniter/mod_audio_stream)。需要如实说明:
- 它们都是第三方模块,不在 FreeSWITCH 官方发行版里 ,需要自己拿源码、装好 libwebsockets 等依赖后单独编译,再在
modules.conf.xml里加载; - 不同分支的命令参数和能力有差异,尤其是"机器人把音频回传给 FS 播放"这部分。上线前请对照你实际编译的那份源码,确认命令参数和事件名。
本文以 mod_audio_fork 的经典用法为例,它提供 API 命令 uuid_audio_fork。
把这一节的概念拼起来,就是下面这张图:FreeSWITCH 本身是一个核心,SIP、拨号计划、ESL、音频流、话单都是插在核心上的模块。
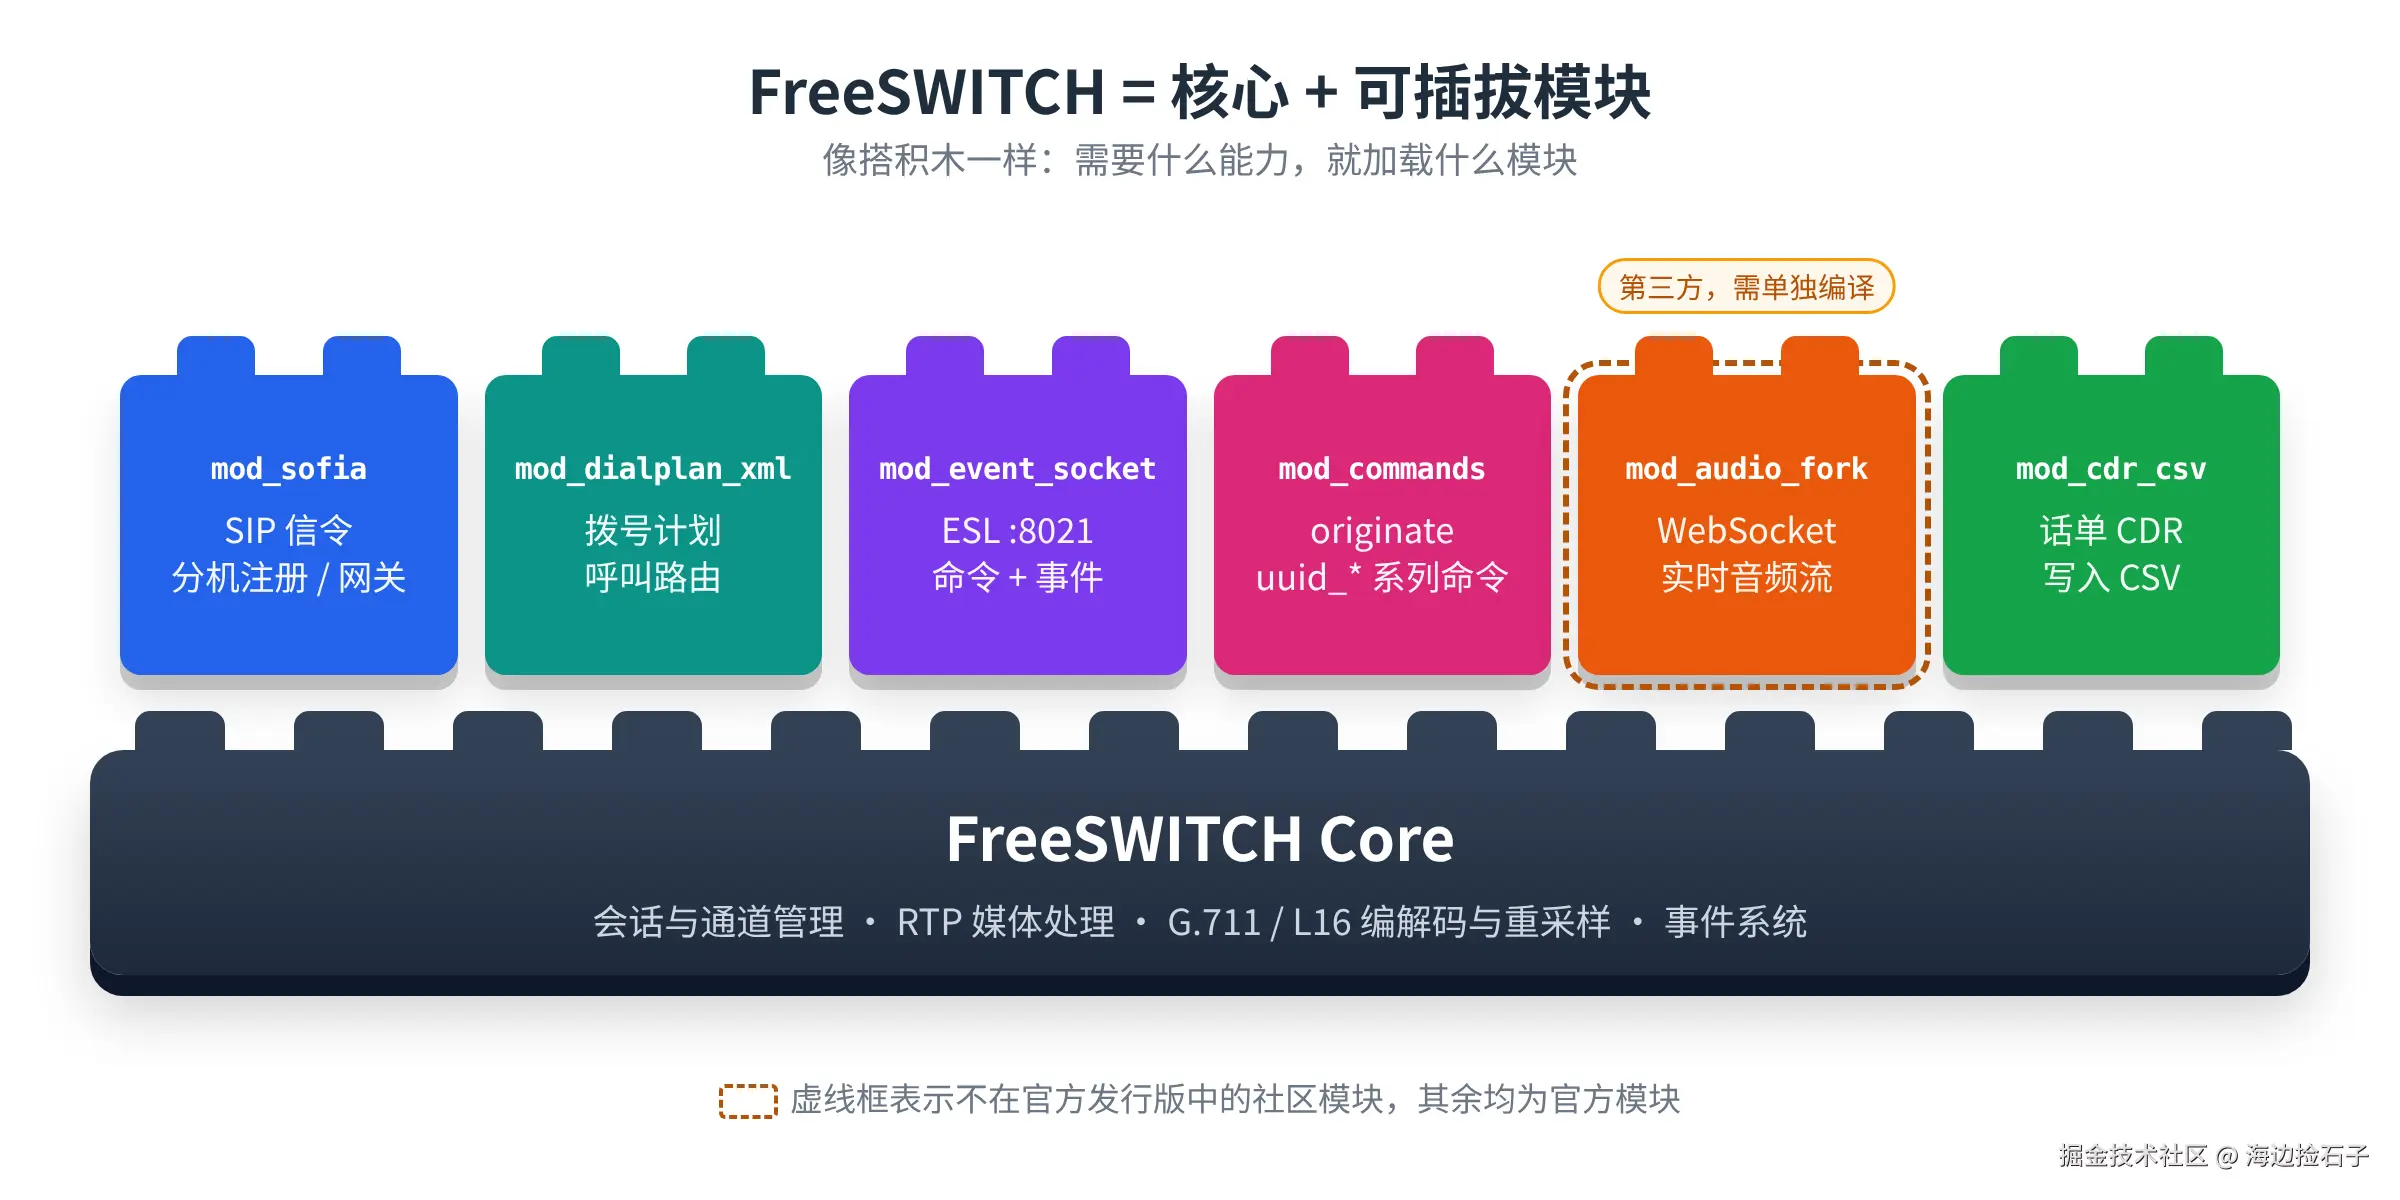
图 4 FreeSWITCH 模块组成:核心之上按需加载 mod_sofia、mod_dialplan_xml、mod_event_socket、mod_commands、mod_audio_fork(第三方)、mod_cdr_csv
3. 整体架构
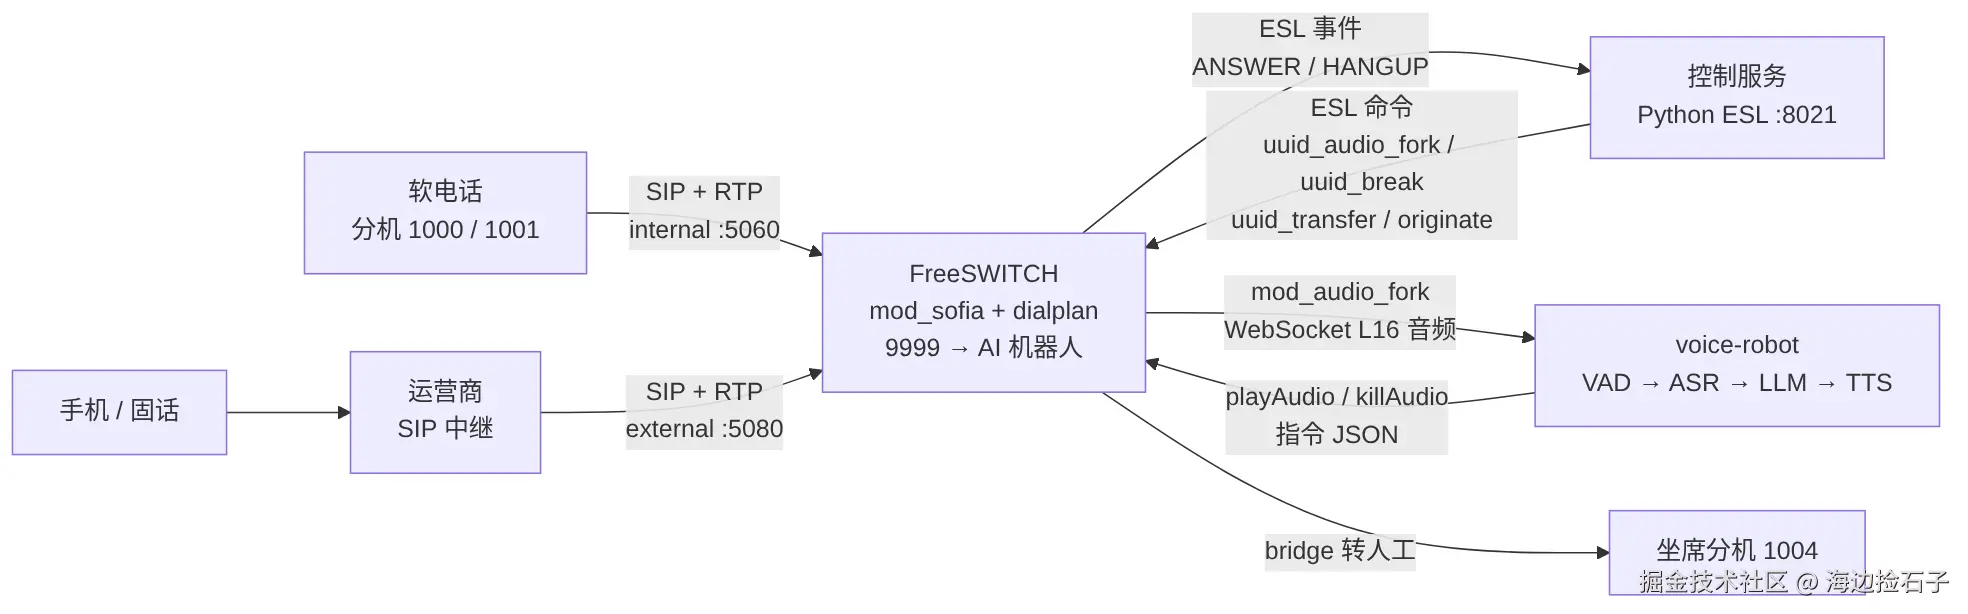
图 5 整体架构:电话接入、ESL 控制与 WebSocket 音频流
分工一句话:FreeSWITCH 管电话,控制服务(ESL)管"这通电话下一步干什么",voice-robot 管"听懂并回答"。控制面和媒体面分开,各自可以独立扩容、独立重启。
4. 核心流程:一通 AI 电话的一生
4.1 呼入流程
- INVITE :用户拨 9999(或拨打运营商号码,中继把呼叫送进 external profile)。FS 回
100 Trying,为这条腿创建 channel,分配 UUID。 - 拨号计划匹配 :在对应 context 中找到
destination_number为9999的 extension,开始执行 action。 - answer :接听,FS 回
200 OK,RTP 开始流动。FS 发出CHANNEL_ANSWER事件。之后执行park,让通道"停着"等控制服务指挥。 - 把音频转给机器人 :控制服务收到
CHANNEL_ANSWER,看到通道变量ai_bot=true,执行uuid_audio_fork <uuid> start ws://... mono 16k {...}。FS 主动连到 voice-robot 的 WebSocket,先发一帧 JSON 元数据,之后持续发二进制音频帧。 - ASR → LLM → TTS :voice-robot 做 VAD 断句、流式识别,把一句话交给 LLM,回复按句切分送进 TTS。合成的音频通过 WebSocket 发回(
playAudio),或者落盘后由控制服务用uuid_broadcast播放。 - 打断(barge-in) :机器人说话期间音频流不停 ,ASR 一直在听。一旦检测到用户开口(且不是回声),立刻停止放音(
uuid_break <uuid> all或发killAudio),并取消正在生成的 LLM/TTS 任务。 - 转人工(bridge) :LLM 判断需要人工(或者用户说"转人工"),voice-robot 通知控制服务;控制服务先停掉音频流,再
uuid_transfer到坐席分机 1004,由拨号计划执行bridge user/1004,把用户和坐席接通。 - 挂断与话单(CDR) :任何一方挂机,FS 发出
BYE,最后抛出CHANNEL_HANGUP_COMPLETE事件,里面带着完整的通道变量(开始/接听/结束时间、挂断原因等)。控制服务据此写话单、清理该 UUID 的会话状态。
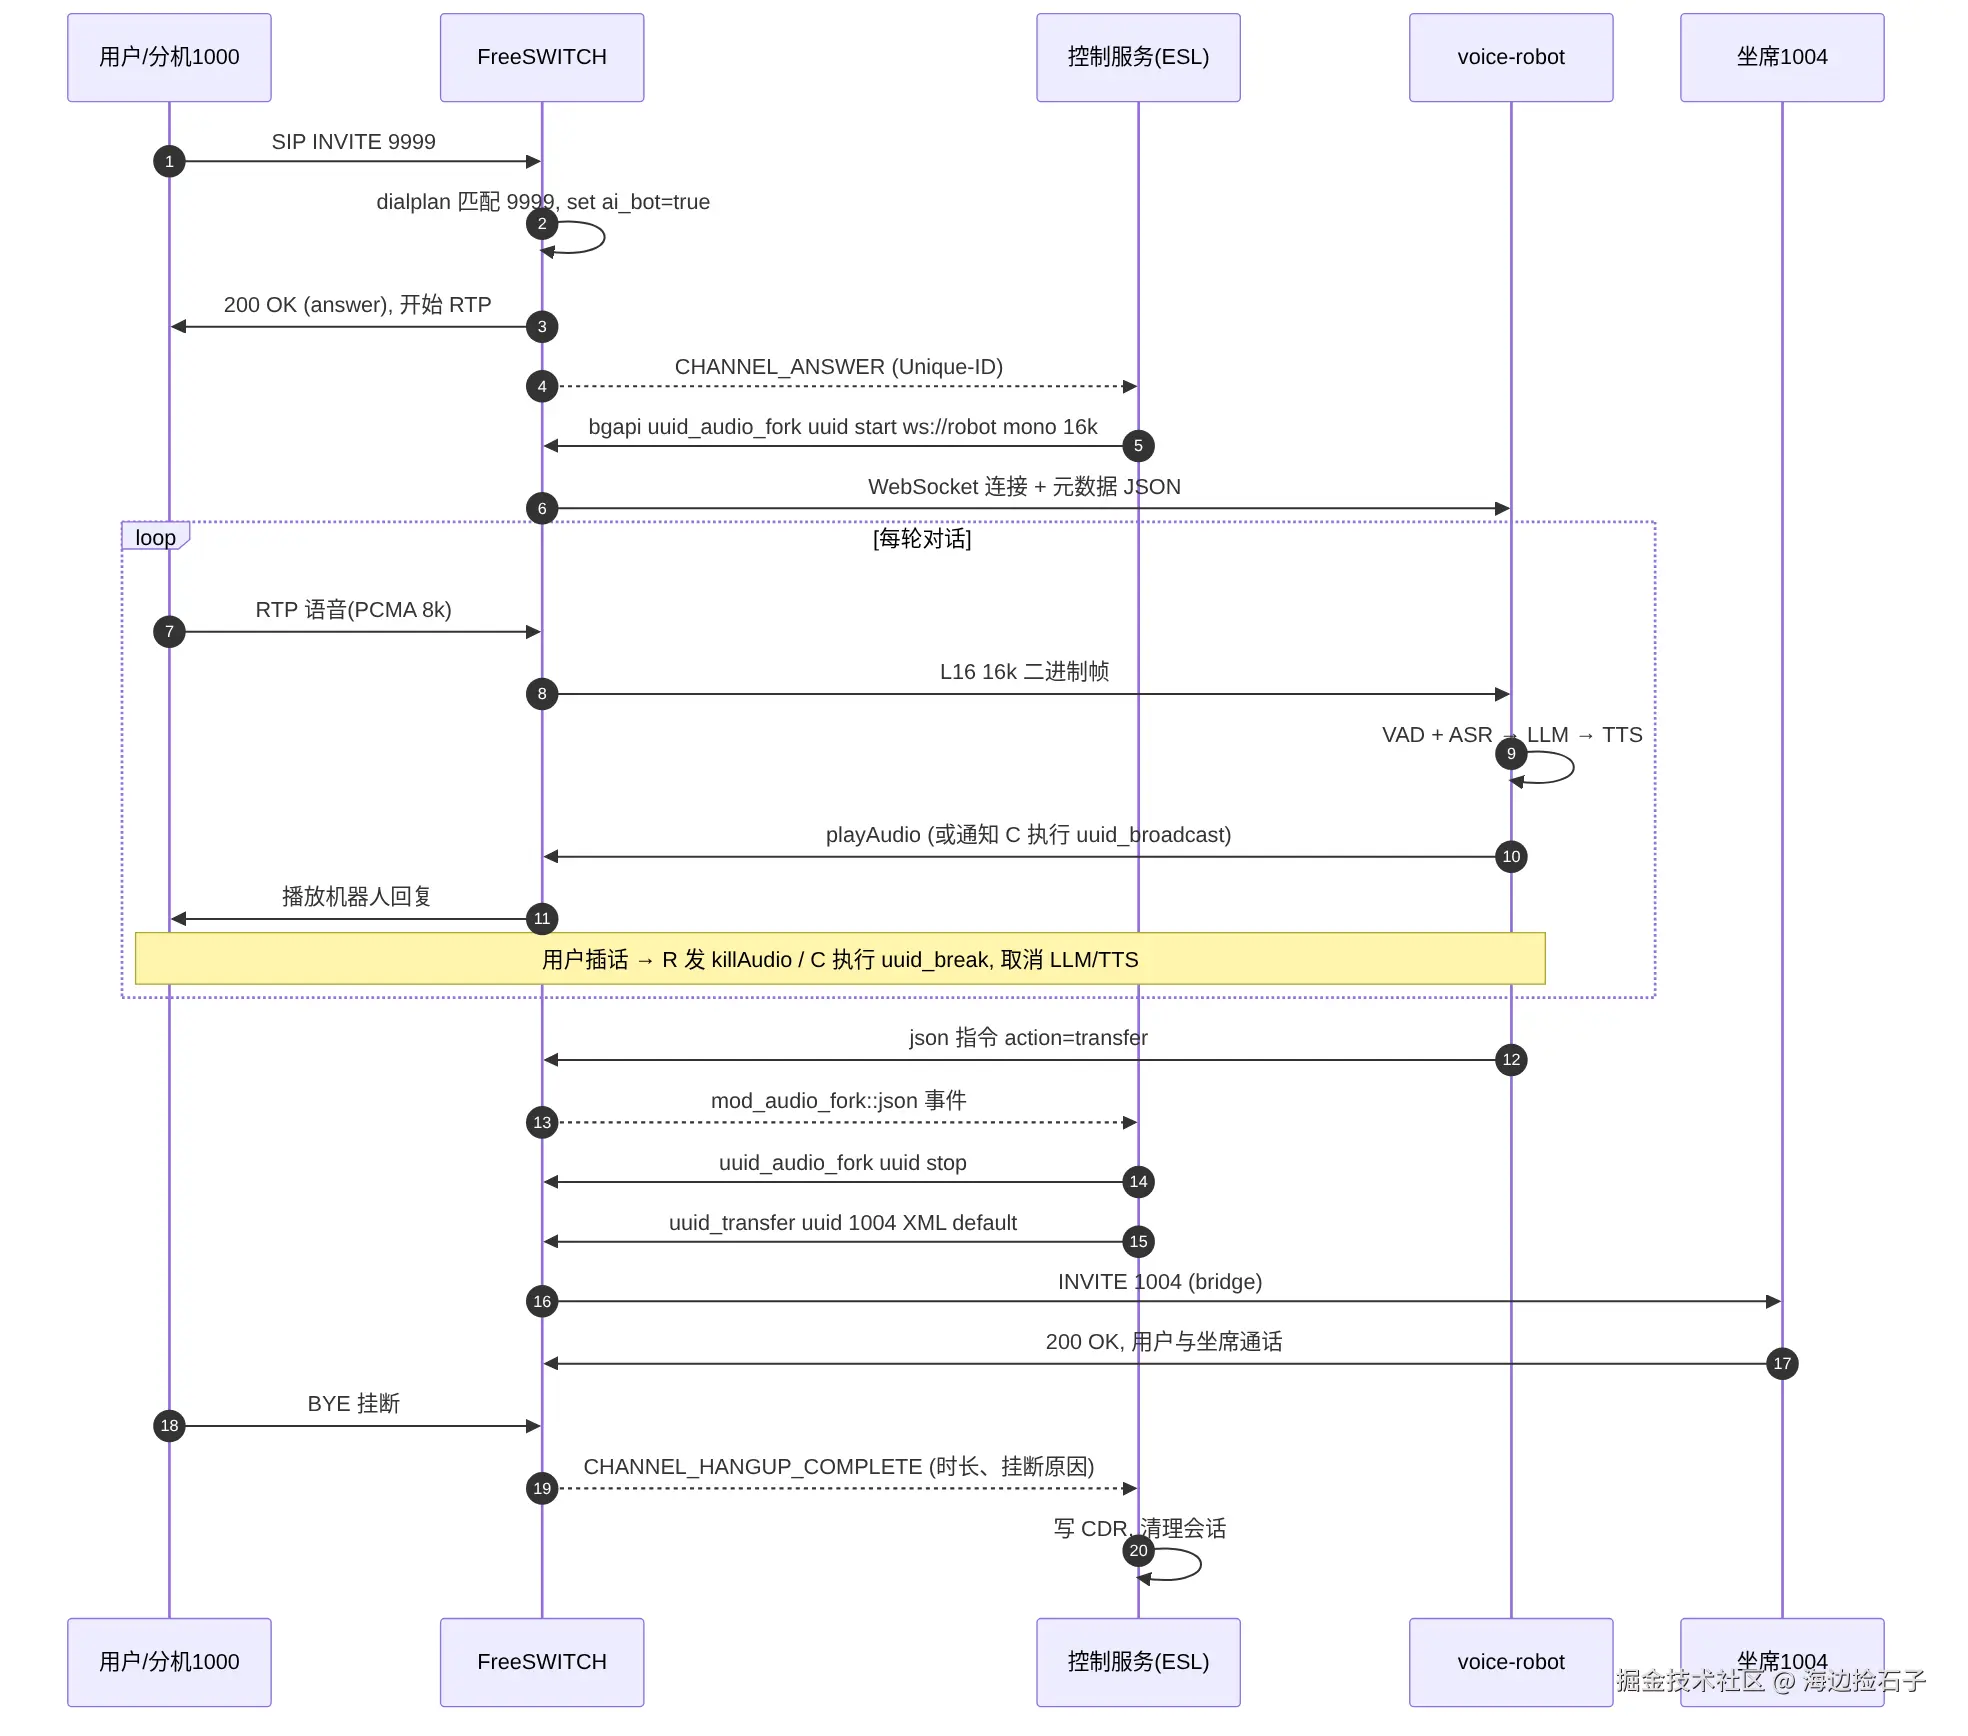
图 6 一通 AI 呼入电话的完整时序:从 INVITE 到写话单
4.2 呼出流程(originate)
外呼回访、催缴、通知类场景是机器人主动打出去 ,核心命令是 originate(完整写法见 5.2):
{}里是只作用于这一路的通道变量 :ai_bot=true打标记,origination_caller_id_number是主叫号码(必须是运营商允许你使用的号码),originate_timeout是振铃超时秒数;- 中间是拨号字符串 :真实线路用
sofia/gateway/carrier1/<号码>,本地测试用user/1001; - 末尾的
&park()表示对方接听后先"停住",等控制服务接管。
接下来的流程和呼入一样:对方接听 → CHANNEL_ANSWER(带 variable_ai_bot=true)→ 开始音频流 → 对话 → 挂断写话单。在 ESL 里用 bgapi originate ... 异步执行,结果通过 BACKGROUND_JOB 事件返回,失败时可以看到 -ERR NO_ANSWER、-ERR USER_BUSY 之类的原因。
外呼要额外注意:接通不等于是真人。有可能是彩铃、语音信箱、"您拨打的电话已关机"的运营商提示音,机器人开场前最好等用户先出声,或者做一个简单的应答检测。
5. 最小实操:用自部署 FreeSWITCH 跑通
环境:一台 Linux 服务器上自部署的 FreeSWITCH,默认配置。分机 1000 是测试用户(拨 9999 体验机器人),1001 是外呼测试对象,1004 是人工坐席。先给这三个分机改掉默认密码,再用软电话分别注册上去。
5.1 dialplan:拨 9999 进 AI 机器人
在 dialplan/default/ 下新建 01_ai_robot.xml,保存后在 fs_cli 里执行 reloadxml:
xml
<extension name="ai_robot">
  <condition field="destination_number" expression="^9999$">
    <action application="set" data="ai_bot=true"/>
    <action application="answer"/>
    <action application="park"/>
  </condition>
</extension>
ai_bot=true 是给控制服务看的标记,park 让通道停住等 ESL 指挥。转人工的 1004 不用另外配置,默认的 Local_Extension 规则会对 10xx 分机执行 bridge。运营商号码打进来时,在 public context 里用 transfer 把它转到 9999 XML default 即可。
5.2 fs_cli 常用命令
fs_cli 是 FreeSWITCH 自带的命令行客户端,最常用的就这几条:
text
sofia status profile internal reg        # 哪些分机注册上来了
show channels                            # 当前所有通道
originate {ai_bot=true}user/1001 &park() # 让机器人外呼 1001(真实线路换成 sofia/gateway/carrier1/<号码>)
uuid_break <uuid> all                    # 停止放音(打断)
uuid_transfer <uuid> 1004 XML default    # 转人工
5.3 控制服务(ESL)伪代码
控制服务用 inbound 模式连 8021,Python 可以选 greenswitch 或 python-ESL。逻辑如下:
text
连接 ESL(127.0.0.1:8021, 密码);断线后指数退避重连,重连后重新订阅
订阅 CHANNEL_ANSWER、CHANNEL_HANGUP_COMPLETE、CUSTOM mod_audio_fork::json

on CHANNEL_ANSWER(ev):
    if ev.variable_ai_bot != "true": return
    bgapi "uuid_audio_fork {uuid} start ws://127.0.0.1:9000/fs mono 16k {meta}"

on mod_audio_fork::json(ev):            # voice-robot 发来的指令
    barge_in → api "uuid_break {uuid} all"
    transfer → api "uuid_audio_fork {uuid} stop"; api "uuid_transfer {uuid} 1004 XML default"
    hangup   → api "uuid_kill {uuid}"

on CHANNEL_HANGUP_COMPLETE(ev):
    写 CDR(字段见 6.7);清理该 uuid 的会话状态
两点提醒:mod_audio_fork 各版本的 start 参数顺序不同,有的分支在采样率后面多了 bugname 参数,务必按你编译的版本调整;机器人回传音频的方式也因版本而异,经典版收到 playAudio 后只落成临时文件、抛出 mod_audio_fork::play_audio 事件,需要控制服务再用 uuid_broadcast 播放。
5.4 voice-robot 侧伪代码
mod_audio_fork 连上 WebSocket 后,先发一帧文本(元数据 JSON),之后是二进制帧:16 位、小端、单声道 PCM,采样率就是 start 里指定的 16k。
text
ws_server(127.0.0.1:9000, subprotocol="audiostream.drachtio.org")
on connect: meta = 第一帧 JSON;session = RobotSession(meta.uuid)

for frame in ws:                              # 每帧 L16 16k PCM
    if session.speaking and vad.user_speaking_confirmed(frame):
        session.cancel_llm_tts()              # 打断
        ws.send({"type": "killAudio"}); ws.send({"type": "json", "action": "barge_in"})
    text = asr.feed(frame)
    if vad.end_of_utterance and text:
        if intent(text) == 转人工: ws.send({"type": "json", "action": "transfer"}); break
        for sentence in llm.stream(text):     # 流式 LLM,按句送 TTS
            pcm = resample(tts(sentence), tts_rate → 8000)
            ws.send({"type": "playAudio", "data": {"audioContentType": "raw",
                     "sampleRate": 8000, "audioContent": base64(pcm)}})
on close: session.close()
重采样提示:推流直接用 16k,模块会从 8k 升采样,但这样做并不会多出信息,选支持 8k 电话场景的 ASR 往往效果更好;TTS 常输出 16k/24k,回传前降到 8k,能省掉 FS 的一次转码。
6. 生产注意事项
6.1 延迟预算
电话里沉默超过 1.5 秒,用户就会"喂?喂?"。下面是一个经验性的预算拆分(数值随厂商、网络差异很大,只是量级估算):
| 环节 | 典型耗时 | 优化手段 |
|---|---|---|
| 网络 + 抖动缓冲 | 50--150 ms | FS 与 voice-robot 同机或同内网 |
| VAD 判断"说完了" | 300--700 ms | 调尾部静音阈值;结合语义判断说完 |
| ASR 出最终结果 | 100--300 ms | 流式 ASR,边说边识别 |
| LLM 首 token | 200--800 ms | 流式输出、短 system prompt、就近部署 |
| TTS 首包 | 100--300 ms | 流式 TTS、按句合成、首句优先 |
| 回放链路 | 50--100 ms | 减少落盘和转码 |
目标是用户说完到听到第一个字控制在 1--1.5 秒内。等用户时可以先播一句很短的"好的""稍等"来填补空白,但别滥用。
6.2 回声与打断
- 用
mono只推用户声道,避免 ASR 听到机器人自己的声音; - 用户用免提时,机器人的声音会通过对方的话筒"漏"回来,被误判成插话。打断条件不要太敏感:要求持续语音几百毫秒,或者出现有意义的识别文字再打断;
- 打断要做彻底:停止放音(
uuid_break <uuid> all)、取消 LLM 生成、清空 TTS 队列,并把"机器人说到一半被打断"写进对话历史,让 LLM 知道用户没听完。
6.3 编解码与采样率
- 运营商线路国内多是 PCMA。在
vars.xml里设置global_codec_prefs/outbound_codec_prefs时,把线路支持的编码放进去,减少转码; - 一条链路里尽量只做必要的重采样,每多一次转换就多一点延迟和音质损失;
- 用
uuid_dump <uuid>查看read_codec、write_codec,确认实际协商出来的编码。
6.4 并发与资源
- FreeSWITCH 本身处理几百路 G.711 通话压力不大,转码(尤其 Opus)和录音才是 CPU/磁盘大户;
- 真正的瓶颈通常在 AI 侧:每路通话占一个流式 ASR 连接、一个 LLM 会话、一个 TTS 流。要按路数做压测,并为 ASR/TTS 服务配置并发上限;
- 在
switch.conf.xml里调整max-sessions、sessions-per-second,在系统层调大文件描述符上限; - RTP 端口段要够用(每路通话占用若干 UDP 端口),安全组要整段放行。
6.5 ESL 断线重连
- 控制服务重启或网络抖动时,ESL 连接会断。要像示例里那样指数退避重连 ,重连成功后重新订阅事件;
- 断线期间发生的事件会丢失。重连后用
show channels对账:哪些机器人通话还在、哪些已经挂了,修正内存/Redis 里的会话状态,补写缺失的话单; - 订阅
HEARTBEAT事件(FS 默认每 20 秒一次)做看门狗,长时间收不到就主动断开重连; - 关键:控制服务挂了不应导致通话立刻异常 。通道在
park状态会一直停着,所以要有兜底:比如在拨号计划中设置超时挂断,或者重连后对"无人认领"的通话播放致歉语后转人工。
6.6 安全
FreeSWITCH 上公网后几分钟内就会被 SIP 扫描器盯上(日志里常见 friendly-scanner、sipvicious 等 User-Agent),被盗打一晚上可能就是一大笔话费。最低限度要做到:
- 改默认密码 :
vars.xml的default_password(默认1234),并给每个分机设独立强密码;event_socket.conf.xml的 ESL 密码(默认ClueCon); - ESL 只监听本机 :
listen-ip设为127.0.0.1(部分版本默认是::,即所有网卡),配合apply-inbound-acl;远程调试走 SSH 隧道; - ACL 白名单 :在
acl.conf.xml里定义运营商 IP 段,external profile 只接受这些来源;internal profile 也可以限制来源网段; - fail2ban :在 Sofia profile 里打开
log-auth-failures,让 fail2ban 监控 FS 日志里的认证失败,自动封禁暴力破解的 IP; - dialplan 隔离 :
publiccontext 里绝不能出现直接桥接到网关的规则,否则任何人都能借你的线路打国际长途; - 改掉默认的 SIP 端口能挡掉一部分扫描,但只是"降噪",不能替代以上措施;
- voice-robot 的 WebSocket 服务也只监听本机或内网。
6.7 录音与 CDR
录音 :用 record_session 录整通电话,RECORD_STEREO=true 时双方分别在左右声道,方便质检和 ASR 回放分析。注意录音前要按当地法规告知用户("本次通话可能会被录音"),并制定保存期限。
CDR(Call Detail Record,话单) :FS 自带 mod_cdr_csv(默认写到日志目录下的 cdr-csv/)、mod_xml_cdr(可以 POST 到你的 HTTP 接口)等模块;也可以像示例那样在 CHANNEL_HANGUP_COMPLETE 事件里自己写库。建议记录的字段:
| 字段 | 取值位置(事件头 / 通道变量) | 用途 |
|---|---|---|
| UUID | Unique-ID |
会话主键,关联对话日志 |
| SIP Call-ID | variable_sip_call_id |
与运营商对账、抓包 |
| 主叫 / 被叫 | Caller-Caller-ID-Number / Caller-Destination-Number |
统计与回拨 |
| 方向 | Call-Direction |
呼入 / 呼出 |
| 开始 / 接听 / 结束时间 | variable_start_stamp / answer_stamp / end_stamp |
时长计算 |
| 通话时长 / 计费时长 | variable_duration / variable_billsec |
计费 |
| 挂断原因 | Hangup-Cause、variable_sip_term_status |
分析失败原因(如 USER_BUSY、NO_ANSWER) |
| 谁先挂 | variable_sip_hangup_disposition |
用户挂断还是系统挂断 |
| 编码 | variable_read_codec |
排查音质 |
| 录音路径 | 自定义变量 | 质检回放 |
| 业务字段 | 自定义变量,如意图、是否转人工、坐席 ID、对话轮数 | 运营分析 |
7. 总结与下一步
回顾一下整条链路:SIP 管"打电话",RTP 管"传声音";dialplan 决定电话去哪;ESL 让程序遥控电话;mod_audio_fork 把声音用 WebSocket 交给 voice-robot;voice-robot 用 ASR→LLM→TTS 回答,必要时打断或转人工;挂断后用 CDR 收尾。
对 voice-robot 来说,接入电话的改动其实很小:原来浏览器推上来的 WebSocket 音频,现在换成由 FreeSWITCH 推上来;多出来的只是采样率处理和一个用于转人工、挂断的控制通道。
建议的学习路线:
- 装好 FreeSWITCH,分机互拨 :1000 拨 1001,用
sofia status profile internal reg、show channels观察,开siptrace看一遍 INVITE/200 OK/BYE; - 读懂 dialplan :自己写 9999 的规则,用
playback、echo练手; - 用 telnet 手动走 ESL :
auth→event plain ALL→ 拨个电话看事件流,理解 UUID 和通道变量; - 跑通 Python 控制服务 :
originate、uuid_broadcast、uuid_break、uuid_transfer; - 编译安装 mod_audio_fork,先写一个把收到的音频存成 wav 的 WebSocket 服务,确认音频正常;
- 接上 voice-robot:先做一问一答,再做流式、打断、转人工;
- 接运营商中继:配置 gateway,处理 NAT,做好安全加固,再上线真实号码;
- 进阶:mod_callcenter 排队转人工、多台 FS 的负载均衡(Kamailio/OpenSIPS 做前置)、通话质量监控(MOS、丢包、抖动)。
电话系统看起来古老,但把 SIP/RTP、dialplan、ESL 这三件事搞懂,你会发现它和后端开发的思路是相通的:路由、事件、长连接、状态管理。剩下的,就是让 AI 在电话那头说得更快、更像人。