上一篇 02 把「对话怎么存、系统提示怎么常驻、上下文怎么裁剪」收敛成了 ConversationStore。但当 Agent 需要陪你聊二三十轮甚至跨会话时,仅仅「丢最旧」会直接把关键信息(用户偏好、待办、身份)一起丢掉。06 这一篇在 02 的基础上再叠一层:把超窗的旧对话摘要进长期记忆,后续按关键词把它召回、重新注入模型上下文。这样模型既能看清眼前的轮次,也能想起很早之前你说过什么。
本文定位:记忆不是 RAG
很多刚接触 Agent 的同学会把「记忆」与 04 篇的 RAG 混为一谈。二者的检索来源完全不同:
- 04 RAG:从外部文档向量库检索。知识来源是 Wiki、制度文档、产品手册,检索目标是「文档里写了什么」。
- 06 记忆:从本场对话自己的历史摘要里检索。知识来源是 agent 与用户已经说过的话,检索目标是「自己之前聊过什么」。
二者可以叠加:先用记忆补全上下文,再用 RAG 补外部知识。但不要把记忆当 RAG 用,也不要把 RAG 当记忆用。
为什么不能只把窗口开大
最直觉的「解法」是把 02 的 maxMessages 从 40 改成 400------只要全带上,就不会丢了。这条路在真机上走不通,代价体现在三个地方:
| 维度 | 开大窗口 | 摘要进长期记忆 |
|---|---|---|
| token 成本 | 随轮数线性上涨,长对话直接翻数倍 | 旧轮次压成一句话,成本近似恒定 |
| 首字延迟 | 上下文越长,预填充越慢 | 只带最近的几轮,延迟稳定 |
| 信息密度 | 大量「好的」「谢谢」挤占窗口 | 摘要只留结论,密度高 |
| 关键事实 | 被淹没在中间,模型容易忽略 | 命中时以系统提示回注,位置更靠前 |
更麻烦的是「中间丢失」现象:关键信息夹在很长的上下文中间时,模型的注意力反而最弱。摘要回注把它显式地放在靠近问题的位置,命中率比「原样全带上」更高。
所以正确的思路不是「多带」,而是「分层」------短期窗口保证连贯,长期记忆保证不忘。
核心抽象:MemoryConversationStore
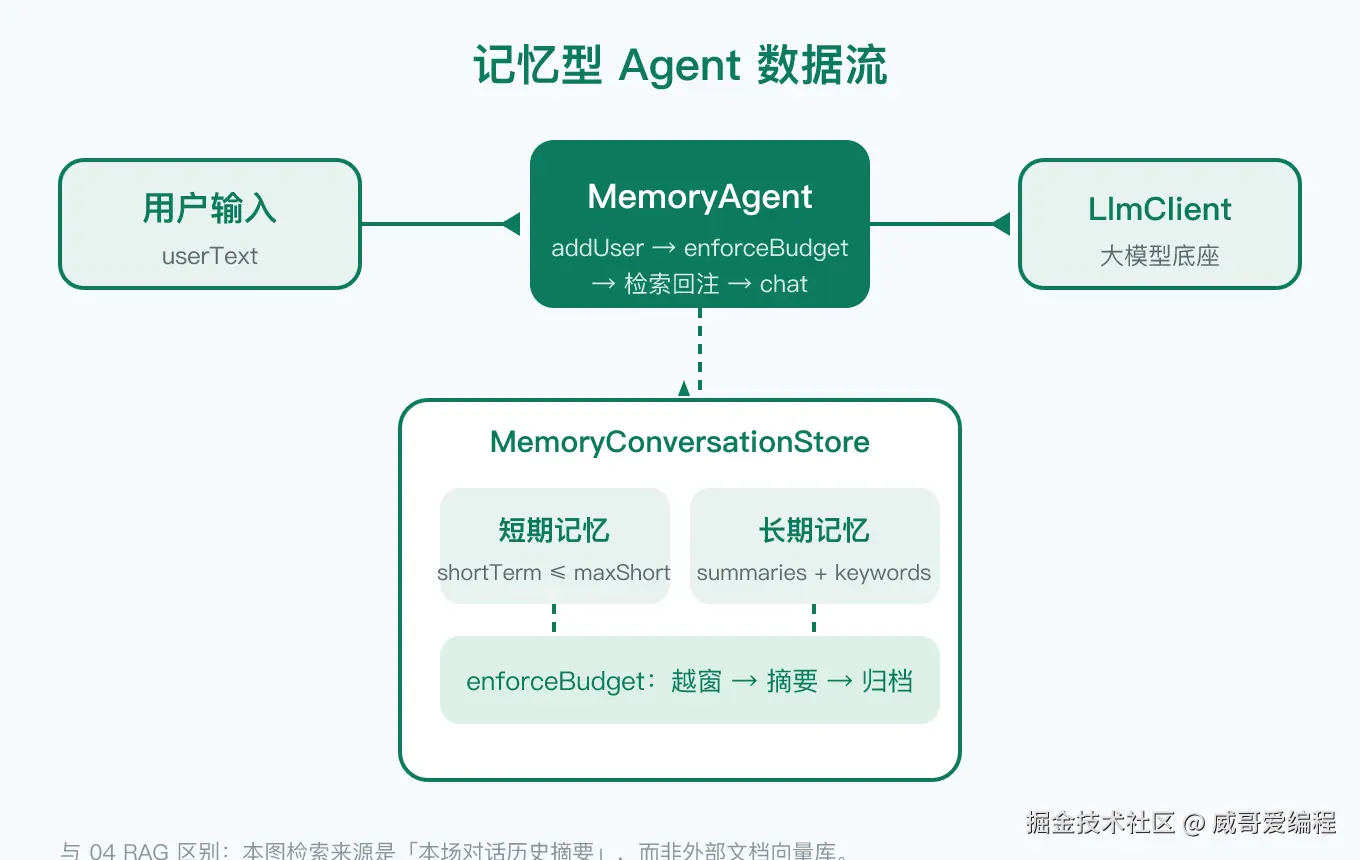
设计思路是在 ConversationStore 之上再包一层,新增两个池子:
shortTerm:短期窗口,直接喂给 LLM;longTermMemory:长期记忆,存放{summary, keywords}。
当短期消息数超过 maxShort,就取最旧的 (len - keepRecent) 条非系统消息交给 summarizeFn,生成摘要并归档;短期窗口只保留最近的 keepRecent 条。系统提示始终常驻,且永远不会被拿去摘要。
typescript
export interface MemoryRecord {
  summary: string;
  keywords: string[];
}

// 带记忆的对话容器:短期窗口 + 长期记忆 + 预算裁剪
export class MemoryConversationStore extends ConversationStore {
  private longTermMemory: MemoryRecord[] = [];

  // maxWindow 给基础 store 一个很大的上限,真正的预算由 enforceBudget 接管,
  // 避免基础 store 在摘要之前就把旧消息直接丢掉。
  constructor(systemPrompt: string = '', maxWindow: number = 1000) {
    super(systemPrompt, maxWindow);
  }

  get memoryCount(): number {
    return this.longTermMemory.length;
  }

  // 短期对话消息条数(不含系统消息)
  get shortTermCount(): number {
    return this.getConversation().length;
  }

  // 从一批消息里抽取关键词(供长期记忆索引)
  private extractKeywords(msgs: ChatMessage[]): string[] {
    const text: string = msgs.map((m: ChatMessage): string => m.content).join(' ');
    return extractTopics(text);
  }

  // 预算裁剪:把最旧的若干条非系统消息摘要归档,并从短期窗口移除
  enforceBudget(
    maxShort: number,
    keepRecent: number,
    summarizeFn: (msgs: ChatMessage[]) => string
  ): void {
    const conv: ChatMessage[] = this.getConversation();
    if (conv.length <= maxShort) {
      return;
    }
    const toMoveCount: number = conv.length - keepRecent;
    if (toMoveCount <= 0) {
      return;
    }
    const oldest: ChatMessage[] = conv.slice(0, toMoveCount);
    const keywords: string[] = this.extractKeywords(oldest);
    const summary: string = summarizeFn(oldest);
    this.longTermMemory.push({ summary, keywords });
    this.removeOldest(toMoveCount);
  }

  // 按关键词检索长期记忆,返回命中的摘要列表(精确匹配关键词)
  retrieveMemory(keyword: string): string[] {
    const out: string[] = [];
    for (const rec of this.longTermMemory) {
      if (rec.keywords.includes(keyword)) {
        out.push(rec.summary);
      }
    }
    return out;
  }
}
removeOldest(n) 是 02 的 ConversationStore 新增的一个小方法:只从对话消息头部删,系统消息不动。这个顺序很关键------必须先摘要再删除 。如果先 removeOldest 再摘要,你摘要的就是一批已经被丢掉的消息,长期记忆永远是空的。
关键词抽取:extractTopics
记忆能不能被召回,全看归档时有没有留下可检索的关键词。示例工程用一份轻量主题词表做纯逻辑演示,好处是零依赖、可单测、不联网:
typescript
const TOPIC_LEXICON: string[] = [
  '机票', '酒店', '火车票', '天气', '报销', '年假', '密码',
  '订单', '物流', '退款', '发票', '行程'
];

// 从一段文本里抽取命中的主题词(对外导出,供 Agent 复用)
export function extractTopics(text: string): string[] {
  const hit: string[] = [];
  for (const t of TOPIC_LEXICON) {
    if (text.includes(t)) {
      hit.push(t);
    }
  }
  return hit;
}词表是领域相关 的:做差旅助手就放「机票/酒店/行程」,做 IT 助手就放「密码/报销/工单」。生产环境可以换成 NLP 分词、NER,或者直接调一次模型让它输出关键词------但无论用哪种,extractTopics 的签名不变,上层 MemoryConversationStore 一行都不用改。这就是把「抽取」隔离成一个纯函数的价值。
检索回注:getMessagesForLLM
模型真正拿到手的上下文由三部分按序拼接:系统提示 + 命中记忆(作为一条新的 system note)+ 短期对话。代码上就是:
typescript
// 组装发给大模型的历史:系统消息 +(命中的历史记忆作为系统提示)+ 短期对话。
// keyword 为空时不做记忆回注,等价于 02 的纯短期窗口。
getMessagesForLLM(keyword?: string): ChatMessage[] {
  const sys: ChatMessage[] = this.getMessages().filter((m) => m.role === Role.SYSTEM);
  const shortTerm: ChatMessage[] = this.getConversation();
  let injected: ChatMessage[] = [];
  if (keyword !== undefined && keyword.length > 0) {
    const matched: string[] = this.retrieveMemory(keyword);
    if (matched.length > 0) {
      const note: string = '[历史记忆]\n' + matched.join('\n---\n');
      injected = [{ role: Role.SYSTEM, content: note }];
    }
  }
  return [...sys, ...injected, ...shortTerm];
}
keyword 来自当前用户输入里命中的第一个主题词。命中多条时全部注入,模型自己判断该用哪条。注意回注用的是 system 角色而不是再塞一条 user------把记忆伪装成用户说的话,会让模型误以为这是刚发生的对话,从而给出错误的时序判断。
MemoryAgent:一次 chat 串起完整往返
MemoryAgent.chat(userText) 的时序是固定的:
store.addUser(userText);store.enforceBudget(...)触发摘要归档;- 从
userText提取关键词,getMessagesForLLM(keyword)构造含记忆回注的请求; - 调
LlmClient.chat(req)(演示用MockLlmClient离线返回); store.addAssistant(reply)落库并返回。
typescript
// 一次完整往返:落用户消息 → 预算裁剪(必要时摘要归档)→ 检索回注记忆 → 调底座 → 落助手回复
async chat(userText: string): Promise<string> {
  this.store.addUser(userText);
  this.store.enforceBudget(this.maxShort, this.keepRecent, this.summarizeFn);
  const kw: string = this.keywordFrom(userText);
  const req: ChatRequest = {
    model: this.model,
    messages: this.store.getMessagesForLLM(kw),
    temperature: this.temperature
  };
  const resp: ChatResponse = await this.client.chat(req);
  this.store.addAssistant(resp.text);
  return resp.text;
}

// 默认摘要:把消息按角色拼成易读的一句话(纯逻辑,无网络)
private static defaultSummarize(msgs: ChatMessage[]): string {
  const parts: string[] = [];
  for (const m of msgs) {
    const who: string = m.role === Role.USER ? '用户' : (m.role === Role.ASSISTANT ? '助手' : '系统');
    parts.push(who + ':' + m.content);
  }
  return parts.join(';');
}
默认摘要是纯字符串拼接,不联网、可单测------这样单测才能稳定断言「归档后长期记忆条数 +1」。真实场景想让摘要更像人话,把 opts.summarize 换成一次额外的模型调用即可,主流程不受影响。
真实接入时,把 MockLlmClient 换成 LlmClientFactory.create('pangu' | 'openai', config) 即可,业务页面一行都不用改。
落地生产:记忆要能存下来
示例工程把记忆放在内存里,App 一退就没了。真机上要跨会话记住用户,需要把 longTermMemory 持久化。HarmonyOS 侧按数据量分三档选择:
- 小量(几十条以内) :用
@ohos.data.preferences存序列化后的 JSON,读写简单,适合用户偏好类记忆。 - 中量且要查询 :用关系型数据库
@ohos.data.relationalStore,给keywords建索引,retrieveMemory直接走 SQL 查询。 - 大量且要语义检索:把摘要也过一遍 Embedding 存进向量库------但这已经接近 04 的 RAG 形态了,只有当「记忆条数多到关键词匹配不够用」时才值得上。
无论哪一档,持久化的是 MemoryRecord(summary + keywords),不是原始消息。原始消息可以随短期窗口一起丢弃,这正是分层带来的存储收益。
演示页:两个按钮看懂记忆
entry/src/main/ets/pages/Index.ets 做了一个最小化演示:
- 「连续对话 10 轮」:循环调用
MemoryAgent.chat,话题覆盖机票、酒店、天气、退款等;越窗后自动摘要,页面上实时显示「长期记忆条数」和「短期对话条数」。 - 「按「机票」检索记忆」:直接调用
store.retrieveMemory('机票'),验证长期记忆可被关键词召回。
页面同样复用 02 的 ChatUIMessage 把状态渲染成列表,主色用 #0E7A5F,背景用 #F7FAFD,与图保持一致。
测试:底座 + 记忆双保险
entry/src/ohosTest/ets/test/LlmClient.test.ets 保留 01/02 的底座断言(RetryPolicy、ResponseParser、ConversationStore、ChatUIMessage),并新增 06 的记忆断言:
enforceBudget超限时生成一条记忆摘要,短期窗口被裁剪到keepRecent;- 系统消息不参与摘要,
getMessagesForLLM首条仍是系统; retrieveMemory('机票')命中,retrieveMemory('密码')在密码尚未被归档时未命中;getMessagesForLLM('机票')在 system 与 shortTerm 之间插入一条记忆 system note;MemoryAgent端到端跑完多轮后,MockLlmClient.lastMessages里出现带「摘要」字样的注入提示。
verify-node.cjs 用纯 JS 镜像了同样的逻辑,命令行 21 条断言全绿,不依赖 DevEco 也能先验纯逻辑。
避坑:六个常见错误
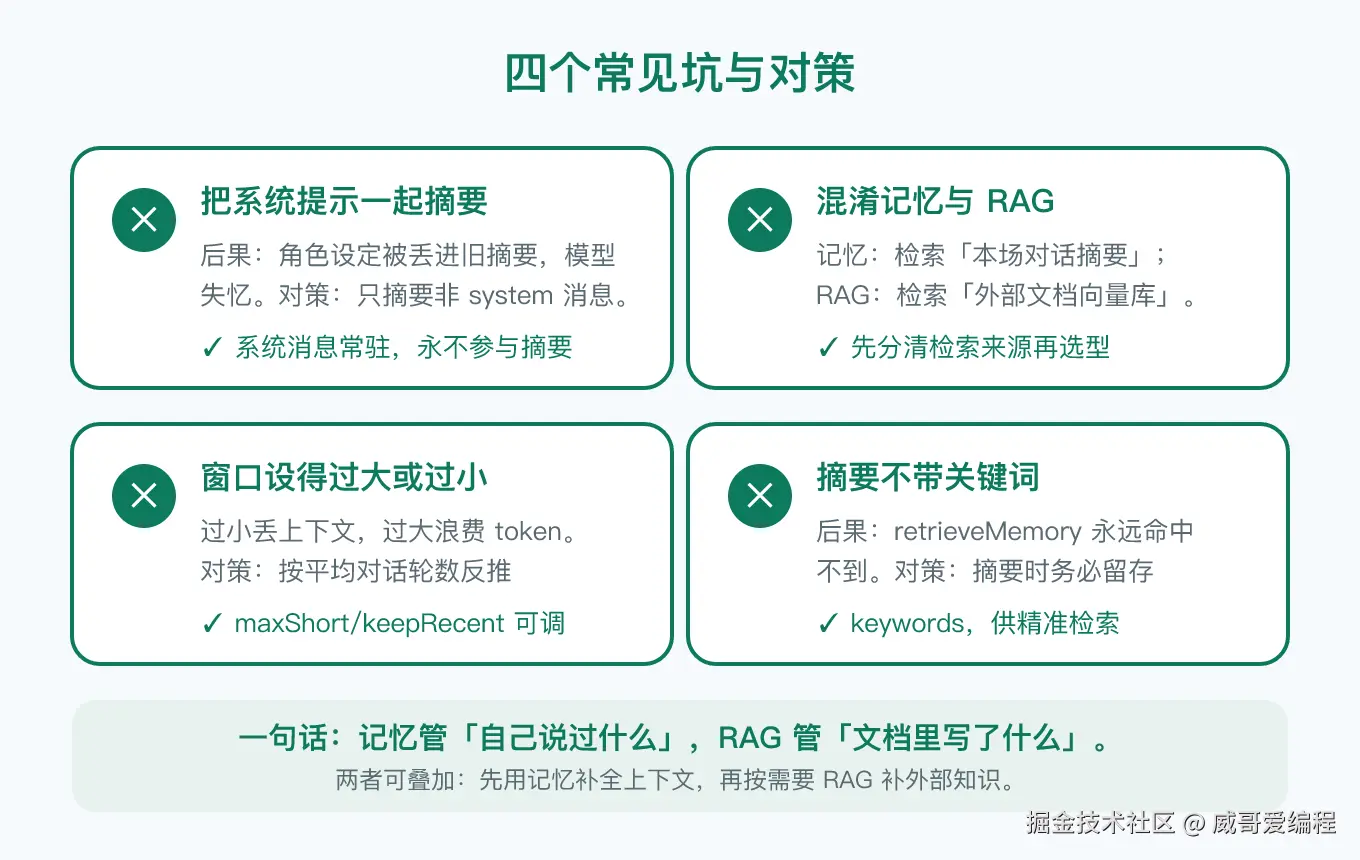
- 别把系统提示一起摘要 。角色设定被归档后,模型就忘了自己是谁。对策:只摘要非
system消息,系统提示常驻。 - 先删后摘 。必须先
summarizeFn(oldest)再removeOldest,顺序颠倒会导致长期记忆永远为空。 - 混淆记忆与 RAG。记忆检索「本场对话历史摘要」,RAG 检索「外部文档向量库」。两者检索来源不同,别互相替代。
- 窗口设得过大或过小 。过小丢上下文,过大浪费 token。对策:按平均对话轮数反推
maxShort和keepRecent。 - 摘要不带关键词 。摘要若没留下
keywords,后续retrieveMemory永远命中不到。对策:归档时务必附带可检索关键词。 - 把记忆伪装成用户消息 。回注必须用
system角色,塞成user会让模型误判时序。
参考与出处
最后一句:记忆让 Agent 不再「聊完就忘」,把长对话的过去稳稳地接进现在。