Agent Memory(三)团队记忆:以 TencentDB Agent Memory 为例
这一篇讲记忆被多人、多 Agent 共享之后的事。这里以开源项目 TencentDB Agent Memory 为例,展开说说
一、从一个人的记忆,到一支队伍的记忆
前两篇解决的是一个 Agent 服务一个人:会话内怎么取舍,跨会话怎么留存。记忆只属于一个人,要操心的是"记得住、找得准、会遗忘"。
现在把场景换成一个最小的团队:两个人、两个 Agent、一个项目。
- 同事 A 用编码 Agent 定下一条规则:支付回调重试的幂等键用
payment_id + event_type,不能用订单号,因为一个订单可能有多笔支付; - 同事 B 用评审 Agent 审这次改造的 PR。
如果评审 Agent 不知道这条规则,就可能放过"用订单号做幂等"的代码。同事 A 讲过一遍的事,团队里每个 Agent 都得再学一遍。团队记忆要做的,就是让一个 Agent 学到的东西,安全地被另一个 Agent 用上。
"安全地"这三个字,带出了个人记忆里没有的四个问题:
| 问题 | 个人记忆 | 团队记忆 |
|---|---|---|
| 放在哪 | 只在我这里 | 放在哪个团队、由哪个 Agent 持有? |
| 谁能用 | 只有我 | 默认谁能读?怎么分享,怎么收回? |
| 怎么用 | 召回后放进上下文 | 分享出去的记忆怎么送到别人的 Agent 手里,又不把上下文塞满? |
| 错了怎么办 | 只影响我 | 一条错误记忆会被很多人复用:能不能查到源头、改掉、不再扩散? |
所以团队记忆不是"把个人记忆库的读权限放大"。它在个人记忆之上多了四件事:作用域、权限、分发、纠错。下面用 TencentDB Agent Memory 把这四件事逐个拆开。
二、先认识 TencentDB Agent Memory
TencentDB Agent Memory 是腾讯云开源的 Agent 团队记忆项目。选择它,是因为它的定位就是团队记忆,上面四个问题在它的设计里都有明确的回答,可以直接对照着看。
它的出发点很朴素:减少使用 Agent 时的重复劳动 。项目背景讲过一次,不该换个会话再讲;文档读过一遍,不该每个 Agent 从头再读;一套做法跑通了,不该下次再摸索一遍。 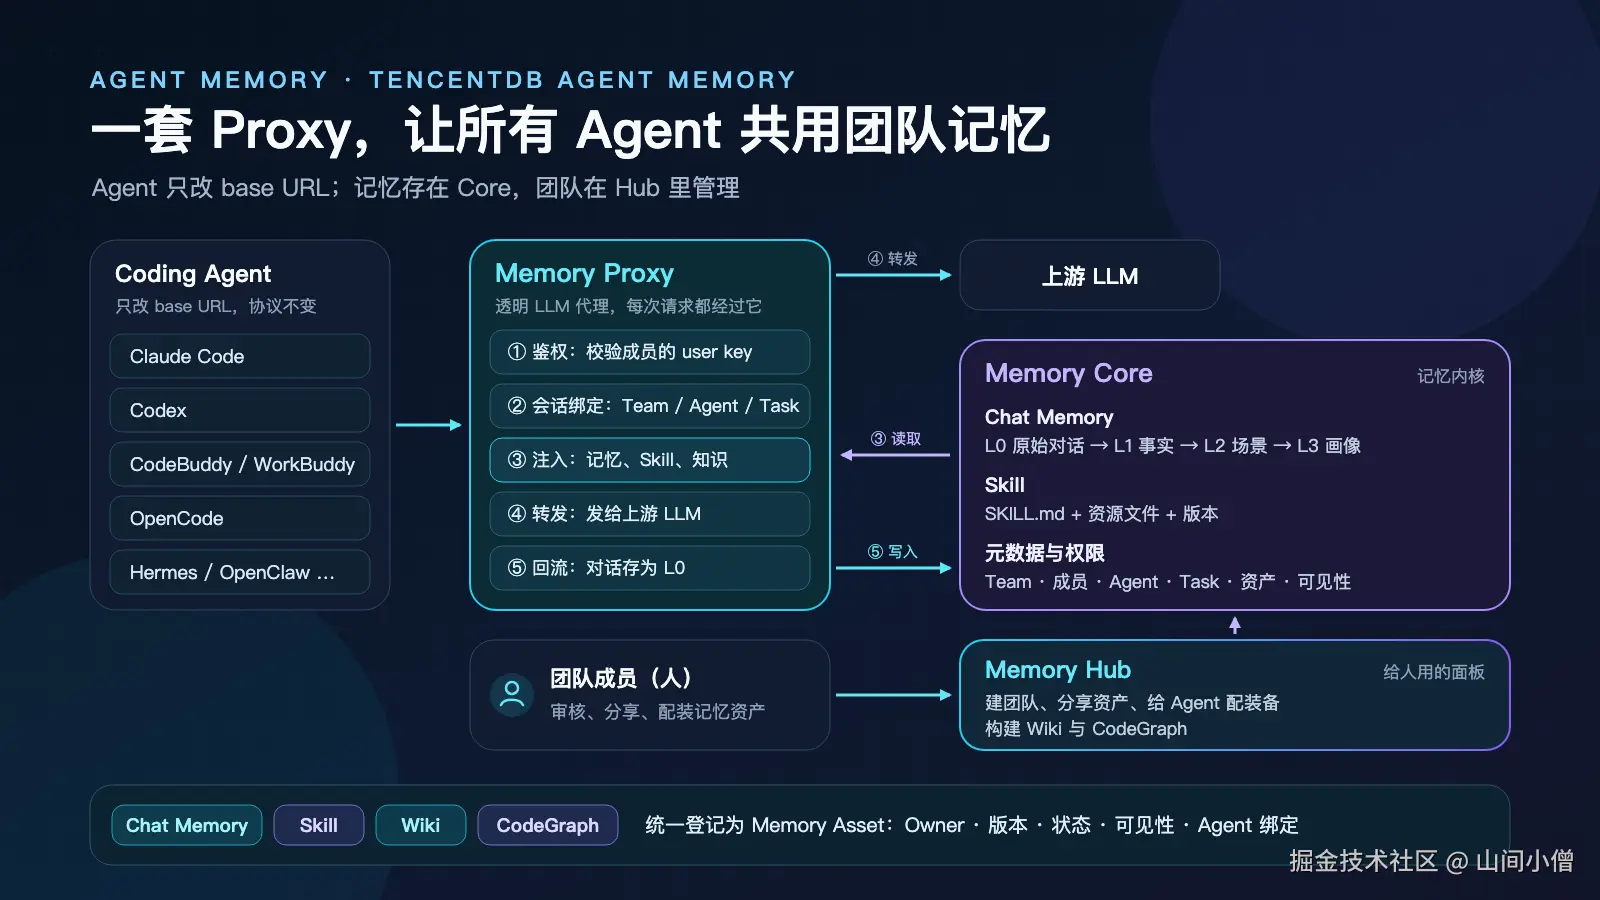
它由三个服务组成:
| 组件 | 做什么 |
|---|---|
| Memory Proxy | 透明的 LLM 代理。Agent 只要把 base URL 指向它,协议不变,不用装插件。它负责鉴权、绑定会话归属、把记忆注入 prompt、把对话回流存档 |
| Memory Core | 记忆内核。存 L0--L3 记忆和 Skill,管理团队、成员、Agent、资产和权限 |
| Memory Hub | 一个容器里跑两个服务:面板(Panel)给人用,建团队、分享资产、给 Agent 配装备;知识服务(Knowledge)负责把文档整理成 Wiki、把代码索引成 CodeGraph,并提供检索 |
它管理四类记忆资产:
| 资产 | 是什么 | 对应的记忆类型 |
|---|---|---|
| Chat Memory | 从对话里沉淀的偏好、事实、决策,分 L0→L3 四层 | 发生过什么、知道什么 |
| Skill | 从跑通的任务里提炼的做事方法,带版本、资源文件、触发边界和验证规则 | 怎么做事 |
| Wiki | 把文档整理成结构化页面和链接图谱 | 组织知识 |
| CodeGraph | 索引代码的符号、调用关系和影响范围 | 组织知识 |
Chat Memory 的分层沿用第二篇的思路:L0 是原始对话,L1 是抽出来的原子事实,L2 是按场景组织的知识块,L3 是长期画像。对话先原样存成 L0,再由后台流水线逐层提炼。
四类资产的来路和可改范围各不相同:
| 资产 | 怎么产生 | 可以改什么 |
|---|---|---|
| Chat Memory | Proxy 把对话存成 L0,后台再抽出 L1--L3;也可导入历史对话 | Owner 可改写 L1--L3,L0 不能改 |
| Skill | 从对话中自动提炼,或用 mem:create-skill 手动触发;也可上传 SKILL.md |
Owner 可在线编辑,每次保存升一版;别人的只能 fork 后再改 |
| Wiki | 上传文档,由 LLM 生成页面和链接图谱 | 可增删文档、重建、删页面,不能直接改正文 |
| CodeGraph | 登记代码仓库,自动克隆并索引 | 不能手改,只能重新同步 |
有两点容易忽略:
- 自动生成的内容会被改写:后台可能直接修改已有 Skill 并生成新版本,不经人工审核;L2、L3 也可能在下次更新时覆盖你的手工修改。只有通过接口手写的 Wiki 页面会被锁定。
- Agent 不能直接改资产 :它拿到的工具默认都只能查,要让它写 Skill,得打开 Proxy 的
allowLlmWrite。它影响记忆,主要靠自己说的话回流成 L0、再被抽取。第六节里评审 Agent 的猜测变成记忆,走的就是这条路。
四类资产统一登记为 Memory Asset,带有 Owner、版本、状态、可见性、Agent 绑定等字段,后面四节讲的就是这些字段怎么起作用。
三、作用域:一条记忆放在哪一层
一条记忆该放多大的范围
同事 A 说的"幂等键用 payment_id + event_type",这条记忆应该放在哪?
- 只放在同事 A 个人身上:同事 B 的 Agent 用不了;
- 放到整个公司:其他项目的 Agent 也会读到,影响面太大;
- 放在这个团队里,由编码 Agent 持有:团队里需要的人能用上,范围也清楚。
这就是作用域要回答的问题:一条记忆放在哪一层,决定了它最多能被多大的范围看到。作用域通常分几层,每层的作用不同:
- 组织(租户)是硬边界:再相似、再相关,也不能跨组织召回;
- 团队是共享边界:团队规范、项目约束在这一层共享,分享出去的记忆最远也只到这一层;
- Agent 是记忆的基本单位:记忆由哪个 Agent 产生,就归哪个 Agent 持有;
- 会话是来源:记下它从哪段对话来,以后好回查。
作用域只回答"放在哪"。在这个范围里具体谁能读、谁能改,是下一节权限要讲的事。
TencentDB 的做法:三层结构 + 会话绑定
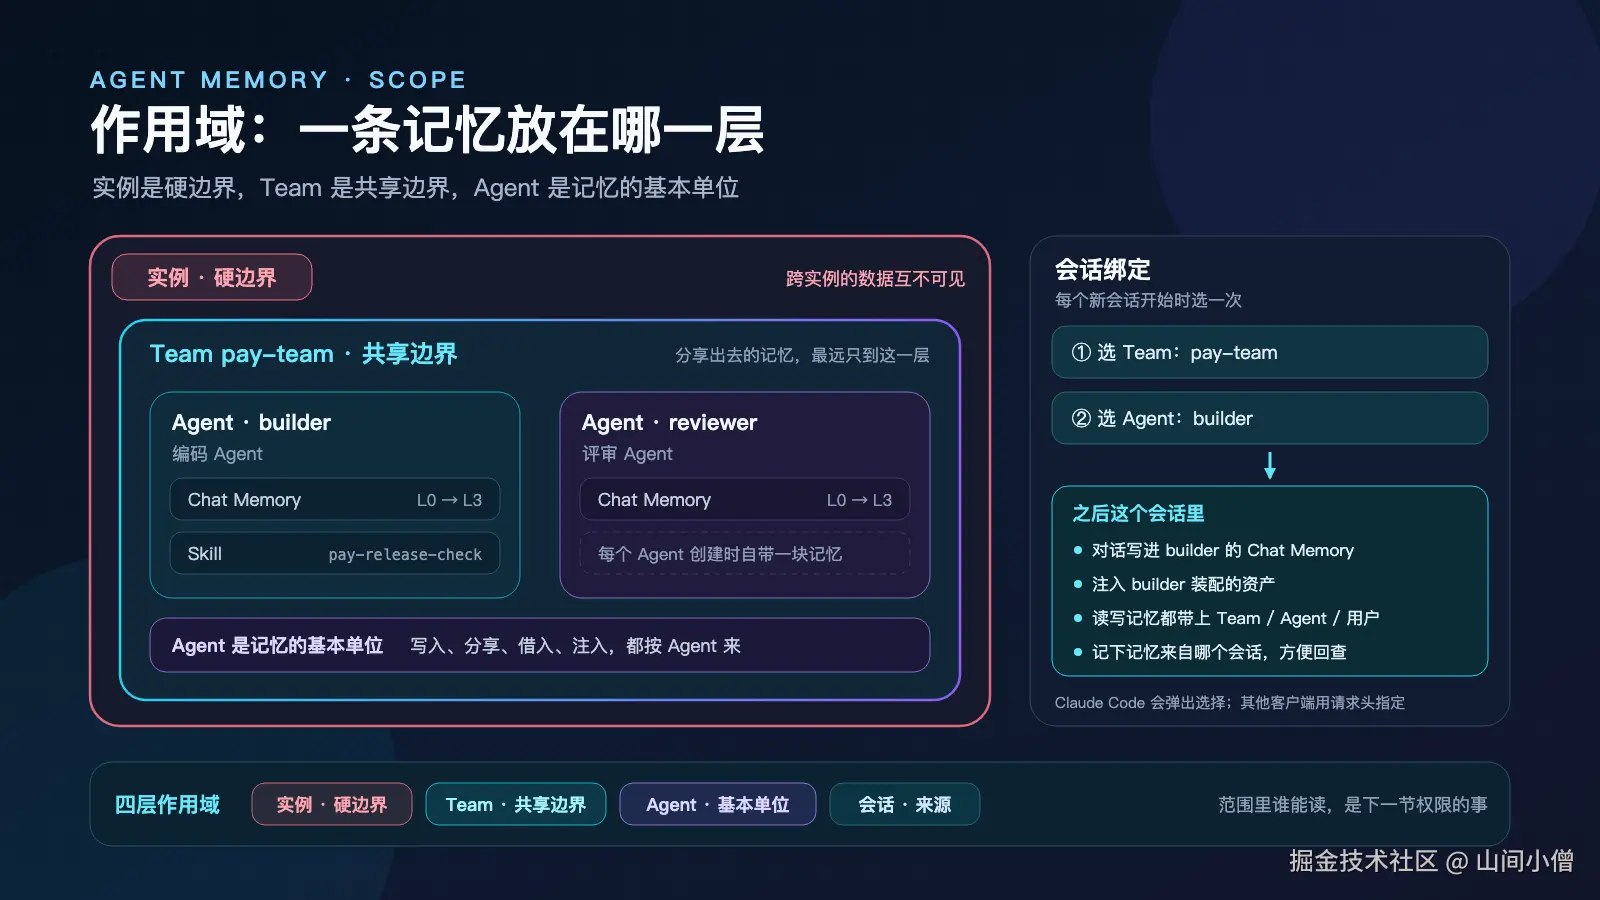
TencentDB 的作用域就是三层。拿实战里的团队举例:
text
实例:硬边界,跨实例的数据互不可见
└── Team pay-team:共享边界,记忆、Skill、知识都登记在 Team 下
    ├── 编码 Agent:一块 Chat Memory(L0 → L3),还有自己的 Skill
    └── 评审 Agent:一块 Chat Memory(L0 → L3)
其中最关键的是 Agent 这一层。每个 Agent 创建时会自动带上一块独立的 Chat Memory。之后记忆写进哪里、分享什么、别人借入什么、给谁注入什么,都以 Agent 为单位。在资产表里,一个 Agent 的整块 Chat Memory 就是一条资产,分享时整块一起分享。
为什么按 Agent 划分,而不是按人?因为同一个人可能用好几个不同角色的 Agent,写代码时需要的记忆和做评审时需要的记忆并不一样。按 Agent 划分,后面讲的装配和注入才有抓手。
有了结构,还要知道每段对话该归到哪里,这就是会话绑定。每开一个新会话,Proxy 先让用户选定 Team 和 Agent,还可以选一个关联的 Task。在 Claude Code 里,它会弹出选择;没法弹表单的客户端,可以用请求头直接指定。选定之后,这个会话里的对话写进这个 Agent 的 Chat Memory,注入的也是这个 Agent 装配的资产;底层读写记忆时,都强制带上团队、Agent、用户三个字段。
这一步的意义在于:"这段对话产生的记忆放在哪",在对话开始时就定下来了,而不是事后去猜。
多层规则冲突时:越具体越优先,但硬约束不能破
作用域分了层,同一件事就可能在好几层都有规则。TencentDB 的"提取 Prompt"就是一个例子:Agent、Team、实例都可以配置自己的记忆提取规则,生效顺序是 Agent > Team > 实例 > 系统内置,越具体越优先。
这个思路可以推广到记忆本身:
- 同类且不冲突的规则,越具体越优先,比如个人偏好可以把默认测试命令从全量改成增量;
- 组织级的硬约束不能被下层覆盖,比如安全扫描必须跑;
- 真正冲突时,不要静默覆盖,而要标出来,请人确认。
四、谁能用:默认私有,分享要有动作
先分清两种身份:成员和 Owner
作用域划定了记忆放在哪;权限要回答的是,在这个范围里谁能读、谁能改。这要先分清两种身份:
- 成员:被拉进团队的人。系统管理员(admin)负责建团队、建用户、把人拉进团队;团队内部再分团队管理员和普通成员,普通成员在团队里使用和管理自己的 Agent。
- Owner:每块记忆、每个 Skill 都有一个 Owner,就是创建它的那个成员。修改可见性、编辑、删除,都只有 Owner 能做。
身份判断以"调用者本人"为准。试用中,系统管理员想以同事 A 为 Owner 建团队,被拒绝了;同事 B 想把自己拉进同事 A 的团队,也被拒绝了。
为什么不能"默认大家都能看"
团队工具最容易犯的错,是觉得"既然是团队的,那就默认大家都能看"。这样一来,个人的试错记录、还没验证的经验、只适用于特殊情况的例外,都会直接扩散给所有 Agent。
比如同事 A 某次紧急处理时让 Agent 记下:"发布卡住时,可以直接 kubectl apply 绕过流水线。"在他自己的会话里,他知道这是例外;一旦默认共享,新同事的 Agent 就可能把它当成常规做法。
更稳妥的逻辑是三条:
- 默认私有:新产生的记忆只属于它的 Owner;
- 分享是一个明确动作:Owner 主动改成团队可见,"谁对这条记忆负责"也就清楚了;
- 分享不等于装配:别人看得到,不代表他的 Agent 会自动用上,还需要主动借入或绑定。
还有一条最容易被忽视:权限要在检索之前过滤,并且要覆盖每一条读取路径。
- 如果先检索再过滤,结果数量会忽多忽少,"这里有内容但你看不了"本身也是一种泄露;
- 一个系统的读取入口通常不止一个:列表、搜索、按 ID 打开、导出、给 Agent 用的工具接口。
TencentDB 的做法:四档可见性 + 借入
TencentDB 给每个资产定义了四档可见性:
| 可见性 | 谁能读 |
|---|---|
private |
只有 Owner,团队管理员也不例外 |
team |
团队成员 |
restricted |
通过 ACL 精确授权给指定的人、角色或 Agent |
agent |
定向装配给同团队的某个 Agent |
新建的 Chat Memory 和 Skill 默认都是 private。Owner 在面板里把可见性改成 team,才算分享出去。分享之后,同事 B 想用,还要把它"借入"自己的 Agent。检索时,系统先按团队、用户、Agent 和可见性把范围缩小,再按问题召回。
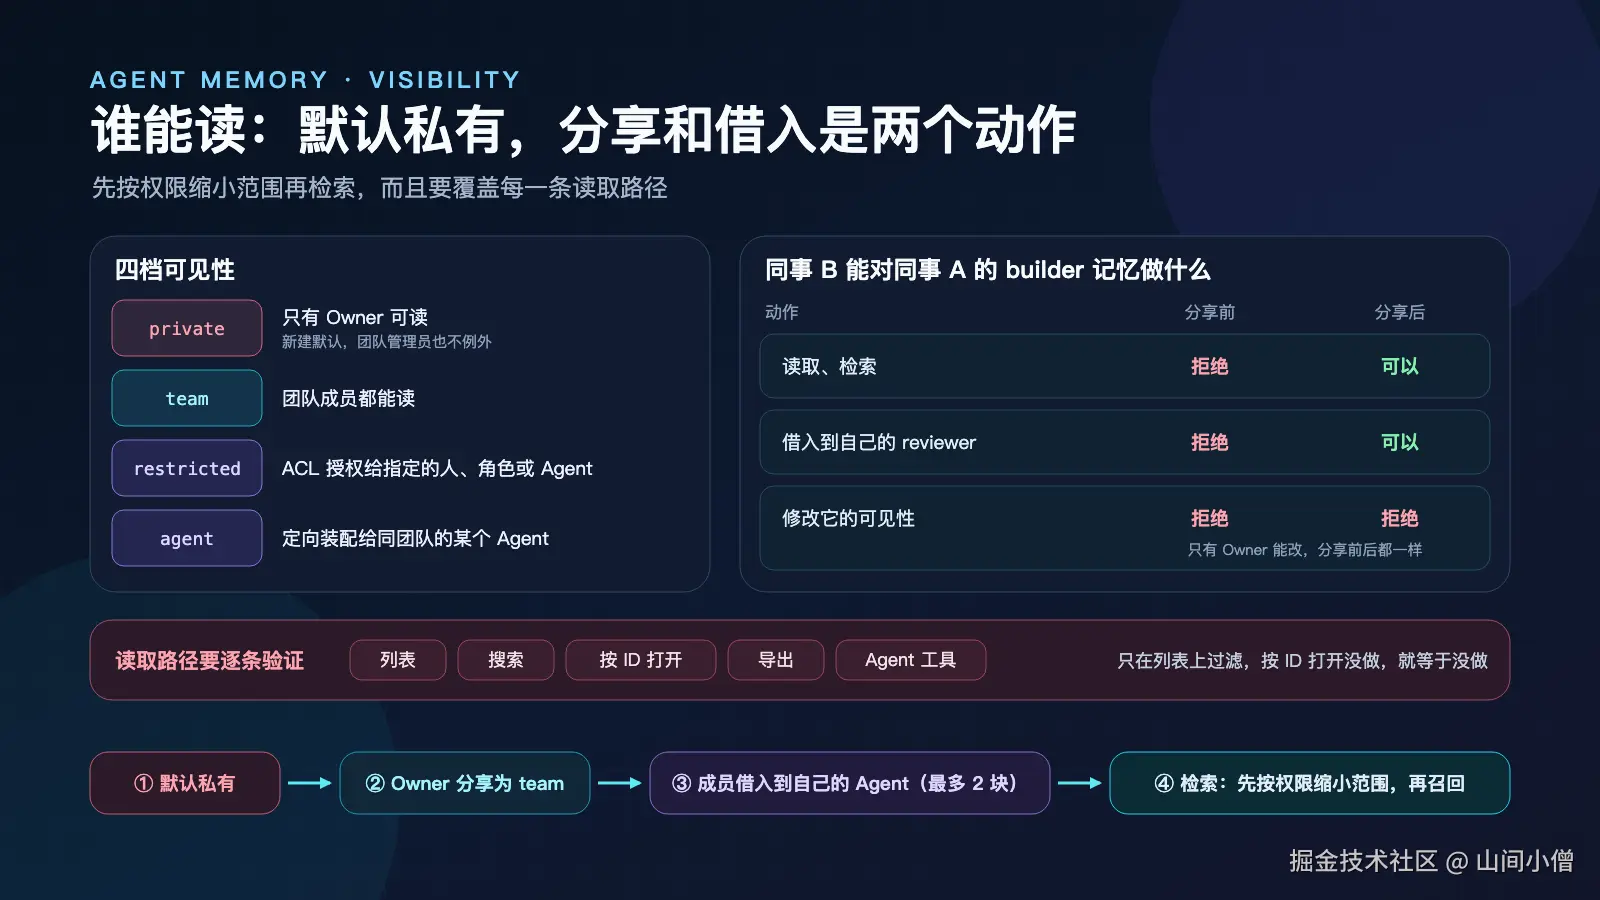
使用中,这条链路在面板上完全按设计工作:分享前,同事 B 读取、借入、修改可见性都被拒绝;同事 A 分享后,同事 B 可以读,也可以借入。
但"覆盖每一条读取路径"这一点没有做全。同事 A 的一个私有 Skill,在资产列表、普通搜索和 Agent 的搜索工具里都被正确隐藏了,却能通过"团队范围搜索"看到片段,通过"按 ID 打开"读到全文,连 Agent 自己用的查看工具也能读到。原因是两层的定义不一致:Skill 存储层的规则是"团队内可读",资产层的 private 却是"只有 Owner 可读"。这恰好说明了,为什么权限要按读取路径一条条验证,而不是按功能验证。
五、怎么用:装配和注入
记忆分享出去以后,要真正送到 Agent 手里才有价值。但不能把团队的所有记忆都塞进 prompt:上下文有限,噪音多了还会干扰判断,这在第一篇讲过。所以分发要回答两个问题:
- 给哪个 Agent 什么:不同角色需要不同的记忆。评审 Agent 需要项目约束和历史事故,不需要市场调研;
- 以什么方式给:哪些直接放进 prompt,哪些让 Agent 需要时再查。
装配:给每个 Agent 配一套"装备"
TencentDB 把这一步叫 Agent Loadout:在面板里给不同的 Agent 绑定不同的资产,并设置优先级和使用方式。比如把"发布检查 Skill"绑给发布 Agent,把"架构 Wiki"绑给所有开发 Agent,把 CodeGraph 绑给编码和评审 Agent。
官方也说明了现状:目前以人工绑定为主,让系统自动判断"哪条记忆该给哪个 Agent"还在迭代中。
注入:稳定的放进 system,易变的做成工具
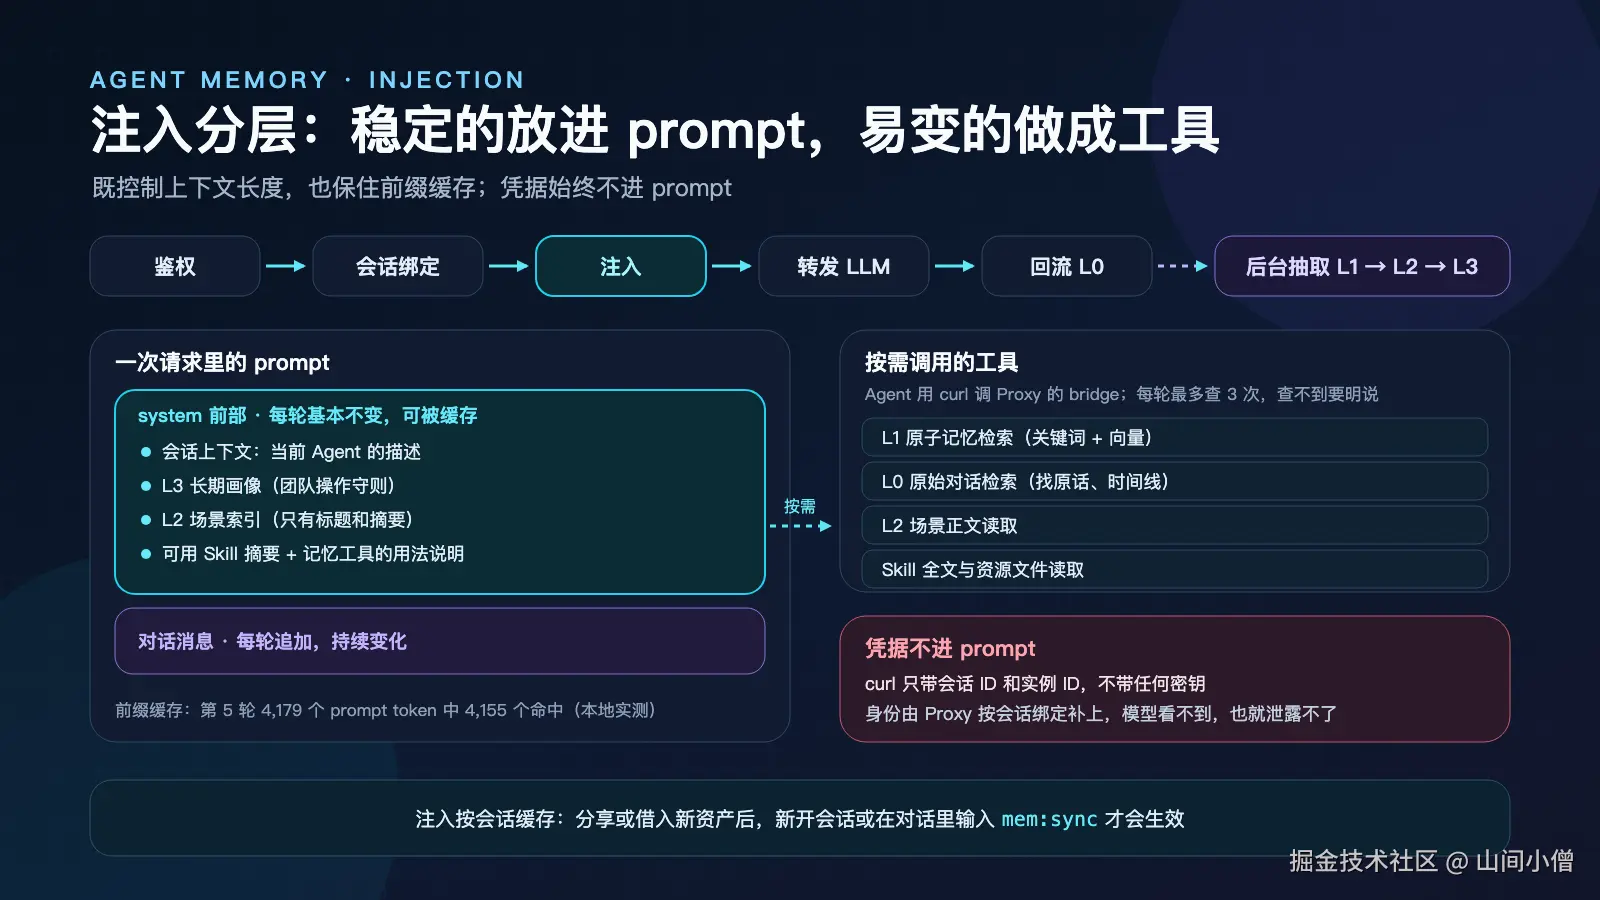
Proxy 在每次请求里做的事,可以概括成一条流水线:
text
鉴权(校验成员的 user key)
  → 会话绑定(Team / Agent)
  → 注入资产
  → 转发给上游 LLM
  → 回流(对话存为 L0,后台再逐层抽取 L1 → L2 → L3)
其中注入是分层的:
- 变化慢的,直接放进 system prompt:当前 Agent 的描述、L3 长期画像、L2 场景索引、可用 Skill 的摘要;
- 每轮都在变的,做成工具:L1 原子记忆、L0 原始对话、L2 场景正文、Skill 全文,Agent 需要时自己调用查询。
这样分有两个原因。
一是控制上下文:prompt 里只放索引和画像,细节按需取用。
二是保住前缀缓存:推理服务会复用 prompt 开头相同的部分,省掉重复计算。system 前部保持稳定,缓存才能一直命中;如果每轮都把检索到的 L1 塞进 system,开头就会每次都变,缓存也就失效了。第一轮试用中,同事 A 第 5 轮请求的 4,179 个 prompt token 里,有 4,155 个命中了前缀缓存。
还有一个安全细节:Agent 调用记忆工具时,请求里不带任何密钥,身份由 Proxy 按会话自动补上。凭据不出现在模型能看到的 prompt 里,模型也就没机会把它泄露出去。
另外,注入内容是按会话缓存的。分享或接入了新资产后,要开一个新会话,或者在对话里输入 mem:sync 刷新,才会生效。
Skill:找的时候可以模糊,用的时候必须确定
Skill 是程序记忆,回答"怎么做事"。如果只写一句"发布前跑一遍回归、检查配置、通知相关方",Agent 还是要猜:跑什么命令、查哪些配置、怎样算通过。TencentDB 的 Skill 是一个完整的单元:
text
SKILL.md   触发边界(什么时候用、什么时候不能用)、执行步骤、验证规则
资源文件    脚本、检查清单、基线配置
版本       每次修改生成新版本,旧版本可以按版本号取回
Skill 和普通记忆有一个关键区别:找的时候可以模糊,用的时候必须确定。
- 发现阶段,按关键词、语义去搜候选 Skill,没有问题;
- 执行阶段,必须落到明确的某个 Skill 的某个版本上,不能把两个版本的步骤混着用。
修改也要防止互相覆盖。TencentDB 更新 Skill 时要求声明"基于哪个版本改",如果这个版本已经过期,就直接拒绝。这就是常说的乐观锁。
六、错了怎么办:来源、冲突与纠错
先假设"一定会有错"
个人记忆错了,影响一个人;团队记忆错了,会被多个 Agent 当成共识反复使用。所以团队记忆要先假设"一定会有错",再保证四件事:
- 能追溯:一条记忆是从哪段原话来的,用哪个版本的提取规则生成的;
- 能分辨来源角色:这句话是用户说的、工具返回的,还是 Agent 自己推断的;
- 能发现冲突:两条规则互相矛盾时,系统要提示出来,而不是交给检索排序去"随机裁决";
- 能改、能撤:Owner 能修正或废弃,最好还能留下"为什么错"的痕迹。
第 2 点值得展开说。一段对话里,信息至少有三种来源:
| 来源角色 | 例子 | 怎么对待 |
|---|---|---|
| 用户 | "幂等键必须用 payment_id + event_type" | 约束、偏好、决策以它为准 |
| 工具 | 接口回执、测试报告 | 事实类信息最可靠,可以回查 |
| Agent 自己 | 它总结、推测、改写出来的结论 | 最不可靠,用之前要确认 |
英文里常把这种"来源角色"叫 actor。每条记忆都记下 actor,系统就能区别对待:Agent 推断出来的内容先标成待确认,不自动共享;出现冲突时,以用户原话和工具结果为准。
TencentDB 的现状:追溯做得好,来源角色和冲突没处理
追溯做得比较完整。 每条记忆都有生成日志,记录用了哪个提取 Prompt 的哪个版本、由哪几条 L0 原文生成、产出了哪几条记忆。提取 Prompt 本身也有版本,每更新一次版本号就加一。所以如果发现某个版本的 Prompt 总把"最好"抽成"必须",可以翻生成日志,找出出自这个版本的记忆,逐条改掉或删掉。修好 Prompt 之后,新生成的记忆会用上新版本;已经生成的不会自动重抽,目前也没有现成的重跑入口。
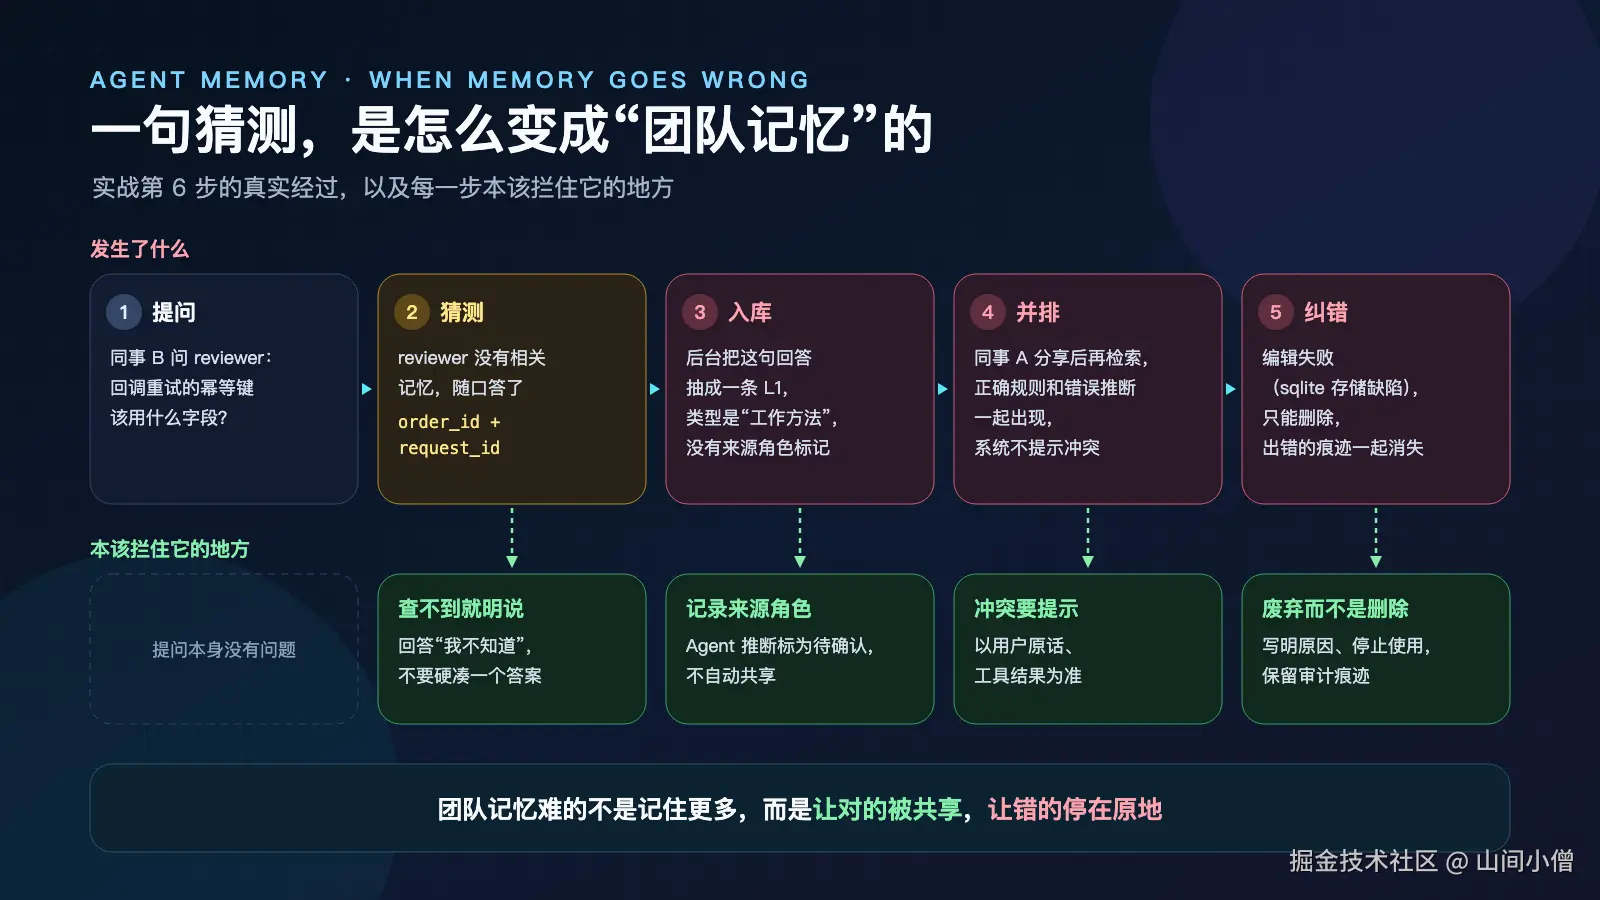
来源角色和冲突没有处理。 第一轮试用中最典型的一幕是这样的:
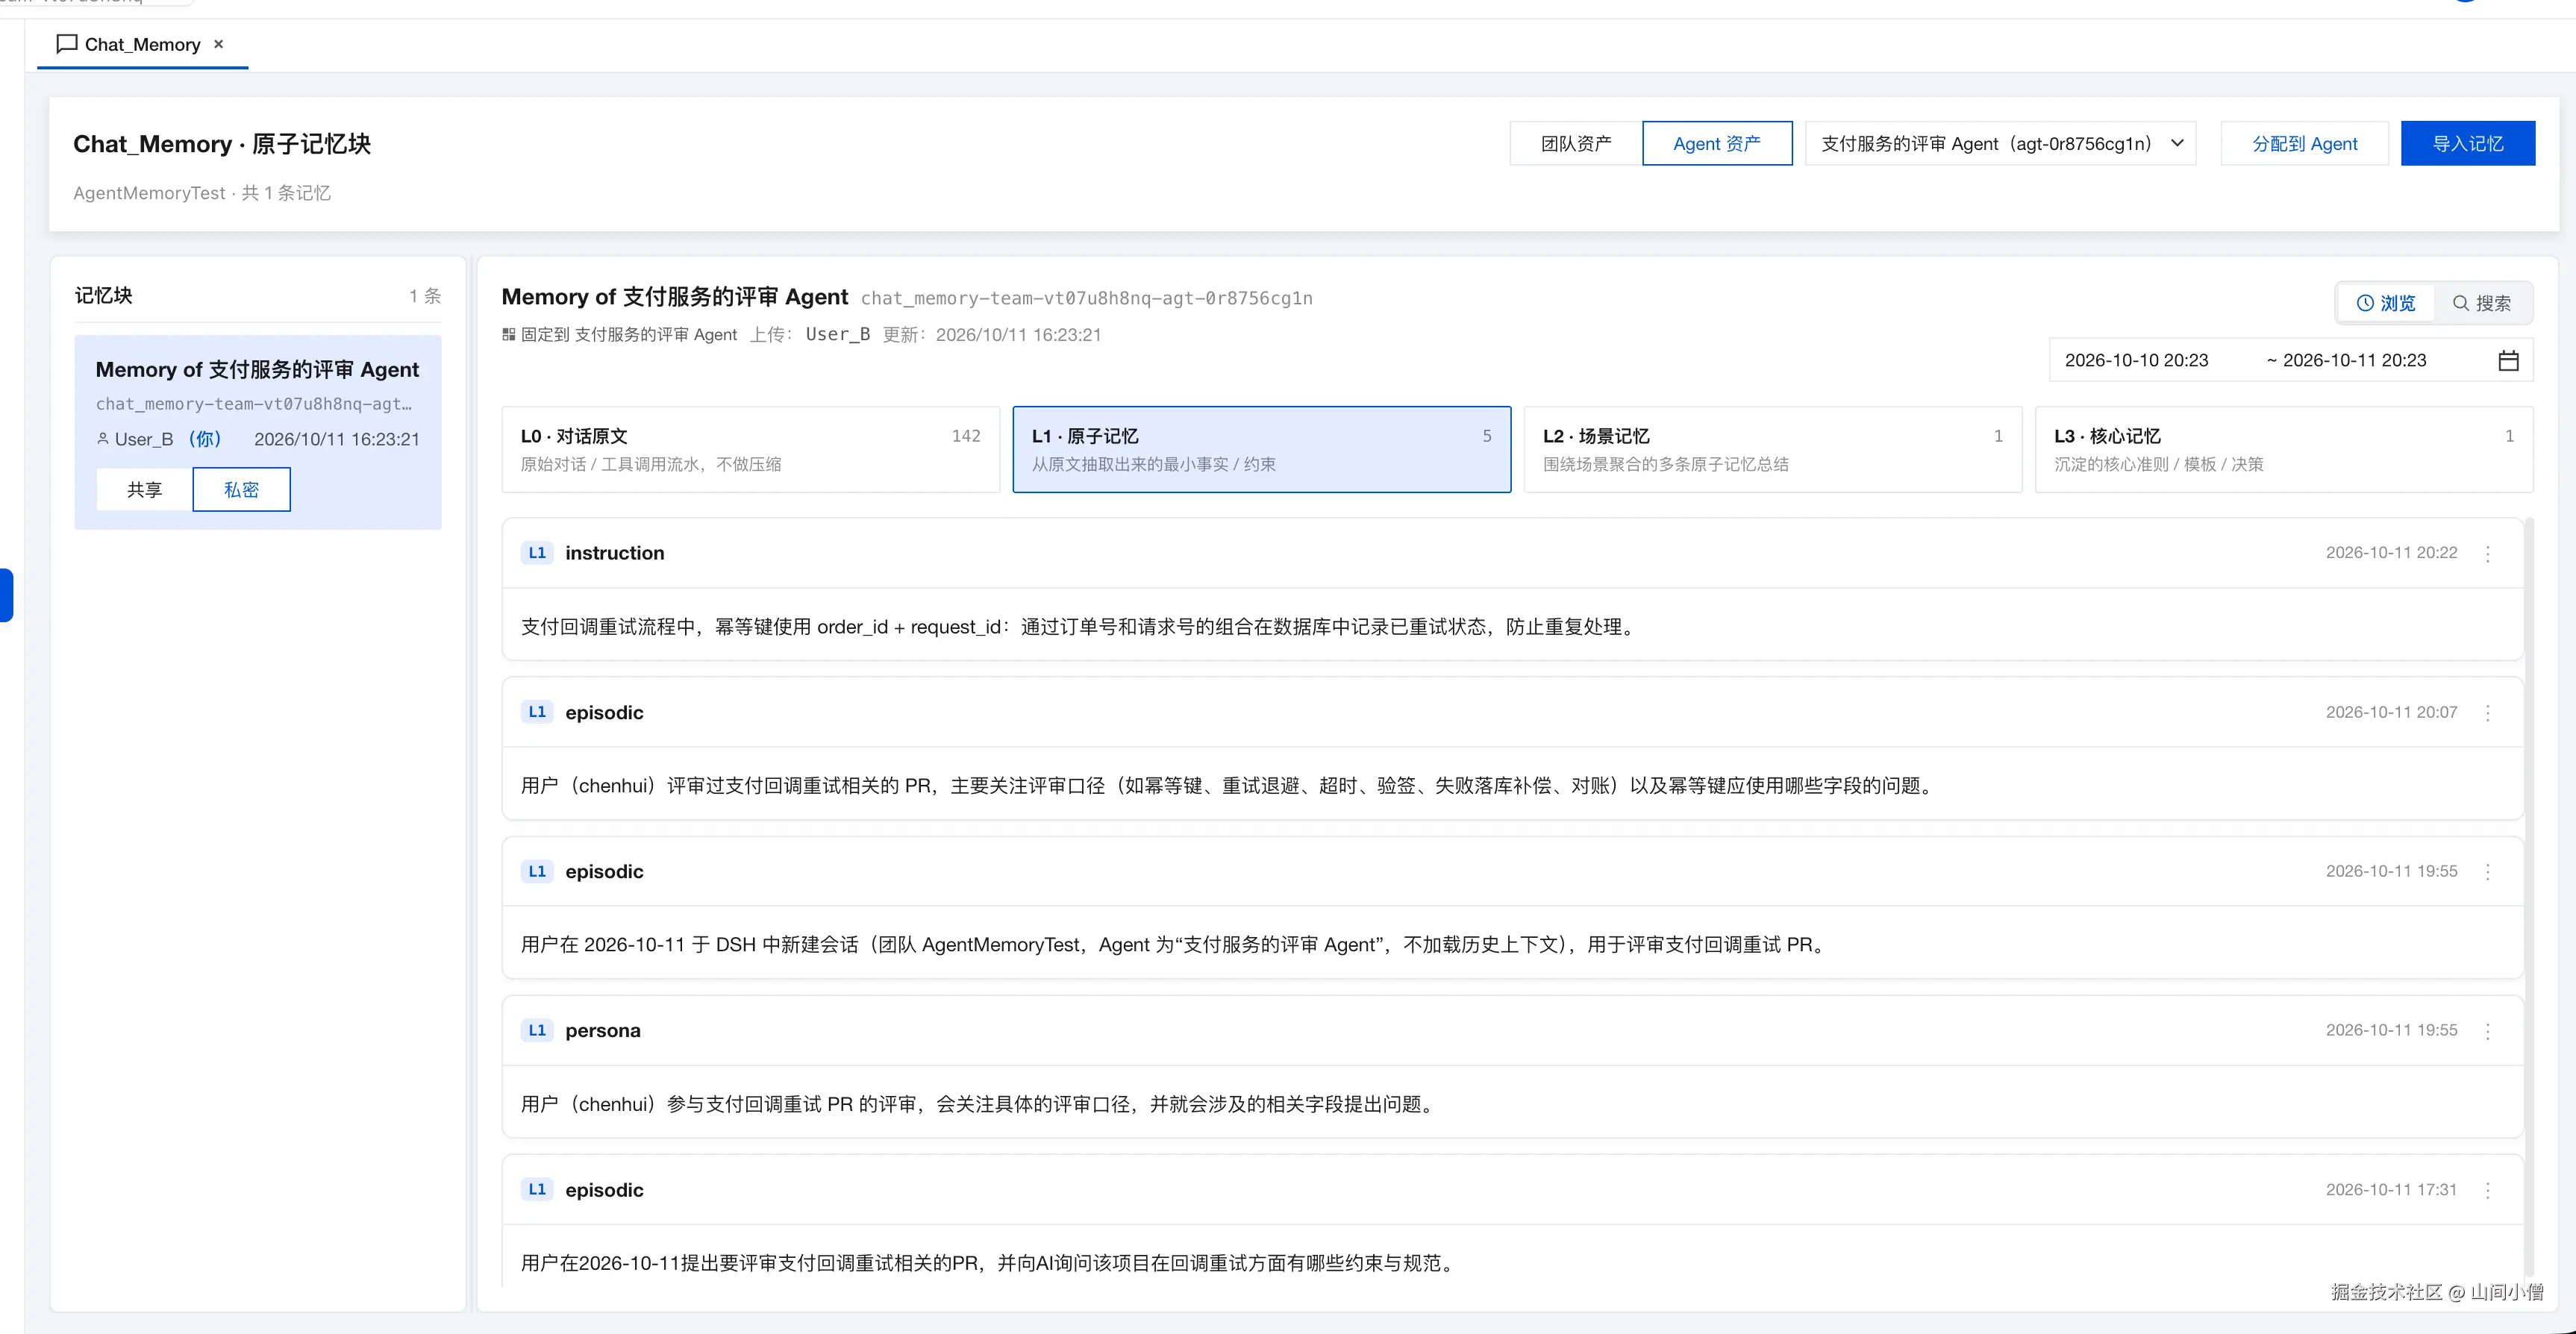
同事 B 问评审 Agent,幂等键该用什么字段。它当时没有任何相关记忆,就泛泛地答了一句"用 order_id + request_id"。后台流水线把这句回答也抽成了一条记忆,类型是"工作方法",没有任何标记说明它来自 Agent 的推测。等同事 A 分享了正确规则,同事 B 再去检索时,正确规则和这条错误推断并排出现,系统没有提示冲突。
一句没有依据的猜测,就这样变成了"团队记忆"。如果当时记录了 actor,在入库那一步就能拦住它。
纠错入口有,但还不完整。 Owner 可以在面板里改写自己的 L1、L2、L3,删除单条记忆目前只开放了接口;非 Owner 做这些操作都会被拒绝。但在开源版默认的 sqlite 存储下,编辑单条 L1 记忆多数情况下会失败,只能走接口删除。而删除会把"这里曾经有一条错误推断"的痕迹一起抹掉。更理想的做法是:把它标为废弃,写明原因,让它不再被使用,但仍然可以审计。
七、部署边界:权限做在哪一层,就要守住哪一层
分层鉴权的前提
一个系统可以把权限检查放在不同的层:面板层、代理层、数据层。放在哪一层都可以,前提是别人绕不过这一层。
如果用户级的权限只在面板和代理里检查,那数据层就只能当内部接口,靠网络隔离和服务密钥保护。一旦有人能直接连到数据层,前面的权限就形同虚设。
TencentDB 的情况
TencentDB 正是这样分层的:用户级权限在面板和 Proxy 里检查;Memory Core 的数据接口只校验服务密钥和实例 ID,请求里写的是哪个团队、哪个 Agent、哪个用户,它就查哪个。官方文档也要求,Core 一旦监听本机以外的地址,就必须配置服务密钥。
问题在于,一键部署脚本为了兼容 Proxy,把这个密钥留空了。试用中直接调用 Core 的接口,带上任意一个 Bearer 值,再填上同事 A 的团队、Agent 和用户 ID,就能读到同事 A 的记忆。而这些 ID,普通成员在成员列表和 Agent 列表里就能看到。
Agent 用的记忆工具也有类似的情况:它只凭会话 ID 识别身份。Claude Code 的会话 ID 每次随机生成,问题不大;但有些客户端需要在配置文件里写死会话 ID,这时会话 ID 就成了一把长期有效的钥匙。
落到部署上,就是三条:
- Core(8420)和 Knowledge(8424)只对 Proxy、Panel 所在的内网开放,成员只通过面板和 Proxy 访问;
- 生产环境一定要配置服务密钥;
- Proxy 不要暴露到不可信的网络,会话 ID 要做到不可猜测。
八、实战:两个人、两个 Agent 跑一遍
这一节用 dsh 做 Agent 客户端,上游模型和记忆提取模型都用 deepseek-v4-flash,把整个过程重跑了一遍。
1. 部署
- 官方的一键部署:
bash
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env- 编辑
.env
bash
MEMORY_LLM_BASE_URL=https://api.deepseek.com
MEMORY_LLM_API_KEY=<api key>
MEMORY_LLM_MODEL=deepseek-v4-flash
MEMORY_LLM_PROTOCOL=openai

PROXY_UPSTREAM_URL=https://api.deepseek.com
PROXY_UPSTREAM_API_KEY=<同一把 key>
PROXY_UPSTREAM_MODEL=deepseek-v4-flash

# 可选:换一组新的数据卷名,和之前部署留下的数据分开
MEMORY_CORE_VOLUME=tdai-demo-core-data
PANEL_VOLUME=tdai-demo-panel-data-
修改
start-proxy.sh在injection:段里添加externalGatewayUrl: "http://127.0.0.1:${PROXY_PORT}"在sessionInit:段里添加defaultTaskId: "no-task" -
执行
./start-all.sh。如果本机之前拉过镜像,脚本会直接复用本地的latest,不会自动更新;想用最新版,执行PULL=1 ./start-all.sh。
2. 建团队
- 先打开 http://localhost:8125 ,用
deploy/global-images/.admin-key文件里的 key 登录。 - 新建团队
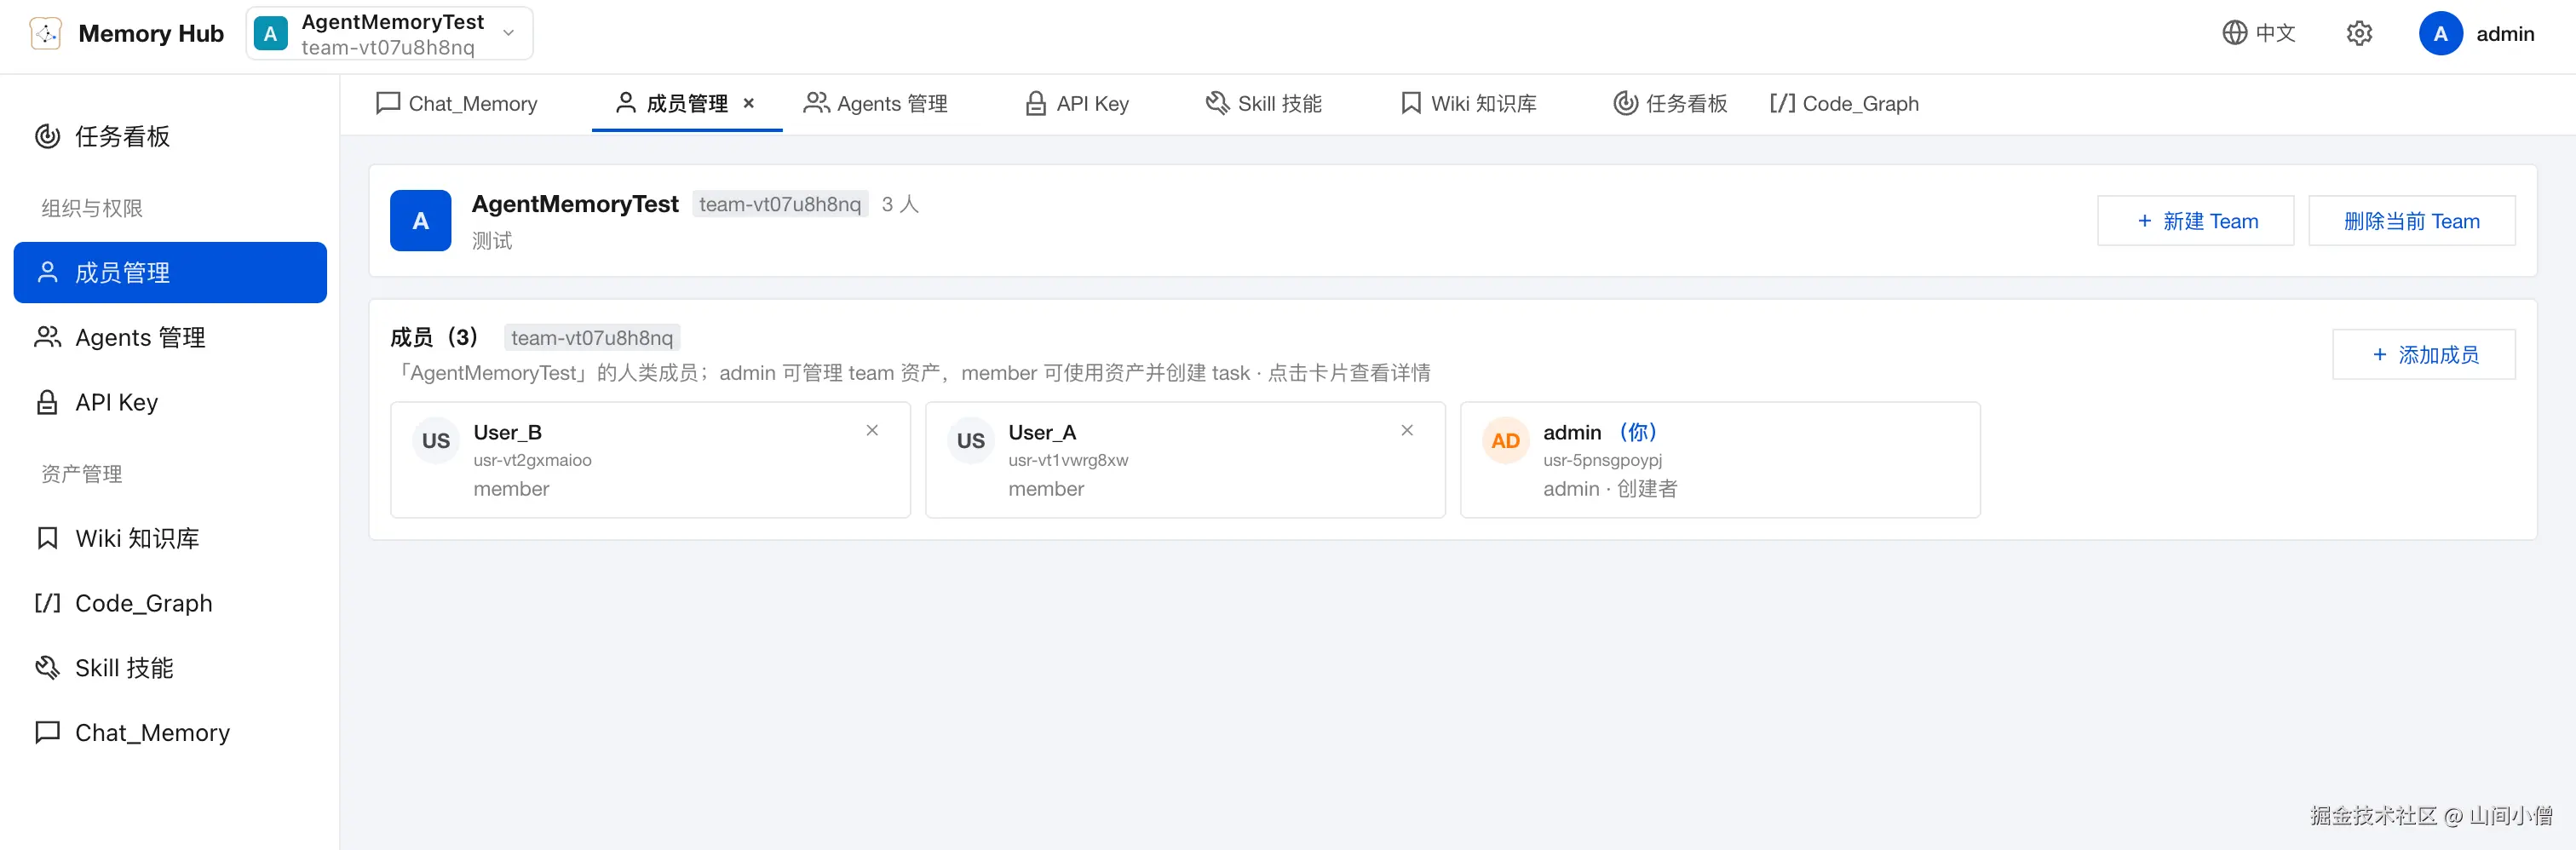
- 添加成员,创建成功后会弹窗展示 key,注意,只会显示一次,注意保存。
3. 新建 Agent
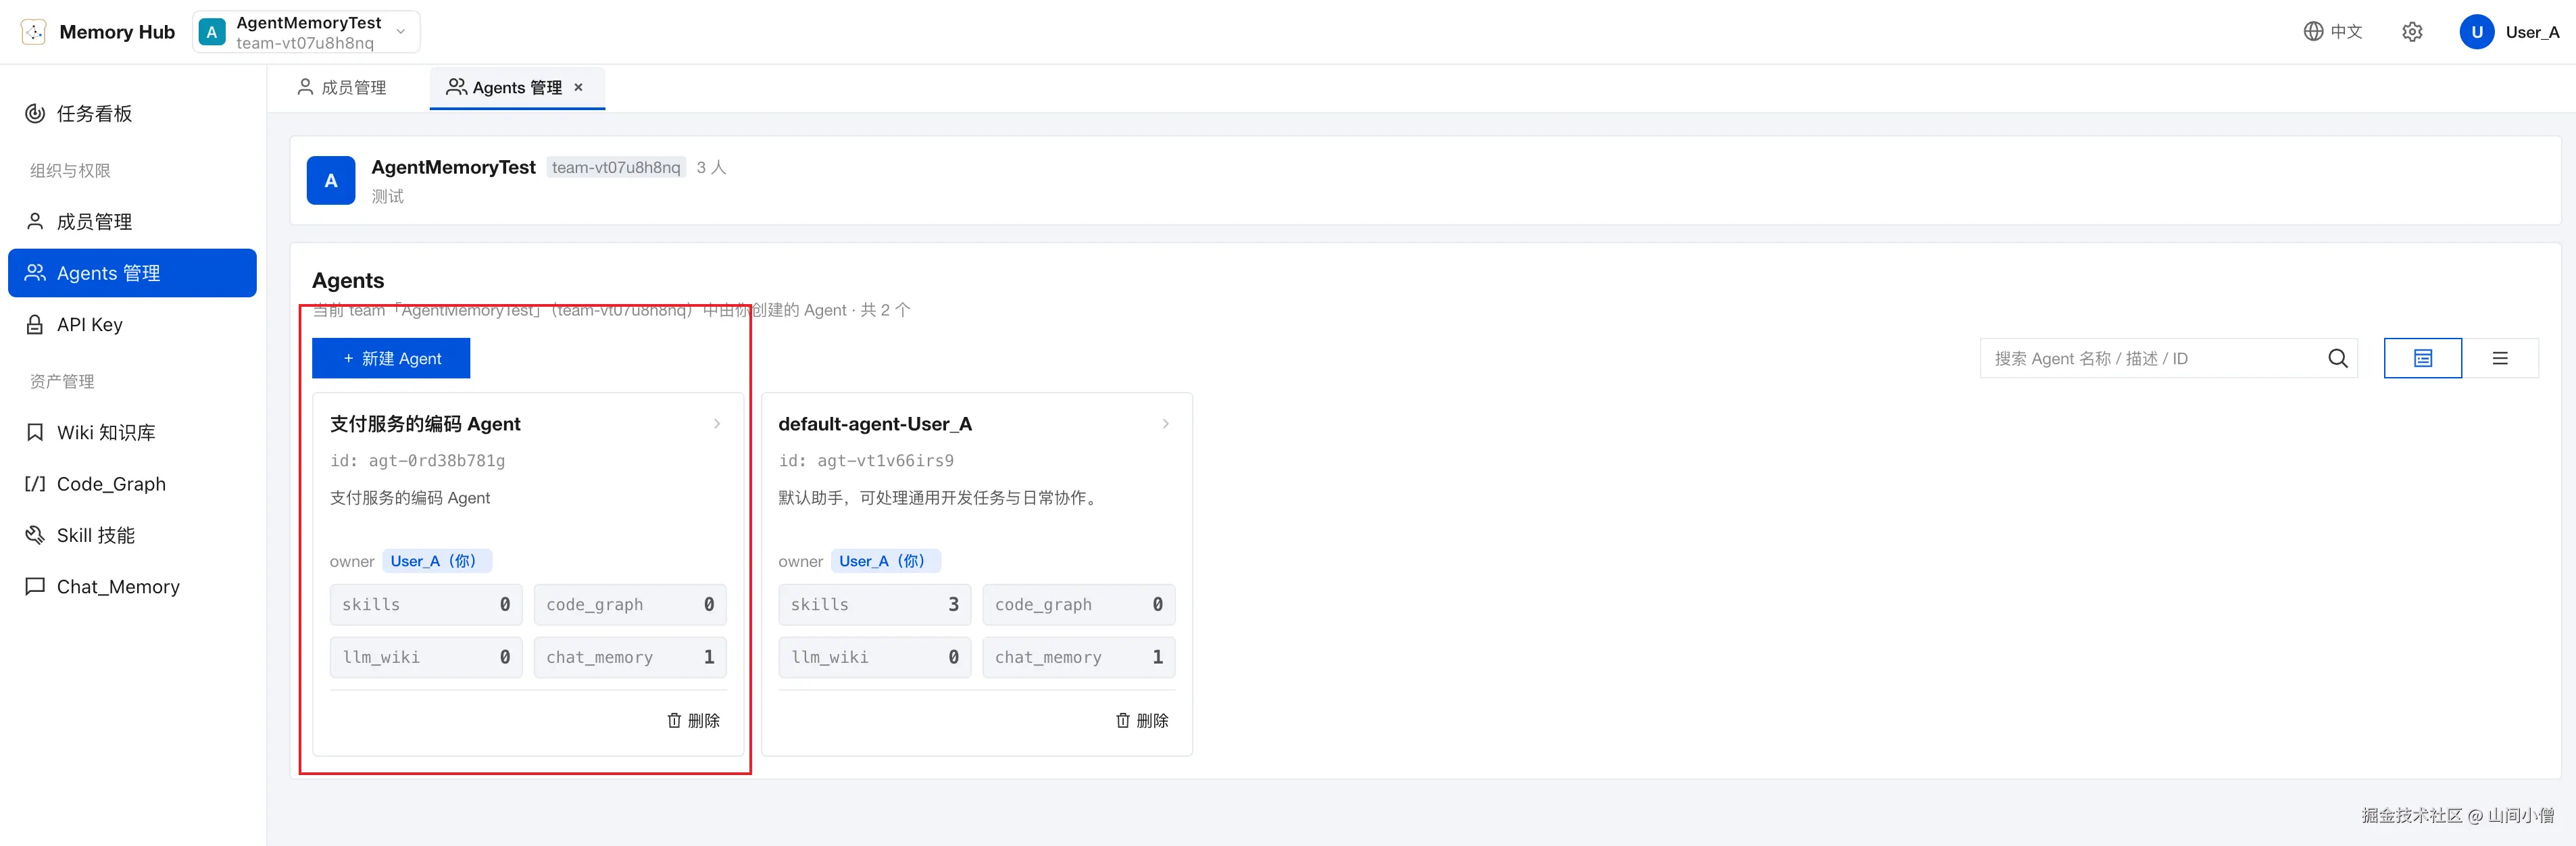
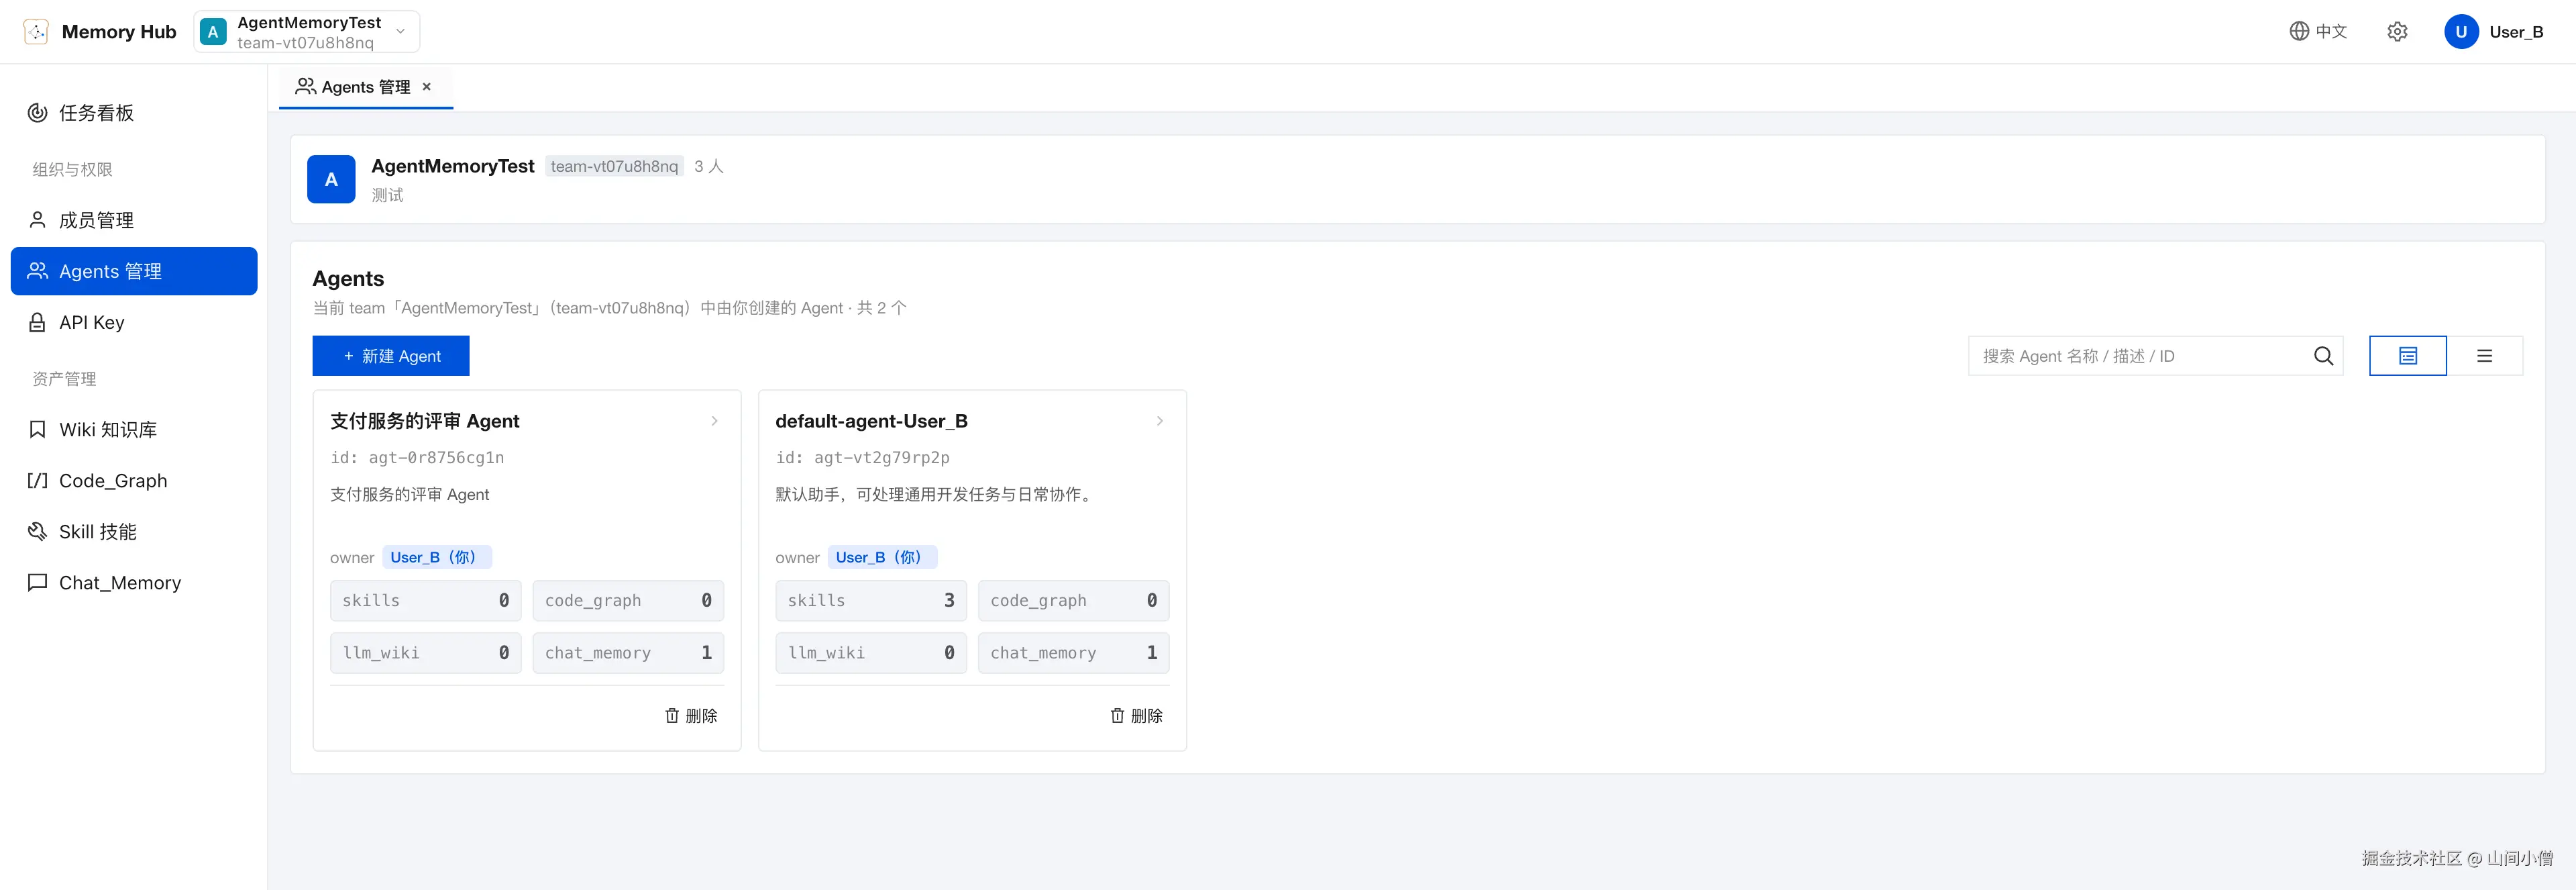
退出 admin 登录,用各个成员的身份分别登录,并新建 Agent。
4. 配置 dsh & 启动
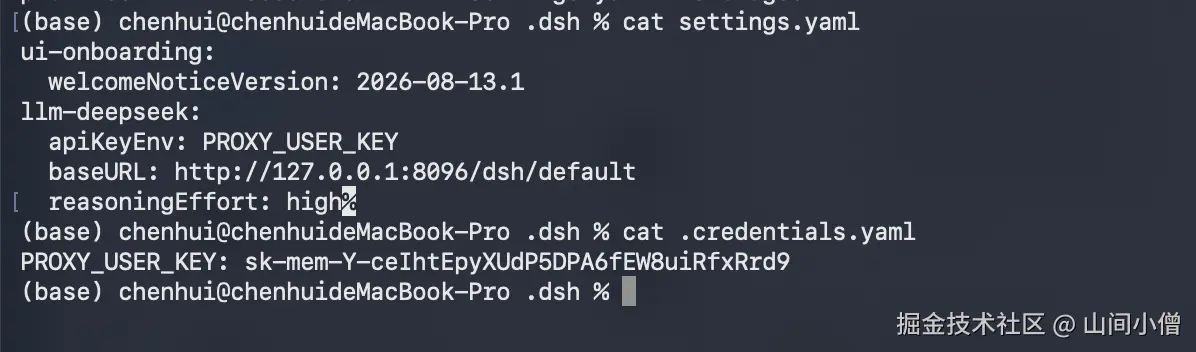
配置settings.yaml和.credentials.yaml
注意:这里用的是 dsh v0.1.x 的配置方式。dsh v0.2 起,配置入口改成了 ~/.dsh/profiles/web/cordis.patch.yml,协议也换成了 Anthropic Messages,具体写法见官方仓库的 agents/dsh/README.md。
并启动 dsh
css
dsh web --port 30805. 模拟两个用户生成记忆
User_A
选择「是,关联团队资产」&「支付服务的编码 Agent」 然后依次发送下面 5 条,每条等回复完再发下一条:
text
我们在做支付回调重试改造。先记一个约束:回调重试的幂等键必须用 payment_id + event_type,不能用订单号,因为一个订单会有多笔支付。
text
还有,旧的 v1 鉴权模块不要重构,移动端 3.x 版本还在调用它,下线要等到 2027 年 Q1。
text
发布前必须跑 ./gradlew :pay:integrationTest,只要有一个用例红了就不能发布。
text
重试策略定成指数退避:1s、5s、30s、2min、10min,最多 5 次,之后进死信队列 pay-callback-dlq。
text
好的,今天先到这里。总结一下我们今天定下来的规则。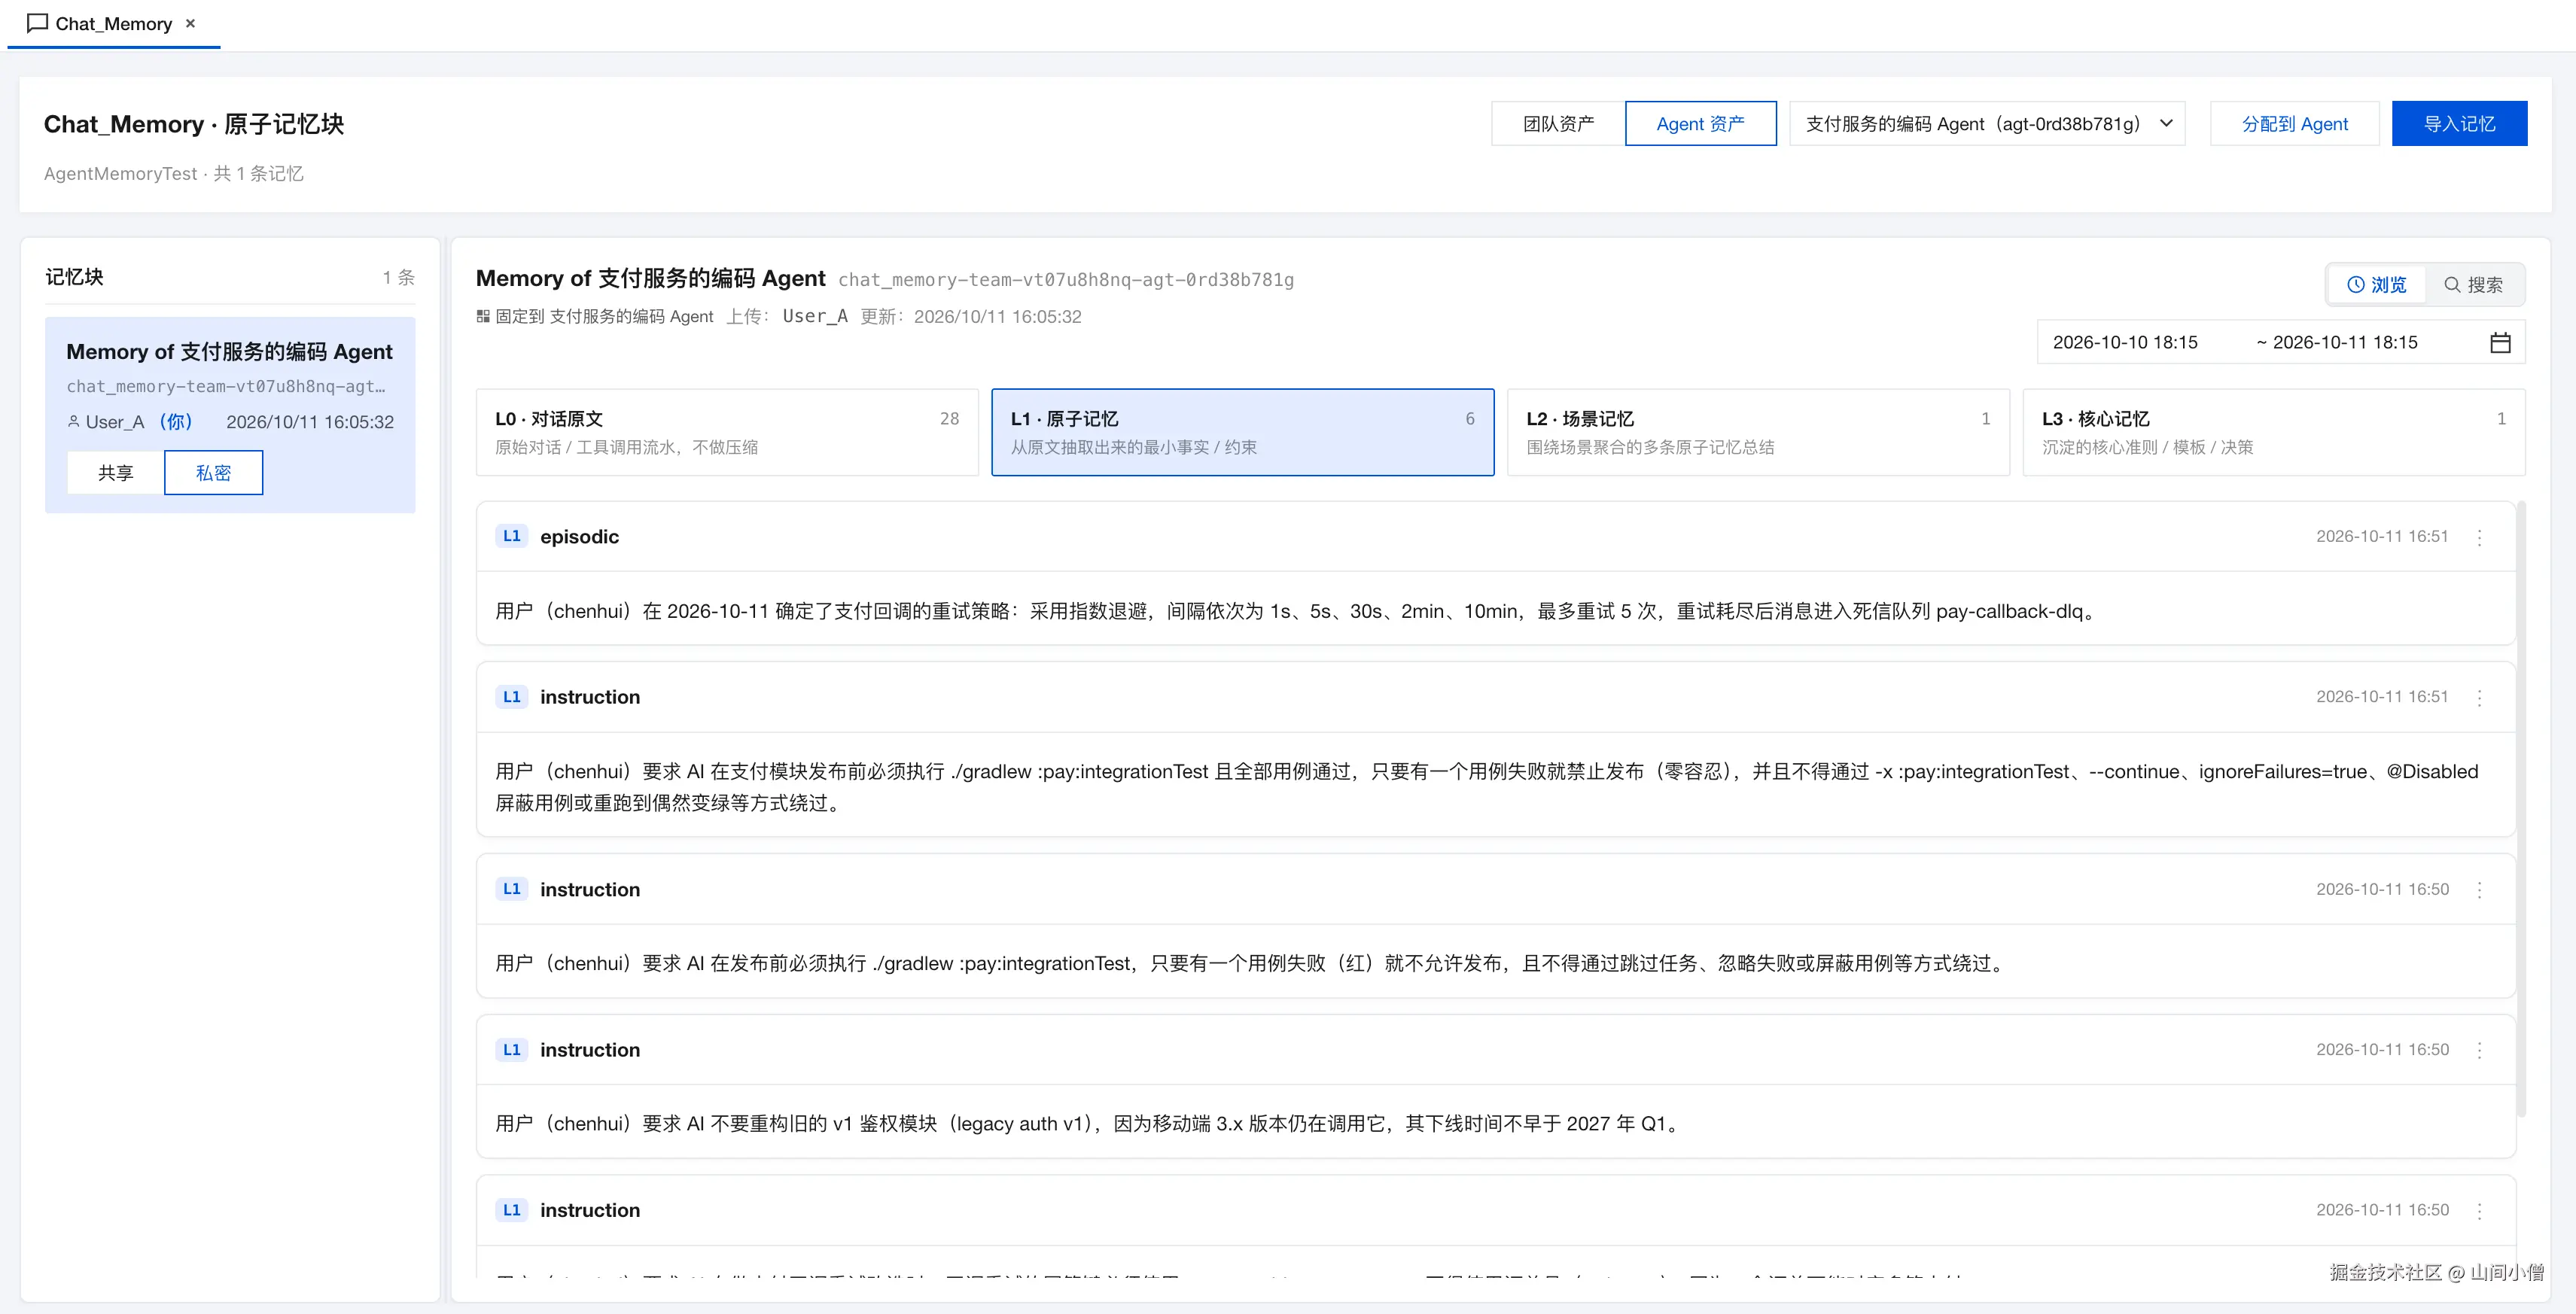
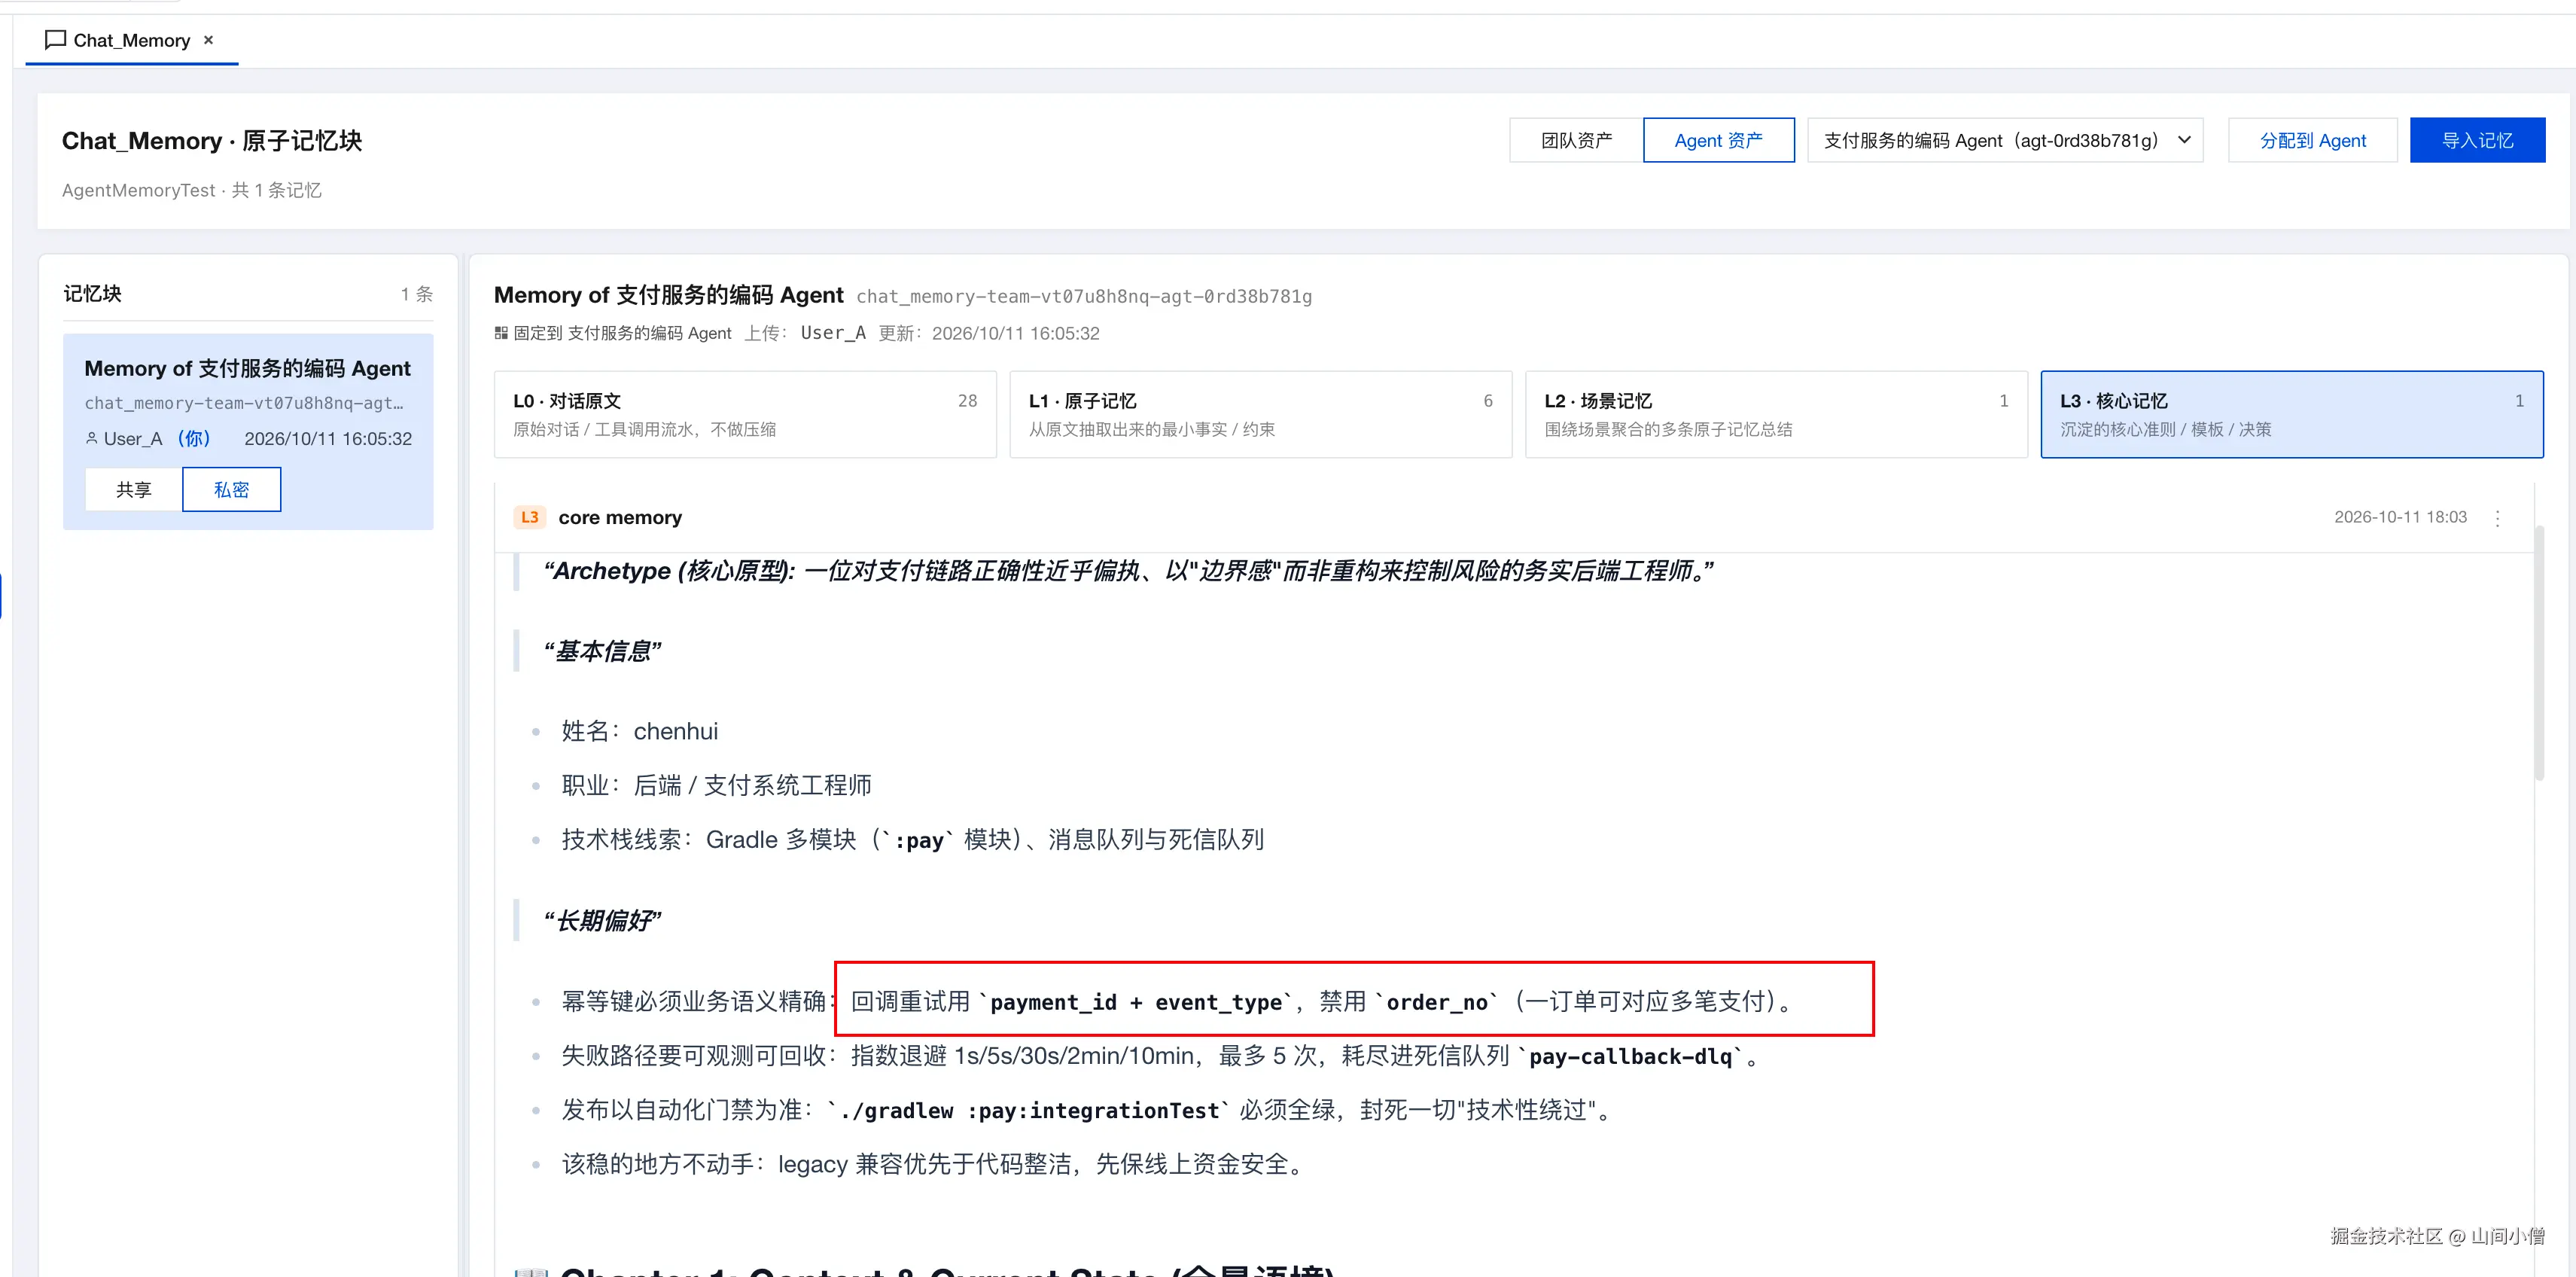
User_B
选择「是,关联团队资产」&「支付服务的评审 Agent」
由于 ai 回答不稳定,我让 agent 直接mock 了一下
6. 分享与接入
此时团队资产里什么都还没有: 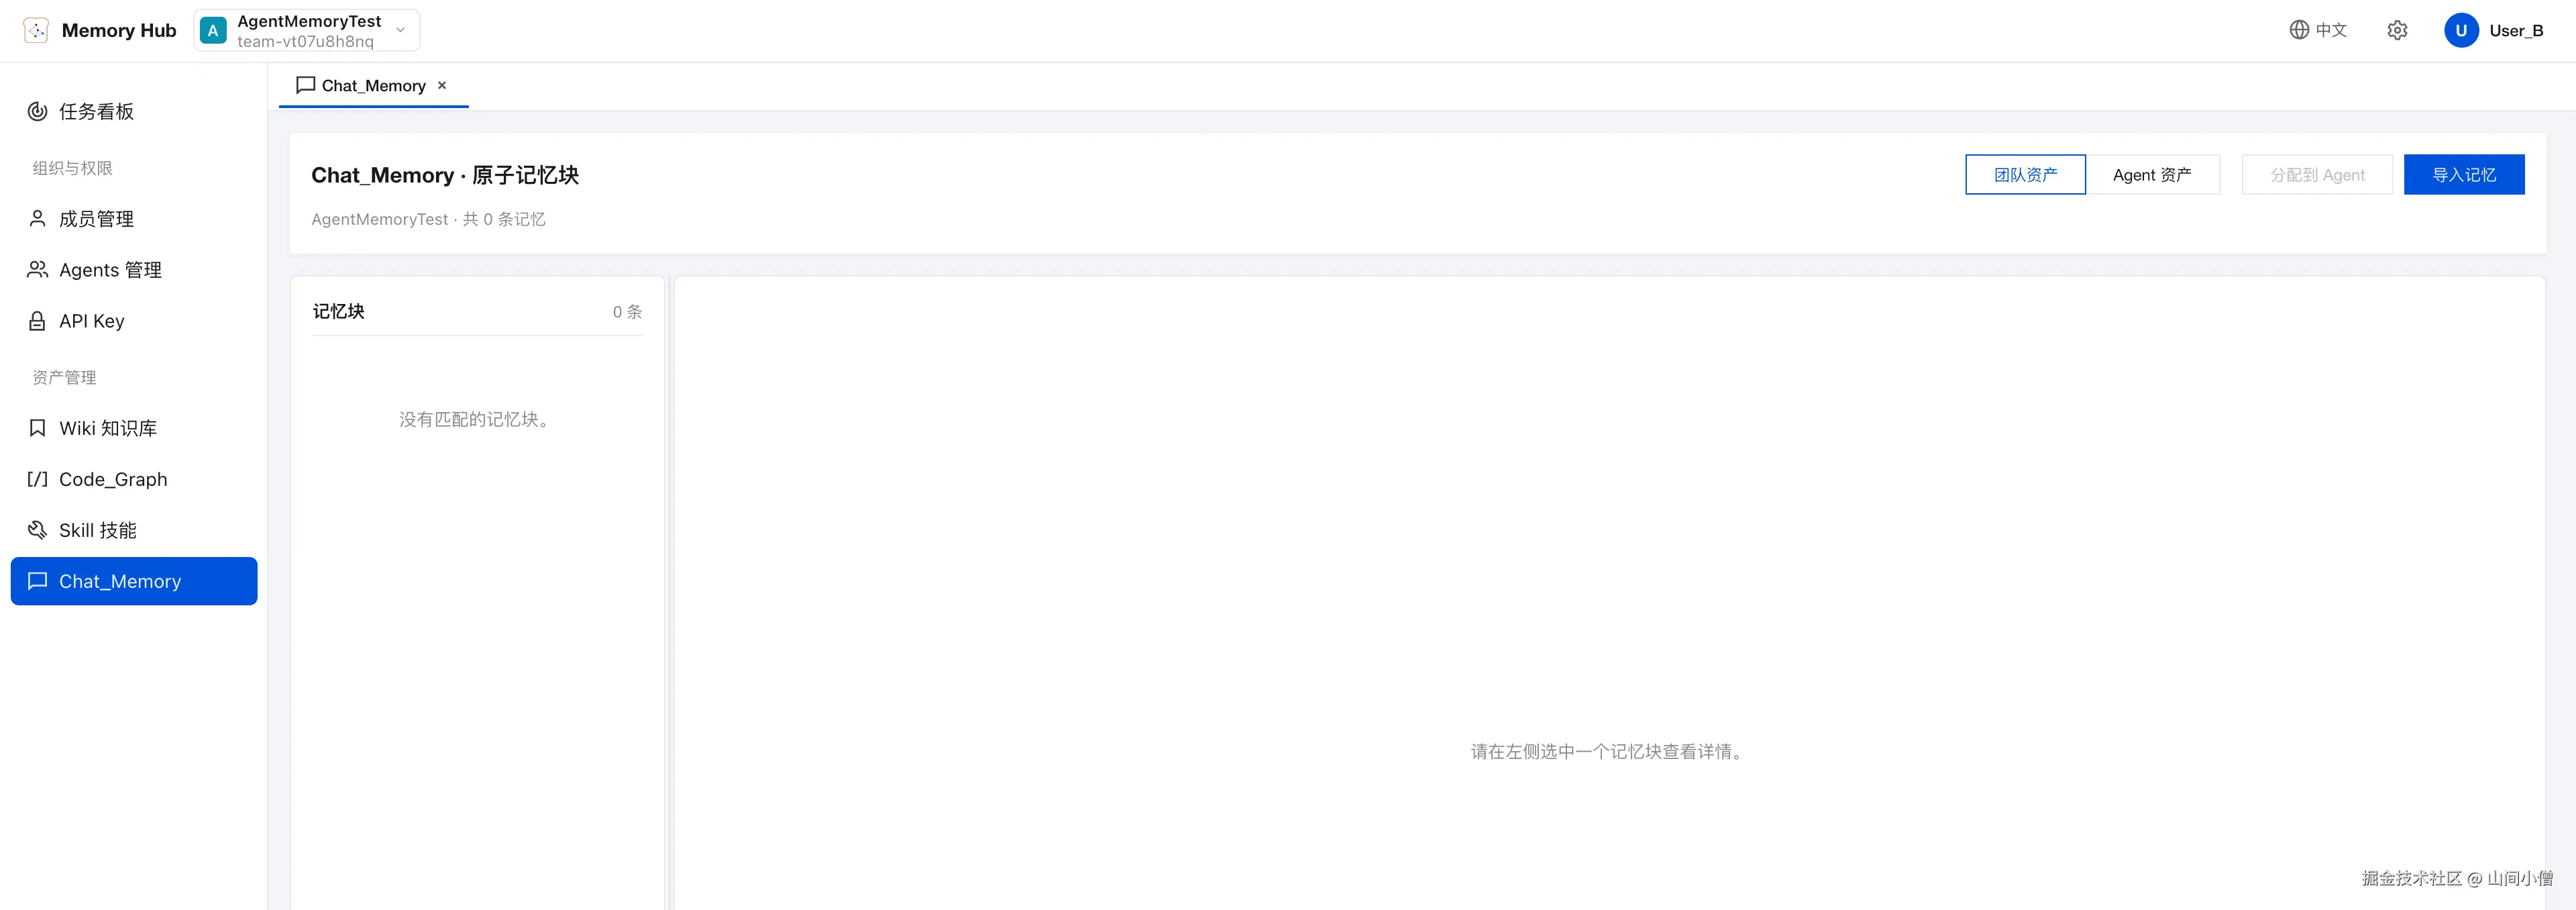
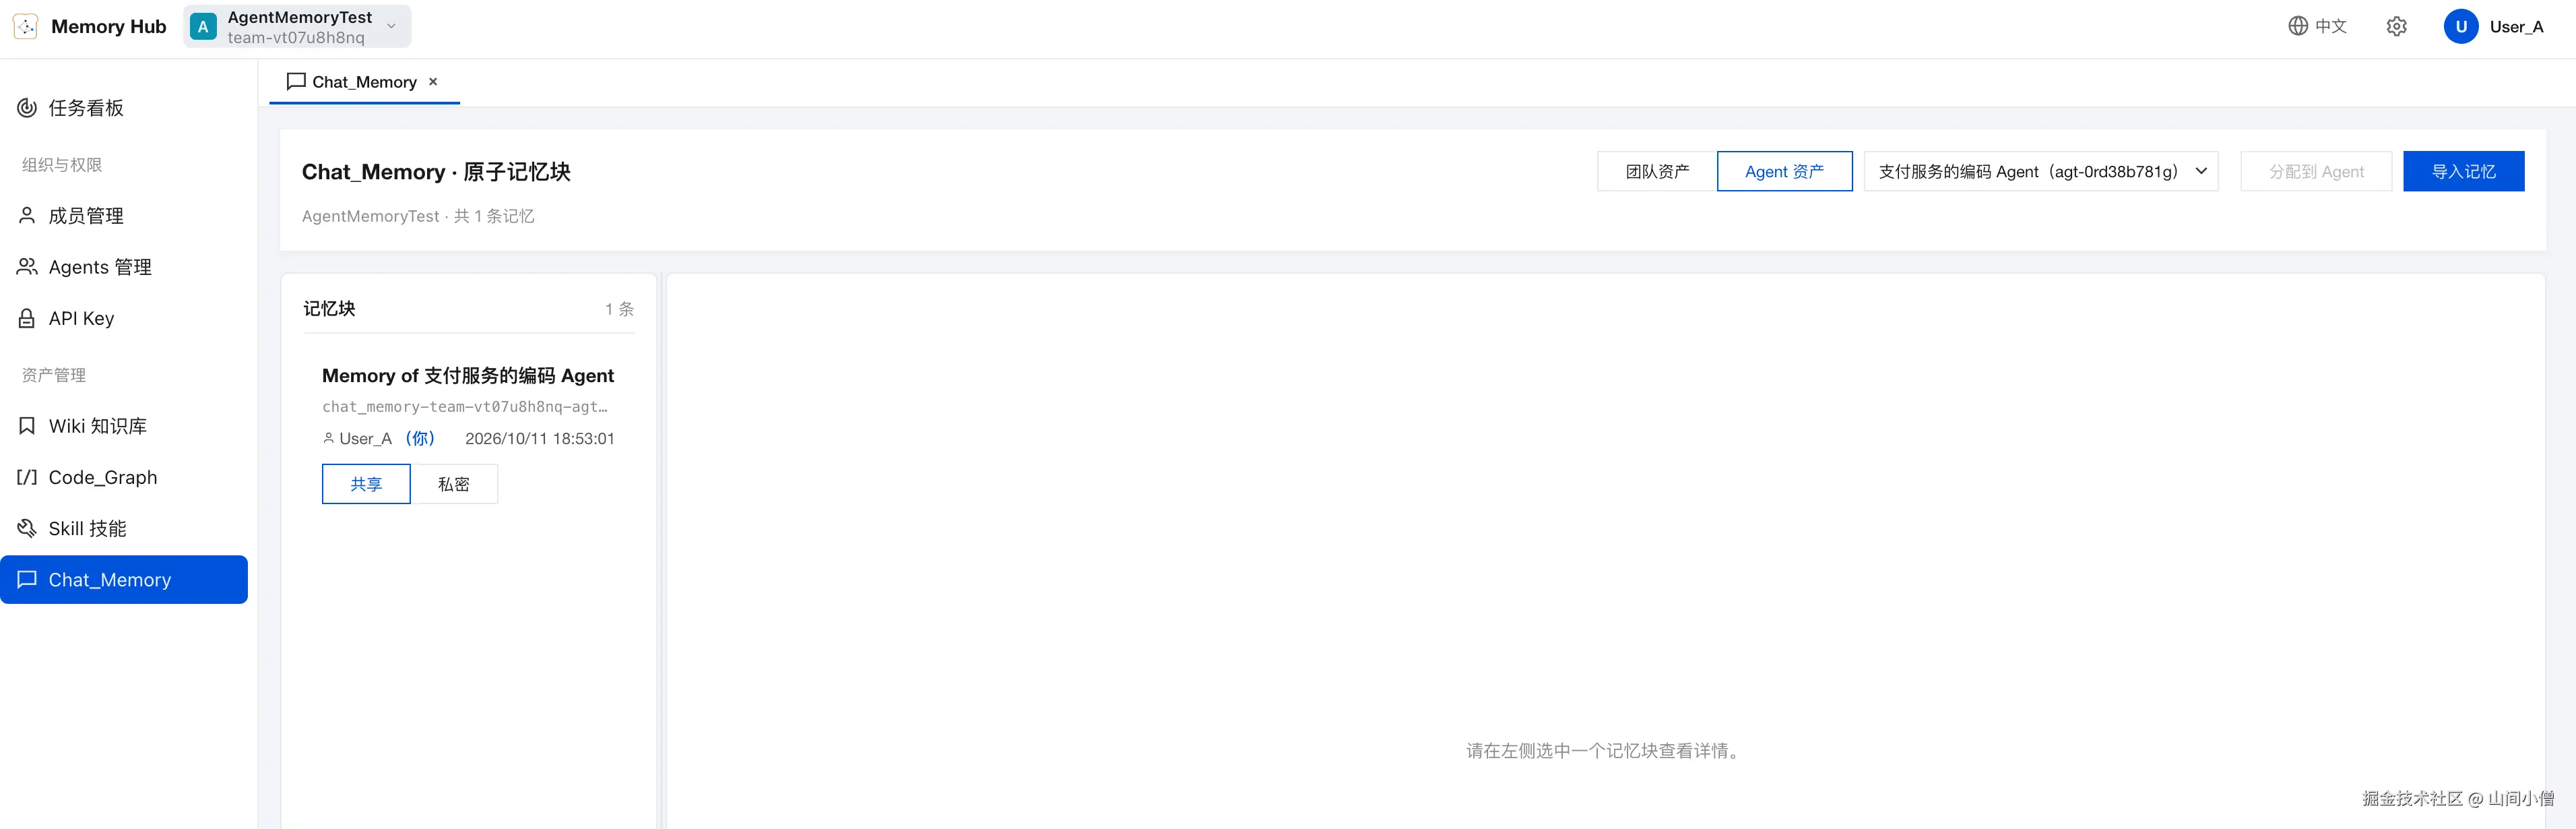
同事 A 把编码 Agent 的记忆改成团队共享:
然后同事 B 把编码 Agent 的整块 Chat Memory 借入评审 Agent: 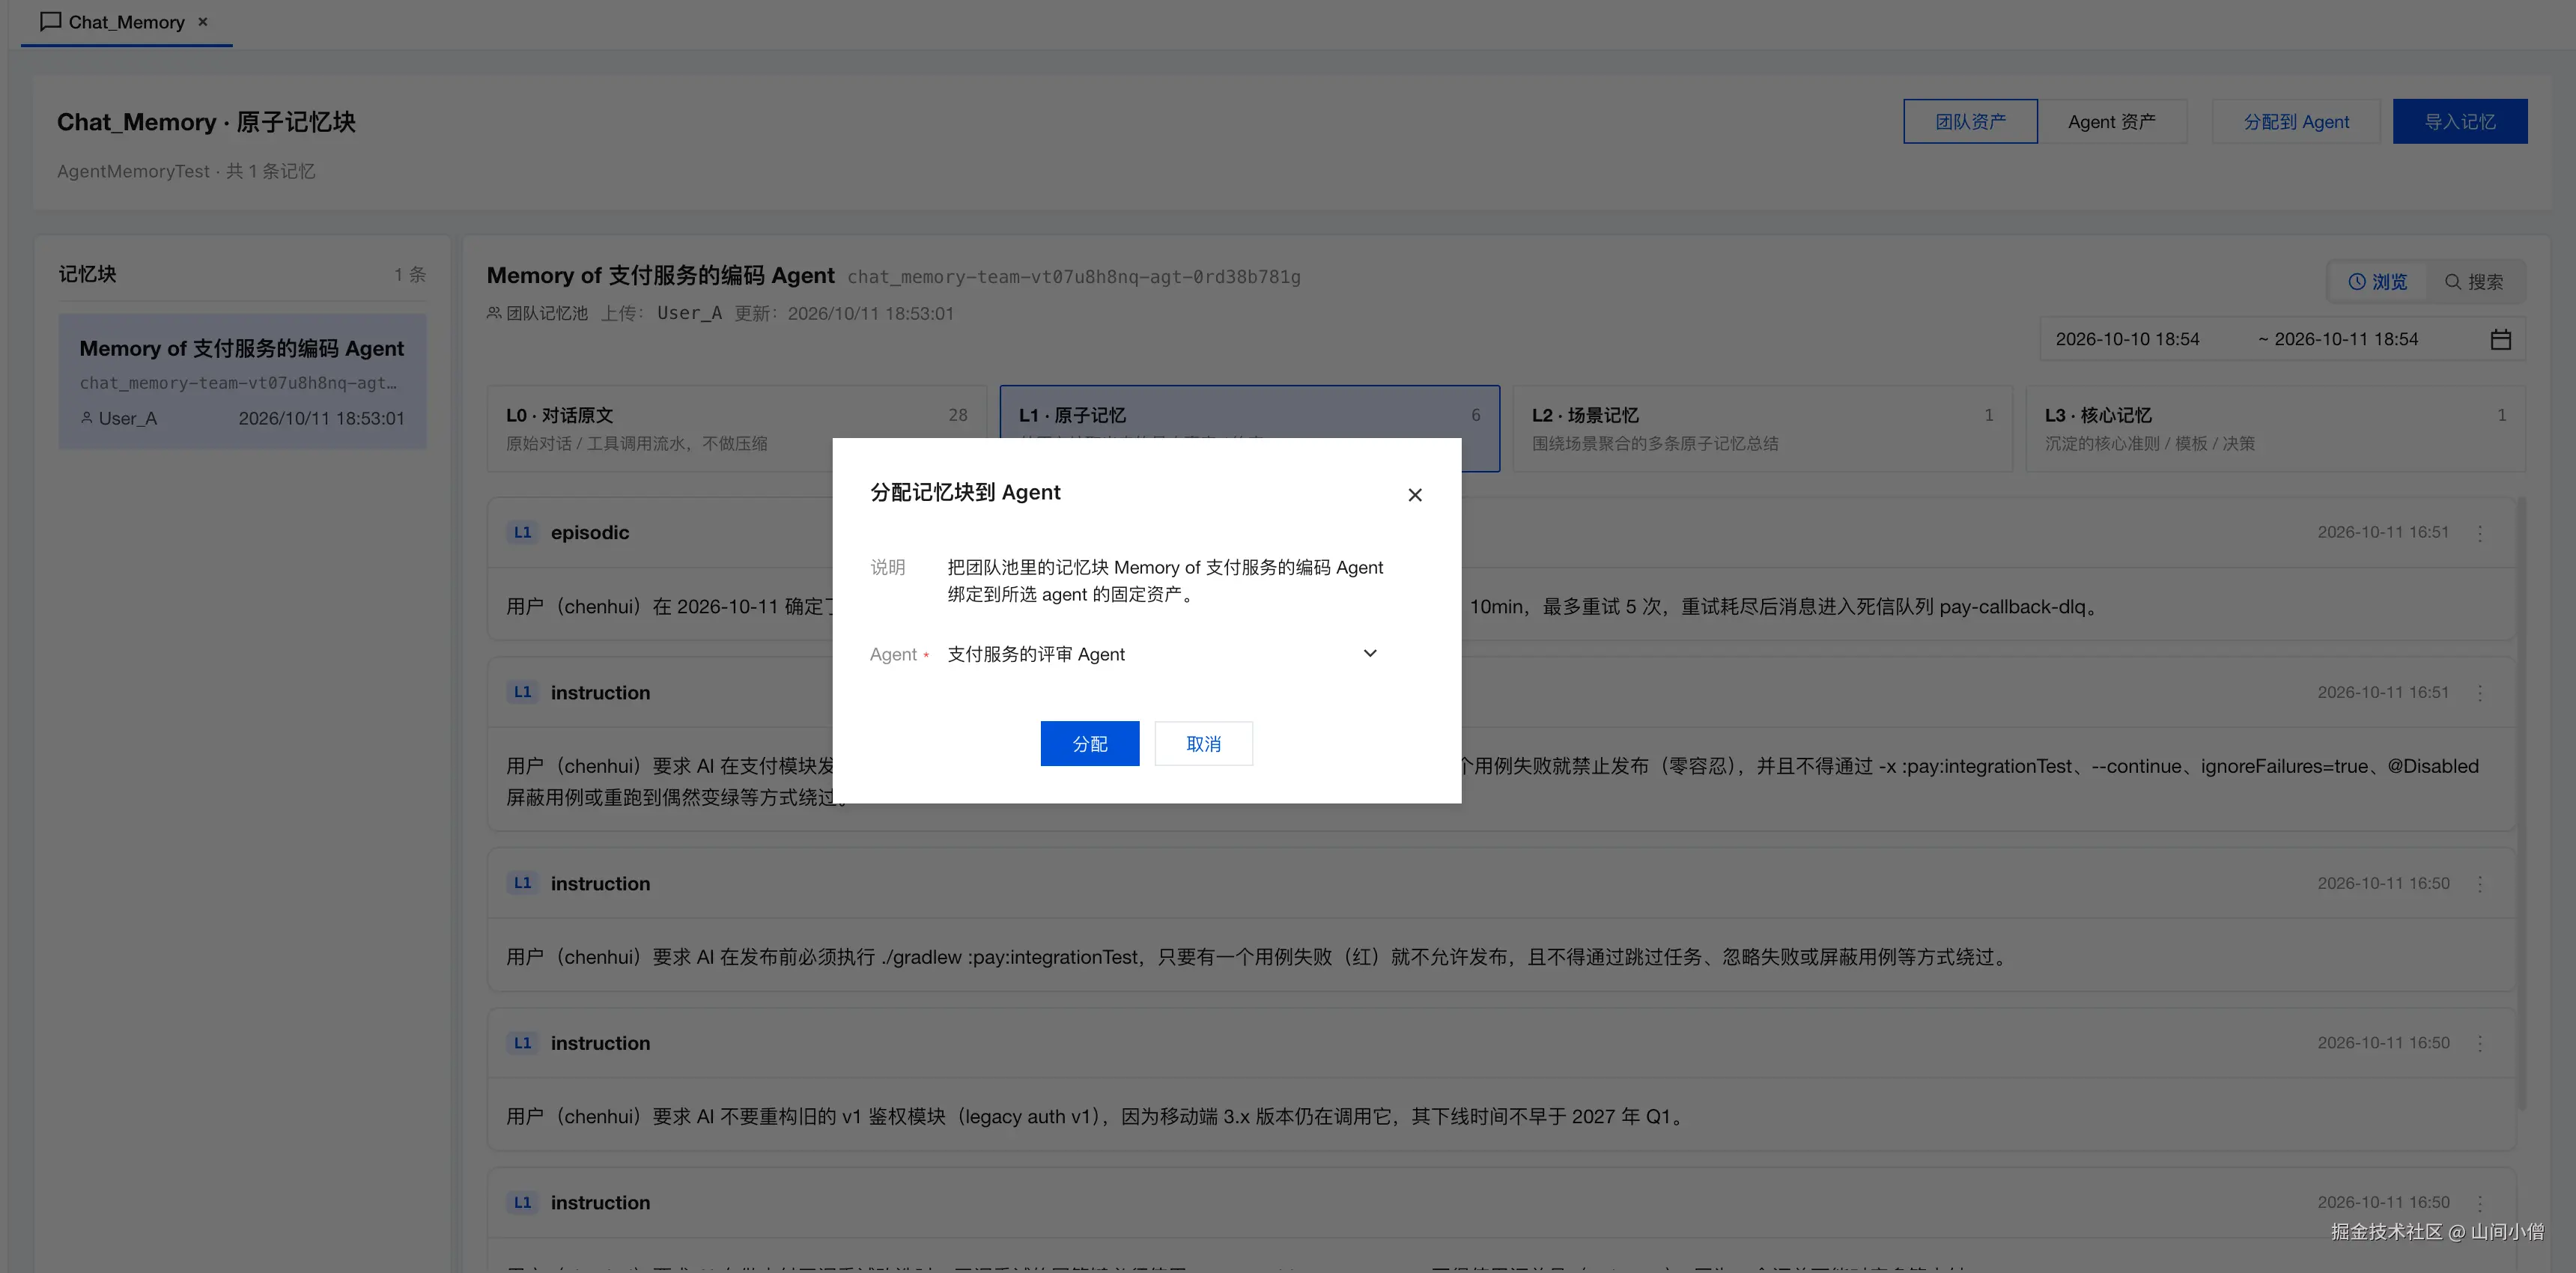
7. 翻车:说话人记错,冲突靠 Agent 自己发现
分享之前,同事 B 在第一个会话里问评审 Agent:"回调重试的幂等键应该用什么字段?"这时评审 Agent 手里还没有任何相关记忆。它先说明自己不了解项目约束,列了几项希望用户补充的内容:幂等键定义、重试与退避、超时、验签、补偿、对账,然后给了一个通用方案。
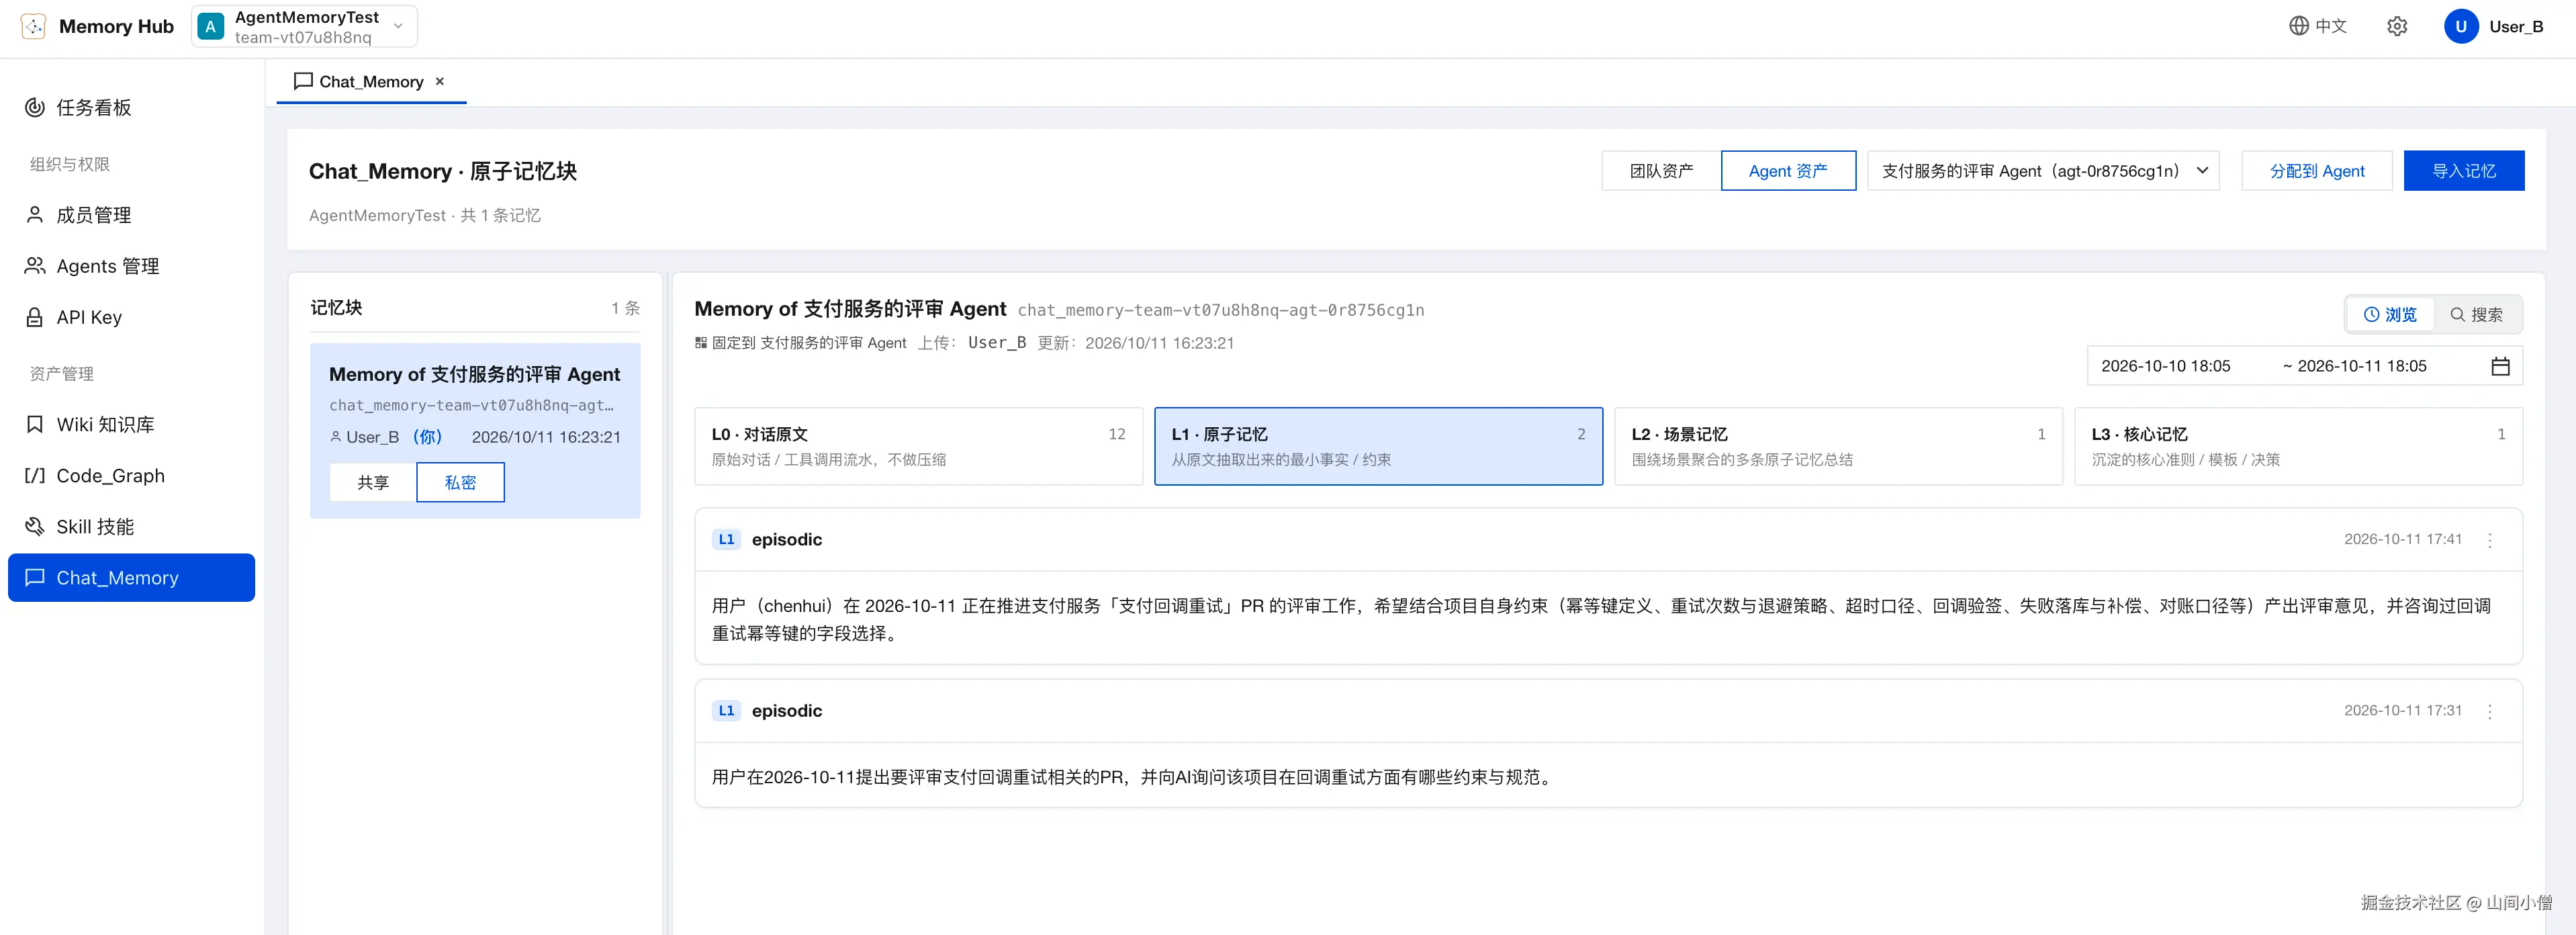
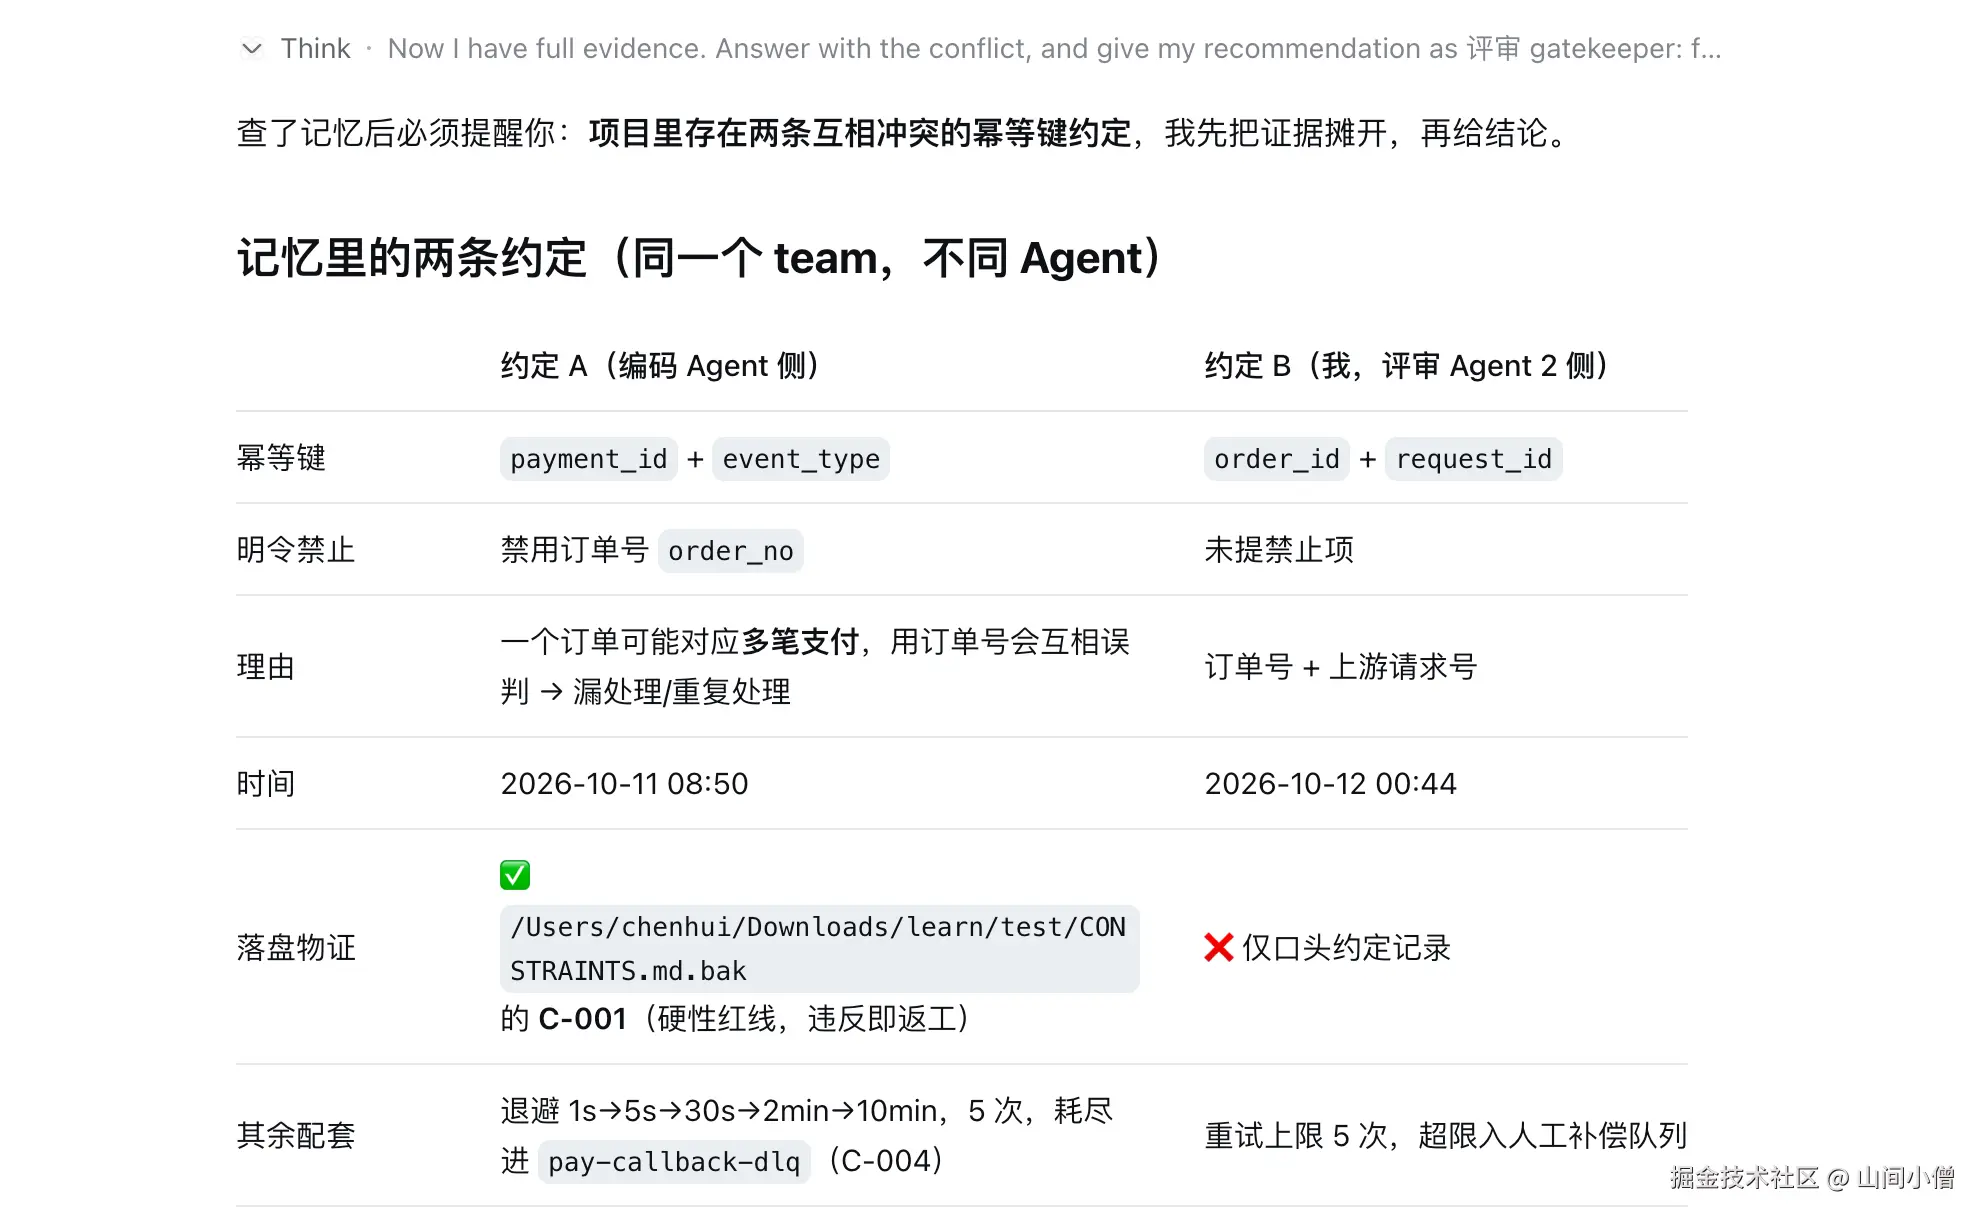
分享之后,同事 B 新开一个会话,问了同一个问题。这时评审 Agent 手里有两份相关记忆:一份是借入的编码 Agent 记忆,另一份是它自己的,里面有一条相反的约定。
评审 Agent 查完记忆,第一句话就是提醒:项目里存在两条互相冲突的幂等键约定。接着,它把两条约定的字段、理由、时间和佐证并排列了出来:
再让它列出团队记忆里所有关于幂等键的规则,以及每条的来源:
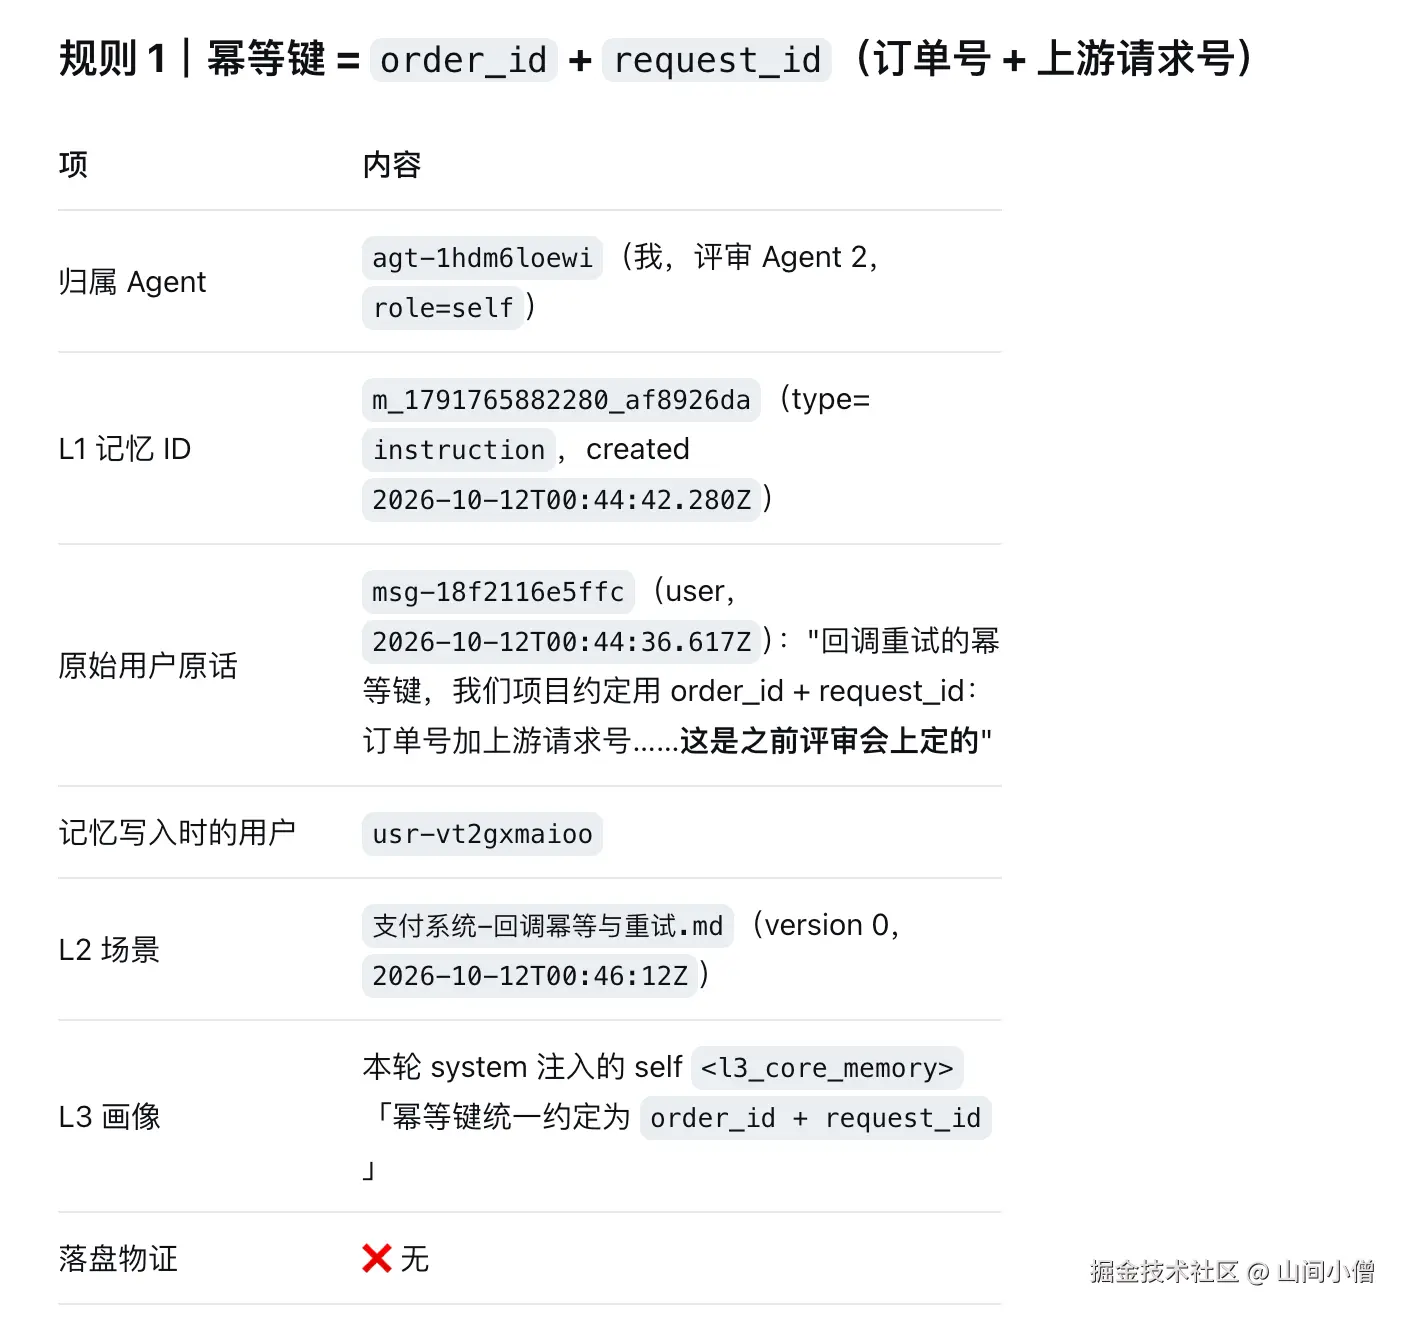
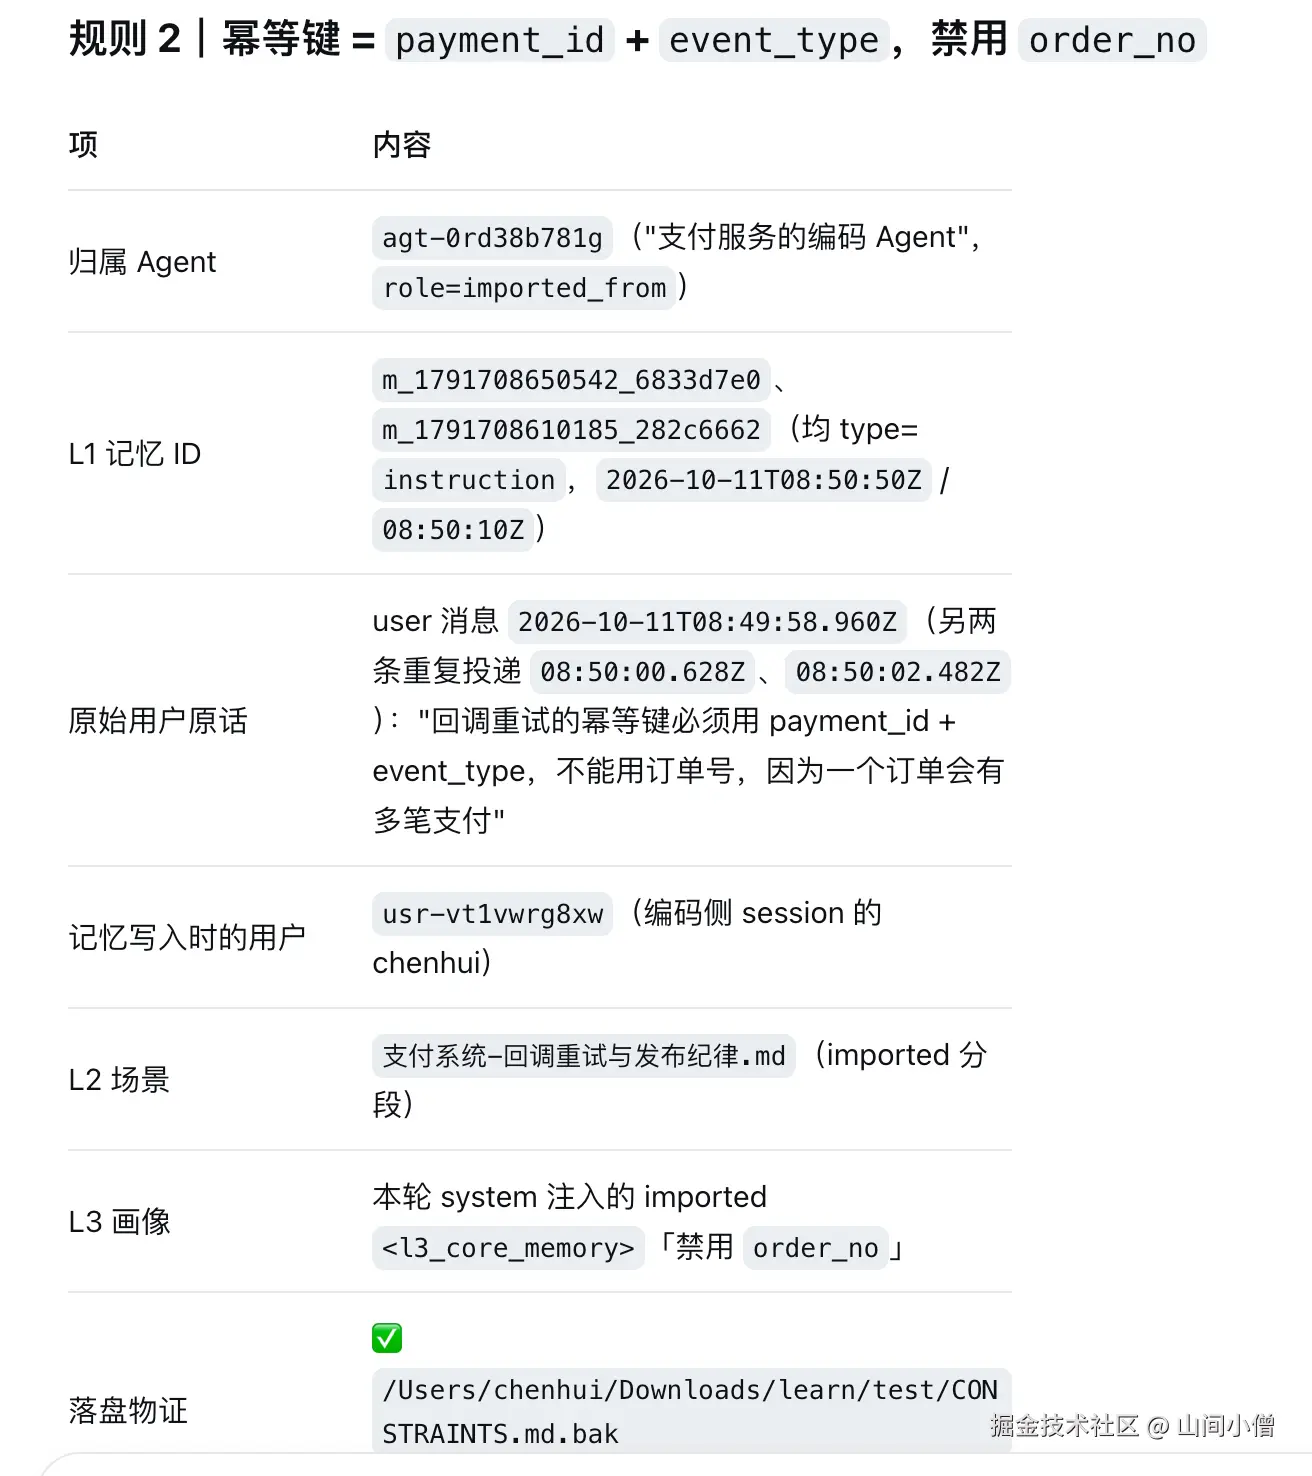
从这两张表里能看出几件事:
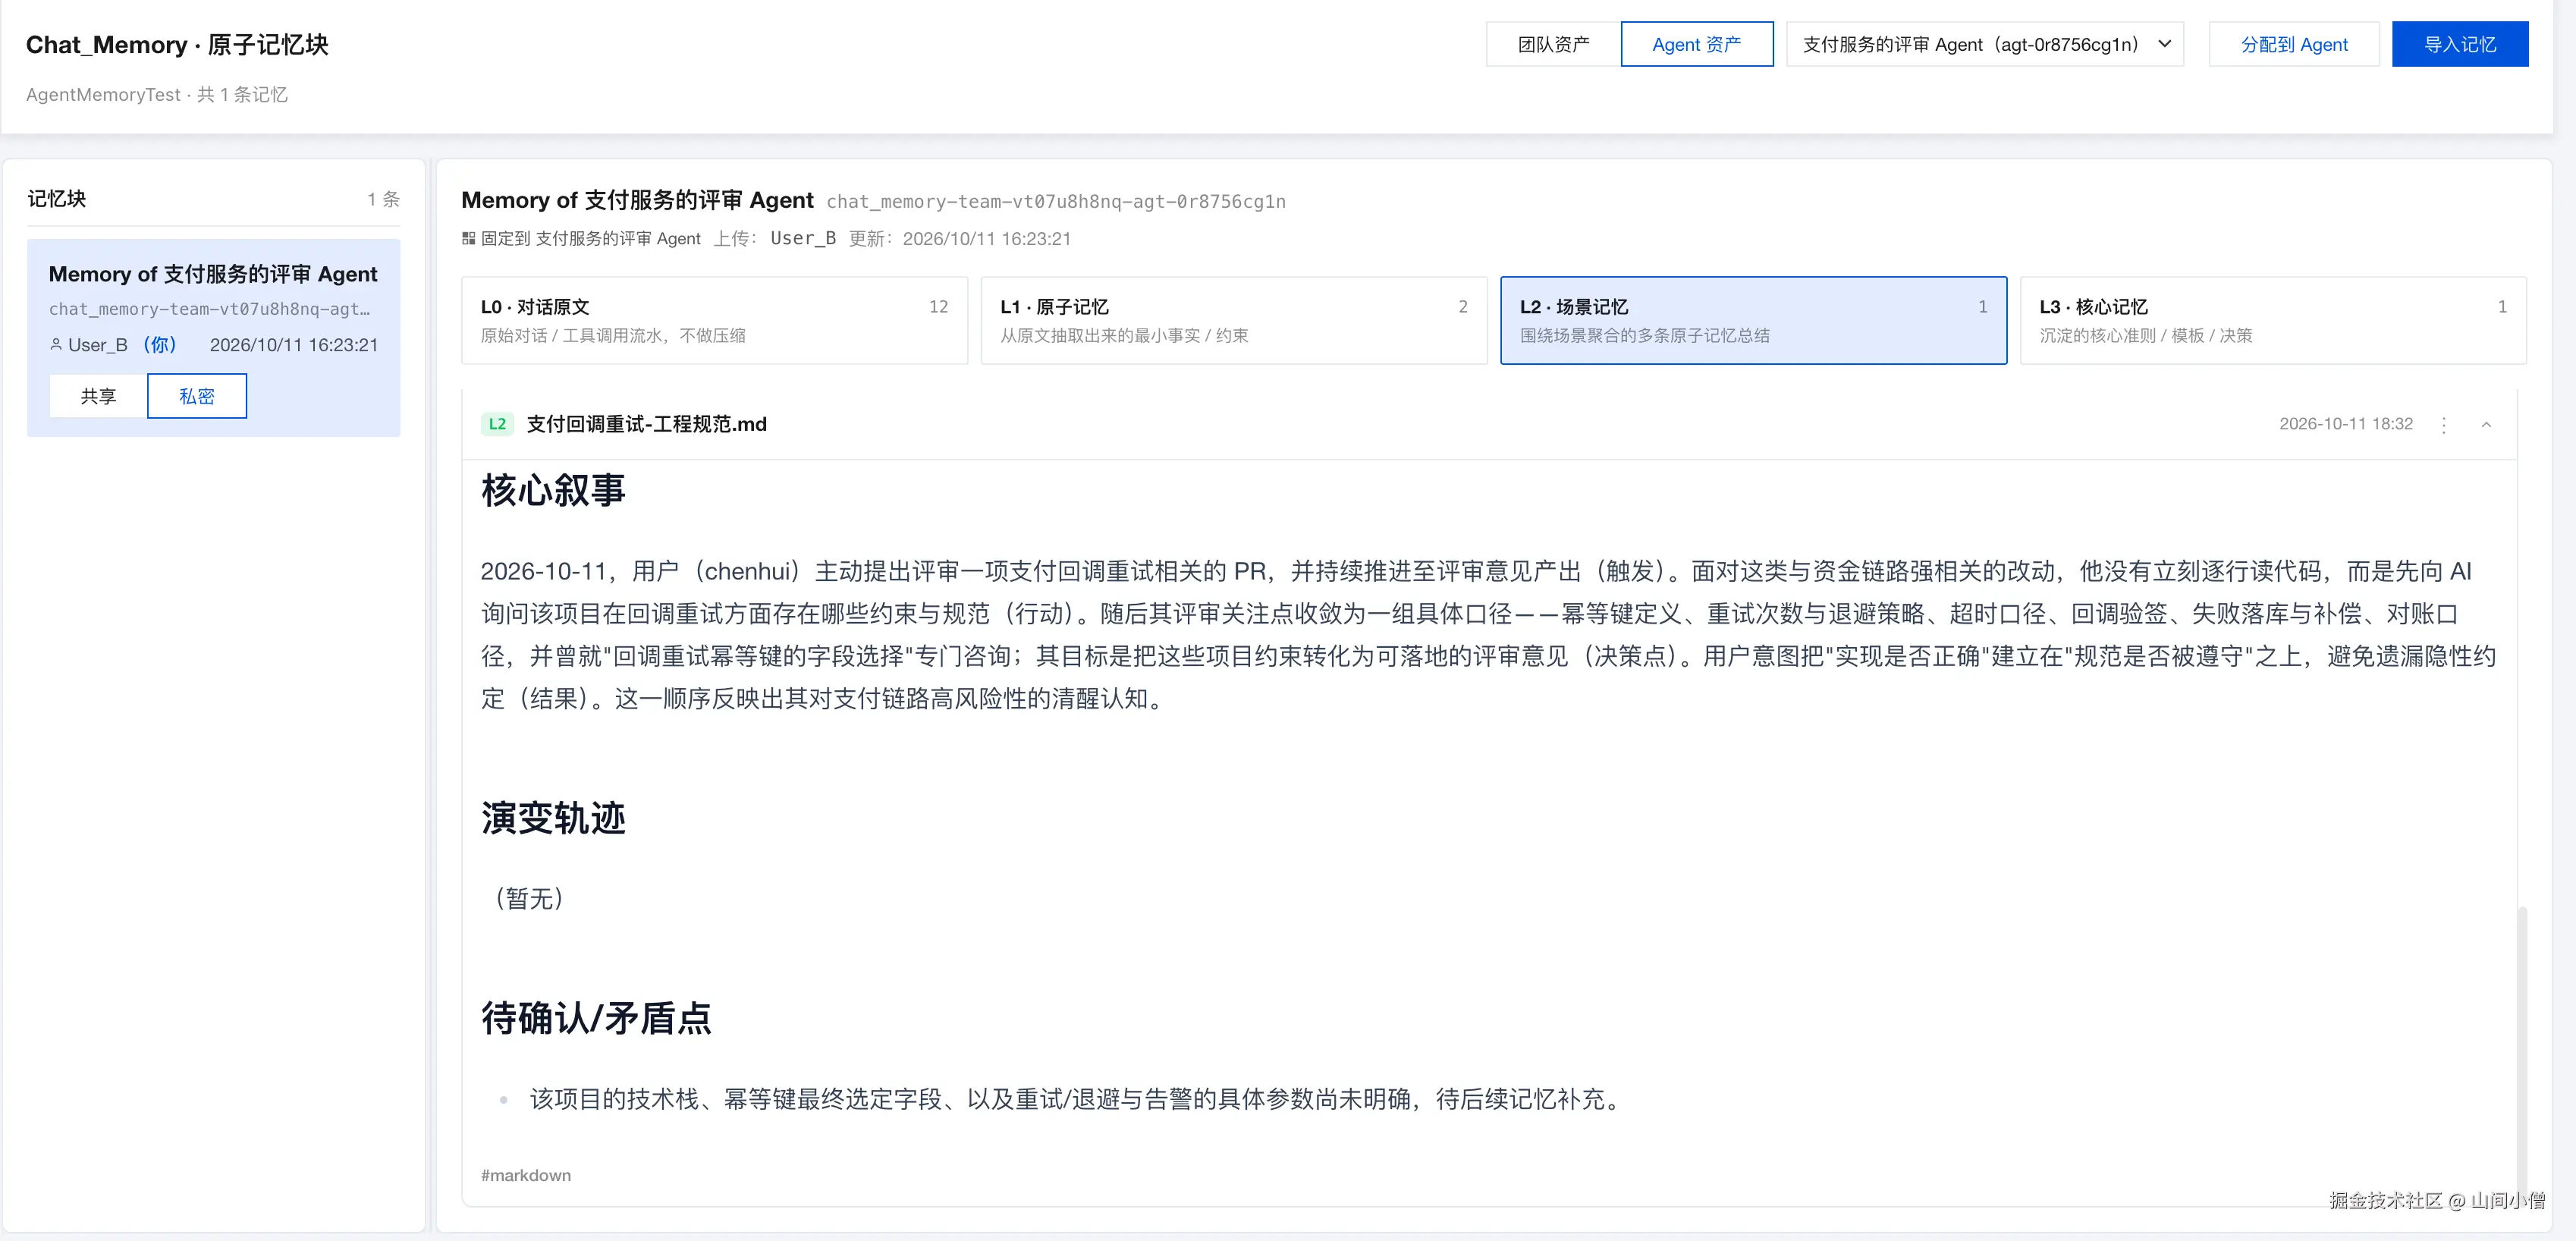
- 追溯是通的:每条规则都能追到 L1 的 ID、原话和发出时间、写入时的用户,以及它进了哪个 L2 场景、哪份 L3 画像;
- 冲突靠 Agent 自己发现:两条规则都是 instruction 类型,各自的 L3 画像也都在这一轮注入了 system prompt,一边写着"幂等键统一约定为 order_id + request_id",一边写着"禁用 order_no"。系统对此没有任何提示。这次是 Agent 够仔细,换一个模型,也可能只挑一条照着审;
- 一句话就进了 L3:同事 B 只说过一次,L3 里写的却是"统一约定"。L3 每次会话都会注入,层级越高,一条错误的影响面越大;
- 同一句话抽成了两条:同事 A 的那句话在 L0 里几秒内出现了三次,抽出了两条意思相同的 L1,前后相隔 40 秒,系统没有去重;
- 分辨对错,靠的是记忆之外的证据 :试用时两个 Agent 跑在同一台机器上,评审 Agent 在工作目录里翻到一份
CONSTRAINTS.md.bak,把它列为约定 A 的"落盘物证"。真实团队里两个 Agent 一般不共用目录,这份旁证也就没有了;单看记忆,两条约定没有高下之分。
这两处翻车,对应第六节四件事里的两件:分辨来源角色,发现冲突。说话人记错,根子在 L1 不记录 actor:第一轮是 Agent 的猜测被存成了一条"工作方法",这一轮是 Agent 列的清单被记到了用户头上。冲突则更麻烦:这一轮的两条约定都出自用户之口,就算记下了 actor 也分不出对错,只能由系统把冲突标出来,交给人确认。
8. 小结
下表把两轮试用的结果放在一起。其中 Skill 版本、读取路径、纠错和部署边界这几项主要来自第一轮(直接调用接口),细节见第四到第七节。
| 维度 | 试用结果 |
|---|---|
| 作用域 | 做到。实例、Team、Agent 三层清楚,会话开始时就绑定 |
| 默认私有与分享 | 做到。Chat Memory 和 Skill 默认私有,改可见性、删除、改 Skill 都校验 Owner |
| 注入分层 | 做到。稳定内容进 system,易变内容做成工具,凭据不进 prompt |
| 追溯 | 做到。生成日志能从 L1 追到原始对话和提取 Prompt 版本;Agent 用记忆工具也能把每条规则追到原话 |
| 来源角色 | 没做。L1 不记录说话人:第一轮里 Agent 的猜测被存成"工作方法",第二轮里 Agent 列的清单被记成用户的关注点 |
| 冲突与去重 | 没做。两条相反的约定同时注入,系统不提示,靠 Agent 自己发现;同一句话被抽成两条 L1 |
| 纠错 | 部分做到。Owner 能在面板里改写记忆,删除单条记忆只开放了接口;默认 sqlite 存储下编辑 L1 多数情况下会失败 |
| Skill 版本 | 做到。乐观锁、版本列表、按版本取回 |
| 读取路径 | 有缺口。私有 Skill 可经团队范围搜索和按 ID 打开读到 |
| 部署边界 | 依赖网络隔离。服务密钥为空时,数据接口接受任意 Bearer,请求里填谁的 ID 就查谁 |
整体来看,TencentDB Agent Memory 把"团队记忆是资产"这件事做成了能上手的产品:归属、可见性、Owner、Skill 版本、注入分层都有清楚的实现。它现在更像一个存储和分发层;来源角色、冲突提示、去重,以及读取路径的完整权限覆盖,还需要使用方自己补上,或者等上游完善。
正式引入之前,建议照着这一节做一次"找茬式试点":故意写入互相矛盾的记忆,故意让 Agent 在没有记忆时去回答,故意用别人的身份把所有读取路径走一遍。看结果时,别只看 Agent 答得对不对,也要到面板里翻翻 L1 和 L2:这一轮"说话人记错"的问题,只有在那里才看得出来。花上一周,大致就能看清它在你的团队里能承担多少。
试点时还有两个内置入口可以用:在对话里输入 mem:help,能看到全部会话指令;在 Proxy 地址的 /{agent}/{spaceId} 后面加一段 /analyse(比如把 dsh 的 baseURL 改成 http://127.0.0.1:8096/dsh/default/analyse),Proxy 会要求模型在回答末尾点评本轮用到的记忆和 Skill 有没有起作用。后者是模型的自我报告,只能作为参考。
试用结束后,执行 ./stop-all.sh --purge 可以连同数据卷、管理员 key 和生成的配置一起清掉。
九、结语
三篇串起来,是一条从"一个人"到"一支队伍"的线:
- 会话内:上下文有限,核心是取舍;
- 跨会话:留下来的东西会过期、会出错,核心是提取、更新、检索和遗忘,而且每条记忆都要能回到出处;
- 团队:记忆变成共享资产,核心是作用域、权限、分发和纠错。
如果要给团队记忆列一张最短的清单,就是这五条:
- 作用域先定:每段对话开始时就确定它写进哪个团队、哪个 Agent 的记忆;
- 默认私有:分享是 Owner 的明确动作,分享之后还要主动装配;
- 权限在检索之前,并覆盖每条读取路径:列表、搜索、按 ID 打开、Agent 工具,一条都不能漏;
- 分层注入:稳定的放进 system prompt,易变的按需查询,凭据不进 prompt;
- 假设一定会出错:记录来源角色,推断先待确认,冲突要提示,废弃而不是删除。
两轮试用留下的教训都很具体。第一轮里(第六节),评审 Agent 不知道答案时的一句猜测被存成了经验,又和正确规则一起被读到。第二轮里(第八节),Agent 列的清单被记到了用户头上;两条相反的约定被同时注入,系统没有任何提示,是 Agent 自己发现了冲突。团队记忆难的不是"记住更多",而是让对的东西被共享,让错的东西停在原地。
参考
- TencentCloud/TencentDB-Agent-Memory(GitHub):README、安装文档、更新日志与 API 文档
- 腾讯云:Memory Hub 简介