Transformer与自注意力机制:一台"全员检索"机器的说明书
一句话剧透全文:注意力机制不是"像"一次检索,它本身就是一次检索------只是发生在模型内部、发生在词与词之间。想通这一点,Transformer 的每一个零件都会变得顺理成章。
0. 引子:从"它"指代谁说起
先看一句话:
那只猫追老鼠,因为它饿了。
"它"指的是谁?你大概连半秒都没用------是猫,不是老鼠。因为饿了才去追的,是猫。
这个判断对你毫不费力,但对计算机来说是一道天堑:"它"这个字本身不携带任何信息,它的含义完全取决于上文里的哪个词。机器怎么知道该把"猫"的含义注入到"它"身上?
这个能力,就是注意力(Attention)。2017 年 Google 的一篇论文用了一个嚣张的标题------《Attention Is All You Need》(注意力就是你所需要的一切)------宣布:只要这一个机制,就能替代之前所有的文本处理方案。此后 GPT、BERT、Claude、通义千问......你听说过的所有大模型,全部建在这块地基上。
这篇文章要零数学门槛地讲透两件事:注意力到底是什么 ,以及 Transformer 怎么把这个机制组装成一台完整的机器。全程只用类比和图。
1. 先看病:一场传话游戏
要理解注意力为什么伟大,得先看它治好了什么病。
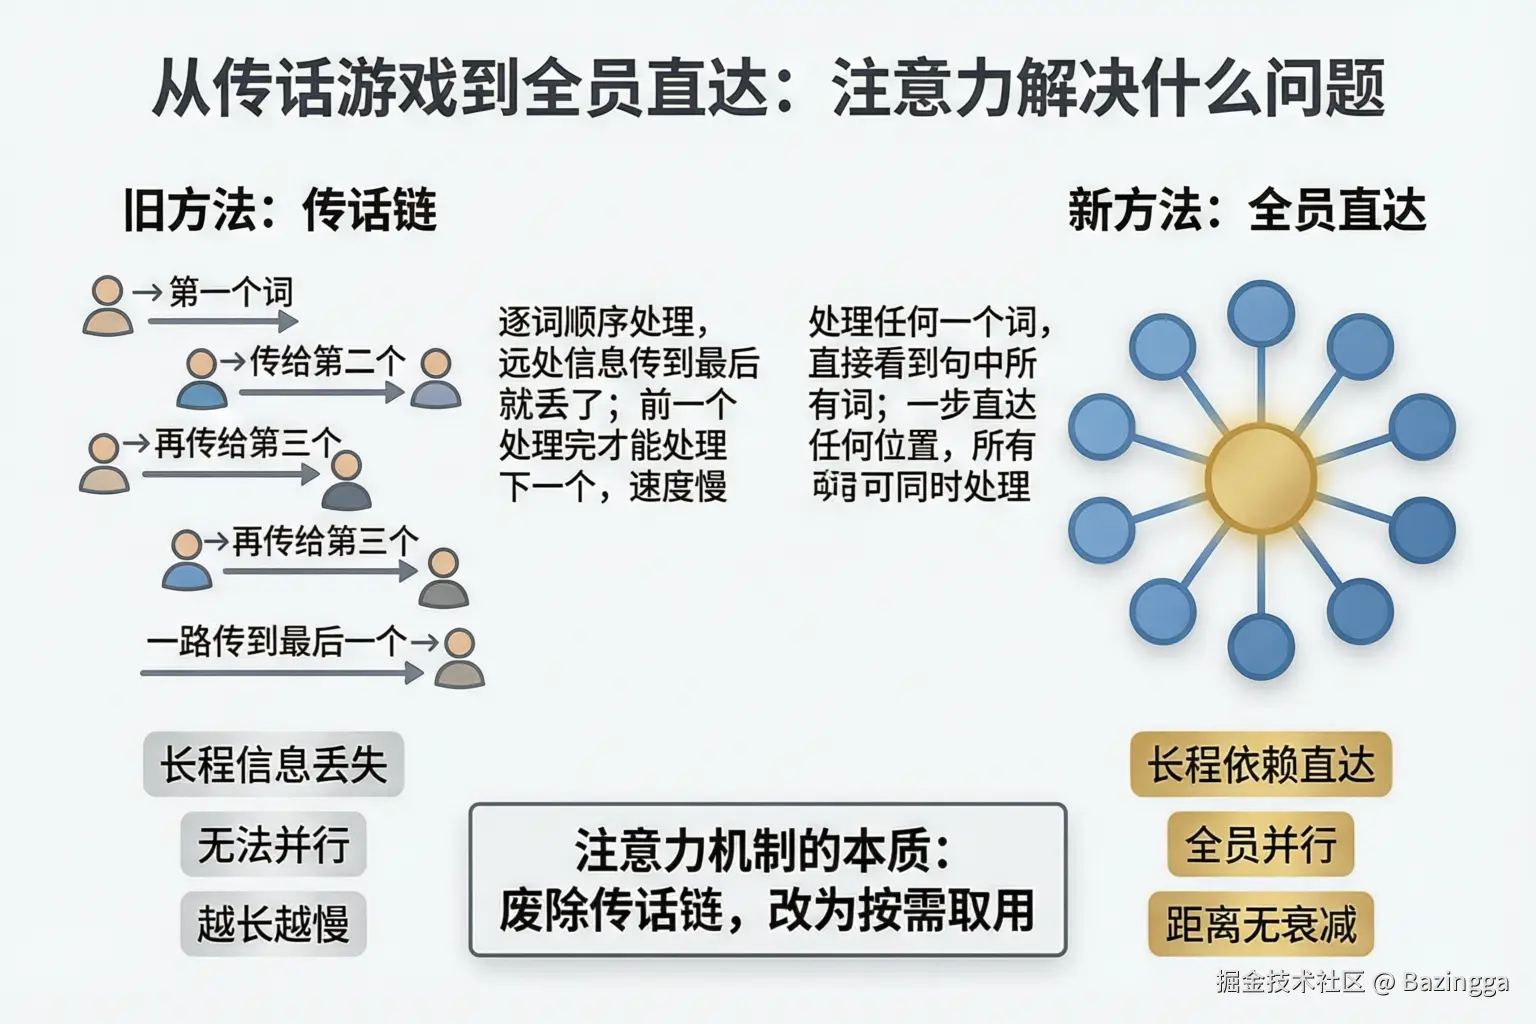
在 2017 年之前,处理文本的主流方案是循环神经网络(RNN):读一个词、消化一个词、把"消化后的摘要"传给下一个位置,接着处理下一个词------像一场传话游戏。
这场游戏有三个致命伤:
| 病症 | 机制 | 直观感受 |
|---|---|---|
| 长程信息丢失 | "它"想接上三十个词之前的"猫",信息必须经过三十次传话 | 传着传着就变味了,甚至传丢了 |
| 无法并行 | 第 100 个词必须等前 99 个词处理完 | 像排队买奶茶,前面的人不走你就干等 |
| 越长越慢 | 处理时间随句长线性叠加 | 一千字的文档要等"一条队"排完 |
有人试图硬修:把整句话压缩进一个固定大小的"摘要容器",要用时从容器里取。但一万字塞进一个杯子,怎么压都是有损的------这就是著名的信息瓶颈。
注意力的解法干脆利落:废除传话链 。处理任何一个词时,允许它直接回头看整句话的所有词,自己判断需要什么、去取什么。距离不再是问题------"它"一步跨回三十个词之前,直接和"猫"对上话。而且所有词可以同时各自取材,排队变成了全员并行的开窗办理。
一句话总结这场手术:从"逐级传话"改成"按需取用"。
2. 直觉:聚会上的耳朵
"注意力"这个名字来自认知科学,它的直觉你每天晚上都在体验。
想象你在一场嘈杂的聚会上听一个人讲话:
- 说话的那个人,你投入 90% 的听音量;
- 邻座的闲聊,压到 5%;
- 背景音乐,只剩 2%。
你的大脑在给每个声源动态分配权重。关键在"动态"二字------换一个人开口,权重分配立刻重排。
把这份直觉搬到句子上:处理"它"这个词时,模型给句中每个词打一个"此刻我该听你多少"的分数------三十个词之前的"猫"拿到 0.7 的高分,旁边的"因为"只拿 0.05。然后按分数把所有词的信息加权混合,得出"它"的新表示。这个新表示里"猫"的成分占七成------"它"不再是空洞的代词,而是"那只猫"的化身。
注意力 = 一组随当前任务实时变化的权重。 这就是它的全部直觉。剩下的问题只有一个:这组权重是怎么算出来的?
3. 机制:每个词发起的一次内部检索
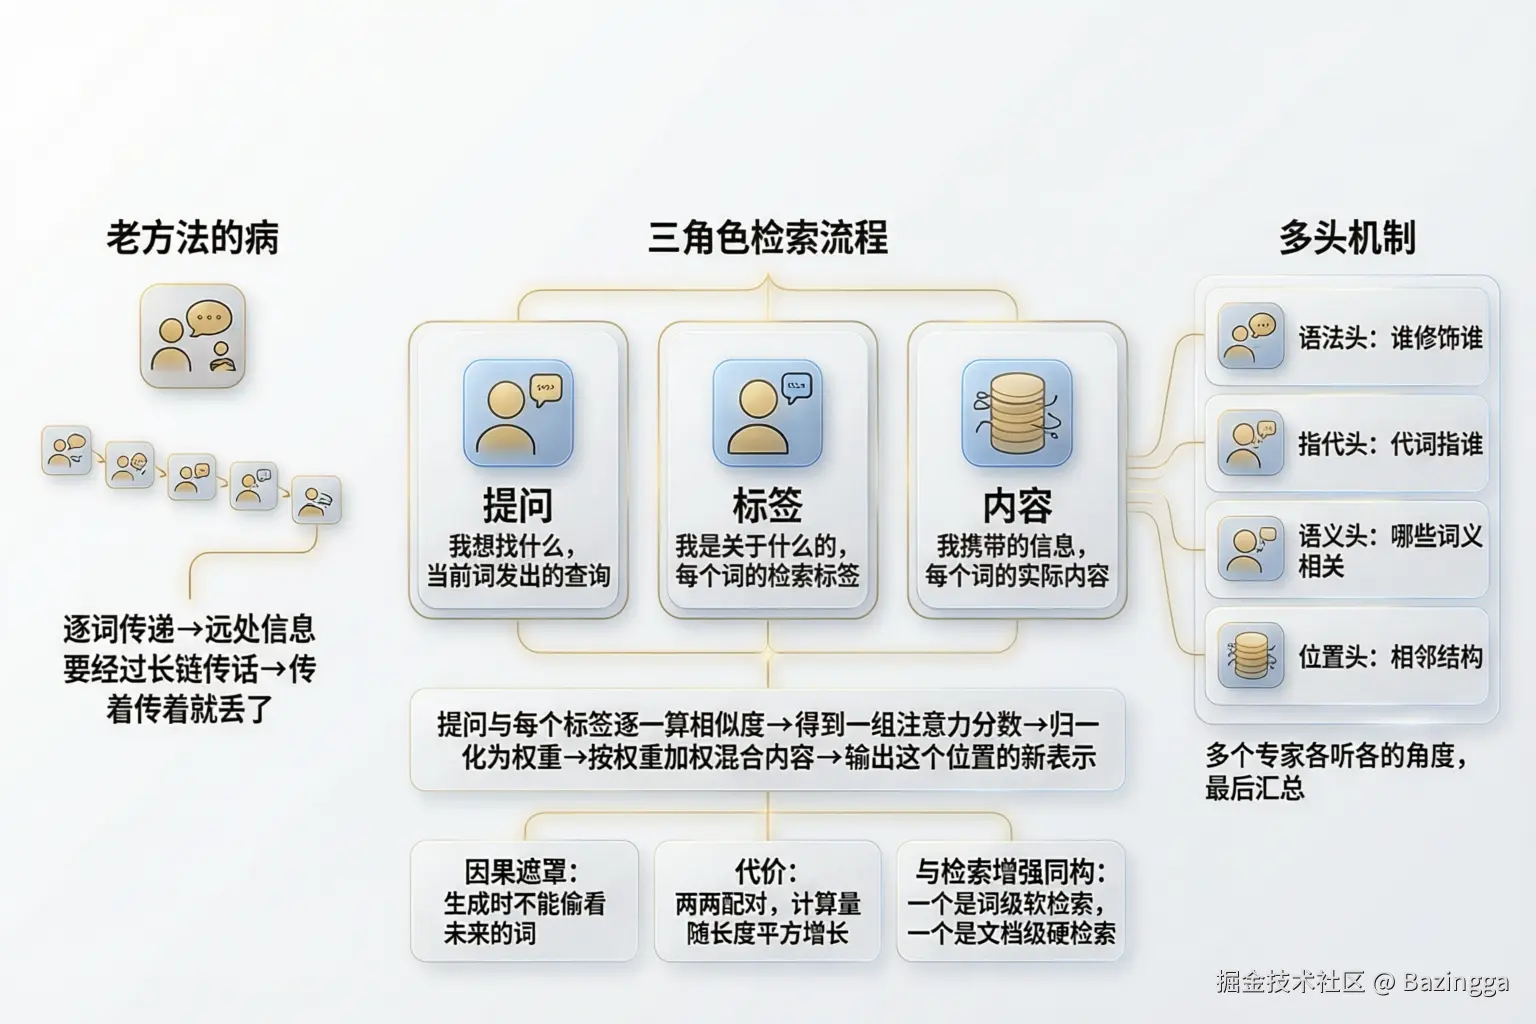
答案会让你会心一笑:用检索的方式算出来的。你在搜索引擎或图书馆查资料的那套流程,就是注意力的运转方式。
3.1 三个角色
每个词进入注意力层前,会被改造成三种身份(英文术语叫 Query / Key / Value,下文统一用中文角色名):
| 角色 | 图书馆里的对应 | 职责 |
|---|---|---|
| 查询 | 你的检索词 | 当前这个词想知道:"我该从别处取什么信息?" |
| 标签 | 每本书书脊上的索引标签 | 句中每个词亮出的自我介绍:"我是关于什么的,可供匹配" |
| 内容 | 书的正文 | 句中每个词真正携带的信息,等着被按分量取走 |
用视频网站类比更亲切:你在搜索框输入"transformer 教程"(查询),网站里每个视频都挂着标签(标签)------"AI、机器学习"的匹配度高,"美食、做饭"的匹配度为零------最终按匹配度加权返回视频内容(内容)。搜索框是查询,视频标签是被匹配项,视频本身是被取回的内容。
3.2 一个关键设定:自己检索自己
注意一个精妙之处:句子里每个词既是提问者,也是被检索的书。
"猫"在被"它"取走内容的同时,自己也在发起查询------它也许想确认"追"这个动词跟自己的关系。一场注意力计算下来,句中所有词两两之间都完成了一次"互相打听"。这就是"自注意力"(Self-Attention)里"自"的含义:自己检索自己,句内词互查,不假外求。
3.3 五步流程
处理"它"这个词时,完整跑一遍:
- 发出查询:"它"亮出自己的查询向量(我想找:我指代的对象是谁);
- 逐一打分 :拿这个查询和句中每个词的标签算相似度------与"猫"的标签相似度极高,与"老鼠"的低("算相似度"就是两个向量做点积:方向越一致、得分越高,和你用余弦相似度比对两段文本是同一族数学);
- 缩放:把分数除以一个固定的小系数(防止数值失衡,第 4 节细讲);
- 归一化:把一排分数压成总和为 1 的百分比------高分者拿大头,但不至于通吃;
- 加权混合 :按百分比把所有词的内容加权平均------"猫"的内容占七成。
产出:"它"的新表示,一个融合了全句信息的新身份。整句话里每个词都各自走一遍这套流程,谁也不落下。
3.4 补一堂点积课:两张打分表的"意见一致度"
五步流程里最陌生的词藏在第 2 步------"算相似度"用的是什么运算?答案:点积。它值得单独补一堂三分钟的小课。
运算本身极简 :两个向量对应位置相乘,再全部加起来:
\[1, 0\] \\cdot \[2, 1\] = 1 \\times 2 + 0 \\times 1 = 2
真正的问题是:这么朴素的一道乘加算式,凭什么能衡量"相似"?
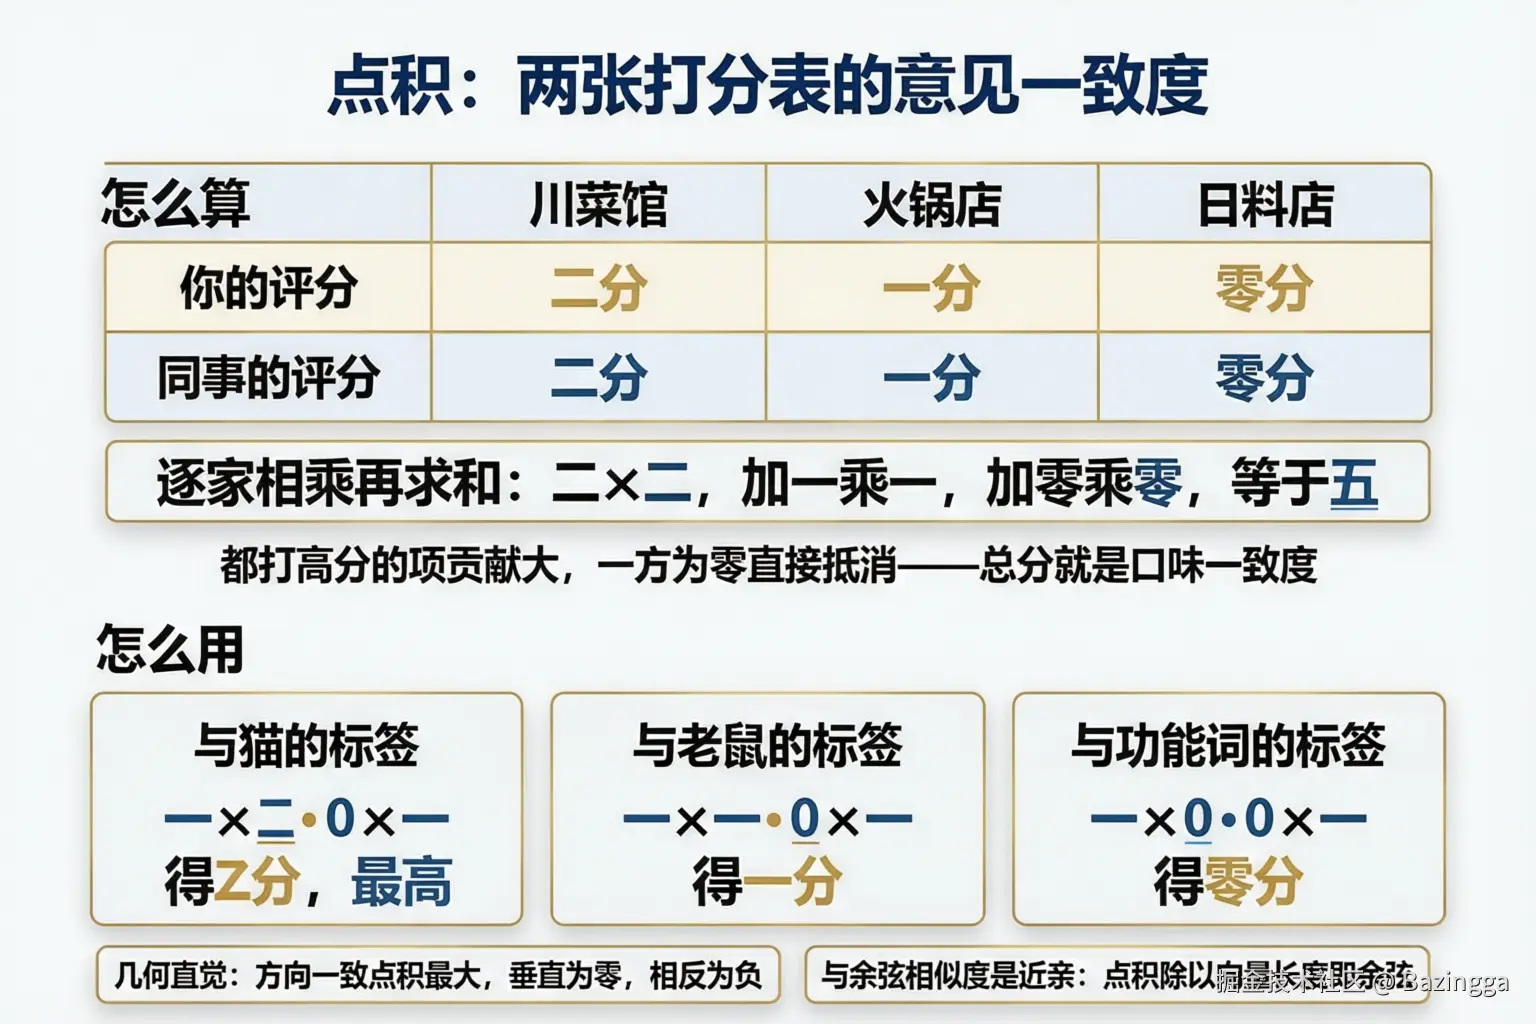
用一个生活场景想它。你和一位同事给三家餐厅打分:
| 川菜馆 | 火锅店 | 日料店 | |
|---|---|---|---|
| 你的评分 | 2 | 1 | 0 |
| 同事的评分 | 2 | 1 | 0 |
想知道两人口味有多一致,怎么办?逐家把两人的分数相乘,再加总:
2 \\times 2 + 1 \\times 1 + 0 \\times 0 = 5
这就是点积。它的妙处全在"逐项相乘"上:某一家只有你们俩都打了高分,乘积才大------你打 2、同事打 0,乘积归零,彻底抵消;俩人都打 2,乘积直接顶格。逐项相乘再求和,等于在问:"我们俩的高分区重合吗?"总分越高,口味越一致。
把"餐厅"换成"语义维度",就是注意力的打分:查询向量与标签向量逐位相乘再求和------两张意见表的重合度。点积大,意味着两个词在这个语义空间里"看重的东西高度重合",也就是语义相近。
再送两条几何直觉,知道即可:两个向量方向完全一致 时点积最大;互相垂直 时点积恰为零(意见完全不搭界);方向相反 则为负数(意见相左)。另外,你若接触过 RAG 检索里的余弦相似度------点积除以两个向量的长度就是它。两者是近亲:注意力用点积(配合缩放),向量检索常用余弦,同源不同衣。
3.5 实况走查:"它"的一次完整检索
现在把点积装回五步流程,用"那只猫追老鼠,因为它饿了"给整条流水线放一段实况。
真实的查询、标签向量有几百上千个维度,且每个维度没有人类可读的名字。这里做一个教学专用的二维度玩具版------假装每个词只有两个维度:
- 维度一:是不是一个实体名词("猫""老鼠"这类有实义的"东西")
- 维度二:是不是一个功能词("因为"这类只起语法作用、本身没内容的词)
由此设定(数字是编的,但语义方向自洽):
| 词 | 向量 | 语义解读 |
|---|---|---|
| 它的查询 | 1, 0 | "我想找实体名词,功能词与我无关" |
| 猫的标签 | 2, 1 | 强实体、弱功能 |
| 老鼠的标签 | 1, 1 | 也是实体,强度弱一档 |
| 因为的标签 | 0, 1 | 纯功能词 |
第 2 步 · 逐一打分(点积现场):
| 打分对象 | 点积计算 | 得分 |
|---|---|---|
| 猫 | 1×2 + 0×1 | 2 |
| 老鼠 | 1×1 + 0×1 | 1 |
| 因为 | 1×0 + 0×1 | 0 |
"它"的查询全力寻找实体名词:"猫"拿到最高分;"老鼠"也是实体但弱一档;"因为"是纯功能词,与查询恰好垂直------零分。
第 3 步 · 缩放(本例可跳过):真实向量几百上千维,点积会膨胀得很大,所以要除以根号维度防止"赢家通吃"。玩具版只有两维、分数本来就温和,这步按理可省------保留它是为了提醒:真实模型里它一直在岗。
第 4 步 · 归一化(softmax 上场):把 (2, 1, 0) 压成百分比。softmax 的算法是把每个分数变成 e 的幂再摊分(e² ≈ 7.4,e¹ ≈ 2.7,e⁰ = 1):
| 词 | 原始分 | 归一化权重 |
|---|---|---|
| 猫 | 2 | 约 67% |
| 老鼠 | 1 | 约 24% |
| 因为 | 0 | 约 9% |
注意一个漂亮的细节:原始分 2 : 1 : 0 的悬殊差距,归一化后变成约 67 : 24 : 9------差距被温柔地压缩了。这正是"高分者拿大头,但不至于通吃"的数学实现:哪怕"因为"得了零分,softmax 也只让它掉到 9%,而不是归零。注意力因此是"软"的------软检索不开除任何候选,只给它们排座次。
第 5 步 · 加权混合:"它"的新表示 = 67% × 猫的内容 + 24% × 老鼠的内容 + 9% × 因为的内容。三分之二的猫------那个空心的代词,此刻正式成为"那只猫"的化身。
第 7 节那张注意力矩阵热力图里"它把七成注意力给了猫",画的正是这样一次计算的结果------区别只是真实模型用几百维向量、几十层流水线,而且没人给维度起过名字。
4. 手算走查:三个词的完整账本
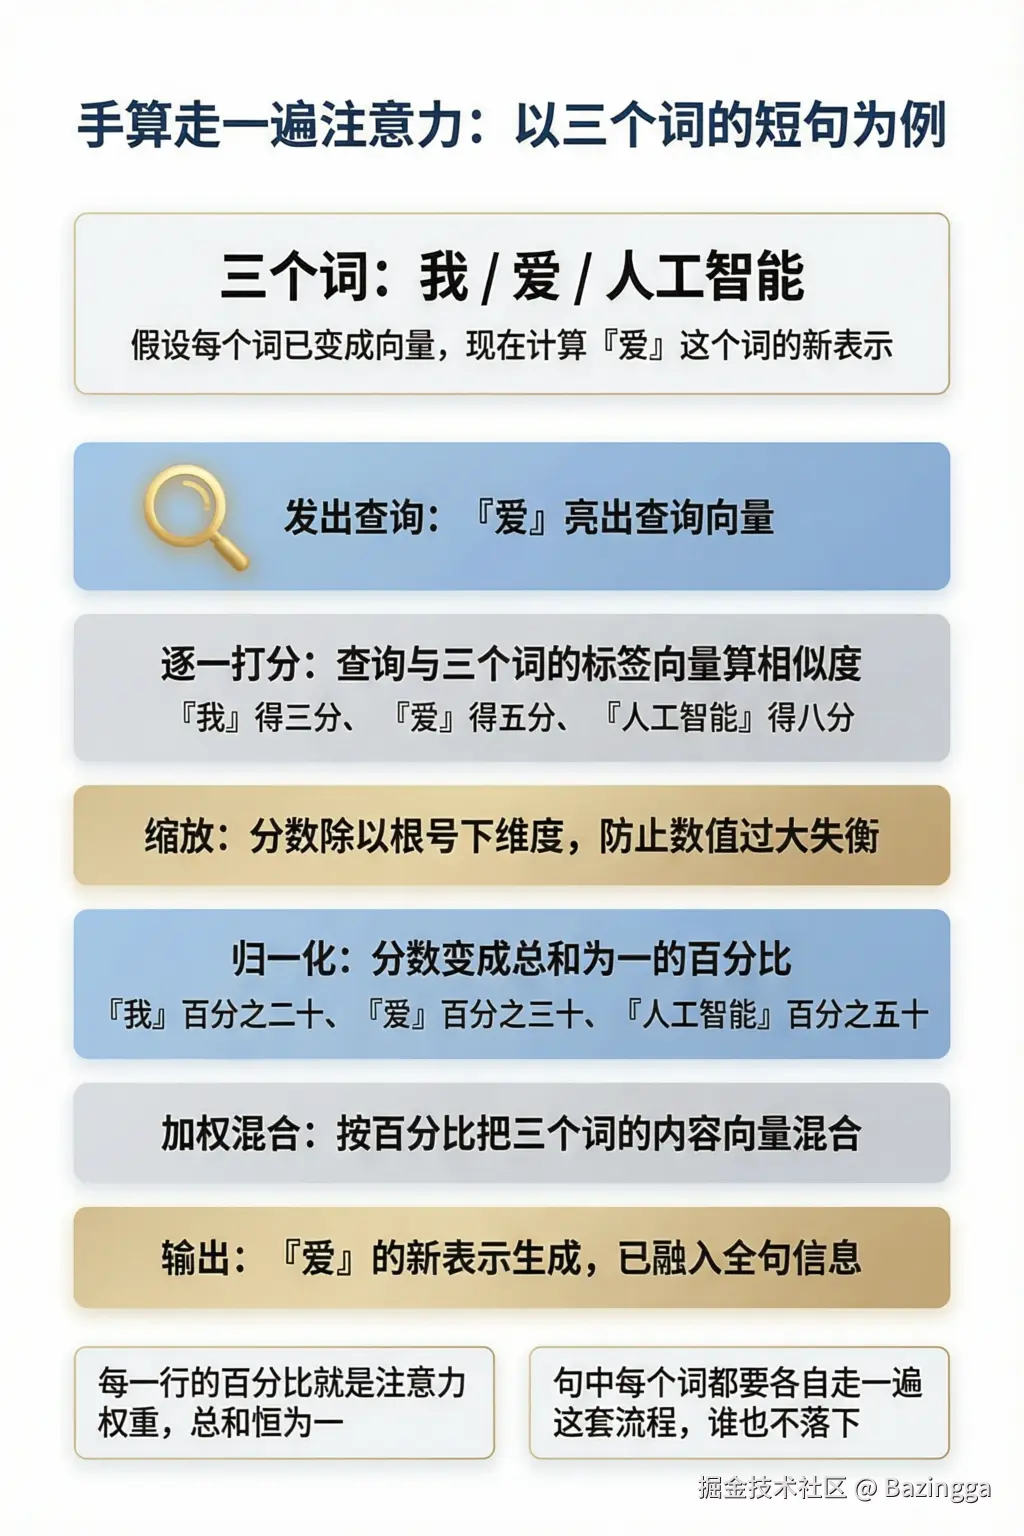
五步流程已经在 3.5 看过一段"它"的实况,这一节换一个句子、把六步账本完整走一遍:"我 / 爱 / 人工智能"。假设每个词已经变成了向量,现在计算"爱"这个词的新表示。
4.1 逐步走账
第一步,发出查询。"爱"亮出查询向量:作为一个动词,我想知道------我的主语是谁?我的宾语是谁?
第二步,逐一打分。"爱"的查询与三个词的标签分别算相似度(相似度怎么算出来的?就是 3.4 那堂点积课------查询与标签逐位相乘再求和;这里直接给出结果):
| 被打分的词 | 原始分 |
|---|---|
| 我 | 3 分 |
| 爱 | 5 分 |
| 人工智能 | 8 分 |
"人工智能"拿了最高分------在这个句子里,"爱"最关心的确实是自己的宾语。
第三步,缩放 。分数除以"根号下向量维度"。为什么?打分用的是点积,向量维度一大,分数天然膨胀------一大排巨大的数值直接进入下一步的归一化,会让最高分逼近 100%、其余全部归零,变成一家独大。除以根号维度是把分数的波动幅度拉回温和区间,让权重分布"有区分、但不独裁"。一个字:防赢家通吃。
第四步,归一化。softmax 登场------像评委打分变成百分比:原始分 (3, 5, 8) 变成权重:
| 被看的词 | 权重 |
|---|---|
| 我 | 20% |
| 爱 | 30% |
| 人工智能 | 50% |
三个百分比加起来恒等于 100%。这一排百分比,就叫注意力权重。
第五步,加权混合。新表示 = 20% × 我的内容 + 30% × 爱的内容 + 50% × 人工智能的内容。
第六步,输出。"爱"的新表示生成完毕------它已经不再是一个孤零零的动词向量,而是一个"知道自己主语是我、宾语是人工智能"的语境化向量。
全文唯一的"公式"就这一行,它概括了上面所有步骤:
\\text{新表示} = \\sum_i w_i \\cdot \\text{内容}_i, \\quad w_i = \\text{归一化}\\big(\\text{相似度}(\\text{查询}, \\text{标签}_i)\\big)
4.2 走完一个词,只是走完一句话的三分之一
别忘了:"我"和"人工智能"也要各自走一遍这五步。三词短句走三遍,千字长文走一千遍------每一遍的查询都不同,所以每一行权重分布都不同。这就是"动态"的物理形态:没有哪两组词之间的权重是复制的。
5. 多头注意力:多个专家同时开会
到这里有一个新问题:一次打分只学得出一种关系,可语言里的关系远不止一种。
"它"需要找指代对象(指代关系),"漂亮"需要找它修饰的名词(语法关系),"服务器"需要找语义搭档"宕机"(语义关联),"追"需要知道紧跟自己的是"老鼠"(相邻结构)------这些是不同维度的"相关"。单打一种相似度,顾此失彼。
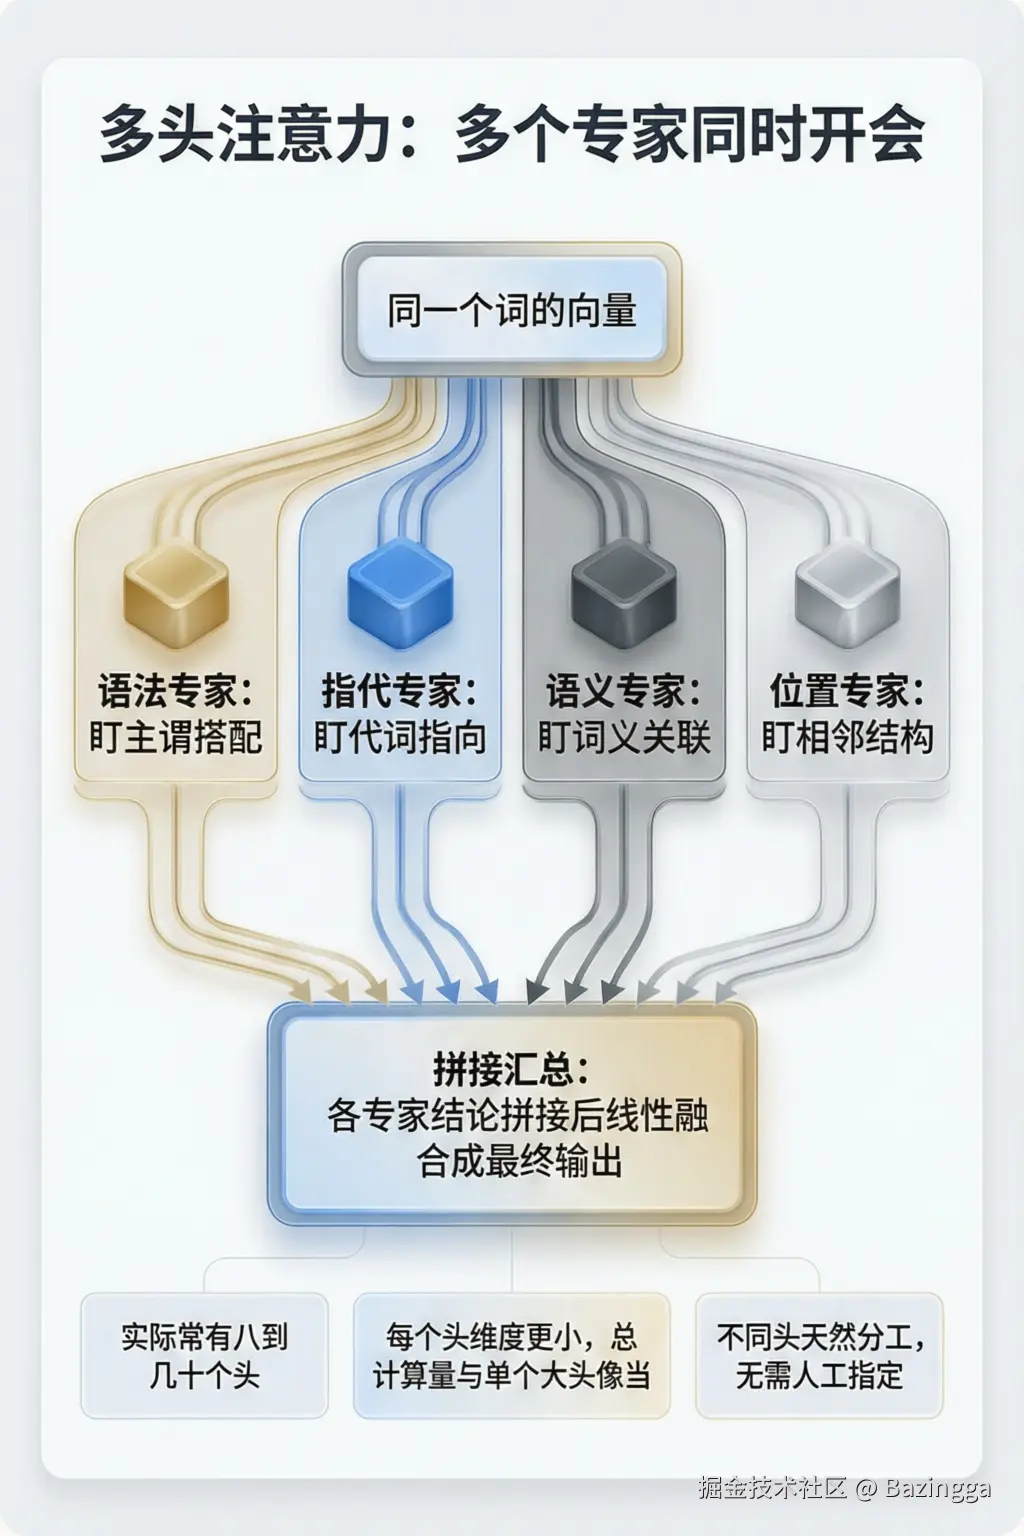
解法朴素得漂亮:并行开多组独立的注意力通道,每组一套自己的查询/标签/内容变换,各自学各自的关系,最后把各通道的输出拼接融合。类比一个审稿团队同时开会:
- 语法专家盯主谓搭配;
- 指代专家盯代词指向;
- 语义专家盯词义关联;
- 位置专家盯相邻结构。
各审各的,意见汇总成最终评审。三个工程事实值得知道:
- 实际模型常有八到几十个头;
- 每个头的维度更小(比如 512 维切成 8 个 64 维的头),总计算量和一个"大单头"相当------多头是白捡的多视角;
- 哪个头学什么关系,没有任何人工指定------纯靠训练自然分工。研究者事后把头的行为可视化出来才发现:有的头专门干"指代消解",有的头专门盯"相邻位置"。分工是涌现的,不是设计的。
6. 位置编码:给散珠子发座位号
注意力有一个天生的盲区,必须在组装机器前补上。
它打分靠的是"标签与查询的匹配度",而两袋词的匹配关系是一样的,无论怎么排列。也就是说,在纯注意力眼里:
"狗咬了人" 和 "人咬了狗" ------ 是同一句话。
对,注意力天生不识词序,句中的词对它来说就是一袋散珠子。而词序对语言的重要性不言而喻(上一句就是证明)。
解法:给每个词的向量额外加一份"座位号"信息再送进注意力------第一个词带 1 号座位的印记,第二个词带 2 号的。原始论文用正弦/余弦函数生成座位号(好处:值域温和、任意长度都能生成、相邻座位的关系有规律可循);现代模型多用"旋转角度"方案(座位越远、向量间的旋转差越大,注意力据此天然感知远近)。
无论哪种方案,本质都一样:注意力自己不看词序,我们给它配一副眼镜。
7. 因果遮罩:不许偷看答案
现在把前面所有零件装到"生成文本"这个任务上,会立刻发现一个作弊漏洞。
模型的工作是"预测下一个词"。如果注意力可以看到未来的词------预测"爱"的时候直接看到了"人工智能"已经写在后面------那还预测什么?答案就摆在卷面上。
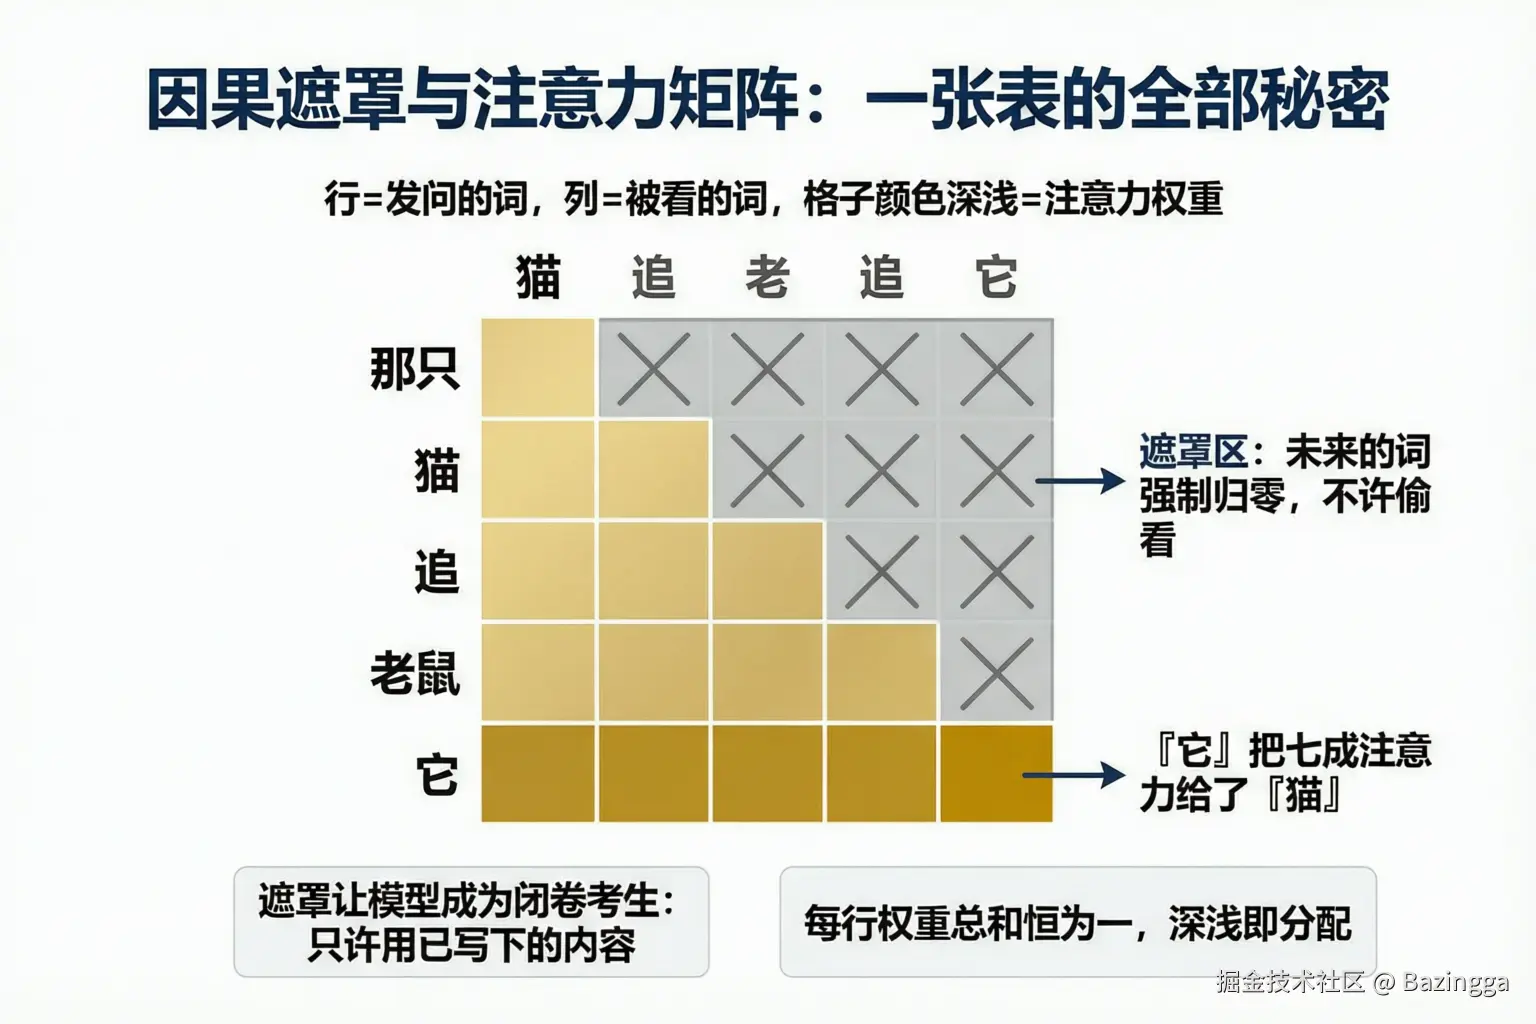
解法叫因果遮罩 :处理第 5 个词时,强制把第 6 个词及之后所有位置的注意力分数压成零。只许回头看,不许偷看未来。
这张图里的方格表值得学会怎么看,它是理解注意力最直观的一扇窗:
- 行 = 发问的词,列 = 被看的词,格子颜色深浅 = 注意力权重;
- 右上半部分整片涂灰打叉------那就是遮罩区:每个词只能看到自己左边的词(含自己),未来的格子全部封死;
- 每一行的权重总和恒为一------深浅就是这个行主把百分之多少的注意力分给了谁。
看最后一行"它":深色格子集中在"猫"那一列------"它"把七成注意力给了"猫",代词消歧的现场。这不是画出来的示意,真实训练出来的注意力矩阵就是这样:把模型内部某一层的权重导出来,你就能亲眼看到每个词在听谁说话。
遮罩还有一个你每天都 在承受的副产品:既然每个词都只能"回头看",模型生成文本就只能一次吐一个词,吐完把整句重读一遍,再吐下一个(自回归)。你等一段长回答时那一下一下蹦出来的节奏,以及回答越长等得越久的脾气,根源都在这道遮罩上------这是另一篇故事的主角,这里只埋一个钩子。
8. Transformer 全家福:把零件组装成机器
零件齐了,总装开始。Transformer 就是一台把上述零件按固定顺序组装、再重复堆叠几十次的流水线。
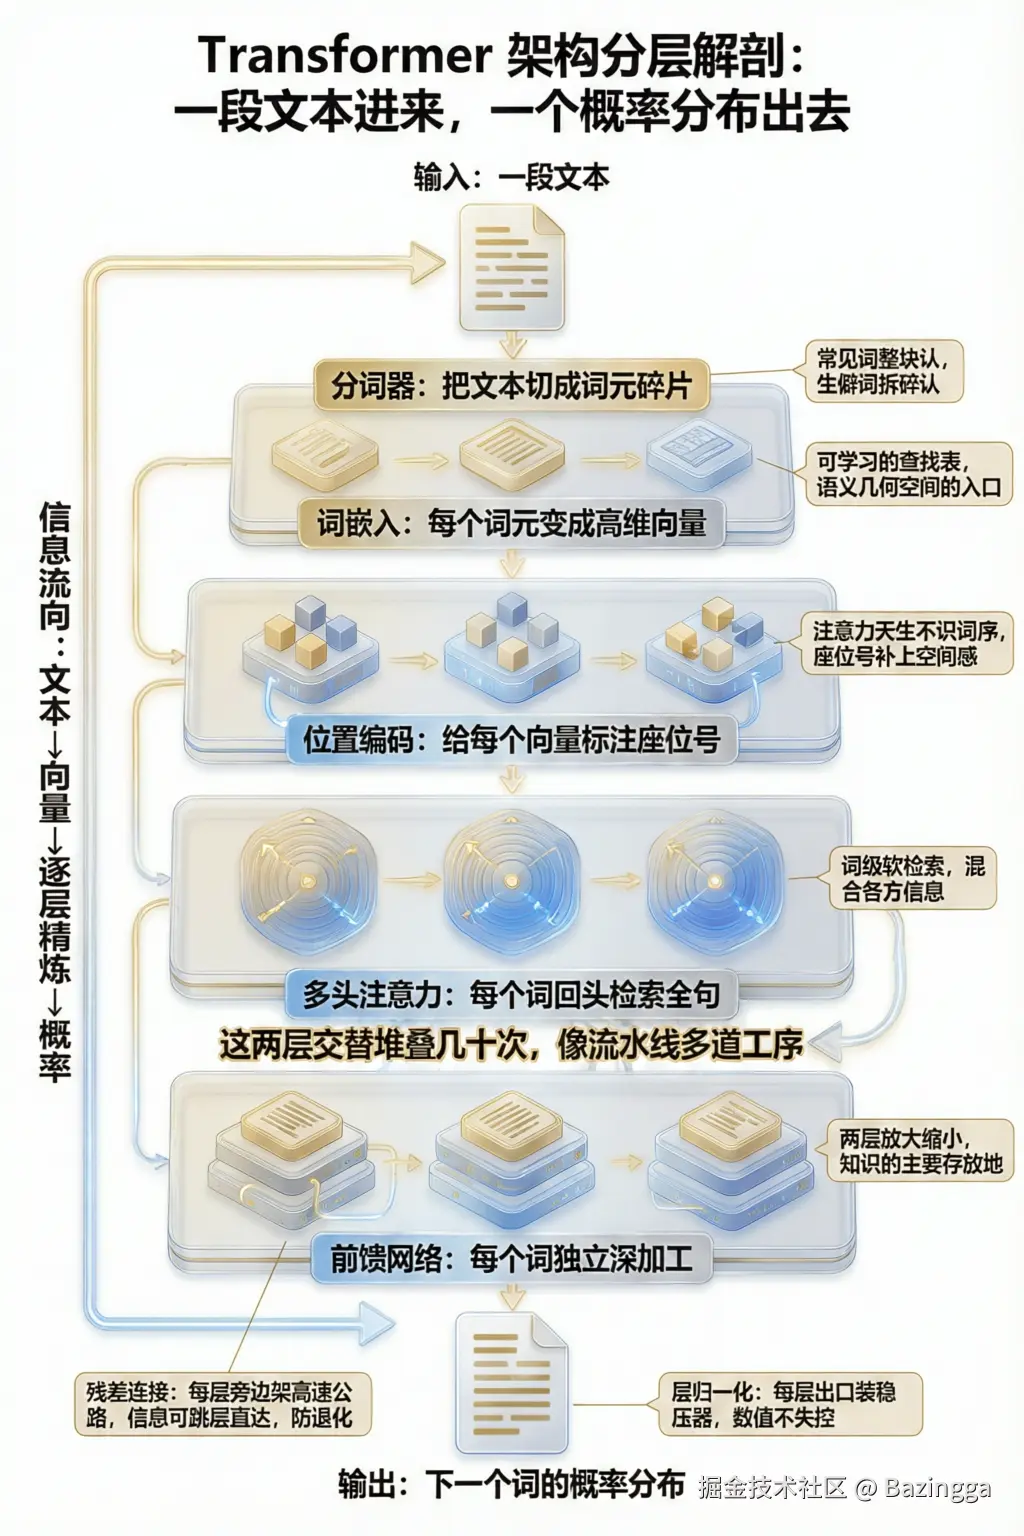
一段文本从进到出,依次过这些工位:
| 工位 | 职责 | 一句话点评 |
|---|---|---|
| 分词器 | 把文本切成词元碎片:常见词整块认,生僻词拆碎认 | 文字进机器前的碎纸机 |
| 词嵌入 | 每个词元变成高维向量 | 语义几何空间的入口 |
| 位置编码 | 给每个向量标注座位号 | 给不识词序的注意力配眼镜 |
| 多头注意力 | 每个词回头检索全句 | 路由器:搬运、组合、调配词间信息 |
| 前馈网络 | 每个词独立过一遍"放大再缩小"的两层网络 | 知识库:事实性知识的主要存放地 |
| 残差连接 | 每层旁边架高速公路,信息可跳层直达 | 保命零件一:防几十层堆叠训崩 |
| 层归一化 | 每层出口装稳压器,数值分布拉回稳定区间 | 保命零件二:防数值失控 |
其中"注意力 + 前馈"是一组工序,交替堆叠几十次------第一道工序混好的信息,交给第二道深加工;加工完再进下一组的注意力,重新检索、重新混合。粗读一遍、精读一遍、再精读一遍......每一层都在前一层的基础上把理解推向更深。
分工的精髓值得单独强调:注意力管"信息怎么流",前馈管"知识存哪里"。一个当路由器,一个当仓库------大模型里参数量约三分之二在前馈层,注意力层负责让正确的知识在正确的时刻流到正确的位置。
编码器与解码器:两个工种
原始论文的 Transformer 是为翻译设计的,分两个工种:
- 编码器 :读入原文,专职理解------每个词可以看到左右所有词(双向视野);
- 解码器 :逐词生成译文,专职输出------戴因果遮罩(单向视野),另有一道"翻译注意力"专门去读编码器理解好的原文。
GPT 的取舍:只要解码器
后来的剧情有了转折:对于"续写文本"这个任务(写文章、对话、写代码),根本不需要两个工种------把输入和输出看成同一个序列就够了。你输入"今天天气",模型接着续写"真好啊"------生成"真"的时候能看"今天天气",但看不到还没写的"好啊"。
这就是 Decoder-Only(纯解码器)架构,GPT 全系、Claude、LLaMA、通义千问......今天几乎所有对话大模型都是这个路线。它们丢掉了编码器和翻译注意力,只留"戴遮罩的自注意力 + 前馈"这对组合,堆上几十层,然后把整套机器扔进互联网级的语料里做亿万次"预测下一个词"的填空训练------训练出来的成品,就是你每天对话的那个它。
一句话收拢本节:Transformer 是图纸,GPT 是照着图纸盖出来的大楼。
9. 尾声:同一把尺子的三个尺度
最后一步升华,回到开头那句话:注意力不是"像"检索,它就是检索。而且它和你可能已经熟悉的另一个东西共享同一个数学内核。
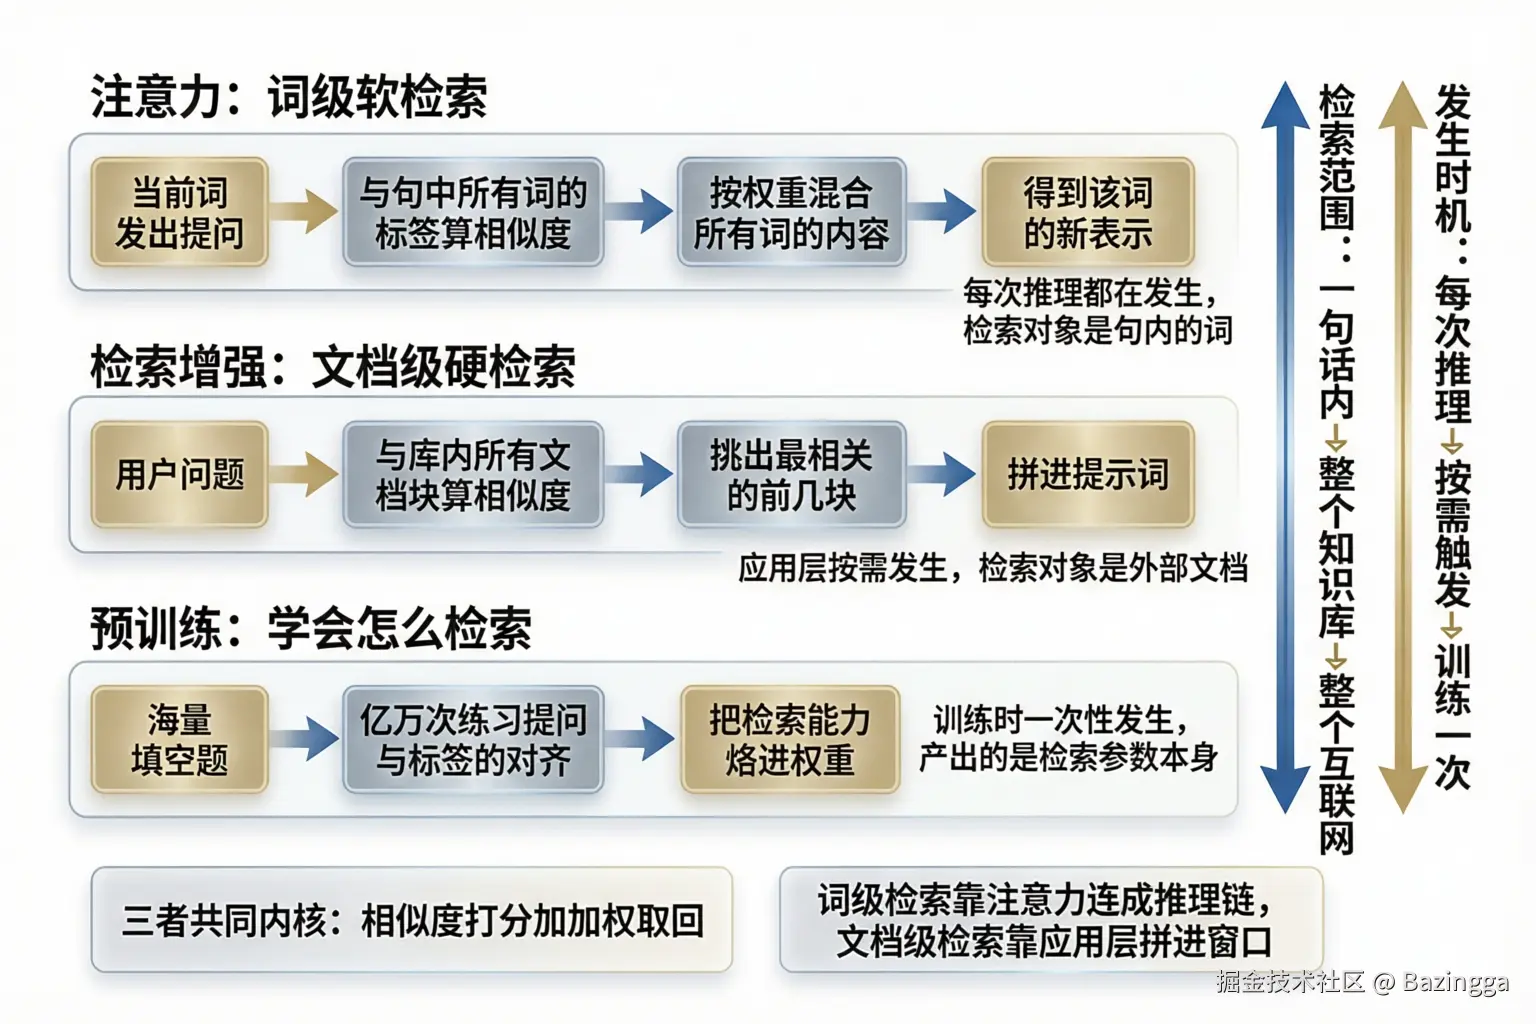
| 注意力 | 检索增强生成(RAG) | 预训练 | |
|---|---|---|---|
| 尺度 | 词级,句内 | 文档级,整个知识库 | 互联网级,整个训练语料 |
| 检索方式 | 软检索:所有词全保留,按权重分量混合 | 硬检索:算完相似度只取前几名,其余丢弃 | 不检索------训练出检索参数本身 |
| 发起者 | 模型内部,每层每词自动发生 | 应用层代码,按需触发一次 | 训练循环,一次性发生 |
| 角色 | 用尺子的人 | 用尺子整理书房的人 | 造尺子的人 |
"软"与"硬"是这两兄弟唯一的性格差异:RAG 像相亲市场------千人选三,落选者出局;注意力像调鸡尾酒------所有原料都入杯,只是配比悬殊。前者做"要不要"的二值决策,后者做"要多少"的连续决策。同一个"相似度打分 + 加权取回"的内核,在词级叫注意力,在文档级叫 RAG,而预训练用海量填空题把这个内核的参数烙进权重------尺子是同一把,造尺子的、用尺子读句的、用尺子查库的,是一家人。
代价也要交代一句:注意力要求句中每个词和所有词两两配对打分,计算量随句长平方增长------句子长十倍,打分次数涨百倍。这是"长上下文又贵又慢"的物理根源,也是工程界所有优化(分块计算、缓存复用)努力对抗的对象。
10. 预判疑惑四连
Q1:为什么叫"自"注意力? "自"指检索对象是自己人:句内词互查,不假外求。与之相对的"交叉注意力"(如翻译场景中解码器去查编码器的原文)检索的就不是自己------那才需要"交叉"二字标明内外有别。
Q2:为什么要除以根号维度,而不是别的数? 目标是把点积的波动幅度拉回归一化函数喜欢的"温和区间"。向量维度越大点积天然越大,除以根号维度恰好把方差稳定住------系数跟着维度走,是"对症下药"而非任意常数。
Q3:Transformer 和 GPT、BERT 是什么关系? 图纸与大楼。Transformer 是 2017 年的架构图纸;GPT 是照图纸的"解码器"部分盖的生成系大楼,BERT 是照"编码器"部分盖的理解系大楼(擅长分类、语义检索,不擅长写文章)。
Q4:注意力权重能被亲眼看见吗? 能。每一层、每一个头的完整权重矩阵都可以导出并可视化成第 7 节那样的热力图表------"它把七成注意力给了猫"不是修辞,是可以打印出来贴墙上的数字。这也是研究模型内部行为(可解释性)的经典素材。
结语
把整台机器再压缩成三句话:
- 注意力是一场内部检索:每个词发出查询、给所有词的标签打分、按权重把所有词的内容混合成自己的新表示------查询、标签、内容三角色,打分、缩放、归一化、混合四步走。
- Transformer 是这台检索机的总装线:分词与嵌入是入口,位置编码补词序,多头开多路视角,因果遮罩管住不看未来,前馈层当知识库,残差与归一化保命,整组堆叠几十次------GPT 只是它"纯解码器"路线的一种盖法。
- 它与 RAG、预训练共享同一个数学内核:相似度打分、加权取回------词级软检索、文档级硬检索、造尺子的预训练,一把尺子三个尺度。
下次你再听到"注意力机制"四个字,希望脑子里浮现的不是玄学,而是一间开满检索窗口的图书馆:每个词都在柜台前亮出检索词,每个书架都亮着标签,亿万次匹配在几十层流水线里同时发生------而你随口问出的每一个问题,都在被这样处理着。