1 概述
一段内容进入另一种语言时,需要保留下来的往往不只有字面意思。字幕要适应画面时长,技术文档要保留术语和格式,小说要延续人物称呼与叙述风格,视频配音还要接住原声中的表达。翻译模型需要在语义忠实、任务约束和内容形态之间建立联系。
围绕这些需求,哔哩哔哩 Index LLM 团队推出 Index-Translate 系列 。文本翻译覆盖 150 种语言 ,提供 2B、9B 和 35B-A3B(preview) 三种规模,同时支持图文翻译;系列还提供语音翻译、音节控制与长文档翻译能力。本文简要介绍这些功能,重点展开它们背后的训练设计。
我们还观察到图片文字翻译的跨模态泛化:Index-Translate 的中训练与后训练均未使用图片数据,但借助继承自 Qwen3.5 的视觉通路,模型可以直接根据图片生成译文。后文将结合多模态评测说明这种能力的表现,以及它随模型规模变化的边界。
开源不到半个月,GitHub Star 已超过 1,600 ,Hugging Face 系列模型总下载次数突破 10 万次。感谢大家的关注、试用与反馈。
Index-Translate:主力翻译模型,支持多语言文本翻译与图文翻译;文本翻译可遵循术语、格式、风格与上下文指令。
围绕不同内容形态与任务约束,我们还推出三款衍生模型:
-
Index-Echo:语音到文本、语音到语音翻译,并利用源音频提供音色条件。
-
Index-Homura:根据指定音节数调整译文,用于字幕和配音等时间受限场景。
-
Index-NativeLong:完整输入长文档,一次生成完整译文,学习跨段落的一致性。
- 在线 Demo:index-translate.bilibili.com/
- GitHub:github.com/bilibili/In...
- Hugging Face:huggingface.co/collections...
- 免费 API:github.com/bilibili/In...
完整方法与实验见 Index-Translate 技术报告(*arxiv.org/abs/2609.40...
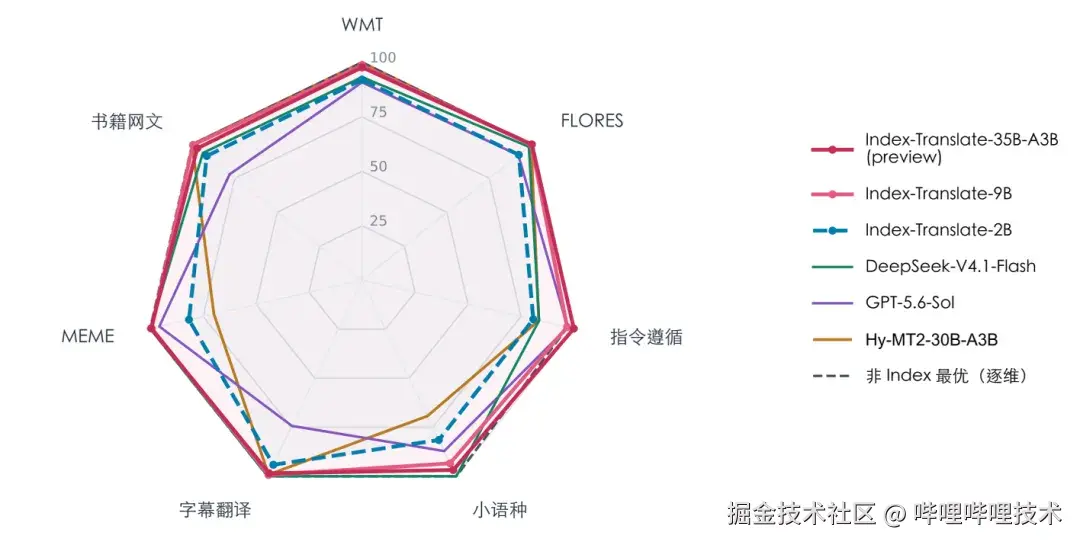
图 1 Index-Translate 文本翻译七维评测,包含 35B-A3B(preview)、9B、2B,以及 Hy-MT2-30B-A3B 等代表性模型。各轴按全部 14 款参评模型的最小值和最大值归一化至 0--100,表示相对表现,不是准确率;灰色虚线由各项非 Index 最优分数组成,并非单一模型。
2 多语言底座如何形成
Index-Translate 基于 Qwen3.5 base构建2。中训练同时使用通用文本回放(G)、独立采样的单语文本(M)和平行翻译数据(P):前两者保留语言理解与表达能力,平行数据加强跨语言对齐。进入训练后期,再增加中转组织数据(V),关联同一内容的多个语言版本3。
我们采用 WSD(Warmup--Stable--Decay)学习率调度 中的 constant 和 decay 阶段4。Constant 阶段 保持固定学习率,使用通用、平行、单语数据的均衡配比;decay 阶段逐步降低学习率,并以中转数据为主,兼顾核心与完整语种覆盖。2B、9B、35B-A3B 共享下面的基础文本配方,使用 AdamW、4,096 tokens 序列长度和 4,096 条序列的全局 batch。
表 1 基础文本模型的 WSD 中训练配方
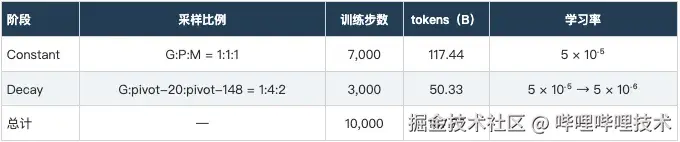
pivot-20 与 pivot-148 的计数不含英语、中文;加入这两种语言后,分别对应 22 个核心语言条目 和 150 个完整语言条目。这里的中转是训练数据的组织方式,实际推理直接生成目标语言译文。
配方选择参考了技术报告中的先导实验。下表保留代表性 constant 设置,以及相同 decay 预算下的平行/中转对比1。
表 2 Constant 与 decay 的代表性配方实验
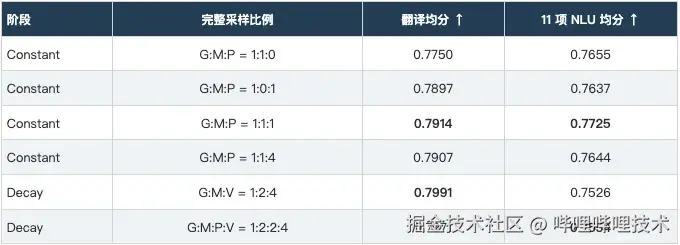
Constant 组在 4K 上下文、step 7,000 比较,翻译分为 FLORES-200 与 WMT24++ 的英文源、中文源四项 COMET 均分的等权平均,分别覆盖 20 和 18 个目标语言。Decay 组采用 Qwen3-8B、16K 上下文,均到达 step 10,000,decay 预算同为 25.17B token positions,评测 20 个目标语言。两组翻译口径不同,应分组比较;NLU 为 11 项多语言通用任务的宏平均。粗体表示各组内的指标最优。先导实验与表 1 的最终共享配方分别报告。
Constant 阶段需要兼顾单语与平行数据。 1:1:1 在完整的八种候选配比中取得最高翻译分,并列最高 NLU 分;去掉单语或平行数据,两项分数都下降。继续提高平行权重到 1:1:4,也没有带来更高的翻译分。
Decay 阶段的"纯中转"仍保留 G 和 M,只是不含普通平行数据 P。 它的翻译分为 0.7991,略高于平行+中转的 0.7971;后者完整比例为 G:M:P:V = 1:2:2:4,NLU 略高。加入 P 也改变了其他数据流的归一化份额,所以这是两套完整配方的比较。
阶段收益还在 2B、9B 上单独跟踪。按"原始底座 → constant 结束 → decay 结束",2B 的翻译分为 0.7015 → 0.7707 → 0.7898 ,9B 为 0.7726 → 0.7924 → 0.8007;两个阶段都观察到翻译收益。NLU 在 constant 阶段下降,在 decay 阶段部分恢复,但仍低于原始底座。这组结果来自 20+ 语种开发集。
语言覆盖也要单独验证。在 81 个目标语言的实验中,2B 的 decay 数据由 20+ 扩到 100+ 语种后,61 个非核心语种的校正 COMET 均分(错目标语言输出计零)从 0.5605 提升至 0.6570 ,目标语言偏离率从 1.94% 降至 0.89% ,核心语种均分大体稳定。后训练继续保留低资源方向,使这种覆盖能够延续下去。
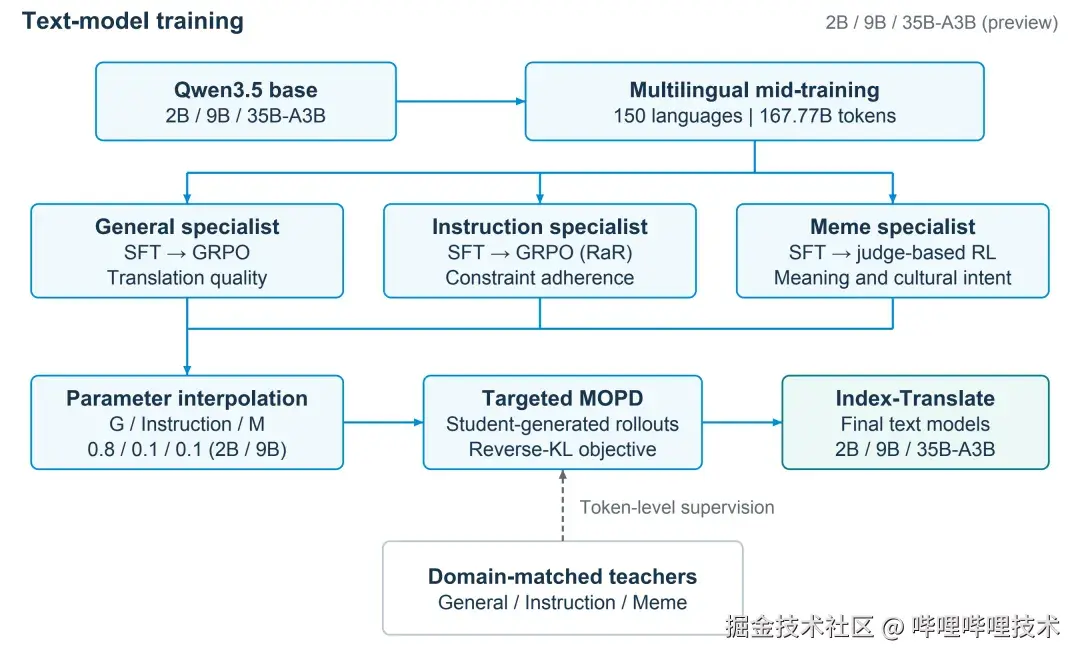
图 2 多语言中训练之后,通用、指令与梗翻译专家分别学习任务能力,再通过参数融合和针对性蒸馏形成文本模型。图中的 0.8/0.1/0.1 融合权重对应报告中的 2B 与 9B 配置。
3 通过任务奖励学习可用的翻译
3.1 先学习示例 再优化任务目标
在共同底座上,我们分别训练通用翻译、指令翻译和梗翻译专家。监督微调(SFT)提供高质量示例,强化学习(RL)则让模型围绕各类任务的目标继续优化。
通用翻译需要关注漏译、增译与事实偏移。仅靠语义相似度指标,可能无法充分惩罚这些错误。因此,我们将目标语言有效性、基于参考译文的 XCOMET-XXL 翻译质量评分17和基于源文的忠实性评分结合起来:语言错误触发门控,忠实性错误则降低奖励,避免一段流畅译文掩盖内容缺失。
指令翻译面对的是更具体的要求,例如"保持 JSON 结构""产品名按词表翻译""保留代码占位符""使用某种叙述语气"。我们采用 Rubric-as-Reward,将约束拆成可检查的硬条件和分级评估的软条件。结构、术语或占位符等硬检查失败时,奖励门控会置零;风格、上下文理解等软条件则参与分级评分。
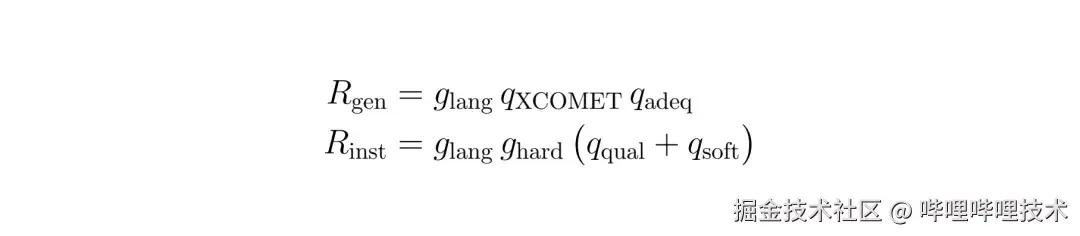
图 3 通用翻译奖励组合语言门控、参考质量与忠实性;指令翻译奖励进一步引入硬约束门控。g 表示二值门控,q 表示分级质量或约束评分。
通用与指令专家使用 GRPO 优化1,通过同一输入下多条候选译文的相对奖励学习更好的输出。梗翻译则使用上下文与参考引导的评审,让模型学习非字面含义、文化功能和语用效果,必要时选择意译、解释或文化适配。
3.2 让评审器跟上模型变化
奖励函数同样可能成为模型投机的对象:输出得到更高评分,不一定意味着真实翻译质量同步提高。随着策略模型更新,固定评审器面对的输出分布也在变化。
我们引入 RIVAL 的对抗式评审监督5,交替更新评审器与策略模型,并结合偏好排序、辅助定量监督和历史输出回放,让评审器持续学习当前策略的错误模式。这样,强化学习中的监督可以随模型行为变化而调整,降低对固定评审器弱点的依赖。
3.3 融合专家后改善薄弱任务表现
不同专家各有所长,但将参数合并后,能力并不一定全部保留。我们先对兼容的专家做参数插值6,再评测融合模型在哪些任务上仍有不足。报告中的 2B、9B 配置采用通用、指令、梗翻译专家 0.8/0.1/0.1 的融合权重。
随后,我们进行针对性的多教师 on-policy 蒸馏(MOPD)7:学生先生成自己的译文,再由与任务匹配的教师提供 token 级监督,使用 reverse-KL 目标优化。学生在自己实际会产生的输出路径上继续学习,用于改善融合后的薄弱任务;实际效果需要结合翻译质量与约束遵循共同评估。
这套流程将"分别学好任务""整合互补能力"和"检查整合后的缺口"连接起来,也保留了对能力迁移边界的观察。比如,精确音节控制在报告研究的融合与蒸馏设置下迁移较弱,因此我们继续保留专门的 Homura 模型。
4 Index-Echo 如何连接翻译与声音
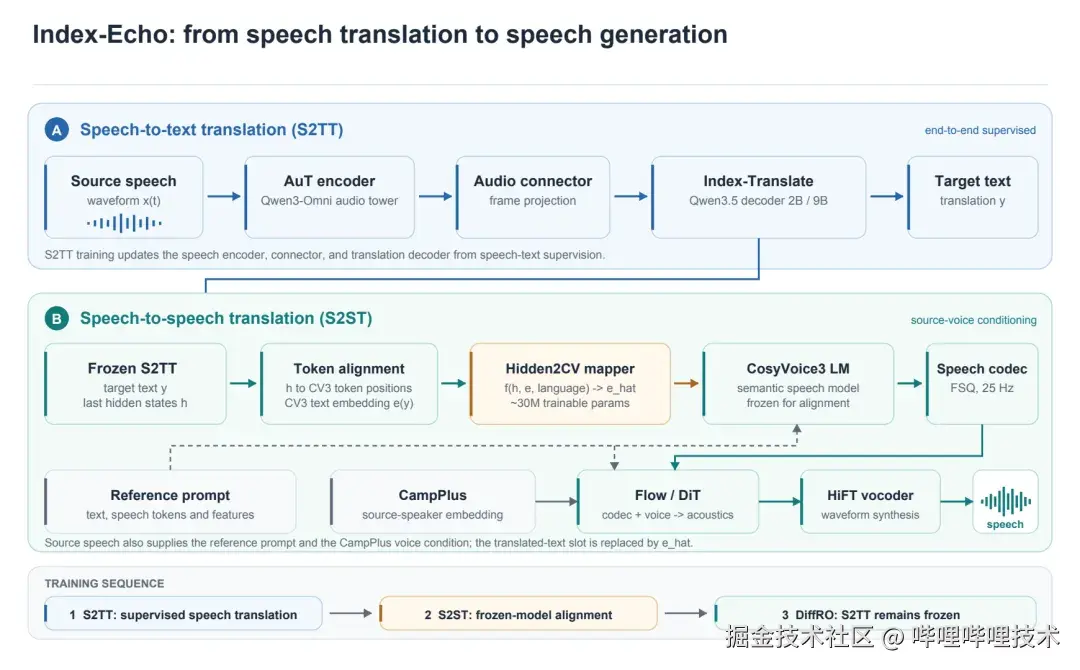
图 4 Index-Echo 先学习语音到文本翻译,再通过 Hidden2CV mapper 连接语音生成路径。S2ST 的对齐与后续 DiffRO 阶段保持 S2TT 骨干冻结。
4.1 从音频理解到目标语言文本
Index-Echo 的语音到文本翻译(S2TT)由音频编码器、连接器和 Index-Translate 解码器组成。音频编码器使用 Qwen3-Omni 的 AuT 模块8,连接器把音频特征接入翻译模型,目标语言指令控制输出方向。训练时,这些模块通过语音翻译监督端到端更新,使文本底座能够直接利用源音频完成翻译。
4.2 用隐层表示接入语音生成
语音到语音翻译(S2ST)在已训练好的 S2TT 上继续扩展。我们使用约 30M 参数的 Hidden2CV mapper,将翻译模型最后一层的 hidden states 映射到 CosyVoice3 的语义层9,让语音生成路径接收翻译模型的连续表示。源音频同时提供参考提示与 CampPlus 说话人向量,为跨语种输出提供音色条件。
训练分两步进行:先冻结语音翻译与语音生成骨干,蒸馏对齐 mapper;随后进行可微奖励优化(DiffRO),继续保持 S2TT 冻结。DiffRO 通过 Gumbel-Softmax 对语音 token 采样做可微近似,使 Token2Text 内容一致性奖励能够沿语音生成路径回传,优化生成内容与目标译文的一致性9。
目前发布的 S2ST 覆盖六个方向:中文到英语、西班牙语、日语,以及英语到中文、西班牙语、日语。Demo 中可以直接查看视频字幕翻译与跨语种配音效果。
5 时间预算与长文档的专项训练
5.1 Homura 让音节预算进入训练目标
配音中,一句译文即使含义正确,也可能读不进原视频留下的时间窗口。单纯要求"简短一些"难以稳定控制输出,过度压缩又可能损失信息。
Index-Homura 将目标音节数作为显式输入,并用 GRPO 联合优化翻译质量和音节偏差。模型通过词汇选择与句法重组调整表达长度,使译文接近给定预算,同时尽量保留原意。音节数为时间受限翻译提供可操作的控制量;最终播放时长还与语速、停顿和语音合成设置有关。
在技术报告的 SandGlass 评测中,Index-Homura-9B 的音节数落在目标值 ±10% 范围内的比例为 81.92% 。这类评测同时检查翻译质量与预算遵循,使长度控制的收益可以与内容损失一起分析。HOMURA 的研究背景和方法可进一步阅读论文(*arxiv.org/abs/2601.10...
5.2 NativeLong 学习持续生成完整译文
文档翻译的难点会随着上下文拉长而变化。人物名、术语和概念区分可能在几十段之后再次出现;逐块翻译时,局部译文各自通顺,整篇却可能出现称呼漂移或概念混用。
Index-NativeLong 将完整源文与完整目标译文作为文档级监督,让模型在保留全文上下文的条件下持续生成11。2B 模型结合长序列中训练衰减与文档 SFT,9B 模型则从融合后的文本模型继续进行文档训练。报告中的训练与评测覆盖约 4K--64K 中文侧 tokens 的文档长度分组。
例如,一篇地质文献先区分 ice age 与其中的 glacial 阶段,后文再次出现这些词时,译文需要持续保留"冰河时代"与"冰期"的概念差异。文档级训练关注的正是这种跨段落关系,以及长输出中可能出现的漏译、提前结束和术语不一致。我们也构建了 NativeLongBench,按不同长度分组检验完整文档翻译能力。
6 用不同评测检验不同能力
6.1 文本翻译评测
通用翻译、指令遵循、文化表达和文档一致性,需要分别评测。我们使用 FLORES12、WMT24++13等检验通用质量,用 instTrans 检查格式、术语、风格与上下文约束,并通过 MEME、SandGlass 和 NativeLongBench 检验相应的专项能力。
在报告的文本对比中,Index-Translate-35B-A3B(preview)的 FLORES COMET-22 为 0.8794 ,instTrans IFscore 为 0.8336 。文本翻译与通用能力对比中的所有参评模型均关闭思考模式;语音评测中开启思考的基线在表内明确标注。各任务的完整设置、对比结果与分析见技术报告(*arxiv.org/abs/2609.40...
为便于阅读,技术报告的文本主表按指标分组呈现,保留全部 14 款对比模型。
表 3a 通用翻译 指令与文化表达
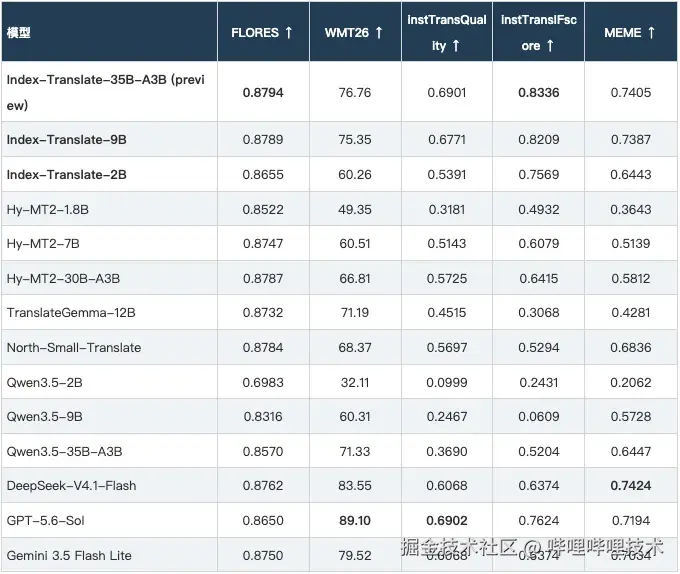
FLORES 使用 COMET-2216;WMT26 为 0--100 的评审分,其余指标为 0--1,均为越高越好。instTrans 的译文质量(Quality)和指令遵循(IFscore)由 GPT-5.6-Sol 分别评审;MEME 评测社区与文化表达的翻译质量。粗体数值表示本列最优。
表 3b WMT24++ IFMTBench 与垂类评测
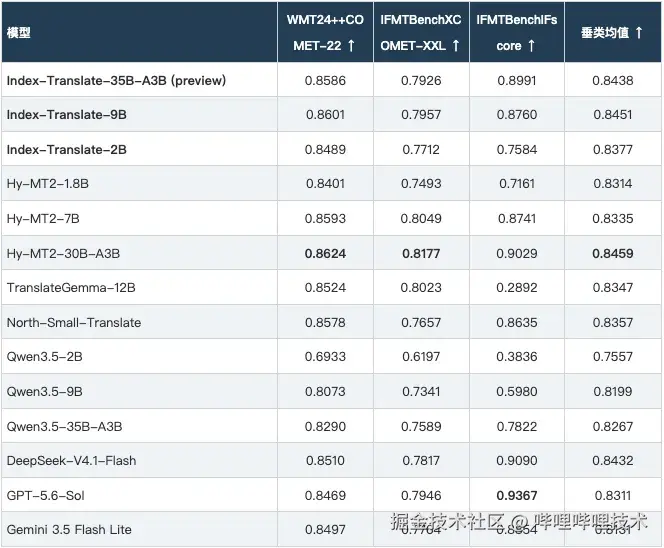
**
**
以上指标均为 0--1,越高越好。IFMTBench14的翻译质量与指令遵循分别报告;垂类均值为五项领域翻译分数的等权平均,包含 GuoFeng 文学翻译评测15。
表 4a 小语种通用翻译 FLORES_minor_pair
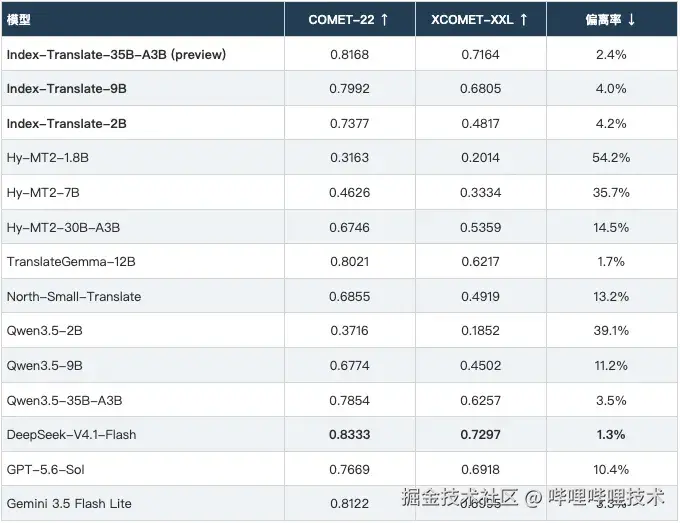
表 4b 小语种指令翻译 instTrans_minor
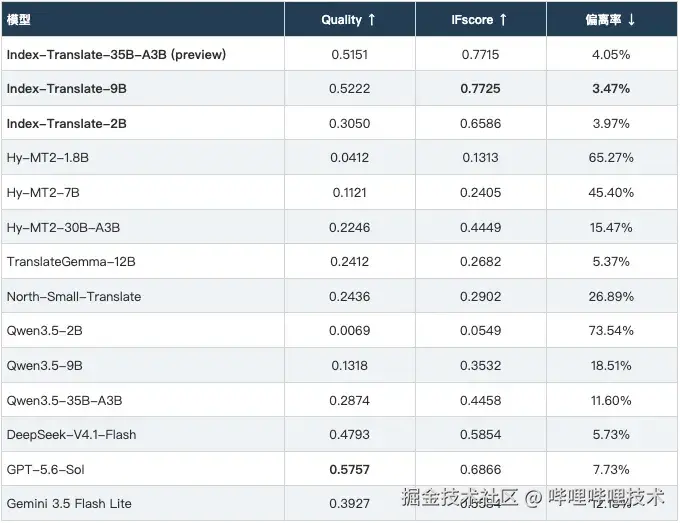
FLORES_minor_pair 覆盖 62 种语言的 1,040 个方向;instTrans_minor 含 2,793 项指令翻译任务。偏离率表示输出语言不是指定目标语言的比例,越低越好;其余指标越高越好。North-Small-Translate 指 218B-A25B 模型,TranslateGemma-12B 指 translategemma-12b-it。以上结果完整保留技术报告文本主表的指标与模型,更多设置见完整评测表(*github.com/bilibili/In...
6.2 图片翻译能力的涌现
Index-Translate 在文本训练后展现出图片翻译能力,可直接读取图片中的文字并生成目标语言译文。模型沿用 Qwen3.5 的视觉通路,中训练与后训练均使用文本数据1,2。
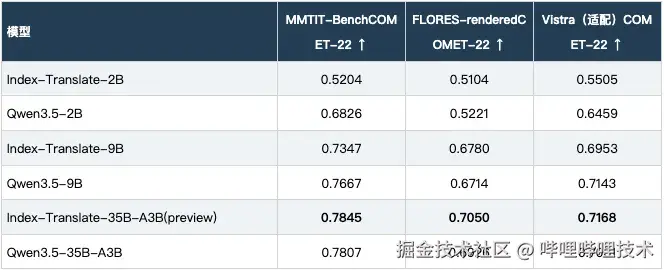
我们在三组数据上评估图片翻译能力:MMTIT-Bench18 包含 1,243 张图片、14 种源语言,译入英语和中文;FLORES-rendered 将 FLORES_minor_pair 文本渲染为 1,200 张纯色背景图片,覆盖 60 种源语言和两个目标语言;Vistra19 包含 763 张自然场景图片、四个目标语言,采用按阅读顺序拼接的参考译文评估整图翻译。评测采用图片输入和零样本翻译指令,以 COMET-2216 衡量译文质量,各模型使用统一的非思考推理设置。
Index-Translate-35B-A3B(preview)在三项评测中均取得表内最高分:MMTIT-Bench 为 0.7845,FLORES-rendered 为 0.7050,Vistra(适配)为 0.7168,分别比同规模 Qwen3.5 高 0.0038、0.0124 和 0.0137。从 2B、9B 到 35B-A3B,Index-Translate 的三项图片翻译得分逐步提高,较大模型表现出更强的跨模态翻译能力。
表 5 图片文字翻译评测
下一个版本,我们将进一步融合语音翻译、视觉语言翻译与文本翻译,并将长文本翻译能力纳入统一模型。通过统一的多语言与多模态能力,同一模型将面向文字、图片和语音输入完成翻译,同时强化长篇内容中的上下文衔接、术语一致性与完整译文生成,保留原文的语义和表达风格。
7 在线体验与免费 API
想先看看效果,可以打开 Demo(index-translate.bilibili.com/ );推理代码与使用教程在 GitHub(*github.com/bilibili/In... Face(*huggingface.co/collections...
我们也提供无需本地 GPU 的免费公开 API ,兼容 OpenAI 的 chat completions 与 responses 接口。当前服务模型标识为 Index-Translate-35B-A3B,可用下面的请求体验中文翻译:
curl index-translate.bilibili.com/v1/chat/com... \
-H 'Content-Type: application/json' \
-d '{
"model": "Index-Translate-35B-A3B",
"messages": [
{
"role": "user",
"content": "Translate into Chinese: Welcome to EMNLP."
}
],
"temperature": 0
}'
API base URL 为 **index-translate.bilibili.com/v1**。更多调用方式... API 文档(*github.com/bilibili/In... GitHub 分享反馈。
8 EMNLP 现场见
如果你也会参加 EMNLP,欢迎来听我们的 oral 、到 poster 现场交流,一起聊聊翻译、强化学习和多语言内容生产。
HOMURA oral 已安排在 2026 年 10 月 27 日 09:00--10:30 的 Machine Translation and Semantics session,地点 F9-10。
我们也会参加 Poster Session D(10 月 26 日 11:00--12:30,Hall H) ,以及 WMT poster session ,欢迎到现场交流。以上时间均为布达佩斯当地时间,具体安排请以 EMNLP 官方日程(2026.emnlp.org/program/ )和 WMT 官方日程(*www2.statmt.org/wmt26/progr...
现场还会发放精美谷子,欢迎来交流技术与使用体验,把喜欢的周边带回去。我们 EMNLP 见!
图 5 团队周边展示。
参考文献
1 Tianjiao Li, Mengran Yu, Chenyu Shi, Lusheng Zhang, Qisi Chen, Yanshan Zhou, Ji Qi, Jingying Liu, Yuang Feng, Ziang Cui, and Tianxing Yan. Index-Translate: A Multilingual Translation Model Family --- Text, Speech, Controlled Dubbing, and Long-Document Translation. arXiv:2609.40181, 2026. 原文(*arxiv.org/abs/2609.40....
2 Qwen Team. Qwen3.5: Towards Native Multimodal Agents. February 2026. 原文(*qwen.ai/blog?id=qwe....
3 Yingli Shen, Wen Lai, Shuo Wang, Ge Gao, Kangyang Luo, Alexander Fraser, and Maosong Sun. From Unaligned to Aligned: Scaling Multilingual LLMs with Multi-Way Parallel Corpora. Proceedings of EMNLP, pages 7357--7379, 2025. 原文(aclanthology.org/2025.emnlp-... ).
4 Shengding Hu et al. MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies. arXiv:2404.06395, 2024. 原文(*arxiv.org/abs/2404.06....
5 Tianjiao Li, Mengran Yu, Chenyu Shi, Yanjun Zhao, Xiaojing Liu, Qiang Zhang, Qi Zhang, Xuanjing Huang, and Jiayin Wang. RIVAL: Reinforcement Learning with Iterative and Adversarial Optimization for Machine Translation. arXiv:2506.05070, 2025. 原文(*arxiv.org/abs/2506.05....
6 Mitchell Wortsman et al. Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time. ICML, PMLR 162:23965--23998, 2022. 原文(*proceedings.mlr.press/v162/wortsm....
7 Wenhan Ma, Jianyu Wei, Liang Zhao, Hailin Zhang, Bangjun Xiao, Lei Li, Qibin Yang, Bofei Gao, Yudong Wang, Rang Li, Jinhao Dong, Zhifang Sui, and Fuli Luo. MOPD: Multi-Teacher On-Policy Distillation for Capability Integration in LLM Post-Training. arXiv:2606.30406, 2026. 原文(*arxiv.org/abs/2606.30....
8 Jin Xu et al. Qwen3-Omni Technical Report. arXiv:2509.17765, 2025. 原文(*arxiv.org/abs/2509.17....
9 Zhihao Du et al. CosyVoice 3: Towards In-the-wild Speech Generation via Scaling-up and Post-training. arXiv:2505.17589, 2025. 原文(*arxiv.org/abs/2505.17....
10 Ziang Cui et al. HOMURA: Taming the Sand-Glass for Time-Constrained LLM Translation via Reinforcement Learning. arXiv:2601.10187, 2026. 原文(*arxiv.org/abs/2601.10....
11 Yushi Bai et al. LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs. ICLR, 2025. 原文(*arxiv.org/abs/2408.07....
12 NLLB Team et al. No Language Left Behind: Scaling Human-Centered Machine Translation. arXiv:2207.04672, 2022. 原文(*arxiv.org/abs/2207.04....
13 Daniel Deutsch et al. WMT24++: Expanding the Language Coverage of WMT24 to 55 Languages & Dialects. Findings of ACL, pages 12257--12284, 2025. 原文(aclanthology.org/2025.findin... ).
14 Mao Zheng et al. Hy-MT2: A Family of Fast, Efficient and Powerful Multilingual Translation Models in the Wild. arXiv:2605.22064, 2026. 原文(*arxiv.org/abs/2605.22....
15 Longyue Wang et al. Findings of the WMT 2023 Shared Task on Discourse-Level Literary Translation: A Fresh Orb in the Cosmos of LLMs. Proceedings of the Eighth Conference on Machine Translation, pages 55--67, 2023. 原文(aclanthology.org/2023.wmt-1.... ).
16 Ricardo Rei et al. COMET-22: Unbabel-IST 2022 Submission for the Metrics Shared Task. Proceedings of the Seventh Conference on Machine Translation, pages 578--585, 2022. 原文(aclanthology.org/2022.wmt-1.... ).
17 Nuno M. Guerreiro, Ricardo Rei, Daan van Stigt, Luisa Coheur, Pierre Colombo, and André F. T. Martins. xCOMET: Transparent Machine Translation Evaluation through Fine-grained Error Detection. Transactions of the Association for Computational Linguistics, 12:979--995, 2024. 原文(aclanthology.org/2024.tacl-1... ).
18 Gengluo Li et al. MMTIT-Bench: A Multilingual and Multi-Scenario Benchmark with Cognition-Perception-Reasoning Guided Text-Image Machine Translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 16593--16602, 2026. 原文(*openaccess.thecvf.com/content/CVP....
19 Elizabeth Salesky, Philipp Koehn, and Matt Post. Benchmarking Visually-Situated Translation of Text in Natural Images. Proceedings of the Ninth Conference on Machine Translation, pages 1167--1182, 2024. 原文(aclanthology.org/2024.wmt-1.... ).
-End-
作者丨哔哩哔哩 Index LLM 团队