上一篇结尾留下了一条悬念:Producer 「查元数据缓存」查到的那些 Leader 位置,最初是从哪来的?bootstrap.servers 明明只写了一个地址,客户端怎么找齐了整个集群?
带着这个问题打开客户端源码,读到的第一件事就可能颠覆认知:bootstrap 地址基本只用一次。用完之后,客户端走的是另一套地址------一套它自己从没配置过、由 Broker 亲手「广播」进元数据的地址。这套广播机制平时我们感知不到,但笔者切实踩过这个坑。那时团队的 Leader 出于安全隔离的理由想让 Kafka 也统一走 L4 代理,可加上代理之后却发现:Producer 超时、Consumer 时好时坏、日志里翻滚着 NOT_LEADER_FOR_PARTITION。
这个现象当时让笔者困惑了好一阵:HTTP 服务挂个负载均衡天经地义,为什么 Kafka 不行?
这一篇就沿着「客户端怎么找 Broker」这条线,来看一看是什么机制让这样一件看似没有差别的事情出现了不一样的现象。
bootstrap.servers只写了几个地址,客户端凭什么找齐整个集群?这些地址用完之后还有用吗?- Broker 广播出去的地址从哪来、存在哪、客户端靠什么保持它新鲜?
- Broker 前面挂一台 L4 代理,为什么会出事?怎么接才是对的?
bootstrap.servers
先看客户端启动时拿到的那几个地址去了哪。入口在 clients/src/main/java/org/apache/kafka/common/Cluster.java:211 的 Cluster.bootstrap:配置里的每个 host:port 被包成一个 Node,nodeId 从 -1 开始递减,同时整个 Cluster 被打上 isBootstrapConfigured 标记。负数 id 是个很直白的暗示------真实 Broker 的 nodeId 都是非负整数,负数意味着「这不是集群里的节点,只是个门」。
客户端连上任意一扇门之后干什么?发一次 MetadataRequest。发往哪台也是就近原则:clients/src/main/java/org/apache/kafka/clients/NetworkClient.java:1211 的 DefaultMetadataUpdater#maybeUpdate 每轮都挑一个 leastLoadedNode(负载最轻的节点)作为元数据刷新的目标,集群刚启动时可选的只有那几个负数 id 的 bootstrap 节点,谁先连上用谁。
响应回来,NetworkClient.java:1277 的 handleSuccessfulResponse 在 :1306 调 metadata.update------从这一刻起,客户端 Cluster 里的节点换成了 MetadataResponse 里的真实 Broker,负数 id 的 bootstrap 节点退场。之后的所有连接、所有元数据刷新,都只认真实 nodeId。「bootstrap 只用于第一次连接」,这句文档里的话在代码里就是这样落地的。
不过我在 4.3.1 的源码里找到了一条文档没直说的回头路:metadata.recovery.strategy 配置(clients/src/main/java/org/apache/kafka/clients/CommonClientConfigs.java:230 ,默认值 REBOOTSTRAP,:242 )------当元数据里的节点全军覆没、一个都连不上时,客户端会退回 bootstrap 地址重走一遍上面的流程;服务端也可以主动回一个 REBOOTSTRAP_REQUIRED 错误码(clients/src/main/java/org/apache/kafka/common/protocol/Errors.java:417 ,错误码 129),由 NetworkClient.java:1117 的 handleRebootstrap 和 :1297 的分支处理。所以更准确的说法是:bootstrap 从「一次性门票」升级成了「应急通道」。这也是我更喜欢读源码而不是文档的原因------文档说 bootstrap 只用于初次连接、发现集群全貌,代码里却留着一条回头的路,而这条路恰好解释了一些线上「换个 bootstrap 地址就好了」的都市传说。
地址簿从哪来:advertised.listeners 的一生
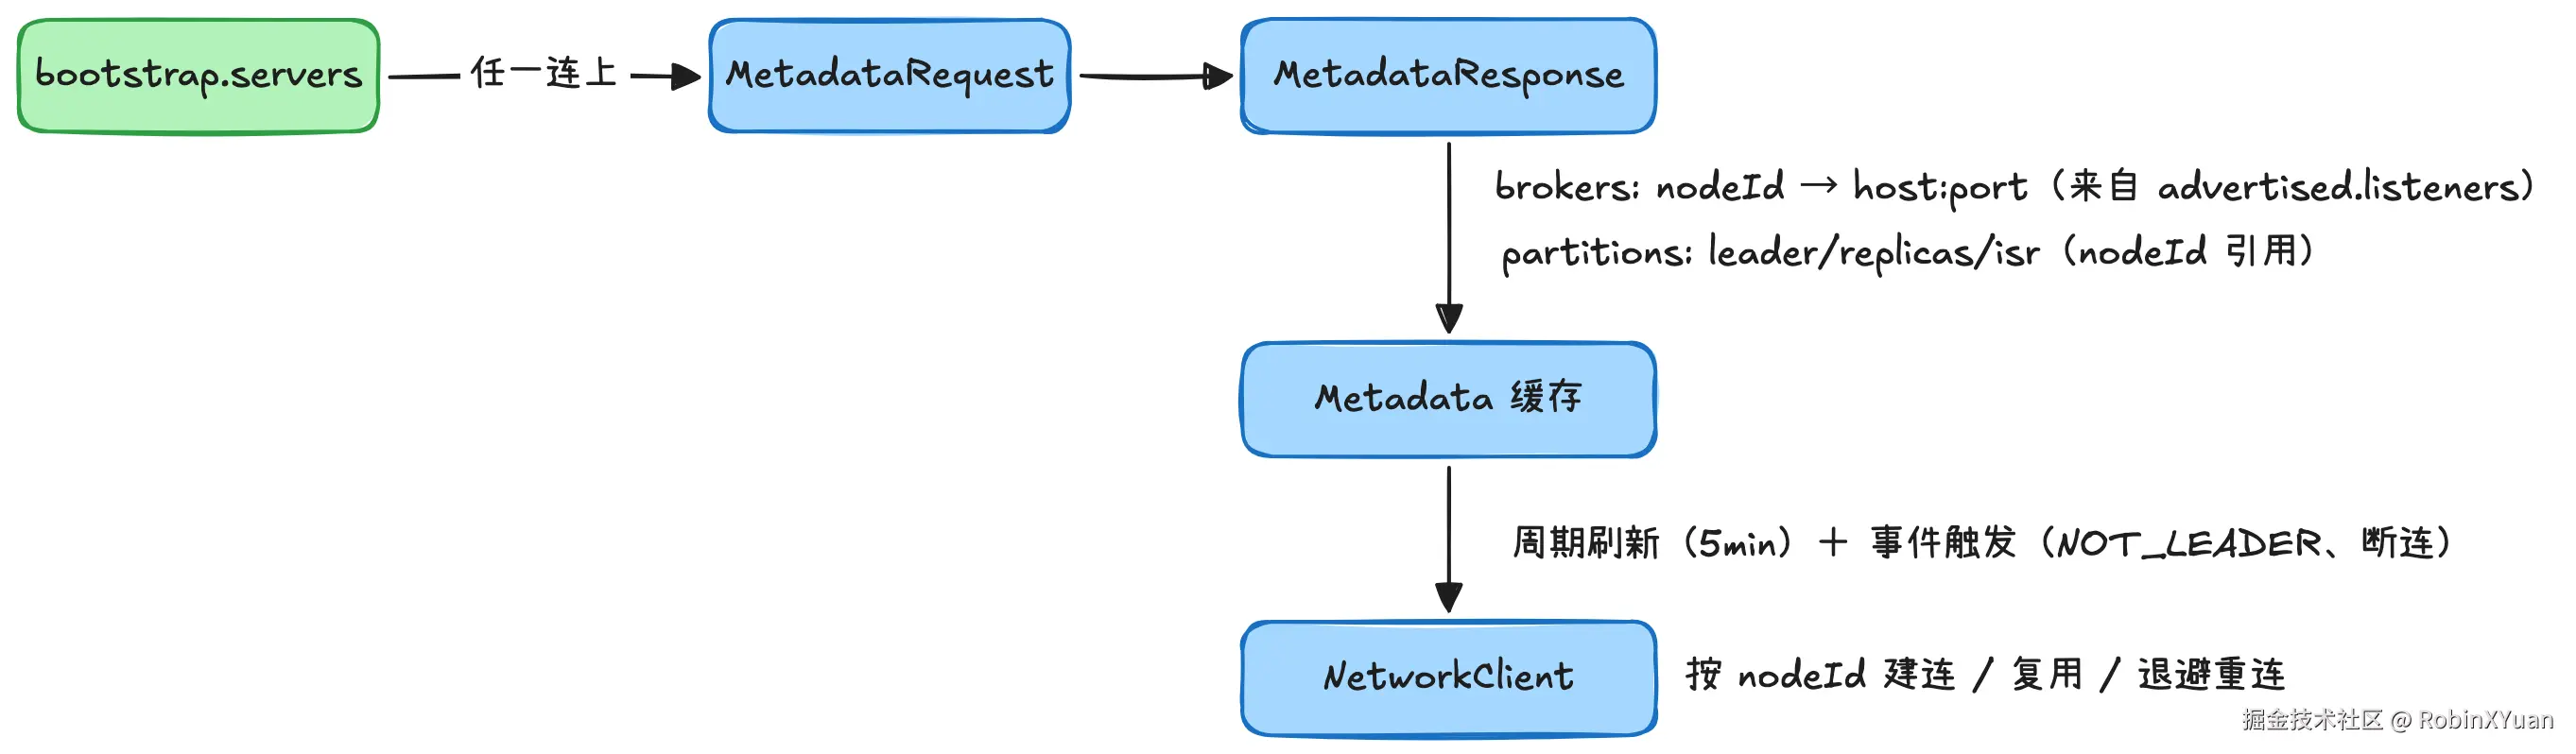
MetadataResponse 本质上是一本地址簿:一部分是 brokers 数组,nodeId 到 host:port 的映射;另一部分是每个 Partition 的 Leader、Replicas、ISR------全是 nodeId 引用。客户端要做的事,就是拿 nodeId 查地址簿,找到 Leader 所在的那台 Broker,把请求发过去。
问题来了:地址簿里的 host:port 是谁填的?我在源码里把 KRaft 模式下这段旅程追了一遍,advertised.listeners 一辈子大概是这样:
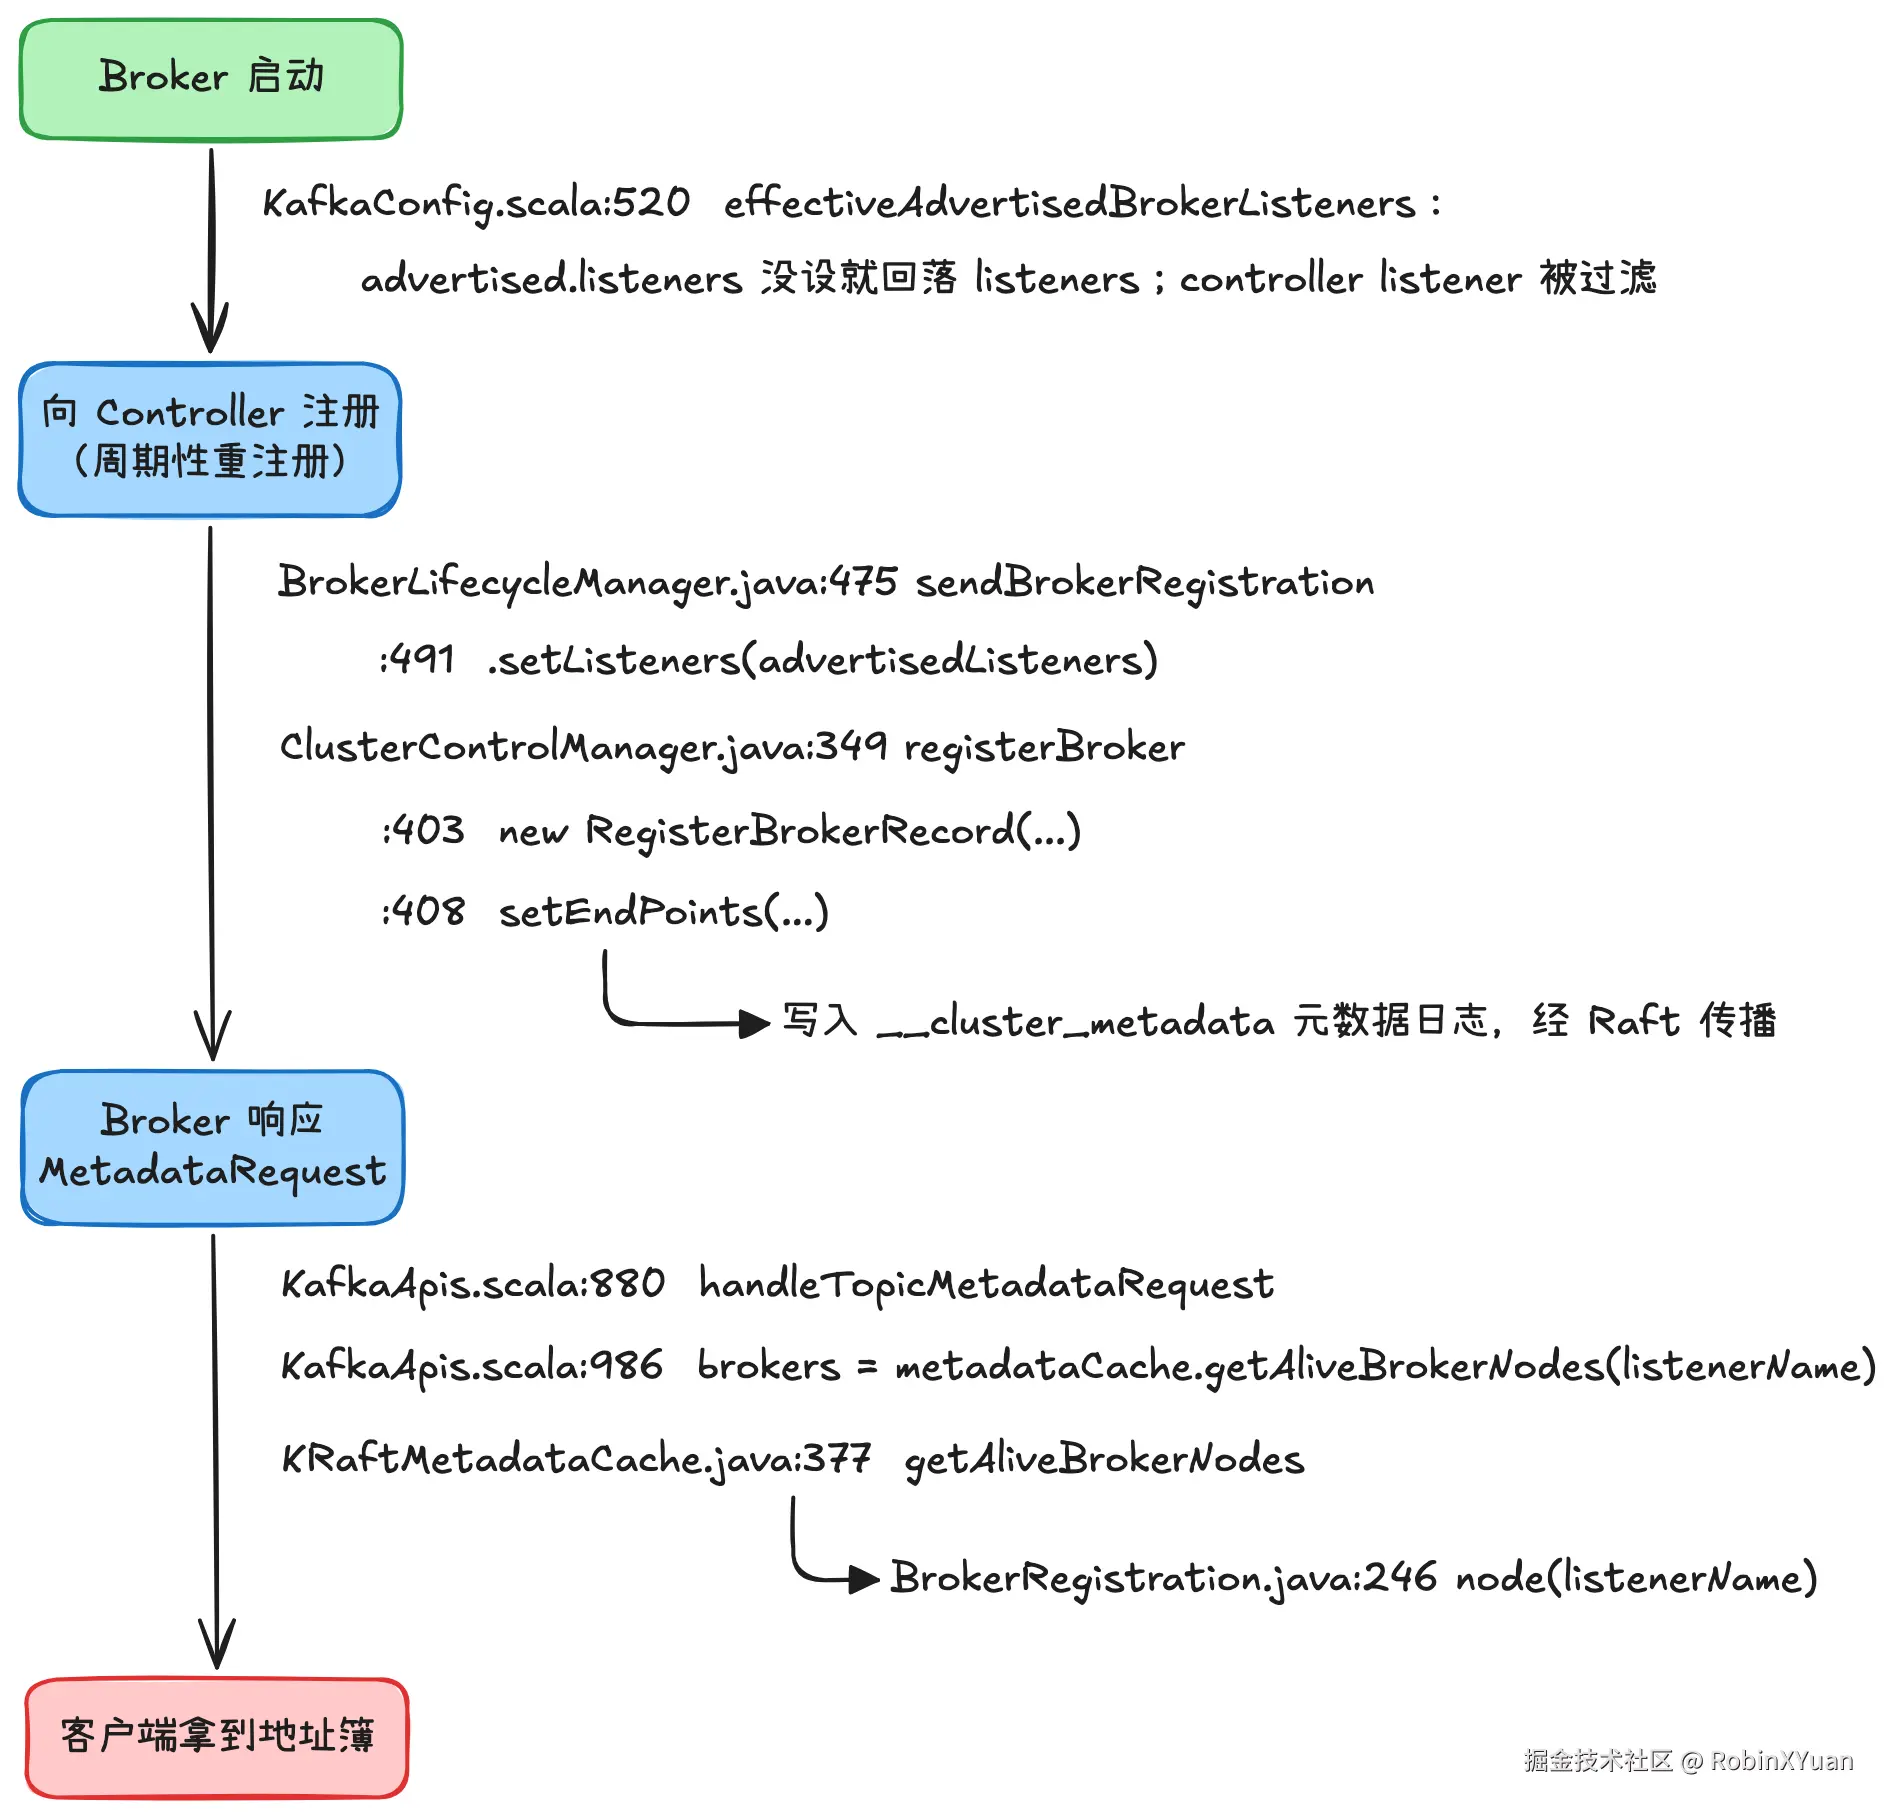
下面我们对每个环节都做一下说明。
第一个环节有个坑在 core/src/main/scala/kafka/server/KafkaConfig.scala:520 :advertised.listeners 不设就回落到 listeners。单机环境下两者无所谓,于是很多人从来没想过它们的区别;等 Broker 挂到需要跨网络访问的地方,「监听在哪个地址」和「告诉别人我在哪个地址」就不再是同一件事了。
第二个环节是这套机制的灵魂:地址是 Broker 自己声明、Controller 记账 。server/src/main/java/org/apache/kafka/server/BrokerLifecycleManager.java:475 的 sendBrokerRegistration 在注册请求里带上自己的 advertised listeners(:491 ),Controller 侧的 metadata/src/main/java/org/apache/kafka/controller/ClusterControlManager.java:349 把它写进 RegisterBrokerRecord(:403 、:408 ),落进 __cluster_metadata 这条元数据日志,再经 Raft 传播到集群每个节点。ZooKeeper 时代这些地址写在 /brokers/ids 下,KRaft 把它收编进了元数据日志------存储形式变了,「Broker 自报地址、控制面分发」的本质没变(元数据日志内部怎么传播,后面有专门的一篇展开)。
第三个环节藏着一个我一开始没看懂的设计:KafkaApis.scala:986 取 brokers 时用的是 metadataCache.getAliveBrokerNodes(request.context.listenerName)------按请求进来的 listener 名过滤端点 。追进 metadata/src/main/java/org/apache/kafka/metadata/KRaftMetadataCache.java:377 和 metadata/src/main/java/org/apache/kafka/metadata/BrokerRegistration.java:246,每个 Broker 注册时上报的是一组 listener 名到端点的映射,响应元数据请求时按对方从哪个 listener 进来就给哪组地址。
这意味着同一个集群对外有不止一本地址簿。回头看 03 篇实验的配置------PLAINTEXT://kafka-N:19092 给容器间互访、PLAINTEXT_HOST://localhost:29092 给宿主机客户端------我们当时已经在用这套机制了:同一个集群,对内网给内网地址,对外网给外网地址。那时我只当它是 Docker 环境的例行麻烦,现在才明白那就是 advertised 机制的正用,而且 03 篇里两个网络互不干扰的原因,正是这个按 listener 过滤的逻辑。
同时我们可以看到一个善意的报错:如果某台 Broker 广播的 listener 名在请求侧不存在,v6 起的 MetadataRequest 会让响应带上 LISTENER_NOT_FOUND(KafkaApis.scala:954 的 errorUnavailableListeners;更早的 v0 还有个 errorUnavailableEndpoints),客户端侧 NetworkClient.java:1281 到 :1290 会把受影响的分区打出来------最多列 10 个,防止刷屏。比起默默连不上,这至少把「服务端自以为广播的地址」和「客户端实际能用的地址」对不上的问题摆上了台面。
写到这里,三种地址终于可以摆在一起说了,谁写、谁读、进不进元数据:
| 地址 | 谁写 | 谁读 | 进元数据吗 |
|---|---|---|---|
bootstrap.servers |
客户端配置 | 客户端自己(进门用,加应急通道) | 不进 |
listeners |
Broker 配置 | Broker 自己(决定绑在哪监听) | 不进 |
advertised.listeners |
Broker 配置,缺省回落 listeners |
随注册写进元数据日志,真正的读者是客户端 | 进------它就是地址簿 |
回头看代理事故为什么逃不掉:三行里只有第三行的值会离开 Broker 所在的机器去旅行,而 L4 代理恰恰只出现在这趟旅行的路上。
地址簿会过期吗:Metadata 的保鲜
地址簿拿到手只是开始。Leader 会切换、Broker 会上下线,客户端怎么知道手里的地址簿还是新的?机制在 clients/src/main/java/org/apache/kafka/clients/Metadata.java,两条线:
一条是周期兜底。metadata.max.age.ms 默认 5 分钟(clients/src/main/java/org/apache/kafka/clients/producer/ProducerConfig.java:447 ,ConsumerConfig.java:452 同值),Metadata.java:178 的 timeToNextUpdate 用 lastSuccessfulRefreshMs + metadataExpireMs 算出下次刷新时间,到点就刷。
另一条是事件触发。业务请求撞上 NOT_LEADER_FOR_PARTITION 这类错误,客户端会 requestUpdate(Metadata.java:200 )------标准应对,不新鲜。让我意外的是另一条触发路径:连接断开本身就触发刷新 。NetworkClient.java:1245 的 handleServerDisconnect 在 :1266 调了 metadata.requestUpdate(false)。也就是说,客户端对「连接挂了」的解读不是「网络抖了,重连就好」,而是「我对这个集群的认知可能过期了」。这两个解读的差别,在后面的代理事故里会变得非常直观。
还有个优先级细节:NetworkClient.java:518 的 isReady 会先看元数据是否该刷(metadataUpdater.isUpdateDue)------该刷的时候,节点即使连接就绪也不算 ready,业务请求不放行,先让 MetadataRequest 插队。元数据优先于业务,客户端把这条优先级写死在了调度逻辑里。
连接按 nodeId 记账
最后一块拼图:连接本身。NetworkClient.java:359 的 ready 是总入口,依次问三件事------节点连接就绪了吗(:518 isReady)、能发起新连接吗、要不要 :1136 的 initiateConnect。真正建立连接的地方在 initiateConnect:先在 ClusterConnectionStates 里登记状态,取 currentAddress,然后 selector.connect(nodeId, InetSocketAddress(address, node.port()))------注意第一个参数是 nodeId,clients/src/main/java/org/apache/kafka/common/network/Selector.java 的连接池就是按 nodeId 划分的,一个 nodeId 一条连接 ,建立、复用、断开、重连,全以 nodeId 为主。
clients/src/main/java/org/apache/kafka/clients/ClusterConnectionStates.java 是每条连接的状态机,有三处我认为比较重要的地方:
- :77
canConnect:状态得是DISCONNECTED,且距上次尝试超过reconnectBackoffMs。退避是指数的:reconnect.backoff.ms默认 50ms 起步、reconnect.backoff.max.ms默认 1000ms 封顶(ConsumerConfig.java:515 到 :523)。Broker 短暂不可用时,客户端的重连节奏是先密后疏,而不是傻等固定间隔。
java
/**
 * Return true iff we can currently initiate a new connection. This will be the case if we are not
 * connected and haven't been connected for at least the minimum reconnection backoff period.
 * @param id the connection id to check
 * @param now the current time in ms
 * @return true if we can initiate a new connection
 */
public boolean canConnect(String id, long now) {
    NodeConnectionState state = nodeState.get(id);
    if (state == null)
        return true;
    else
        return state.state.isDisconnected() &&
               now - state.lastConnectAttemptMs >= state.reconnectBackoffMs;
}- :181
disconnected:这里区分了两种情况。- 已建立的连接断开,会
clearAddresses------下次重连重新做 DNS 解析,因为节点 IP 可能真的换了(云上滚动替换实例很常见); - 而连接建立阶段失败,走的则是连接超时的更新。我原本以为 DNS 只在启动时解析一次,代码否定了我的这一推断。
- 已建立的连接断开,会
java
/**
 * Enter the disconnected state for the given node.
 * @param id the connection we have disconnected
 * @param now the current time in ms
 */
public void disconnected(String id, long now) {
    NodeConnectionState nodeState = nodeState(id);
    nodeState.lastConnectAttemptMs = now;
    updateReconnectBackoff(nodeState);
    if (nodeState.state == ConnectionState.CONNECTING) {
        updateConnectionSetupTimeout(nodeState);
        connectingNodes.remove(id);
    } else {
        resetConnectionSetupTimeout(nodeState);
        if (nodeState.state.isConnected()) {
            // If a connection had previously been established, clear the addresses to trigger a new DNS resolution
            // because the node IPs may have changed
            nodeState.clearAddresses();
        }
    }
    nodeState.state = ConnectionState.DISCONNECTED;
}- :525
moveToNextAddress与 :534resolveAddresses:一个节点名解析出多个地址时(多网卡、多条 A 记录),客户端在地址列表里轮着试。这背后是client.dns.lookup的语义,默认USE_ALL_DNS_IPS(ConsumerConfig.java:422)------多条 A 记录会被视为同一个节点的多个地址。这个默认值后面会坑到人。
这里补充说明一下 A 记录是什么:DNS 里把域名映射到一个 IPv4 地址的记录类型(IPv6 对应的是 AAAA 记录),最常见的就是
名字 → IP这一行。一个域名可以同时挂多条 A 记录------比如kafka.example.com同时指向10.0.0.1、10.0.0.2、10.0.0.3------所谓 DNS 轮询负载均衡,靠的就是解析时轮换返回这些记录的顺序。所以「一个节点名解析出多个地址」并不奇怪:要么机器有多块网卡,要么名字后面挂了多条 A 记录,两种情况客户端都当成同一节点的多个候选地址轮流试。
java
/**
 * Jumps to the next available resolved address for this node. If no other addresses are available, marks the
 * list to be refreshed on the next {@link #currentAddress()} call.
 */
private void moveToNextAddress() {
    if (addresses.isEmpty())
        return; // Avoid div0. List will initialize on next currentAddress() call

    addressIndex = (addressIndex + 1) % addresses.size();
    if (addressIndex == 0)
        clearAddresses(); // Exhausted list. Re-resolve on next currentAddress() call
}

private void resolveAddresses() throws UnknownHostException {
    // (Re-)initialize list
    addresses = ClientUtils.resolve(host, hostResolver);
    if (log.isDebugEnabled()) {
        log.debug("Resolved host {} to addresses {}", host, addresses);
    }
    addressIndex = 0;

    // We re-resolve DNS after disconnecting, but we don't want to immediately reconnect to the address we
    // just disconnected from, in case we disconnected due to a problem with that IP (such as a load
    // balancer instance failure). Check the first address in the list and skip it if it was the last address
    // we tried and there are multiple addresses to choose from.
    if (addresses.size() > 1 && addresses.get(addressIndex).equals(lastAttemptedAddress)) {
        addressIndex++;
    }
}另有一个与代理事故直接相关的参数:connections.max.idle.ms 默认 9 分钟(ConsumerConfig.java:610),源码注释特意写明------故意比服务端默认的 10 分钟略低一点,避免两端同时关闭连接。我很喜欢这种注释,一个魔数背后的取舍被写了下来。记住这个 9 分钟,实验环节它会和代理的空闲超时过一次招。
到这里,客户端侧的完整图景齐了:
现在把一台 L4 代理放到 Bootstrap 和 Broker 中间,看看这些环节会出现怎样的问题。
事故现场:一台 L4 代理引发的寻址混乱
场景设定:出于合规或跨机房的考虑,Broker 只对内网开放,所有外部流量必须过一台 Nginx stream(L4 TCP 转发),vip:9092 轮询转发到三台 Broker。HTTP 服务这么挂负载均衡是标准操作,但放到 Kafka 身上,有两种典型死法。
死法一:什么都不改。 Broker 广播的还是自己的真实地址(内网 ip:9092)。客户端连 vip:9092 成功------代理转发嘛------拿到地址簿,里面是三个内网地址。接下来客户端按地址簿直连 Leader:不通,防火墙只开了代理(更阴险的情况是通的------客户端绕过代理直连成功,代理形同虚设,安全审计追查起来才发现)。症状很有辨识度:客户端日志翻滚 Error connecting to node kafka-N:9092 ... java.net.UnknownHostException------地址泄漏直接写在报错里,console-producer 撞满 delivery.timeout.ms 后报废整批消息。
死法二:把三台的 advertised.listeners 全改成 vip:9092。 看起来「让客户端全走代理」思路正确,实际上制造了一个更精妙的故障。地址簿里三个 nodeId 指向同一个地址;客户端为 node-1/2/3 各建一条 TCP 连接,三条都到 Nginx,Nginx 轮询分发到随机一台。于是一条连接的「身份」出现了分歧:客户端认定它是 node-1 的连接,Nginx 随手把它分给了 broker-2。客户端在这条连接上发 P0 的 ProduceRequest(元数据说 P0 的 Leader 是 node-1),broker-2 一看自己不是 Leader,如实回答 NOT_LEADER_FOR_PARTITION。按照我们之前阅读的源码,客户端的反应是:刷新元数据。但元数据没有错------任何一台 Broker 返回的集群元数据都是一致的、正确的------刷回来的地址簿还是 vip:9092,一模一样。重试,走同一条连接(它还活着),到同一台错的 Broker,再收一次 NOT_LEADER。只要那条连接活着,错误就是稳定的 :客户端和服务端对「线的那头是谁」各执一词,而协议里没有任何一方会纠正另一方。直到某次连接恰好断了重连、Nginx 恰好分对了,或 delivery.timeout.ms 到期放弃。
死法二的症状因此特别迷惑人:时好时坏、部分 Partition 卡死部分正常、延迟抖动、错误日志里全是 NOT_LEADER 却查不出 Leader 有什么问题。诊断指纹倒是不难找:跑一下 kafka-broker-api-versions --bootstrap-server vip:9092,输出里三个不同 id 的 Broker 地址完全相同------正常集群里这是不可能的。
现在能回答「为什么 HTTP 挂 LB 就行」了。两个约束差异:
其一,HTTP 按请求路由,Kafka 按连接路由。HTTP 协议里每个请求自描述(方法、Host、路径),代理可以逐请求无状态分发,连接只是运输管道;Kafka 协议的请求不携带「我要找哪个 Broker」------目标 Broker 的身份记在两处:TCP 连接本身(客户端单方面认定这条连接属于某 nodeId),和元数据里的地址簿。代理只要维持不了 nodeId 与端点的 1:1 对应,两处身份就对不上。
其二,HTTP 的代理可以完全透明,Kafka 的寻址是元数据驱动的。HTTP 客户端不需要知道背后有几台服务器;Kafka 客户端则被服务端亲手塞进了一本地址簿。代理插在地址的传播路径中间,却不被通信的任何一方知晓------它改不了地址簿,就永远保证不了地址簿可用。
再补充一点:Consumer 找 Group Coordinator 的 FindCoordinator 请求(clients/src/main/java/org/apache/kafka/clients/consumer/internals/AbstractCoordinator.java:269 的 ensureCoordinatorReady)拿到的是 Coordinator 所在 Broker 的地址,同样出自这本地址簿。代理接错时,死的不只是读写,整个 Consumer Group 的协调一起遭殃------后面展开 Consumer 协议时我们再细说。
三类解法:地址保持、元数据改写、控制面代劳
弄明白了死因,化解的思路也就清楚了。故障的根源是 nodeId 与端点的 1:1 对应被打破,修复的思路有两种,要么把这个 1:1 的对应关系亲手建出来------保证广播出去的每个地址都有一条唯一固定的转发规则,代理可以不认识协议;要么反过来,让代理本身感知协议,在出口把地址簿里的地址改写成自己的入口。前者的优势很明显:代理无需感知具体协议、性能无损、也不需要随着 Kafka 协议进行演进淘汰,局限在于每个 Broker 要占一个独立端口或域名,而且「三台广播的地址」和「代理的转发规则」必须严格一致,这个人肉维护的契约提升了维护成本。后者恰好相反:客户端零改动、对外只有一个入口地址,代价是代理从此和 Kafka 协议演进绑在一起,每次大版本升级都得跟着验证。
如果顺着第一种思路来做,那么可以有如下解法:
解法一:地址保持------让代理不必懂协议。 最直接的实现是 per-broker 端口映射:vip:19091 只转发 broker-1,19092 只转发 broker-2,19093 只转发 broker-3(Nginx stream、HAProxy 都是几行配置的事),三台的 advertised.listeners 分别写 vip:1909N。更优雅的是 per-broker 域名:b1.kafka.example.com、b2.、b3.------地址可读、TLS 证书好办,但记得前面那个 USE_ALL_DNS_IPS 默认值:多条 A 记录会被当成同一节点的多个地址轮着试,per-broker 域名必须保证解析结果唯一指向一台。云托管平台都是这条路线的工程化:AWS MSK、Confluent Cloud 给每个 Broker 独立的 DNS 名,把 per-broker 端点做成了产品默认值。TLS 场景还有个不解密也能分流的变体:按握手阶段的 SNI 转发(HAProxy、Nginx 的 ssl_preread),身份从端口号换成了 SNI,1:1 的本质没变。
这是手动配置的情况,工程上我们可以将这一过程自动化实现。于是有了:
解法二:控制面代劳------把解法一自动化。 Kubernetes 上跑 Kafka 的 Strimzi 是代表:它给每个 Broker 生成独立的 Service(LoadBalancer、NodePort 或 OpenShift Route;Route 场景用 TLS passthrough 加 SNI 分流),并依据这些 Service 自动渲染出每台各不相同的 advertised.listeners------Kafka CRD 里 listener 的 configuration.brokers[] 支持逐台覆盖 advertisedHost/advertisedPort。机制上没有任何新东西,它自动化的正是解法一,把「每台广播的地址与转发规则是否一致」这个极易配错的人肉步骤,交给了程序。三类解法里,这一类把出错面压得最小。
如果反过来,我们顺着第二种思路,就可以这么实现:
解法三:元数据改写------代理必须懂协议。 与其保证广播地址为真,不如在出口把地址簿改了:代理解析 Kafka 的二进制协议,拦截 MetadataResponse 和 FindCoordinatorResponse,把里面的地址改写成自己的入口地址。现成的实现有 Envoy 的 contrib kafka_mesh filter、kube-logging 的 kafka-proxy。好处是客户端零改动、只有一个入口地址;代价是代理从此和 Kafka 协议演进绑在一起------flexible versions(KIP-482)改了请求头格式,KIP-848 在动 Consumer 协议------每次 Kafka 大版本升级,这类代理都要跟着验证适配。要提醒一个命名陷阱:Confluent 的 REST Proxy 是另一种东西,HTTP 到 Kafka 的协议网关,客户端整个换成 HTTP 说话,不属于这类「协议感知透明代理」。
实验:把事故复现出来
理论讲了很多,还是亲自上手操作一遍印象更深刻。这一节的脚本同样放在附录中,已经在 apache/kafka:4.3.1 三节点集群上实测过,代理用 nginx:alpine 的 stream 模块。下面的输出与日志都摘自真实运行输出。
实验布局:三节点集群(照 03 篇,PLAINTEXT://kafka-N:19092 供容器互访与管理)加一个 kafka-proxy 容器跑 Nginx stream,Broker 只在容器网络里监听,宿主机唯一可访问的入口是 Nginx:9092 轮询转发三台,19091/19092/19093 各自只转发一台。脚本按广播地址分三种模式切换:adv 广播 kafka-N:9092、vip 三台全广播 localhost:9092、fix 广播 localhost:1909N。topic orders(3 分区 3 副本,三个 Leader 恰好分属三台)从容器内管理端口创建,不经代理------要看的是宿主机客户端的遭遇。
死法一(adv 模式),宿主机上执行:
bash
kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic orders卡了约一分钟后超时告终:
text
org.apache.kafka.common.errors.TimeoutException: Timed out waiting for a node assignment. Call: listTopics这一结果说明:--describe 并非只碰 bootstrap 节点,AdminClient 拿到元数据后要等某个真实节点可用(node assignment),而地址簿里那三个节点一个都连不上。等它超时的那一分钟里,DEBUG 日志每秒一条地刷着地址泄漏的铁证:
text
Error connecting to node kafka-1:9092 (id: 1 rack: null isFenced: false)
java.net.UnknownHostException: kafka-1
换 console-producer:
bash
printf 'k1:v1\n' | kafka-console-producer.sh --bootstrap-server localhost:9092 --topic orders127 秒后退出,最后的报错我们很熟悉(delivery.timeout.ms 默认 120s,ProducerConfig.java:406):
text
ERROR Error when sending message to topic orders with key: null, value: 5 bytes with error:
org.apache.kafka.common.errors.TimeoutException: Expiring 1 record(s) for orders-2:120003 ms has passed since batch creation. The request has not been sent, or no server response has been received yet.
还有一个细节需要单独说明:它的退出码是 0。console-producer 发送失败照样成功退出,拿它当健康检查或冒烟测试,会漏掉这一整类故障。想更直观地看地址暴露,可以 sudo tcpdump -i lo0 port 9092 -A 抓包(PLAINTEXT 不加密,MetadataResponse 里的主机名字符串肉眼可读,Wireshark 装上 Kafka dissector 更清楚);感兴趣的读者可以自行操作,这里我没有实际操作------报错里的 UnknownHostException: kafka-1 已经将地址完完全全地暴露到了我们眼前。
死法二(vip 模式)先看诊断信息:
bash
kafka-broker-api-versions.sh --bootstrap-server localhost:9092
text
localhost:9092 (id: 1 rack: null isFenced: false) -> (
	Produce(0): 0 to 13 [usable: 13],
	Fetch(1): 4 to 18 [usable: 18],
	...
localhost:9092 (id: 2 rack: null isFenced: false) -> (
	...
localhost:9092 (id: 3 rack: null isFenced: false) -> (
	...
4.x 里这个工具的输出是每个 Broker 一段多行 API 列表,跟老版本的单行格式不一样,但破绽一目了然:三个 id 不同、地址全同------正常集群不可能如此。
然后复现那个死循环。直接跑 console-producer,首先是一个迷惑性极强的现象------发 3 条消息,约 1.5 秒整批报废:
text
ERROR Error when sending message to topic orders with key: null, value: 5 bytes with error:
org.apache.kafka.common.errors.NotLeaderOrFollowerException: This server is not the leader for that topic-partition.
4 次 Produce 尝试全落在同一条被 Nginx 分错了的连接上收到 NOT_LEADER_OR_FOLLOWER,重试 3 次用完就放弃。翻源码才知道为什么这么快:console-producer 默认不解析 key(key 为 null 时消息全粘在一个分区------StickyPartitioner 的行为),而 --message-send-max-retries 默认 3(tools/src/main/java/org/apache/kafka/tools/ConsoleProducer.java:169 起,这个参数控制的就是 retries)------它等不到 delivery.timeout.ms 上场就认输了。要让死循环的全貌显形,把 key 和重试都放开:
bash
kafka-console-producer.sh --bootstrap-server localhost:9092 --topic orders \
  --property parse.key=true --property key.separator=: \
  --producer-property retries=100000
同一条命令跑两次,结果截然不同------这正是 vip 模式「时好时坏」口碑的来源。第一次 8 秒三分区全部写入成功,一次 NOT_LEADER 都没碰到:Nginx 恰好把三条连接都分对了。第二次 127 秒,三分区各收到约 123 次 NOT_LEADER_OR_FOLLOWER,每秒撞一次墙;出错后客户端每次都如实去刷元数据,DEBUG 日志明白告诉我们「刷了也白刷」:
text
For orders-2, incoming leader(LeaderIdAndEpoch{leaderId=3, epoch=0}) is not-newer than
the one in the existing metadata LeaderAndEpoch{leader=Optional[localhost:9092 (id: 3 ...)]},
so ignoring.
新刷回来的地址簿还是那三个一模一样的 localhost:9092,epoch 没变,被判定「不比现有的新」就直接丢弃。四条连接(bootstrap 加 node-1/2/3)只在开场建立了一次,之后两分钟里再没重连过------「只要连接活着,错误就是稳定的」,直到 delivery.timeout.ms 到期:Expiring 1 record(s) for orders-0:120370 ms has passed since batch creation.。两分钟整的寿命与我们的预期对得上;日志里每个来回都长一个样:发出去、收到 NOT_LEADER、毫秒级刷回一轮元数据、又被 not-newer 判定无效,退避后再发,一个分区约一秒一个来回。
修复版(fix 模式):kafka-broker-api-versions 里三个地址各归各位------localhost:19091 (id: 1)、localhost:19092 (id: 2)、localhost:19093 (id: 3);--describe 从宿主机约 4 秒返回;同一条 producer 命令约 4 秒写完三分区,容器内消费 3 条全落地。没有任何魔法:广播地址与转发规则一一对齐之后,前面所有症状一起消失。
最后是之前那个 9 分钟的伏笔。把 19091 的 proxy_timeout 设成 60 秒------远短于客户端 connections.max.idle.ms 的 9 分钟------在单个会话里发一条、sleep 120、再发一条。我预想的场景是:连接空闲 60 秒被 Nginx 静默关闭,客户端不知情(TCP 半开),第二条消息挂在死连接上直到 request.timeout.ms 超时才重连成功,于是「空闲后的第一条消息延迟异常」。但实际测试完发现情况不太一样:总耗时 121 秒,约等于纯 sleep。DEBUG 日志给出了真相------空闲整 60 秒的那一刻,客户端当场就发现了断连:
text
Connection with localhost/127.0.0.1 (channelId=-1) disconnectedNginx 的 proxy_timeout 到期后是显式关闭连接,客户端的选择器一直盯着这条连接的读事件,服务端一关它就知道。于是第二条消息到来时,客户端对 node-1 发起一条全新连接,17 毫秒后 Produce 请求已经在线上了------无感恢复。所以「代理空闲超时过短」在 Nginx 这里只是多付一次建连的代价;预想场景中那种半开连接等到 request.timeout.ms 挂掉的情况,病根在静默丢包 的中间设备------状态防火墙、NAT 超时丢表项且不通知两端。L4 代理的 checklist 里真正该写的是:空闲超时以 connections.max.idle.ms 为参考下限之外,更要紧的是弄清中间设备超时后到底是「打个招呼再走」还是「不辞而别」------前者对我们而言无感,后者则可能引发线上问题。
对比参照:地址是不是协议的一部分
拿「服务端地址是否内嵌于协议」这一点去分析,我们可以将系统分为两类。
HTTP 是一类:请求自描述、无连接状态,代理逐请求分发即可,连接只是运输通道。所以「挂个 LB 就行」不是 HTTP 的特性,是它的约束带来的"副作用"。
Kafka、RocketMQ 则是另一类。RocketMQ 的客户端从 NameServer 拿到的是 Broker 的真实 IP:port,路由表由客户端持有、连接长驻------同样的约束:长连接 RPC,地址写进协议响应,代理必须维护节点与端点的 1:1,或者亲自改写协议。
再往外看,etcd 的 --advertise-client-urls、Redis Cluster 的 cluster-announce-*、Cassandra 的 broadcast_address------名字五花八门,但干的都是同一件事:节点自己声明「客户端该用什么地址找我」。凡是这么设计的系统,在容器、NAT、双网卡环境下都可能会碰上同一类故障:声明错了,客户端遭殃,而服务端自我感觉良好。解决办法也差不多------要么运维手工保证声明为真,要么控制面代填。
约束不同,设计才不同:地址若不是协议的一部分,代理可以透明;地址若写进了协议响应,透明代理就是个谎言。
工程启示
用好 Kafka:代理场景的接法 checklist。 从这一篇的教训我们可以总结出几条 checklist:
- 每个 Broker 一个独立可路由端点,优先 per-broker 域名,其次 per-broker 端口映射;
advertised.listeners逐台写、与代理转发规则严格一致,多网络用多 listener 分地址簿;- 中间设备的空闲超时不短于
connections.max.idle.ms(默认 9 分钟),并且分清它超时后是显式关闭还是静默丢包------前者(如实测的 Nginx)客户端无感重建,后者(NAT、状态防火墙)会让空闲后首条请求等到request.timeout.ms之后才挂掉; - 留意
client.dns.lookup的默认语义(USE_ALL_DNS_IPS把多条 A 记录当同一节点的多地址轮询); - 排查时先跑
kafka-broker-api-versions,看各 id 地址是否唯一------一条命令就能区分是哪种死法。
设计借鉴:advertised 地址由谁保证为真。 把服务端地址写进协议响应的系统,只要跨网络部署,就必须回答这个问题------声明与现实的最终一致性靠谁维护。人肉维护必然漂移(三台配置改漏一台,就是死法二的其中一种成因),工程上站得住的答案只有一个:让控制面成为地址的唯一写入者,地址声明与转发规则同源生成、原子生效。Strimzi 的做法是范本,而这个模式本身远不止适用于 Kafka------任何「节点自报地址」的系统都可以借鉴。
小结
总结一下这次事故场景。bootstrap.servers 是门:正常情况下只会用到一次,偶尔可用于救急(REBOOTSTRAP);门后的地址簿由 Broker 亲笔书写------advertised.listeners 随着注册进元数据日志,Broker 按 listener 名分发不同版本;客户端拿 5 分钟周期加事件触发维持数据新鲜,按 nodeId 建立连接、复用、退避重连。L4 代理事故从头到尾不是网络问题,而是「地址簿的权威性」问题:HTTP 的惯性让我们以为代理可以透明,Kafka 的寻址协议明确说不可以------想透明,先保证每个 nodeId 背后是唯一且真实的端点,或者干脆改写地址簿,或者让控制面替你保证。
而文章开头那次 MetadataRequest,穿过代理抵达 Broker 之后,故事才讲到一半:Broker 那边怎么接住一个请求------谁来 accept、谁来读、请求排到哪、由谁处理?
下一篇:Broker 网络层与请求处理。