这篇回答一个实际问题:你在业务代码里写了 producer.send(record, callback),当 Broker 返回成功时,这个 callback 到底是在哪个线程、以什么顺序、拿到什么参数被调用的?为什么 acks=0 时 callback 立即触发?
01 最终处理链路:七步走完
从 NetworkClient.poll() 读到完整响应,到你写的 callback 被调用,中间经过七个环节。
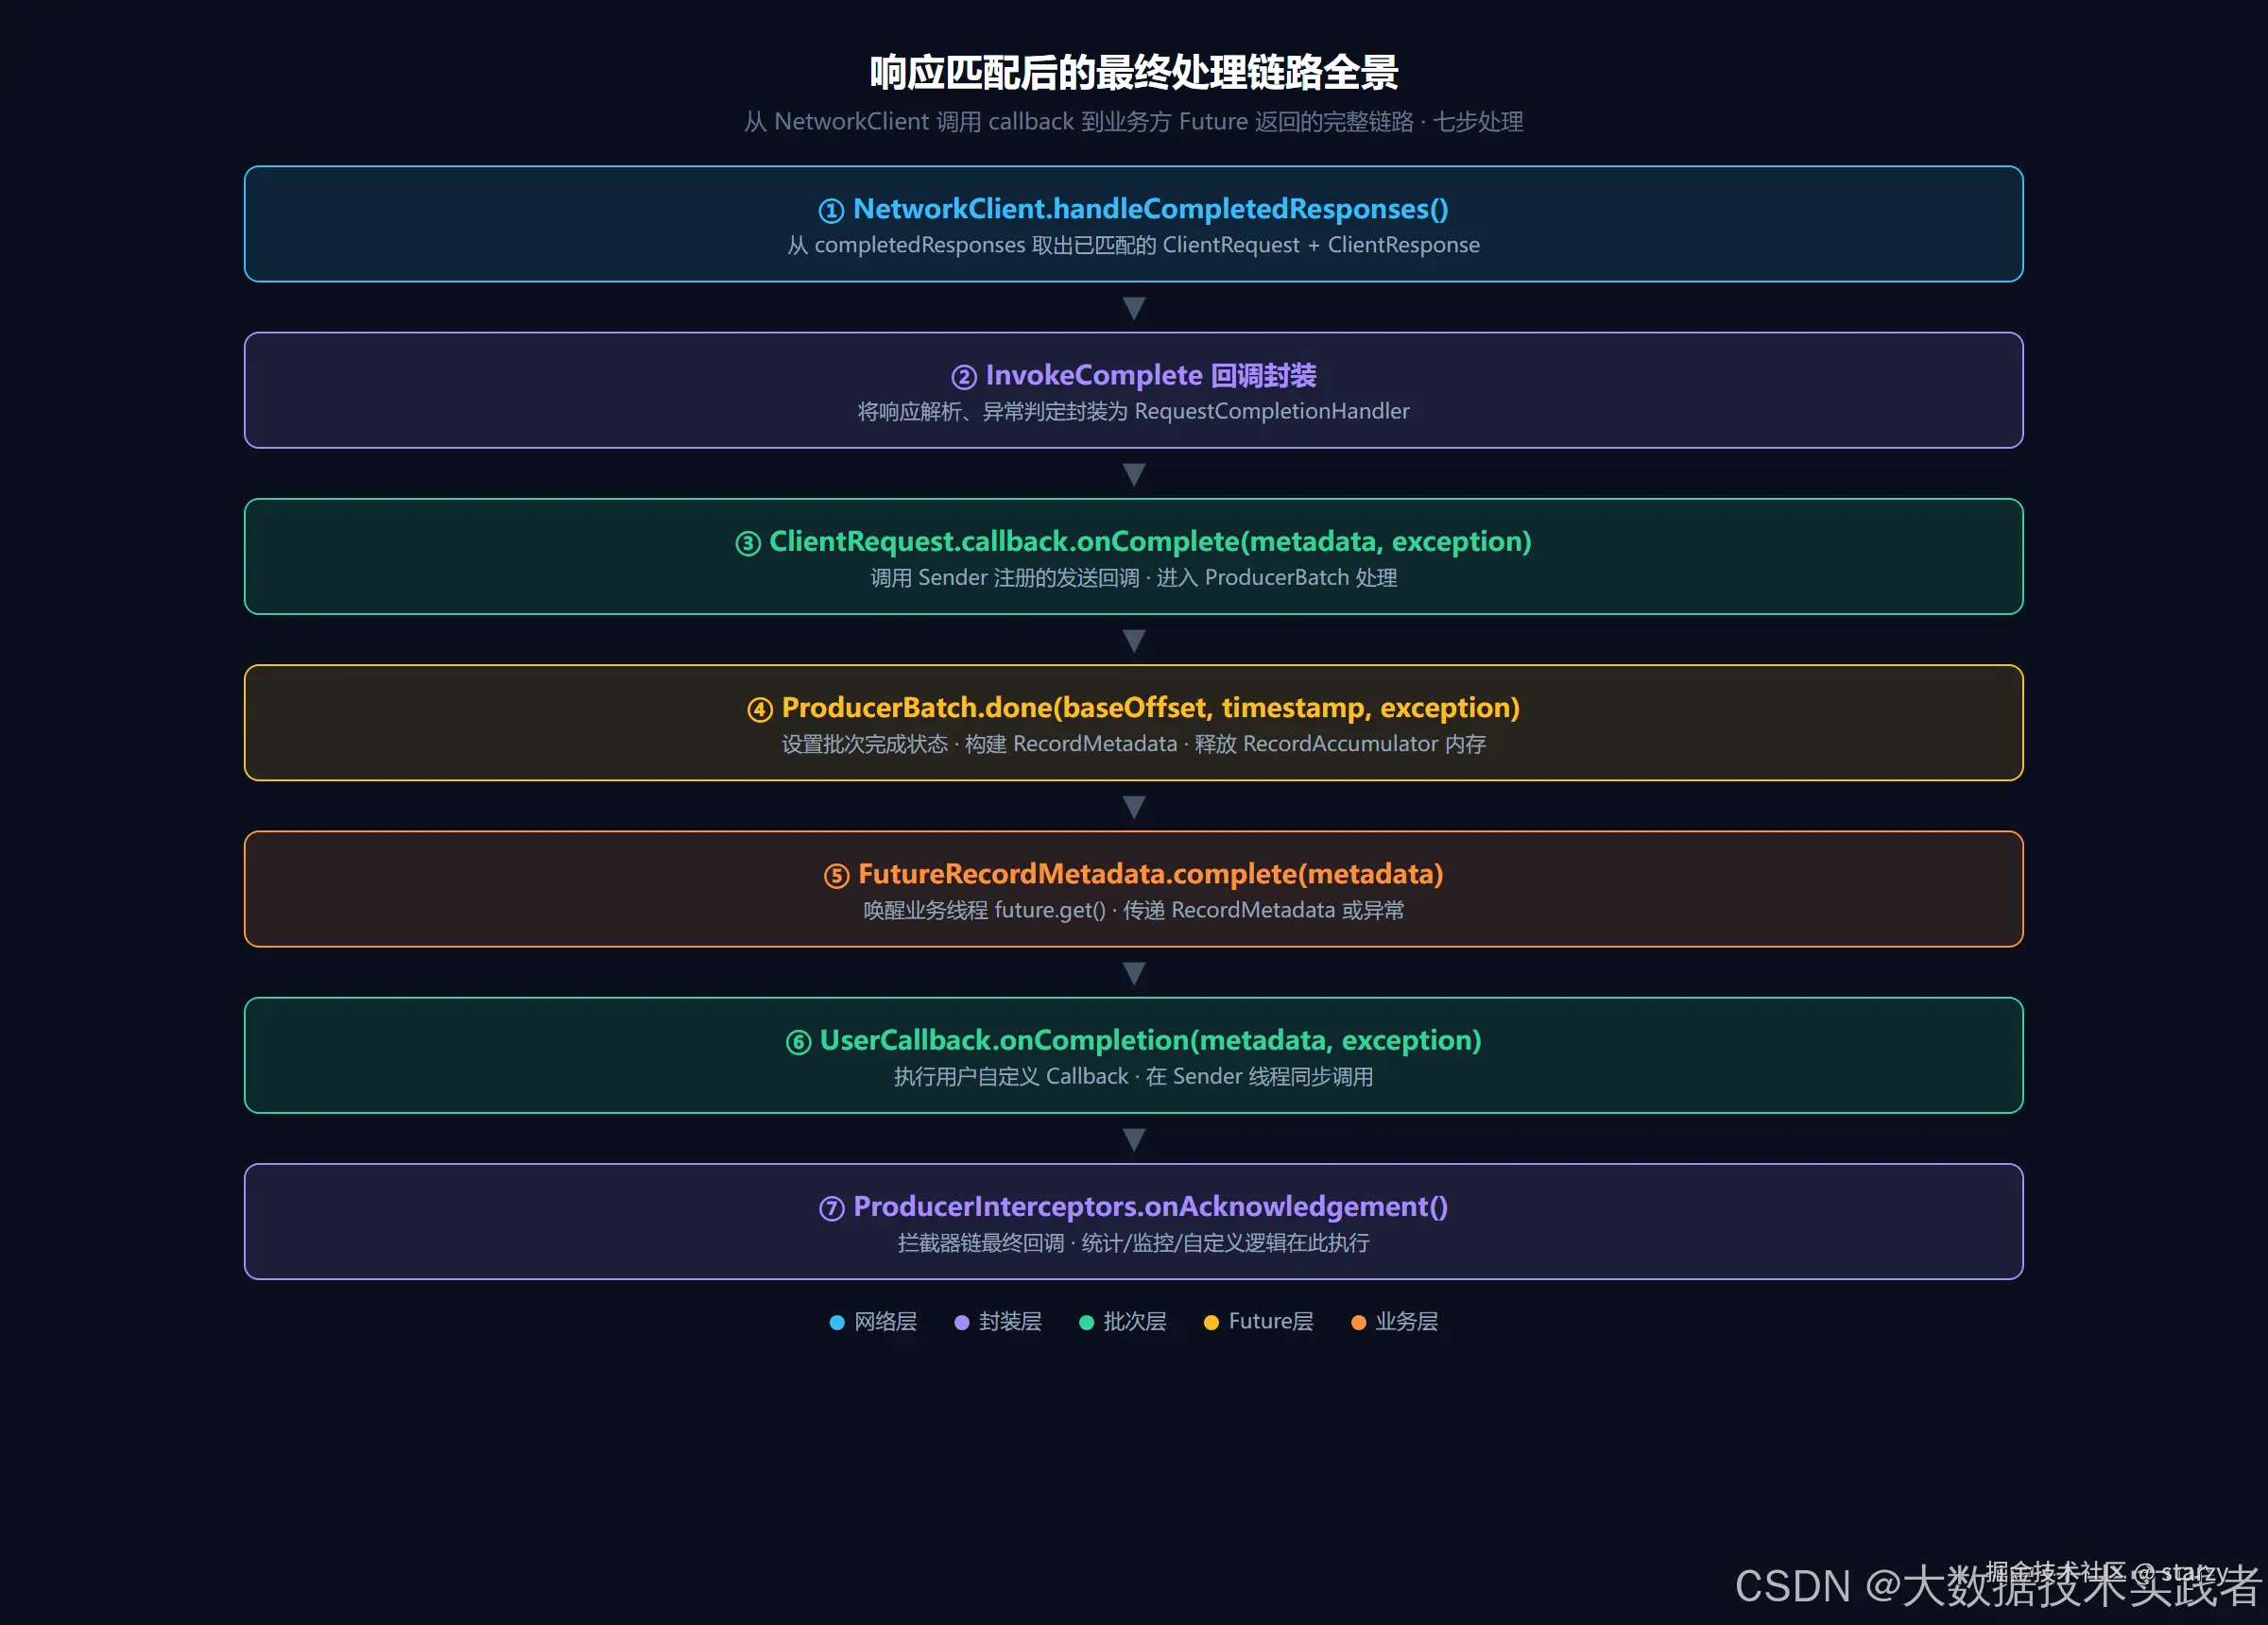
① handleCompletedResponses:NetworkClient 从 completedResponses 队列取出已匹配的 (ClientRequest, ClientResponse) 对,调用 request.completed(response)。
② InvokeComplete 封装:Sender 在 doSend() 时注册的回调不是直接的用户回调,而是一个 InvokeComplete 对象。它负责解析 ClientResponse、判断异常、调用真正的发送回调。
③ ClientRequest.callback.onComplete():进入 Sender 层的发送回调,这一步把响应和 ProducerBatch 关联起来。
④ ProducerBatch.done():这是核心------标记批次完成、构建 RecordMetadata、释放 RecordAccumulator 的内存、从队列移除。
⑤ FutureRecordMetadata.complete() :业务线程调用 future.get() 时阻塞在这里,CAS 状态后 notifyAll 唤醒。
⑥ UserCallback.onCompletion():你写的 callback 在这里执行。
⑦ ProducerInterceptors.onAcknowledgement():拦截器链最后执行,不管成功失败都会调用。
02 成功路径:RecordMetadata 怎么来的
成功响应(errorCode=0)时,最关键的产出是 RecordMetadata------你 callback 里拿到的那个对象。
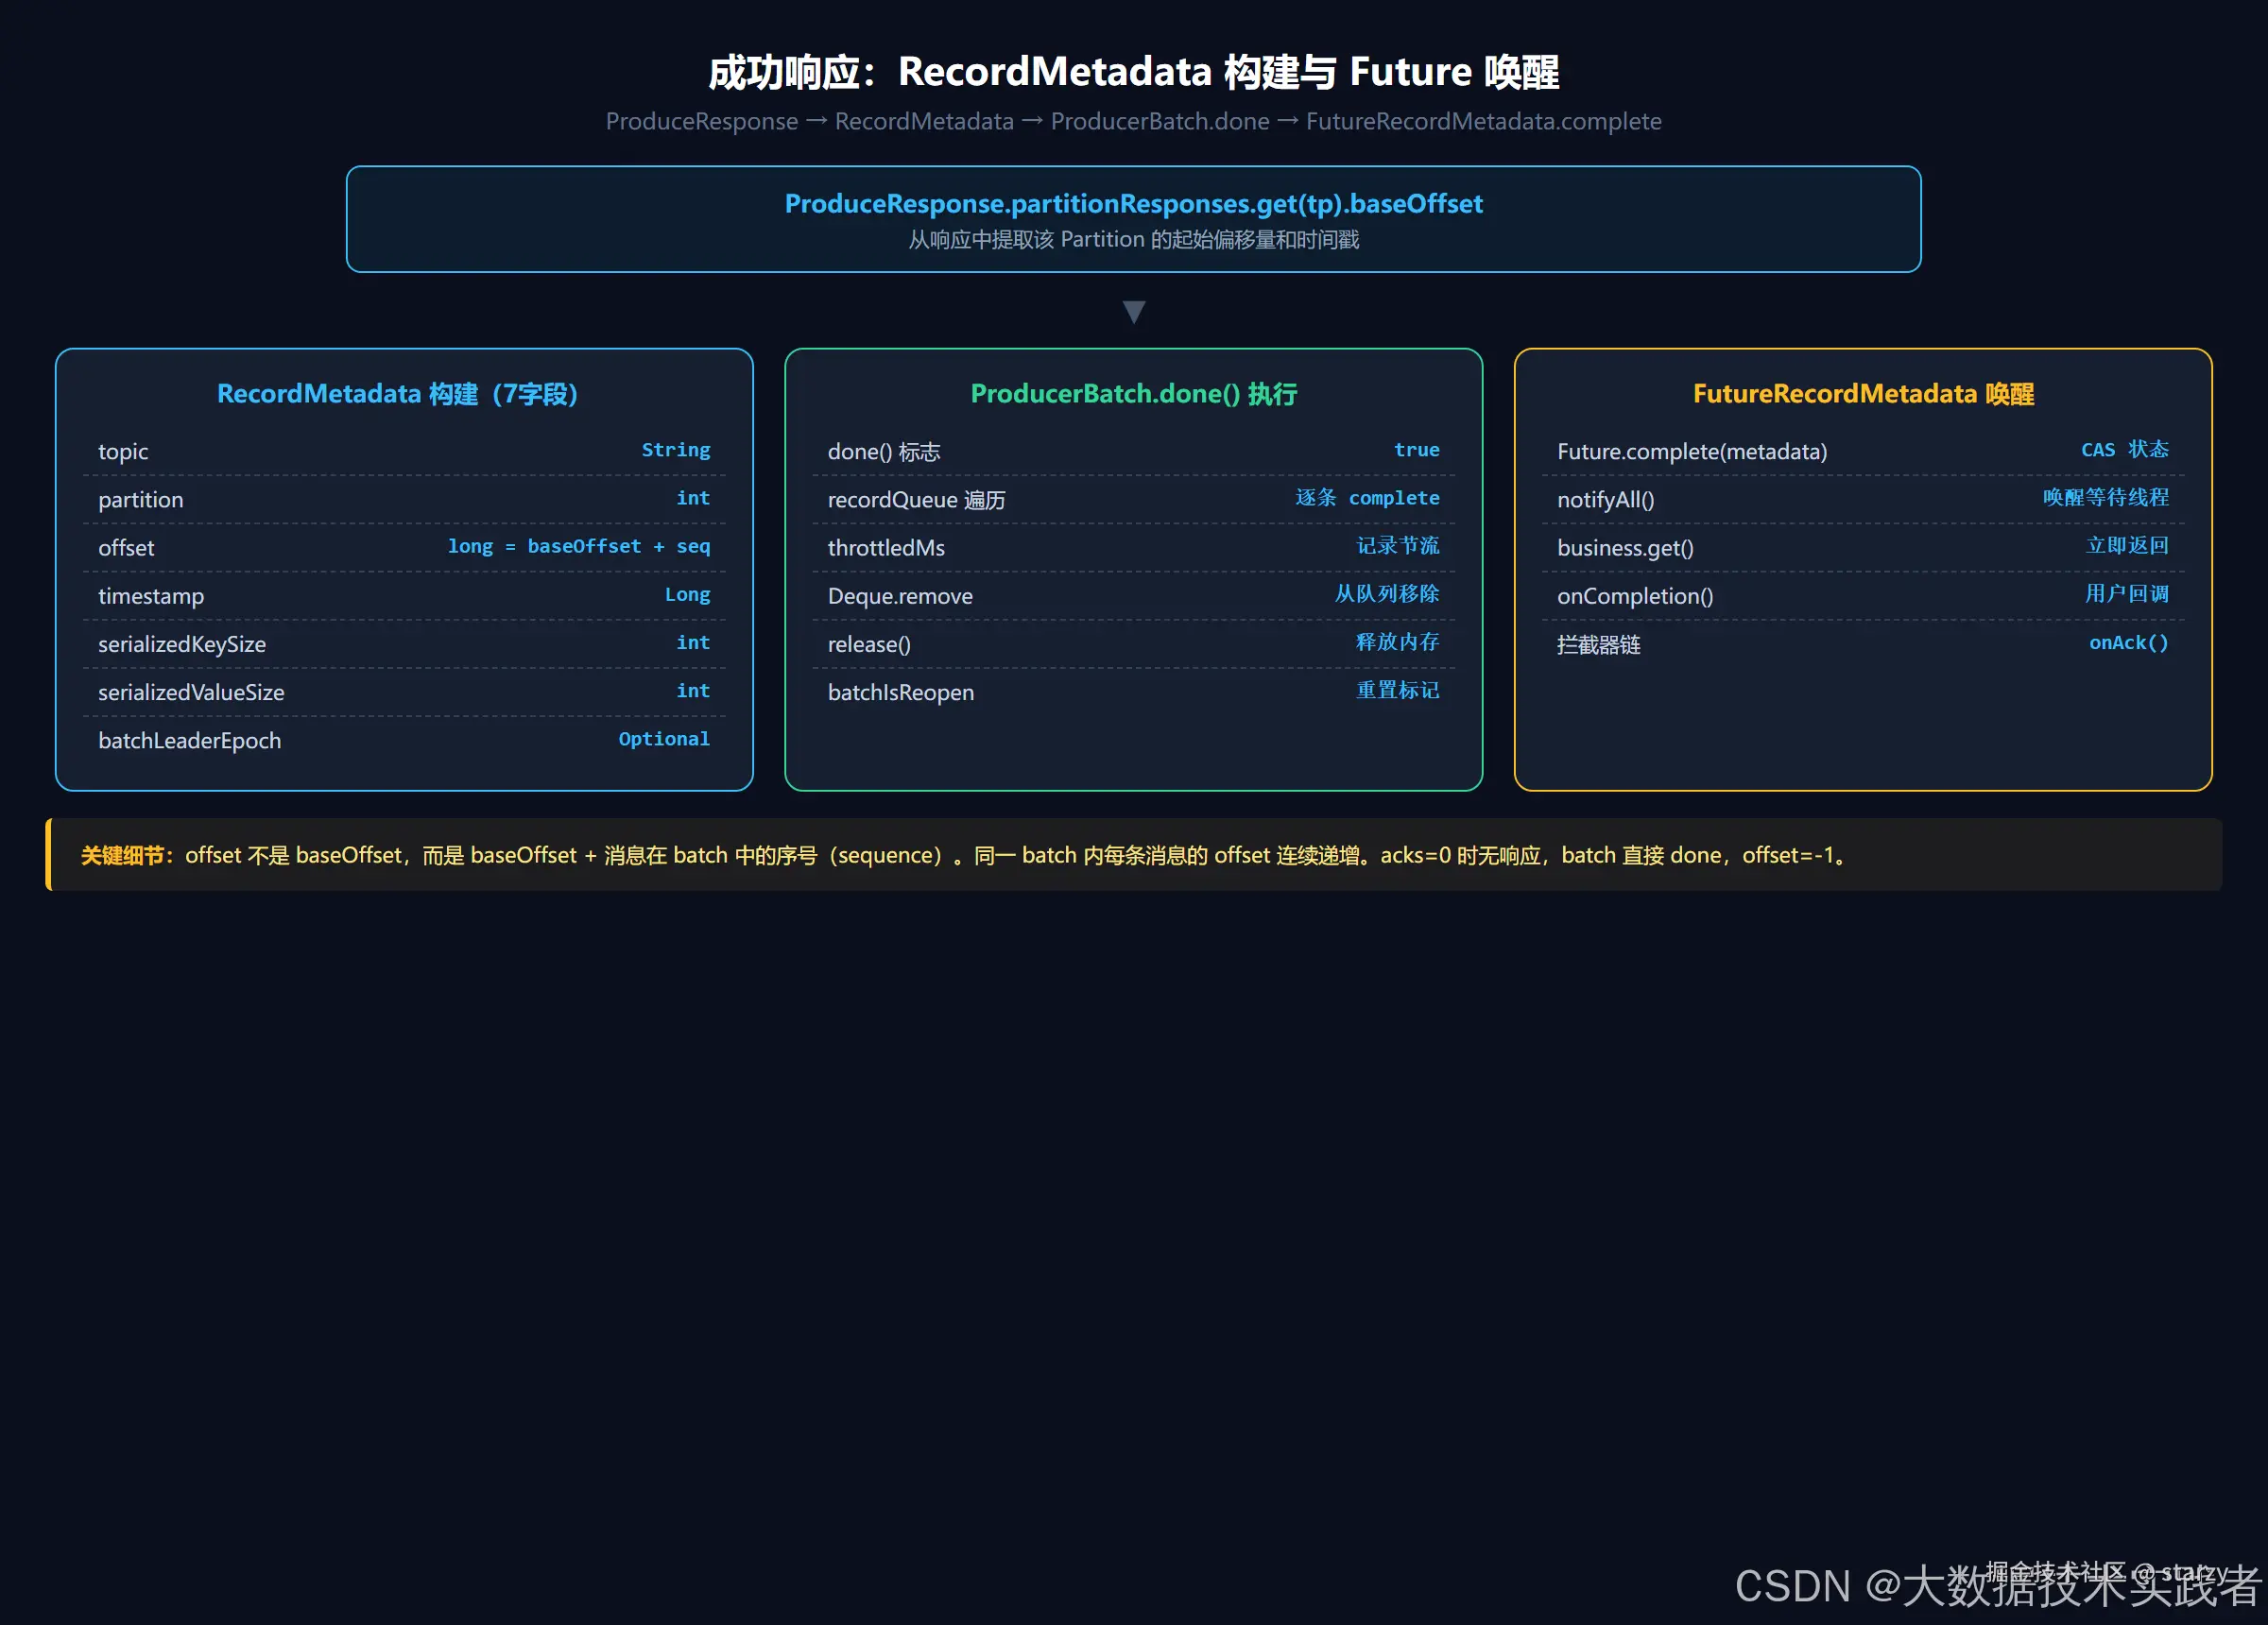
RecordMetadata 的七个字段:
- topic:写入的 Topic 名
- partition:分区号
- offset:消息在分区中的偏移量,= baseOffset + 消息在 batch 中的 sequence
- timestamp:Broker 写入时间或 CreateTime
- serializedKeySize:序列化后 key 的字节数
- serializedValueSize:序列化后 value 的字节数
- batchLeaderEpoch:leader 纪元(可选,用于 leader 切换后校验)
ProducerBatch.done() 做了什么:
arduino
// 伪代码,核心逻辑
void done(long baseOffset, long timestampMs, RuntimeException exception) {
    // 1. 遍历 batch 中每条未完成的 record
    for (FutureRecordMetadata future : futures) {
        if (exception == null) {
            // 成功:构建 RecordMetadata
            RecordMetadata metadata = new RecordMetadata(tp, baseOffset + sequence, ...);
            future.complete(metadata);  // 唤醒业务线程
        } else {
            future.completeExceptionally(exception);  // 失败:传异常
        }
    }
    // 2. 从 RecordAccumulator 的 deque 中移除
    // 3. 释放 ByteBuffer(归还给 ByteBufferPool)
    // 4. 唤醒 sender 继续发新 batch
}这里有个容易忽略的点:offset 不是 baseOffset。同一 batch 里 N 条消息,offset 从 baseOffset 开始连续递增。你在 callback 里拿到的是单条消息的最终 offset,不是整个 batch 的起始 offset。
acks=0 的特殊情况:不等待响应,batch 在发送后直接 done,offset=-1,timestamp=-1。此时 callback 在 Sender 线程同步触发,但 RecordMetadata 里的 offset 没有意义。
03 失败路径:异常怎么传出来
失败时,errorCode 决定走哪条路。
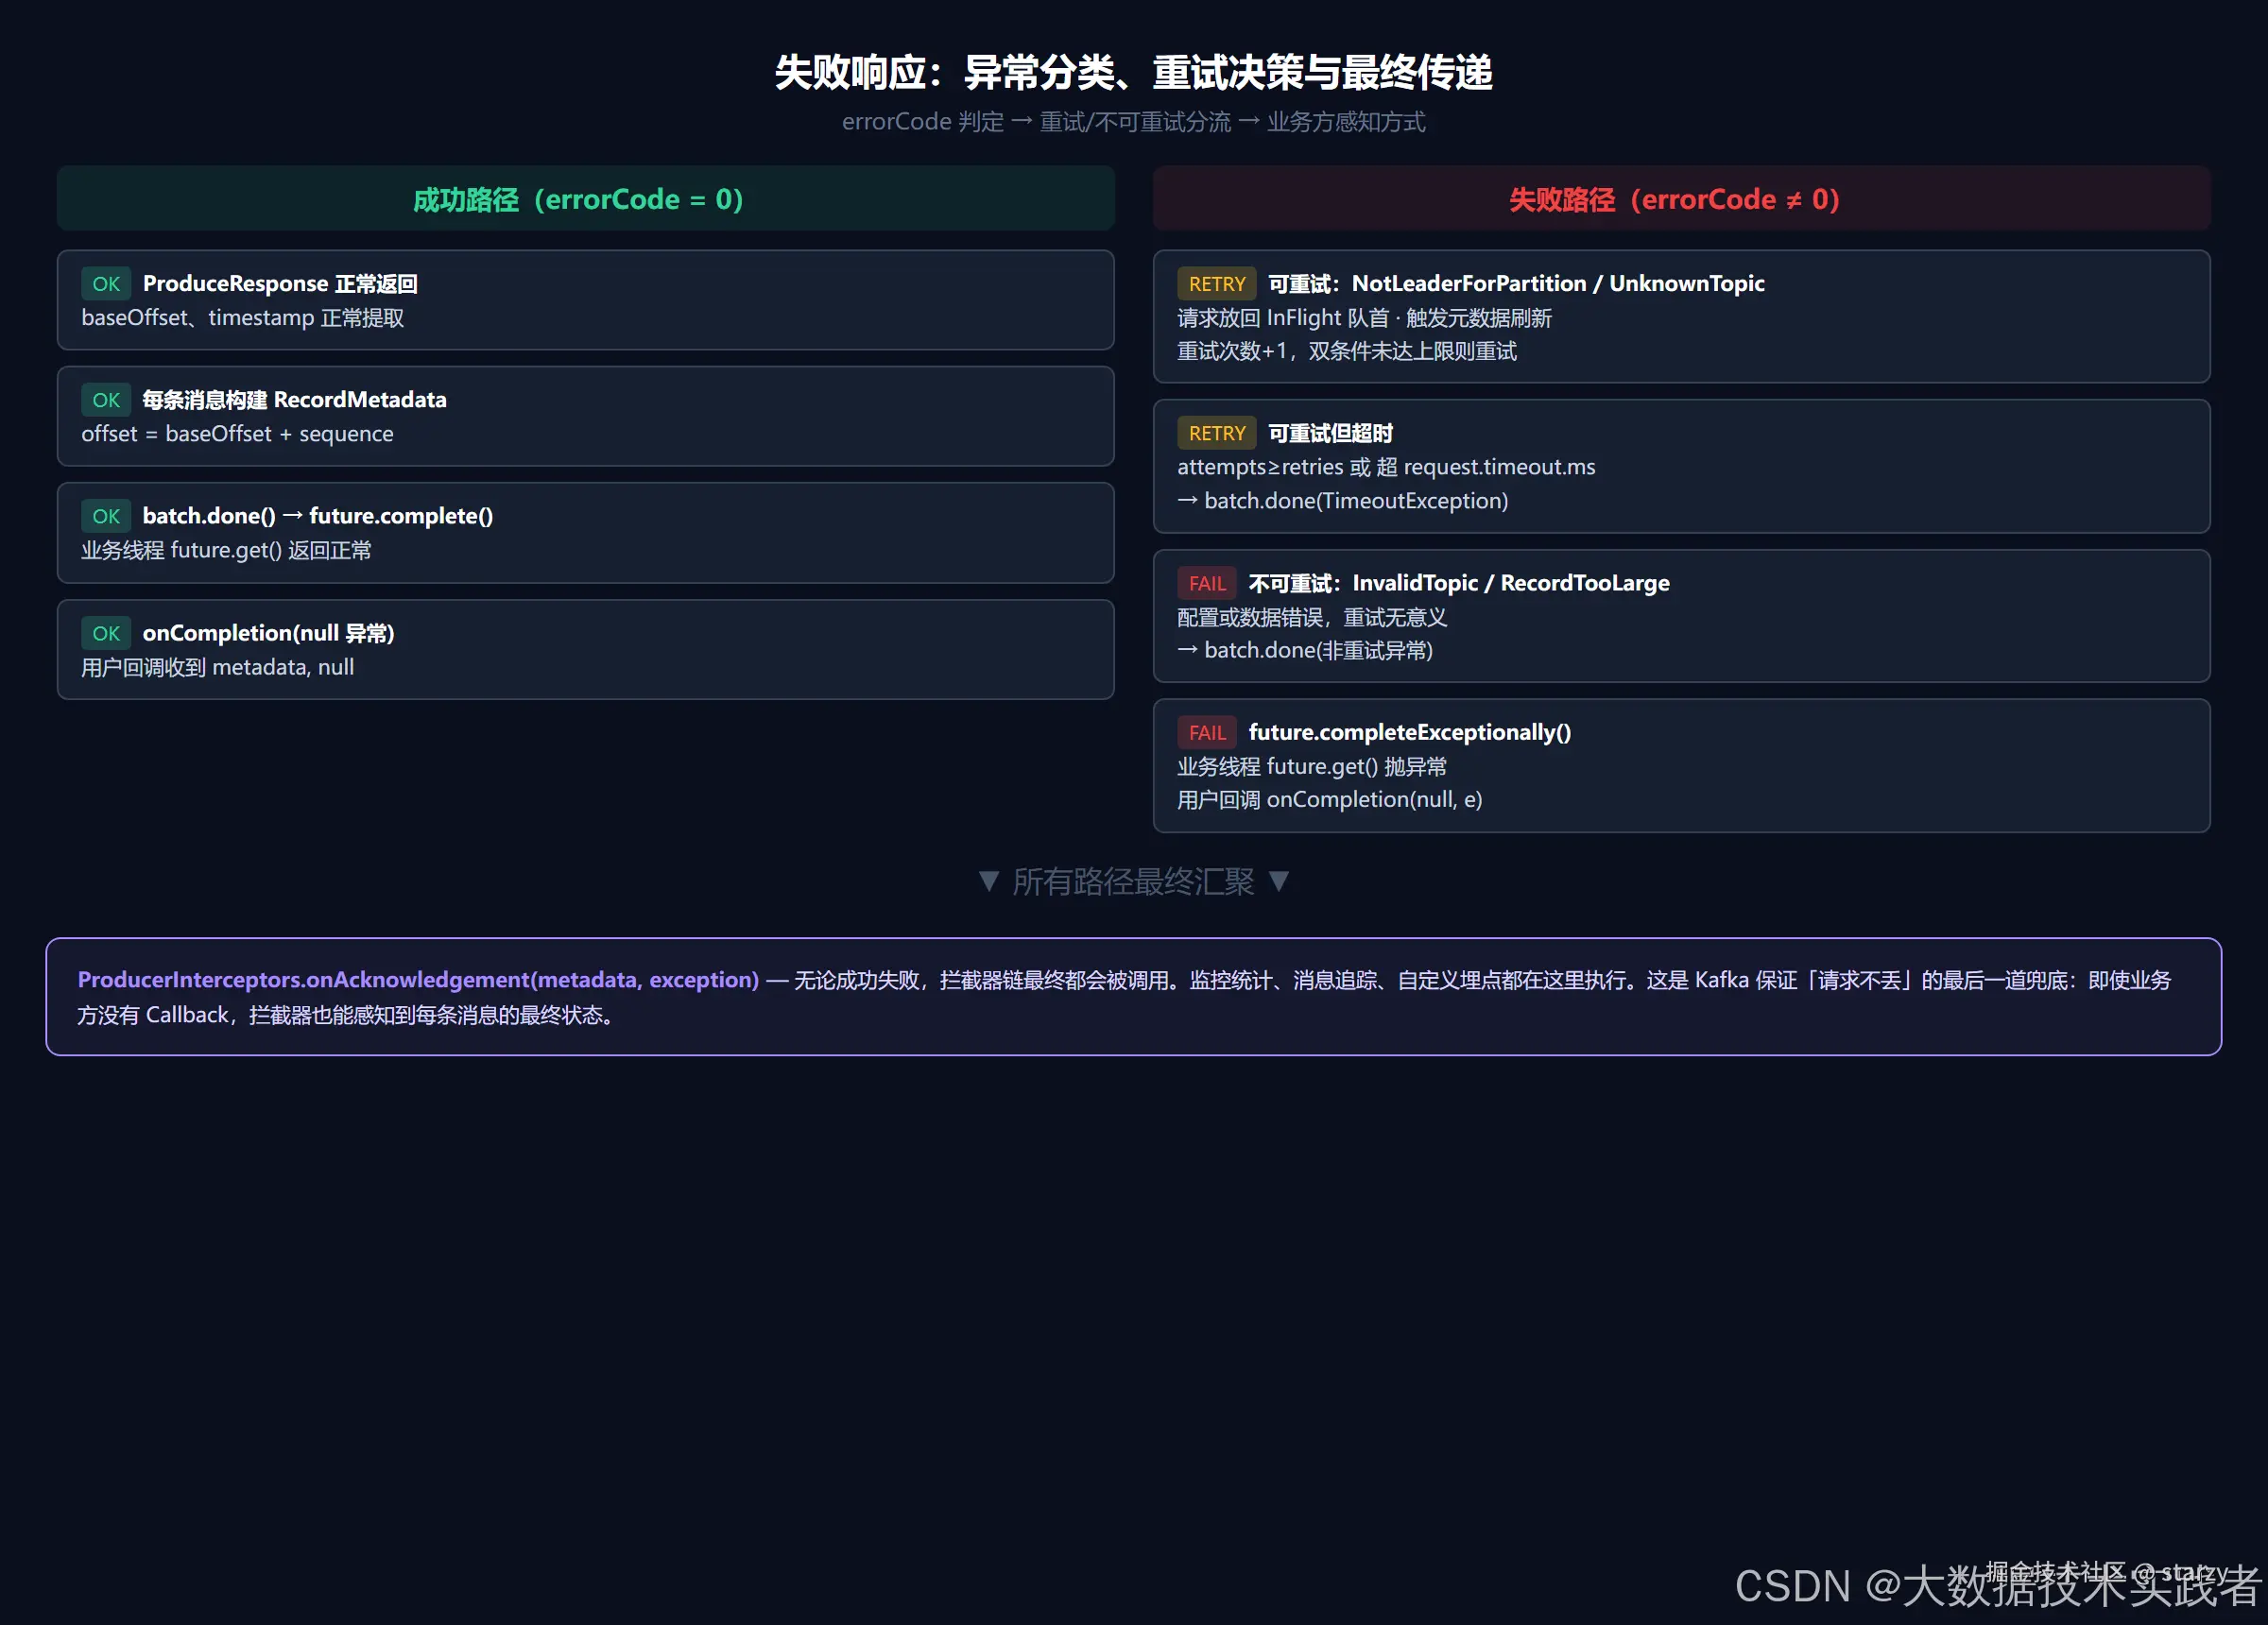
可重试异常(RetriableException):
- NotLeaderForPartition、UnknownTopicOrPartition 等------leader 可能刚切换
- 请求放回 InFlight 队首,下次 poll 重新发送
- 同时触发元数据刷新,更新 leader 位置
- 双条件限制:重试次数 < retries 且耗时 < request.timeout.ms
不可重试异常(NonRetriableException):
- InvalidTopicException、RecordTooLargeException 等------配置或数据本身有问题
- 重试没有意义,直接失败
- future.completeExceptionally(),业务线程 get() 时抛异常
超时的边界: 即使是可重试异常,如果重试次数用完或总耗时超过 request.timeout.ms,也会转为失败,抛 TimeoutException。
业务方怎么感知失败: 两条路------同步 send().get() 会抛异常;异步 callback 的 onCompletion(null, exception) 收到非空异常。两种方式拿到的异常是同一个。
04 两个容易踩的坑
坑一:callback 在哪个线程执行?
所有 callback(包括用户 callback 和拦截器)都在 Sender 线程同步执行。这意味着:你的 callback 里不能做耗时操作------如果 callback 里执行了一个 RPC 调用或复杂计算,整个 Sender 线程会被卡住,所有消息的发送都会被阻塞。
坑二:拦截器最后执行,不是最先
ProducerInterceptor.onSend() 在消息序列化前执行(发送前),onAcknowledgement() 在响应处理完最后执行。如果你在拦截器里做消息追踪,onAcknowledgement 才是消息"最终命运"的准确时间点------onSend 时消息可能还没发出去,甚至可能因为缓冲满而阻塞。
写在最后
响应处理的本质是:把网络层的字节流,还原成业务层能理解的 RecordMetadata 和异常。七步链路看起来长,但核心只有两个动作------构建 RecordMetadata、complete Future。其余都是围绕这两个动作的资源清理和拦截器编排。
到这里,KafkaProducer 的完整发送链路就走完了:从 send() 方法初始化、选分区、进 RecordAccumulator、Sender 线程聚合、网络发送、粘包拆包、InFlight 匹配、最终响应处理。