前言
可能大家在日常开发中多多少少接触过一些反射编程技术。反射可以让在运行中的程序动态地解析并操作自身从而改变一些行为。本篇文章以 Go 的反射特性为例讲述反射技术的使用,其他语言的反射特性不多做介绍。
为什么需要反射?
函数在编译时不知道传入对象的具体类型,却需要读取它的字段、调用它的方法,甚至自动完成参数绑定,那么该如何实现?
那么这时候就需要使用反射来实现这个功能,通常在编程语言中有一种用来描述反射类型的类型:Type 或者 Class,不同编程语言的实现不一样。
比如说下面这个例子,我要给结构体的所有字段赋默认值,根据结构体标签的给的值而定:
go
// SetDefaultValue 根据 default 标签给结构体字段赋默认值
// type User struct {
//     Name sting `default:"Trump"`
//     Age int `default:"88"`
// }
func SetDefaultValue(obj any) error {
    v := reflect.ValueOf(obj)
    // 首先判断是否是指针 类别
    if v.Kind() != reflect.Ptr {
       return fmt.Errorf("SetDefaultValue requires a pointer to a struct")
    }
    v = v.Elem()
    // 再判断是不是指向结构体指针
    if v.Kind() != reflect.Struct {
       return fmt.Errorf("SetDefaultValue requires a pointer to a struct")
    }

    return setDefaults(v)
}

func setDefaults(v reflect.Value) error {
    t := v.Type()

    for i := 0; i < v.NumField(); i++ {
       field := v.Field(i)
       fieldType := t.Field(i)
       defaultVal := fieldType.Tag.Get("default")

       // 递归处理结构体
       if field.Kind() == reflect.Struct {
          if err := setDefaults(field); err != nil {
             return err
          }
       }

       // 没有 default 标签跳过
       if defaultVal == "" {
          continue
       }

       // 只有当字段当前零值才设置
       if !isZeroValue(field) {
          continue
       }

       // 对不同类型进行赋值
       if err := setFieldValue(field, defaultVal); err != nil {
          return fmt.Errorf("field %s: %w", fieldType.Name, err)
       }
    }
    return nil
}

// 判断是否是零值
func isZeroValue(v reflect.Value) bool {
    return reflect.DeepEqual(v.Interface(), reflect.Zero(v.Type()).Interface())
}

// 根据字段类型设置值
func setFieldValue(field reflect.Value, val string) error {
    switch field.Kind() {

    case reflect.String:
       field.SetString(val)

    case reflect.Int, reflect.Int8, reflect.Int16, reflect.Int32, reflect.Int64:
       // 特殊处理 time.Duration
       if field.Type() == reflect.TypeOf(time.Duration(0)) {
          d, err := time.ParseDuration(val)
          if err != nil {
             return err
          }
          field.SetInt(int64(d))
          return nil
       }

       i, err := strconv.ParseInt(val, 10, 64)
       if err != nil {
          return err
       }
       field.SetInt(i)

    case reflect.Uint, reflect.Uint8, reflect.Uint16, reflect.Uint32, reflect.Uint64:
       u, err := strconv.ParseUint(val, 10, 64)
       if err != nil {
          return err
       }
       field.SetUint(u)

    case reflect.Float32, reflect.Float64:
       f, err := strconv.ParseFloat(val, 64)
       if err != nil {
          return err
       }
       field.SetFloat(f)

    case reflect.Bool:
       b, err := strconv.ParseBool(val)
       if err != nil {
          return err
       }
       field.SetBool(b)

    default:
       return fmt.Errorf("unsupported type: %s", field.Kind())
    }

    return nil
}
假如不使用反射编程,那么很难实现这个功能。包括 JSON 文本和结构体类型的相互映射绑定都需要使用反射。
为什么接口和泛型不能完全替代反射?
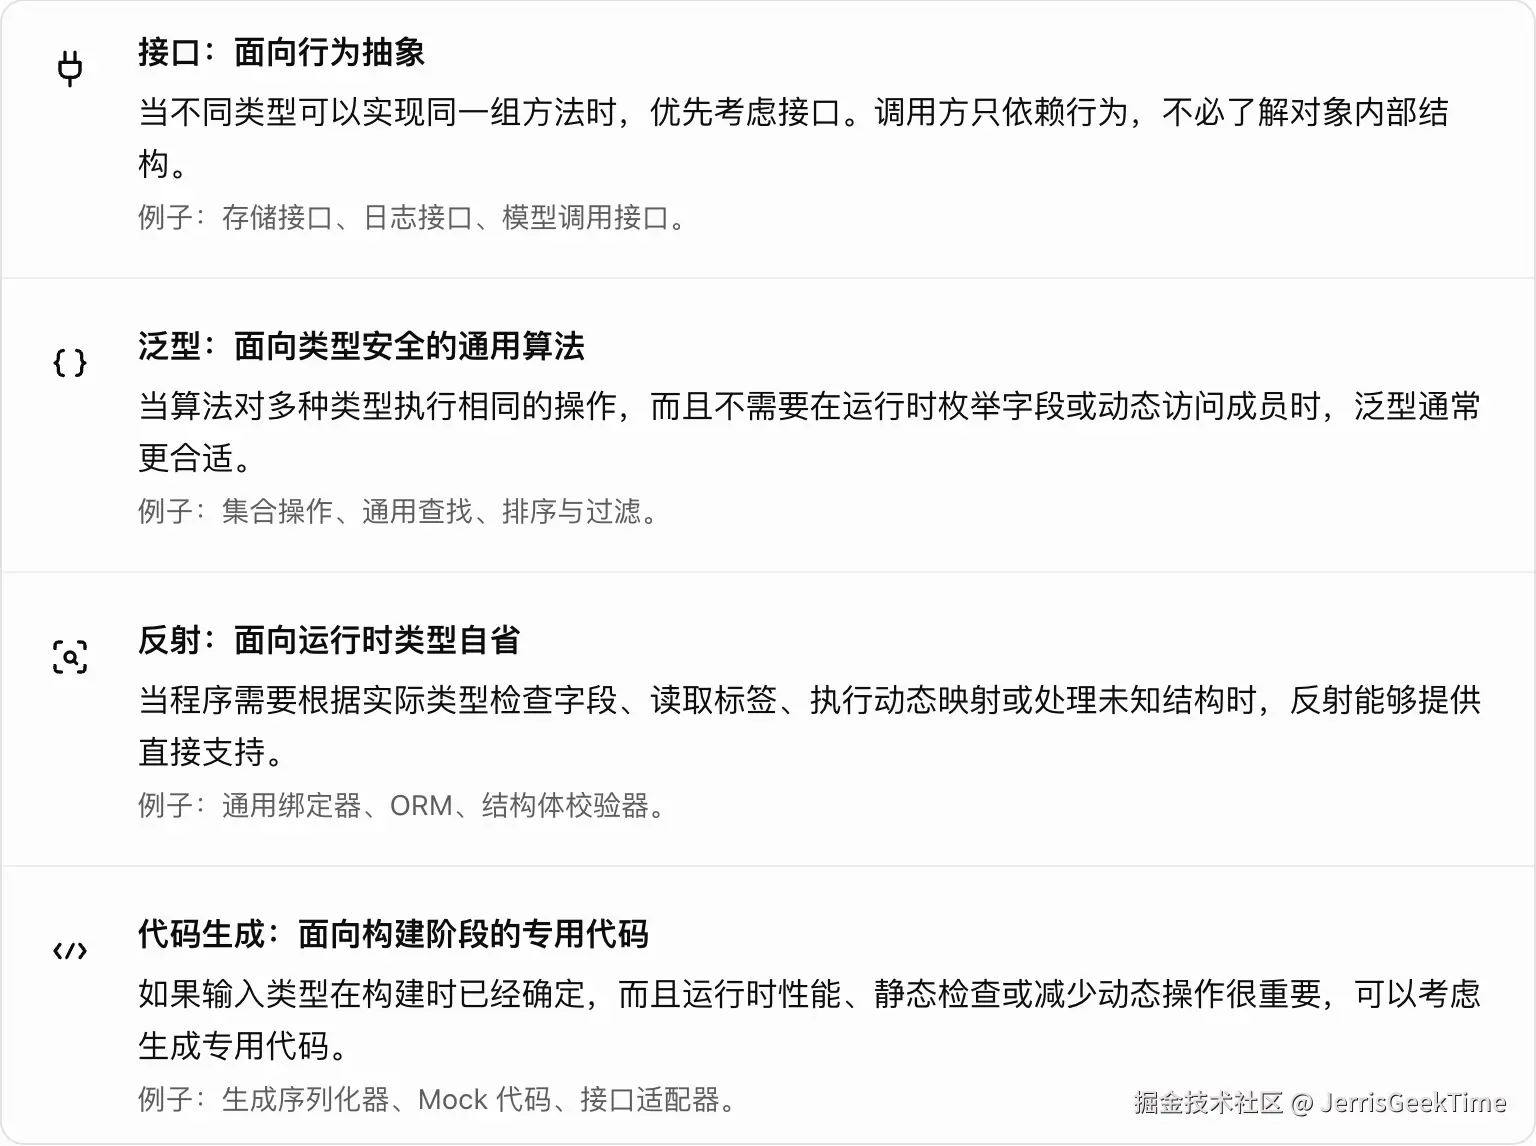
Go 已经提供了接口和泛型,那么为什么还需要反射?关键在于它们解决的是不同层面的问题。
| 技术 | 主要解决的问题 | 典型场景 |
|---|---|---|
| 接口 | 不同类型具有相同的行为 | 日志输出器、存储驱动 |
| 泛型 | 对不同类型复用算法,同时保留编译期类型约束 | 通用集合、排序、数据转换 |
| 反射 | 在运行时检查类型结构,并动态操作字段和值 | ORM、通用序列化、参数绑定 |
| 代码生成 | 在构建阶段提前生成类型专用代码 | 高性能序列化、重复代码生成 |
例如,接口可以统一调用一个类型事先实现的方法:
go
type Stringer interface {
    String() string
}
但它不能直接提供一个通用的、根据字符串 "Name" 查找任意结构体字段的能力。泛型同样如此。即使定义了:
go
func Process[T any](v T) {
    // ...
}
这里的 T 也不意味着可以直接使用 v.Name,因为 any 并没有声明 Name 字段。反射提供了另一条路径:运行时获取类型描述,再根据实际类型查找字段。
有了反射,程序就可以在运行时完成以下操作:
- 获取一个值的实际类型。
- 判断它是结构体、指针、切片还是 Map。
- 枚举结构体中的字段及其类型。
- 根据字段名称读取或修改字段值。
- 根据类型信息动态执行符合条件的调用。
反射究竟在运行时做了什么?
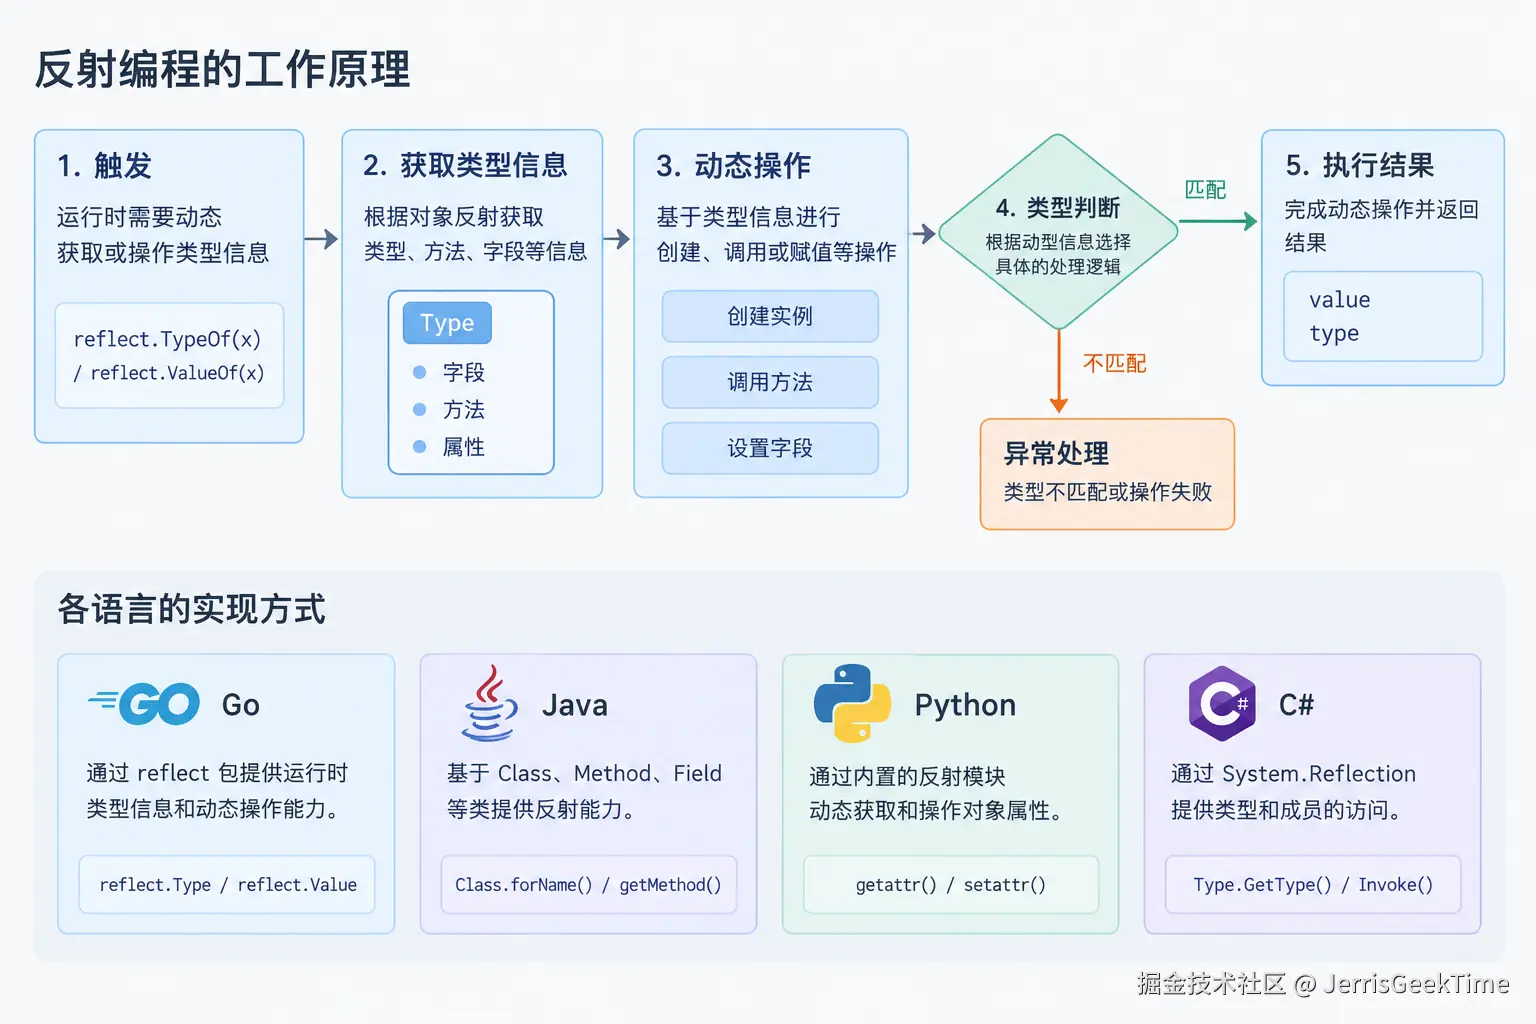
反射的核心:类型信息与值信息
Go 的反射 API 最重要的两个抽象是:
reflect.Type:描述一个值是什么类型,以及这个类型具有什么结构。reflect.Value:表示一个具体的值,并提供检查和操作该值的能力。
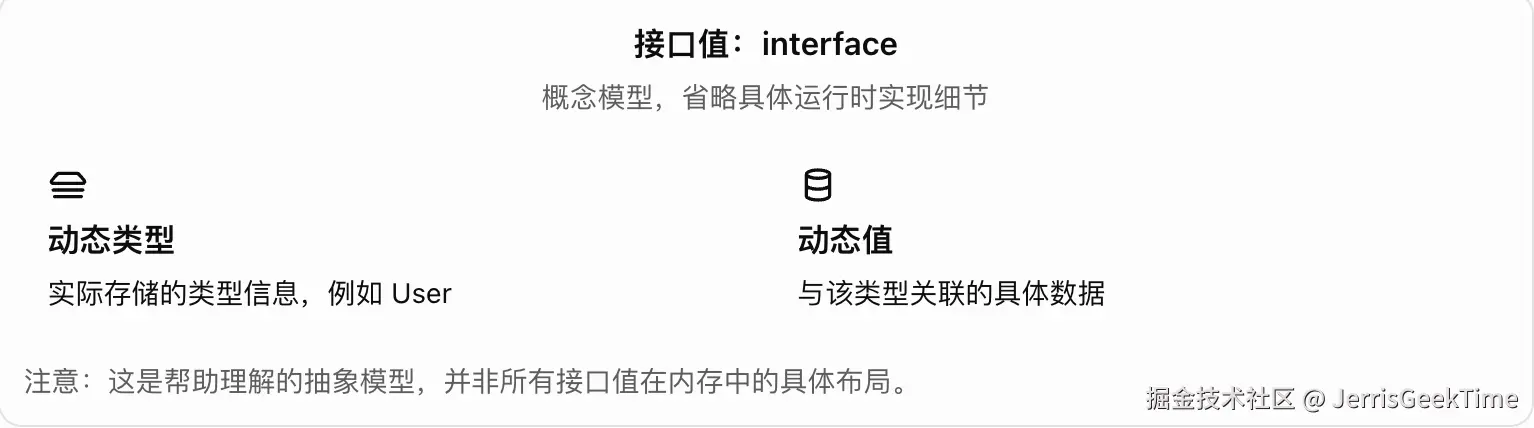
Go 接口与反射之间的关系
从概念上看,一个非空接口值可以理解为包含两部分信息:
反射如何支撑自动化框架?
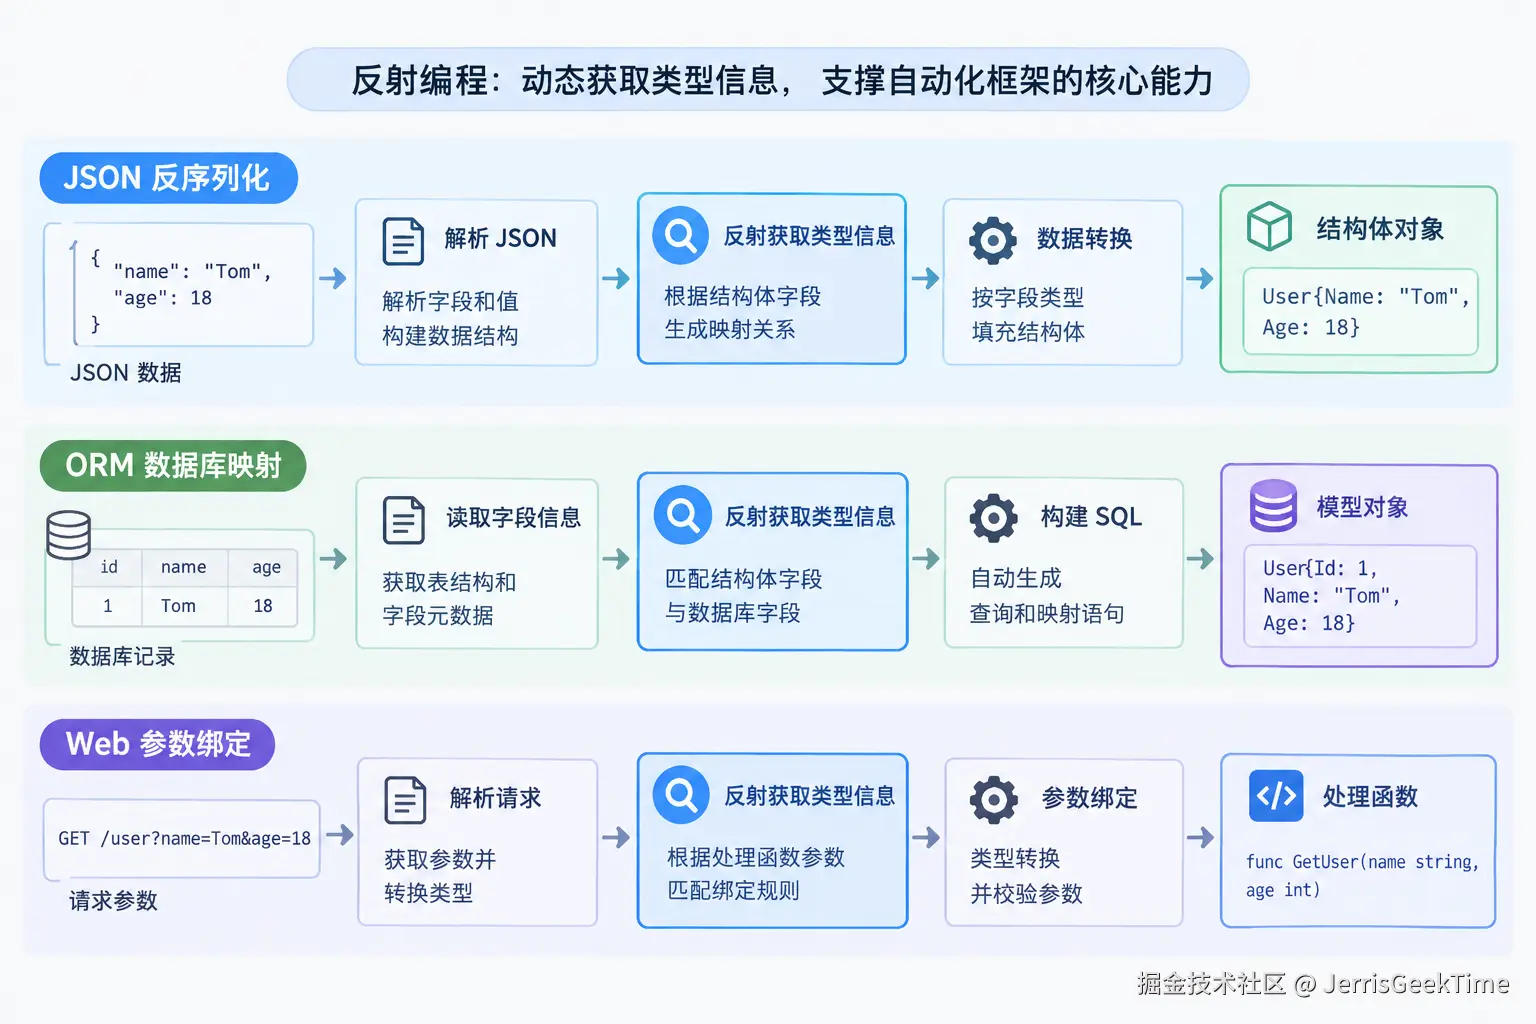
在 JSON 反序列化、ORM 数据库映射、Web 请求参数绑定这些底层就是反射在起作用。
反射为什么有时会更慢?
有时候滥用反射可能会让程序变得很慢。
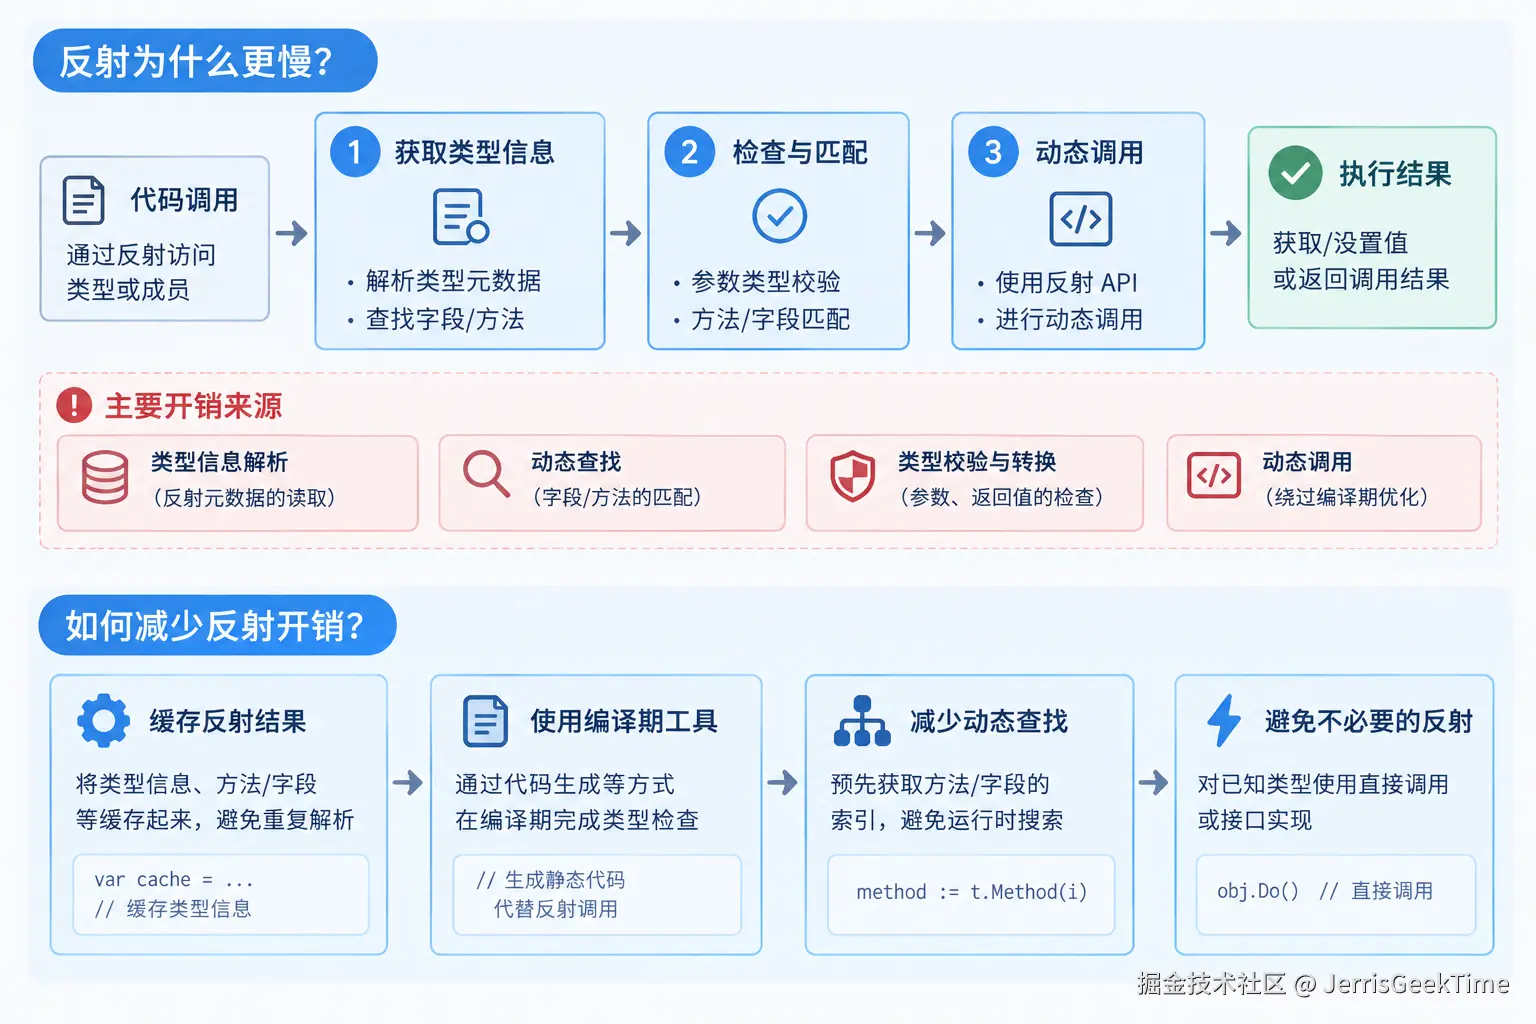
反射的开销可能来自哪里
主要有以下几类:
- 运行时类型检查: 需要检查值的类型、类别和可访问性。
- 动态字段查找: 如果每次都按字段名称查找,就会重复进行元数据查询。
- 动态操作: 反射调用通常比直接、静态确定的操作更间接。
- 内存分配: 某些使用方式会引入额外分配,但并非每次反射都会分配内存。
- 类型转换与错误检查: 通用代码通常需要处理更多类型分支和异常情况。
尤其是在序列化、ORM 或请求绑定等高频路径中,重复查找字段元数据可能产生不必要的成本。
如何减少反射开销?
一个常见的优化方法是缓存类型元数据。
例如,首次处理 User 类型时,遍历所有字段并记录:
- 字段名称。
- 字段索引。
- 字段类型。
- 标签信息。
- 必要的访问与转换规则。
之后再次处理同类型对象时,直接使用已经构建好的元数据,而不是重新扫描所有字段。
缓存可以减少重复的元数据解析,但它不会让所有反射操作自动变成零成本。字段值读取、动态转换等操作仍然可能存在开销。
如果使用并发访问,还需要考虑缓存的同步、内存占用和生命周期管理。
设计取舍:反射、泛型、接口和代码生成如何选择?
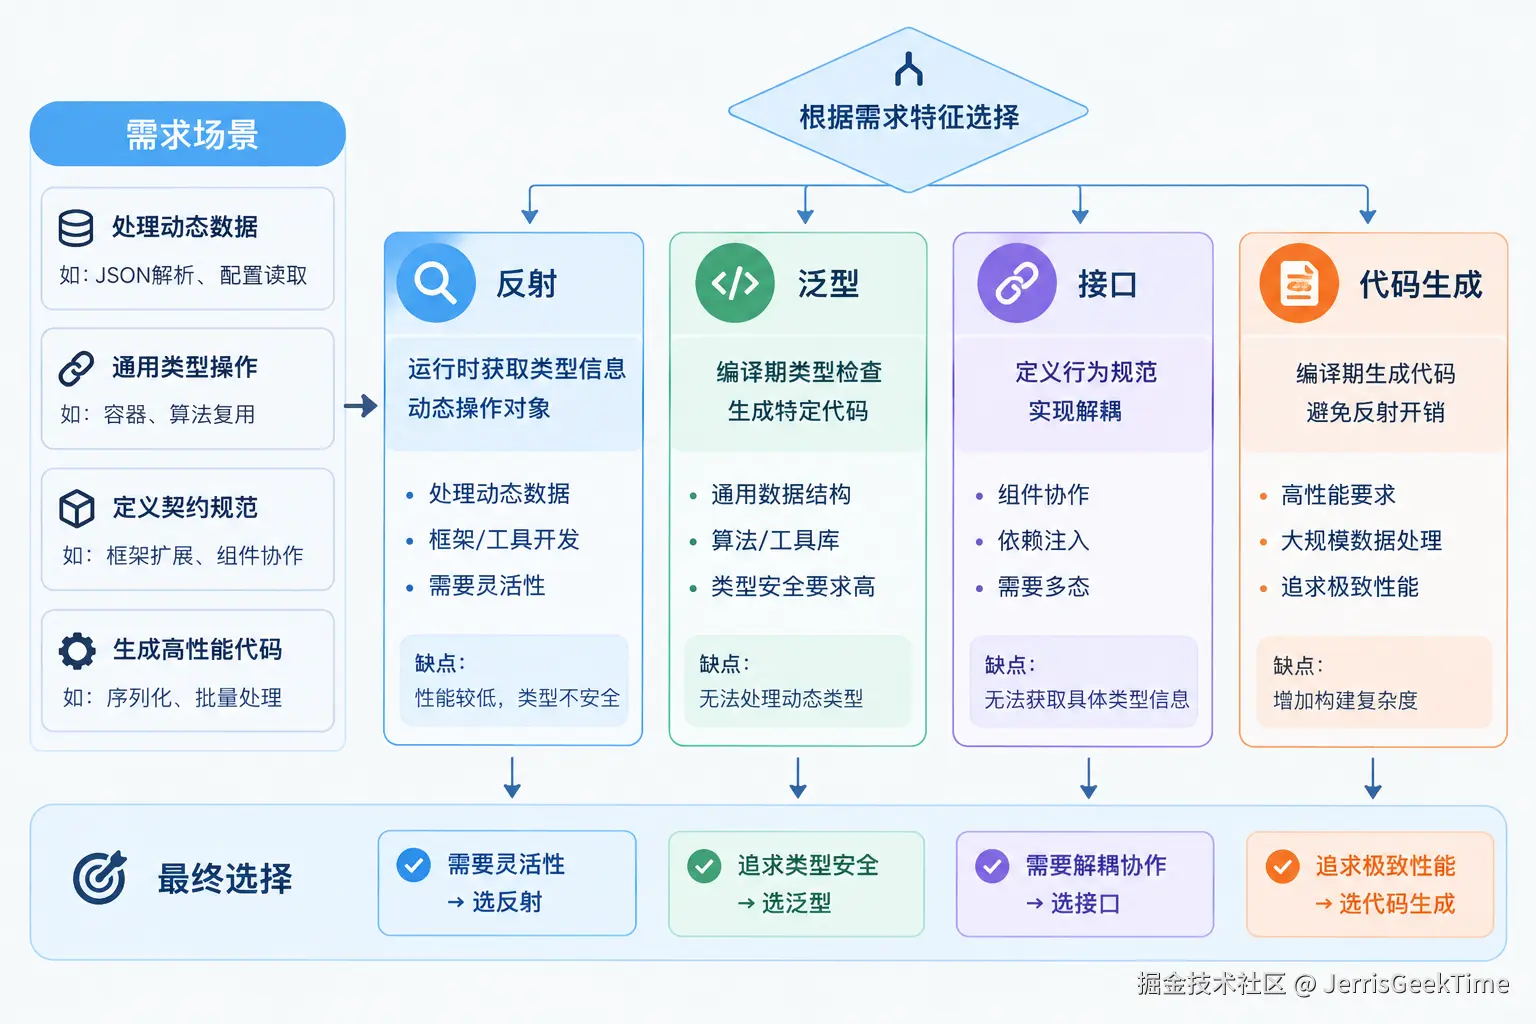
反射不是通用编程的唯一方案,也不是越少越好或越多越好。关键在于:程序究竟需要在运行时动态理解类型,还是只需要在编译期复用一段算法?