9月23日上午,2026云栖大会多模态数据处理与模型训推论坛举行。阿里云与卓驭科技、中国电信人工智能公司、乐享元游、微财等企业嘉宾,围绕多模态数据底座、模型训练与推理、智能体应用和数据工程自主交付展开交流。面对Agent与Physical AI带来的新需求,论坛呈现出一条贯穿数据、算力与应用的技术主线:让业务反馈进入数据生产,让高质量数据驱动模型优化,再将模型能力交付到真实业务中,形成持续迭代的闭环。
阿里云智能集团计算平台事业部解决方案负责人魏博文在《算力之源、数据之脉:从模型训推到多模数据处理的全栈解决方案》演讲中,系统介绍了从数据采集、统一存储、处理与标注,到训练、推理及复杂强化学习链路的端到端方案。其核心并非孤立提升某一环节的性能,而是以统一数据底座和计算资源协同,打通"数据闭环"与"模型闭环",支撑企业在各自场景中构建更适合业务的模型与Agent。
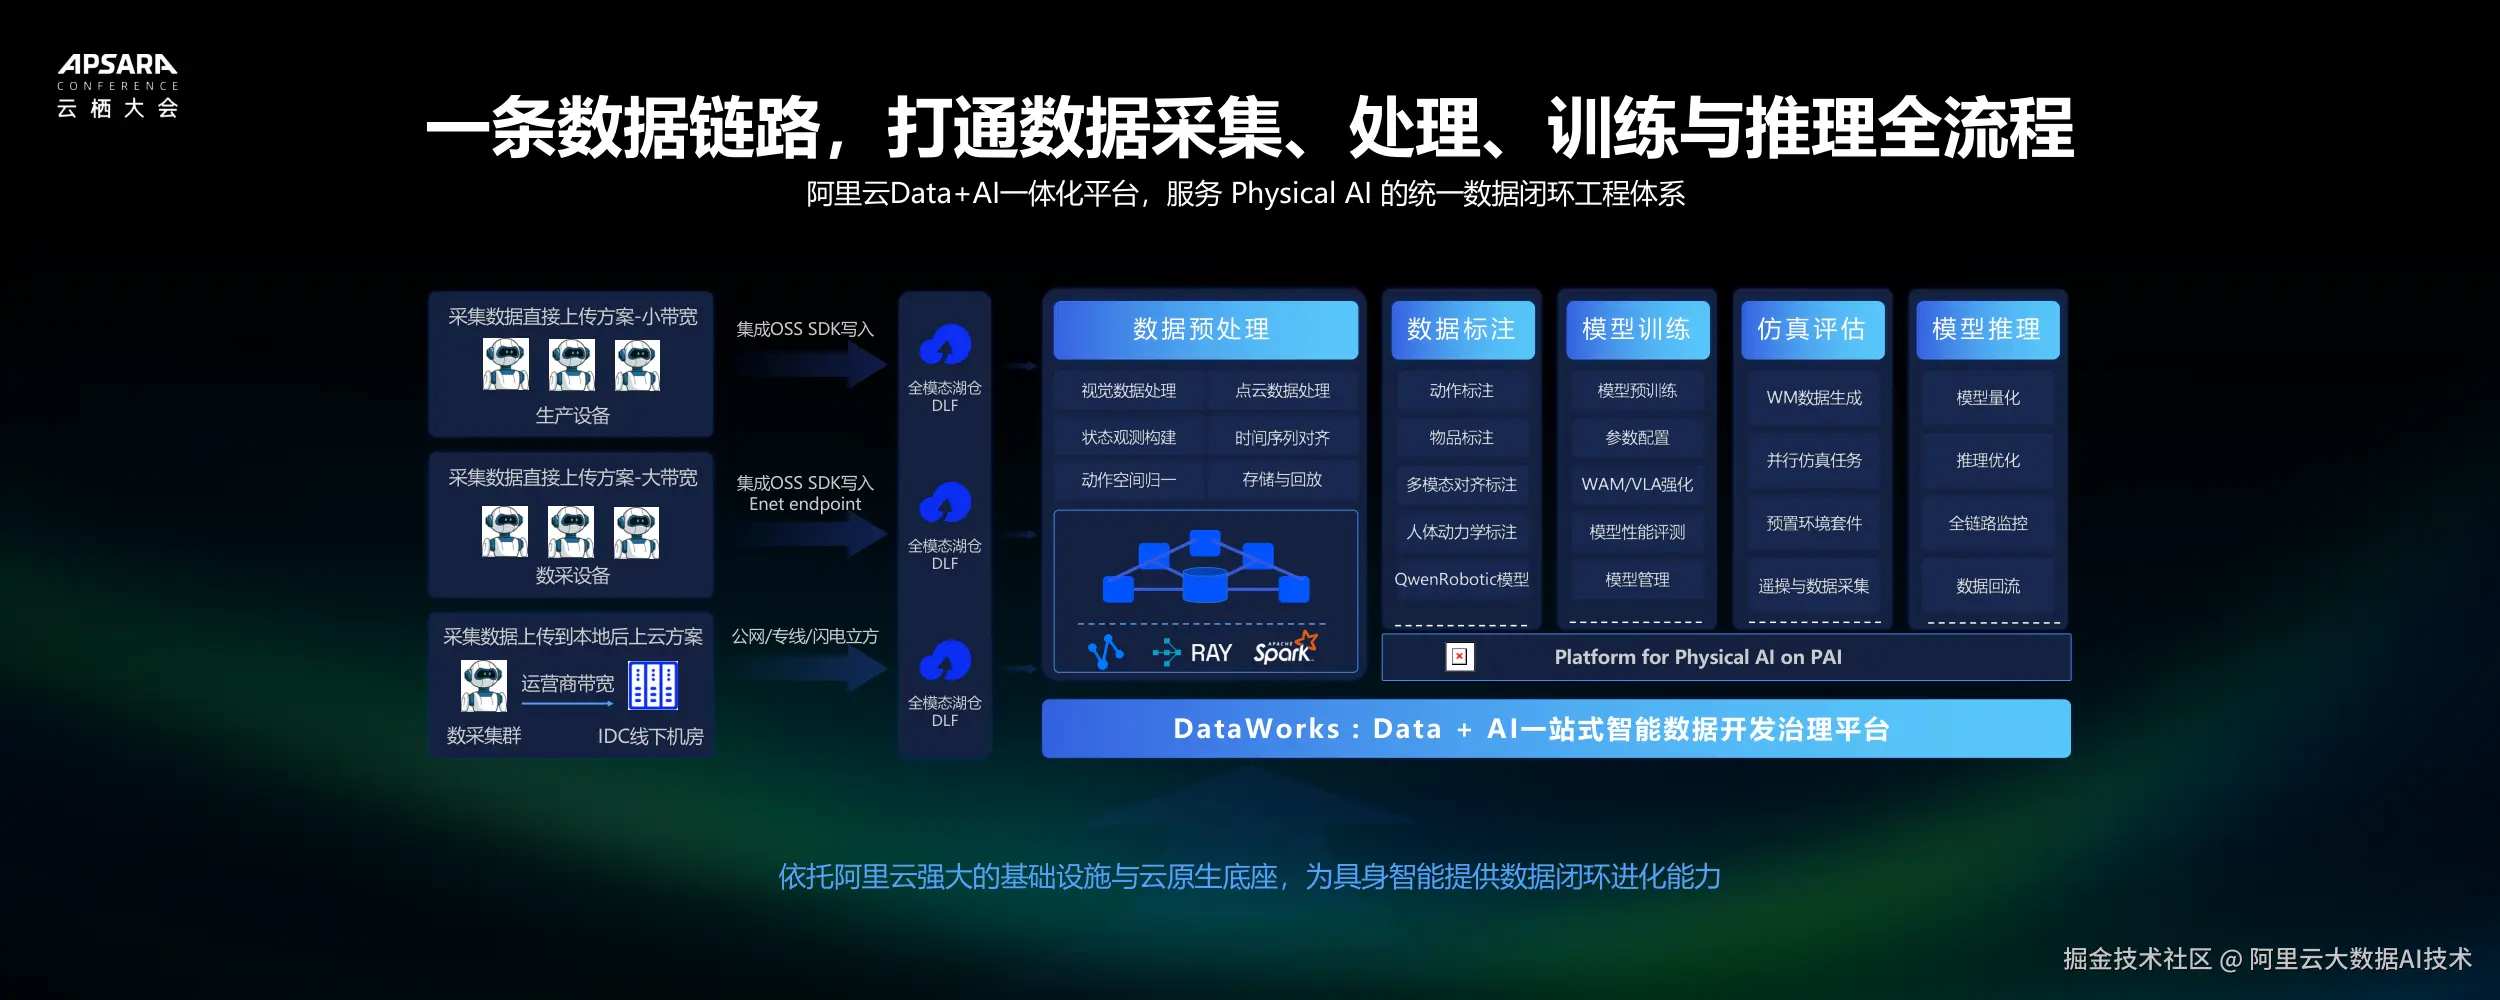 端到端数据与模型生产链路
双闭环协同:让业务反馈成为模型持续进化的起点
Agent如何产生真正服务业务的高质量Token?魏博文将答案指向应用背后的完整生产链路。随着大模型进入领域定制与后训练阶段,企业需要解决的问题不再只是"能否训练一个模型",而是如何持续获得高质量样本、组织复杂多模态数据,并把训练结果转化为可用的业务能力。
他将这一阶段的挑战归纳为四个方面:高质量数据生产成本上升,视频、点云和物理反馈等模态增加,模型架构持续演进,以及后训练工程链路更加复杂。尤其在Physical AI场景中,部分数据需要通过具身本体与物理环境交互采集;强化学习也不仅涉及训练与推理之间的协同,还可能连接外部工具、仿真环境及端侧机器人,形成更长的反馈链路。
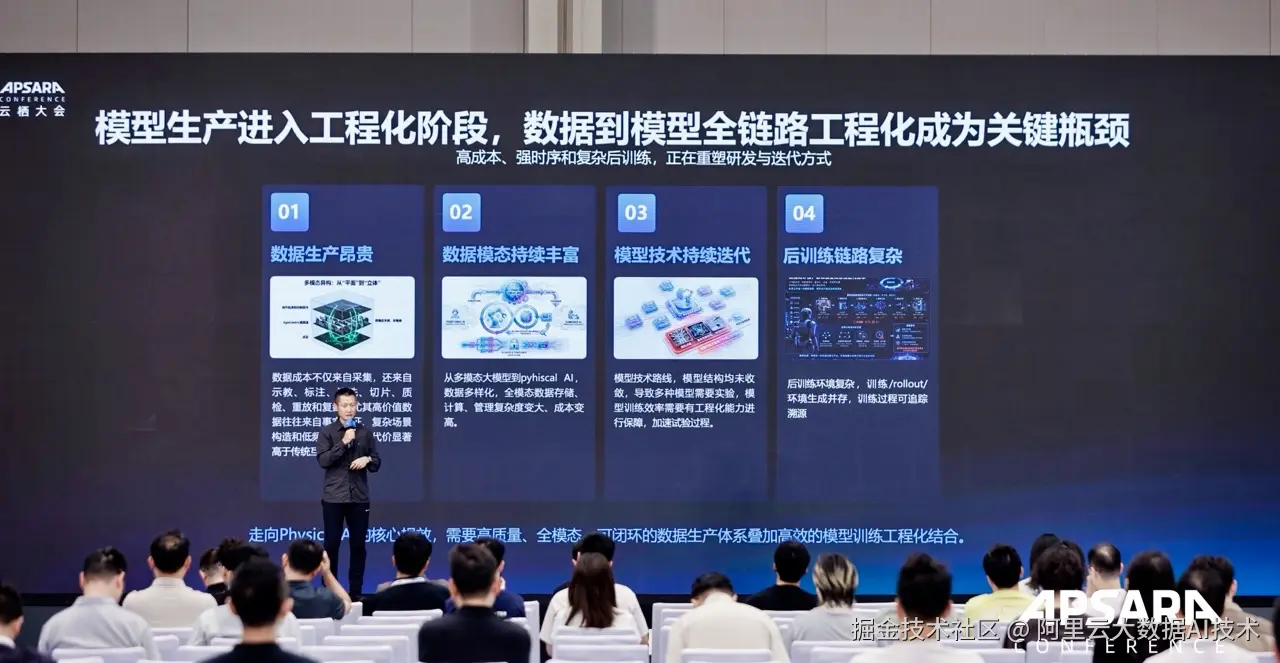
模型生产进入工程化阶段,企业需要的是数据到模型全链路工程化能力
"这条链路本质上包含两个闭环:数据闭环与模型闭环。"魏博文表示。两者需要依托统一的数据底座,明确数据经过哪些处理、进入哪些训练任务,让数据血缘贯穿模型生产过程。
在数据闭环中,业务反馈首先用于发现Bad Case。经过精细标注,团队需要分析这些问题在现有样本中的分布,再从海量样本库中抽取相应数据进行补充,而不是把少量问题样本直接投入训练。数据接入、预处理、标注、抽取与样本形成,由此成为有质量控制、有分布分析的生产流程,为后续模型优化提供依据。
模型闭环则承接这些高质量样本,连接对齐、强化学习、迭代与部署,并将应用端反馈重新带回数据链路。在涉及物理世界交互的场景中,世界模型与仿真环境也可以参与这一过程,帮助发现和构造Corner Case。数据与模型因此不再是两条相互割裂的流水线,而是共同支撑业务持续迭代的飞轮。
围绕这一目标,阿里云提供能够承接文本、图像、视频、点云及物理反馈等数据的统一底座,通过多种格式、文件及SDK接口适配不同业务,并结合权限、血缘与索引能力,支撑数据治理和高效访问。在数据生产侧,标准化Pipeline连接预处理、标注和质量校验;魏博文现场展示的Demo进一步通过自然语言定义需求,由Agent构建ETL流程并调用底层引擎执行预处理,展示了复杂数据工程向智能化编排演进的方式。
在模型生产侧,方案以稳定的训练平台、高效计算框架和可供Agent调用的标准Skill,降低训练调优门槛。针对强化学习,平台提供自定义与全托管链路,并通过样本异步、流水线异步等机制优化训练与推理资源协同。统一管理数据预处理与模型训练的计算资源,让数据和算力围绕同一条业务闭环发挥作用,是全栈方案的重要价值。
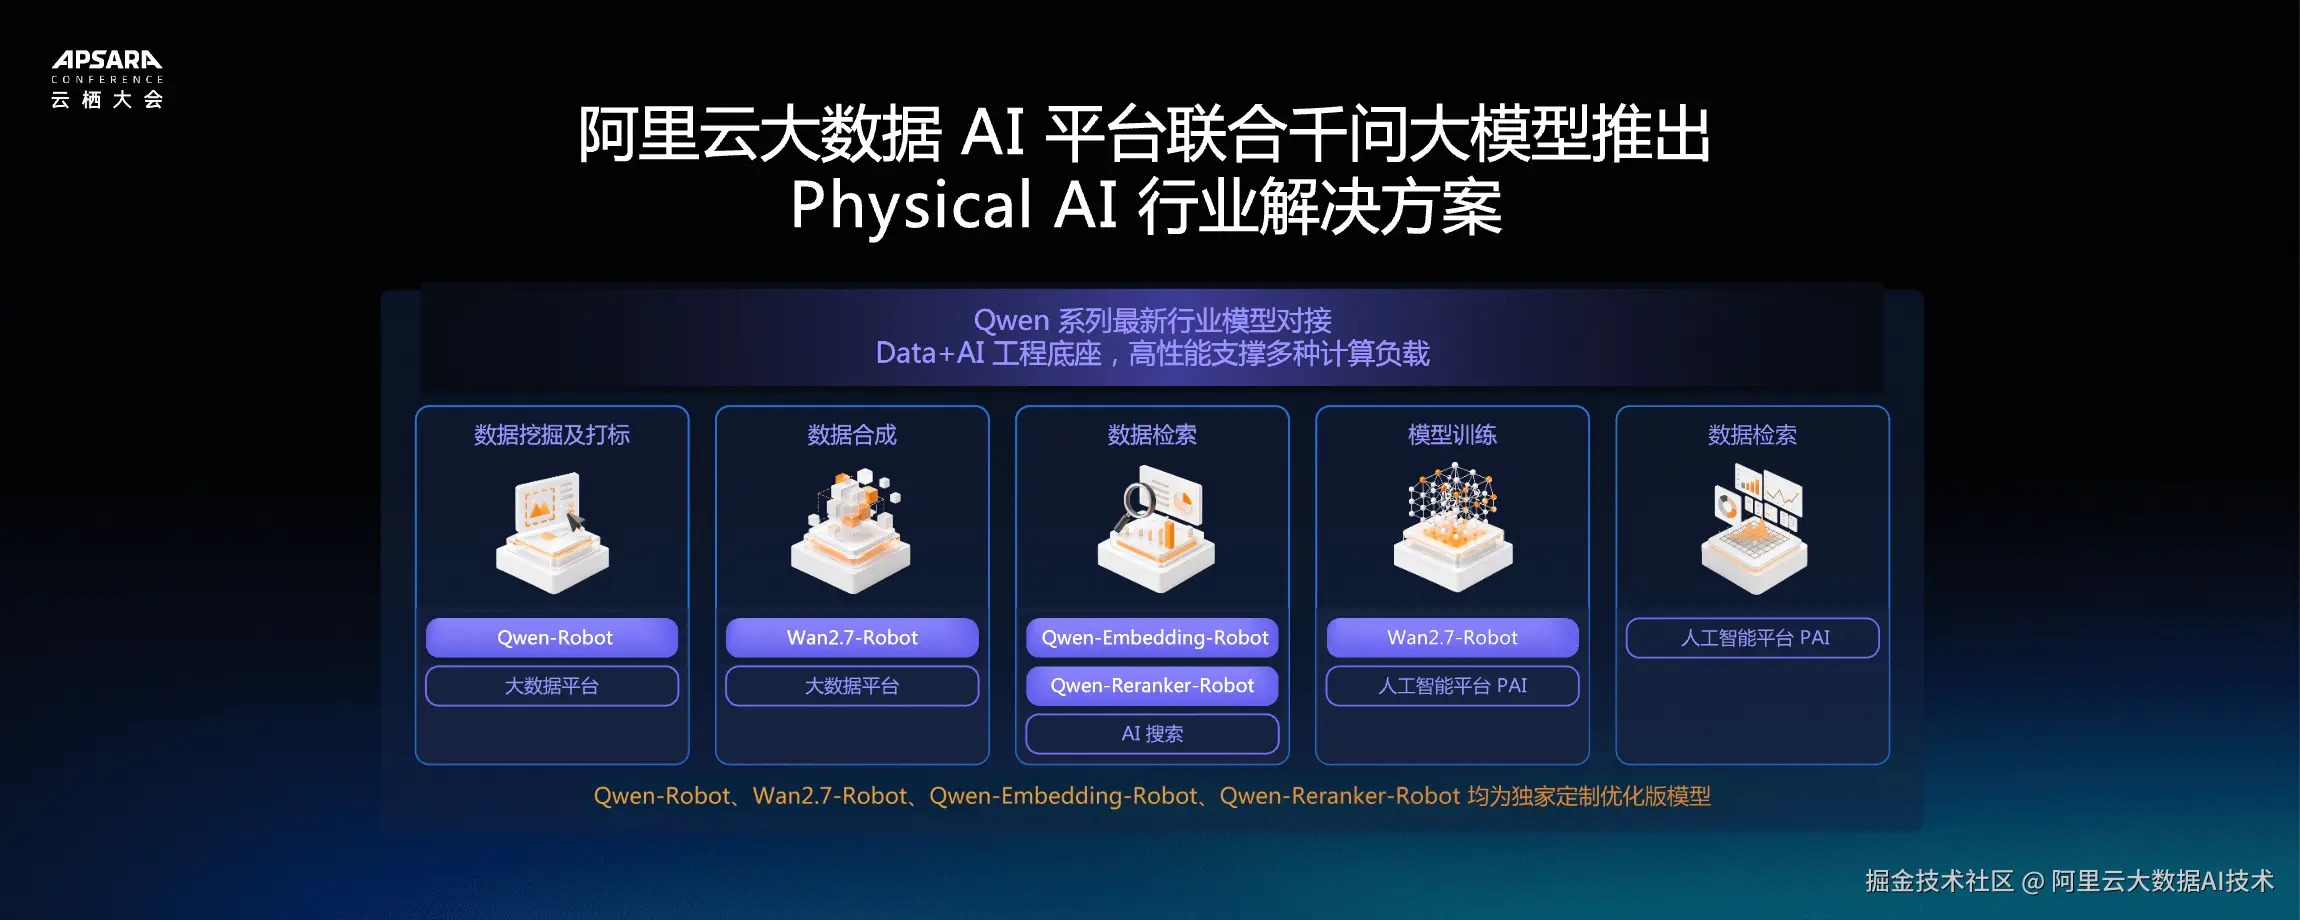
Physical AI行业解决方案
魏博文介绍,这套思路已应用于智驾和具身智能等场景:前者贯通车联网与自动驾驶数据链路,后者连接采集、预处理、标注和训练。通过统一数据管理和计算资源池化,方案帮助减少重复建设与数据冗余,并优化模型迭代效率。
从"万物皆表"到Agentic Lake:让多模态资产可理解、可使用
双闭环能否高效运行,首先取决于底层数据是否能够被统一组织和持续复用。卓驭科技基础架构总监王鹏围绕移动物理AI基础设施的挑战与实践,介绍了基于阿里云大数据产品体系构建的多模态湖仓ZLake。面对视觉、文本、语音、动作等模态的联合训练需求,卓驭以"万物皆表"的理念,将不同数据统一为可寻址、可检索、可治理的资产,支撑移动基模训练评测、智驾数据闭环和企业经营分析。
这一体系进一步形成"一湖两域":来自物理世界的基模与智驾数据,以及数字世界的企业运营数据,共用存储、表结构、检索与计算能力。王鹏强调,共用存储之外,更关键的是共用业务语义。通过Ontology表达领域对象、关系与规则,异常事件能够关联售后和生产信息,路测人员的优质行为也能够转化为模型训练数据,为跨域分析和双向反馈建立基础。
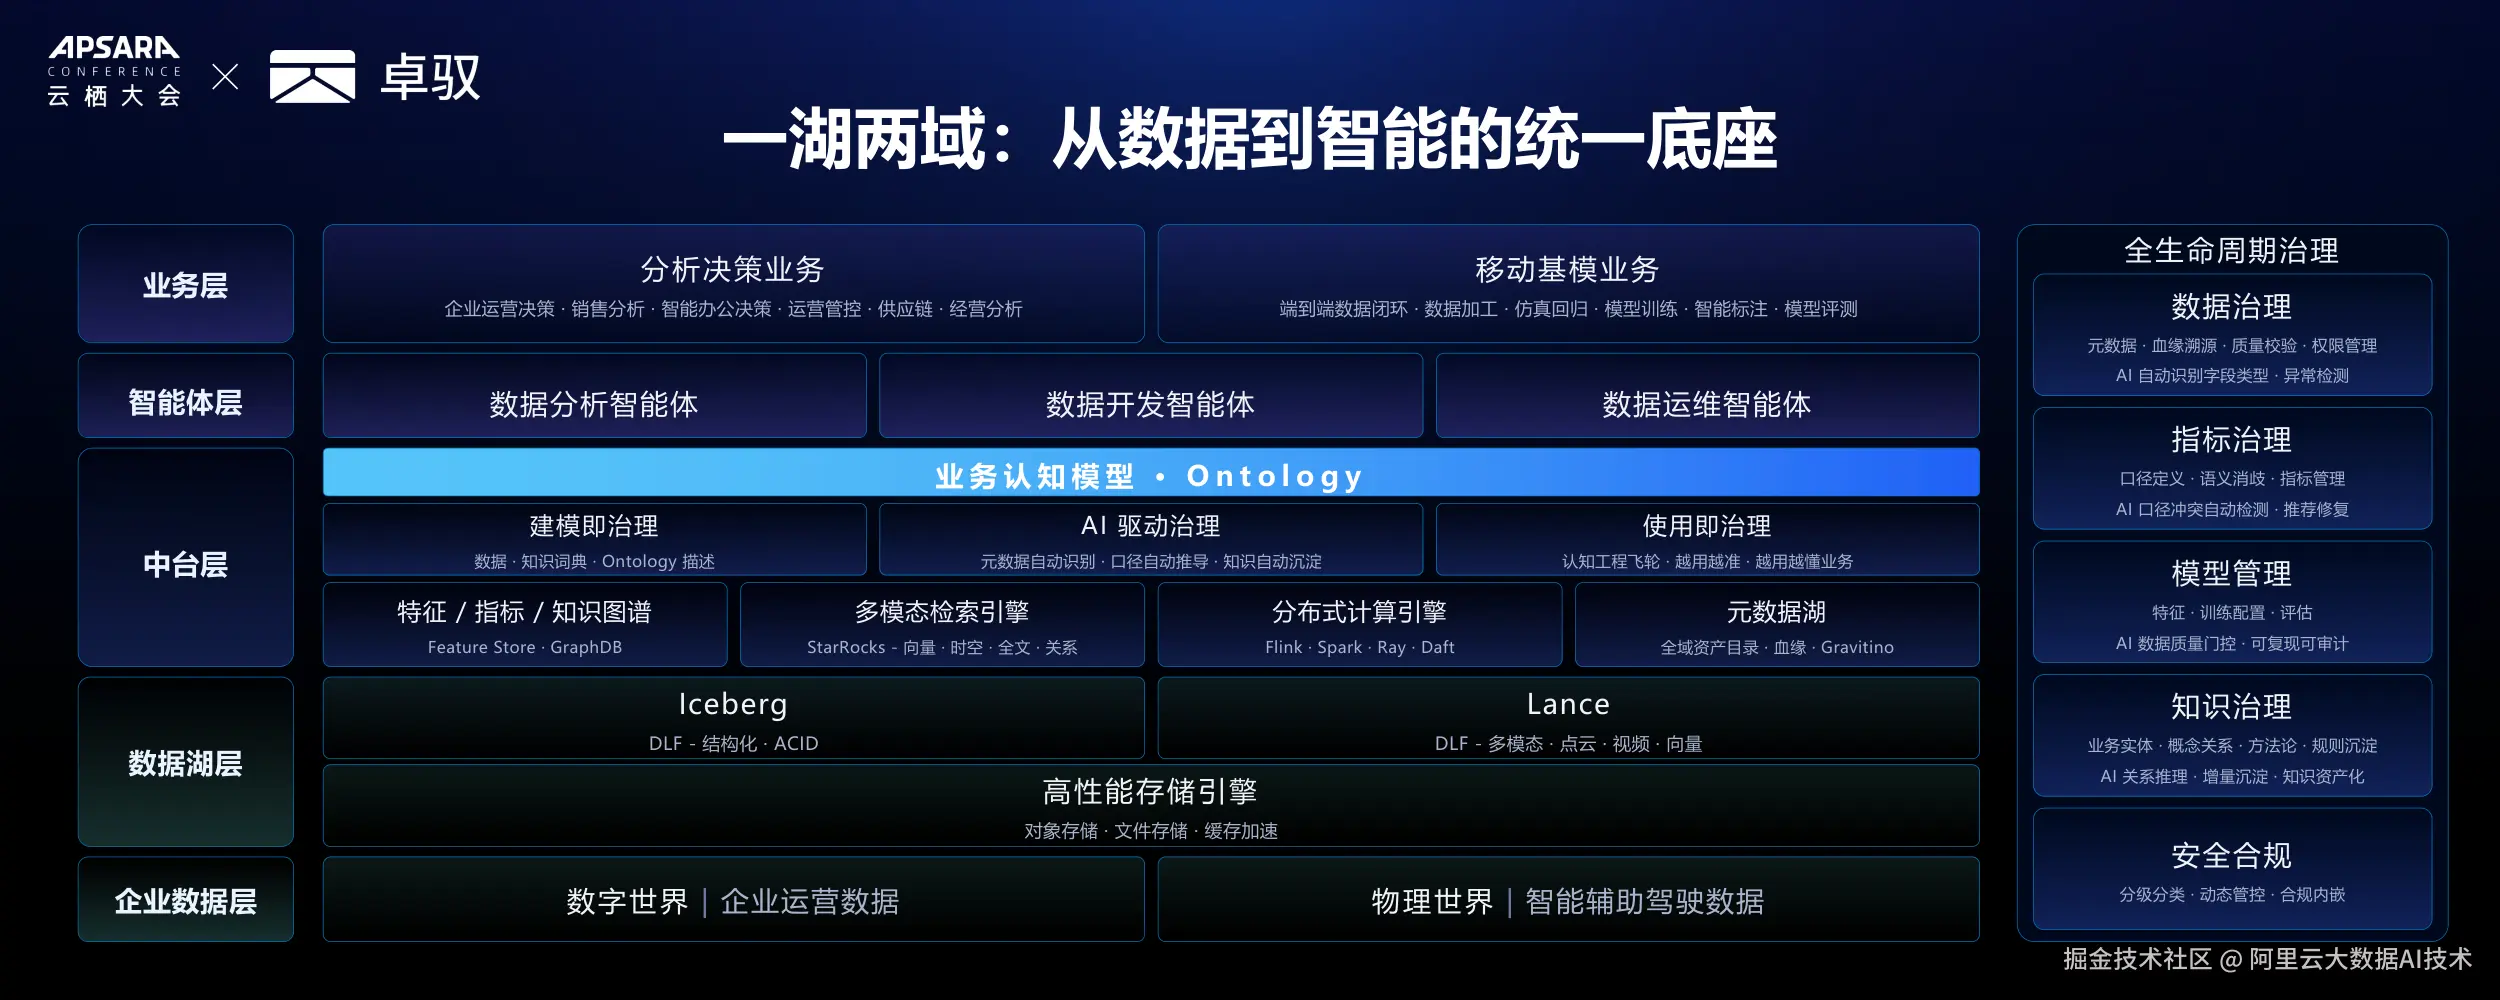
物理与数字两域共享数据及业务语义
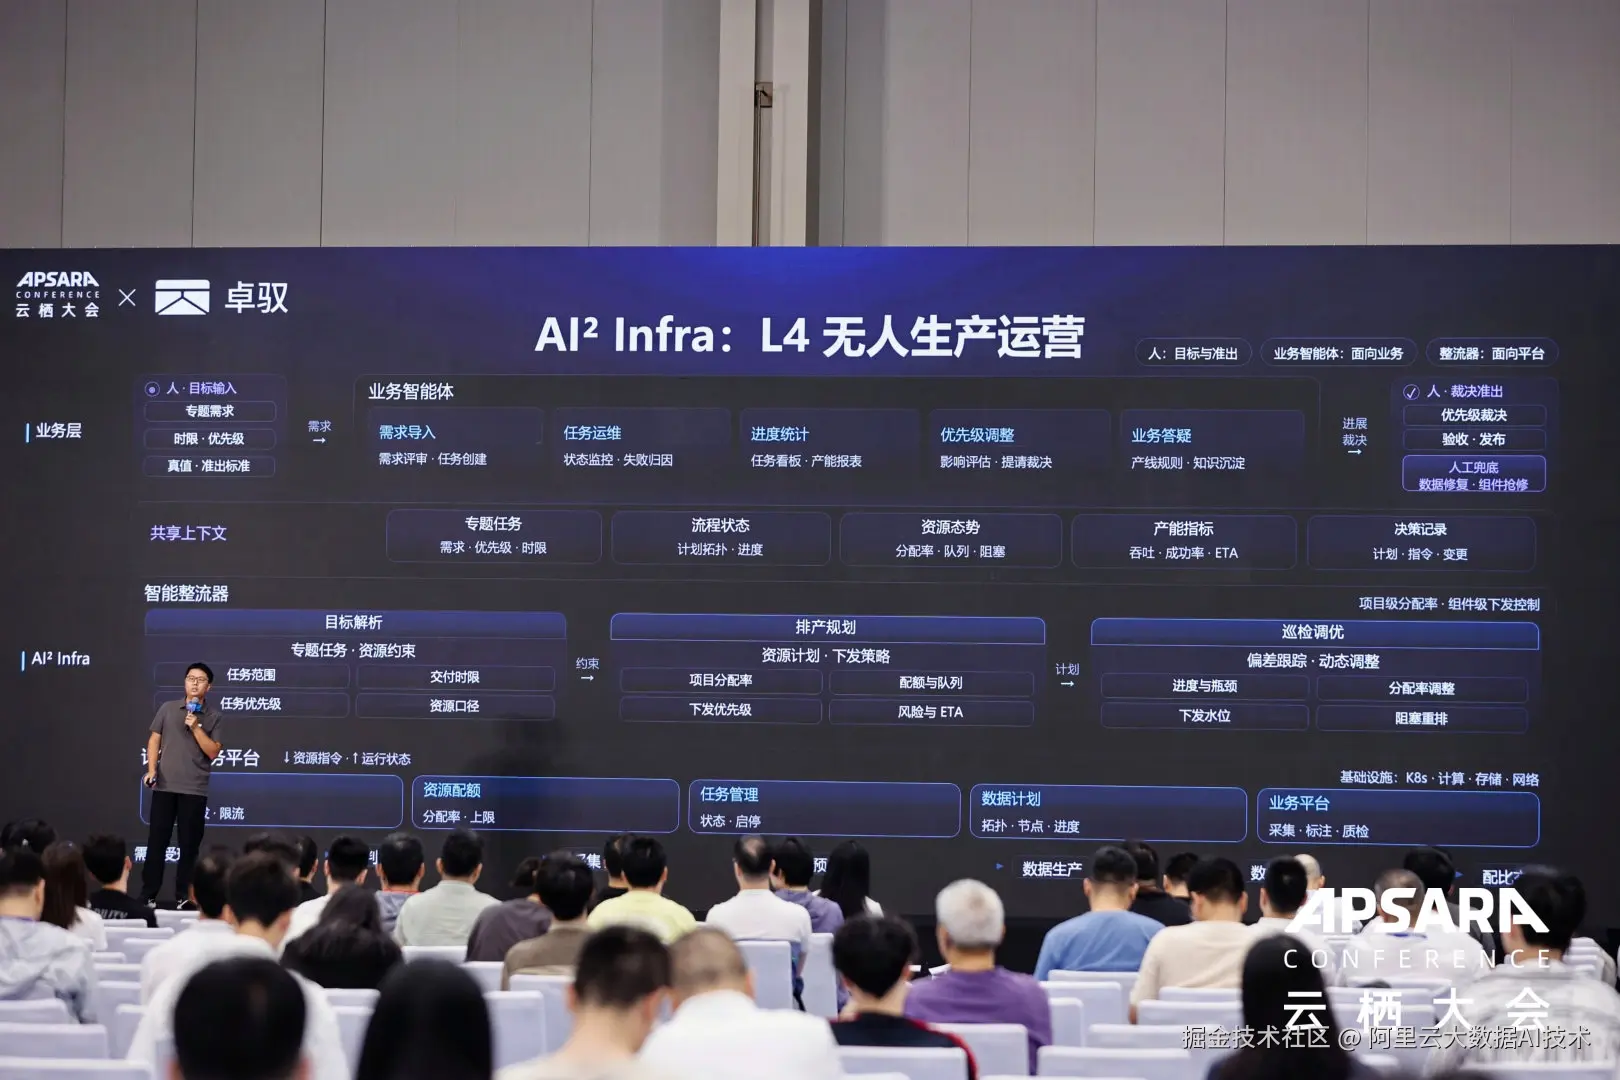
王鹏还介绍了AI-Squared Infra,即"AI for AI infra"的探索:基础设施能力由供人使用的平台进一步转化为智能体可调用的工具,让Agent参与数据生产运营和模型实验迭代;人在其中保留目标设定、发布与准出等关键职责。
围绕湖仓向Agentic Lake演进,阿里云智能集团DLF产品负责人李鲁兵在《Agentic Lake:全模态AI数据湖底座》演讲中分享了面向全模态AI数据处理的技术思路:**让BI与AI使用同一份数据资产,并把数据访问、任务编排与统一治理结合起来。**实时摄取、离线加工、检索分析和模型训练,可以按任务特点使用不同引擎,而不必为每类应用重复建设数据链路。
在这一体系中,DLF Omni Catalog连接多种开放湖表生态,Blob、Variant和向量字段用于组织图片、视频、标签及向量信息;湖上索引与混合检索帮助发现数据,DLF Cache和数据集预热改善热点访问,Union Read统一实时与历史数据读取。结合版本管理及文件级血缘,湖仓不仅承担存储职责,也为Agent和模型提供可追踪、可复用的数据基础。
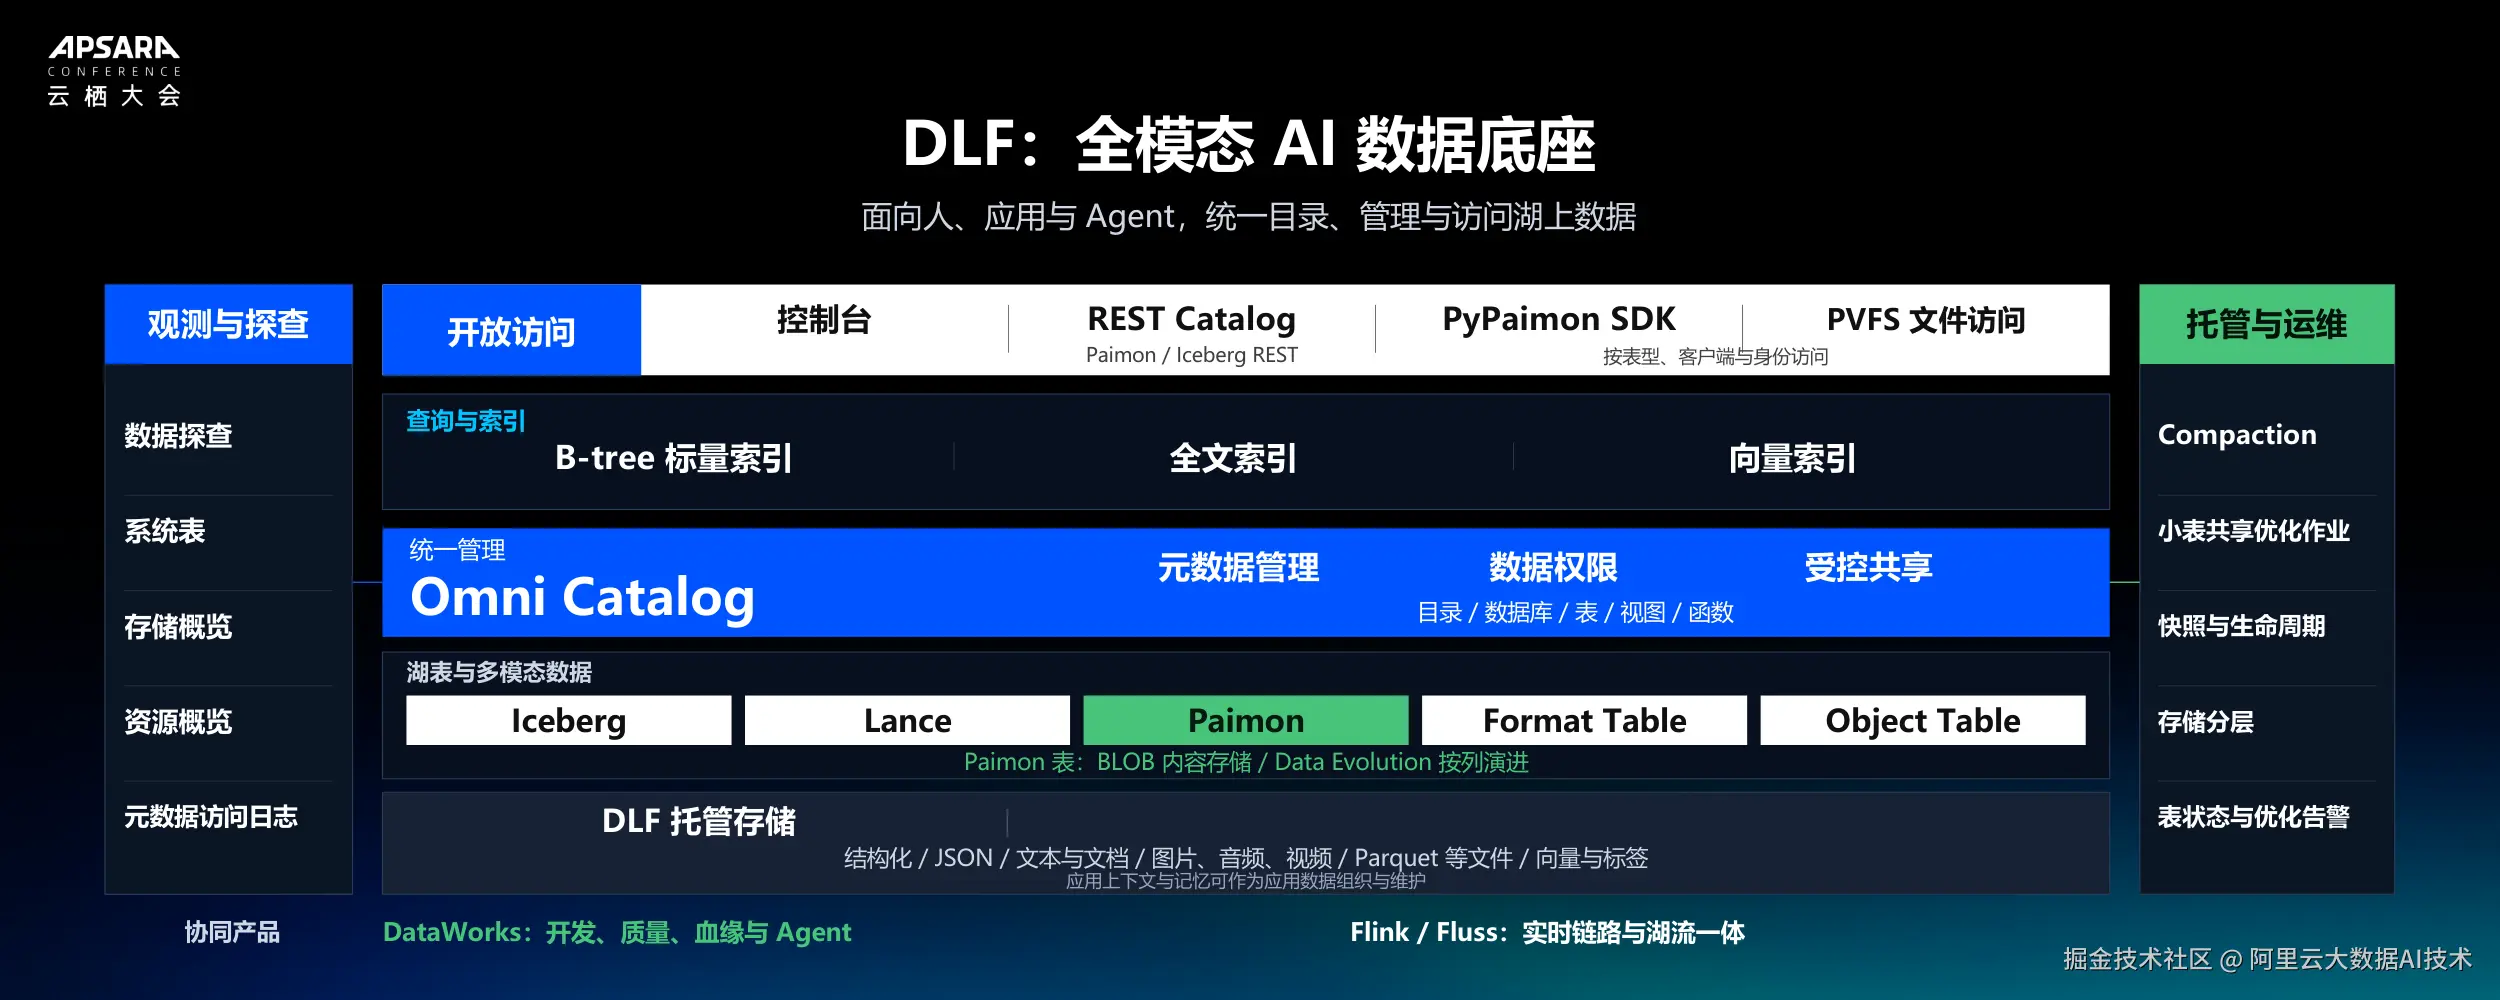
DLF全模态AI数据底座架构示意
从算力效率到Token经济学:训练、推理与应用共同优化
高质量数据进入模型闭环后,如何以合适的成本和服务体验交付能力?阿里云人工智能平台PAI产品负责人黄博远在《面向大规模生产级Agent的企业级训推平台》演讲中,将这一问题归纳为"Token经济学"。Agent任务更长、工具调用更多,企业需要关注的不仅是请求吞吐,还包括会话状态、缓存命中和不同业务对服务目标的差异。KV Cache命中有助于减少重复计算、降低推理成本,因此成为平台优化的重要环节。
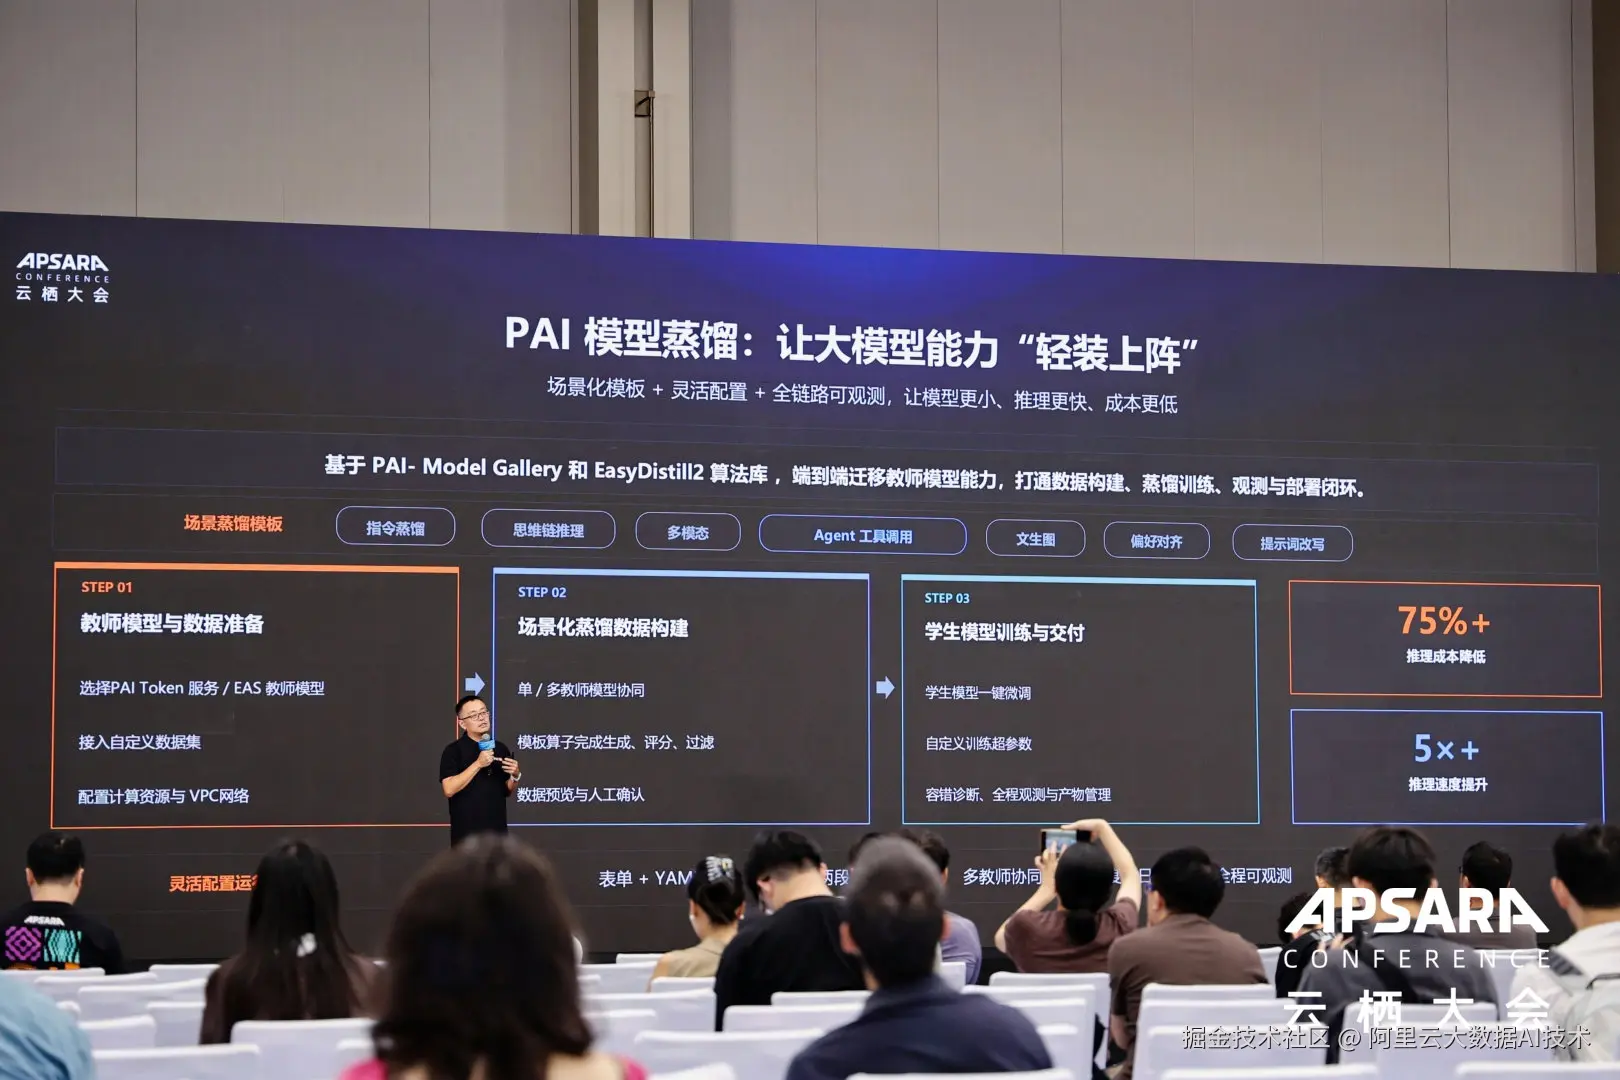
围绕芯片、模型、推理引擎与服务平台的协同,黄博远介绍了PAI在硬件适配、DLC 3.0训练服务、TurboX训练加速、故障诊断和模型蒸馏方面的能力。Model Gallery与EasyDistill2帮助企业利用自身数据构建更适合特定任务的模型,而不是让所有场景都使用同一种高成本模型。按会上披露的规划,处于预发布阶段的PAI-RLS将面向复杂强化学习链路,帮助连接Agent运行轨迹与后训练过程。
面向推理服务,PAI-InferX围绕智能路由、流量调度、KV Cache、引擎优化、模型预热和企业Token管理进行整合,并提供多地域统一调度能力。从"模型能运行"走向"业务能持续使用",需要将模型选择、推理效率、服务目标和企业治理纳入同一套优化体系。
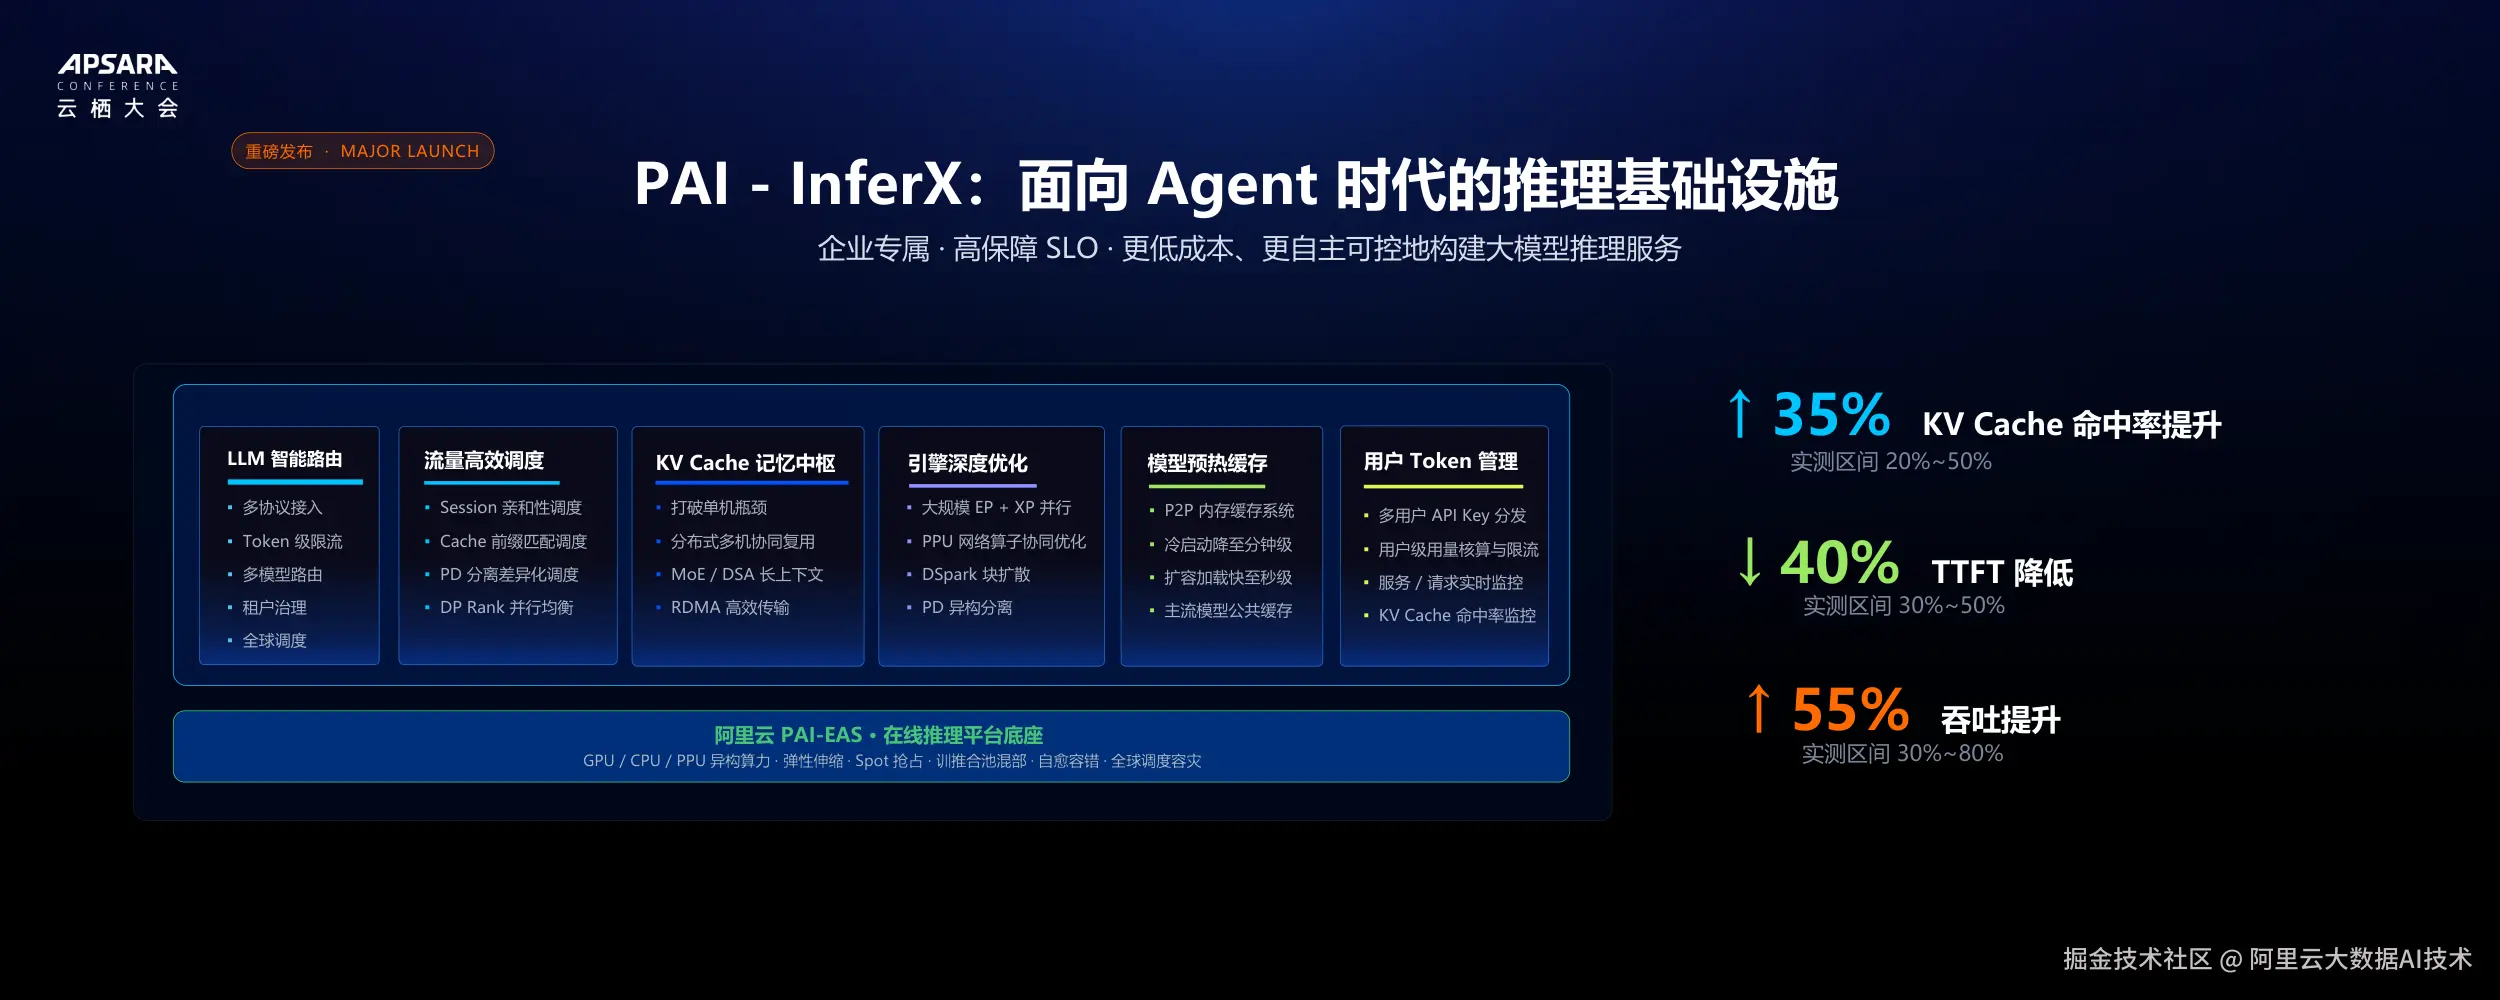
PAI-InferX的路由、缓存与企业治理能力
中电信人工智能产品总监娄双双围绕智能体应用新范式与TeleAgent,展示了这一变化在应用侧的体现。与回答问题的Chatbot不同,Agent需要理解目标、调用工具并完成端到端任务,对长上下文、多步决策以及训练推理协同提出更高要求。
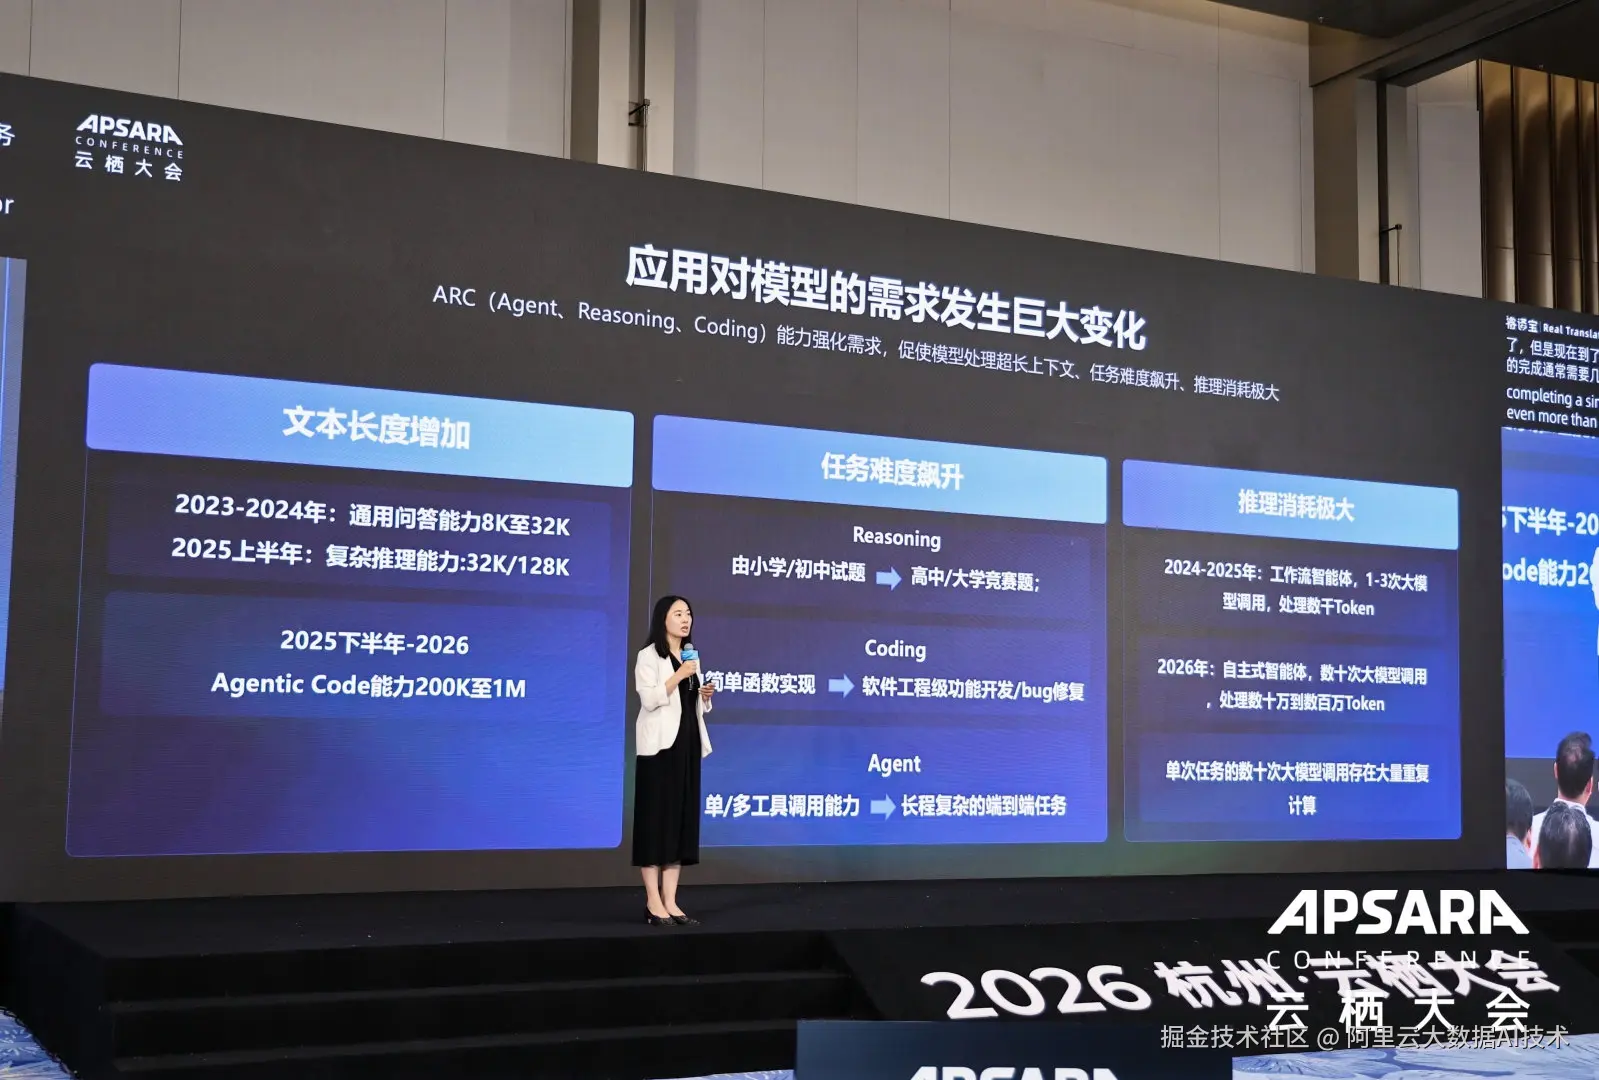
中国电信围绕星辰大模型、Agentic强化学习和分布式推理等技术,支撑TeleAgent在公文、PPT、表格、信息整合及办公自动化中的应用,并通过Skill、记忆、主动任务和IM入口连接员工工作流。娄双双介绍,企业内部已有两万多名员工贡献五万多个技能。将真实业务经验沉淀为可复用能力,同时配合企业安全防护,成为智能体从个人工具走向组织级应用的重要路径。
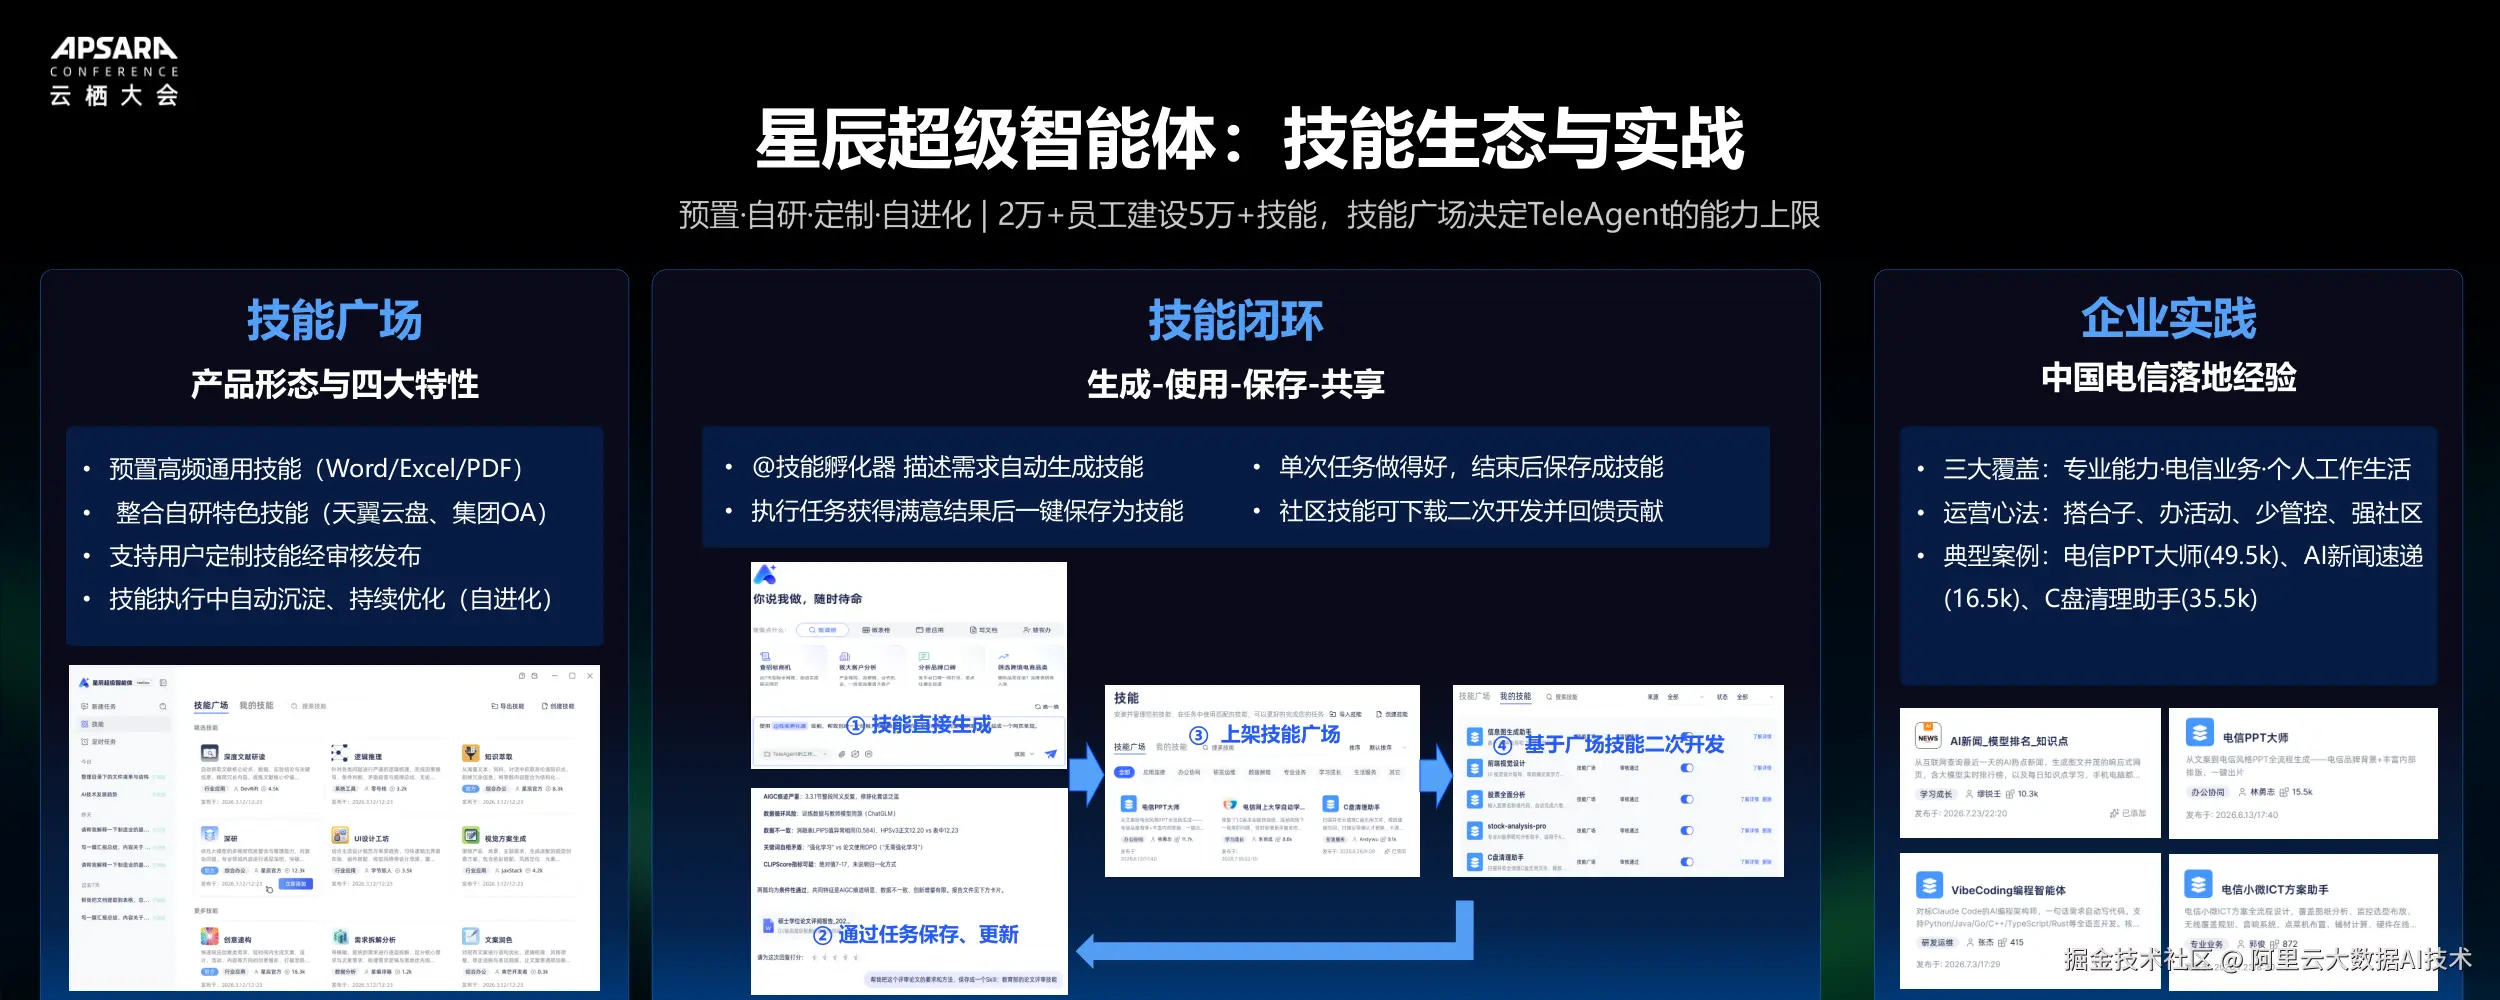
员工经验沉淀为可复用的智能体技能
从实时湖仓到自主交付:把数据资产与专家经验交给Agent
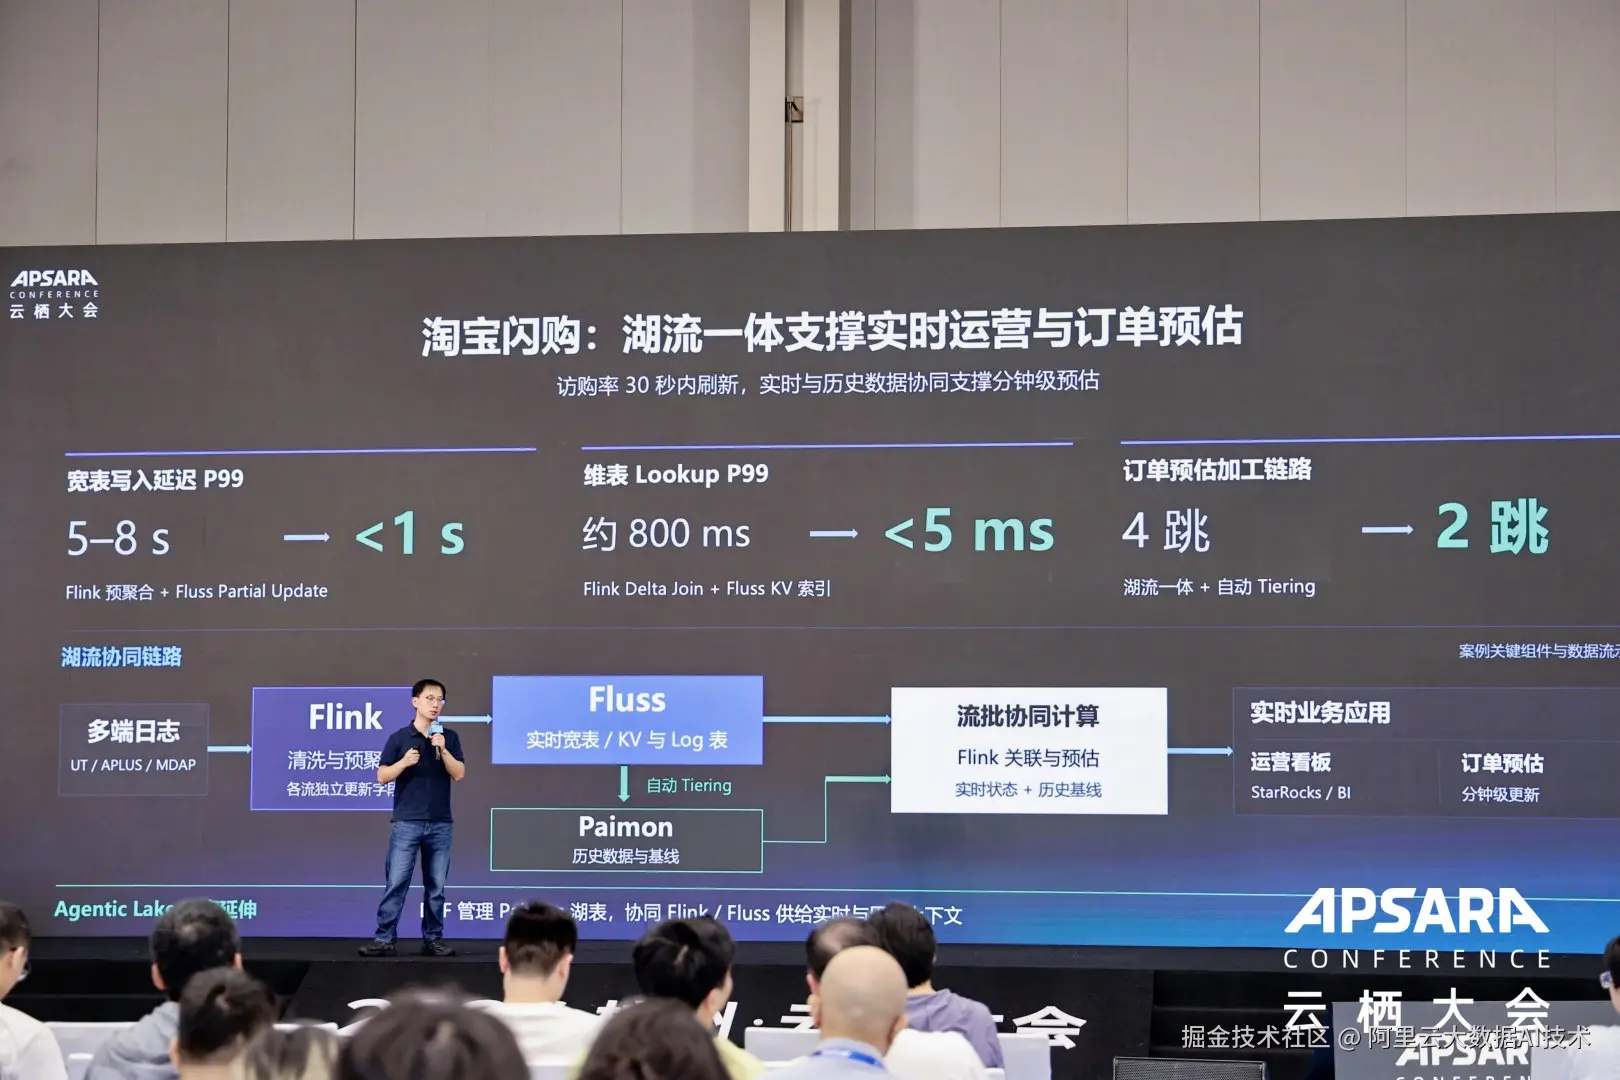
论坛中的企业实践进一步说明,Agent能力并不只来自模型本身,也来自长期建设的数据分层、指标体系和业务知识。北京乐享元游科技有限公司数据总监杨文锋,围绕从传统数据架构到实时湖仓、再到Data Agent的提效历程,介绍了以Flink、Paimon和StarRocks构建统一实时湖仓的实践。
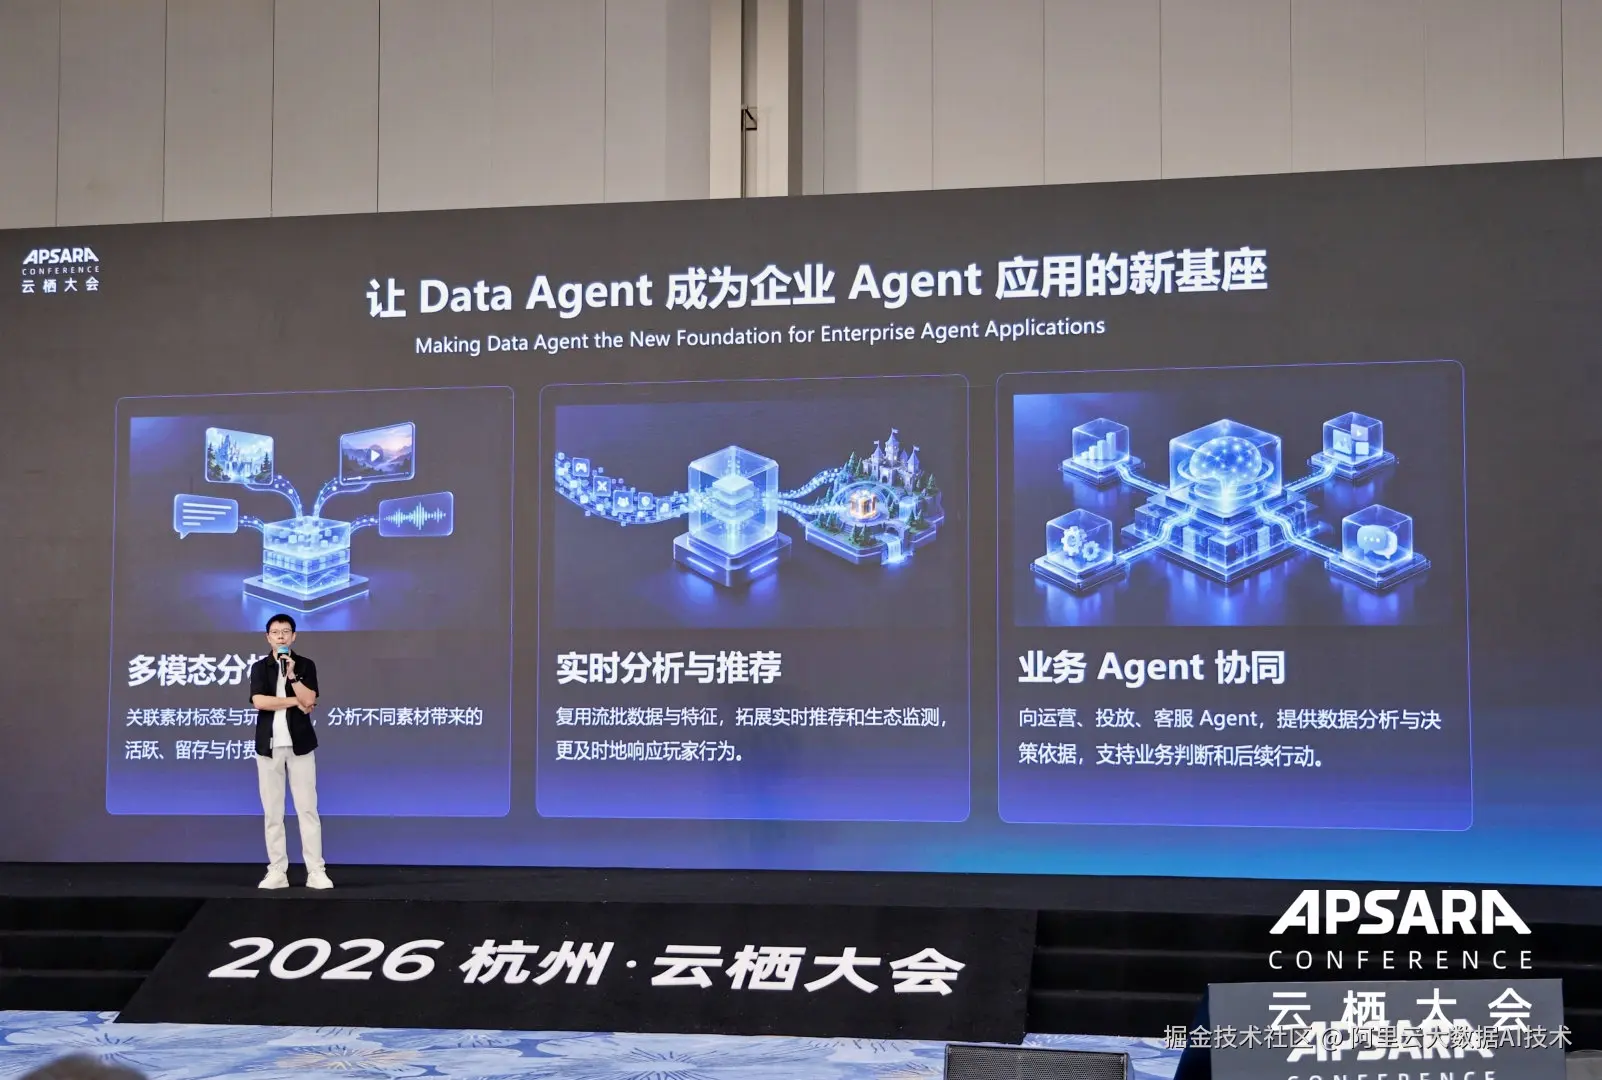
通过渐进式迁移、统一查询入口和分层建模,乐享元游打通不同版本与业务线之间的数据,改善分析负载与交易负载相互影响的问题。据杨文锋介绍,经营报表更新周期由一天缩短到一分钟,数据分析师人均报告产出也得到提升。其Data Agent"小问"进一步以自然语言提供分析过程、结论、图表和证据,利用沉淀到Skills中的业务知识与分析框架指导选表、计算和验证。
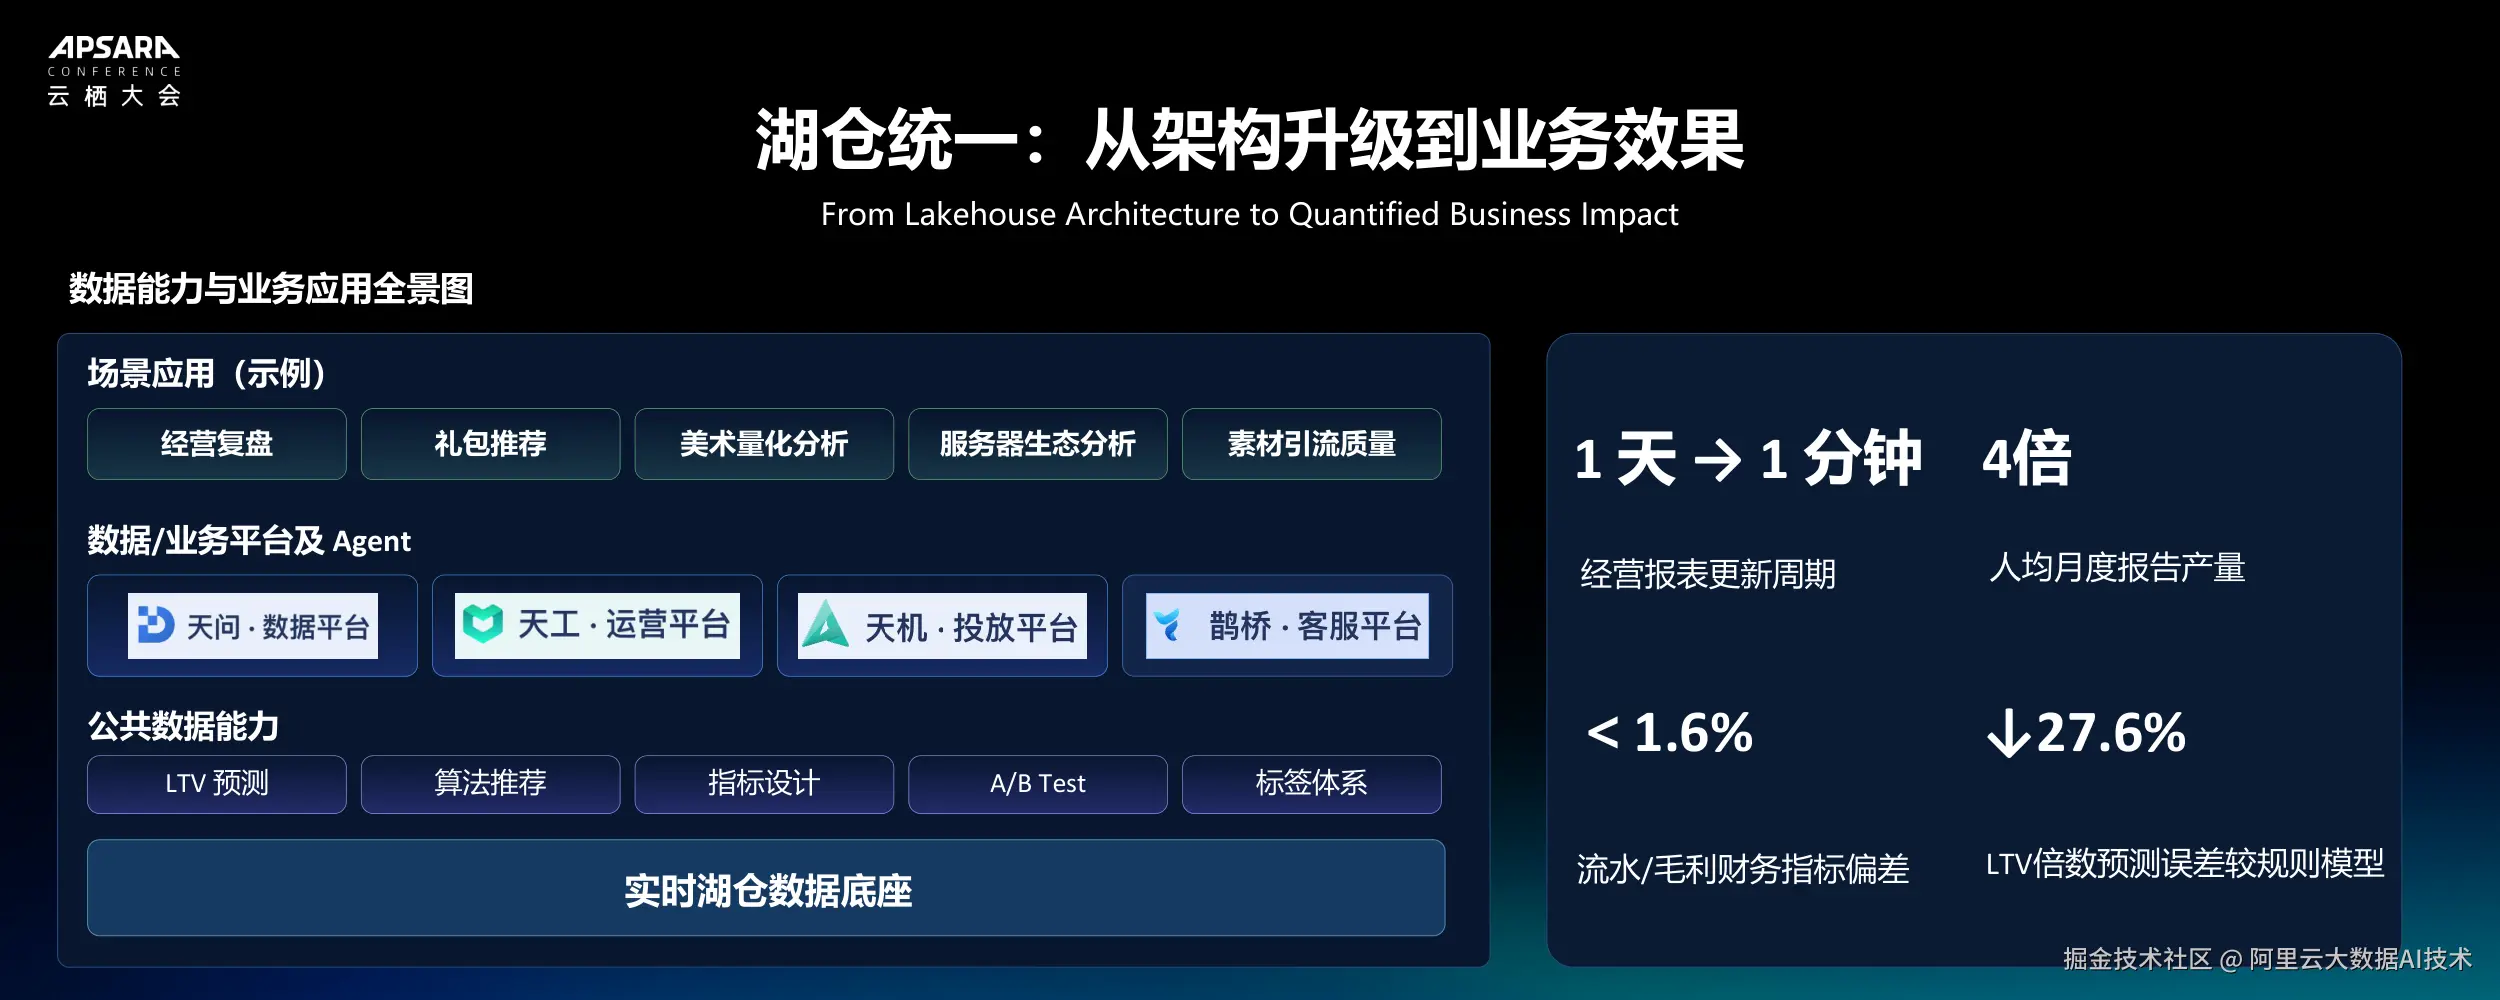
统一实时湖仓支撑经营提效
"小问"以标准API满足高频经营查询,以AutoSQL支持复杂探索,并结合SQL校验、访问约束和业务评测控制风险。乐享元游仍保留稳定报表作为数据准确性的交叉验证工具,在复杂问题排查中由专家提出假设、判断方向,Agent承担取数、关联和证据核查。统一湖仓降低取数复杂度,专家经验赋予分析业务语义,两者结合才使数据资产转化为可复用的智能能力。
阿里云智能集团DataWorks Data Agent研发负责人朱佳墩,围绕Data Agent驱动企业多模态数据工程迈向自主交付,展示了DataWorks Data Agent如何在授权范围内完成更完整的工作流。它不仅需要找到候选表,还需要对齐业务口径、回溯上下游血缘并核验数据,再形成分析结果。
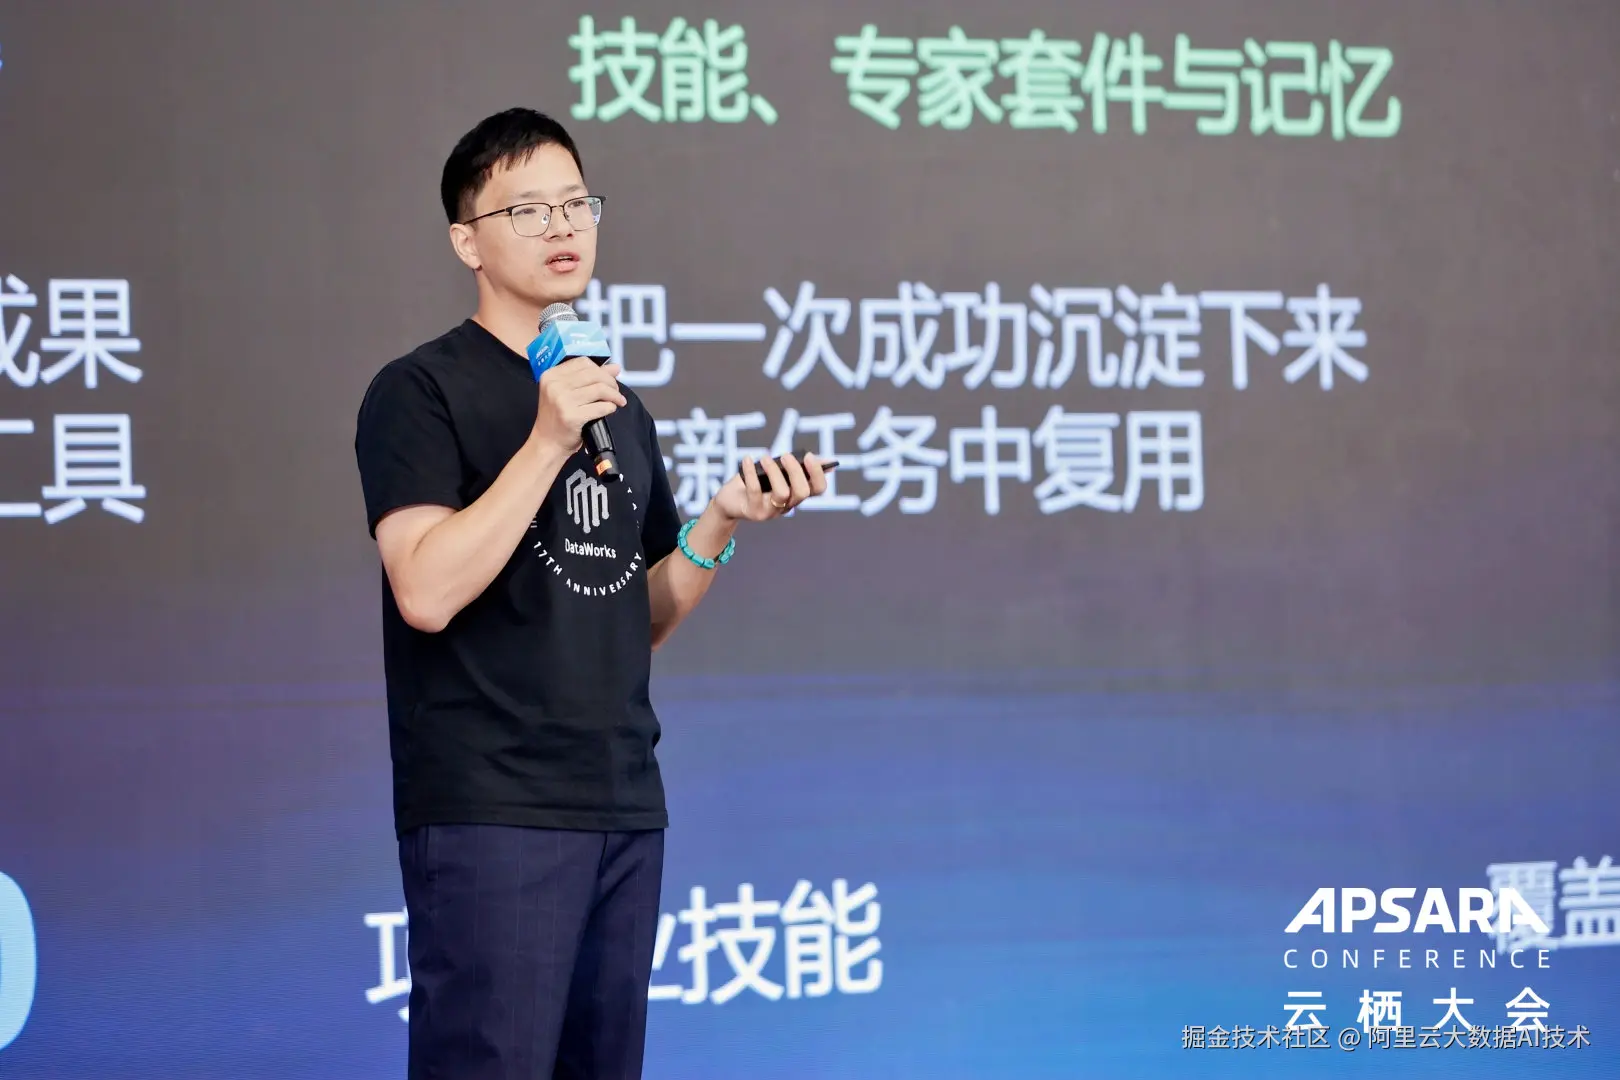
在现场演示案例中,Agent将订单与用户画像等结构化数据、钉钉聊天记录,以及直播视频和图片结合起来,追查业务波动的背景,并将分析流程转化为可重复执行的任务。在技术架构上,交互、平台管控与执行运行相互协同,通过MCP与Skill连接企业数据和工具,并结合租户隔离、最小权限、凭证管理与操作审计,支撑受控的数据工程执行。
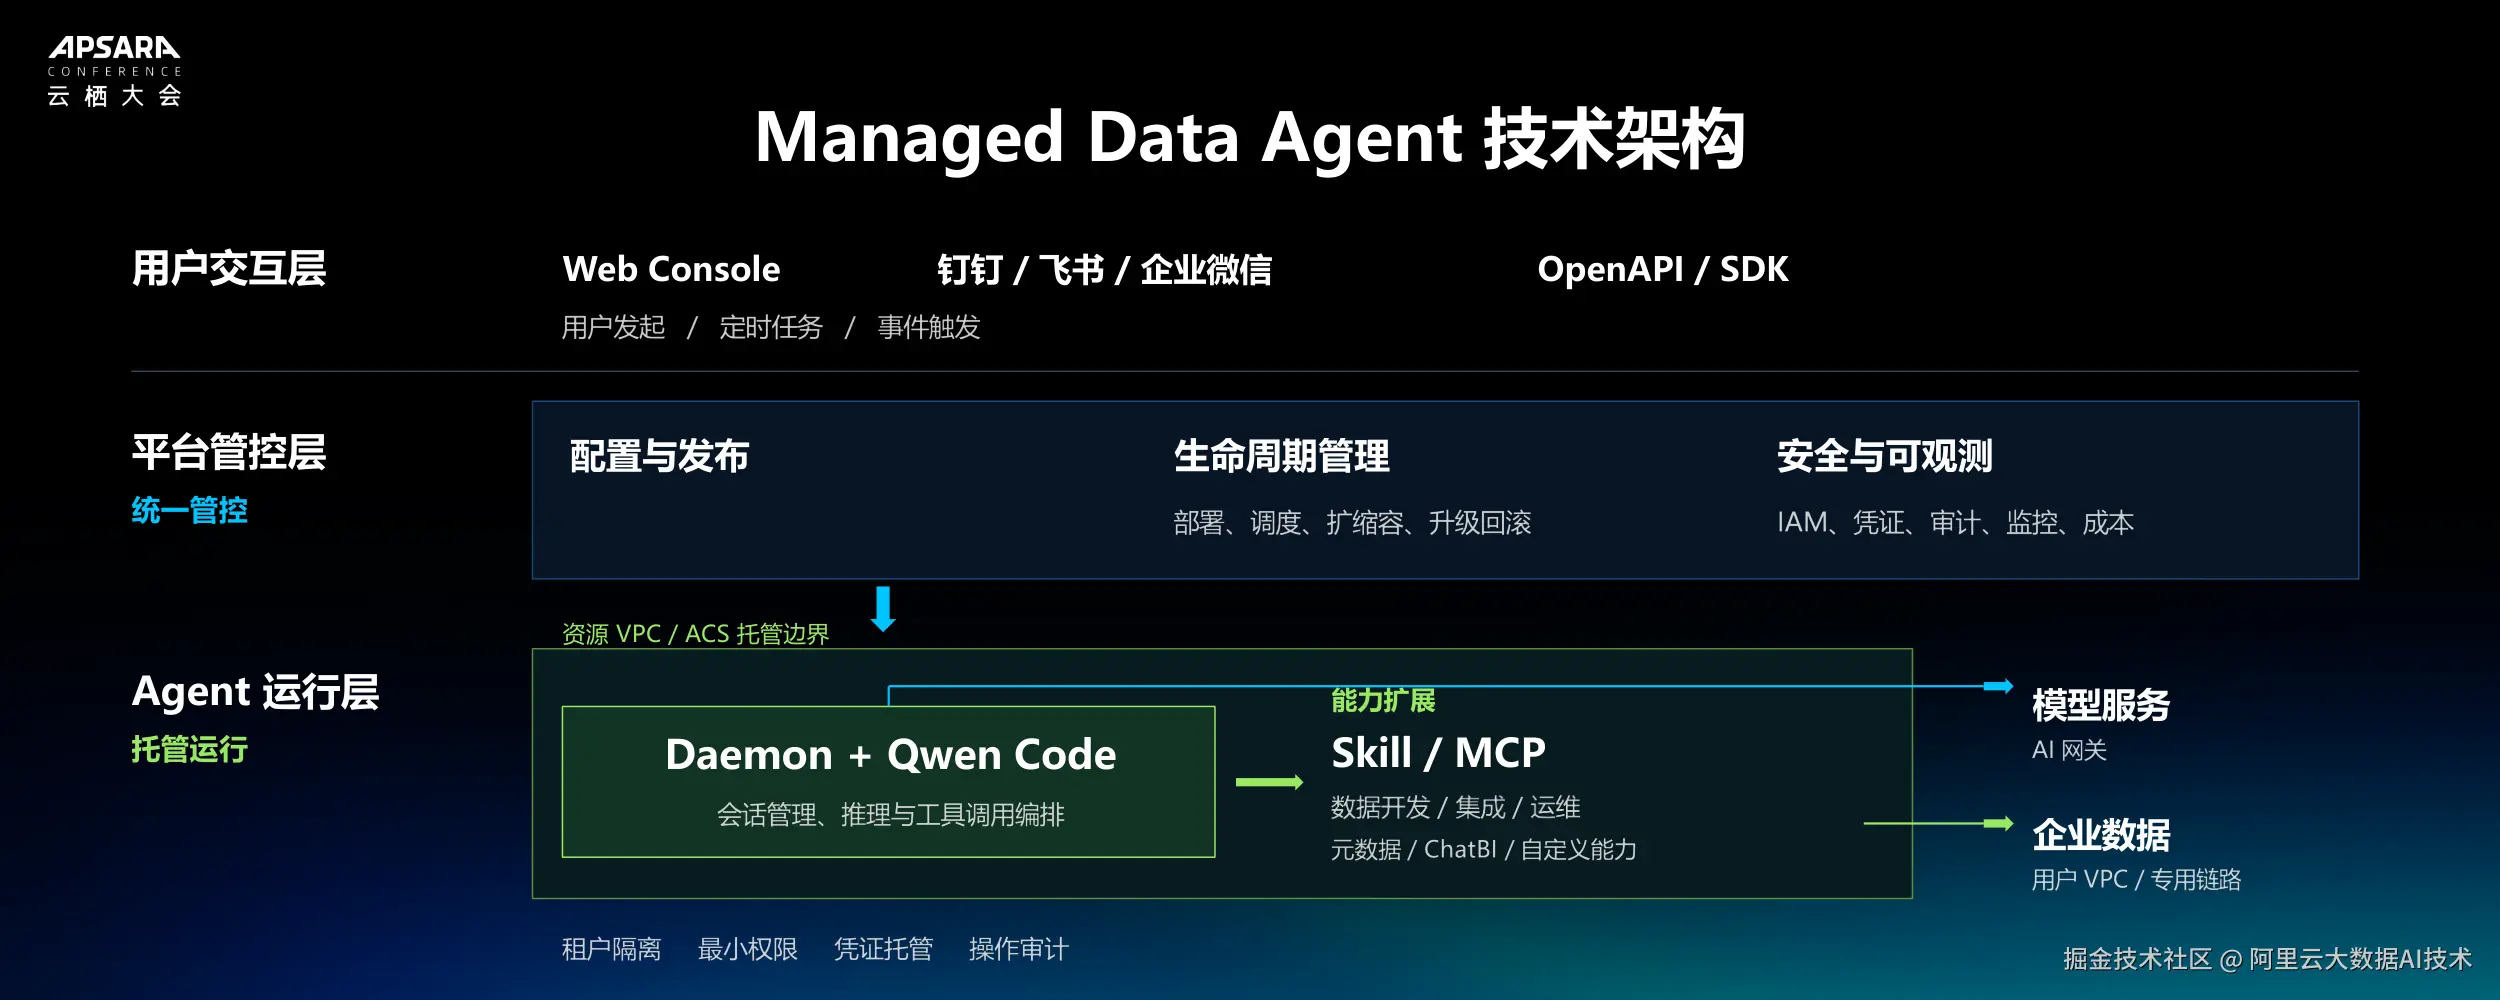
交互、管控与运行协同的Data Agent架构
微财科技数据智能部总监邢捷在《从L0到L3:微财科技数据特征开发的"自动驾驶"进化之路》演讲中,则呈现了特征开发从规范化到智能化的演进。微财以实时预计算和离线计算改善特征供给,再建设原子存储层、特征计算层与特征池,将开发、测试、上线流程平台化,减少对人工操作的依赖。
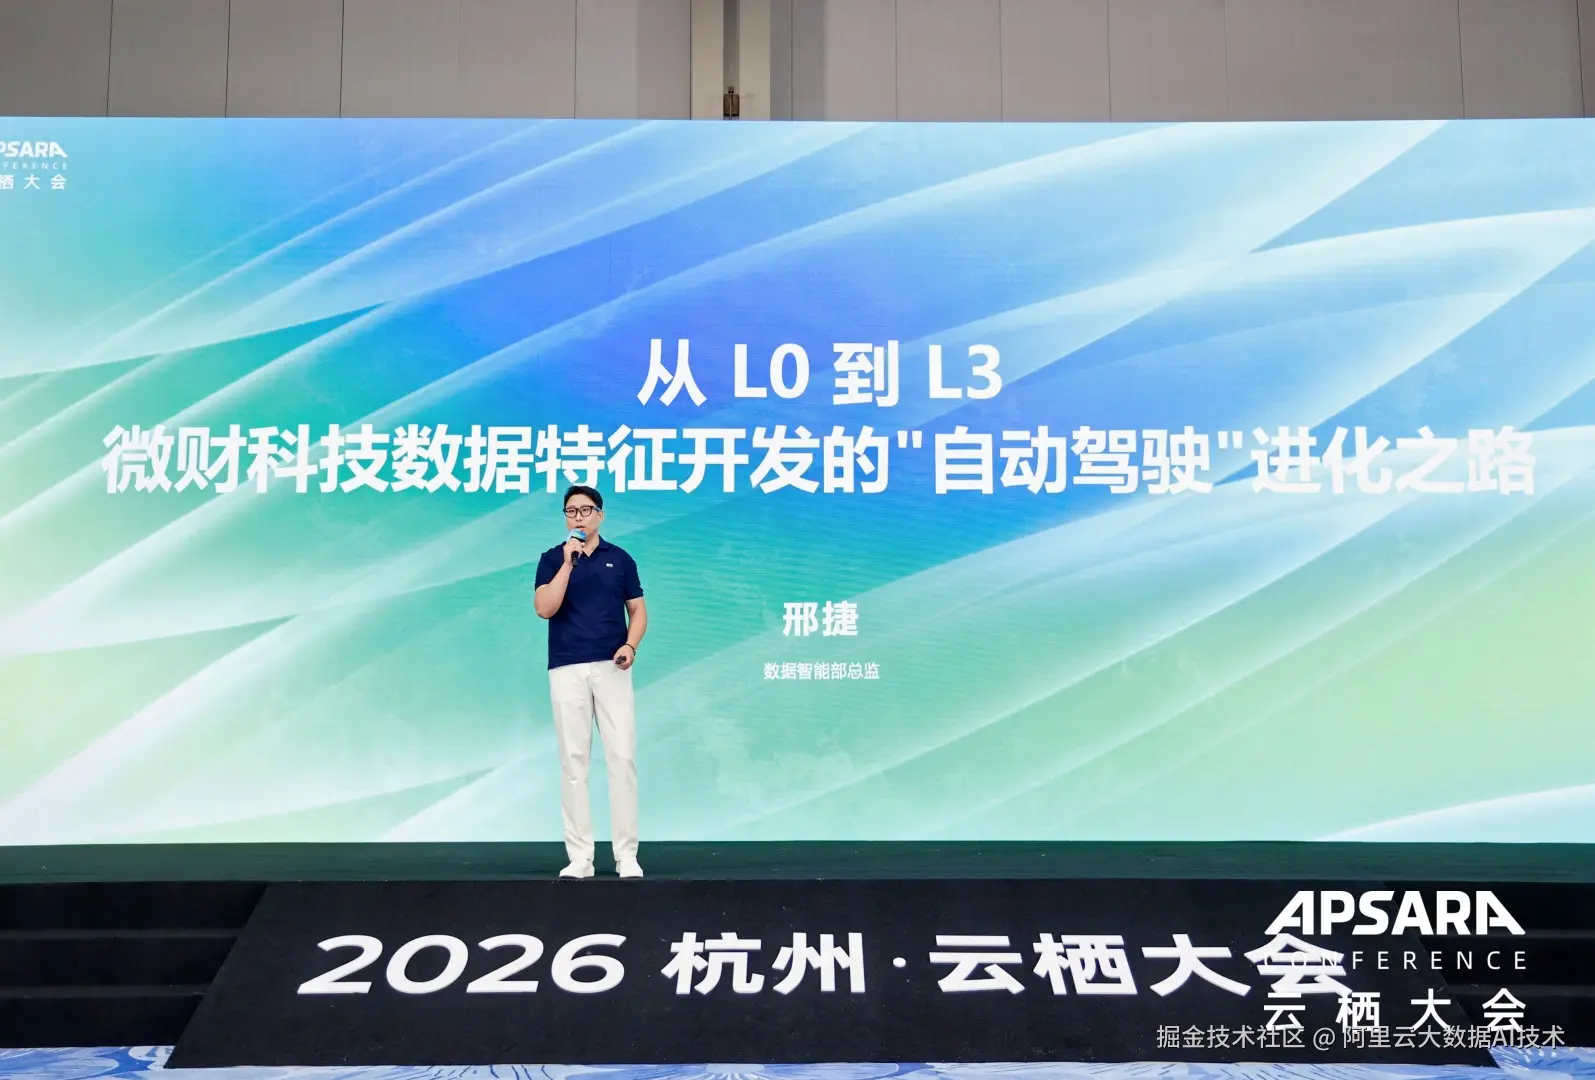
在此基础上,微财将元数据与标准操作流程封装为CLI,把特征开发经验沉淀为Skill,并将智能体嵌入特征开发流程,利用历史需求进行测试与精调,推动其定义的L3阶段特征开发流程自动化,同时保留审批与异常转人工机制。邢捷强调,这一过程的价值不仅在于缩短开发时效,也在于让原有开发人员从重复工作转向智能体开发;特征挖掘和模型训练,则是后续继续探索的方向。
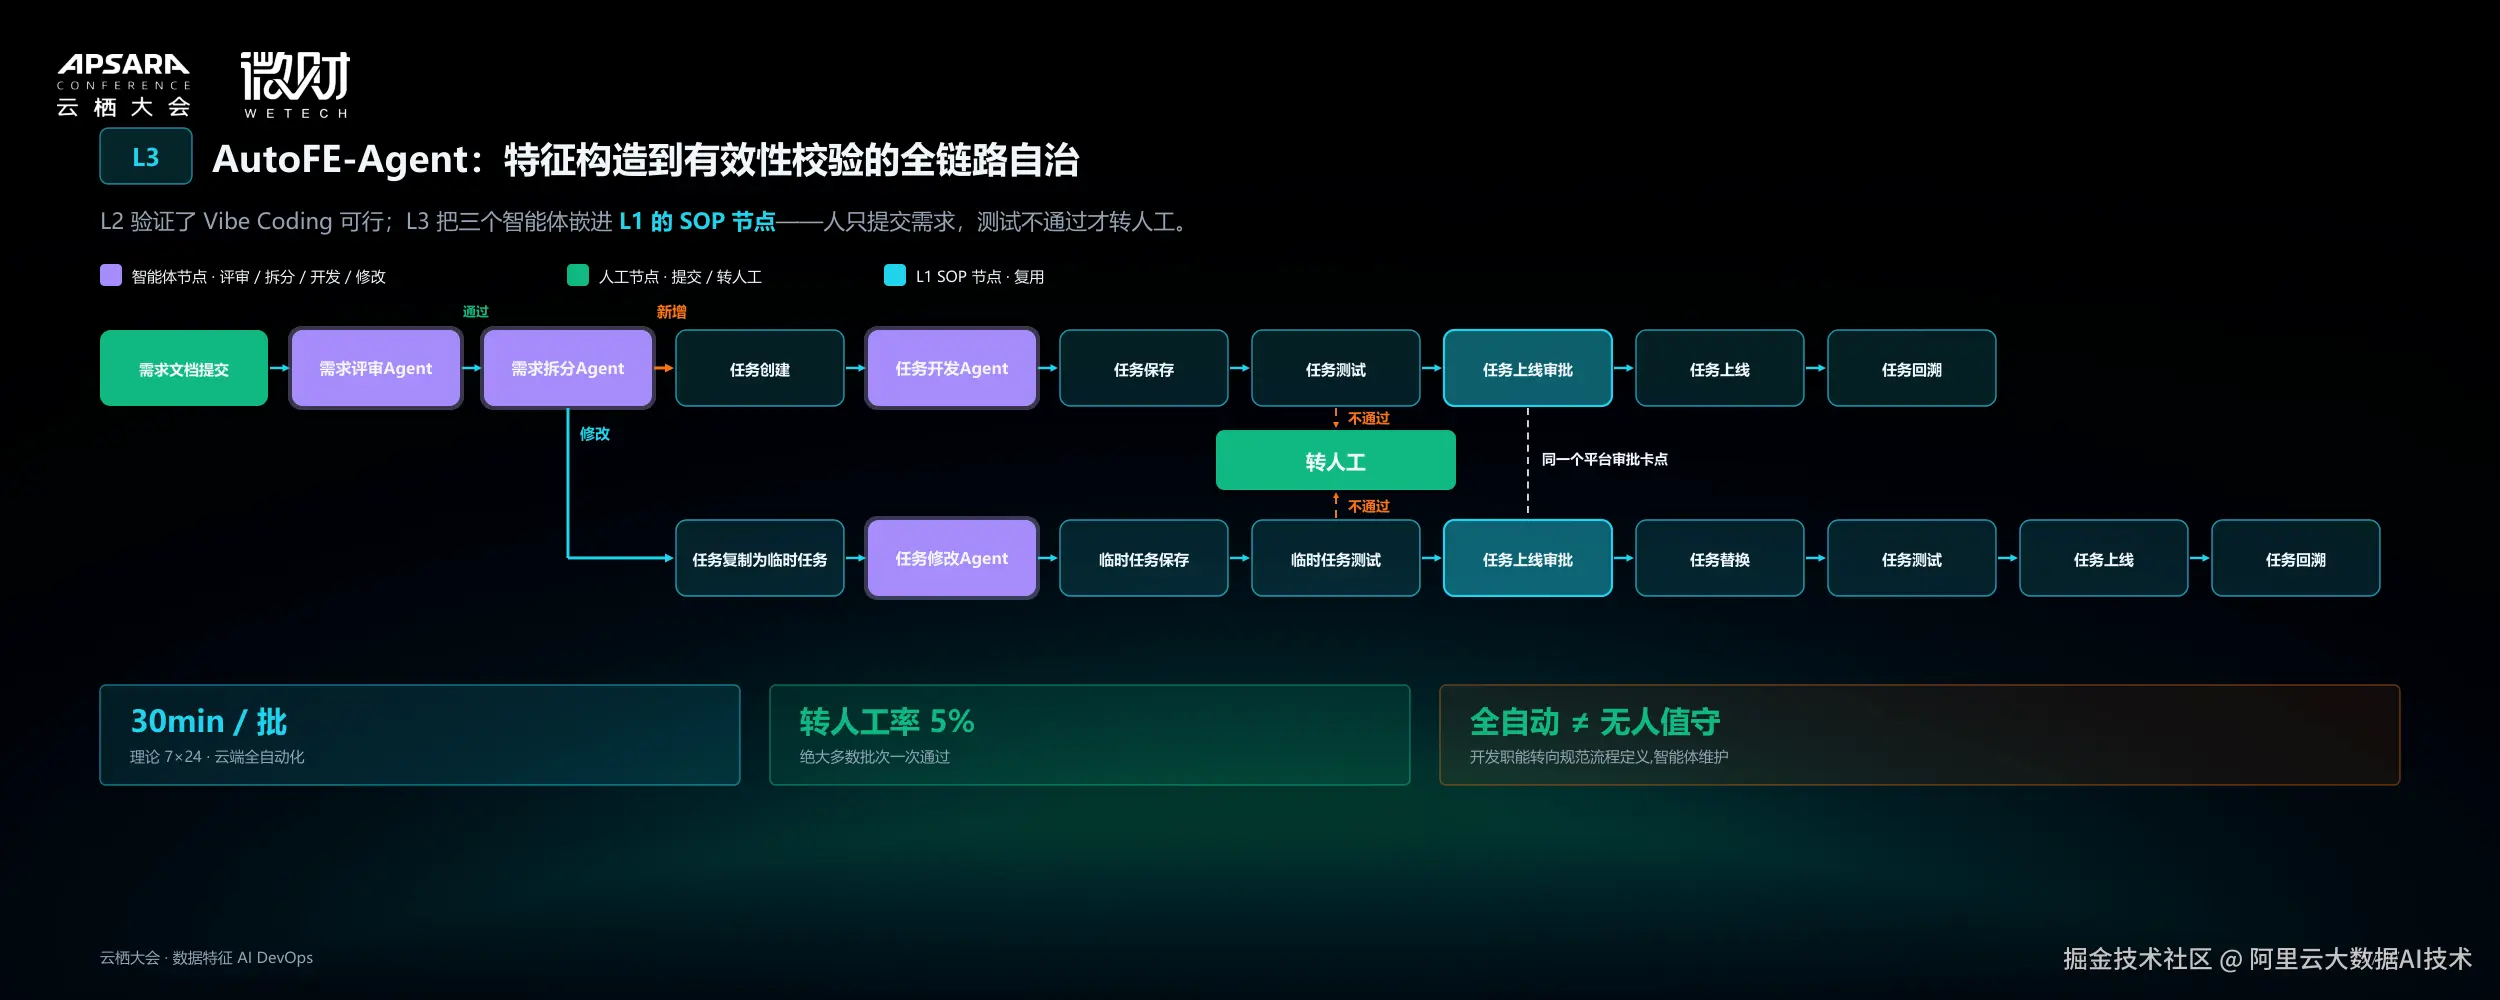
智能体嵌入特征开发与有效性校验流程
以全栈协同,让数据、模型与业务形成持续迭代的飞轮
从魏博文提出的双闭环全栈方案,到移动物理AI、企业办公、游戏运营和金融特征开发的实践,这场论坛展示了多模态AI走向生产的共同基础:可复用的数据资产、可理解的业务语义、高效稳定的训推平台,以及能够承接专家经验、在授权和监督下执行任务的Agent。让数据处理、模型优化与业务反馈持续协同,才能把AI能力转化为可迭代的业务价值。