在日活数亿的大厂,召回通道非常多,汇总起来的视频会达到上万条。而精排模型虽然排序很准,但算的极慢。如果把上万条视频直接送入精排模型,会造成巨大的计算负担和极高的时间延迟。于是工程师们在召回和精排之间切入了一个承上启下的关卡,也就是粗排
粗排必须在极短的10到20毫秒内,从召回的1万个结果筛选到1000个,在交给下游的精排。可以说粗排是**推荐系统中对速度和精度的又一次折中**。既然粗排要在极短时间内完成上万次筛选,那他该以什么标准来挑选视频呢?
粗排的发展历史
在推荐系统的发展史上,工程师们曾经爆发过一次流派之争,流派一我们称之为独立主权派。早期的工程师认为粗排就是精排的微缩版任务和精排一模一样,直接去预测用户对视频的点击率。除了模型结构更简单之外,学习方式、打分逻辑完全是独立自主的,听起来很合理,实际上却隐藏着一个逻辑漏洞。粗排挑选出来的好视频,精排可能根本看不上,把它排在了1000名开外,那么粗排的努力瞬间白费
于是第二种流派占据了主流,让粗排成为精排的先头部队,也就是 LTR 模型,这种流派的观点是,粗排的终极目标不是去预测用户会不会点赞,而是去预测精排模型会怎么打分,既然决定了要模仿精排的排序口味,粗排具体该怎么学呢?
在LTR体系下有三种经典的方法,单点法、配对法和列表法。
单点法最简单粗暴,预测单个视频的分数,比如给科幻片A打85分,给喜剧片B打80分。但排序的本质是比较,绝对分数往往不靠谱,有人打分偏高,有人打分偏D这会让模型非常困惑。
配对法不需要知道绝对得分,把视频两两组对比大小,知道A排在B前面就足够了,这完美契合了排序任务的本质
列表法最理想,直接学习一整个视频列表的最优顺序。但这在数学计算上极其复杂,粗排到可量的十几毫秒根本算不完。
工业界选择的是最折中的方法------配对法。而配对法中最经典的算法叫做 RankNet,它的核心是最小化视频对的排序误差,
原理
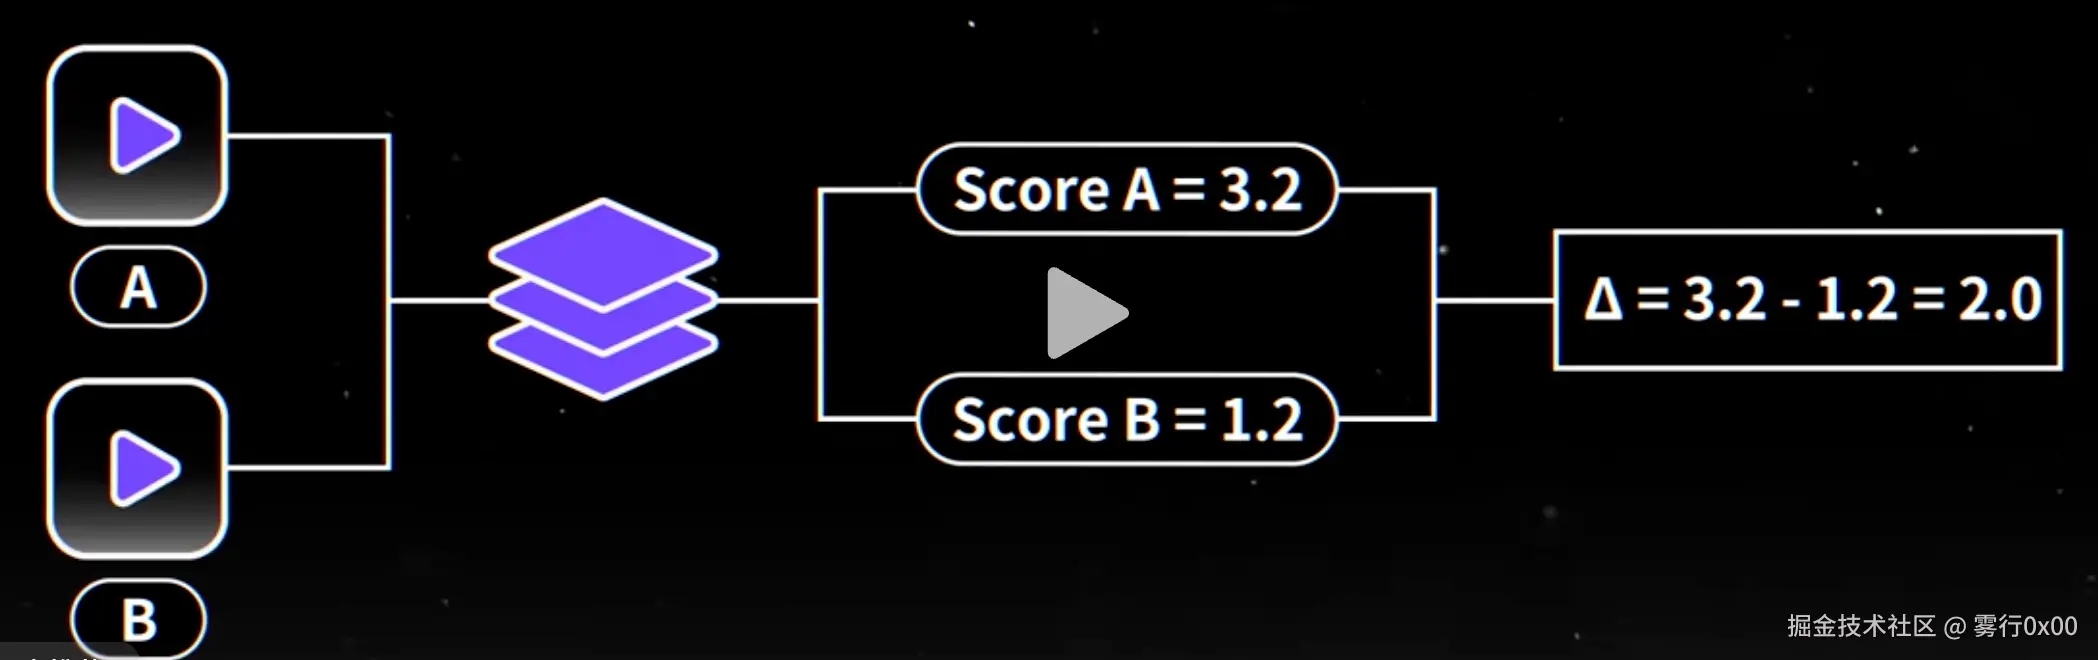
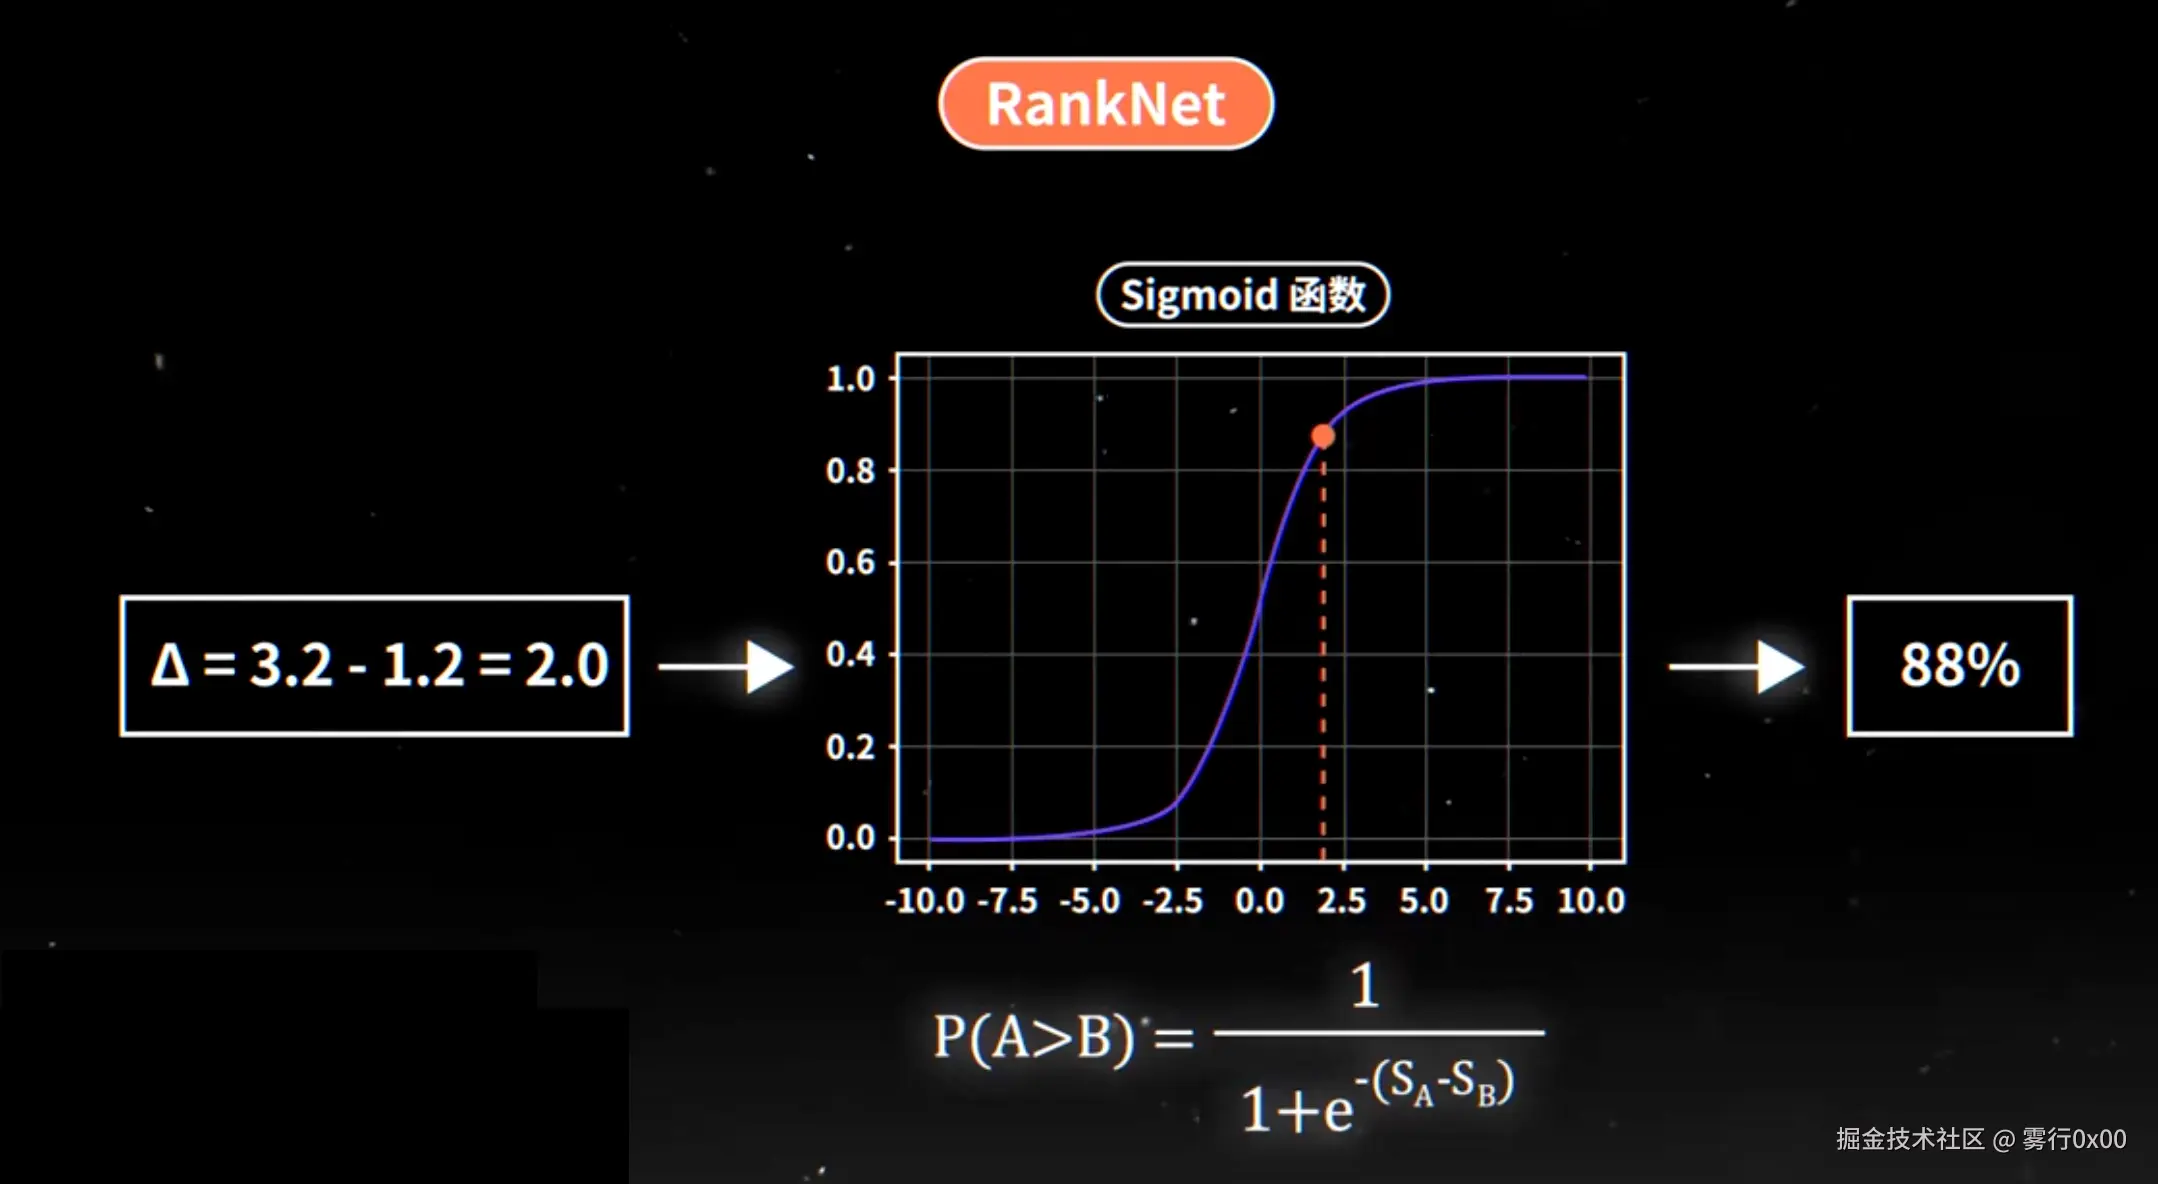
首先接受视频A和B,通过简单的神经网络得到两个视频的兴趣得分a b,接下来把两个得分相减,算出一个差值,然后塞进一个经典的数学函数里,转换成了一个0到1之间的概率。
比如它输出88%,意思就是粗排模型,有88%的信心认为精排大老板会把A排在B前面
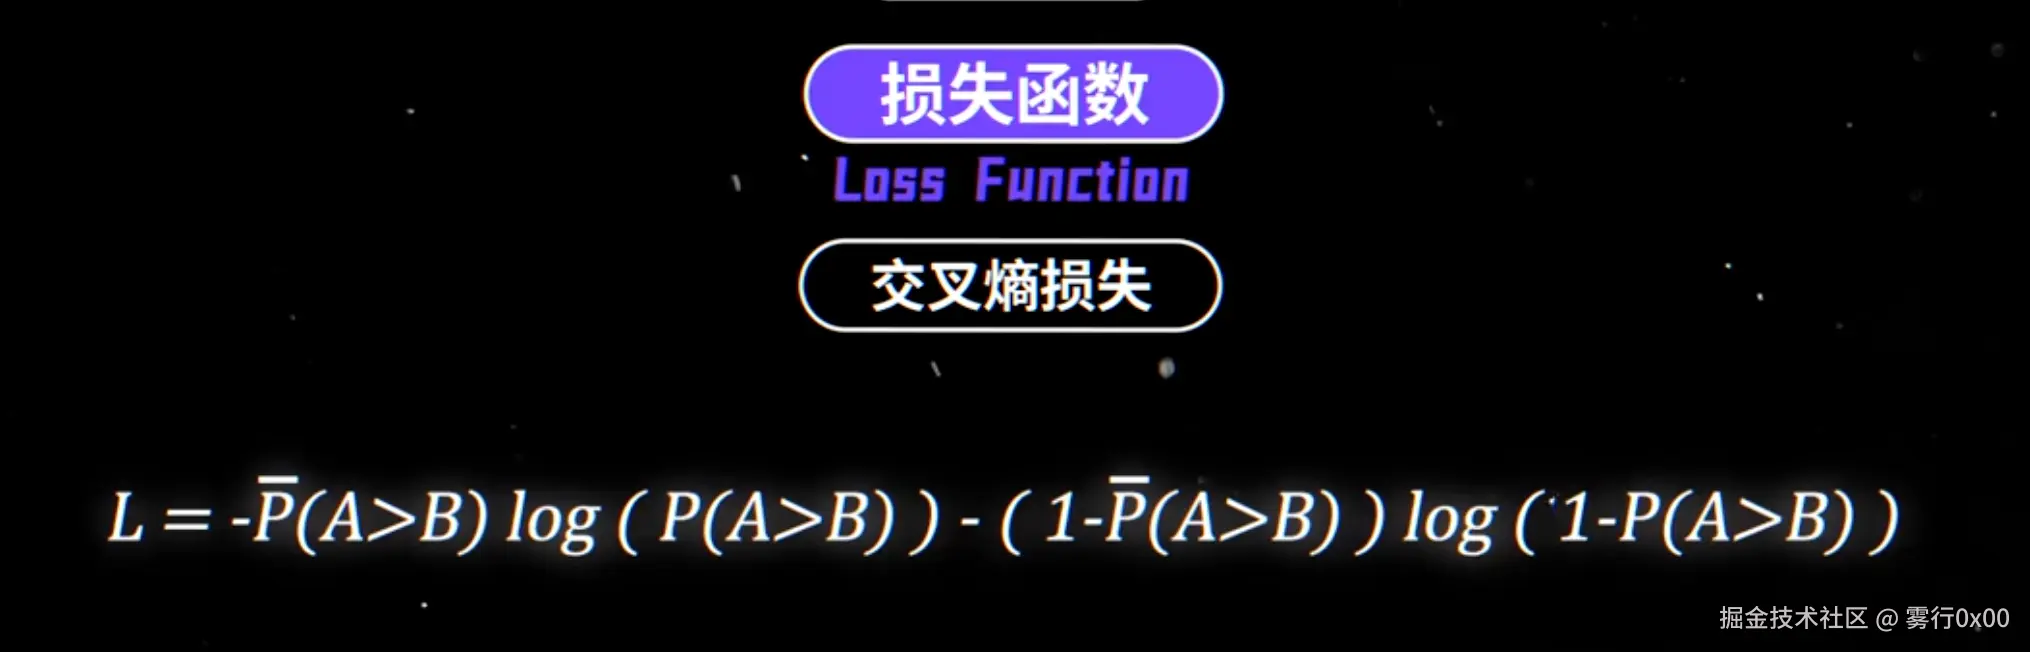
那么他怎么知道自己猜的准不准呢?这就必须引入机器学习中最重要的一个概念------损失函数,损失函数可以理解为现实与理想的差距。
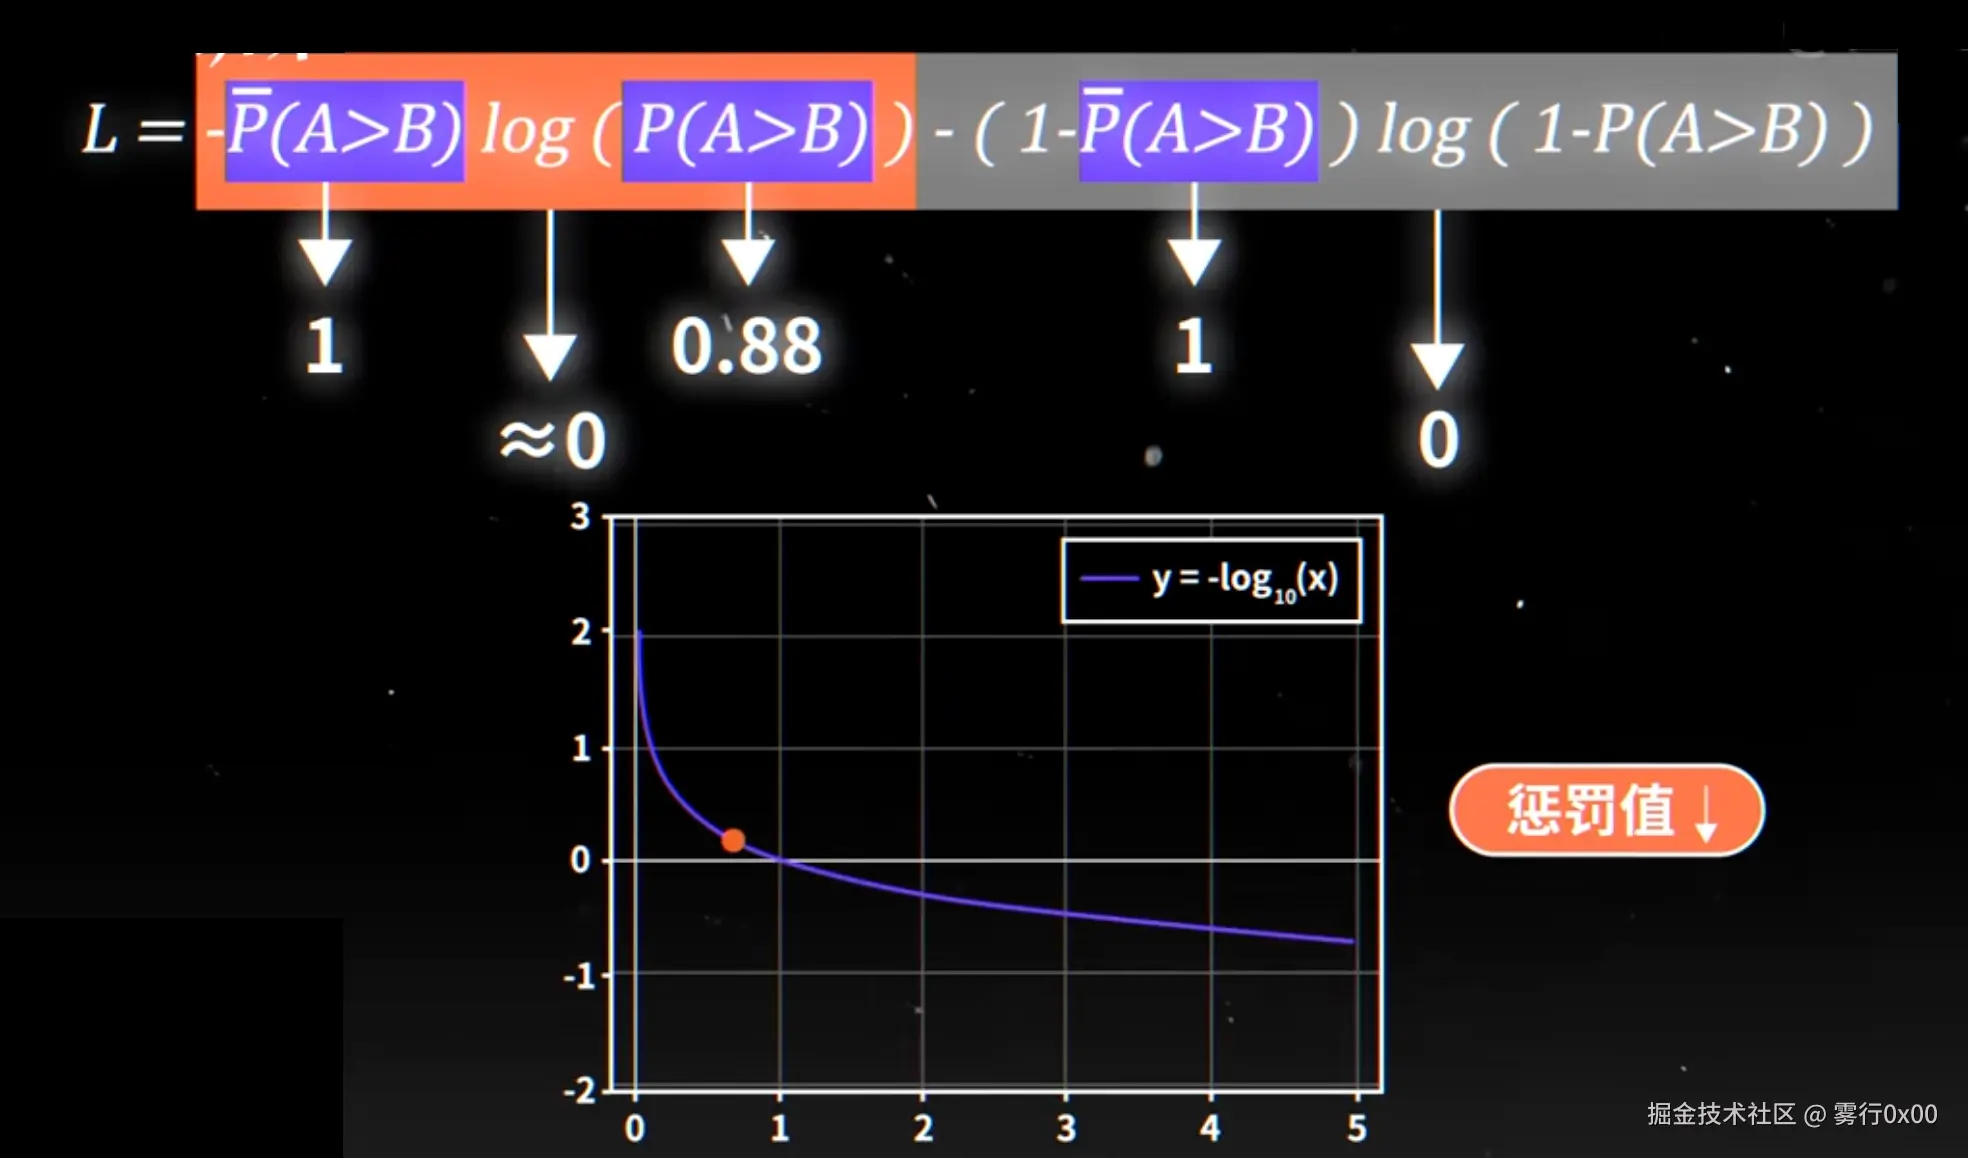
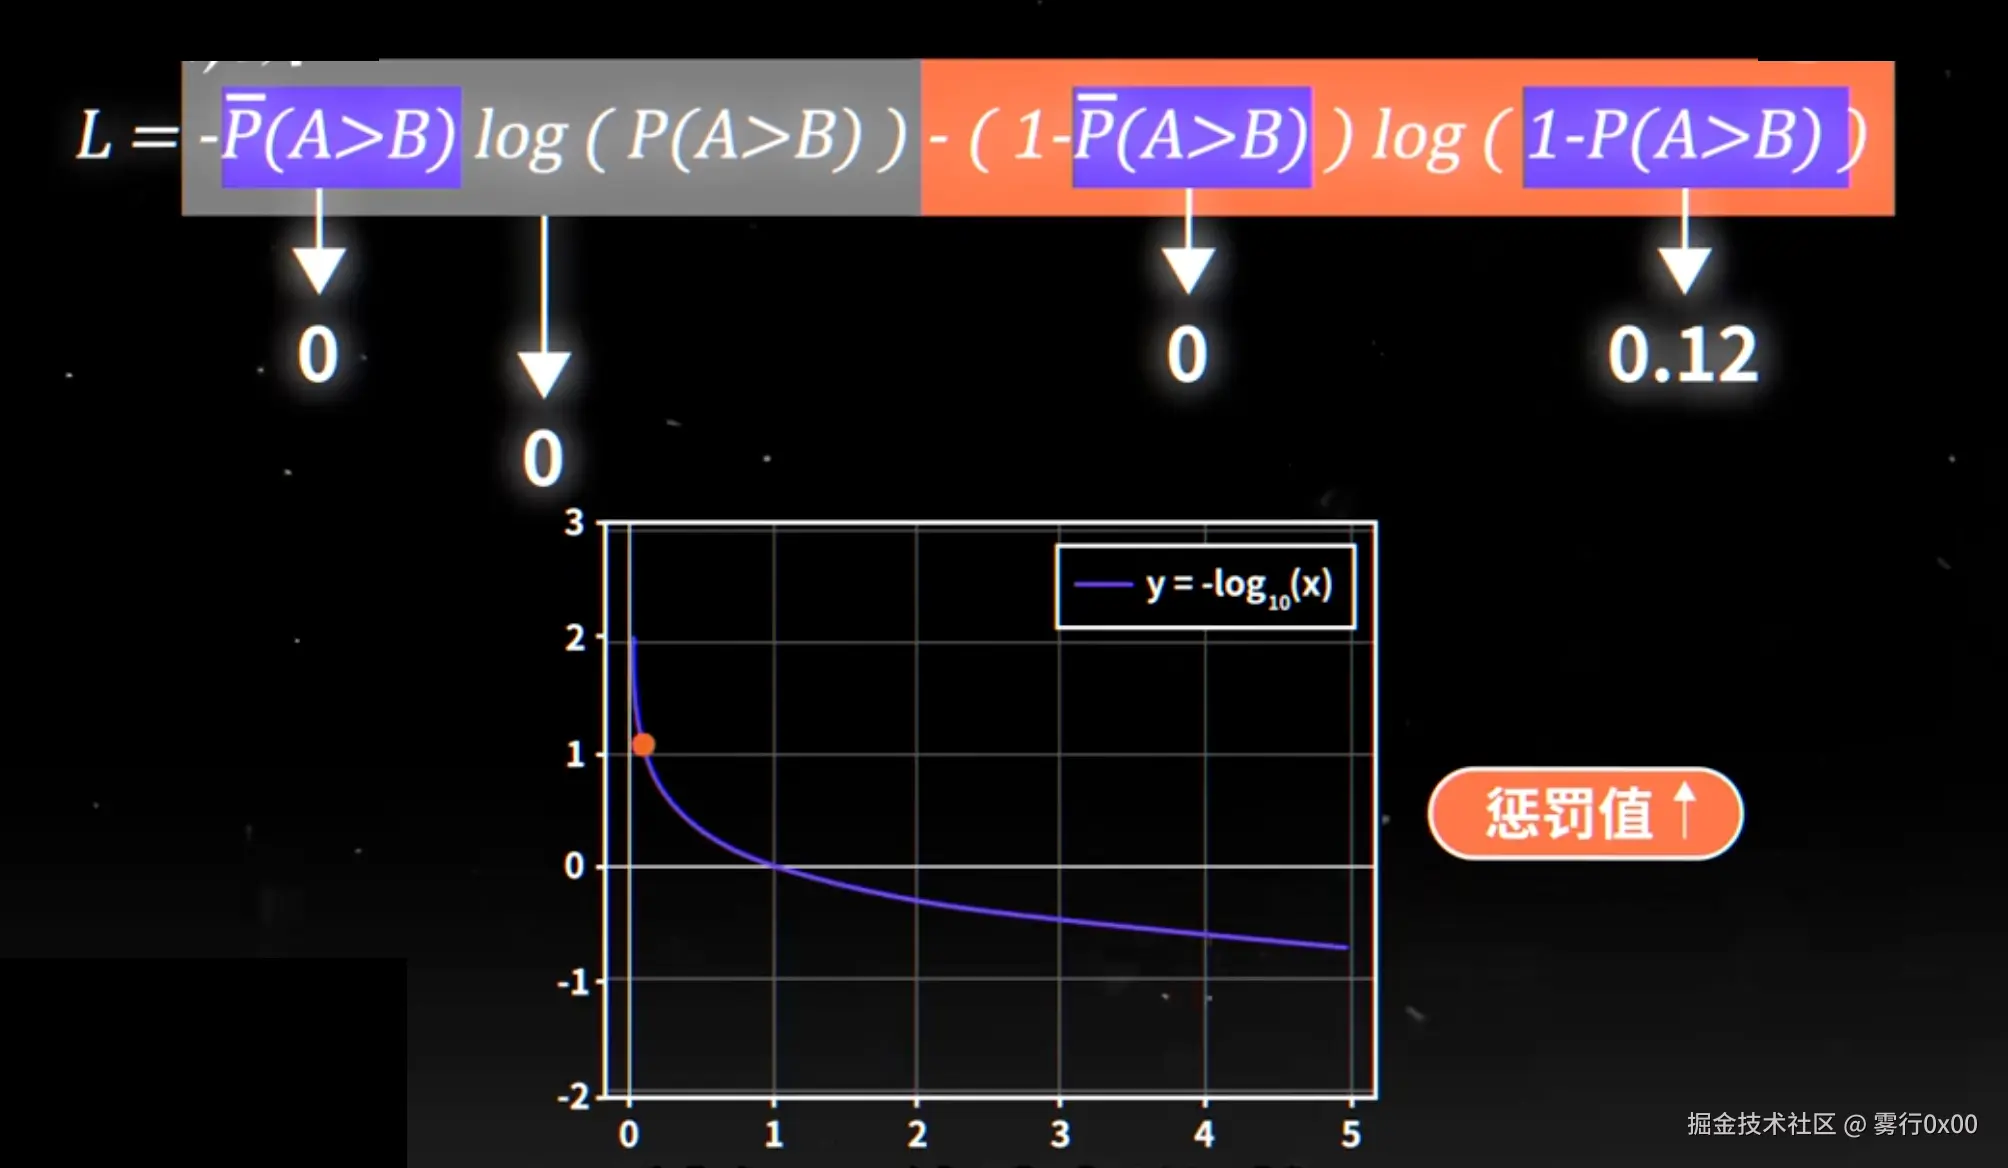
在rank net中,损失函数是交叉熵损失。公式里的 P 代表精排老板认为A大于B的概率,而P 代表粗排预测的概率。假如精排数A确实比B好,标准答案P=1,这时候公式的后半部分因为会直接归零消失,系统只计算前半部分。由于P等于0.88很接近于一,负log之后就很接近于0,算出来的惩罚值很小,模型参数保持稳定。
但如果精排认为P更好,标准答案P=0公式前半部分消失启动,后半部分计算一减P很接近于零,负log出来的惩罚值就会飙升,神经网络大幅调整
模型会把它当成自己优化的目标,一次次试错,调整自己脑子里的网络参数,直到损失函数降到最低。无论你给它哪两个视频,它看一眼就能精准预判出精排会选谁。
明确了对齐精排的思想后,粗排还需要一副强健的躯体来执行任务。为了在10毫秒内达成1万次计算,粗排的架构经历了几次进化。
基于统计打分
在深度学习尚未普及的第一代,粗排的逻辑简单粗暴:基于统计打分
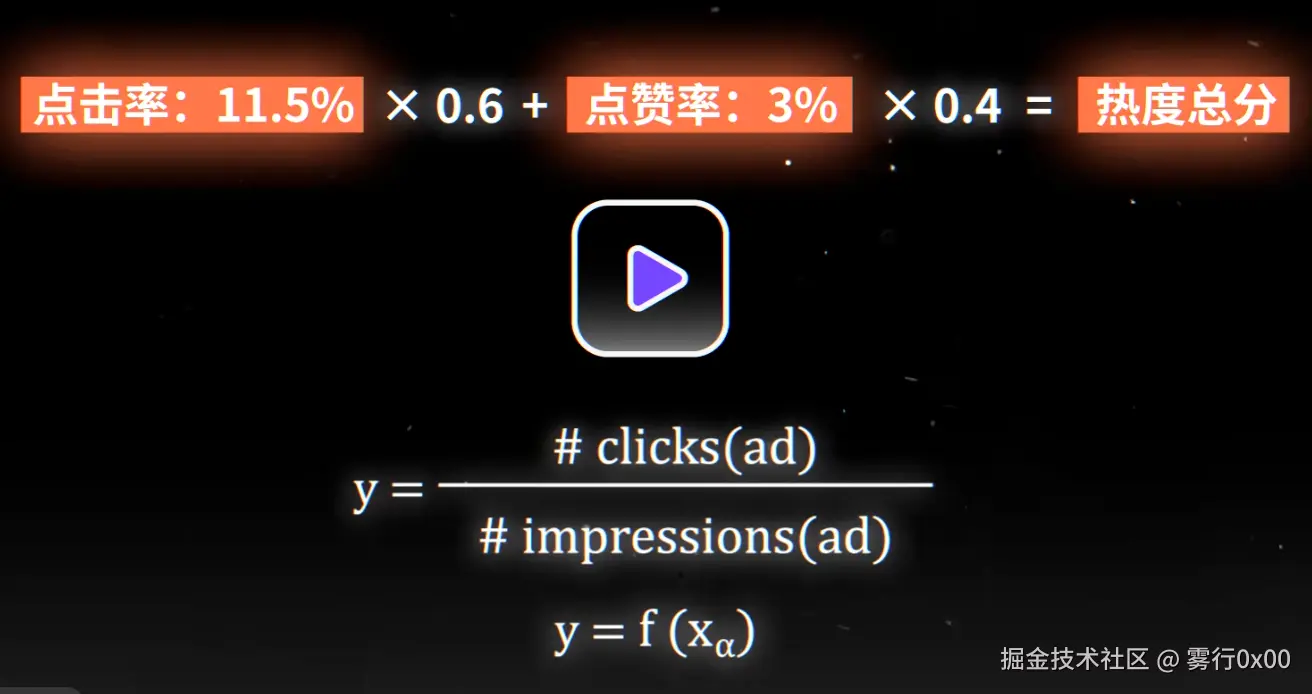
就是看历史统计数据在人工设定一套规则,比如把视频的点击率乘以0.6,点赞率乘以0.4加起来算出一个热度总分,排名前一千的直接送给精排 ,这极度省算力,但也完全没有个性化。1000个不同的用户打开app,粗排挑出来的都是同一批热门视频。
逻辑回归
为了让粗排拥有一点个性化,第二代粗排引入了机器学习中最经典的算法 逻辑回归,从这时候起,推荐系统终于把排序看作了一个严谨的数学分类问题
逻辑回归是怎么工作的?它会把你的特征和视频的特征一起输入进来,给每个特征分配一个权重 ,所有分数加权求和后,再通过 sigmoid函数把总分压缩成一个0到1之间的数字 ,代表你对这个视频感兴趣的概率。
有了逻辑回归,粗排终于可以做到千人千面,而且计算速度依然非常快。
双塔模型
但是模型简单理解不了复杂的组合,逻辑表达能力极其有限。随着深度学习时代的到来,粗排迎来了它的第三代引擎:双塔模型。
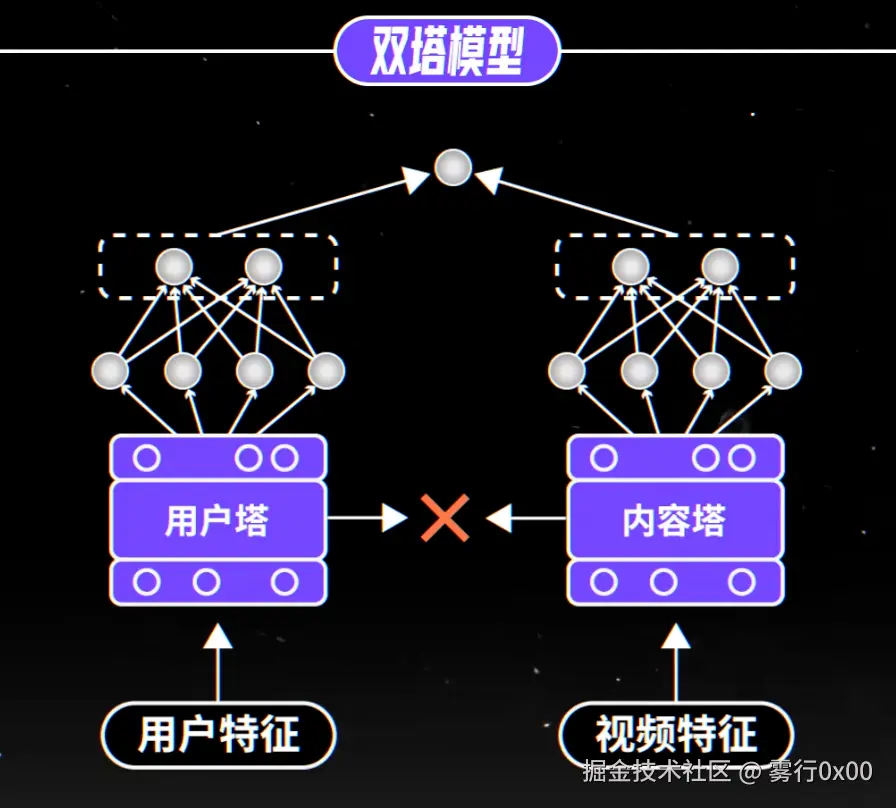
用户数据走左边的塔,视频数据走右边的塔,两者各自在塔内进行极其复杂的深度神经网络计算。最后在塔顶部相遇算出一个匹配得分。
但是双塔模型存在一个致命的缺陷,用户塔和视频塔是相互独立的,无法引入用户与视频的实时交叉特征。
COLD
为了打破双塔模型互不相见的物理隔绝,第四代粗排引擎诞生了,其中最著名的行业标杆之一就是阿里巴巴提出了 cold 方案,cold 给出的是一场算法与工程的联合压榨。
-
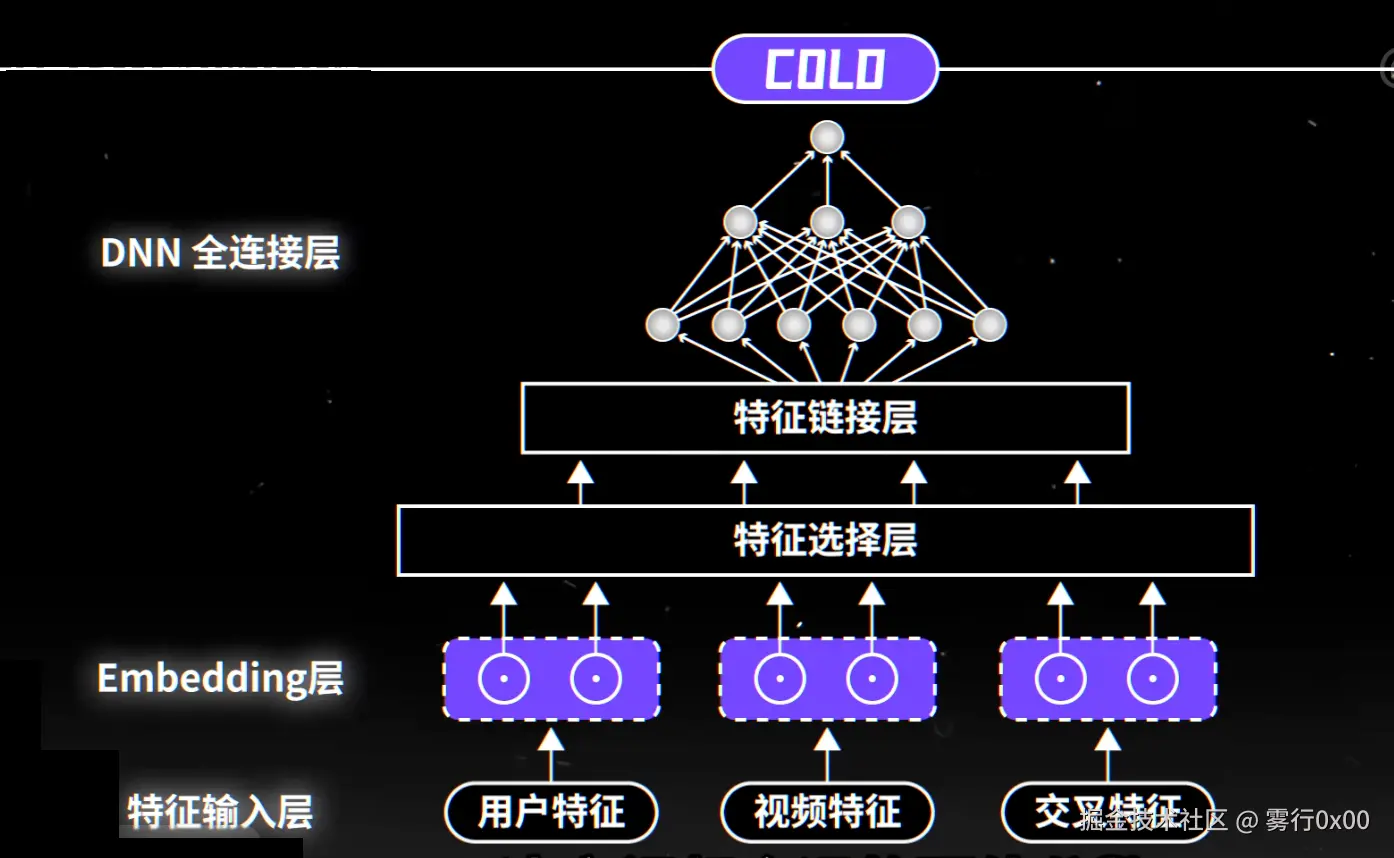
最底层是特征输入层,在这里除了常规的用户特征和内容特征,模型引入了交叉特征。比如你过去一小时内有没有点赞过类似标签的内容。这就意味着在起跑线上,用户和内容就已经开始产生联系了。
-
紧接着庞大的原始数据向上进入embedding层,你可以把这里理解为一个翻译器,它把各种参差不齐的信息转换成长度固定机器能极速处理的数字向量。
-
准备工作做完,马上就要进入最耗费算力的阶段了,为了不让服务器当场死机,co在这里插入了一道智能闸门。特征选择层,它的核心是一个叫做 SE block 的网络结构,自动识别哪些特征对排序最重要,并调节它们的流量,也就是权重分数。接着系统会按照权重排名,只保留排在前top k的特征,剩下的特征直接拦截在外。通过这种动态的特征筛选模型甩掉了巨大的计算包袱,让后续的神经网络计算变得轻量便捷。
-
幸存下来的特征进入特征连接层,被拼接在一起
-
最后他们被送入最顶端的大脑 DNN 全连接层。在这里三种特征成了深度的交叉运算,并吐出视频的预估分数。
想要把时间死死压在10到20毫秒内,还需要底层工程进一步优化。除了筛选特征,他们还降低了神经网络的训练精度,把高精度的浮点数降级为低精度,用微小的误差换取了速度的翻倍,同时开启多层级的并行计算,把计算任务分成多份发数同时处理,最后再合并结果。
教师-学生模式
尽管有了 COLD 这样强大的工程优化,粗排模型的脑容量,也就是参数量注定不能太大。而模型小就意味着智商受限。既然自己学的太慢,那不如直接找个顶级大佬拜师学艺。这就引出了知识蒸馏,顾名思义,就是把极其庞大复杂的知识库像蒸馏一样提炼出最核心的精华,注入到轻量级模型中去 。在推荐系统中,这被称作教师-学生模式。结构复杂、算力庞大的精排模型就是老师,而结构简单、只能在15毫秒内完工的粗排模型就是学生。给他们输入完全相同的视频信息。过去粗排模型都是自学成才,他只看用户真实的点击结果,也就是所谓的硬标签。这就好比做题只看标准答案,学生只知其然,不知其所以然。
而知识蒸馏的精髓在于,学生不仅要抄答案,更要学习老师的解题思路。在神经网络中,粗排模型在做出最终决定之前,它的输出层前会生成一个向量,我们称之为 Logits,你可以把它理解为老师在面对这个视频时,脑子里闪过的一组概率分布,能代表模型的预估能力,我们称之为软标签。
知识蒸馏的本质就是让粗排模型去全面模仿精排老师的这个 Logits 分布。只要学生的预估概率分布能够无限逼近老师的,这就意味着这个学生学到了老师的真传。
为了在十几毫秒内完成1万个视频的排序,工程师们不仅把底层的硬件算力压榨到了极限,还让粗排模型去向更聪明的大老板拜师学艺,最终做到了**速度和精度之间的最完美的平衡**。经过粗排这道关卡的过滤召回阶段,捞上来的那一万个后选视频现在只剩下了1000个,接下来会被直接送进推荐系统里最核心、最聪明的大脑精排模型
详见下篇------精排:推荐系统如何给内容打分?从多目标预估到分数融合