大促开始后,运营希望马上看到各渠道的成交变化;设备出现异常后,业务希望把刚刚发生的事件与过去一周的记录放在一起分析;数据工程师则希望直接查一查实时链路中的中间表,尽快定位指标偏差。
这些需求有一个共同点:数据已经产生,分析不应该总在等待下一次搬运。
StarRocks 与 Apache Fluss 的组合,为实时分析提供了一条更直接的路径:Fluss 承接持续变化的数据,StarRocks 提供熟悉的 SQL 分析入口;需要长期保留和历史回溯时,再结合 Paimon 构建湖流一体,让实时与历史通过同一张逻辑表进入查询。
实时分析的难点不只在查询速度
建设实时数仓时,我们通常会分别优化数据接入、计算和查询。但对业务来说,真正重要的是:一笔刚发生的交易,什么时候能出现在分析结果中。
传统链路里,事件可能已经进入 Kafka,报表所依赖的分析表却还在等待下游同步。采用湖仓架构后,数据更容易统一管理,但如果多层加工都要等上一层湖表提交后再继续,等待也可能沿着链路传递。
为了同时满足实时看板、历史分析和问题排查,团队往往又会增加数据副本和同步任务。链路越长,需要核对的进度、数据口径和运行状态就越多。
Fluss 的价值,是让持续到来的数据先成为一张可访问、可复用的表。 上游可以持续写,下游可以继续加工,分析引擎也能访问这份数据。各层流式加工可以通过 Fluss 交换结果,入湖则由独立的分层服务持续推进。这样,实时消费不必逐层等待湖表提交。参见 Fluss 湖流一体架构。
在这套组合里,各个组件的分工很清楚:Flink 负责接入与加工,Fluss 负责实时流存储,Paimon 承接长期数据,StarRocks 负责查询、关联和聚合。
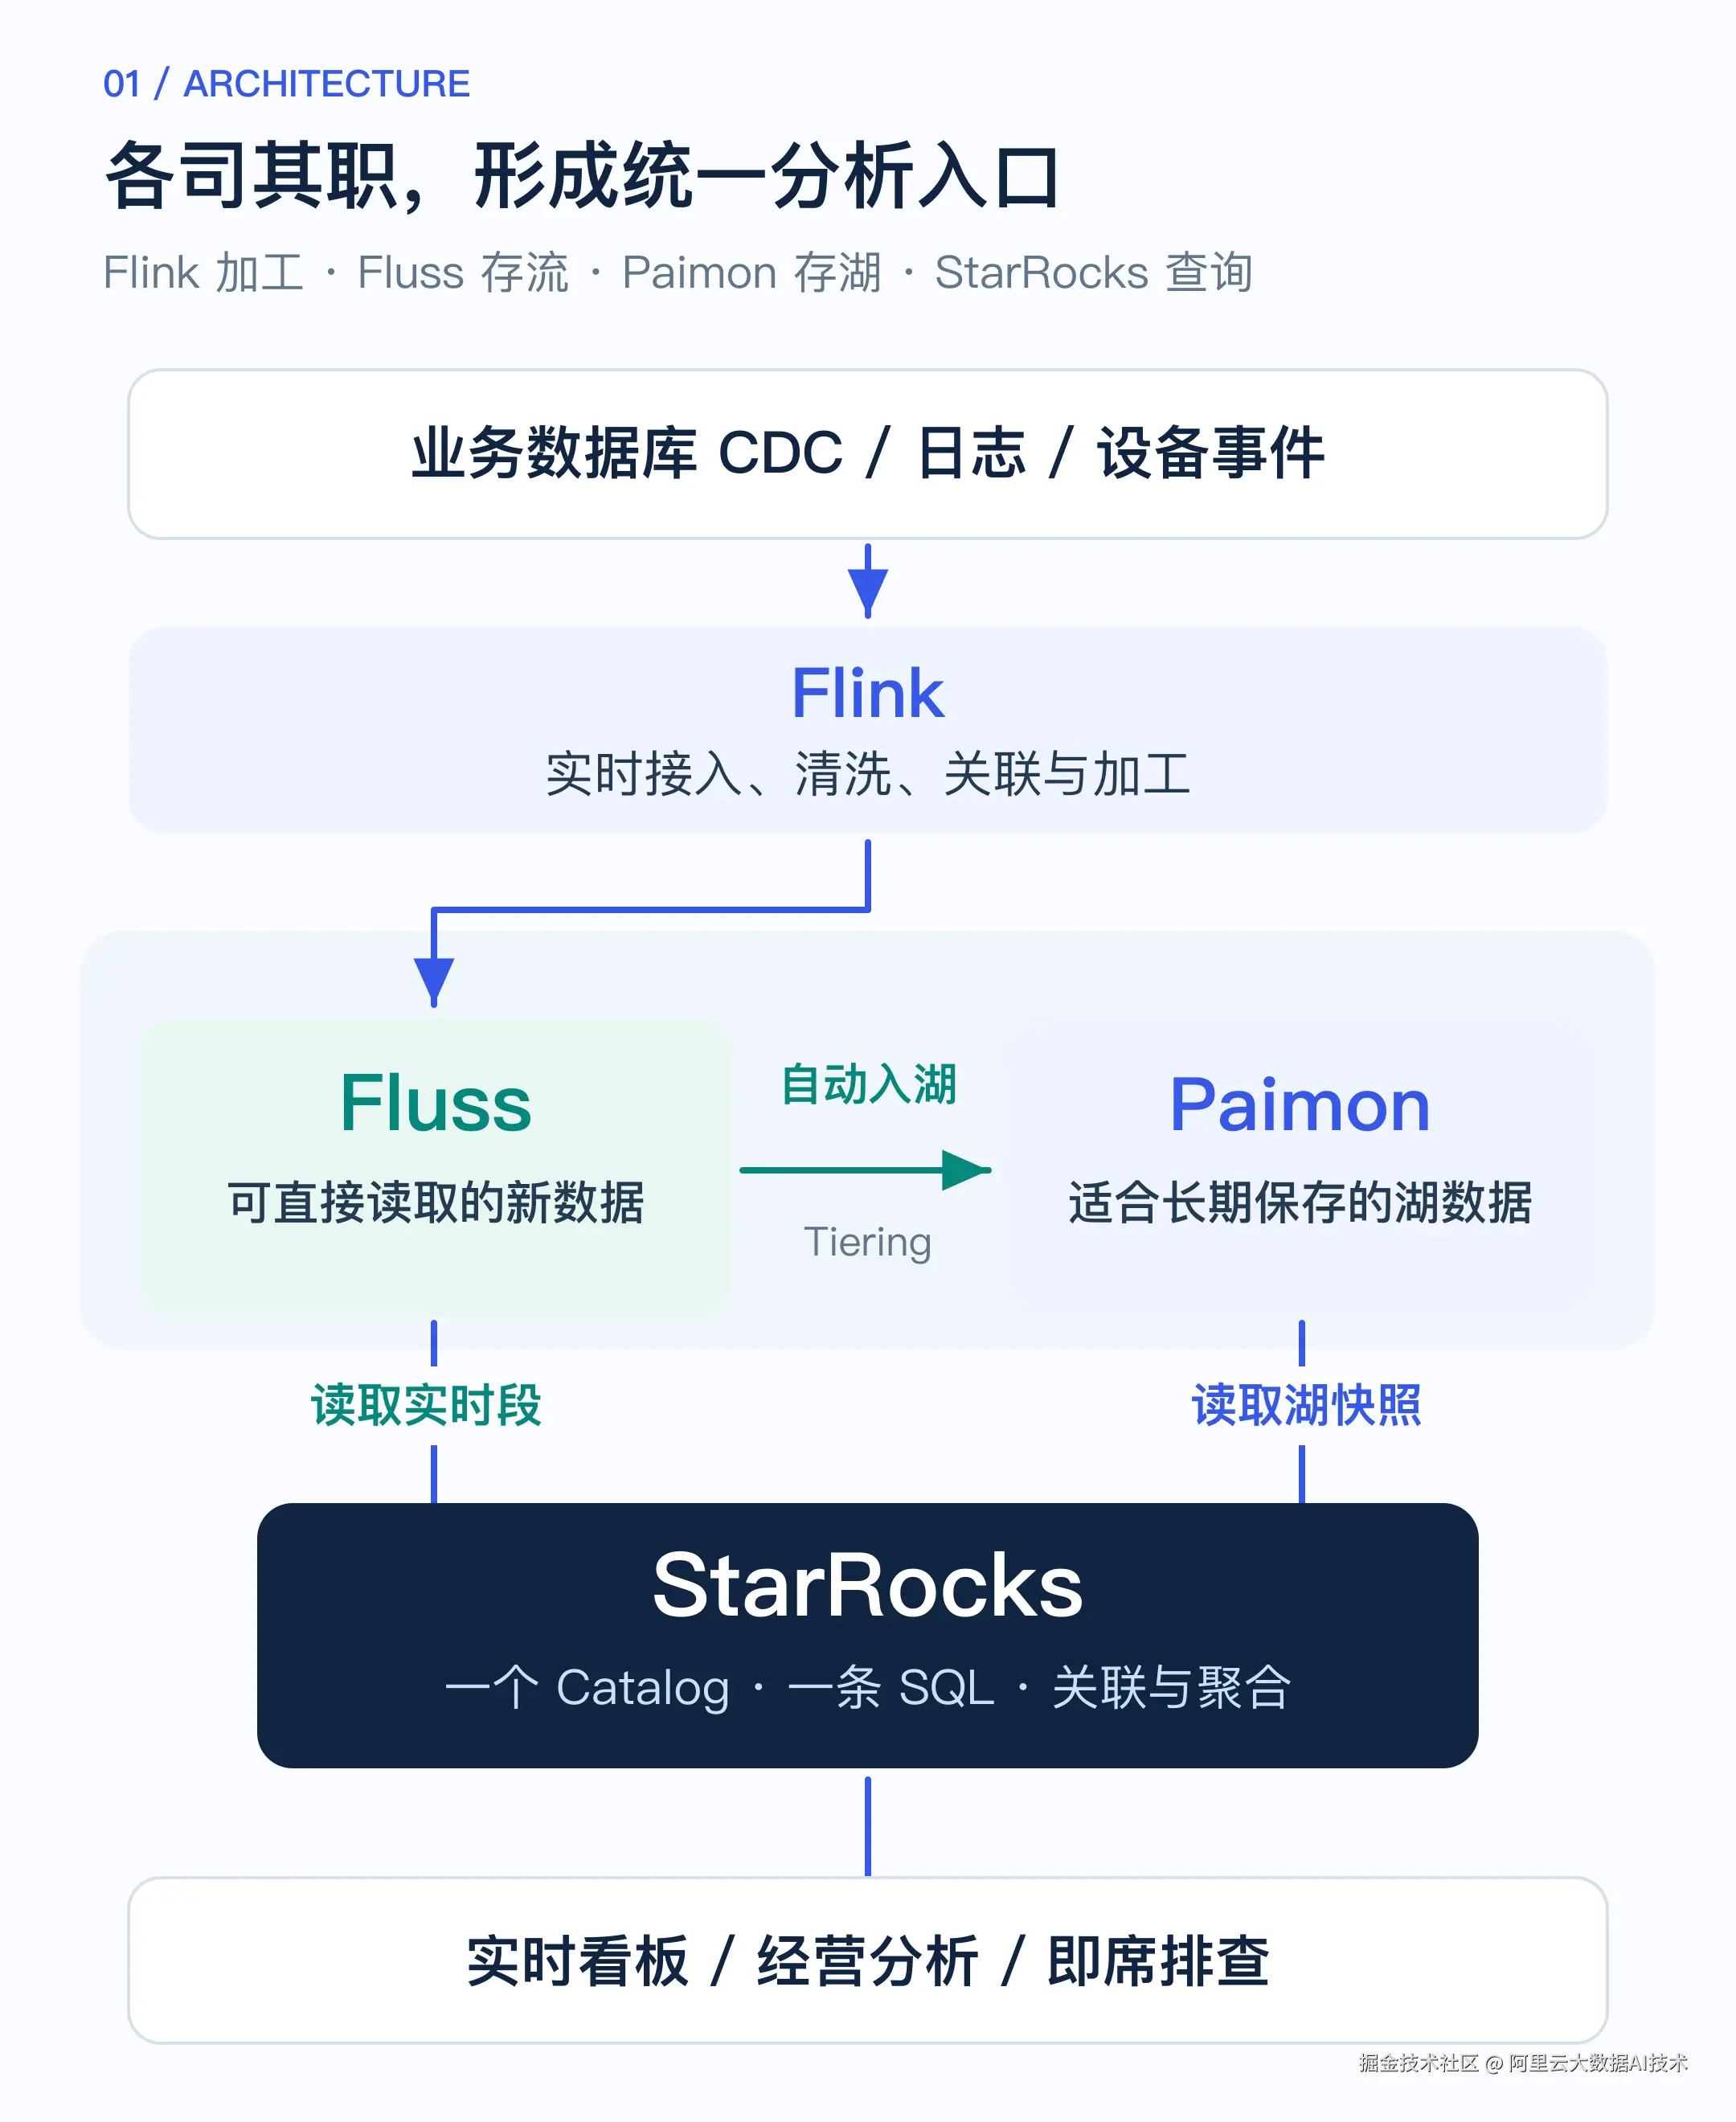
图 1:实时段与湖上数据各司其职,StarRocks 提供统一查询入口。需要湖流一体时启用入湖与相应权限配置。
可以优先从三类场景开始:
-
实时经营分析。 把刚到达的交易、支付或访问事件纳入统计,并与历史趋势一起观察。
-
实时链路排查。 用 SQL 查看日志表或加工结果,验证某批数据是否到达、某个字段是否符合预期。
-
实时与历史联合分析。 设备监控、业务异常分析既关注新变化,也需要较长时间范围的上下文。
这些是方案适用场景示例,实际收益取决于现有链路、数据规模和查询负载。
Fluss 相比 Kafka 和湖仓带来了什么
理解 Fluss,可以从用户每天要做的事情出发。
Kafka 擅长把事件可靠地交给下游。 发布订阅、服务解耦、消费回放和丰富的客户端生态,都是它的优势。如果核心需求是消息传递,Kafka 仍然是成熟的选择。
Fluss 更贴近分析型数据的组织方式。 它具备表结构,提供日志表和主键表,支持列式读取;主键表还提供更新、删除和按主键访问能力。对于持续变化的业务数据,表的语义让后续加工与访问更容易衔接。参见 Fluss 与 Kafka 官方对比。
以一张宽表为例,一次分析只关注渠道、时间、金额等少量字段时,按需读列可以减少无关数据的传输。订单状态不断变化时,主键表也能表达同一条业务记录的更新。这些都是 Fluss 作为流存储提供的基础能力;SQL 分析仍由 StarRocks 等计算引擎完成。参见 Fluss 存储与访问架构。
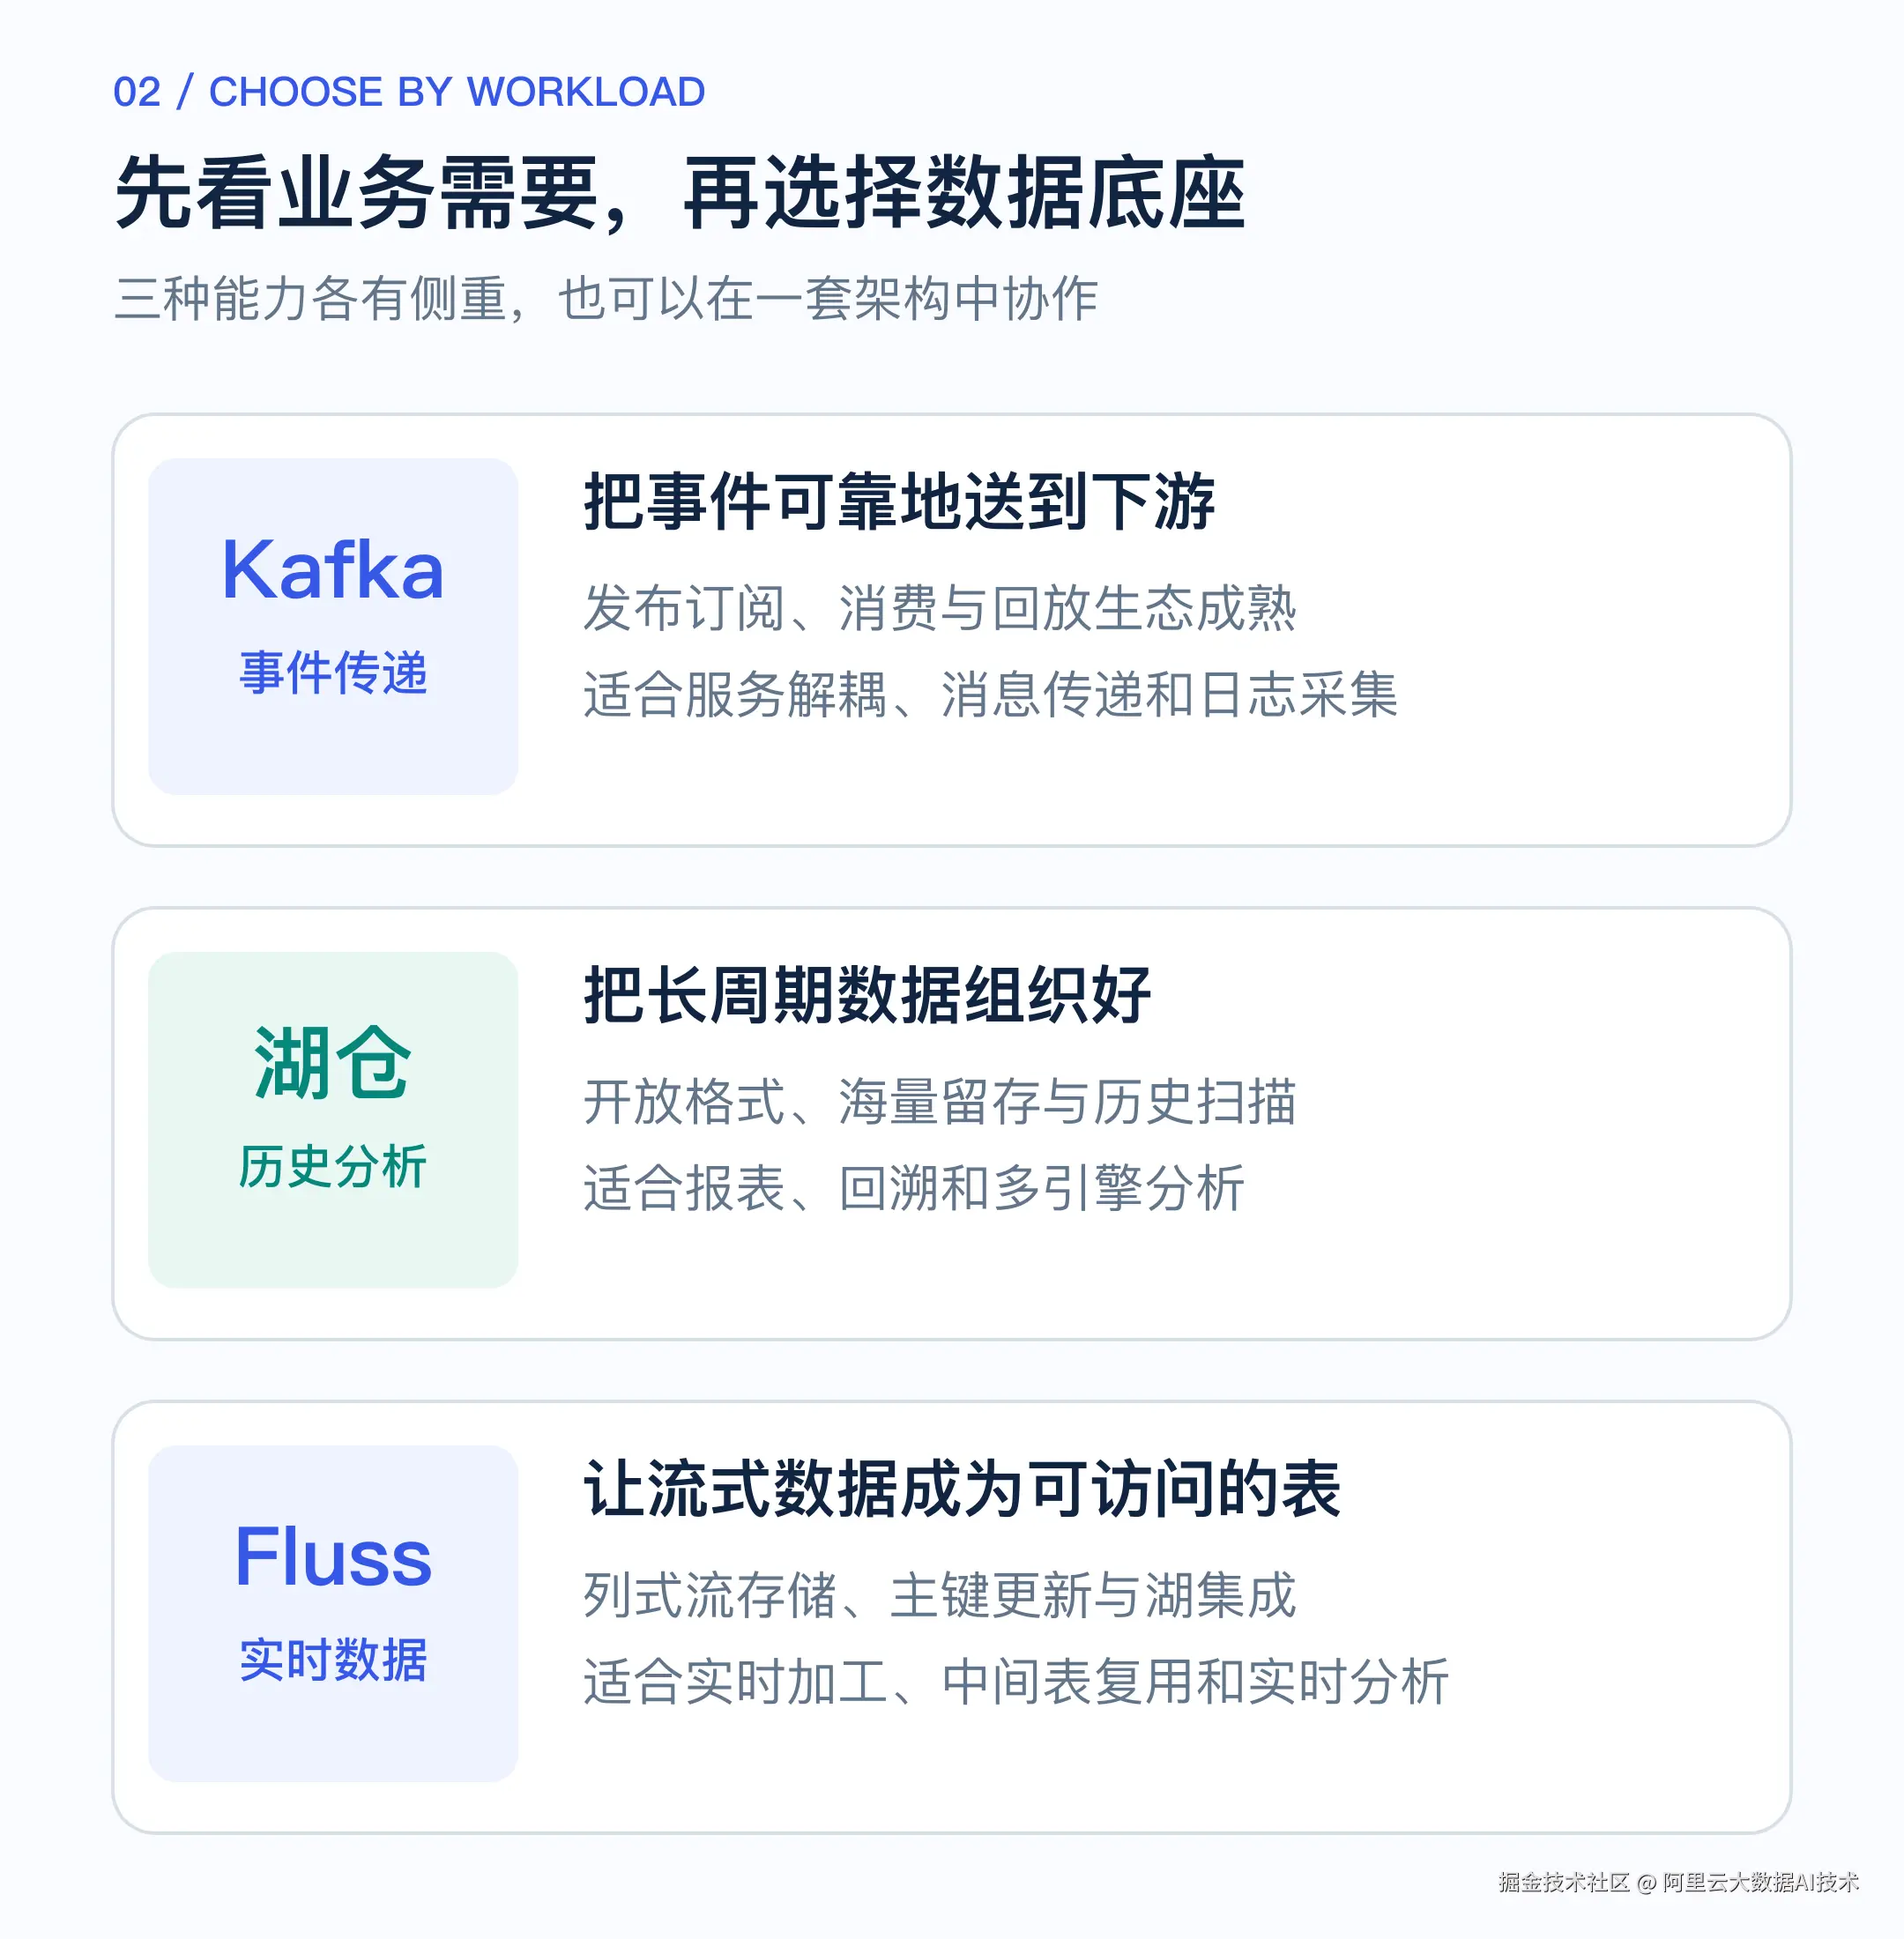
图 2:按业务需求选择能力,Kafka、Fluss 与湖仓也可以协同使用。
与湖仓组合时,Fluss 补上了对最新变化的直接访问。 Paimon 等开放湖格式适合长周期留存和历史扫描;Fluss 保留可快速访问的实时数据。启用湖流一体后,Tiering Service 持续把数据写入湖中,并维护两层之间的同步进度。参见 Fluss Tiering Service。
对用户来说,这意味着可以把高频实时访问与长期历史保存分工处理,减少为查询额外维护独立副本和同步链路的需要。节省多少成本,要结合保留周期、副本数、对象存储和计算资源一起评估。
这里的"一张表"是统一的逻辑视图。底层仍有流存储、湖存储及各自的副本与缓存,价值在于由系统协调它们,而不是要求用户手工拼接两套数据。
StarRocks 如何把 Fluss 数据变成可用的分析
建立连接后直接用 SQL 查询
StarRocks 通过 Fluss Catalog 访问 Fluss 中的数据库和表。已有数据无需先导入 StarRocks 内表,即可进入 SQL 查询流程。
开始前,需要准备好 Fluss 连接地址、认证信息和网络连通性,并确保拥有相关库表及底层存储的读取权限。使用湖流一体时,还需启用对应表的入湖能力,并确保已有可读取的湖快照。
下面是采用 SASL 账号密码认证的 Catalog 示例。地址、账号和密码需要替换为实际值:
sql
CREATE EXTERNAL CATALOG fluss_catalog
PROPERTIES (
    "type" = "fluss",
    "bootstrap.servers" = "<Fluss连接地址>:9123",
    "fluss.option.client.security.protocol" = "SASL",
    "fluss.option.client.security.sasl.mechanism" = "PLAIN",
    "fluss.option.client.security.sasl.username" = "<用户名>",
    "fluss.option.client.security.sasl.password" = "<密码>"
);
认证配置需与 Fluss 集群保持一致。网络除了发现地址外,也需要允许 StarRocks 访问 Fluss 返回的数据服务节点。
假设业务已经有一张追加写入、按 dt 分区的支付事件表 retail.payment_events,包含渠道 channel 和金额 amount,按渠道统计某一天的支付金额,可以直接写成:
sql
SELECT channel,
       COUNT(*) AS payment_count,
       SUM(amount) AS payment_amount
FROM fluss_catalog.retail.payment_events
WHERE dt = '2026-10-10'
GROUP BY channel
ORDER BY payment_amount DESC;
日期和表字段仅用于演示。对开启 Paimon 入湖的表,默认查询会合并湖上数据与实时增量;对未开启入湖的日志表,则直接读取 Fluss 中仍在保留范围内的数据。
查询接入 StarRocks 后,还可以进行筛选、聚合和排序,与 StarRocks 内表或其他已接入的数据源做关联。对于需要进一步沉淀的数据,也可以使用 INSERT INTO ... SELECT ... 将查询结果写入 StarRocks 内表,再服务后续分析。
一条 SQL 如何同时看到实时与历史
这背后的关键能力是 Union Read,也就是冷热数据合读。
可以把湖中的快照理解为一本已经整理好的账本,把 Fluss 中尚未被该快照覆盖的变化理解为后续流水。查询时,系统依据已记录的同步进度选择读取范围,将两部分衔接起来。
日志表主要需要对齐读取边界;对于主键表,还需要按更新语义处理同一条记录的变化。例如,湖中某个订单仍是"待支付",而实时段已经记录了"已支付",合读结果需要反映更新后的状态。
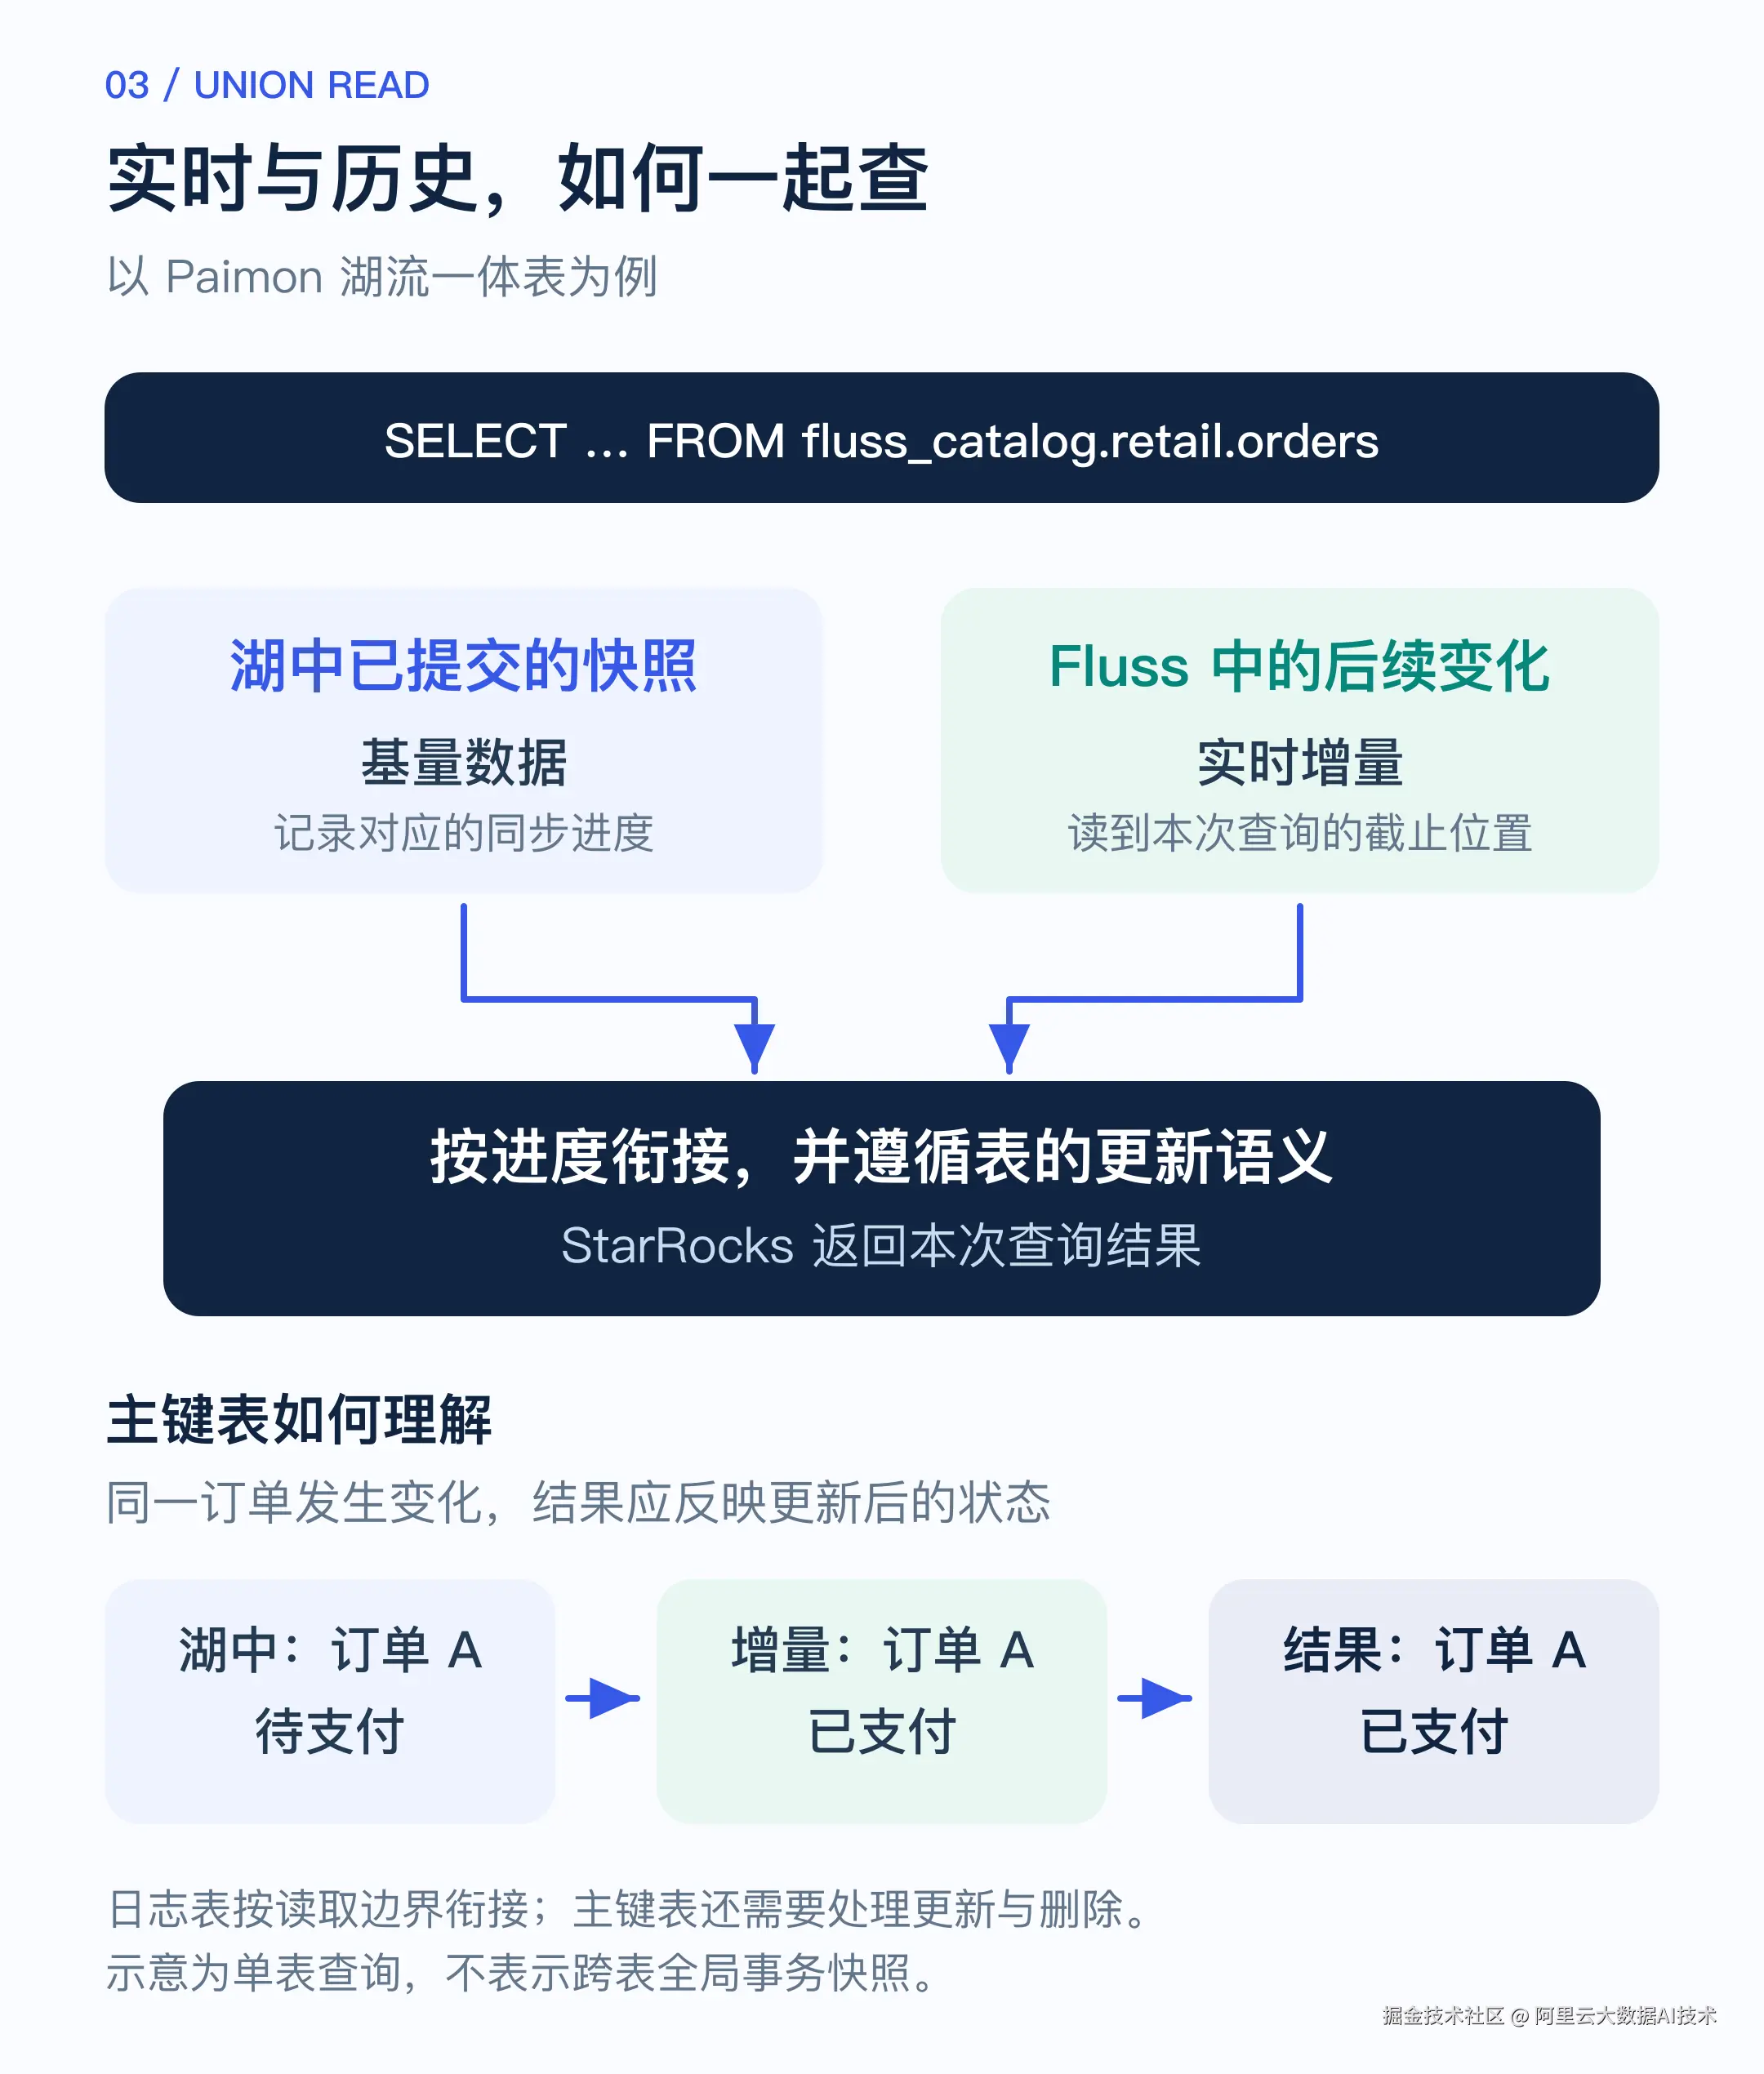
图 3:用户查询默认表名,由读取链路协调两层数据;主键表还需处理更新与删除。
这让查询可以覆盖尚未入湖的新变化,缩短数据进入分析的等待时间。数据新鲜度与 SQL 执行耗时是两个指标:前者取决于接入、加工与可见进度,后者还受扫描量、关联复杂度和资源配置影响。
日常业务分析优先使用不带后缀的默认表名。对于开启入湖的追加写日志表,如果需要分别排查两段数据,还可以使用以下入口:
sql
-- 查看本次读取计划中的湖快照部分
SELECT * FROM fluss_catalog.retail.`payment_events$lake` LIMIT 20;

-- 查看湖快照之后、本次查询范围内的实时增量
SELECT * FROM fluss_catalog.retail.`payment_events$rt` LIMIT 20;
$rt 的范围随入湖进度变化,不能用来代表"今天的全部支付"。主键表需要合并更新状态,本文也不将这两个后缀作为主键表的通用拆分读取方式。
近期升级让接入更轻量也让查询更高效
围绕 Fluss 查询,近期能力已经从基础接入继续向使用体验延伸。
首先,日志表可以先查起来,再按需要开启入湖。 对于实时排查、短周期事件分析等场景,未启用 DataLake 的 Fluss 日志表也能直接查询,初次使用不再必须先搭好完整湖流链路。需要更长时间的历史分析时,再规划入湖与保留策略。
其次,查询更注重少读无关数据。 按需选列可以减少字段读取;分区条件可以减少需要扫描的分区;能够转换的湖上过滤条件还会向下传递,让读取更早排除无关数据。例如,只分析某一天、某个渠道时,清晰的分区和过滤条件更有机会缩小访问范围。
历史数据的读取路径也在优化。 对于能够直接扫描的 Paimon 文件,StarRocks 使用原生读取路径,减少跨运行时的数据转换。对仍需要合并处理的数据,则保留相应的合并读取路径,兼顾效率与结果语义。
此外,连接复用、分区信息复用,以及对计数查询、空扫描和复杂湖分片的处理也持续完善。这些改进不要求业务改写分析逻辑,却能减少查询过程中的重复准备与边界问题。
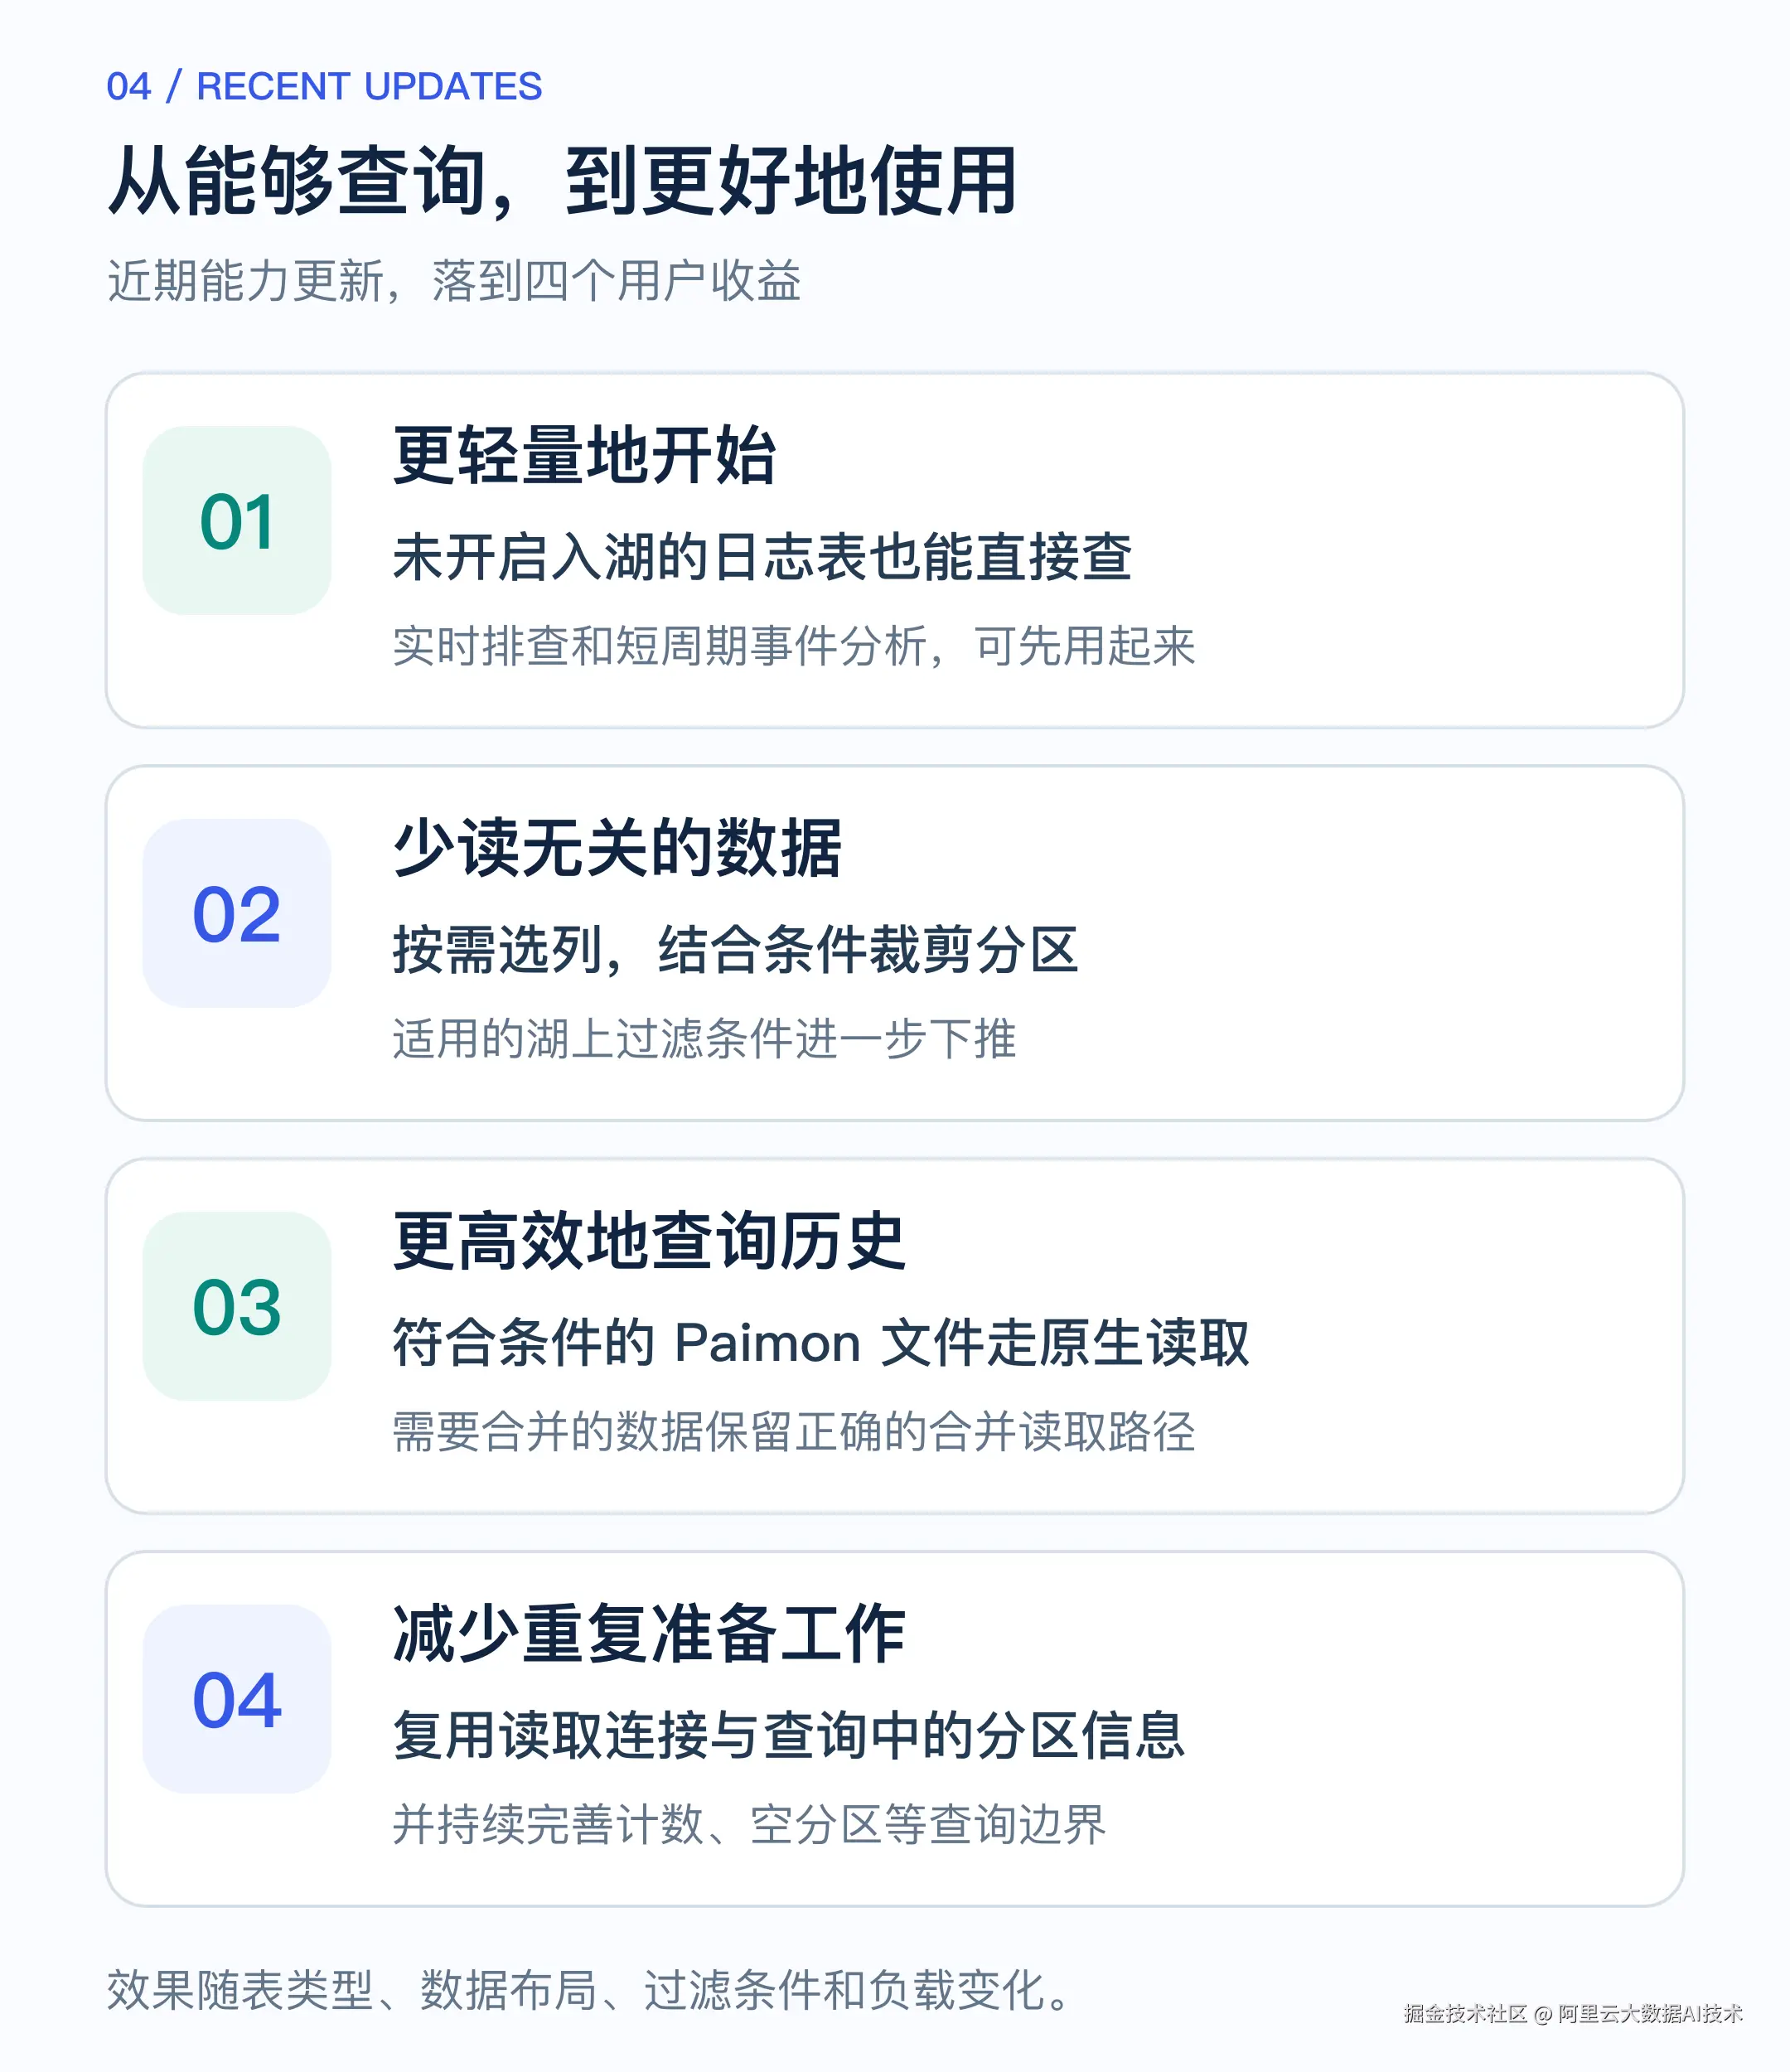
对于普通用户,一条实用的起步路径是:选一张日志表,接入 Catalog,先验证日常查询;再根据历史保留需求开启湖流一体,并用真实看板负载评估查询体验。
后续演进会重点关注什么
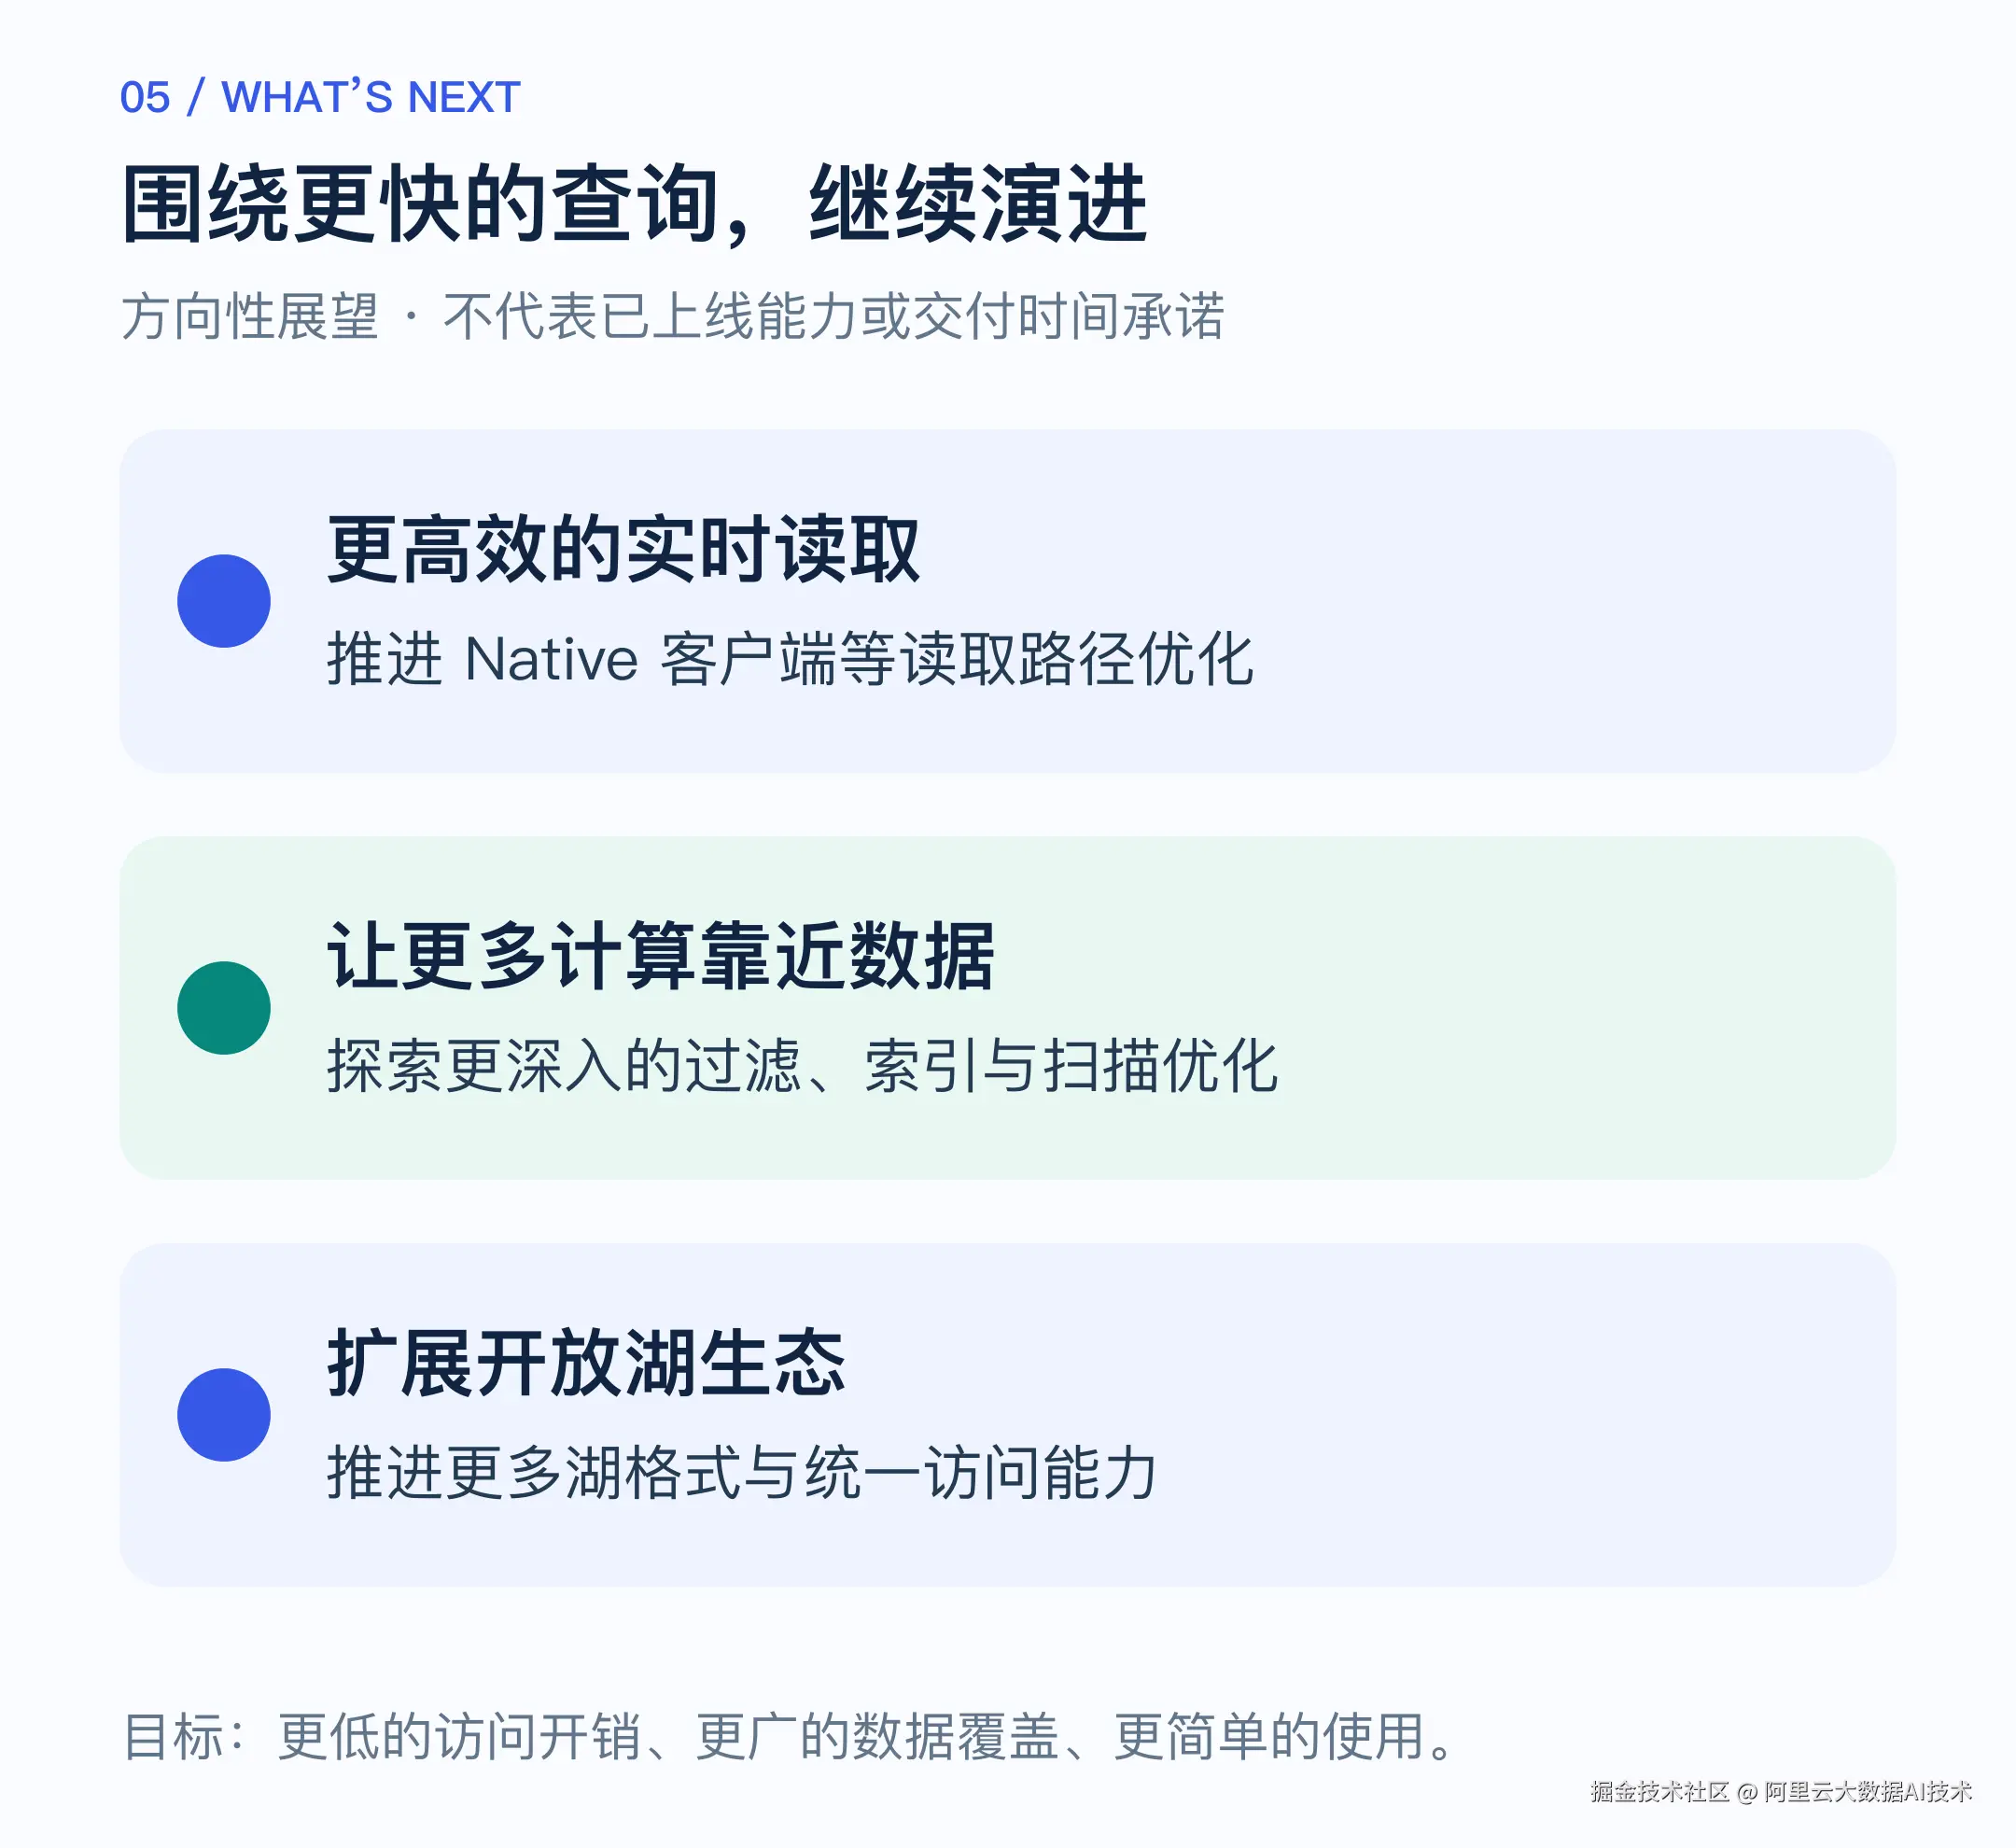
在现有接入和合读能力之上,后续值得关注的方向,是让查询访问更高效、优化更深入、可覆盖的数据形态更丰富。
更高效的实时读取。 围绕 Native 客户端和数据交换路径继续优化,减少实时数据读取中的额外开销。当前已经具备的 Paimon 文件原生读取,是湖侧优化;实时侧的 Native 接入仍应作为后续方向来理解。
让更多计算靠近数据。 Fluss 的生态规划包含更深入的过滤、聚合下推及索引能力。这些演进为分析引擎进一步减少扫描和传输提供了空间,StarRocks 中的具体支持仍需逐项落地。
扩展开放湖生态。 随着更多湖格式和统一访问能力演进,未来可以探索让更广泛的数据资产进入同一分析入口。本文介绍和展示的 StarRocks 湖流一体查询以 Paimon 为基础。
对于已经使用 StarRocks 的团队,可以先把 Fluss 中的一张实时表接进来,用熟悉的 SQL 看见刚刚发生的变化,再逐步延伸到历史回溯与联合分析。
让实时数据更容易被分析,也让已有分析更及时地用上实时数据。 这正是 StarRocks 与 Fluss 组合希望带给用户的价值。