拿到一份新数据,想先摸清楚:"大概是什么水平","波动大不大","有没有离谱的异常值"等。
很多人的第一反应是打开 Python,import pandas,read_csv,然后 describe()。
这当然没错,但为了几个数字去起一次环境、读一次文件,链路有点长------尤其当数据还躺在服务器上,或者你只是想瞄一眼的时候。
这些描述性统计信息,我们直接用系统自带的命令行工具也能直接算出来。cut 取列、sort 排序、uniq 计数、awk 做算术,四个工具拼起来基本覆盖日常九成的探查需求。
它们在 Linux、macOS、WSL 上全都现成可用,不用装任何东西,处理大文件时也不用先把整个文件读进内存。
下面用一份"每日学习打卡记录"做例子,从造数据开始,演示如何用命令行来把描述性统计要回答的三类问题跑一遍。
1. 先把数据准备好
示例数据直接模拟生成,省得去网络上下载寻找了。
下面这段直接粘进终端执行,会在当前目录生成一个 study.csv,记录 15 天的学习打卡情况:
bash
cat > study.csv << 'EOF'
date,minutes,problems,accuracy
2024-03-01,45,12,66.7
2024-03-02,60,18,72.2
2024-03-03,30,8,62.5
2024-03-04,90,25,80.0
2024-03-05,45,12,75.0
2024-03-06,120,30,86.7
2024-03-07,75,20,78.5
2024-03-08,30,9,55.6
2024-03-09,60,15,73.3
2024-03-10,45,12,70.0
2024-03-11,90,22,81.8
2024-03-12,60,16,76.5
2024-03-13,150,28,88.0
2024-03-14,45,11,68.2
2024-03-15,75,19,79.5
EOF
四个字段:日期、当天学习分钟数、做题数、正确率。
后面所有命令都基于它,主要盯第 2 列 minutes。
2. 动手之前,先确认数据长什么样
任何分析开始之前,有两件事必须先确认:一共多少条数据,以及字段顺序是不是你想的那样。
跳过这一步,后面算出来的数字再漂亮也可能是错的。
bash
wc -l study.csv          # 16 ------ 减掉 1 行表头,实际 15 条记录
head -n 5 study.csv      # 预览前 5 行,确认列含义
cut -d',' -f2 study.csv | tail -n +2   # 抽第 2 列,tail -n +2 跳过表头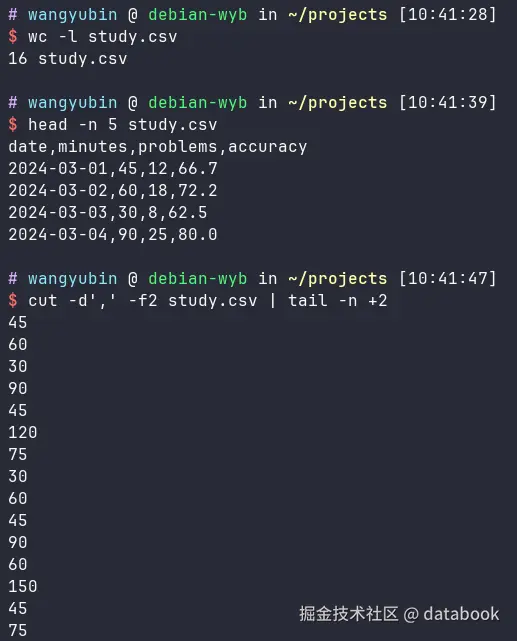
这里出现了本文最常用的一个组合:cut -d',' -f2 用逗号切分取第 2 列,tail -n +2 从第 2 行开始输出、把表头丢掉。
所有统计量几乎都是在这一串后面接一个 awk 完成的,整条链路长这样:
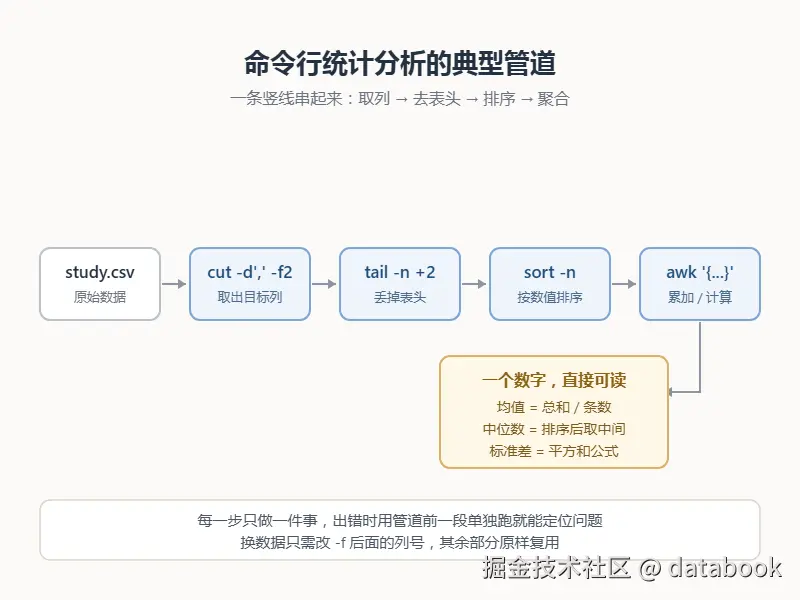
值得留意的是管道每一段都只做一件事,所以结果不对的时候,把管道截断、单独跑前几段就能快速定位是取错列了还是表头没去掉。
3. 第一类问题:数据一般落在哪
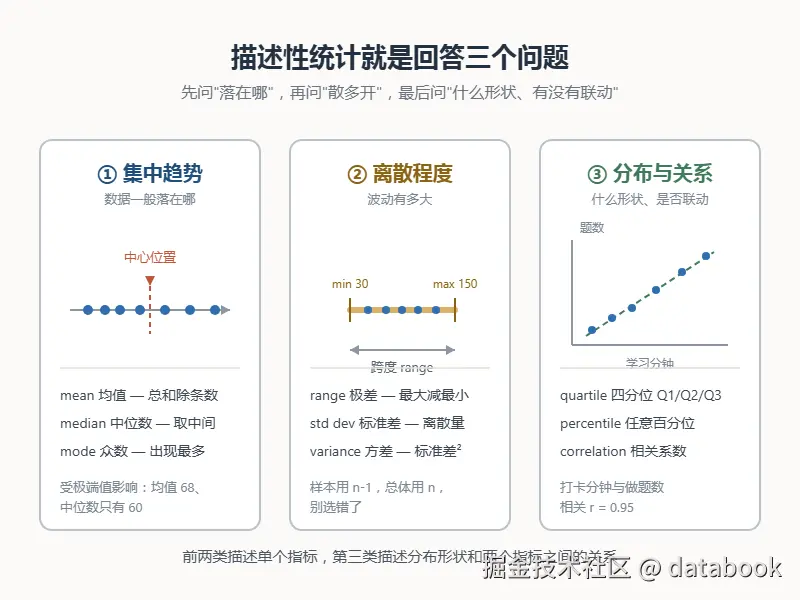
描述性统计本质上是回答三个问题,第一个是"这份数据一般落在什么位置",对应均值、中位数、众数三个数。
均值最直观,就是累加之后除以条数,用 awk 的 END 块在读完所有行之后统一输出:
bash
cut -d',' -f2 study.csv | tail -n +2 | awk '{s+=$1; n++} END {print "Mean:", s/n}'
# Mean: 68
中位数要先排序再取中间位置,所以比均值多一个 sort -n(按数值排序,不是按字典序)。
核心是排序后存进数组,奇数条取正中、偶数条取中间两个的平均:
bash
cut -d',' -f2 study.csv | tail -n +2 |  sort -n | awk '{a[NR]=$1; n=NR}
  END {if (n%2) print "Median:", a[(n+1)/2];
       else     print "Median:", (a[n/2]+a[n/2+1])/2}'
# Median: 60
众数靠 uniq -c 统计重复值出现次数,再按次数倒序取第一行:
bash
cut -d',' -f2 study.csv | tail -n +2 |  sort -n | uniq -c | sort -rn | head -n 1
# Mode: 45(出现 4 次)
三个数摆在一起就有意思了:均值 68,中位数 60,众数 45。
均值明显高于中位数,是因为 3 月 6 日和 13 日那两天冲刺了 120 和 150 分钟,把平均值往上抬了------这就是均值对极端值敏感的典型表现。
如果你只想描述"典型的一天",看中位数;如果要算总量、做预算,才用均值。
看到两者差得多,基本就能断定数据里有长尾。
4. 第二类问题:波动有多大
知道中心位置之后,下一个问题是数据散得有多开。
最省事的是极差,awk 一趟扫描就能同时拿到最小最大值:
bash
awk -F',' 'NR==2 {mn=$2; mx=$2}
  NR>2 {if ($2<mn) mn=$2; if ($2>mx) mx=$2}
  END  {print "Min:", mn, "Max:", mx}' study.csv
# Min: 30  Max: 150
极差只有两个数,容易受异常值支配,所以更常用的是标准差。
命令行里不用真的去算每个值的偏差,用平方和公式一趟搞定:
bash
# 总体标准差:sqrt(Σx²/n − 均值²)
awk -F',' 'NR>1 {s+=$2; q+=$2*$2; n++}
  END {m=s/n; print sqrt(q/n - m*m)}' study.csv      # 32.34

# 样本标准差:贝塞尔校正,除以 n−1
awk -F',' 'NR>1 {s+=$2; q+=$2*$2; n++}
END {print sqrt((q - s*s/n)/(n-1))}' study.csv # 33.48这两个的区别值得记住:你这 15 天就是全部研究对象时用总体版本(除以 n);这 15 天只是从更长时间里抽出来的样本、想估计总体波动时用样本版本(除以 n−1)。
日常记打卡、看监控,绝大多数情况都属于后者。
方差就是标准差的平方,把 sqrt 去掉即可,这份数据是 1046。
标准差 32 分钟放在均值 68 旁边,说明波动相当剧烈:差不多有均值的一半。
单看"平均每天学 68 分钟"会以为自己很稳定,加上这个数才能看出其实是"有时 30 分钟、有时 150 分钟"。
5. 第三类问题:什么形状,指标之间有没有联动
前两类都在描述单个指标,第三类要看分布的形状,以及两个指标之间的关系。
分位数是最实用的形状描述工具。排序后按位置取值,就能拿到 Q1、Q2、Q3:
bash
cut -d',' -f2 study.csv | tail -n +2 | sort -n | awk '{a[NR]=$1; n=NR}
  END {print "Q1:", a[int((n+1)/4)],
             "Q2:", a[int((n+1)/2)],
             "Q3:", a[int(3*(n+1)/4)]}'
# Q1: 45   Q2: 60   Q3: 90
把位置公式里的系数换成一个变量,就变成任意百分位。
位置落在两个数之间时按比例插值,比直接取整更准:
bash
P=90
cut -d',' -f2 study.csv | tail -n +2 | sort -n | awk -v p=$P '{a[NR]=$1; n=NR}
  END {pos=(n+1)*p/100; i=int(pos); f=pos-i
       print "P"p":", a[i] + f*(a[i+1]-a[i])}'
# P90: 132
P90 = 132 的读法是"九成的日子学习时长在 132 分钟以内"。
换成运维场景,这就是 P99 响应时间;换成销售场景,就是头部 10% 订单的门槛。
最后看两个指标之间的关系。
多列同时求均值只是多开几个累加器,而皮尔逊相关系数把协方差除以两个标准差的乘积,就能得到 -1 到 1 之间的联动强度:
bash
awk -F', *' 'NR>1 {x[NR-1]=$2; y[NR-1]=$3; sx+=$2; sy+=$3; n++}
  END {mx=sx/n; my=sy/n
       for (i=1;i<=n;i++) {dx=x[i]-mx; dy=y[i]-my
         cov+=dx*dy; vx+=dx*dx; vy+=dy*dy}
       print "Correlation:", (cov/n)/(sqrt(vx/n)*sqrt(vy/n))}' study.csv
# Correlation: 0.9505
学习分钟数和做题数的相关系数是 0.95,接近 1,说明两者几乎同步变化------多花时间确实多做题,没有什么"耗时长但产出低"的日子。
注意相关不等于因果,它只能告诉你两个指标一起动,不能说明谁导致谁。
6. 补充说明
最后再强调下命令行定位的问题。
命令行这套东西是拿来做快速探查和数据校验的:拿到文件先看一眼量级、范围、分布有没有明显异常,几秒钟就有结论。
真正要做建模、画图、跑假设检验,还是回到 Python 和 R 更合适。
两者不是替代关系------先命令行摸清数据长什么样,再决定后面用什么方法处理它,这条顺序通常更省时间。