十五年数据库相关经验,做过 DBA、架构师、技术顾问。不求"颠覆",只求"靠谱"。
异构数据同步,很多人以为最难的是"把数据从A搬到B"。
实际上不是。数据搬运是基本功,真正让人头疼的是源库结构一直在变------新增字段、改数据类型、加索引、加约束,这些 DDL 操作源端一执行,目标端如果还是老结构,后续的 DML 就算捕获了也写不进去。
更麻烦的是异构。Oracle 的 NUMBER 到 MySQL 是 DECIMAL 还是 BIGINT?SQL Server 的 DATETIME2 到 PostgreSQL 用什么类型?一条 ALTER TABLE 在不同数据库上的语法、数据类型、默认值写法完全不同。源端跑得通的 DDL,原样送到目标端大概率直接报错。
几条链路的时候,人工分析 SQL、写转换规则、验证后再恢复链路,还能应付。放到 260+ 条长期运行的链路里,这就是一项只增不减的运维工作。
最近在一个大型医院数据汇聚项目里碰到了这个场景:源端涉及 Oracle、MySQL、SQL Server、金仓 KES、Vastbase 等 10 多种数据库,260+ 条同步链路持续向目标库汇聚数据。DDL 自动转换是这个项目交付的关键环节之一。今天把这套机制的完整逻辑讲清楚------DDL 怎么拆、异构差异怎么映射、目标端 DDL 怎么生成、执行失败怎么处理。
01 为什么正则替换搞不定 DDL 转换
很多人做 DDL 转换的第一反应是:字符串替换。遇到 Oracle 的 NUMBER 换成 DECIMAL,遇到 DATE 换成 DATETIME------写一堆正则规则。
简单 DDL 没问题。但生产环境的 DDL 不会这么干净。一条 ALTER TABLE 可能同时做三件事:改字段 A 的类型、给字段 B 加默认值、给字段 C 加约束。继续按字符串处理,匹配条件只会越叠越多,规则之间还会打架。
踩坑提醒:正则替换的本质是在源 SQL 上做修改------删一段字符、换个关键词、改个类型。它不理解这条 SQL 的结构,只知道"看到 X 就换成 Y"。遇到嵌套结构、多操作合并、数据库特有语法,正则就会失效。
实测对比:
| 维度 | 正则替换 | 结构化解析 |
|---|---|---|
| 单字段类型修改 | 有效 | 有效 |
| 多字段同时修改 | 规则膨胀,容易漏匹配 | 逐字段拆解,不遗漏 |
| 数据库特有语法 | 需要为每种语法单独写规则 | 统一解析为结构信息 |
| 规则冲突 | 多条规则可能互相覆盖 | 结构化后无冲突 |
| 扩展新数据库 | 要加一套新正则规则 | 增加一组映射规则即可 |
小结:DDL 转换不能靠堆字符串规则。必须先搞清楚这条 SQL 到底做了什么,再做后续处理。
02 第一步:拆解 DDL 的结构信息
正确的做法是先"拆"。
在源端增量解析过程中,系统先判断这次变化是 DML 还是 DDL。对 DDL,继续拆成更细的结构信息:
- DDL 类型:ALTER TABLE、CREATE INDEX、DROP COLUMN 等
- 操作对象:哪张表、哪个索引
- 字段动作:新增、修改、删除、重命名
- 数据类型:源类型、目标类型映射
- 默认值和约束:NOT NULL、DEFAULT、CHECK、UNIQUE 等
sql
源端 DDL:
ALTER TABLE patients
    MODIFY age NUMBER(5) NOT NULL DEFAULT 0,
    ADD gender VARCHAR2(1) DEFAULT 'U',
    DROP COLUMN old_field;

拆解为结构信息:
{
  type: "ALTER TABLE",
  table: "patients",
  operations: [
    { action: "MODIFY", column: "age", type: "NUMBER(5)",
      constraints: ["NOT NULL", "DEFAULT 0"] },
    { action: "ADD", column: "gender", type: "VARCHAR2(1)",
      default: "'U'" },
    { action: "DROP", column: "old_field" }
  ]
}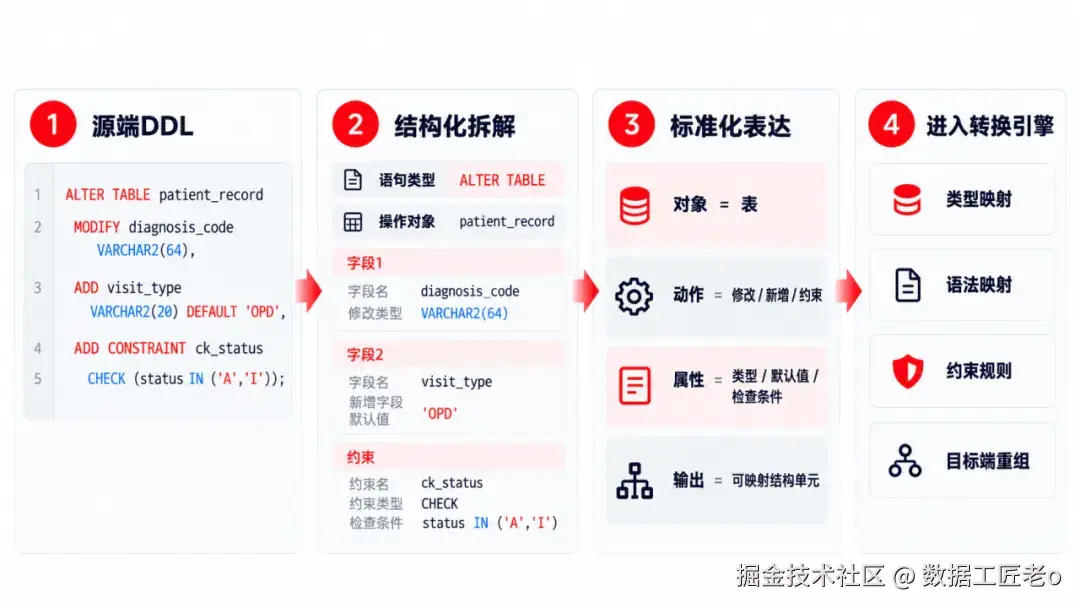
拆完之后,后面所有处理依据的都是"结构到底变了什么",不再是猜源 SQL 该怎么改。
踩坑提醒:拆解过程中要注意复合操作。一条 ALTER TABLE 里可能同时有 ADD、MODIFY、DROP 多个操作,必须逐个拆成独立的结构单元,不能当成一个整体处理。
小结:拆解是 DDL 转换的基础。结构信息拆得越清楚,后续映射和重构越准确。
03 第二步:异构数据库的差异映射
数据库之间的差异分两类。
第一类:稳定、反复出现的差异。 数据类型对应、基础 DDL 语法差异。这些适合内置到产品里,不需要每个项目重配。
| Oracle | MySQL | SQL Server | PostgreSQL/KES |
|---|---|---|---|
| NUMBER(p,s) | DECIMAL(p,s) | DECIMAL(p,s) | NUMERIC(p,s) |
| VARCHAR2(n) | VARCHAR(n) | NVARCHAR(n) | VARCHAR(n) |
| DATE(含时分秒) | DATETIME | DATETIME2 | TIMESTAMP |
| CLOB | LONGTEXT | NVARCHAR(MAX) | TEXT |
| SYSDATE | NOW() | GETDATE() | CURRENT_TIMESTAMP |
第二类:带着项目特征的差异。 字段精度、长度、特殊默认值、业务定制约束------这些通用规则覆盖不了,需要按项目配置。
在金仓 KFS 的实现里,这两类映射都有覆盖。内置规则处理 Oracle、MySQL、SQL Server、KES、Vastbase 等常见数据库之间的类型和语法差异,项目级的特殊规则单独配置。260+ 条链路里,大量源库之间的类型差异是重复的,沉淀到产品规则库里,就不必每条链路都从零配一遍。
目前,KFS 已经覆盖建表、增删改字段、表与字段重命名、索引变更、约束增删及启停等常见结构变化。在项目典型 DDL 样本中,约 95% 的常规变化可以直接进入自动转换,只有少量带特殊默认值、复杂约束或业务定制逻辑的 DDL 需要人工补规则。 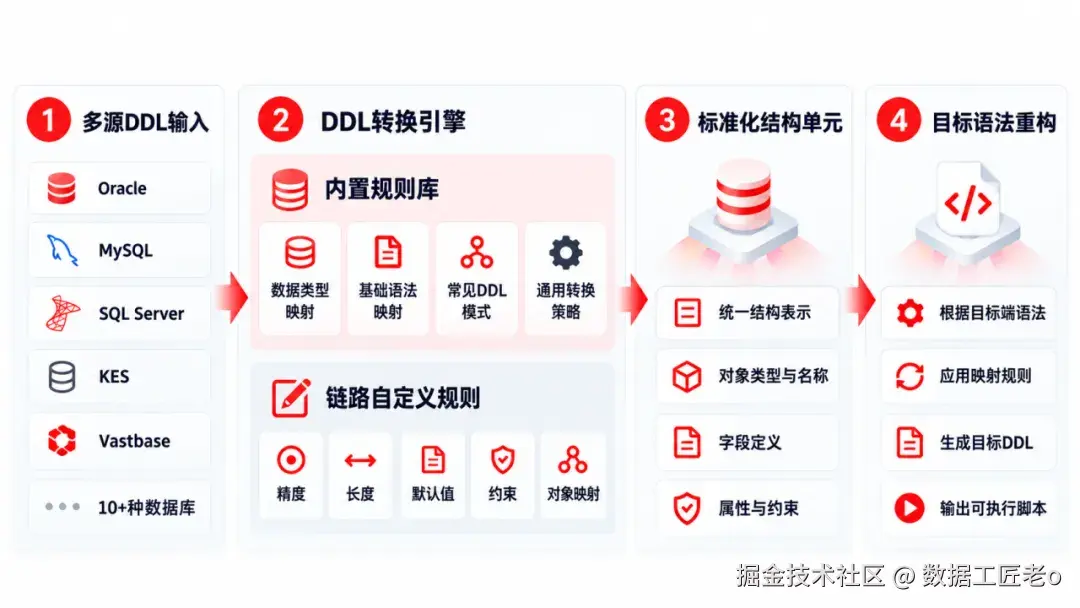
踩坑提醒:数据类型映射不是"一对一"那么简单。Oracle 的 DATE 包含时分秒,MySQL 的 DATE 只包含日期------这种语义差异必须在映射规则里体现,否则目标端写入时数据会丢精度。
小结:通用差异内置化,项目差异可配置。95% 的常规 DDL 能自动转换,剩下 5% 留给人工------这是效率和安全的平衡。
04 第三步:按目标端语法重新生成 DDL
拆解和映射完成后,最关键的一步:把结构信息重新变成目标数据库能执行的 DDL。
这一步是结构化转换和正则替换的最大区别。
正则转换在源 SQL 上修改,而结构化转换是按目标库的语法,把操作对象、字段动作、数据类型和相关规则重新组织,生成新的 DDL。
sql
结构信息(已映射):
{
  type: "ALTER TABLE",
  table: "patients",
  target_db: "MySQL",
  operations: [
    { action: "MODIFY", column: "age", type: "DECIMAL(5,0)",
      constraints: ["NOT NULL", "DEFAULT 0"] },
    { action: "ADD", column: "gender", type: "VARCHAR(1)",
      default: "'U'" },
    { action: "DROP", column: "old_field" }
  ]
}

生成目标端 DDL(MySQL):
ALTER TABLE patients
    MODIFY COLUMN age DECIMAL(5,0) NOT NULL DEFAULT 0,
    ADD COLUMN gender VARCHAR(1) DEFAULT 'U',
DROP COLUMN old_field;整个过程是:源端 DDL → 结构化解构 → 数据类型与语法映射 → 目标语法重构 → 生成目标 DDL。
源端怎么写是一回事,目标端要求怎么表达是另一回事。中间靠结构信息和映射规则解耦,同一套机制才能适应更多异构场景。这也是为什么数据库类型不断增加时,"先拆后组"比不断堆正则规则更容易扩展。 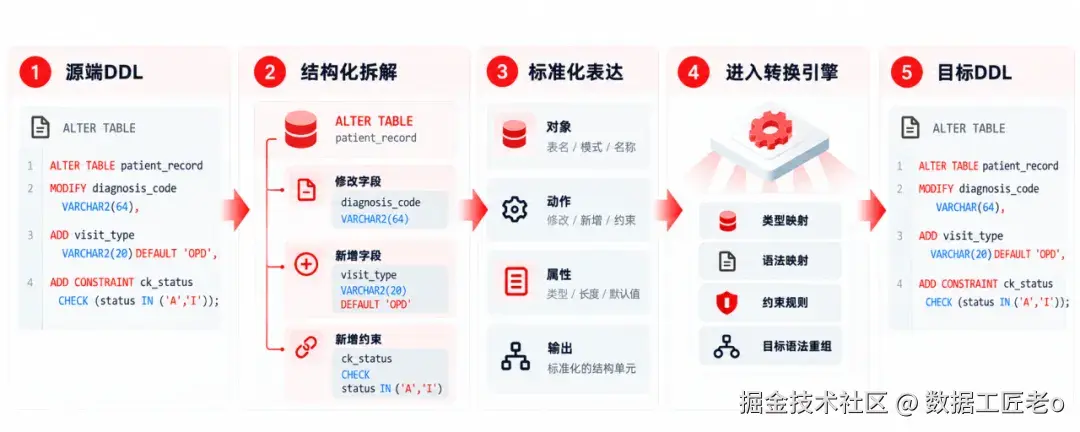
小结:生成 DDL 不是字符串替换,是按目标语法结构重新组装。源端和目标端的语法差异被结构信息解耦。
05 生成不是终点:目标端执行成功才算完成
一条 SQL 看起来"翻译对了",不代表 DDL 同步就完成了。生产环境只有一个标准:目标库能不能执行。
KFS 的处理流程是:生成目标端 DDL → 下发执行 → 检测执行结果。
成功 → 结构变化同步完成,后续 DML 按新表结构继续写入
失败 → 捕获错误信息,进入异常处理
当前规则转不了的 DDL,KFS 不会硬凑一个不确定的结果,而是保留原始 DDL 并跳过。如果后续 DML 已经依赖这次没做完的结构变化,链路会中断并进入人工干预。
这种机制对生产系统很重要。DDL 转换真正危险的,是那条转错的语句被悄悄执行,导致目标端结构与源端出现偏差,后续问题反而更难定位。
踩坑提醒:DDL 转换最可怕的不是失败,是"看起来成功但实际上不对"。比如类型映射错了但没报错,目标端存进去的数据精度丢失了,这种问题比直接报错更难排查。所以宁可保守------能确定的自动完成,不能确定的及时暴露。
在项目典型场景抽样验证中,经过自动转换的常规 DDL,目标端一次执行通过率可达到 98% 以上。剩下的 2% 通常是特殊默认值、复杂约束或者目标端不支持的语法------这些交给人工处理,比让系统硬凑更靠谱。 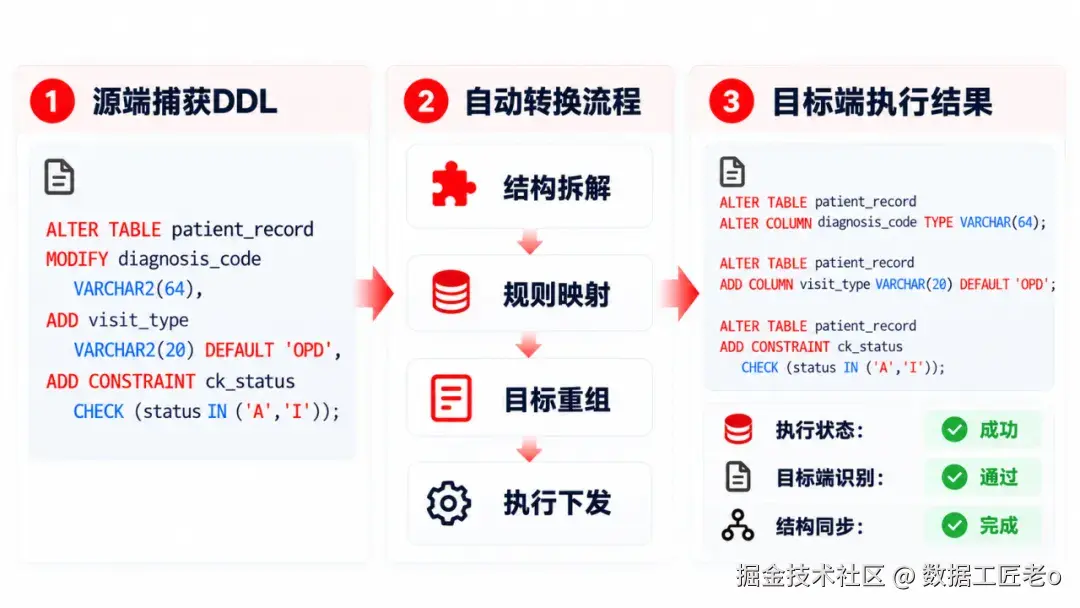
小结:执行结果是最终验证。自动转换 + 执行验证 + 异常暴露,比"全部自动"更安全。
对比:DDL 转换方案的效果和风险
| 方案 | 适用场景 | 自动覆盖率 | 维护成本 | 生产风险 |
|---|---|---|---|---|
| 纯人工分析 | 几条链路,变更少 | 0%(全人工) | 高(持续投入人力) | 低(人工可控) |
| 正则替换 | 源库类型单一,DDL 简单 | 60-70% | 中(规则持续膨胀) | 高(转换错误不易发现) |
| 结构化转换 | 多源异构,链路多,DDL 复杂 | 95% | 低(规则内置+可配置) | 低(执行验证兜底) |
决策框架:按链路规模和异构程度选择方案
| 链路数 | 源库类型 | DDL 变更频率 | 推荐方案 | 说明 |
|---|---|---|---|---|
| < 5 条 | 同构 | 低 | 人工分析 | 变更少,人工成本可控 |
| < 5 条 | 异构 | 低 | 正则替换 | 规则量不大,维护成本可接受 |
| 5-50 条 | 异构 | 中 | 结构化转换 | 人工成本开始失控,需要自动化 |
| 50+ 条 | 多源异构 | 高 | 结构化转换 + 自动执行 | 必须自动化,且需要执行验证 |
| 200+ 条 | 10+ 种数据库 | 高 | 结构化转换 + 内置规则库 | 通用差异必须产品化,否则配置量爆炸 |
深度分析:为什么"先拆后组"比正则替换更靠谱
DDL 转换的本质是"语言翻译"------把一种数据库的语法翻译成另一种数据库的语法。
正则替换的做法是"词典翻译"。 看到 NUMBER 换成 DECIMAL,看到 VARCHAR2 换成 VARCHAR。单个词没问题,但DDL 不是单词列表,它有语法结构、操作顺序、嵌套关系。一条 ALTER TABLE 里的多个操作之间有依赖关系,正则替换理解不了这种关系,只能一条一条规则硬匹配。
结构化转换的做法是"语法分析翻译"。 先理解源 DDL 的完整结构(做了什么、改了哪些字段、每个字段的类型和约束是什么),再按目标数据库的语法重新表达。这种方式的优势是:结构信息是中间层,源端语法和目标端语法都被抽象成结构信息,两者解耦。增加一种新数据库,只需要增加一组映射规则,不需要重写整个转换逻辑。
随着源端数据库类型从 3 种增加到 10 种以上,正则替换的规则量会呈指数增长(每种数据库的组合都要单独写规则),而结构化转换的规则量是线性增长(每种数据库只增加一组映射规则)。260+ 条链路的场景下,这个差异就是"能不能交付"的区别。
总结
异构数据库 DDL 同步的核心不是"把 SQL 翻译过去",是"理解结构变化,在目标端重新表达"。
正则替换在简单场景能用,但源库类型多、DDL 复杂、链路规模大时,规则会膨胀到无法维护。结构化转换先拆解 DDL 的结构信息,再做数据类型和语法映射,最后按目标端语法重新生成------源端和目标端的差异被结构信息解耦,扩展成本低。
生成的 DDL 必须下发执行验证。能确定的自动完成,不能确定的及时暴露------生产系统宁可中断,不能悄悄出错。
260+ 条链路的规模下,95% 的常规 DDL 自动转换,98% 以上的执行通过率,剩下的 5% 交给人工------这不是做不到全自动,是生产系统需要安全边界。
后续我会继续分享主备切换与故障转移、锁排查这些话题,跟着我一篇篇学,数据库这块就没问题了。
有问题评论区见。
十五年数据库领域老炮。关注我,一起把数据库这件事搞明白。