TL;DR:10 月 20 日,DeepSeek 把支撑自家线上服务的推理引擎 DeepInfer 以 Apache 2.0 开上 GitHub:vLLM 深度魔改、只服务 DeepSeek 模型族,首发支持 V4.1-Flash,英伟达 SM100 与华为昇腾 950 双栈同步适配;官方口径单集群日吞吐 155 万亿 token------注意这是自报数字,尚无第三方复现。KV cache 与分离式部署不在本次范围内,直接替换现有部署前先看清单。
想直接翻代码?
- 💻 GitHub · deepseek-ai/DeepInfer:github.com/deepseek-ai...
- 📄 官方开源索引说明:github.com/deepseek-ai...
- 🔥 Hacker News 讨论(2108 分):news.ycombinator.com/item?id=501...
这事多大:从「只给零件」到「整台交出」
先补一个背景,才能看懂这步跨得有多大。
2025 年初的 DeepSeek 开源周,官方放出了 FlashMLA、DeepEP 这类算子与通信库,但对「干脆把推理引擎整个开源」的呼声,当时的答复是明确的不:代码库从一年多前的 vLLM fork 分化得太远、和内部集群管理工具耦合太深、小团队维护带宽有限------三条理由写在 open-infra-index 的声明里,落点是「改为抽取独立组件回馈社区」。
一年半之后的现在,同一份开源索引里多了个 DeepInfer 仓库,README 第一句就是「这是驱动 DeepSeek 大规模生产服务的高性能推理框架」。当年列的三条困难并没有消失,但引擎本体还是开出来了------第一财经的标题用了「进一步」三个字,用得准确。
对部署 DeepSeek 系模型的开源推理团队来说,这是第一次能拿到官方生产级引擎,而不是对着论文和开源周零件自己拼。
引擎里到底有什么?
本次放出的是离线推理 + 规模化服务核心特性 ,当前只支持 DeepSeek-V4.1-Flash(默认拉取 DeepSeek-V4.1-Flash-1017 checkpoint)。几块值得点名的东西:
- 🚀 优化内核全家桶:FlashMLA、DeepGEMM、DeepEP 这些开源周老面孔,加上 TileKernels、DeepSelect 和 TileLang 自定义核------生产环境里真实跑过的版本。
- 🎯 MTP 草稿 + 置信度调度验证:用草稿 token 加速解码,再按置信度决定验证调度,草稿长度默认 5。这是 speculative decoding(推测解码,用小步快跑猜 + 大模型验的加速套路)的生产化实现。
- 🪞 批不变推理与确定性采样 :同一个输入换 batch 组合结果一致(
DEEPINFER_BATCH_INVARIANT=1,仅 NVIDIA)。做评测、做复现实验的人都懂这四个字的分量------多少人被「同参数不同 batch 结果漂移」坑过。 - ✂️ 解码 SWA 有界回放:prefill 只回放有界后缀(V4.1 默认保留 140 token),砍重复计算。
- 📦 结构化输出:regex / JSON Schema / EBNF 约束生成,做 Agent 和工作流的原生刚需。
并行侧是 Attention DP / 均衡 CP、MoE EP + EPLB 的组合,异步调度器默认开启。依赖清单很「2026」:Linux、Python 3.12、GCC≥13,NVIDIA 侧要 CUDA 13(SM100/Blackwell),昇腾侧要 CANN 9.2(Ascend 950)。
官方给的性能口径,怎么读?
两个数字值得摆出来。一是 X 官宣里的「单集群服务吞吐 155 万亿 token/天」;二是仓库里两张 Pareto 图------prefill 用 4×SM100、decode 用 64×SM100(各在单个 scale-up 域内),吞吐对延迟的曲线附了复现脚本。
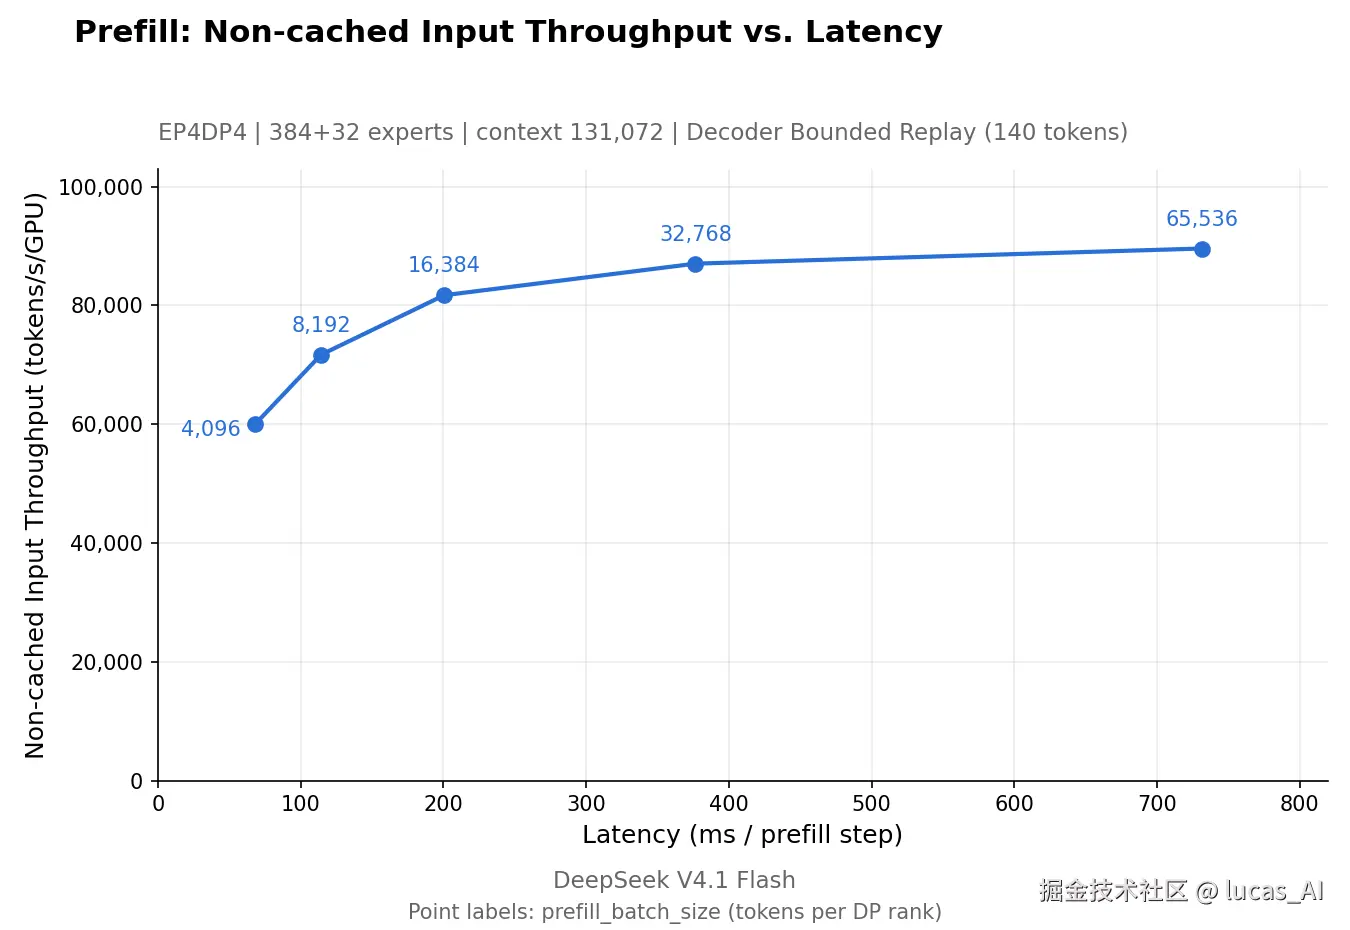
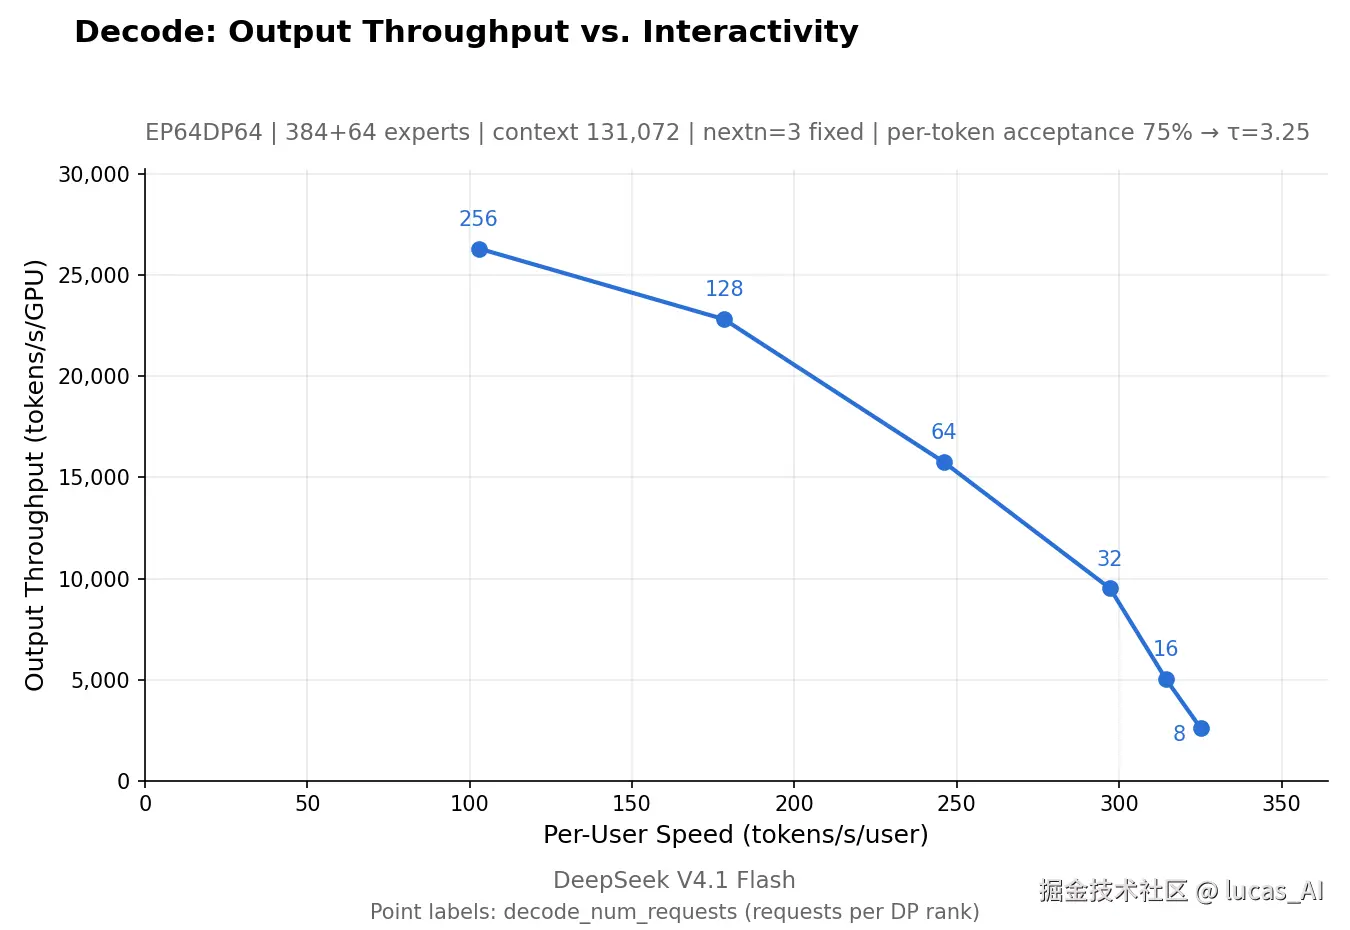
需要如实转述的两点保留:这些数字均为官方自报,目前没有第三方独立复现(TNW 与第三方字段指南 deepinfer.net 都明确点了这一点);且图表只覆盖 V4.1-Flash 在单一硬件族上的表现,「证据宽度小于讨论热度」。Hacker News 上 2108 分的热度里,相当一部分评论正是在吵这组数字背后的推理利润率------「开源模型最终会把超额利润磨薄」是反方高赞。
昇腾 950 同步首发,这件事本身就是信号
README 把 Huawei Ascend 950 NPU 与 NVIDIA SM100 并列为受支持硬件,构建脚本里 DEEPINFER_ACCELERATOR=ascend 一键切换。官方引擎背书国产算力栈,和之前 vLLM-Ascend 社区适配的路线是两个量级------对昇腾生态的推动,可能比对推理引擎本身的影响更深远。
也正因为双栈首发,「新模型发布前主动同步推理工程、社区 Day-0 SOTA 支持」这句官方承诺有了可信的载体:引擎、模型、硬件三边同步,才是这套开源打法的完整拼图。
三块不含的东西,替换部署前先看
README 主动列出了完整推理服务还缺的三块:KV cache 系统、VE/Prefill/Decode 分离式部署(大部分引擎功能已实现)、跨 DP 副本负载均衡。换句话说,DeepInfer 现在是台强力发动机,不是整车------想直接从 vLLM/SGLang 迁移的团队,先确认自己有现成的 KV cache 与调度方案,或者等官方与社区的后续拼装。
另外,2025 年声明里「小团队维护带宽有限」这句话对今天依然成立:引擎级开源项目的长期维护承诺,是接下来比性能数字更值得盯的指标 (uncertain:README 未给出维护与上游同步计划)。
参考来源
- GitHub · deepseek-ai/DeepInfer(官方仓库,Apache 2.0):github.com/deepseek-ai...
- GitHub · deepseek-ai/open-infra-index(官方开源索引与 2025 开源周声明):github.com/deepseek-ai...
- 第一财经:《DeepSeek:进一步将内部推理框架 DeepInfer 全面开源》:www.yicai.com/news/103401...
- IT之家:《DeepSeek 宣布将内部推理框架 DeepInfer 全面开源,目标实现大模型普惠》:www.ithome.com/1/015/429.h...
- Quartz:DeepSeek open-sources DeepInfer software for running its AI models:qz.com/deepseek-op...
- The Next Web:DeepSeek open-sources DeepInfer, the engine that runs its AI models:thenextweb.com/news/deepse...
- Hacker News 社区讨论(2108 分):news.ycombinator.com/item?id=501...