本文是 Android 性能原理系列的 APM 篇。前几篇我们聊过启动优化、网络请求的奇幻漂流和 Native Heap 监控,这一篇来聊一个贯穿所有场景的问题:App 在用户手机上变卡了、崩了、无响应了,你怎么知道?
源码版本约定:AOSP 部分基于
android-17.0.0_r1对应的 main 分支,BlockCanary 基于 1.5.0 的 GitHub master 源码。文中所有结论都可以在参考链接里逐行复核。
前言:深夜的餐厅与喊冤的主厨
先讲个故事。
你开了一家餐厅(一个 App)。某天后台收到一堆投诉:"上菜太慢!"(用户反馈:页面卡死)。你把主厨叫来对质,主厨一脸无辜:
"冤枉啊!我今晚一道菜都没停过,从头忙到尾!"
你无言以对------因为餐厅里没有任何记录。没有人知道 21:37 那道红烧肉到底做了多久,也没有人知道主厨那会儿是在切肉、在等冰箱解冻,还是在跟隔壁厨师抢一把刀。
解决方案很老套:在出餐口装一台打卡机。每道菜开工打一次卡,完工再打一次。哪道菜超时,机器自动回放监控录像,看看主厨当时到底卡在哪儿。
这就是 APM(Application Performance Monitoring,应用性能监控) 的全部灵魂:
- 打卡:量化每一项工作用了多久(指标);
- 录像:出问题时有现场证据(堆栈、日志);
- 上报:把记录汇总到总部,形成看板和告警(平台)。
而这台打卡机,就藏在每一个 Android 工程师都见过却很少有人细看的 API 里。今天我们把它拆开------你会发现,整个 APM 卡顿监控体系,就是围绕主线程上两行日志字符串建立起来的帝国。
本文的角色映射表
| 故事角色 | 真实世界 |
|---|---|
| 餐厅 | App 进程 |
| 主厨 | 主线程(Main Thread) |
| 订单小票队列 | MessageQueue |
| 一张订单 | Message |
| 主厨的工作循环 | Looper.loop() |
| 出餐口的打卡机 | Looper.setMessageLogging(Printer) |
| 打卡机打出的两行字 | ">>>>> Dispatching to ..." / "<<<<< Finished to ..." |
| 品控经理 | BlockCanary 的 LooperMonitor |
| 抓拍摄像头 | StackSampler(定时抓主线程堆栈) |
| 突发事件的遗言信箱 | UncaughtExceptionHandler |
| 总部 | 服务端 APM 平台 |
一、主厨的真实身份:一个死循环
要看懂卡顿监控,得先看懂主线程在干嘛。很多初学者以为主线程在"等事件",其实它是一个永不停止的 for 循环。
打开 AOSP 的 frameworks/base/core/java/android/os/Looper.java(本文基于 android-17.0.0_r1 对应的 main 分支,为便于阅读做了精简,完整逻辑位于 loopOnce() 方法):
java
public static void loop() {
final Looper me = myLooper();
// ...
for (;;) {
// 1. 从订单架上取下一张小票,没有订单时主线程会在这里休眠
final Message msg = me.mQueue.next(); // might block
if (msg == null) {
// 没有消息且队列已退出,循环结束(对主线程来说几乎不会发生)
return;
}
// 2. 【打卡:开工】这就是 APM 卡顿监控的命门
final Printer logging = me.mLogging;
if (logging != null) {
logging.println(">>>>> Dispatching to " + msg.target + " "
+ msg.callback + ": " + msg.what);
}
// 3. 真正干活的只有这一行:把消息交给目标 Handler 执行
// (执行 mRunnable、回调 handleMessage 等都发生在这一行里)
msg.target.dispatchMessage(msg);
// 4. 【打卡:完工】
if (logging != null) {
logging.println("<<<<< Finished to " + msg.target + " " + msg.callback);
}
// ...
}
}读懂了吗?主线程的每一段工作,都严格被两次 logging.println(...) 调用包夹:
- 开始执行一条消息前,打印
">>>>> Dispatching to ..."; - 执行完毕后,打印
"<<<<< Finished to ..."。
两条打卡记录之间的时间差,就是这一条消息从开始执行到执行结束的真实耗时(注意:这里测到的是消息的 dispatch 耗时,不含消息在队列里排队等待的时间,后文会详细拆解这个口径)。
系统设计者在这里留了一个精巧的机关:logging.println() 并不是写死往 Logcat 打日志,而是调用一个可以被任何人替换的接口。这个接口就是打卡机的插槽:
less
// Looper.java ------ 官方预留的"打卡机插槽",实现可以随意替换
public void setMessageLogging(@Nullable Printer printer) {
    mLogging = printer;
}
arduino
// android.util.Printer ------ 整个接口只有这一个方法
public interface Printer {
    /**
     * Write a line of text to the log in your implementation.
     */
    void println(String x);
}一行赋值语句、一个单方法接口。系统把自家日志都吐给了它------只要我们塞进自己的 Printer,主线程每一次开工、完工打卡,都会先路过我们的代码。这等于官方亲手把卡顿监控的入口递到了你手上。
顺带一提:你可能好奇不装 Printer 时这些 >>>>> 日志去哪了。答案是插槽是空的(mLogging == null),两次 if 判断直接跳过,所以默认你什么都看不到。
二、品控经理上岗:BlockCanary 如何用这台打卡机
2016 年,腾讯工程师 MarkZhai 开源了 BlockCanary(仓库名 AndroidPerformanceMonitor),第一次把"打卡机"用法完整展示给社区。虽然它已多年未更新、不能直接用于现代工程,但它的采集原理至今仍是几乎所有国产 APM 卡顿监控模块的原型(Matrix 的 Trace Canary 等都能看到它的影子)。
接入只需三行:
scala
public class DemoApplication extends Application {
    @Override
    public void onCreate() {
        super.onCreate();
        // 安装品控经理:传入业务自定义的配置(阈值等)
        BlockCanary.install(this, new AppContext()).start();
    }
}
start() 里面干的事情,就是往打卡机插槽里装上品控经理:
csharp
// BlockCanary.java(blockcanary-android 模块)
public void start() {
    if (!mMonitorStarted) {
        mMonitorStarted = true;
        // 把 LooperMonitor 这个 Printer 安装到主线程 Looper 上
        Looper.getMainLooper().setMessageLogging(mBlockCanaryCore.monitor);
    }
}
这个 monitor 的类型是 LooperMonitor,它实现了 Printer 接口。现在,主线程每次 dispatch 消息,都会走到它的 println()。
2.1 品控经理的打卡逻辑:逐行精读
来看 LooperMonitor.java 的核心------全文不到 110 行,却构建了完整的卡顿检测状态机:
java
// LooperMonitor.java(GitHub master,1.5.0)
class LooperMonitor implements Printer {
// 默认卡顿阈值:3 秒
private static final int DEFAULT_BLOCK_THRESHOLD_MILLIS = 3000;
private long mBlockThresholdMillis = DEFAULT_BLOCK_THRESHOLD_MILLIS;
private long mStartTimestamp = 0; // 开工打卡:墙上时钟
private long mStartThreadTimestamp = 0; // 开工打卡:主厨的手表(线程 CPU 时间)
private BlockListener mBlockListener = null;
private boolean mPrintingStarted = false; // 状态机:当前处于"开工"还是"完工"
private final boolean mStopWhenDebugging; // 调试器挂上时停止工作,防止误报
@Override
public void println(String x) {
// 调试时直接跳过:单步调试、断点挂起会让 dispatch 时间虚高
if (mStopWhenDebugging && Debug.isDebuggerConnected()) {
return;
}
if (!mPrintingStarted) {
// ① 收到 ">>>>> Dispatching to ...":某条消息开工
mStartTimestamp = System.currentTimeMillis(); // 墙上时钟
mStartThreadTimestamp = SystemClock.currentThreadTimeMillis(); // 线程 CPU 时钟
mPrintingStarted = true;
startDump(); // ② 通知"摄像头"开始定时抓拍主线程堆栈
} else {
// ③ 收到 "<<<<< Finished to ...":这条消息干完了
final long endTime = System.currentTimeMillis();
mPrintingStarted = false;
if (isBlock(endTime)) { // ④ 判断是否超过阈值
notifyBlockEvent(endTime); // ⑤ 超时:转交后台线程组装报告
}
stopDump(); // ⑥ 摄像头停止工作
}
}
private boolean isBlock(long endTime) {
return endTime - mStartTimestamp > mBlockThresholdMillis;
}
}整个状态机可以浓缩成一句话:
看到
>>>>>就开始计时并开摄像头;看到<<<<<就停止计时,超时就出报告。
有几个细节值得停下来体会:
- 为什么需要
mPrintingStarted这个布尔值? 因为println()只是一个单方法接口,BlockCanary 不去解析字符串内容(解析">>>>>"前缀是后来的框架如 Matrix 才做的优化),而是靠调用次序推断:第一次调用一定是开工,第二次一定是完工。交替往复。 startDump()里启动的是谁? 下文的抓拍摄像头------StackSampler(抓堆栈)和CpuSampler(抓 CPU 使用率)。notifyBlockEvent()为什么不直接处理? 看它的实现:
java
private void notifyBlockEvent(final long endTime) {
    final long startTime = mStartTimestamp;
    final long startThreadTime = mStartThreadTimestamp;
    final long endThreadTime = SystemClock.currentThreadTimeMillis();
    // 关键:把组装报告的工作 post 到专门的写日志线程
    HandlerThreadFactory.getWriteLogThreadHandler().post(new Runnable() {
        @Override
        public void run() {
            mBlockListener.onBlockEvent(startTime, endTime, startThreadTime, endThreadTime);
        }
    });
}注意这里的克制:println() 本身跑在主线程上 ,如果在这里做 IO、序列化,就等于品控经理每次打卡都要亲自跑去档案室写报告------打卡机本身成了卡顿源。所以它只收集四个时间戳,然后把脏活累活扔给后台线程。这是所有 APM 采集代码的铁律:主线程回调里只允许 O(1) 的轻量操作。
2.2 摄像头的工作时间表:不是从开工就开始抓拍
接下来的问题:主线程卡住时,怎么"看到"它卡在哪?答案很朴素------隔一段时间给主线程拍一张"堆栈照片" 。
但抓拍不是从消息开工就开始的。看调度逻辑 AbstractSampler.java:
csharp
// AbstractSampler.java
abstract class AbstractSampler {
private static final int DEFAULT_SAMPLE_INTERVAL = 300; // 默认每 300ms 拍一张
protected AtomicBoolean mShouldSample = new AtomicBoolean(false);
protected long mSampleInterval;
private Runnable mRunnable = new Runnable() {
@Override
public void run() {
doSample(); // 拍一张
if (mShouldSample.get()) {
// 没收到停止指令,就安排下一张
HandlerThreadFactory.getTimerThreadHandler()
.postDelayed(mRunnable, mSampleInterval);
}
}
};
public void start() {
if (mShouldSample.get()) {
return;
}
mShouldSample.set(true);
HandlerThreadFactory.getTimerThreadHandler().removeCallbacks(mRunnable);
// 注意!第一张照片延迟 getSampleDelay() 才拍,不是立刻拍
HandlerThreadFactory.getTimerThreadHandler().postDelayed(mRunnable,
BlockCanaryInternals.getInstance().getSampleDelay());
}
public void stop() {
if (!mShouldSample.get()) {
return;
}
mShouldSample.set(false);
HandlerThreadFactory.getTimerThreadHandler().removeCallbacks(mRunnable);
}
abstract void doSample();
}第一张照片延迟多久才拍?答案是阈值 × 0.8:
csharp
// BlockCanaryInternals.java
long getSampleDelay() {
    return (long) (BlockCanaryInternals.getContext().provideBlockThreshold() * 0.8f);
}
为什么是 0.8?这是个漂亮的工程取舍:消息只要没超过阈值,就不值得出报告。如果阈值是 5 秒,一条 1 秒就干完的消息,前 0.8 秒里拍的照片全是废片------反正不会生成报告,白拍还白耗 CPU。所以摄像头被设计成"等消息大概率要超时了(80% 阈值时刻),再开始连拍"。既保证了超时消息必有现场,又不为正常消息付一分钱。
而拍照这个动作本身,就是读一次线程堆栈:
scss
// StackSampler.java
@Override
protected void doSample() {
    StringBuilder stringBuilder = new StringBuilder();
    // "拍照" = 读取主线程此刻的调用栈
    for (StackTraceElement stackTraceElement : mCurrentThread.getStackTrace()) {
        stringBuilder.append(stackTraceElement.toString()).append(BlockInfo.SEPARATOR);
    }
    synchronized (sStackMap) {
        // 相册最多存 100 张,满了就丢最旧的
        if (sStackMap.size() == mMaxEntryCount && mMaxEntryCount > 0) {
            sStackMap.remove(sStackMap.keySet().iterator().next());
        }
        sStackMap.put(System.currentTimeMillis(), stringBuilder.toString());
    }
}
两个要点:
mCurrentThread是主线程对象 (在BlockCanaryInternals构造时通过Looper.getMainLooper().getThread()拿到的)。任何线程都可以调用thread.getStackTrace()读别的线程的栈------这正是"后台线程给卡住的主线程拍照"的原理,主线程甚至感知不到。- 相册
sStackMap是一个 LinkedHashMap,上限 100 张,防止长时间卡顿时照片堆积把内存吃爆。
最后,报告在后台组装完毕:
less
// BlockCanaryInternals.java ------ 构造函数里注册的 BlockListener
public BlockCanaryInternals() {
stackSampler = new StackSampler(
Looper.getMainLooper().getThread(), // 拍摄对象:主线程
sContext.provideDumpInterval()); // 拍摄间隔
cpuSampler = new CpuSampler(sContext.provideDumpInterval());
setMonitor(new LooperMonitor(new LooperMonitor.BlockListener() {
@Override
public void onBlockEvent(long realTimeStart, long realTimeEnd,
long threadTimeStart, long threadTimeEnd) {
// 把卡顿时间窗内的所有"照片"捞出来
ArrayList<String> threadStackEntries = stackSampler
.getThreadStackEntries(realTimeStart, realTimeEnd);
if (!threadStackEntries.isEmpty()) { // 一张照片都没有,就不出报告
BlockInfo blockInfo = BlockInfo.newInstance()
.setMainThreadTimeCost(realTimeStart, realTimeEnd,
threadTimeStart, threadTimeEnd) // 两个时钟的耗时
.setCpuBusyFlag(cpuSampler.isCpuBusy(realTimeStart, realTimeEnd))
.setRecentCpuRate(cpuSampler.getCpuRateInfo()) // CPU 占用
.setThreadStackEntries(threadStackEntries) // 堆栈照片
.flushString();
LogWriter.save(blockInfo.toString()); // 落盘
// ... 依次经过拦截器链(显示通知 / 上报)
}
}
}, getContext().provideBlockThreshold(), getContext().stopWhenDebugging()));
}打开 BlockCanary 的通知,你会看到一份完整的"事故报告":卡顿时长、CPU 是否繁忙、以及一串按时间排列的堆栈照片------最后一张照片指向的代码行,通常就是卡顿元凶。
三、全景时序图:一次卡顿监控的完整生命周期
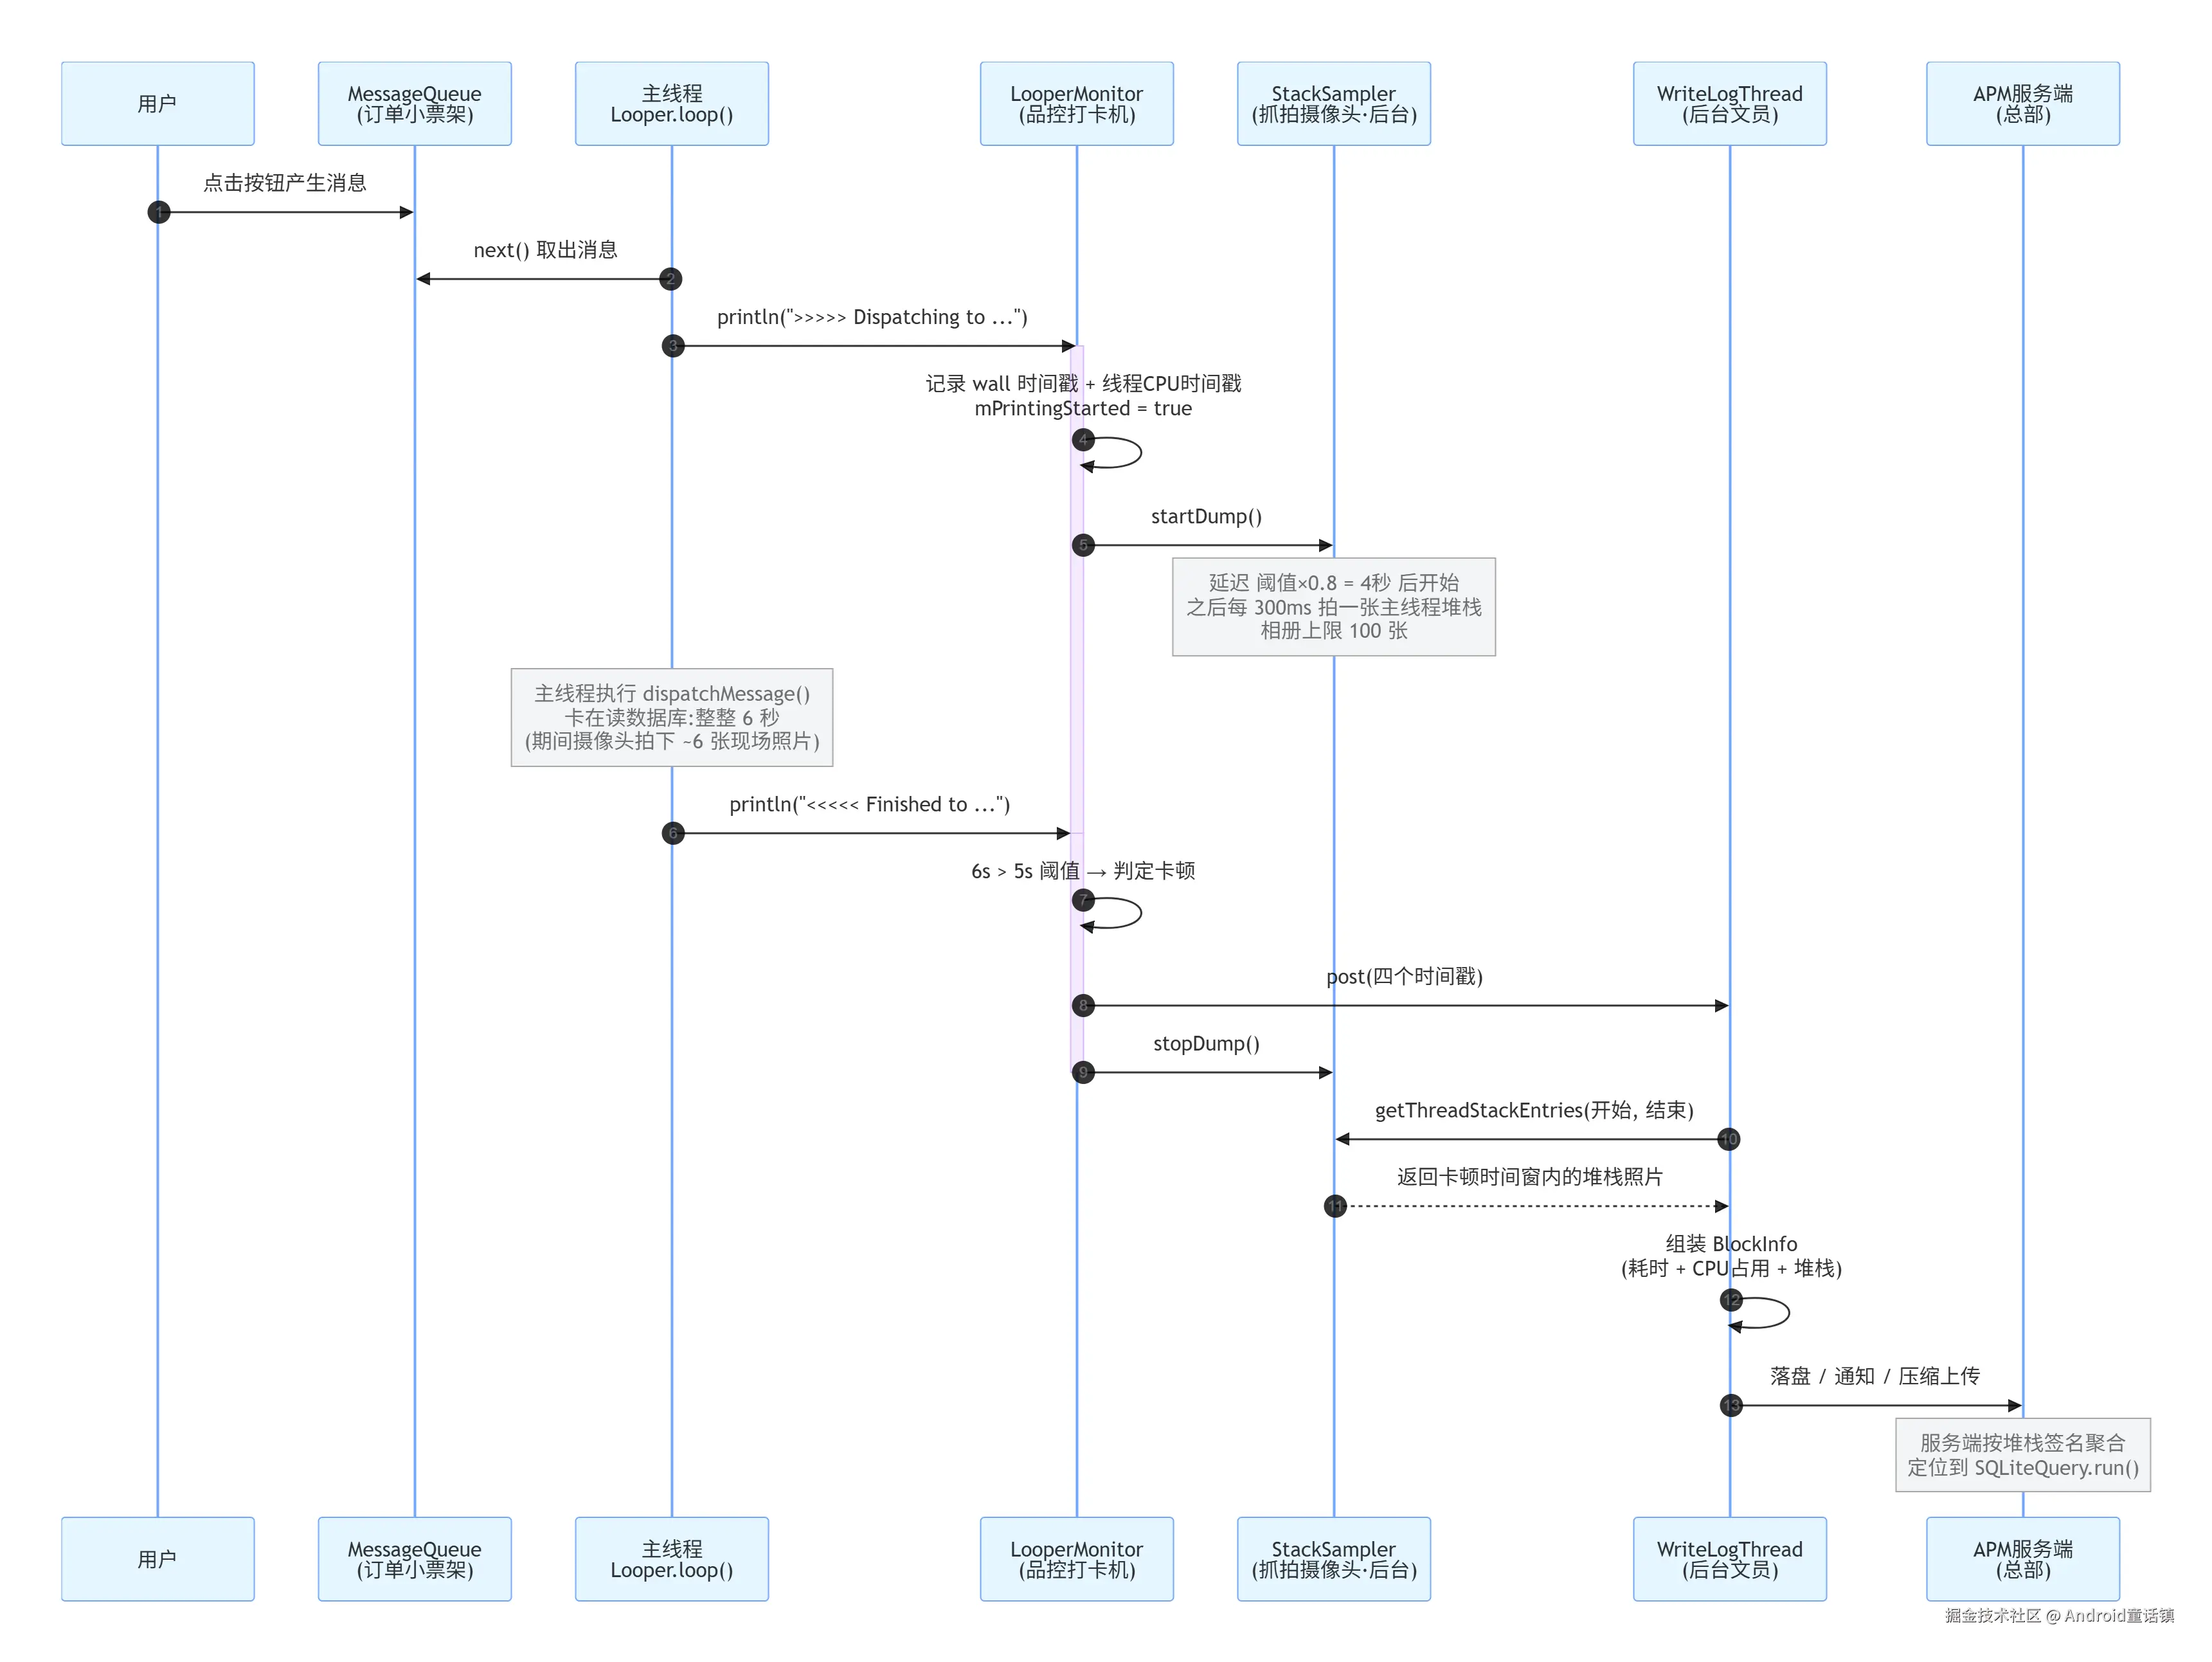
把上面所有角色放进同一张时序图。假设阈值 5 秒,主线程某条消息因为在主线程读了一个大数据库文件卡了 6 秒:
scss
用户MessageQueue(订单小票架)主线程Looper.loop()LooperMonitor(品控打卡机)StackSampler(抓拍摄像头·后台)WriteLogThread(后台文员)APM服务端(总部)点击按钮产生消息1next() 取出消息2println(">>>>> Dispatching to ...")3记录 wall 时间戳 + 线程CPU时间戳mPrintingStarted = true4startDump()5延迟 阈值×0.8 = 4秒 后开始之后每 300ms 拍一张主线程堆栈相册上限 100 张主线程执行 dispatchMessage()卡在读数据库:整整 6 秒(期间摄像头拍下 ~6 张现场照片)println("<<<<< Finished to ...")66s - 0s > 5s 阈值 → 判定卡顿7post(四个时间戳)8stopDump()9getThreadStackEntries(开始, 结束)10返回卡顿时间窗内的堆栈照片11组装 BlockInfo(耗时 + CPU占用 + 堆栈)12落盘 / 通知 / 压缩上传13服务端按堆栈签名聚合定位到 SQLiteQuery.run()用户MessageQueue(订单小票架)主线程Looper.loop()LooperMonitor(品控打卡机)StackSampler(抓拍摄像头·后台)WriteLogThread(后台文员)APM服务端(总部)对着图回顾一遍源码,五个关键时间点各就各位:
>>>>>打卡 → 记录双时钟、启动摄像头;- 阈值 × 0.8 时刻 → 摄像头开始每 300ms 连拍;
<<<<<打卡 → 计算耗时、判定超阈值;post到后台线程 → 组装 BlockInfo(无照片则不出报告);- 落盘、通知、上报。
四、两块手表的哲学:wall time 与 thread CPU time
回到 println() 里那两行容易一眼扫过的代码:
ini
mStartTimestamp = System.currentTimeMillis();            // 手表一:墙上时钟
mStartThreadTimestamp = SystemClock.currentThreadTimeMillis(); // 手表二:主厨的手表这是整篇原理里最容易被小白忽略、却最能体现 APM 功力的设计。
System.currentTimeMillis()(wall time,墙上时钟) :两点之间的真实经过时间,跟墙上的挂钟一样走。主厨做这道菜"实际花了 6 分钟"。SystemClock.currentThreadTimeMillis()(thread CPU time,线程 CPU 时间) :这个线程真正占着 CPU 干活的时间。注意它统计的是当前线程,且不包含线程休眠、阻塞、等待锁的时间------主厨"真正动手切菜 4.5 分钟,另外 1.5 分钟在等冰箱解冻"。
报告里的 realTimeStart/End 与 threadTimeStart/End(BlockInfo 中的 timeCost 字段)就是这两块手表的读数。两个数字的组合,直接决定你该往哪个方向查:
| 现象 | 主厨在干嘛 | 排查方向 |
|---|---|---|
| wall 长 + CPU 长(如 6s / 5.5s) | 真的在埋头猛干 | CPU 密集:死循环、大量计算、JSON 解析、过度绘制 measure/layout,直接看堆栈照片定位 |
| wall 长 + CPU 短(如 6s / 0.3s) | 大部分时间在等 | 等待型:锁竞争、Binder 跨进程调用、磁盘 I/O、线程被调度饿死------此时堆栈照片会显示停在 Object.wait()、BinderProxy 或 read() 上 |
| wall 短 + CPU 短 | 一切正常 | 忽略 |
BlockCanary 自己也承认"等"的场景需要更多证据------它的 CpuSampler 记录 /proc/stat 的整机与进程 CPU 占用,给报告打上 isCpuBusy 标记,就是为了帮你区分上面两种情况。更深一步的归因(到底是 Runnable 排队、Binder 等待还是 I/O),需要 Perfetto 这样的系统级 trace 才能精确回答------线程堆栈只能告诉你"卡在哪一行",不能告诉你"为什么卡在那里" 。
五、打卡机的三个坑:原作者没骗你,但你有必要知道边界
BlockCanary 的 README 里其实写了限制,但被太多文章断章取义成"装上就能监控卡顿"。用打卡机的比喻讲清楚三个坑,这也是现代 APM 方案改掉它的地方。
坑一:一个 Looper 只有一个插槽
less
public void setMessageLogging(@Nullable Printer printer) {
    mLogging = printer;   // 是赋值,不是 add
}
mLogging 是单个引用,不是列表。后果:
- 后安装的 SDK 会顶掉 先安装的。你的 App 同时接入监控 SDK A 和 SDK B,最后活着的是后
start()的那个,先来的从此失联、无人知晓; - 有些 SDK 停止时会把插槽清成 null,把别家 SDK 顺手带走。
生产级方案(如 Matrix)的对策是:在 install 时读取并保存旧 Printer,自己变成"分发中心" ------先转交给旧 Printer,再执行自己的逻辑;停止时恢复旧 Printer。但这依然防不住"别人后装覆盖我",所以多 SDK 共存时 Printer 冲突必须专项测试。一句话记住:这个插槽的官方语义是"替换",任何"共存"都是各家 SDK 私下协商的结果。
坑二:测量的口径不是"帧",更不是"流畅度"
打卡机测的是单条消息的 dispatch 耗时,它有几个天然盲区:
- 不含排队时间 。消息在
MessageQueue.next()里等待的时间(比如主线程忙不过来、消息积压)不在两次打卡之间------打卡从"开工"才开始。积压的队列可能在用户无感知地持续恶化。 - 不覆盖完整帧流水线。一帧的完整旅程是:输入处理 → 动画 → measure/layout/draw(主线程)→ RenderThread 录制绘制命令 → GPU 渲染 → SurfaceFlinger 合成 → 上屏。打卡机只能看到主线程 dispatch 那一段;RenderThread 之后的世界它一概不知。主线程打卡全绿但用户就是觉得卡,完全可能。
- 一条消息 ≠ 一帧。Choreographer 的一帧回调是一条消息,但一条消息也可能横跨多帧(比如一个超长的触摸事件处理),也可能一帧里塞了好几条消息。
所以现代方案把"帧体验"交给官方口径:API 24+ 的 FrameMetrics(系统直接给你每帧的完整时间线,包括 deadline)、Jetpack JankStats (在 FrameMetrics 基础上补了 UI 状态和低版本回退)。打卡机方案退守它真正擅长的领域------主线程停顿(main dispatch stall)检测 + 抓栈。
坑三:采样窗口有盲区
回忆摄像头的时间表:第一次抓拍在阈值 × 0.8 时刻,之后每 300ms 一张。这意味着:
- 一条超时消息卡顿开始后的前 0.8T 毫秒里没有任何照片。如果热点恰好发生在前段(比如先做了 800ms 的重计算,后面只是在等待),照片里看到的就是"等待",真正的热点被完美错过;
- 若时间窗内一张照片都没赶上(比如恰好卡了阈值+一点点),BlockCanary 会因为
threadStackEntries.isEmpty()直接不出报告------卡顿发生了,但你什么都看不到。
现代方案对此的改进是"堆栈采样与阈值判断解耦":要么全时段低频采样(用信号处理/sigquit 等更精细的手段),要么在 >>>>> 打卡后立刻补拍第一张。但无论怎么改进,基于采样的问题定位本质上都是"照片回放",不是全程录像------想看全程,请用系统 trace。
顺带回答一个高频面试题:"为什么不用
Thread.getStackTrace()每秒抓一次就完事?"------可以,但抓栈本身有成本(getStackTrace需要 VM 暂停目标线程拷贝栈帧),高频抓拍会让摄像头变成新的卡顿源。BlockCanary 的"超时才抓、0.8 阈值起拍、100 张上限"全部是在采集成本和现场完整性之间做平衡。
六、番外一:突发事件的遗言信箱------Crash 监控
卡顿监控之外,APM 还有一类更刚性的信号:Crash。它的原理不需要打卡机,用的是另一个官方预留的插槽------全局未捕获异常处理器。
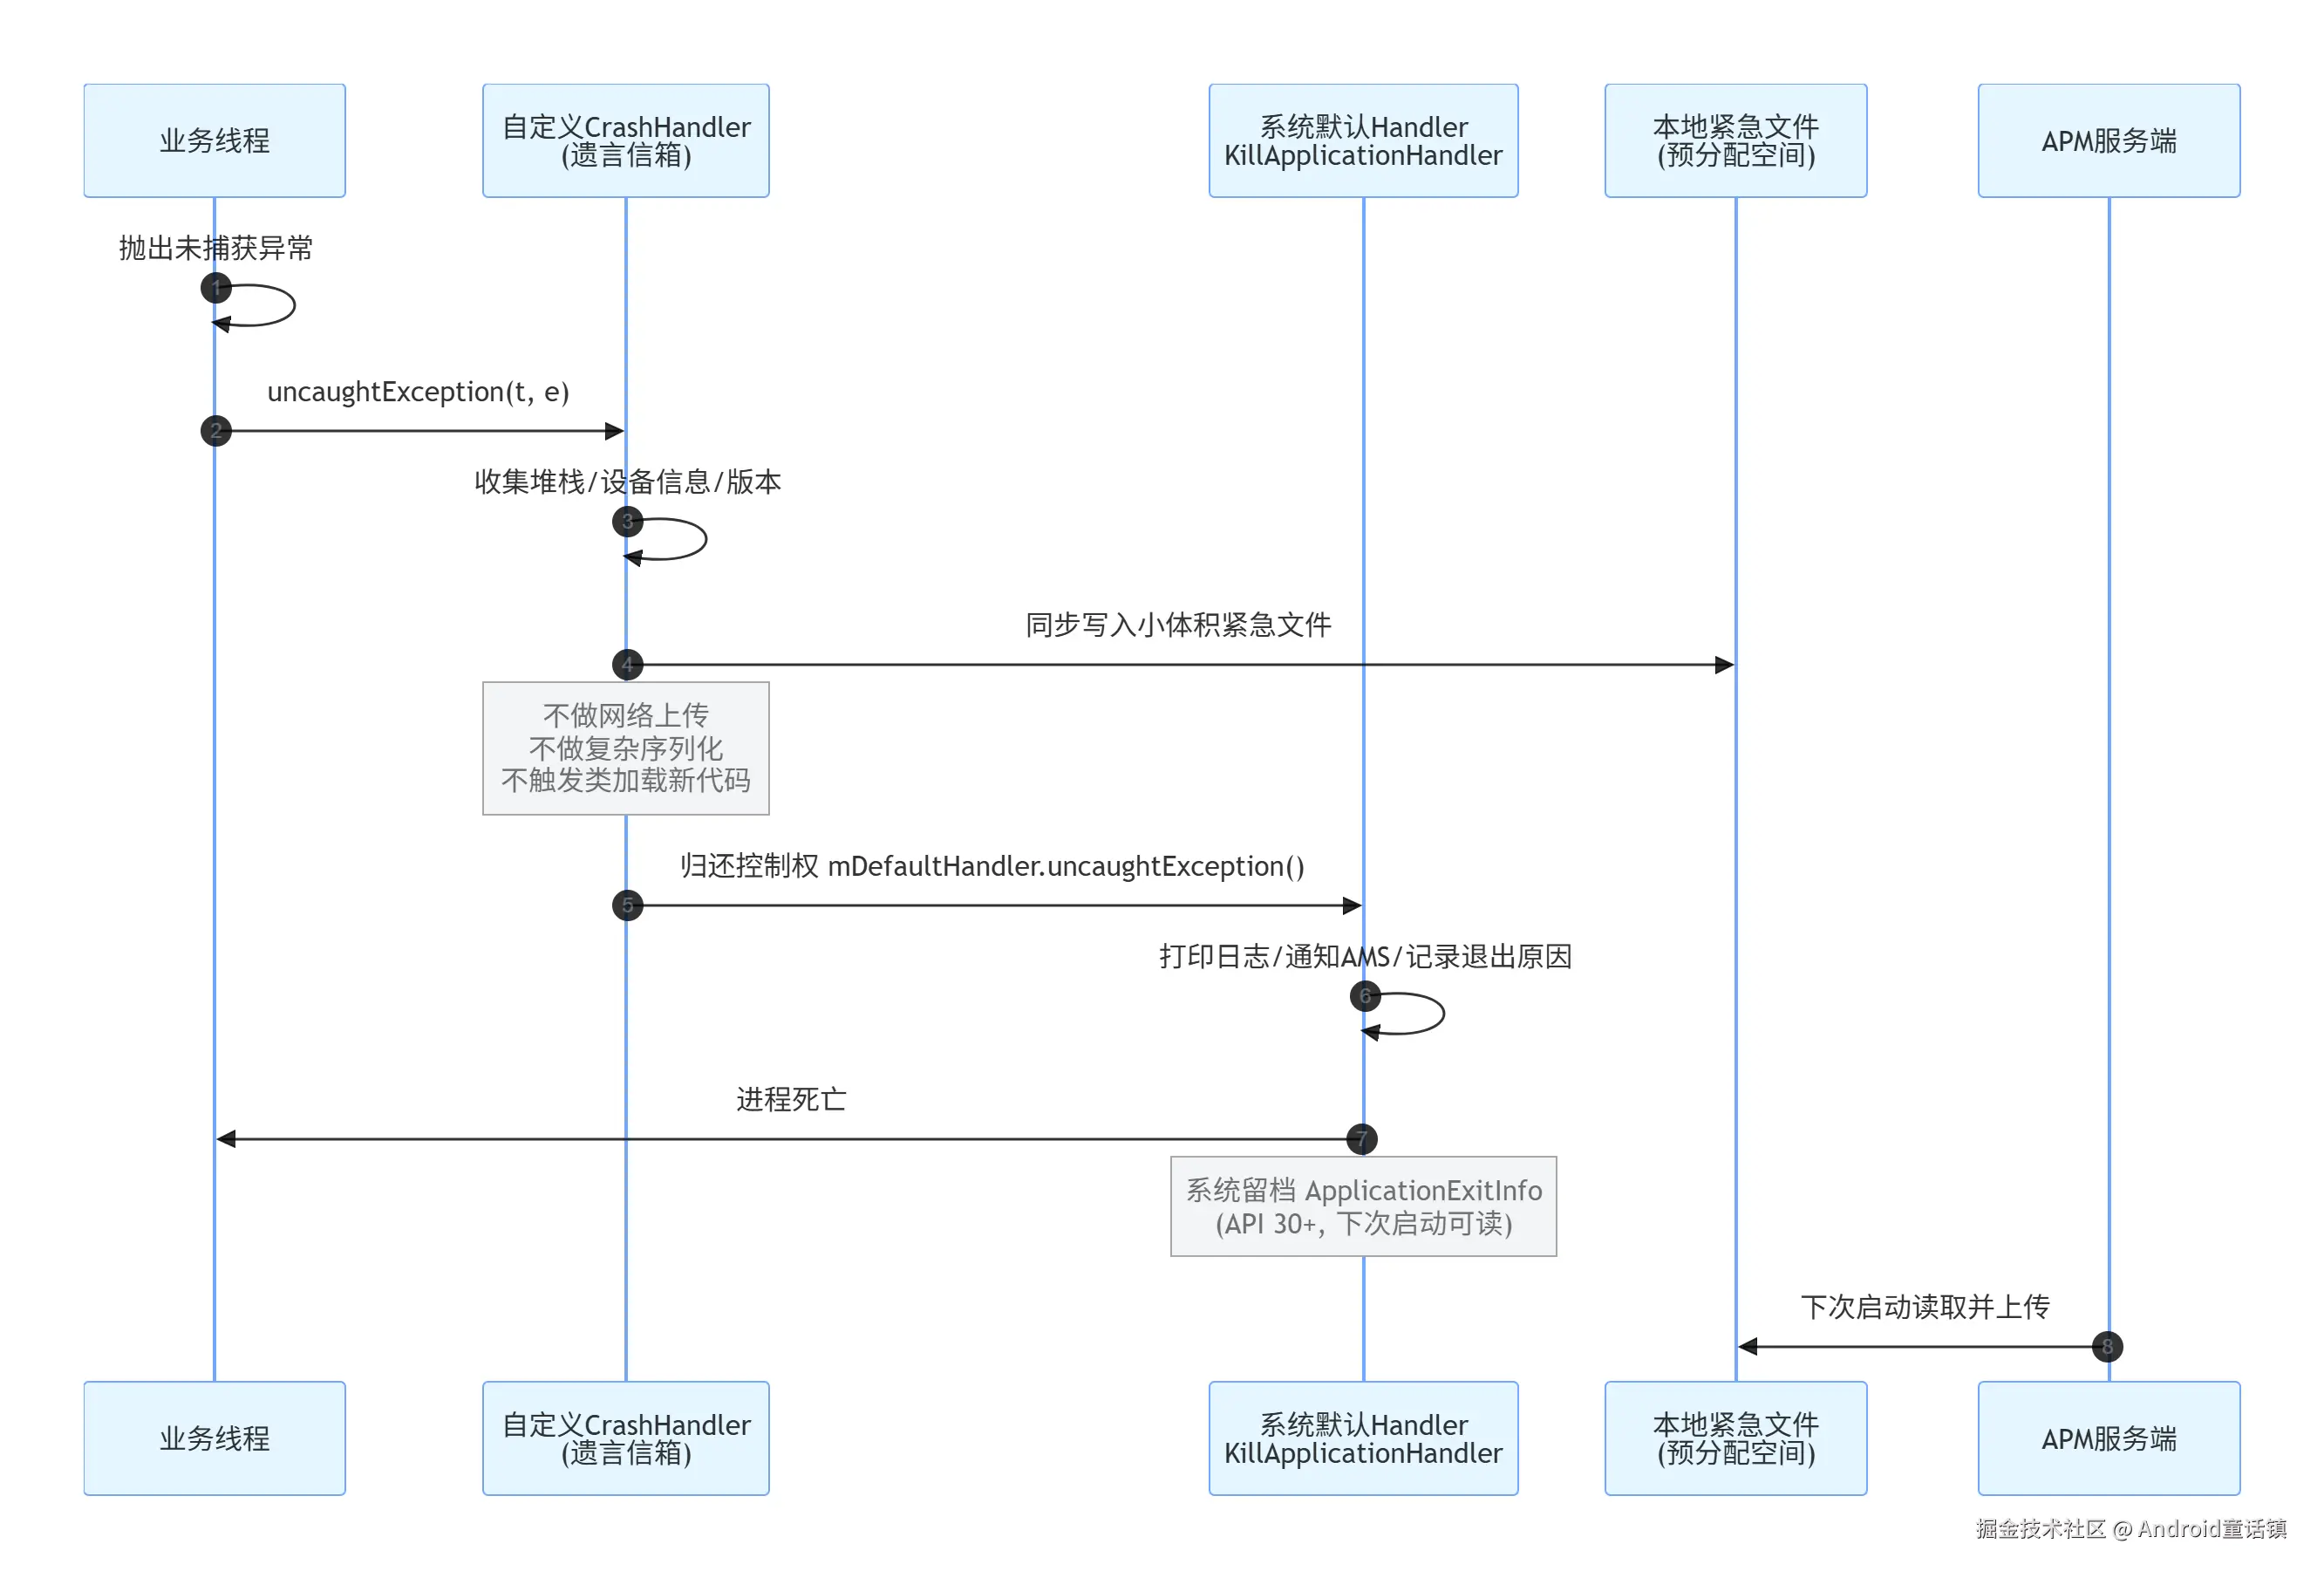
Java 线程死于未捕获异常时,会走 Thread.UncaughtExceptionHandler。JVM 启动时系统已经装好了默认处理器(RuntimeInit 里的 KillApplicationHandler,负责打日志、通知 AMS、杀进程)。APM 的做法是经典的三明治:
typescript
// 伪代码:Crash 监控的标准姿势
public class CrashMonitor implements Thread.UncaughtExceptionHandler {
private Thread.UncaughtExceptionHandler mDefaultHandler; // 保存系统默认的
public void init() {
mDefaultHandler = Thread.getDefaultUncaughtExceptionHandler();
Thread.setDefaultUncaughtExceptionHandler(this); // 换成自己的
}
@Override
public void uncaughtException(Thread t, Throwable e) {
try {
// 1. 抓现场:堆栈、设备信息、版本、内存状态
// 2. 关键约束:只做同步、小体积、可校验的本地持久化
// (此刻进程濒死,不要搞网络上传!)
saveCrashInfoToLocal(e);
} finally {
// 3. 千万不要忘记把控制权还给系统默认处理器,
// 否则 ApplicationExitInfo 等系统记录会断链
mDefaultHandler.uncaughtException(t, e);
}
}
}为什么第 3 步"归还控制权"如此重要?Android 11(API 30)引入的 ApplicationExitInfo 允许应用在下次启动时 读取进程上一次的退出原因(ANR、被 LMK 杀、被系统杀、异常退出等)。这条系统记录要靠默认处理器走完标准的死亡流程才会留下。如果你的自定义 handler 处理完直接 System.exit(),系统记录就断档了------这也是线上常见事故:自研 Crash 上报正常,但 getHistoricalProcessExitReasons() 里永远是空。
scss
业务线程自定义CrashHandler(遗言信箱)系统默认HandlerKillApplicationHandler本地紧急文件(预分配空间)APM服务端抛出未捕获异常1uncaughtException(t, e)2收集堆栈/设备信息/版本3同步写入小体积紧急文件4不做网络上传不做复杂序列化不触发类加载新代码归还控制权 mDefaultHandler.uncaughtException()5打印日志/通知AMS/记录退出原因6进程死亡7系统留档 ApplicationExitInfo(API 30+, 下次启动可读)下次启动读取并上传8业务线程自定义CrashHandler(遗言信箱)系统默认HandlerKillApplicationHandler本地紧急文件(预分配空间)APM服务端一个容易被忽略的细节:Native Crash(C/C++ 层的 SIGSEGV 等信号崩溃)不走 Java 的 handler ,需要 breakpad / Crashpad / xCrash 这类信号处理组件,涉及信号安全、unwind、符号化一整套工程,本文不展开。记住一句话即可:Java handler 只能听 Java 世界的遗言。
七、番外二:ANR------系统的判罚与 SDK 的预警,别混为一谈
很多老文章把 Looper 打卡方案称为"ANR 监控",这是不严谨的。用餐厅的话说:
- 系统 ANR 是监管机构的判罚:不是你觉得自己慢,是系统拿着精确的计时器判定你违规,然后可能当场处决(弹窗/杀进程)。
- Looper 打卡测到的是"单次主线程停顿" (stall):主厨连续 5 秒没出餐,你自己家摄像头拍到的预警。
两者的超时类型和阈值完全不同(不同版本/设备有差异,以下为常见值):
| 系统判定类型 | 触发条件(常见值) |
|---|---|
| Input dispatch timeout | 输入事件 5 秒内没被消费 |
| Broadcast timeout | 前台广播 onReceive 10 秒 |
| Service timeout | 前台 Service 生命周期回调 20 秒 |
| ContentProvider timeout | publish 10 秒等四类出口 |
而且系统 ANR 的判定逻辑横跨 InputDispatcher、AMS、系统 watchdog,很多场景(无焦点窗口、广播洪峰、freezer 冻结、Binder 线程池耗尽)Looper 打卡方案根本看不见。反过来,一次 5 秒的主线程停顿也不一定触发 ANR(如果期间没有输入事件要处理)。
所以现代 APM 的事件命名规范是明确的:SDK 抓到的叫 main_dispatch_stall,不许 叫 anr。真实的 ANR 证据来自两个系统渠道:
ApplicationExitInfo(API 30+):进程死亡后,下次启动读历史退出记录,getAnrInfo()返回发生 ANR 的进程、主题、时间------这是"已发生"的回执,但 trace 可能拿不到;- ANR 预警回调 (API 37 / Android 17 新增的
ActivityManager.registerAnrWarningListener()):接近超时时系统尽力回调一次,把"预警"和最终ApplicationExitInfo里的 anrId 关联起来------注意是"尽力回调",不能替代退出记录,且回调执行器不要用主线程(进程马上要被判罚了,主线程还可能活着吗)。
一句话总结这层关系:打卡机帮你提前抓栈自救,监管记录帮你事后对账,两份证据合在一起才能闭环。
八、番外三:内存监控一瞥------怀疑仓库被谁堆满了
内存泄漏监控的思路和卡顿完全不同:它不是"超时报警",而是"清仓盘点"。
以 LeakCanary 为例:在 Activity onDestroy() 后把它塞进一个弱引用 观察,等待 GC;GC 之后对象还活着?说明有强引用链拴着它------"值得进一步检查",随后抓 heap dump(Debug.dumpHprofData()),用 Shark 库离线分析引用链,找出谁在扣住对象。
但注意两个工程红线,一个真实的反面教材(某轻量开源 APM 的实现)值得每个初学者引以为戒:
- heap dump 会冻结整个进程并把堆写到文件里(可能几十上百 MB,还可能包含 token 等敏感数据)。生产环境必须采样触发、严格限频,不能常开;
- 主动 GC 是大忌:那个反面教材为了检测泄漏,在应用退后台时连续分配 4MB 大数组并主动请求 GC 来"逼出"泄漏对象------这等于为了查库存把全店盘点一遍,把正常营业的客人全部赶出去。用制造内存压力的方式探测泄漏,本身就是对被测对象的严重扰动。生产方案应该用采样 + 趋势指标(PSS/heap 曲线)做前哨,重样本只对命中样本定向抓取。
KOOM 这类线上内存框架的核心贡献是降开销 :Java fast dump(fork 子进程 dump,父进程几乎无感)、native leak 监控、以及针对大堆的流式分析。原理一圈看下来还是那句话:监控行为本身的开销,必须比它要发现的问题小得多。
九、集大成:一个能上线的最小 APM SDK 长什么样
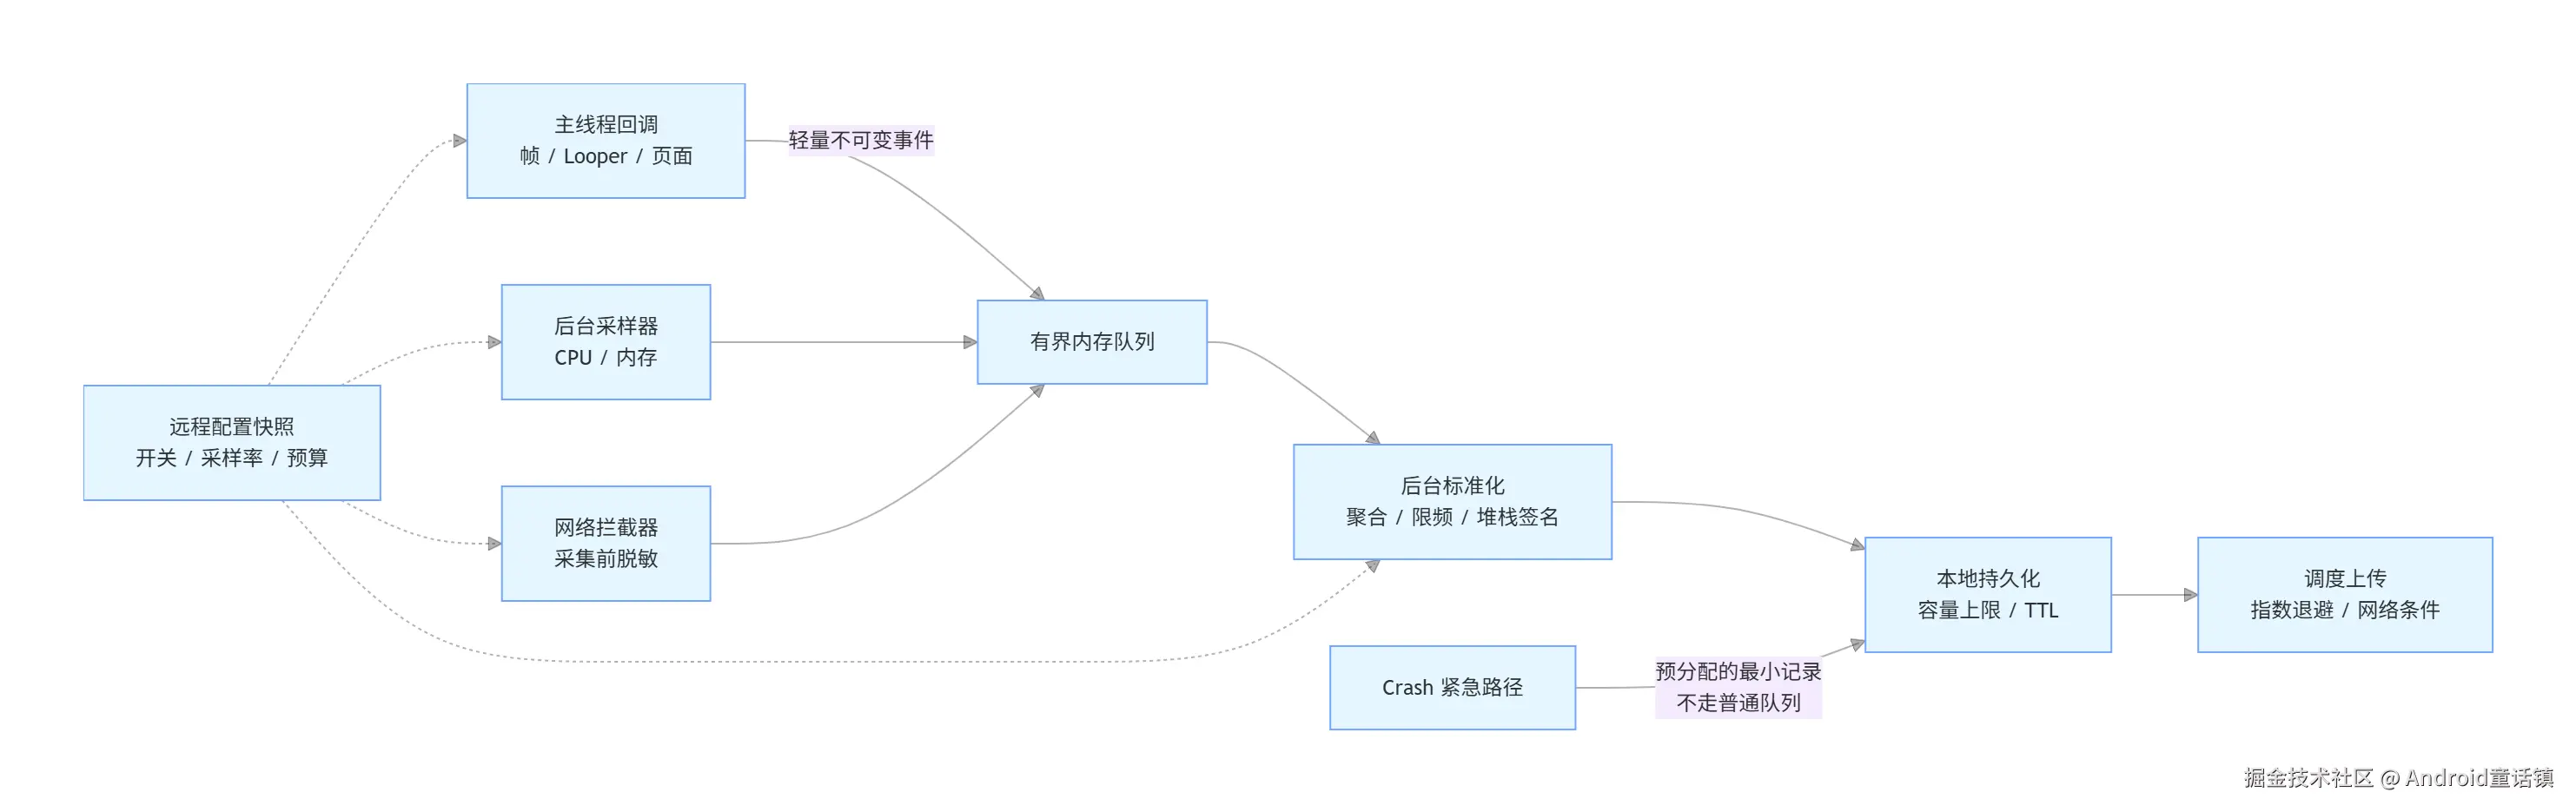
读完原理,把镜头拉远。一个生产级 APM 客户端,本质是一套有严格纪律的采集管线:
轻量不可变事件
预分配的最小记录
不走普通队列
主线程回调
帧 / Looper / 页面
有界内存队列
后台采样器
CPU / 内存
网络拦截器
采集前脱敏
后台标准化
聚合 / 限频 / 堆栈签名
本地持久化
容量上限 / TTL
调度上传
指数退避 / 网络条件
Crash 紧急路径
远程配置快照
开关 / 采样率 / 预算
图里每一个箭头都是血泪教训,展开三条最核心的纪律:
纪律一:主线程回调里只许造小对象。 帧回调、Looper 打卡、生命周期回调跑在主线程上,只允许创建不可变的小事件对象塞进有界队列 ------JSON 序列化、压缩、写文件统统滚到后台。"有界"两个字至关重要:历史上某轻量 APM 用了无界 LinkedBlockingQueue 转交事件,流量高峰时生产速度压过消费速度,队列无上限堆积------监控 SDK 自己把 App 监控出了内存问题。队列满时按模块策略丢弃并计数,丢弃数本身也要上报(你得知道自己丢了多少证据)。
纪律二:Crash 走紧急通道,不赌普通队列。 进程濒死时,普通队列可能来不及排空。崩溃信息必须同步写入尺寸受控、预分配、可校验的最小文件。
纪律三:上传要有预算和退避。 指数退避 + 随机抖动,避免配置更新后百万台设备同时连总部。事件要带 config_version 和 sample_rate,否则服务端无法解释"为什么这个版本上报量涨了十倍"。
最小事件协议长这样(示意,main_dispatch_stall 正是打卡机事件的现代命名):
css
{
  "schema_version": 3,
  "event_id": "018f7d7e-6a39-7f42-a3d1-78d39f0e9c31",
  "session_id": "s_7c2f",
  "process": { "name": "com.example.app", "instance_id": "p_b641" },
  "app": { "version_name": "8.4.0", "version_code": 840012 },
  "device": { "api_level": 37, "abi": "arm64-v8a" },
  "signal": {
    "type": "main_dispatch_stall",
    "dispatch_ms": 5213,
    "thread_cpu_ms": 4890,
    "threshold_ms": 3000,
    "window": "FeedActivity",
    "stack_signature": "com.example.db.FeedDao.queryAll"
  },
  "time": {
    "wall_ms": 1784973600123,
    "elapsed_realtime_ns": 983402100000
  },
  "config_version": 42,
  "sample_rate": 0.01
}
注意 dispatch_ms 与 thread_cpu_ms 并排出现------正是第四节的"两块手表"。服务端拿到后先按 stack_signature(堆栈签名)聚合,一个 5213ms 的个案就变成了"FeedActivity 的 queryAll 在 8.4.0 版本 P90 停顿 4.8s,影响 0.7% 会话"的排期依据。时长用单调时钟计算,wall_ms 只用于跨设备检索------墙上时钟可能被校时回拨,绝不能用来算时长。
十、尾声:官方正在一步步把打卡机标准化
最后看一眼时间线,你会发现 Android 官方正在把 APM 生态的"黑魔法"逐个收编成公开 API(ProcessLifecycleOwner、JankStats 等 Jetpack 库随依赖版本发布,不随系统版本):
| Android 版本 | APM 相关的公开能力 |
|---|---|
| 4.1 (16) | Choreographer 帧回调 |
| 7.0 (24) | FrameMetrics:系统直接上报每帧完整时序 |
| 11 (30) | ApplicationExitInfo:读取上次进程退出原因 |
| 12 (31) | FrameMetrics.DEADLINE 等完整帧时序(JankStats 据此给出超帧纳秒数) |
| 15 (35) | ProfilingManager:应用可请求系统抓 trace / heap dump / 栈采样 |
| 16 (36) | addProfilingTriggers():按触发器(如 APP_FULLY_DRAWN)自动采集 |
| 17 (37) | COLD_START / OOM / ANOMALY 等触发器;registerAnrWarningListener() ANR 预警 |
平台给的信号越来越准,但打卡机方案并没有失业------Looper.printer 至今仍是所有 APM 卡顿模块的地基,因为主线程停顿 + 低成本抓栈 这个组合,官方 API 到今天也没有给出对等物。理解原理的意义正在于此:工具会过时,但"官方在消息循环里留了一个观测点"这个设计事实不会变。
总结:三个带走的知识点
- APM 卡顿监控的地基是
Looper.setMessageLogging(Printer):主线程每条消息的执行被">>>>> Dispatching to"和"<<<<< Finished to"两次回调包夹,时间差即 dispatch 耗时。这是官方预留的观测点,一行源码都不用 hack。 - 测量口径决定优化方向:wall time 和 thread CPU time 两块手表组合定位是"真忙"还是"在等";dispatch 耗时 ≠ 帧耗时 ≠ 流畅度,帧体验请用 FrameMetrics/JankStats,别拿打卡机冒充。
- 监控 SDK 的第一美德是克制:主线程回调 O(1)、有界队列、采样触发重操作、Crash 走紧急通道、上报带预算------"采集行为本身不能成为性能问题",这条纪律比任何采集技巧都重要。
下次你接入手边的 APM SDK 时,不妨打开它的源码搜一下 setMessageLogging------十有八九,你会看到那台熟悉的打卡机。
参考资料
AOSP 源码
- Looper.java(AOSP main,含 loopOnce 与 Printer 调用点)
- SystemClock.java(currentThreadTimeMillis 语义)
- ApplicationExitInfo(API 30+)
BlockCanary / 开源 APM
- AndroidPerformanceMonitor(BlockCanary)仓库:文中源码取自
blockcanary-analyzer模块的LooperMonitor.java、AbstractSampler.java、StackSampler.java、BlockCanaryInternals.java - Matrix(腾讯):Trace Canary 等模块的 Printer 分发中心实现
- KOOM(快手) / LeakCanary(Square)
官方文档与 Jetpack
- JankStats / FrameMetrics
- ProfilingManager(API 35+)与 ProfilingTrigger(API 36+)
- Perfetto:系统级 trace,用于"为什么卡在那里"的深度归因